历史问题计算复用:面向LLM多轮推理的STAIR查询重寻址 Can Computation from Earlier Problems Help LLMs Solve New Ones?
冻结主干仅训12288参数学会读取历史K/V库,多轮推理最高提升11.67个百分点
前置知识
KV缓存(注意力键/值)
Transformer 自注意力的每层把输入投影成查询 Q、键 K、值 V,注意力输出是查询与键匹配后对值加权求和。推理时把已算过的 K/V 缓存起来可避免重复计算,这就是 KV cache。键决定被关注的地址,值决定读到的内容,二者必须配对使用。
STAIR 的核心就是把早前回答生成时的 K/V 存进只读库供当前查询重新读取,读懂方法必须先理解 K/V 各自扮演的角色。
RoPE 旋转位置编码
RoPE 通过按 token 位置旋转查询和键向量,把相对位置信息注入注意力分数,是 Qwen、LLaMA 等主流模型的标准位置编码。同一旋转作用于查询和键后,二者内积自然反映相对距离。
STAIR 在 RoPE 之前捕获库内 key,再为库单独分配一套辅助位置($0..M_t-1$,当前 token 为 $M_t+p$),理解这一点才能看懂它的重寻址机制。
Prefill 与 Decode 两阶段
LLM 推理分两步:prefill 并行处理整段输入 prompt,生成首 token 之前的所有内部状态;decode 逐 token 自回归生成。prefill 是大矩阵并行计算,decode 是串行小步,二者的计算形态和优化策略完全不同。
STAIR 的辅助分支只在当前 prompt 的 prefill 期间生效,之后按原生解码路径进行,这是它运行开销可控的关键设计。
Householder 反射
一种正交线性变换:沿单位法向 $u$ 把向量做镜像翻转,$\tilde q^R=\tilde q-2u(u^\top\tilde q)$,即反转向量在 $u$ 方向上的分量、保留垂直分量。它严格保持向量长度(保范数),几何上等价于关于一个超平面的镜面反射。
STAIR 用每个查询头可学习的法向 $n^{\ell,h}$ 对查询做反射,保范数性质保证只改变读取方向而不破坏表征数值稳定性。
Avg@4 与 Pass@4
推理评测的两种采样指标:每题采样 4 条回答,Avg@4 是 4 条回答正确率的平均值(衡量平均水平),Pass@4 是至少一条正确的题目占比(衡量覆盖上限)。本文每轮每题采 4 条,AIME 2025 每轮共 120 条响应,MATH-500 每轮 2000 条。
论文所有结果(Table 2 及附录 D 各表)都以 T2–T4 均值的 Avg@4/Pass@4 报告,这是解读其实验数字的基准语言。
LoRA 低秩适配
冻结原模型权重,在每个大权重矩阵旁加一个低秩旁路 $BA$(秩 $r\ll d$)作为可训练参数,是主流参数高效微调方法。本文对比的 LoRA 覆盖 36 层全部投影矩阵、秩 2,共 4,128,768 可训练参数,是 STAIR 的 336 倍。
STAIR 与 LoRA 的对比及联合训练实验(Table 4)是论证历史读取能力与权重适配互补性的关键证据。
研究动机
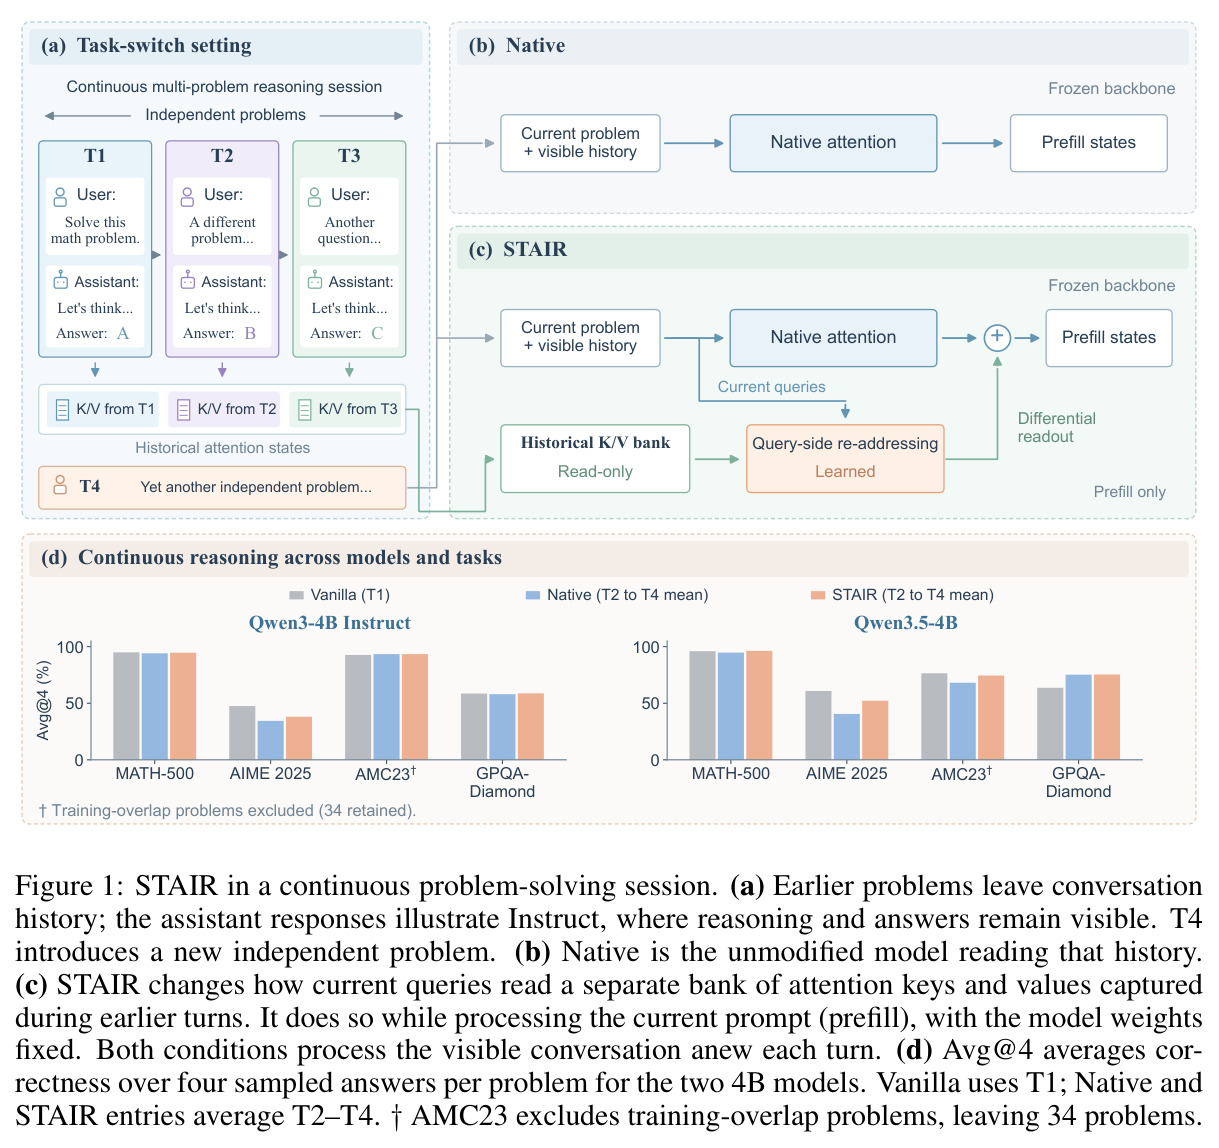
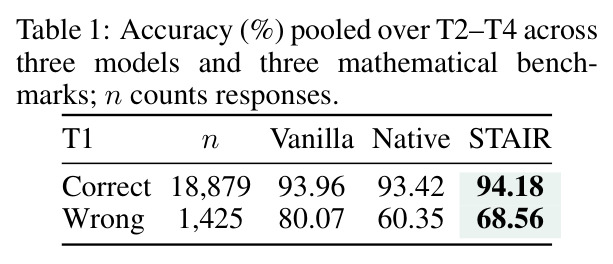
用户在同一会话里连续让 LLM 解相互独立的题目时,早前轮次的文本与内部计算都会留在上下文中。本文实测发现历史的作用是双刃剑:Qwen3-4B Instruct 在 MATH-500 上 Avg@4 从无历史 T1 的 95.00% 降到带完整历史的 T4 的 93.75%;而 Qwen3.5-4B 在 GPQA-Diamond 上却从 63.64% 升到 75.25%(T2/T3/T4 均如此)。更细的分组统计(Table 1)显示,即使会话第一题答对(18,879 条响应池),Native 的后续均值 93.42% 仍低于无历史的 93.96%;第一题答错时(1,425 条),Native 暴跌到 60.35%,而无历史为 80.07%。在 Qwen3-4B Instruct 的 MATH-500 上,T4 相对 T1 有 35 个答案由错转对、60 个由对转错,净降 1.25 个百分点。也就是说,保留历史既可能带来跨题收益,也可能系统性污染当前推理,何时有益何时有害此前并不清楚。
本文的目标是本文目标分两层。诊断层:在权重冻结、解码配置固定的条件下,精确刻画某个当前问题与某段源历史的配对如何在内部改变当前问题的表征——注意力如何分配到早前回答、表征位移有多大、其中哪些成分与具体配对相关、这种配对依赖的结构在不同历史之间是否可复现。方法层:既然历史状态必然被当前查询通过注意力读取,就应当学会怎么读——在不改动主干权重、只训练极少参数的前提下,有选择地强化或抑制历史状态的影响,把保留历史从风险变成可复用的计算资源,并在数学与科学推理基准、三种模型规模上验证其收益。
与已有工作不同的是,已有复用历史计算的工作多出于效率动机:Transformer-XL、Memorizing Transformers、Prompt Cache、CacheBlend、StreamingLLM 各自用递归、kNN 检索或缓存复用来提速,都不针对跨题准确率。多轮退化研究(Laban et al., 2026)停留在文本层面,且其任务是信息递增式而非每轮独立成题。本文的独特切入是:用冻结模型做交叉历史重放(每组 128 个当前问题×32 条三轮源历史,两组互斥,共 8,192 个配对单元),并把表征位移 $d^\ell(x,H)=h^\ell(x|H)-h^\ell(x|\emptyset)$ 分解为 $d^\ell=\mu^\ell+a^\ell(x)+b^\ell(H)+e^\ell(x,H)$,首次分离出配对特异的交互响应 $e^\ell$——它虽只占总位移能量的 0.69%/0.66%,却在不同源历史间保有 48.06%/46.50% 的 8 近邻重合率(打乱对照仅 11.73%/12.08%),由此提出把已完成问题的计算当作可学习读取的资源。
核心方法
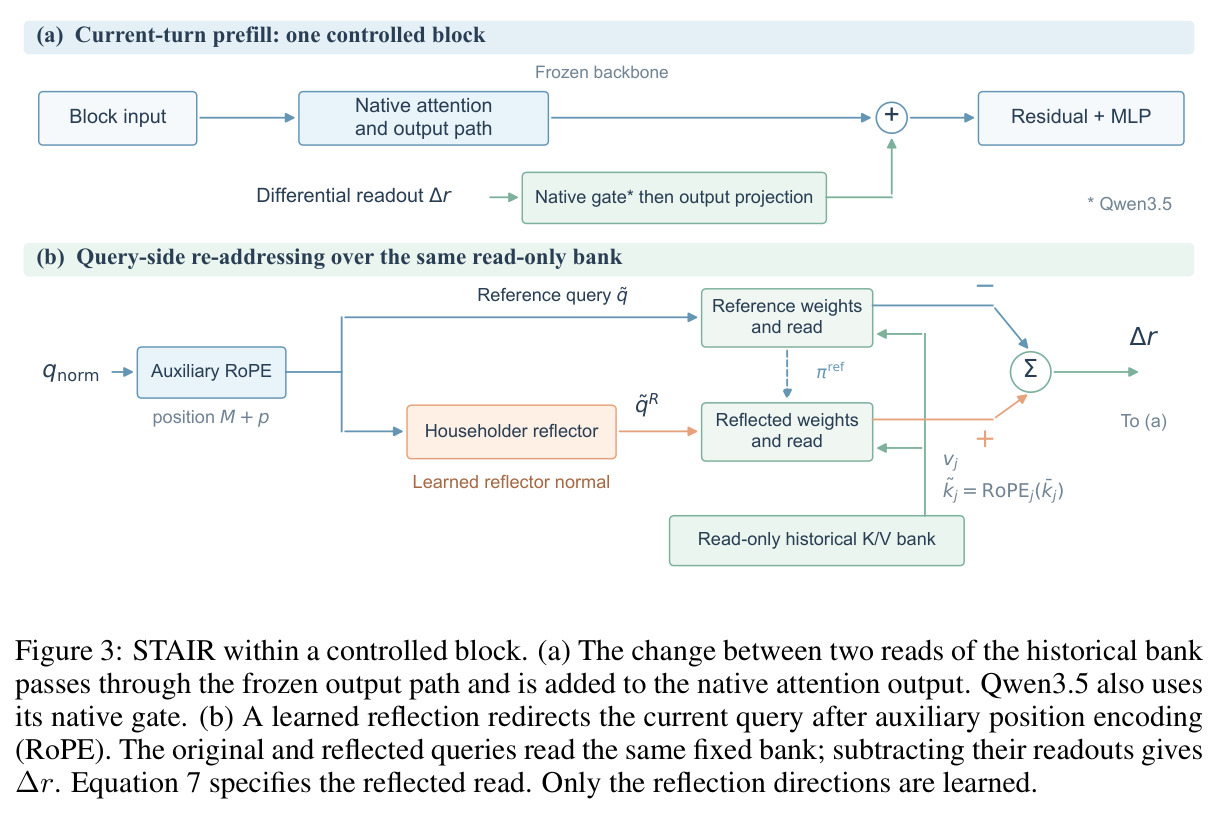
直觉上,早前题目的推理 K/V 是已经算好的草稿:Native 模型让当前查询按常规注意力原样读取它们,好坏全凭运气;STAIR 则给当前查询装上可学习的重新寻址机构。技术路线分四步:(1) 存储——把早前回答生成时受控层(零基索引 [3,11,19])的 K/V 立即 detach 存入只读库,key 取投影加归一化后、RoPE 之前的向量;(2) 重定位——当前轮 prefill 时为库内 token 分配辅助位置 $0,\dots,M_t-1$,当前 token 赋 $M_t+p$,再施加 RoPE;(3) 重寻址——每个查询头学习一个反射法向 $n^{\ell,h}$,用 Householder 反射 $\tilde q^R=\tilde q-2u(u^\top\tilde q)$ 改变查询方向,进而改变其在库上的注意力分布;(4) 差分注入——参考读取与反射读取之差 $\Delta r=r^R-r^{ref}$ 经冻结输出投影(Qwen3.5 再过原生门控)加回原生注意力输出。prefill 结束后辅助分支关闭,解码走原路径;主干全程冻结,每模型仅 12,288 个可训练参数。
核心创新是只学读取方式、不动存储与权重。与把历史压回输入(prefix/soft prompt tuning)、修改权重(LoRA)、或外挂可检索记忆(Memorizing Transformers)都不同,STAIR 把历史 K/V 冻结为只读库,唯一可学习的是每个查询头的反射法向,总共 12,288 个参数。其巧妙处有三:一是反射保范数,只旋转读取方向而不破坏表征尺度,且位移 $c=\tilde q^R-\tilde q$ 依赖当前查询,使共享反射器能对不同 token 产生不同的重寻址效果;二是差分读取 $\Delta r=\sum_j(\pi^R_j-\pi^{ref}_j)v_j$ 的权重和恰为零,精确隔离反射改变了什么,把注入量自然限制在与历史读取相关的子空间;三是与 Differential Transformer 的同层双注意力图相减形似而质不同——STAIR 相减的两个读取来自同一冻结历史库、仅由是否反射查询区分,且只在 prefill 阶段作用。
方法步骤详情
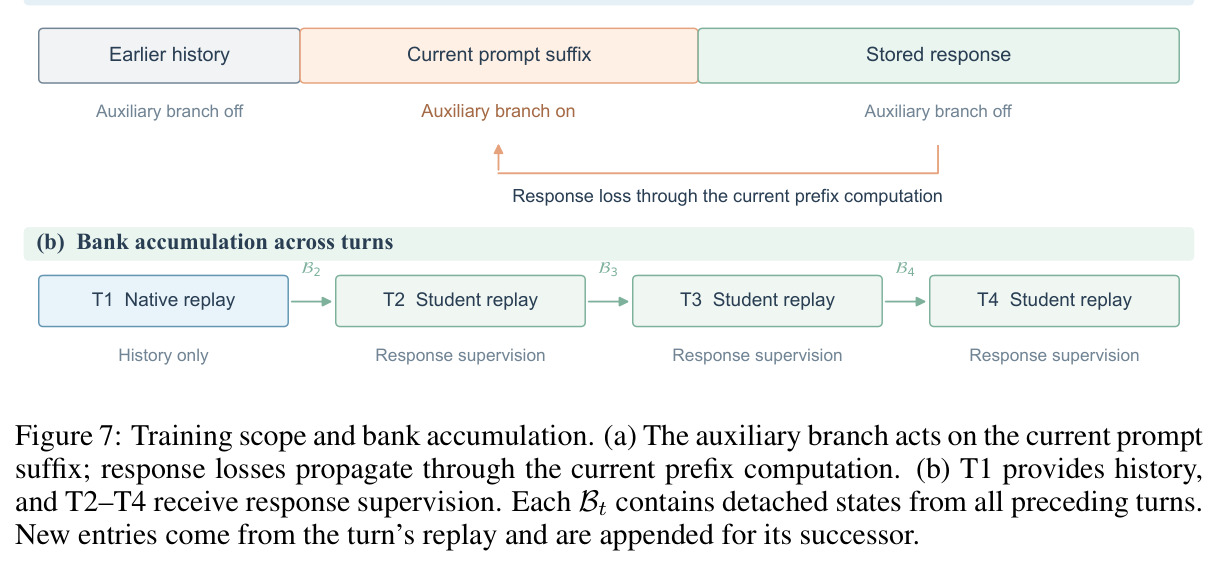
第一步捕获(每轮生成时):对受控层与 K/V 头存库 $B_{t,\ell,g}=\{(\bar k_{\ell,g,j},v_{\ell,g,j})\}_{j=0}^{M_t-1}$,Qwen3.5 捕获到最后 的推理体,Instruct 捕获回答体,全部立即 detach 并按轮拼接。第二步读取(当前轮 prefill):库键赋辅助位置 $0..M_t-1$、当前 token 赋 $M_t+p$ 后做 RoPE;法向归一化后做反射 $\tilde q^R=\tilde q-2u(u^\top\tilde q)$;参考分布 $\pi^{ref}_j=(1-\varepsilon)\mathrm{softmax}_j(\tilde q^\top\tilde k_j/\sqrt{d_h}+M_t)$,反射分布 $\pi^R_j\propto\pi^{ref}_j\exp(c^\top\tilde k_j/\sqrt{d_h})$。第三步注入:差分读取 $\Delta r=r^R-r^{ref}$ 过冻结 $W_O$(Qwen3.5 先乘门控)加到原生注意力输出,分支只作用于当前 prompt 后缀。第四步训练:用各模型在 DAPO-Math-17k(14,806 训练+128 验证题)的 rollout 组成 4 轮会话,T1 走 Native 供历史,T2–T4 教师强制,损失为 CE 加 $\lambda=1$ 的 $D_{KL}(p_{Native}\|p_{STAIR})$;AdamW、lr 0.003、单 epoch,只更新反射法向。
技术新颖性
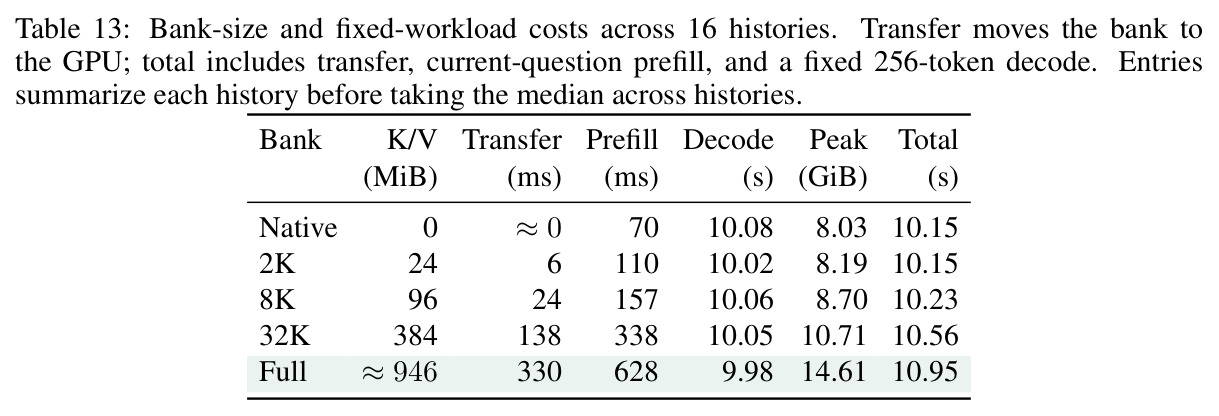
新颖性体现在三个层面。诊断上,本文首次用交叉历史重放加可加分解证明:不同源历史下,当前问题与历史配对的交互响应 $e^\ell(x,H)$ 虽只占总位移能量的不到 0.7%,其 8 近邻结构在不同历史间的重合率仍达 48.06%/46.50%(打乱对照 11.73%/12.08%),即历史的影响存在跨历史复现的问题依赖组织,这为可学习的读取规则提供了表征层面的依据。机制上,把查询侧寻址参数化为保范 Householder 反射是最小而充分的改动:每模型仅 12,288 参数(LoRA 的 1/336),却能稳定改变对冻结库的注意力分配。系统上,只读库加仅 prefill 的差分读取保证解码路径零改动,实测全库读取中位仅增加 0.81 秒和 6.60 GiB 峰值内存。区别于 Memorizing Transformers 的可检索记忆、Prefix-tuning 的输入侧连续提示、Coconut/CoLaR 的潜空间推理,STAIR 不改存储、不改权重、不改解码,只改当前查询如何读历史。
实验结果
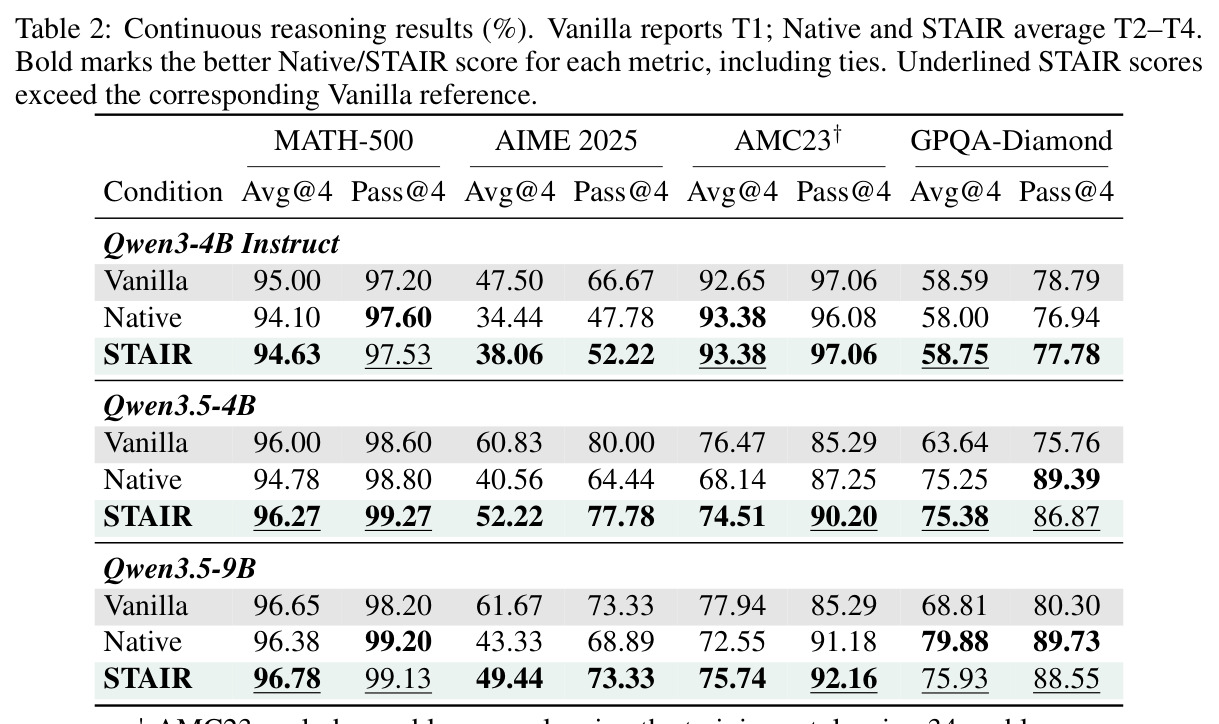
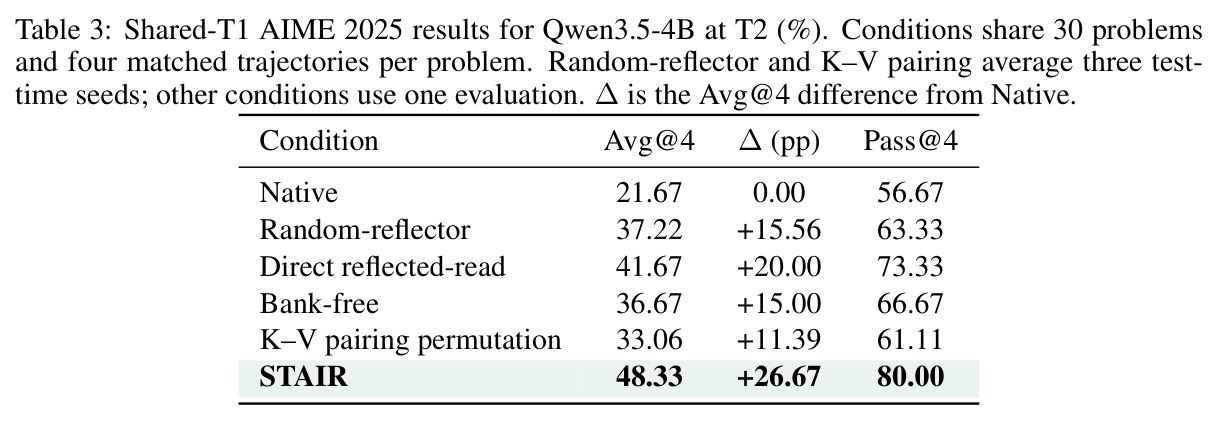
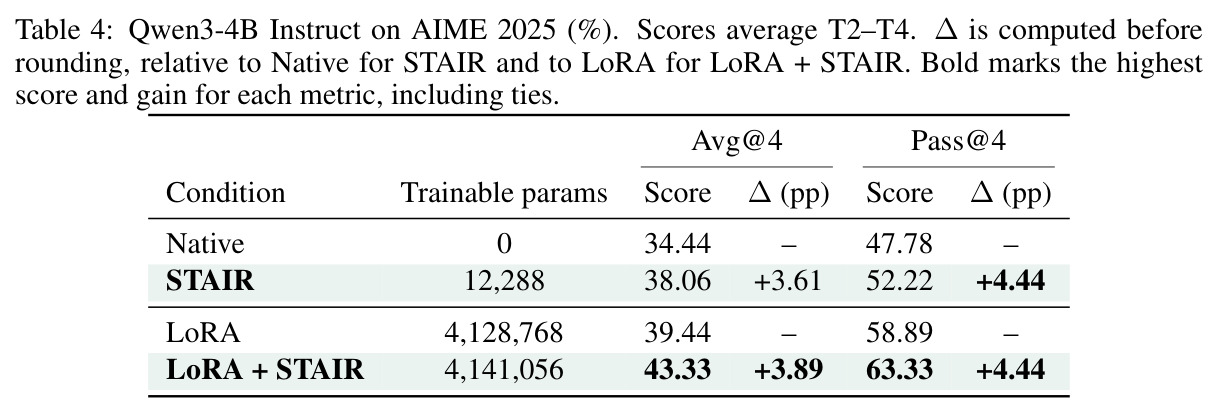
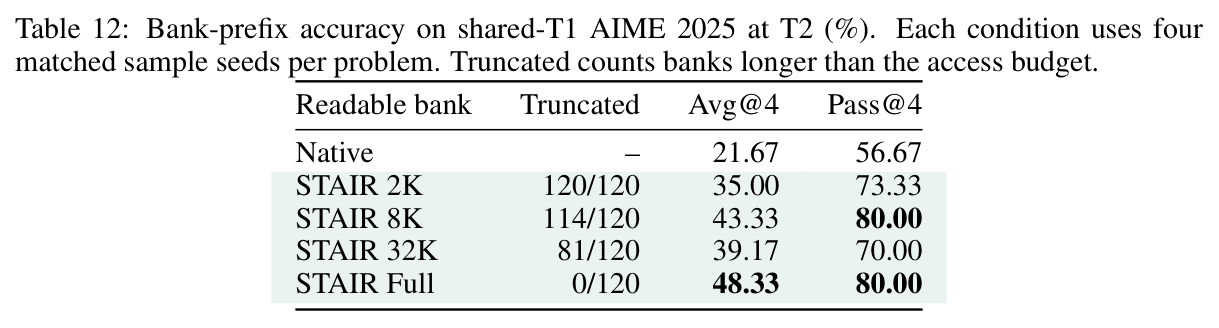
主实验(Table 2,T2–T4 均值)显示 STAIR 全面缓解历史干扰:AIME 2025 上 Avg@4 比 Native 提升 11.67pp(Qwen3.5-4B 40.56→52.22)、6.11pp(9B 43.33→49.44)、3.61pp(Instruct 34.44→38.06),每个后轮均提升且 Pass@4 同步上升;Qwen3.5 两模型在 MATH-500 双指标超过无历史 Vanilla(96.27 与 96.78),Qwen3.5-4B 在 AMC23† 上比 Native 高 6.37pp(68.14→74.51)。GPQA 上仅 Instruct 双指标改善(58.00→58.75),9B 反从 79.88 降到 75.93。消融(Table 3,共享 T1 的 AIME T2):STAIR 48.33% 对 Native 21.67%(+26.67pp),且高于随机反射器 37.22、直接反射读取 41.67、无库控制器 36.67、K–V 配对置换 33.06,说明作用于完好 K/V 配对的学习差分读取是关键。LoRA 对比(Table 4):LoRA+STAIR 43.33 比 LoRA 39.44 高 3.89pp。库前缀实验显示性能与库长度非单调(2K/8K/32K/全库=35.00/43.33/39.17/48.33);全库读取中位仅 +0.81 秒、+6.60 GiB 峰值内存。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME 2025 连续推理(Qwen3.5-4B,T2–T4 均值) | Avg@4 (%) | 52.22 | Native 40.56(无历史 Vanilla 为 60.83) | +11.67pp,为全文最大增益 |
| AIME 2025 连续推理(Qwen3.5-9B,T2–T4 均值) | Avg@4 (%) | 49.44 | Native 43.33 | +6.11pp |
| AIME 2025 连续推理(Qwen3-4B Instruct,T2–T4 均值) | Avg@4 (%) | 38.06 | Native 34.44 | +3.61pp(Pass@4 同升 +4.44pp) |
| 共享 T1 历史的 AIME 2025 T2(Qwen3.5-4B) | Avg@4 (%) | 48.33(Pass@4 80.00) | Native 21.67(Pass@4 56.67) | +26.67pp;且高于全部四个消融对照(33.06–41.67) |
| AMC23†(Qwen3.5-4B,T2–T4 均值) | Avg@4 (%) | 74.51 | Native 68.14 | +6.37pp |
| MATH-500(Qwen3.5-4B,T2–T4 均值) | Avg@4 (%) | 96.27(Pass@4 99.27) | Native 94.78 / 无历史 Vanilla 96.00 | +1.49pp,且两项均值均超过无历史参考 |
| AIME 2025(Qwen3-4B Instruct,与 LoRA 对比) | Avg@4 (%) | LoRA+STAIR 43.33 | LoRA 39.44 | +3.89pp;STAIR 仅增 12,288 参数,LoRA 有 4,128,768(336 倍) |
局限与改进
作者承认:反射方向是在数学题(DAPO-Math-17k)上拟合的,其对注意力的作用取决于当前查询与历史键,因此在 GPQA-Diamond 上两个 Qwen3.5 模型没有可比增益、9B 反降 3.95pp,读法规则呈现域相关性;证据限于 4 轮会话与 Qwen 家族;会话变长时库存储与 prefill 读取成本随之增长(全库中位 80.7K token、约 946 MiB,构建库的重放另需中位 7.29 秒)。我的补充观察:AIME 2025 每轮仅 30 题×4 采样=120 条响应、AMC23† 剔除 6 道训练重叠题后只剩 34 题,小样本使 +11.67pp 这类结论的方差偏大;STAIR 在 AIME 上的均值仍未追平无历史 Vanilla(如 Qwen3.5-4B 52.22 对 60.83),说明它缓解而非消除历史干扰;库长度与准确率非单调(8K 的 43.33 高于 32K 的 39.17)暗示读取对库内容敏感且缺乏选择性保留机制;Qwen3.5 的 Gated DeltaNet 层不受控,机制归因可能不完整;此外未与删除或摘要早前回答文本等简单基线对比。
独立分析的弱点
独立分析出六点弱点及改进方向。(1) 域迁移脆弱:数学训练的反射器在 GPQA 上对 Qwen3.5 无增益甚至有害(9B 79.88→75.93),可改用多域混合训练或按任务自动路由多组反射器。(2) 评测统计功效不足:AIME 每轮 120 条响应、AMC23† 仅 34 题,应换更大题库或报告置信区间与多种子方差。(3) 库无选择性:每轮全量追加 K/V,长会话成本线性增长(全库 6.60 GiB、中位 +0.81 秒),可引入重要性评分或记忆压缩(类似 attention sink、记忆合并)。(4) 反射是每头一个线性方向的极简参数化,表达力有限:可扩展为低秩双线性映射或每头小型 MLP,同时保持参数量小。(5) 差分读取只在 prefill 生效,解码阶段新 token 无法回读历史库:可在受限解码步上稀疏启用。(6) 训练目标用 KL 把 STAIR 拉向 Native 分布,可能限制超越 Native 的上限:可加入以答案正确性为奖励的强化学习来微调读取策略。
未来方向
作者提出的方向:用更广的任务切换训练混合检验域依赖;在预训练阶段就让主干学习任务切换下的读取;用 SFT 或 RL 适配随推理行为变化的读法;做选择性保留以控制库增长;LoRA+STAIR 联合训练已证明互补(+3.89pp),值得沿权重适配与历史读取共同学习的路线深入。基于本文成果还可延伸:(1) 把交互响应的近邻几何发展为多轮会话的通用诊断工具,定位历史干扰发生的层与成分;(2) 扩展到 agent 长程任务,复用工具调用与探索历史;(3) 库与主干解耦,研究跨模型甚至跨架构的库共享与迁移;(4) 与 Prompt Cache、CacheBlend 等 RAG/长上下文缓存系统做联合优化;(5) 从理论上分析保范反射为何足以改变推理结局,以及差分读取是否存在更优的参数化形式。
复现评估
复现条件相当友好。数据全部公开:MATH-500、AIME 2025、AMC23(math-ai/amc23)、GPQA-Diamond、DAPO-Math-17k;模型公开:Qwen/Qwen3-4B-Instruct-2507、Qwen3.5-4B、Qwen3.5-9B。训练极轻:每模型仅 12,288 参数,AdamW(lr 0.003)单 epoch、1,851–1,941 次更新,每次更新 8 个 4 轮会话、24 条监督响应,BF16+FlashAttention2,rollout 用 SGLang 生成;运行时测试单张 A800 80GB、batch 1 即可。附录 A–D 详细给出重放设计、捕获边界(RoPE 前 key、detach、 边界)、辅助 RoPE 与差分读取公式、训练目标与权重聚合、评测协议(解码参数、答案抽取判定、每轮分母 2,000/120/136/792)及逐轮结果,信息充分。正文未见明确代码开源链接。难度评估:中等——瓶颈在工程细节(教师强制重放的梯度流、Qwen3.5 混合架构下禁用跨轮 KV 复用等),而非算力门槛。
论文图表
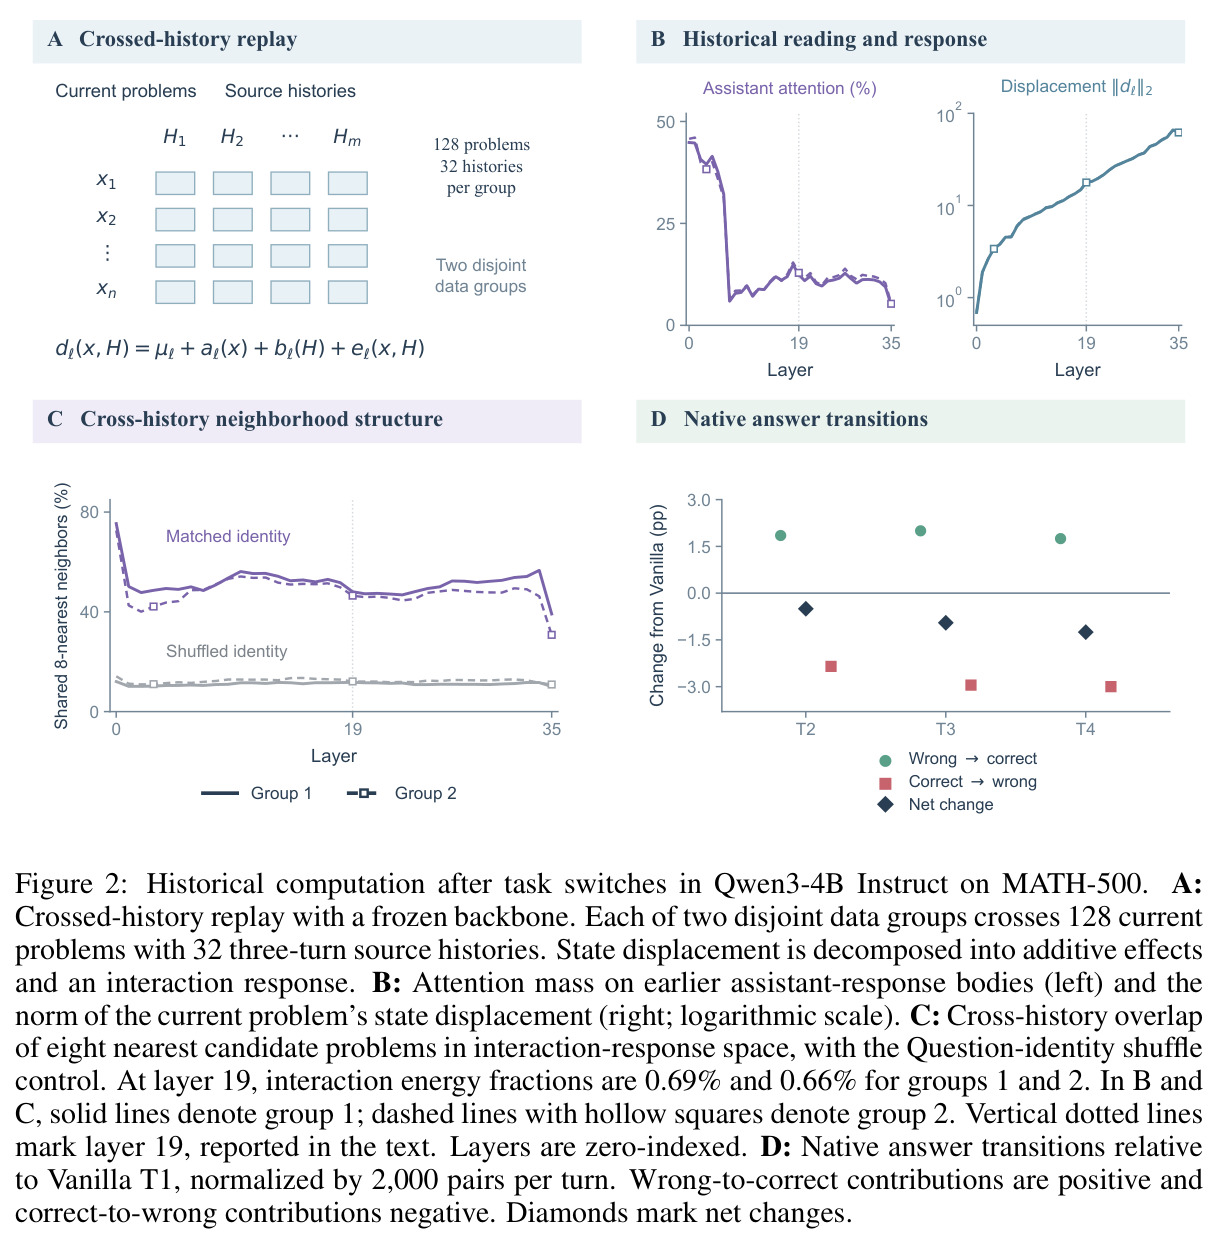
诊断实验总图。(A) 交叉历史重放设计:两组互斥数据各把 128 个当前问题与 32 条三轮源历史交叉,位移按 $d^\ell=\mu^\ell+a^\ell(x)+b^\ell(H)+e^\ell(x,H)$ 分解;(B) 当前问题查询对早前回答体的注意力质量(层 3 约 39%,层 19 仍约 12%)与表征位移范数(对数尺度,持续到深层);(C) 交互响应空间中 8 近邻的跨历史重合率 48.06%/46.50%,远高于打乱对照 11.73%/12.08%;(D) Native 相对 Vanilla 的答案转变:T4 时 35 个错转对、60 个对转错,净降 1.25pp。
支撑全文动机的核心证据链:历史注意力确实存在、位移可分解、交互成分虽小却具问题依赖结构、历史对答案正负影响并存。
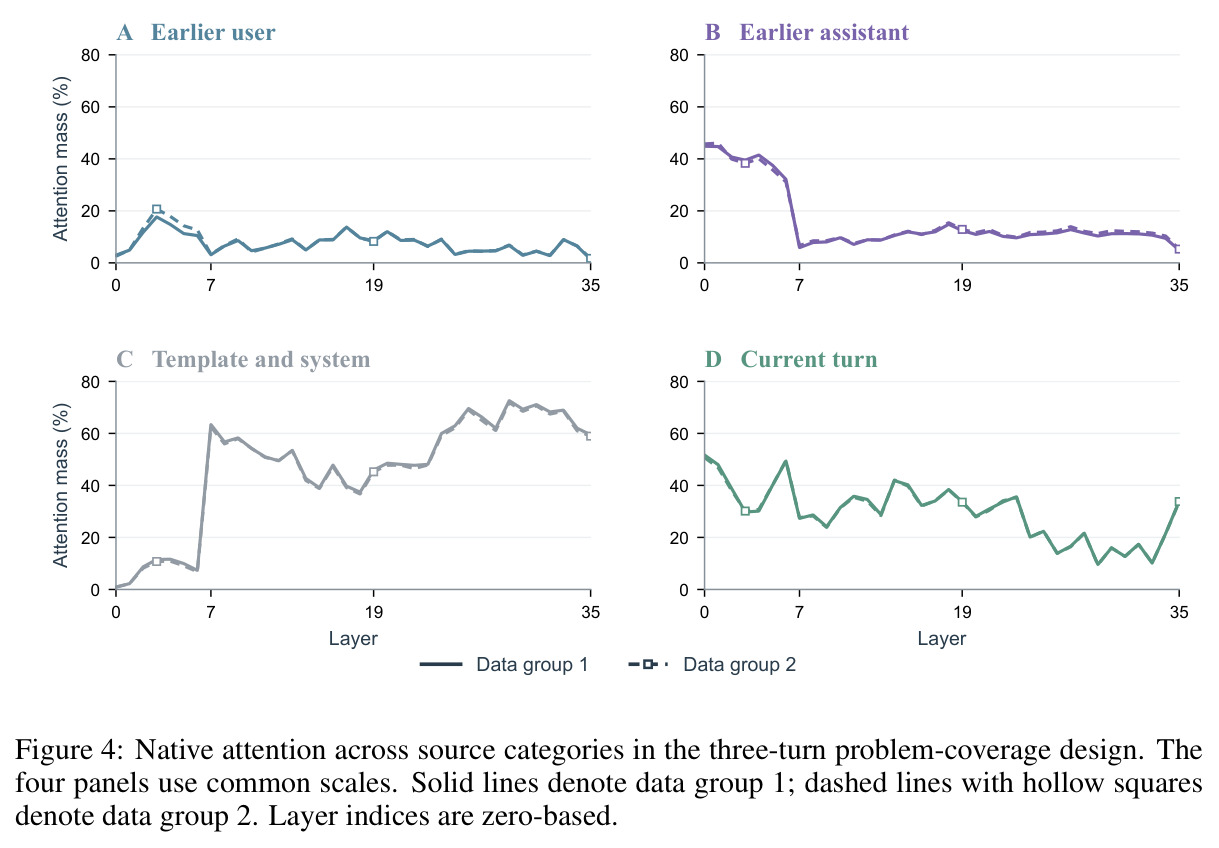
四面板分别给出当前问题查询分配给早前用户内容、早前回答体、模板/系统位置、当前轮位置的逐层注意力质量(两组数据、公共坐标轴)。早前回答体在层 3 吸引约 38–39% 注意力,到层 19 仍有约 12–13%,而模板/系统与早前用户内容的分布截然不同。
补充 Figure 2B,按来源类别细分注意力去向,说明模型确实在持续读取早前回答而非仅模板位置,是层选择 [3,11,19] 的依据之一。
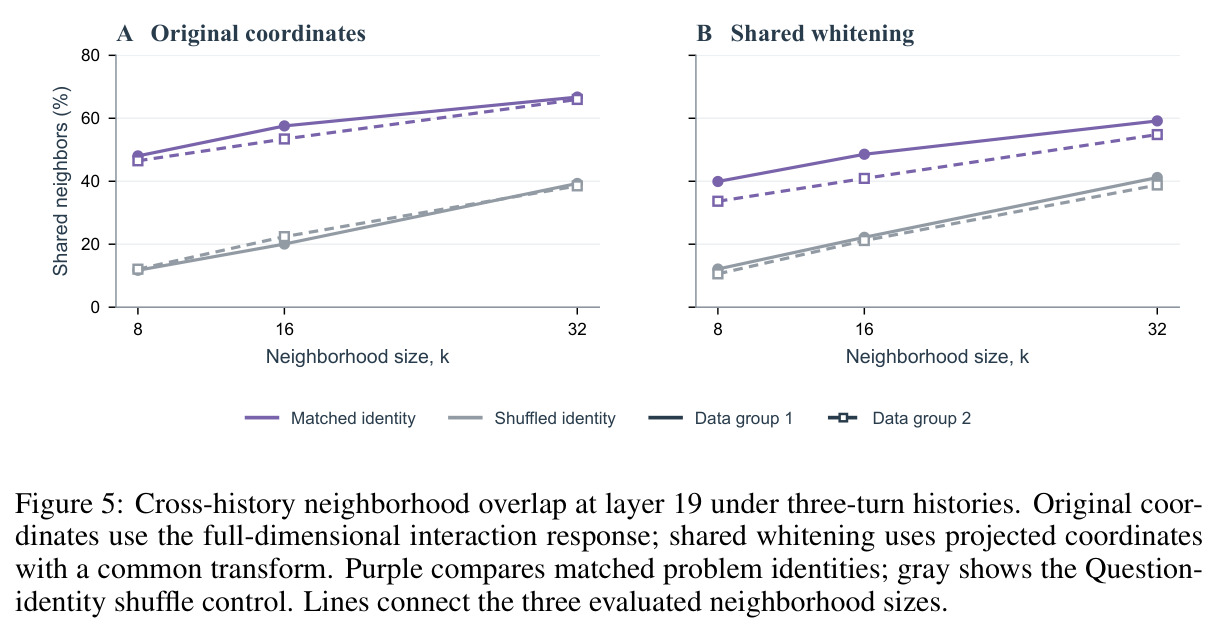
层 19 处跨历史近邻重合率随邻域大小 k(8/16/32)的变化:原始 2560 维交互响应坐标与共享白化坐标下,匹配身份的重合率(约 48%/46%,k=8)稳定高于问题身份打乱对照(约 12%);k 增大时差距保持。
交互响应稳健性的稳健性检验,证明问题依赖结构不是特定 k 或坐标选择造成的伪象。
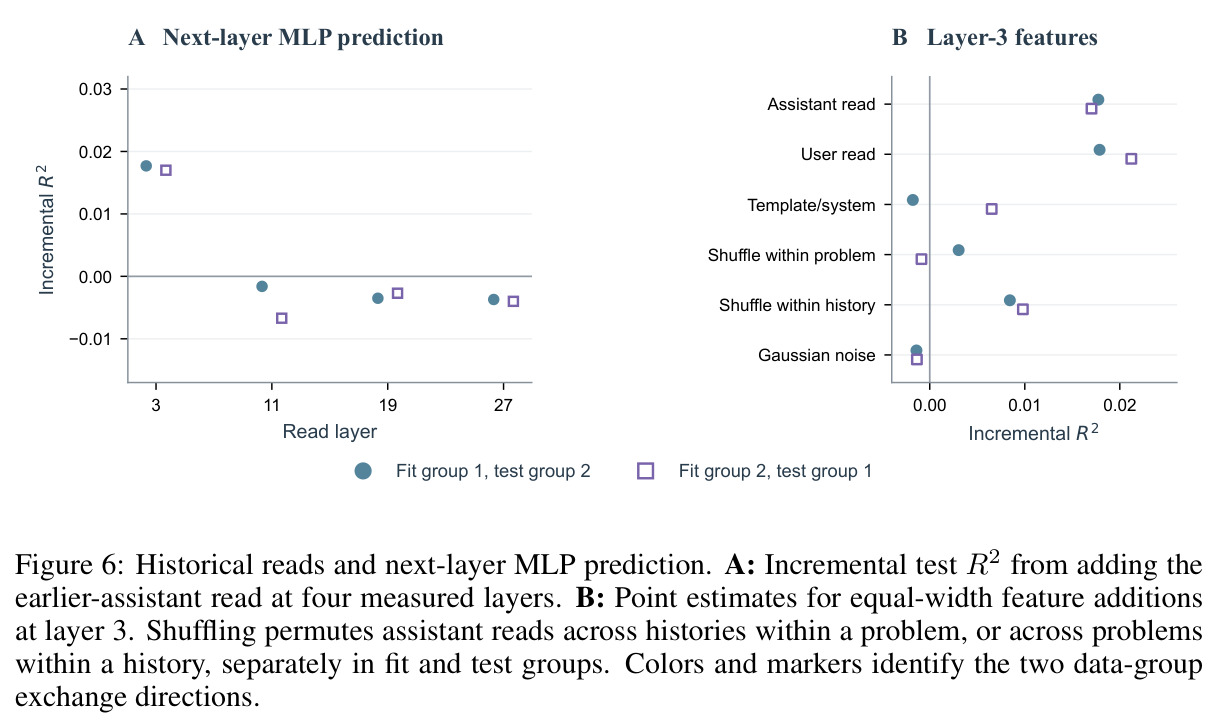
用岭回归预测下一层 MLP 输出位移。(A) 加入早前回答读取特征带来的增量 $\Delta R^2$ 集中在层 3(0.0177/0.0170);(B) 层 3 处各类特征对比:早前回答与早前用户读取携带相近信息,而按问题或按历史打乱后增量骤降到 0.00304/−0.00087,高斯噪声对照接近零。
把历史读取与后续计算联系起来,证明注意力读取确有因果性的下游作用,且打乱实验佐证读取内容的配对特异性。