LexReward:面向法律语言模型的分类学驱动奖励框架 LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
将法律回答质量分为风格、要素、推理链三维,训练首个中文法律奖励模型家族LexRM
前置知识
奖励模型与 RLHF
奖励模型是一个给定(输入,回复)对输出标量分的神经网络,通常用人类偏好对比数据配合 Bradley-Terry 损失训练,使其学会给更被偏好的回复更高分。在强化学习中它充当代价函数,指导策略模型的优化方向。
本文的核心产出 LexRM 就是一家族维度专用的法律奖励模型,理解奖励模型如何训练、如何被使用是读懂全文的基础。
DPO(直接偏好优化)
DPO 是一种绕过显式奖励模型的对齐方法:直接用成对的(好回复,坏回复)数据优化策略,提高好回复似然概率、降低坏回复似然概率。它计算简单、稳定,是目前最常用的偏好对齐算法之一。
本文用量表奖励构造的偏好数据做 DPO 训练,并与 SFT、GRPO 对比效果,是下游实验的重要组成部分。
GRPO(组相对策略优化)
GRPO 是一种免 value 网络的强化学习算法:对每个查询采样一组回复,用组内回复的奖励均值作为基线,以相对优势作为优势函数更新策略。它因 DeepSeek 系列模型而广为使用,适合可验证奖励与学习型奖励两类信号。
本文把 LexRM 接入 GRPO 作为奖励函数(GRPO(RM)),并与规则结果奖励(GRPO(rule))对比,证明细粒度奖励的优势。
LLM-as-a-Judge
用一个强大的 LLM 按给定评分标准(rubric)对候选回复打分或排序,代替人工或专门训练的评估器。优点是灵活、可理解上下文;风险是存在 judge 偏差、位置偏好等。
本文中 Element 维度和开放场景的 Chain 维度完全依赖带量表的 LLM judge(DeepSeek-V4-Flash)生成奖励,这是奖励体系的一半。
KL 散度与统计距离度量
KL 散度度量两个概率分布的差异,$D_{KL}(P\|Q)=\sum_t P(t)\log\frac{P(t)}{Q(t)}$,非对称且非负。欧氏距离则度量两个向量的直线距离。两者常用于比较文本的词频分布、n-gram 覆盖率等统计特征。
Style 维度的规则奖励完全建立在这些度量上:法律术语与情感词分布用 KL 散度,句长统计与 n-gram 搭配覆盖用欧氏距离,不懂这些就读不懂公式推导。
任务向量与模型合并
从同一预训练骨干出发微调出的不同任务模型,其参数更新 $\tau_d=\theta_d-\theta_0$ 称为任务向量。若各任务向量近似正交,可直接线性相加(task arithmetic)得到同时具备多任务能力的单一模型,无需重新训练。
LexRM-Merge 正是用 $\theta_{merged}=\theta_0+\sum_d\lambda_d\tau_d$ 把三个维度奖励模型合为一体,依赖任务向量余弦相似度极低(≤0.03)这一实证观察。
研究动机
法律大模型的输出质量远不止“最终答案是否正确”。一份合格的法律回答需要准确识别当事人与案件事实、援引恰当法条、构建完整且无冗余的推理链,并用严谨客观的法律语言表达结论。然而现有法律 AI 的奖励设计大多依赖两类粗糙做法:一是通用奖励模型的整体打分,二是只评估判决结果的正确性,如预测罪名、法条或赔偿金额是否与标准答案一致(Unilaw-R1、Legal∆ 等法律 RL 工作均属此类)。这类方法无法判断性能提升究竟来自真正的法律质量改善,还是仅仅利用了回复长度、语言流畅度等表面特征;更根本的问题是,缺少对“法律回答质量”的结构化定义,导致奖励应该评估什么都不明确。
本文的目标是本文的目标是为法律语言模型建立一套可解释、可操作的奖励体系。具体包括:邀请法律专家构建法律回答质量的三维分类学(Style 文风、Element 要素、Chain 推理链),并把每个维度细化为可评估的细粒度标准;针对每条标准设计评分量表,根据是否依赖输入上下文选用规则评估器或 LLM judge 生成奖励信号;用这些奖励在 5 个模型的候选池上构造成对偏好数据,既用于 DPO 训练,也用于训练中文法律奖励模型家族 LexRM(Style/Element/Chain 三个专用模型加一个任务算术合并的 LexRM-Merge);最终验证这些奖励在 Test-Time Scaling 候选选择和 GRPO 强化学习中的有效性,且奖励时不需要参考答案。
与已有工作不同的是,与已有工作的差异在于系统性。此前的法律领域过程奖励(如 SCPRM)只针对特定任务(刑法知识图谱问答);通用细粒度评估方法(如 Prometheus)提供了量表化评估范式,但缺少法律领域特有的质量定义;Legal∆ 等法律强化学习工作依赖可验证的最终答案作为结果奖励,无法监督得出答案的推理过程本身,也不适用于开放式法律场景。LexReward 从法律专家的自顶向下规范与模型错误归纳的自底向上分析双向构建分类学,再将领域质量定义完整贯通到量表奖励、偏好数据、奖励模型训练与策略优化全链条,是首个面向中文法律场景的系统性奖励建模框架。
核心方法
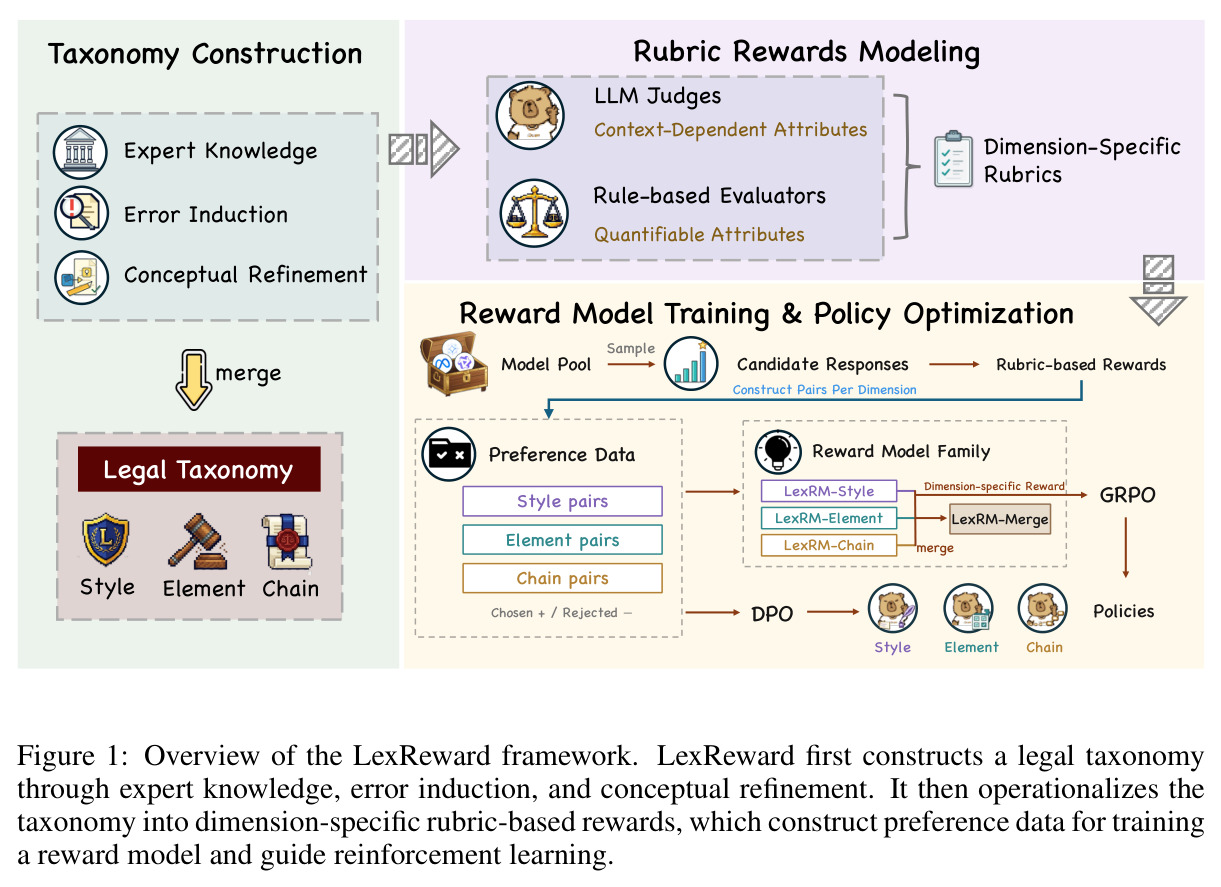
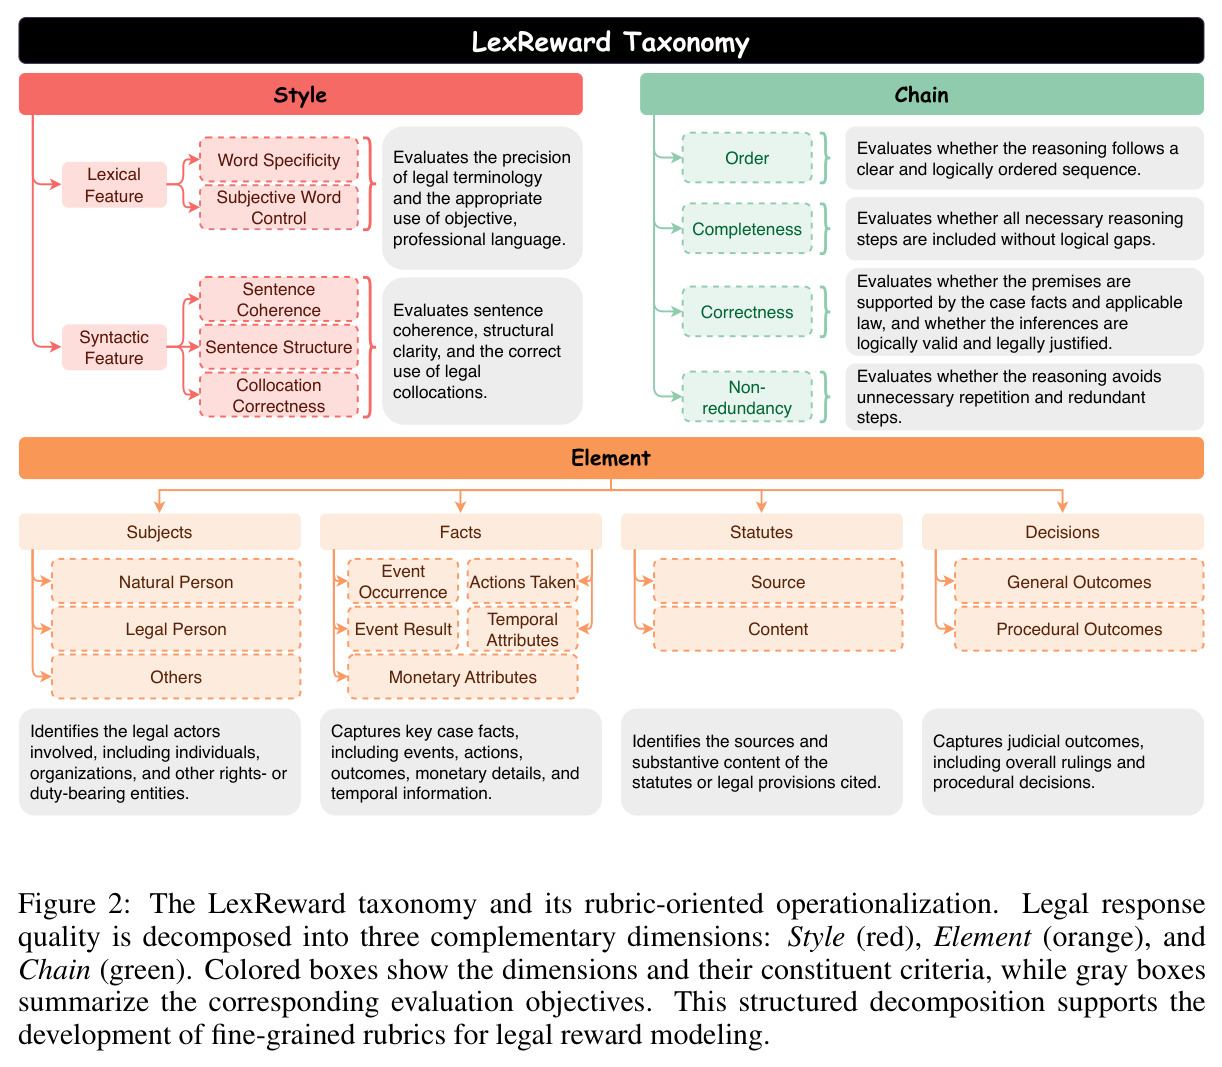
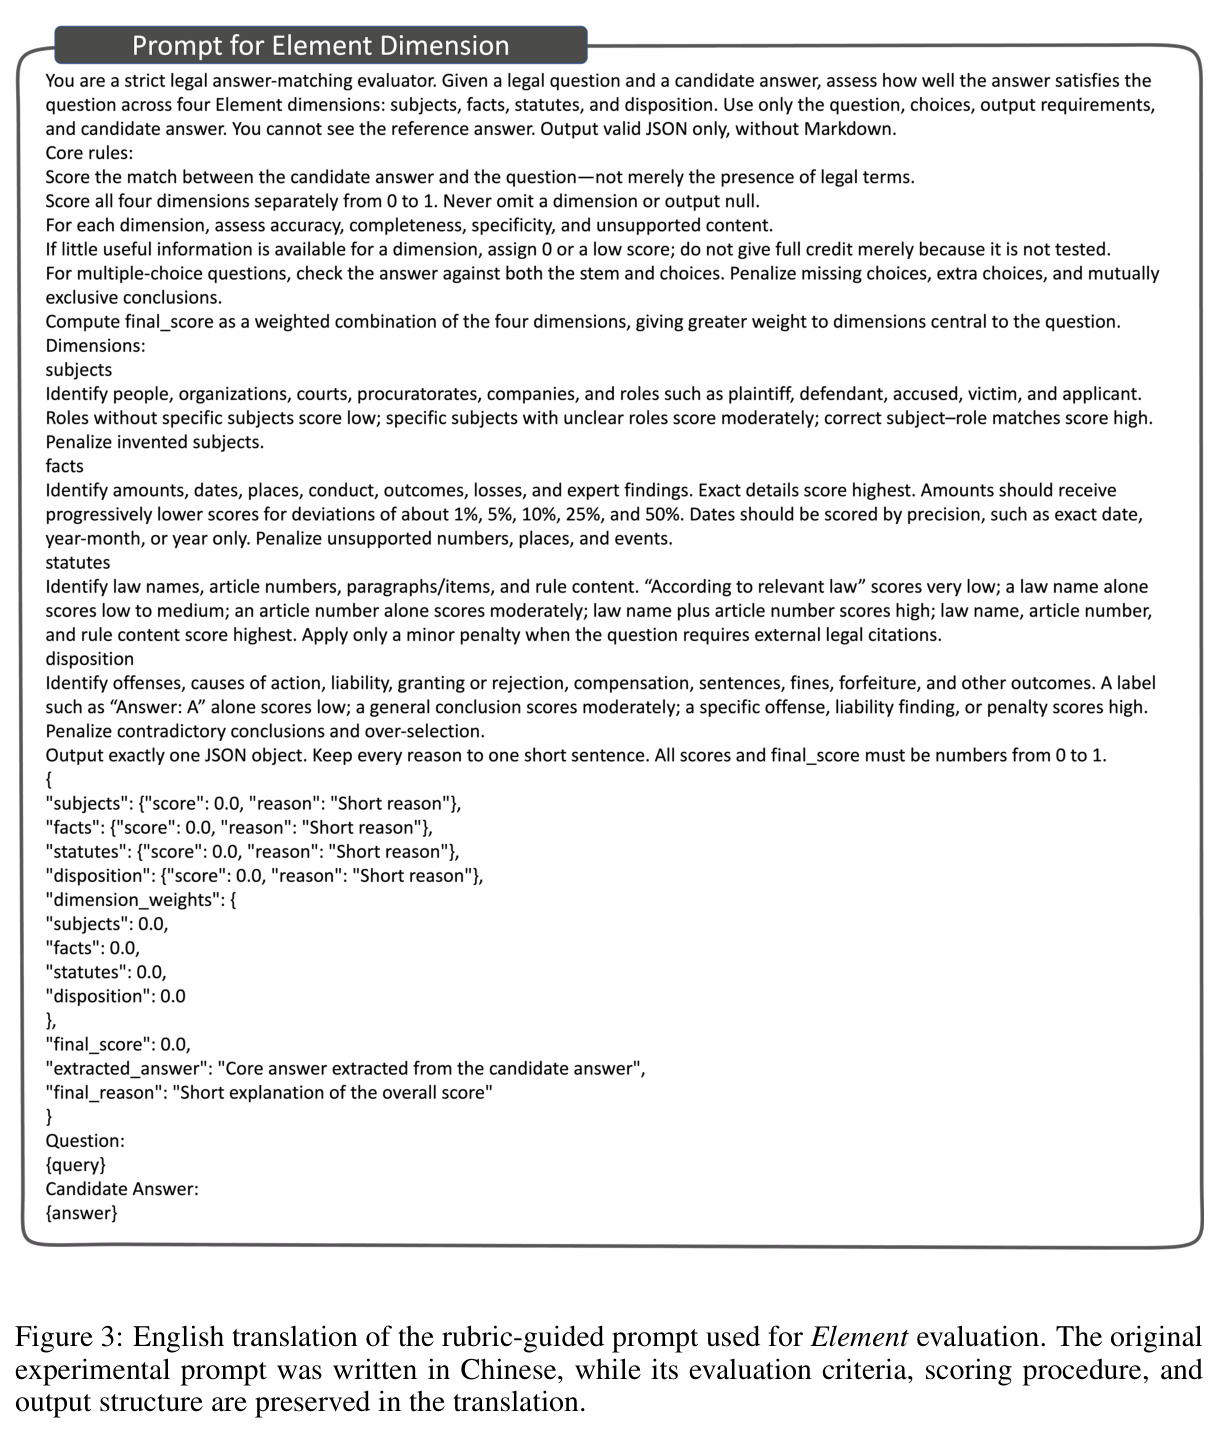
LexReward 的整体流程分三阶段。第一是分类学构建:法律专家结合领域知识(自顶向下)与对多个模型在法律基准上错误回复的归纳分析(自底向上),提炼出三维质量分类学——Style 关注词汇与句法层面的法律文风,Element 关注主体、事实、法条、裁判结果四类法律要素的覆盖,Chain 关注推理的顺序、完整性、正确性与非冗余性。第二是量表化奖励:对不依赖输入上下文的标准用确定性规则评估器(Style 全部用规则;Chain 在有预定义推理步骤时用规则),对依赖上下文的标准用 LLM-as-a-Judge(Element 与开放场景的 Chain)。第三是模型训练:用 5 个模型池对同一查询各生成一条候选,按量表得分构造三类偏好对,以 Bradley-Terry 目标训练三个维度专属奖励模型 LexRM,再通过任务向量相加合并为 LexRM-Merge;偏好数据同时用于 DPO,LexRM 则作为 GRPO 的奖励函数指导强化学习。
核心创新是“先定义质量,再设计奖励”的分类学驱动范式。与用单一标量或结果正确性打分不同,LexReward 把法律回答质量显式分解为专家认可的互补维度,每个维度再用量表规定评估标准与质量等级,使奖励信号可解释、可定位缺陷。奖励构造上采用巧妙的二分法:风格本质上是回复的内在语言属性,因而用与真实裁判文书语料统计特征(连接词率 $\rho^*_{conj}=0.0191$、句长均值 $\mu^*=64.7$、标准差 $\sigma^*=45.3$ 等)的校准偏差来计算,完全无需参考答案;要素与推理链依赖对输入案件的理解,则交给不提供参考答案的 LLM judge。另一个关键设计是用奖励模型解决量表分数稀疏、大量平分无法区分候选的问题,让连续打分的 RM 内化量表标准并泛化到量表无法区分的候选之间。
方法步骤详情
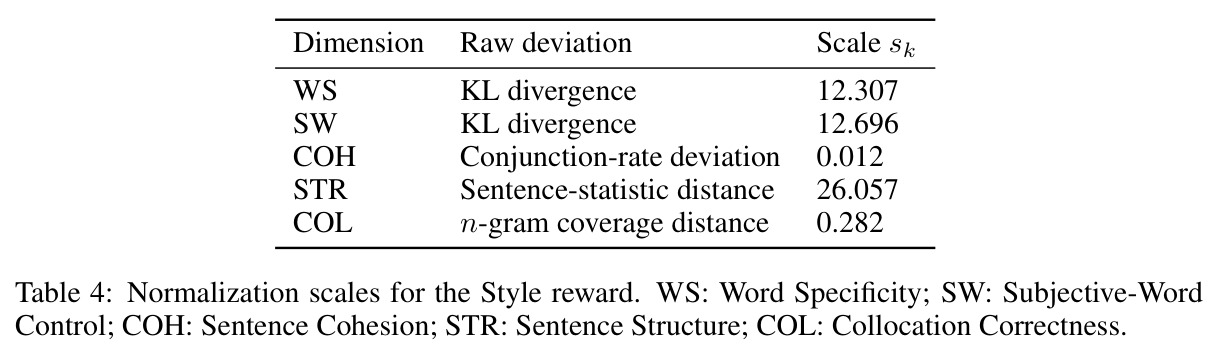
第一步,构建分类学:专家审阅 Qwen、Llama 等模型在 LawBench 等基准上的回复并与参考答案对比,归纳错误类型,与领域知识整合成 Style(词义专业性、主观词控制、句间衔接、句式结构、搭配正确性)、Element(主体/事实/法条/裁判)、Chain(顺序/完整性/正确性/非冗余)。第二步,实现量表奖励:Style 对五个属性分别用 KL 散度(法律术语与 HowNet 情感词分布)、连接词频率绝对差、句长统计欧氏距离、3至6-gram 覆盖向量欧氏距离计算偏差 $d_k(y)$,除以校准尺度归一化,$R_{Style}(y)=-\frac{1}{|K_{Style}|}\sum_k \hat{e}_k(y)$,其中 $\hat{e}_k(y)=d_k(y)/(s_k+\epsilon)$;Element 由 DeepSeek-V4-Flash 对四个子维度各打 0-1 分取平均;Chain 有预定义步骤时规则评分,否则 LLM 按四准则评分。第三步,构造偏好数据:从 Qwen3-4B、Qwen3.5-4B、Qwen3.5-9B、Llama-3.1-8B-Instruct、gemma-4-12B-it 各采样一条回复,在同查询内构造高分对次高、高分对中分、中分对低分三类偏好对(全同分的查询丢弃),如 Element 维度得到 2244 对。第四步,训练 LexRM:以 Qwen3-8B 为骨干,用 Bradley-Terry 损失 $\mathcal{L}_{BT}^{(d)}=-\mathbb{E}_{(x,y^+,y^-)\sim P_d}\log\sigma(R_\theta^d(x,y^+)-R_\theta^d(x,y^-))$,DeepSpeed ZeRO-3、学习率 $1\times10^{-7}$、batch 32、LoRA 训练 2 个 epoch。第五步,下游应用:偏好数据做 DPO(直接从 Qwen3-8B 初始化);先 SFT 后 GRPO,GRPO(RM) 用维度专属 LexRM 作奖励,GRPO(rule) 用结果奖励或 ROUGE;三个维度模型因任务向量余弦相似度平均不超过 0.03、最高 0.14,可用 $\theta_{merged}=\theta_0+\sum_{d\in\mathcal{D}}\lambda_d\tau_d$($\lambda_d=1$)合并。
技术新颖性
技术新颖性体现在四点。其一,首个中文法律奖励模型家族 LexRM,填补了法律垂直领域奖励建模的空白,实验显示通用 RM(Skywork-Reward-V2 系列)在法律三维度上系统性弱于领域专用模型。其二,Style 奖励完全基于与真实裁判文书语料(中国裁判文书网 1000 篇文书)的统计差异,包括法律术语分布 KL 散度、情感词分布、jieba 词性标注的连接词率、句长分布与 n-gram 搭配覆盖率,归一化尺度在独立的 986 篇校准集上估计,可解释且零样本即可打分。其三,偏好对按分数区间分层构造(高-次高、高-中、中-低三类),兼顾强回复间的细微差别与跨质量层级的大差异。其四,用任务向量分析证明三个维度 RM 的参数更新近似正交(余弦相似度平均 $|\cos|\le 0.03$,最高不超过 0.14),从而支持零成本的任务算术合并为单一模型,省去三倍推理开销。
实验结果
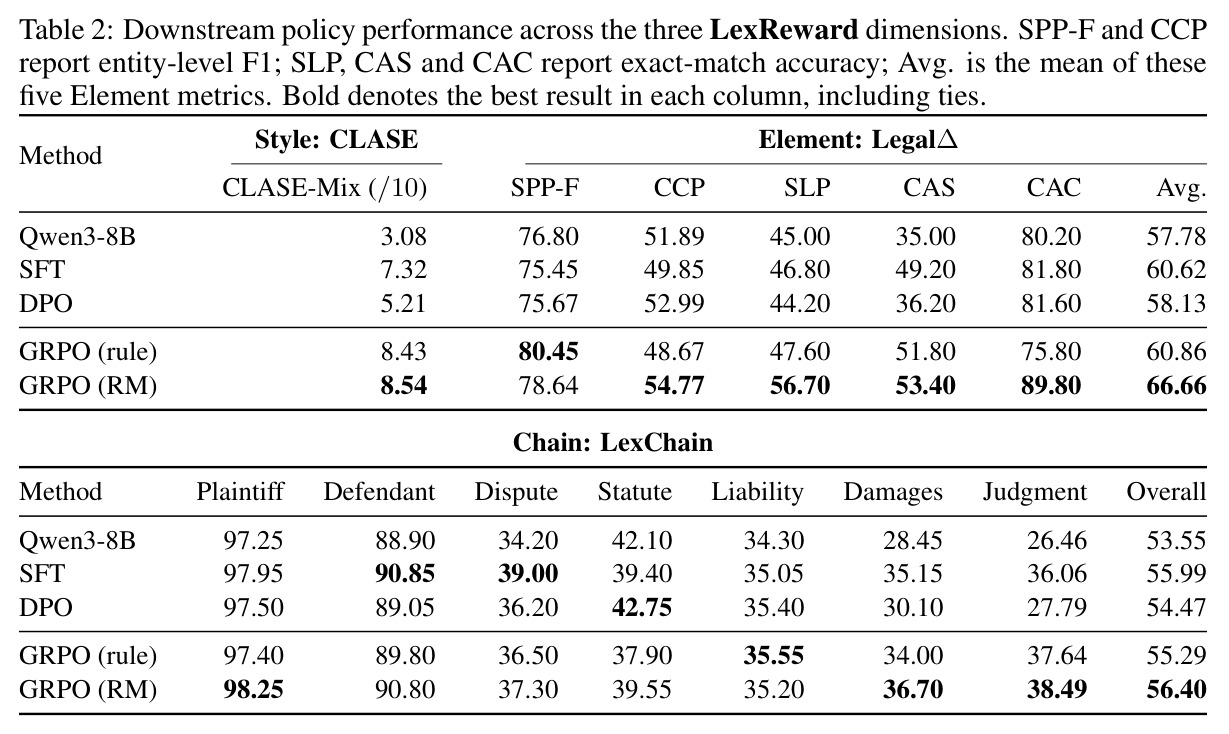
论文在三个层面验证方法有效性。第一,量表奖励与 RM 的候选选择能力(Table 1):CLASE 风格数据集上随机基线配对准确率 50.00%,量表 79.00%,通用 RM Skywork-Qwen 78.50%,而 LexRM-Style 达到最佳 81.75%;Legal∆ 要素任务上五模型平均 49.63%,量表 60.27%,Skywork-Qwen 68.04%,LexRM-Element 以 66.32% 居第二,LexRM-Merge 65.77% 与专家接近且在罪名预测上最高(58.27%);LexChain 推理链上 LexRM-Chain 总分 50.46% 最佳,超过 Skywork-Qwen 的 50.19%。第二,下游策略优化(Table 2):CLASE-Mix 上 Qwen3-8B 原始 3.08/10,DPO 5.21,SFT 7.32,GRPO(RM) 8.54 略胜 GRPO(rule) 的 8.43;Element 平均分 GRPO(RM) 达 66.66,比 SFT 的 60.62 提升 6.04 点且五项指标全面领先,而 GRPO(rule) 几乎无提升(60.86);Chain 上 GRPO(RM) 56.40 优于 SFT 55.99 与 GRPO(rule) 55.29。第三,维度消融(Table 3):三个维度上聚合量表均取得最佳总分(Style 79.00%、Element 60.27%、Chain 47.80%),单一准则偶尔在个别任务小胜但从不全面占优,证明多维联合评分的必要性——例如 Element 只用主体准则时法条预测 F1 跌到 48.76,加入法条准则后恢复到 57.03。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Style 风格评估(CLASE,从金牌/模型负例中选出正确回复) | 配对选择准确率 (%) | LexRM-Style 81.75(量表 79.00) | 随机 50.00;Skywork-Qwen 78.50;Lawformer 68.50;Legal-BERT 41.00 | 比最强通用 RM 高 3.25 个百分点,比随机高 31.75 个百分点 |
| Element 要素评估(Legal∆ in-domain,含法条/罪名/量刑/案情分析/金额计算五项) | 五项均分 Avg. (%) | LexRM-Element 66.32(量表 60.27,LexRM-Merge 65.77) | 五模型平均 49.63;Skywork-Qwen 68.04;Skywork-Llama 57.64 | 比随机选择高 16.69 个百分点,仅次于用更大数据训练的 Skywork-Qwen |
| Chain 推理链评估(LexChain,七个裁判要件维度) | 七维总分 Overall (%) | LexRM-Chain 50.46(量表 47.80) | 五模型平均 45.41;Skywork-Qwen 50.19;Skywork-Llama 49.83 | 超过所有通用 RM 与量表本身,比随机高 5.05 个百分点 |
| Element 下游策略(Qwen3-8B 经 SFT 后 GRPO) | Legal∆ 五项平均分 | GRPO(RM) 66.66 | SFT 60.62;GRPO(rule) 结果奖励 60.86;原始模型 57.78 | 比 SFT 提升 6.04 点,五项指标全面领先;结果奖励几乎无效 |
| Style 下游策略(CLASE-Mix) | CLASE-Mix 分(/10) | GRPO(RM) 8.54 | GRPO(rule) ROUGE 8.43;SFT 7.32;原始模型 3.08 | 学习型奖励优于词汇重叠类规则奖励 0.11 分,远超原始模型 |
| Chain 下游策略(LexChain) | 总分 Overall | GRPO(RM) 56.40 | SFT 55.99;GRPO(rule) 55.29;原始模型 53.55 | 比 SFT 高 0.41,比规则奖励高 1.11,幅度相对较小 |
局限与改进
作者承认两点:分类学基于中文法律材料,评估仅限中文数据集,对其他语言和法律体系(如普通法系)的适用性未经验证;如何把多个维度组合成统一量表奖励或 RM(聚合权重、偏好数据构成、训练策略)仍是开放问题。我的补充观察:Element 与开放 Chain 的奖励依赖 DeepSeek-V4-Flash judge,存在 judge 偏差、API 成本与评分随模型版本漂移的风险;Style 奖励基于表层统计特征,理论上可通过模仿句长与术语频率“骗分”而内容错误;GRPO 在 Chain 上的提升(56.40 对 SFT 55.99)幅度较小;实验仅用 Qwen3-8B 单一规模骨干,对更大或更小模型的泛化未知;LexRM-Merge 在 CLASE(69.75)与 LexChain(46.84)上明显低于各自专家模型,合并的收益与代价尚需权衡。
独立分析的弱点
具体分析几个弱点。其一,Style 奖励是纯表层的:它度量的是与裁判文书的词汇、句长、搭配统计距离,一个内容错误但措辞地道的回复可能得高分,五个特征均无语义一致性检查;改进方向是叠加法律 NLI 或引用一致性校验。其二,LLM judge 的客观性风险:Element/Chain 依赖单一 judge(DeepSeek-V4-Flash),既无多 judge 交叉验证,也未报告 judge 分数与人工标注的相关性;改进方向是多 judge 投票或与人工标注对齐校准。其三,偏好对的构造完全由量表分数决定,全部同分的查询被丢弃会引入训练分布偏移,粗粒度的高/中/低分层也可能带入噪声标签;可改为软标签或按分数差加权。其四,GRPO(rule) 与 GRPO(RM) 的对比中规则侧对 Style 用 ROUGE、对 Element/Chain 用结果匹配,两种奖励的信号密度不同,结论虽合理但维度间可比性依赖逐一配平。每个弱点都指向后续可量化的实验。
未来方向
作者提出的方向:把框架扩展到其他语言与法律体系,研究分类学与奖励准则如何迁移适配;系统研究多维度统一奖励的聚合权重 $\lambda_d$ 学习、偏好数据组合与训练策略。基于本文成果可延伸:用 LexRM 的维度分数做错误诊断与可解释评估工具,定位模型在文风/要素/推理上的具体短板;将“分类学驱动奖励”模板推广到医疗、金融、代码审查等其他垂直领域;探索过程奖励与结果奖励的混合(Element 上两者信号互补);在更大骨干(如 30B+)上验证任务向量正交性是否保持,以及把量表奖励用于推理时拒绝采样与 self-correction 的多轮优化。
复现评估
复现条件较好。代码与数据已在 GitHub(thunlp/LexReward)开源;训练骨干为 Qwen3-8B,SFT/DPO/GRPO/RM 训练全部用 LoRA 配合 DeepSpeed ZeRO-3,学习率 $1\times10^{-7}$、batch 32、2 个 epoch,单节点多卡即可承担;偏好数据来源模型(Qwen3-4B/3.5-4B/3.5-9B、Llama-3.1-8B、gemma-4-12B)均为开源权重;评估数据集 CLASE、JEC-QA、LexChain、Legal∆ 均为公开学术数据集。主要障碍有两处:LLM judge 需要 DeepSeek-V4-Flash API(产生费用且评分可能随模型版本漂移),以及 Style 校准需要 1000 篇裁判文书网语料的获取与清洗;此外 CLASE-Mix 主观部分调用 GPT-4o-mini、LexChain 评测用 GPT-4o-2024-05-13,评测 API 成本也需预算。总体属于中等偏易的复现难度。
论文图表
展示当任务没有预定义推理步骤时用于 Chain 评估的 prompt:先让 LLM 把自由格式的推理文本转换为带标签的有序步骤序列,再用规则量表对顺序、完整性、正确性、非冗余四个准则评分。
它揭示了 Chain 奖励在开放场景下的实现细节——先结构化再规则化评分,是理解 Chain 维度如何兼顾规则与 LLM 评估的关键。
三个数据集上量表与各奖励模型的候选选择性能:CLASE 风格配对准确率(随机 50.00%、量表 79.00%、Skywork-Qwen 78.50%、LexRM-Style 81.75%);Legal∆ 要素五项均分(五模型平均 49.63%、量表 60.27%、Skywork-Qwen 68.04%、LexRM-Element 66.32%、LexRM-Merge 65.77%);LexChain 推理链总分(五模型平均 45.41%、量表 47.80%、Skywork-Qwen 50.19%、LexRM-Chain 50.46%)。
这是奖励信号本身质量的核心证据:量表能区分不同质量的回复,在其上训练的 LexRM 在 Style 和 Chain 上超过更大数据量的通用 RM,证明了领域量表的价值。
每个维度内单一准则与聚合量表的对比:Style 上词汇 76.50%、句法 77.50%、聚合 79.00%;Element 上主体 49.57%、事实 51.33%、法条 59.95%、裁判 55.72%、聚合 60.27%;Chain 上四个准则均低于聚合的 47.80%。聚合在三个维度总分均最佳,单一准则仅偶尔小幅领先个别任务。
这张表验证了分类学设计的内在逻辑:价值不在于某一个准则足够好,而在于多准则联合评分能阻止与任务无关的准则决定结果。