基于在线自蒸馏缓解强化学习后训练的长度扩展税 Mitigating the Length-Scaling Tax with Online Distillation
LSD把已解题组路由到EMA自教师做在线蒸馏,消除冗余长度且精度不降反升
前置知识
RLVR(可验证奖励强化学习)
用可自动验证的正确性奖励(如数学答案对错)做后训练的范式。典型实现为 GRPO:对每个提示采样一组回答,用组内相对优势 $A_i=(r_i-\bar{r})/(\sigma+\epsilon)$ 计算策略梯度。当组内所有回答全对时,各奖励相同,组相对优势趋近于零,该组不再产生有效梯度信号。
本文的核心问题正是:全对组优势归零后,难题的更新会外溢改变共享参数,使简单题的回答变长。理解组相对优势的消亡机制是理解 LST 成因与 LSD 路由设计的前提。
在线策略蒸馏(OPD)
在学生自己生成的序列前缀上,用教师模型对每个 token 的分布给出密集监督,直接最小化师生分布的 KL 散度。相比只在最终答案上监督的常规蒸馏,OPD 在学生实际访问的状态分布上逐 token 约束策略,能更精确地保留行为模式(例如何时停止推理)。
LSD 把已解题组的 OPD 作为保留信号,与困难组的 RL 目标混合训练;三种 KL 变体(SG-FKL/SG-RKL/PG-RKL)的设计与对比构成方法主体。
前向/反向 KL 散度
前向 KL $D_{KL}(p\|q)$ 以教师分布加权差异,倾向覆盖教师的全部概率质量;反向 KL $D_{KL}(q\|p)$ 以学生分布加权,倾向模式-seeking,惩罚学生在教师低概率 token 上的概率质量。本文还比较了直接微分(SG,监督梯度)与采样动作策略梯度(PG)两种估计方式。
三个 LSD 变体的行为差异(保简洁强度、熵变化、最终精度)主要由 KL 方向和梯度估计方式决定,实验分析大量围绕此展开。
EMA 指数移动平均自教师
以 $\bar{\theta}_k=\beta\bar{\theta}_{k-1}+(1-\beta)\theta_k$ 维护策略参数的历史平均作为教师,$\beta=2^{-1/H}$ 由半衰期 H 控制:H 越大教师越滞后、行为锚定越强。它不需要外部更强模型,本质是同一策略血统的延迟版本。
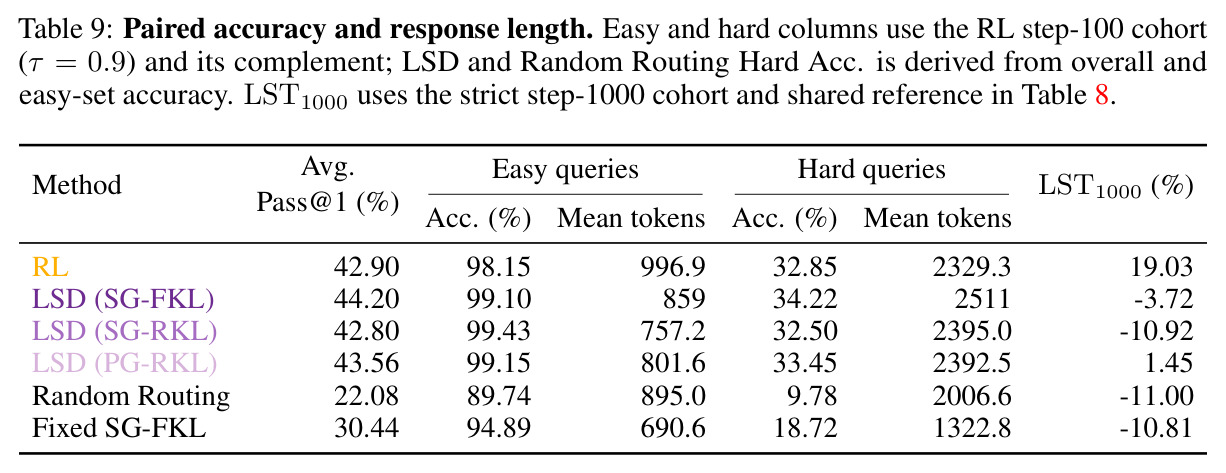
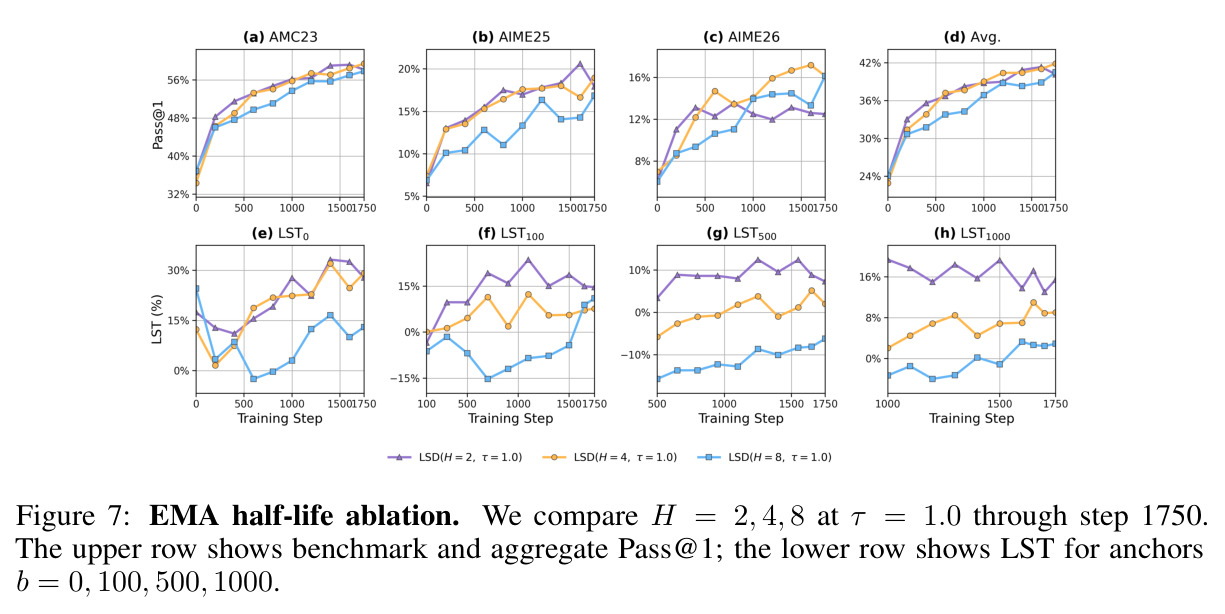
LSD 的教师就是这个 EMA 自教师,半衰期 H 是关键超参(消融显示 H=4 最优);实验证明固定 π0 教师会严重损害能力获取(Pass@1 从 42.90% 跌到 30.44%)。
Pass@k 与固定简单集评测
Pass@k 表示每题采 k 个回答至少一个正确的比例。固定简单集指在某个锚点检查点用解题率阈值 τ 冻结题目集合,之后所有检查点都在同一集合上评测,以避免反复重新定义简单集带来的幸存者偏差。
论文的 LST 指标和主要结论都建立在冻结简单集协议之上,只有如此才能把长度增长归因于训练的副作用而非题目集合的变化。
研究动机
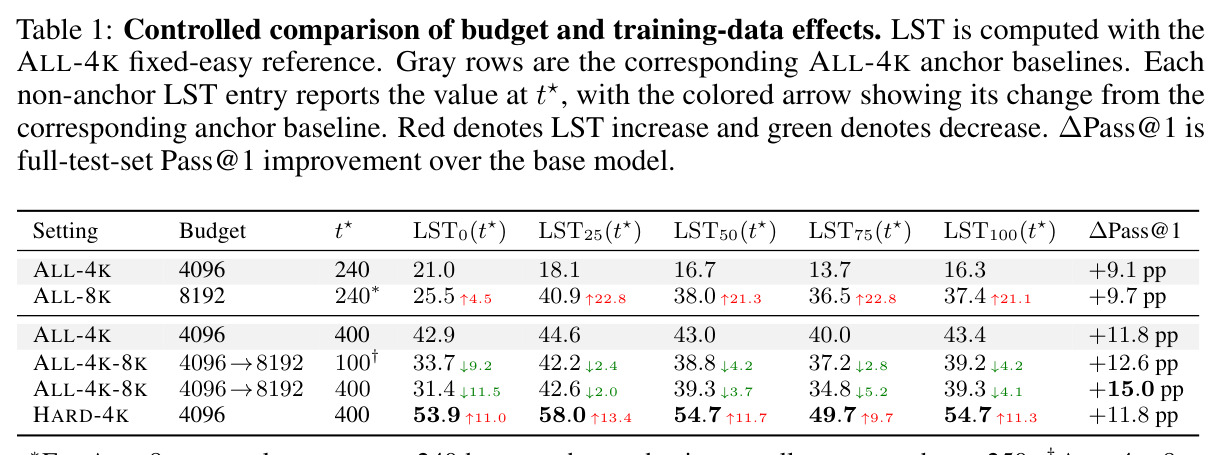
RLVR 后训练中响应长度持续增长常被视为推理能力提升的标志,但对已能稳定解对的题目,变长只是浪费:反思词和重复 bigram 显著增多,准确率却没有相应提升。本文以 Qwen3-4B-Base 在 DAPO-Math-17K 上做标准 GRPO 训练(4096 token 预算),在 AMC 2023、AIME 2025/2026 上每题采 32 个回答量化这一现象。根源在组相对目标:简单题 rollout 组全对时优势归零,组内没有梯度保留简洁解法,而难题组的更新仍改动共享参数,一阶近似 $\Delta\log\pi_\theta(a|s_E)\approx\eta\rho_H\nabla_\theta\log\pi_\theta(a|s_E)^\top g_H$ 一般非零,简单题输出分布被动漂移。常用数据策略还会放大该效应:dynamic sampling 丢弃全对组,难度课程降低简单题权重。受控实验显示 HARD-4K(只训难题)使各锚点 LST 高达 49.7%–58.0%,ALL-8K 前期 LST 达 40.9%(同锚点 ALL-4K 仅 18.1%)。而现有评测多用平均长度这类粗粒度指标,无法定位已解题上的额外长度。
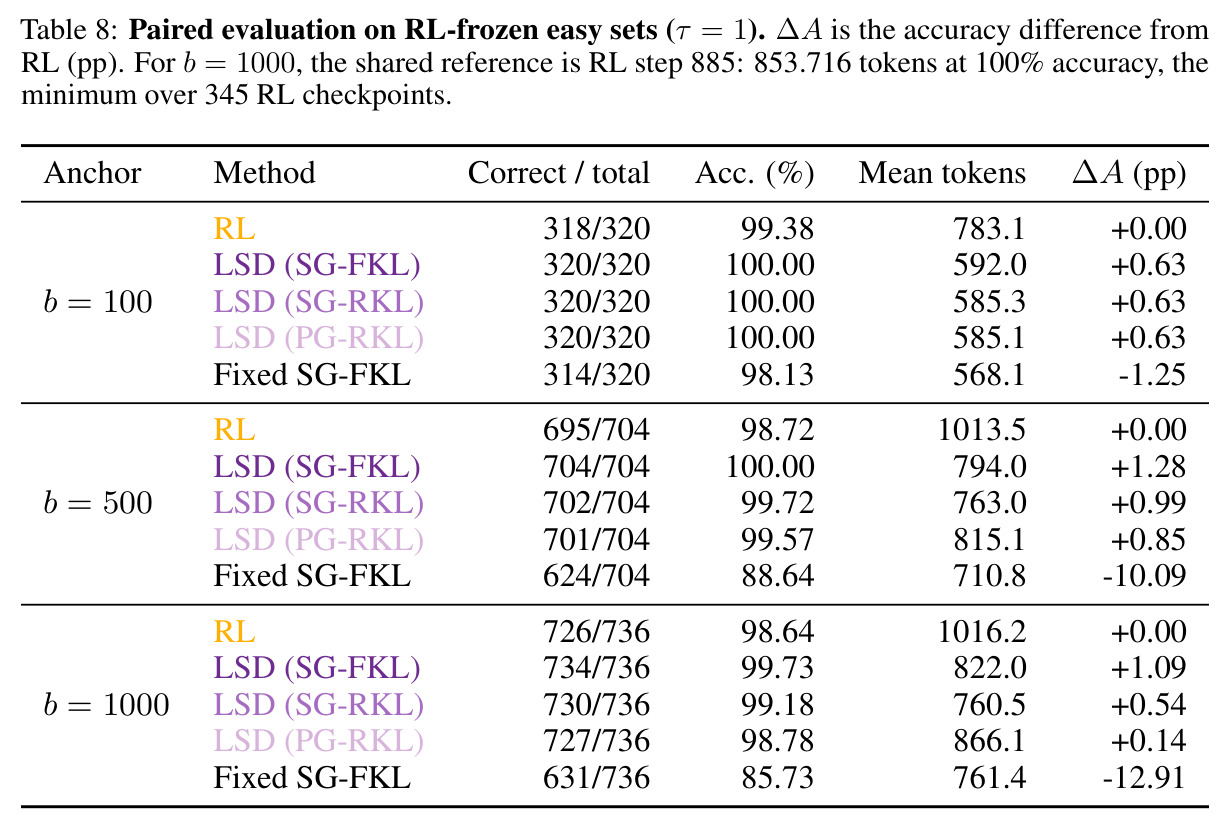
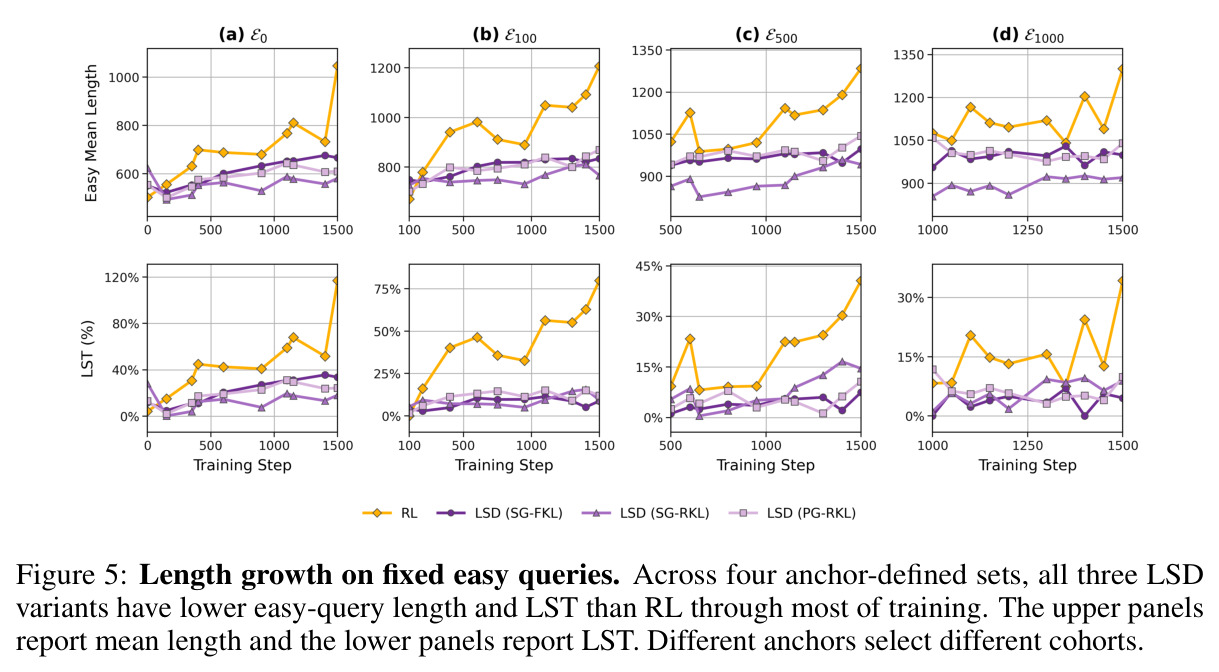
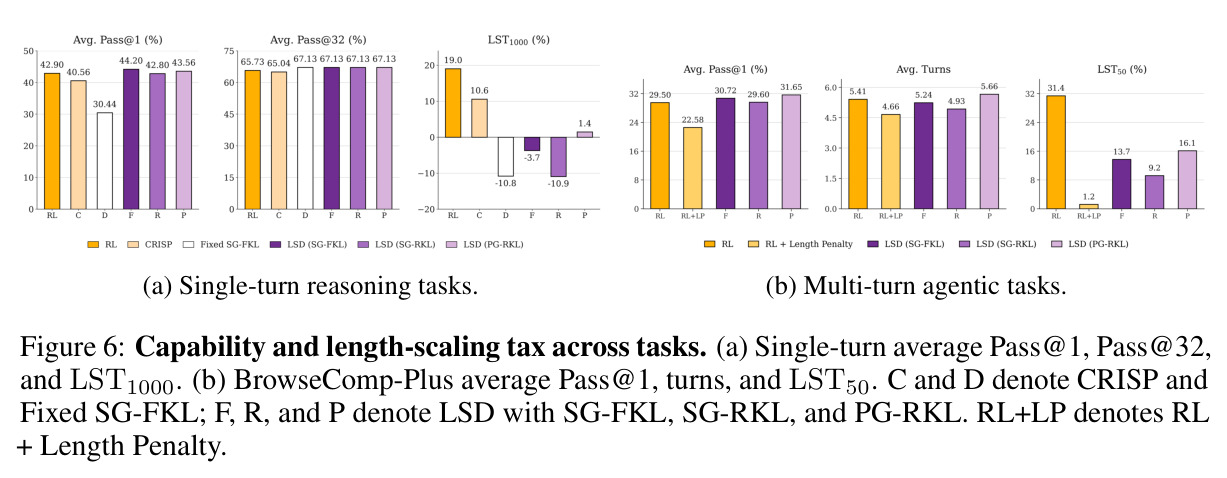
本文的目标是论文目标分两层。第一是度量:定义长度扩展税 LST——在锚点检查点用阈值 τ(默认 1,即 rollout 全对)冻结一个简单题集合,随后跟踪该集合在各检查点上的平均准确率与平均长度,以准确率达标检查点中最短的平均长度 $L^\star_b$ 为参照,定义 $LST_b(k)=(L_b(k)-L^\star_b)/L^\star_b$,即在同等可解性下多花费的 token 百分比。第二是干预:提出 LSD(Length Self-Distillation),在不引入外部更强教师、不施加长度惩罚、不限制难题探索的前提下,消除简单题上的长度膨胀。具体量化目标是在单轮数学推理和多轮智能体任务上同时做到:LST 大幅下降(如单轮从 19.0% 降到 -3.7%、智能体从 31.4% 降到 13.7%),平均 Pass@1 持平或超过纯 RL,且难题上的回答长度保持增长以支持探索。
与已有工作不同的是,现有高效推理工作三条线各有局限:一是测试时计算分配(如 s1、budget forcing)只调节推理阶段花多少算力,不改变训练造成的冗余模式;二是 RL 长度整形(L1、DAST、AdapThink、lazy length penalties)对简单题施加更强长度惩罚,但惩罚是间接的标量信号,不显式保留策略已有的简洁行为,常伴随精度损失——本文复现的 RL+Length Penalty 在 BrowseComp-Plus 上 LST50 降到 1.2%,但 Pass@1 从 29.50% 跌到 22.58%;三是蒸馏压缩(CRISP、O1-Pruner)把 OPD 当作全局压缩目标,对所有 rollout 无差别蒸馏,CRISP 的 Pass@1 40.56% 反而低于 RL 的 42.90%。本文独特切入:LST 是查询条件化的度量,只盯已解题集合;干预上用在线难度路由加时间自教师,把 token 级蒸馏精确用在 RL 信号消失的位置,其余照常 RL,兼得保简洁与继续探索。
核心方法
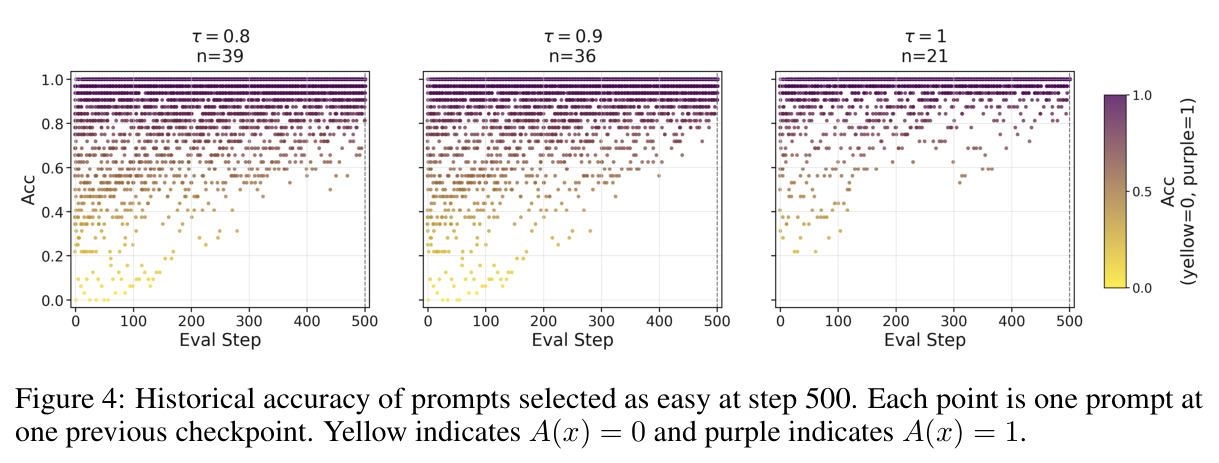
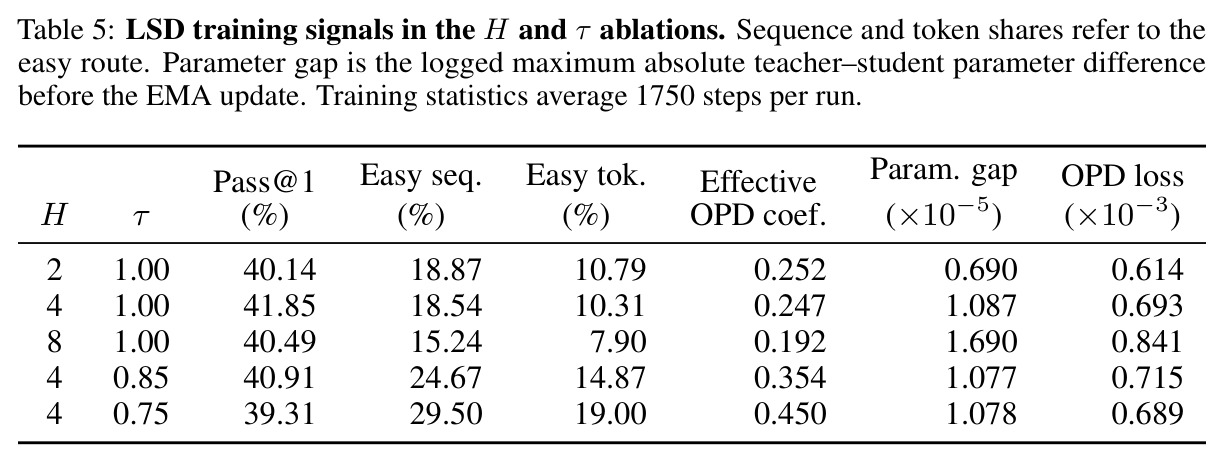
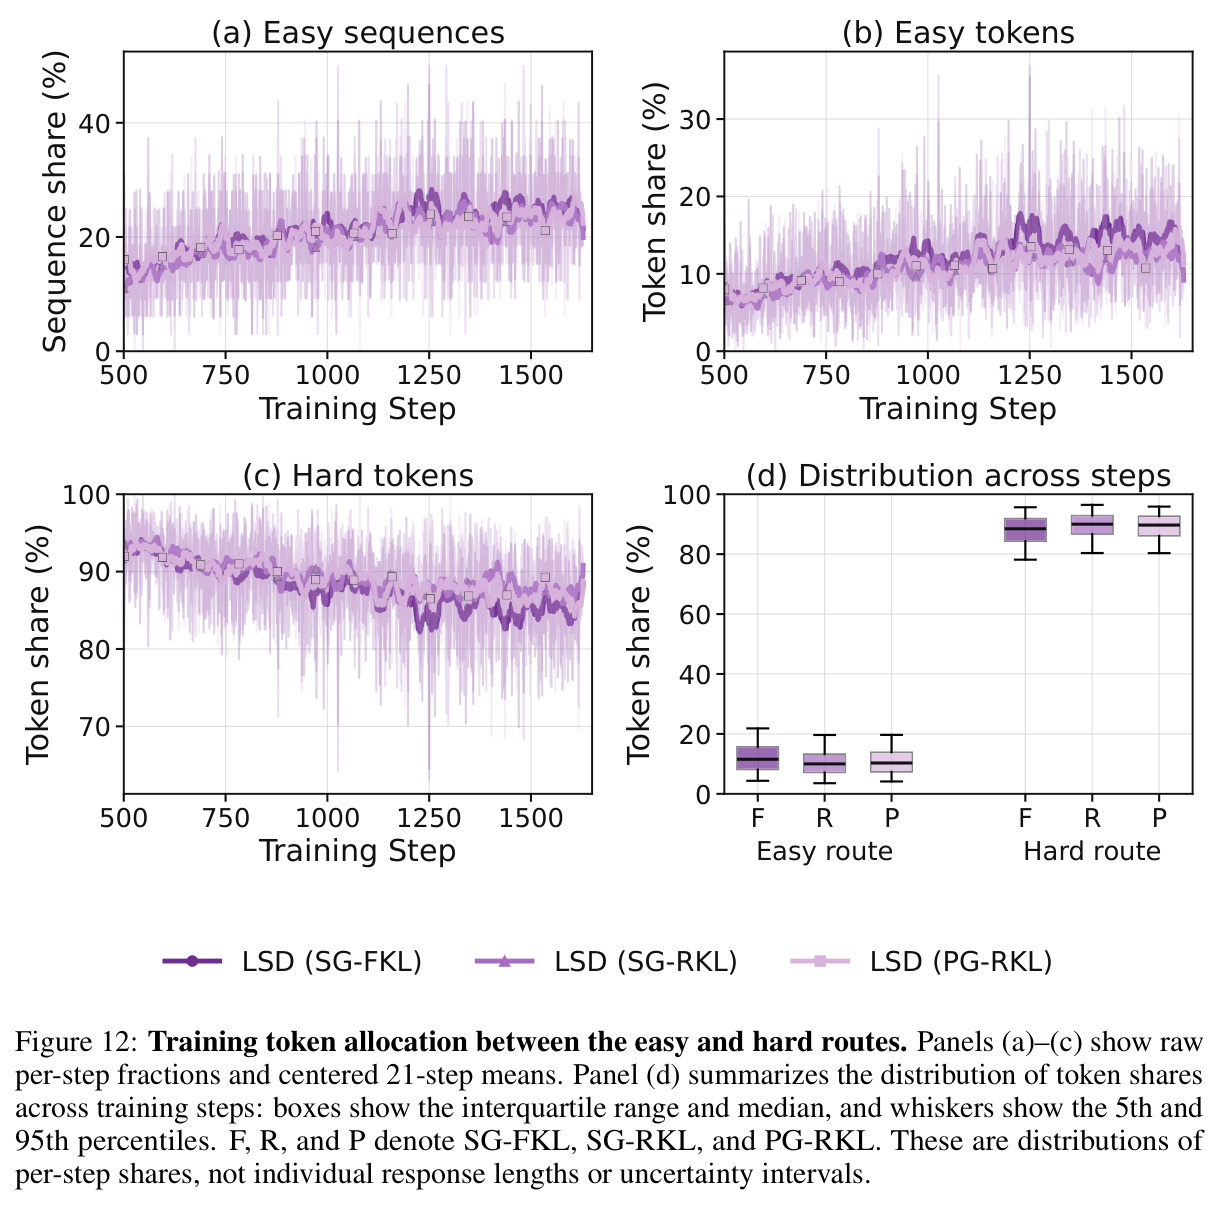
直觉上,LSD 在每个训练步对 batch 内题目按难度分流:能全解对的组说明策略已掌握,改用自蒸馏逐 token 固定其简洁解法;没全解对的组继续用原 RLVR 目标探索。技术路线是在标准 RL 训练器上加两个组件。其一是在线难度路由:用当前策略该题 rollout 组的实证解题率 $\hat{R}(x;\pi_k)$ 与阈值 τ(默认 1)比较,把 batch 划分为简单组 $E_k$ 和困难组 $H_k$;论文验证了该代理信号有效——step-500 被判为简单的题,超过 87% 在 step-250 教师处同样被判为简单。其二是时间自教师:维护策略参数的 EMA 检查点 $\bar{\theta}_k=\beta\bar{\theta}_{k-1}+(1-\beta)\theta_k$,半衰期 H(默认 4)控制教师滞后程度。两组样本分别计算 RL 损失与蒸馏损失,再按序列数加权合并。整体开销几乎不变:教师前向与训练共享,简单路由仅占约 10%–12% 的训练 token,87% 以上算力仍用于难题。
核心洞见是零梯度不等于分布不变:组内全对使相对优势趋零,但共享参数仍被难题更新推动,简单题前缀上的 token 分布被动漂移、回答越写越长。与已有方法的本质区别有三点。其一,LST 把过度思考从全局平均长度改为条件化到已解题集合,并用冻结集合避免幸存者偏差,能回答『这些题本来 853 个 token 就能全对,现在为何要多花 19%』。其二,教师是自己:固定 π0 教师会与新解出的题严重错配,且蒸馏会限制能力获取,实验显示 Fixed SG-FKL 的 Pass@1 只有 30.44%(RL 为 42.90%);EMA 自教师随策略一起进步,既提供行为锚又不妨碍学新能力。其三,监督信号性质不同:长度惩罚是标量间接信号,OPD 是 token 级密集分布信号,直接规定此处应停、此分布应如何。随机路由消融(相同蒸馏量但组随机选)Pass@1 仅 22.08%,证明把蒸馏精确路由到全对组而非蒸馏本身是收益来源。
方法步骤详情
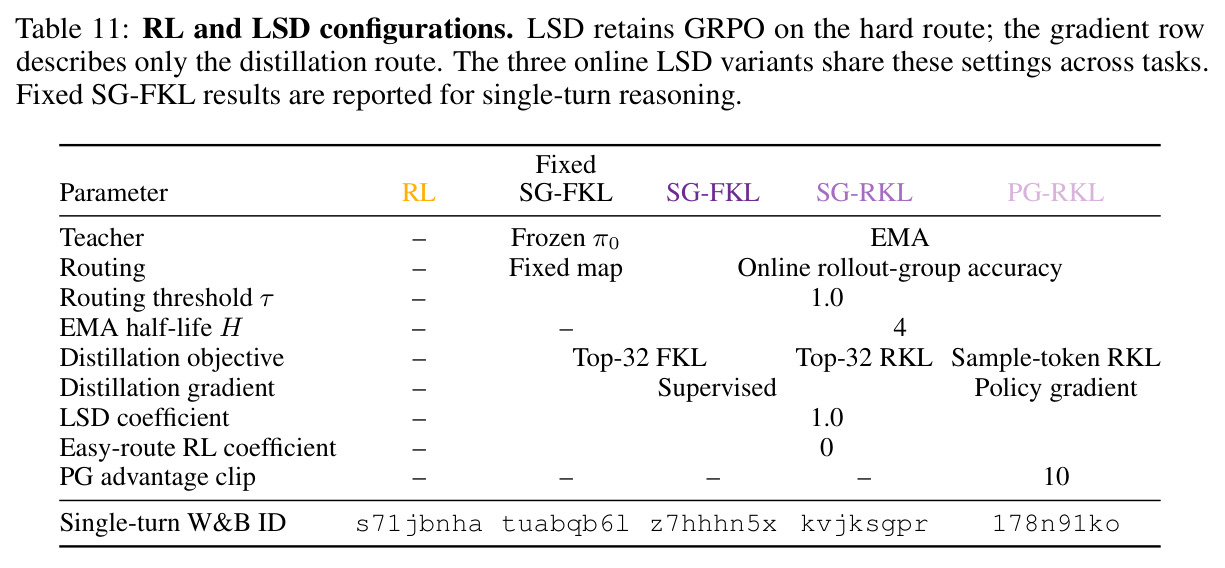
流程分五步。第一步 rollout:当前策略 $\pi_k$ 对每个提示采 G=8 个回答,计算每组实证解题率 $\hat{R}(x;\pi_k)$。第二步路由:$\hat{R}\ge\tau$(默认 1,即 8/8 全对)的组进入简单集 $E_k$,其余为困难集 $H_k$。第三步困难路由保持原 GRPO:按组相对优势 $A_i=(r_i-\bar{r}_x)/(\sigma_x+\epsilon_{adv})$ 计算 PPO-clip 损失 $\ell^{RL}$。第四步简单路由计算蒸馏损失 $\ell^{OPD}$,教师为 EMA 检查点($\beta=2^{-1/4}$),三种实现:SG-FKL 取教师 top-32 token 并入 stop token 归一化后做前向 KL,梯度直通学生 logits;SG-RKL 把师生都归一化到同一支持集做反向 KL;PG-RKL 用 $\log\bar{\pi}_k-\log\pi_{old}$ 的 stop-gradient 差值作 PPO 式 clipped 目标的 detached 优势。第五步按序列数加权合并:$\mathcal{L}_{LSD}=\frac{n_H}{n_H+n_E}\ell^{RL}+\frac{n_E}{n_H+n_E}\ell^{OPD}$,蒸馏系数 1、简单路由上 RL 系数为 0。
技术新颖性
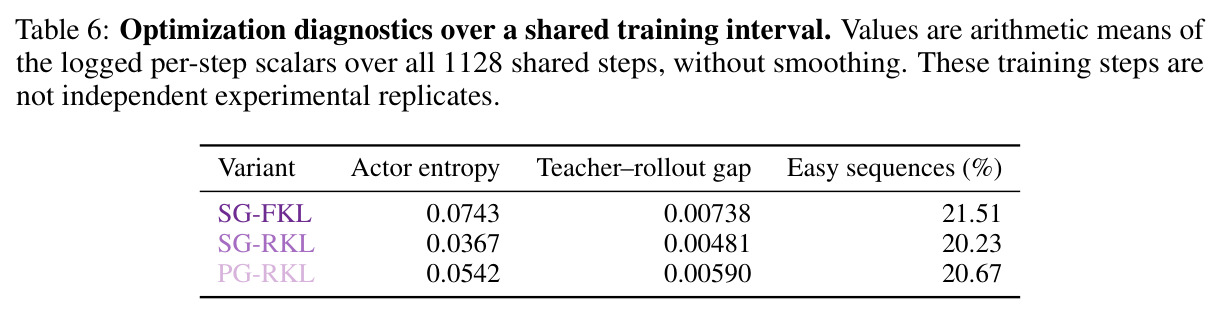
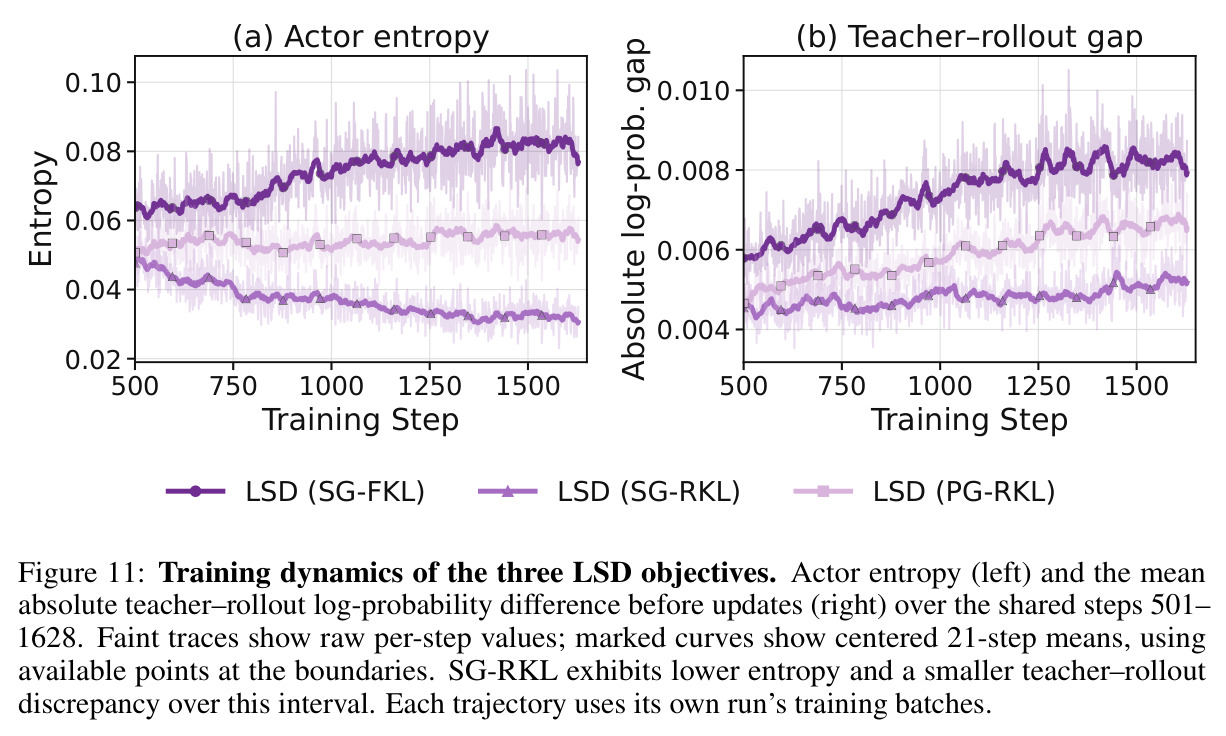
技术新颖性体现在四方面。第一,LST 指标设计:以准确率约束的最短长度为参照 $L^\star_b=\min_{j:R_b(j)\ge\tau}L_b(j)$,把冗余定义为同准确率下的可比长度差,并跨锚点 0/25/50/75/100 多次定义以证明现象稳健,而非某一快照的偶然。第二,路由用学生自身解题率而非教师额外 rollout,避免约两倍的推理开销,并通过历史回溯验证代理的可靠性(>87% 一致)。第三,自教师血统设计:EMA 滞后教师是『过去一点的自己』,在固定教师(能力天花板)和即时自身(无锚定)之间折中,消融显示 H=4 优于 H=2/H=8。第四,对三种 KL 目标的系统对比:SG-RKL 压缩最强(LST1000 -10.92%)但把 actor 熵从 0.0743 压到 0.0367、Pass@1 略降至 42.80%;SG-FKL 保留更多探索、Pass@1 最高 44.20%;PG-RKL 只监督采样动作、居中(43.56%)。这种『保什么、用谁保、怎么保』的问题分解对该领域有方法论价值。
实验结果
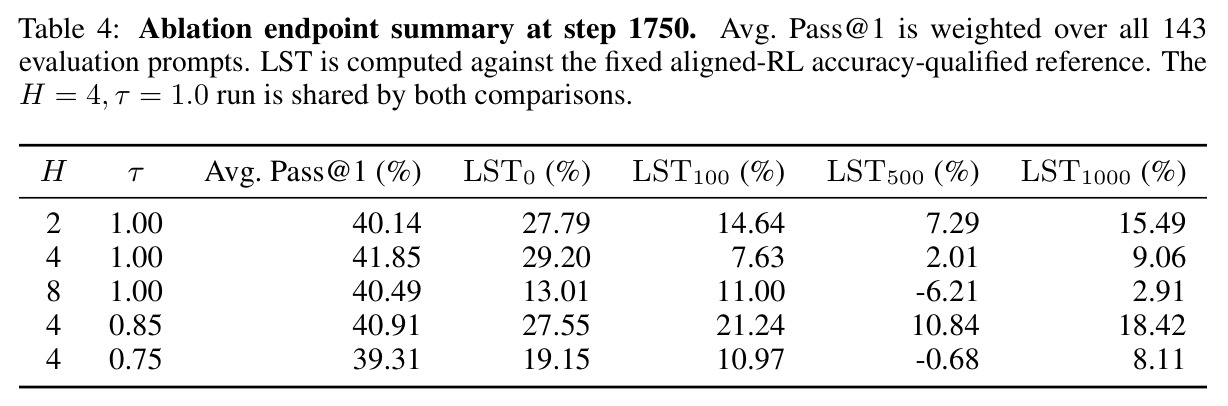
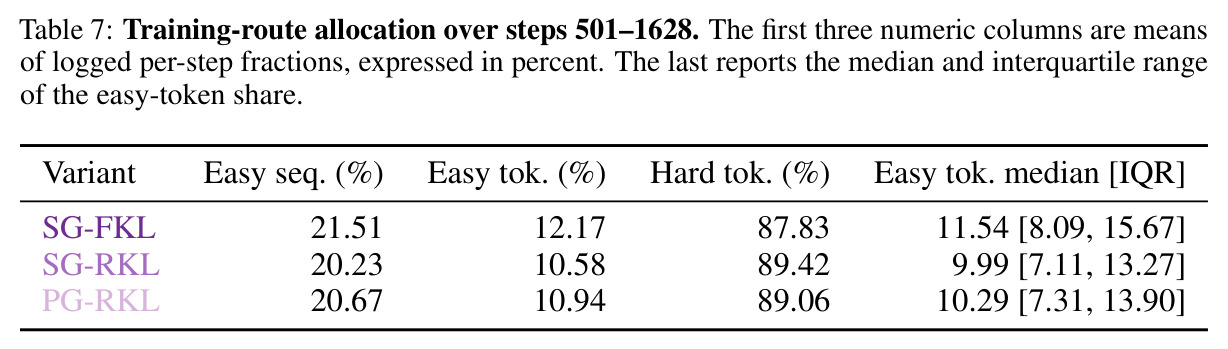
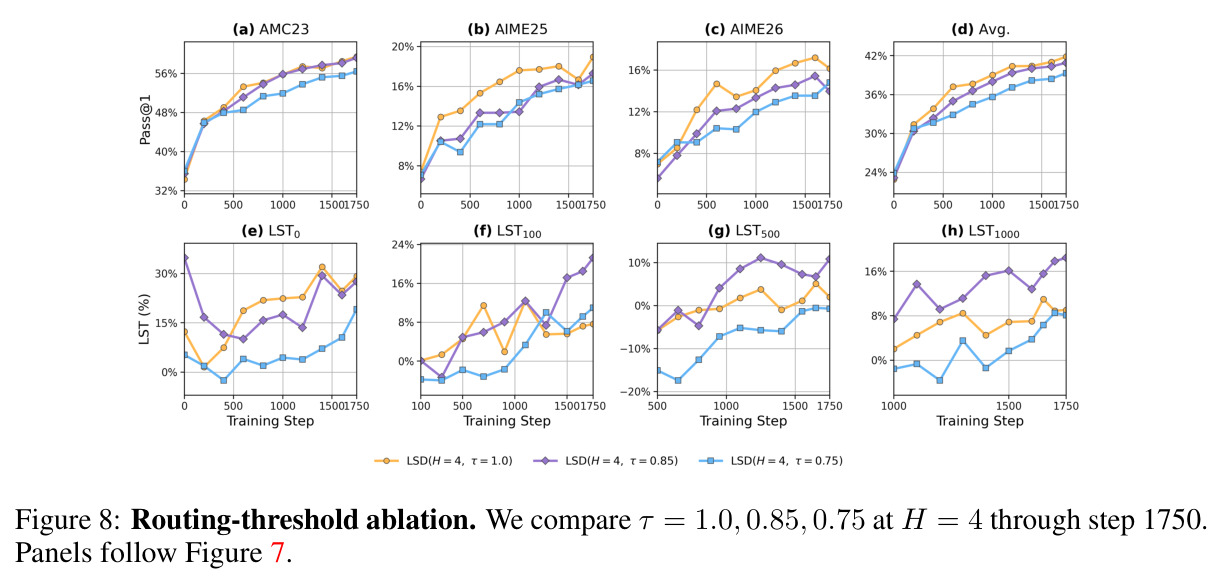
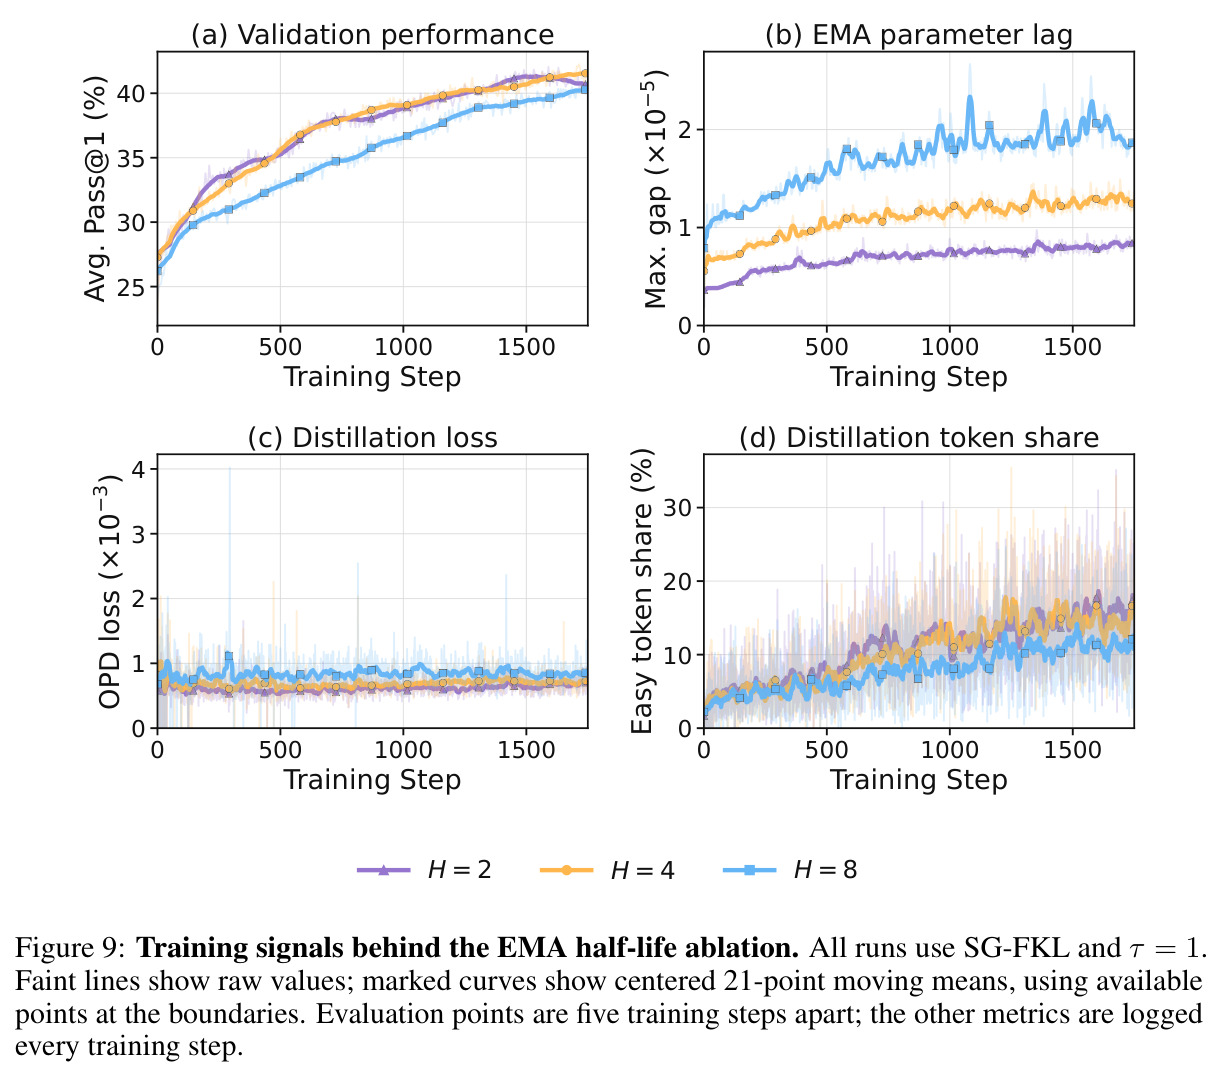
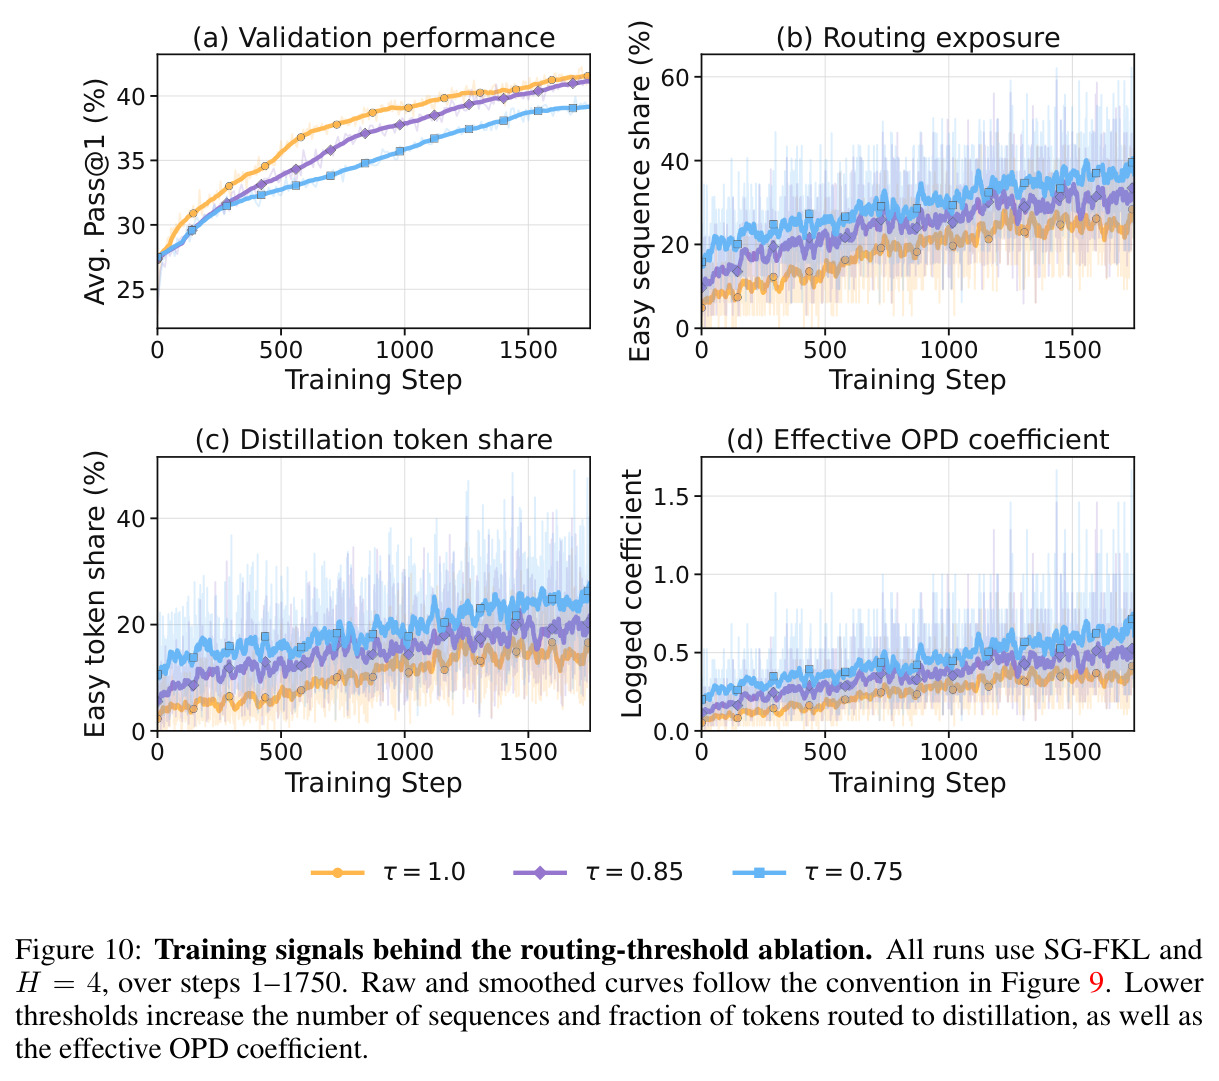
单轮数学推理(Qwen3-4B-Base,AMC23+AIME25/26,每题 32 采样):RL 基线平均 Pass@1 42.90%、LST1000 19.03%;LSD(SG-FKL) 达 44.20%、-3.72%,Pass@32 升至 67.13%;SG-RKL 的 LST1000 最低 -10.92% 但 Pass@1 42.80%;PG-RKL 43.56%/1.45%。固定简单集长度从 RL 的 997 token 降到 757(SG-RKL)/859(SG-FKL),难题长度反而从 2329 升到 2393–2511,呈现简单变短、难题更长的定向效应;Table 8 显示三个冻结集上所有 LSD 变体均比 RL 更准且更短(b=1000:98.64%/1016 → 99.73%/822)。多轮智能体(Qwen3-8B-Base,BrowseComp-Plus):RL 29.50%/LST50 31.4%;SG-FKL 30.72%/13.7%,PG-RKL 31.65%/16.1%,SG-RKL 29.60%/9.2%;RL+Length Penalty 把 LST50 压到 1.2% 但 Pass@1 崩到 22.58%。基线:CRISP 40.56%,Fixed 30.44%,Random Routing 仅 22.08%。消融:H=4 最优(step-1750 Pass@1 41.85%),H=8 的 LST 更低(2.91%)但 40.49%;τ=1.0 优于 0.85/0.75(40.91%/39.31%);简单路由仅占 10.58%–12.17% 训练 token。
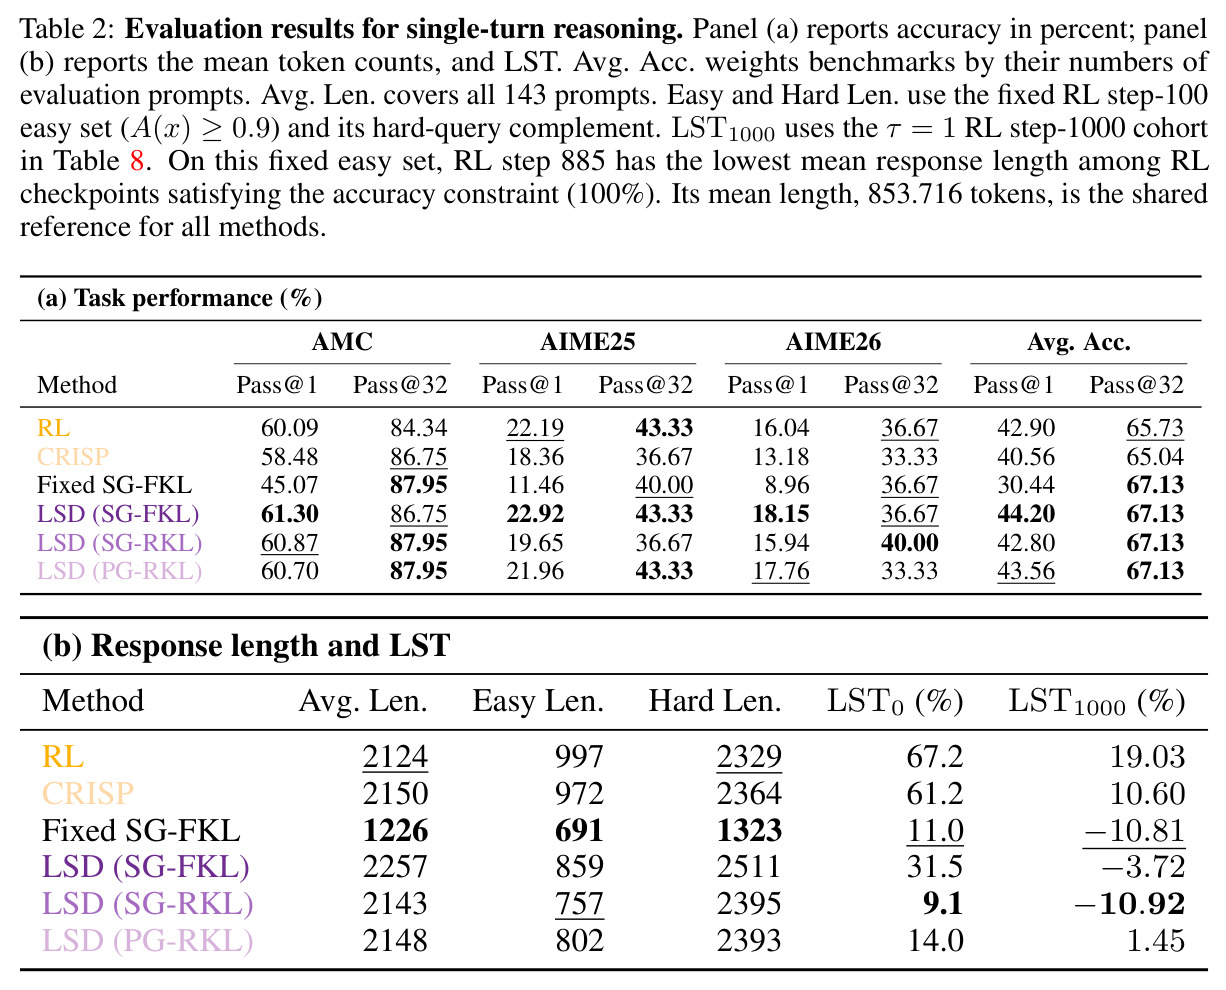
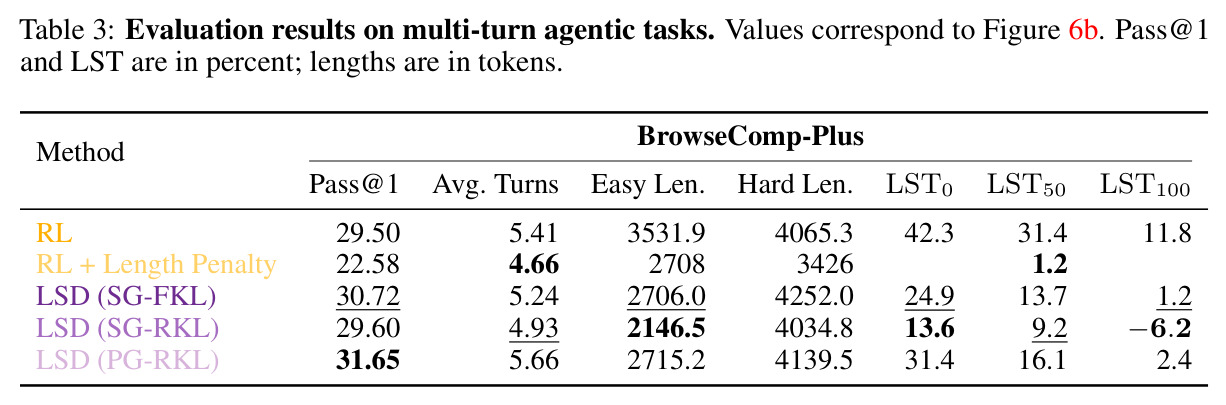
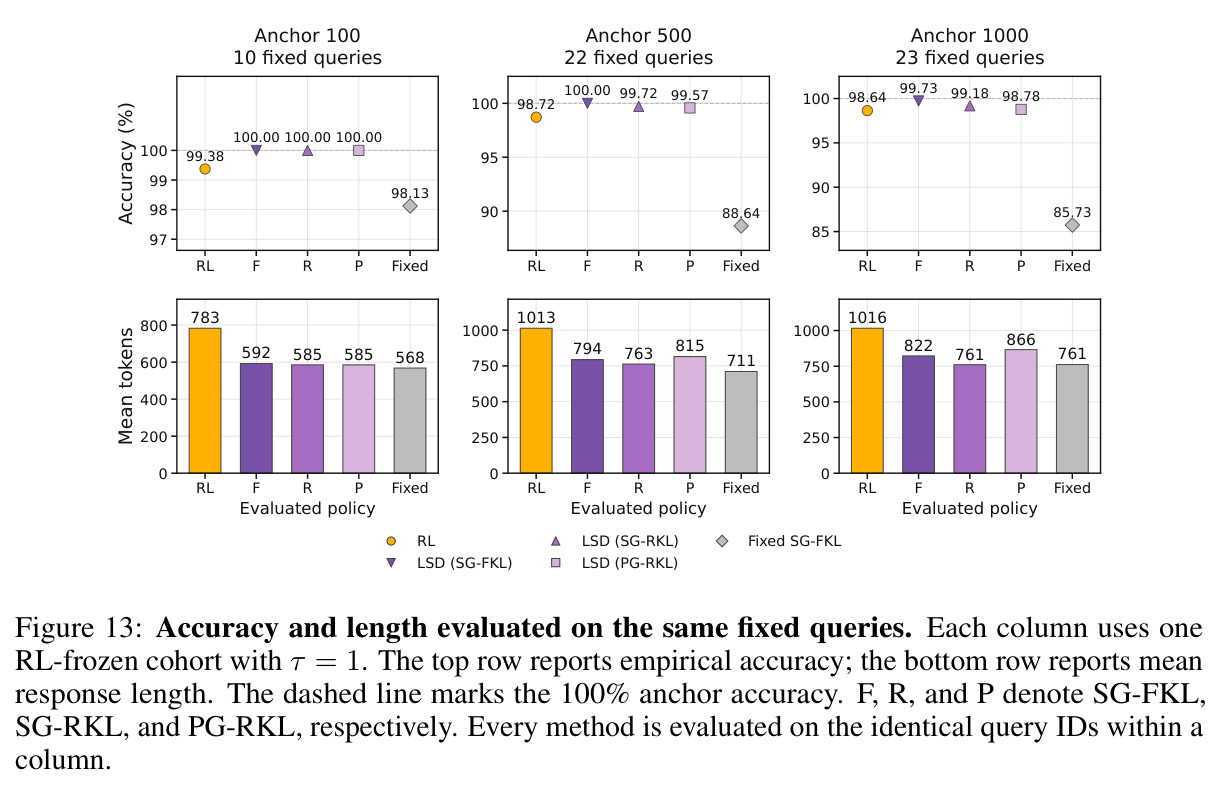
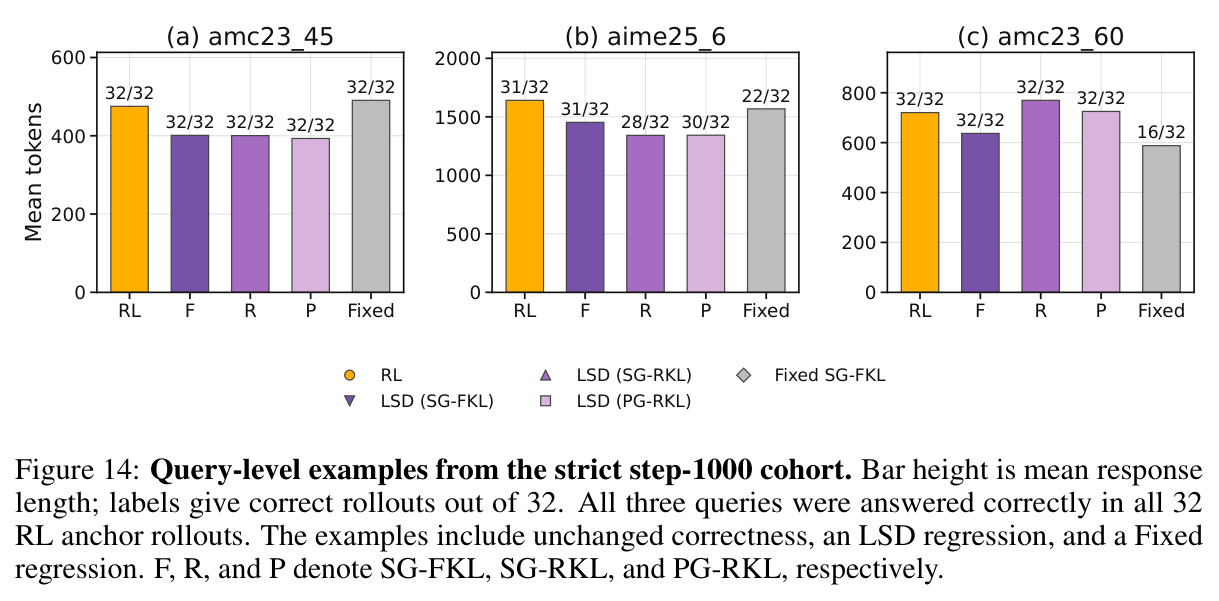
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单轮数学推理(AMC23+AIME25/26,143 题) | 平均 Pass@1 (%) | 44.20(LSD SG-FKL) | 42.90(纯 RL);40.56(CRISP);30.44(Fixed SG-FKL) | 较 RL 提升 1.3 个百分点,同时长度税下降 |
| 单轮数学推理 | LST1000 (%) | -3.72(SG-FKL)/ -10.92(SG-RKL)/ 1.45(PG-RKL) | 19.03(RL) | 减少约 20–30 个百分点 |
| 单轮固定简单集(step-100,τ=0.9) | 简单题平均长度(token) | 757(SG-RKL)/ 802(PG-RKL)/ 859(SG-FKL),准确率均高于 RL | 997(RL,准确率 98.15%) | 缩短 14%–24% 且准确率提升 |
| 多轮智能体(BrowseComp-Plus,830 题) | 平均 Pass@1 (%) | 31.65(PG-RKL)/ 30.72(SG-FKL) | 29.50(RL);22.58(RL+Length Penalty) | 提升 1.2–2.15 个百分点 |
| 多轮智能体 | LST50 (%) | 9.2(SG-RKL)/ 13.7(SG-FKL)/ 16.1(PG-RKL) | 31.4(RL) | 减少 15–22 个百分点;RL+Length Penalty 虽降至 1.2% 但 Pass@1 掉 6.9 个百分点 |
| 单轮消融(step-1750) | 平均 Pass@1 (%) | 41.85(H=4, τ=1.0) | 40.14(H=2)/ 40.49(H=8)/ 40.91(τ=0.85)/ 39.31(τ=0.75) | 中间滞后与全对路由的组合最优 |
局限与改进
作者承认的局限:实验仅覆盖 4B/8B 模型,更大模型留待未来;代码承诺接收后开源,目前不可得;LST 在 τ<1 时只度量阈值约束下的超长,并不能严格证明同等准确率下的浪费(τ=1 时参照已是满分准确率,才可如此解读);负 LST 只表示比参照检查点更短,不必然更好。我自己的观察:其一,评测集很小(AMC 83 题、AIME 各 30 题),Pass@1 上 1–2 个百分点的差异未必统计显著,且每题 32 采样的评估成本高;其二,路由依赖简单题历史稳定性(>87% 一致)这一经验事实,在数据分布剧烈变化或能力快速增长阶段可能失准;其三,SG-RKL 的低熵(0.0367 vs SG-FKL 0.0743)暗示过强保形可能损害长期探索,但文中只有单次训练佐证;其四,智能体场景的 LST 只计策略生成 token,工具观测与 refinement agent 的成本是独立分量,端到端经济性未完整核算;其五,EMA 教师需要额外 FP32 参数副本,工程开销未量化。
独立分析的弱点
独立分析的弱点:第一,超参敏感性与耦合——H 和 τ 各有消融,但二者交互未探索,且论文自承这些耦合变化不能隔离哪个训练信号导致性能差异;改进方向是做 H×τ 网格或随训练进度自适应调整 H。第二,路由阈值 τ=1 过于保守:7/8 对的部分可解组仍保留有效 RL 信号,这个选择合理,但意味着 LSD 对接近掌握的题目没有加速收益;可研究随能力增长动态移动 τ 的课程式方案。第三,奖励只有 0/1 正确性,LST 框架目前绑定可验证任务,扩展到开放域生成需要质量代理。第四,三个变体各有短板(SG-RKL 低熵、PG-RKL 智能体轮次反而更多 5.66 vs 5.41),缺少理论解释何种条件下哪个占优;可用 mode-covering 与 mode-seeking 的分布层面刻画补足。第五,与 CRISP 等基线的比较依赖实现细节(蒸馏系数、教师刷新频率),公平性依赖附录配置,最好在统一超参搜索后对比。第六,LST 的参照 $L^\star_b$ 依赖锚点选择与检查点密度(论文用了 345 个 RL 检查点取最小),工程实践中难以如此密集评测。
未来方向
作者提出的方向:把 LSD 评估扩展到更大模型;探索如何从采样数据中提取更密集的学习信号以提升监督效率。可延伸的方向:其一,把难度路由与课程学习结合,让路由阈值随策略能力自适应移动,或与 dynamic sampling 统一成组信息量框架;其二,将 EMA 自教师思路推广到抑制 RL 的其他副作用,如安全感退化、格式漂移等,形成行为税家族的系统治理;其三,LST 指标可扩展为多维度条件化税(长度、工具调用次数、反思词频率、重复 bigram 率),论文已显示后两者随训练上升,可纳入监控面板;其四,从理论上分析零优势组的隐式动态并推导最优路由比例;其五,与 off-policy 方法结合(第一作者此前有 buffer 方面的 ICLR 2026 工作),把自蒸馏监督用于回放缓冲中的旧轨迹;其六,在多轮智能体上研究轮次与 token 的联合税指标,因为 PG-RKL 表明 LST 低不等于交互轮次少;其七,探索路由错误(把新解出的难题误路由)的在线纠错机制。
复现评估
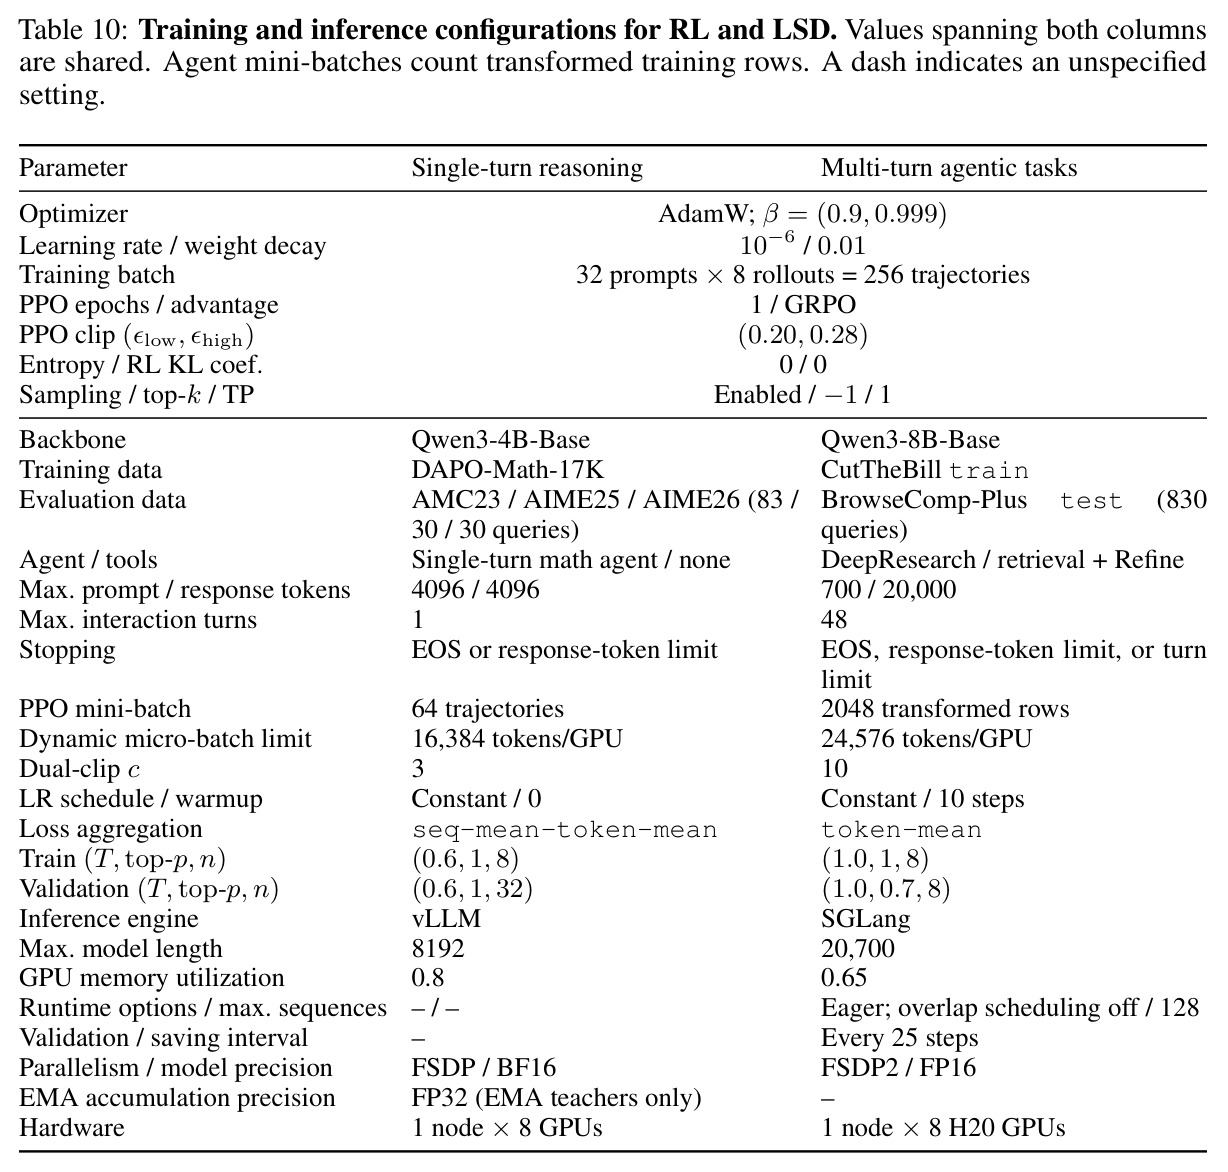
复现评估:代码接收后发布,当前未开源,这是最大障碍。但附录 F 极为详尽:Table 10 给出全部训练/推理配置(AdamW,学习率 1e-6,batch 32 提示×8 rollout=256 轨迹,PPO clip (0.20,0.28),FSDP/BF16,单轮用 vLLM、智能体用 SGLang),Table 11 给出各变体差异参数(EMA 半衰期 4、蒸馏系数 1、top-32 KL 支持集、PG 优势 clip 10),并附 W&B run ID(s71jbnha、z7hhhn5x、178n91ko 等)可查训练曲线。数据全部公开:DAPO-Math-17K、CutTheBill、BrowseComp-Plus、AMC23/AIME。算力门槛:单轮任务 1 节点 8 GPU,智能体任务 1 节点 8 张 H20;训练超过 1750 步、每 25 步在 143 题上做 32 采样验证,评估开销可观。拥有 8 卡 A100/H100 集群的团队复现主表可行但需数天;个人难以完整复现,不过 LST 指标计算只依赖 checkpoint 评测(每题 32 采样),可在任何已有 RL 运行上低成本验证现象本身。
论文图表
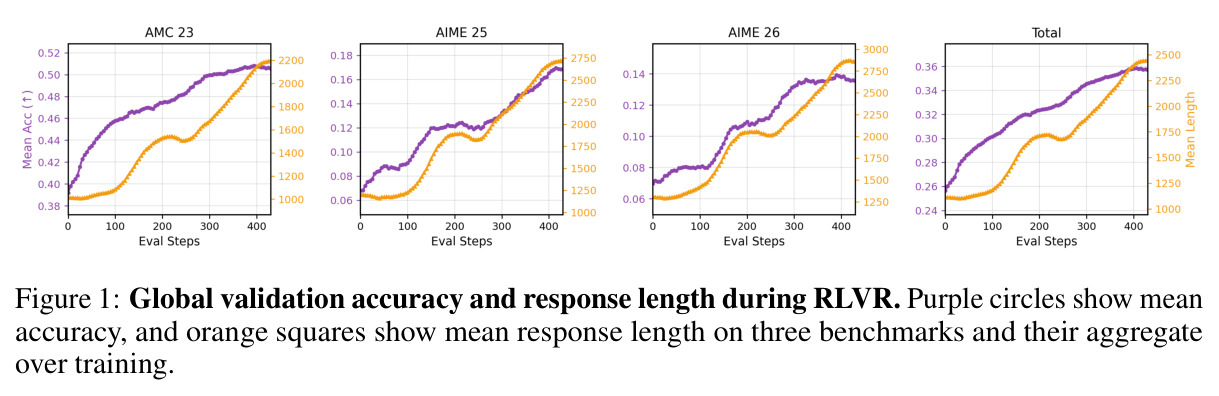
紫色圆点为平均准确率、橙色方块为平均响应长度,在 AMC/AIME 三个基准及其聚合上随训练步数的演化:准确率稳步上升的同时平均长度持续增长。
展示 LST 现象的全局背景——长度增长本身不全是坏事(难题确实需要更长推理),为后续把它条件化到已解题集合的度量设计做铺垫。
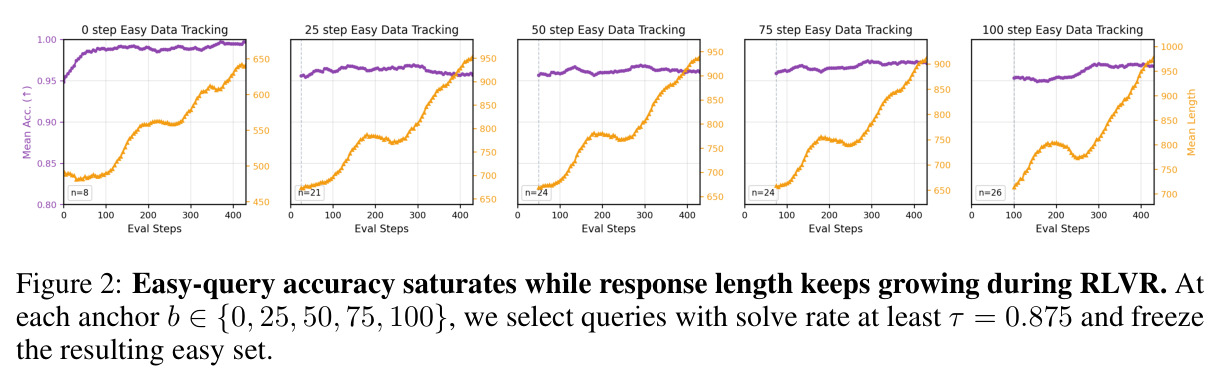
对锚点 b∈{0,25,50,75,100} 各自冻结的简单题集(解题率≥0.875),在后续所有检查点上跟踪:准确率基本稳定,而响应长度持续上升,无论用哪个锚点定义集合都如此。
LST 核心现象的首次系统呈现,也是冻结简单集评测协议的直接可视化,是全文立论的基础证据。
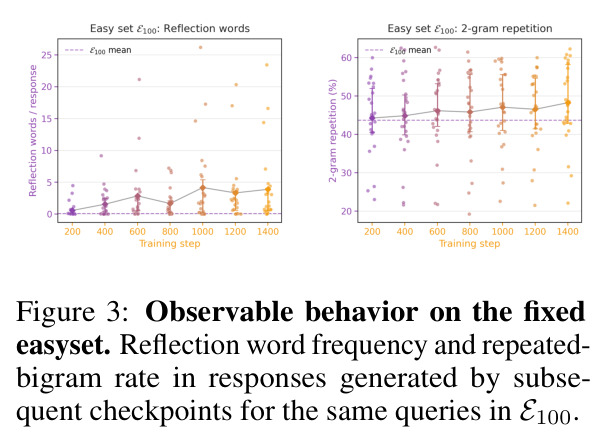
对 step-100 简单集 E100 的 26 题、5824 个回答做词表分析:随训练进行,反思词(犹豫、验证、自我修正)频率与重复 bigram 率大幅上升。
从行为学角度证明简单题上多出的 token 是犹豫和重复而非有效推理,支撑把这部分长度定性为可征税的浪费。