当EOS令牌不一致时:在线策略蒸馏中的长度膨胀机理 When EOS Tokens Disagree: Understanding Length Inflation in On-Policy Distillation
师生终止符错配使学生停不下来,概率层语义聚合可大幅缓解OPD长度膨胀
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
学生模型在自己的 rollout(自己采样出的回答)上训练,由固定教师模型在每个 token 上给出密集监督。本文研究的 sampled-token OPD 只对教师评分为 $A_t=\log\pi_E(y_t|s_t)-\log\pi_\theta(y_t|s_t)$ 的被采样 token 做策略梯度式更新,每步用 16 个 prompt × 4 条 rollout。它是把大型后训练模型的行为迁移到小模型的实用框架,与 RLVR 的区别在于没有结果奖励、完全依赖教师分布。
论文的全部现象(长度膨胀、终止概率坍缩)与四种修正策略都定义在 OPD 的训练信号上;不理解『教师只给学生采样出的 token 打分』这一点,就无法理解 EOS 错配为何会系统性压制学生的停止动作。
EOS 与特殊终止符
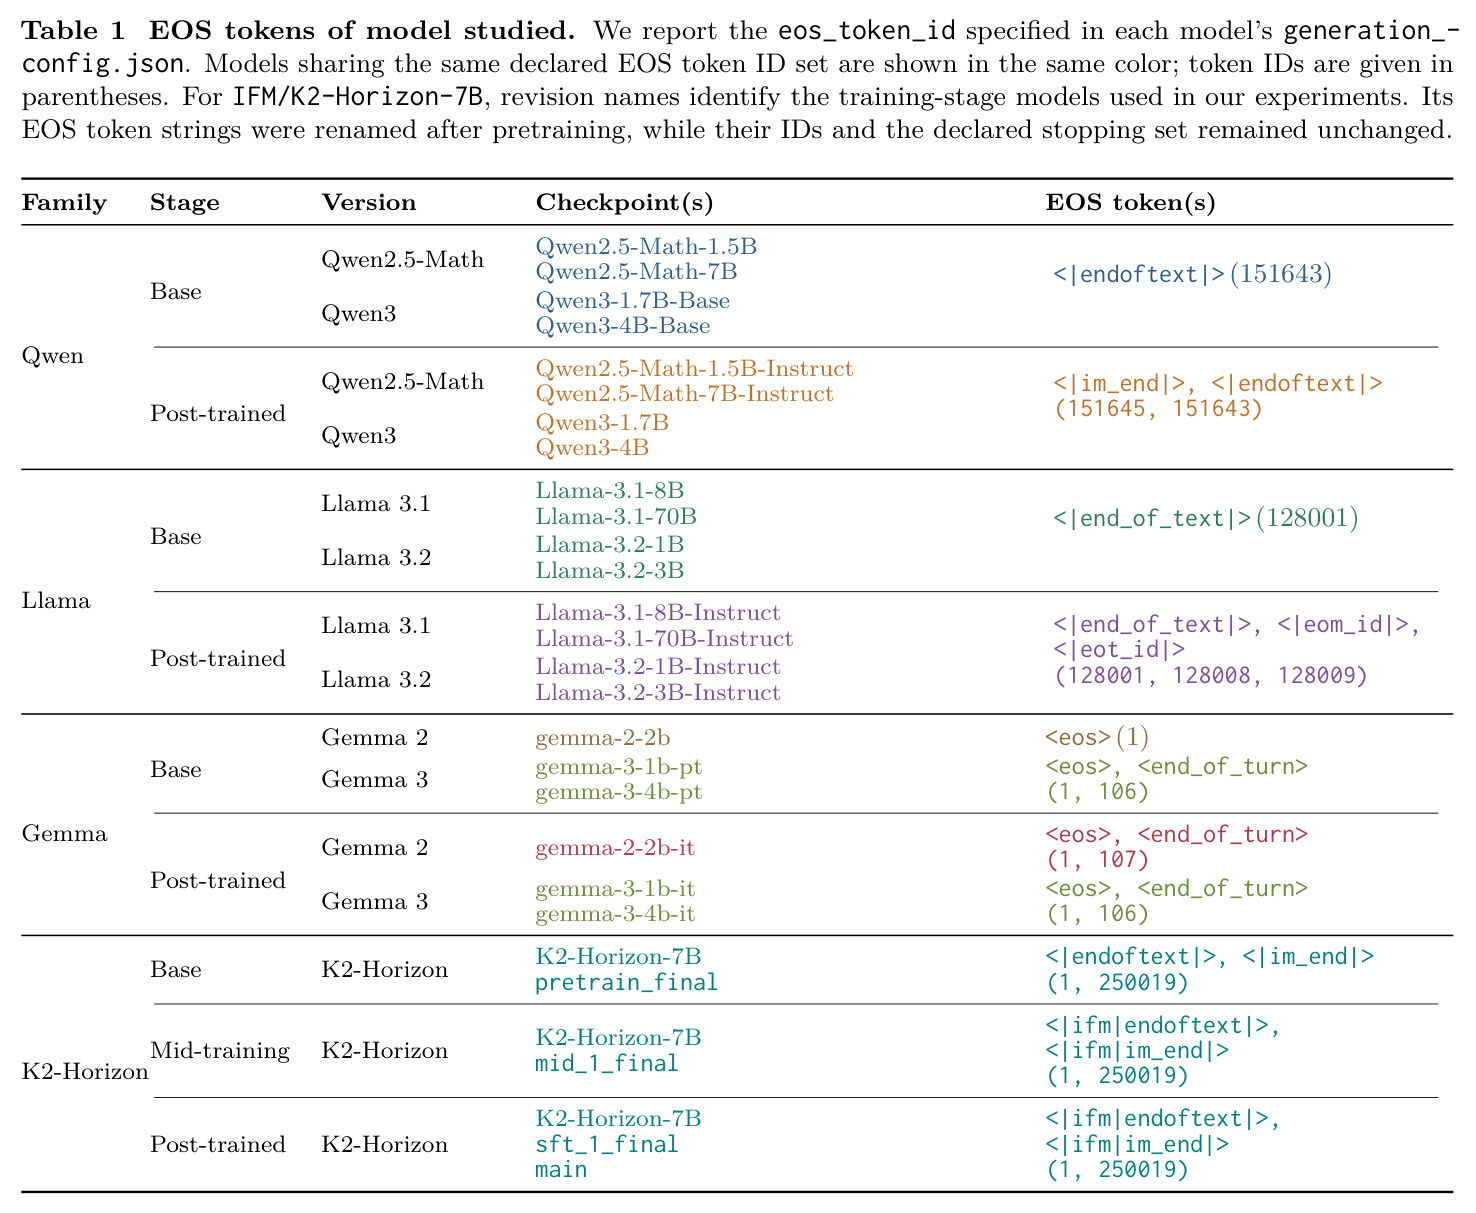
词表中的特殊 token,用于标记回复结束,如 <|endoftext|>、<|im_end|>、<|eot_id|>。模型在 generation_config.json 里声明的 eos_token_id 集合决定解码器何时停止生成;但模型实际把学到的终止概率放在集合中的哪个 token 上是训练出来的。base 模型与 post-trained 模型经常采用不同的终止惯例(如 Qwen3 base 用 <|endoftext|>,对话版增加 <|im_end|>)。
论文的核心发现是:师生可能把『停止』这一语义动作编码在不同特殊 token 上,即便双方声明的 EOS 集合完全相同(Gemma 3)也一样出问题。区分『声明集合』与『学到的偏好』是读懂全文的前提。
反向KL蒸馏与score-function梯度
反向 KL $D_{KL}(\pi_\theta \| \pi_E)$ 是 OPD 常用目标,其梯度可用 score function 形式估计:系数 $A_t=\log\pi_E(y_t|s_t)-\log\pi_\theta(y_t|s_t)$ 乘以 $\nabla_\theta\log\pi_\theta(y_t|s_t)$。系数为负时压低该 token 的 logit;softmax 耦合还意味着对其他 token 的惩罚会间接抬升相对 logit。轨迹级一致的目标还包含后继项 $-V_\theta(f(s_t,y_t))$。
EOS 错配正是通过这个梯度起作用的:学生采样自己的 EOS 时教师对该具体 surface token 概率低,于是 $A_t<0$ 持续惩罚终止;附录C的命题1也是围绕该梯度推导出局部 OPD 缺少 $p_\theta(s)C_\theta(s)\ge0$ 的停止压力。
生成预算与截断率(clipping ratio)
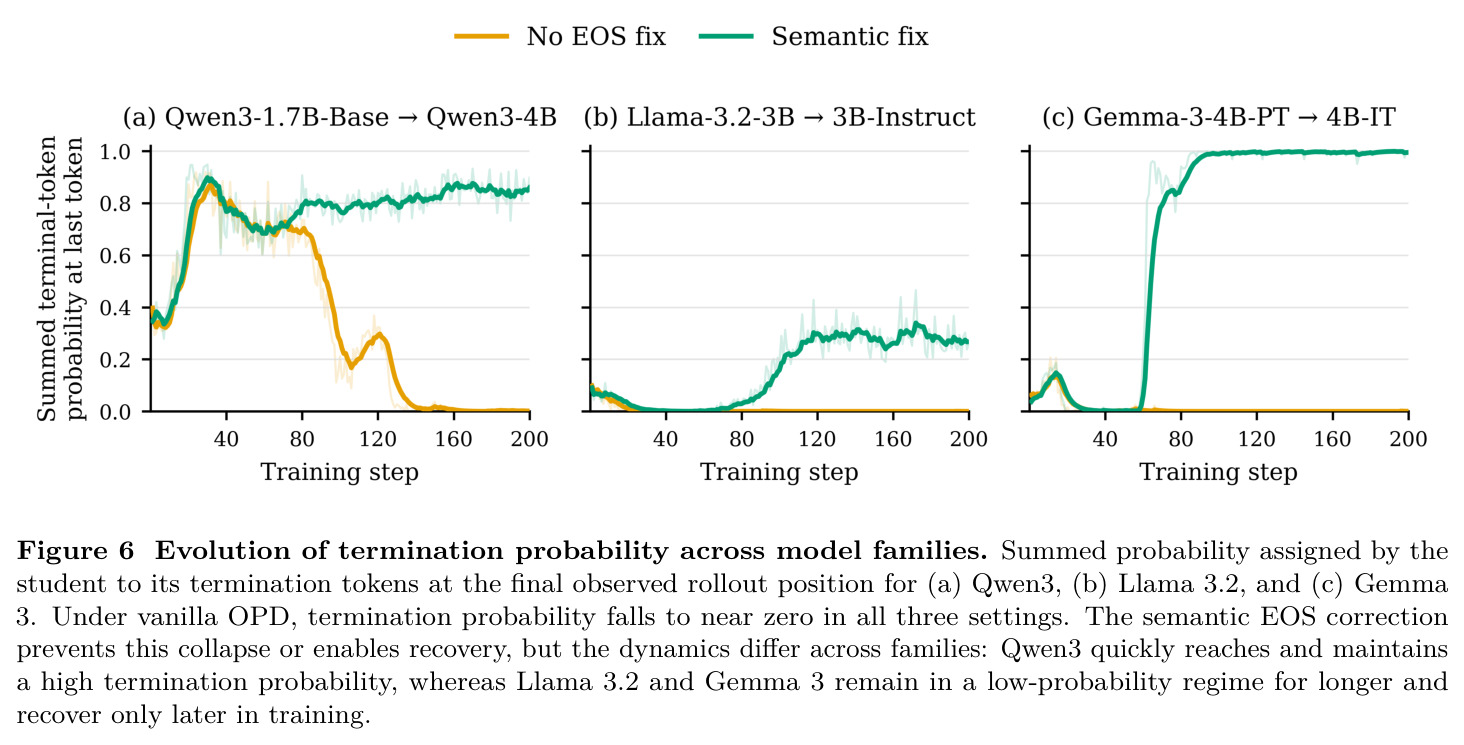
rollout 设定最大生成长度(本文训练时 1,024 prompt + 7,168 响应 token),达到预算仍未输出 EOS 就被截断。截断率指打满预算的响应占比,与平均响应长度一起构成训练期监控长度膨胀的两个核心指标;终止总质量 $q^\pi(h)=\sum_{e\in E_{EOS}}\pi(e|h)$ 则从概率层直接观测『想不想停』。
长度膨胀的全部定量证据都建立在这几个指标上;论文反复强调生成长度、截断率(生成行为)与终止概率(模型内部偏好)是不同的量,混用会导致误读实验曲线。
研究动机
在线策略蒸馏(OPD)近来被多篇工作报告存在『长度膨胀』:学生回答越训越长,严重时大量 rollout 打满生成长度预算,伴随截断与重复等生成病理。已有解释包括反向KL目标隐式偏好长而重复的序列(Luo et al., 2026)、过大生成预算导致教师监督随轨迹深度退化(Li et al., 2026)、反向KL引发熵坍缩(Zhao et al., 2026)等。作者在 Qwen3、Llama、Gemma 上用 base 学生 + post-trained 教师做单轮数学蒸馏时复现了同一现象,且能给出触目惊心的具体案例:Qwen3 学生在 AMC23 第10题上于第 1,094 个 token 就写出正确答案 \boxed{5},随后又生成 7,098 个冗余 token(占全响应 86.6%),把『### Final Answer: \boxed{5}』重复了 704 次;另一例冗余占比 90.7%、『Let’s try』块重复约 368 次;最严重的例子冗余占 94.4%、同一符号重复 3,836 次。回答变长完全不等于推理更充分,很多时候只是『停不下来』。
本文的目标是本文的目标是定位 OPD 长度膨胀的一个直接、可诊断且易于修复的根因,并给出最小代价的修正。具体拆成四件事:(1) 证明 base 学生与 post-trained 教师之间存在终止 token 错配——不仅声明的 EOS 集合可以不同(Qwen3 base 声明 <|endoftext|> 即 ID 151643,post-trained 增加 <|im_end|> 即 151645),即便声明集合完全相同(Gemma 3 的 PT/IT 都声明 + ),两者学到的终止概率偏好也可能落在集合内不同 token 上;(2) 系统比较四种终止处理策略,干净地分离『解码层对齐』与『蒸馏信号概率层对齐』各自的作用;(3) 利用 K2-Horizon-7B 公开的 pretraining/midtraining/SFT/final 四阶段检查点,刻画终止偏好如何随训练演化,并确定修正之后仍残留哪些长度动态;(4) 把修正方案在 Qwen3、Llama 3.2、Gemma 3 三个家族上做交叉验证,并发布带修正的实现。
与已有工作不同的是,已有工作把长度膨胀归因于算法层机制:目标函数偏好(反向KL偏爱长重复序列)、rollout 退化(教师对漂移前缀的监督失准)、熵坍缩等。这些机制共享一个隐含前提——学生先要停止失败。本文的切入角度更底层、更『工程』:先追问学生是否根本没学会停止,并发现一个被忽视的实现层事实——师生把同一个语义动作『停止』编码在不同特殊 token 上。由于 sampled-token OPD 中教师只对学生实际采样出的 token 打分,学生采样自己的原生 EOS 时,教师对这个具体 token 概率很低(即使教师语义上认可停止),于是 $A_t<0$ 持续抑制终止;而教师偏好的替代 EOS 在学生分布下概率仅约 $10^{-11}$,几乎不会被采样、得不到直接监督。这与 RLVR 形成有趣的对照:RLVR 中格式敏感的奖励会主动把模型往可解析格式上推,而 OPD 没有结果奖励来纠正表面形式,错配因此得以累积成灾难。
核心方法
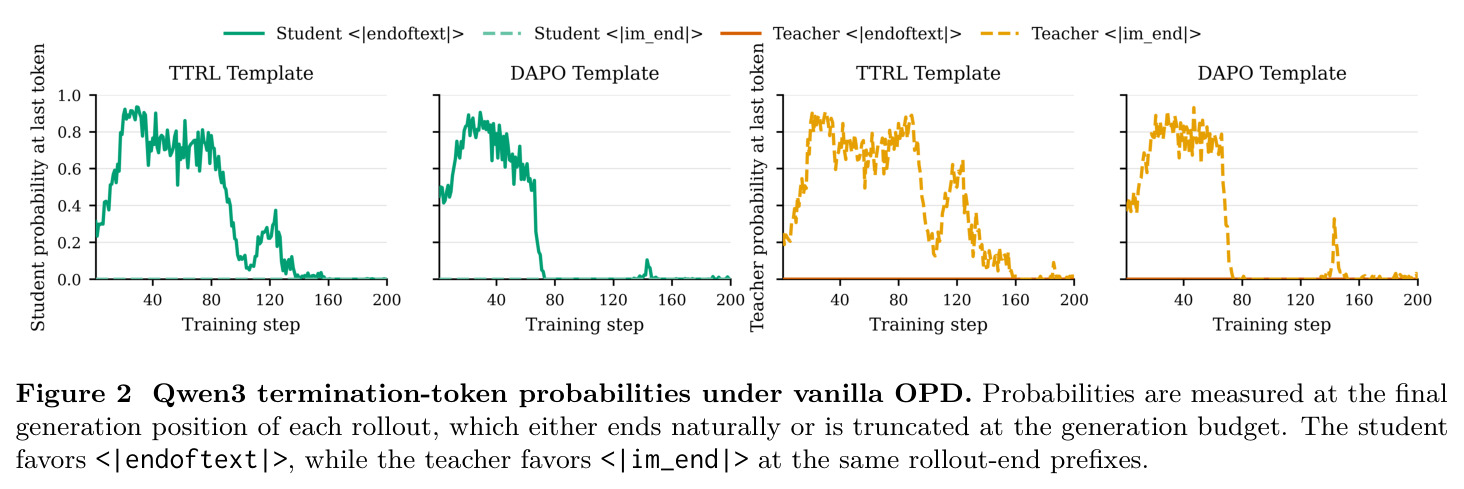
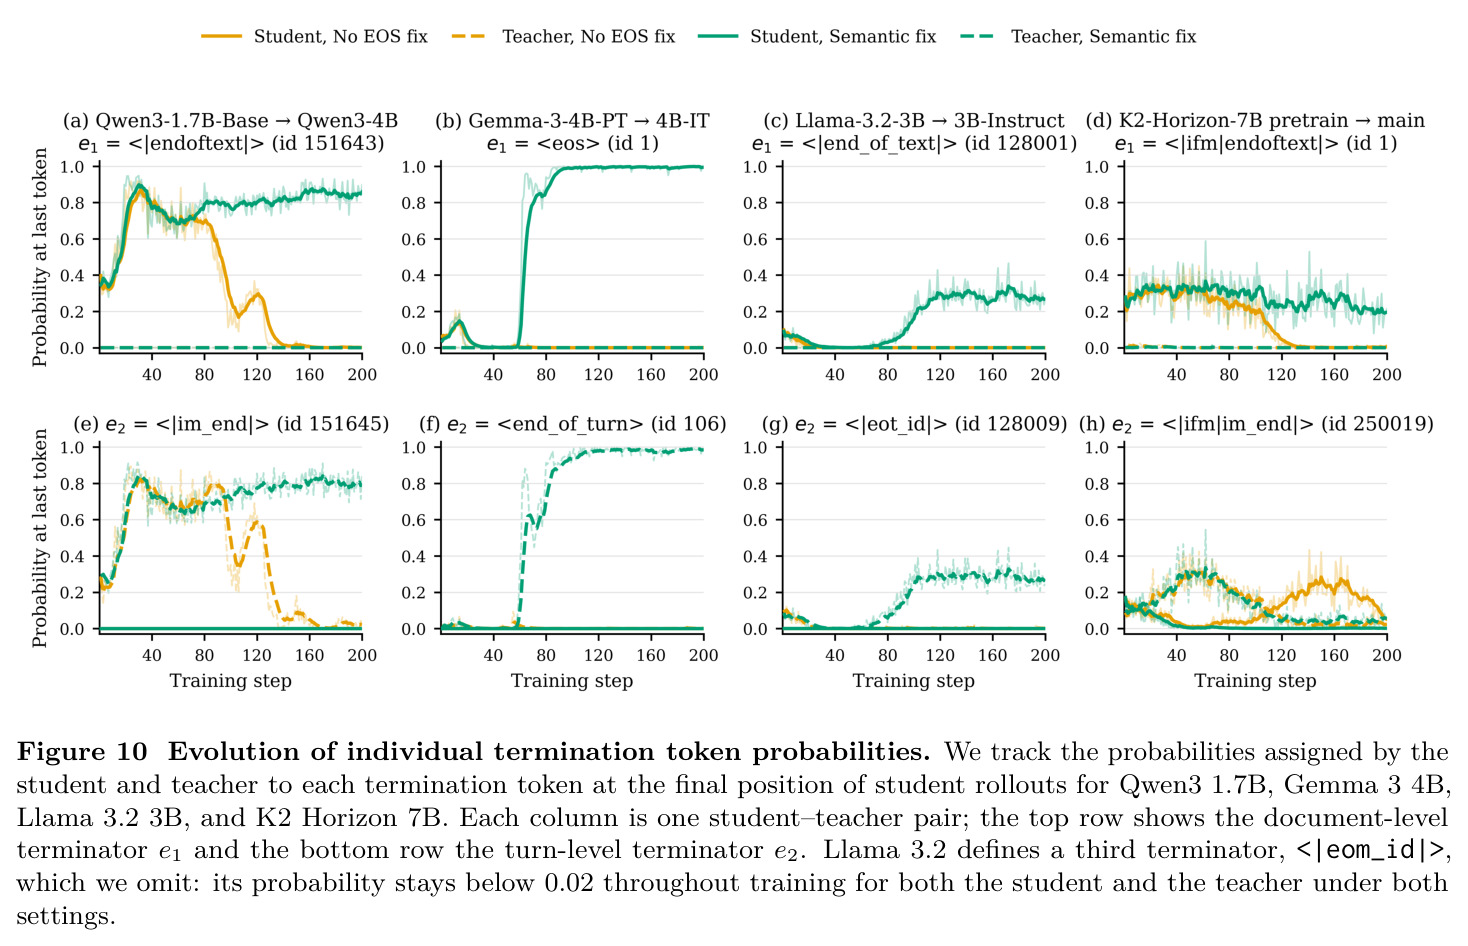
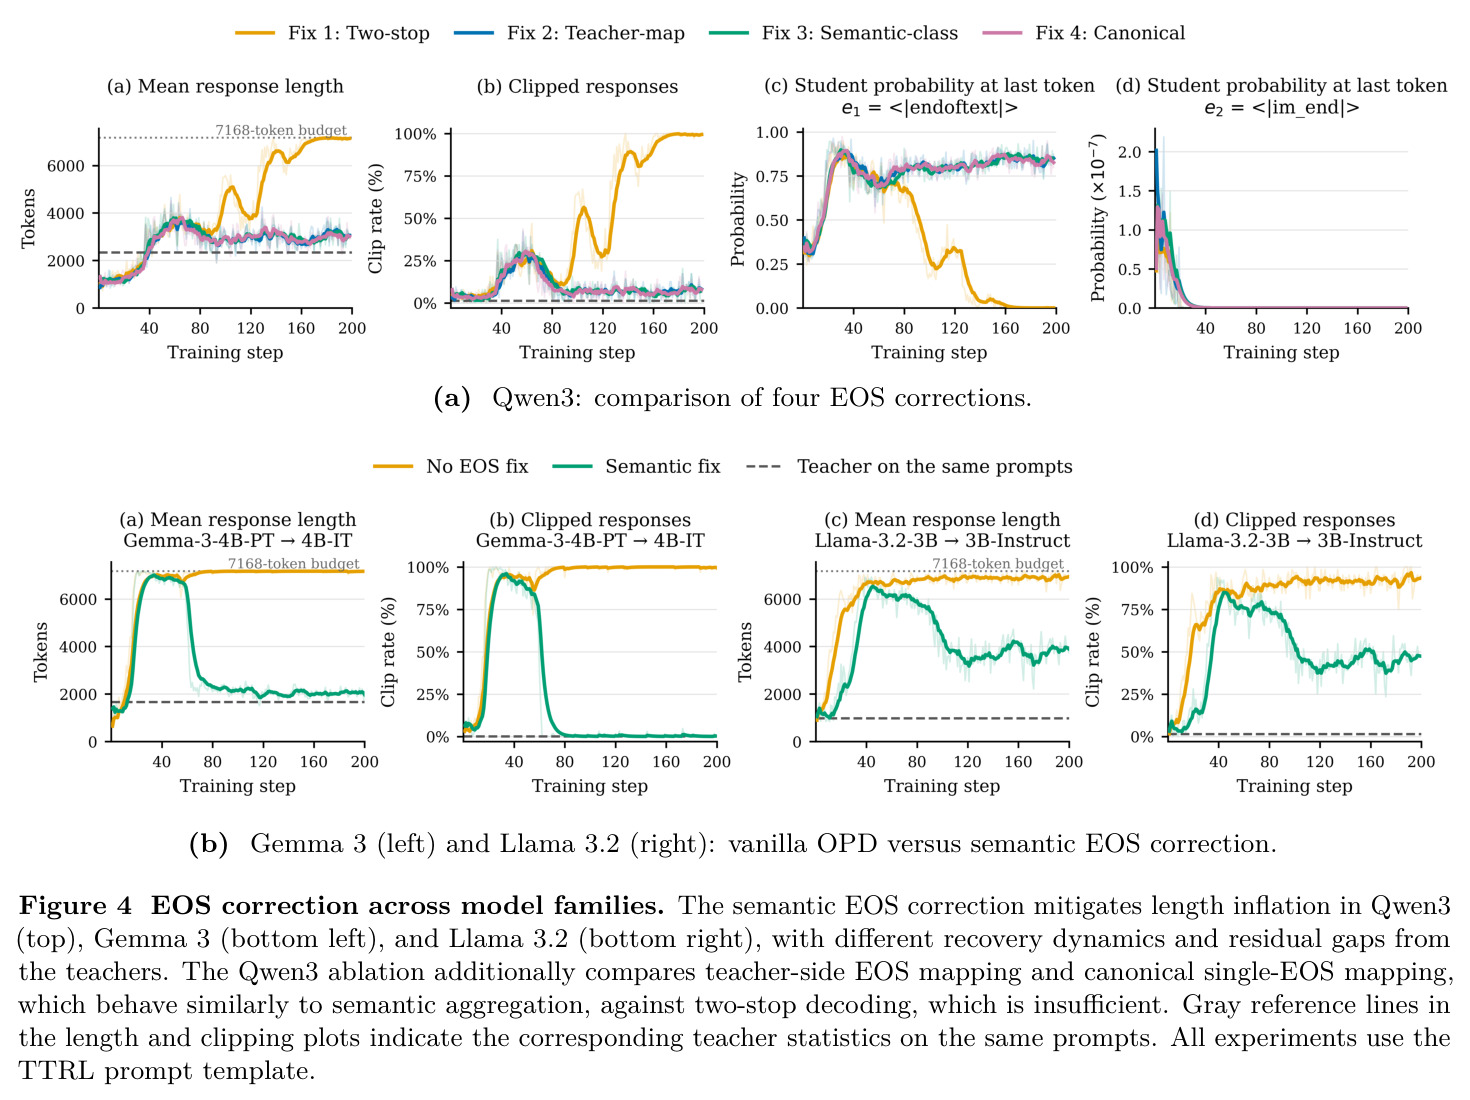
直觉很朴素:学生并非想不出答案,而是不会说停;要让 OPD 把『停止』当作语义动作而非特定 surface token 来监督。路线是『诊断—排除—修正—验证』。诊断:在学生 rollout 终点测量师生对每个终止 token 的概率,发现 Qwen3 学生把约 0.8 的终止概率放在 <|endoftext|>,教师却偏好 <|im_end|>,且学生对后者概率仅约 $10^{-11}$。排除:Fix 1 只把师生所有 EOS 注册为合法停止 token,长度与截断率轨迹和 vanilla OPD 几乎重合,证明解码层对齐无效。修正:三个概率层方案——Fix 2 教师侧映射 $\bar\pi_E(e^\star|s_t)=\sum_{e\in E_{EOS}}\pi_E(e|s_t)$;Fix 3 语义 EOS 类,把 $E_{EOS}$ 内所有 token 视为同一动作 stop;Fix 4 规范单 EOS 动作空间,在 Fix 2 基础上把其余 EOS 从学生采样分布移除并重归一化。验证:Qwen3-1.7B-Base 学生 + Qwen3-4B(非思考)教师,DAPO-Math-17K 数据,每步 16 prompt × 4 rollout 训 200 步,再到 Llama 3.2、Gemma 3 与 K2-Horizon 各阶段交叉验证。
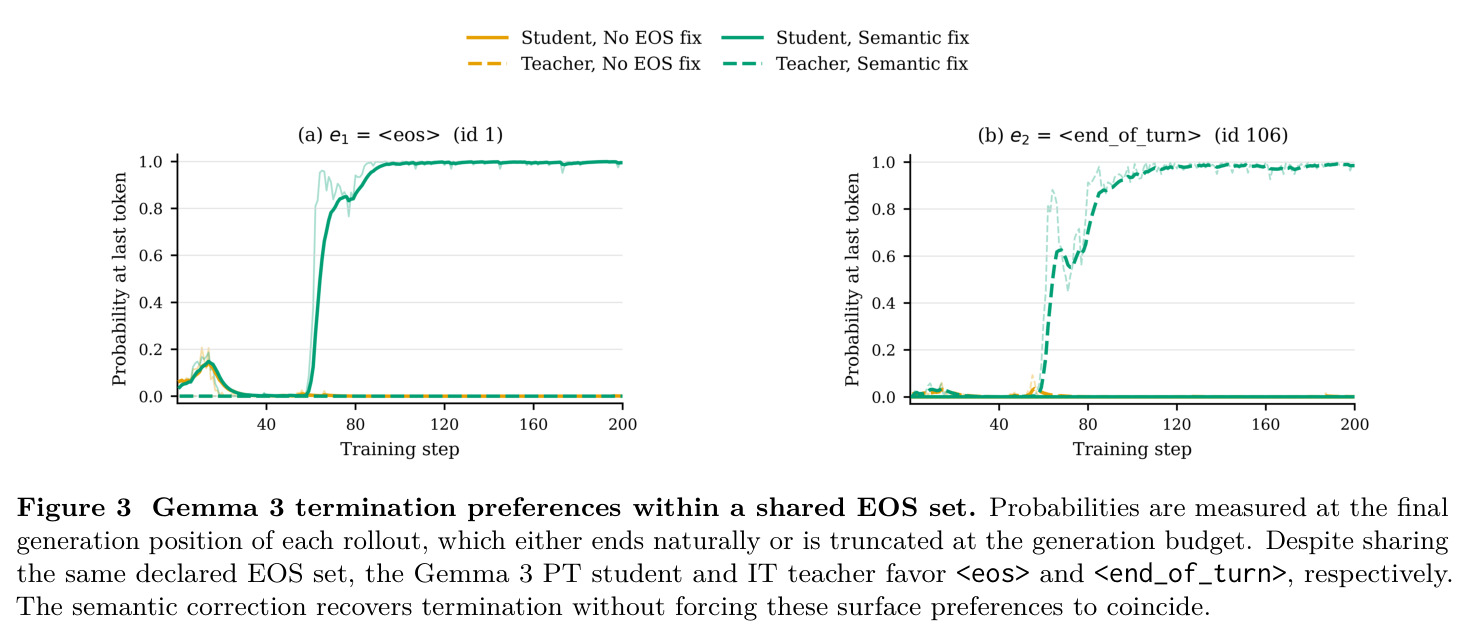
核心创新是把『终止』从 surface token 层面提升到语义动作层面来监督。与 Fu et al. (2026) 直接把问题特殊 token 从蒸馏信号里 mask 掉、Plyusov et al. (2026) 把师生 EOS 规范化到同一停止事件不同,本文把错配本身当作研究对象:系统追踪表面 token 分歧如何被 token 级目标放大为终止概率坍缩与长度膨胀,并构造四点干预的受控消融——解码规则(Fix 1,无效)、教师分布(Fix 2,有效)、语义动作空间(Fix 3,有效)、学生动作空间(Fix 4,有效)。最关键的经验结论是:只有改变蒸馏信号的概率层对齐有效,单纯扩大解码停止集无效——从反方向证明问题在训练目标而非解码配置。第二个洞察是错配比『声明集合不同』更普遍:Gemma 3 PT/IT 声明集合相同,但学生把终止概率放在 、教师放在 ,错配照样发生。语义聚合不要求师生学会相同的表面偏好、只匹配终止总概率,因此成为跨家族的默认修法,还带来一个反直觉的好性质:学生恢复可靠终止时不必 adopt 教师偏好的那个表面 token。
方法步骤详情
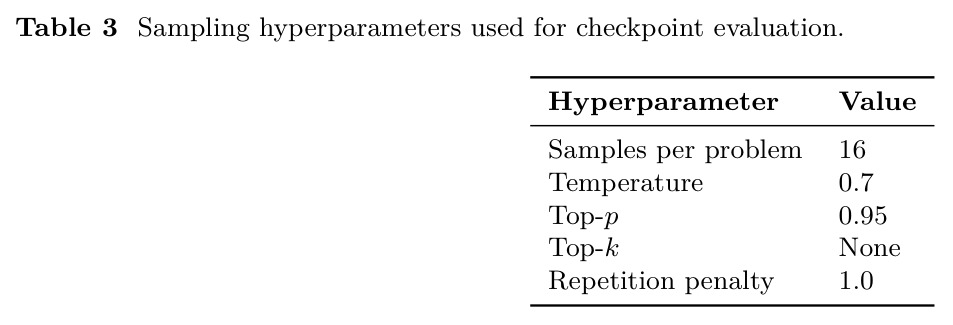
步骤一(诊断):读 generation_config.json 得到声明 EOS 集合(Table 1),在学生 rollout 终点测师生对各终止 token 的概率:Qwen3 学生约 0.8 概率在 <|endoftext|>,教师偏好 <|im_end|>,学生对其概率约 $10^{-11}$。步骤二(Fix 1,排除解码层解释):把 <|im_end|> 注册为额外停止 token,目标不变;长度/截断轨迹与 vanilla 几乎重合——学生几乎不采样该 token,<|endoftext|> 仍持续收到负信号。步骤三(概率层修正):Fix 2 把教师在所有 $e\in E_{EOS}$ 上的概率质量加到学生原生 $e^\star$(保留极小概率、总质量不变),rollout 只在 $e^\star$ 停止;Fix 3 定义聚合分布 $\bar\pi(\text{stop}|s_t)=\sum_{e\in E_{EOS}}\pi(e|s_t)$,采到任意 EOS 就替换为 stop,用 $A_t=\log\bar\pi_E(\bar y_t|s_t)-\log\bar\pi_\theta(\bar y_t|s_t)$ 做标准更新,所有 EOS 都是合法停止 token;Fix 4 在 Fix 2 之上把其余 EOS 从学生分布移除并重归一化。步骤四(验证):在 Llama-3.2-3B(<|end_of_text|> vs <|eot_id|>)与 Gemma-3-4B(同集合内 vs )重复 base→post-trained 蒸馏;K2-Horizon-7B 上固定 final 为教师、从 pretrain/midtrain/SFT 分别初始化;每 20 步存 checkpoint,在 AIME24/25(各 30 题)与 AMC23(40 题)上以 Avg@16 评估。
技术新颖性
新颖性有四点。第一,问题定位新颖:把长度膨胀的一个重要根因归结为实现层的终止 token 错配,而非反向KL偏好、熵坍缩或 rollout 退化等算法层机制;这些先前机制共享一个前提——学生先要停止失败——本文恰好在『前提』层面动刀,并把算法层机制变成错配修复后仍成立的互补解释。第二,诊断方法新颖:明确区分『声明的 EOS 配置』与『学到的终止概率偏好』,引入终止总质量 $q^\pi(h)=\sum_{e\in E_{EOS}}\pi(e|h)$ 在概率层直接观测终止行为,而非只看生成长度这类间接量。第三,干预比较新颖:四个 fix 构成把『解码接口 vs 蒸馏信号』干净分离的消融(Fix 1 无效、Fix 2/3/4 有效),并给出决策规则——已知 Qwen3 型显式错配时 Fix 2 最简;跨家族或集合内分歧时默认 Fix 3;Fix 4 收益相近但更约束动作空间。第四,边界刻画诚实且带理论:K2-Horizon 显示修正后仍存在晚期再膨胀(Phase 3),附录C命题1证明局部 OPD 相对轨迹一致反向KL更新总是缺少 $\Delta^\star_e(s)-\Delta^{\text{OPD}}_e(s)=p_\theta(s)C_\theta(s)\ge0$ 的停止 logit 抬升,为残余动态提供了有推导支撑的候选解释。
实验结果
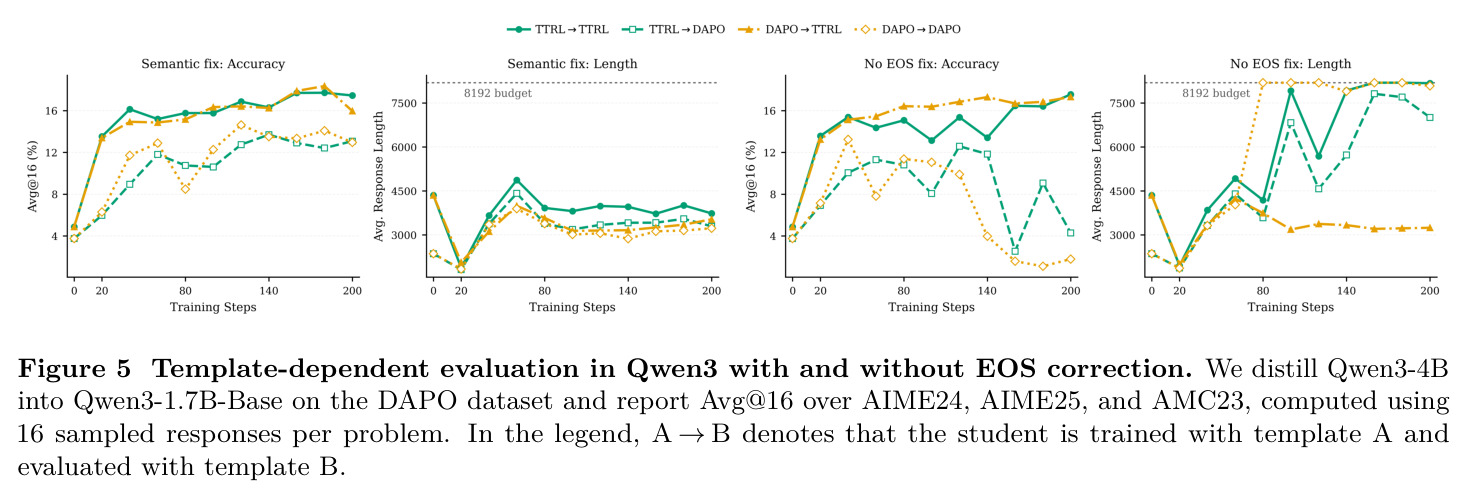
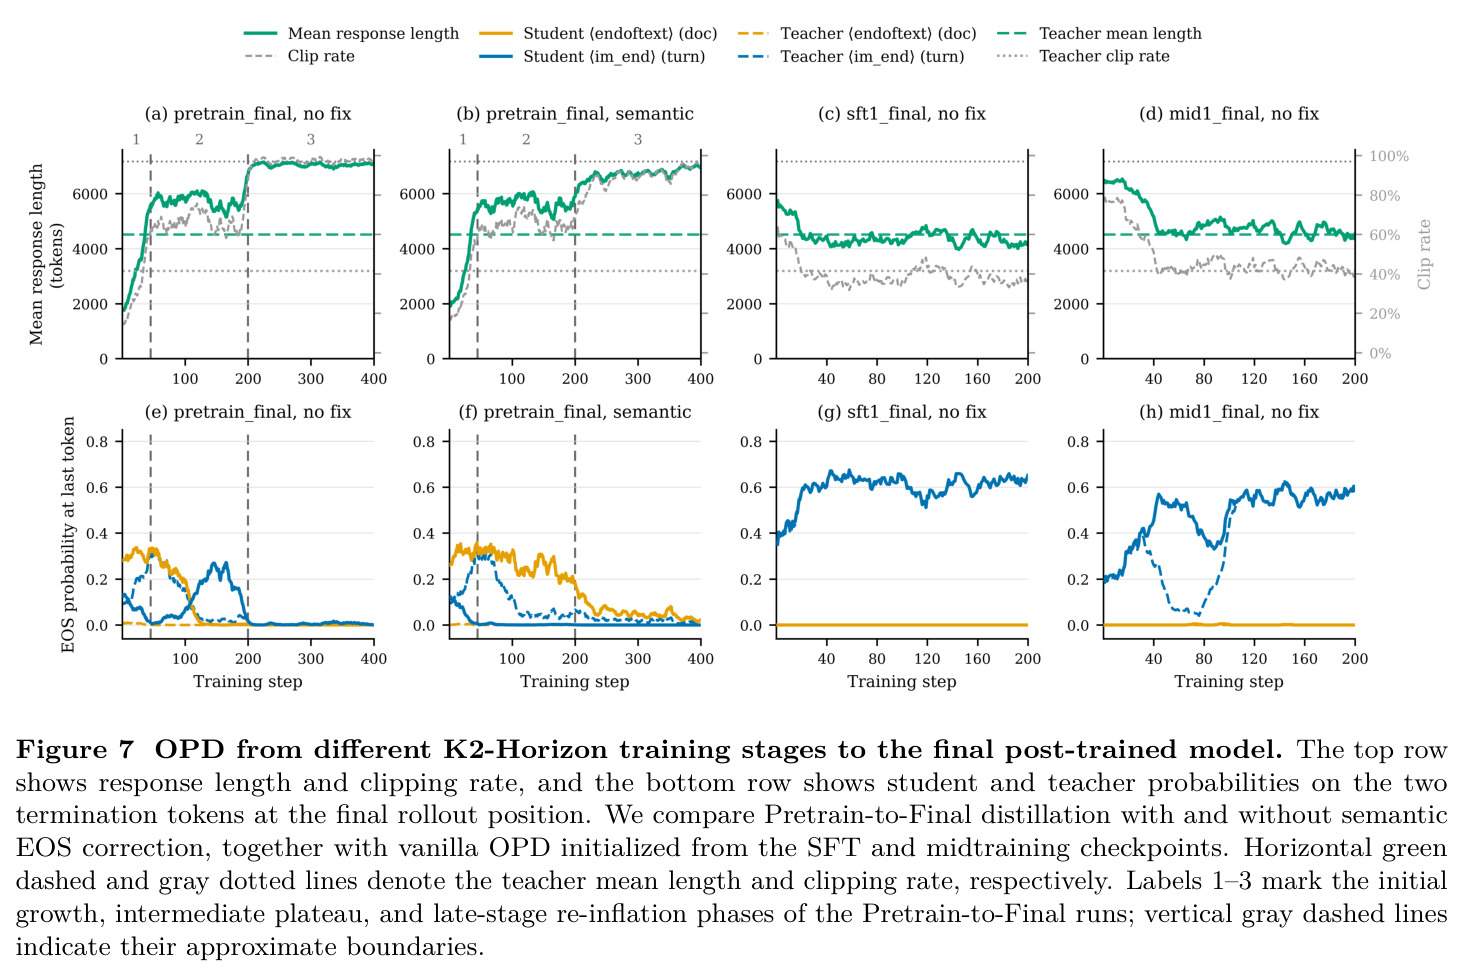
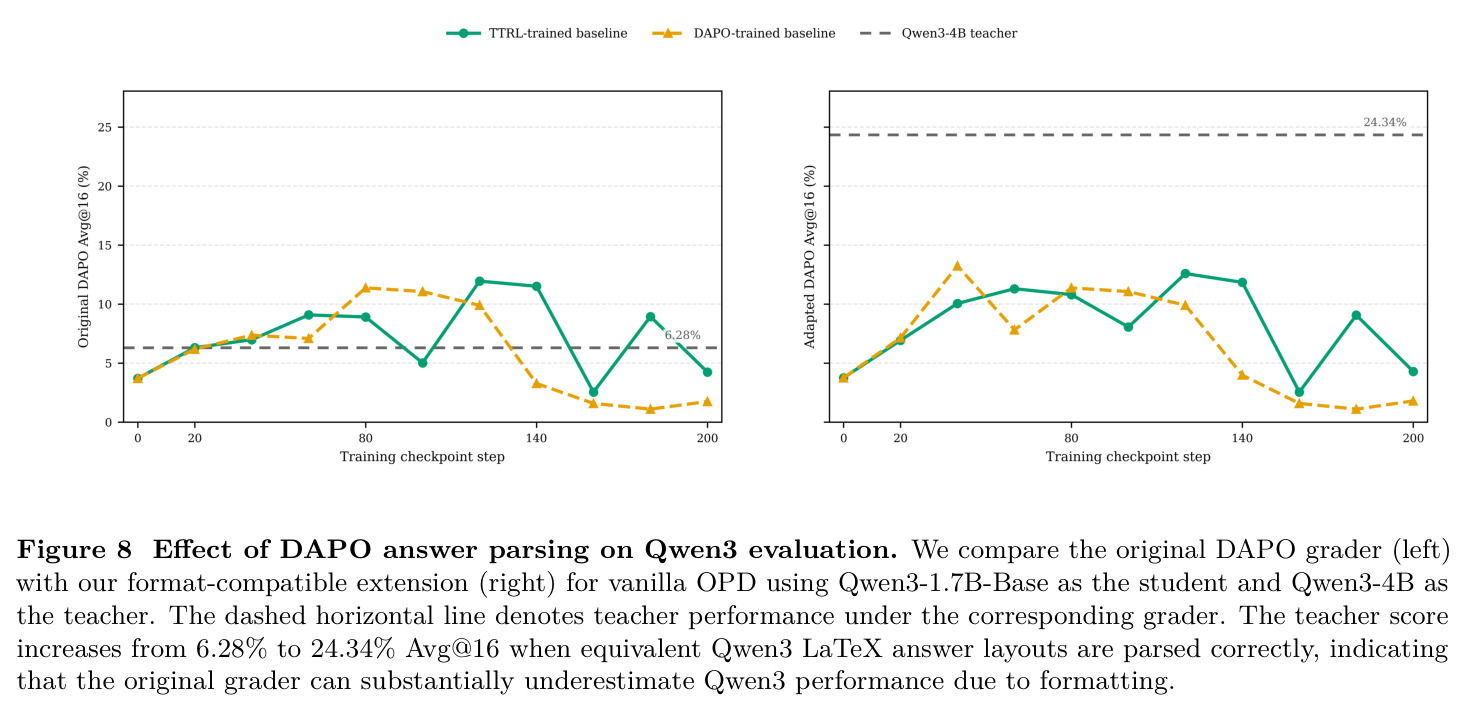
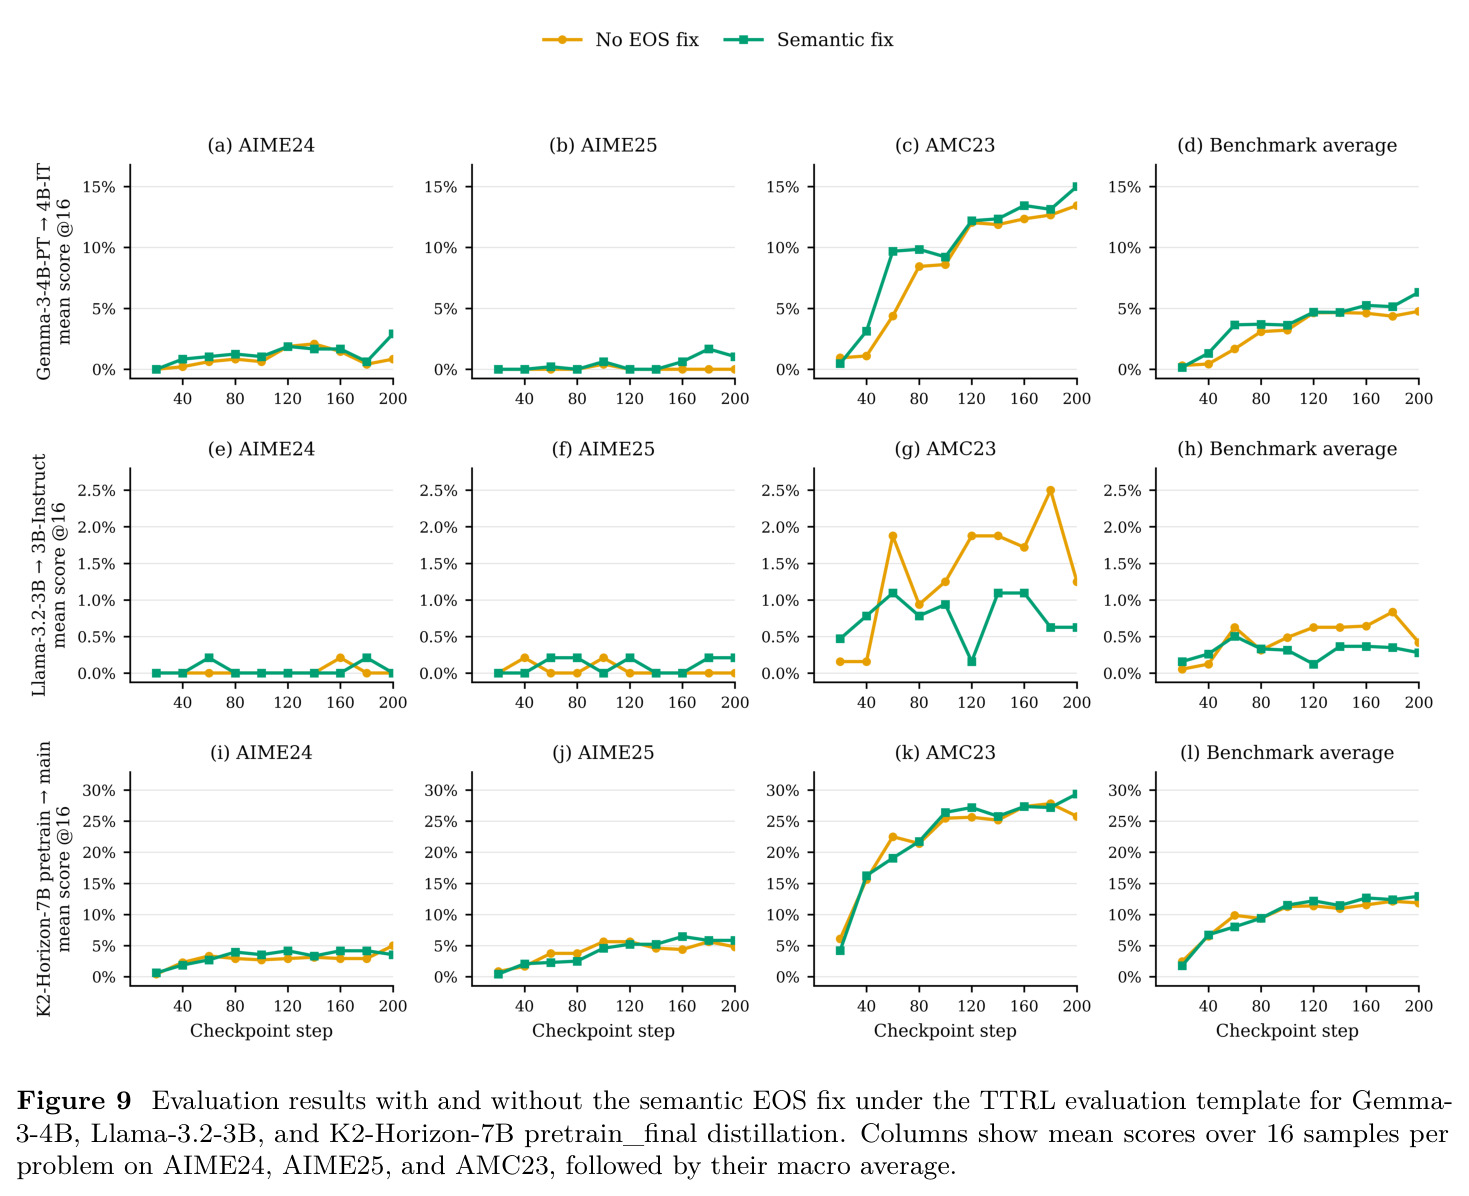
逐个实验看。(1) Qwen3 消融(Figure 4a):vanilla OPD 长度与截断率持续上升直至大量 rollout 打满 7,168 预算,学生原生 EOS 概率从约 0.8 跌到近 0;Fix 1 与 vanilla 几乎重合,证明解码对齐无效;Fix 2/3/4 都把长度与截断率拉回教师参考线附近,三者经验相似。(2) 跨家族(Figure 3/4b/6):语义修正在三个家族都显著降低长度与截断率;Gemma 3 声明集合相同仍膨胀(学生 vs 教师 );Llama 修正后仍留较大残余差距;Qwen3 快速恢复高终止概率,Llama/Gemma 在低终止区间停留更久,<|eom_id|> 师生概率全程 <0.02。(3) 下游精度(Figure 5/9/12):Avg@16 上语义修正带来温和、依赖模型的改变,Llama 两变体全程近 0 分——停止改善不必然转化为推理精度;训练模板诱导持久长度偏置(DAPO 训练更短),评测格式强烈影响测得精度(TTRL 评测普遍更高),长度与精度部分解耦。(4) 评测陷阱(Figure 8):原版 DAPO grader 因不识别 Qwen3 的 display-math 排版,把 Qwen3-4B 教师从 24.34% 压到 6.28% Avg@16,甚至造成学生『超过』教师的假象。(5) K2-Horizon 分阶段(Figure 7):pretrain 学生偏好 <|ifm|endoftext|>、教师偏好 <|ifm|im_end|>,但学生对教师偏好 token 概率并非可忽略,vanilla OPD 能完成表面迁移;随后经历 Phase 1 早期增长、Phase 2 高位平台、Phase 3 晚期再膨胀——终止概率重新趋零、几乎全部 rollout 打满预算,且语义修正后 Phase 3 依然出现;midtrain/SFT 对照显示错配小时修正惰性、无精度损害。
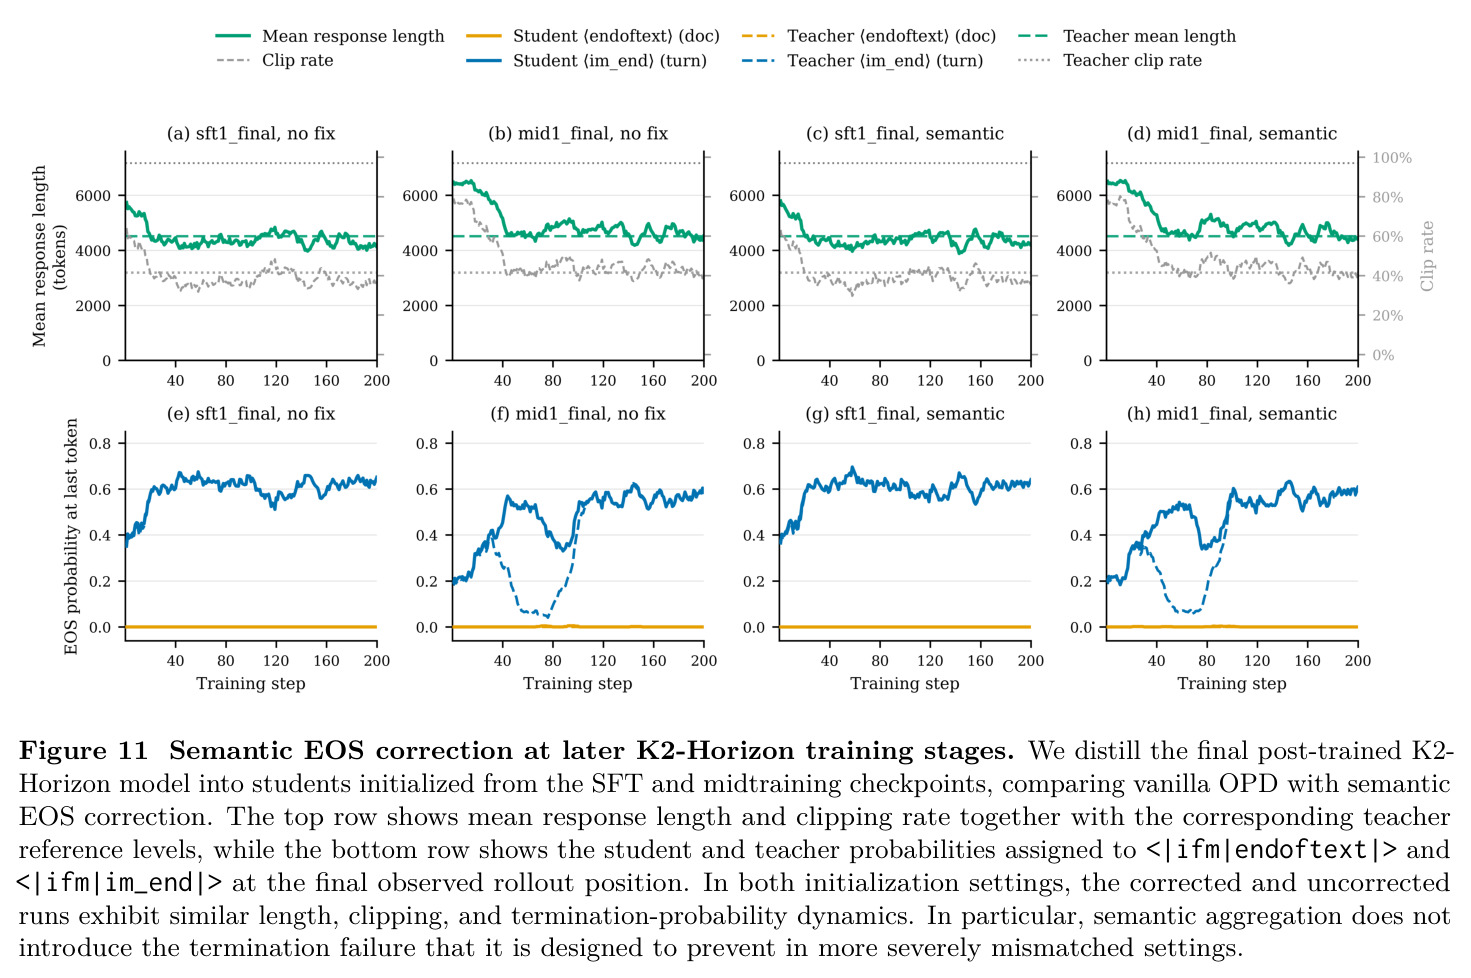
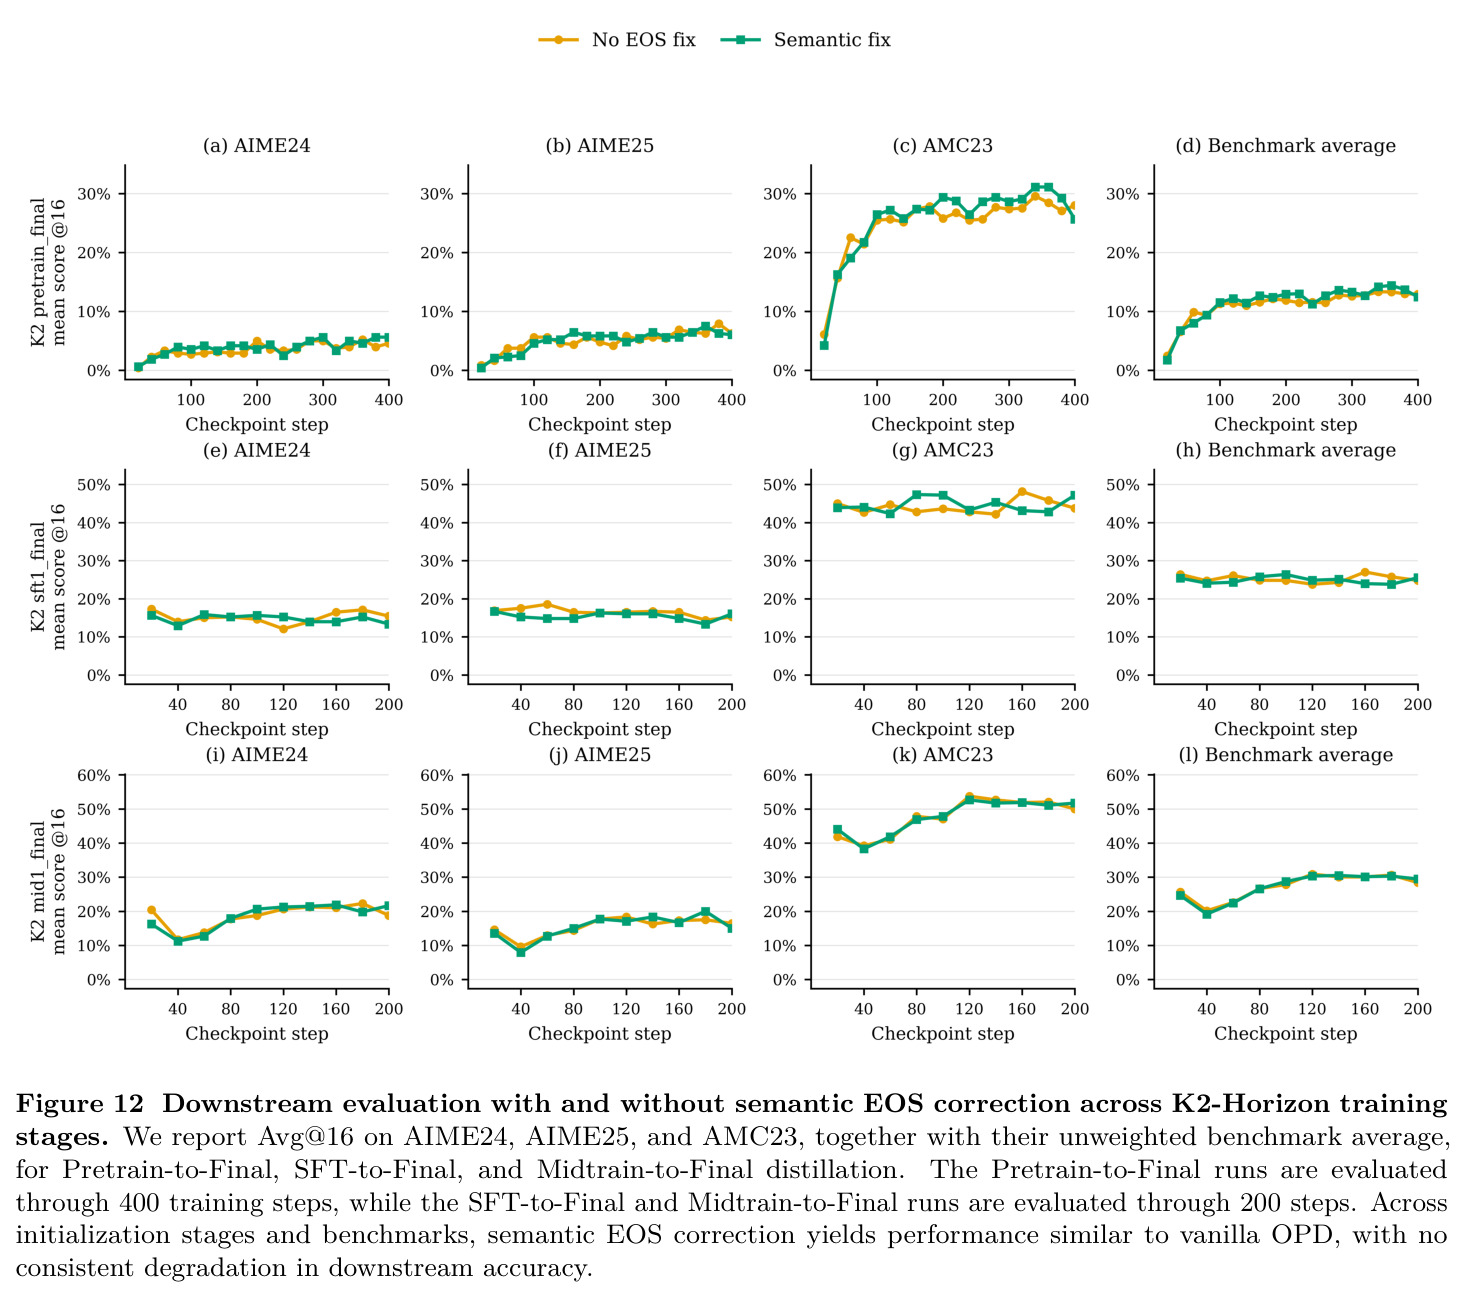
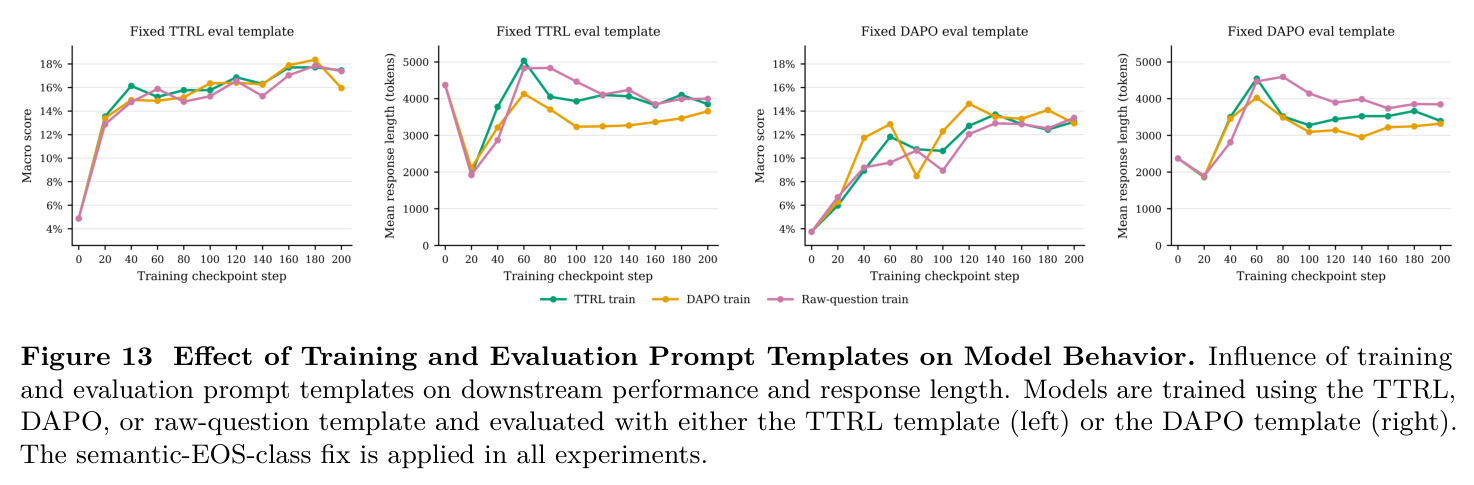
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Qwen3 OPD 训练期长度动态 | 平均响应长度 / 截断率 | Fix 2/3/4:长度与截断率贴近教师参考线,原生终止概率不坍缩 | vanilla OPD 与 Fix 1(共享集解码) | vanilla/Fix 1 长度与截断率持续上升至打满 7,168 预算、EOS 概率从约 0.8 崩到近 0;概率层修正将其恢复到教师水平 |
| Gemma-3-4B PT→IT 蒸馏(声明集合相同的错配) | 长度 / 截断率 / 终止概率 | 语义 EOS 修正恢复可靠终止,学生保留 <eos> 偏好而非被迫转向 <end_of_turn> | vanilla OPD(同集合内 <eos> vs <end_of_turn> 竞争,仍然膨胀) | 消除同声明集合内的表面偏好竞争,证明错配比配置差异更普遍 |
| Llama-3.2-3B Base→Instruct 蒸馏 | 长度 / 截断率 | 语义修正显著缓解膨胀,低终止区间持续更久、恢复更慢 | vanilla OPD(学生 <|end_of_text|> 被抑制,教师 <|eot_id|> 未获迁移;<|eom_id|> 全程 <0.02) | 膨胀大幅下降,但相对教师参考仍留有较大残余差距 |
| 下游数学推理(AIME24/AIME25/AMC23) | Avg@16(每题采样16次) | 语义修正带来温和、模型依赖的精度变化;K2 各阶段修正与 vanilla 基本持平 | vanilla OPD | 终止改善 ≠ 精度提升:Llama 两变体全程接近 0 分,长度与精度部分解耦 |
| Qwen3 评测协议校准(DAPO grader) | Avg@16(Qwen3-4B 教师) | 格式兼容解析扩展后 24.34% | 原版 DAPO grader 6.28% | +18.06 个百分点,纯属格式误判修正,排除学生『超过』教师的假象 |
局限与改进
作者明确承认三点。其一,终止错配是长度膨胀的重要来源但非穷尽解释:K2-Horizon Pretrain-to-Final 在教师偏好 token 已被学会、语义修正也已生效之后,仍出现晚期终止概率坍缩与长度再膨胀(Phase 3),机制未知。其二,结论限于单轮数学推理:多轮/agent 场景中不同特殊 token 有不同语义(消息结束 vs 回合结束 vs 文档终止 vs 工具移交),把功能不同的终止事件混为一类可能改变交互控制流,且 base→post-trained 配对无法直接搬到 agent(base 模型没有工具调用能力)。其三,模板分析仅覆盖 Qwen3 的三种模板与两种 grader,跨家族泛化未验证。我的补充观察:下游精度证据较弱——Llama 3.2 两个变体全程近 0 分,说明『修好了停止』并未转化为『修好了推理』的证据;所有主实验都是同家族内蒸馏(共享 tokenizer 与词表),跨家族异构蒸馏下错配形态与修法是否成立是开放的;在教师自身终止总质量就很低的前缀上语义修正无能为力,它与附录C的局部偏差机制如何定量叠加也未刻画。
独立分析的弱点
弱点一:语义等价类 $E_{EOS}$ 依赖人工先验。类成员目前由人工从配置文件与观察确定,若模型还用其他方式事实终止(先输出分隔符再 EOS、特殊停止字符串),类成员不全则修正不彻底,换新家族就要重查。改进方向:自动发现等价类——统计师生在自然终止点的 top-k token 分布并聚类,或学习最小化师生终止分布 KL 的分组。弱点二:修正只对齐『用哪个词停』,不对齐『何时停』。附录C已证明局部 OPD 缺少 $p_\theta(s)C_\theta(s)\ge0$ 的停止压力,可解释早期长度漂移甚至疑似晚期再膨胀,但论文未给出对应算法。改进方向:设计带后继 KL 修正的 OPD 目标(如用 rollout 内自举估计 $V_\theta$)并消融。弱点三:实验规模与任务域窄。学生最大 3B(K2 7B 除外)、单轮数学、200~400 步;代码生成等任务中重复病理与终止的关系可能不同。改进方向:在代码/SWE 任务和更大规模学生上重复诊断流程。弱点四:下游指标说服力不足。Llama 全程近 0 分意味着长度结论部分建立在『学不动』的配对上,宜补充能力更匹配的师生对或更易任务,让终止修复的收益在精度上显现。
未来方向
作者提出的方向:(1) 解释 K2-Horizon 的晚期再膨胀(Phase 3)——终止概率在表面形式已迁移、语义已对齐后二次坍缩,可能与附录C的局部停止压力缺失、教师在前缀上本身低终止概率有关;(2) 把终止类扩展到多轮与 agent 场景,构造上下文相关的终止类,区分消息结束/回合结束/文档终止/工具移交等语义不同的事件;(3) 跨模型家族、任务域、评测协议的系统化模板效应研究。基于本文成果可自然延伸的:(4) 把『先查 EOS 再怪算法』固化为 OPD 训练的默认诊断清单和库级默认值(任何 base→post-trained 蒸馏自动检测终止偏好错配);(5) 学习式等价类发现与终止偏好的自动监控告警;(6) 对偶地研究 RLVR 中的终止问题——格式奖励可能诱导模型学会『为奖励而停』,OPD 与 RLVR 的终止对齐经验可互哺;(7) 刻画教师『应停而未停』的前缀分布,用教师侧终止质量的预测模型构造更聪明的蒸馏信号或 rollout 提前终止策略。
复现评估
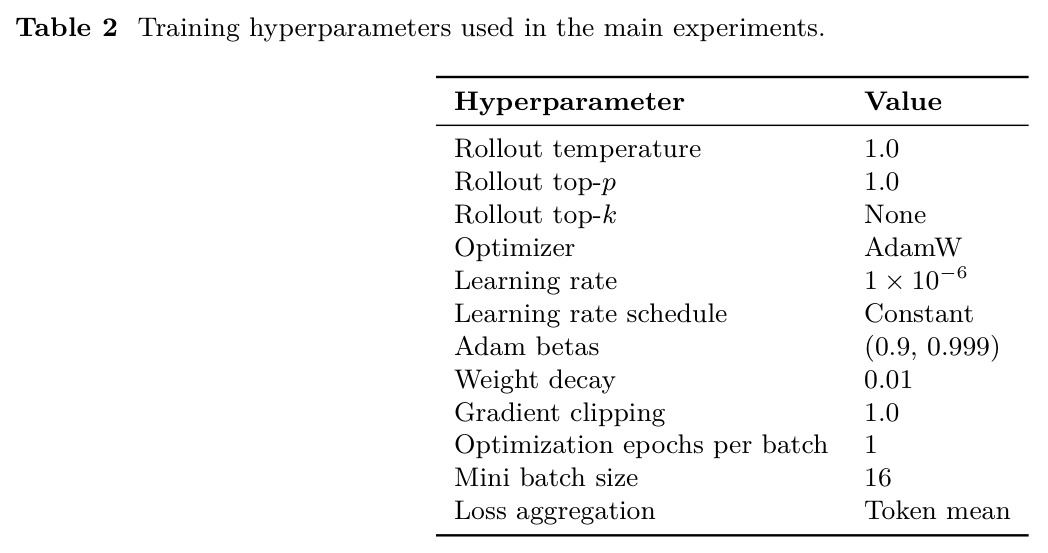
复现条件相当好。实现基于公开 OPD 代码库(Li et al., 2026)改造,作者承诺发布代码与全部实验配置,项目页为 uncsciml.github.io/opd-eos-website。所有模型公开:Qwen3-1.7B-Base/Qwen3-4B、Llama-3.2-3B Base/Instruct、Gemma-3-4B PT/IT、K2-Horizon-7B 各阶段 checkpoint(需向 IFM 获取 revision);数据为公开的 DAPO-Math-17K。算力标注为 4 张 96GB 的 NVIDIA RTX PRO 6000,每步 16 prompt × 4 rollout、训 200 步(K2 Pretrain-to-Final 400 步),属中小规模,学术实验室可负担。超参与采样配置完整(Table 2/3:rollout 温度 1.0、AdamW、恒定学习率 $1\times10^{-6}$;评测每题 16 样本、温度 0.7、top-p 0.95、固定 seed 0)。主要门槛在实现细节:终止概率测量脚本、语义聚合的数值稳定性处理、格式兼容 grader 的复刻;AIME/AMC 题量小(30+30+40),单 seed 的 Avg@16 仍有噪声,复现建议多 seed。总体:中等难度,熟悉训练框架的工程师约 2-4 周可复现主结论。
论文图表
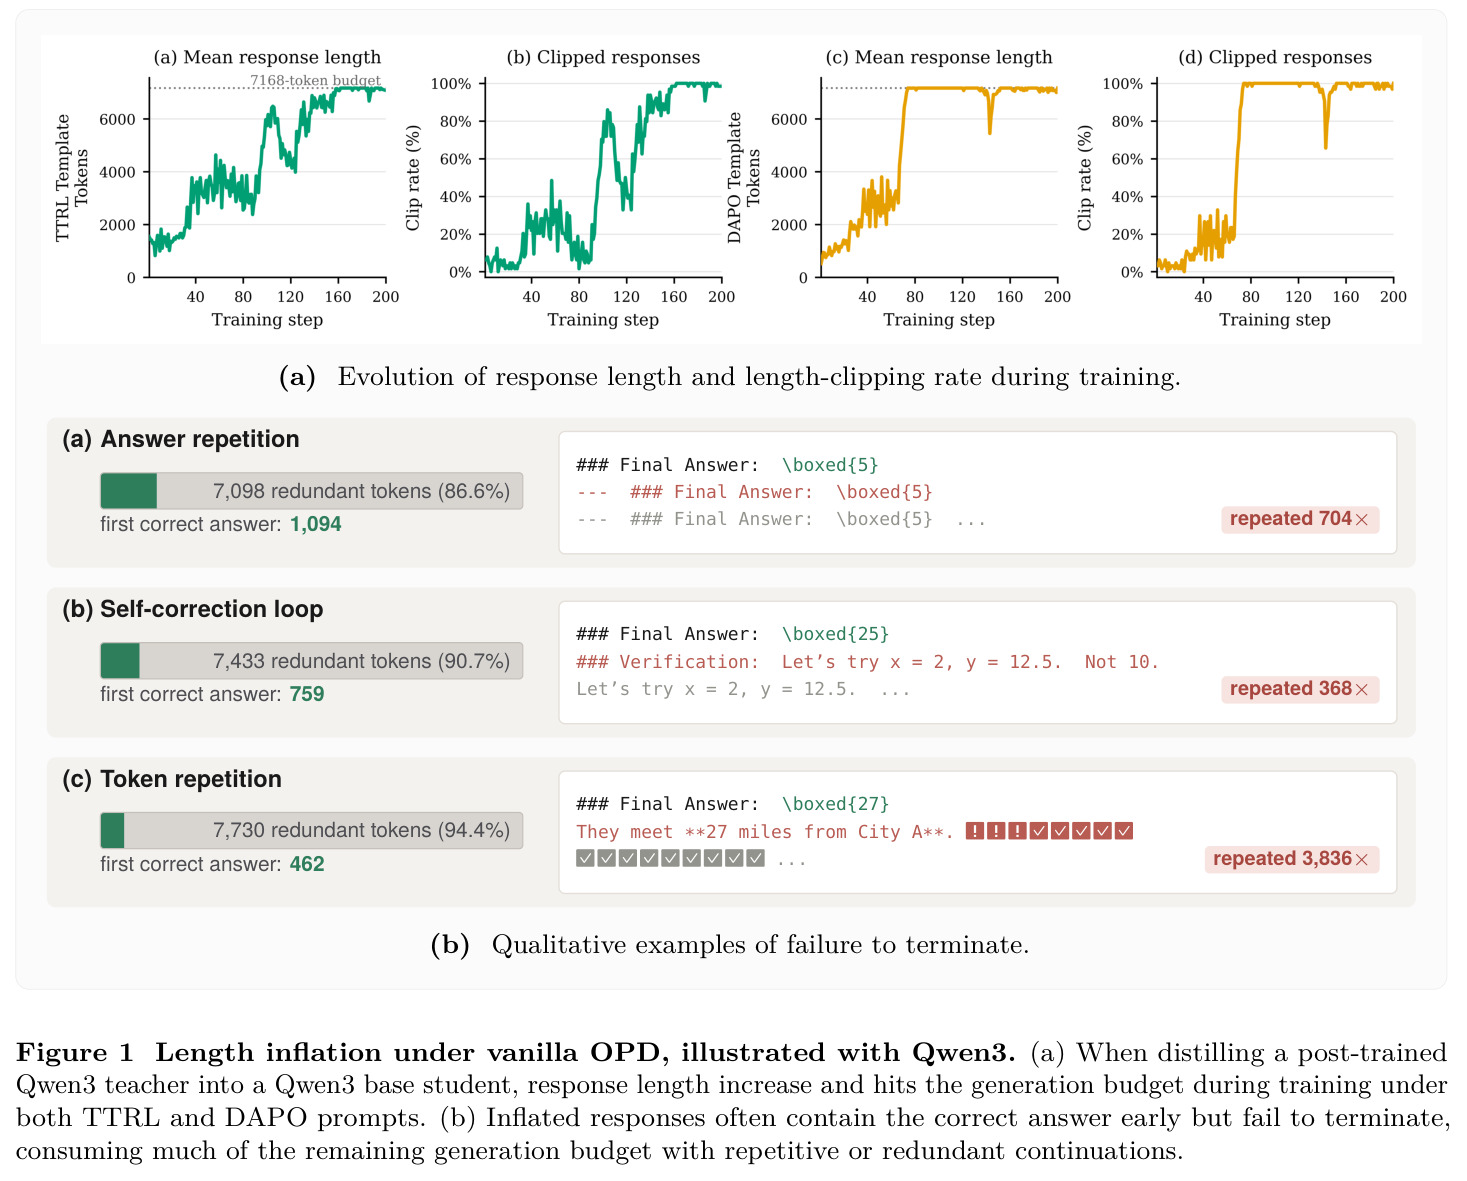
(a) 展示把 post-trained Qwen3-4B 教师蒸馏进 Qwen3-1.7B-Base 学生时,TTRL 与 DAPO 两种 prompt 下平均响应长度和截断率随训练持续上升并撞上生成长度预算;(b) 给出三个失败终止的定性案例:AMC23 第10题在第 1,094 token 就得到正确答案 \boxed{5},随后 7,098 个冗余 token(86.6%),答案块重复 704 次;AIME24 第7题 759 token 后正确、冗余 7,433(90.7%)、自证循环重复约 368 次;AMC23 第0题 462 token 后正确、冗余 7,730(94.4%)、同一符号重复 3,836 次。
这是全文的问题定义图:既用训练曲线量化长度膨胀,又用真实 rollout 证明膨胀的本质是『答案早就对了但不会停』,把读者直接带到终止失败这一核心线索上。