WUSH-KV:基于数据自适应变换的KV缓存量化 WUSH-KV: KV Cache Quantization with Data-Adaptive Transforms
用二阶统计为键值各造一个可逆变换,把2-bit KV缓存质量拉回接近全精度
前置知识
KV 缓存(KV Cache)
自回归生成时,注意力层把每个历史 token 的键向量 K 和值向量 V 缓存下来,避免每生成一个新 token 就重算全部历史投影。缓存大小随序列长度 $S$ 和批大小线性增长,约为 $2n_{layer}n_{kv}dS$ 个元素,且每步解码都要被反复读取,是长上下文推理的显存与带宽瓶颈。
本文的全部目标就是压缩这个缓存:量化对象、键变换的放置位置(RoPE 前后)、全精度窗口等所有设计都围绕缓存的结构与读写方式展开。
分组查询注意力(GQA)
让 $n_q$ 个查询头共享 $n_{kv}$ 个键/值头的注意力结构,每个键/值头被 $n_q/n_{kv}$ 个查询头读取,查询头记作 $(h,g)$(键/值头 $h$ 加组内位置 $g$)。它以极小的质量损失减少缓存体积,是 Qwen3 等主流模型的标准配置。
WUSH-KV 按键/值头各构造一个 $d\times d$ 变换,键的 Hessian 取'读取该头缓存键的组内查询'的外积和,理解 GQA 的头-组结构才能读懂 Eq. (4) 的构造。
RoPE 旋转位置编码
用与位置 $s$ 有关的正交旋转矩阵 $R_s$ 旋转每个键/查询向量,把相对位置信息注入注意力分数。模型在 RoPE 之后缓存键($k_{h,s}$ 已含位置旋转),读取时无需再做任何归一化或旋转。
键变换的放置是本文关键设计论证:折入权重需与 RoPE 和学习式 Norm 交换(只剩无用的符号翻转),放 RoPE 之前则补偿随位置变化,因此最终选择在 RoPE 之后在线施加键变换。
变换量化与 Hadamard 变换
量化前对向量做可逆变换 $TX$、量化后用 $T^{-1}$ 还原,把少数大离群值摊到各坐标、提高量化网格利用率。Hadamard 是最常用的固定正交变换,vLLM 等系统的 TurboQuant 风格实现即采用归一化 Hadamard, QuaRot/SpinQuant 等也属于这一路线。
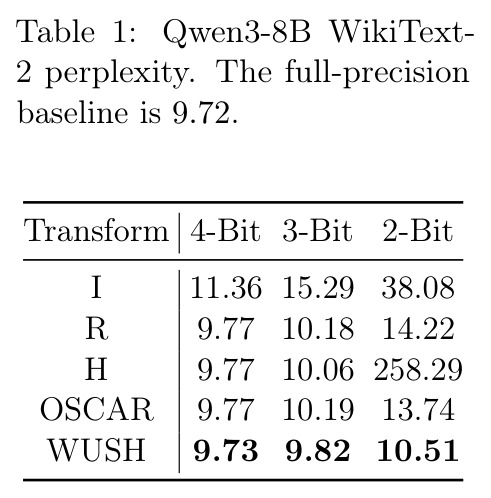
Hadamard/随机正交是本文主要基线,理解'换基改变量化难度'这一机制,才能体会数据自适应变换为何在 2-bit 下大幅领先(困惑度 10.51 对 258.29)。
Gram 矩阵与 Hessian(二阶统计)
Gram 矩阵 $M=XX^\top$ 描述被量化张量各坐标的二阶相关与幅度分布;Hessian $H$ 是损失对扰动 $\varepsilon$ 的二次型 $\ell=\tfrac12\mathrm{tr}(\varepsilon^\top H\varepsilon)$ 的曲率矩阵,刻画哪些坐标方向的误差对层输出伤害更大。
WUSH 变换正是由这两个矩阵闭式合成:$M$ 负责'压平分布',$H$ 负责'保护敏感坐标',读懂二者才能理解 $T=cH\Lambda^{-1/4}U^\top L^\top$ 的含义。
量化组与裁剪量化器
per-token 量化把一个头缓存的 $d$ 个通道作为一组共享 scale;裁剪量化器把超出范围的极端值截断到 $\pm\alpha_b$ 倍 RMS 内再用 $2^b$ 个均匀电平重建。文中用到 QuEST 的 RMS 定步长对称量化器和 OSCAR 的 $\kappa$-分位裁剪非对称仿射量化器(带零点 $z$)。
理论分析(Theorem 2)依赖 QuEST 裁剪半径 $\alpha_b$,而端到端实验用 OSCAR 式仿射量化器与分位超参 $\kappa$,两者都是读懂实验设置的前提。
研究动机
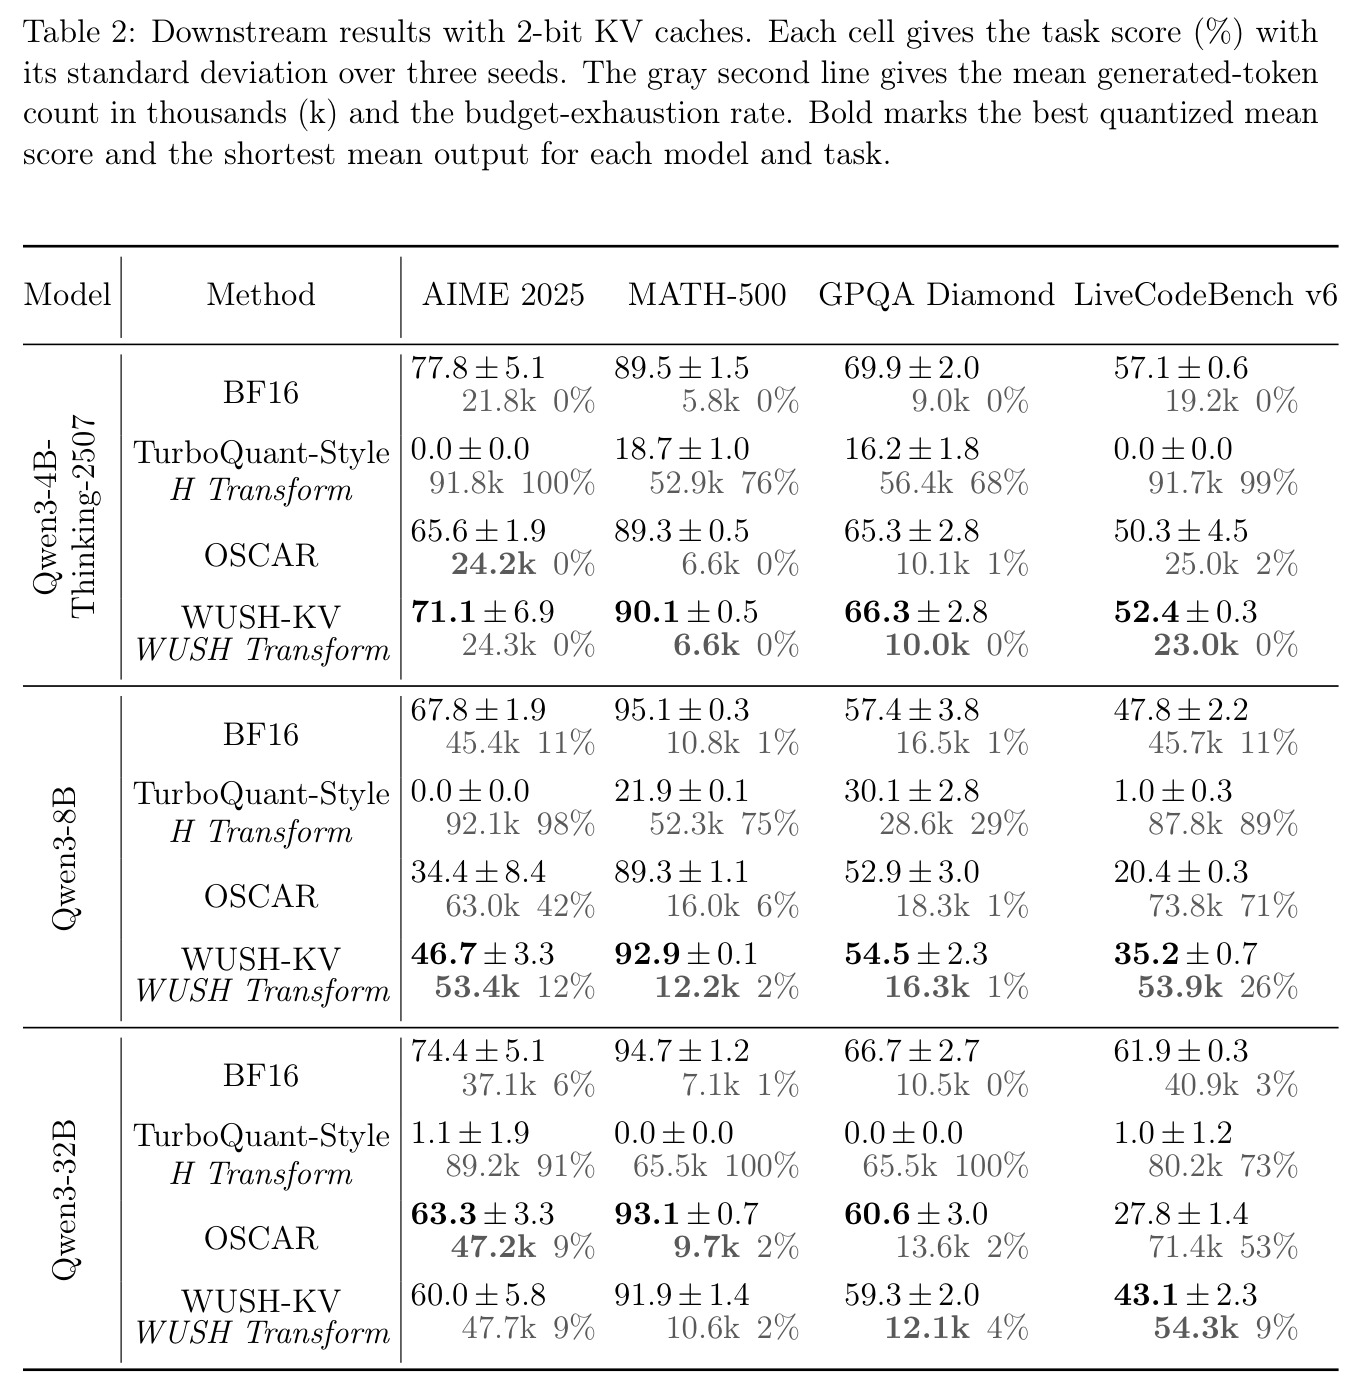
大模型推理时,注意力层必须缓存此前所有 token 的键(K)与值(V),KV 缓存的显存与带宽开销随上下文长度和批大小线性增长,且每步解码都被反复读取,成为长上下文推理的主要瓶颈。低比特量化是直接手段:把 KV 从 BF16 压到 2-bit 名义上可省 8 倍存储,但激进量化会把大量误差注入注意力分数和输出。现有变换多为数据无关的固定旋转(随机正交、Hadamard),不反映真实缓存分布:在 Qwen3-8B 上,Hadamard 变换 + 2-bit 的 WikiText-2 困惑度恶化到 258.29(全精度基线 9.72),原因是第一个注意力模块的键向量尖峰集中在单一坐标,Hadamard 恰好把它摊平到相邻两个 2-bit 重建电平的中点附近,产生密集误差;下游任务中 TurboQuant 风格 H 变换在 AIME 2025 得 0 分、约 98% 样本耗尽生成预算。并发的 OSCAR 虽利用离线注意力感知协方差构造键值变换,但被限制为正交矩阵,无法对各坐标做各向异性缩放来同时平衡缓存统计与下游敏感性。
本文的目标是本文目标是把量化误差理解为'矩阵乘积中的误差',为每个注意力头的缓存键和值分别构造数据自适应的可逆变换,使 2-bit KV 缓存的端到端质量尽量接近全精度。具体包括:(1) 用校准数据一次性估计每个 KV 头的 Gram 矩阵与下游敏感性 Hessian,以闭式解构造变换 $T_K$、$T_V$;(2) 给出理论保证——在 QuEST 量化器与温和假设下,理想 WUSH 变换在所有'敏感性均衡'可逆变换中近优;(3) 工程上把值变换折入模型权重(零在线开销),键变换放在 RoPE 之后并同步补偿查询,配合全精度 sink/近期窗口与批量冲刷;(4) 集成进 SGLang,用 OSCAR 风格百分位裁剪仿射量化器在 2-bit 下与 OSCAR 直接对比,覆盖 WikiText-2 困惑度与 AIME 2025、MATH-500、GPQA Diamond、LiveCodeBench v6 等下游基准,以及 RULER/MRCR 长上下文评测。
与已有工作不同的是,独特切入是把 WUSH(Chen et al., 2026)'乘积感知'的权重-激活联合量化思想迁移到 KV 缓存:缓存键只通过 $K_h^\top Q_{h,g}$ 被读取、缓存值只通过 $W_O^{(h,g)}V_h$ 被读取,量化误差只有通过这些乘积才造成损失,所以好的变换不能只看被量化张量自身的分布,还必须看它的'配对因子'。由此形成与已有工作的清晰区隔:KIVI/KVQuant/AQUA-KV 在量化器设计、离群值处理与跨层预测上做文章;QuaRot/SpinQuant/FlatQuant/RotateKV/TurboQuant 依赖 Hadamard、学习正交或 Kronecker 等受限结构;并发的 OSCAR 数据感知但限制为正交变换。WUSH-KV 允许一般可逆变换,借各向异性重缩放同时平衡两侧统计量,给出 Cholesky+特征分解的闭式解,并证明其在敏感性均衡变换类中的近优性。
核心方法
直觉上,在乘积 $K_h^\top Q_{h,g}$ 与 $W_O V_h$ 的两因子之间插入互逆可逆矩阵不改变结果,因此可以自由换基后再量化,而'好基'应由乘积两侧的二阶统计共同决定。技术路线分四步:(1) 离线校准:对每个 KV 头积累被量化张量的 Gram 矩阵 $K_hK_h^\top$、$V_hV_h^\top$,以及局部代理 Hessian——键用组内查询外积和 $H_K^{(h)}=2\sum_g Q_{h,g}Q_{h,g}^\top$,值用输出投影块外积和 $H_V^{(h)}=2\sum_g W_O^{(h,g)}W_O^{(h,g)\top}$;(2) 用 WUSH 闭式构造 $T=cH\Lambda^{-1/4}U^\top L^\top$(阻尼 $\gamma=10^{-2}$),一次校准跨比特复用,Qwen3-8B 在单张 L40S 上约 12 分钟、峰值 39 GiB;(3) 值变换折入权重 $W_V^c$、$W_O^c$ 零在线开销,键变换在 RoPE 后逐 token 施加并同步变换查询;(4) per-token 分组配 QuEST 或 OSCAR 风格裁剪量化器,用 $S_{sink}=64$、$S_{keep}=256$ 的全精度窗口保护 sink 与近期 token。
核心创新是'双因子二阶统计'驱动的变换构造。层输出损失可写成扰动的二次型 $\ell=\tfrac12\mathrm{tr}(\mathcal{E}^\top H\mathcal{E})$,$H$ 是损失对被量化张量扰动的 Hessian;WUSH 用 Gram 矩阵 $M$(缓存自身分布)与 $H$(下游敏感性)闭式合成 $T$,使量化后坐标既不偏向异常值方向也不偏向高敏感方向。这与数据无关的 Hadamard 有本质区别,也与 OSCAR 的正交约束不同:一般可逆变换允许各向异性缩放,能同时'压平'缓存分布并'抬升'低敏感坐标、相对放大高敏感坐标的网格精度,这是正交矩阵做不到的。理论上(Theorem 2),在加性舍入噪声、高斯尾部与裁剪对齐假设下,对任意满足敏感性均衡($T^{-\top}HT^{-1}$ 对角元相等)的可逆 $T$,有 $\mathbb{E}[\ell(T_\star)]\le(1+O(\alpha_b^{-2}))\,\mathbb{E}[\ell(T)]$($b\to\infty$),即理想 WUSH 变换在该类中近优。
方法步骤详情
校准(Algorithm 1):输入 $W_Q,W_K,W_V,W_O$ 与校准序列;逐序列前向计算 RoPE+Norm 后的 $Q,K$ 与 $V$;对每个头累加 Gram 矩阵 $M_K=K_hK_h^\top$、$M_V=V_hV_h^\top$,并由查询(对键)与输出投影块(对值)计算 Eq. (4) 的 Hessian,跨序列求和以省内存;调用 Wush 构造 $T_K,T_V$ 并折叠值侧权重 $W_V^c=T_VW_V$、$W_O^c=W_OT_V^{-1}$;键侧因与 RoPE、学习式 Norm 不可交换必须在线保留。推理(Algorithm 2):新 chunk 先算 $Q',K',V'$,对每个新键和新查询施加 $T_K$;全精度追加进缓存后做混合精度分组查询注意力并用折叠权重投影;再按批量化——维护量化右边界 $S_{quant}$,对超出 $S_{sink}$ 与 $S_{keep}$ 窗口、按 $S_{flush}$ 对齐的区段逐组量化(困惑度用 $16/128/16$,下游用 $64/256/8$),每组用量化器原地替换缓存值:QuEST 取 $\Delta=2\alpha_b\|x\|/(\sqrt{d}(2^b-1))$,OSCAR 式取 $\kappa$-分位裁剪的仿射 scale 与零点。
技术新颖性
技术新颖性有四点。(1) 方法迁移:首个把 WUSH 的乘积感知闭式变换从权重-激活联合量化搬到 KV 缓存,并给出缓存特有的配对因子选择——键配查询、值配输出投影,全程无需反向传播,WUSH-A 的注意力感知 Hessian 也只需前向量。(2) 放置分析:系统证明把键变换折入权重需同时与 RoPE 和学习式 Norm 交换、只剩无用的符号翻转,放 RoPE 之前补偿随位置变化、需跨缓存旋转,因此选择 RoPE 后在线施加,是对'折叠 vs 在线'的完整权衡论证。(3) 表达能力:相对 OSCAR 的正交限制,一般可逆变换带来各向异性缩放自由度,实验上体现为 2-bit 困惑度 10.51 对 13.74。(4) 理论:给出针对 QuEST 量化器、裁剪感知的敏感性均衡类近优性证明($O(\alpha_b^{-2})$ 空隙),把旋转类启发式提升为有保证的构造;与 TurboQuant 的随机旋转不同,WUSH-KV 确定性且值侧可完全折叠。
实验结果
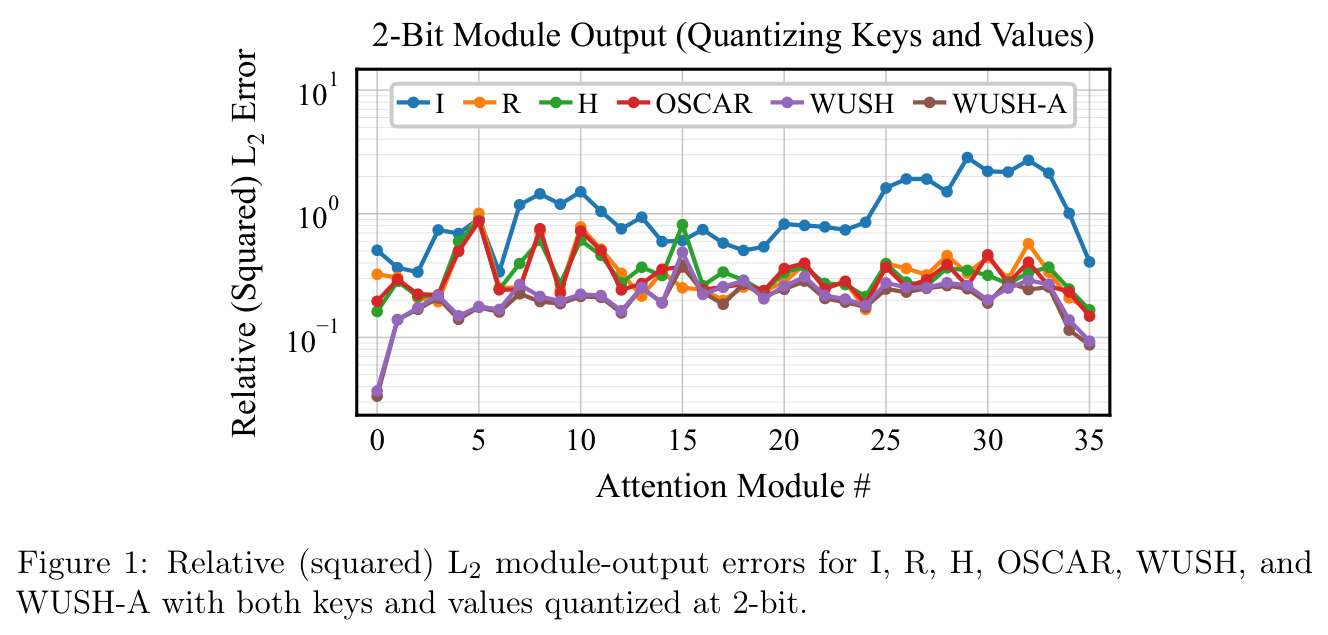
三个层面实验一致支持方法有效。(1) 受控重建(Qwen3-8B 全部 36 个注意力模块,2-bit 键值同量化,统一 QuEST 量化器隔离变换效应):模块输出相对平方 L2 误差几何均值,WUSH 0.208、WUSH-A 0.195,低于 H 的 0.325 与 OSCAR 的 0.309,最大改进在前几个注意力模块。(2) 困惑度(WikiText-2,基线 9.72):4/3/2-bit 下 WUSH 为 9.73/9.82/10.51,每个比特宽度最优;2-bit 时 OSCAR 13.74、随机正交 14.22、恒等 38.08,Hadamard 因首层键尖峰被摊到电平中点恶化至 258.29。(3) 下游(SGLang,OSCAR 式量化器,3 seeds):Qwen3-8B 四项全面超过 OSCAR——AIME 46.7 对 34.4、MATH-500 92.9 对 89.3、GPQA 54.5 对 52.9、LiveCodeBench v6 35.2 对 20.4(BF16 为 67.8/95.1/57.4/47.8);32B 在 LCB 上 43.1 对 27.8,4B 在 AIME 上 71.1 对 65.6。生成 token 最多约 BF16 的 1.5 倍,远小于 8 倍存储压缩比;长上下文 RULER NIAH 与 MRCR 上在最长测试长度处保持更高精度。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Qwen3-8B 注意力重建(键值同时 2-bit) | 模块输出相对平方 L2 误差几何均值(越低越好) | WUSH 0.208;WUSH-A 0.195 | Hadamard 0.325;OSCAR 0.309 | 相对 Hadamard 降低约 36%,相对 OSCAR 降低约 33% |
| Qwen3-8B 语言建模质量 | WikiText-2 困惑度(FP 基线 9.72,越低越好) | WUSH 2-bit 10.51(4/3-bit:9.73/9.82) | OSCAR 2-bit 13.74;Hadamard 2-bit 258.29 | 2-bit 下比 OSCAR 低 3.23,仅比全精度高 0.79 |
| Qwen3-8B 数学推理 | AIME 2025 准确率 %(2-bit KV,3 seeds) | 46.7 ± 3.3(BF16:67.8 ± 1.9) | OSCAR 34.4 ± 8.4;H 变换 0.0(预算耗尽 98%) | +12.3 个百分点 |
| Qwen3-8B 代码生成 | LiveCodeBench v6 准确率 %(2-bit KV) | 35.2 ± 0.7(BF16:47.8 ± 2.2) | OSCAR 20.4 ± 0.3 | +14.8 个百分点 |
| Qwen3-32B 代码生成 | LiveCodeBench v6 准确率 %(2-bit KV) | 43.1 ± 2.3(BF16:61.9 ± 0.3) | OSCAR 27.8 ± 1.4 | +15.3 个百分点 |
| Qwen3-4B-Thinking-2507 数学推理 | AIME 2025 准确率 %(2-bit KV) | 71.1 ± 6.9(BF16:77.8 ± 5.1) | OSCAR 65.6 ± 1.9 | +5.5 个百分点 |
| 生成效率(三模型四任务) | 平均生成 token 数相对 BF16 的倍数 | 最多约 1.5× | BF16→INT2 名义存储压缩 8× | 冗长化远小于 8× 存储节省,缓存净收益为正 |
局限与改进
作者承认的局限:键侧稠密 $d\times d$ 变换因在 RoPE 之后必须在线计算,每个新键和每个查询各需 $d^2$ 次乘加(每头),给推理增加固定开销;理论保证只覆盖 QuEST 对称量化器,而端到端最优的 OSCAR 式百分位裁剪仿射量化器不满足同样证明条件,理论与实践存在缺口;下游实验直接复用 OSCAR 的裁剪比例($\kappa_K=0.96$,$\kappa_V=0.92/0.96$)而未为 WUSH 变换后的分布调参,存在提升空间。我自己的观察:评测全部集中在 Qwen3 家族(4B/8B/32B)且 8B/32B 用 YaRN×4,跨架构(MHA、MLA 类注意力)的泛化未验证;全文未报告吞吐、延迟等系统级指标,在线键变换的实际性能代价不明;校准峰值 39 GiB 显存,更大模型或梯度版 Hessian(作者承认 backward 校准太贵而未做)时成本会上升;全精度窗口的收益占比依赖任务长度分布,超长上下文下 $S_{sink}+S_{keep}$ 的相对开销需要重新评估。
独立分析的弱点
独立分析几点弱点。其一,在线键变换是稠密 $d\times d$ 矩阵乘:RoPE 后施加意味着每个解码步对每个新键、每个查询都要做 $d^2$ 次乘加,大 batch 下这部分可能成为算术强度瓶颈,而论文未给内核实现与吞吐数据,工程收益存在不确定性;改进方向是寻找与 RoPE 近似可交换的结构化变换(块对角+置换),或把补偿吸收进 RoPE 查表。其二,理论-实践错位:近优性只对 QuEST 的加性均匀噪声模型成立,而实际更强的 OSCAR 式仿射量化器未被理论覆盖,2-bit 下变换与量化器各自的贡献只能靠附录 D.2 消融间接推断。其三,超参迁移:裁剪比例与窗口大小全部照搬 OSCAR,未做 WUSH 特异调优,文中也承认有 headroom,对比结论对超参选择敏感。其四,只测 Qwen3 稠密 GQA 模型;KIVI 发现的'键按通道、值按 token'结构差异与本文 per-token 分组之间的关系未讨论,对多模态或 MLA 架构的适配未知,迁移价值有待验证。
未来方向
作者提出的方向:更便宜的结构化变换以降低键侧在线成本;更强的注意力感知敏感性度量(WUSH-A 的注意力感知 Hessian 只把重建误差从 0.208 降到 0.195,经验 Fisher 或端到端任务损失可能是下一步);系统级优化与吞吐评测。基于成果可延伸的方向:(1) 把近优性证明推广到仿射/非对称量化器与含零点网格,弥补理论缺口;(2) 键变换与 RoPE 的联合设计——构造与特定旋转结构可交换的变换族,实现键侧完全折叠;(3) 与 KIVI 式 per-channel 键量化或 AQUA-KV 跨层预测组合,冲击 1.5-bit 以下;(4) 研究校准域外分布(代码、超长文档)下变换的稳健性与在线更新;(5) 验证与分页缓存、投机解码的兼容性,量化 2-bit KV 在大 batch 服务场景对吞吐与并发的真实收益。
复现评估
复现难度中等偏易。有利条件:方法是纯训练后量化,无需训练;校准只用公开的 FineWeb-Edu(128 条序列,困惑度实验长度 32,768),一次校准跨所有比特宽度复用;Algorithm 1/2 伪代码、变换公式(Eq. 1/4)、两个量化器定义(Eq. 5/7)与窗口超参($S_{sink}/S_{keep}/S_{flush}$、$\kappa$)都在正文完整给出;OSCAR 基线使用其公开发布的变换与 SGLang 集成,评测管线统一。算力门槛低:Qwen3-8B 校准在单张 L40S 上约 12 分钟、峰值 39 GiB;下游评测每任务 3 seeds、生成上限 65,536/92,160 token,总量不小但单机多卡可控。不确定项:提供的正文未明确声明开源代码仓库,WUSH 原始实现的可用性需另行查证;32B 端到端评测的 GPU 配置未说明;作者自述无法完全复现 OSCAR 原论文分数而改用同一 SGLang 流水线重跑,第三方复现时应同样统一评测管线以免混淆口径。
论文图表
离线校准伪代码:输入 $W_Q,W_K,W_V,W_O$ 与 $n_{cal}$ 条校准序列;逐条独立前向,计算 RoPE+Norm 后的 $Q,K$ 与 $V$;对每个头累加 Gram 矩阵 $M_V=V_hV_h^\top$、$M_K=K_hK_h^\top$;由查询与输出投影块(可选地结合 $K,V$)计算 Hessian $H_K,H_V$;跨序列求和后对每个头调用 Wush 得到 $T_K,T_V$,并折叠权重 $W_V^c$、$W_O^c$。逐序列求和的设计避免同时存储所有校准激活与投影。
校准是一次性离线成本的全部来源(Qwen3-8B 约 12 分钟、39 GiB 显存),这段伪代码是复现者实现统计积累、Hessian 构造与权重折叠的确切依据。
单注意力模块解码步伪代码:计算新 chunk 的 $Q',K',V'$;对每个查询与新键施加 $T_K$;以全精度追加进缓存($S\leftarrow S+S'$);用混合精度分组查询注意力计算输出并以折叠权重 $W_O^c$ 投影;随后维护量化右边界 $S_{quant}$:从 $\max(S_{quant},S_{sink})$ 出发,按 $S_{flush}$ 对齐地推进边界,对落界区段的键值逐头用量化器 $Q$ 原地替换。窗口尺寸 $S_{sink},S_{keep},S_{flush}$ 是显式输入。
它完整定义了在线阶段的数据流与窗口/批量冲刷逻辑(混合精度注意力、$S_{quant}$ 推进规则),是理解 SGLang 集成方式与全精度开销占比的基础。
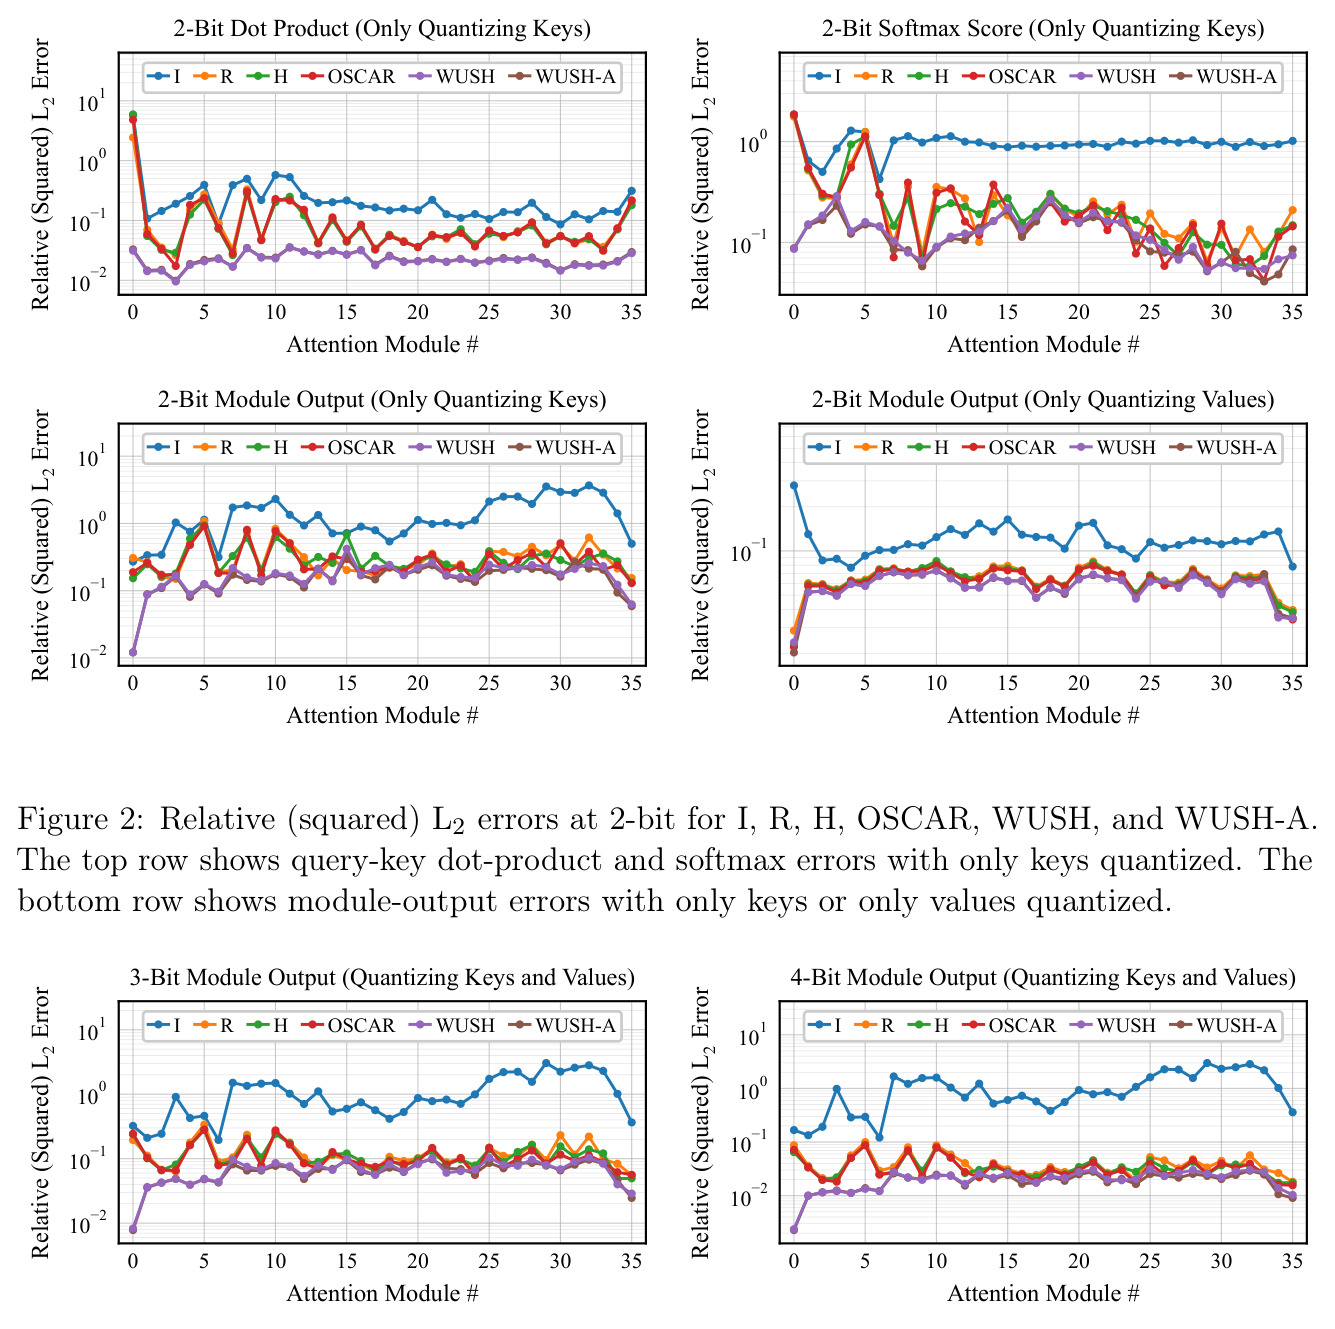
与 Figure 1 同设置(36 个注意力模块、QuEST 量化器、键值同量化)的 3-bit 和 4-bit 版本。随比特升高各方法误差整体下降,但 WUSH/WUSH-A 在大多数模块上仍保持最低误差,说明数据自适应变换的优势随压缩率放松而缩小但不消失,并非只在 2-bit 极端情形下偶然成立。
补全比特宽度维度的证据链,与 Table 1 的困惑度趋势互相印证:方法收益随压缩率单调放大,这对实际部署中选择比特宽度有直接参考价值。