QuantWM:面向视频世界模型的时间一致性2比特KV缓存量化 QuantWM: Temporally Consistent 2-Bit KV Cache Quantization for Video World Models
以保护注意力选址为目标的2比特KV量化,消除视频世界模型时间闪烁
前置知识
KV缓存 (KV Cache)
自回归Transformer逐步生成内容时,会把每层历史token的Key与Value矩阵缓存下来,避免每步重算全部历史注意力。视频世界模型每个chunk包含大量时空token,缓存随生成持续增长,例如LingBot-World-v2生成93帧约5秒视频需要超过21 GiB显存,成为部署瓶颈。
本文的全部动机就是压缩这个持续膨胀的KV缓存,量化、补偿与显存分析全部围绕KV缓存的存储与读取展开。
低比特KV缓存量化
把BF16的Key/Value用低比特整数近似存储:按组计算缩放因子 $s$ 与零点 $z$,量化 $X_q=\mathrm{clip}(X/s+z, q_{\min}, q_{\max})$,反量化 $\hat{X}=s(X_q-z)$。粒度可按token、通道或组共享参数;比特越低显存越小,但引入的重构误差越大。
QuantWM建立在2比特仿射量化与分组粒度之上,QSAC对残差量化误差的理论估计直接来自这套框架。
质心-残差量化
QVG提出的方案:用K-means把每个Key token $k_i$ 分配到质心 $\mu_{z_i}$,质心以BF16保存,残差 $r_i=k_i-\mu_{z_i}$ 用INT2量化,重构为 $\hat{k}_i=\mu_{z_i}+Q_b(r_i)$。质心吸收主体信息,残差动态范围小,适合极低比特。
QSAC改造的正是这一步的质心选择准则:从最近邻距离换成以注意力扰动最小为目标的评分。
注意力logits与时空token选择
注意力logits为 $L=QK^\top/\sqrt{d}$,softmax后按分数对历史token加权。Key被量化扰动后产生 $\Delta L=Q(K-\hat{K})^\top/\sqrt{d}$,可能改变logits排序,使Query选中的时空token(历史帧/空间位置)发生漂移,即token选择偏移。
论文核心发现:Key误差虽小但直接扰动 $QK^ op$ 并转移选中token,这是时间闪烁的根源,也是QSAC与PSAC共同的优化对象。
二阶Query统计与低秩分解
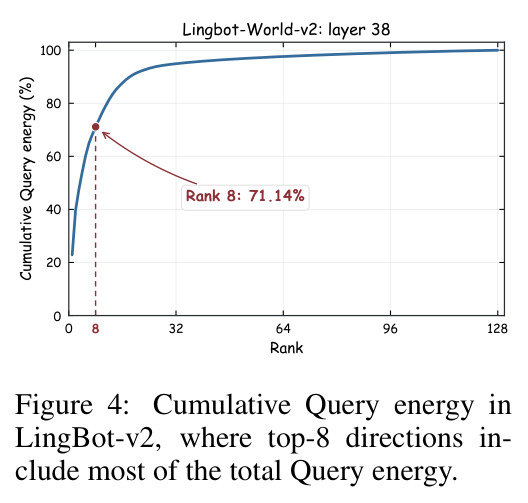
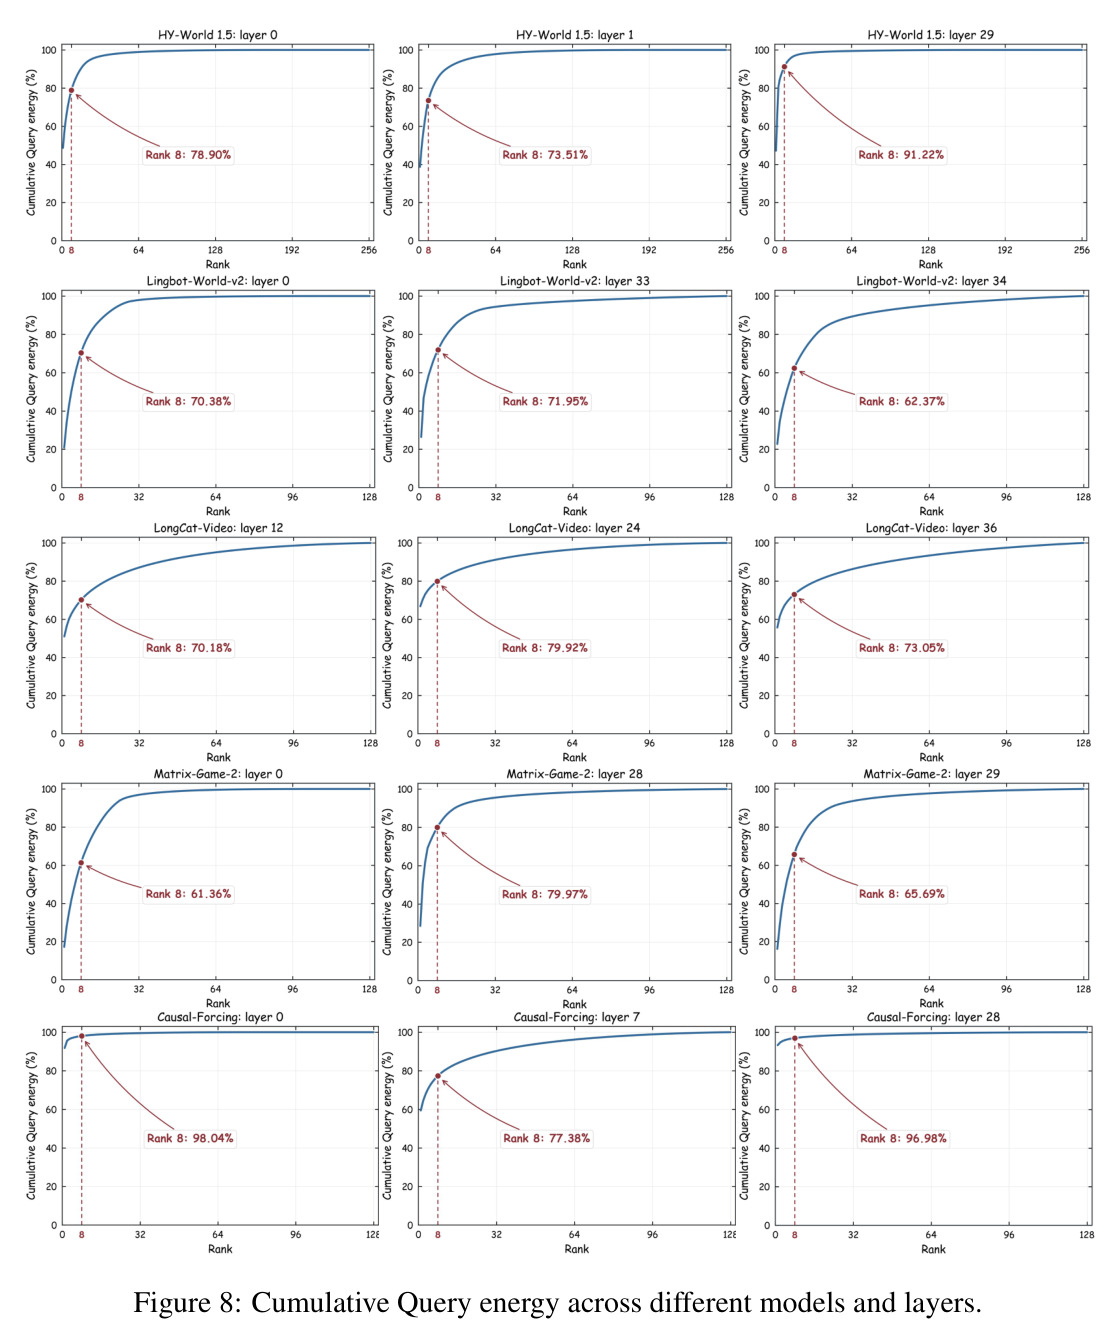
对历史Query做外积平均得到 $M_h=\frac{1}{N}\sum q q^\top$,Key量化误差 $e$ 的期望logit扰动为 $E_Q[(q^\top e)^2]=e^\top M_h e$。对 $M_h$ 特征分解 $M_h=U\Lambda U^\top$,前 $r$ 个特征向量张成Query能量的主子空间(LingBot-v2第38层top-8占71.14%),可用于低秩误差补偿。
它是QSAC通道加权与PSAC低秩补偿共同的数学基础,两个模块都依赖 $M_h$ 及其对角近似。
研究动机
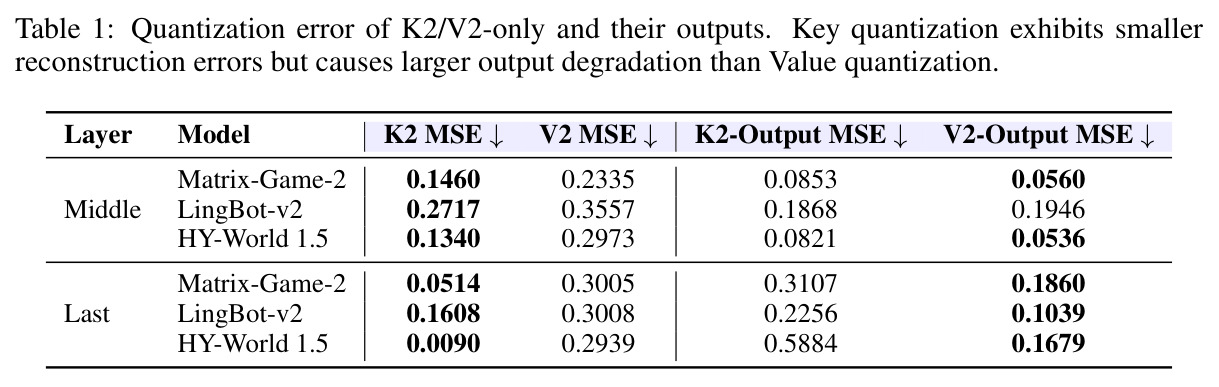
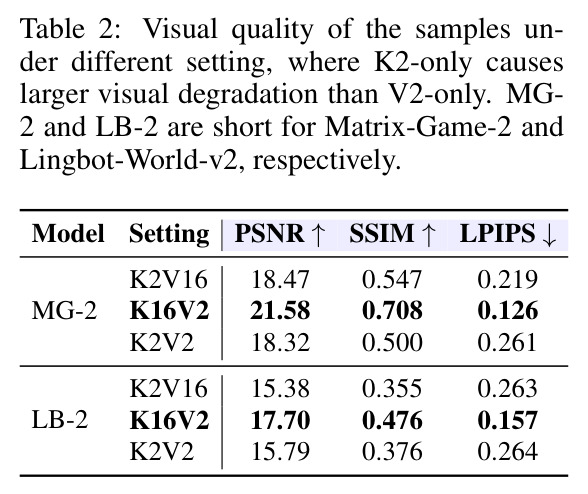
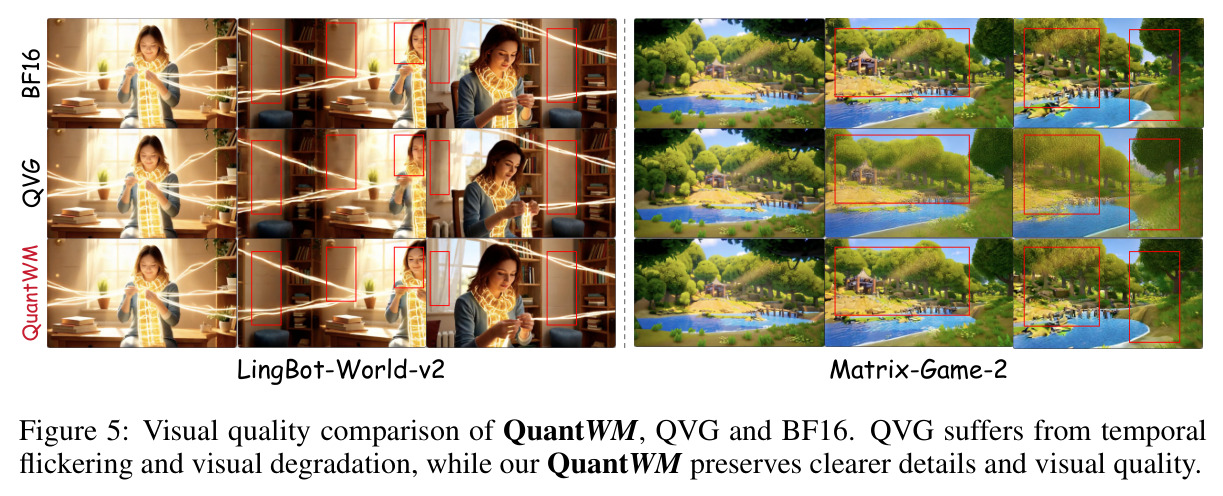
视频世界模型依靠KV缓存实现长程时间一致性与持续交互,但缓存随生成不断膨胀:LingBot-World-v2生成93帧(约5秒)视频需要超过21 GiB的KV显存。现有2比特KV量化方法(如QVG)在VBench上接近无损(Figure 1中BF16/QVG/QuantWM的时间闪烁分数为95.62%/95.85%/95.84%,几乎相同),但作者发现它们应用到视频世界模型时产生严重的时间闪烁、模糊和伪影,基准分数完全无法反映这些退化。进一步解剖发现Key主导退化:Table 2中Matrix-Game-2上K16V2的PSNR为21.58,而K2V16只有18.32–18.47;更反直觉的是Table 1显示Key的重构误差比Value更小(中间层K2 MSE 0.1460 < V2 0.2335),输出误差却更大(0.0853 > 0.0560),HY-World 1.5最后一层K2 MSE仅0.0090而输出MSE高达0.5884。这说明Key的敏感性无法用误差幅度解释。
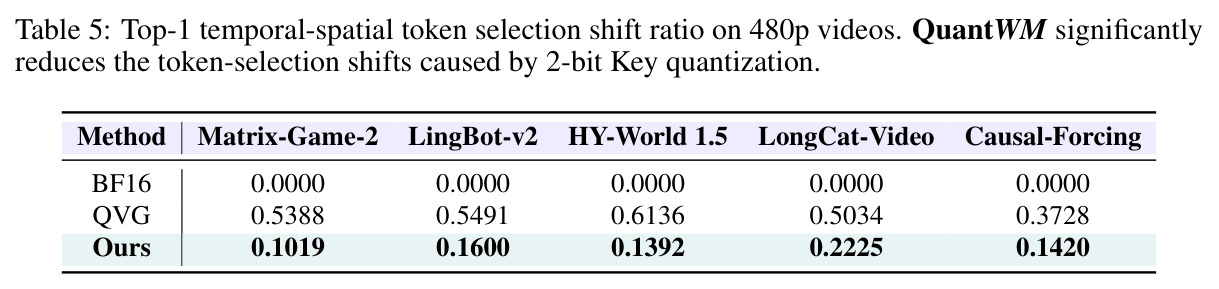
本文的目标是作者的目标是构建一个免训练(training-free)的2比特KV缓存量化框架,使量化后的视频世界模型保持与BF16一致的时间一致性和视觉质量。具体包括三点:一、把量化目标从'最小化重构误差'改为'最小化对注意力logits $QK^\top$ 与时空token选择的扰动',从根源上抑制时间闪烁;二、在实现最高6.20×KV缓存压缩的同时,把端到端延迟开销控制在很低水平(部分模型甚至能净提速);三、在LingBot-World-v2、HY-World 1.5、Matrix-Game-2三个交互世界模型与LongCat-Video、Causal-Forcing两个自回归视频生成模型上系统验证泛化性,并显著降低Query的top-1 token选择偏移率(从平均51.55%降到15.31%)。
与已有工作不同的是,以往LLM与视频生成的KV量化工作(KIVI、KVQuant、CommVQ、QVG等)都以重构误差或基准分数为优化信号,用K-means最近邻分配质心,忽略了量化误差与Query交互后对注意力分布的影响。本文的独特切入是解剖注意力计算本身:Key扰动直接进入 $\Delta L=Q(K-\hat{K})^\top/\sqrt{d}$,改变Query选中的时空token——Figure 3显示K2量化使LingBot-World-v2的top-1 patch从帧4位置(23,0)漂移到帧8位置(23,44),Matrix-Game-2从帧0跳到帧4,时间闪烁正是这种选帧漂移的宏观表现。作者据此提出以历史Query二阶统计加权的'注意力敏感度'作为质心选择与误差补偿的第一性准则,并利用Query能量的低秩结构(top-8方向占60%以上能量)实现廉价的在线logits补偿,这是与既有方法本质不同的视角。
核心方法
直觉上,Key量化误差之所以致命,不是因为它大,而是因为它打在注意力的'坐标系'上:$\Delta L=Q(K-\hat{K})^\top/\sqrt{d}$ 与历史Query的方向强相关,一旦改变logits排序,Query就会跳到错误的历史帧或空间区域。QuantWM因此把优化目标定为保护 $QK^\top$,在QVG的质心-残差2比特框架上叠加两个免训练模块。其一,QSAC(量化敏感度感知聚类)在量化前选择让注意力扰动最小的Key质心:用历史Query的通道敏感度 $w_{h,c}$ 加权Query距离筛出候选,再用各残差组的动态范围 $R_g$ 估计INT2量化误差,取综合得分 $S(k_i,\mu_j)$ 最小的质心。其二,PSAC(主子空间注意力补偿)在量化后对残余误差沿Query主子空间做低秩补偿:存一个INT8低秩修正项 $C=EU_r$,推理时把logits修正为 $Q\hat{K}_0^\top+QU_rC^\top$。整个流程按chunk流式推进,所有统计只来自已生成内容,满足严格因果性,无需校准数据或再训练。
核心创新是把量化误差的'好坏'重新定义为对注意力logits的期望扰动而非欧氏距离。给定Key误差 $e$,历史Query下的期望logit扰动是 $E_Q[(q^\top e)^2]=e^\top M_h e$,对角近似给出通道权重 $w_{h,c}$,即哪些通道的误差最伤注意力。QSAC据此改写质心选择:先用 $d_Q(k_i,\mu_j)=\sum_c w_{h,c}(k_{i,c}-\mu_{j,c})^2$ 选top-$M$候选,再估计各组残差的INT2误差 $E[e_c^2]\approx R_g^2/[12(2^b-1)^2]$,组合成得分 $S=\sum_g(\sum_{c\in G_g}w_{h,c})R_g^2$ 选质心——K-means最近邻只是它的无敏感度特例。PSAC更进一步:既然2比特无法消除全部误差,就对 $M_h$ 做特征分解,只把误差沿前 $r=8$ 个主方向(承载约60%–71%的Query能量)用低秩投影 $C=EU_r$ 精确保存,并在logits端直接加回,相当于在注意力层面做'误差回填'。两者一防一治,统计全部来自已生成chunk,免训练且严格因果。
方法步骤详情
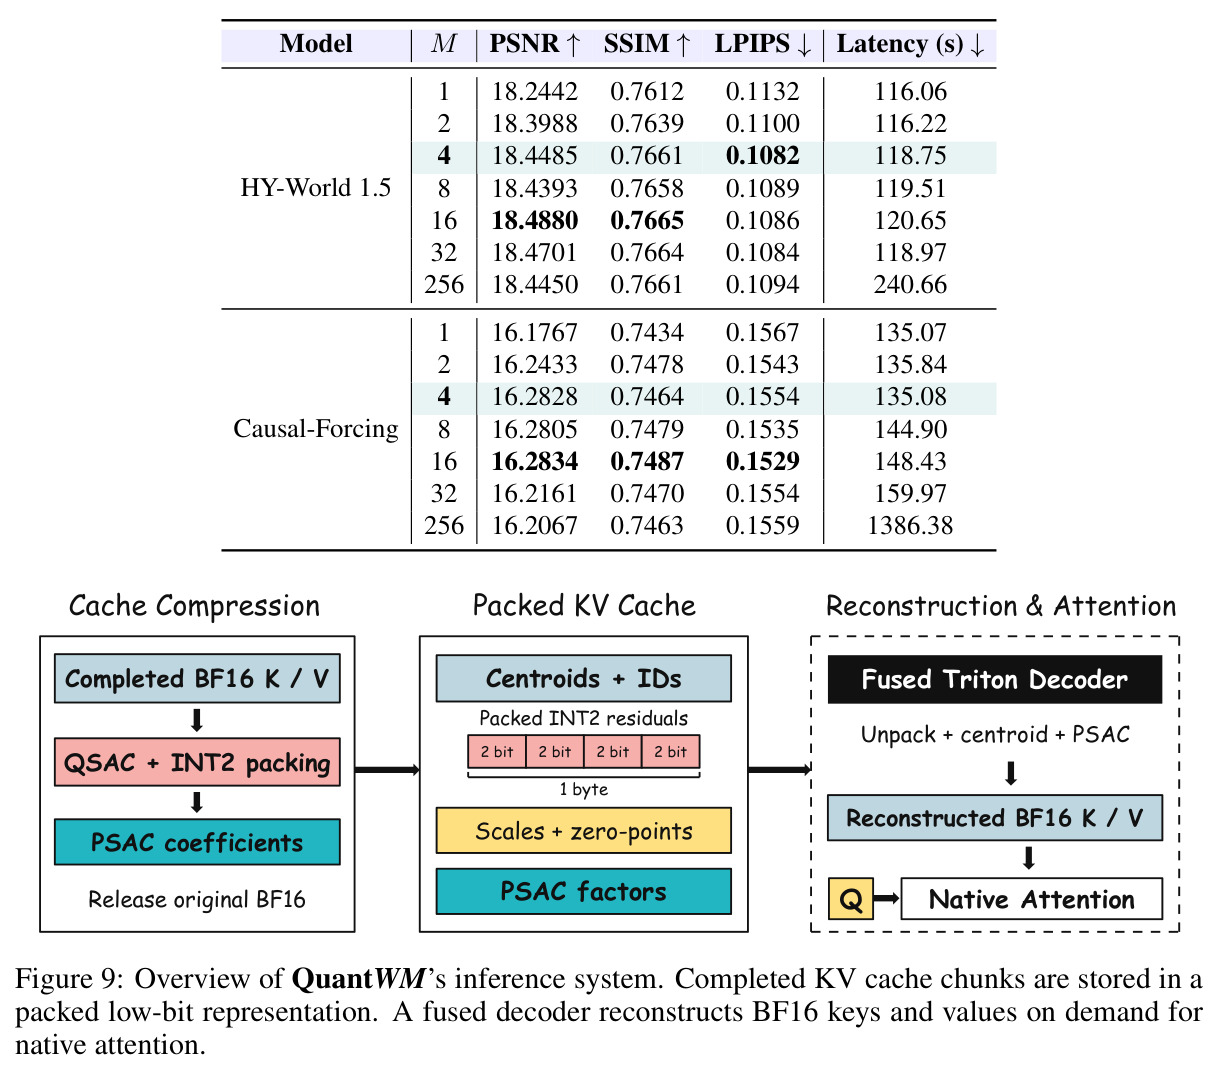
流程按流式chunk推进:(1) 维护统计:每头 $h$ 累积历史Query二阶矩阵 $M_h^{t-1}=\frac{1}{N}\sum q q^\top$;首个chunk冷启动用均匀权重 $w_{h,c}=1$,PSAC暂不启用。(2) QSAC选质心:对每个Key $k_i$,先用Query感知距离从256个质心中选top-4候选,再按groupsize 64分组计算残差动态范围 $R_g$,按 $S=\sum_g(\sum_{c\in G_g}w_{h,c})R_g^2$ 取得分最小的质心。(3) 量化打包:INT2残差4码并1字节,组缩放INT8+FP16二级缩放,质心索引uint8。(4) PSAC补偿:算 $E=K-\hat{K}_0$,对 $M_h$ 特征分解取前 $r=8$ 个特征向量 $U_r$(BF16),$C=EU_r$ 存INT8(仅当降低Query加权误差时保留),重构时 $\hat{K}=\hat{K}_0+CU_r^\top$。(5) 融合解码:Triton kernel把解包、反量化、质心gather与PSAC累加融合,按需输出BF16的K/V给原生FlashAttention/SDPA,兼容pre/post-RoPE;chunk完成后释放BF16原缓存。
技术新颖性
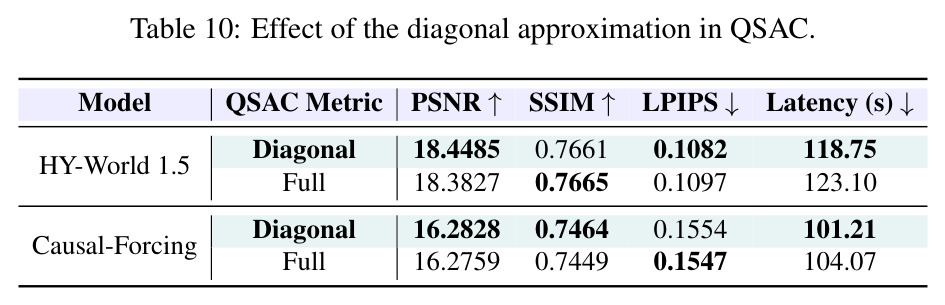
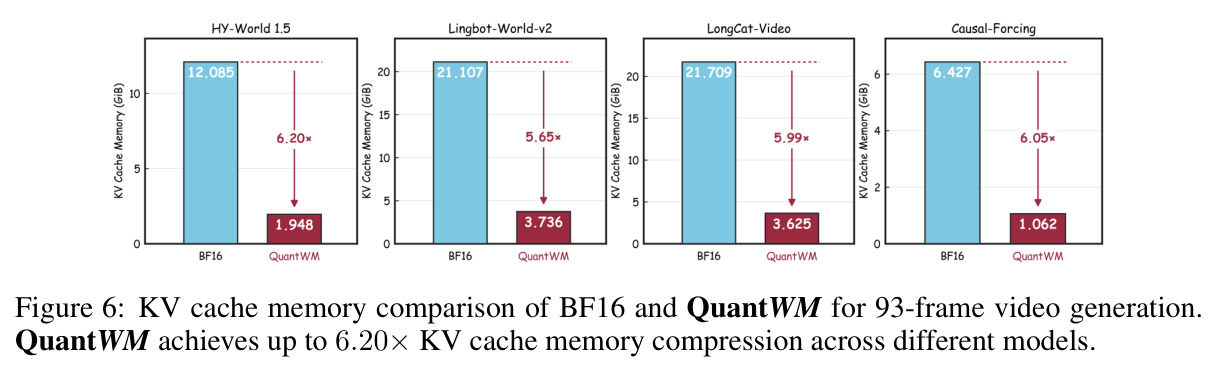
技术新颖性有四点。其一,目标函数革新:把KV量化从最小化重构MSE转向最小化Query加权的logit扰动 $e^\top M_h e$,并用Table 1的实证(Key重构误差更小、输出误差反而更大)论证旧目标失效;相比Tuncer等人的softmax偏置校正,本文直接作用于 $QK^\top$ 与时空token选择。其二,QSAC把Query敏感度与残差量化难度耦合进质心分配,是对QVG的K-means方案的实质性改造,且Table 10、11证明对角近似与 $M=4$ 候选即可(穷举256个质心使Causal-Forcing延迟从135.08s暴涨到1386.38s却无质量收益)。其三,PSAC利用Query能量低秩性(top-8占71.14%)把无法存储的全误差压缩为低秩INT8修正,是低秩补偿思想在视频世界模型KV缓存上的新应用。其四,算法-系统协同:INT2位打包、按需Triton融合解码、保留原生RoPE约定,使6.20×压缩的代价仅为个位数百分比延迟,甚至在缓存外载的LongCat-Video上提速17.78%。
实验结果
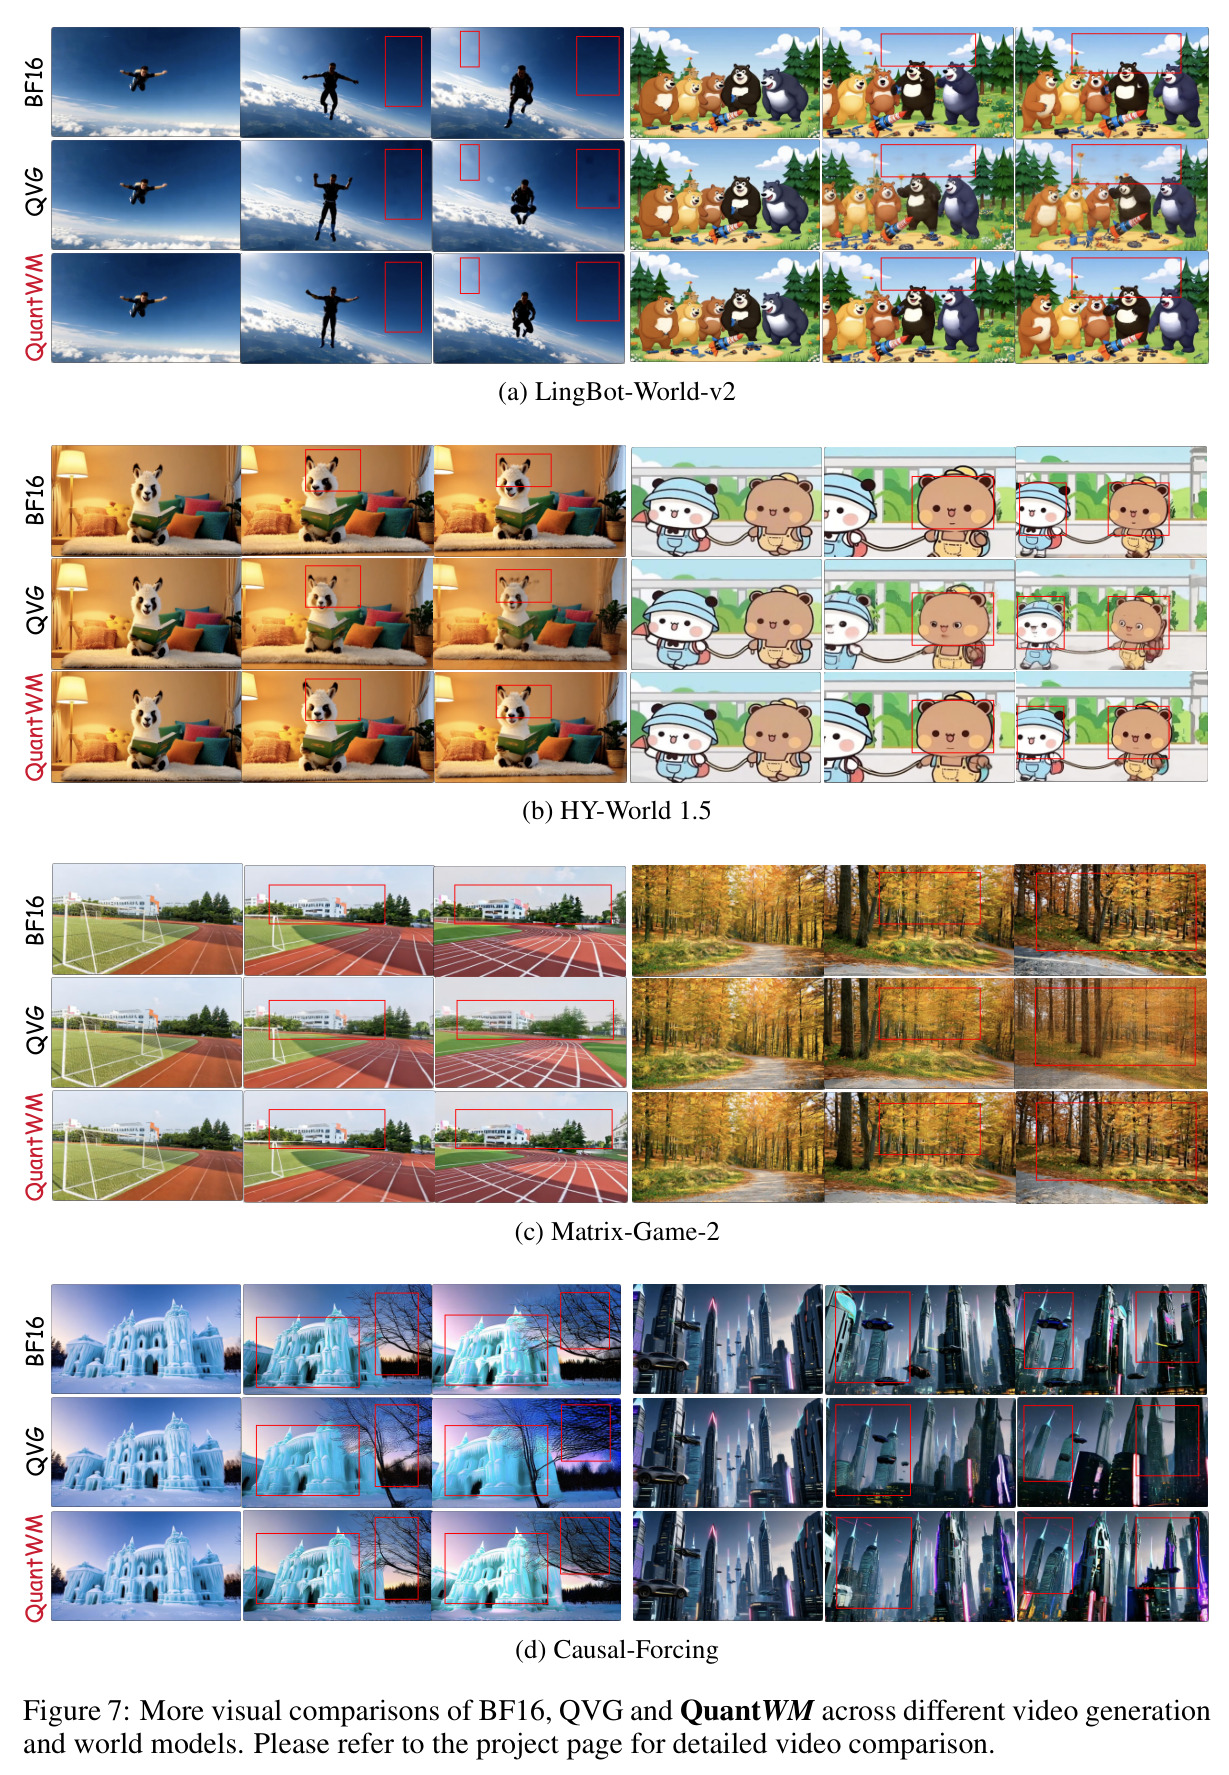
五方面发现。(1) 主结果(Table 3/4):480p下QuantWM在五个模型上全面超过KIVI与QVG——PSNR分别为Matrix-Game-2 20.615(QVG 17.749)、LingBot-v2 16.138(14.414)、HY-World 1.5 18.449(16.118)、LongCat-Video 25.508(20.683)、Causal-Forcing 16.283(14.887),720p趋势一致;VBench平均Rank全部最优(1.0–1.6),而各方法Temporal分数几乎相同(LingBot-v2约0.932),再次证明该指标无法反映闪烁。(2) token选择偏移(Table 5):QVG平均偏移率51.55%(最高61.36%),QuantWM降至平均15.31%。(3) 消融(Table 6,HY-World 1.5):单加QSAC把PSNR从16.118提到17.990、偏移61.36%→38.17%;单加PSAC到17.849、偏移22.90%;结合最优18.449/偏移13.92%。(4) 效率(Figure 6、Table 7):KV缓存最高6.20×压缩(LongCat-Video从21.709 GiB到3.625 GiB);延迟仅+5.44%/+5.87%,LongCat-Video反而−17.78%。(5) 长视频(Table 8,1分钟):HY-World 1.5的Image分数从QVG的0.4756恢复到0.6242,五个模型平均Rank均最优。附录消融进一步确定 $r=8$、$M=4$ 与对角近似是质量-开销甜点。
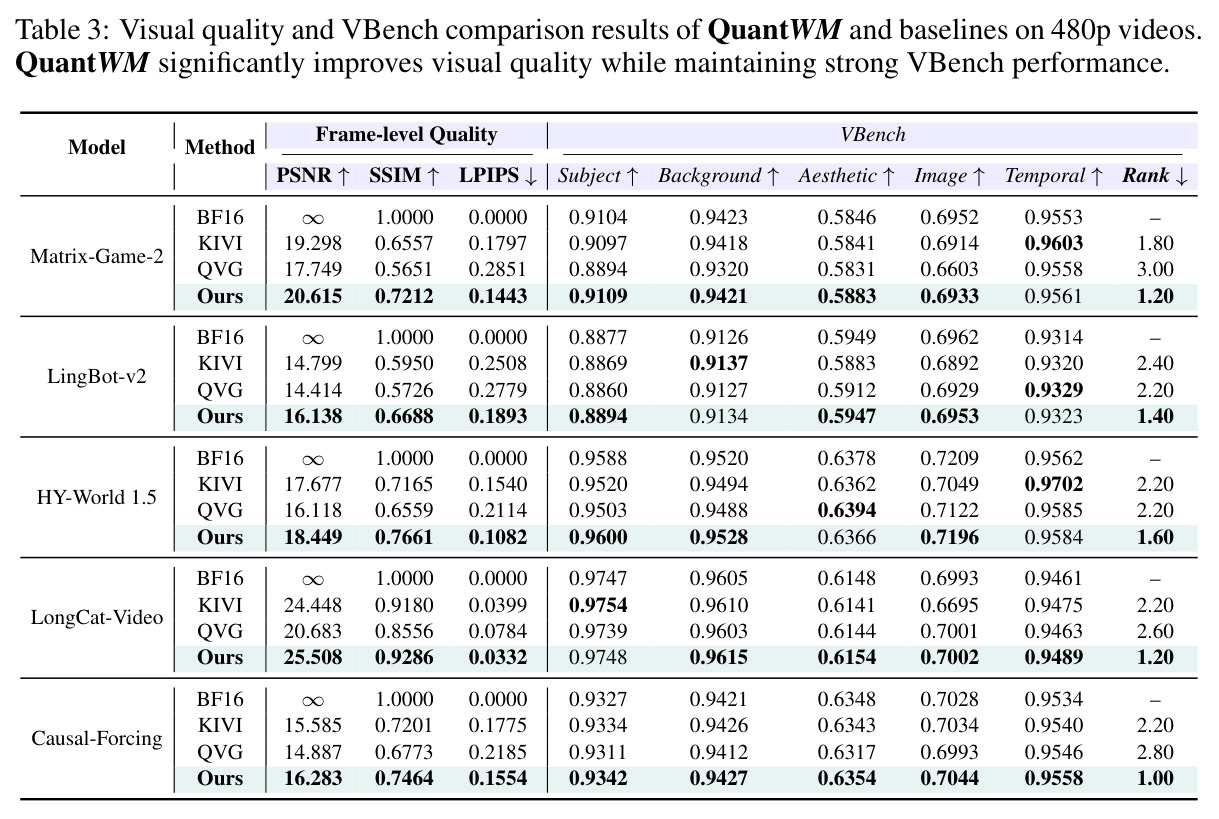
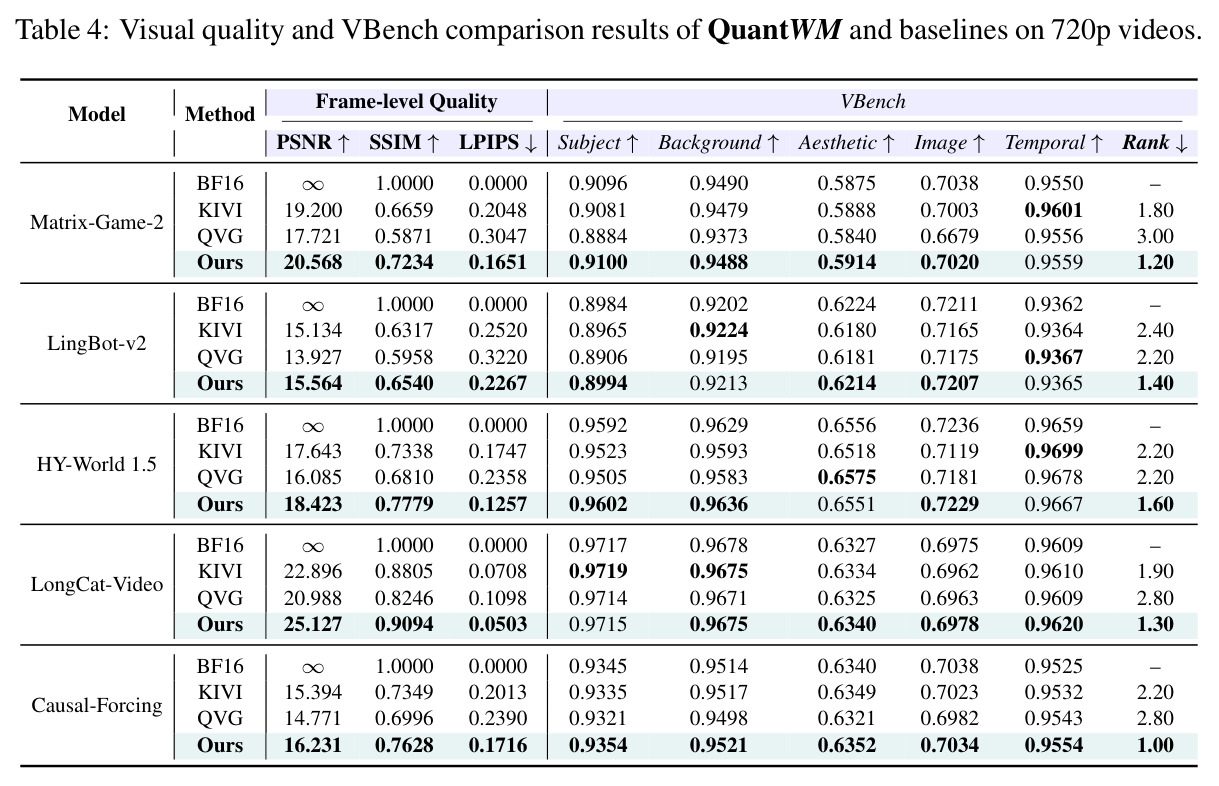
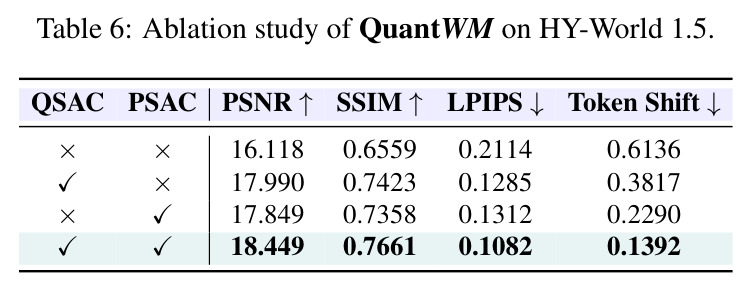
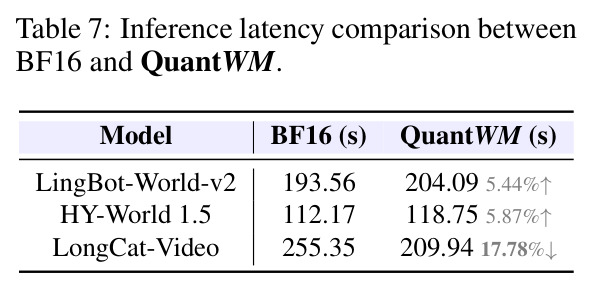
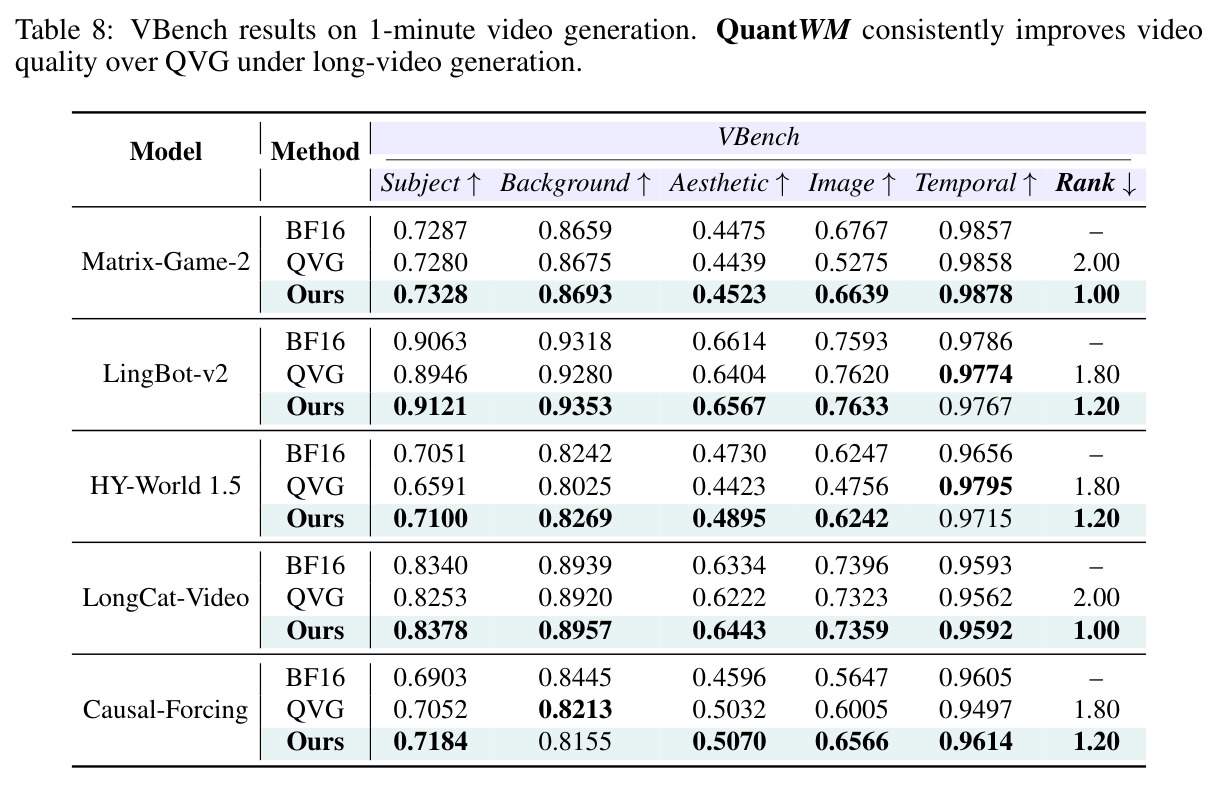
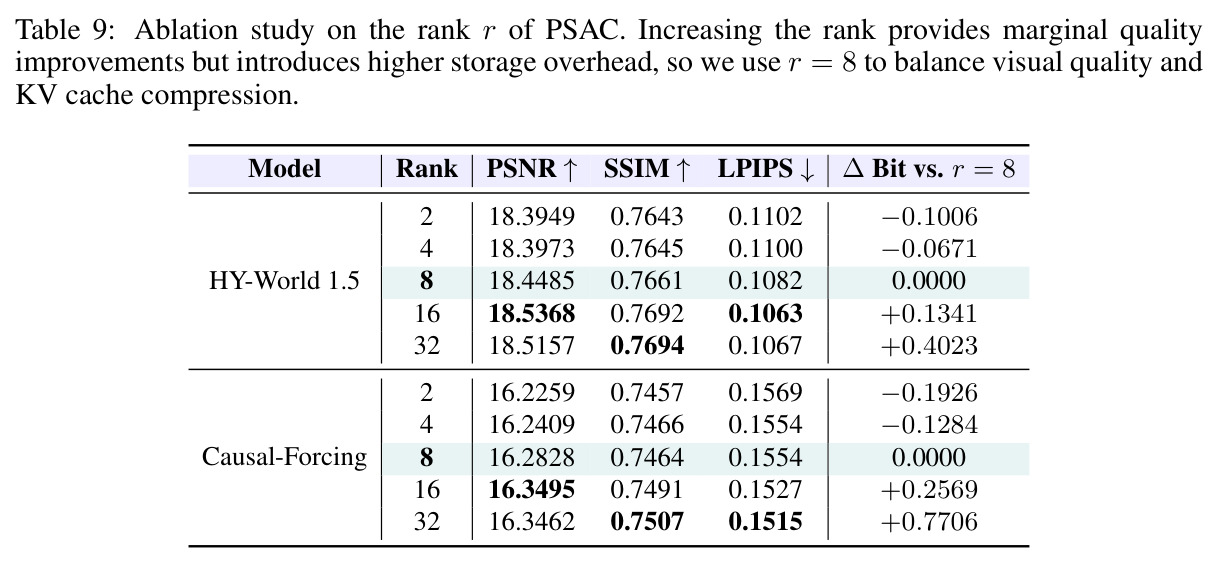
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 480p帧级视觉质量(五个视频世界/生成模型,93帧) | PSNR↑ / SSIM↑ / LPIPS↓ | HY-World 1.5:PSNR 18.449、SSIM 0.7661、LPIPS 0.1082;LongCat-Video:25.508/0.9286/0.0332 | QVG:HY-World 1.5 PSNR 16.118、SSIM 0.6559、LPIPS 0.2114;LongCat-Video 20.683/0.8556/0.0784 | HY-World 1.5 PSNR +2.33 dB、LPIPS降低48.8%;LongCat-Video PSNR +4.83 dB、LPIPS降低57.7% |
| top-1时空token选择偏移率(480p,对比BF16) | 偏移率↓ | 平均15.31%(HY-World 1.5为13.92%,Matrix-Game-2为10.19%) | QVG平均51.55%(HY-World 1.5为61.36%,Matrix-Game-2为53.88%) | 平均偏移率降至原来的约1/3.4,直接证明注意力保护有效 |
| VBench综合评测(93帧,480p/720p) | 平均Rank↓ | 所有模型均为第一:480p Rank 1.0–1.6,720p 1.2–1.6 | KIVI 1.8–2.4,QVG 2.2–3.0 | 五个模型全部排名第一,且Temporal分数与BF16几乎持平 |
| KV缓存显存(93帧视频生成) | GiB / 压缩比 | LongCat-Video 21.709→3.625 GiB;HY-World-1.5 12.09→1.95 GiB | BF16全精度KV缓存 | 最高6.20×KV缓存压缩 |
| 端到端生成延迟(93帧) | 秒(相对BF16变化) | LingBot-World-v2 204.09s(+5.44%)、HY-World 1.5 118.75s(+5.87%)、LongCat-Video 209.94s(−17.78%) | BF16:193.56s / 112.17s / 255.35s | GPU驻留缓存场景开销<6%,缓存外载模型反而净提速17.78% |
| 1分钟长视频生成(VBench,长程误差累积) | Image分数↑ / 平均Rank↓ | HY-World 1.5 Image 0.6242(接近BF16),Matrix-Game-2 Rank 1.0 | QVG:HY-World 1.5 Image仅0.4756 | 长程生成下质量显著恢复,五个模型平均Rank全部最优 |
局限与改进
作者承认的局限:一是VBench等现有基准无法捕捉2比特KV量化引入的时间闪烁与伪影,评测部分依赖自建的帧级配对指标与token偏移率;二是延迟影响依赖系统配置,KV驻留GPU时仍有约5.4%–5.9%的开销,只有缓存外载场景才能转为净收益(附录D.2);三是冷启动问题——第一个chunk没有历史Query统计,只能用均匀权重且PSAC暂不启用。我的补充观察:其一,对角近似丢弃通道相关性,而Table 10显示全矩阵反而更差(PSNR 18.3827 < 18.4485),更可能是在线二阶估计噪声伤害了质心选择,块对角、shrinkage等中间形态未被探索;其二,PSAC只修正logits的线性投影分量,softmax非线性引入的高阶偏差未处理;其三,帧级指标要求量化输出与BF16轨迹逐帧配对,而自回归世界模型对扰动敏感、轨迹可能发散,公平性依赖严格受控的种子与动作脚本;其四,结论限于2比特与Key侧补偿,Value误差(重构误差更大)没有对应对策。
独立分析的弱点
弱点一:Query敏感度用对角加权 $w_{h,c}$ 是最粗糙的各向同性近似,忽略通道相关性;可改用分组对角块、shrinkage正则或随机投影近似 $e^\top M_h e$。弱点二:QSAC的INT2误差估计依赖均匀量化理论(Widrow 1996),对尖峰分布或离群通道会系统性低估误差,可用在线残差直方图做非均匀修正。弱点三:PSAC秩 $r=8$ 全局固定,但Figure 8显示不同模型、层的能量集中度差异明显,Table 9中r=32仍有收益,应做逐层自适应秩。弱点四:补偿只在Key侧,Value量化误差虽不进入logits但线性进入注意力输出,可在输出端做类似低秩补偿。弱点五:K-means质心码本本身仍是离线的,未针对Query敏感度联合优化质心位置,增量式更新码本以适应长程分布漂移是自然延伸。弱点六:评测依赖与BF16逐帧配对及人工视觉检查,缺乏可直接回归'闪烁强度'的自动可微指标。
未来方向
作者提出的方向:把QSAC/PSAC推广到更多模态的世界模型与更长的持续生成(1分钟以上的误差累积分析仅在附录初步展开),并完善真实量化推理系统的实现(附录D给出的是原型)。基于成果可延伸的方向:其一,与KV缓存淘汰/滑动窗口/稀疏注意力正交结合——QuantWM保护'留下的token'被正确选中,token剪枝决定'谁留下',两者天然互补;其二,把注意力logit保真作为训练目标(量化感知训练或蒸馏),让模型学出对2比特友好的Key分布,突破免训练框架的精度上限;其三,将主子空间补偿思想扩展到Value输出端与前向激活量化,形成全链路注意力保真框架;其四,把token选择偏移率发展为视频世界模型的新评测维度,推动建立对时间闪烁敏感的自动化基准;其五,结合硬件感知的INT2 Tensor Core或查找表kernel,把质心-残差解码开销进一步压缩,使GPU驻留场景也实现零开销甚至加速。
复现评估
复现评估:论文提供项目主页 quantwm-project.github.io,但正文未明确承诺开源代码,需关注主页后续发布。可复现细节相当充分:PyTorch+Triton实现,NVIDIA A800 80GB;量化配置为256质心、groupsize 64、BF16质心+INT2残差、PSAC秩 $r=8$、$C$ 存INT8、$U_r$ 存BF16、候选质心 $M=4$;基线KIVI与QVG用官方仓库按各模型原生缓存约定复现;评测用MovieGen Benchmark提示集与Matrix-Game-2官方首帧加7–8条动作序列,480p/720p各93帧。主要门槛:(1) 需要五个模型权重,其中LingBot-World-v2、HY-World 1.5、Causal-Forcing等较新模型获取与跑通成本高;(2) PSAC需侵入式修改注意力前向与KV缓存生命周期,Triton融合解码kernel是最大工程难点;(3) 帧级指标需BF16与量化输出逐帧配对,多模型多分辨率生成对算力要求不低。总体属于'细节充分但依赖重工程与模型资源'的中等偏难复现,若官方开源则难度大幅下降。
论文图表
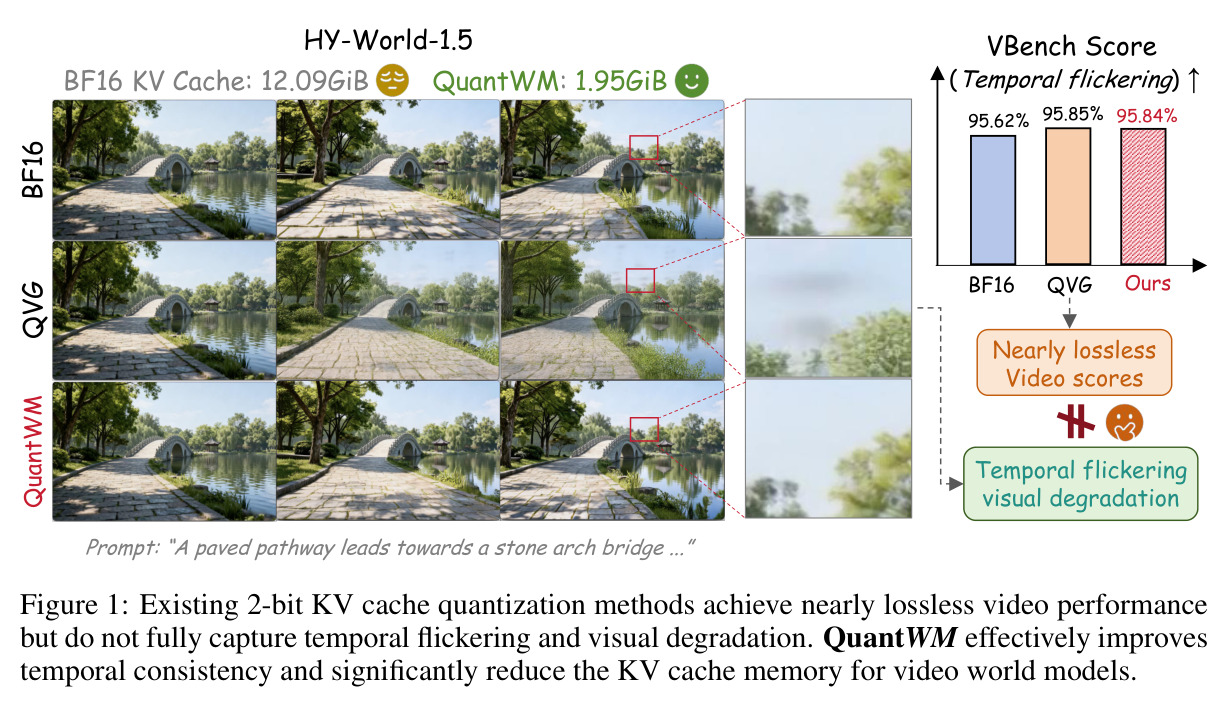
HY-World-1.5上的对比示例:BF16缓存占12.09 GiB,QuantWM仅1.95 GiB;QVG虽然VBench时间闪烁分数95.85%与BF16的95.62%几乎一致('nearly lossless'),但生成视频出现明显的时间闪烁与视觉退化;QuantWM在1.95 GiB显存下保持接近BF16的视觉质量与时间一致性。
这张图一图道破论文动机:现有基准分数与真实视觉退化严重脱节,同时展示QuantWM以极低显存解决问题的效果,是理解全文研究问题的入口。
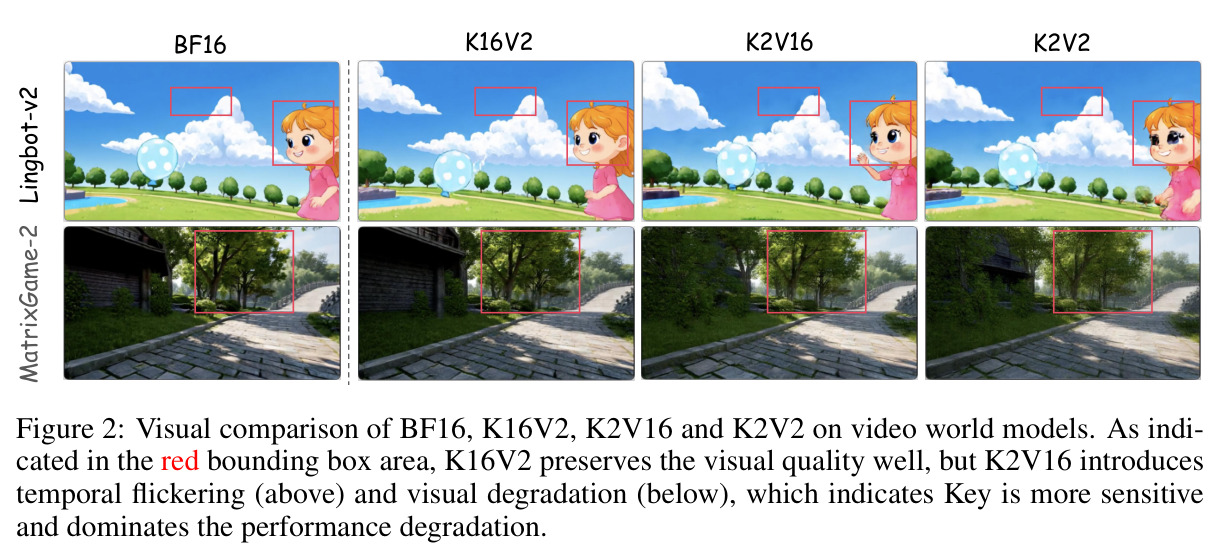
在LingBot-World-v2与Matrix-Game-2上对比四种缓存设置:K16V2(Value量化、Key保留)视觉质量保持良好,而K2V16(Key量化、Value保留)出现时间闪烁(上)与视觉退化(下),K2V2与K2V16相近,红框标出差异区域,证明Key量化主导性能退化。
这是定位问题根源的关键消融图:把退化归因到Key而非Value,直接引出后文对 $QK^ op$ 扰动的分析与QSAC/PSAC两个针对Key的设计。
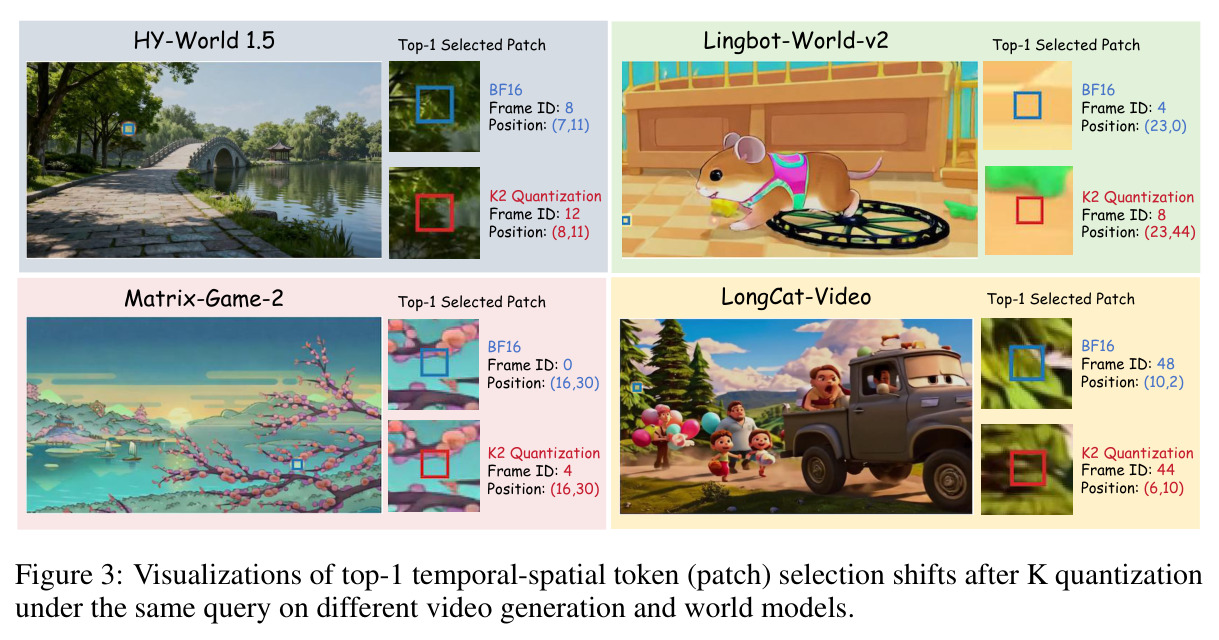
四个模型上同一Query在BF16与K2量化下选中的top-1时空patch可视化(帧ID+空间位置):如HY-World 1.5从帧8位置(7,11)漂到帧12位置(8,11),LingBot-World-v2从帧4位置(23,0)漂到帧8位置(23,44),Matrix-Game-2与LongCat-Video同样出现帧号跳变,直观展示Key量化如何改变时空token选择。
它把抽象的注意力扰动机制变成了可见证据,是'Key误差小但危害大'这一核心论断的直接可视化支撑,解释了时间闪烁的成因。
QSAC候选质心数 $M$ 的消融:HY-World 1.5上M=4达到PSNR 18.4485、延迟118.75s,穷举全部256个质心PSNR仅18.4450而延迟暴涨到240.66s;Causal-Forcing上M=256延迟高达1386.38s且无质量收益。
论证两阶段筛选(先Query距离粗筛、再敏感度得分精选)的必要性:小候选集即可逼近穷举质量,这是QSAC近乎零开销的关键。