EVO-WAM:通过视频-动作验证进化世界动作模型 EVO-WAM: Evolving World Action Models through Video-Action Verification
用VLM与逆动力学双重验证自生成轨迹,让世界动作模型无需专家示范自我进化新任务
前置知识
世界动作模型(World Action Model, WAM)
区别于只输出动作的视觉-语言-动作(VLA)模型,WAM 以视觉观测、机器人状态和任务指令为条件,联合预测未来视频潜变量和配对动作,代表工作有 DreamZero、Cosmos3、LingBot-VA。它通过大规模视频预训练获得运动、物理交互与场景演化的先验,视频预测可为动作生成与规划提供引导。
整篇论文的方法对象就是 WAM:在其上增强状态预测与锚定上下文,并在 Cosmos3、DreamZero 两个骨干上做自进化实验。
逆动力学模型(Inverse Dynamics Model, IDM)
与正向过程(由动作推下一状态)相反,IDM 从观测转移(前后帧视频)反推执行了什么动作。本文把预训练视频模型改造成动作输出型 IDM,以视频窗口、机器人状态和指令为条件,在真实视频-动作对上训练,因此能充当"给定这段画面,专家会做什么动作"的参照。
IDM 是视频-动作一致性验证的核心裁判,没有它就无法判断生成动作能否真实复现画面行为。
自训练与自我改进
指模型不依赖新的外部标注或专家演示,而是用自身输出经过筛选后的数据继续训练自己。关键在筛选标准:若不加甄别,模型的错误会被自我强化。本文采用双重标准——视觉上完成任务(VLM 判)且视频-动作一致(IDM 判),通过的前缀才进入 SFT,并跨轮累计迭代。
理解 EVO-WAM 的逐轮收益(26.9%→68.0%)以及第 3 轮出现回退的现象,都需要自训练的基本直觉。
视觉语言模型(VLM)作为验证器
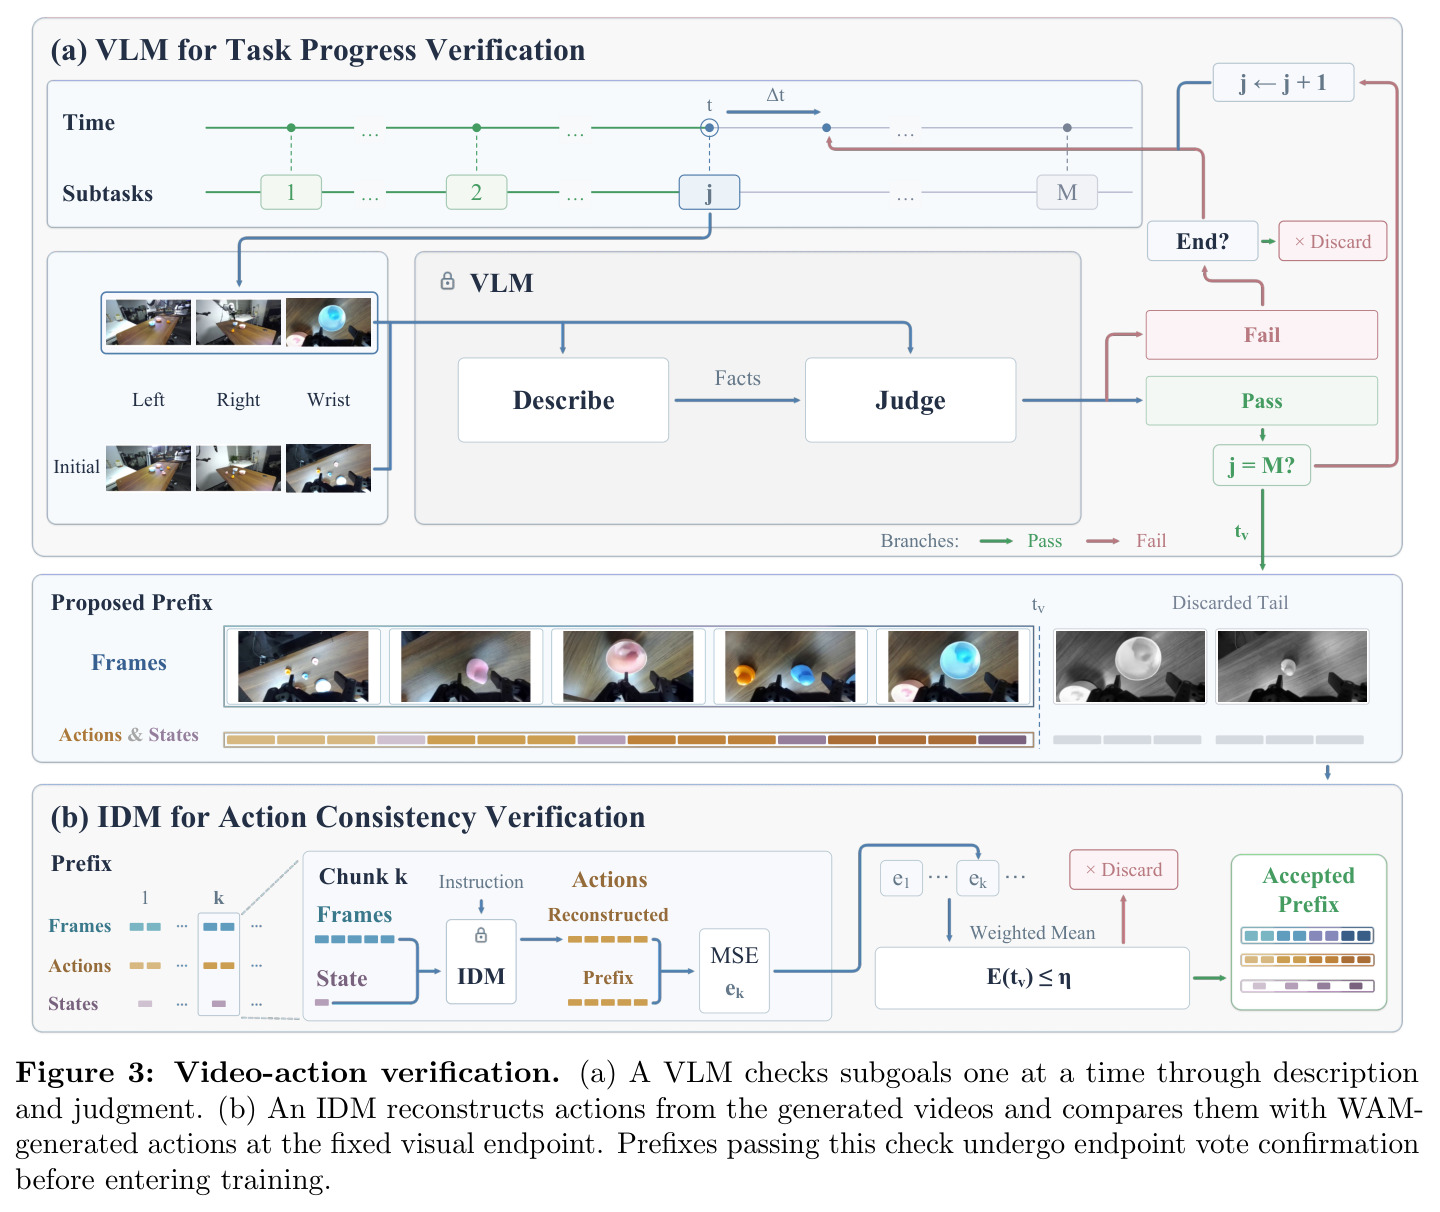
VLM 能看图并按文本指令推理。本文让它先从多相机视角描述物体、空间关系与机器人构型,再对照任务指令与当前子目标做"描述-判断"两步判定,涵盖目标达成、夹爪释放、物体一致、机器人结构一致四项检查,并用 3 次判断至少 2 次通过的投票稳住结论。
VLM 是任务完成验证的执行者,其能力规模直接影响上限(Qwen3.8 达 68.0%,小一号的 Qwen3.5 也有 65.7%)。
研究动机
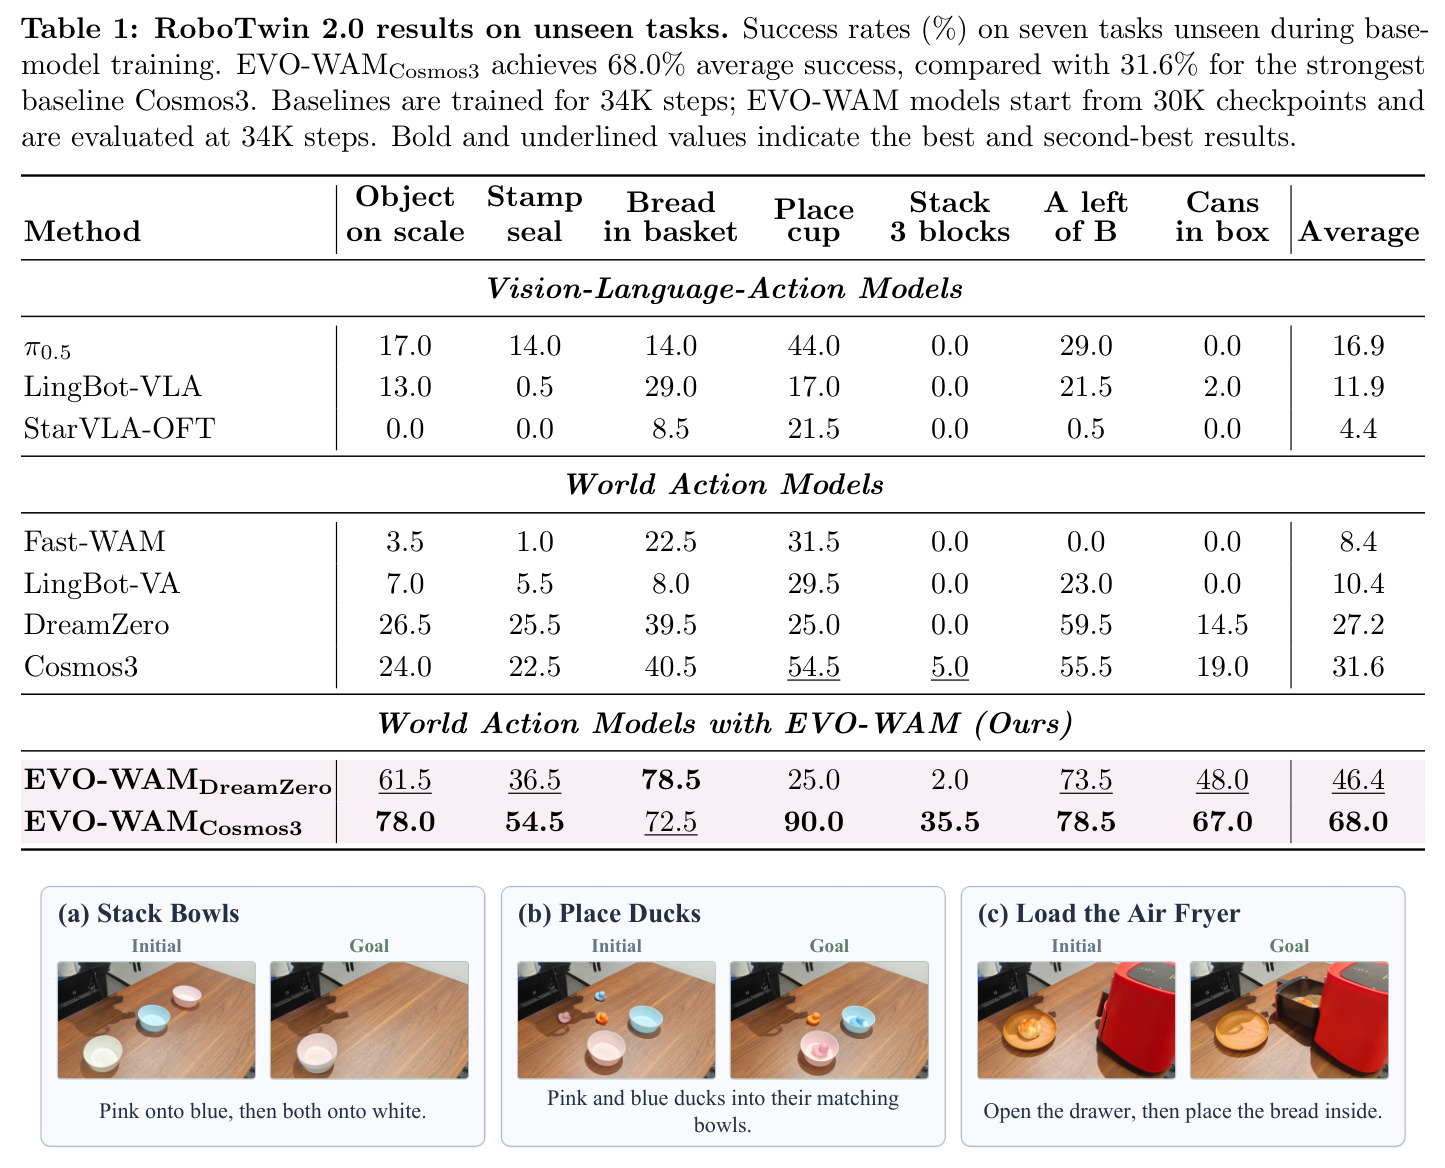
机器人策略要泛化到训练时没见过的任务,通常得额外采集专家演示,成本高昂。世界动作模型(WAM)如 DreamZero、Cosmos3、LingBot-VA 靠大规模视频预训练获得运动与物理交互先验,联合预测未来视频和动作,在部分试验中能推进未见任务,但这不等于可靠适应:相同初始条件和指令下,同一模型生成的视频有时描绘成功、有时描绘失败(论文 Figure 6 中 Rollout 1 就把蓝鸭放进了粉碗导致验证失败);更隐蔽的是,即便视频画面正确,配对动作也可能与画面行为不一致,真机执行照样失败。直接拿这样的自生成数据训练会强化不完整行为或无效动作。实测基线确实很弱:在 7 个 RoboTwin 2.0 未见任务上,Cosmos3 平均成功率仅 31.6%,DreamZero 27.2%,最强的 VLA 基线 π0.5 也只有 16.9%,Stack 3 blocks 等任务上多数方法为 0%。
本文的目标是本文的目标是在不采集任何新专家演示、也不在外部环境中执行候选动作的前提下,让 WAM 利用自身生成的视频-动作轨迹在未见任务上持续自我提升。具体拆成三个可验证的子目标:其一,让模型能在没有环境反馈的条件下自回归生成完整轨迹(视频、动作、机器人状态齐备);其二,自动筛出可靠的训练数据——只保留既在视觉上完成任务的片段、又保证视频与动作一致的前缀;其三,通过多轮"生成-验证-训练"迭代把性能推高。定量目标是在 7 个 RoboTwin 2.0 未见任务上把 Cosmos3、DreamZero 的成功率显著抬升(最终 26.9%→68.0% 与 28.5%→46.4%),在 3 个真实长程组合任务上从 20.0% 提到 76.7%,同时已见任务性能基本不退化(85.8%→84.8%)。
与已有工作不同的是,已有方法要么用独立的世界模型生成经验来改进策略,要么用 WAM 生成回放在持续学习中保住旧技能,但学新任务仍依赖外部世界模型或任务演示,没有人把 WAM 自身的视频先验直接当作未见任务的监督来源。本文的关键洞察是:WAM 自生成的 rollout 里就藏着可靠训练信号,只要挑出"描绘任务完成且视频-动作一致"的前缀,完全不必执行任何动作。独特切入是双阶段验证:VLM 判视觉完成、IDM 判动作一致性,从而无需目标任务模拟器就能过滤自生成数据。消融直接支撑这一角度的价值:仅用 VLM 四轮后只有 43.7%,加上 IDM 达 68.0%,逼近需要模拟器的 VLM+Simulator 的 72.7%,而 IDM 方案可同时覆盖没有模拟器的真实世界任务。
核心方法
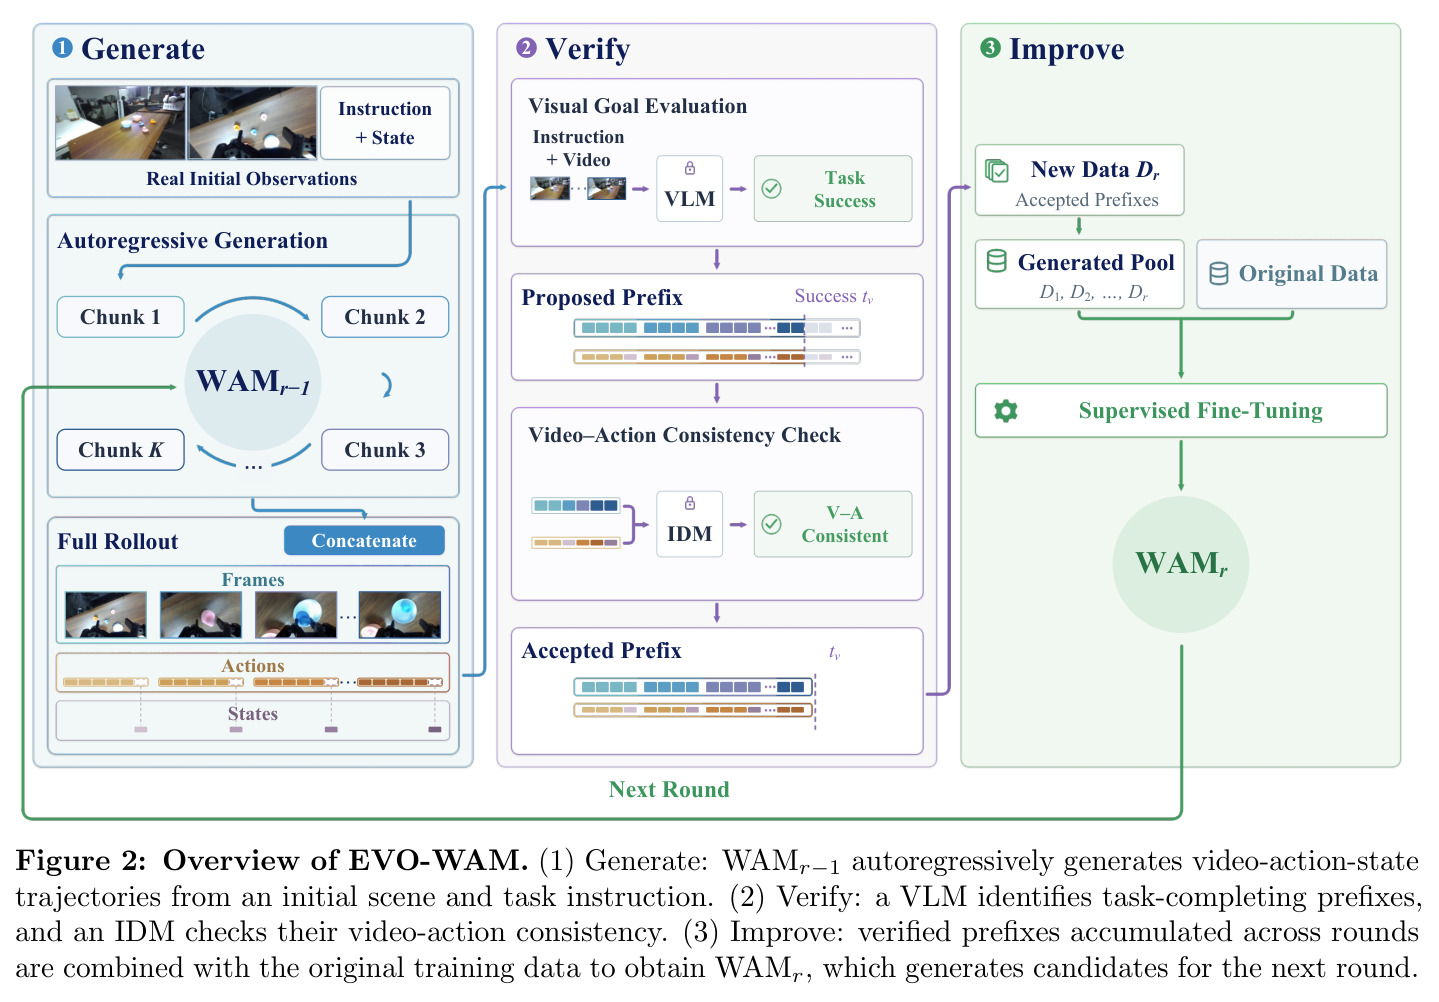
直觉是让机器人"想象自己完成任务,再把想象中可信的部分变成教材"。路线分三块:(1) 生成——给 WAM 加状态预测头(每块末尾预测状态 $\hat{s}^+_k$)与锚定多帧上下文,只凭初始潜变量 $z_0$、状态 $s_0$ 和指令 $\ell$ 即可自回归 rollout:第 1 块条件为 $(z_0,s_0)$,第 $k\geq 2$ 块条件为 $h_k=(z_0,\mathrm{Tail}_m(\hat{V}_{k-1}),\hat{s}^+_{k-1})$,锚定帧 $z_0$ 常驻以防场景漂移;(2) 验证——VLM 沿预定义时间点逐子目标做"描述-判断"筛出任务完成前缀,IDM 从生成视频重建动作并与 WAM 自配动作在归一化空间比 MSE,满足 $E(t_v)\leq\eta$ 才通过,加端点投票;(3) 改进——每轮把新验证数据与历史轮次及原始数据混合做 SFT:$\theta_r \leftarrow \mathrm{SFT}(\theta_{r-1}; D_{\mathrm{base}}, D_1,\ldots,D_r)$,新模型再生成下一轮候选,共 4 轮。
核心创新是把"视频-动作一致性"确立为自生成数据可靠性的判据。以往自训练与世界模型经验生成方法只看视觉结果是否达成,本文指出视觉成功不等于动作正确:生成视频画面对了,配对动作仍可能无法真实复现画面行为,训练这种数据会学出"想得到却做不到"的策略。为此引入逆动力学模型当裁判——IDM 在真实视频-动作对上训练、只看视频反推动作,从生成视频重建动作后与 WAM 自配动作比 MSE,误差 $E(t_v)\leq\eta$ 才录取。它与"模拟器执行验证"效果接近(68.0% vs 72.7%)但不需要目标任务模拟器,因此能直接迁移到真实机器人。第二项创新是锚定多帧上下文加状态预测,让模型脱离环境反馈也能完整自回归;第三项是端点投票(每端点 3 次描述-判断至少 2 次 Accept)与"一致性不过则整条丢弃、不在更晚端点续检"的严格准入规则,从机制上保证训练数据质量。
方法步骤详情
先准备基础模型:模拟设定从 43 个 RoboTwin 任务训练到 30K 步的 Cosmos3/DreamZero checkpoint 出发,真实设定把公开 Cosmos3 在 DROID 上续训 31K 步。第二步生成:每轮对每个未见场景自回归生成候选轨迹,模拟每任务每轮 2,800 条、真实 800 条,每条含初始观测 $o_0$、状态 $s_0$、指令 $\ell$ 及按预算 $K$ 块生成的视频-动作-状态序列。第三步视觉验证:VLM 先从多相机视角描述物体、空间关系与机器人构型,再对照指令与子目标 $g_j$ 判断,须同时满足目标达成、夹爪释放、物体一致、结构一致四项;按时间顺序扫描,首个 Accept 处固定 $t_j$,全过后 $t_v=t_M$。第四步一致性验证:IDM 重建动作与原动作算跨窗口平均 MSE 得 $E(t_v)$,满足 $E(t_v)\leq\eta$ 通过,每端点再做 3 判断至少 2 次通过的投票,任一环节失败整条丢弃。第五步训练:各轮通过前缀与原始数据混合,模拟每轮 1K 次、真实 500 次更新(全局 batch 256),共 4 轮。
技术新颖性
技术上新颖之处有四点。其一,验证对象是"视频-动作对"而非单看视频结果,这是与既有世界模型经验生成(Dreamer 系、World Model replay 等)最本质的区别,Table 4 显示这一区别带来 43.7%→68.0% 的巨大差距。其二,用"视频模型改造的动作输出 IDM"替代模拟器执行作为一致性裁判,把验证成本从"需要目标场景模拟器"降到"只需真实演示数据训练 IDM",是该框架能上真机的关键。其三,状态预测加锚定多帧上下文的条件化设计,解决了 WAM 脱离环境反馈后自回归续写时丢失场景参照的难题。其四,验证流程采用了任务级分解(子目标逐个检查)、四项物理合理性检查、端点 3 选 2 投票、失败即整体丢弃等多重保守机制, 宁可少收数据也不放行可疑样本。相比 VLM+Simulator(72.7%),IDM 方案只损失 4.7pp 却换来对真实任务的适用性,是实用性导向的工程设计。
实验结果
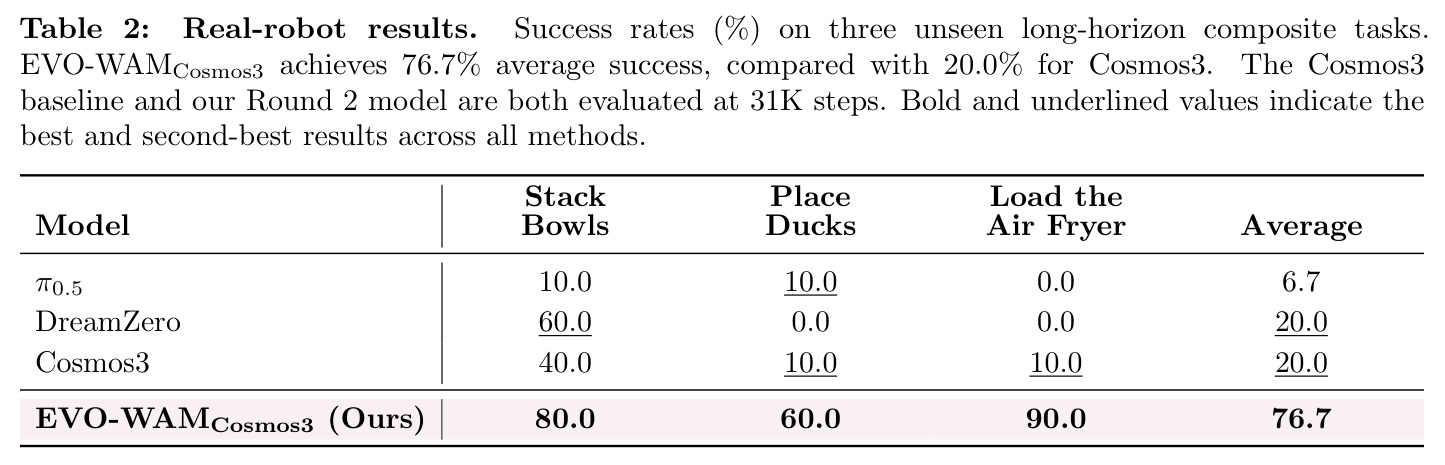
(1) 模拟:7 个 RoboTwin 未见任务上 EVO-WAM-Cosmos3 平均 26.9%→68.0%(约 2.5 倍),EVO-WAM-DreamZero 28.5%→46.4%,最强基线 Cosmos3 仅 31.6%,π0.5 只有 16.9%;分任务如 Place cup 54.5%→90.0%、Cans in box 19.0%→67.0%。(2) 真实长程:叠碗/放鸭/装空气炸锅平均 20.0%→76.7%(+56.7pp),超最强基线 20/50/80pp。(3) 轮次:第 1 轮增益最大(模拟 +31.4pp、真实 +40pp),第 3 轮回落(63.6%/73.3%)后第 4 轮恢复,自训练非单调。(4) 消融:R4 时 VLM only 43.7%、VLM+IDM 68.0%、VLM+Simulator 72.7%;换小 VLM Qwen3.5-27B 仍达 65.7%,双验证必要且对 VLM 规模稳健。(5) 泛化与保留:100 个新场景 70.4% vs 基线 24.9%;43 个已见任务 84.8% vs 85.8%,几乎无损。
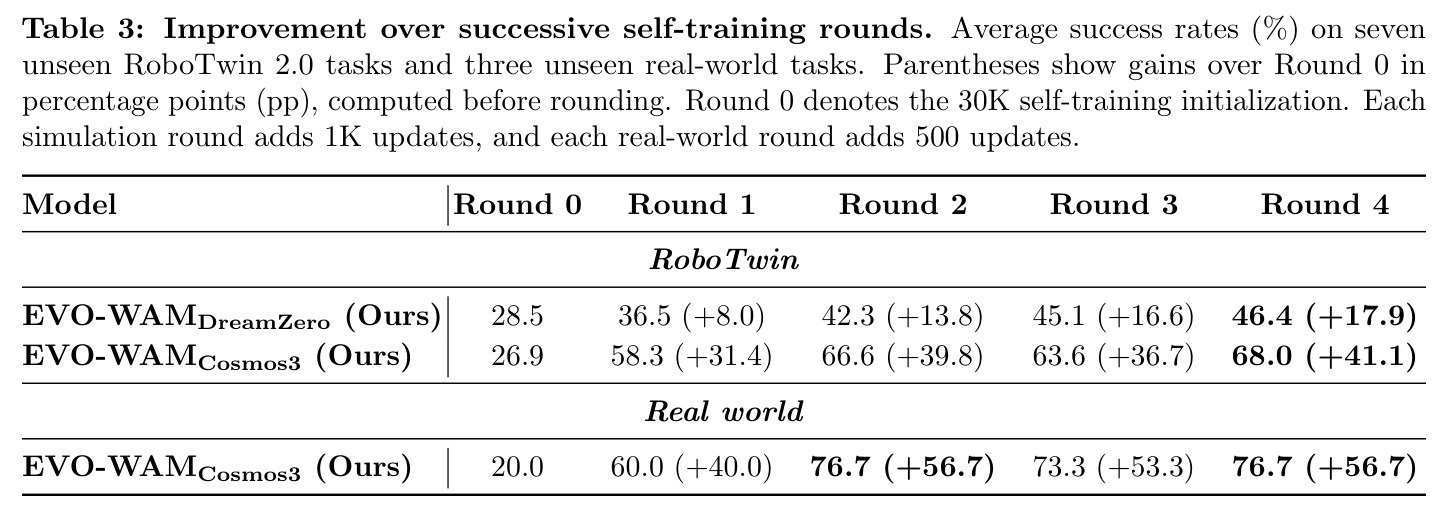
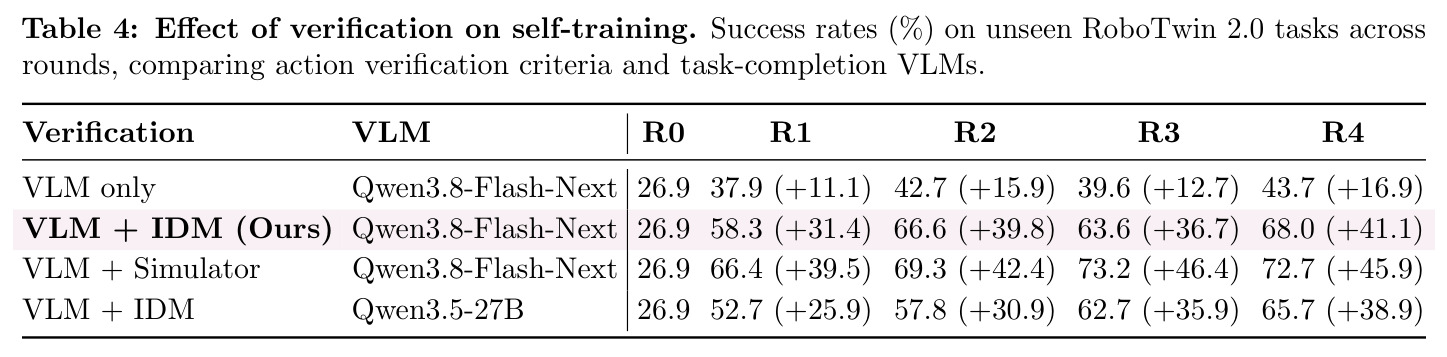
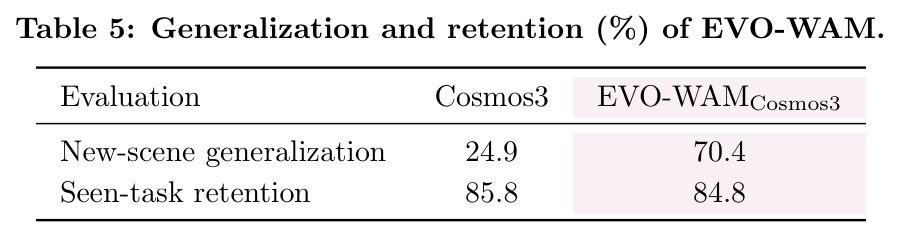
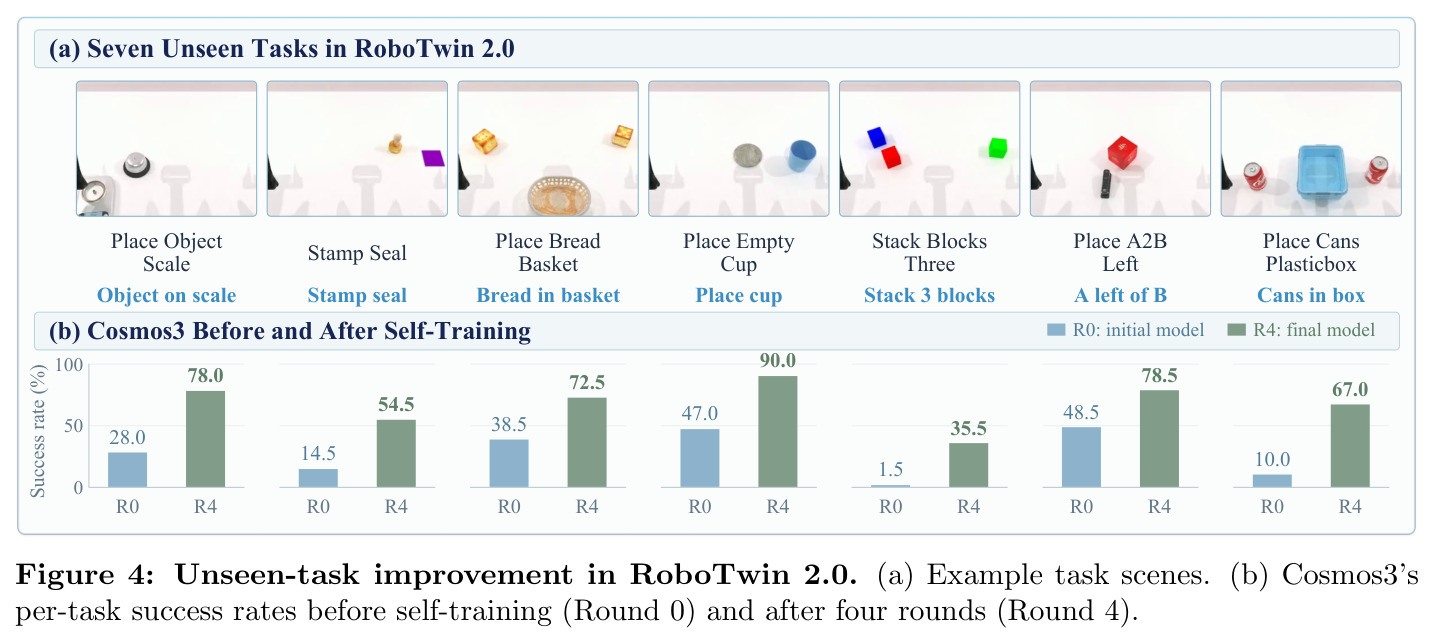
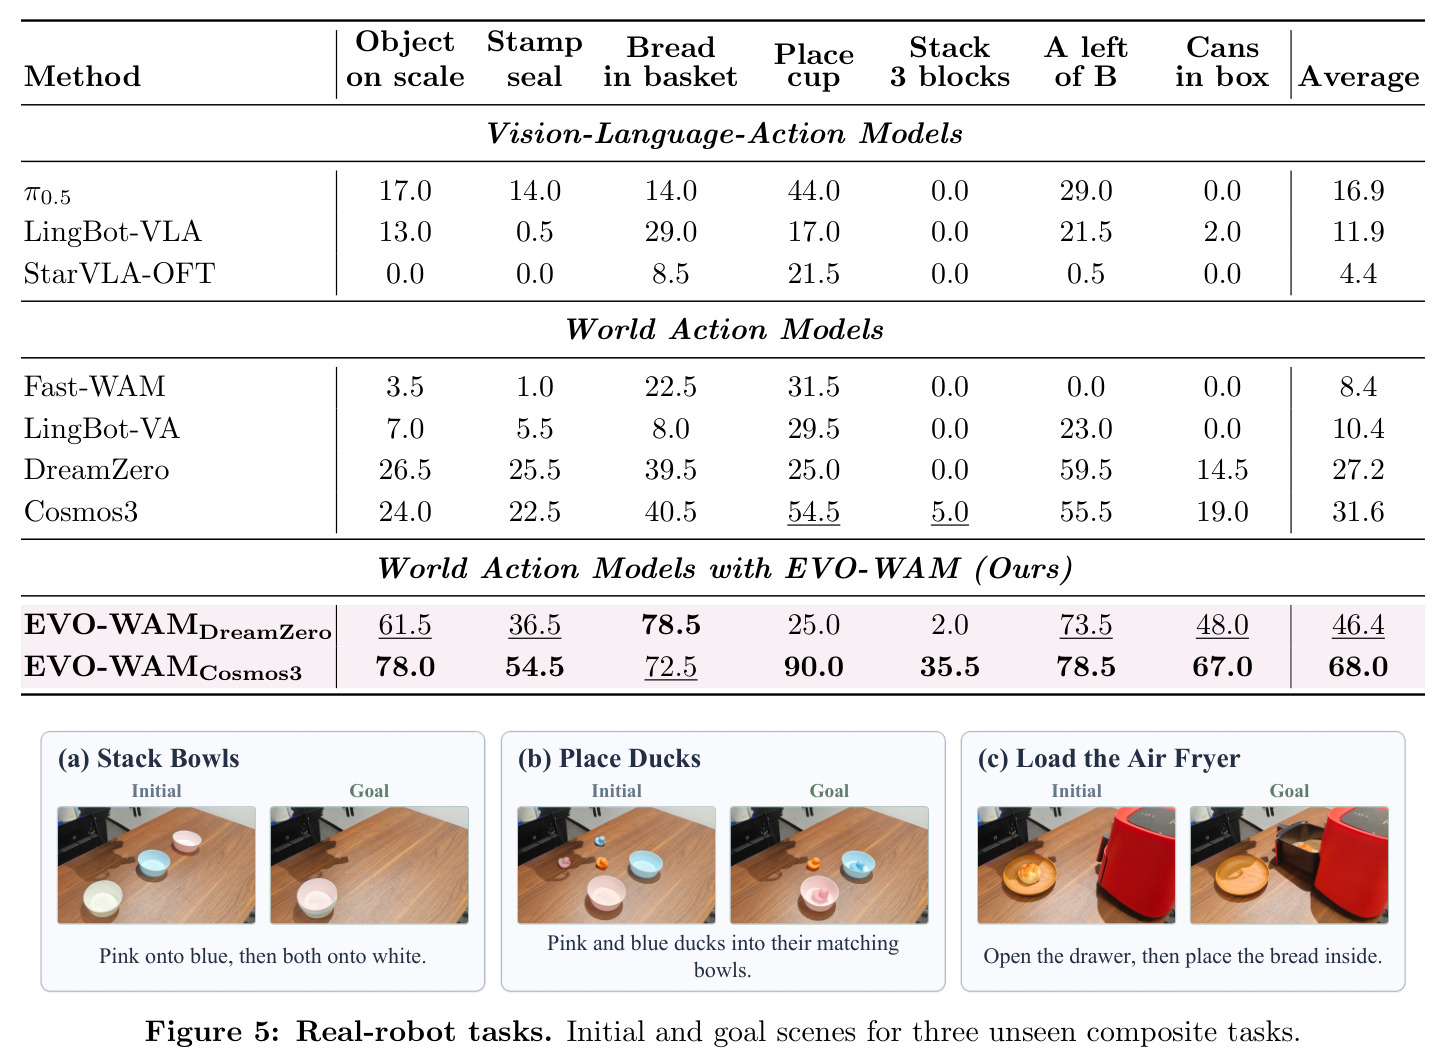
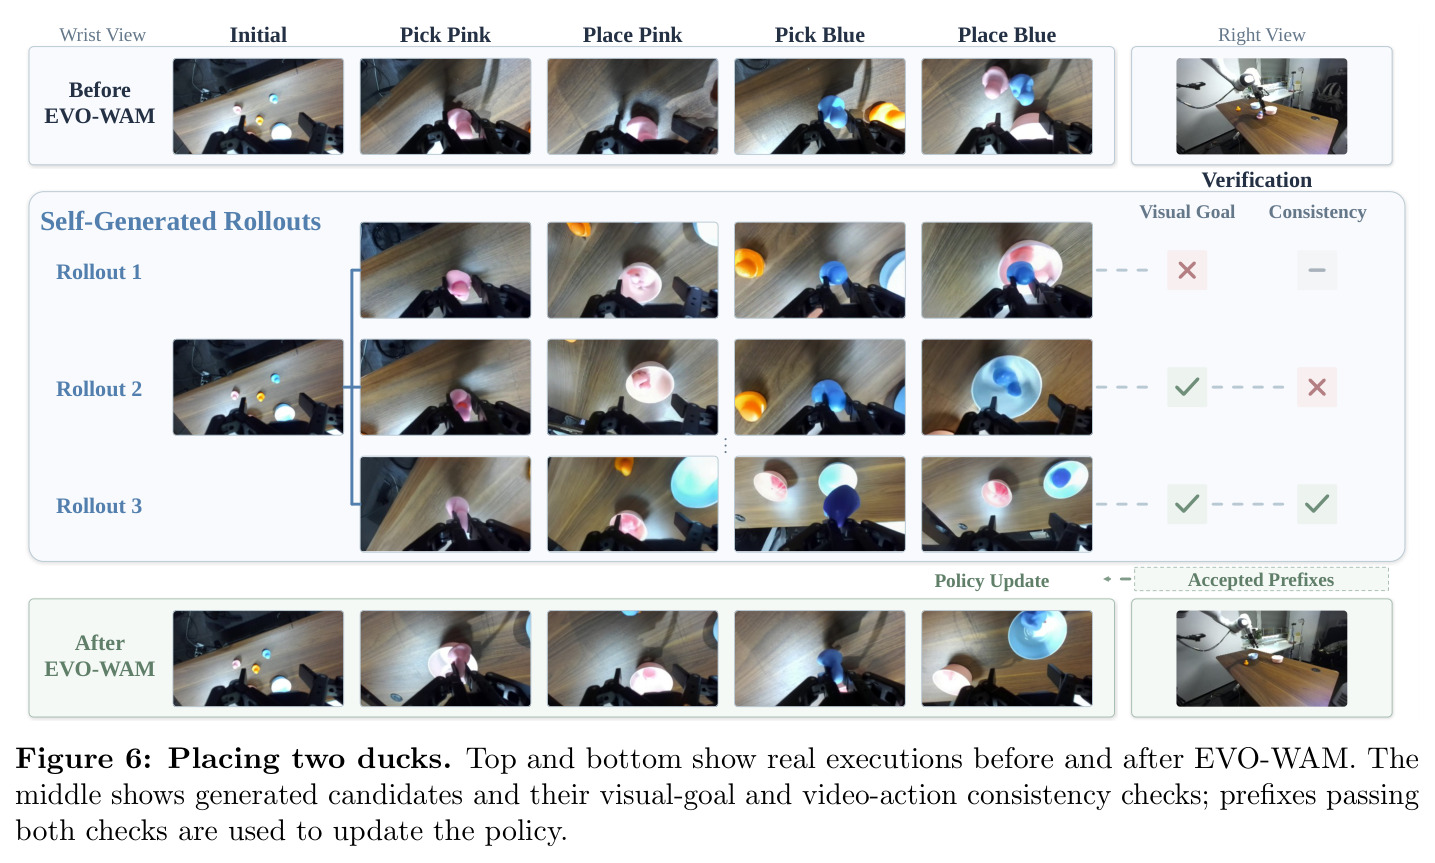
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboTwin 2.0 七个未见任务(模拟) | 平均成功率(每任务 100 Clean + 100 Randomized 试验) | EVO-WAM_Cosmos3 68.0%;EVO-WAM_DreamZero 46.4% | Cosmos3 31.6%;DreamZero 27.2%;π0.5 16.9% | Cosmos3 骨干 +36.4pp(约 2.5 倍);DreamZero 骨干 +19.2pp(约 1.6 倍) |
| 三个真实长程组合任务(叠碗/放鸭/装空气炸锅) | 平均成功率(每任务 10 次试验) | EVO-WAM_Cosmos3 76.7%(80%/60%/90%) | Cosmos3 20.0%;DreamZero 20.0%;π0.5 6.7% | +56.7pp,超最强基线 20/50/80 个百分点 |
| 消融:验证准则对比(RoboTwin 未见任务,R4) | 平均成功率 | VLM+IDM 68.0% | VLM only 43.7%;VLM+Simulator 72.7% | 比 VLM only +24.3pp;比需模拟器的 Simulator 仅低 4.7pp |
| 新场景泛化(每任务随机 100 个新场景) | 平均成功率 | EVO-WAM_Cosmos3 70.4% | Cosmos3 24.9% | +45.5pp,提升不局限于自训练所用场景 |
| 已见任务保留(43 个任务,各 50 Clean + 50 Randomized) | 平均成功率 | EVO-WAM_Cosmos3 84.8% | Cosmos3 34K 基线 85.8% | 仅 -1.0pp,未见任务大涨同时旧任务几乎无损 |
局限与改进
作者承认的局限:其一,增益依赖基础模型的生成质量,DreamZero 在 Place cup(25.0% 持平)和 Stack 3 blocks(0%→2.0%)上几乎没提升,作者归因于其生成候选中可用行为受限,说明框架更像"放大器"而非"从零创造";其二,自训练非单调,Cosmos3 变体第 3 轮从 66.6% 回落到 63.6%,真实世界第 3 轮也降到 73.3%,需靠累计数据与多轮缓解。我补充的观察:IDM 一致性只衡量"动作像不像真实演示",不保证动作真能完成任务,这正是与 VLM+Simulator 72.7% 之间 4.7pp 差距的来源;阈值 $\eta$ 需按 backbone 与数据集逐一校准,跨域迁移成本未知;VLM 验证依赖人工预定义的子目标序列与扫描时间点,自动化程度有限,且强 VLM 效果更好说明对验证器能力有依赖;真机评估仅 Franka 单臂、每任务 10 次试验,样本量小、统计置信有限;论文也未报告生成与训练的算力开销和推理延迟。
独立分析的弱点
弱点一:天花板受骨干生成质量限制,DreamZero 仅达 46.4%,弱生成池挑不出足够多的好前缀,Place cup 和 Stack 3 blocks 几乎原地踏步。改进方向:对失败 rollout 引入 DPO 式负向偏好学习,或用温度采样、指令扰动提升候选多样性,而不是只做正样本筛选。弱点二:验证流程强依赖人工设定的子目标时间点与提示工程,换任务需重新配置。改进方向:让 VLM 自动分解任务并输出子目标-时刻序列,或用可完成性预测模型替代固定扫描。弱点三:IDM 判据与真实任务成功解耦,与模拟器验证存在 4.7pp 差距。改进方向:为通过的前缀附加轻量价值估计并按预估成功率加权采样。弱点四:每次适应新任务都要跑完整生成-验证循环(每轮 2,800 候选加 1K 次更新),在线部署成本高。改进方向:把多轮自进化的成果蒸馏进单个前向策略,或做元学习加速少样本适应。弱点五:真机每任务仅 10 次试验,76.7% 这类结论置信区间很宽;已见任务 85.8%→84.8% 的轻微遗忘在更长训练下可能放大,值得监控。
未来方向
作者指出的方向:视频-动作验证让 WAM 能把自身预测转化为适应新任务的经验,指向自我改进的机器人策略。可延伸的方向:(1) 把验证通过的生成数据接入离线强化学习或偏好优化,显式利用被丢弃 rollout 的负信号,而当前只用正样本前缀;(2) 混合验证策略——有模拟器时用执行验证(上限 72.7%),无模拟器时退回 IDM,按任务自适应切换以吃满两种判据的互补优势;(3) 扩展到更多骨干(如 LingBot-VA)、双臂/移动操作与更复杂长程任务,目前真实长程仅 3 个任务;(4) 阈值 $\eta$ 与子目标分解的自动化、课程式难度递增,进一步减少人工配置;(5) 与持续学习结合,研究多轮自进化对已见任务的长期影响;(6) 用世界模型 rollout 做安全预筛后再上真机执行,把"想象-验证"作为执行前的风险评估层。
复现评估
复现要素较齐全但存在关键缺口。有利条件:RoboTwin 2.0 是公开基准(43 训练/7 评估任务划分明确);Cosmos3 有公开 checkpoint(真实设定在 DROID 上续训 31K 步);自训练超参写得很细——每轮 2,800 候选(真实 800)、每轮 1K 次(真实 500 次)SFT 更新、全局 batch 256、共 4 轮;验证器用 Qwen3.8-Flash-Next 或 Qwen3.5-27B;IDM 由预训练视频模型改造,流程在附录 C.1/C.2(含 $\eta$ 校准方法);项目页 evo-wam.github.io 提供视频结果。缺口:正文未明确承诺开源代码与 IDM 权重,Qwen3.8-Flash-Next 的可得性存疑;VLM 提示词、子目标时间点定义等工程细节是复现的最大不确定项。算力方面,4 轮×数千条视频生成加批量 SFT 需要多卡 GPU 与大量推理资源;真机部分还需 Franka 平台和三个场景的搭建与标定。综合评估:模拟部分中等偏难,真机部分较难。
论文图表
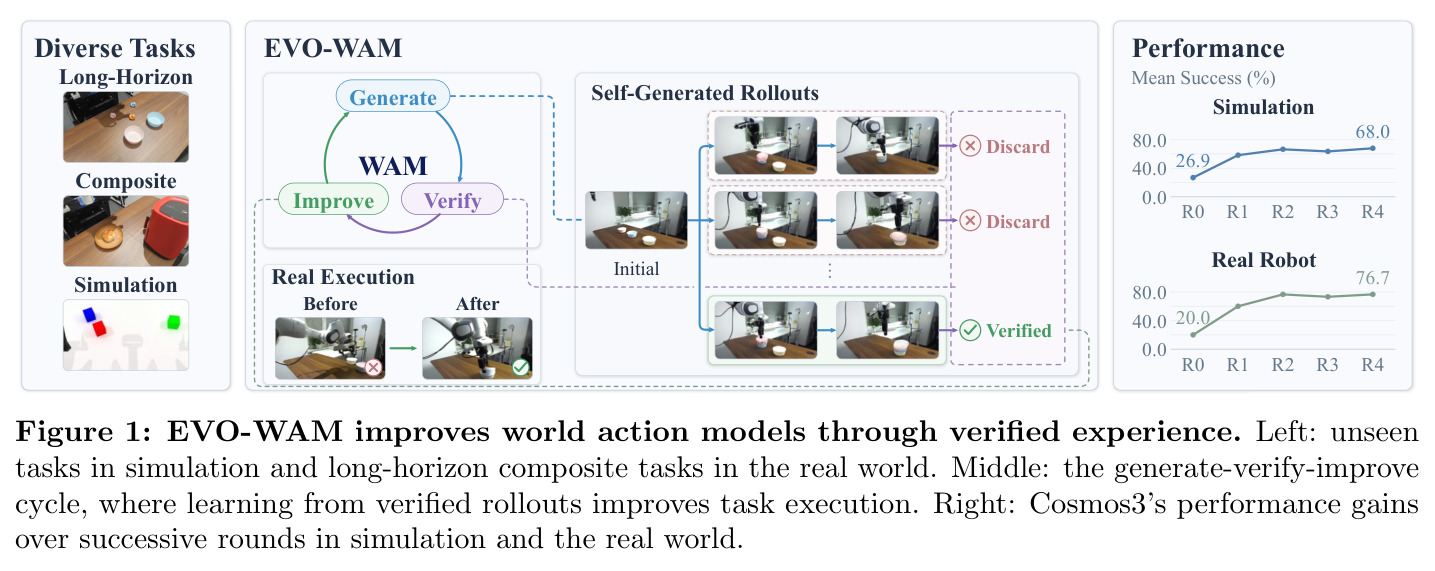
总览图。左侧展示模拟中的未见任务与真实世界长程组合任务示例;中间是"生成-验证-改进"循环示意:WAM 自生成 rollout,被丢弃的候选与通过验证的经验分流,用于改进 WAM;右侧是 Cosmos3 在模拟(26.9%→68.0%)与真实(20.0%→76.7%)上逐轮平均成功率的柱状对比。
一图看懂全文的问题设定、方法循环和最核心的性能数字,是快速把握论文贡献的入口。