EngiWorld:前沿智能体在专业工程环境中的能力基准 EngiWorld: What Can Frontier Agents Deliver in Professional Engineering Environments?
首个覆盖完整设计闭环的工程智能体基准,最强模型仅得44.3分
前置知识
计算机操作智能体(Computer-Use Agent)
以LLM/MLLM为大脑的智能体,在真实软件环境中通过观察(截图、终端输出)和动作(点击、键入、执行脚本)完成数字任务。它把交互建模为循环:观察 $o_t$ → 推理 → 动作 $a_t$ → 环境转移,直到声明完成或失败。OSWorld、SWE-bench 等基准推动了这一方向。
EngiWorld 评测的对象正是这类智能体,理解其交互循环(观察-动作-反馈)是读懂任务形式化与实验设置的前提。
CAD/CAE/CAM/BIM/EDA 工程领域划分
工业设计软件按阶段分工:CAD(计算机辅助设计,如 SolidWorks、FreeCAD)负责几何建模;CAE(计算机辅助工程,如 Abaqus、ANSYS)负责仿真分析;CAM(如 FreeCAD Path)生成加工刀路;BIM(如 Revit、Archicad)管理建筑信息模型;EDA(如 KiCad、Altium)做电子设计;3D 可视化(如 Blender、ZBrush)处理场景与雕刻。
EngiWorld 的六大域、26 个软件平台和验证器家族都按这一划分组织,各域的伪影格式(STEP、ODB、G-code、IFC、网表)决定了验证方法。
伪影中心评测(Artifact-Centric Evaluation)
不检查智能体的操作轨迹或最终界面状态,而是重开其提交的工程文件(几何模型、仿真结果、网表、G-code、IFC 模型等),用程序化验证器提取属性并与容差约束比对。例如用 CadQuery/OCCT 校验实体几何、用 IfcOpenShell 校验建筑模型、用 odbAccess 读取仿真结果。
这是本文的核心方法论创新:工程伪影"看起来对"不等于"能用",非流形几何或违反物理约束的模型必须由验证器在数据层面判定。
POMDP(部分可观测马尔可夫决策过程)
智能体只能通过观测 $o_t \sim \Omega(\cdot|s_t)$ 看到环境真实状态 $s_t$ 的一部分,需依历史 $h_t$ 选择动作 $a_t \sim \pi_\theta(\cdot|g, o_t, h_t)$。这是交互式决策任务的标准数学框架,OSWorld 等基准均采用类似形式化。
论文用 POMDP 严格定义了工程任务的交互模型(状态、观测、转移、终止条件),是理解第 3.1 节任务形式化的数学基础。
可行性门控的连续评分(Feasibility-Gated Scoring)
对定量设计任务,先检查硬性工程约束 $F_i(Y_T) = \prod_k \psi_{ik}(Y_T)$(几何、材料、载荷、物理响应上限),不可行则 $Q_i = 0$;可行时才按规格达成度计算连续质量分,如归一化改进量 $Q_i = \mathrm{clip}_{[0,1]}\frac{m(Y_T)-m_{base}}{m_{ref}-m_{base}}$。
这区别于传统二值判定:它衡量"任务完成得多好"而非"是否完成",是 EngiScore 指标的构成基础,也是理解定量实验结果的关键。
中性交换格式(Neutral Exchange Formats)
不同工程软件间传递数据的标准格式:CAD 用 STEP/DXF,BIM 用 IFC,制造用 G-code,电路用网表。验证器会重新导入这些文件,因此导出错误(如单位、坐标、实体丢失)会直接影响得分。
多软件任务的核心是中间伪影经这些格式在应用间交接,跨阶段一致性检查和许多失败案例(如 DXF 比例错误)都发生在格式交接环节。
研究动机
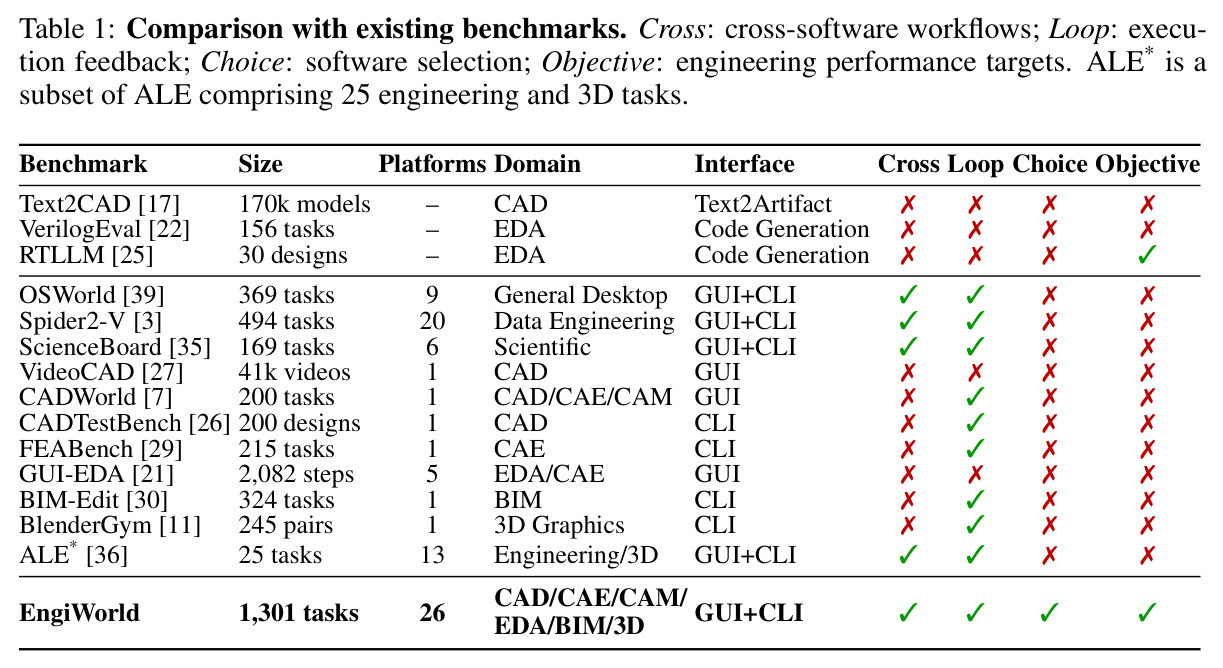
通用计算机操作智能体在网页、办公、软件工程上进展迅速,但在专业工业设计软件上的可靠自动化仍是空白,而现有基准存在三重缺陷。其一,验证能力缺失:OSWorld(369 任务、9 平台)、Spider2-V(494 任务)、ScienceBoard(169 任务)靠比对最终状态或参考解判定成功,无法验证工程伪影的功能完整性——一个视觉上"正确"的 CAD 模型可能因非流形几何、拓扑约束不当或违反物理定律而完全不可用。其二,覆盖面窄且交互浅:FEABench(215 任务,仅 COMSOL)、BIM-Edit(324 任务)、CADTestBench(200 设计)各自局限于单一软件和单一任务格式;Text2CAD 以单轮生成为主,CADWorld 虽引入 GUI 交互但步数上限仅 100 步,无法覆盖工业任务所需的长序列参数化逻辑——早期一个错误会使后续所有操作失效。其三,反馈断层:智能体只能收到文本信号(如编译错误),GUI-EDA 甚至退化为不执行任何动作的离线单步预测;而真实工程师依赖领域工具的原生反馈(渲染输出、仿真收敛曲线、设计规则违规报告)迭代改进设计。真实工程是一个完整设计闭环,而每个已有基准只覆盖其中一环。
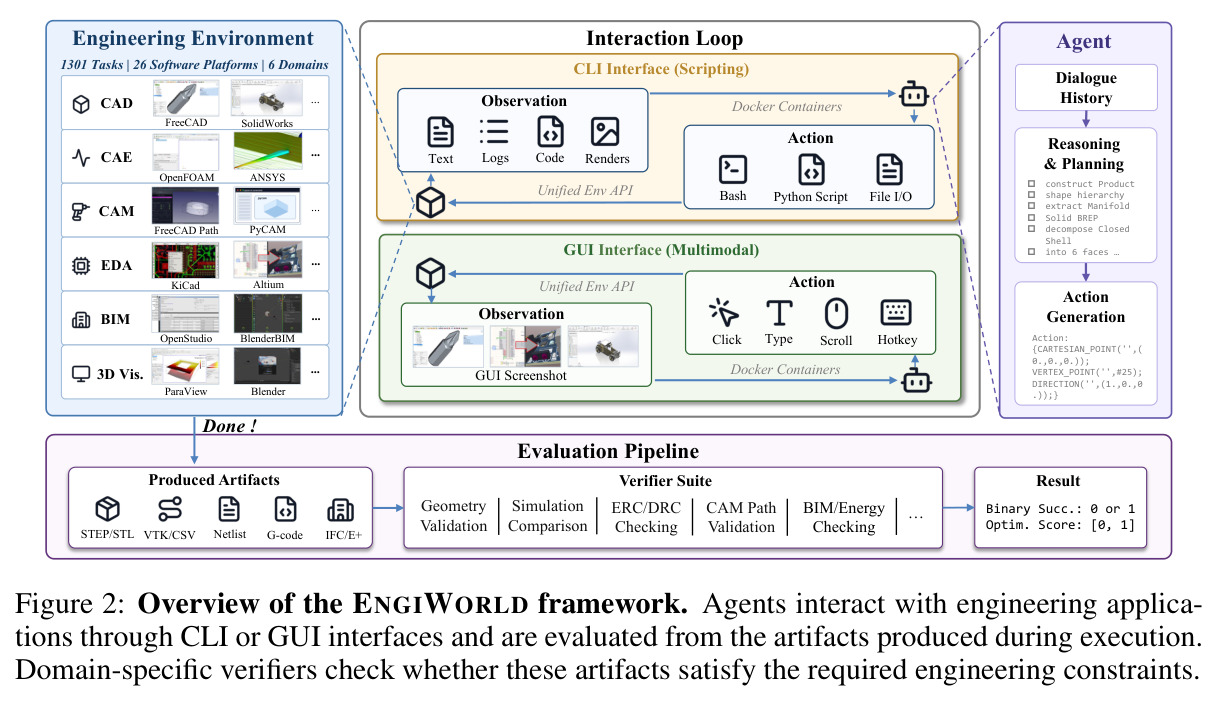
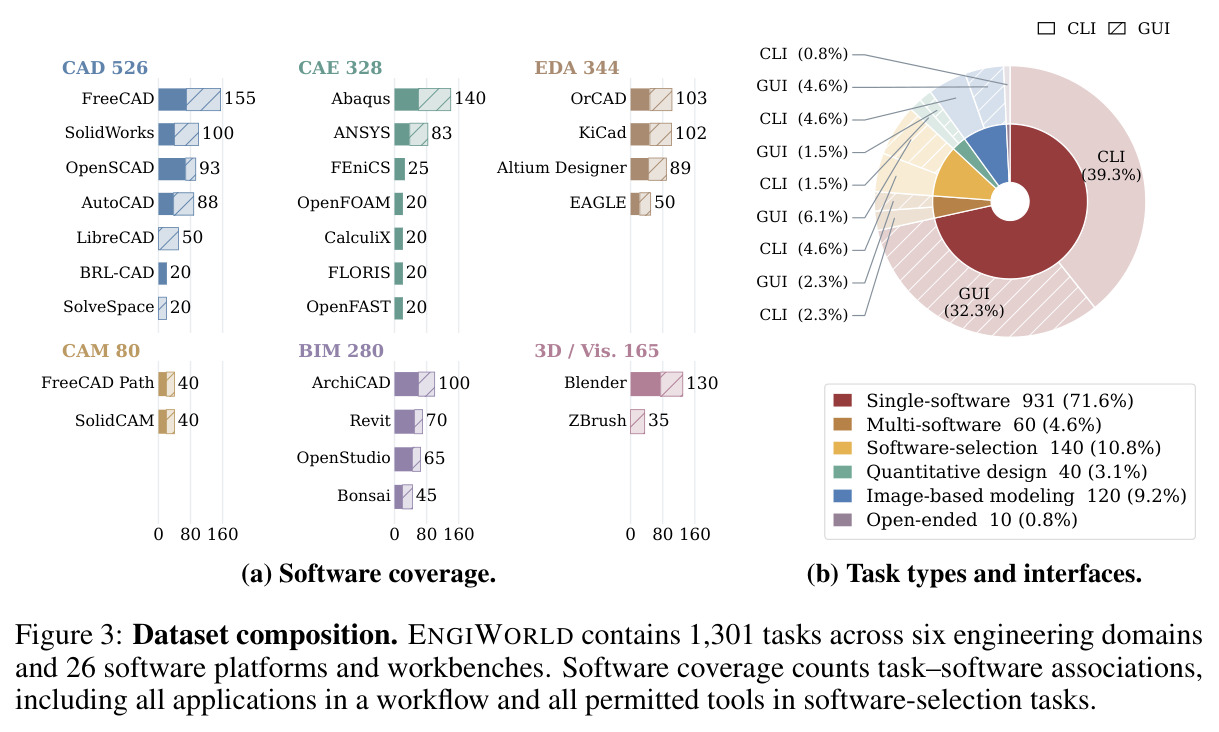
本文的目标是本文要构建第一个围绕完整设计闭环组织的基准 EngiWorld,系统回答"前沿智能体在专业工程环境中究竟能交付什么"。具体目标包括四个层面:(1)覆盖面上,横跨 CAD、CAE、CAM、BIM、EDA、3D 可视化六个工程领域,覆盖 26 个专业软件平台与工作台,包含 1,301 条专家策划的任务,同时支持 GUI 与 CLI 两种交互接口,并设置从软件选择到开放任务在内的 6 种任务类型,覆盖设计过程的全部阶段;(2)评测方法上,建立伪影中心的统一域验证器套件,程序化检查最终与中间伪影(STEP 文件、网表、G-code 等)的几何有效性、物理可行性与规则符合性;(3)评分机制上,对定量设计任务用规格达成度连续评分取代二值成功判定,先经可行性门控再报告质量分;(4)诊断层面上,对多个前沿模型做系统评测与失败分析,刻画通用智能与专业工程需求之间的能力鸿沟。
与已有工作不同的是,本文的独特切入角度是把"真实工程工作是一个完整设计闭环"作为组织原则,而非简单堆砌任务数量。闭环的每个环节——从视觉参考理解设计意图、选择合适的工具、在单一软件内精确构建、达成定量规格、跨工具链交付中间产物、到验证交付物——分别对应一种任务类型,使基准能定位智能体究竟在哪个环节断裂。方法论上的独特之处在于:将伪影级程序化验证从单领域先例(FEABench、BIM-Edit、CADTestBench 各自为战)推广为横跨六域的统一验证器套件,并同时检查最终伪影与中间伪影、以及跨工作流阶段的一致性;评分上引入可行性门控加连续质量分,承认工程产出的开放性与非唯一性(多个不同实现都可合法满足同一规格),而非像通用桌面基准那样只做二值判断。这使 EngiWorld 成为首个既测广度(26 软件、6 域)又测深度(长序列参数逻辑、跨软件依赖)还测质量(连续评分)的工程智能体基准。
核心方法
直觉上,评价工程智能体不该看它"点了哪里",而该看它交出了什么样的图纸、模型、网表或刀路——这些伪影要么满足工程约束,要么不满足,没有含糊空间。技术路线分四步。第一步,任务形式化:每个任务表示为 $\tau_i = (g_i, x_i, e_i, A_i, Y_i, C_i)$,分别是目标、输入、软件环境、可用接口动作、必需交付物和验收标准;交互建模为 POMDP,终止时只对提交的伪影 $Y_T$ 评分。第二步,环境构建:37 个隔离的 Windows/Ubuntu 虚拟机环境(26 个单软件、10 个多软件组合、1 个开放任务环境),每回合从干净快照恢复。第三步,任务构建:专家从软件文档、教程与工程教材中提炼代表性工作流,经 LLM 辅助标准化为可执行任务规格,专家审查后构建参考实现。第四步,评测协议:统一验证器套件重开提交文件提取属性做检查,二值任务要求所有验收判据全部通过($S_i = \prod_{k=1}^{K_i} \phi_{ik}(Y_T)$),定量任务先过可行性门 $F_i$ 再算质量分 $Q_i$,最终按 $\mathrm{EngiScore}(D) = \frac{100}{|D|}\left(\sum S_i + \sum Q_i\right)$ 汇总为 0–100 分。
核心创新是"伪影中心评测 + 可行性门控连续评分"的组合,与已有方法的本质区别有三点。第一,评价对象从轨迹/界面状态转移到工程伪影本身:验证器在任务虚拟机内用领域原生数据模型或格式解析器(CadQuery/OCCT 校验实体、ezdxf 读图纸、IfcOpenShell 读建筑模型、Abaqus odbAccess 读仿真结果)重开提交文件,中性格式(STEP、DXF、IFC)强制重新导入,使导出错误无法隐藏;缺失或不可读的交付物直接判失败。第二,多软件任务的验证器额外检查中间伪影与跨阶段一致性——例如 KiCad→OpenSCAD→FreeCAD→Blender 工作流中,验证器会把板卡标识符和安装孔尺寸与机械地图比对,再验证外壳、装配和审查场景是否保留这些特征,上游伪影缺失则下游判据连带失败。第三,定量设计任务用两阶段评分:可行性门 $F_i(Y_T)=\prod_k \psi_{ik}(Y_T)$ 先筛选工程上合法的设计,只有可行输出才获得按规格达成度归一化的质量分,使"做得有多好"与"是否合法"解耦。此外还有完整性检查机制防止脚本绕过 GUI 作弊。
方法步骤详情
任务构建流水线(Figure A.1)分三个阶段。阶段一,任务构建:领域专家从官方文档、用户指南、教程和工程教材中为每个软件挑选代表性场景,表述为结果导向的任务规格(目标、输入、交付物、约束),AI 辅助统一结构与措辞,专家复核定稿。阶段二,任务实例构建:专家在指定软件中准备初始工程状态并构建经验证的参考实现,多软件任务的中间伪影要保留阶段间依赖;同一规格允许多个合法实现。阶段三,评测标准构建:专家定义属性与容差(几何拓扑、元件布局、间隙、连接性、物理输出、制造约束、跨伪影关系),AI 辅助翻译成任务专属程序化验证器,再用参考实现确认应接受、受控缺陷变体确认应拒绝,最后专家整体审查完整任务包。评测执行时:所有模型在相同的 300 任务分层子集上评测(152 CLI + 148 GUI,覆盖 73 个按软件与任务类型定义的层);GUI 智能体经 PyAutoGUI 以 1920×1080 截图操作,CLI 智能体发终端命令并可用 readimg 检查图像;两者都保留最近 15 轮历史,决策上限 GUI 200 轮、CLI 100 轮(多软件与开放任务增至 300/150 轮);每回合从干净虚拟机快照启动,结束后验证器在任务 VM 内运行。
技术新颖性
技术新颖性可从四个维度分析。覆盖维度:与 Table 1 中 13 个已有基准对比,EngiWorld 是唯一同时具备跨软件工作流、执行反馈、软件选择、工程性能目标四项能力的基准——OSWorld 系列缺后两项,单领域基准(FEABench、BIM-Edit、CADTestBench)缺跨软件与软件选择,ALE 的工程子集(25 任务)虽具备前三项但缺定量目标且规模只有 EngiWorld 的五分之一。验证维度:首次把单领域伪影验证推广为六域统一验证器套件,且经过三重人群校验——96 个参考伪影全部通过、85 个替代合法解全部接受、42 个空提交/仅指标提交全部拒绝(Table B.3)。评分维度:可行性门控的连续评分是工程评测新范式,让部分正确的设计获得部分分数(如 KiCad 布局任务 Gemini 得 0.982),同时保证几何缺陷的输出得零分(Qwen 3.8 Flash 的 RMSE 0.181 但含退化面片得 0)。诊断维度:按终端结局分类失败(DONE 零分、步数耗尽、显式 FAIL、超时、桌面关闭),并用多软件/开放任务配对实验分离"构建能力"与"流程遵守"两种失败根源,这种归因方法本身就是方法论贡献。
实验结果
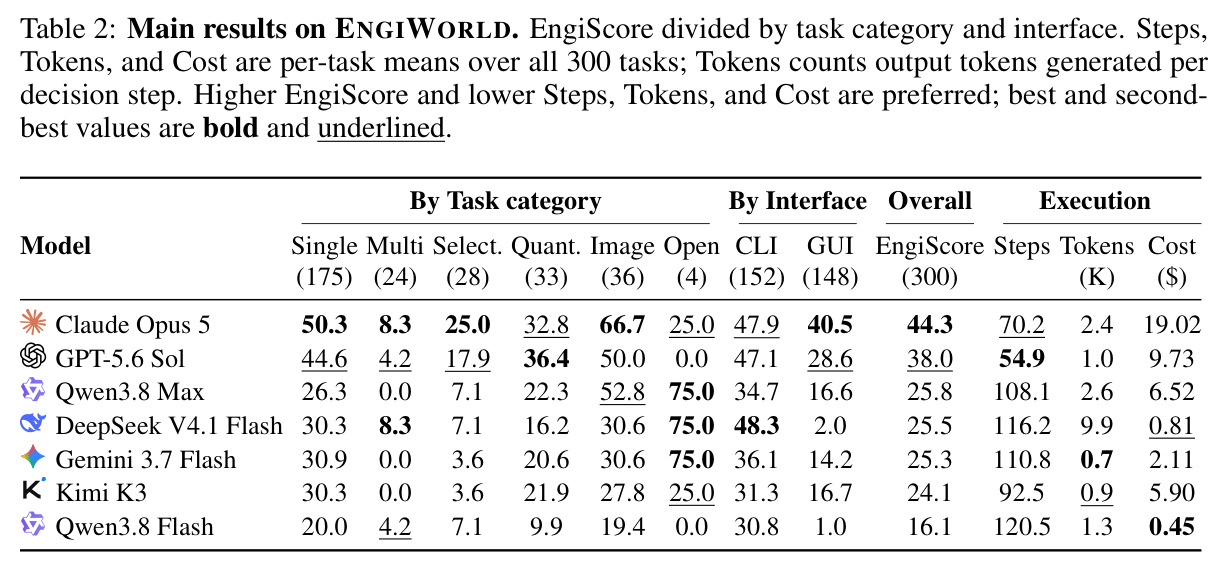
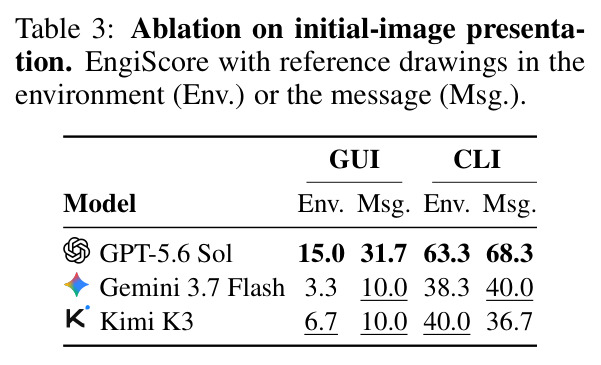
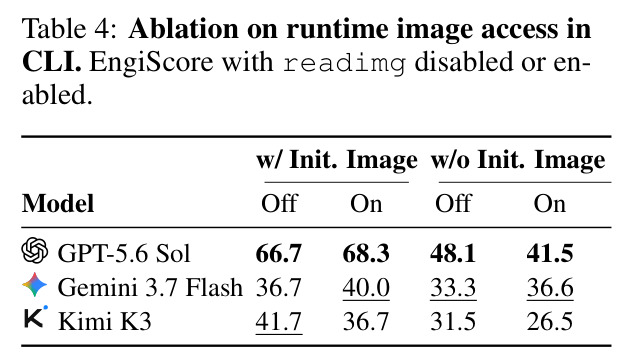
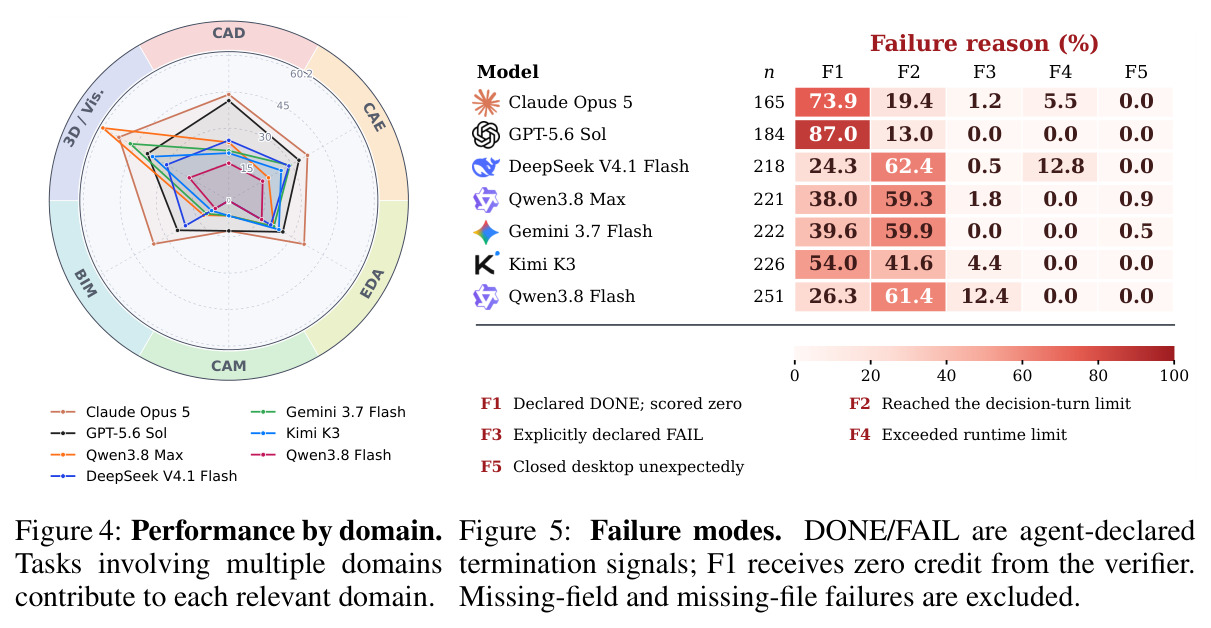
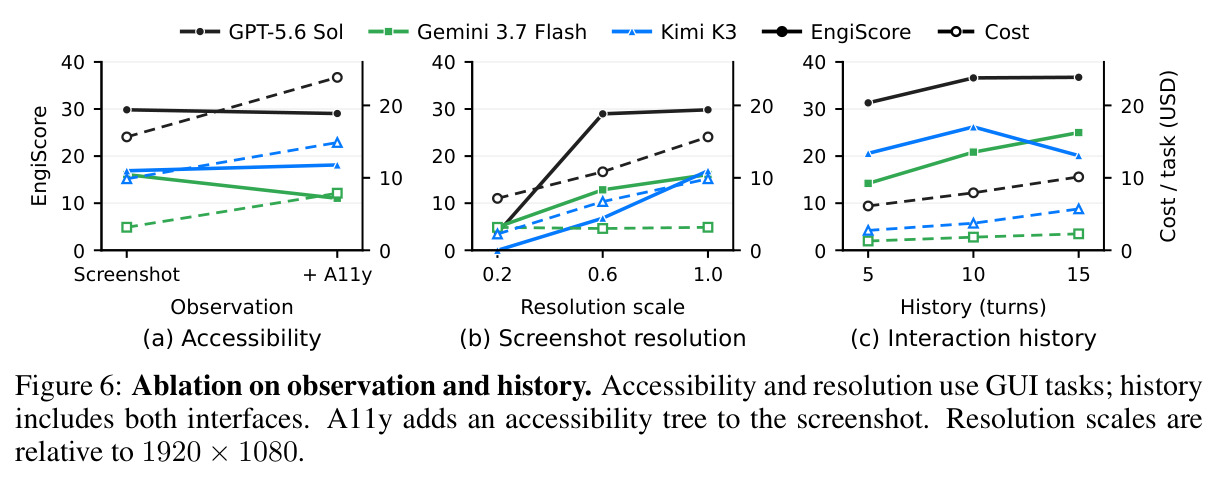
主实验(Table 2)在 300 任务分层子集上评测七个前沿模型:Claude Opus 5 以 EngiScore 44.3 居首(CLI 47.9 / GUI 40.5,成本 $19.02/任务),GPT-5.6 Sol 38.0 次之(GUI 仅 28.6,视觉操作明显弱于命令行);其后是 Qwen3.8 Max 25.8、DeepSeek 25.5、Gemini 25.3、Kimi 24.1、Qwen3.8 Flash 16.1。绝对水平极低:128/300 任务被全部七个模型判零(Figure C.1),仅 29 个被所有模型解决。任务类型断崖分化:Claude 完成约一半单软件任务、约三分之二图像建模任务,但全部模型合计仅 6/168 次多软件尝试成功(3.6%),软件选择 Claude 也只解出四分之一。定量设计 231 次运行中 169 次零分、53 次部分分、仅 9 次满分;Gemini 在 KiCad 布局优化中把加权成本从 64.21 降到 3.21 得 0.982 分,而 Qwen3.8 Flash 虽有 0.181 的曲面 RMSE 却因退化面片被可行性门判零。失败归因(Figure 5、Table D.1):3,347 次失败中 DONE 零分占 49.0%、步数耗尽占 44.8%(合计 94.1%);GPT 87.0%、Claude 73.9% 的失败以"自称完成"收尾,Gemini/Qwen/DeepSeek 更多是步数耗尽;步数耗尽在 GUI 上占 55.3%、CLI 上占 36.6%。消融(Table 3、4、Figure 6):参考图放入消息使 GPT 的 GUI 分从 15.0 升至 31.7;加无障碍树使成本上升 50.7–147.9% 但分数未必提升;原生分辨率对三模型都最优;Kimi 历史从 10 轮延至 15 轮,分数从 26.21 降到 20.12 且成本增 53%。配对实验(Table C.3)最有启发:多软件任务 09 全模型失败,其开放版却有 4 个模型成功——Gemini 的多软件失败仅因交付日志 478 字节低于 500 字节下限,而其开放版用 FreeCAD 脚本 41 步即通过几何检查。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 整体工程任务(300 任务分层子集) | EngiScore(0-100) | Claude Opus 5:44.3(最强) | GPT-5.6 Sol 38.0;其余五模型 16.1–25.8 | 最强模型距工业级可用仍差一半以上;128/300 任务全模型零分 |
| 多软件协作任务 | 成功次数 / 尝试次数 | 全部七模型合计 6/168(3.6%) | 单软件任务 Claude 达 50.3 分 | 跨应用协作比单软件操作难一个数量级,是设计闭环断裂点 |
| GUI 界面任务(148 任务) | EngiScore | Claude 40.5(最高) | DeepSeek 2.0、Qwen3.8 Flash 1.0 | CLI 强不代表 GUI 强:DeepSeek CLI 得 48.3 却只成功 3 个 GUI 任务 |
| 定量设计任务(33 任务) | EngiScore(可行性门控连续分) | GPT-5.6 Sol 36.4(含 5 次满分) | Qwen3.8 Flash 仅 9.9(29/33 零分) | 231 次运行仅 9 次满分,可行性门控否决了大量几何缺陷输出 |
| 软件选择任务 | EngiScore | Claude 25.0(最高) | Gemini/Kimi 仅 3.6 | 为任务选对工具本身仍是未解难题 |
| 验证器有效性校验 | 接受/拒绝正确率 | 96 参考伪影全部通过,85 替代合法解全部接受 | 42 个空提交与仅指标提交全部拒绝 | 证明验证器既不误杀合法方案也不放过违规交付 |
局限与改进
作者承认的局限包括:出于成本控制只在 300 任务分层子集上评测(其余 1,001 个任务未报告模型结果),每层仅 4–5 个任务使层级粒度的统计功效有限;开放式任务仅 10 个(主评测只含 4 个),其结论(如"放开流程约束反而提升成功率")样本量过小;消融结论高度依赖模型——readimg 对 Gemini 有益对 Kimi 有害、无障碍树对三者方向不一,作者只能给出假设而非机理。我自己的观察补充四点:其一,验证器只能检查可程序化的属性,视觉美学、设计意图契合度等主观质量无法覆盖,定量任务的 $Q_i$ 定义依赖任务作者设定的基线 $m_{base}$ 与参考 $m_{ref}$,存在人为性;其二,模型间成本比较(如 DeepSeek 每步 9.9K token vs Gemini 0.7K)混合了定价策略与行为差异,跨厂商价格变动会让结论失效;其三,软件版本固定(如 FreeCAD 0.21.2、Blender 4.2.3),结论对版本升级的鲁棒性未知,且商业软件许可证使社区复现和扩展任务集受限;其四,任务构建经"专家+LLM"流水线,任务分布偏向文档与教程中的典型工作流,可能低估真实工业中混乱、非标准的工程场景难度。
独立分析的弱点
独立分析有五个可操作的弱点。第一,自我验证能力缺失是最大瓶颈:近半失败(49.0%)以"自称 DONE 但验证器判零"告终,GPT 的失败中 87% 属于此类——智能体无法从可见的软件状态判断工程正确性。改进方向:挂载轻量自检工具(导出后自动跑几何检查脚本),或训练过程奖励模型在 DONE 前评估伪影。第二,跨软件交接极度脆弱:一个 CSV 字段名差异(hole_dia_mm vs hole_diameter_mm)就让含 18 个文件的完整交付全盘判零;AutoCAD 导入比例错误在崩溃后复发,耗尽 300 轮。改进方向:标准化中间伪影交接 schema,让验证器接受等价别名。第三,物理语义理解错误:SolidWorks→Abaqus 案例中智能体用 −11.111 MPa 压力近似 1 kN 集中力,因评测器按原生力参数检查而判失败——模型缺乏"压力×面积=力"的量纲换算意识。第四,GUI 交互远落后于 CLI(Qwen3.8 Flash GUI 仅 1.0 分),且误操作具毁灭性:LibreCAD 案例中一次 Ctrl+A+Delete 清空了整个图纸。改进方向:专业软件 GUI 的 grounding 训练与高危操作确认机制。第五,反馈利用不足:智能体经常忽视求解器残差等关键信号,延长历史反而让 Kimi 变差,说明问题不在信息量而在信息筛选策略,值得研究自适应的反馈过滤与自检时机。
未来方向
作者提出将 EngiWorld 作为工业智能体研究的严格基础,方向是让智能体"超越操作单个工具,闭合工程设计环"。基于本文成果可延伸的方向包括:(1)把验证器套件改造成训练信号——可行性门 $F_i$ 天然是二值奖励、$Q_i$ 是稠密奖励,可直接用于强化学习或拒绝采样微调,解决 DONE 零分问题;(2)构建工程领域的过程奖励模型,在中间伪影(STEP 文件、网表)上训练验证器,弥补智能体无法自检的短板;(3)研究跨软件交接协议:本文证明交付义务(日志格式、文件命名)与几何能力是可分离的失败源,标准化 agent-to-agent 交接格式可能以极低成本释放多软件成功率;(4)GUI 专业软件的视觉 grounding 与无障碍树融合策略,消融显示两者收益模型相关,值得做条件计算或自适应选择;(5)把设计闭环向前向后延伸:向前接需求工程(从模糊客户需求生成规格),向后接制造验证与现场反馈迭代;(6)扩展到本文未覆盖的领域(如结构优化、芯片版图物理设计)并随软件版本迭代维护基准;(7)成本效率研究:Claude 以近两倍于 GPT 的成本换 6.3 分提升,值得探索测试时算力分配与早停策略。
复现评估
复现评估总体中等偏难。有利条件:项目页 engiworld.github.io 公开,附录极为详尽——Table B.1 列出全部 37 个环境的软件版本与操作系统,Table B.2 给出验证器家族的属性与判据,附录 B.3 说明验证器三方校验协议,任务包(指令、初始文件、参考实现、验证器)结构标准化。主要障碍有三:其一,环境依赖商业软件许可证——AutoCAD 2024、SolidWorks 2025、ANSYS 2026R、Abaqus 2025、Revit 2025、Archicad 27、Altium 等需正版授权,个人研究者难以凑齐 26 个平台;其二,费用高昂——单模型评测 300 任务,Claude 均摊 $19.02/任务(约 $5,700),且 DeepSeek 有 28 次、Claude 有 9 次运行触及 5 小时单任务上限,完整复现七个模型需数万美元 API 费用和大量虚拟机算力;其三,工程繁琐——37 个 Windows/Ubuntu 快照的维护、PyAutoGUI 自动化的稳定性、验证器在 VM 内调用原生 API 都需要熟练的 DevOps 与领域软件知识。建议路径:先用开源子集(FreeCAD、KiCad、OpenSCAD、Blender、OpenFOAM、CalculiX 等 Ubuntu 环境)低成本复现,再按需扩展到商业软件环境。
论文图表
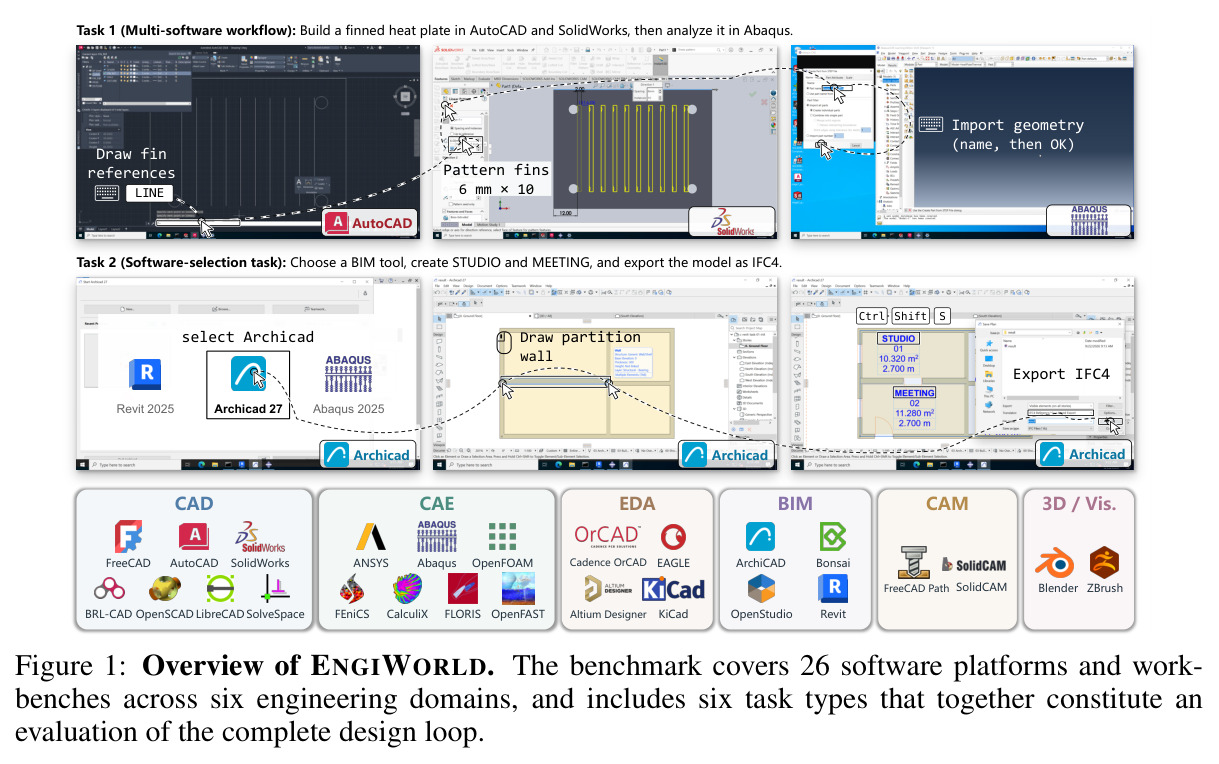
基准总览图:上方展示两个任务示例——多软件工作流任务(在 AutoCAD 画肋板、SolidWorks 建模、Abaqus 分析散热板)和软件选择任务(从 Revit/Archicad/Abaqus 中选 BIM 工具建房间并导出 IFC4);下方矩阵展示六个工程域(CAD、CAE、EDA、BIM、CAM、3D/可视化)及其 26 个软件平台。
一图看懂基准的广度设计:六域、26 软件、6 任务类型如何共同构成完整设计闭环的评测,是论文的招牌总览。
各模型失败原因分布表与条形图(n 为各模型分析失败的运行数):F1 声称 DONE 但判零、F2 步数耗尽、F3 显式 FAIL、F4 超时、F5 意外关闭桌面。GPT 的失败 87.0% 是 F1,Claude 73.9%;DeepSeek/Gemini/Qwen 的 F2 占 55-62%;DeepSeek 有 12.8% 超时(28 次触及 5 小时上限)。
失败模式是论文诊断分析的核心:"自称完成却判零"与"步数耗尽"两类合计 94.1%,分别对应验证阶段和构建阶段的闭环断裂,直接指明改进方向。
任务构建流水线图:从代表性工程场景出发,经任务构建(规格制定与专家审查)、任务实例构建(初始状态、参考实现、多软件中间伪影)、评测标准构建(属性容差定义与验证器生成)三个阶段,全程穿插专家评审与验证。
说明 1,301 个任务的质量是如何保证的:专家+LLM 协作、参考实现校准、缺陷变体测试,理解数据可靠性必看此图。
全部 37 个环境配置表:26 个单软件环境(含软件名、精确版本号、操作系统、支持接口,如 FreeCAD 0.21.2/Ubuntu、AutoCAD 2024/Windows、Abaqus 2025L/Windows、KiCad 10.0.2/Ubuntu)、6 个多软件组合环境(如 AutoCAD+SolidWorks+Abaqus)、4 个软件选择组合环境、1 个开放任务环境。
复现该基准的环境清单,也直观展示了工程软件生态的商业/开源构成(Windows 商业软件 vs Ubuntu 开源工具链)。
六个验证器检查家族的代表属性与判据:全局几何(包围尺寸、体积、表面积、实体有效性)、局部几何(基准坐标系下指定截面轮廓,容差如 0.005–0.08 mm)、实体-空腔占用(材料、腔体、通孔,残余材料 ≤0.1 mm³)、工程指派(材料/载荷/边界条件/热区)、仿真输出(场量与物理响应的误差界)、结构关系(网络连接性、实体角色、跨文件引用的精确检查)。
伪影中心评测的具体化:数值容差与精确检查如何落地,是理解验证器严谨性的关键表格。
验证器校验结果表:96 个参考伪影全部被接受;80 个替代合法解(Abaqus/ANSYS CLI/GUI 各 40、FreeCAD 轻量化设计 5)全部被接受;42 个应拒提交(空交付 21、只有指标没有伪影 21)全部被拒绝。零误杀零漏判。
验证器是整套评测的裁判,此表证明裁判本身可靠——既不冤枉合法的多解方案,也不放过敷衍的提交。
两个条形图:左图显示 300 任务中 128 个全模型零分、29 个全模型解决、37/35/24/24/10/13 个分别由 1-6 个模型解决;右图分解 128 个全零任务的构成——单软件 65、多软件 22、软件选择 18、定量设计 12、图像建模 10、开放任务 1;CLI 40 vs GUI 37。
打破"失败都集中在难题型任务"的直觉:大量单软件任务也没人能解,说明差距是普遍性的而非仅跨软件协作导致。
定量设计任务(每模型 33 任务)的得分分布:231 次运行中 169 次零分、53 次部分分、9 次满分。GPT-5.6 Sol 最佳(EngiScore 36.4,5 次满分),Claude 32.8(4 次满分),Gemini/Kimi/Qwen Max 虽有 9 次部分分却零满分,Qwen3.8 Flash 29 次零分。
展示可行性门控连续评分的实际效果:部分分数能区分"合法但平庸"的设计,而满分稀缺说明达到规格要求极难。
两个代表性定量任务的细节数据:KiCad task 01 布局优化中 Gemini 加权成本 3.2135、走线 40.1688 mm、间距 4.6174 mm、0 过孔,得 0.982(基线 0.647);ZBrush task 04 曲面拟合中 GPT RMSE 0.07650 得 0.892、Gemini RMSE 0.15098 得 0.804,而 Qwen3.8 Flash RMSE 0.18097 但因退化面片/重叠三角形被判 Invalid 得 0;GPT task 05 因覆盖率 94.75% 低于 98% 要求得 0。
最直观地演示可行性门控如何工作:近似精度不能补偿拓扑缺陷——这是工程评测与一般生成评测的本质区别。
配对任务设计图:任务 02(稳压器散热夹包,117.2×75.2×18.6 mm 外壳,硬约束含接触柱距 U1 0.1 mm 内、L1 禁布区、C1 上方 2.4 mm 间隙)和任务 09(热像仪标定板 PCB 支架,131×105×25.1 mm,每个加热器开孔 ≥99% 开放且边缝 ≥10 mm),两者都有多软件版(规定 KiCad→OpenSCAD→FreeCAD→Blender 流程、18 个交付物)和开放版(只验最终 STEP 装配)。
展示了巧妙的对照实验设计:同一工程目标、不同交付要求,用于分离"几何构建能力"与"流程遵守能力"两种失败。
配对任务结果表:多软件版任务 02 和 09 全部七个模型失败(8 个 0);开放版任务 09 有四个模型成功(Claude、Gemini、Qwen3.8 Max、DeepSeek 均 1),开放版任务 02 仍全失败。Qwen3.8 Max 在开放版仅用 30 步完成,而其多软件版耗尽 150 步仍缺必需文件。
全文最有洞察力的结果:放开流程约束后成功率大幅上升,证明许多多软件失败源于交付义务(日志格式、中间文件)而非几何能力不足。
四个成功的 GUI 单软件案例流程图:KiCad 中标注 DATA0–DATA7 建立 MCU-SRAM 一对一映射并解决全部电气错误(0 电气错误);AutoCAD 用 5×3 与 4×2 两个矩形阵列组合出 23 个交错管孔并导出 DXF;SolidWorks 用 Profile Center 配合居中滑块并导出含两个独立实体的 STEP;Blender 烘焙 512×512 环境光遮蔽图、打包图像并保存场景。
展示智能体当前能做什么:在参数化操作清晰、验证规则明确的单软件任务中,前沿模型可以可靠交付,为能力边界提供了具体样本。
全部实验 3,347 次失败的分类统计:DONE 但零分 1,641 次(49.03%)、步数耗尽 1,499 次(44.79%)、显式 FAIL 167 次(4.99%)、超时 37 次(1.11%)、智能体关闭桌面 3 次(0.09%)。前两类合计 93.8%。
给出失败的全景分布,支撑"验证缺位与执行超限是两大断裂点"的核心诊断,是设计改进方案的问题清单。
主评测 300 任务上各模型 1,487 次失败的五类分布:GPT 184 次失败中 160 次是 DONE 零分;Qwen3.8 Flash 251 次失败中 154 次是步数耗尽、31 次显式 FAIL;DeepSeek 218 次失败含 136 次步数耗尽和 28 次超时;Claude 有 9 次超时和 2 次显式 FAIL。
揭示失败风格的模型差异:推理强的模型倾向"过早宣布完成",较弱的模型倾向"磨到超时"——两种失败需要完全不同的改进策略。
按接口分解的失败构成条形图:636 次 CLI 失败中 DONE 零分占 59.7%、步数耗尽占 36.6%;851 次 GUI 失败中步数耗尽占 55.3%、DONE 零分占 37.0%。
接口维度上的失败机制截然不同:CLI 的瓶颈是"不知道自己错了",GUI 的瓶颈是"操作太慢做不完"——提示 GUI 效率是独立的研究问题。
四个"声称完成但验证器判零"的具体违规案例:Gemini 的 OpenSCAD 微流控盖子从错误面切通道导致材料与空腔状态反转;Gemini 的 V 槽皮带轮在基准坐标系下槽根与截面不达标;Gemini 的四软件工作流中机械地图的安装孔角色与源板不一致;GPT 的开放任务中 MH1 孔残留 3.70 mm³ 材料超出 0.1 mm³ 容差。
用实例证明"智能体自以为的成功"与"工程验证的成功"之间的鸿沟——几何细节错误在软件界面上完全不可见,只有程序化验证能抓住。
四个多软件失败案例的动作-伪影-结果对照图:(1) SolidWorks→Abaqus 中用 −11.111 MPa 压力替代 1 kN 集中力,ODB 已产出但负载表示不匹配判零;(2) AutoCAD→SolidWorks→Abaqus 中 10000 µm 导入比例错误在崩溃后复发,300 轮网格化失败无解;(3) LibreCAD 中一次 Ctrl+A+Delete 误清空图纸,DXF 缺 8 个窗口;(4) KiCad CLI 写的 CSV 用 hole_dia_mm 字段名而验证器要求 hole_diameter_mm,第 7 步即断链。
多软件失败不是抽象概念:负载语义、单位换算、误操作、命名约定——每一类都是可定位、可修复的工程问题,为后续研究提供了具体的失败原型库。