CADWorld:面向长程计算机辅助设计的计算机使用基准 CADWorld: Computer-Use Benchmark for Long-Horizon Computer-Aided Design
200个FreeCAD长程CAD任务上,最强智能体仅17.5%成功,人类专家87%
前置知识
计算机使用智能体(CUA)
以屏幕截图为观测、以鼠标点击/键盘输入为动作、直接操作图形界面的通用智能体,不调用软件专用 API 或命令行。典型代表是 OpenAI 的 computer-use 模型和 Claude 的 computer tool,它们把屏幕像素映射为 pyautogui 等可执行的 UI 操作序列,通过观察-行动循环逐步完成任务。
CADWorld 的全部 200 个任务都要求智能体像人一样操作 FreeCAD 图形界面,理解 CUA 的观测-动作循环是理解实验设置、动作空间和失败分析的前提。
参数化 CAD 与特征树
参数化 CAD 把模型记录为可编辑的构建历史:草图→尺寸/几何约束→特征(拉伸、圆角、阵列等)→装配关系,每个对象都携带参数与依赖关系。特征树保存后,工程师可以随时回到早期步骤修改尺寸或草图,下游特征会自动重建更新。
CADWorld 的核心评判标准是保存的 .FCStd 原生文件是否保留正确且可编辑的参数化结构,而不是最终几何看起来对不对;不理解特征树就无法理解论文中『构建过程错误』这类失败模式。
FreeCAD 与工作台(Workbench)
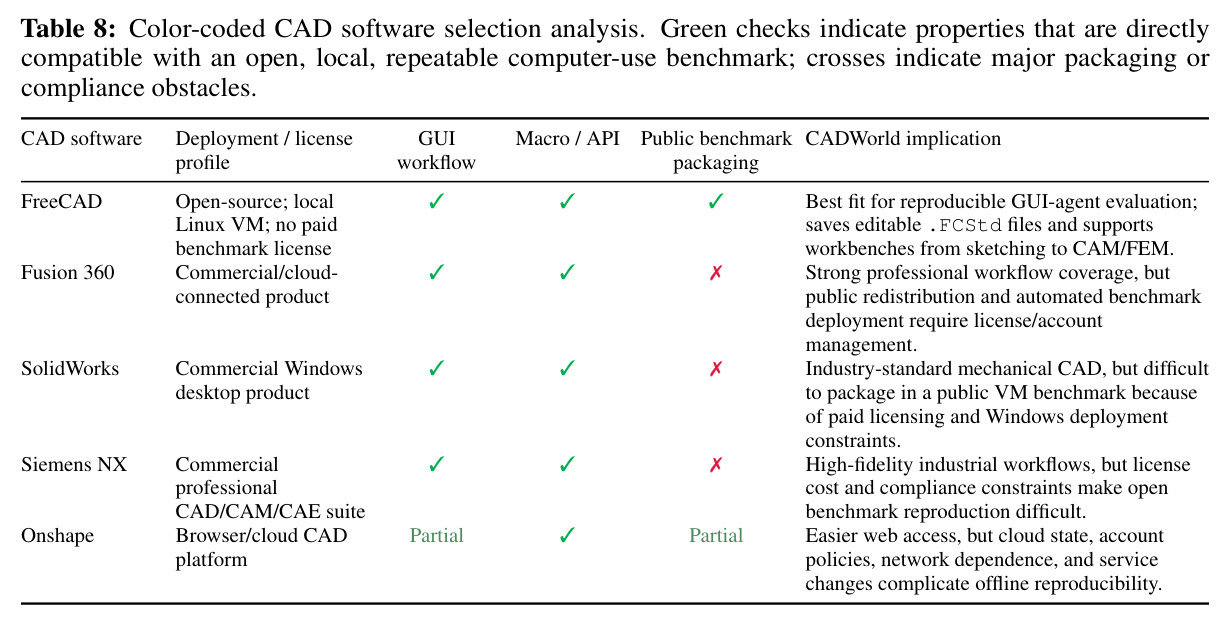
FreeCAD 是开源参数化 3D 建模器,按功能划分工作台:Sketcher(草图)、Part/PartDesign(零件)、Assembly(装配)、CAM(加工)、FEM(有限元)、Mesh、TechDraw(工程图)等。项目保存为 .FCStd 文件,既有人工图形界面又支持 Python 脚本读写,可自由再分发。
它是本基准的唯一环境,11 个任务类别正对应其工作台;作者选 FreeCAD 正是看中其开源、免许可、可打包进本地 VM 的可复现性。
草图约束与全约束
二维草图通过尺寸约束(长度、半径、角度)和几何约束(重合、相切、平行、垂直等)定义形状;当自由度被全部消除时称为全约束(fully constrained)。欠约束的草图几何会随求解器或后续操作漂移,导致形状意外变化。
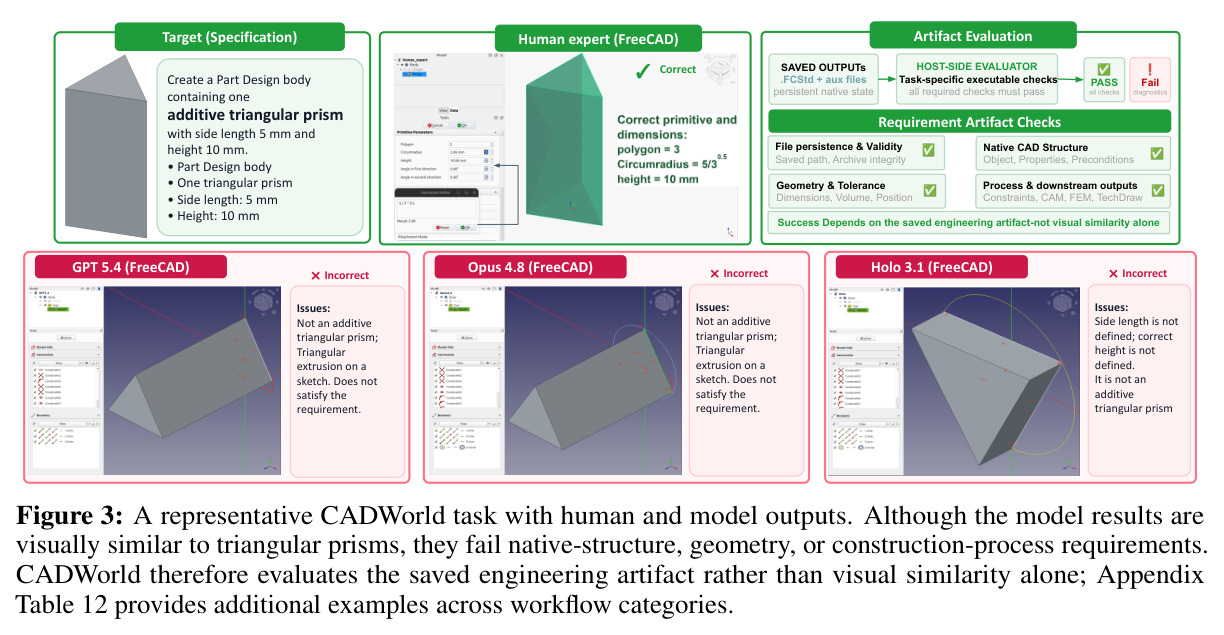
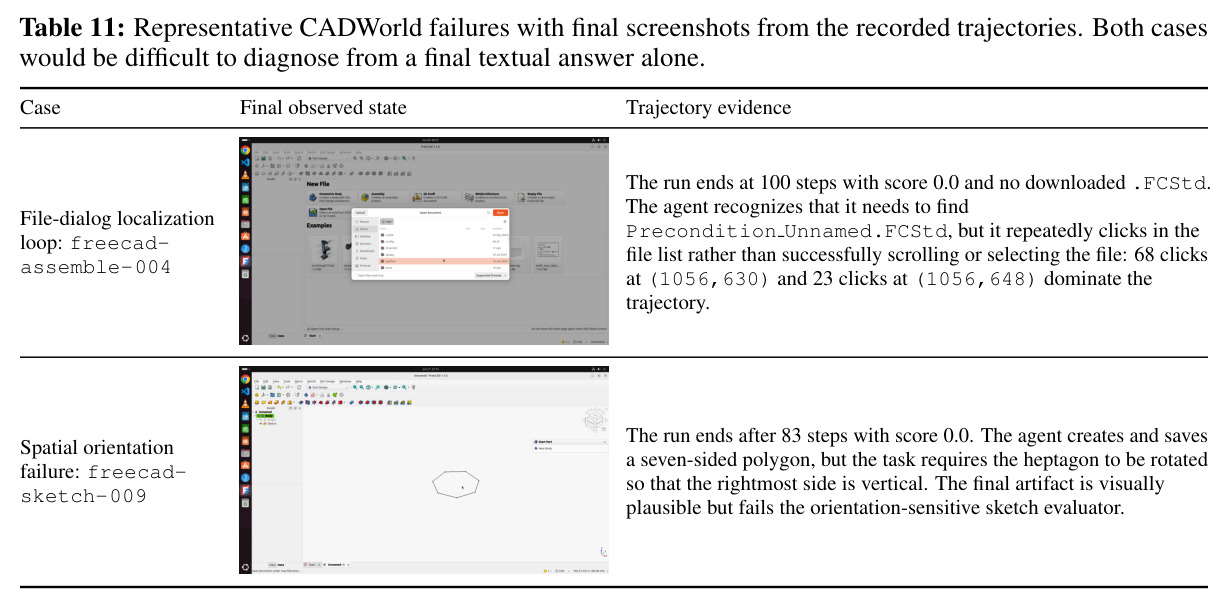
评估器会解析草图实体与约束来判断任务是否达标;论文中的失败案例(如七边形方向错误)正是约束和方向没有保住的典型表现。
CAM 与 FEM
CAM(计算机辅助制造)在毛坯(stock)上规划刀具路径并做材料切除仿真,验证过切/欠切;FEM(有限元分析)对模型施加材料、载荷与边界条件后求解应力/位移并导出结果数据。两者的关键中间状态(路径对象、求解器、边界条件)大多不在屏幕上直观可见。
CAM/FEM/TechDraw 是所有被测模型成功率全部为 0% 的类别,理解其『中间状态不可视』的特点才能解释为何通用 GUI 能力迁移不过去。
POMDP(部分可观测马尔可夫决策过程)
智能体无法观察完整环境状态,只能获得部分观测(截图、轨迹摘要),每步发出动作使隐状态发生转移,奖励在终止时刻给出。论文用元组 $(S, O, A, T, R_i, H_i)$ 将每个 CAD 任务形式化为 POMDP,隐状态包含 FreeCAD 应用、文档与文件系统的全部状态。
论文将奖励定义为终局工件评估 $R_i(s_\tau) = e_i(\phi(s_\tau)) \in \{0,1\}$,这是理解其『工件锚定评测』区别于通用桌面基准的形式化关键。
研究动机
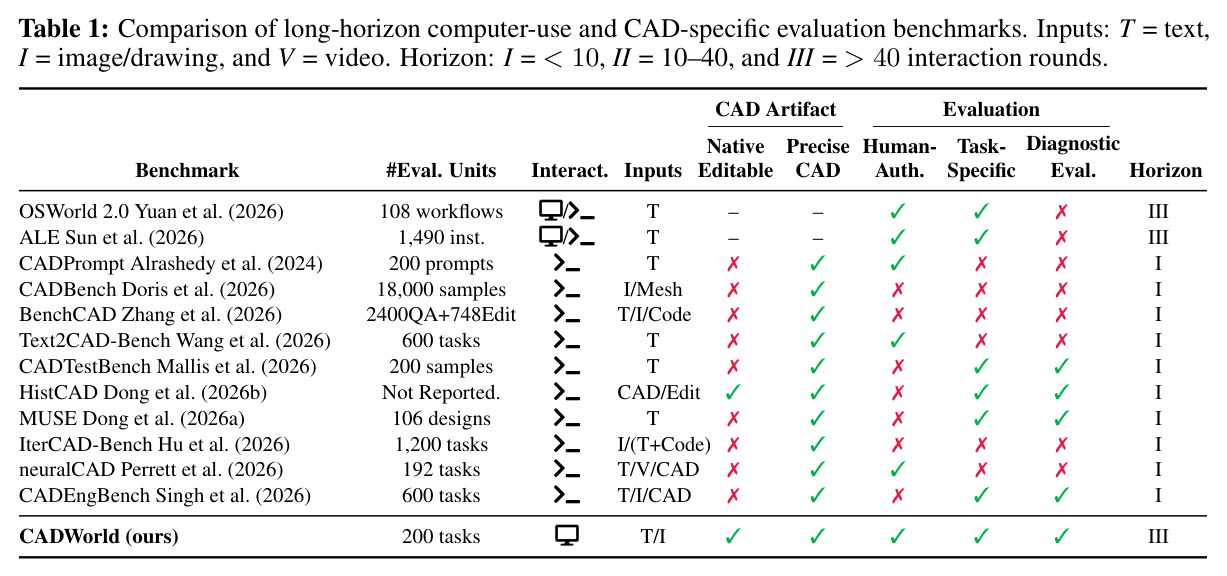
现有计算机使用基准(Mind2Web、WebArena、OSWorld、OSWorld 2.0 的 108 条长工作流、Agents' Last Exam 的 1490 个任务等)已系统覆盖网页与桌面操作,但机械 CAD 在其中只占零星子集,无法考察草图约束、参数化建模、装配、CAM、FEM、技术图纸等领域知识是否真正被掌握。另一条线的 CAD 专用基准(CADBench 18000 样本、BenchCAD、Text2CAD-Bench 600 任务、CADTestBench 200 样本等)评测的是模型生成的 CAD 代码或几何,交互轮数集中在 Horizon I(小于 10 步),产物多为扁平 STEP/网格或可重跑脚本:既不要求在原生工程环境里直接重开并修改早前的草图/特征/约束,也不提供任务级可执行诊断。结果是『通用 GUI 能力』与『可靠执行持久、可验证的工程工作流』之间的鸿沟无人度量——一个能在桌面基准上熟练点击按钮的模型,完全可能在 CAD 里选错工作台、留下欠约束草图、把尺寸填进错误的输入框,产出看似正确却不可编辑、不可测量的废件。
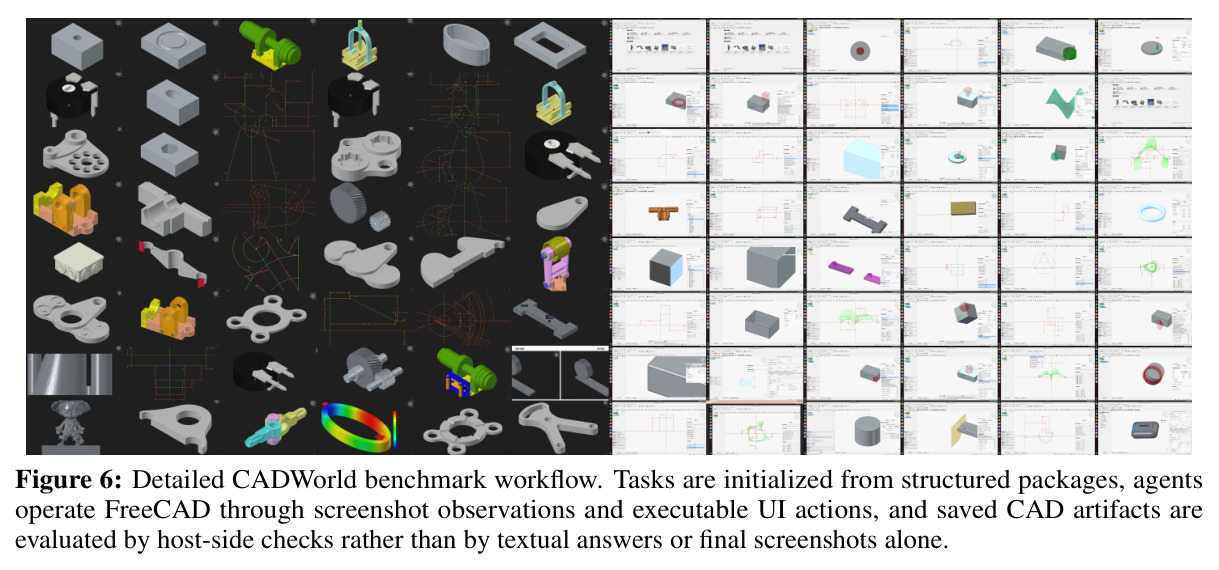
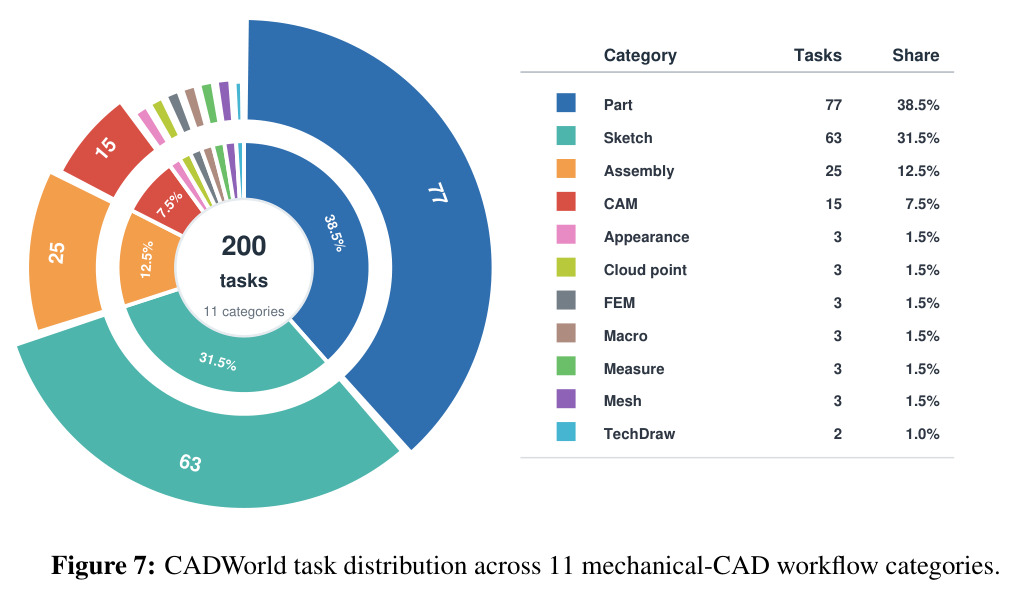
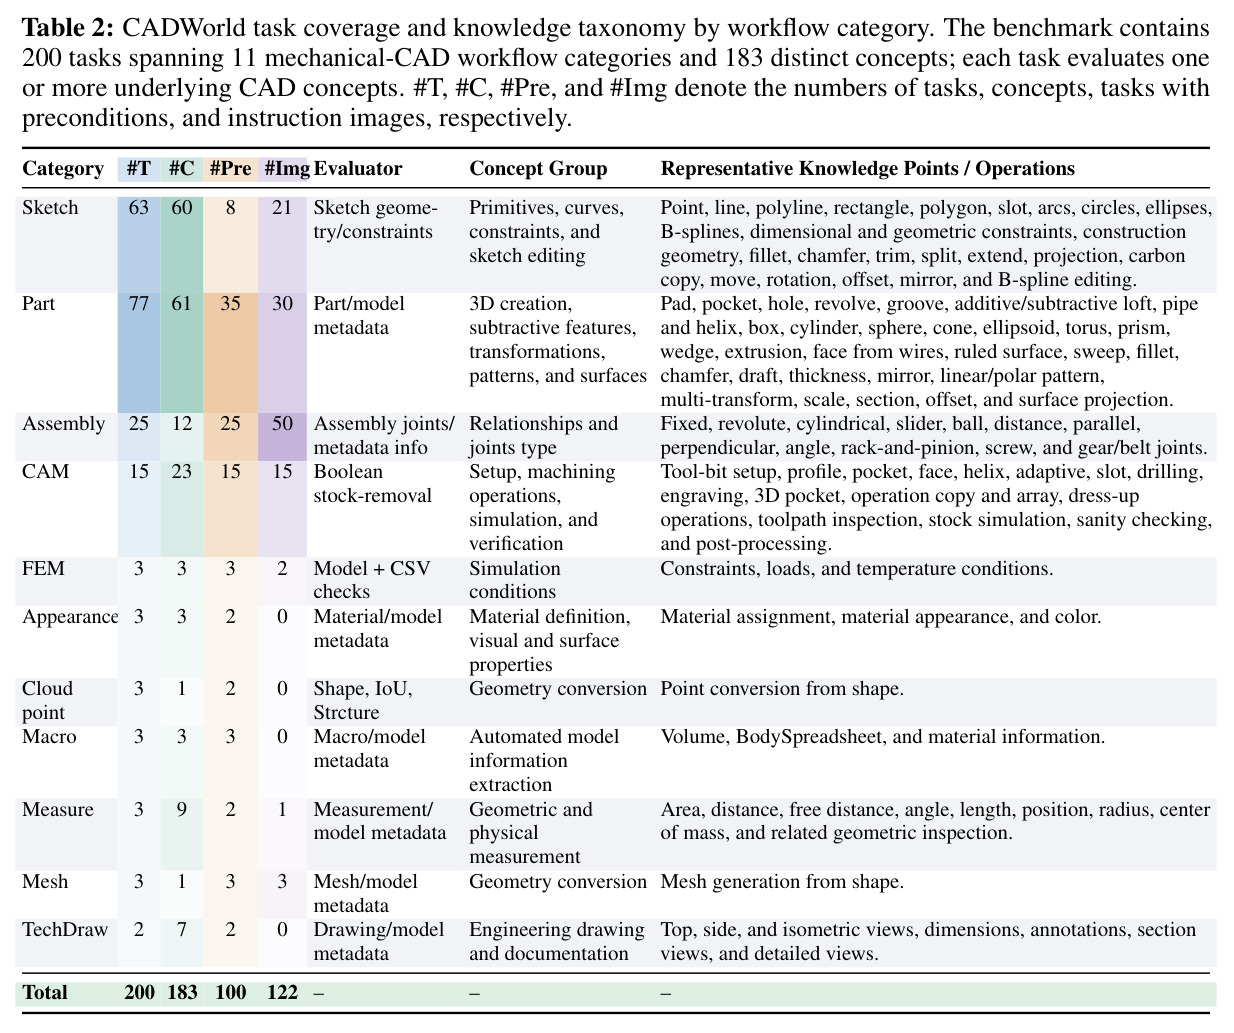
本文的目标是本文的目标是构建并开源 CADWorld:一个以 FreeCAD 为唯一载体的长程计算机使用基准,包含 200 个任务、11 个机械 CAD 工作流类别(Sketch 63、Part 77、Assembly 25、CAM 15、FEM/外观/点云/宏/测量/网格各 3、TechDraw 2)和 183 个知识点,覆盖建模、装配、制造、仿真、检查与文档全链路。每个任务由自然语言指令(中位数 63 词,最长 178 词)、初始应用状态、可选参考资产和可执行评估器组成;智能体只能通过截图和 pyautogui 类 GUI 动作操作,成功与否由保存的 .FCStd 原生工件经任务专用检查(几何属性、参数化结构、约束、制造状态、仿真结果)二值判定。在此之上,作者用 7 个当代智能体实测,给出效率指标(步数、token、费用)与 11 类确定性失败归因,定量刻画当前 CUA 与可靠工程自动化之间的差距。
与已有工作不同的是,本文的独特切入有三点。第一,作者论证 GUI 不是可替换的前端:CAD 的工程状态本身就通过视口、特征树、约束标注、选择高亮等可视化载体表达,『从工作区识别相关工程状态→决定如何修改→验证修改后果』正是交互式 CAD 的核心工作,把结构化状态直接喂给脚本会抽象掉这一关键环节。第二,评测对象从答案字符串或瞬时屏幕状态换成持久原生工件:两个模型的产出可能视觉相似,却在尺寸、约束、特征历史、对象层级、制造与仿真状态上完全不同,只有能被重新打开、测量、继续编辑的 .FCStd 才算成功。第三,它首次把通用 CUA 的长程 GUI 执行(Horizon III,大于 40 轮)与 CAD 专业知识放进同一基准联合评测,并配上无需 LLM 裁判的 F1–F11 确定性失败诊断——Table 1 显示此前没有一个基准同时满足『原生可编辑 + 精确 CAD + 人工出题 + 任务专用 + 诊断式评测』这五项。
核心方法
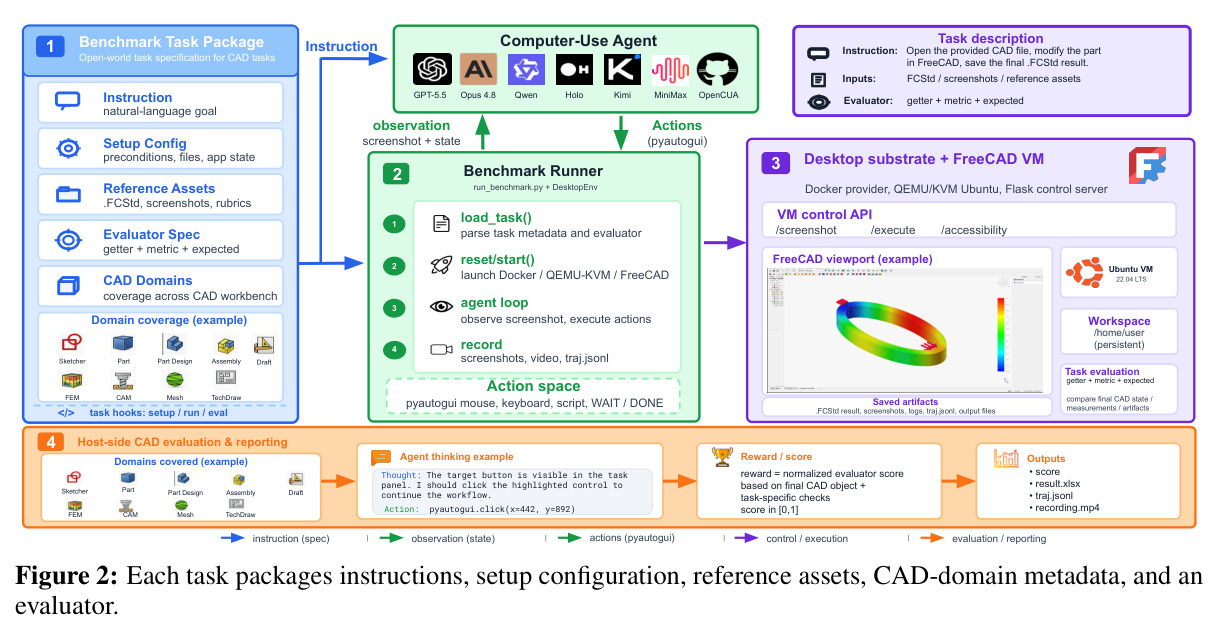
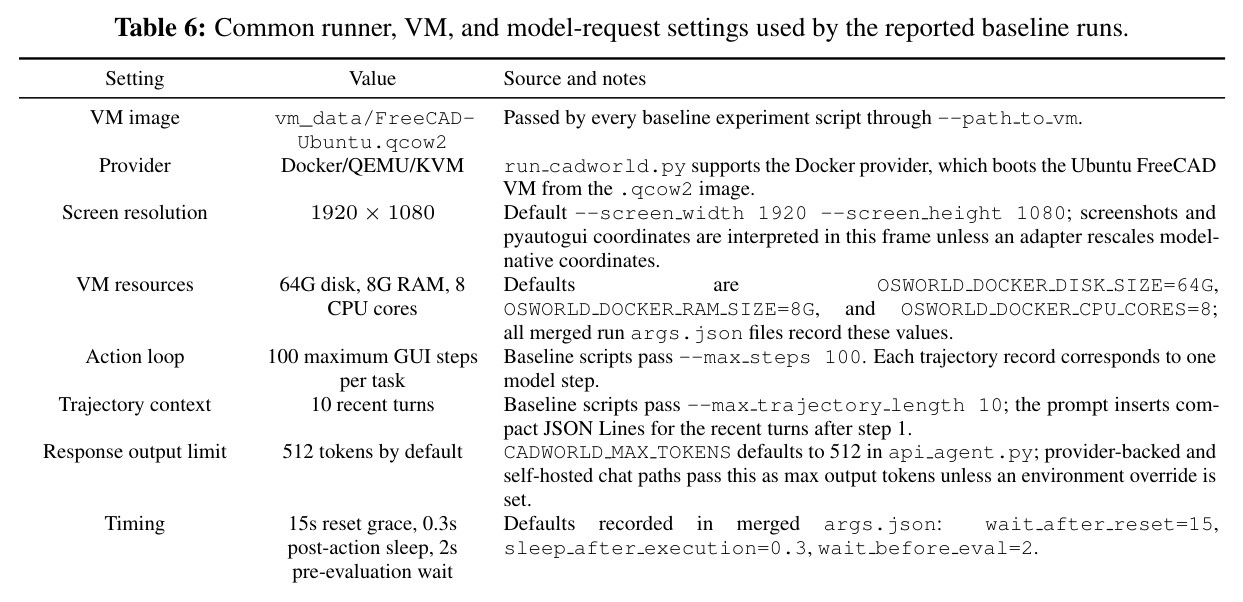
CADWorld 把每个任务形式化为 POMDP:任务实例是五元组 $x_i = (\iota_i, p_i, u_i, e_i, H_i)$,即自然语言指令 $\iota_i$、可选前置 .FCStd 文件 $p_i$、参考资产 $u_i$、任务专用评估器 $e_i$ 和最大交互步数 $H_i$(实验中为 100 步)。执行流程四段式:打包任务→重置 Ubuntu 22.04 虚拟机(Docker/QEMU/KVM 启动,1920×1080 分辨率,8 核 CPU、8G 内存)→截图-动作循环→主机侧评估。循环中智能体每步收到任务指令、当前截图、可选参考图和最近 10 轮轨迹摘要,输出经清洗的 pyautogui 动作或 WAIT/DONE/FAIL 控制符;终止后运行器从 VM 提取保存的 .FCStd 与附属输出文件,计算奖励 $R_i(s_\tau) = e_i(\phi(s_\tau)) \in \{0,1\}$——所有必需检查全部通过才计成功,无部分得分。整个流程记录截图、JSONL 轨迹、屏幕录像和日志,使最终工件可以回溯到具体的 UI 操作序列。
核心创新是『工件锚定评测』(artifact-grounded evaluation)。与看最终截图相似度或执行生成的 CAD 代码不同,CADWorld 在交互结束后解析持久工程状态的多个层级:草图任务检查实体、约束、尺寸、轮廓面积/周长/质心;零件、外观、宏、测量、网格、点云、TechDraw 任务检查对象类型、标签、归档文件、属性、包围盒、体积、表面积与任务专用对象约束;装配任务检查 Grounded、Rack-and-Pinion、Slider 等关节元数据;CAM 任务比较毛坯-目标的材料去除量、生成路径数据与过切/欠切比例;FEM 任务要求分析对象、材料、边界条件、网格、求解器、结果对象和导出 CSV 数值全部正确。作者同时定义了四条设计标准:可回溯(traceable,截图/动作/日志连接结果与轨迹)、可测量(measurable,尺寸与几何量可程序化检查)、可诊断(diagnisable,失败定位到缺失对象、属性不匹配、公差违规)、可编辑(editable,工件可在原 CAD 环境中重开修复扩展)。评估不需要 LLM 裁判或人工检查,可在线和回溯复用。
方法步骤详情
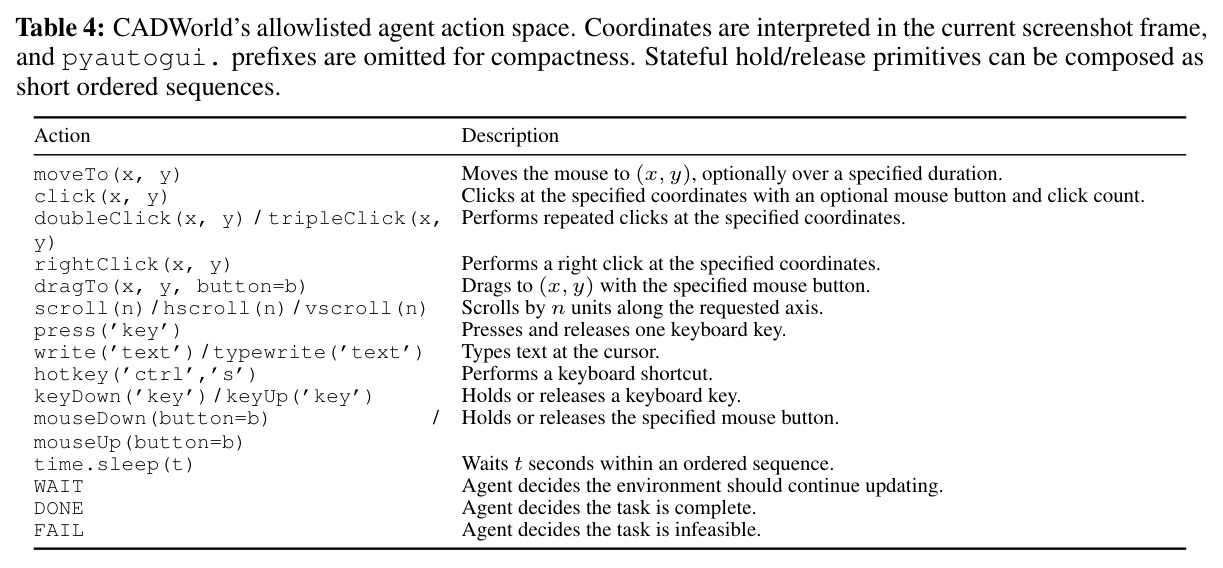
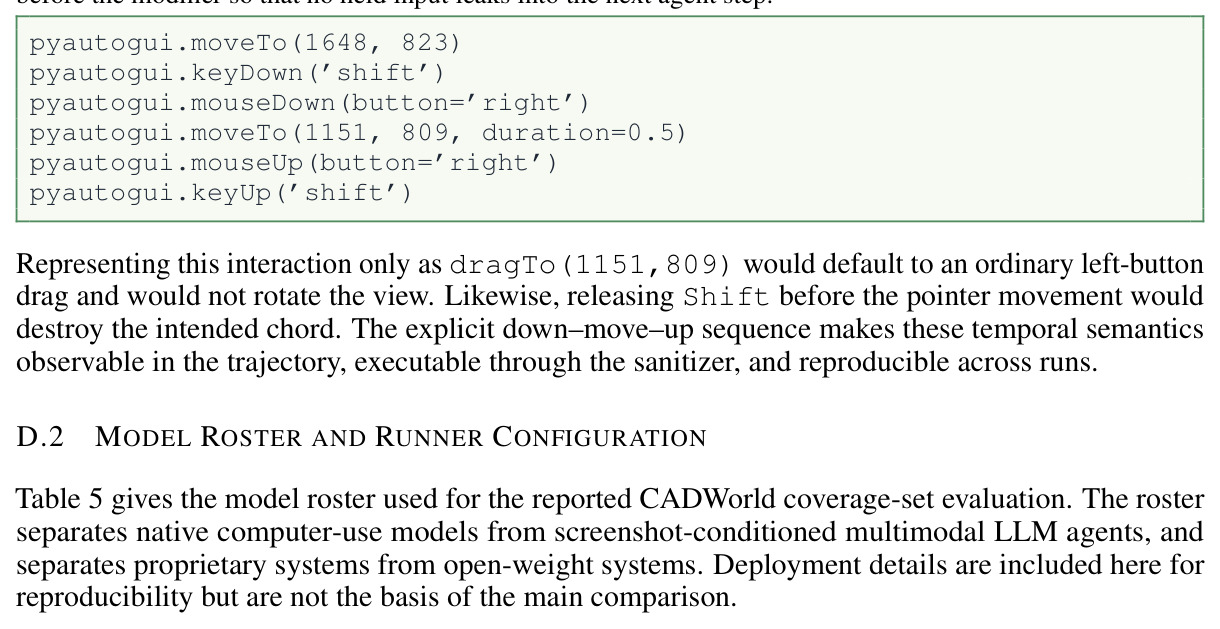
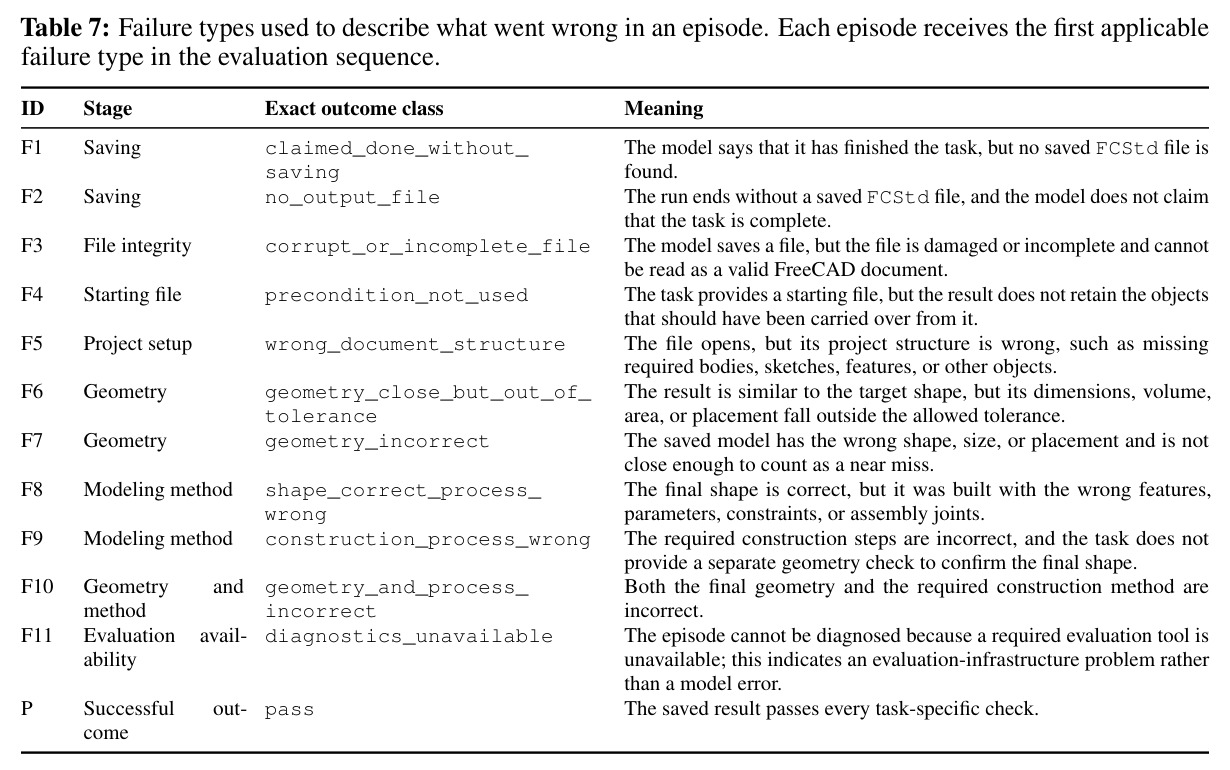
第一步,任务打包:撰写指令与前置条件(200 个任务中 100 个有前置 .FCStd 文件、122 个带指令参考图),配置 setup 与评估器规范,标注与验证共耗时约 3 个月、1300 人时。第二步,环境重置:运行器上传任务资产、清除陈旧输出、打开初始状态,等待 15 秒后交出控制权。第三步,交互循环:动作空间含 moveTo/click/rightClick/dragTo/scroll/press/write/hotkey,以及关键的 keyDown/keyUp、mouseDown/mouseUp 状态化组合——例如旋转 3D 视图需要 Shift+右键拖拽,必须按 moveTo→keyDown('shift')→mouseDown(right)→moveTo→mouseUp(right)→keyUp('shift') 的顺序执行,只发 dragTo 会退化成左键拖拽而无法旋转视图。第四步,评估:提取 .FCStd 与附属文件,运行 $e_i$ 的全部必需检查输出二值结果,同时落盘体积误差、包围盒 IoU、质心距离等连续诊断量和逐规则报告;效率上区分全跑均值与成功均值(步数、token、API 费用),失败归因按评测序列自动划入 11 类(F1–F11)。
技术新颖性
与既有工作相比的新颖性有五点。(1) 相对 OSWorld 2.0 和 Agents' Last Exam,它把整个基准聚焦机械 CAD 的 183 个知识点,而前者的 CAD 只是零星子集,不覆盖草图、参数化建模、装配、CAM、FEM 等系统知识。(2) 相对 CADBench、BenchCAD、Text2CAD-Bench 等程序化 CAD 基准,它要求在原生工程环境里直接重开并修改早前的草图/特征/约束/装配操作,保留专业 CAD 实践的工作流连续性——『改代码再重跑』只有程序级可编辑性,reopen 原生项目才有工程级可编辑性。(3) 状态化输入组合(hold/release 有序序列)是被通用基准忽略的动作语义问题:紧凑动作摘要通常只暴露原子点击与拖拽,丢掉按住状态会改变语义,本文显式保留完整事件顺序。(4) F1–F11 失败分类是确定性规则归因,不需要模型裁判或人工复核。(5) 用自研 CUA Collector 录制 112 个任务的人类专家演示作为效率锚点,并专门设计 10 个短任务为低性能模型保留区分度。
实验结果
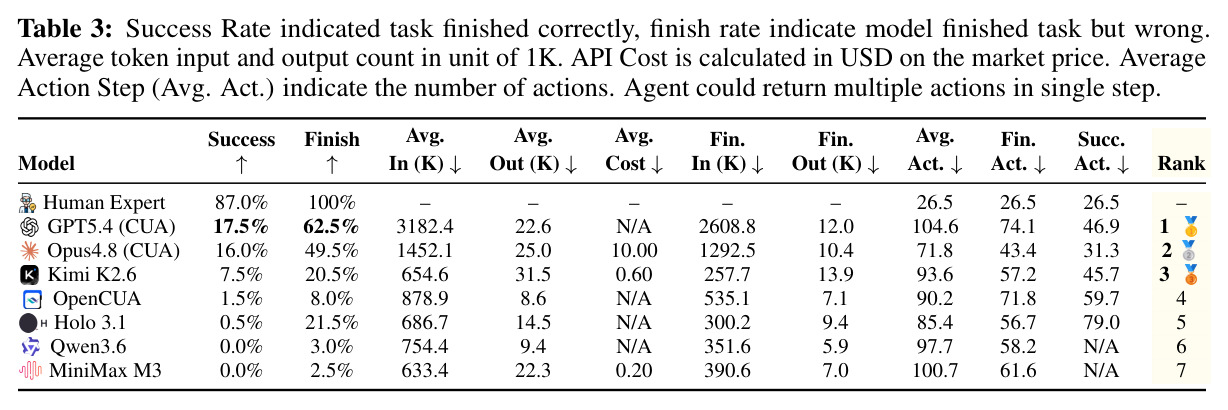
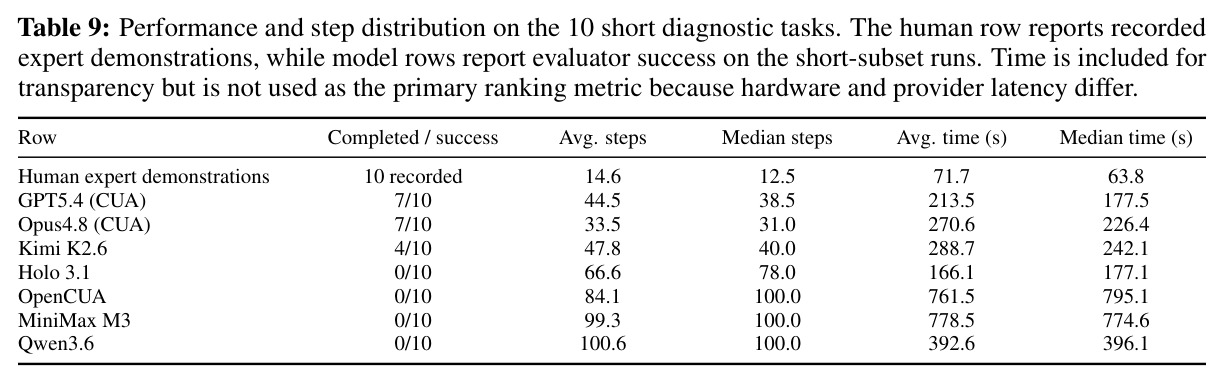
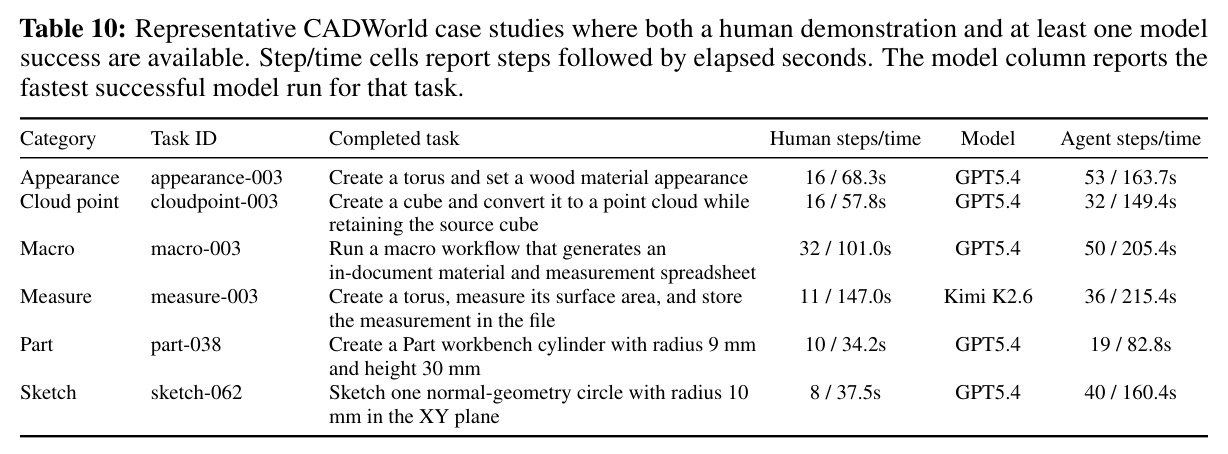
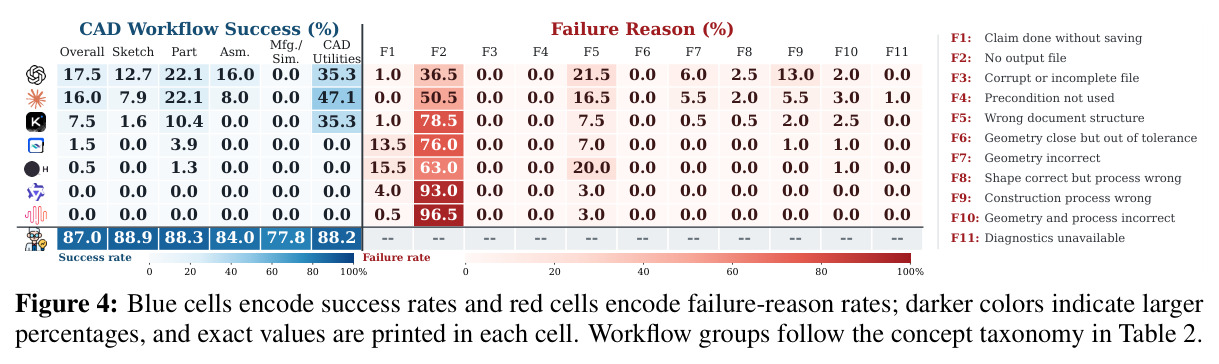
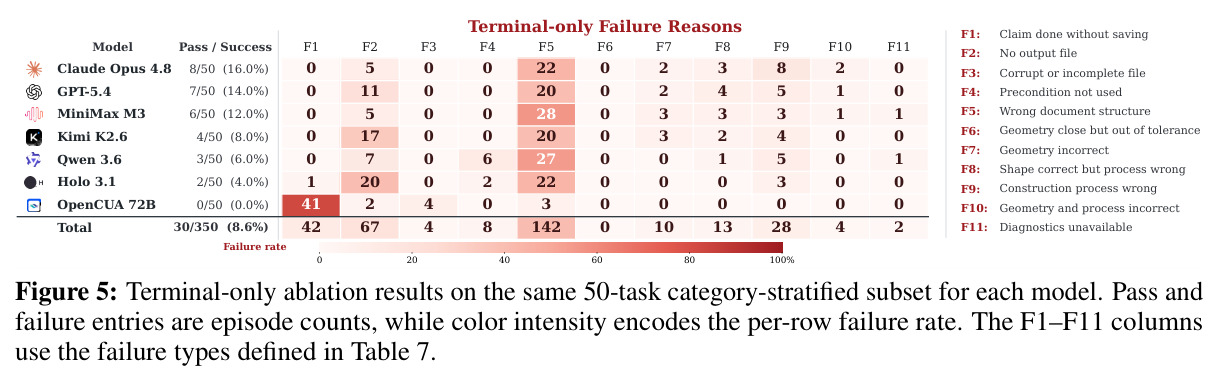
在全 200 任务上,七个智能体的成功率为:GPT5.4(CUA)17.5%、Opus4.8(CUA)16.0%、Kimi K2.6 7.5%、OpenCUA 1.5%、Holo 3.1 0.5%、Qwen3.6 0%、MiniMax M3 0%,而人类专家参考通过率为 87.0% 且平均只需 26.5 步;GPT5.4 平均要 104.6 步(成功任务也要 46.9 步),平均输入 token 高达 3182.4K,Opus4.8 平均 API 成本约 10 美元/任务。分组看,GPT5.4 在 Part 22.1%、Assembly 16.0%、Sketch 12.7%,但 CAM、FEM、TechDraw 全部为 0%。失败分布随模型能力分化:弱模型被『无输出文件』(F2)主导——Qwen3.6 占 93.0%、MiniMax 96.5%,并呈现『死亡循环』模式,如在文件对话框 100 步内 68 次点击同一坐标 (1056,630) 却始终没打开前置文件;强模型更多死在下游——GPT5.4 有 21.5% 败于文档结构错误(F5)、13.0% 败于构建过程错误(F9),Opus4.8 对应 16.5% 和 5.5%。消融实验一(终端-only,50 任务×7 模型):成功率量级相近(合计 30/350 即 8.6%,最高 Opus4.8 16.0%),但失败集中转向 F5(142 例),因为脚本建模破坏了可编辑性——工程师无法再修改构建段落。消融二:GPT5.4 去掉 computer-use 工具后从 17.5% 掉到 0%,证明 CUA 工具链贡献了全部性能。成功案例研究显示即便做对,模型也要 19–53 步/82.8–215.4 秒,而人类只要 8–32 步/34.2–147.0 秒。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全基准 200 任务总成功率 | 成功率 | 17.5%(GPT5.4 CUA,最强模型) | 人类专家参考 87.0% | 落后 69.5 个百分点 |
| Part 零件建模(77 任务) | 成功率 | 22.1%(GPT5.4) | 人类专家 88.3% | 落后 66.2 个百分点 |
| Sketch 草图(63 任务) | 成功率 | 12.7%(GPT5.4) | 人类专家 88.9% | 落后 76.2 个百分点 |
| Assembly 装配(25 任务) | 成功率 | 16.0%(GPT5.4) | 人类专家 84.0% | 落后 68.0 个百分点 |
| CAM / FEM / TechDraw 专项工作流 | 成功率 | 0%(全部 7 个模型均为 0) | 人类专家在这些工作流上 77.8%–88% | 完全失败,暴露训练数据 exposure 缺口 |
| GPT5.4 去除 CUA 工具消融 | 成功率 | 0%(无 computer-use 工具) | GPT5.4 (CUA) 17.5% | CUA 工具链贡献全部性能 |
| 终端-only 消融(50 任务 × 7 模型) | 成功率 | 合计 30/350(8.6%),最高 Opus4.8 16.0% | GUI 模式最高 17.5% | 量级相当,但失败集中转向 F5 文档结构错误(142 例) |
| 10 个最短短任务诊断集 | 成功数 / 平均步数 | GPT5.4 7/10、44.5 步;Opus4.8 7/10、33.5 步 | 人类演示 10/10、平均 14.6 步 | 步数约为人类 3 倍,4 个开源模型 0/10 |
局限与改进
作者承认四点局限:任务必须提供显式目标和必要源资产才能做确定性评估,无法覆盖真实工程中需求引导(requirement elicitation)、不完整源设计搜索和方案权衡等开放式环节;被测模型的原生接口、上下文上限、访问策略与延迟各不相同,效率指标需结合部署细节解读;人类行是单个专家的一次参考演示(非人口级人类研究);只在 FreeCAD 上实现,商业 CAD 套件在几何内核、UI 惯例、约束求解器与云集成上差异很大,结论外推需谨慎。我自己的观察补充如下:正文存在数字不一致——引言说『预算受限的 60 任务子集上最强 25.0%』,而摘要与 Table 3 的全量结果是 17.5%,疑为旧稿残留;类别样本量极不均衡(FEM 仅 3 个、TechDraw 仅 2 个任务),『全部 0%』的结论统计上脆弱;主榜是全有全无的二值评分,虽诊断文件保留了体积误差、IoU 等连续量但不计入分数;每个模型每种配置似乎只跑一次,没有多次采样的方差报告,17.5% 与 16.0% 的排序未必稳定。
独立分析的弱点
弱点一,二值成功掩盖过程质量:两个模型可能同样失败,但一个只差 0.01mm 公差、一个完全错形,主指标无法区分,改进方向是把连续诊断量(体积误差、包围盒 IoU、质心距离)纳入分层计分或 Pareto 分析。弱点二,单次运行无方差:LLM 输出具有随机性,应报告多 pass 成功率与置信区间,否则相邻名次的比较不可靠。弱点三,任务制作成本高:约 3 个月、1300 人时,评估器逐任务手写,扩展到其他 CAD 或更大规模的可扩展性存疑,可探索半自动任务生成加人工校验的流水线。弱点四,智能体侧基线较朴素:仅 10 轮轨迹上下文、512 输出 token、无记忆/技能库/自我验证机制;弱模型的『死亡循环』本可被简单的重复动作检测器或回退策略打断,但基线未提供此类兜底,可能低估了中等模型的真实水平。弱点五,正文与图表数字存在不一致(引言的 60 任务 25.0% vs 全量 17.5%;Figure 4 中 GPT5.4 与 Kimi 在某制造分组同为 35.3%),提示实验数据管线需要更强的自动一致性校验。
未来方向
作者提出的方向:扩展到开放式设计任务,引入需求引导与设计权衡,使基准覆盖 CAD 工作开始之前的工程环节;跨多个 CAD 内核与商业套件验证可迁移性(附录 Table 8 已分析 Fusion 360、SolidWorks、NX、Onshape 的可行性);利用 CUA Collector 录制的人类演示做行为克隆或奖励建模训练。基于本文成果可延伸的方向:(1) 把 F1–F11 诊断和连续几何误差转化为过程奖励信号,训练 CAD 专用的过程监督策略,而非只用终局二值奖励;(2) 设计面向 CAD 的智能体架构——维护显式的特征树/约束状态记忆、加入几何 grounding 模块处理 2D 指针轨迹到 3D 视图的映射、保存前调用 FreeCAD 脚本自检;(3) 从 10 个短任务到 81 步长工作流的课程学习,以及技能复用(宏录制与回放);(4) 针对 CAM/FEM 等『中间状态不可视』工作流研究语义状态摘要或辅助可视化观测;(5) 用多级工件检查系统研究『看起来对但工程上错』的幻觉几何问题,并连接下游可制造性与装配可行性分析。
复现评估
复现基础较好。项目页为 cad-world.github.io;环境是开源 FreeCAD 加 Ubuntu 22.04 的 qcow2 镜像,通过 Docker/QEMU/KVM 一键启动,无商业许可障碍;运行器参数全部公开(1920×1080、100 步上限、10 轮轨迹上下文、512 输出 token、0.3 秒动作后等待、15 秒重置等待、评估前 2 秒等待),共享提示词模板与 GPT5.4/Opus4.8/Kimi/Holo/Qwen/OpenCUA 各家适配器在附录 Listing 2–5 完整给出;评估器为确定性脚本,无需 LLM 裁判。算力方面:闭源最强基线需要 GPT5.4 与 Opus4.8 的付费 API(单任务平均成本最高约 10 美元、平均输入 318 万 token),开源模型自托管使用了 4 张 NVIDIA RTX PRO 6000 Blackwell Max-Q(每张 97,887 MiB)工作站 GPU,每次用 2 张。主要门槛在于任务与评估器的制作(约 3 个月、1300 人时)和 VM 并行调度;若只复现评测(用现成 200 任务跑自己的模型),工程难度中等,属于有 GPU 或 API 预算即可完成的基准。
论文图表
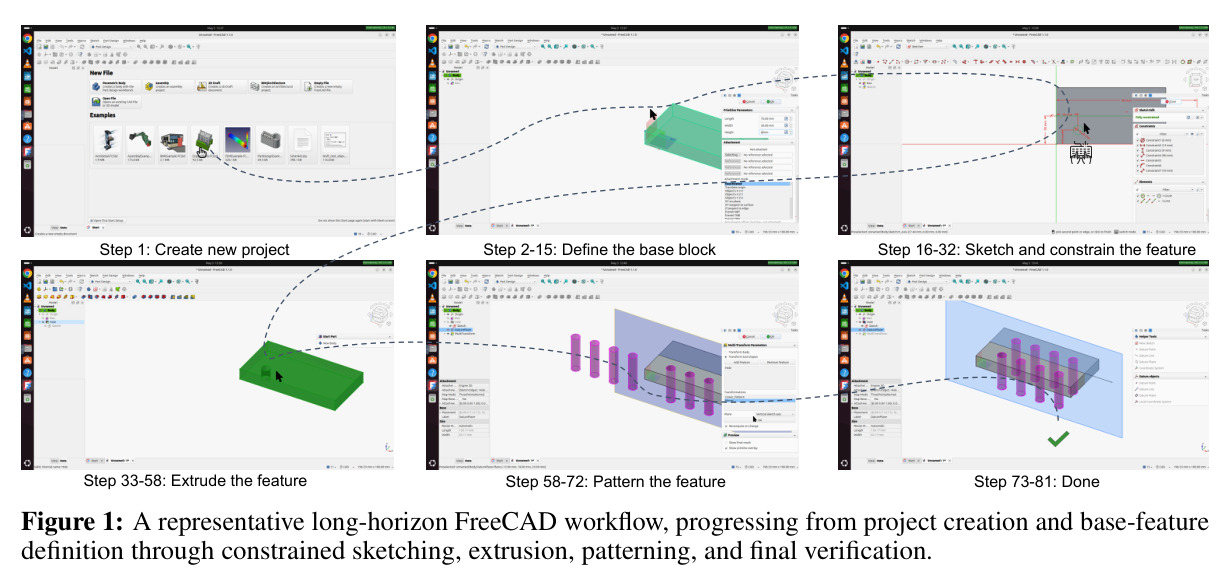
一个代表性长程 FreeCAD 工作流的步骤分解:第 1 步新建项目,第 2–15 步定义基础块体,第 16–32 步绘制并约束特征草图,第 33–58 步拉伸特征,第 58–72 步阵列特征,第 73–81 步完成验证,共约 81 步。
直观展示『长程』的含义:一个常规零件任务需要几十到上百步协调操作,远超一般桌面基准的 10–40 轮,解释了当前智能体为何频繁失败。