SAKI:面向在线策略蒸馏的最大耦合路由教师监督 SAKI: Maximal-Coupling-Routed Teacher Supervision for On-Policy Distillation
用最大耦合的接受/纠正事件内生路由token级监督,让在线策略蒸馏既准又快
前置知识
在线策略蒸馏 (On-Policy Distillation, OPD)
传统序列级蒸馏让学生在教师生成或固定数据的前缀上训练,训练与推理时的状态分布不一致。OPD 反其道而行:让学生自己生成 rollout 轨迹,再由教师在学生实际访问到的每个前缀上提供分布级监督,从而消除 train–test 状态错配。其代价是训练状态分布完全取决于当前学生的能力——学生越弱,访问的状态越偏离教师自身会生成的行为分布。
本文的问题设定和方法改进都建立在 OPD 框架之上,理解其'学生自采样 + 教师在访问状态上打分'的机制是读懂 SAKI 动机与实验对照(OPD/ExOPD/TRB 均为其变体)的前提。
反向 KL 散度 (Reverse KL, RKL)
$D_{KL}(p_\theta\|T)=\sum_v p_\theta(v)\left[\log p_\theta(v)-\log T(v)\right]$ 以学生分布加权,是模式寻求(mode-seeking)的散度:学生倾向集中模仿教师的某个众数而非覆盖全部模式。其 RL 式实现中,采样 token 的对数比 $-[\log p_t(y_t)-\log T_t(y_t)]$ 构成单样本 score-function 梯度估计(附录 C)。缺点是学生支持度低但教师偏好的 token 获得的梯度很弱。
SAKI 在接受位置保留的正是这种 sampled-token RKL;而纠正位置之所以需要切换为教师 Top-1 直接监督,正是为了弥补 RKL 对低学生支持度 token 的监督盲区。
信任域 (Trust Region)
约束新行为分布与参考分布距离不超过半径 $\epsilon$ 的优化技术。本文采用以学生为中心的约束 $D_{KL}(q_t\|p_t)\le\epsilon$,在该约束下取最大可行几何插值系数 $\beta$,构造教师引导分布 $q_t(v)\propto p_t(v)^{1-\beta}T_t(v)^{\beta}$:$\epsilon=0$ 退化为纯学生 rollout,$\epsilon$ 足够大时若教师本身在信任域内则 $q_t=T_t$。
TRB 信任域桥接是 SAKI 的直接前身,理解信任域如何同时控制 rollout 偏移与干预频率(经 Pinsker 不等式联系)是理解全文理论主线(命题 1、2 与推论 1)的钥匙。
最大耦合 (Maximal Coupling)
给定边缘分布 $p$ 和 $q$,耦合指构造以 $p$、$q$ 为边缘的联合分布。最大耦合(Lindvall, 2002)以概率 $\sum_v\min\{p(v),q(v)\}$ 让两个样本取相同值:学生先提议 $z\sim p$,以 $\min\{1,q(z)/p(z)\}$ 概率接受;否则从正残差 $[q-p]_+$ 采样一个'纠正' token。其不一致事件概率 $\Pr(C=1)=TV(p,q)$ 是所有耦合方式中最小的。
SAKI 的全部核心创新——把实现 $q_t$ 过程中暴露的接受/纠正事件复用为监督路由器——就建立在这一经典概率构造上,命题 1/2 给出其精确语义。
全变差距离 (Total Variation, TV)
$TV(p,q)=\tfrac12\sum_v|p(v)-q(v)|=1-\sum_v\min\{p(v),q(v)\}$,衡量两个分布最优假设检验的最大判别概率。在最大耦合下它恰好等于纠正事件的发生概率,并由 Pinsker 不等式 $TV(p,q)\le\sqrt{D_{KL}(q\|p)/2}$ 受信任域半径控制。
它把'rollout 距学生多远'与'多大比例的位置需要纠正/特殊监督'统一成同一个量,是 SAKI '一个半径同时管两件事'这一理论卖点的核心。
投机解码 (Speculative Decoding)
用廉价草稿模型一次提出 $K$ 个 token,再由强目标模型并行验证,只提交到首个拒绝位置为止的前缀,从而在严格保持目标采样分布不变的前提下加速自回归生成。本文中学生充当草稿模型,教师在线验证;在首个拒绝处提交精确的残差纠正 token 并丢弃其后所有投机状态。
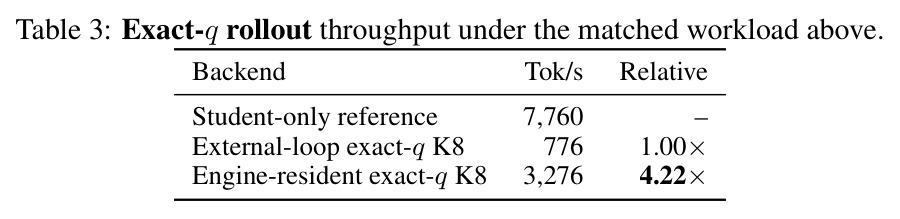
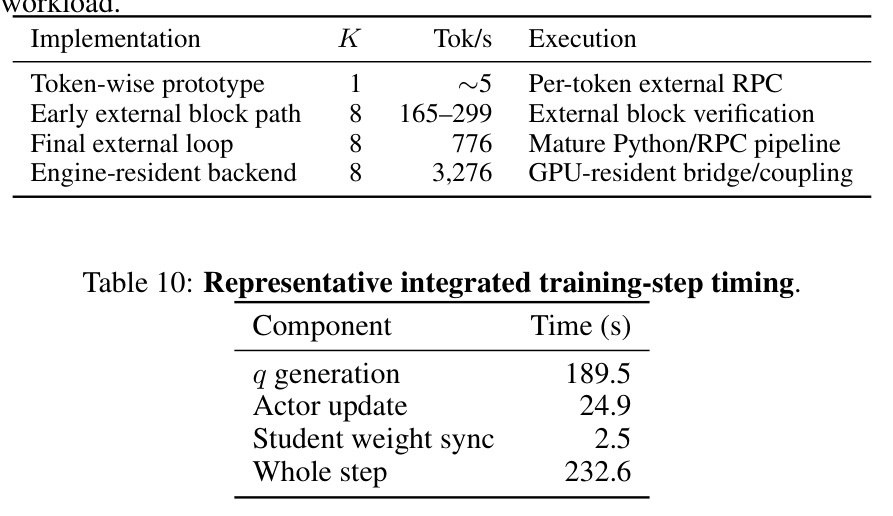
教师引导 rollout 要求在生成时的每个位置同时拿到学生与教师全词表分布,投机块验证是把这一昂贵过程加速 4.22 倍(776→3,276 tokens/s)并保持精确 q 分布语义的系统基础。
研究动机
在线策略蒸馏(OPD)让学生在自己生成的轨迹上接受教师监督,缓解了传统蒸馏的 train–test 状态错配,但其有效性高度依赖学生所访问状态的质量。本文设定中师生初始差距极为悬殊:Qwen3-1.7B-Base 在七个数学基准上的 Mean@8 平均仅 3.0(教师 Qwen3-4B-GRPO 为 41.3),在 AIME 类难题上几乎为零(0.4);0.6B 学生更是只有 1.7。如此弱的学生在 rollout 早期一旦犯错,错误会级联放大,把轨迹引向教师自身几乎不会生成的低概率前缀——教师在这些前缀上的条件分布虽然数学上有定义,却不再代表使教师强大的推理行为,监督信号的可用性随之下降。更麻烦的是,OPD 常用的反向 KL 是学生加权的:学生支持度低但教师偏好的 token 只能获得微弱梯度,而恰恰是这些高冲突位置最需要直接干预。
本文的目标是本文要同时回答 OPD 中'在哪里查询教师监督'与'在各位置如何更新学生'这两个互补问题。具体而言:在不引入离线数据、不放弃以学生为中心训练的前提下,(1) 把 rollout 分布在 KL 信任域内向教师拉动,改善学生早期访问的状态分布;(2) 区分引导 rollout 中学生提案被保留的位置与必须被覆盖的位置并给予不同监督——前者保留常规 sampled-token RKL,后者切换为对教师最高概率 token 的直接负对数似然;(3) 保证整个流程数学上精确(rollout 严格服从目标分布 $q$)且工程上高效可行;(4) 在 1.7B 与 0.6B 两个学生规模、七个数学基准上稳定超过同预算的教师引导基线 TRB 及 OPD/ExOPD/SKD 等对照。
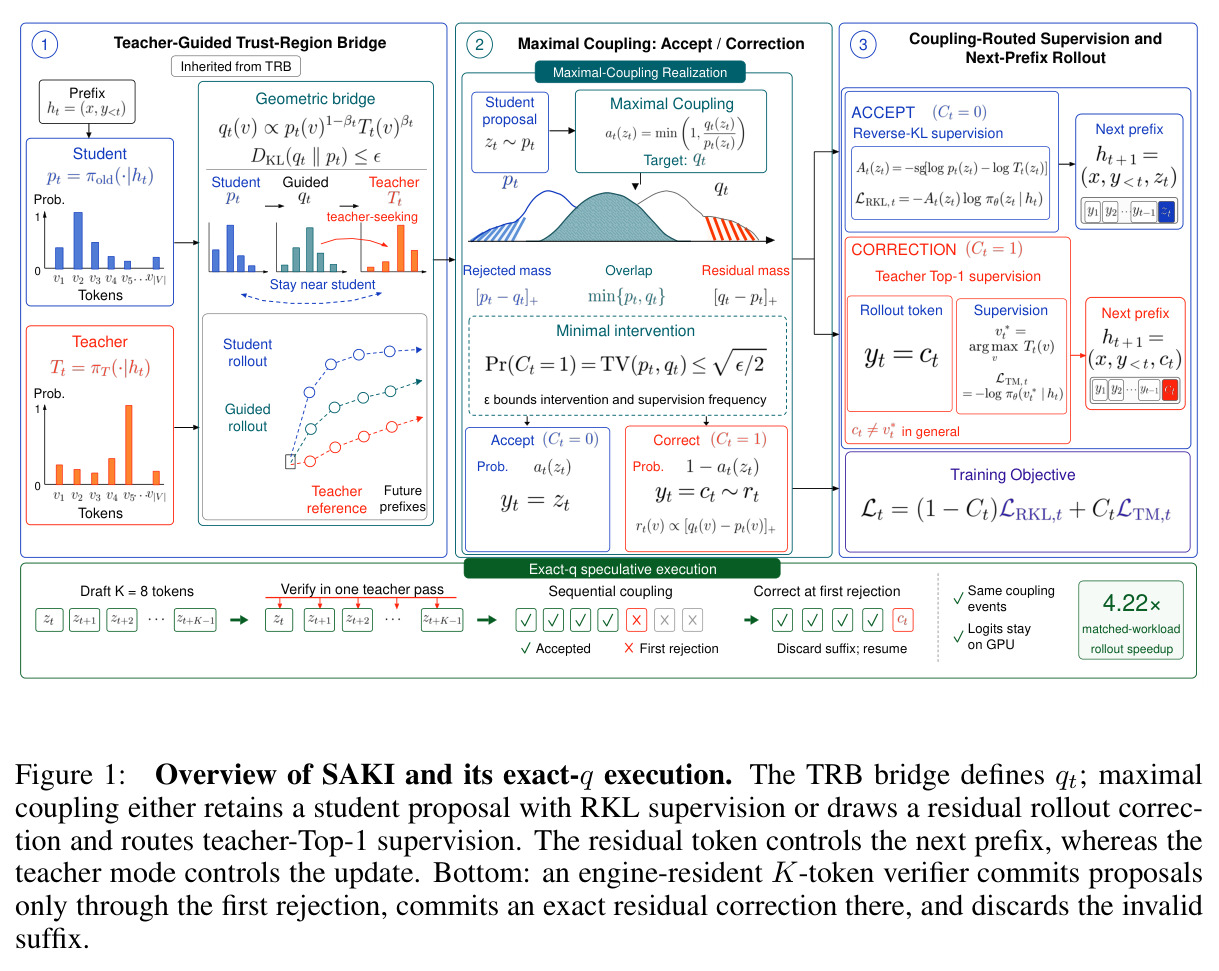
与已有工作不同的是,已有工作各只解决一半问题。TRB(Plyusov et al., 2026)提出信任域行为混合:在每个前缀构造向教师靠近但满足 $D_{KL}(q_t\|p_t)\le\epsilon$ 的中间分布 $q_t$,回答了'在哪里查询',却对所有位置保留同一个 per-prefix RKL 目标,未区分'学生提案被保留'与'被推翻'两类状态。另一支工作用外部启发式(如按局部 TV 打分选 token)做特殊监督,路由信号与 rollout 过程本身脱节。SAKI 的独特切入是:当用最大耦合精确实现 $q_t$ 时,接受/纠正事件是 rollout 过程'免费'暴露的内生信号——纠正概率精确等于 $TV(p_t,q_t)$,并被信任域半径以 $\sqrt{\epsilon/2}$ 上界约束。于是同一次耦合采样既决定轨迹走向又决定监督路由,无需任何外部阈值或 token 选择规则,且干预频率有理论保证。
核心方法
直觉上,SAKI 把一次 rollout 采样变成'学生提案、最小干预修正'的过程,并把'是否需要修正'这一事件直接变成训练信号的开关。技术上分三步:首先继承 TRB 的信任域桥接,在每个前缀取最大可行系数 $\beta_t$,构造几何插值分布 $q_{\beta,t}(v)=\frac{p_t(v)^{1-\beta_t}T_t(v)^{\beta_t}}{Z_t(\beta_t)}$,满足 $D_{KL}(q_{\beta,t}\|p_t)\le\epsilon$;其次用最大耦合实现 $q_t$:学生提议 $z_t\sim p_t$,以 $\min\{1,q_t(z_t)/p_t(z_t)\}$ 概率接受,否则从正残差 $[q_t-p_t]_+$ 采样纠正 token;最后按耦合事件路由监督——接受位置保留 sampled-token RKL,纠正位置改为对教师 Top-1 token 的负对数似然。训练中 $\epsilon$ 从 0.02 线性退火到 0(前 50 步),第 51 步起精确退回纯学生 rollout 的 RKL 训练。为摊销在线教师推理,作者实现了引擎常驻的投机块验证器:学生草拟 $K=8$ 个 token、教师单批验证,在保持精确 q 轨迹分布与耦合语义的同时把吞吐提升 4.22 倍。
核心创新是'耦合事件即路由器'这一内生设计。与 TRB 的本质区别在于:TRB 只改变行为分布(在哪里采样),对所有位置一视同仁地用 RKL;SAKI 则利用最大耦合的精确分布语义——纠正概率恰为 $TV(p_t,q_t)$(命题 1),是所有耦合中最小的干预概率(命题 2),且被信任域半径以 $\sqrt{\epsilon/2}$ 上界约束(推论 1)——把'学生提案能否被保留'这一实现事件复用为监督路由信号。理论上(式 17),接受位置的 RKL 期望恰好作用在学生–引导重叠质量 $\min\{p_t,q_t\}$ 上,纠正位置构成同一耦合实现的互补分支,恰好是学生提案无法保留、需要教师直接指示的位置。另一个精妙之处是角色解耦:从残差分布采出的纠正 token 决定后续前缀(探索导向),而参数更新用教师在同一前缀的 Top-1 token(低方差确定性锚点 $L_{TM,t}=-\log\pi_\theta(v_t^*|h_t)$),二者可以不同。这与用 TV 分数等标量冲突度量做外部 token 选择有本质区别——$C_t$ 是依赖于实际采样提案的实现事件,具有明确的分布含义而非任意门控。
方法步骤详情
完整流程如下。(1) 前缀编码:给定前缀 $h_t=(x,y_{<t})$,冻结的 rollout 学生给出 $p_t$,固定教师给出 $T_t$(全词表 logits 常驻 GPU)。(2) 信任域求解:对每个位置批量二分(16 个固定波次)求满足 $D_{KL}(q_{\beta,t}\|p_t)\le\epsilon$ 的最大 $\beta_t$;附录 H 证明正残差只落在教师-学生似然比超过某个前缀相关阈值的 token 上。(3) 最大耦合:学生提议 $z_t\sim p_t$,接受概率 $a_t(z_t)=\min\{1,q_t(z_t)/p_t(z_t)\}$;接受则 rollout token 为 $z_t$、$C_t=0$;否则从 $r_t(v)\propto[q_t(v)-p_t(v)]_+$ 采出纠正 token $c_t$ 作为 rollout token、$C_t=1$。(4) 监督路由:接受位置计算 $L_{RKL,t}=-A_t\log\pi_\theta(y_t|h_t)$,其中 $A_t=-\mathrm{sg}[\log p_t(y_t)-\log T_t(y_t)]$;纠正位置取 $v_t^*=\arg\max_v T_t(v)$,计算 $L_{TM,t}=-\log\pi_\theta(v_t^*|h_t)$;总损失 $\mathcal{L}=\frac{1}{N_{valid}}\sum_t M_t\left[(1-C_t)L_{RKL,t}+C_t L_{TM,t}\right]$,纠正项不与 RKL 叠加。(5) 退火:$\epsilon$ 从 0.02 线性降至 0(前 50 步),第 51 步后无纠正事件,目标精确退化为标准 OPD RKL(附录 J.1)。(6) 高效执行:学生一次草拟 $K=8$ 个 token,教师单批验证整个提案路径,引擎内批量构造 $q$、解 $\beta$、从左到右评估接受;首个拒绝处提交精确残差纠正并丢弃其后投机 token 与 KV 状态,训练循环只接收提交 token、纠正掩码、所选 log 概率、教师 Top-1 目标等紧凑元数据。
技术新颖性
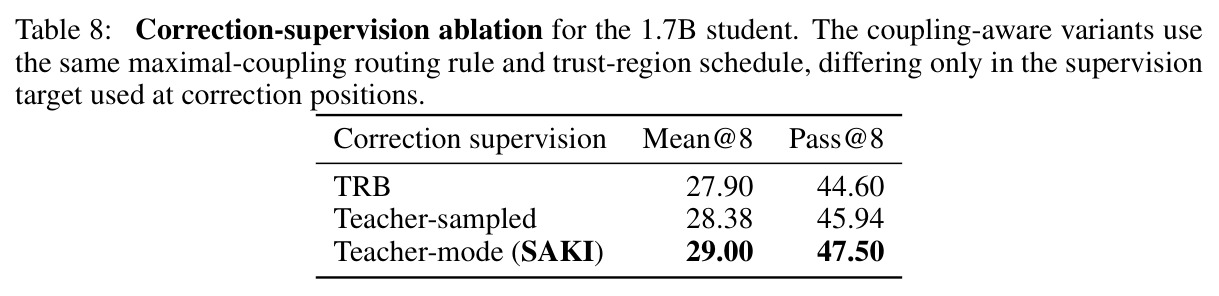
技术新颖性体现在四个层面。第一,目标层面:此前没有工作把引导 rollout 的实现事件(接受/纠正)作为监督路由器——Draft-OPD 用投机验证结果提供训练结构但服务于草稿模型蒸馏,TV 加权等方法是外部启发式,而 $C_t$ 是带精确分布语义($TV(p_t,q_t)$)的内生实现事件。第二,理论层面:论文给出三条干净的保证——输出边缘精确等于 $q$(命题 1)、纠正概率是所有耦合中最小的(命题 2)、信任域同时约束 rollout 偏移与干预/特殊监督频率(推论 1,经 Pinsker 不等式),并证明接受分支的 RKL 期望恰支持在重叠质量 $\min\{p,q\}$ 上,使两类监督构成同一耦合实现的互补分解。第三,目标设计层面:纠正处采用教师 Top-1 的硬标签 NLL(等价于以点质量 $\delta_{v^*}$ 为目标的前向 KL),与 teacher-sampled 目标相比多 0.62 Mean@8 / 1.56 Pass@8,说明高冲突位置需要低方差的众数锚点。第四,系统层面:引擎常驻的精确 q 投机验证(含首次拒绝提交/回滚与精确残差纠正)被证明与顺序采样严格同分布(命题 3),在保持数学语义的同时把吞吐从 776 提升到 3,276 tokens/s(4.22 倍),这与只做加速、不保耦合语义的常规投机解码应用不同。
实验结果
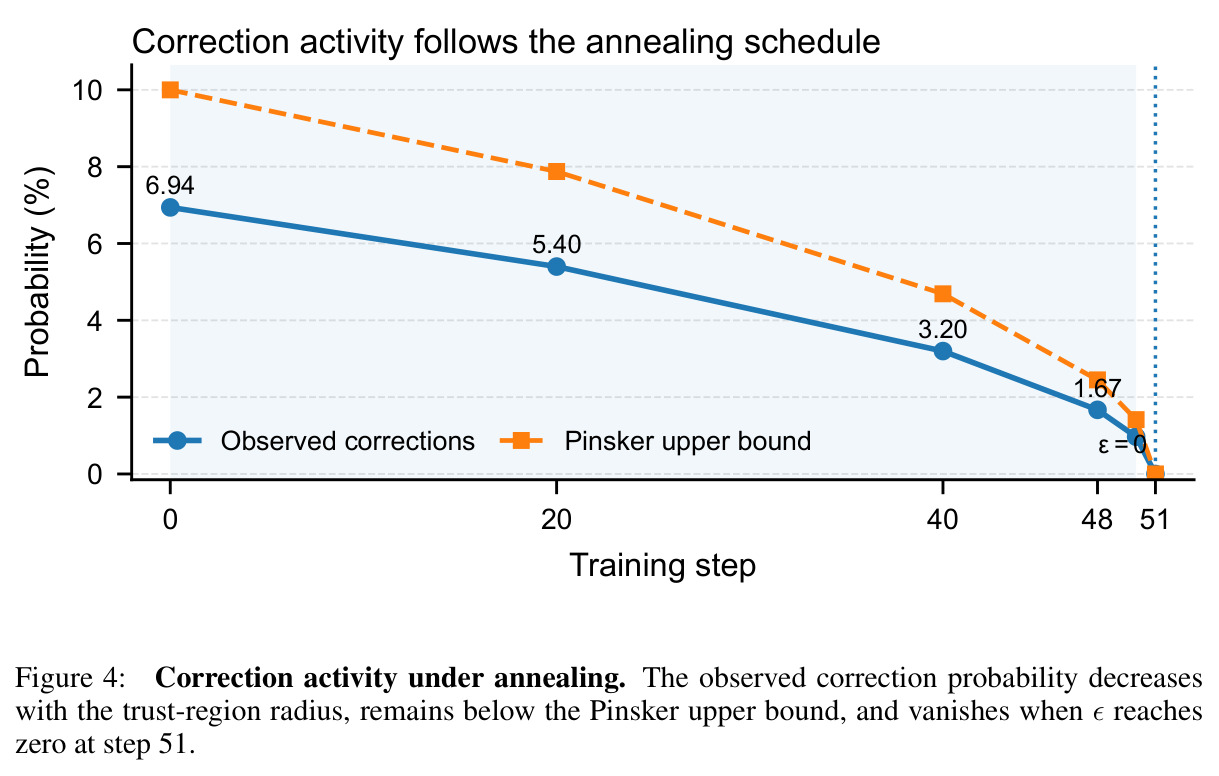
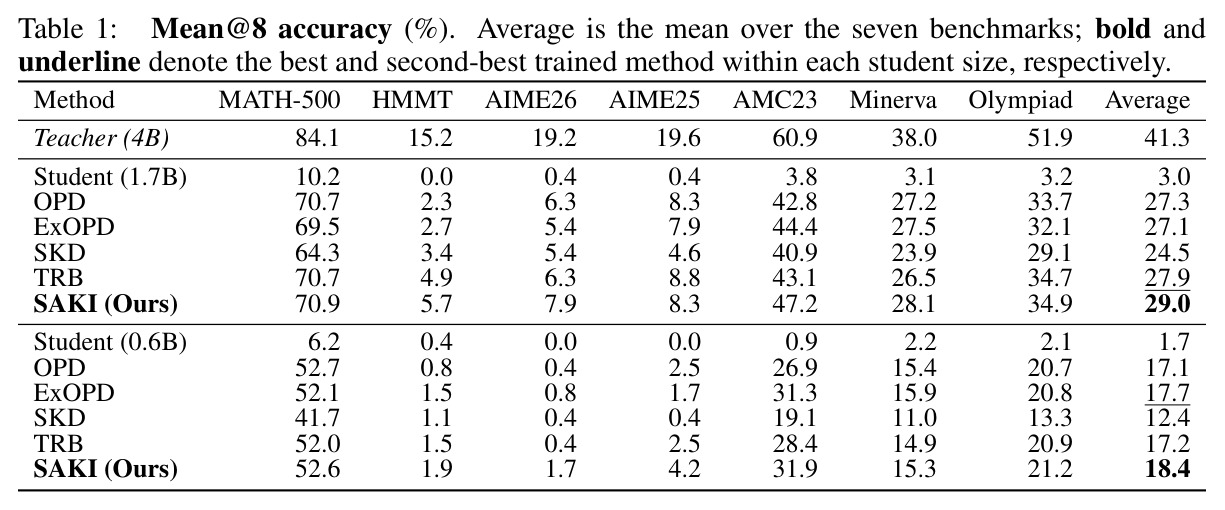
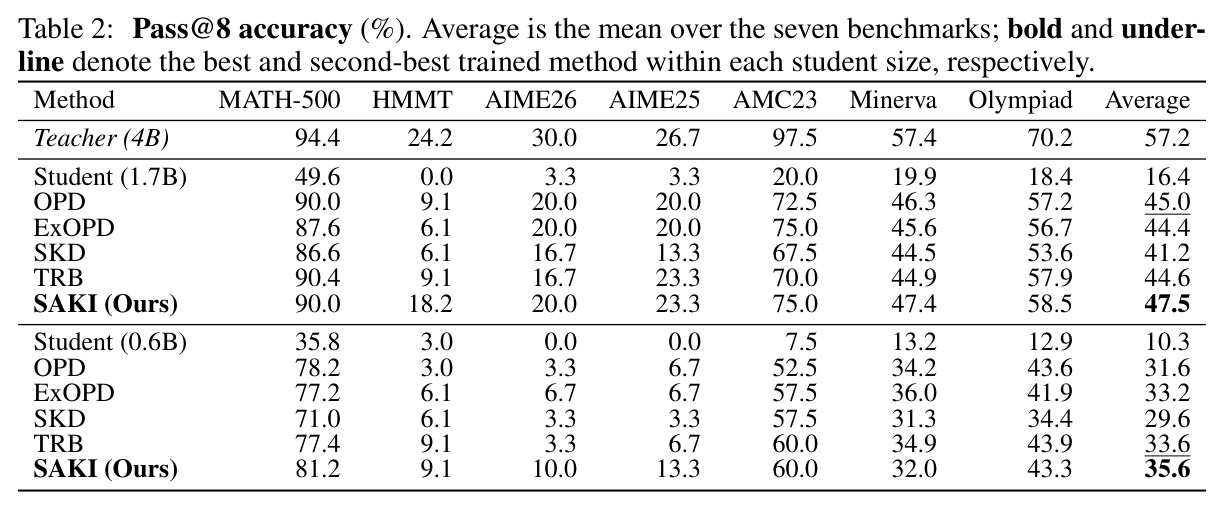
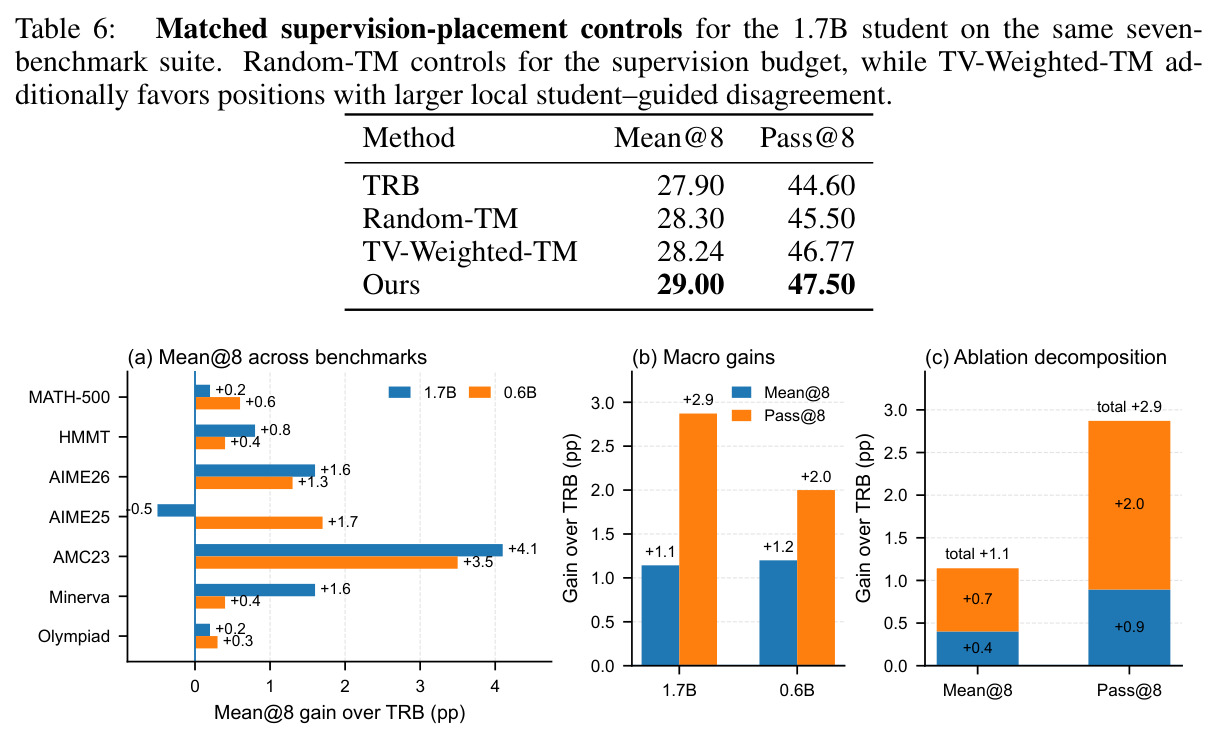
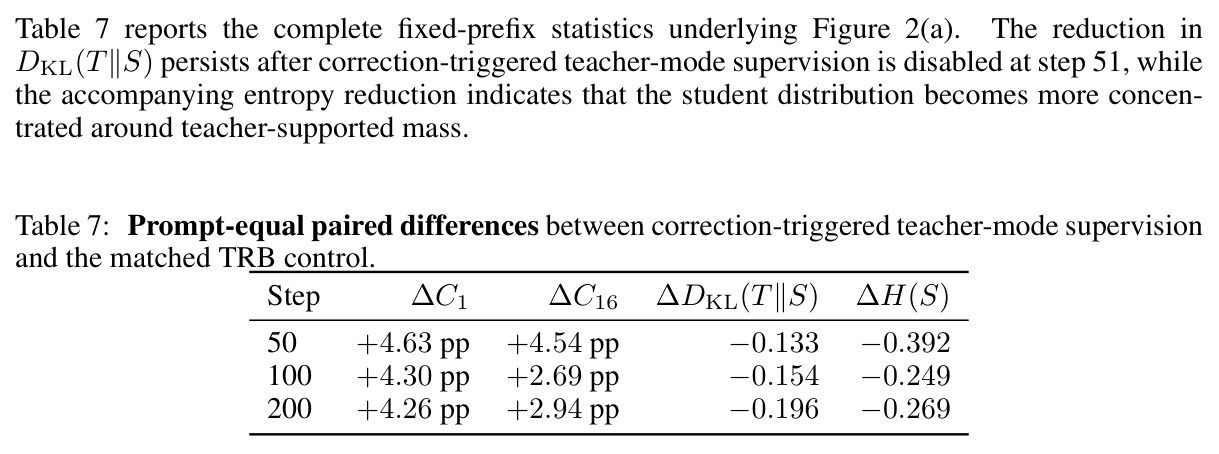
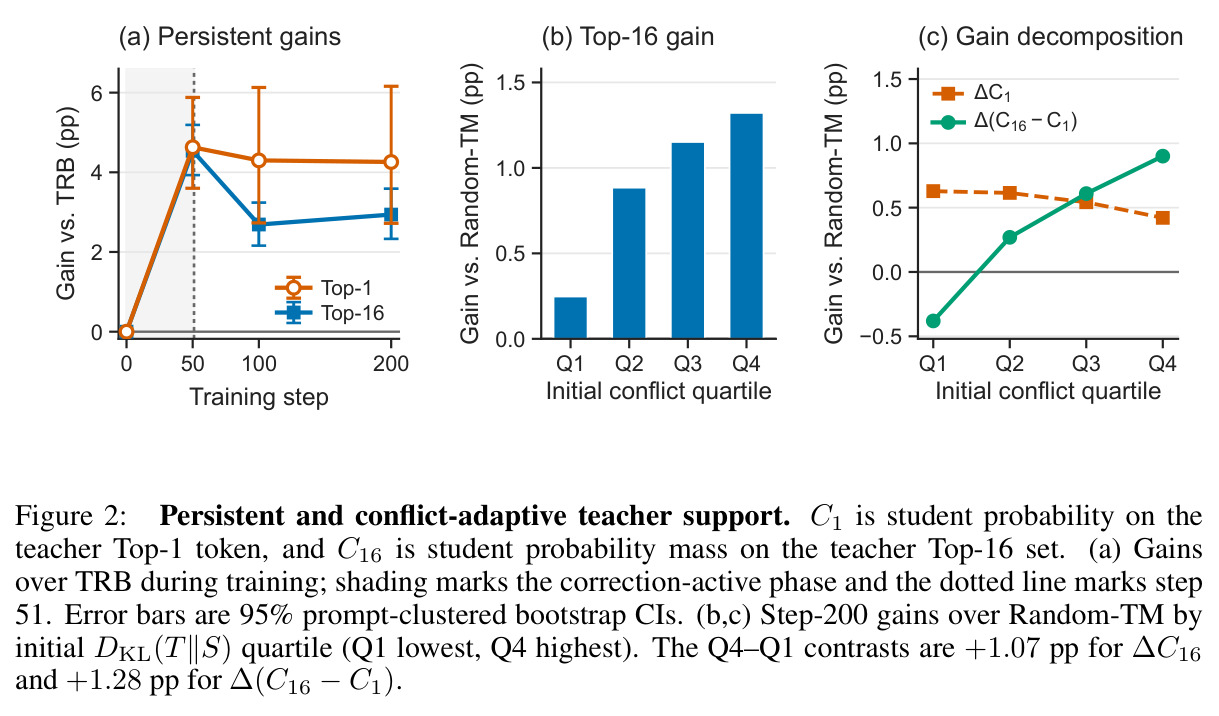
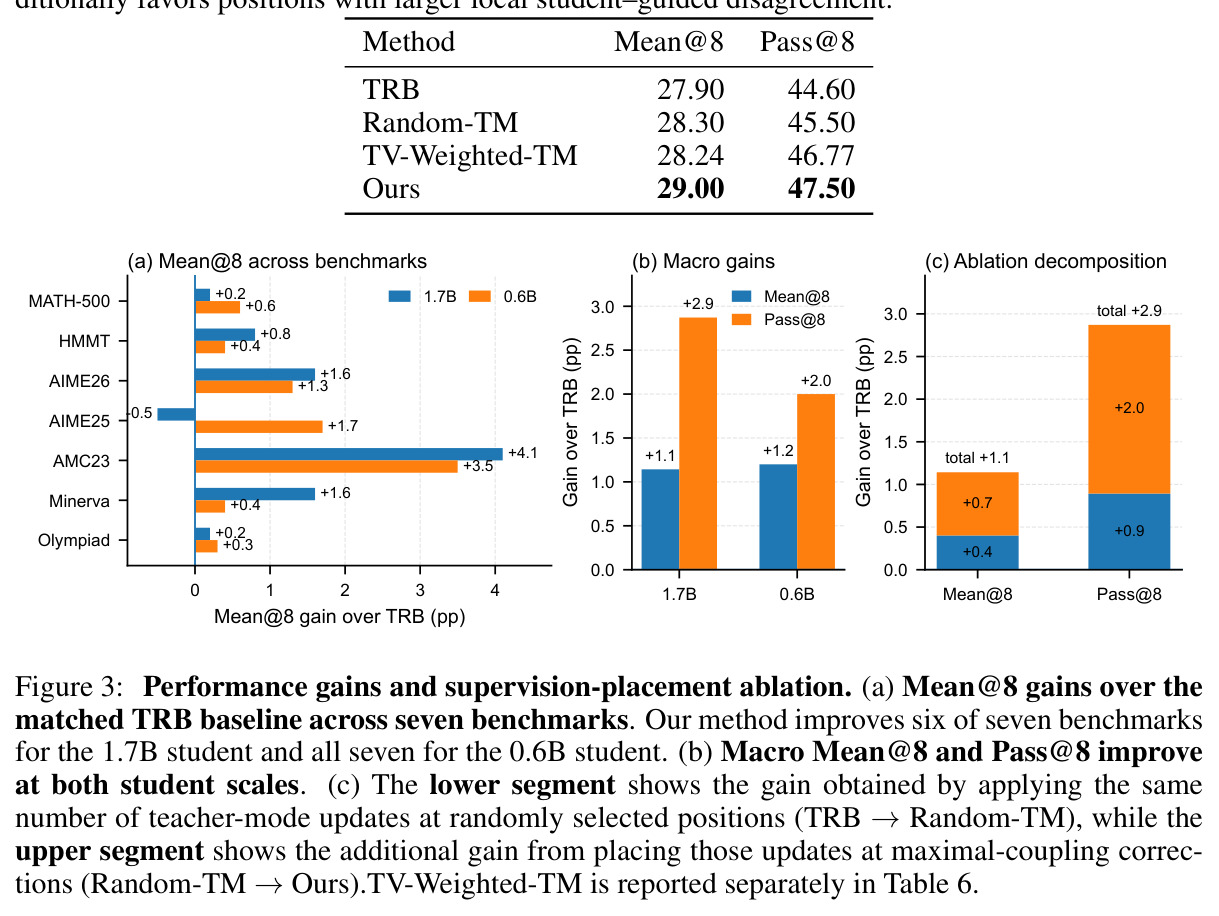
主实验在七个数学基准(MATH-500、HMMT-Feb26、AIME 2026、AIME 2025、AMC 2023、Minerva Math、OlympiadBench)上评测,温度 1.0 每题采样 8 次。对 1.7B 学生,SAKI 宏观平均达 29.0 Mean@8 / 47.5 Pass@8,优于 TRB 的 27.9/44.6(+1.1/+2.9)、OPD 的 27.3/45.0、ExOPD 的 27.1/44.4、SKD 的 24.5/41.2(对 SKD 为 +4.5/+6.3);对 0.6B 学生为 18.4/35.6,对 TRB +1.2/+2.0,对 SKD +6.0/+6.0。Mean@8 在 14 个学生-基准对中的 13 个超过 TRB,唯一例外是 1.7B 的 AIME25(图 3a 显示 −0.5)。监督放置对照(同等教师模式更新预算):Random-TM 28.30/45.50,TV-Weighted-TM 28.24/46.77,SAKI 29.00/47.50,比 TV 加权放置高 +0.76/+0.73,说明耦合事件本身比标量 TV 打分提供更强的路由信号。固定前缀探针(2,048 个位置、213 个 prompt,含 1,024 个真实纠正位置与 1,024 个匹配接受位置):第 50 步 SAKI 在教师 Top-1 概率 C1 上超 TRB 4.63 个百分点、C16 超 4.54;第 51 步关闭纠正监督后增益持续存在——第 200 步仍分别 +4.26/+2.94,且 $D_{KL}(T\|S)$ 的降幅扩大至 −0.196、熵下降 −0.269,说明分布持续向教师支持的质量集中。按初始冲突四分位分析,C16 增益从最低冲突组 Q1 的 +0.25 增长到最高冲突组 Q4 的 +1.32(Q4−Q1=+1.07 pp,95% CI [0.87,1.29]),且主要由教师支持的非 argmax token 承载($\Delta(C_{16}-C_1)$ 的 Q4−Q1 为 +1.28 pp),证明路由是冲突自适应的而非预算效应。纠正目标消融(表 8):teacher-sampled 28.38/45.94 vs teacher-mode 29.00/47.50。系统方面(表 3),引擎常驻后端 3,276 tokens/s vs 外部循环 776(4.22 倍),达到学生-only 参考吞吐(7,760)的 42% 以上;代表性训练步耗时分解(表 10):q 生成 189.5s + actor 更新 24.9s + 学生权重同步 2.5s ≈ 232.6s,同步仅占 1.1%。图 4 显示观测纠正率(6.94%→5.40%→3.20%→1.67%→0)始终低于 Pinsker 上界并随 $\epsilon$ 退火精确归零。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 七基准宏观平均(Qwen3-1.7B 学生) | Mean@8 (%) | 29.0 | TRB 27.9 | +1.1 |
| 七基准宏观平均(Qwen3-1.7B 学生) | Pass@8 (%) | 47.5 | TRB 44.6 | +2.9 |
| 七基准宏观平均(Qwen3-0.6B 学生) | Mean@8 (%) | 18.4 | TRB 17.2 | +1.2 |
| 七基准宏观平均(Qwen3-0.6B 学生) | Pass@8 (%) | 35.6 | TRB 33.6 | +2.0 |
| 七基准宏观平均(1.7B 学生) | Mean@8 (%) | 29.0 | SKD 24.5 | +4.5 |
| 监督放置对照(1.7B,同教师模式更新预算) | Mean@8 / Pass@8 (%) | 29.00 / 47.50 | TV-Weighted-TM 28.24 / 46.77;Random-TM 28.30 / 45.50 | +0.76 / +0.73 (vs TV-Weighted) |
| 精确 q rollout 吞吐(64 prompt × 8 响应,K=8) | committed tokens/s | 3,276(引擎常驻) | 外部循环 776;学生-only 参考 7,760 | 4.22×,达学生-only 上限的 42%+ |
| 固定前缀探针(2,048 位置,1.7B) | 第 200 步 C1 / C16 增益 (pp) | +4.26 / +2.94 (vs TRB);+0.648 / +0.816 (vs Random-TM) | TRB / Random-TM | 高冲突组 C16 增益 Q4−Q1 = +1.07 pp (95% CI [0.87,1.29]) |
局限与改进
作者承认的局限:(1) 系统层面,精确 q rollout 仍显著慢于纯学生生成(3,276 vs 7,760 tokens/s),在线教师验证的内在成本无法消除,吞吐依赖响应长度、纠正率与每波接受数;(2) 纠正监督是瞬态的——$\epsilon$ 退火到 0 后即关闭,方法最终退回普通 OPD,收益依赖其持久化效应(论文用固定前缀探针证明了 149 步 RKL-only 后增益仍在,但更长训练是否成立未验证);(3) 实验仅覆盖数学推理、仅 Qwen3 家族,且因终止符约定不同必须使用 Base-to-Base 师生配对。我自己的观察:(1) 个别基准增益很小甚至为负——1.7B 的 MATH-500 仅 +0.2、AIME25 为 −0.5,0.6B 的 Minerva Pass@8(32.0)低于 TRB(34.9),说明改进集中在困难任务的 Pass@8 而非全面领先;(2) TV-Weighted-TM 在 Mean@8 上与 Random-TM 几乎持平(28.24 vs 28.30),路由优势主要体现在 Pass@8,提示其在'至少解对一次'上更强而非平均答案质量;(3) 教师硬 Top-1 目标在教师自身不确定的前缀可能传播其错误众数,且 $\epsilon$ 调度(0.02→0 共 50 步)与 $K=8$ 直接沿用 TRB 设置,缺乏敏感性分析;(4) 放置对照只在 1.7B 上做,0.6B 缺失;AIME 类基准题目数少(各 30 题),±0.5 量级的差异可能落在噪声区间,主表未报告置信区间。
独立分析的弱点
第一,教师模式目标的鲁棒性:纠正位置直接对教师 argmax 做硬标签 NLL,当教师在该前缀本身不确定(Top-1 概率很低、分布平坦)时,会把学生拉向一个可能错误的众数。改进方向:按教师置信度门控——仅在 $T_t(v^*)$ 超过阈值时启用硬目标,否则退回 teacher-sampled 或软 Top-k 目标。第二,吞吐天花板:即使引擎常驻也只达到学生-only 的 42%,且每步 232.6s 中 q 生成占 189.5s(约 81.5%)。改进方向:教师 KV 缓存跨波复用、按接受率动态调节块长 $K$、或在训练后期利用 $\epsilon=0$ 检测更激进地切换纯学生快路径(现有实现仅对精确零半径做检测)。第三,域与任务单一:全部实验为数学推理的可验证奖励场景,开放式生成、代码、多轮/代理任务中纠正事件的位置分布与 TV 率可能截然不同。改进方向:先在代码生成上验证,再研究纠正率作为任务难度在线指标的可能性。第四,消融不完整:$\epsilon$ 调度、退火步数、$K$ 均沿用 TRB 默认值,未做敏感性分析;放置对照与 TV 加权对照仅覆盖 1.7B。改进方向:补齐超参扫描与跨规模对照。第五,统计功效:AIME26/AIME25 各仅 30 题,Mean@8/Pass@8 的 ±0.5 差异可能在噪声内,主表没有置信区间(探针分析倒是用了 prompt 聚类 bootstrap)。改进方向:为主结果报告 bootstrap CI 或增加评测样本量。
未来方向
作者方向之外的延伸:(1) 自适应信任域调度——用观测纠正率相对 Pinsker 上界的裕量在线调节 $\epsilon$,让干预频率与学生学习进度挂钩,而非固定 50 步线性退火;(2) 与 RLVR 的组合——纠正位置的教师 Top-1 监督本质上是一步密集的教师模仿,可探索在强化学习训练中按同样路由方式混合教师信号,并研究其与组相对优势估计的相互作用;(3) 路由信号复用到其他 token 级目标——耦合纠正位置已被证明是高冲突位置的充分统计量,可接入 selective KL、反射式 credit assignment(如作者组的 AMR-SD)或工具调用场景的 token 级策略梯度;(4) 理论深化——接受分支 RKL 支持在 $\min\{p,q\}$ 上、纠正分支为点质量前向 KL 的精确分解,值得分析其与 JSD 等混合 f-散度的偏差-方差权衡,以及瞬态纠正监督为何留下持久对齐(类似隐式正则化);(5) 系统推广——引擎常驻精确 q 后端对任何需要'每位置双分布'的算法(在线 f-散度蒸馏、过程奖励打分、教师引导搜索)都是通用基础设施,可抽象为独立组件;(6) 扩展到弱-强极不对称设定(如 0.5B 学 70B 教师)与多教师路由,检验 TV 上界在极端情况下的实际意义。
复现评估
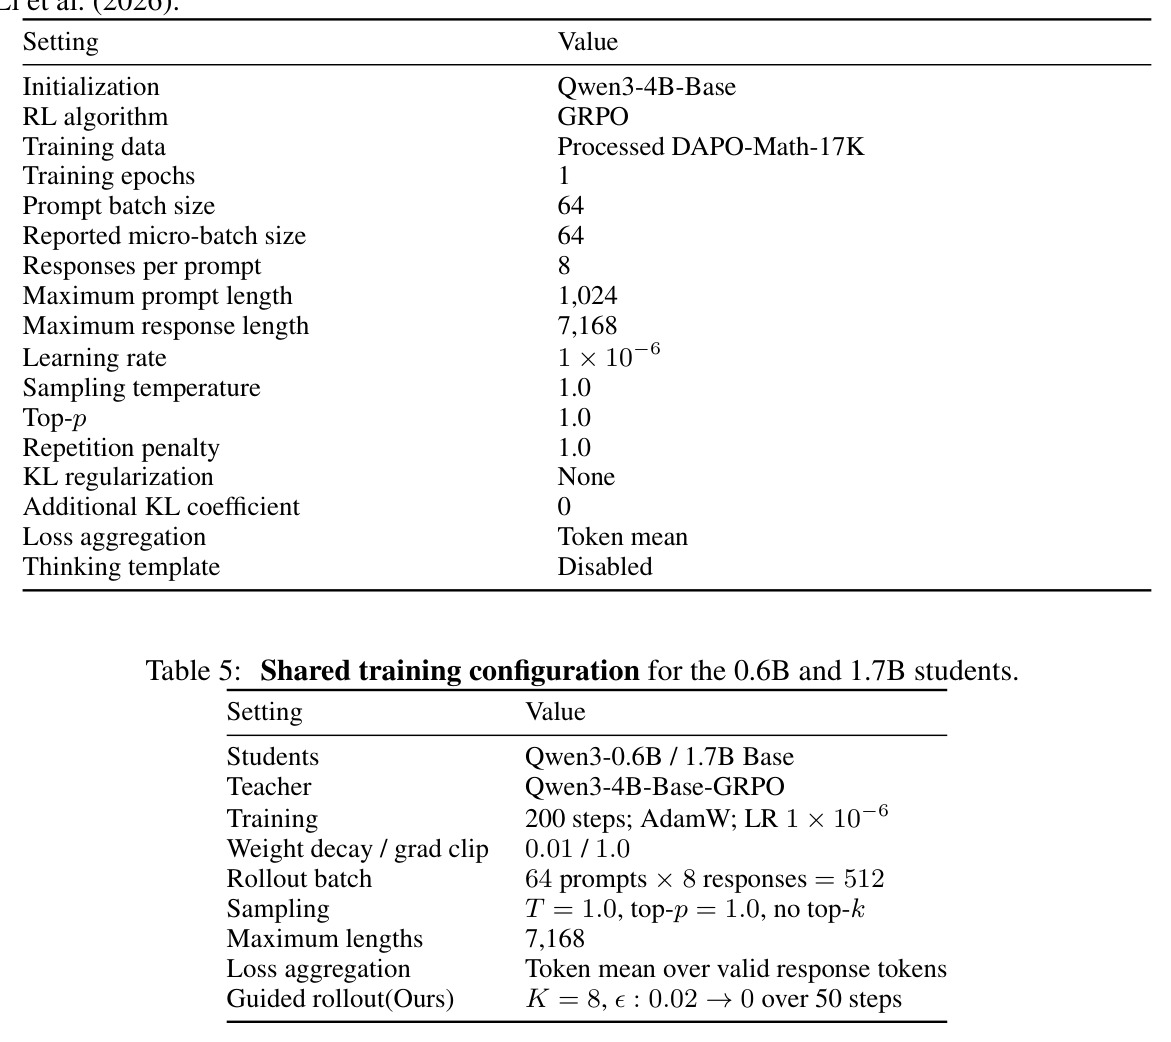
复现条件总体友好但系统部分门槛较高。论文声明提供核心组件的参考实现(GitHub: github.com/Miteto-sudo/SAKI),附录完整给出训练/评测配置(表 4-5)、桥接与耦合推导(附录 B/G)、精确执行证明(附录 I)与系统实现细节(附录 K)。数据与模型全部公开:DAPO-Math-17K 训练集(17,917 个 prompt),Qwen3-0.6B/1.7B-Base 学生;教师需按 Li et al. (2026) 的 GRPO 配方自行复现(Qwen3-4B-Base 初始化,1 epoch,prompt 批 64、每 prompt 8 响应、LR $1\times10^{-6}$、最大响应 7,168、禁用 KL 正则与思考模板)。算力方面,8×GPU 布局(GPU 0-3 跑 actor 更新,GPU 4-7 常驻 q 引擎)即可训练 200 步,单步约 232.6s,单规模总训练时长约 13 小时。难点在于复现 4.22× 吞吐的引擎常驻后端:需要在推理引擎内部实现 GPU 上的全词表桥接构造($[B,K,V]\to[BK,V]$)、16 波批量 $\beta$ 二分、向量化耦合接受($\alpha(a)=\exp(\min\{0,\log q(a)-\log p_s(a)\})$ 前缀累积积)、首次拒绝 KV 回滚,并通过附录 K.5 的四维正确性验证(桥接/耦合/训练状态/路由);若退化为外部循环实现(776 tokens/s),训练慢约 4 倍但算法结论应可保留。评测协议明确可对表:温度 1.0、每题 8 采样、最大 16,384 长度、七个公开基准。综合评级:算法复现中等难度,系统级完全复现偏难。
论文图表
教师构建配置:Qwen3-4B-Base 初始化、GRPO 算法、processed DAPO-Math-17K 数据、1 epoch、prompt 批 64、每 prompt 8 响应、最大 prompt/响应长度 1,024/7,168、学习率 $1\times10^{-6}$、温度 1.0、禁用 KL 正则与思考模板、token mean 损失聚合。
教师是所有方法的共同监督来源,此表给出精确复现教师检查点的全部超参数,是实验可比性与复现性的基础。
系统演进:Token-wise 原型(K=1,逐 token 外部 RPC)约 5 tokens/s;早期外部块验证(K=8)165–299 tokens/s;成熟外部循环 776 tokens/s;引擎常驻后端(GPU 上桥接/耦合)3,276 tokens/s。
展示 4.22× 加速不是单点优化而是系统结构演进的结果,量化了'logit 出引擎'这一通信瓶颈的代价,对复现者极具参考价值。