更好的监督就在近旁:邻域在线策略自蒸馏 Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation
将特权教师参数邻域的扰动专家组成池,逐状态路由监督以增强在线自蒸馏
前置知识
在线策略蒸馏(On-Policy Distillation)
学生模型自己从题目采样生成回答,教师在学生实际访问的前缀状态 $(x, y_{<t})$ 上提供下一个词元分布作为监督信号,从而避免离策略模仿训练中的状态分布失配问题。代表作有 GKD、MiniLLM 等思路。
本文的全部训练都发生在学生采样的 rollout 上,理解'监督施加在学生访问的状态'是读懂路由设计与 SCGate 门控的前提。
特权教师与自蒸馏(OPSD)
OPSD 用同一模型的两份拷贝:学生只看题目 $x$,特权教师额外看到训练期才可用的参考解答 $z$,在学生前缀上输出 $q_t(v)=\pi_{\bar\theta}(v\mid x,z,y_{<t})$,通过前向 KL 把参考信息蒸馏进学生;推理时只用学生。
N-OPSD 是对 OPSD 的直接扩展,本文所有基线(OPSD、OPSD+SCGate)与裁剪损失都继承自该框架,不清楚特权教师机制就无法理解'参考对齐纠正'。
逐词元裁剪前向 KL
把逐词元前向 KL 贡献 $\ell_{t,v}=\tilde q_t(v)\log\frac{\tilde q_t(v)}{p_t(v)}$ 截断到阈值 $\kappa$($\ell_{t,v}=\min(\ell_{t,v},\kappa)$),防止教师对个别词元概率极高的尖锐峰产生爆炸性梯度,是 OPSD 稳定训练的关键技巧。
本文的参考侧选择 clip($\kappa_{sel}$)与在线损失共用这一机制,裁剪阈值与锚定词元被裁掉的相互作用正是分位数路由设计的动机。
参数扰动专家(Neural Thickets 思路)
对同一基座检查点注入确定性的高斯噪声得到多个'邻域专家':$\bar\theta_j=\bar\theta+\epsilon_j$,$\epsilon_j\sim\mathcal N(0,\sigma^2 I)$。它们共享权重主体,只在微小参数邻域内行为不同,训练时全部冻结。
本文的证据基础是'邻域专家在相同参考上下文下给出互补纠正',不熟悉扰动专家就无法理解池的来源与半径 $\sigma$ 的意义。
贪心边际收益集合选择
从空集开始,每轮加入使目标函数 $\mathrm{Score}(S)=\sum\max_{j\in S}\tilde A_{j,t}$ 增益最大的候选。由于 max 结构,重叠纠正的边际收益会被自然抵消,从而隐式鼓励互补性,类似次模函数最大化的贪心近似。
论文的互补专家选择(K=25 从 501 个候选中选出)就是这一算法的实例,消融表里它与独立排序的 Top-K 选择的对比是核心证据。
Average@12 评测指标
对每道竞赛数学题采样 12 条回答,计算平均通过率,再对题目集取均值;相比 pass@1 更能反映模型的稳定性与分布质量,是 AIME/HMMT 评测中常用的稳健指标。
论文主表与全部消融都以 Average@12 报告(如 8B 上 66.57 对 64.63),且多数结论建立在三次独立运行的均值与标准差上。
研究动机
在线策略自蒸馏(OPSD)让特权教师在训练时额外看到参考解答,在学生自己采样的前缀上提供下一个词元分布来指导学生,效果已超过 GRPO(如 Qwen3-1.7B 三基准平均 41.88 对 37.70)。但标准 OPSD 在每个学生状态都用同一个未扰动教师 $M_0$:预测虽依赖学生前缀,监督却始终来自单一固定参数设置。固定教师未必能榨干同一基座的全部有用监督。论文的关键观察是:对教师参数做局部高斯扰动,可在相同参考上下文下揭示互补的、参考对齐的纠正——不同专家在不同参考位置提供纠正,其组合覆盖的选择可行参考位置比 $M_0$ 更多($\sigma=0.002$ 时选中池覆盖 26.53%,而 $M_0$ 仅 15.69%)。已有工作并不解决这个问题:TrustMOPD 按学生前缀加权专家监督,RandOpt 按任务正确率选扰动专家再做多数投票,但任务准确率并不反映监督价值(Cho & Hariharan, 2019),也没有刻画所选专家之间纠正的重叠程度。
本文的目标是论文的目标是把特权教师参数邻域中的互补参考对齐纠正,系统地转化为学生访问状态上的逐状态监督,在不增加推理成本的前提下放大 OPSD 的增益。具体分解为三个子目标:其一,设计离线选择准则,从约 501 个随机扰动候选(含 $M_0$)中挑出紧凑的 K=25 专家池,要求每个专家在参考位置上提供超出当前池已有最佳水平的纠正,显式避免冗余;其二,设计在线路由机制——在学生前缀上没有参考词元可参照时,为每个状态从池中挑选合适的专家分布作为训练目标;其三,保持 OPSD 的逐词元裁剪前向 KL 目标与'推理只用蒸馏后学生'的设定,在 Qwen3-1.7B/4B/8B 三个规模、AIME 2024/AIME 2025/HMMT February 2025 三个基准上验证相对 OPSD、EOPD、PW-OPSD 等强基线的稳定增益,并用匹配消融把收益归因到各个组件。
与已有工作不同的是,本文的独特切入角度是把'选哪个专家池'与'每个状态选哪份监督'彻底解耦,并把选择准则从任务级指标下沉到词元级纠正。RandOpt 按任务表现选扰动专家,但专家答对题的能力不等于其监督价值;TrustMOPD 在学生前缀上加权专家,却未建模专家间纠正的重叠。N-OPSD 改用过滤后正向教师优势(filtered PTA)的贪心边际收益构建池:只有当专家在低置信参考位置上、且前向 KL 贡献不超过裁剪阈值的纠正超过池内现有最佳时才得分,天然奖励互补。在线端则首次提出 MaxPeak 锚定分位数路由:用全池最高峰确定锚定词元方向(方向可由单个专家独立供出,无需池共识),再在同一顶层词元集合内按分位数选择支持强度——把'方向'与'支持度'分开,正是'最高峰专家未必给出最佳训练目标'这一实证发现的技术化表达(q=1 比 q=0.75 低 1.29 分)。
核心方法
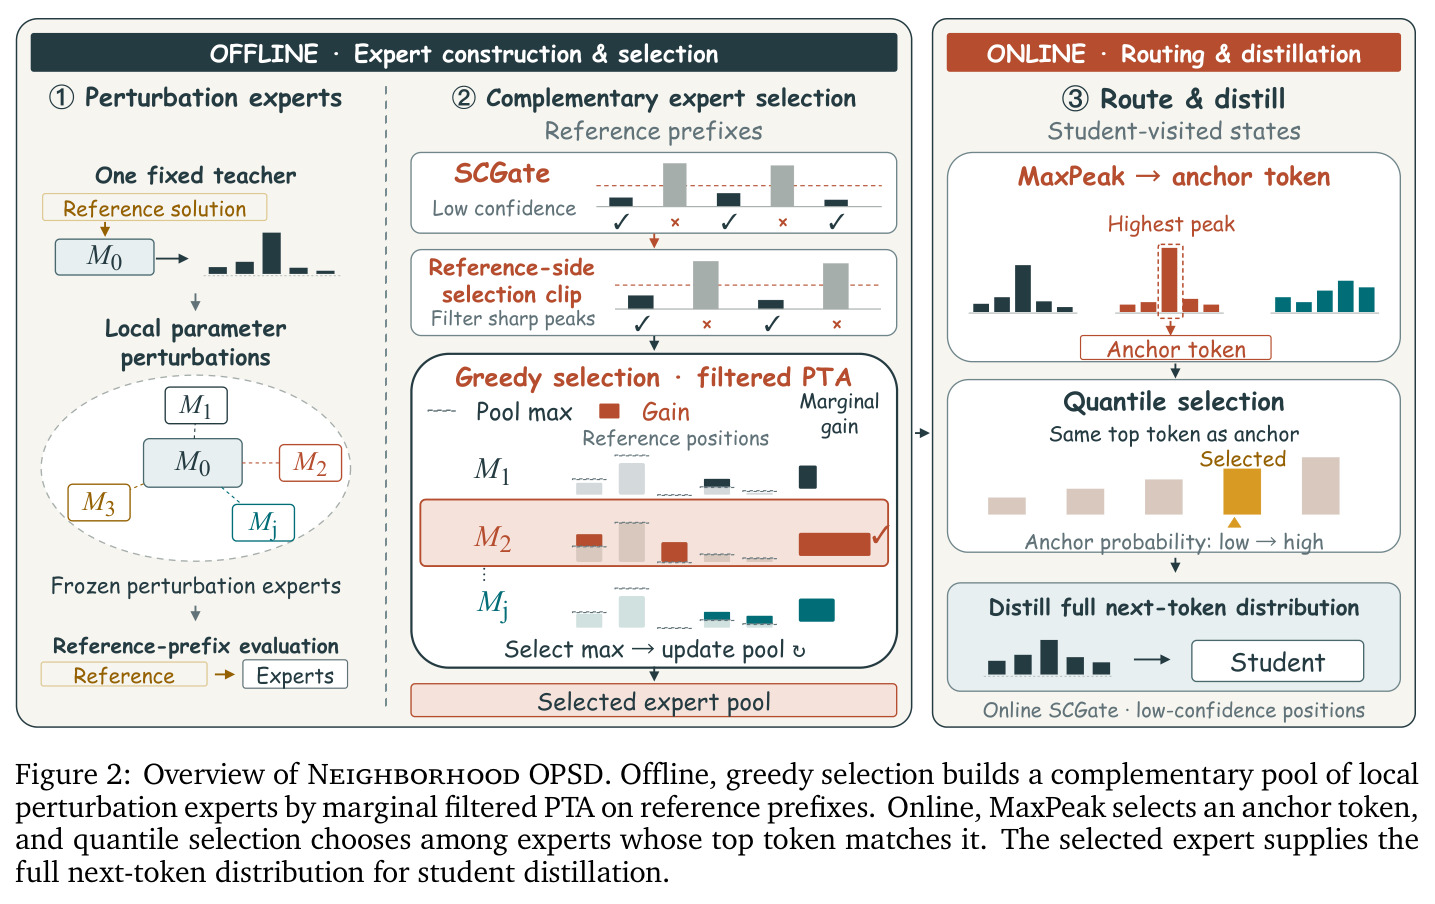
直觉上,固定教师对同一特权参考的解读并非唯一:对参数做微小高斯扰动得到的邻域专家,会在不同位置给出互补的、指向参考词元的纠正,把它们组成池并逐状态路由,能比单一教师覆盖更多需要监督的状态。技术上分离线在线两阶段。离线用 1000 道选题、501 个候选(含 $M_0$,扰动专家 $\bar\theta_j=\bar\theta+\epsilon_j$,$\epsilon_j\sim\mathcal N(0,\sigma^2 I)$,$\sigma=0.002$),在参考前缀上教师强制评估,计算过滤后正向教师优势 $\tilde A_{j,t}=g^{ref}_t\,\mathbb I[c_{j,t}\le\kappa_{sel}]\,[q_{j,t}(y^*_t)-p^S_t(y^*_t)]_+$,贪心最大化 $\mathrm{Score}(S)=\sum_{(x,z)}\sum_t\max_{j\in S}\tilde A_{j,t}$ 选出 K=25 个冻结专家。在线在每个学生状态 $s_t$ 上,先用 MaxPeak 取全池逐词元最大概率的词元作锚定 $a^*_t$,再在顶层词元一致的专家集合 $E_t$ 内按分位数 $q=0.75$ 选出供给完整分布的专家,用继承自 OPSD 的逐词元裁剪前向 KL 只更新学生参数;推理时只用蒸馏后的学生。
核心创新有二。其一,选择信号从任务准确率换成词元级互补纠正:以冻结的问题-only 模型 $p^S_t$ 为公共基线,只有当专家在 SCGate 保留的低置信位置($g^{ref}_t=\mathbb I[p^S_t(y^*_t)\le\tau_{sel}]$)抬高参考词元概率、且前向 KL 贡献 $c_{j,t}=q_{j,t}(y^*_t)\log\frac{q_{j,t}(y^*_t)}{p^S_t(y^*_t)}$ 不超过 $\kappa_{sel}=\kappa$(滤除会被在线裁剪压制的尖锐峰)时才给分,并只奖励超出池内现有最佳的部分,贪心前 50 步甚至不会选中 $M_0$。其二,在线路由把监督'方向'与'支持强度'解耦:MaxPeak 取 $j^*_t=\arg\max_j\max_v q^j_t(v)$ 的顶层词元作锚定,允许单个专家独立供向而无需池共识(参考侧锚定 top-1 准确率 95.58%,高于 $M_0$ 的 91.33%);随后在 $E_t=\{j:\arg\max_v q^j_t(v)=a^*_t\}$ 内按 $k_t=\lfloor q(|E_t|-1)\rfloor$ 选分位数专家。消融显示 q=1(总选最高峰专家)比 q=0.75 低 1.29 分,直接证明最强专家未必给出最佳目标。
方法步骤详情
流程分四步。第一步构造专家:固定教师快照 $\bar\theta$,用确定性种子生成扰动专家 $\bar\theta_j=\bar\theta+\epsilon_j$,加上 $M_0$ 共 501 个候选,全部冻结并共享同一特权参考。第二步离线选择:在 1000 道选题的参考前缀上教师强制评估;先按 $g^{ref}_t=\mathbb I[p^S_t(y^*_t)\le\tau_{sel}]$ 过滤高置信位置(问题-only 模型在 65.63% 的位置 top-1 置信度 $\ge 0.99$、这些位置准确率高达 97.67%,监督价值集中在低置信处),再剔除 $c_{j,t}>\kappa_{sel}$ 的尖锐参考峰,对 filtered PTA 贪心选 K=25;半径用学生前缀续写探针校准为 $\sigma=0.002$。第三步在线路由与蒸馏:学生采样 rollout,每个状态由池内专家计算分布,MaxPeak 定锚定词元、$q=0.75$ 选出专家;对 SCGate 保留($p_t(y_t)\le\tau=0.99$)的位置施加逐词元裁剪损失 $\ell_{t,v}=\min(\tilde q_t(v)\log\frac{\tilde q_t(v)}{p_t(v)},\ \kappa)$,按保留位置归一化,只更新学生。第四步评估:AIME24/25、HMMT25 上 Average@12,每方法三次独立运行。
技术新颖性
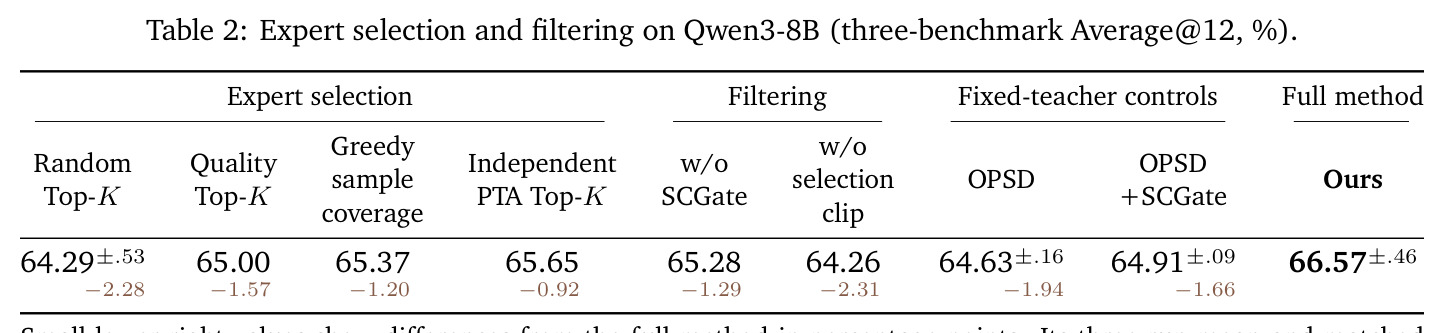
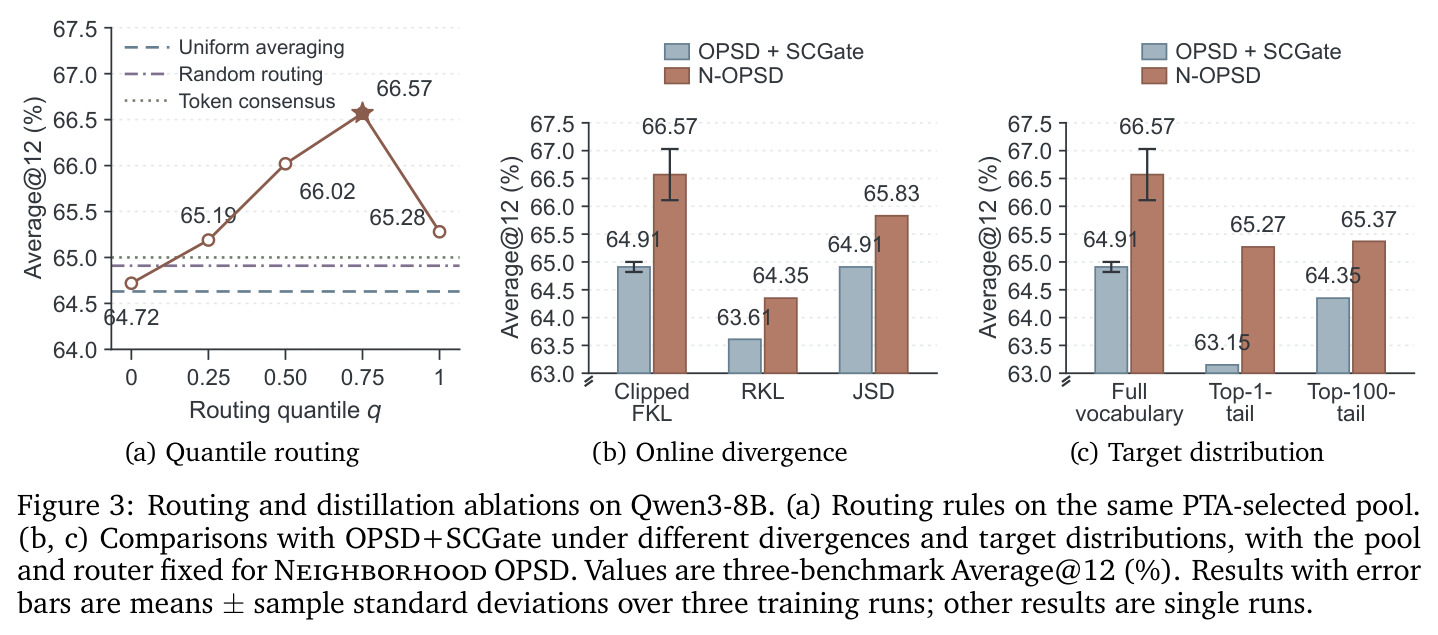
与已有工作的本质区别有三层。相对标准 OPSD(Zhao et al., 2026),N-OPSD 首次证明特权教师的参考对齐监督可以系统性超越其未扰动参数设置,并给出量化证据:K=25 池在 $\sigma=0.002$ 的选择可行覆盖率 26.53%,远高于 $M_0$ 的 15.69%。相对 RandOpt 等按任务表现选扰动专家的方法,本文用参考词元上的 filtered PTA 作选择信号,消融直接支持任务准确率与监督价值脱钩:Quality Top-K 65.00、Greedy sample coverage 65.37、Independent PTA Top-K 65.65、贪心边际 PTA 66.57,层层递进。相对 TrustMOPD 等多教师加权方案,本文显式建模池内纠正重叠并逐状态路由单一专家的完整分布,路由规则本身贡献显著:Uniform averaging 64.91、Random routing 65.19、Token consensus 65.28,均低于完整方法的 66.57。此外,路由目标被证明与散度选择(RKL/JSD)和目标压缩(Top-N-tail)正交,可叠加使用。
实验结果
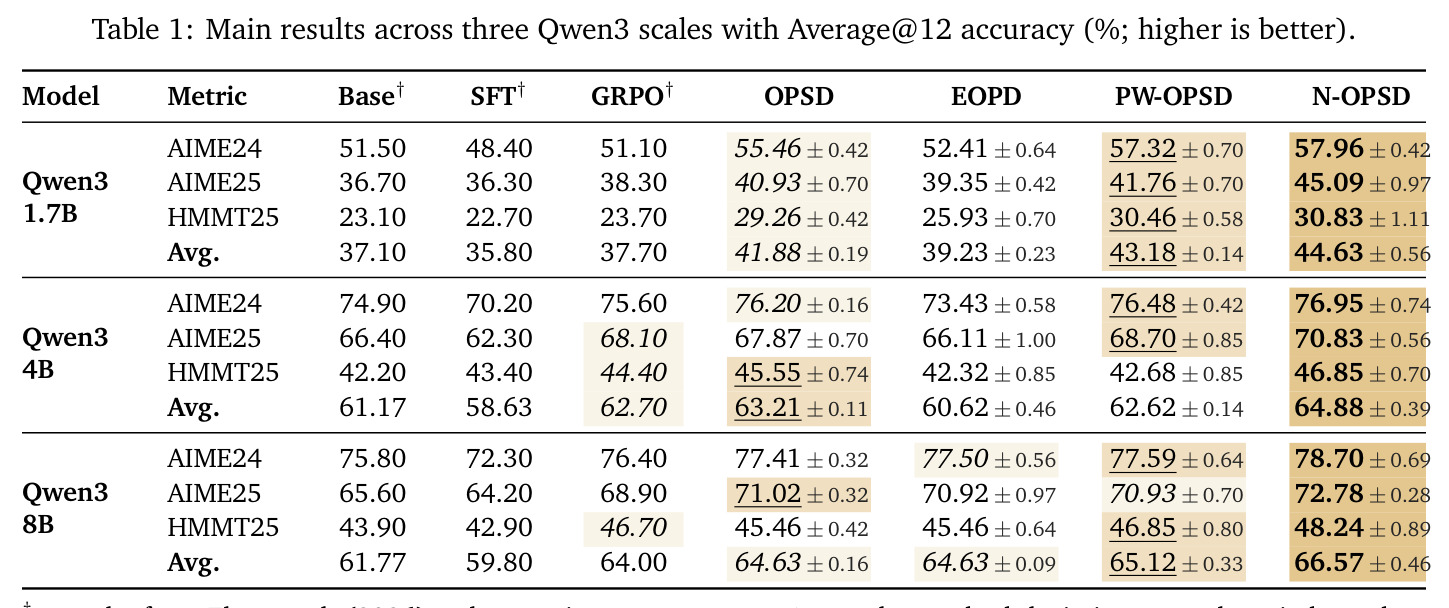
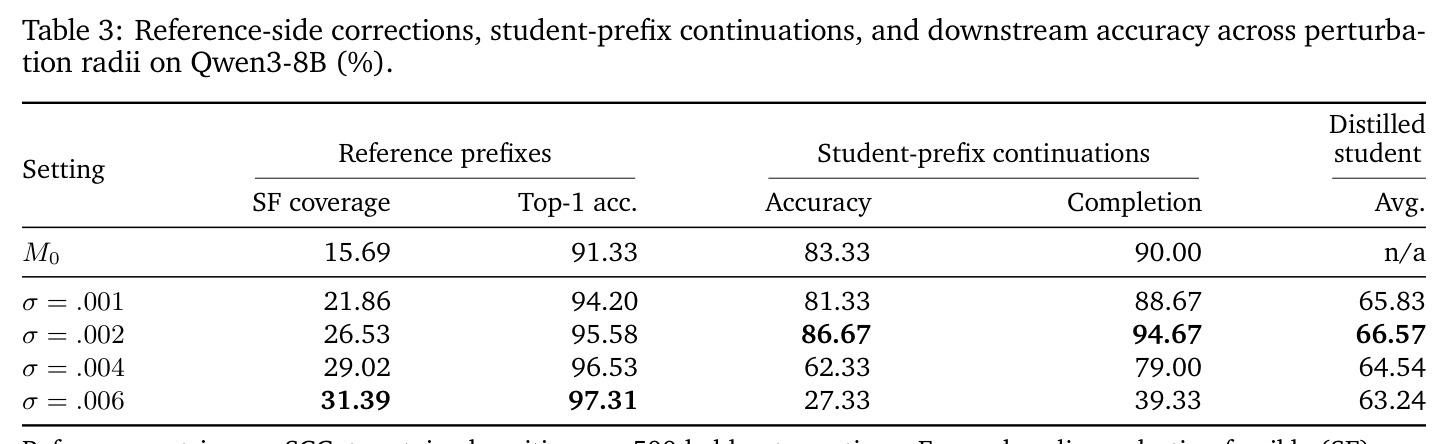
主实验用 Qwen3-1.7B/4B/8B 在 1 万道 OpenThoughts 题上训练 100 个优化步,AIME24/AIME25/HMMT25 上报告 Average@12,每方法三次独立运行。N-OPSD 在全部 9 个模型-基准组合中均排第一:三基准平均相对 OPSD 分别提升 2.75(44.63±0.56 对 41.88±0.19)、1.67(64.88±0.39 对 63.21±0.11)和 1.94 分(66.57±0.46 对 64.63±0.16),同时超过 PW-OPSD(43.18/62.62/65.12)与 EOPD;亮点如 1.7B 的 AIME25 45.09 对 40.93(+4.16)。消融(8B)逐项归因:贪心 PTA 选择 66.57 高于 Random/Quality/Greedy-coverage/Independent-PTA Top-K(64.29/65.00/65.37/65.65);去 SCGate 降 1.29 分,去参考侧 clip 降 2.31 分;路由上 Uniform/Random/Token-consensus 为 64.91/65.19/65.28,q=1 比 q=0.75 低 1.29 分。表 3 显示 $\sigma=0.002$ 下游最优(66.57)且续写准确率最高(86.67%、完成率 94.67%),而覆盖率更高的 $\sigma=0.006$(31.39%)续写骤降至 27.33%。K 从 1 到 25 把平均从 64.54 提到 66.57,K=50 反而降到 64.35。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AIME 2024 + AIME 2025 + HMMT 2025 平均(Qwen3-1.7B) | Average@12 准确率 (%) | 44.63 ± 0.56 | OPSD 41.88 ± 0.19(PW-OPSD 43.18) | +2.75(对 PW-OPSD +1.45) |
| AIME 2025(Qwen3-1.7B) | Average@12 准确率 (%) | 45.09 ± 0.97 | OPSD 40.93 ± 0.70 | +4.16 |
| AIME 2024 + AIME 2025 + HMMT 2025 平均(Qwen3-4B) | Average@12 准确率 (%) | 64.88 ± 0.39 | OPSD 63.21 ± 0.11 | +1.67 |
| AIME 2024 + AIME 2025 + HMMT 2025 平均(Qwen3-8B) | Average@12 准确率 (%) | 66.57 ± 0.46 | OPSD 64.63 ± 0.16 | +1.94 |
| HMMT February 2025(Qwen3-8B) | Average@12 准确率 (%) | 48.24 ± 0.89 | OPSD 45.46 ± 0.42 | +2.78 |
| 学生前缀续写探针(300 条前缀,Qwen3-8B) | 续写准确率 / 完成率 (%) | 86.67 / 94.67(Raw MaxPeak,σ=0.002) | M0 教师 83.33 / 90.00 | +3.34 / +4.67 |
局限与改进
作者承认并讨论的局限:一是训练开销增加,K=25 时估计步时为 OPSD+SCGate 的 1.423 倍(虽比 K=50 省 25.63%),因为每个状态都要对整池冻结专家做前向;二是专家池在参考前缀上离线选出,与学生实际访问的前缀分布存在偏移,虽然 300 条学生前缀续写实验(准确率 83.33%→86.67%、完成率 90.00%→94.67%)支持迁移,但探针只用冻结基座学生验证过;三是超参耦合较强,σ、K、q、τ 需要联合调节——K=50 时最优分位数从 0.75 移到 0.50(64.35→65.83),且表 3 显示参考侧覆盖率与锚定准确率随 σ 单调上升而下游收益在 σ=0.002 后下降,代理指标与最终指标并不完全对齐。我的补充观察:实验仅限数学推理与 Qwen3 家族,扩展到代码、智能体等长链任务的适用性未验证;专家池在整个训练中固定,长训或持续训练下是否仍互补未知;全部专家同源(同一基座+高斯扰动),多样性来源单一。
独立分析的弱点
独立分析几点弱点。第一,离线选择依赖参考解答的教师强制评估,需要 1000 道带参考解的题目和 501 个候选在数万参考位置上的前向计算,选择成本高且对选题分布敏感;若选题与训练分布不一致,选出的池可能失配,可考虑混入学生 rollout 前缀做选择或周期性重选。第二,路由假设锚定词元方向正确:MaxPeak 在参考侧 top-1 准确率 95.58%,但论文未报告学生前缀偏移下的锚定错误率,一旦锚定错误整步监督就指向错误方向,可加入与 $M_0$ 或池共识的一致性校验、或在 $E_t$ 为空集时回退到 $M_0$。第三,分位数 q 是全局常数,而不同状态需要的支持强度显然不同——论文自己发现 q=0 过弱、q=1 过强,按教师熵或学生-教师差距自适应调度 q 值得探索。第四,K=25 步时已是基线的 1.423 倍,随模型增大该开销线性增长,可用 LoRA 化扰动、KV 缓存共享或蒸馏期逐步收缩池来降本。第五,所有专家源自同一基座的高斯扰动,与真正异构教师(不同家族模型)组合的效果未知。
未来方向
作者在附录 F 讨论了局限与未来工作,结合成果可延伸的方向包括:其一,把路由目标与散度自适应、词元加权叠加——论文已证明在 RKL、JSD 及 Top-1-tail/Top-100-tail 压缩目标下 N-OPSD 仍稳定占优(二元目标下仍领先 OPSD+SCGate 2.12 分),组合增益值得系统研究;其二,专家池动态化:随训练进程用在线 filtered PTA 重选或增删专家,避免固定池在长训练后失效;其三,与特权上下文选择(Tian et al., 2026)结合,在'换参数'之外再'换解读方式',两个多样性来源可能互补;其四,研究 σ 的自适应调度——训练早期小半径保稳定、后期增大扩覆盖,替代一次性的续写探针校准;其五,把锚定词元准确率与最终准确率做因果分析,并验证对代码生成、多步智能体等长链推理任务的可迁移性;其六,用低秩扰动、专家分布缓存或池剪枝把训练成本压向单教师 OPSD,推动实际落地。
复现评估
复现评估:这是 2026 年美团 LongCat 团队与合作机构的工作,正文未提及开源代码或模型权重,目前无法直接下载复现。所需资源较重:训练覆盖 Qwen3-1.7B/4B/8B 三个规模、1 万道 OpenThoughts 题、100 个优化步、全参数优化,且每个方法跑三次独立运行;离线选择要在 1000 道题上对 501 个候选做教师强制评估;在线训练每步需对 K=25 个冻结专家在学生 rollout 上前向(步时约 1.423× OPSD+SCGate),8B 级别估计需要多卡高端 GPU 集群。有利的一面是论文超参与实现细节披露非常完整:σ=0.002、K=25、q=0.75、τ=τ_sel=0.99、κ_sel=κ、候选 501、选题 1000、12 采样 Average@12 评估,附录 B 给出全部配置,附录 D 给出阈值敏感性与步时估计,附录 E 给出参考侧审计与续写探针。若代码开放,1.7B 规模复现约需数卡天;按论文描述纯手工复刻难度中等,主要工程量在多专家并行前向与逐状态路由的实现。
论文图表
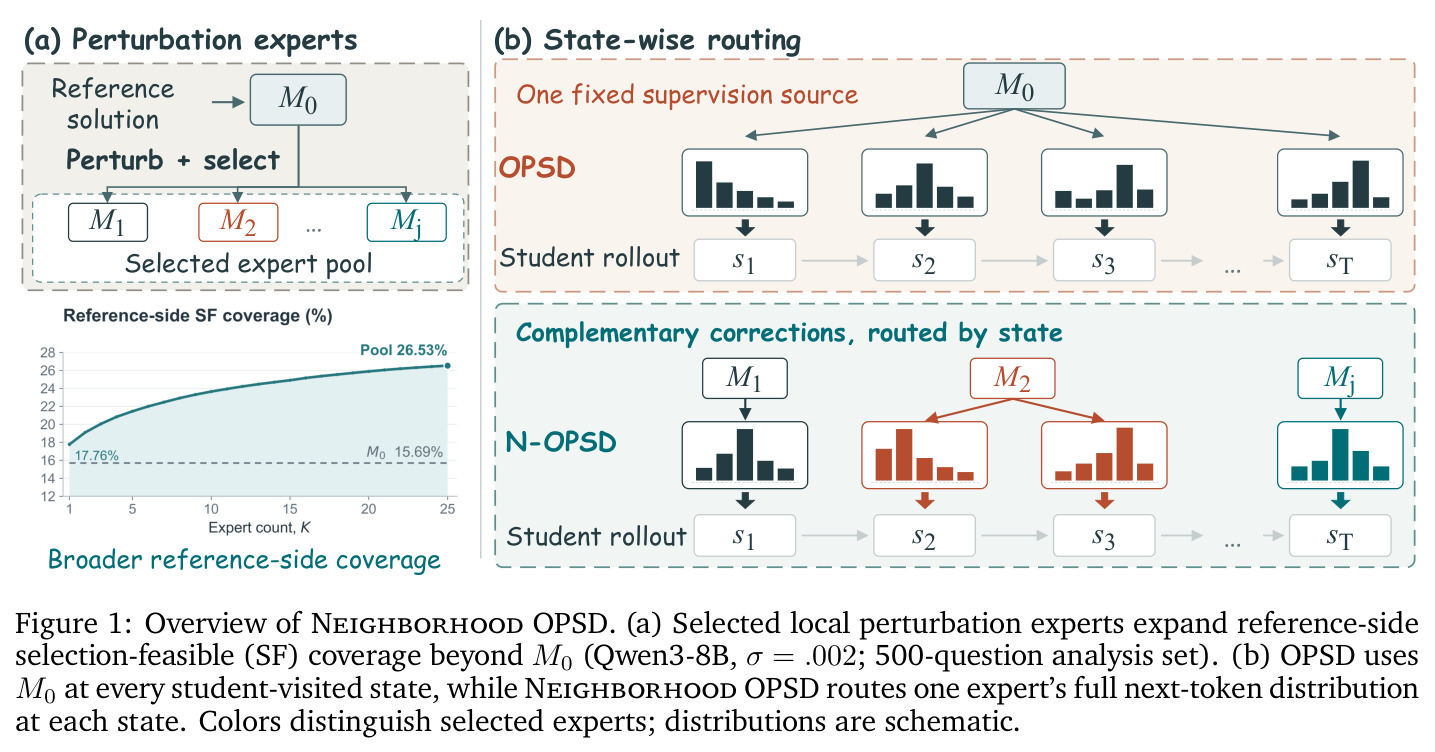
概念总览图。左半部分 (a) 展示扰动专家如何扩展监督覆盖:对教师 $M_0$ 做局部扰动并筛选出专家池 $M_1, M_2, \ldots, M_j$ 后,参考侧选择可行(SF)覆盖率从 $M_0$ 的 15.69% 提升到 26.53%(Qwen3-8B,σ=0.002,500 题分析集);右半部分 (b) 对比标准 OPSD(每个学生状态 $s_1,\ldots,s_T$ 都用同一个 $M_0$ 监督)与 N-OPSD(每个状态由路由选出的不同专家提供完整的下一个词元分布,颜色区分不同专家)。
这张图用一张图讲清了论文的两个核心主张:邻域专家比单一教师覆盖更多需要纠正的参考位置(为什么要扩展监督源),以及逐状态路由与固定教师的区别(怎么用这个池)。看懂它就抓住了论文的动机与方法骨架,是阅读正文前的最佳入口。