ROSS:通过选择性监督从自生成轨迹中再学习 ROSS: Relearning from Self-Generated Rollouts through Selective Supervision
把RL训练中被丢弃的历史自生成轨迹变成可复用经验,只对精选片段施加模仿损失
前置知识
自生成滚动
LLM 后训练中由模型自己采样生成的完整输出序列:RL 训练中每个策略检查点采样的一批回答,或在线策略蒸馏中学生模型在各状态下生成的轨迹。这些数据既承载模型已发现的有效行为(成功推理、备选策略、自我恢复),也夹杂错误、放弃的尝试和冗余探索;随着策略推进,它们通常被当作过时副产品直接丢弃。
ROSS 的全部前提就是把这份被丢弃的自生成经验当作可复用资产。理解 rollouts 的产生机制与'既兼容又掺杂噪声'的双重属性,是读懂论文动机与方法设计的起点。
在线策略蒸馏(OPD/MOPD)
一种蒸馏范式:由学生模型自己采样轨迹,教师模型只在学生访问到的状态上提供逐 token 监督(如下一 token 概率分布),从而保证训练分布与学生策略一致。多教师版本 MOPD 则由多个教师分别覆盖数学、代码、指令遵循等不同领域。
MOPD 是论文三大实验场景之一,六基准平均分 58.40 到 62.20 的核心提升即来自它;理解 OPD 有助于明白为何其历史数据对最终策略'近似在策'。
NLL 与 pass@k
负对数似然 NLL 衡量一段文本在策略 $\pi_\theta$ 下的 $-\sum_t \log \pi_\theta(z_t \mid z_{<t})$,数值越低说明该文本与策略的输出分布越兼容。pass@k 表示每个问题采样 $k$ 次至少成功一次的概率;pass@1 与 pass@32 之间的巨大差距说明'能力存在但未可靠表达'。
论文第 2 节正是用这两个指标定量论证历史经验'兼容但欠巩固'(NLL 接近当前策略、pass@32=99.0% 而 pass@1 仅 37.7%),这是全文立论的实证支柱。
GRPO 与结果级奖励
GRPO 等结果级 RL 算法只在轨迹结束后给出 0/1 奖励(答案对错、测试通过、环境成功),并把同一奖励均匀分配给整条轨迹的所有 token。因此即使轨迹最终成功,其中的局部错误、中途放弃和冗余探索也会被一并强化。
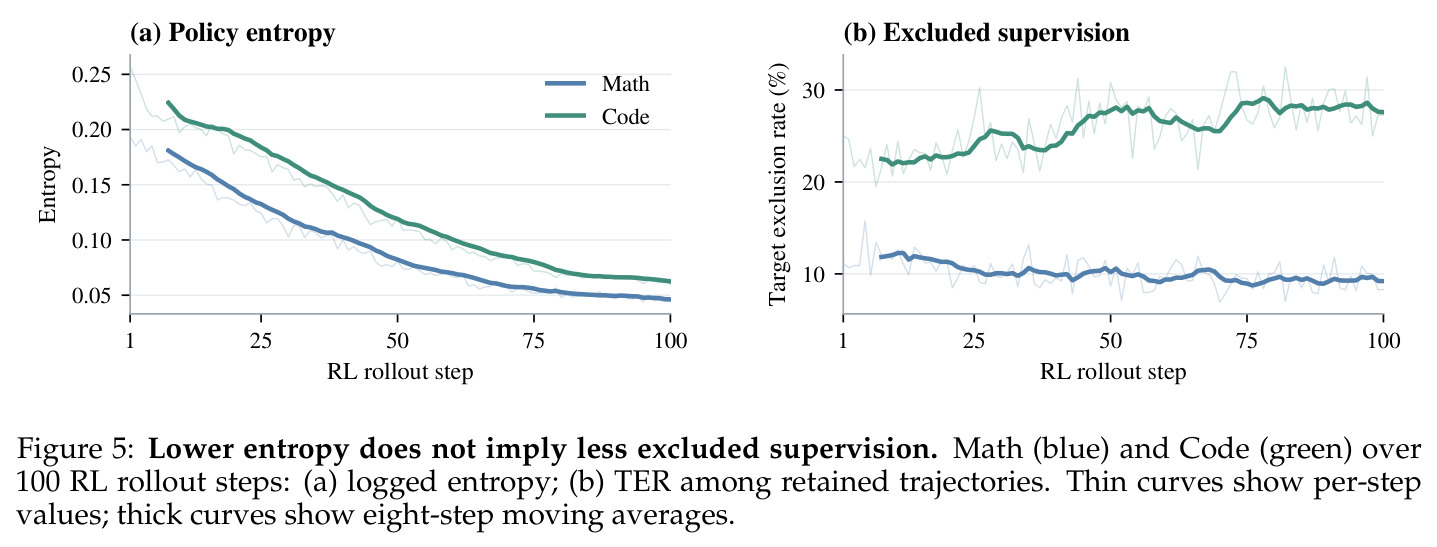
它解释了为什么成功 rollout 内部会积累不可模仿的片段,从而引出 token 级选择性监督的必要性;论文第 4.5 节明确以 GRPO 为例说明 TER 不随训练消失的现象。
掩码 SFT(损失掩码)
在 SFT 的 teacher forcing 中引入二值掩码 $m_t \in \{0,1\}$,损失只对 $m_t=1$ 的 token 计算负对数似然;$m_t=0$ 的 token 不接收梯度,但仍保留在序列中作为前缀上下文参与后续 token 的条件预测,即'从损失中消失而非从序列中消失'。
ROSS 的训练目标(公式 4)正是这种掩码 SFT 的应用:错误和冗余保留在上下文里以再现原始决策状态,但不被模仿,这是它与常规数据清洗后 SFT 的本质区别。
研究动机
LLM 后训练(强化学习 RL 与在线策略蒸馏 OPD)在训练中不断产生自生成 rollouts,但这些经验通常随策略更新被当作过时数据直接丢弃。作者在第 2 节揭示了两个关键事实:其一,历史 rollouts 与后期策略高度兼容——在 100 个数学问题上,历史 rollouts 在最终策略下的 token 级 NLL 与当前策略自身 rollouts 相当,且明显低于外部教师 GLM-5.2 的轨迹,是‘近似在策’的监督源;其二,这些行为虽兼容却未被巩固——在 100 个最难训练问题上(98 题至少有一条历史 rollout 成功),最终策略 pass@32 高达 99.0%,但 pass@1 平均仅 37.7%,且 74/98 题的单次成功率不超过 50%。更麻烦的是,即使最终答案正确的 rollout,内部也混杂着中间错误、放弃的尝试和冗余探索:如附录 D 的例题中,模型先犯下 $2^{10}=1024$ 的计数错误,随后才自我纠正回正确答案 1007。这意味着轨迹级筛选(只保留成功轨迹)不足以保证每一步都值得模仿,而整条轨迹丢弃又浪费了宝贵的行为经验。
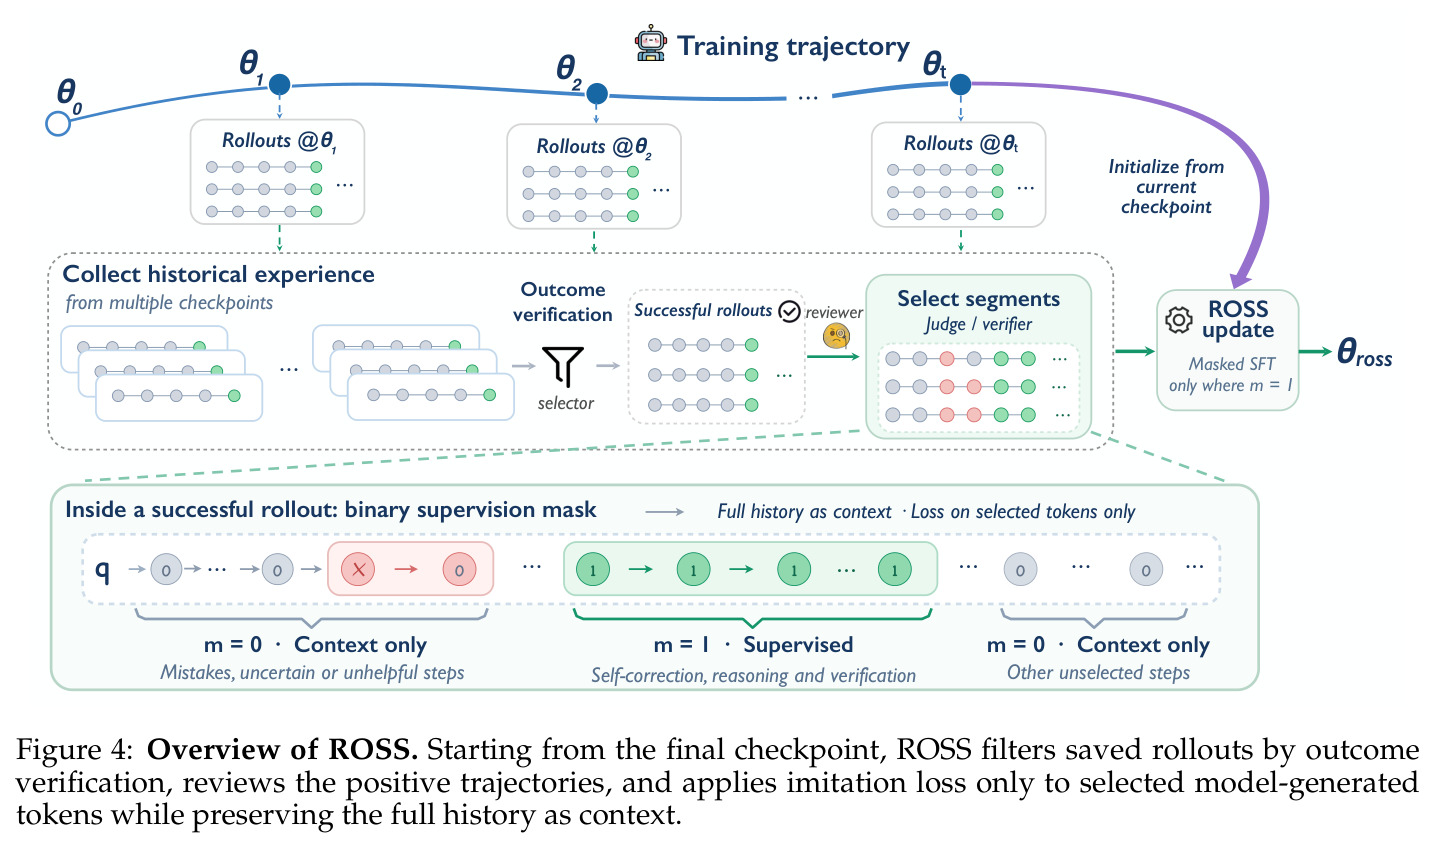
本文的目标是本文的目标是把 LLM 后训练产生的历史自生成 rollouts 从一次性副产品变成可复用的训练资产,让最终 checkpoint 能从中继续学习。具体包含两个层次的'选择性':在轨迹层面,用结果验证器(精确答案匹配、可执行检查器、单元测试或环境成功信号)筛出真正成功的历史轨迹;在片段层面,用 LLM 审查器在成功轨迹内部定位'局部正确、自洽、行为上有用'的模型生成片段,只对这些片段施加模仿损失。同时要求保留完整历史轨迹作为上下文,使被监督的片段在其原始发生状态(包括之前的错误、绕路和环境反馈)下被预测,从而在'巩固已发现但未稳定表达的行为'与'不强化错误和冗余'之间取得平衡,最终在数学、代码、指令遵循和软件工程上全面提升上游 checkpoint。
与已有工作不同的是,现有从自生成数据学习的工作大体把 rollout 当作不可分割的监督单元:RFT 和 RAFT 生成候选后只在整条正确或高质量路径上微调;ReST-MCTS* 用过程奖励引导树搜索做迭代自训练;RLoop 复用中间策略的成功轨迹初始化后续 RL 阶段;RIFT 用标量奖励重加权正负轨迹而非丢弃。过程监督方向(ProcessBench、ThinkPRM)关注识别错误推理步骤,STeP 和 SRFT 开始使用损失掩码避开错误步骤,但主要面向当前策略新生成的数据;与本文最接近的 SWE-Prime 从成功的软件工程轨迹中按贡献、可学性和风险选择片段。ROSS 的独特切入在于:先把'何时值得重访历史经验'形式化为兼容性与互补性两个维度(Figure 2),再专门针对'上游训练中间检查点产生的、对最终策略近似在策的历史成功轨迹'这一数据源,提出轨迹级验证加 token 级审查的两层选择,并配合'完整上下文、选择性目标'的训练配方。
核心方法
直觉上,训练中模型发现的许多有效行为会随策略演化而在当前 rollout 分布中变得欠表达,这些‘已发现但没学牢’的行为恰是历史经验中最有价值的部分。ROSS 是一条纯离线的额外训练流水线:从原始训练的最终 checkpoint $\pi_{\theta_T}$ 出发,先收集历史经验池 $\mathcal{H}_{<T} = \bigcup_{k<T} \mathcal{D}_k$(各中间检查点保存的 rollout 批次);用结果验证器 $v(\tau)$ 做轨迹级筛选得到正轨迹集合 $\mathcal{H}^+$;再用分阶段的 LLM 审查程序 $\mathcal{A}$(GLM-5.2 high-thinking 模式,只审查原始轨迹而不生成替换目标)为每条正轨迹标注审计状态 $q_\tau$ 与有序监督区间 $K_\tau$;经确定性边界检查与 token 对齐校验 VALIDATE 后编译成 token 级掩码;最后从最终 checkpoint 出发执行掩码 teacher forcing 的 SFT。全程无需任何额外策略 rollout。
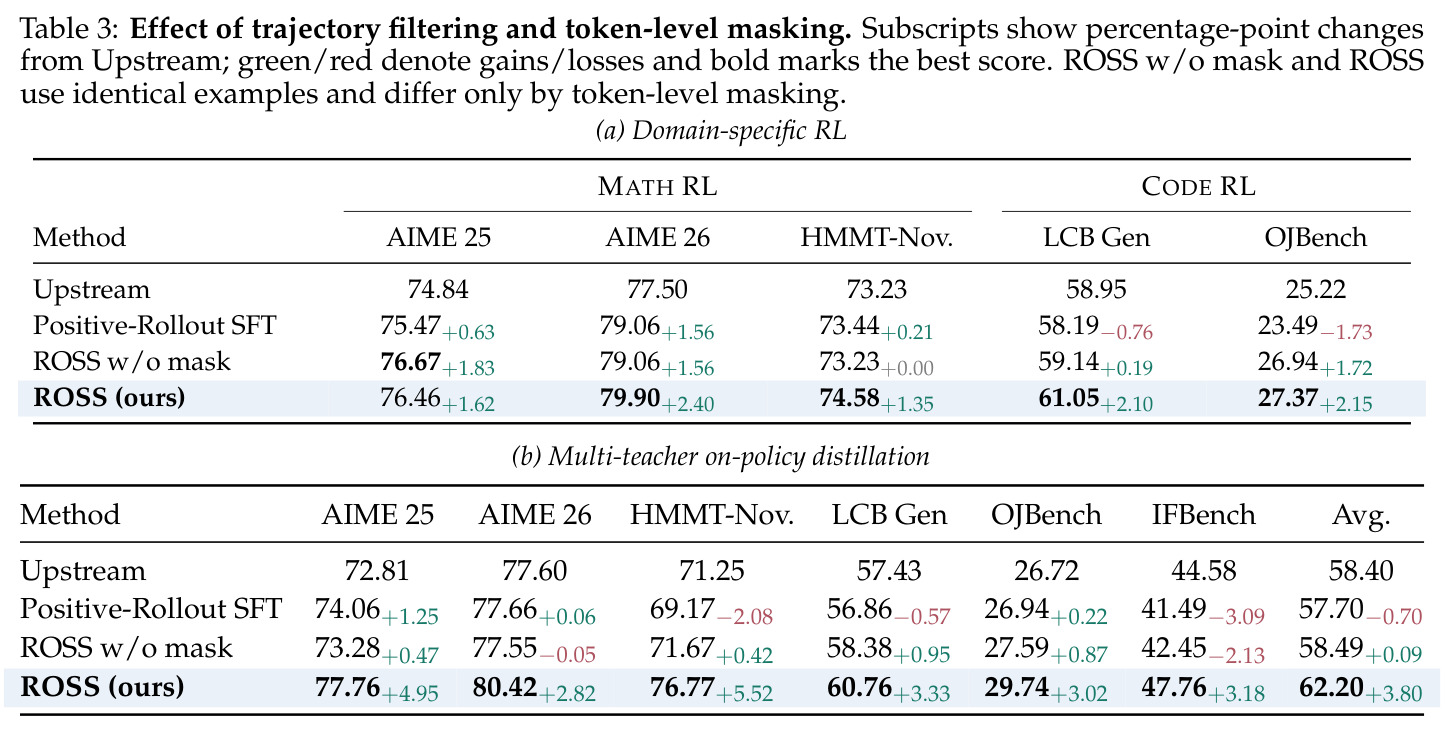
核心创新是‘完整上下文 + 选择性目标’的训练信号设计。形式化地,每条 rollout 表示为 $\tau = (z_1, \dots, z_L)$,$a_t \in \{0,1\}$ 标记该 token 是否为模型生成的可模仿 token(提示与环境观察 $a_t=0$),审查产生的监督掩码满足 $m_t \le a_t$。训练目标为 $\mathcal{L}_{ROSS}(\theta) = -\sum_{\tau \in \mathcal{H}_{ROSS}} \sum_t m_t(\tau) \log \pi_\theta(z_t \mid z_{<t}) / \sum_t m_t(\tau)$,关键在于被掩码的 token 并不从序列中移除:被选中 token 依然在完整原始前缀(含早期错误、放弃尝试、环境反馈)条件下被预测。这与传统 SFT 把整条轨迹当目标、或清洗脏数据再训练有本质区别——错误保留在上下文中作为‘原始状态再现’,但不接收梯度。消融证明其价值:同样样本下仅增加掩码,MOPD 六基准平均分即从 58.49 提到 62.20(+3.71)。
方法步骤详情
第一步,收集历史经验池 $\mathcal{H}_{<T}$:保存 RL/OPD 各检查点的 rollout 批次 $\mathcal{D}_k$,涵盖数学 RL、代码 RL、MOPD 与 OpenSWE 智能体轨迹。第二步,轨迹级筛选:验证器 $v(\tau)$ 依据精确答案、单元测试或环境成功信号,保留正轨迹集合 $\mathcal{H}^+$。第三步,分阶段 LLM 审查:GLM-5.2(high-thinking)读取任务、完整轨迹与验证器证据,单轮响应做正片段提取、智能体历史做缺陷定位,输出审计状态 $q_\tau$ 与有序监督区间 $K_\tau$;无法在不保留已确认错误或不引入缺失推理的情况下提取有效目标则拒绝。第四步,掩码编译与校验:把区间编译为 token 掩码 $m_t(\tau) = a_t \cdot \mathbf{1}[t \in K_\tau]$(仅模型生成的 token 可被监督,$m_t \le a_t$),VALIDATE 做源一致性与 token 对齐的确定性检查。第五步,从最终 checkpoint 起按 $\mathcal{L}_{ROSS}$ 做 3 个 epoch 掩码 SFT(单轮 no-thinking,智能体保留思考轨迹)。
技术新颖性
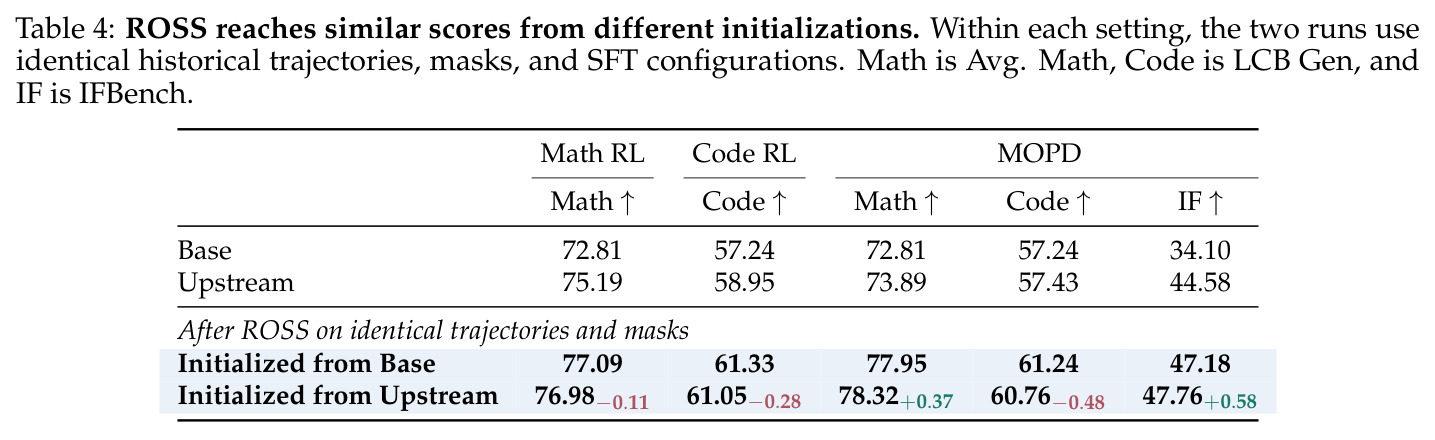
技术新颖性体现在三点。第一,问题定义新:论文首次系统论证'上游训练留下的 rollout 历史本身是可复用资产',用 NLL 兼容性(历史 rollouts 接近当前策略、低于外部教师 GLM-5.2)与 pass@k 差距(pass@32=99.0% 对 pass@1=37.7%)给出实证刻画,并通过 Table 4 进一步证明这种价值可跨初始化迁移——从 Base 初始化的 ROSS 与从 Upstream 初始化效果相当。第二,监督粒度新:把'成功轨迹'从整体单元拆解到 token 级,并提出'目标排除率 TER'来刻画成功 rollout 内部应去除的监督:Math 中 68.3%–72.7% 的被排除内容是错误后的可见纠正,Code 中 67.9%–76.6% 是冗余探索,且 TER 不随训练消失(Code 甚至从 22.65% 升至 28.07%)。第三,工程配方新:LLM 审查只做审计不做重写(保留数据的自生成性质),配合确定性 VALIDATE 校验保证掩码的源一致性与 token 对齐,单轮与智能体两种形态最终统一编译为同一种 token 掩码。
实验结果
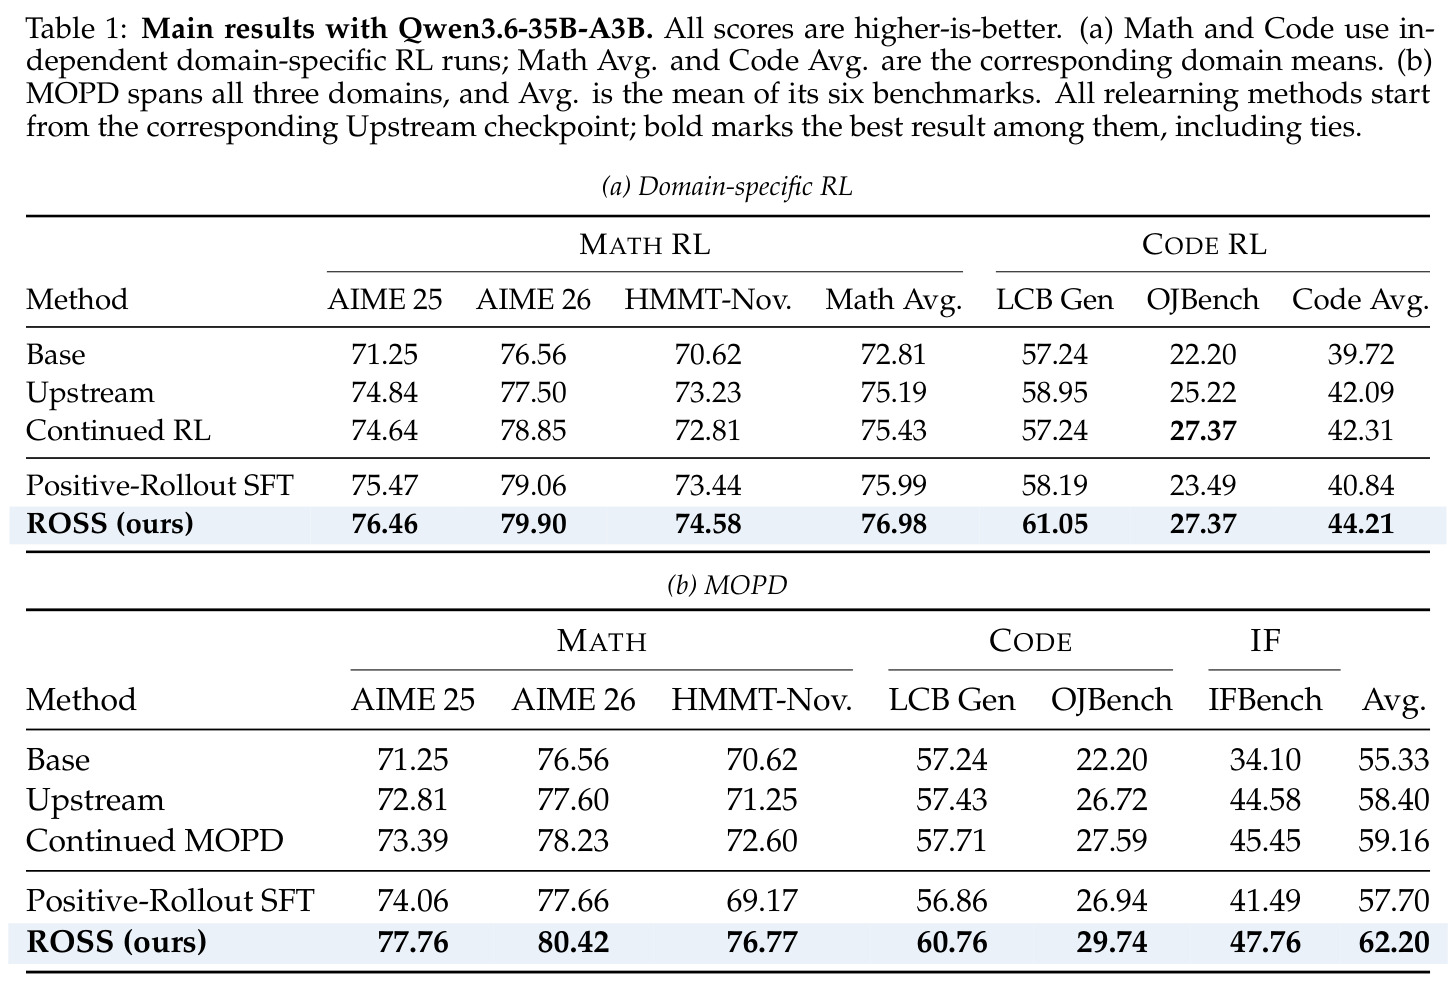
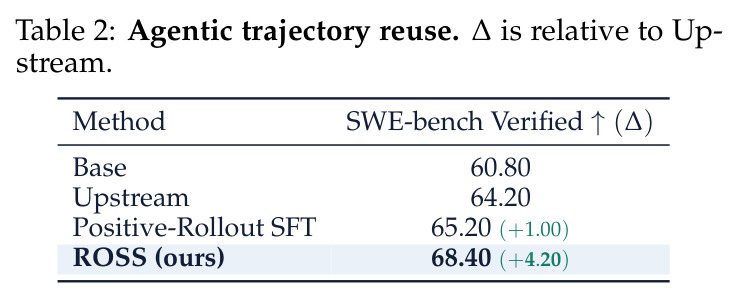
论文在 Qwen3.6-35B-A3B 上完成三组主实验。领域 RL:ROSS 把 Math 平均分从 75.19 提到 76.98,Code 平均分从 42.09 提到 44.21,超过 Continued RL 与 Positive-Rollout SFT。MOPD:六基准平均从 58.40 提到 62.20(+3.80),AIME25 +4.95、HMMT +5.52,而 Positive-Rollout SFT 反而降到 57.70。智能体 RL:SWE-bench Verified 从 64.20 提到 68.40(+4.20,Positive-Rollout SFT 仅 +1.00)。消融把增益拆成两层:轨迹过滤已能反转正轨迹全量 SFT 在 Code 上的退化,token 掩码再贡献 MOPD +3.71。跨初始化实验表明价值不依赖 Upstream 参数继承:Base 初始化达 77.09,与 Upstream 初始化的 76.98 相当。TER 分析显示 Math 从 11.60% 降至 9.27%、Code 从 22.65% 升至 28.07%,说明熵下降不意味着可全量模仿;附录 H 的 4B 运行中平均分从 52.05 提到 63.65。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(领域 RL 后再学习) | Math Avg(AIME25/AIME26/HMMT-Nov 均分) | 76.98 | Upstream 75.19(Continued RL 75.43,Positive-Rollout SFT 75.99) | +1.79 |
| 代码生成(领域 RL 后再学习) | Code Avg(LCB Gen/OJBench 均分) | 44.21 | Upstream 42.09(Continued RL 42.31,Positive-Rollout SFT 40.84) | +2.12 |
| 多教师在线策略蒸馏 MOPD | 六基准平均(AIME25/AIME26/HMMT/LCB Gen/OJBench/IFBench) | 62.20 | Upstream 58.40(Continued MOPD 59.16,Positive-Rollout SFT 57.70) | +3.80 |
| 智能体软件工程 | SWE-bench Verified 解决率 | 68.40% | Upstream 64.20%(Positive-Rollout SFT 65.20%) | +4.20 个百分点 |
| 指令遵循(MOPD 后再学习) | IFBench | 47.76 | Upstream 44.58(Positive-Rollout SFT 41.49) | +3.18 |
| 数学(4B 模型 RL 运行,附录 H) | Avg Math | 63.65 | Upstream 52.05(存在重复回答模式) | +11.60 |
局限与改进
作者没有设置专门的局限性章节,但从实验设置可读出几点边界:第一,流水线依赖可靠的结果验证器 $v(\tau)$,实验全部集中在数学、代码、指令遵循和 SWE 等可验证任务上,缺乏验证器的开放域场景未涉及;第二,token 级标注依赖 GLM-5.2 high-thinking 的审查质量,论文未报告审查器自身的错误率、ACCEPT 比例与标注成本;第三,单轮实验全部在 no-thinking 配置下进行、只训练 3 个 epoch,掩码数量与训练超参的敏感性未系统探索;第四,主实验集中在 Qwen3.6-35B-A3B 一个模型(附录 H 追加 4B 运行),跨模型族与更大规模的泛化证据有限;第五,对照方法 Continued RL/MOPD 只延长两个 epoch 或 200 步,‘训练更久是否同样有效’的对比强度一般。我的观察是:LLM 审查器可能倾向把‘像标准解法’的片段标为有用,而新颖但非常规的探索行为可能被误排除,与论文‘巩固已发现行为’的初衷存在张力;历史 rollouts 与评测基准间的潜在污染也未讨论。
独立分析的弱点
独立分析几个弱点。其一,成本与可扩展性:每个候选 rollout 都要经过强 LLM(GLM-5.2 high-thinking)逐条审查,数十万级 rollout 池的标注开销可观,且每次上游训练更新都需重新审查;改进方向是先用当前策略 token 概率或轻量分类器粗筛(低 NLL 高置信片段优先),只在边界样本上调用大模型。其二,验证器覆盖:$g(\tau)=\mathbf{1}[v(\tau)=1]$ 完全依赖任务可验证性,无法处理‘部分正确’的长程智能体轨迹(如完成大部分步骤但最终失败的 SWE 任务),可引入部分信用或步骤级验证器。其三,掩码误差传播:审查器漏标会剔除有用行为,误标则继续强化错误;VALIDATE 只保证 token 对齐等确定性约束,不保证语义正确,可加双审查员一致性或用过程奖励模型事后审计掩码。其四,训练动态未探索:ROSS 是训练后的一次性阶段,训练中周期性再学习与结束后一次性处理的优劣、多次迭代的收益递减均未回答。其五,AIME、SWE-bench 等基准存在污染可能,历史 rollouts 与评测集的去重审计缺失。
未来方向
作者方向上:附录 H 展示 ROSS 能抑制重复回答等不良模式,提示可发展为'选择性巩固 + 去噪'的通用后训练收尾阶段;结论中提出的'系统性巩固策略演化中的可复用行为足迹'暗示未来可将 ROSS 嵌入训练循环,周期性地从滚动经验池中回放。可延伸的方向包括:第一,把 LLM 审查替换或混合为策略自身信号(当前策略 NLL、token 熵、过程奖励模型分数),实现全自动、可随训练在线更新的掩码生成;第二,研究跨模型经验迁移——Table 4 已证明历史 rollouts 不依赖 Upstream 参数继承即可生效,那么不同架构或不同规模的模型能否直接消费彼此的 rollout 经验值得探索;第三,与在线方法结合,例如在 GRPO 类算法中对采样轨迹施加 token 级优势掩码,把 ROSS 的离线洞察带进在线训练以避免强化局部错误;第四,从理论上刻画掩码 SFT 对梯度方差、分布收缩和过拟合历史分布的影响;第五,把选择性监督从负对数似然扩展到偏好优化(DPO 类)目标,在偏好对内部做片段级选择。
复现评估
论文未在正文给出代码或数据开源声明,作者为 AllSpark Team(企业团队),完全复现门槛较高。所需资源包括:Qwen3.6-35B-A3B 底座及其 RL/MOPD 训练产物(或自行复现上游训练,这本身是最大成本);GLM-5.2 API 作为 LLM 审查器(附录 E 给出了标注协议与核心审查提示词);智能体实验需要 Harbor 框架、Codex CLI agent 和 daVinci-Env 的 OpenSWE 容器化任务环境;35B-A3B 级 MoE 模型 3 个 epoch 的 SFT 需要多卡 GPU 集群。综合评估复现难度中等偏难:方法描述与消融设计相当完整(附录 B 给出完整算法、附录 C 给出训练与评测配置、附录 E 给出标注协议、附录 F 给出排除内容分类体系),核心思想'验证器筛选 + LLM 审查 + 掩码 SFT'可以在小得多的模型规模上独立验证;但历史 rollouts 本身依赖原始训练 run 的完整存档(各检查点 rollout 批次、熵日志、验证器结果),第三方难以获得等价数据,这一数据依赖是复现的最大障碍。
论文图表
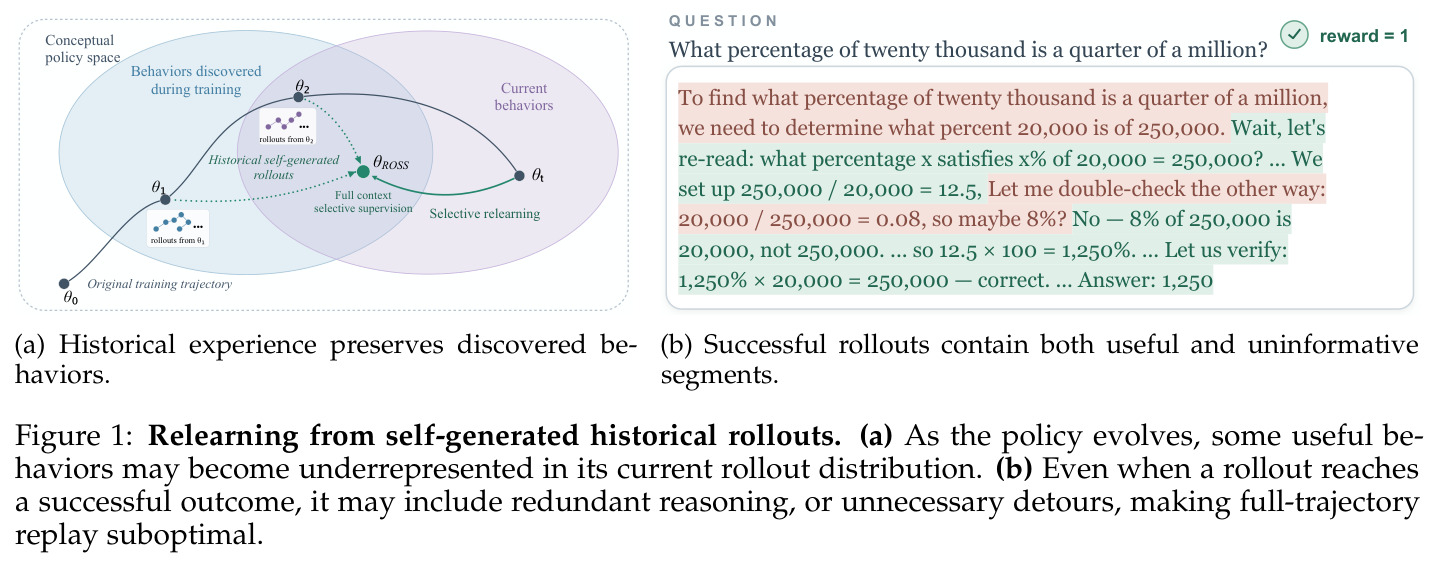
两联示意图。(a) 概念策略空间:策略从 $\theta_0$ 演化到 $\theta_t$,$\theta_1$ 时期发现的部分有效行为(如百分比应用题的正确解法)在当前 rollout 分布中变得欠表达;$\theta_{ROSS}$ 以完整历史轨迹为上下文做选择性再学习,把这些行为找回来。(b) 一个成功 rollout 的片段拆解示例:内部同时包含有用的验证推理(如'1,250% × 20,000 = 250,000 — correct')与冗余推理、不必要的绕路(如先算出 8% 又推翻),说明结果级正确不等于每一步都值得模仿。
一图同时呈现问题动机(行为遗忘 + 成功轨迹不纯)与方法直觉(以完整轨迹为上下文的选择性监督),是理解全文逻辑的入口。
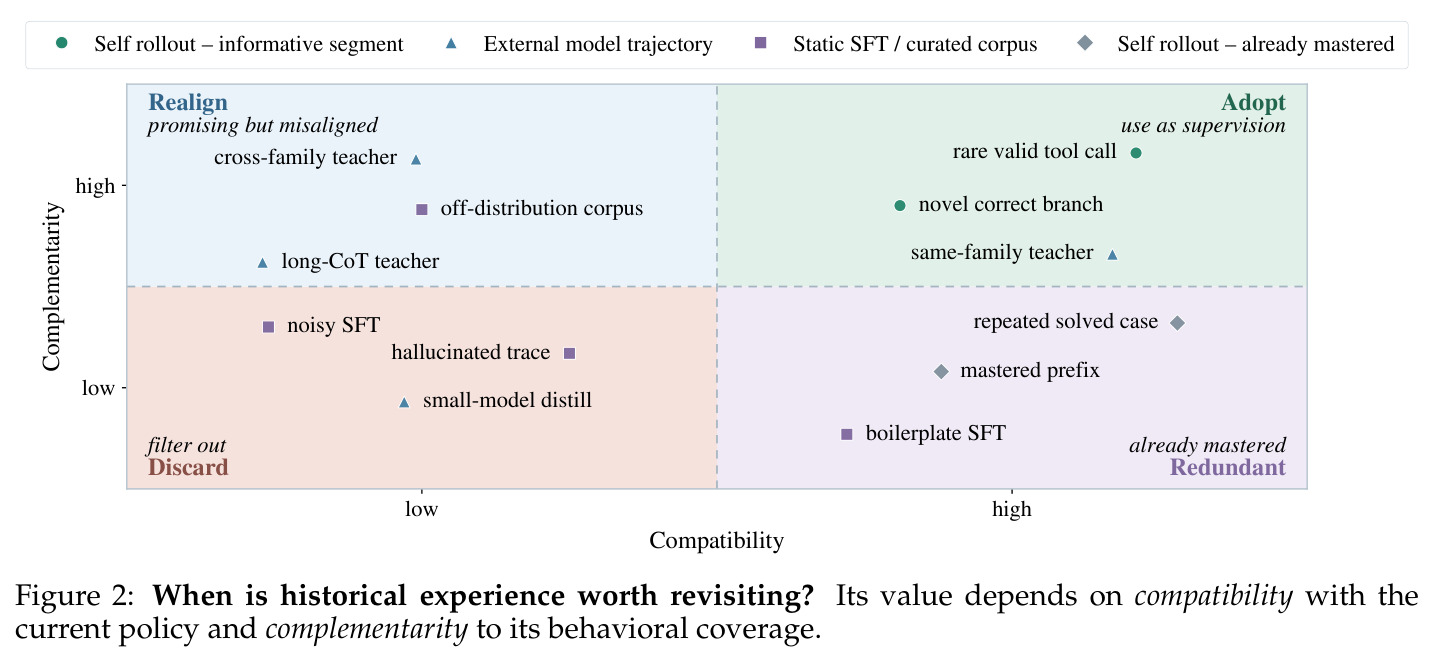
以'与当前策略的兼容性'为横轴、'对当前行为覆盖的互补性'为纵轴的二维定性地图:高兼容且高互补的经验(同族教师的正确新分支、罕见的有效工具调用、novel correct branch)值得采纳;低兼容的(跨族教师、off-distribution 语料、噪声 SFT、小模型蒸馏)应丢弃;高兼容但已被当前策略覆盖的(重复已解题、模板化 SFT、已掌握的前缀)属于冗余;幻觉轨迹等则无价值。
给出全文的决策框架:解释为什么 ROSS 只需要'验证器 + LLM 审查器'两层筛选就能定位值得重访的历史经验,而不需要更复杂的经验价值理论。
三联实证图。(a) 历史 rollouts、当前策略 rollouts 与外部教师 GLM-5.2 轨迹在当前策略下的 token 级 NLL 对比:历史 rollouts 的 NLL 明显低于外部教师、接近当前策略(阈值 ≤0.8 nats 附近),说明兼容性高;(b) 98 个历史已解决难题上最终策略的逐题成功率分布,均值仅 37.7%,74/98 的题目成功率 ≤50%;(c) pass@k 曲线:k=1 时 37.7%,k=8 时 89.8%,k=32 时达 99.0%。
用数据证明'兼容但未巩固'这一核心前提:历史行为存在于策略支撑集内(pass@32≈99%)却不被可靠表达(pass@1=37.7%),是第 2 节动机分析的定量支柱。