在线还是离线学习?知识蒸馏动力学的系统性研究 On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
强到弱蒸馏中,KL方向与学习率而非rollout策略决定性能、遗忘与更新稀疏性。
前置知识
强到弱蒸馏(Strong-to-Weak Distillation)
让参数量更大的教师模型为较小的学生模型提供逐 token 的输出分布监督:在相同前缀下最小化学生与教师 next-token 分布之间的散度(如 KL),把教师的推理行为转移到学生。本文中教师被冻结,学生对全部参数做微调。
整篇论文以强到弱蒸馏作为受控试验台,所有关于 on/off-policy 的结论都是在这个设定下得出的,理解该设定才能理解实验变量的含义。
OnPD 与 OffPD(在线/离线策略蒸馏)
区别在于训练轨迹由谁生成:OffPD(off-policy)用冻结教师采样完整回答,学生在这些固定轨迹上对齐分布;OnPD(on-policy)由学生自己采样轨迹,再沿轨迹向教师查询逐 token 监督。on-policy 需要训练全程持续生成,计算成本显著更高。
论文的核心问题就是『rollout 策略(谁生成训练轨迹)到底贡献了多少差异』,这两个术语是全文的自变量。
前向 KL 与反向 KL
前向 KL $D_{F\text{-KL}}=\sum_v \pi_T(v)\log\frac{\pi_T(v)}{\pi_S(v)}$ 以教师分布加权,mode-covering,重罚学生漏掉教师支持的 token;反向 KL $D_{R\text{-KL}}=\sum_v \pi_S(v)\log\frac{\pi_S(v)}{\pi_T(v)}$ 以学生分布加权,mode-seeking,惩罚学生在教师认为极不可能处放概率。传统上分别与 OffPD/OnPD 搭配。
论文证明 KL 方向(而非 rollout 策略)才是决定任务性能与输出覆盖的主因,必须把两者解耦才能读懂实验设计。
灾难性遗忘与更新稀疏性
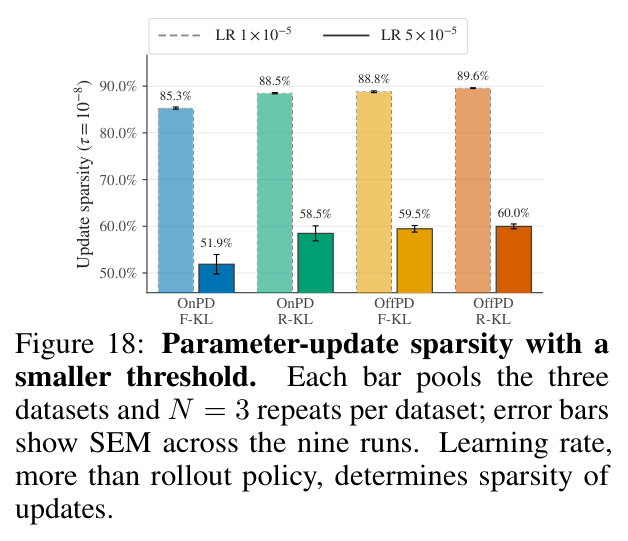
前者指学新任务后在 7 个 OOD 基准(MMLU-Pro、TruthfulQA、IFEval、HumanEval、EQ-Bench、BBQ、ToxiGen,共 3935 例)上的平均分下降;后者定义为 $S_\tau=\frac{1}{P}\sum_i \mathbb{I}[|\theta^{final}_i-\theta^{init}_i|<\tau]$(本文 $\tau=10^{-6}$),即参数基本未动的比例。此前工作声称 on-policy 训练能减少遗忘、更新更稀疏。
这两项正是检验『on-policy 优势』说法的关键指标,而论文结论是它们主要由学习率控制,与 rollout 策略关系不大。
RLVR 与 GRPO
RLVR 指用可验证奖励(答案对错可程序化判定)做强化学习;GRPO 对每个 prompt 采样一组候选、用组内相对优势做策略梯度,常配 DAPO 损失。本文用它训练任务教师(Science/MedReason),并在蒸馏之后继续训练更难的 Countdown-4,检验各种蒸馏配置作为 RLVR 起点的表现。
RLVR 是『on-policy 更优』这一流行说法的主要来源,也是蒸馏实验的上游(教师训练)与下游(后续 RLVR)环节。
pass@k
每题采样 k 个回答、至少一个正确的比例,衡量模型的输出覆盖(多样性与能力的组合)。pass@1 相同的两个模型在 pass@10 上可能差距巨大,因此 pass@1 与 pass@k 的差距反映答案分布的分散程度。
论文用 pass@1/pass@10 之差区分 KL 方向对输出覆盖的影响,并发现这是前向 KL 的一个此前被忽视的优势。
研究动机
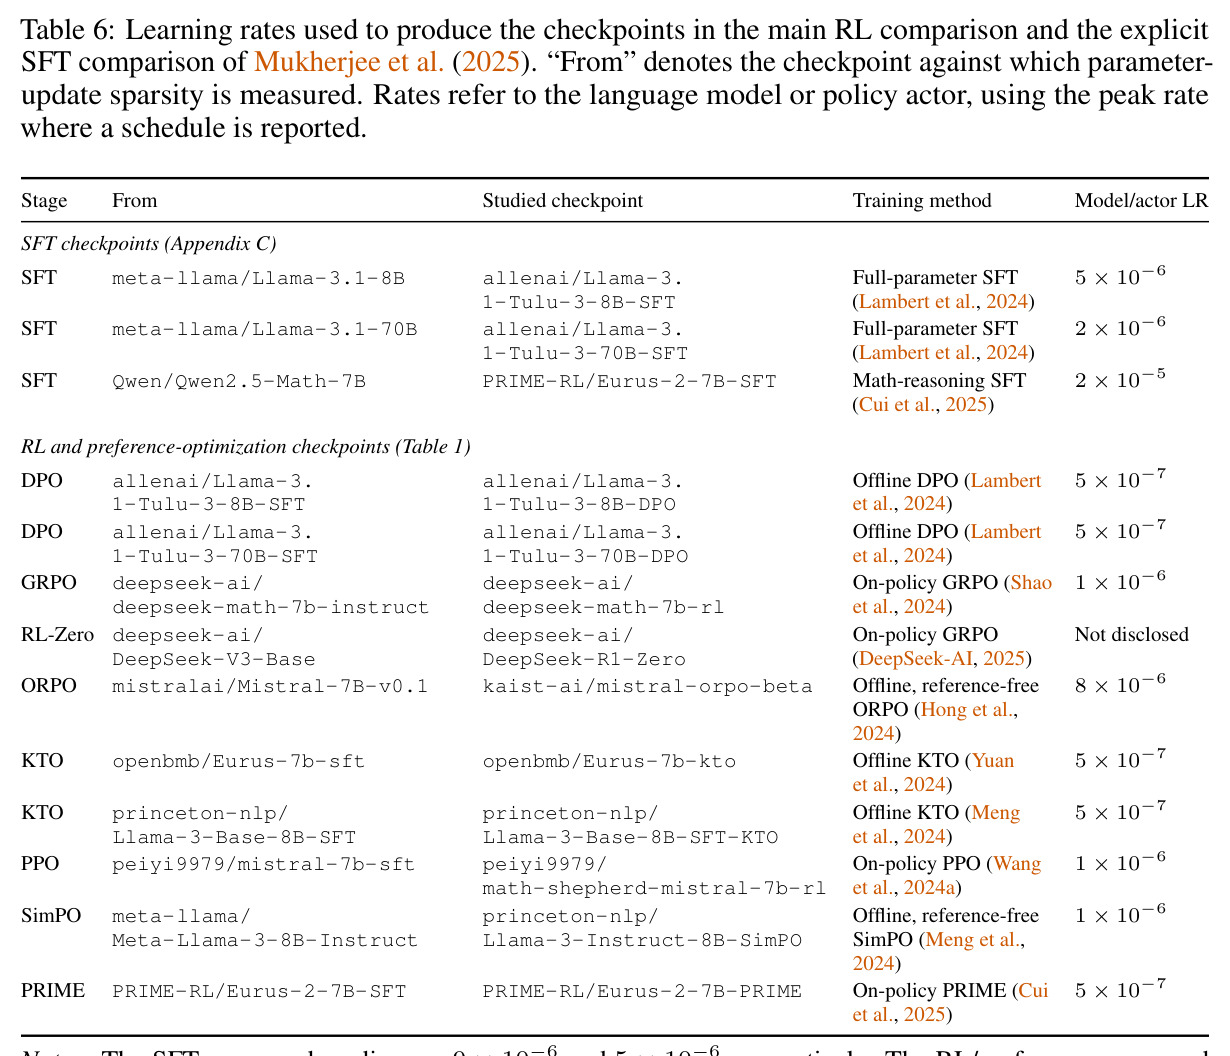
近年一系列有影响力的工作宣称 on-policy 训练(如 RLVR)相比 off-policy 的 SFT 有三大本质优势:减少甚至避免灾难性遗忘(Shenfeld et al. 2025;Chen et al. 2025)、参数更新显著更稀疏(Mukherjee et al. 2025)、分布外泛化更好(Chu et al. 2025 等)。但这些结论几乎全部来自 SFT 与 RLVR 的直接对比,而这类对比同时改变了学习目标、奖励信号、监督来源与密度、优化流程以及学习率,effects 很难归因到『数据是否 on-policy』本身。作者对 Mukherjee et al. (2025) 所分析 checkpoint 的梳理(Table 6)很有说服力:SFT checkpoint 的中位学习率是 5×10^-6,而 RL/偏好优化 checkpoint 的中位只有 5×10^-7,相差整整 10 倍——所谓『RL 更新更稀疏』很可能只是学习率更小的副产品。这个问题在实践上也很要紧:on-policy 方法需要训练全程持续采样生成,成本远高于复用固定数据的 off-policy 方法;如果其优势其实来自别的超参选择,这笔额外开销就是白花的。
本文的目标是本文的目标是把 rollout 策略(训练轨迹由学生还是教师生成)这一单一因素从其他设计选择中干净地剥离出来,量化它对六个方面的真实贡献:目标任务的最终准确率、灾难性遗忘、参数更新稀疏性、输出覆盖(pass@k)、对更难任务变体的泛化、以及作为后续 RLVR 起点的表现。为此作者选择强到弱蒸馏作为受控试验台——与 SFT-vs-RLVR 对比不同,这里可以在完全固定其余训练管线的前提下只改变数据生成策略——并在 Llama 3 与 Qwen2.5 两个模型家族、科学/医学/算术三类推理任务上独立变动 rollout 策略、token 级 KL 方向和学习率三个因子,把以往笼统归因于『on-policy』的效果逐一拆解归因。
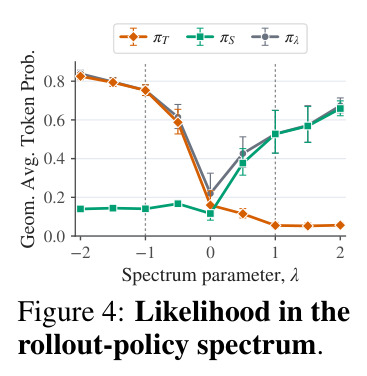
与已有工作不同的是,本文的独特切入角度有三点。第一,解耦经典搭配:以往 OnPD 几乎总是配反向 KL、OffPD 配前向 KL(因为单样本估计下两者的采样解释天然配对),本文在全词表计算 KL 的设定下打破这一绑定,把 {OnPD, OffPD}×{F-KL, R-KL} 四种组合全部实验。第二,构造连续的 rollout 策略谱:用 $z_\lambda(v)=\frac{1+\lambda}{2}\log\pi_S(v)+\frac{1-\lambda}{2}\log\pi_T(v)$ 定义的插值-外推策略,从纯教师(λ=−1)连续过渡到纯学生(λ=1),甚至外推到偏向某一方偏好 token 的极端区域,把离散的 on/off 二分变成可连续调控的旋钮。第三,配套梯度层面的理论分析:证明前向 KL 半梯度对 rollout 分布变化有一致 Lipschitz 界,而反向 KL 不存在这种与分布无关的界,从数学上解释了两个 KL 方向对 rollout 策略敏感度的不对称。
核心方法
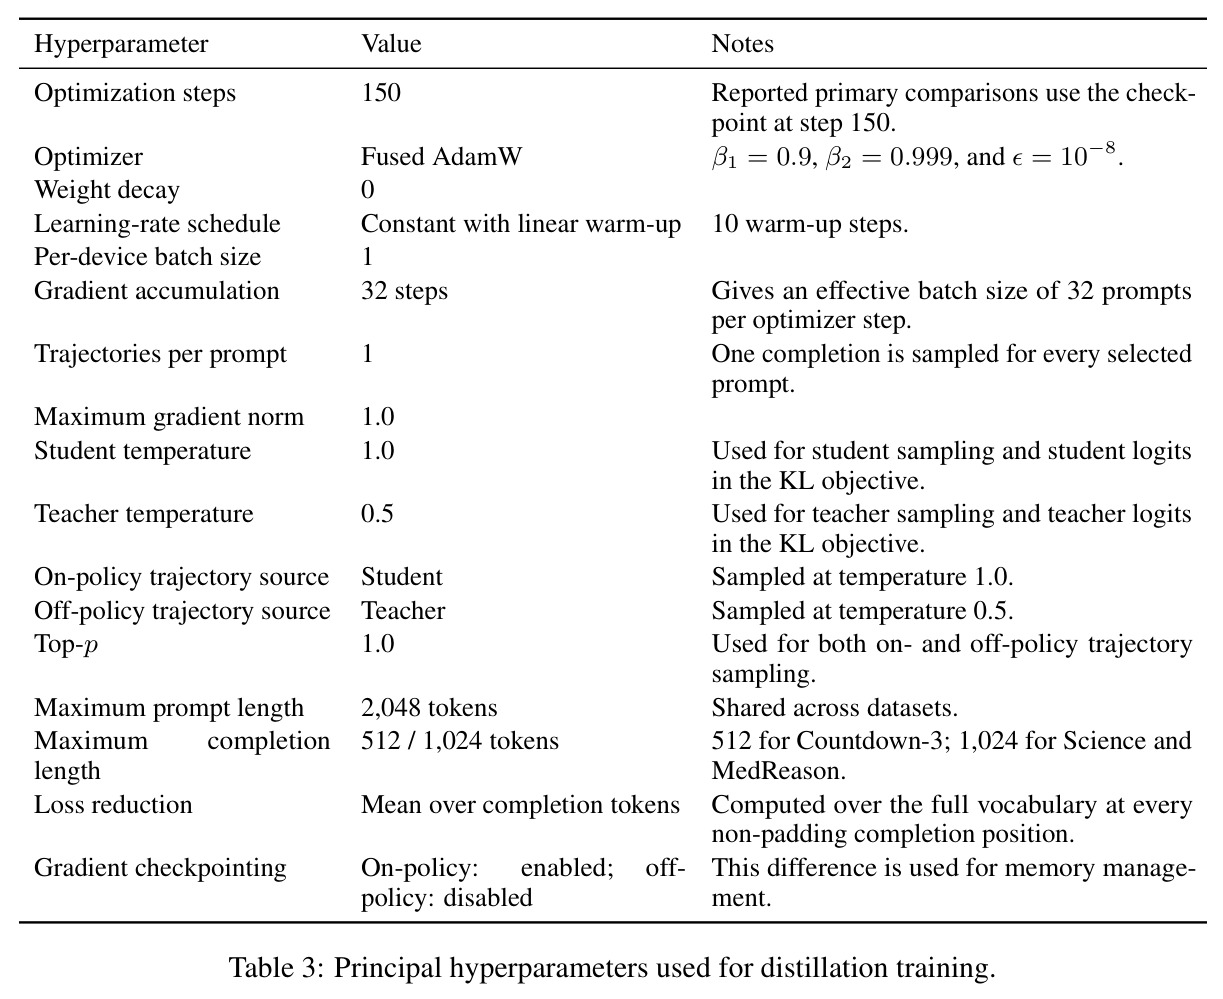
蒸馏目标是 $\mathcal{L}(\theta)=\mathbb{E}_{x\sim p_{data}}\mathbb{E}_{y\sim\rho(\cdot|x)}\frac{1}{L_y}\sum_{n=1}^{L_y} D\big[\pi^S_\theta(\cdot|x,y_{<n})\,\|\,\pi^T(\cdot|x,y_{<n})\big]$,其中 rollout 策略 $\rho$ 取教师分布即 OffPD、取学生分布即 OnPD(对采样轨迹停止梯度,视为固定)。散度 D 用全词表的前向或反向 KL(教师分布温度 0.5、学生 1.0),避免单样本估计带来的方差。主实验网格为 {OnPD, OffPD}×{F-KL, R-KL}×学习率 {1×10^-5, 5×10^-5}:Llama-3.1-8B 教师蒸馏到 Llama-3.2-1B 学生(附录用 Qwen2.5-7B→1.5B 重复),任务为 MedReason(医学选择题)、Science(科学选择题)、Countdown-3(算术推理),学生全参数微调 150 步、有效批 32、每个配置 3 个随机种子。评估三个维度:held-out 任务准确率(每数据集 200 题、温度 0.5)、7 个 OOD 基准上的灾难性遗忘、以 $S_\tau$ 度量的参数更新稀疏性。
核心洞察是把『on-policy 数据』这个笼统概念拆成两个正交机制并分别归因。理论上,前向 KL 对学生 logit 的梯度是 $\pi^S_\theta(v)-\pi^T(v)$,每个分量有界于 [−1,1],由此得到 Theorem C.1:两个 rollout 策略下前向 KL 期望半梯度之差被 $2\sqrt{2}B\,\mathbb{E}[TV(\rho,\rho')]$ 控制(B 为 logit Jacobian 的谱上界)——轨迹分布接近则更新必然接近。反向 KL 的 logit 梯度却是 $\pi^S_\theta(v)\odot\big[\log\frac{\pi^S_\theta(v)}{\pi^T(v)}-D_{R\text{-KL}}\big]$,含无界的对数似然比;Theorem C.2 用双 token 词表的反例证明不存在任何只依赖 rollout 距离的稳定性界(概率质量 $\varepsilon$ 的轨迹变化可被 $\log(1/\delta)$ 级别的局部梯度放大),Corollary C.3 说明只有把似然比范围控制在 $R$ 内才能恢复 $2BR\,\mathbb{E}[TV]$ 形式的界。这从数学上预言:前向 KL 对『谁生成轨迹』几乎免疫,反向 KL 则强烈依赖学生自己的轨迹分布。
方法步骤详情
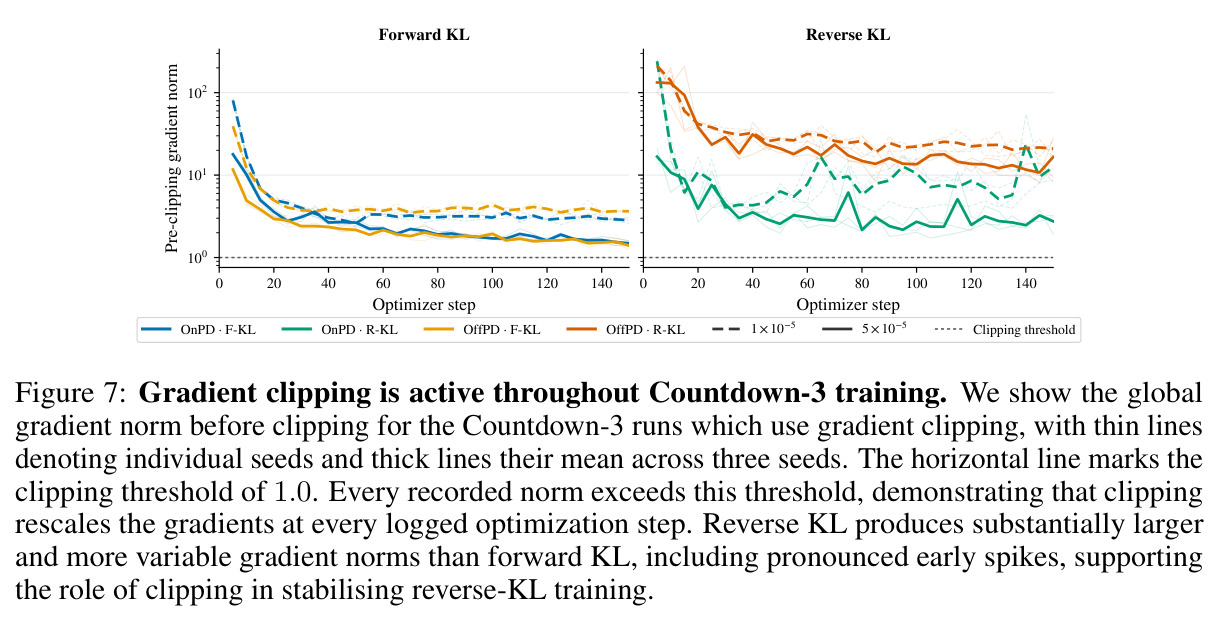
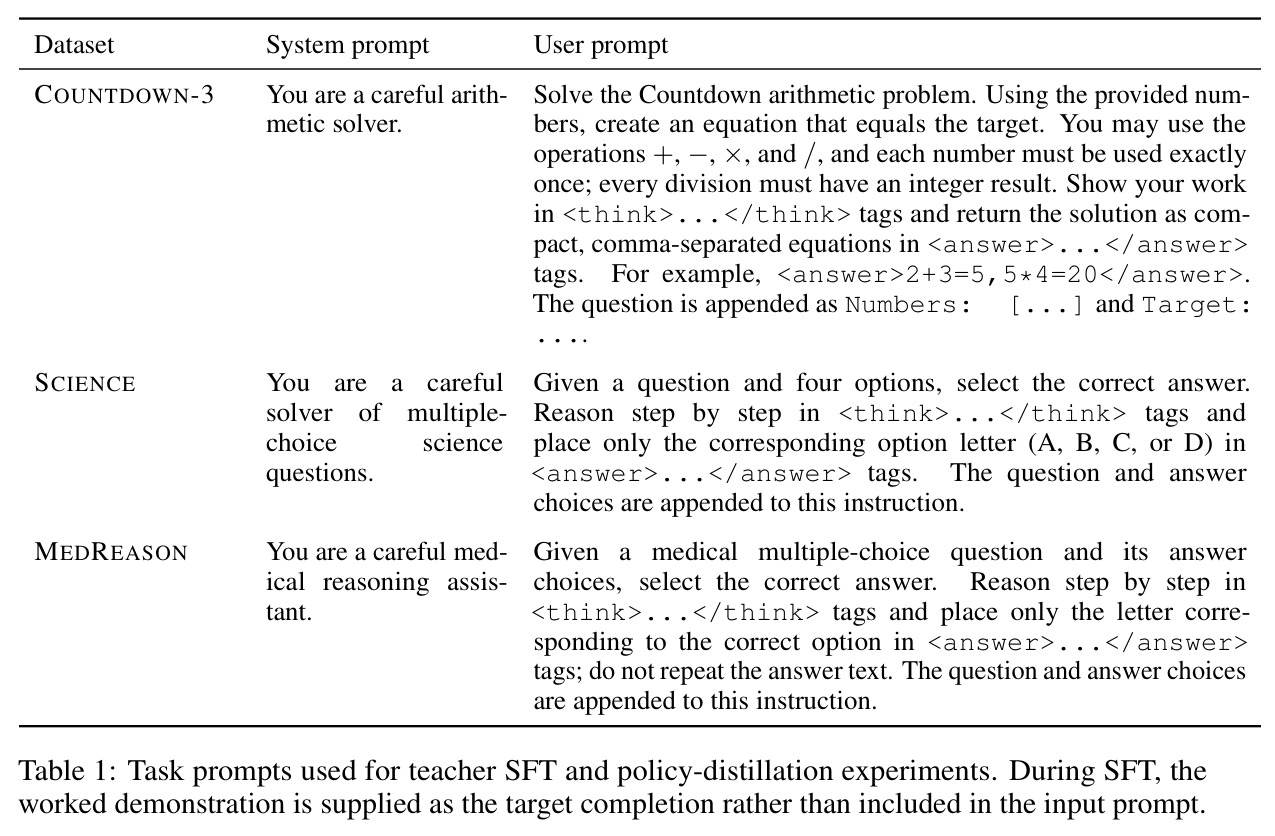
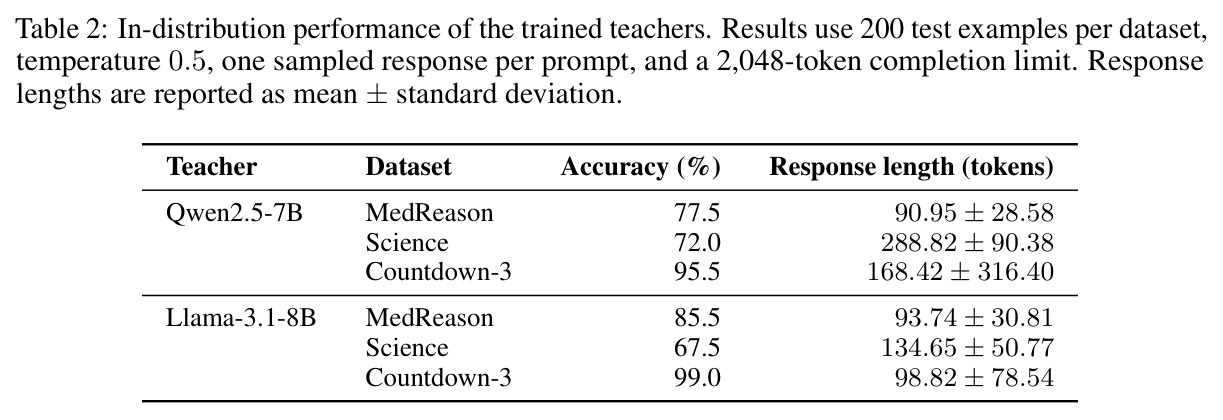
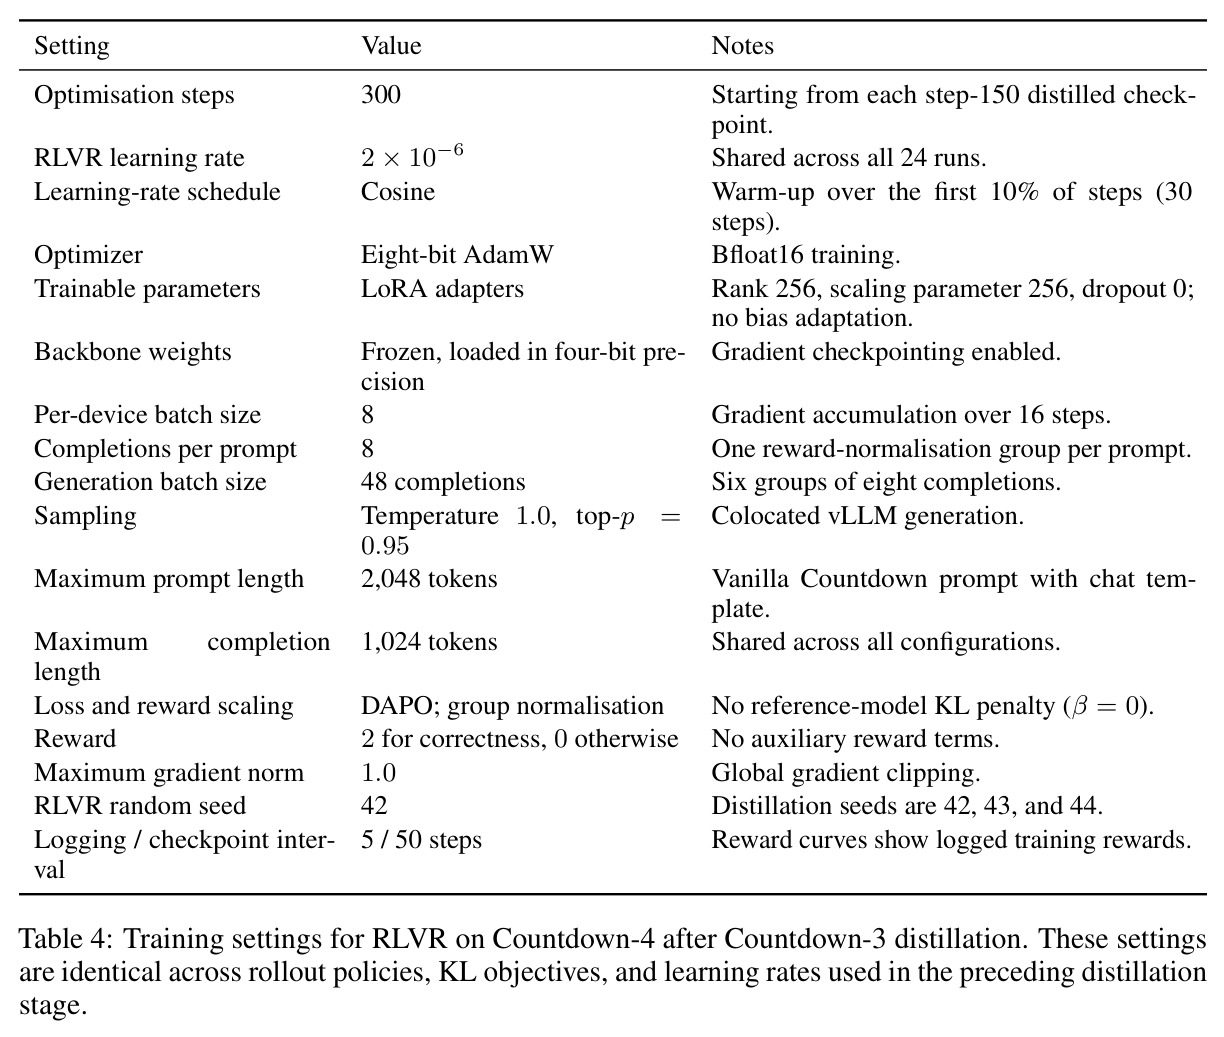
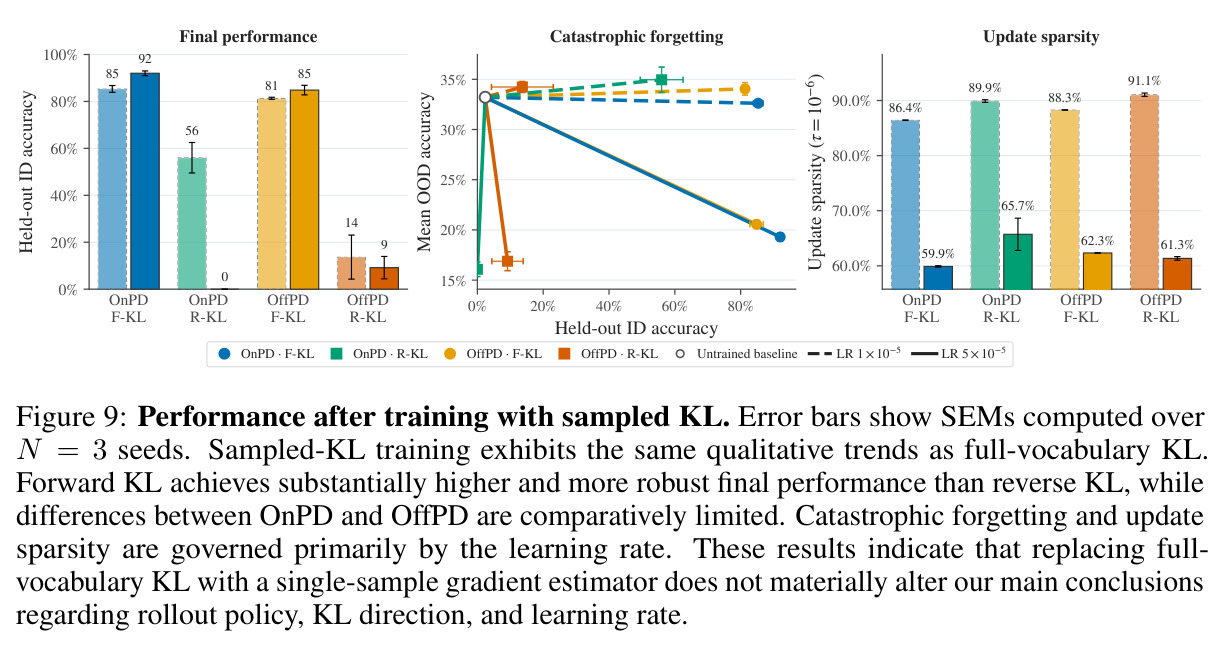
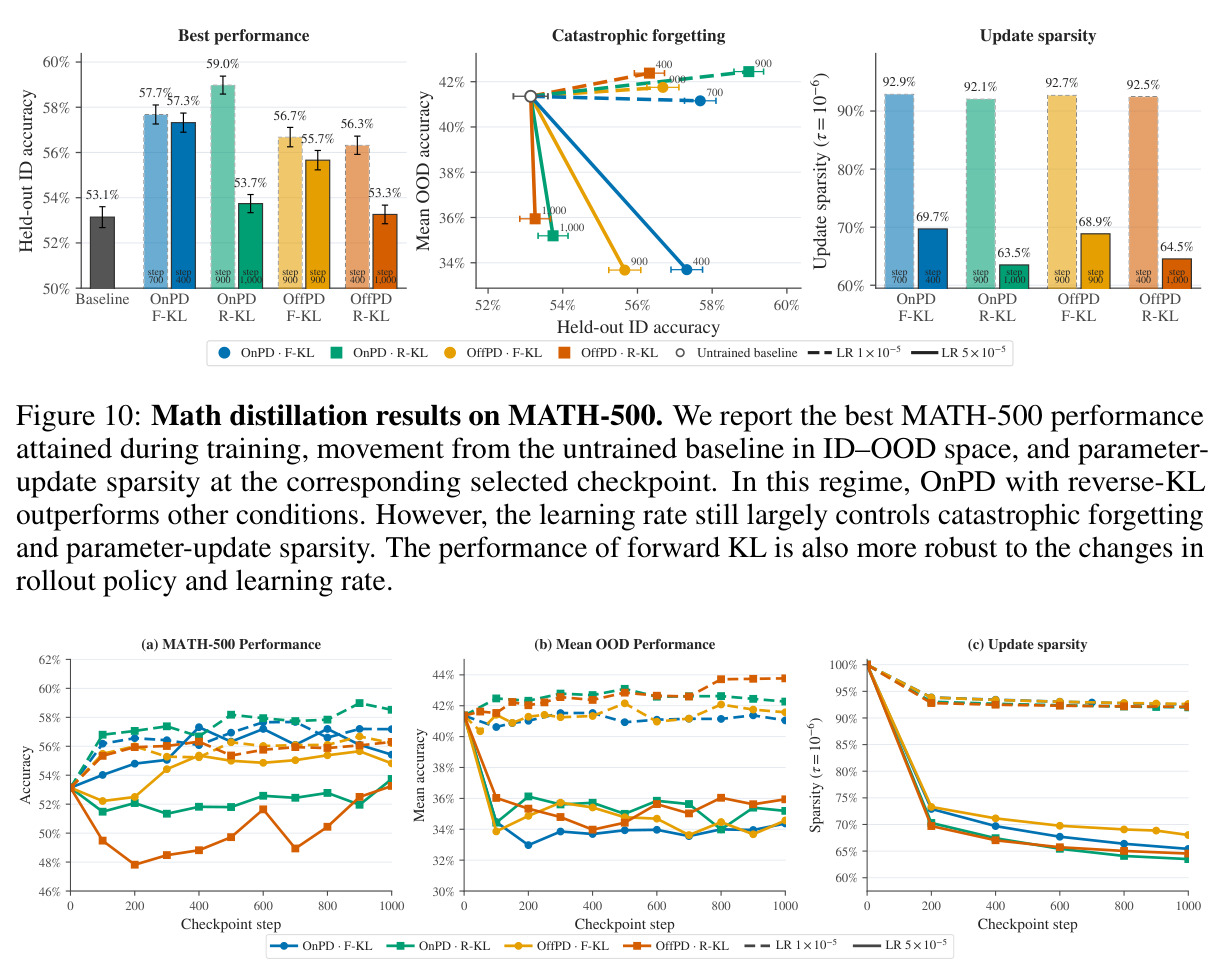
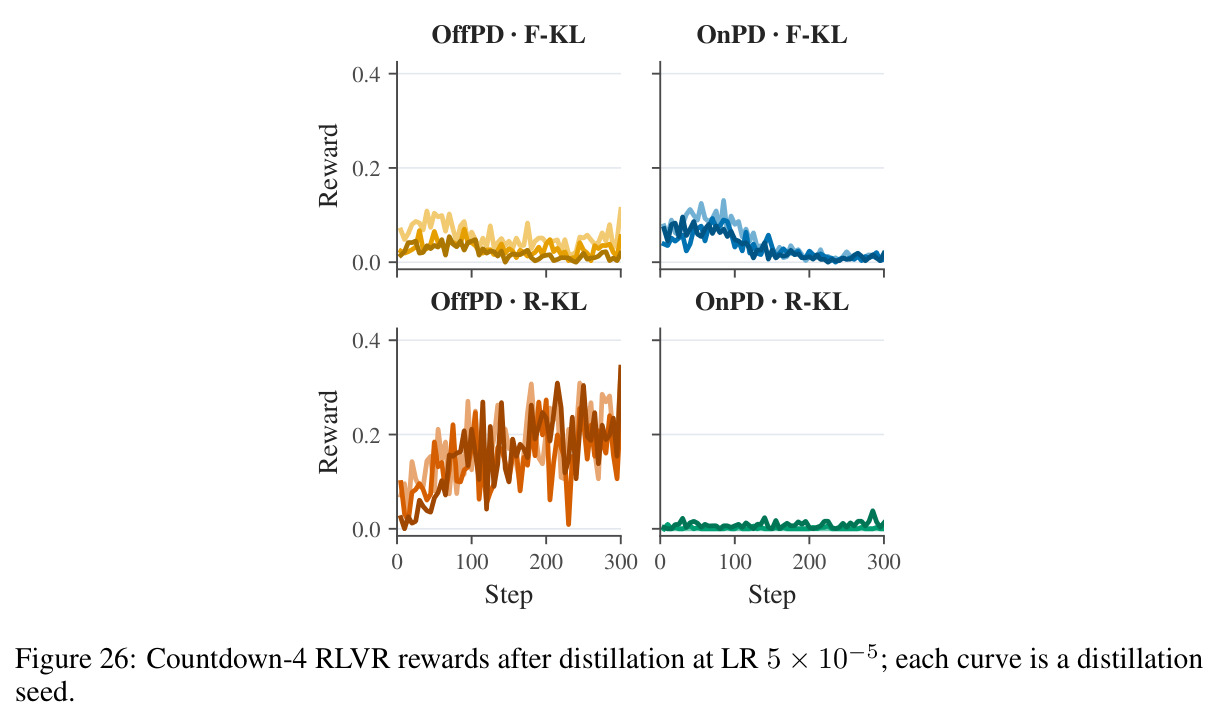
完整流程分六步。第一步训练任务教师:对每个数据集用 SFT(500 步、LoRA rank 256、学习率 5×10^-5)加必要时 GRPO(500 步、正确奖励 2.0 加格式奖励 ≤1.0、DAPO 损失)把 Llama-3.1-8B / Qwen2.5-7B 强化到足够能力——Llama 教师在 MedReason/Science/Countdown-3 上分别达到 85.5%/67.5%/99.0%(Table 2)——之后全程冻结,以保证足够的师生能力差距。第二步蒸馏:学生(Llama-3.2-1B-Instruct)全参数微调 150 步,fused AdamW、常数学习率加 10 步 warmup、全局梯度裁剪 1.0;OnPD 用协同部署的 vLLM 从学生采样轨迹,OffPD 从教师采样。第三步评估:每数据集 200 题测 ID 准确率,7 个 OOD 基准测遗忘,阈值 $\tau=10^{-6}$ 测更新稀疏性。第四步 rollout 谱实验:在 Countdown-3 上令 $\lambda$ 从 −2 扫到 2,配合单侧 log-ratio 裁剪 $c=2\log 3\approx 2.2$ 与合理性掩码 $\alpha=0.2$,防止 |λ|>1 时放大两个模型都不偏好的 token。第五步下游 RLVR:从全部 8 种蒸馏配置的 checkpoint(×3 种子,共 24 个 run)出发,在更难的 Countdown-4 上跑 300 步 GRPO+DAPO(LoRA rank 256、LR 2×10^-6、正确性奖励 2/0)。第六步消融:去掉梯度裁剪、改用单样本 KL 估计器、换用平均 622 token 长推理的 Numina-MATH(Qwen2.5-Math-1.5B→Qwen2.5-1.5B,1000 步)。
技术新颖性
与已有工作的区别体现在四个层面。其一,问题层面:此前 OnPD 文献(Agarwal et al. 2023;Thinking Machines 2025 的 on-policy distillation 等)聚焦算法改进与失败模式,SFT-vs-RL 的对比研究(Chu et al. 2025;Shenfeld et al. 2025 等)则混杂多变量,几乎没有工作在固定其余管线的条件下直接回答『rollout 来源本身值多少钱』。其二,设计层面:全词表 KL 让 KL 方向与 rollout 策略在实现上彻底解耦,2×2×2 因子设计加 3 种子是标准受控实验方法论,但在 LLM 后训练研究中少见。其三,理论层面:Theorem C.1/C.2/C.3 刻画的是训练实际使用的半梯度(对采样前缀停止梯度之后)的稳定性,而非泛泛的目标函数等式,并精确定位反向 KL 的脆弱性来源——学生-教师对数似然比无界;Proposition C.4 还澄清了传统配对只是序列级 KL 的两种链式分解,在停止梯度下不保证更新等价。其四,测量层面:λ 谱借鉴对比解码的外推思想并加裁剪与掩码防护,把 on/off 二分扩展为连续可调的实验维度,这一构造本身对后续实证研究有工具价值。
实验结果
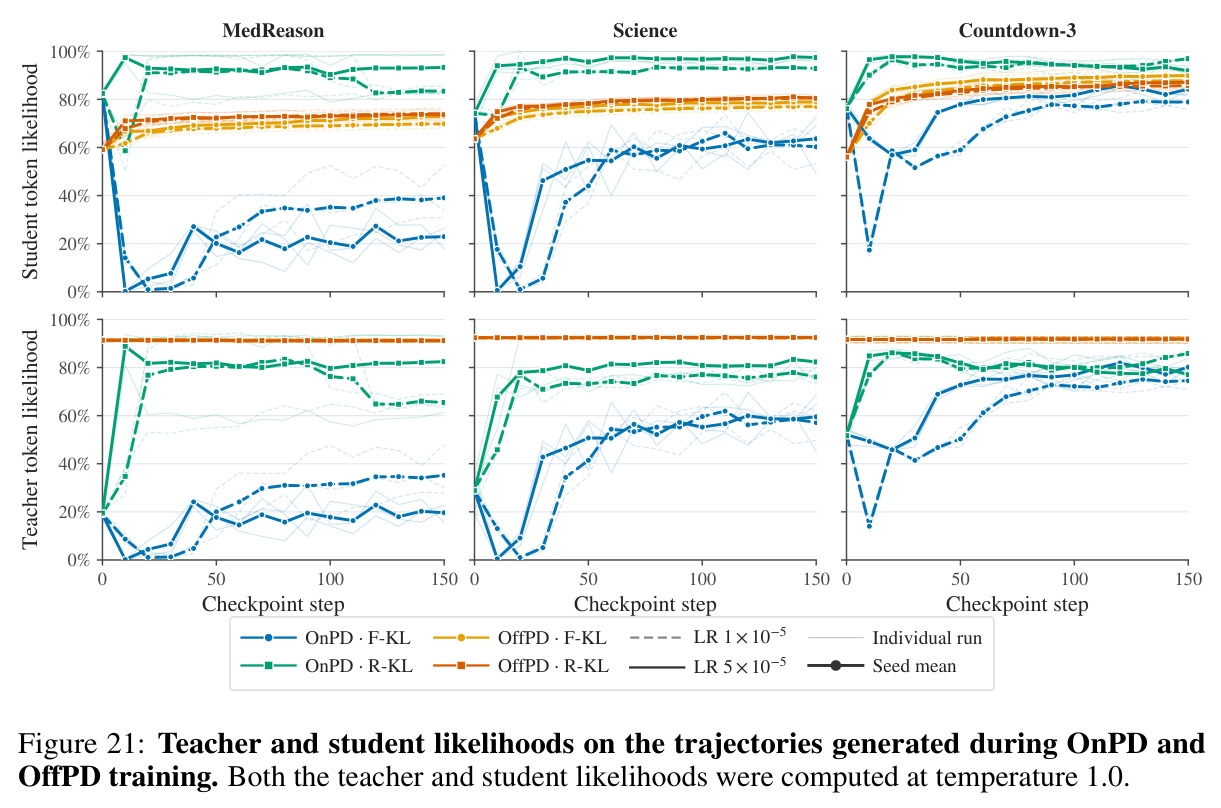
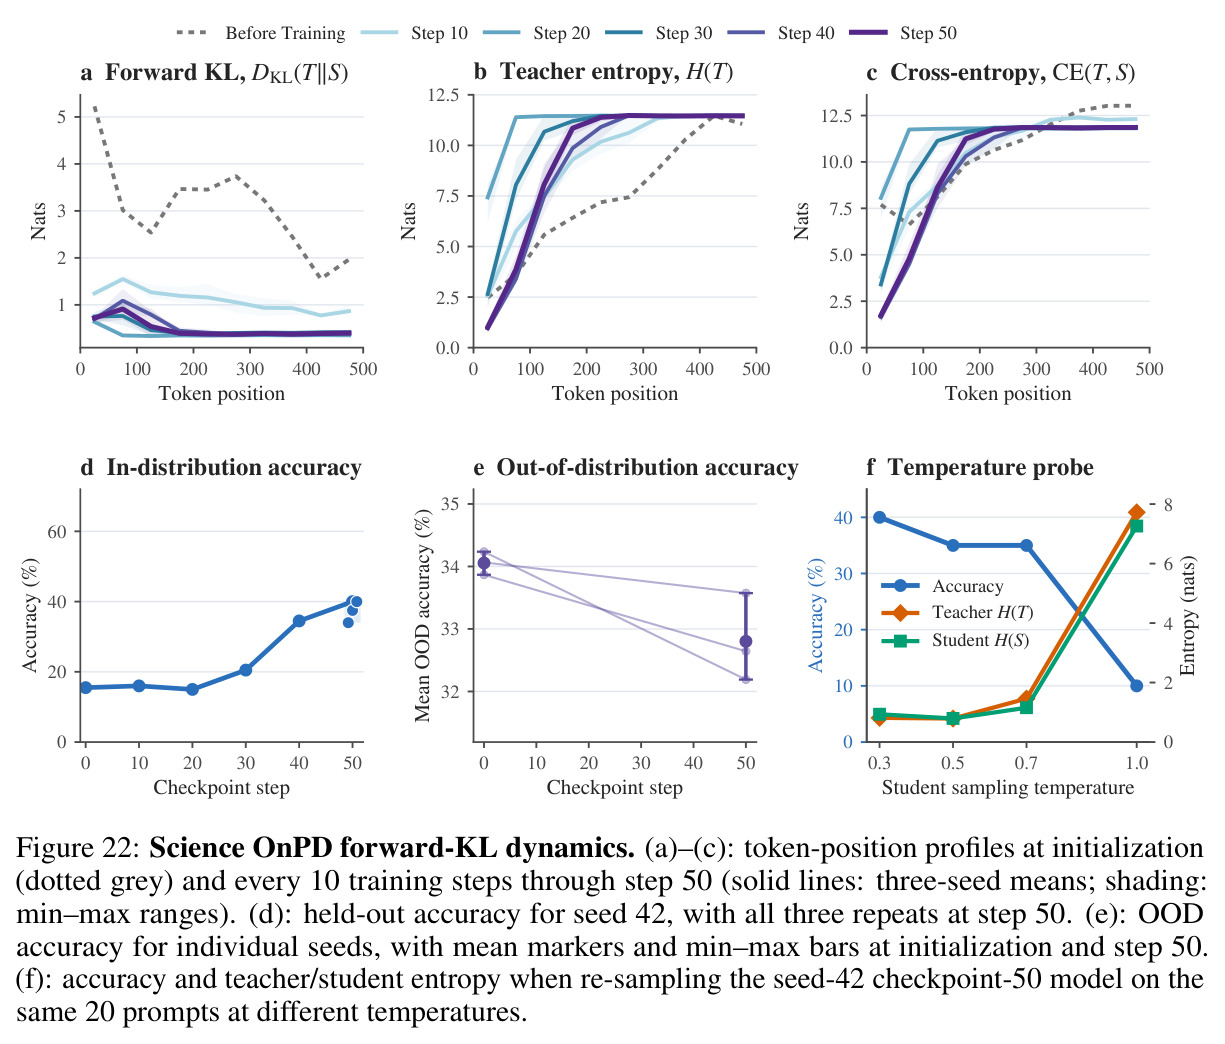
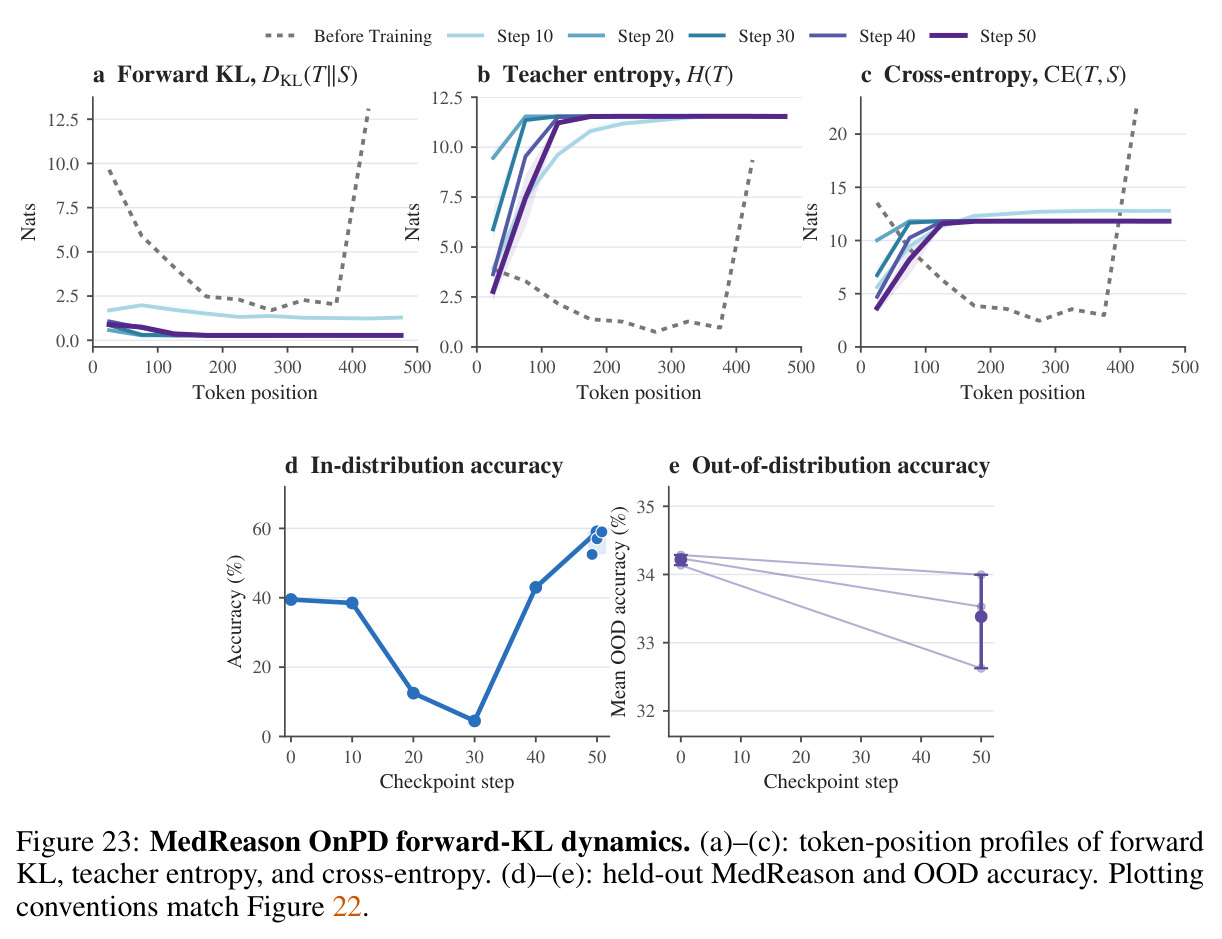
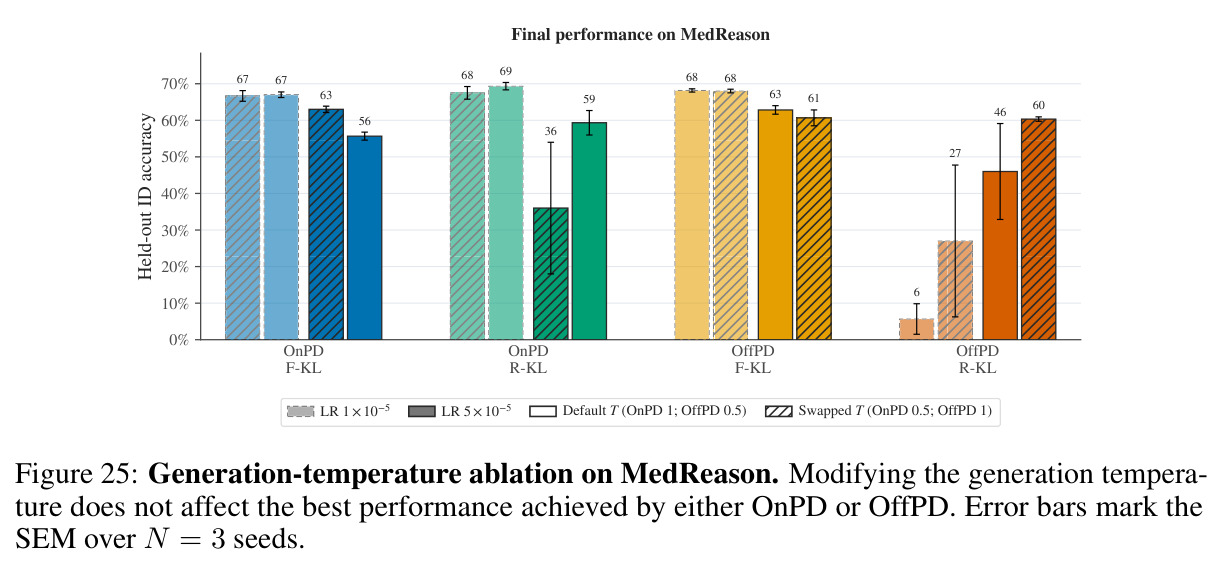
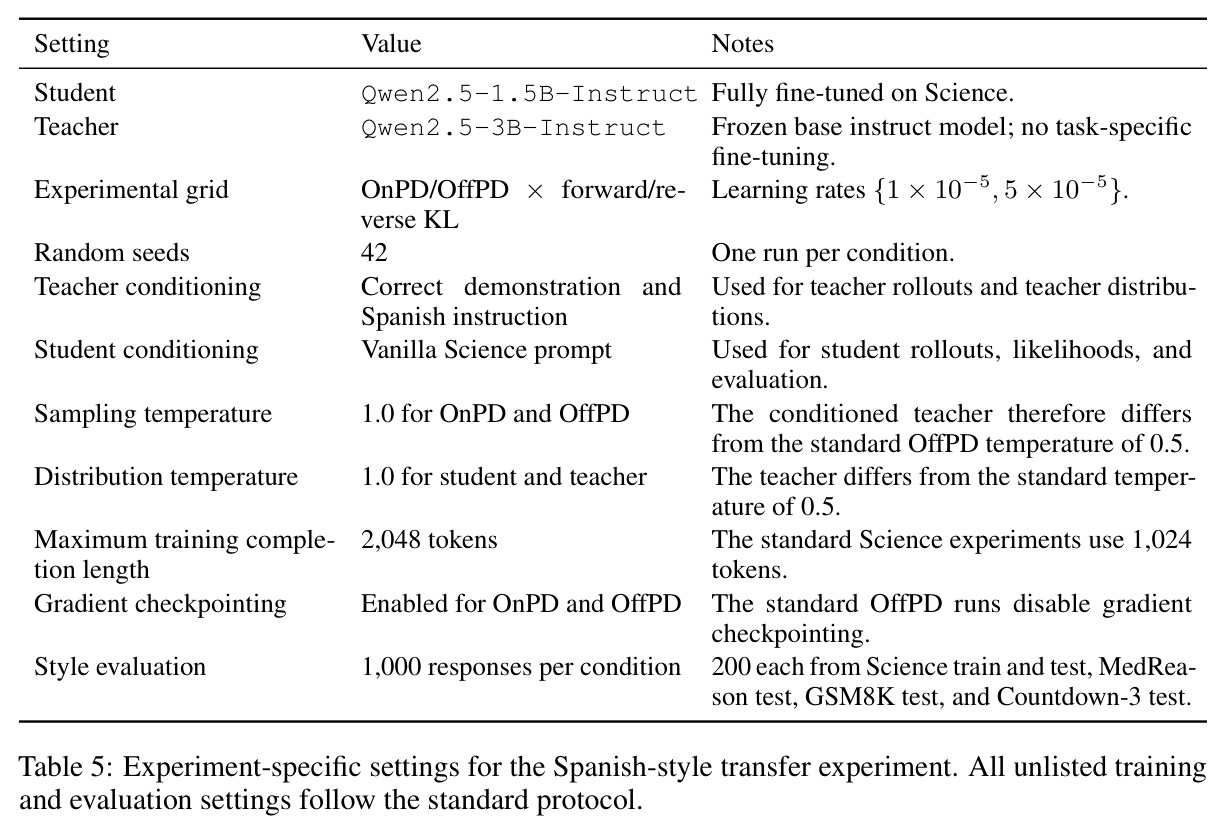
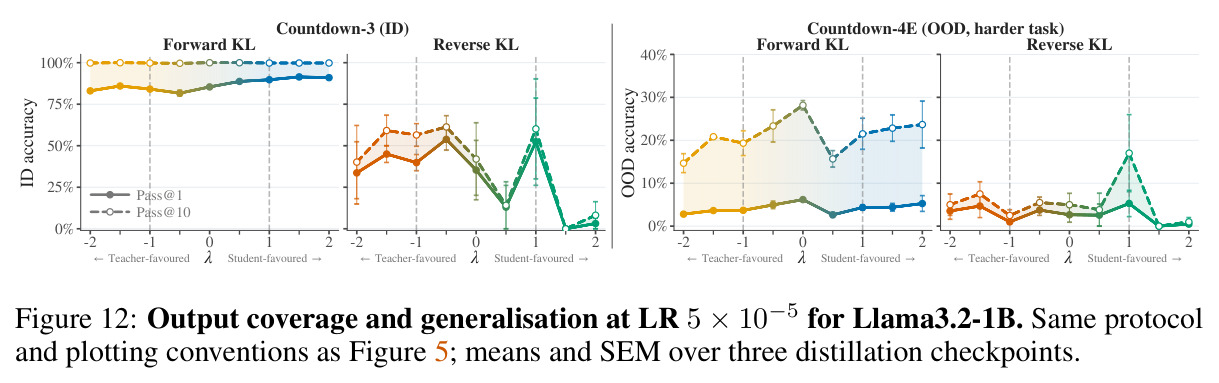
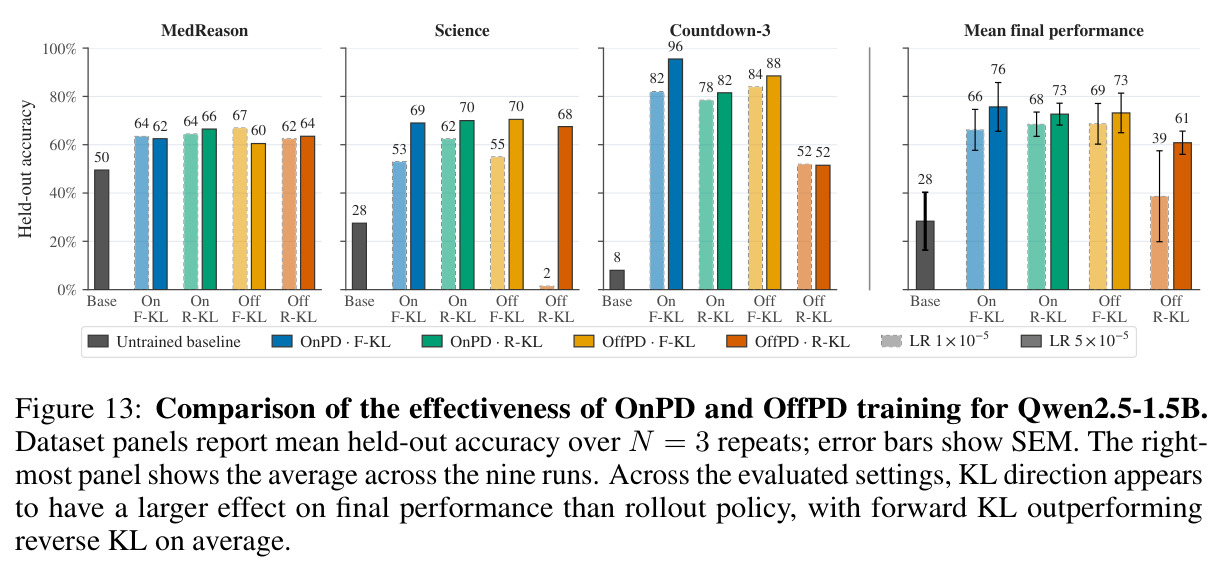
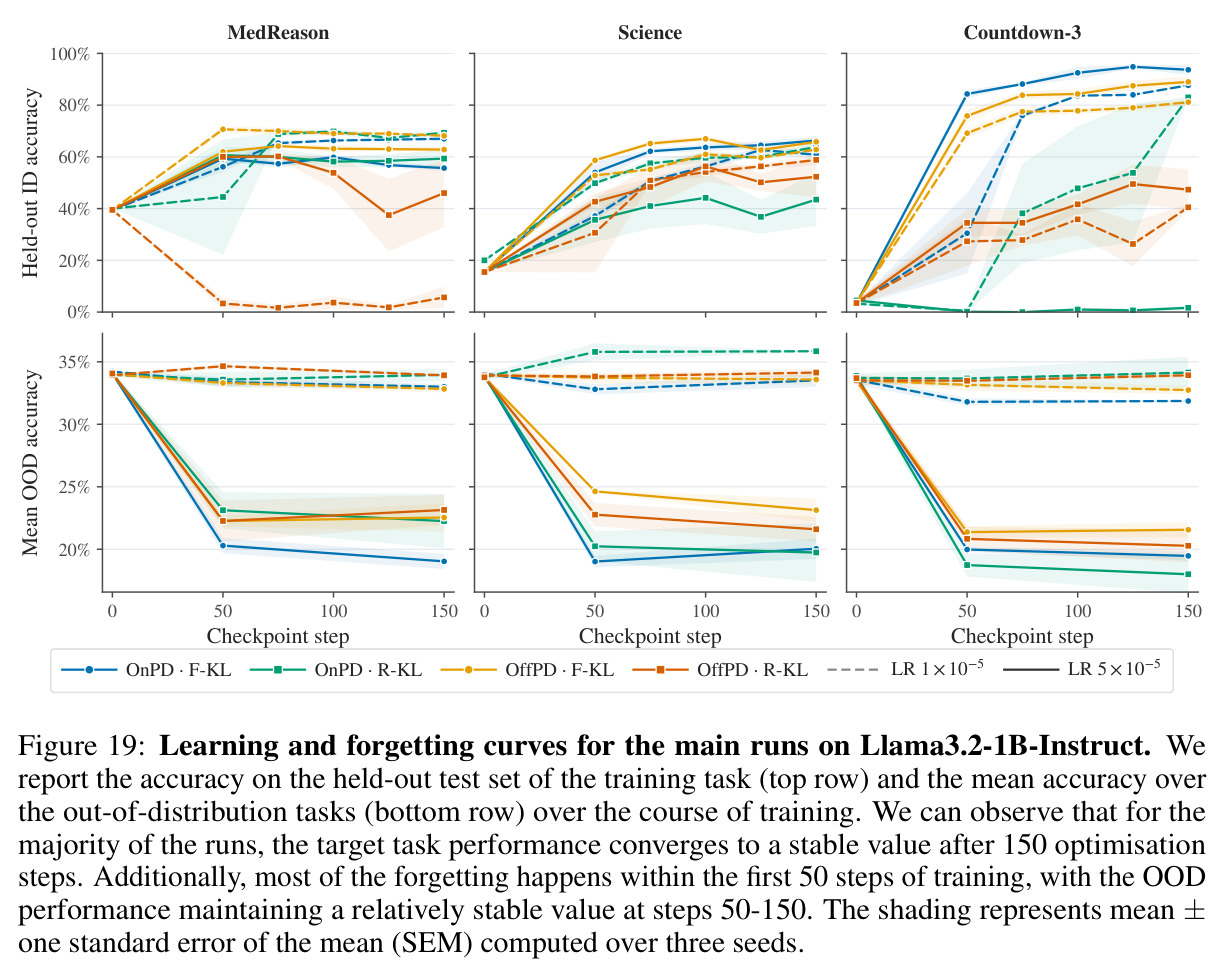
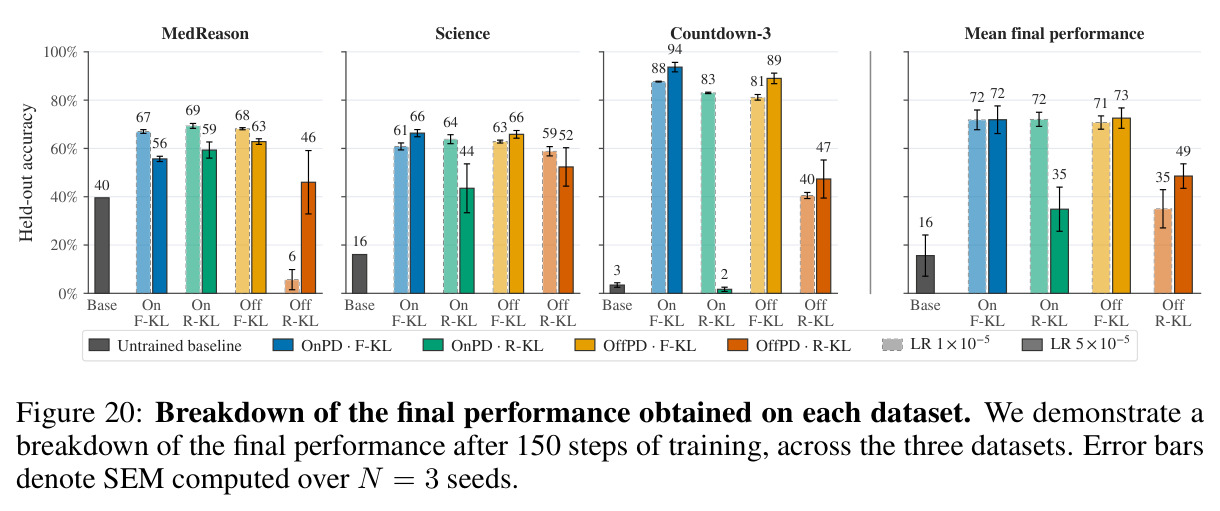
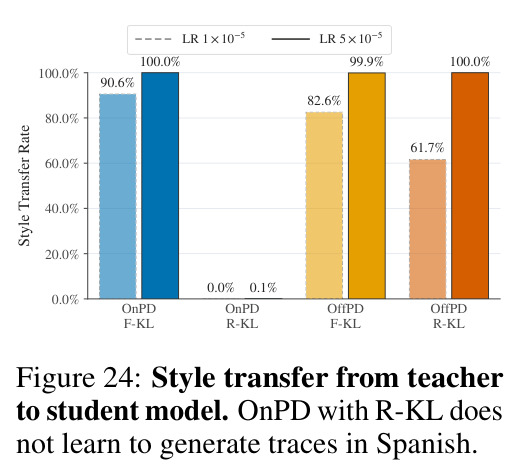
五个核心发现。一,on-policy 无一致优势:三任务平均最优 held-out 准确率 OnPD 72% vs OffPD 73%(Figure 1 左);前向 KL 在所有 rollout 策略与学习率下稳定在 71–73%,反向 KL 则在 35–72% 间大幅波动且对学习率极敏感。二,遗忘与稀疏性由学习率主导:学习率 1×10^-5 时 OOD 平均变化不超过 +1.3 个百分点、稀疏性 85.3–89.6%;5×10^-5 时 OOD 掉 11.2–14.0 个百分点、稀疏性降到 51.9–60.0%;每个配对比较中 OffPD 的更新都不比 OnPD 稀疏。Countdown-3 上 1–6×10^-5 的扫描(Figure 2)显示稀疏性随学习率近似线性下降、遗忘单调上升,且低学习率下前向 KL 能在几乎不遗忘的情况下达到顶级性能(『悬崖』现象)。三,KL 方向决定对 rollout 的敏感度:λ 谱实验(Figure 3)中前向 KL 全谱保持 80% 以上(1×10^-5 下仅波动 5.2 个百分点,甚至能穿过高熵混乱的 rollout 区间,见 Figure 21/22),反向 KL 波动剧烈、在 5×10^-5 下经常崩溃,低学习率时明显偏好学生侧(λ>0)。四,覆盖与泛化要分开看:Countdown-3 上 F-KL 在相近 pass@1 下 pass@10 增益显著更大(Figure 5 左);Countdown-4E(四操作数更难变体)上 on-policy(λ>0)在两种 KL 方向下都比 off-policy 高 10–15% pass@k——这是 on-policy 数据首个明确收益场景,但该优势在后续 300 步 RLVR 后不再可靠保持:反向 KL@1×10^-5 蒸馏的 checkpoint 先快速提升后奖励崩塌,持续最优反而来自 OffPD checkpoint(Figure 6)。五,附带风格迁移:让教师用西班牙语推理时,OnPD+反向 KL 的学生几乎不学风格(0.0–0.1%),其余配置迁移 61.7–100%(Figure 24)。所有结论在去掉梯度裁剪(Figure 8)、单样本 KL(Figure 9)、622 token 长推理(Figure 10:MATH-500 基线 53.1%,各配置 53.3–59.0%,OnPD+R-KL 最高 59.0%)下保持,Qwen2.5 家族上同样复制(Figure 13–16)。
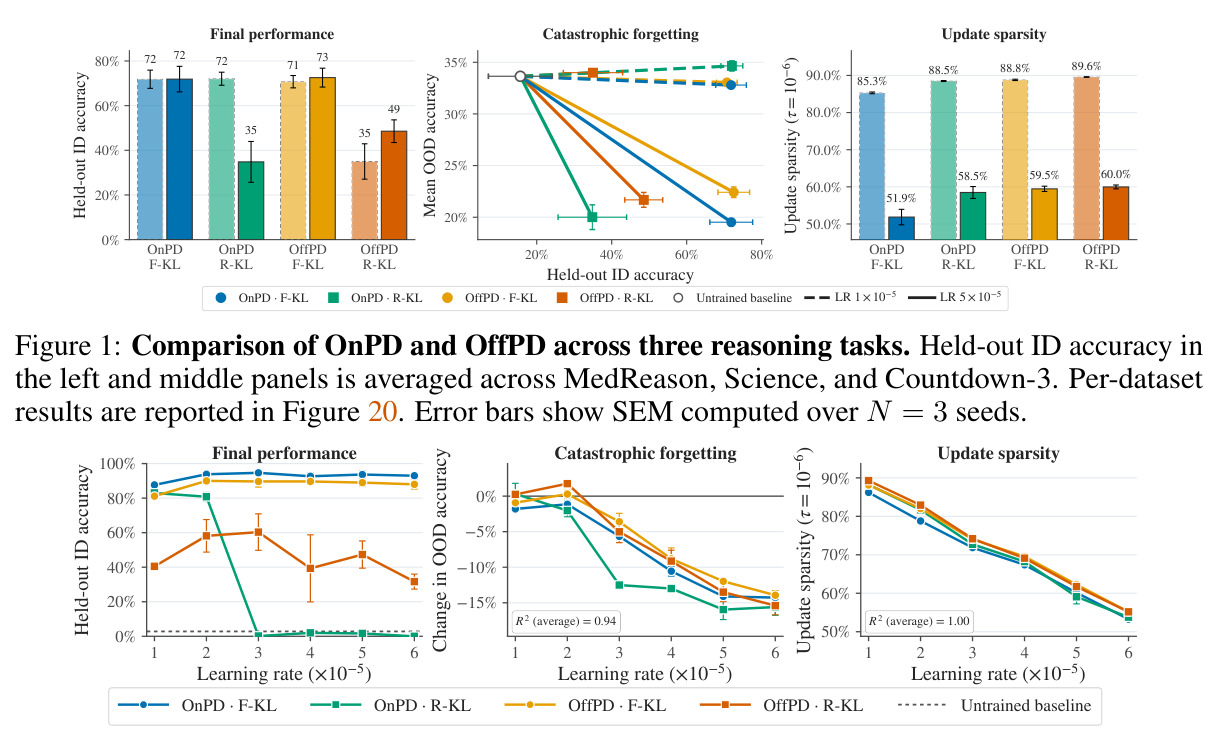
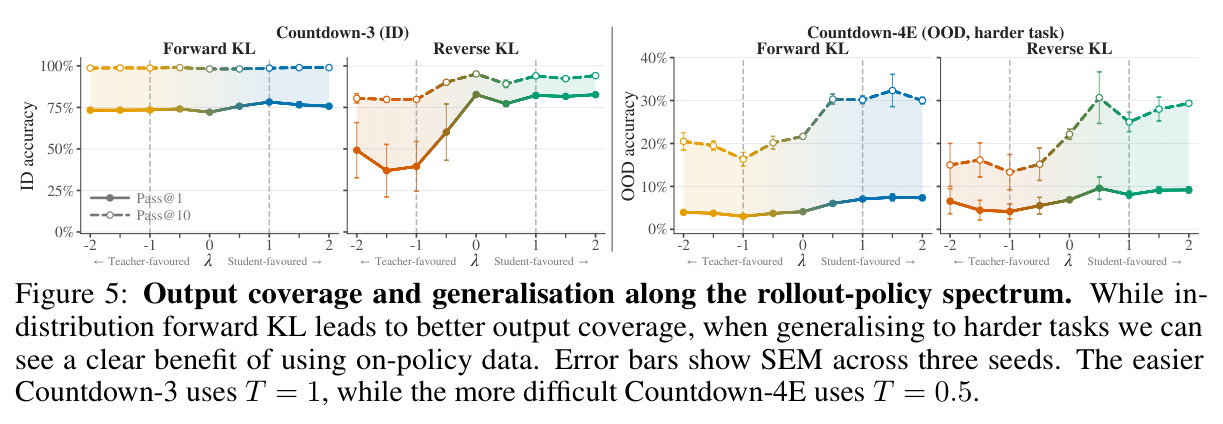
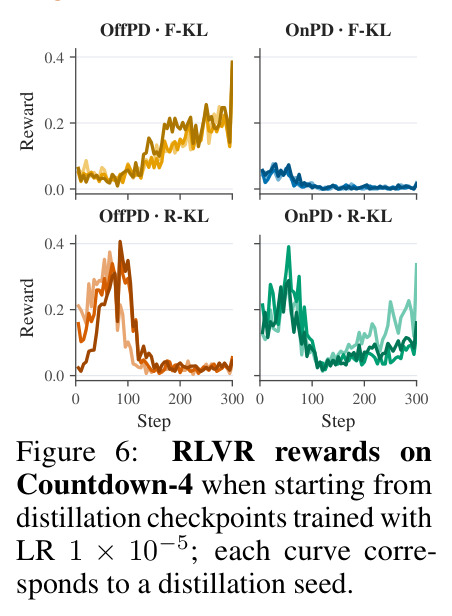
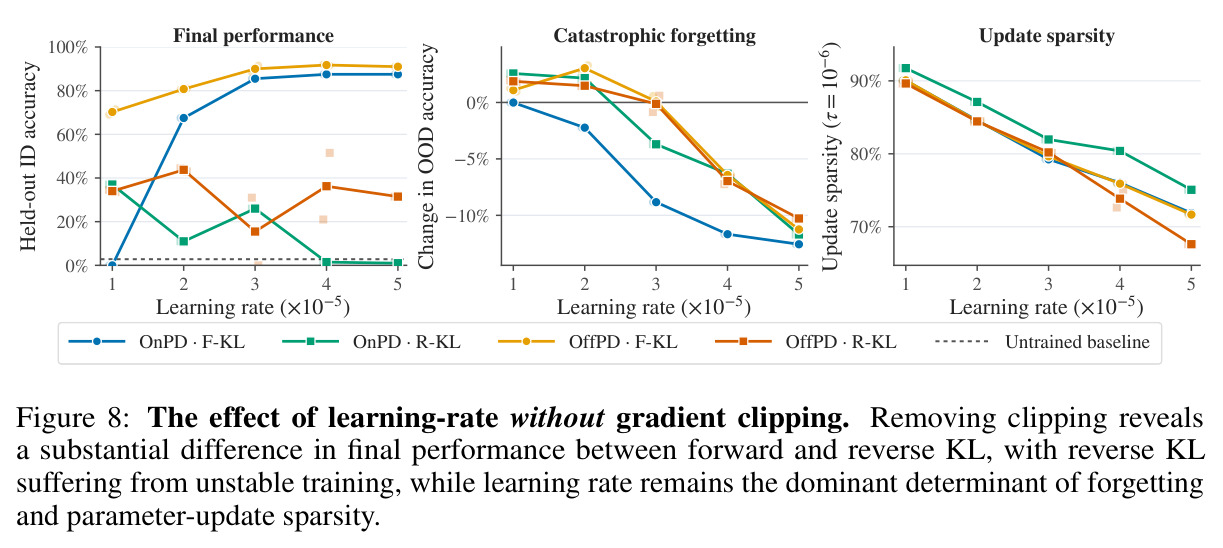
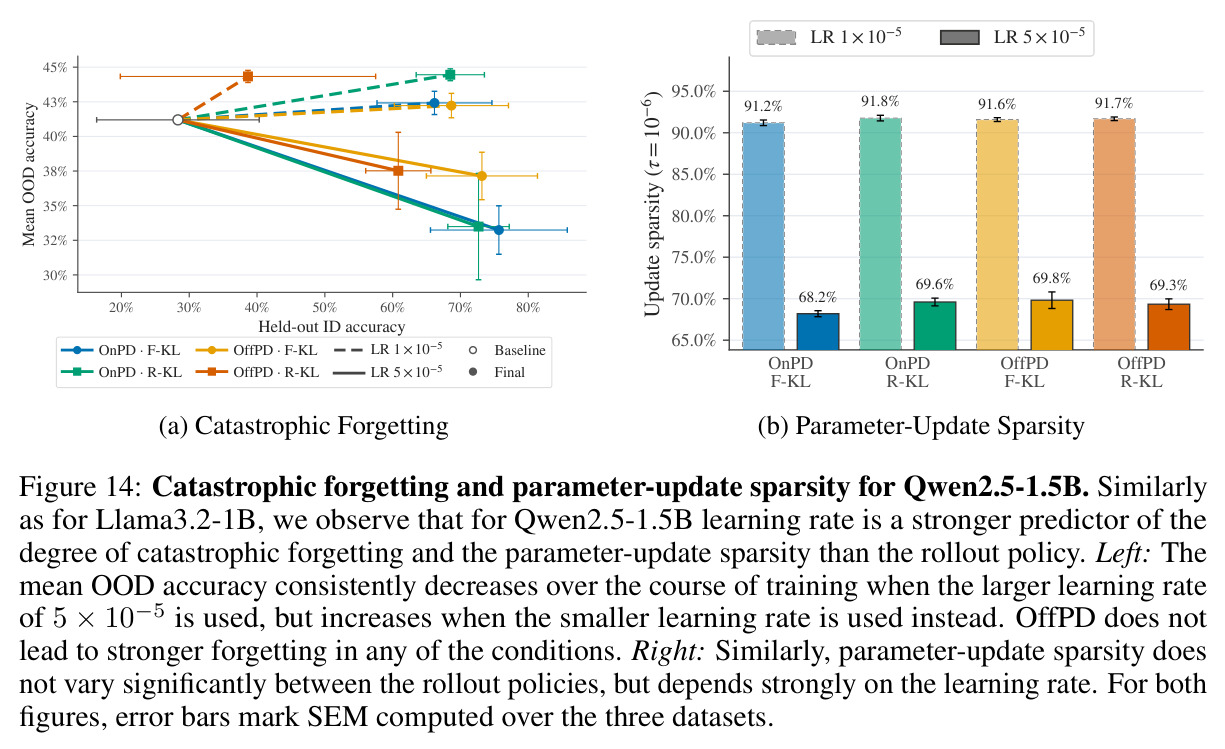
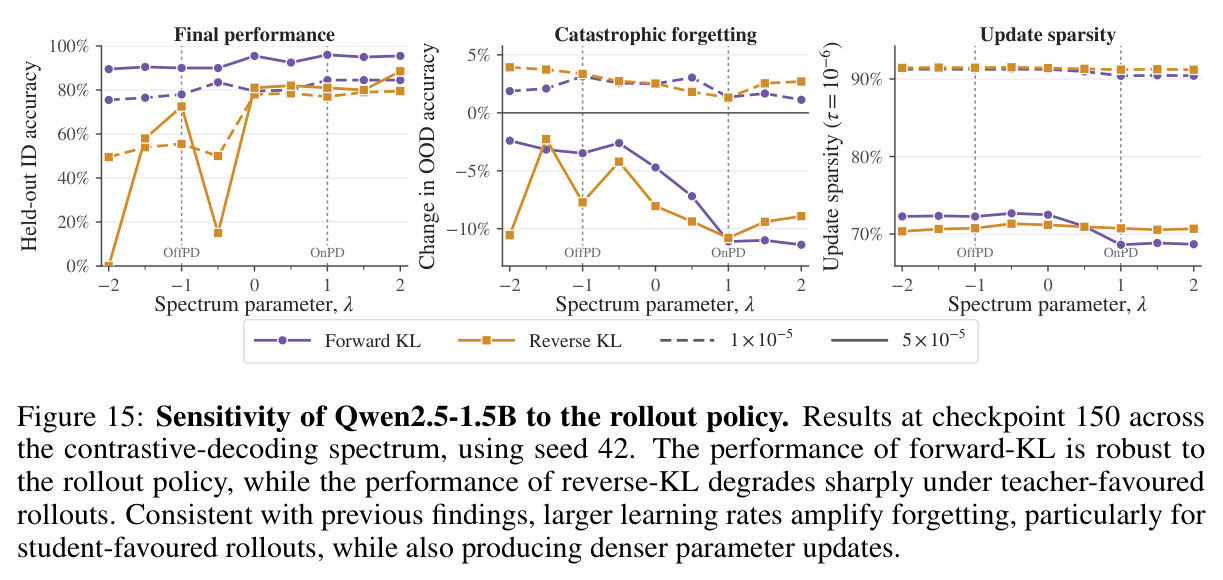
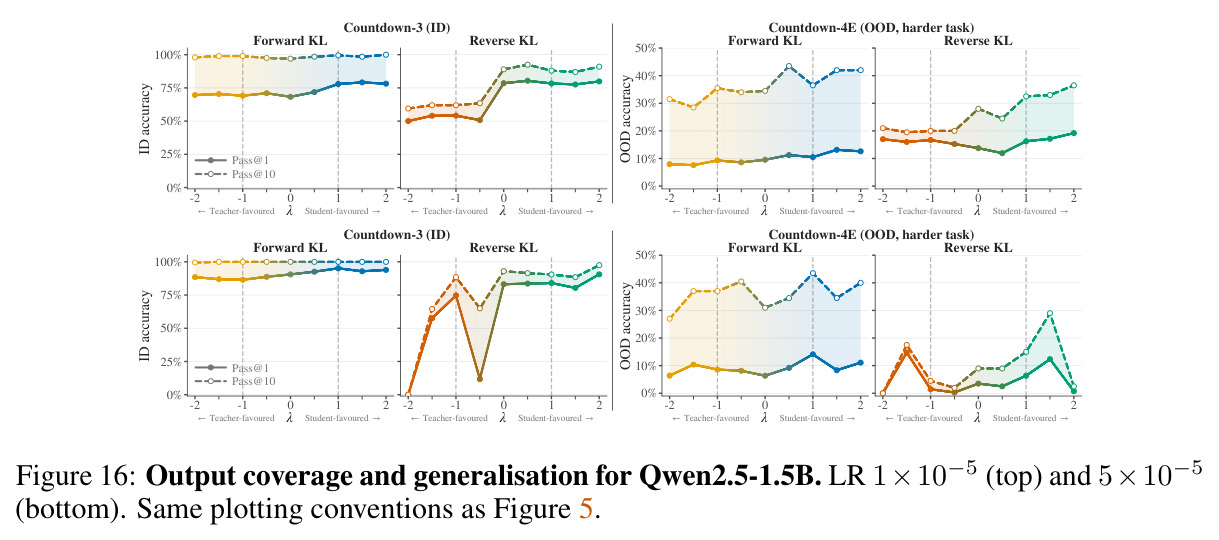
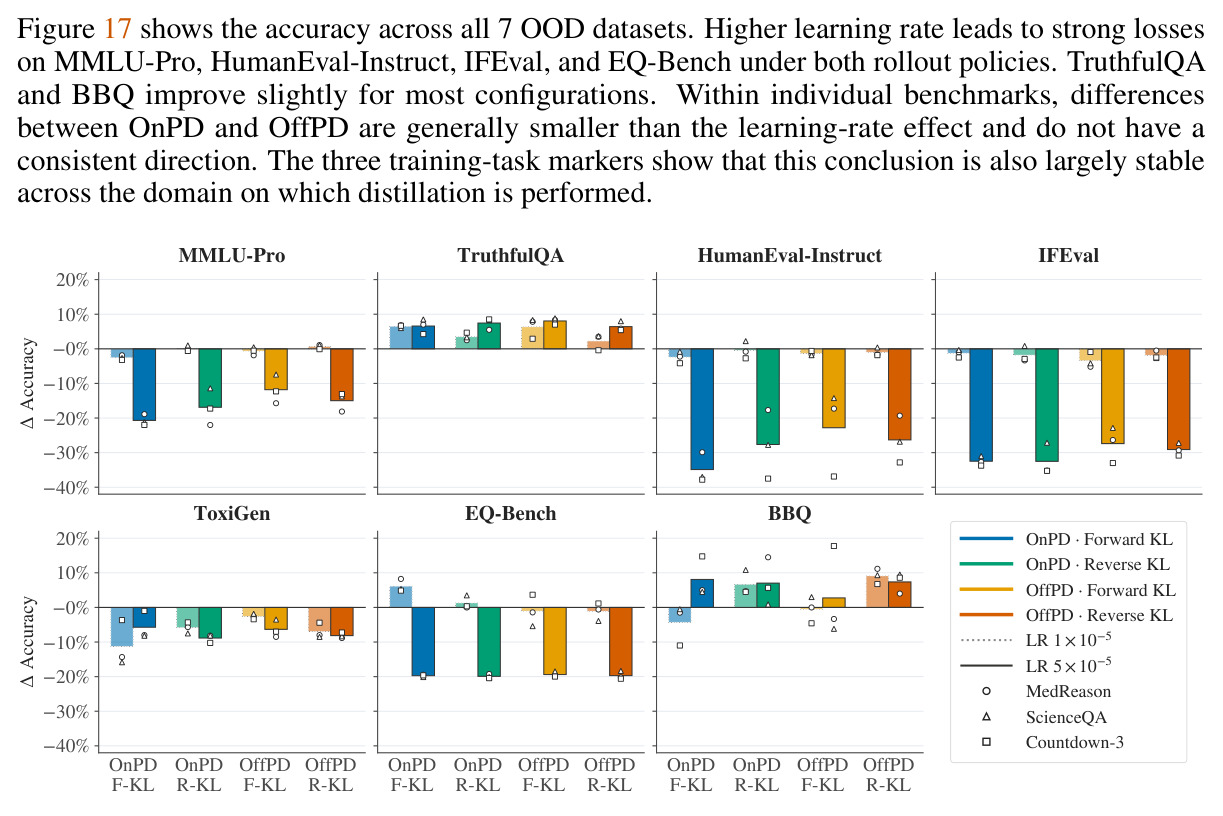
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 三大推理任务平均(MedReason/Science/Countdown-3) | held-out 准确率(200 题/任务,3 种子) | OnPD 最优均值 72% | OffPD 最优均值 73% | −1pp:控制 KL 方向与学习率后 on-policy 无一致优势 |
| 前向 KL 全配置(两种 rollout × 两种学习率) | held-out 准确率范围 | 71–73%,对 rollout 与学习率稳健 | 反向 KL:35–72%,对学习率极敏感 | KL 方向对任务性能的影响远大于 rollout 策略 |
| 7 个 OOD 基准平均(灾难性遗忘) | 训练前后平均分变化 | 学习率 5×10^-5:−11.2~−14.0pp | 学习率 1×10^-5:最多 +1.3pp | 学习率而非 rollout 策略主导遗忘 |
| 参数更新稀疏性(τ=10^-6) | |Δ参数|<τ 的参数比例 | 学习率 1×10^-5:85.3–89.6% | 学习率 5×10^-5:51.9–60.0% | OffPD 在每次配对比较中都不比 OnPD 稀疏 |
| Countdown-4E(四操作数更难变体,泛化) | pass@1 / pass@10 | on-policy(λ>0)高 10–15% | off-policy(λ<0) | on-policy 数据在泛化上的首个一致收益场景(两种 KL 方向皆然) |
| Numina-MATH 长推理蒸馏(平均 622 token) | MATH-500 训练中最高准确率 | OnPD+R-KL 59.0%(各配置 53.3–59.0%) | 未训练学生 53.1% | +5.9pp(单种子,作者标注为提示性证据) |
| 西班牙语风格迁移(Qwen2.5-3B→1.5B) | 学生生成西班牙语回答的比例 | OnPD+反向 KL:0.0–0.1% | 其余配置:61.7–100% | on-policy+反向 KL 可抑制附带的教师风格继承 |
局限与改进
作者承认的局限:实验范围有界——学生模型最大 1.5B 参数、推理轨迹最长约 2000 token;教师模型固定不变,未探索不同学生-教师组合是否会产生差异;长推理实验(Numina-MATH)每个条件只跑一个种子,且报告的是训练过程中的最高 MATH-500(选点与报告用同一评估,数字偏乐观),作者自己只把它当作提示性证据。我补充几点观察:教师是按任务专门训练的(Llama 教师在 Science 上仅 67.5%),与实践中『用前沿大模型蒸馏到小模型』的场景有差距;ID 评估每数据集只用 200 题、每题采一个回答,小样本噪声不可忽略;RLVR 阶段用冻结 4-bit 主干加 LoRA(rank 256),且 RLVR 种子固定为 42,曲线差异部分来自蒸馏种子而非 RL 随机性;风格迁移实验同样只有一次训练运行并依赖 GPT-5 单裁判标注;学生温度 1.0/教师 0.5 的不对称虽经消融(Figure 25)辩护,仍是与许多常见实现不同的设计选择;此外论文通篇没有报告 OnPD 相对 OffPD 的实际算力开销对比,而这恰是其『重新权衡 on-policy 成本』这一实践建议的前提。
独立分析的弱点
独立分析的弱点与改进方向。一,规模外推风险:全部结论建立在 ≤1.5B 学生上,而 7B+ 模型的损失景观、Adam 动力学与遗忘行为可能不同,应在 7–8B 学生上重复关键网格。二,长 rollout 证据太薄:OnPD 在 Numina-MATH 上的优势只有单种子且用 max 指标,应以固定验证集选点、多种子重跑并报告置信区间,否则『on-policy 在难任务上更有利』难以站稳。三,缺成本核算:论文动机是『on-policy 昂贵』,但没有给出 GPU 小时或生成 token 开销的量化,应补充『每准确率点的计算成本』让 OffPD-as-baseline 的建议真正可操作。四,理论与实验之间的缝隙:定理只约束一步期望半梯度,与 150 步后的最终性能之间没有形式化联系(作者也承认),可发展多步训练动力学分析,或直接验证 Corollary C.3 预言的『极端 log-ratio 前缀』诊断量与训练崩溃的对应关系。五,泛化实验局限于 Countdown 家族内部(同一任务的更难变体),on-policy 对真正异分布的迁移(跨领域、跨格式)是否仍有 10–15% 收益未知。六,风格迁移的解释——教师在英文前缀上仍支持英文 mode,因而 mode-seeking 的反向 KL 能锁住英文——只是假设,可通过教师分布在 token 级的直接测量来检验。
未来方向
作者提出的方向:把分析扩展到更大模型与需要更长 rollout 的任务;研究在特定学生-教师配对下 OnPD/OffPD 差异是否会被放大。基于本文成果可以延伸的方向:一,混合数据配方——既然 on-policy 只在泛化到更难变体时一致有益,可设计『off-policy 为主、少量 on-policy 收尾』的廉价混合流程并刻画配比-收益曲线;二,多阶段流水线设计——论文发现蒸馏 checkpoint 的初始泛化优势与 RLVR 后表现脱钩(与 Zhang et al. 2026a 在 SFT 上的发现呼应),值得系统研究 distill→RLVR 流水线中各阶段学习率、KL 方向与数据策略的最优组合;三,为反向 KL 引入似然比控制(满足 Corollary C.3 的条件)或自适应裁剪,以兼得模式寻求行为与训练稳定;四,把 λ 谱推广为诊断工具,用谱扫描定位训练崩溃的临界区域;五,把同样的解耦方法论应用到偏好优化(DPO/KTO)与过程奖励模型等其他后训练范式,检验『rollout 策略归因』结论的普遍性。
复现评估
复现条件总体友好但工程量不小。模型全部公开(Llama-3.1-8B-Instruct、Llama-3.2-1B-Instruct、Qwen2.5-7B/1.5B-Instruct、Qwen2.5-Math-1.5B-Instruct);数据方面 MedReason、SciKnowEval、Numina-MATH 公开,Countdown-3/4 为固定种子的程序化生成,但 Countdown-3 与 MedReason 的训练示范由 GPT-5 生成并过滤,复现者需要 GPT-5 API,否则示范差异会引入偏差。附录文档极其详尽:Table 3/4/5 列出蒸馏、RLVR、风格迁移实验的全部超参(优化器、批次、温度、裁剪、采样设置、LoRA 配置),reproducibility statement 承诺所有配置、数据划分与评估流程均有文档,主结果均为 3 种子加 SEM,少 run 实验被明确标出;论文未明确提及放出官方代码。算力方面:学生是 1B 全参数微调、150 步、有效批 32,主网格约 2×2×2×3 数据集×3 种子=72 个 run,再加 λ 谱、无裁剪/采样 KL 消融、Qwen 重复与 24 个 RLVR run,估计在数百 A100-GPU 小时量级(作者获 Microsoft Azure 赞助)。技术难点在于 OnPD 需要训练引擎与 vLLM 推理引擎每步同步权重的协同部署、全词表 KL 的显存管理(OnPD 开梯度检查点)以及教师温度 0.5 等细节;对拥有小模型训练与 vLLM 经验的团队,复现主结论难度中等,关键是严格照搬附录中的温度、裁剪与停止梯度位置。
论文图表
在 Countdown-3 上把学习率从 1×10^-5 系统扫描到 6×10^-5:更新稀疏性近似线性下降、OOD 性能持续恶化,两种 rollout 策略下趋势一致;相同学习率下 OffPD 遗忘略小,但该差异远小于学习率本身的影响。
把『学习率主导遗忘与稀疏性』从两点比较升级为连续扫描证据,并展示了性能-遗忘权衡的『悬崖』现象。
λ 从 −2(教师偏好)到 2(学生偏好)的 rollout 谱上,前向 KL 的 ID 准确率全程保持在 80% 以上(学习率 1×10^-5 下仅波动 5.2 个百分点),反向 KL 波动剧烈、高学习率下经常崩溃,且低学习率时明显偏好学生侧(λ>0);遗忘与稀疏性沿谱变化不大,仍由学习率决定。
这是『KL 方向决定 rollout 敏感度』这一核心机制发现的最关键证据图,是第 5 节的中心实验。
每 100 步评估一次 MATH-500(每题 10 个回答):低学习率下学习轨迹更稳,高学习率配反向 KL 特别不稳定;不同配置的最优 checkpoint 位置差异很大。
展示长推理训练的动态过程,解释 Figure 10 为何采用 max 指标及其潜在的乐观偏差。