LVMT:面向长时视频分割的视频掩码 Transformer LVMT: Video Mask Transformer for Long-term Video Segmentation
用 GRU 门控记忆加分块截断训练,让视频分割在长时遮挡下既准又快
前置知识
视频实例分割(VIS)
在视频的每一帧中同时完成三件事:分割出目标实例的像素级掩码、预测其类别标签、并在时间轴上保持同一实例的身份一致(即跟踪)。代表数据集有 OVIS(重遮挡场景)和 YouTube-VIS。任务要求在线进行:预测第 $t$ 帧时只能用当前帧和历史帧。本文还在视频全景分割(VPS)和视频语义分割(VSS)上验证,说明方法是通用范式。
本文的全部实验都围绕这三类视频分割任务展开,理解 VIS 的查询匹配与身份保持机制是理解论文动机(身份切换问题)的前提。
查询传播与查询融合
DETR 式分割模型用一组可学习查询 $Q_{\mathrm{lrn}}$ 表示待检测目标。VidEoMT/PMT 把上一帧输出 $\hat{Q}_{t-1}$ 线性投影后加到可学习查询上,即 $Q_t^F = \mathrm{Linear}(\hat{Q}_{t-1}) + Q_{\mathrm{lrn}}$,以此把时序信息传给当前帧。这种融合是无选择的:可学习查询每次都原样叠加,遮挡目标的信息会被逐步稀释。
论文指出的第一个根本缺陷就出在这个公式上,LVMT 的 GRU 传播正是对它的直接替换,必须理解原机制才能体会改进点。
GRU(门控循环单元)
一种经典循环神经网络单元,通过更新门和重置门控制隐状态 $h_t$ 中信息的保留与遗忘:$h_t = (1-z_t) \odot h_{t-1} + z_t \odot \tilde{h}_t$,其中 $z_t$ 是更新门。它维护一个固定大小的隐状态作为记忆,每步根据新输入自适应决定写入多少、保留多少,参数量远小于 LSTM 且更易优化。
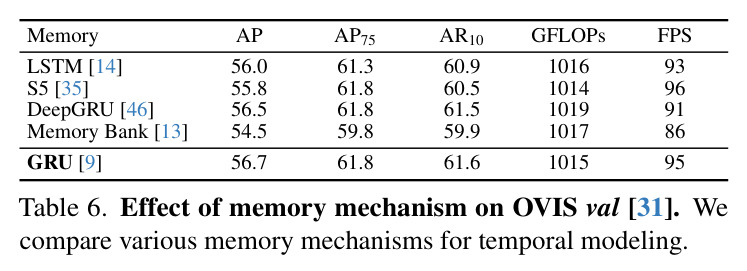
LVMT 用一个在所有查询槽间共享参数的 GRUCell 作为时序记忆模块,是论文的第一大创新;消融实验表明它优于 LSTM、S5、DeepGRU 和显式记忆库。
TBPTT(截断时序反向传播)
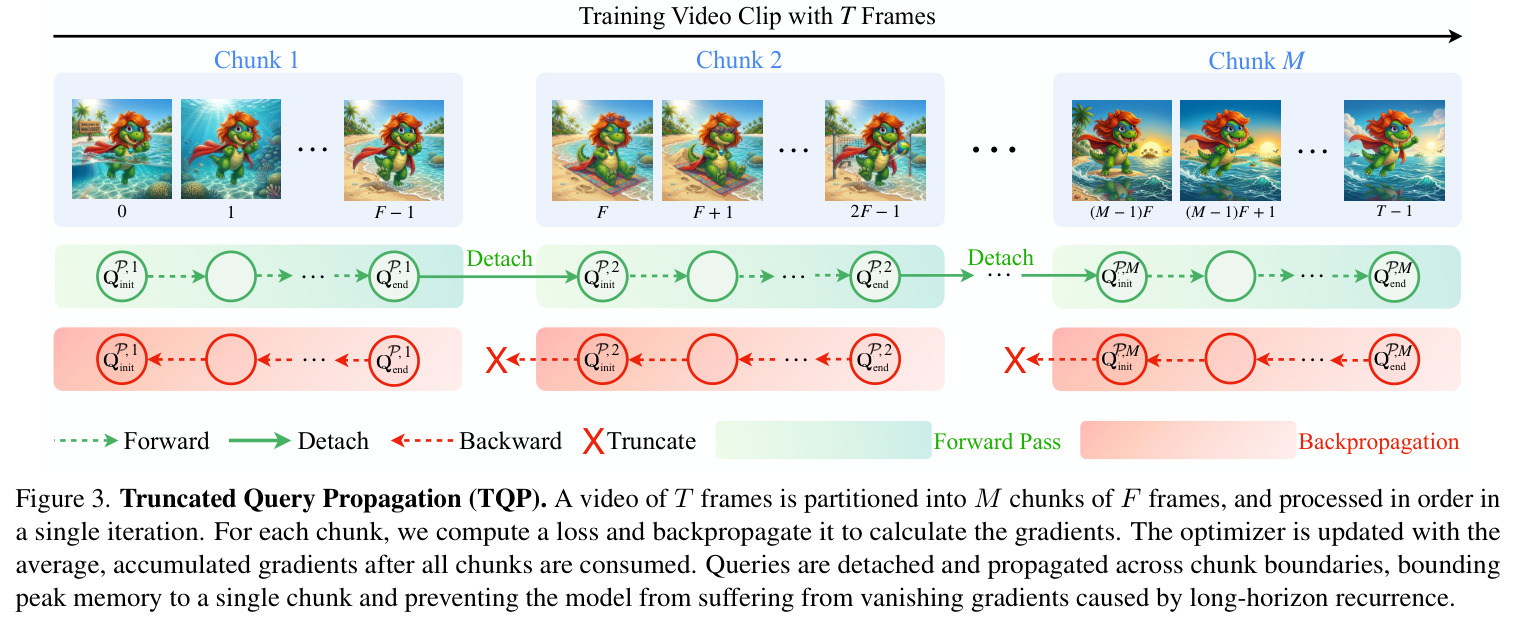
训练循环模型时,把长序列切成若干片段,前向时跨片段传递隐状态以保持长程依赖,但反向传播只在单个片段内进行(在片段边界对隐状态做 detach,切断计算图),从而把峰值显存限制在单片段内,并避免梯度穿过大量时间步而消失。经典方法用于 RNN 语言模型训练。
论文的 Truncated Query Propagation(TQP)就是把 TBPTT 原理首次适配到视频分割的查询传播上,是第二大创新,不理解 TBPTT 就无法理解 TQP 的设计。
冻结 ViT 编码器与 DINOv3 预训练
PMT 范式把大规模视觉 Transformer(如 ViT-L)当特征提取器,用 DINOv2/DINOv3 等自监督权重初始化,训练时冻结编码器、只训练轻量解码器(PMD)。好处是编码器可被多个任务复用、训练更省、实验证明精度反而更高。
LVMT 延续 PMT 的冻结编码器设定(ViT-L + DINOv3),所有效率指标(约 95 FPS、1015 GFLOPs)都基于这一架构,是复现和对比的基线配置。
身份切换(IDS)与跟踪质量指标
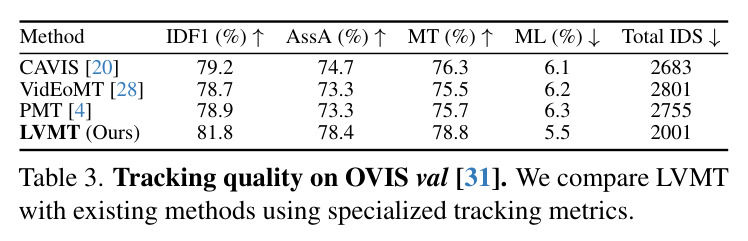
身份切换指同一物体在不同帧被分配了不同轨迹 ID,是视频分割最典型的失败模式,尤其在长时遮挡后重新出现时。衡量指标包括 IDF1(身份保持 F1 分数)、AssA(关联准确率)、MT/ML(大部分被跟踪/丢失比例)和 IDS 总数。
论文用这些指标专门分析长时跟踪能力:LVMT 在 OVIS 上把 IDS 从 PMT 的 2755 降到 2001(约 -27%),直接印证了 GRU 记忆对遮挡重识别的作用。
研究动机
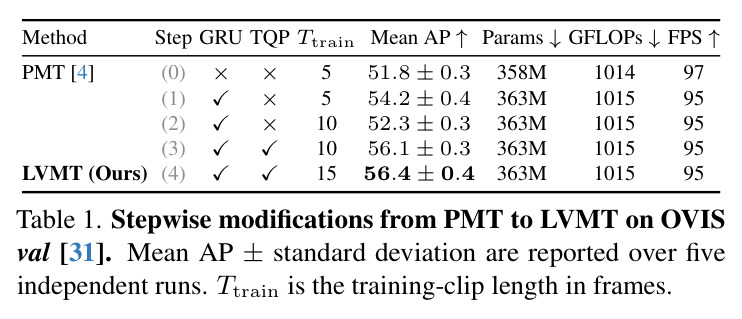
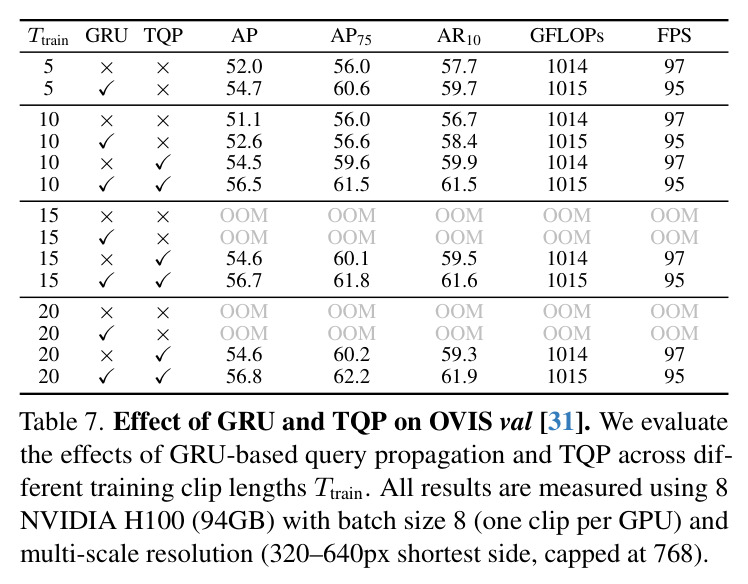
以 VidEoMT 和 PMT 为代表的高效在线视频分割模型用大型预训练 ViT 加简单的时序查询传播取代了早期模型的复杂组件,速度极快(PMT 在 H100 上约 97 FPS),但在长而复杂的视频中频繁出现身份切换。根因有二。其一是传播机制无选择性:融合公式 $Q_t^F = \mathrm{Linear}(\hat{Q}_{t-1}) + Q_{\mathrm{lrn}}$ 中,无时序感知的可学习查询每帧都原样叠加到目标查询上,当物体被长期遮挡时,当前帧编码器无法提供该物体的任何信息,其查询被不断稀释,重新出现时无法被再识别。其二,模型只在 5 帧短片上训练,而作者对 OVIS 上身份切换最多的 20 个视频的统计分析显示:这些视频的物体数量约为普通视频的 3 倍,遮挡事件多 5 倍,平均遮挡时长 13 帧,是训练片段长度的 2.6 倍——遮挡时间跨度远超训练时程。直接把训练片段从 5 帧拉长到 10 帧会导致 AP 从 54.2 降到 52.3,更长则直接显存溢出(OOM),且循环更新上的长程反传会造成梯度消失。
本文的目标是本文的目标是在完全保留 PMT 级别效率(约 95 FPS、约 1015 GFLOPs、冻结编码器可多任务复用)的前提下,让模型具备长时程时序建模能力。具体拆成两个正交目标:第一,让传播机制能够自适应地选择哪些目标信息被保留并跨时间传播——目标被遮挡时把其信息可靠地存进记忆,重现时读出来完成再识别;第二,让模型能够真正在长视频上训练——不因处理更多帧而内存爆炸、不因长程反传而梯度消失,从而使训练时看到的遮挡跨度覆盖测试时遇到的遮挡跨度。最终检验标准是在视频实例、全景、语义分割共六个基准上全面刷新 SOTA,且推理速度与基线几乎一致。
与已有工作不同的是,面对长时记忆问题,已有工作要么用显式查询记忆库(GenVIS)保留所有历史查询,要么用多重记忆库加迭代检索(XMem、Cutie、LiVOS,属 VOS 领域),代价是内存和计算随视频长度与目标数增长,难以用于高效的视频实例分割。SAM3 虽强但架构复杂、速度随目标数下降。本文的独特切入点是:用固定大小的 GRU 隐状态作为记忆——无论视频多长,记忆占用恒定,且门控机制天然提供了『选择性保留』的能力,这是简单线性融合做不到、复杂记忆库又不必需的。训练侧则首次把 TBPTT 思想从 RNN 语言模型迁移到查询传播场景,设计出 TQP:前向跨块传状态、反向块内截断、块间梯度累加取平均后一次更新,作者称之为 Truncated Query Propagation,兼顾长时监督、有界显存和梯度稳定。
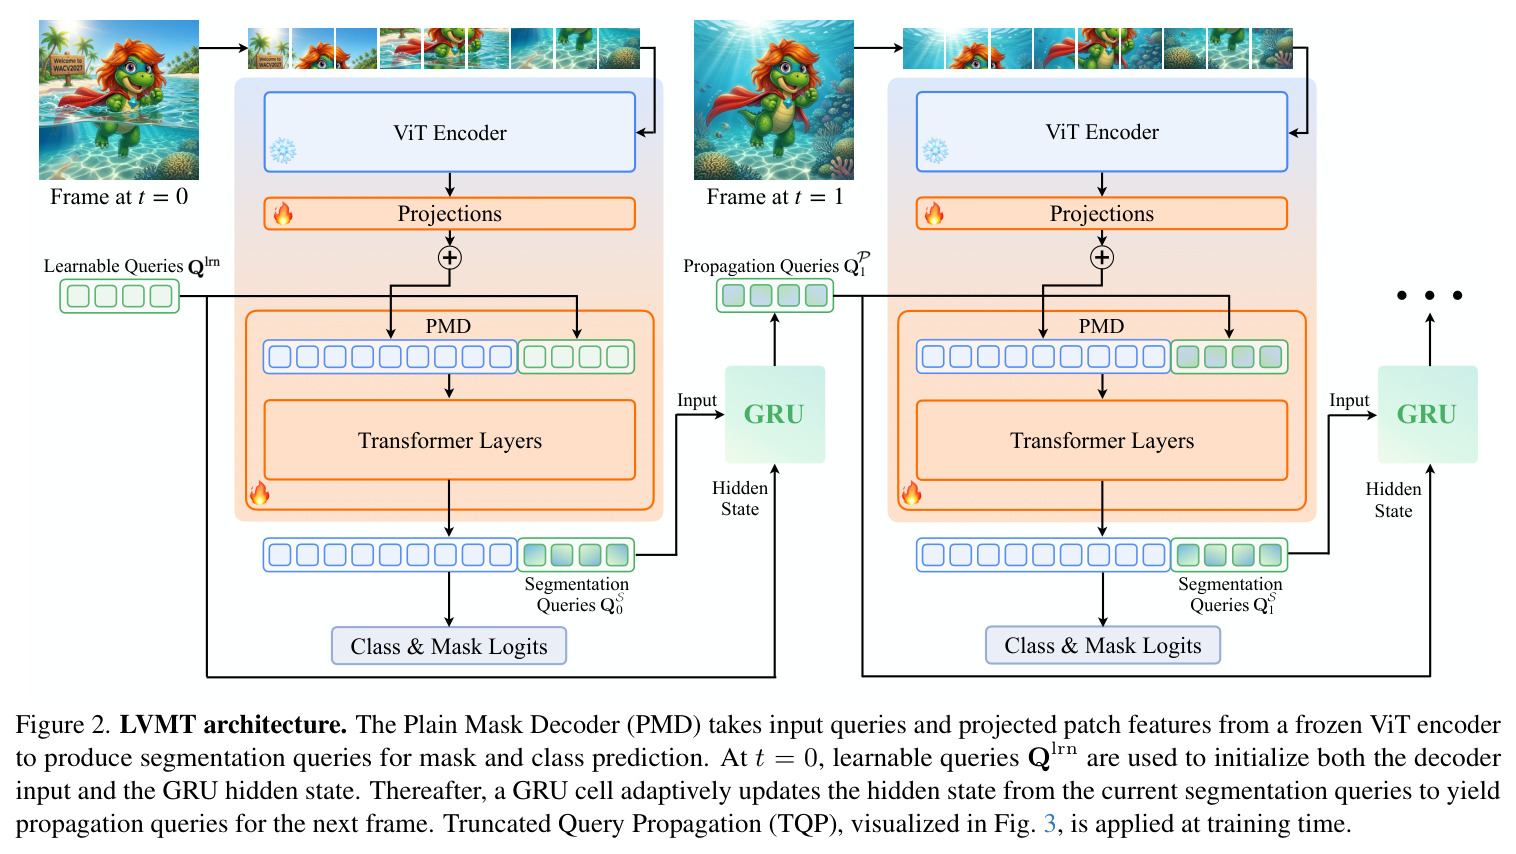
核心方法
LVMT 以 PMT 为骨架:冻结的 ViT-L(DINOv3 初始化)逐帧提取 patch 特征,轻量的 Plain Mask Decoder(PMD)接收传播查询与 patch 特征,输出分割查询 $Q_t^S$,再由轻量头预测类别与掩码。本文只动两处。第一,把查询融合换成 GRU 记忆:第 0 帧用可学习查询同时初始化解码器输入和隐状态 $h_0 = Q^{\mathrm{lrn}}$,随后 $Q_1^P = \mathrm{GRUCell}(Q_0^S, h_0)$;对 $t>0$,$Q_t^S = \mathrm{PMD}(Q_t^P, X_t^l)$,再用 $Q_{t+1}^P = \mathrm{GRUCell}(Q_t^S, h_t)$ 更新状态。GRUCell 在所有查询槽间共享参数,状态大小固定,不随视频长度增长。第二,训练策略 TQP:把 $T$ 帧视频切成 $M=\lceil T/F \rceil$ 个 $F$ 帧的块(默认 $F=5$、$T=15$),在单个迭代内按序前向,每块独立算损失并反传,块边界对隐状态 detach,所有块的梯度平均累加后只做一次优化器步进。
核心洞察是『记忆的选择性』与『监督的长时程』是两个独立问题,必须分别解决。对于选择性:原公式中传播查询永远等于可学习查询加上一帧输出的投影,模型没有任何自由度决定『保留什么、丢弃什么』;GRU 的门控(更新门 $z_t$、重置门)给了模型显式的读写控制——物体消失时可以把它的信息完整存入隐状态不被稀释,重现时再读出,实现长时遮挡后的再识别。消融证明这种自适应选择本身就是关键:仅把融合换成 GRU(不改变训练长度)就在 OVIS 上带来 +2.4 AP。对于长时训练:朴素拉长片段会同时触发显存爆炸和梯度消失(10 帧训练 AP 反降 1.9),TQP 的本质是让信息前向流经完整时序(隐状态跨块传递,第 $i$ 块末态 $h_{\mathrm{end}}^i$ 经 detach 后成为第 $i+1$ 块初态),而把计算图限制在单块内——峰值显存只与一个 5 帧块相关,梯度也无需穿越多次 GRU 更新。
方法步骤详情
第一步(初始化):帧 $I_0$ 经冻结 ViT 与投影层得 $X_0^l$;因尚无传播查询,PMD 以可学习查询为输入:$Q_0^S = \mathrm{PMD}(Q^{\mathrm{lrn}}, X_0^l)$,产出第 0 帧预测;同时 $h_0 = Q^{\mathrm{lrn}}$。第二步(逐帧循环):对 $t>0$,先算 $Q_t^S = \mathrm{PMD}(Q_t^P, X_t^l)$ 得当前帧预测,再算 $Q_{t+1}^P = \mathrm{GRUCell}(Q_t^S, h_t)$,其中 $Q_t^P$ 就是上一时刻隐状态 $h_t$,保证推理只依赖当前帧与历史信息,维持在线性质。第三步(TQP 训练):15 帧片段切成 3 个 5 帧块,在一个迭代内按序处理;每块完整前向与反向得到损失 $\mathcal{L}^{(i)}$ 与梯度;块间传递 $Q_{\mathrm{init}}^{P,i+1} = \mathrm{detach}(h_{\mathrm{end}}^i)$;全部块消费完后用平均累加梯度更新一次权重。第四步(匹配与配置):真值匹配沿用标准做法——物体在首帧出现时分配查询并全程保持;AdamW、混合精度,批大小、学习率与调度器均与 PMT 一致,8 卡 H100(94GB)每卡一个片段。
技术新颖性
架构层面的新颖性在于用最简单的循环单元实现了『选择性记忆』:作者系统对比了 LSTM、结构化状态空间模型 S5、RVM 的 DeepGRU 和 GenVIS 式带交叉注意力的显式记忆库,结果参数最简的共享 GRU 以 56.7 AP 登顶(LSTM 56.0、S5 55.8、DeepGRU 56.5、记忆库 54.5),说明瓶颈不在记忆容量而在选择机制,这是一个反直觉且有价值的设计结论。训练层面的新颖性在于 TQP 是 TBPTT 在视频分割查询传播上的首次系统适配,且有两个非标准设计:块间梯度做平均累加、整个视频只做一次优化器更新,而非每块更新;同时前向信息流跨块、反向计算图块内截断的组合,被证明与 GRU 缺一不可——无 GRU 时 TQP 在 10 帧上仅 54.5 AP,无 TQP 时 15 帧直接 OOM。此外,整套改进完全兼容冻结编码器范式,实验(附录 B.5)表明冻结编码器不仅省算力还比微调更准,保证了编码器可跨任务复用的工程价值。
实验结果
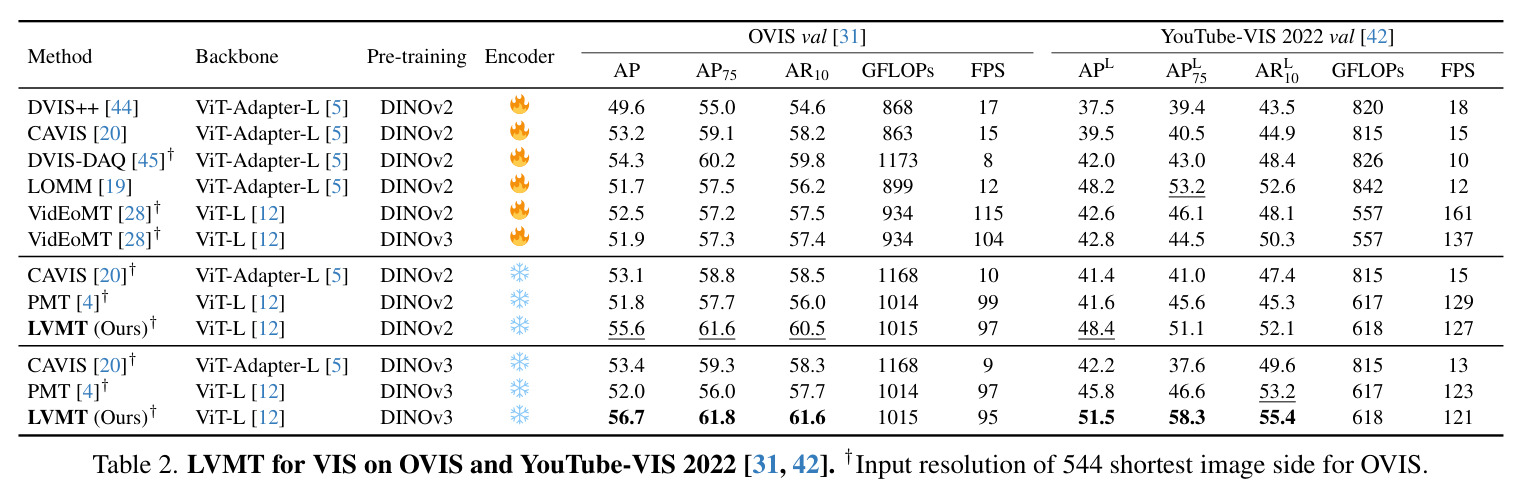
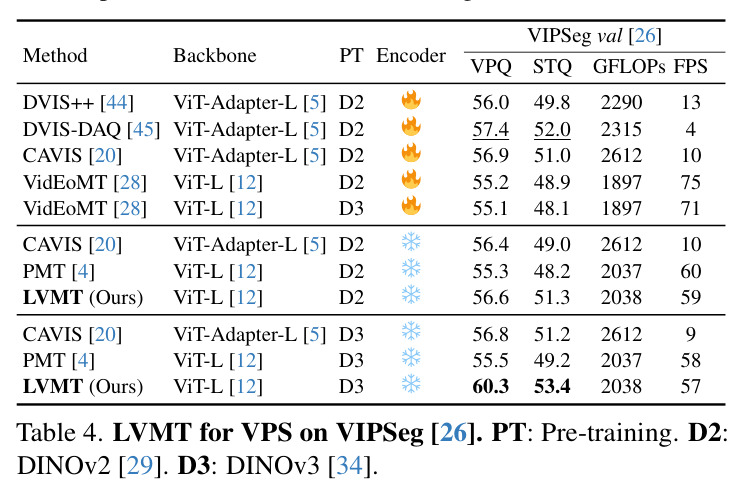
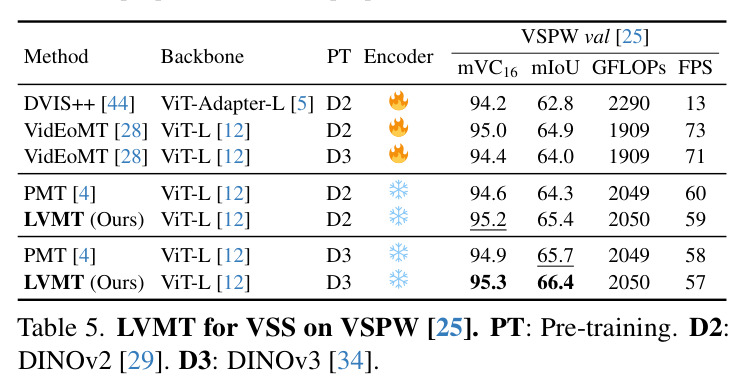
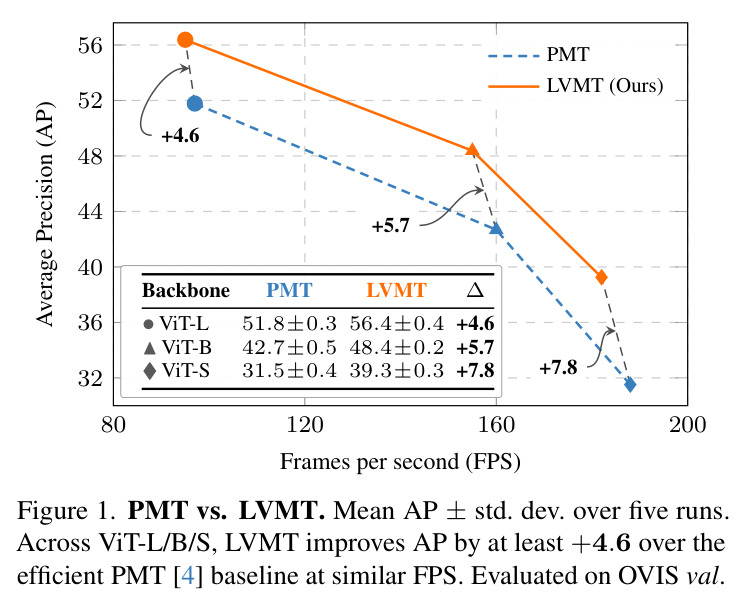
渐进消融(Table 1,OVIS val,5 次运行均值)拆解了各组件贡献:PMT 基线 51.8±0.3 AP;仅换 GRU(训练 5 帧)升至 54.2±0.4(+2.4);朴素拉长到 10 帧反跌至 52.3(梯度消失);叠加 TQP 后 56.1;15 帧训练最终 56.4±0.4,参数仅 358M→363M,GFLOPs 1014→1015,FPS 97→95。主结果(Table 2):DINOv3 下 OVIS 达 56.7 AP,比同设置 PMT 高 4.7,比微调编码器的 SOTA 方法 DVIS-DAQ(54.3)高 2.4 且快 10 倍以上(95 vs 8 FPS);YouTube-VIS 2022 达 51.5 AP,比 PMT 的 45.8 高 5.7。跟踪质量(Table 3):OVIS 上 IDF1 81.8%(PMT 78.9%)、AssA 78.4%、IDS 从 2755 降至 2001(约 -27%),直接验证记忆机制初衷。VPS(Table 4):VIPSeg 上 VPQ 60.3(PMT 55.5,+4.8),比 DVIS-DAQ 高 2.9 且快约 14 倍。VSS(Table 5):VSPW 上 mIoU 66.4(PMT 65.7)、mVC 95.3。记忆机制消融(Table 6):GRU 56.7 优于 DeepGRU 56.5、LSTM 56.0、S5 55.8、显式记忆库 54.5。TQP 消融(Table 7):无 TQP 时 15/20 帧训练全部 OOM;有 TQP 时 15 帧 56.7、20 帧 56.8——收益趋缓是因 OVIS 平均遮挡 13 帧已被 15 帧训练覆盖,暗示在更长遮挡数据集上仍有上行空间。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频实例分割(VIS)— OVIS val(DINOv3) | AP | 56.7 | PMT 52.0 / DVIS-DAQ 54.3 | 较 PMT +4.7,较此前 SOTA DVIS-DAQ +2.4,且 FPS 从 8 提升到 95(约 12 倍) |
| 视频实例分割(VIS)— YouTube-VIS 2022 val(DINOv3) | AP_L(长视频 AP) | 51.5 | PMT 45.8 / LOMM 48.2 | 较 PMT +5.7,较 LOMM +3.3,同时快约 10 倍(121 vs 12 FPS) |
| 视频全景分割(VPS)— VIPSeg val(DINOv3) | VPQ / STQ | 60.3 / 53.4 | PMT 55.5 / 49.2;DVIS-DAQ 57.4 / 52.0 | 较 PMT +4.8 VPQ,较 DVIS-DAQ +2.9 VPQ,速度约 57 FPS 对 4 FPS |
| 视频语义分割(VSS)— VSPW val(DINOv3) | mIoU / mVC16 | 66.4 / 95.3 | PMT 65.7 / 94.9;VidEoMT 64.0 / 94.4 | 较 PMT +0.7 mIoU、+0.4 mVC,FPS 基本持平(57 vs 58) |
| 跟踪质量 — OVIS val | IDF1 / 总 IDS | 81.8% / 2001 | PMT 78.9% / 2755;CAVIS 79.2% / 2683 | IDF1 +2.9 个百分点,身份切换减少约 27% |
局限与改进
作者承认的局限:训练片段从 15 帧加到 20 帧仅带来 +0.1 AP,说明在 OVIS 上长时训练的收益已接近饱和(平均遮挡 13 帧已被覆盖),更大收益需要在遮挡更长的数据集上验证;Table 1 中 20 帧的收益也仅 0.1-0.4。我自己的观察:其一,固定大小的 GRU 状态是硬容量约束——OVIS 上最难的统计组有约 3 倍物体数,当并发跟踪目标很多且多个目标同时长时间消失时,隐状态可能发生信息挤压与混淆,论文未给出目标数上限的分析;其二,TQP 在块边界 detach 后,跨块的长程一致性只有前向信号而无梯度信号,模型对『隐状态应跨块保持什么』没有直接监督,这可能限制超过训练时程的泛化;其三,IDS 仍有 2001 次,重识别问题被缓解而非解决;其四,约 1015 GFLOPs 的计算量在 H100 上流畅,但离边缘端实时部署很远;其五,所有评估限于封闭词表的视频分割,GRU 记忆对开放词汇或 promptable 设置(如 SAM3 类交互)是否适用未验证。
独立分析的弱点
第一,记忆容量与目标数量的矛盾:GRU 隐状态固定为 $K$ 个查询槽的维度,长视频中目标频繁进出、多个目标同时长期消失时,门控必须在外存与遗忘间艰难权衡,可能导致后出现的目标覆盖早消失目标的信息。改进方向:引入稀疏写入或按需扩展的混合记忆(GRU 做短期、小容量显式库做长期归档)。第二,TQP 的无梯度跨块边界:detach 使第 $i$ 块的损失无法指导第 $i-1$ 块的隐状态写入质量。改进方向:随机化截断点、隔块回传(如每第 $j$ 个块允许完整反传),或对跨块状态一致性加辅助损失。第三,纯在线串行推理:每帧必须等上一帧的 GRU 更新,遮挡超过训练时程(15 帧)的极端案例仍可能失败。改进方向:训练时随机跳帧增强(模拟更长间隔的消失重现)。第四,计算开销集中在 ViT-L 逐帧编码(约 1015 GFLOPs)。改进方向:关键帧编码 + 帧间特征传播,或对解码器与 GRU 做蒸馏。第五,所有结论基于分割任务,GRU 门控对其他在线时序预测的可迁移性未验证。
未来方向
作者提出的方向:在遮挡跨度更长的数据集上验证 TQP 的收益上限(Table 7 显示 15→20 帧仅 +0.1,瓶颈在数据而非方法);扩展到更大骨干(论文 Figure 1 已展示 ViT-S/B/L 全线提升,+7.8/+5.7/+4.6,小模型受益更大,值得探索高效小模型路线)。基于成果可延伸的方向:把 TQP 作为通用训练范式迁移到其他在线时序任务,如多目标跟踪、流式 3D 感知、在线视频质检——任何『隐状态传播 + 短片段训练』的场景都适用;探索 GRU 记忆与文本/开放词汇查询的结合,向 promptable 视频分割演进;研究跨块梯度桥接(如低秩总结状态、稀疏全局反传)以进一步拉长有效训练时程;将 GRU 传播与视频世界模型结合,让记忆不仅存过去还能预测遮挡物体的状态;在自动驾驶等长视频真实场景中做长时程压力测试(小时级视频的状态稳定性)。
复现评估
复现条件较友好。代码已开源(https://www.tue-mps.org/lvmt),基线 PMT/VidEoMT/EoMT 均开源,六个数据集(OVIS、YouTube-VIS 2019/2021/2022、VIPSeg、VSPW)全部公开,ViT-L + DINOv3/DINOv2 权重可下载。训练配置在附录 Sec A 有详细说明:AdamW、混合精度、与 PMT 相同的超参,默认 $F=5$、$T=15$。主要门槛是算力:默认配置需 8 卡 H100(94GB)每卡一个片段、多尺度训练(320–640px 短边);但 TQP 恰好把峰值显存限制在单个 5 帧块内,小显存设备通过梯度累加做小规模验证可行。推理侧单卡 H100 即可跑约 95 FPS。作者以 5 次独立运行报告均值±标准差(如 56.4±0.4),可信度高;并给出 GFLOPs(fvcore)与 FPS(batch size 1、FlashAttention v2 + torch.compile)的测量协议,指标可对齐。总体复现难度:中等,卡点在算力而非工程实现。
论文图表