选择何时取代抽取:基于类型化决策模型的智能体记忆预注册检验 When Does Selection Replace Extraction? A Pre-Registered Test of Agent Memory with a Typed Decision Model
预注册非劣性检验:紧预算下原文轮次+一次重排媲美LLM抽取记忆,写成本降3061倍
前置知识
抽取式记忆 vs 原文记忆
抽取式记忆(如 mem0、本文的 engram v2)在写入时用 LLM 把每条对话消息蒸馏成事实条目,常带来源引文和有效期窗口,检索发生在事实库上;原文记忆则原样存储每轮对话(附日期),只在读取时排序挑选。前者写入昂贵(每轮多次 LLM 调用)但条目紧凑,后者写入近乎零成本(仅嵌入)但占上下文 token 更多。
本文的全部实验就是把这两种存储形式放进同一条读路径做受控对比——固定选择器、只换存储内容,读懂这一对立是理解 H1 的前提。
类型化决策模型(Jev)
Jev 是 TypeSafe 的"系统一"决策模型:给定固定选项集的问题,它在一次短请求内为每个选项输出概率,取最大概率选项为决策、以该概率为置信度 $\pi(s,Q)=\max_{o} p(o\mid s,Q)$。它不生成自由文本,输出无需解析,置信度可直接用阈值(如 0.5)筛选,一次请求即可对全部候选打分。
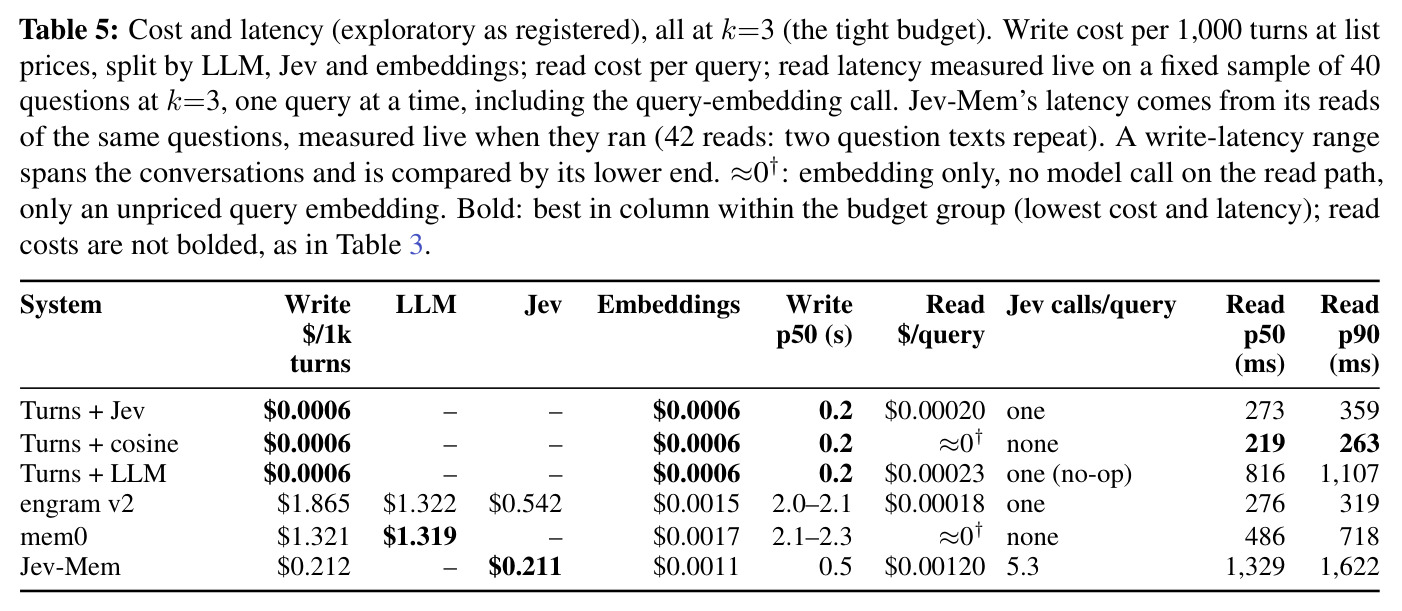
本文的读路径重排器就是 Jev;其成本与延迟优势(读延迟约为 gpt-4o-mini 重排器的 1/3,273ms 对 816ms)完全源于这种单请求封闭式打分模式。
非劣性检验
与"两系统有无差异"的显著性检验不同,非劣性检验问的是"新方案是否至多差 $\delta$ 点"。对每题的配对差值 $d_i=c_i^J-c_i^E$,要求单侧 95% 置信下界超过 $-\delta$:$\bar d - z_{0.95}\, s/\sqrt{N} > -\delta$($z_{0.95}=1.645$)。它回答的是"换便宜方案最多损失多少",而不是"是否严格相等"。
注册主检验 H1 就是一个 $\delta=5$ 分的非劣性检验,"原文不劣于抽取"这一核心结论的合法性完全依赖这个统计框架;换成普通差异检验会因差值小而得出"无差异"的过强结论。
预注册研究
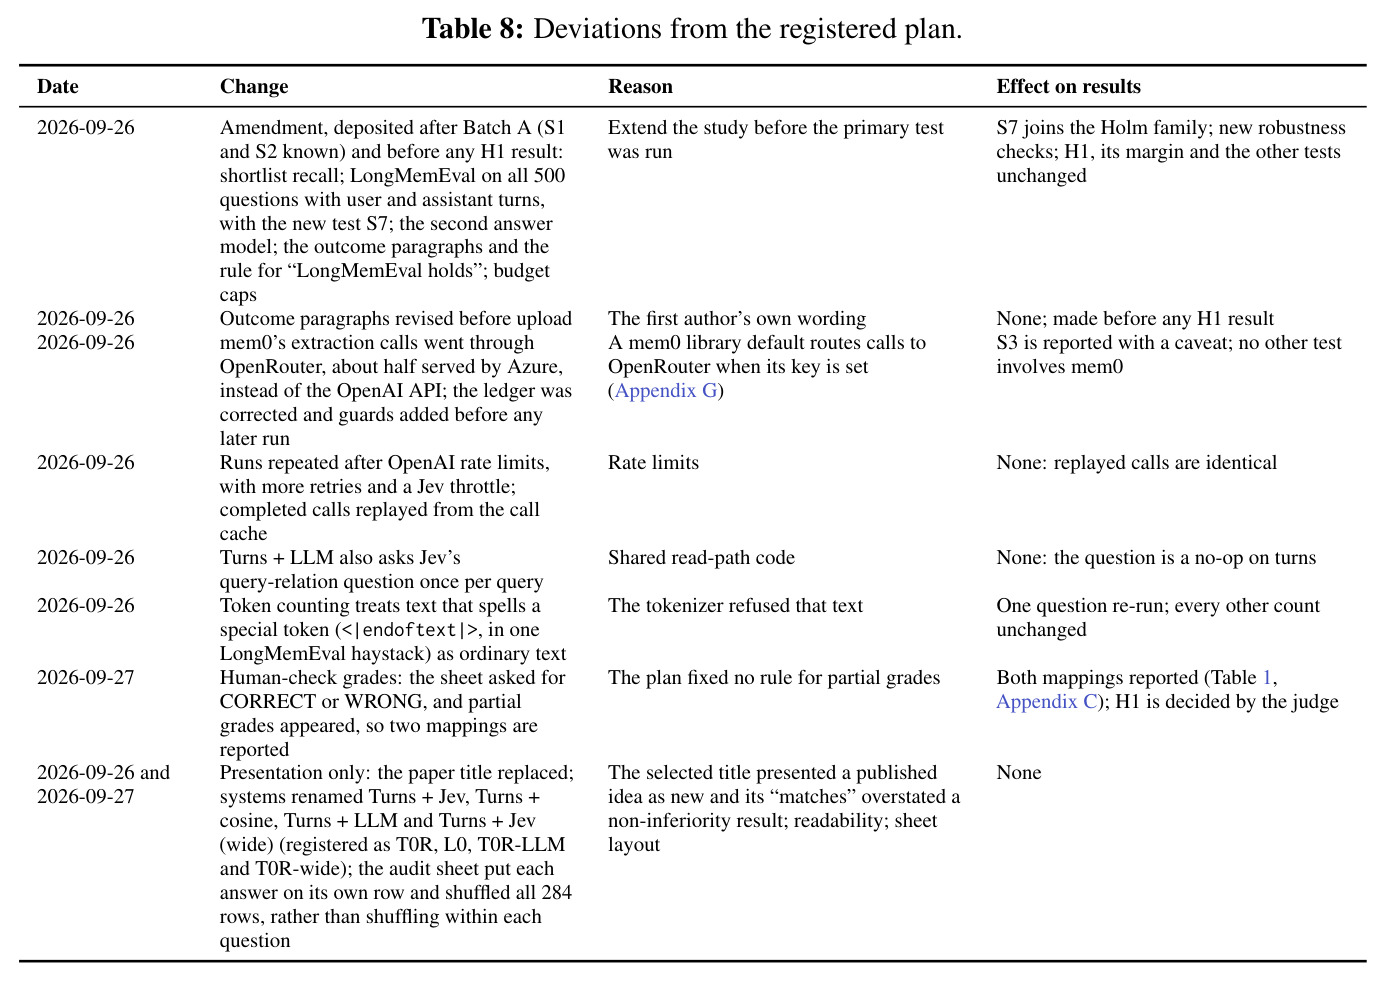
在跑任何留出数据之前,把系统定义、数据切分、token 匹配规则、统计检验、预测和非劣性边际存证冻结(本文存于 Zenodo,带版本 tag),之后所有改动都必须带日期记入 Deviations 部分供审查。这能杜绝事后挑选结果、倒推叙事和 p-hacking。
记忆基准领域结论互相矛盾(排序是否重要都吵不清),本文方法学贡献的一半来自预注册:读者可以确信 H1 的正结果是计划内的,而非跑完数据后挑出来的。
上下文预算与 token 匹配
预算指答案模型实际读到的检索条目数 $k$(对应渲染后的 token 数)。token 匹配要求比较两系统时让进入提示的记忆块 token 数尽量接近:比较者跑自己的 $k_B$(本文为 3),新系统跑匹配的 $k^*=\arg\min_k |T_J(k)-T_B(k_B)|$,否则"谁更准"可能只是"谁读得更多"。
本文的中心发现——重排序收益随预算增大从 +17.4 分缩水到 +1.5 分——就是围绕 $k$ 展开的;不控制 token 就会把"读得多"误判为"方法好"。
McNemar 检验与 Holm 校正
对同一批问题上两系统的配对二值结果(对/错)做精确 McNemar 检验,只统计"仅 A 对"与"仅 B 对"的不一致题数;Holm 校正在多个次级检验家族内控制族错误率 0.05,逐级收紧显著性门槛。
七个次级检验 S1–S7 全用这一组合,论文表格里"Holm p"列和"紫色行=校正后仍显著/非劣、灰色行=不显著"的读法都需要这个背景。
研究动机
对话式智能体的记忆该存什么,文献结论互相冲突。一边是抽取式系统:mem0(Chhikara 等, 2025)对每条消息用 LLM 抽取事实再检索,LongMemEval 设计研究(Wu 等, 2025)发现用抽取事实扩充索引键有助检索,SeCom 对会话分段压缩后检索。另一边,两项 2026 年的研究发现排序良好的原始历史同样好甚至更好:SmartSearch 用确定性流水线加 CrossEncoder/ColBERT 融合排序从原文检索,并断言排序是瓶颈;Fidelity Before Structure 在同一条流水线内只换存储表示,发现逐字片段在 LoCoMo 上领先 LLM 抽取产物 15.9 分(699 题)、在 LongMemEval-S 上领先 22.0 分(500 题),却发现重排序几乎不加增益。这两项研究在"排序是否重要"上也互相矛盾。更糟的是,LLM 评委的宽松度会与答案风格交互,使跨论文的准确率数字更不可比。
本文的目标是本文要在受控条件下回答两个问题。第一,在紧上下文预算(每题只让答案模型读约 129–265 token,即 30 个候选里只留 3 条左右)且 token 匹配的条件下,"原始轮次 + 一次重排调用"是否非劣于强抽取式记忆——作者特意选自己构建、且在其开发对话上最准的 engram v2 当对照,理由是只有足够强的对照才可能让检验失败,这样得出的"非劣"才有分量。第二,重排序相对余弦相似检索的增益如何随预算 $k$(答案模型读取的条目数)变化,以解释 SmartSearch 与 Fidelity 的公开分歧。整项研究预注册:在跑任何留出数据之前冻结计划、主检验、−5 分非劣性边际与预测,并用第二答案模型(Llama 3.3 70B)和盲评人审做稳健性检查。
与已有工作不同的是,独特切入有四点。其一,把"抽取 vs 选择"设计成受控对比:H1 固定选择器(两条路径共用同一套读代码),只更换存储内容(原文轮次 vs 抽取事实);Fidelity 是在一条流水线里换表示,SmartSearch 则是整条流水线都不同,控制变量不如本文严格。其二,据作者所知这是对话记忆领域首个预注册非劣性检验:LazyMem 只预指定了自动指标并把人审当敏感性分析,本文在见任何留出集结果之前就注册了计划、主检验和边际。其三,首次在答案级、匹配上下文下评估类型化决策模型做选择器——此前 Jev-Mem、AtMem–Jev 只报排序指标或架构描述。其四,在同一研究内部做预算扫描(k=3 到 k=20、两个基准),给出解释跨论文分歧的机制,而不是再添一个互相矛盾的点估计。
核心方法
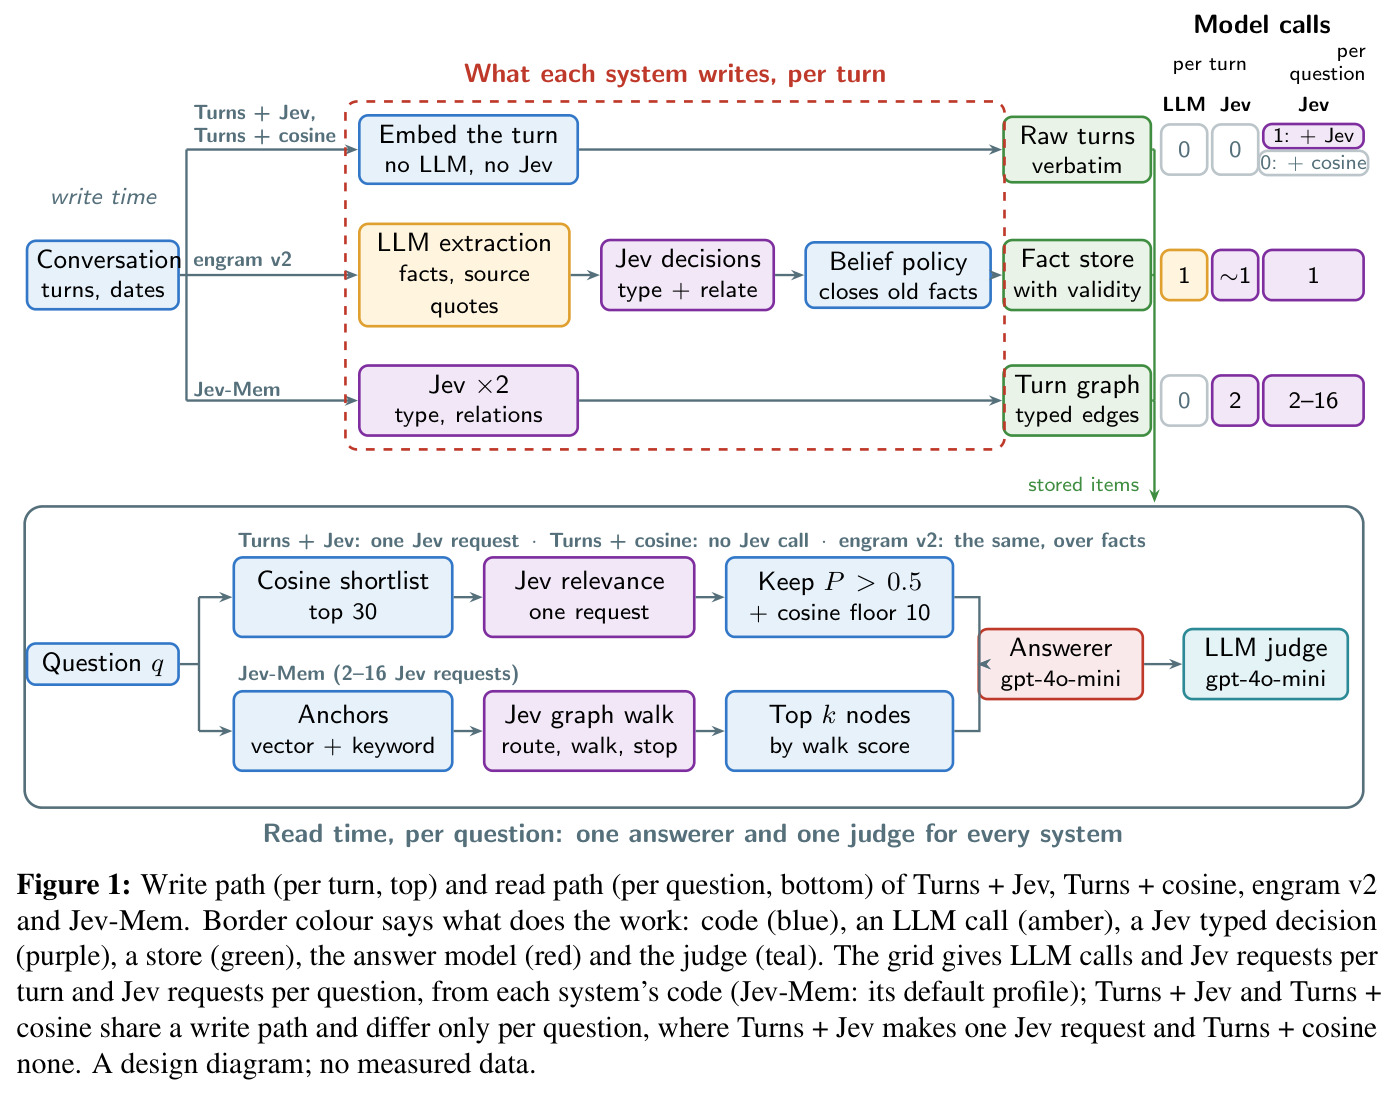
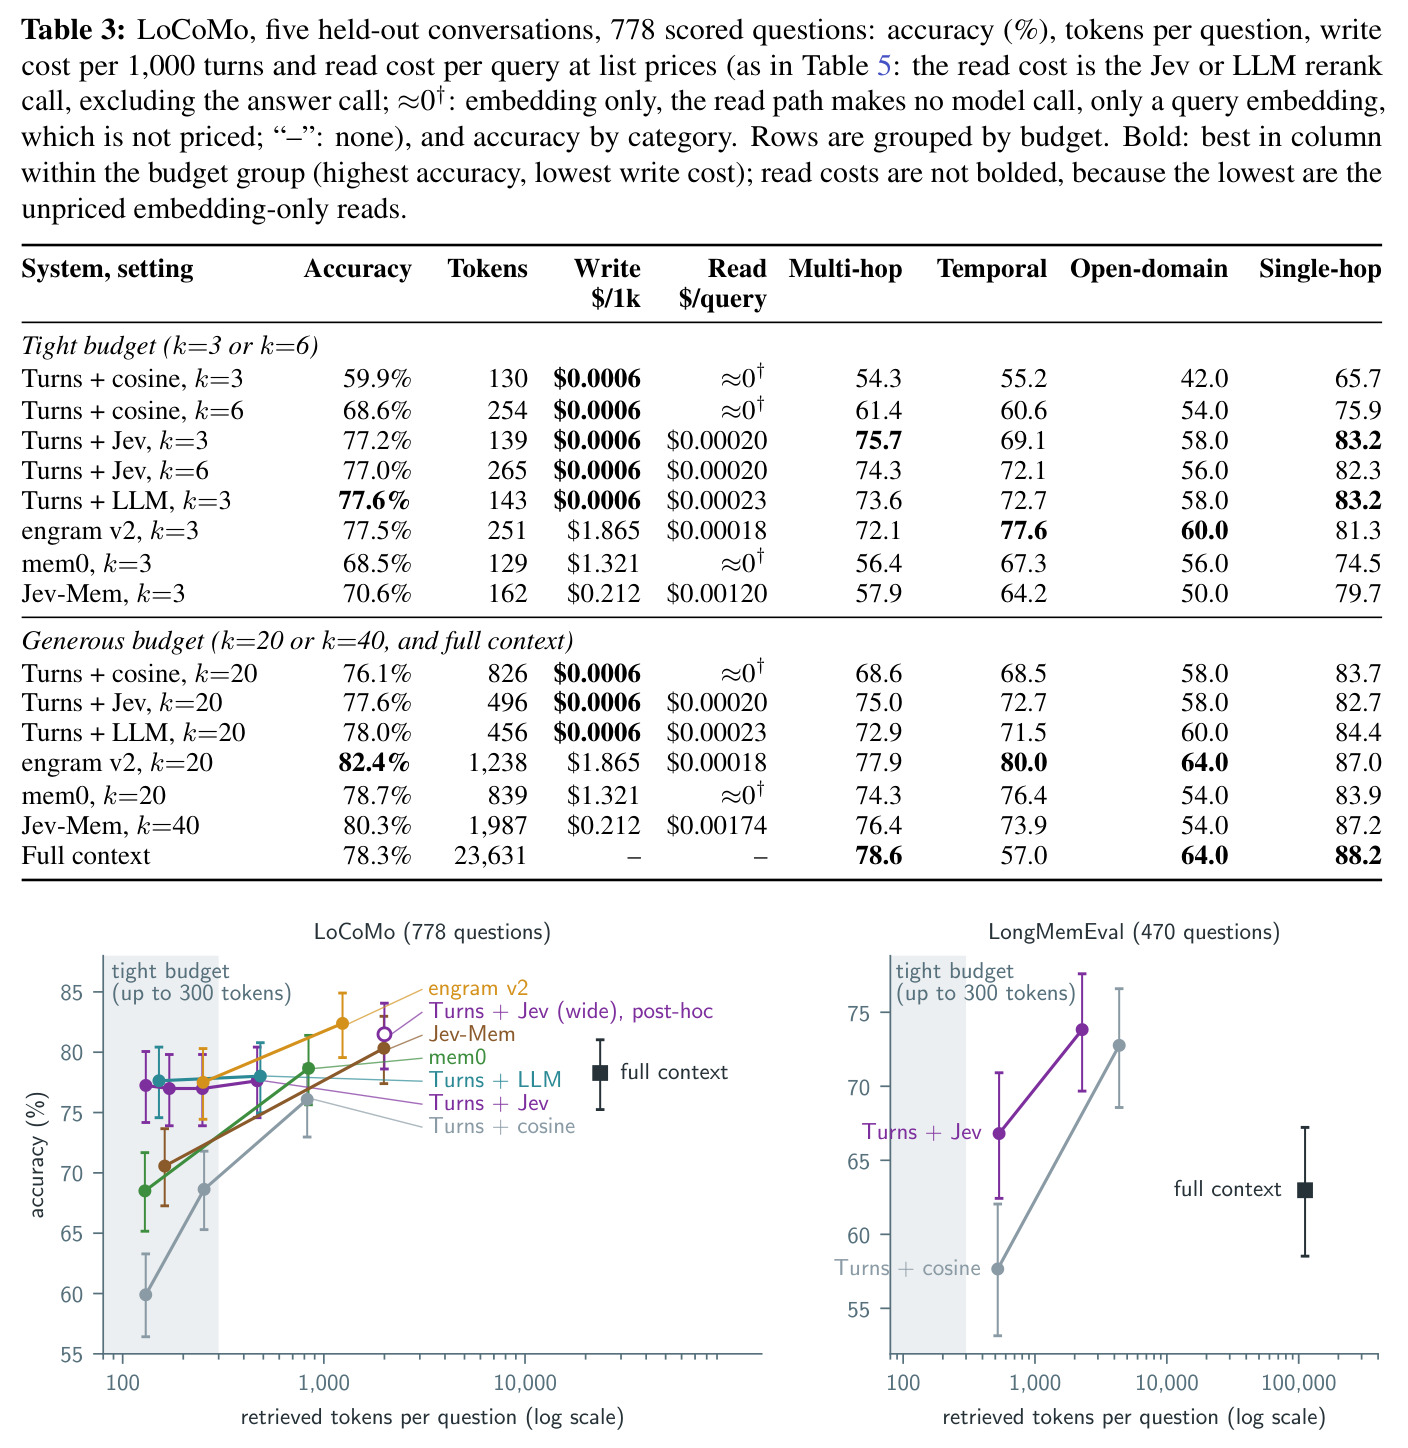
论文把记忆系统形式化为三件套:写函数 $M = W(x_1,\dots,x_T)$ 把对话建成库,读函数选出子集 $S(q)\subseteq M$,答案模型 $a = L(q, \mathrm{render}(S(q)))$ 作答,所有对比都在匹配上下文 token 下进行。原文系系统(Turns + Jev、Turns + cosine、Turns + LLM)的写路径只把每轮经 text-embedding-3-small 嵌入后存为"[日期] 说话人: 文本",零 LLM 调用;读路径先取余弦最近的 $n=30$ 条候选 $C(q)$,再(Jev/LLM 版)重排,答案模型读前 $k$ 条。抽取系统 engram v2 共享同一读路径,只是把库换成 gpt-4o-mini 抽取、Jev 维护的事实条目;Jev-Mem(图遍历)和 mem0 2.1.0 作为外部对照。全部系统用 gpt-4o-mini 作答与评判(mem0 的 LoCoMo 提示)。主检验 H1 在 5 段从未用过的留出对话的 778 道题上,以 $\delta=5$ 分的非劣性边际比较 Turns + Jev 与 engram v2。
核心思想是"选择替代抽取"的条件化:答案取决于上下文预算。直觉是,当预算只容得下 30 个候选中的 3 条时,哪几条进入上下文基本决定答案,一个好选择器对原文轮次重排即可顶替写时抽取;当预算放宽到 20 条时,余弦顺序本身已覆盖大部分证据,重排只剩 1–2 分增益,而抽取产物更紧凑,在宽松预算下反而更准。技术上,Turns + Jev 用一次 Jev 请求对 30 条候选同时回答相关性问题 $Q_{\mathrm{rel}}$("这条记忆是否有助于回答查询?true: 它陈述或直接蕴含答案的一部分;false: 离题或仅共享关键词"),保留 $\rho(m,q)=p(\mathrm{yes}\mid m,q,Q_{\mathrm{rel}})>0.5$ 的轮次并按置信度降序,外加 10 条余弦底线。与 Jev-Mem 每次读取需 2–16 次请求的图遍历相比,单请求选择器在匹配上下文下反而更准且快约 4.9 倍。
方法步骤详情
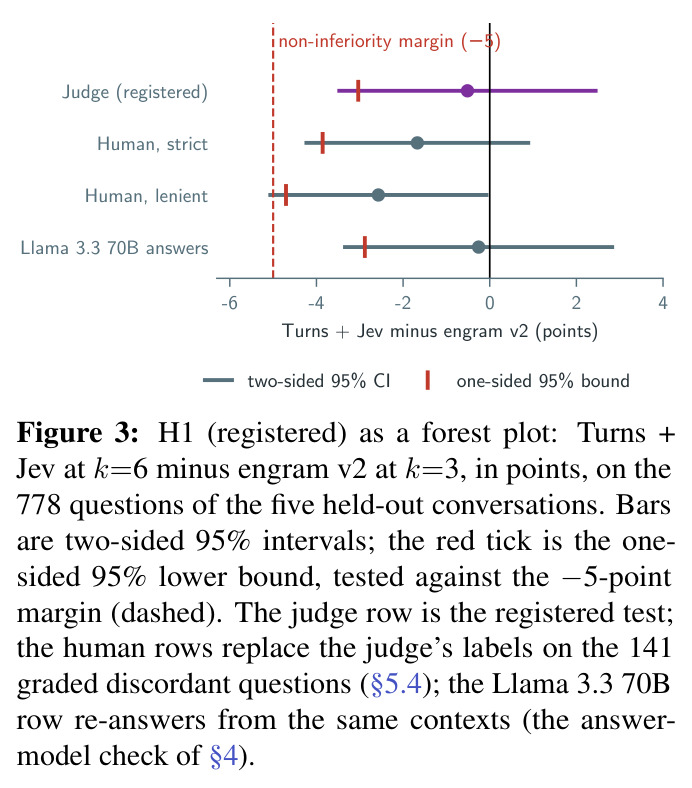
写路径:每轮 $x_t$ 嵌入后以"[日期] 说话人: 文本"存库,无任何模型调用。读路径按式 (3) 取与问题余弦最近的 30 条候选;按式 (4),Jev 一次请求内对每条候选回答相关性问题,保留 $\rho>0.5$ 者按置信度排序,其后补 10 条余弦底线(cosine floor),答案模型读前 $k$ 条;Turns + cosine 完全一样但不调 Jev,Turns + LLM 把 Jev 换成 gpt-4o-mini listwise 重排器。engram v2 的写路径用 mem0 的抽取提示让 gpt-4o-mini 逐消息抽取事实(带会话日期、来源引文与有效期),Jev 回答类型与关系问题(候选事实超过十个时加同属性门控),信念策略关闭被取代的旧事实,读路径同上但作用于事实库。评估流程:H1 为单侧非劣性检验(式 (7),$\delta=5$,$N=778$);S1–S7 为 Holm 校正的精确 McNemar 检验(S4 亦为非劣性);稳健性检查包括用 Llama 3.3 70B 从相同上下文重答、第一作者对 141 道判官分歧题盲评(284 行打乱、不见系统名与判官标签)、以及从冻结存储离线回放计算 shortlist recall。
技术新颖性
技术新颖性不在架构而在检验设计,论文明确声明"原文+重排器是已知模式,engram v2 是我们旧系统的迭代"。新的东西有四件:第一,据作者所知是对话记忆领域首个预注册非劣性检验,边际与主检验在任何留出集结果之前冻结(修正案虽在 Batch A 之后补充了 S7 等,但存证于任何 H1 结果之前)。第二,首次答案级、匹配上下文的类型化决策模型评估:Jev 与 gpt-4o-mini listwise 重排器非劣(S4,差 −0.4 分,下界 −2.0)而延迟约 1/3(273ms 对 816ms p50),与 MemReranker 的小重排器结论互证。第三,用比值 $G=(\mathrm{Acc}_J-\mathrm{Acc}_{\cos})/(\mathrm{Acc}_E-\mathrm{Acc}_{\cos})$ 量化出一次重排调用关闭了余弦检索与抽取之间 94% 的准确率差距,把抽象的"选择够不够"变成可比较的数字。第四,把选择上限分解为 shortlist 未命中(11.5%)与重排丢弃(9.2%)并按类别定位——时间证据最易被重排丢弃(22.7%)、开放域证据最难进候选(63.0%)——这是此前文献没有的诊断粒度。
实验结果
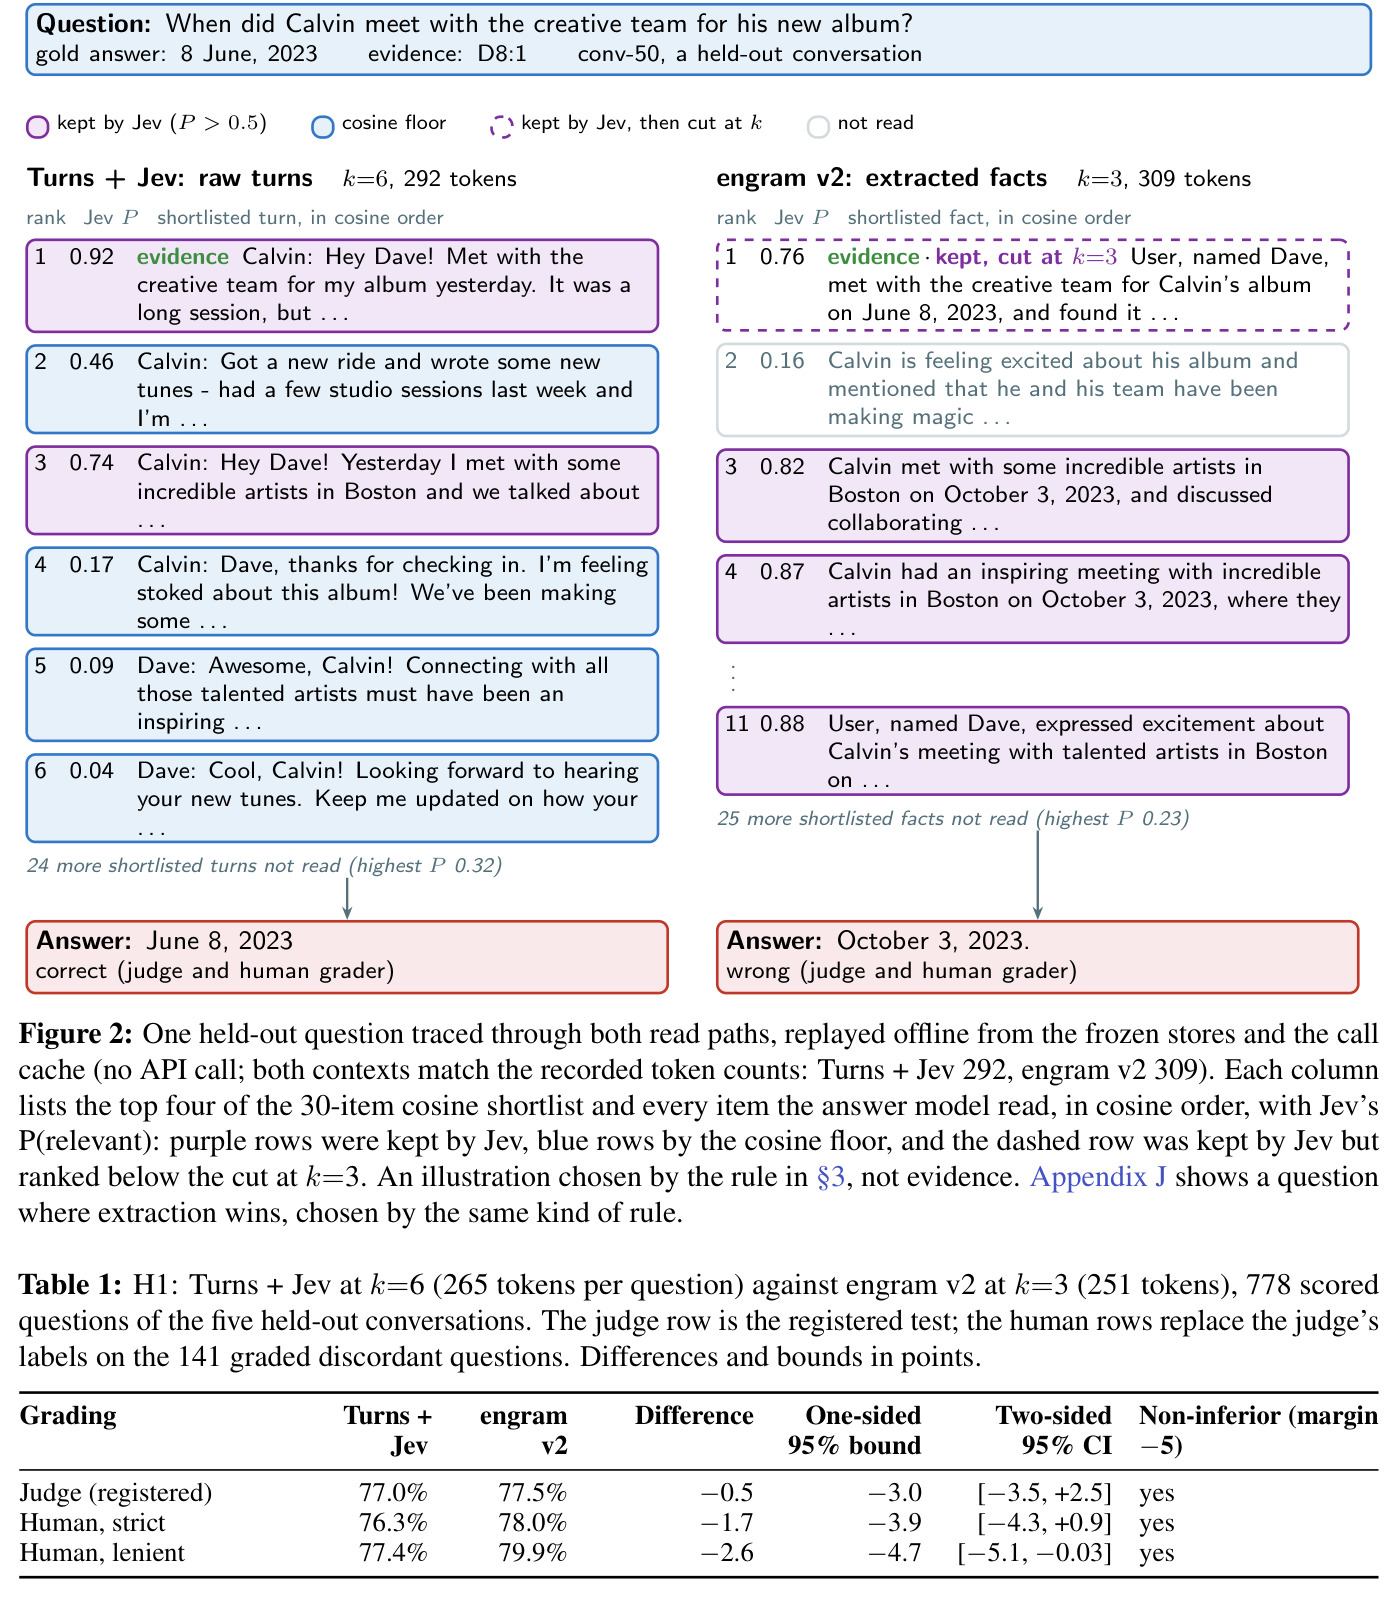
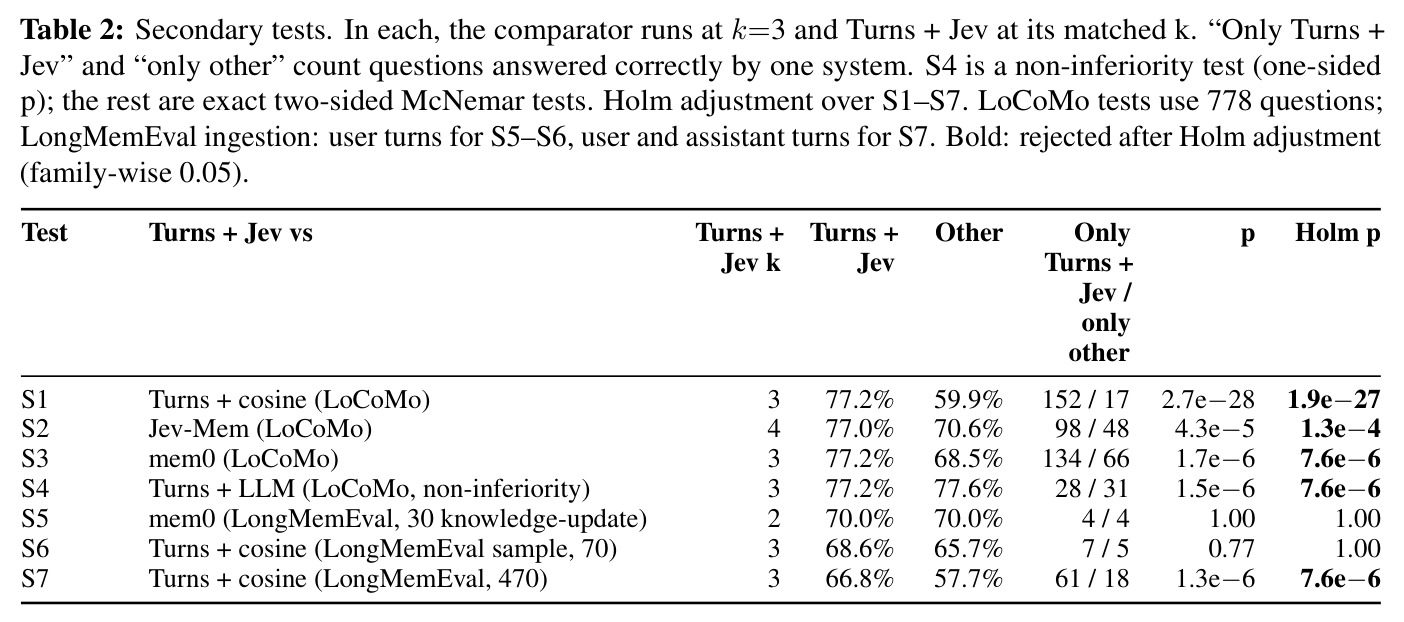
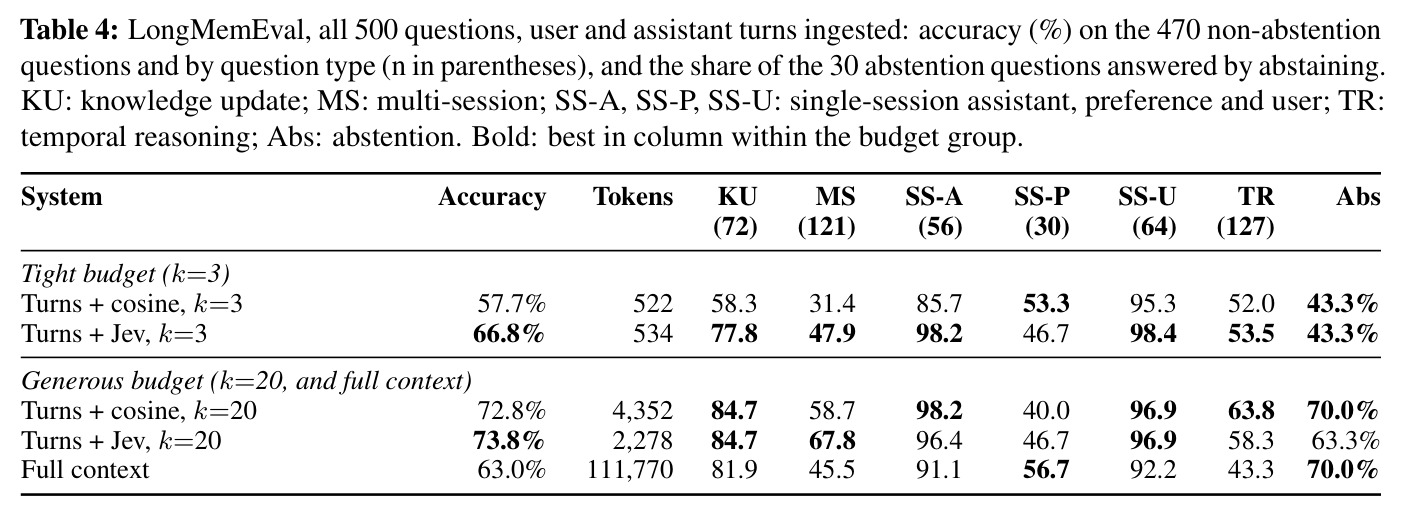
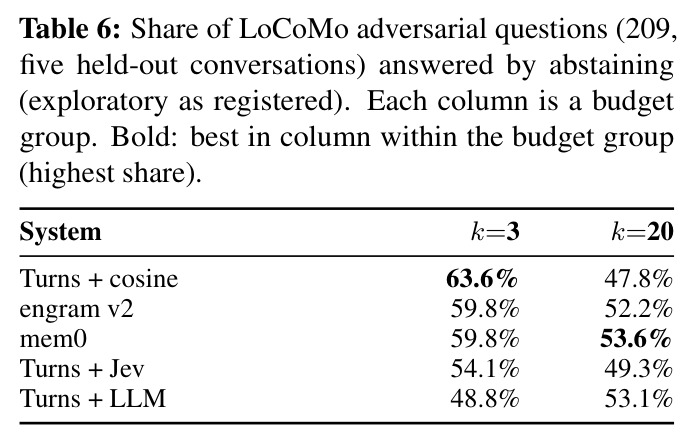
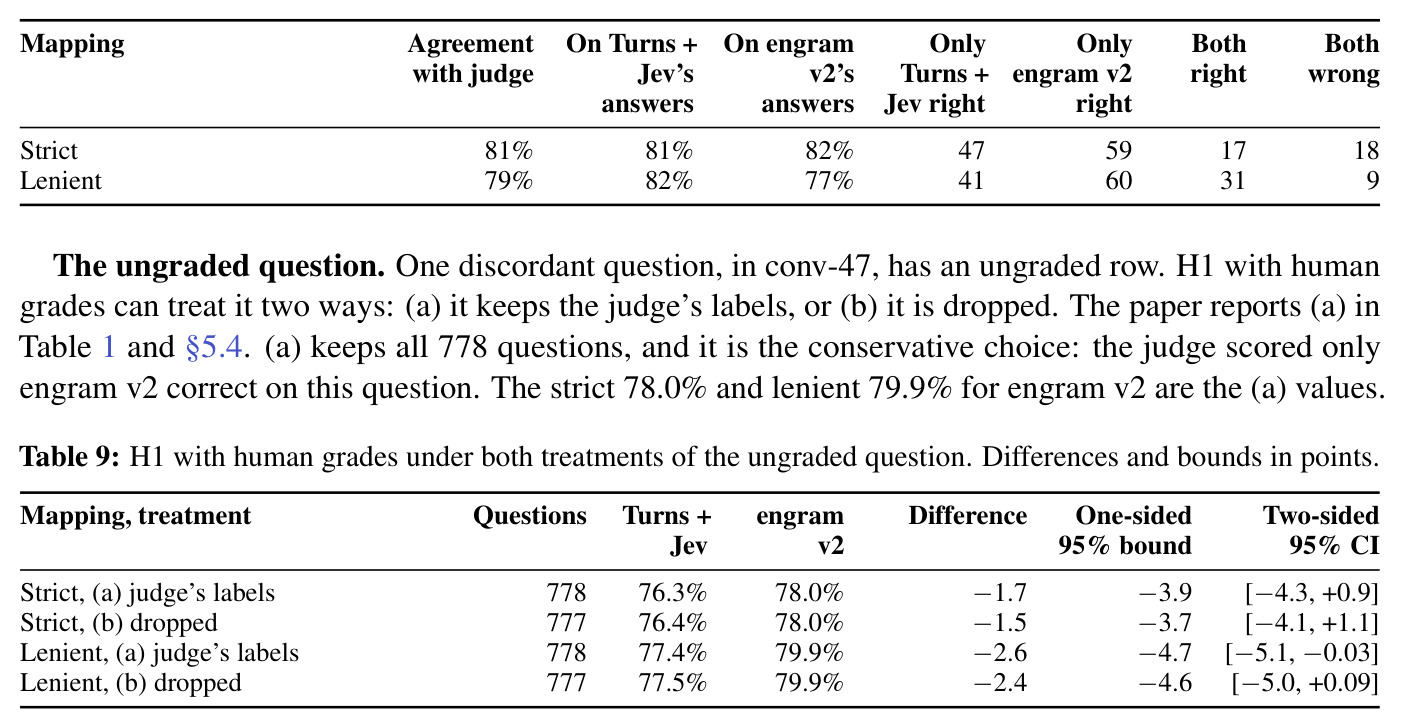
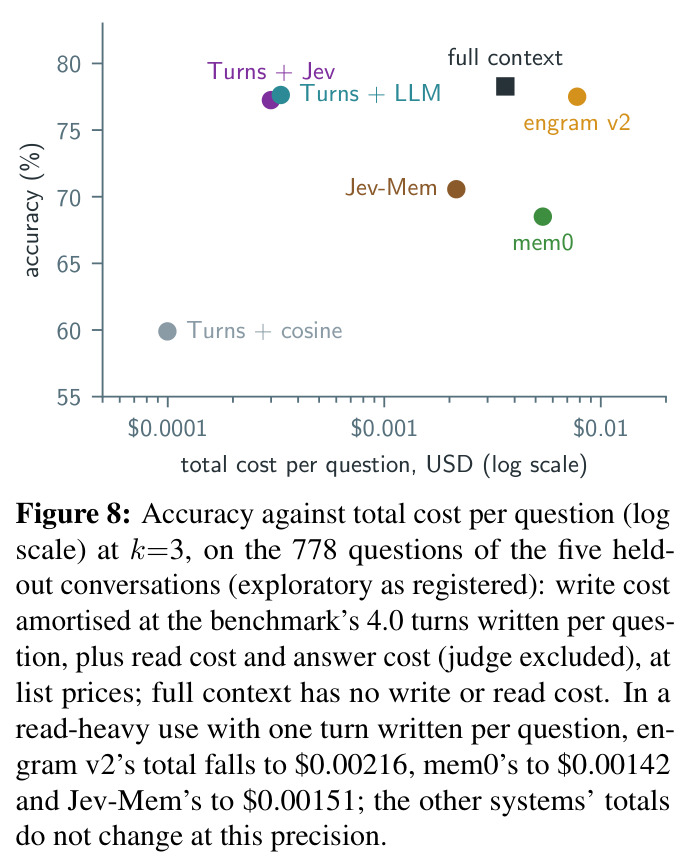
主检验 H1:匹配上下文(265 对 251 token)下,Turns + Jev 77.0% 对 engram v2 77.5%,差 −0.5 分,单侧 95% 下界 −3.0,高于注册的 −5 边际(单侧 p=0.0017),非劣性成立;此时抽取至多加 4.7 分(最严人审口径),写成本却是 3,061 倍($1.865 对 $0.00061/千轮),一次重排关闭了余弦到抽取 94% 的差距($G=0.94$)。盲评人审把差距挪到 −1.7(严格)至 −2.6(宽松),下界 −3.9 至 −4.7,所有口径下仍非劣;换 Llama 3.3 70B 作答差 −0.3、下界 −2.9,结论模型稳健。次级检验(Holm 后):S1 压倒余弦检索(77.2% 对 59.9%,+17.3 分);S2 胜 Jev-Mem(77.0% 对 70.6%);S3 胜 mem0(77.2% 对 68.5%);S4 对 LLM 重排器非劣(下界 −2.0)且读延迟 273ms 对 816ms;S7 在 LongMemEval 全集 470 题上胜余弦(66.8% 对 57.7%,+9.1 分)。中心发现——预算效应:重排增益从 k=3 的 +17.4(LoCoMo)/+9.1(LongMemEval)缩到 k=20 的 +1.5/+1.1;宽松预算下 engram v2 k=20 以 82.4%(1,238 token)成为全场最准,超过 Jev-Mem k=40 的 80.3% 和全上下文的 78.3%(23,631 token)。诊断:约 11.5% 的问题输在候选漏召、9.2% 输在重排丢弃;事后宽读路径(150 条候选、无阈值)达 81.5%@2,000 token,说明瓶颈在读路径而非原文存储。副作用:重排降低正确弃答,k=3 时对抗题弃答率从 63.6%(cosine)降到 54.1%(Jev)、48.8%(LLM 重排)。
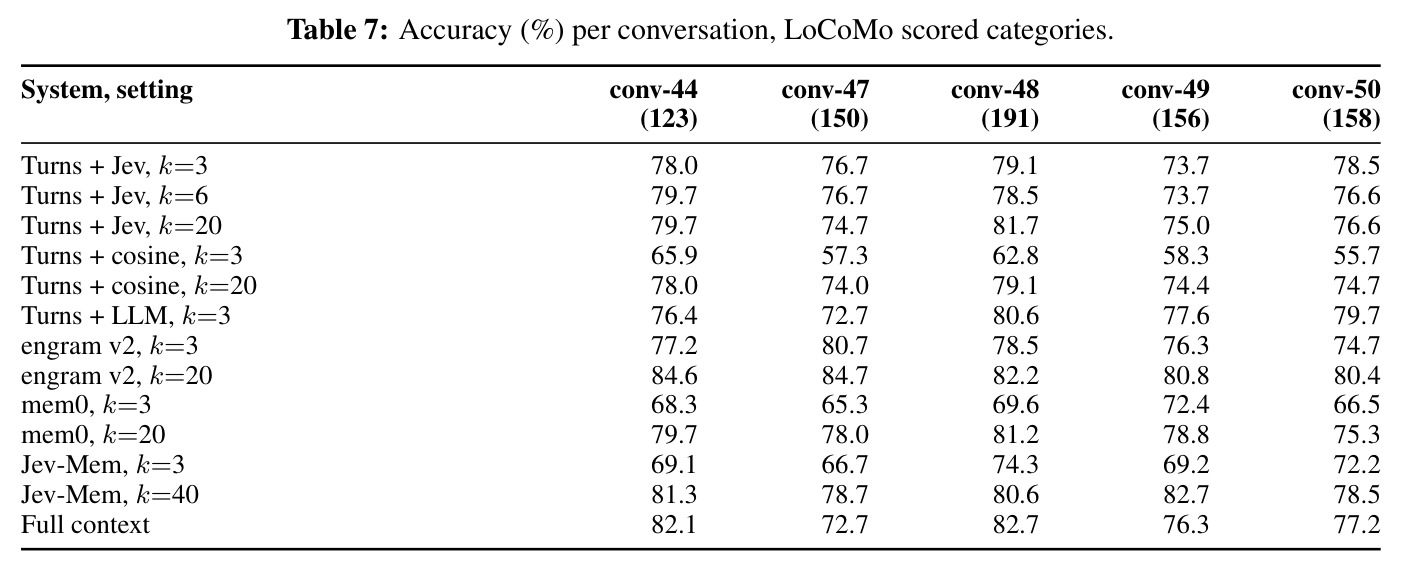
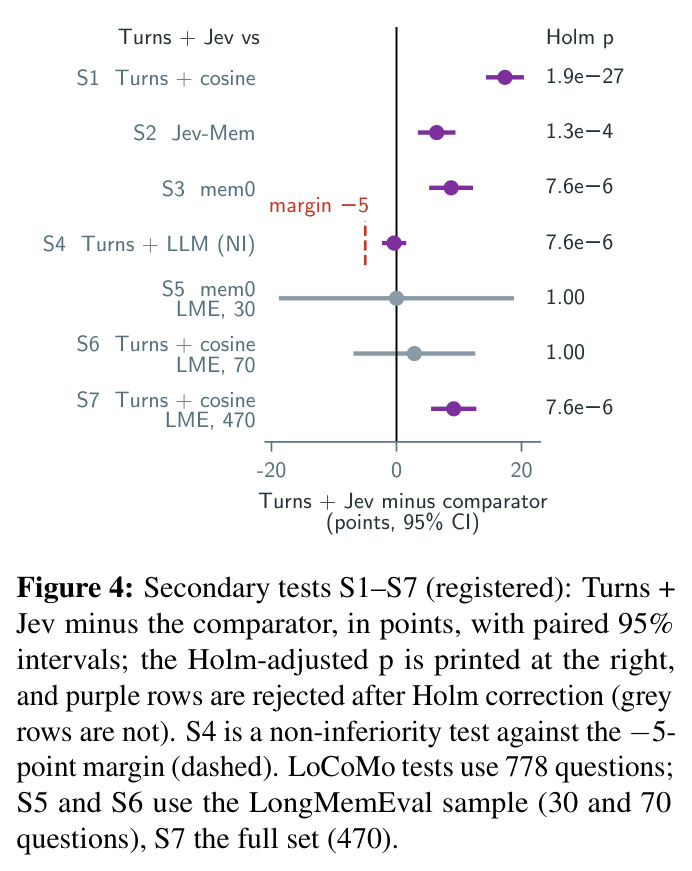
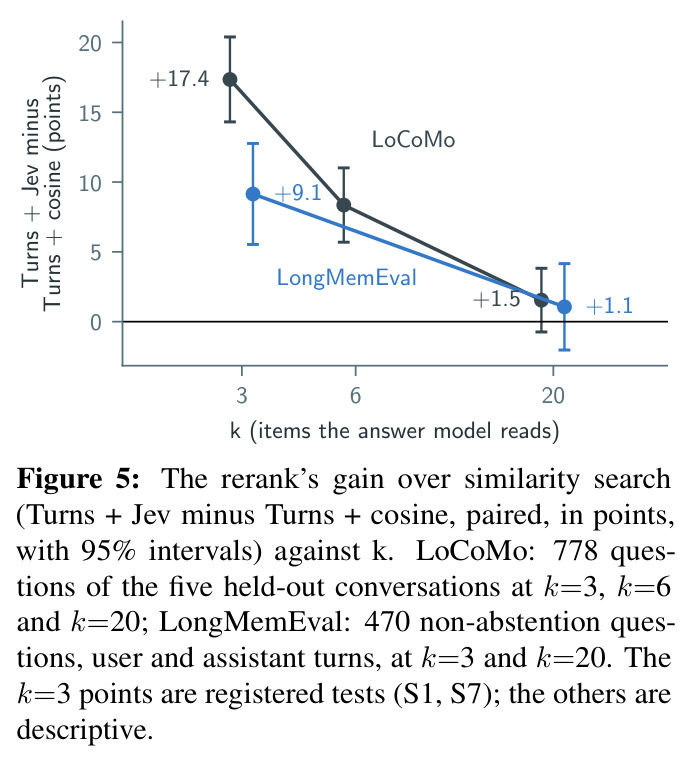
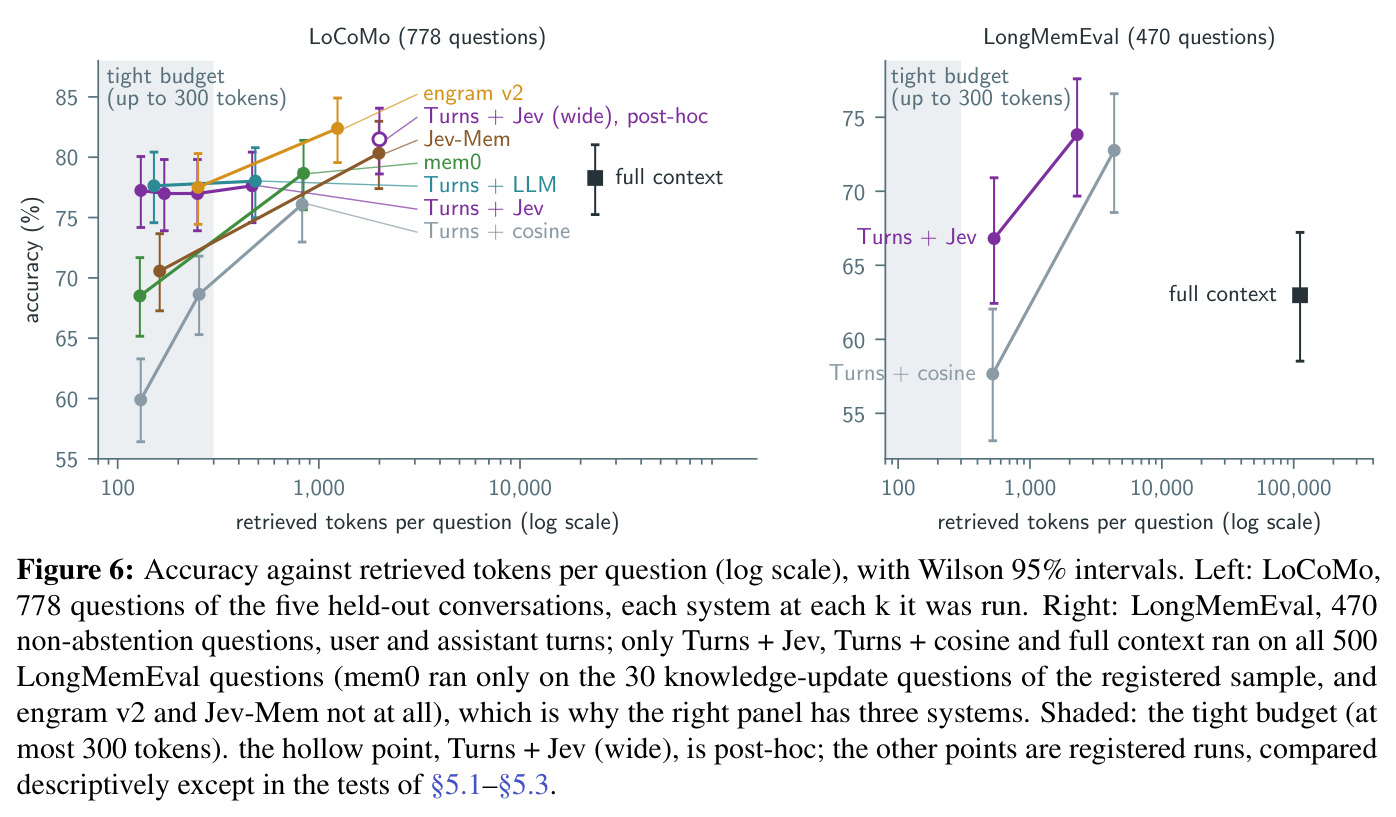
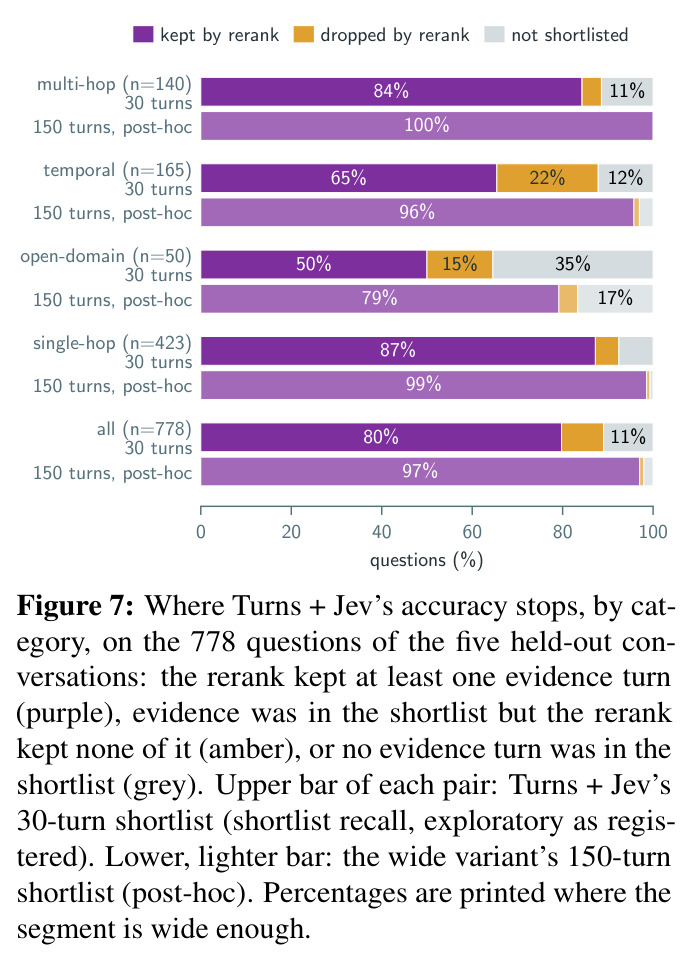
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| H1 主检验:LoCoMo 5 段留出对话 778 题,原文+Jev 对抽取式记忆(匹配上下文 265/251 token) | 判官评分准确率;非劣性(δ=5 分,单侧 95% 下界) | Turns + Jev 77.0%,差 −0.5 分,下界 −3.0,非劣成立(p=0.0017) | engram v2 77.5% | 准确率持平,写成本 $1.865 → $0.00061/千轮(3,061×),一次重排关闭差距的 94% |
| S1:LoCoMo 778 题,原文+Jev 对纯余弦检索 | 判官准确率(精确 McNemar,Holm 校正) | 77.2%(k=3,139 token) | Turns + cosine 59.9%(130 token) | +17.3 分(Holm p=1.9e−27,仅一方正确的题 152 对 17) |
| S2/S3:LoCoMo 778 题,对 Jev-Mem 图遍历与 mem0 2.1.0 | 判官准确率 | 77.0%(对 Jev-Mem);77.2%(对 mem0) | Jev-Mem 70.6%;mem0 68.5% | +6.4 与 +8.7 分(Holm p 分别为 1.3e−4 与 7.6e−6) |
| S4:LoCoMo 778 题,Jev 选择器对 gpt-4o-mini listwise 重排器 | 非劣性(δ=5)与读延迟 p50 | 77.2%,差 −0.4,下界 −2.0;读延迟 273ms,$0.00020/次 | Turns + LLM 77.6%;读延迟 816ms,$0.00023/次 | 非劣成立,延迟约 1/3,且远快于 Jev-Mem 的 1,329ms |
| S7:LongMemEval 全集 470 题(用户+助手轮入索引) | 判官准确率 | 66.8%(k=3,534 token) | Turns + cosine 57.7%(522 token) | +9.1 分(Holm p=7.6e−6);全上下文仅 63.0% 且读 209 倍 token |
| 预算扫描:重排增益随读取条目数 k 的变化(两基准) | $\Delta(k)=\mathrm{Acc}_J(k)-\mathrm{Acc}_{\cos}(k)$ | k=3:+17.4(LoCoMo)/+9.1(LongMemEval);k=20:+1.5/+1.1 | 同 k 的余弦检索 | 紧预算大幅领先、宽预算增益近消失,为 SmartSearch 与 Fidelity 的分歧给出预算解释 |
局限与改进
作者承认的局限:每个设置只有一个基准家族——LoCoMo 的对话本身是 LLM 生成的合成数据,且主数据只有 5 段对话、778 题,类别样本小(开放域仅 50 题);engram v2 未跑 LongMemEval,因此不能推断"原文在长历史上匹配抽取",只能支持较窄的 S7(重排胜余弦)与 S5(与 mem0 无差异,但 30 题不足以建立等效);盲评人由第一作者担任,而他正是被评系统的作者,部分分的映射未预指定(报了两种),只重评了判官分歧题,判官与判官一致的错误未被纠正;Jev 是封闭、版本化模型,结论仅限 jev-1.13.0;Turns + Jev 把原始用户轮直接喂给相关性问题,未测提示注入等对抗内容;绝对准确率在任何协议下都低于 SmartSearch 自报的 91.9%;所有设计选择在单段对话 conv-26 上做出。我的补充:k=20 的比较混淆了预算与读路径上限——阈值 0.5 加 10 条余弦底线使 Turns + Jev 只读 496 token(cosine 826),预算效应的陡峭度部分是实现伪影(wide 变体在 2,000 token 达 81.5% 即为佐证);判定 H1 的判官本身有约 19–21% 与人审不一致;对照只是作者自家的抽取系统,缺乏第三方抽取系统的非劣性证据。
独立分析的弱点
独立分析出三类弱点。第一,读路径设计造成"伪预算效应":保留 P>0.5 者加 10 条余弦底线的策略让 Turns + Jev 在 k=20 时常常填不满 20 个槽(只读 496 token),从而夸大了"宽预算下抽取反超"的陡峭度;事后 wide 变体(150 条候选、无阈值、按 Jev 分数取 top-k)在 2,000 token 拿到 81.5%,说明阈值与底线截断同时压低了召回和表面预算增益。改进方向是把 wide 读路径注册化并校准阈值,或直接采用置信度 top-k。第二,选择器对"只提供时间线索"的轮次系统性失明:22.7% 的时间证据明明在候选里却被重排丢弃,因为一个只说明"某事何时发生"的轮次单独看不像相关;同时貌似相关的上下文还会压低正确弃答率(63.6%→54.1%)。改进方向是在相关性问题中加入时间维度(如追加一问"这条是否标定事件时间?")、多问融合打分,以及弃答感知的上下文组装。第三,评估独立性不足:抽取对照是作者自己的 engram v2,LongMemEval 上完全没有抽取系统,盲评人又是系统作者,抽取消耗的 $4.12 调用还意外经 OpenRouter 被一半路由到 Azure(附录 G 事故)。改进方向是纳入第三方抽取系统、雇独立评审,并在隔离环境中钉住各服务的端点。
未来方向
作者提出的方向:把预算依赖解释(与 Kang 等的"保留还是压缩"结论互补)正式化为"何时选择替代抽取、何时压缩替代保留"的算子选择理论;在新数据上验证 wide 读路径假设——选择上限来自读路径而非原文存储(wide 变体 81.5%、全证据召回 91.9%、重排损失降到 0.9%);记忆基准应按系统报告判官–人一致性,因为判官宽松度与答案风格交互(本文中对 engram v2 答案的一致性 77% 对 Turns + Jev 的 82%,而 Fidelity 的严格判官无此效应)。基于本文成果可延伸:把附录 J 揭示的候选漏召与抽取互补起来——用抽取事实当"召回索引"、原文轮次当"阅读源"的混合存储,兼顾抽取改写带来的可检索性与原文保真;在真实(非合成)对话日志、多个答案模型家族上重复 H1;测对抗与提示注入下类型化选择器的稳健性(论文引了 Wu & Lim 2026 的 decision hijacking 攻击);训练开源的小型类型化判别模型替代封闭的 Jev,消除版本绑定并进一步压成本——S4 已证明单请求判别式重排可匹敌 LLM 重排,这是最自然的后续。
复现评估
复现条件在同类论文中属于极好。代码、预注册计划(Zenodo 10.5281/zenodo.22970745 与修正案 22977848)、逐题答案与判官标签、人审分数及评分密钥全部公开(github.com/ris3abh/Engram,tag v3-frozen / v3-amended / paper-v3-preprint-r3,结果在 bench/results/v3/ 与 v3_posthoc/)。所有表格和图可离线重建(paper_v3/make_numbers.py、figures.py 等,无 API 调用);图 2 与附录 J 的工作示例从冻结存储经只读调用缓存回放,缓存未命中即报错,保证无法偷调 API。算力需求极低:注册账本总计约 $31(OpenAI $23.16 + Jev $5.55 + OpenRouter $0.31 + mem0 经 OpenRouter $2.42),全程用 API 模型(gpt-4o-mini、text-embedding-3-small、jev-1.13.0、Llama 3.3 70B via OpenRouter),无需 GPU。难点:Jev 是封闭模型需申请访问;engram v2 与 Jev-Mem 是作者自建系统,完整复刻需读其代码库;mem0 2.1.0 有个坑——环境里存在 OpenRouter key 时会悄悄把 LLM 调用改道(附录 G),复现者必须钉住端点。总体难度中低,主要工作量在对齐 token 匹配规则与评委提示。
论文图表
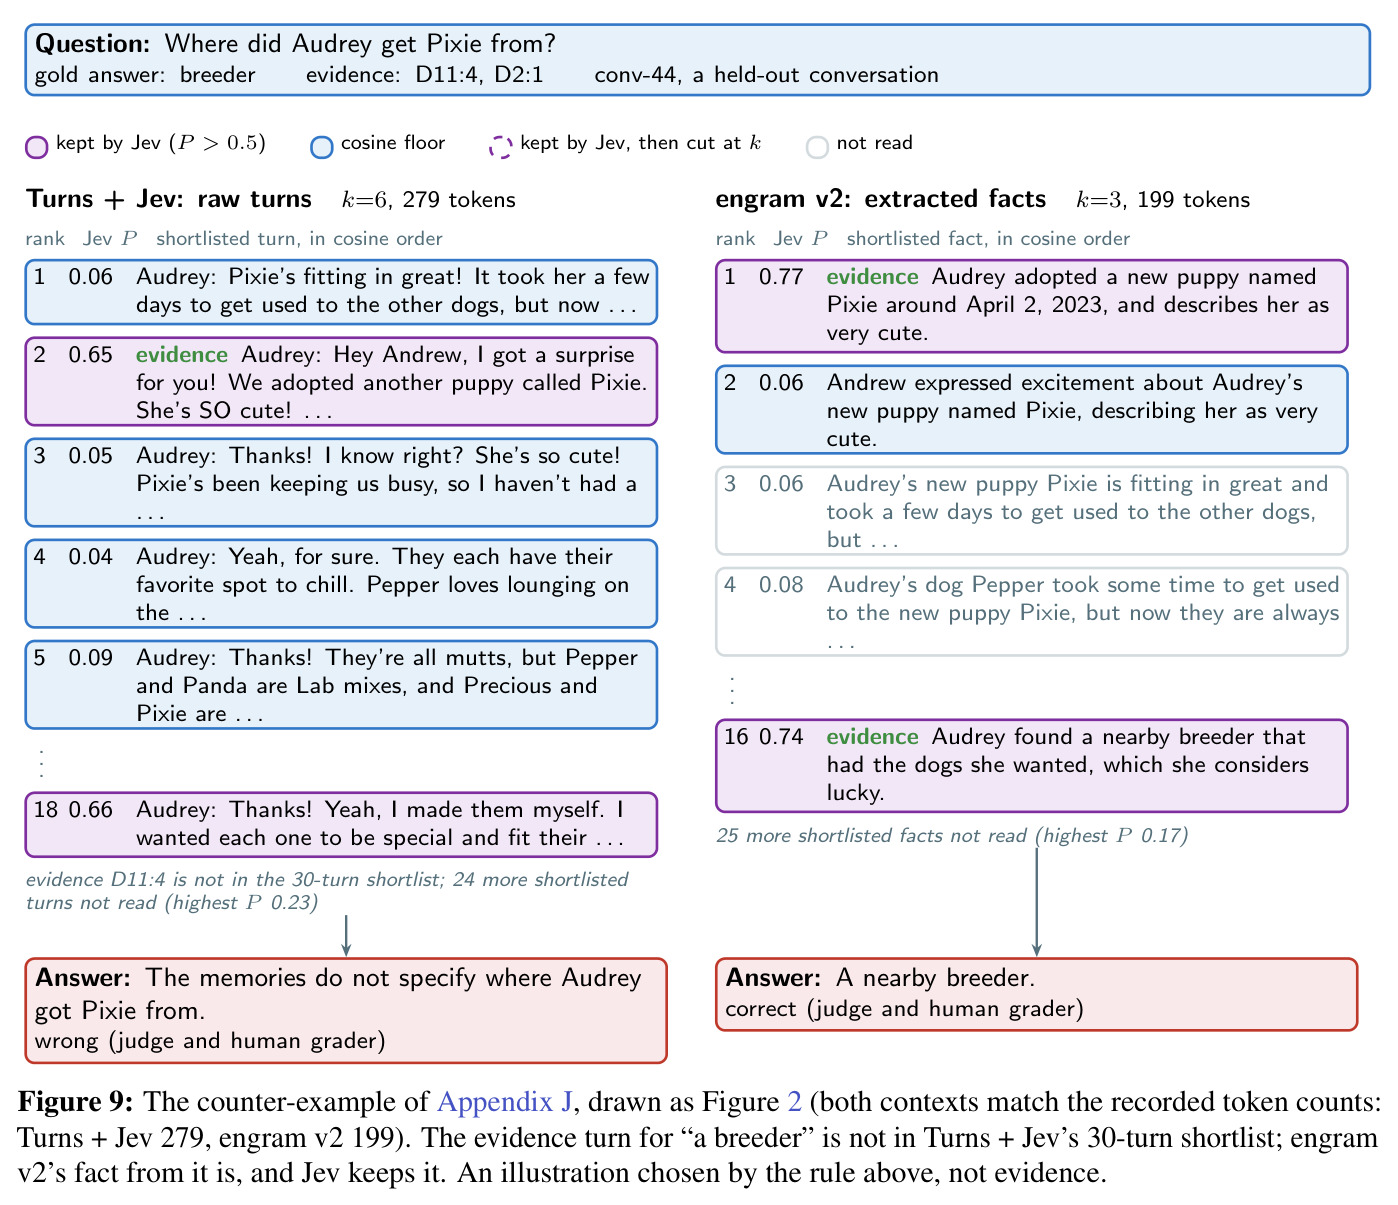
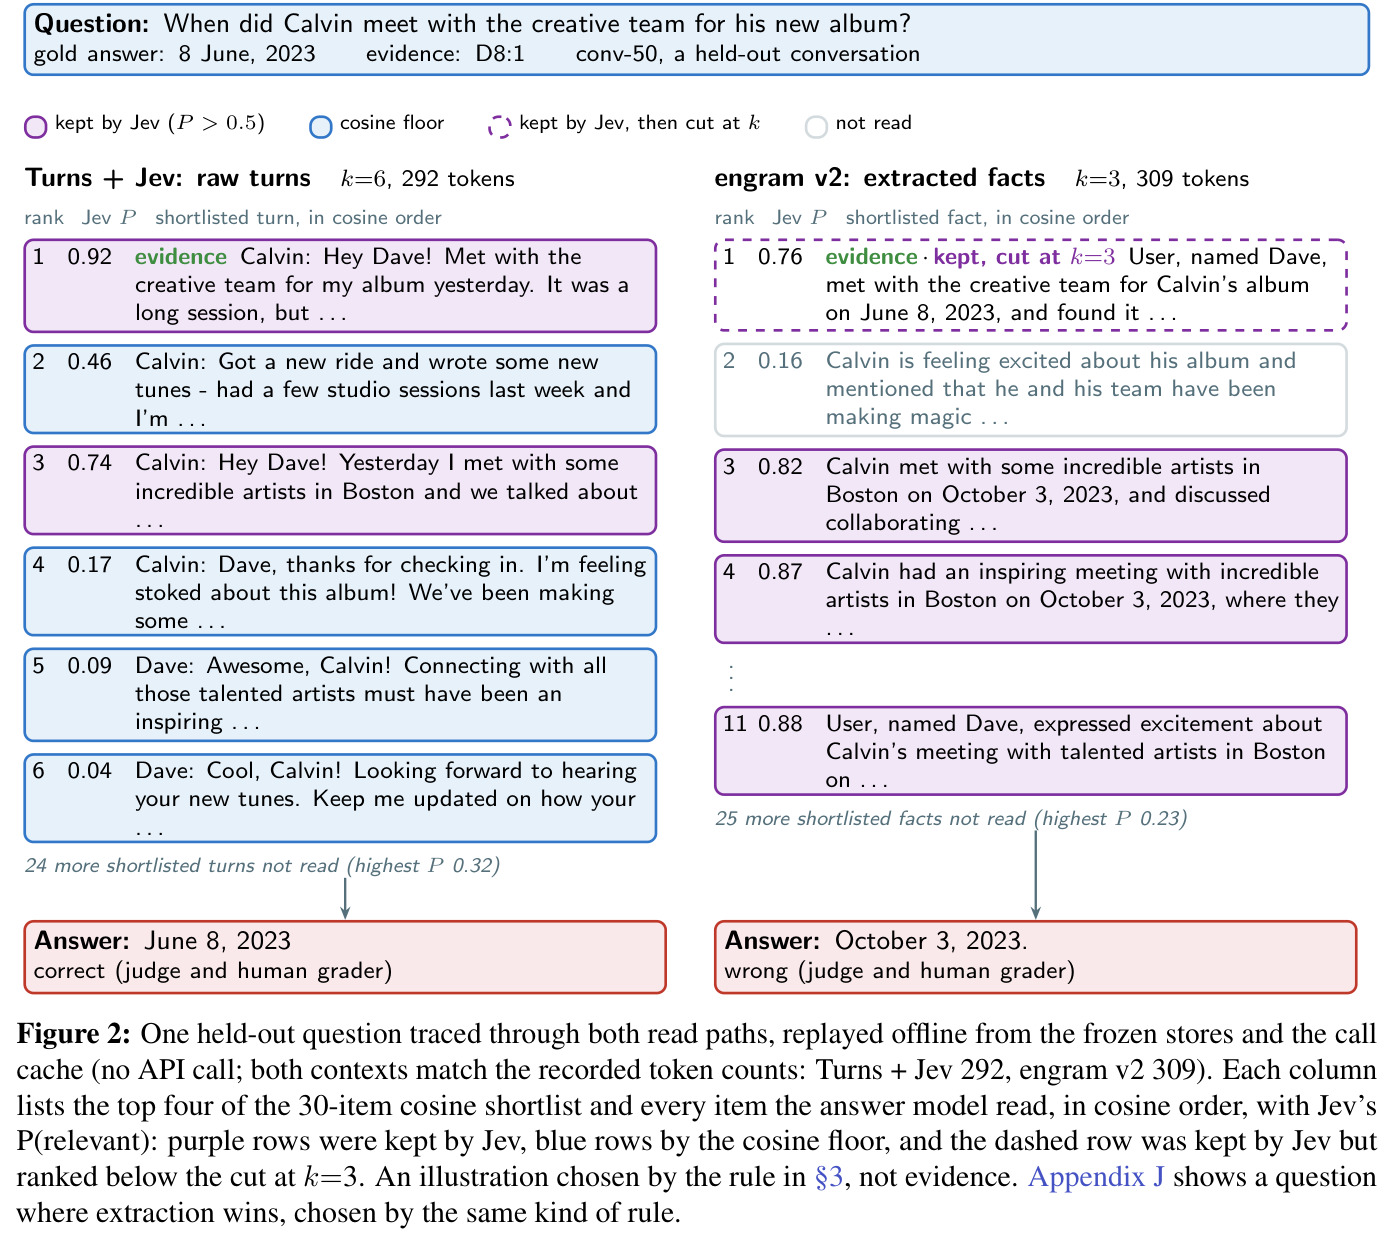
反向示例:问 Audrey 从哪得到 Pixie,金答案"育种者"所在的证据轮不含 Pixie 一词("在附近幸运地找到了有我想要的狗的育种者"),没进 Turns + Jev 的 30 条候选,于是答"记忆未说明";engram v2 抽取时把它改写成"Audrey 在附近找到育种者"这一可检索形式,排在事实候选第 16 位、被 Jev 保留(P=0.74)进入 k=3,答对。
诚实展示抽取的真正优势场景——改写提升可检索性(恰是 Figure 7 里候选漏召的补救),与 Figure 2 构成机制上的两面,防止读者把结论读成"抽取无用"。