MinkowskiPE:面向时空感知的闵可夫斯基位置编码 MinkowskiPE: Minkowski Positional Encoding for Spatiotemporal Perception
用闵可夫斯基几何参数化洛伦兹变换,实现平移不变的时空位置编码
前置知识
相对位置编码
让注意力得分中两个 token 的交互只依赖它们的相对位移 $\Delta x_{ij}=x_j-x_i$,而非绝对坐标。实现手段包括相对位置 embedding、可学习注意力偏置(如 T5 bias)、以及对 Q/K 特征做位置依赖的变换(如 RoPE 的旋转)。其数学等价性质是:对坐标做整体平移 $x_i\to x_i+a$、$x_j\to x_j+a$,得分不变。
MinkowskiPE 的设计目标就是满足式 (1) 的相对编码性质,全文的核心推导都围绕'如何让洛伦兹变换后的 Q/K 点积只依赖相对时空位移'展开,不理解这一点就看不懂为什么需要群同态条件。
缩放点积注意力与 Q/K 变换
注意力得分由 query 与 key 的内积 $\langle q_i,k_j\rangle$ 经缩放和 softmax 得到。位置编码可以在不打断这一接口的前提下作用:要么加性偏置到得分上,要么乘性地变换 $q_i$、$k_j$ 特征。保持标准点积形式意味着可以继续使用 FlashAttention 等高效实现。
本文强调 MinkowskiPE 保留标准点积注意力接口、兼容 FlashAttention,这是它相对很多加性偏置方法的工程卖点;理解 Q/K 上的乘性变换才能读懂式 (11)-(14) 的推导。
闵可夫斯基度规与洛伦兹变换
狭义相对论中时空事件写为 $x=(t,r)\in\mathbb{R}^{1+d}$,其度规是不定的对角矩阵 $\eta=\mathrm{diag}(-1,+1,\cdots,+1)$,时空间隔为 $-\Delta t^2+\|\Delta r\|^2$。保该双线性型的变换叫洛伦兹变换,满足 $\Lambda^\top\eta\Lambda=\eta$,等价于 $\Lambda^\top\eta=\eta\Lambda^{-1}$。最简单的是 $(1+1)$ 维 boost:$\Lambda(\rho)=\begin{pmatrix}\cosh\rho&\sinh\rho\\\sinh\rho&\cosh\rho\end{pmatrix}$。
论文的全部代数构造建立在这两条洛伦兹恒等式上:度规 $\eta$ 的符号区分让时间和空间获得不同几何角色,而 $\Lambda^\top\eta=\eta\Lambda^{-1}$ 正是'各 token 按自身坐标变换、成对得分却只依赖相对位移'的关键。
单参数子群与群同态
若映射 $\Lambda$ 满足 $\Lambda(x_1+x_2)=\Lambda(x_1)\Lambda(x_2)$ 且 $\Lambda(0)=I$,则它是从加法群到变换群的同态,像构成单参数子群,且 $\Lambda(x_i)^{-1}\Lambda(x_j)=\Lambda(x_j-x_i)$。对洛伦兹群而言,多维坐标的一般同态要求各方向生成元相互对易,光滑解基本被限制在一维 boost 的标量参数化上。
这是 MinkowskiPE 只用标量投影 $\rho_i=w^\top x_i$ 而非整个坐标向量的理论原因:附录 A 证明了 2D 洛伦兹特征块上任何光滑同态都归结为这种单参数形式,理解它才能明白方法的表达力边界在哪。
研究动机
现有时空建模方法分两条路线,各有硬伤。物理驱动路线把时间建模视为动力系统演化:循环与卷积传播(ConvLSTM、PredRNN 系列)、微分方程参数化的连续时间演化(NeuralMD 的 ODE/SDE 形式),以及哈密顿动力学、图模拟、扩散分子动力学(BioMD)等更强物理先验。这类方法归纳偏置强,但规定的传播机制限制了模型从数据中学习时空依赖的灵活性。学习驱动路线以 Transformer 为主:分解式时空注意力(SimVP、TAU)、多尺度注意力、轨迹感知注意力等更灵活,但时间坐标与空间坐标的耦合关系隐含在学到的注意力权重里,缺乏显式几何结构。具体到任务:分子动力学中每个原子状态关联时间步与三维空间位置,视频中每个图像块关联帧号与帧内二维位置,两者本质上都是带时空坐标的观测集合,需要显式刻画时空耦合,现有位置编码却往往把时间和空间拆开处理或完全隐式建模,留下'物理结构 vs 数据灵活'的两难。
本文的目标是论文的目标是设计一种时空耦合范式,同时具备数据驱动的灵活性与显式几何先验。具体要求有三:(1) 位置信息只通过两个 token 之间的相对时空位移 $\Delta x_{ij}=x_j-x_i$ 进入注意力得分,对坐标整体平移不变;(2) 保留标准点积注意力接口,兼容 FlashAttention 等高效实现,即插即用、不改动任务特定架构;(3) 同一编码公式能跨物理尺度和模态通用——从微观的分子动力学(原子在三维空间随时间运动)到宏观的视频预测(二维图像平面上的场景演化),用统一的'事件'视角统一两类 token。作者计划用 MISATO 蛋白质-配体结合动力学(单轨迹 10 个体系 + 多轨迹 3 个规模)和 KTH 人体动作视频预测(OpenSTL 协议)两个基准来检验该目标,并在两个任务上做受控消融以分离位置编码本身的贡献。
与已有工作不同的是,本文的独特切入是把闵可夫斯基几何用作表示层面的归纳偏置,而非假设数据服从相对论动力学。与已有位置编码相比:RoPE 类方法在欧氏坐标上做正交旋转;视觉多维位置编码(iRPE 等)处理欧氏相对位移;近期时空位置编码仍基于欧氏几何;双曲变换只用于一维位置。MinkowskiPE 首次把时间与空间放进同一坐标系但赋予不同几何角色——不定度规 $\eta=\mathrm{diag}(-1,+1,\cdots,+1)$ 使时间方向以相反符号进入二次型 $-\Delta t^2+\|\Delta r\|^2$,再用洛伦兹变换 $\Lambda^\top\eta\Lambda=\eta$ 参数化 Q/K 特征变换。事件坐标本身不被变换,而是作为变换的参数,这使闵可夫斯基结构成为纯表示偏置。这一角度精确填补了'物理先验过强'与'时空耦合隐式'之间的空档:先验只作用于位置表示,不规定动力学规律。
核心方法
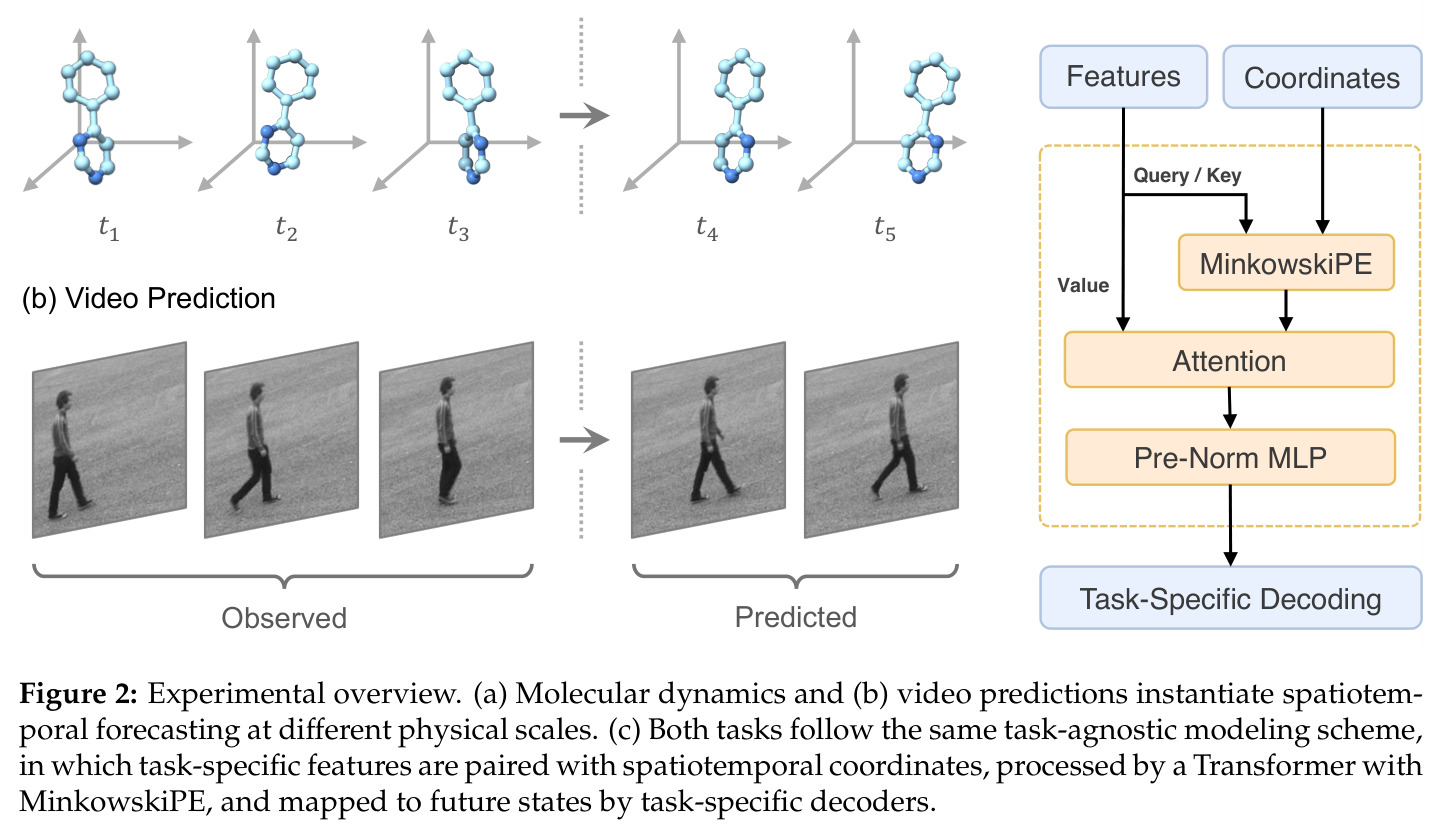
直觉上,MinkowskiPE 把每个 token 视为时空中的一个事件:坐标 $x_i=(t_i,r_i)$,$t_i$ 是时间分量、$r_i$ 是空间分量。技术路线分四步:先把 $D=1+d$ 维坐标经可学习线性投影压缩为标量 $\rho_i=w^\top x_i$,使 $\rho_j-\rho_i=w^\top\Delta x_{ij}$ 只含相对位移;再用 $(1+1)$ 维洛伦兹 boost $\Lambda(\rho)=\begin{pmatrix}\cosh\rho&\sinh\rho\\\sinh\rho&\cosh\rho\end{pmatrix}$ 变换二维 Q/K 特征块;然后利用洛伦兹恒等式 $\Lambda^\top\eta=\eta\Lambda^{-1}$($\eta=\mathrm{diag}(-1,1)$),编码后得分 $\tilde q_i^\top\tilde k_j=q_i^\top\eta\Lambda(w^\top\Delta x_{ij})k_j$ 自动只依赖相对位移;最后扩展到多头——把 $d_h$ 维头特征切成 $P=d_h/2$ 个二维块,各块用共享投影矩阵 $W\in\mathbb{R}^{D\times P}$ 的对应列。实现只需逐元素 cosh/sinh,保持标准点积接口,可直接套用 FlashAttention。
核心创新是用洛伦兹群的代数结构构造平移不变的相对时空位置交互。两个关键要素:一是群同态条件 $\Lambda(x_1+x_2)=\Lambda(x_1)\Lambda(x_2)$、$\Lambda(0)=I$,保证 $\Lambda(x_i)^{-1}\Lambda(x_j)=\Lambda(x_j-x_i)$;二是洛伦兹条件 $\Lambda^\top\eta=\eta\Lambda^{-1}$。二者结合使每个 token 虽按自身事件坐标各自变换 Q/K 特征,成对得分的位置贡献却只依赖 $\Delta x_{ij}$。与 RoPE 的本质区别在几何群:RoPE 用正交群的欧氏旋转,时间空间要么拆开要么同质;MinkowskiPE 用不定度规洛伦兹群的 boost,时间与空间在同一变换中但度规符号相反,天然区分'时间像'与'空间像'方向。与加性注意力偏置的区别在于位置信息经乘性特征变换进入而非加在得分上。附录 A 还证明:对 2D 洛伦兹特征块,任何从加法群到 $\mathrm{SO}^+(1,1)$ 的光滑同态都归结为标量投影单参数形式,说明该构造是受约束下的自然解而非随意选择。
方法步骤详情
第一步,事件化 token。分子动力学:每个配体原子在每个观测时间步是坐标为 $(t,x,y,z)$ 的事件 token,特征编码分子身份与运动信息,蛋白质作为静态残基级上下文;每个 Transformer 块先做配体到蛋白质残基的逐帧交叉注意力,再做配体事件 token 的全局自注意力。视频:卷积编码器把每帧编码为 16×16 潜网格,每个格点是坐标 $(t,u,v)$ 的事件 token。第二步,坐标投影:$x_i\in\mathbb{R}^D$ 经共享矩阵 $W=[w_1,\cdots,w_P]\in\mathbb{R}^{D\times P}$ 得到 $\rho_i=W^\top x_i\in\mathbb{R}^P$,$P=d_h/2$,$W$ 跨所有层和头共享,且 $\rho_{j,p}-\rho_{i,p}=w_p^\top\Delta x_{ij}$。第三步,洛伦兹变换:每个二维块做 $\tilde q_i=\Lambda(\rho_i)q_i$、$\tilde k_i=\eta\Lambda(\rho_i)k_i$,元素级实现为相邻分量配对乘 $\cosh\rho_{i,p}$、交叉乘 $\sinh\rho_{i,p}$(式 14)。第四步,标准注意力:变换后 Q/K 做点积、缩放、softmax,得分自动等于 $q_i^\top\eta\Lambda(w_p^\top\Delta x_{ij})k_p$。第五步,任务解码:MD 中最后一观测帧的配体原子表示经 MLP 预测未来 20 帧位移;视频中未来潜特征重排后经卷积解码器重建未来帧。
技术新颖性
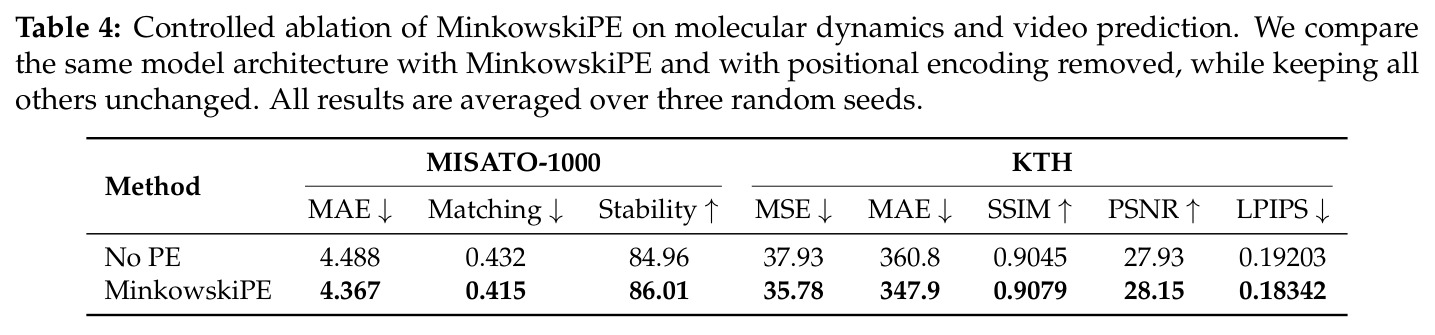
技术新颖性体现在四个层面。(1) 几何选择:首次用闵可夫斯基不定度规(而非欧氏或双曲度规)统一时空坐标,时间与空间以相反符号进入二次型,且只把该几何用作表示偏置而不要求动力学满足洛伦兹对称性。(2) 构造方式:位置信息经坐标参数化的洛伦兹变换乘性地作用于 Q/K 特征,与相对 embedding、加性 bias、欧氏旋转均不同;度规因子 $\eta$ 放在 key 侧使欧氏点积自动实现闵可夫斯基双线性交互(式 12)。(3) 理论刻画:证明平移不变性的充分条件是群同态,并证明交换生成元约束下 2D 洛伦兹块的光滑同态必为标量投影形式(附录 A);附录 C 进一步证明有限维酉逐 token 变换下精确 Galilean 不变会丢失 Galilean 不变的空间分量,指出这类构造的非平凡障碍。(4) 工程兼容与可验证性:不改注意力核、兼容 FlashAttention;表 4 受控消融显示仅移除该编码,MISATO-1000 的 MAE 从 4.367 恶化到 4.488、KTH 的 MSE 从 35.78 恶化到 37.93,证明增益确实来自位置几何本身而非任务架构。
实验结果
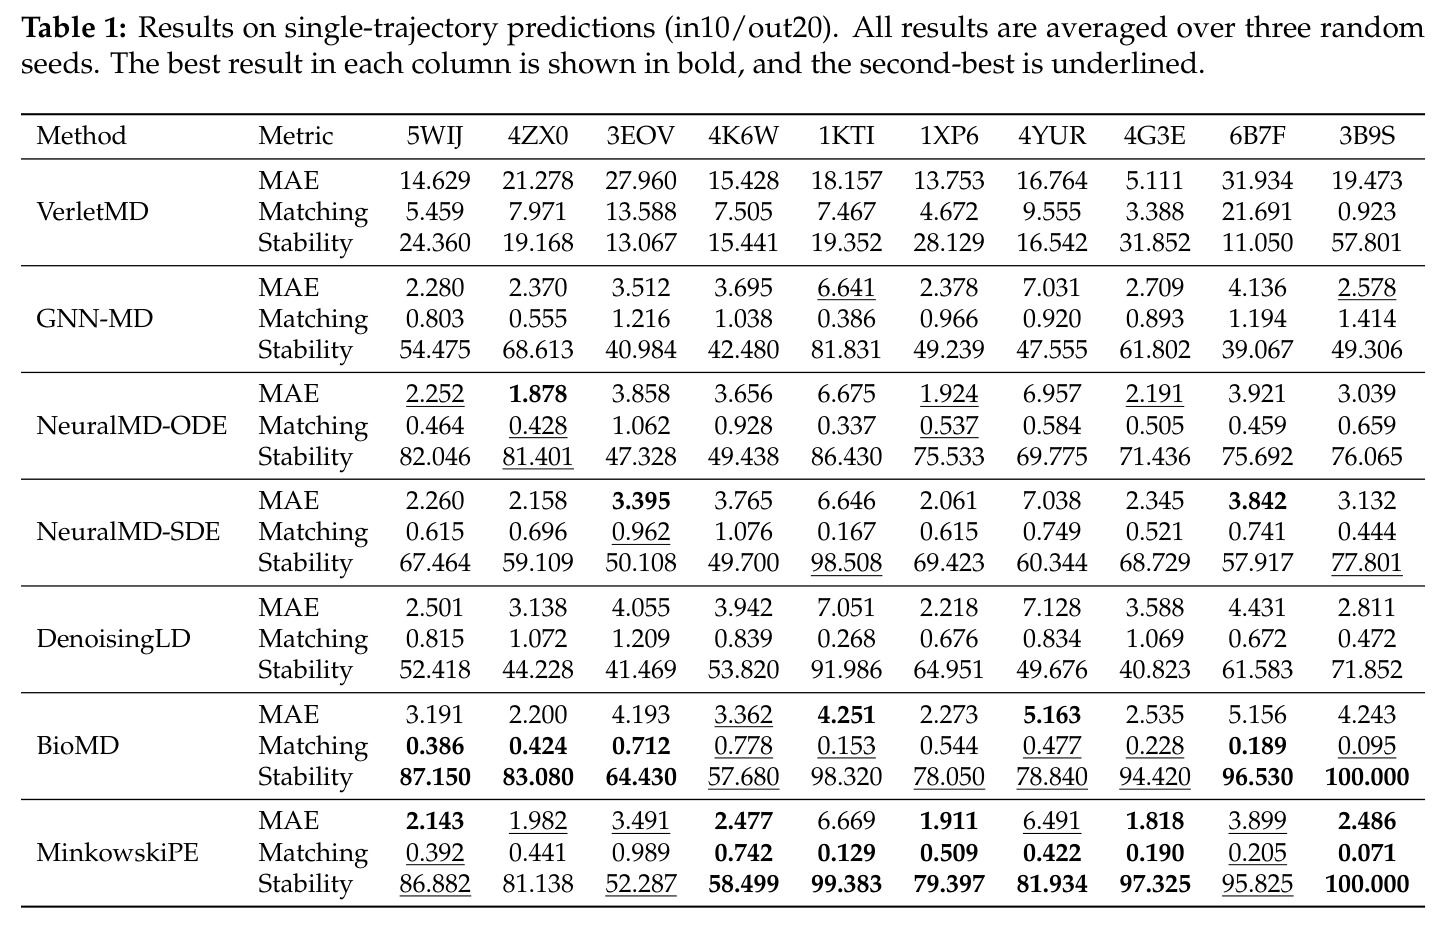
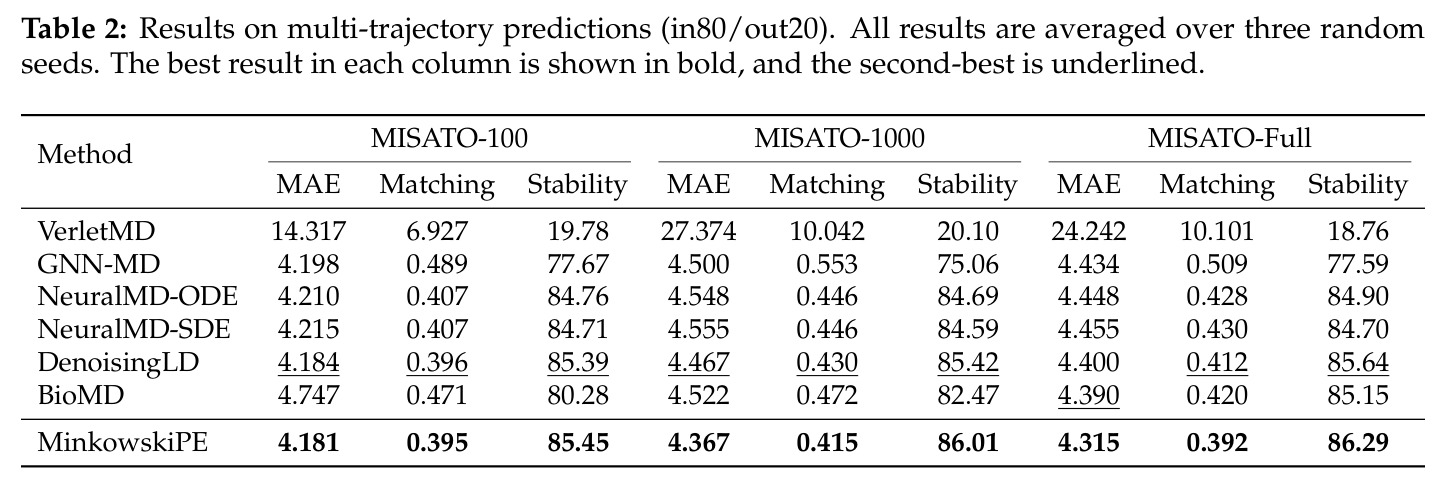
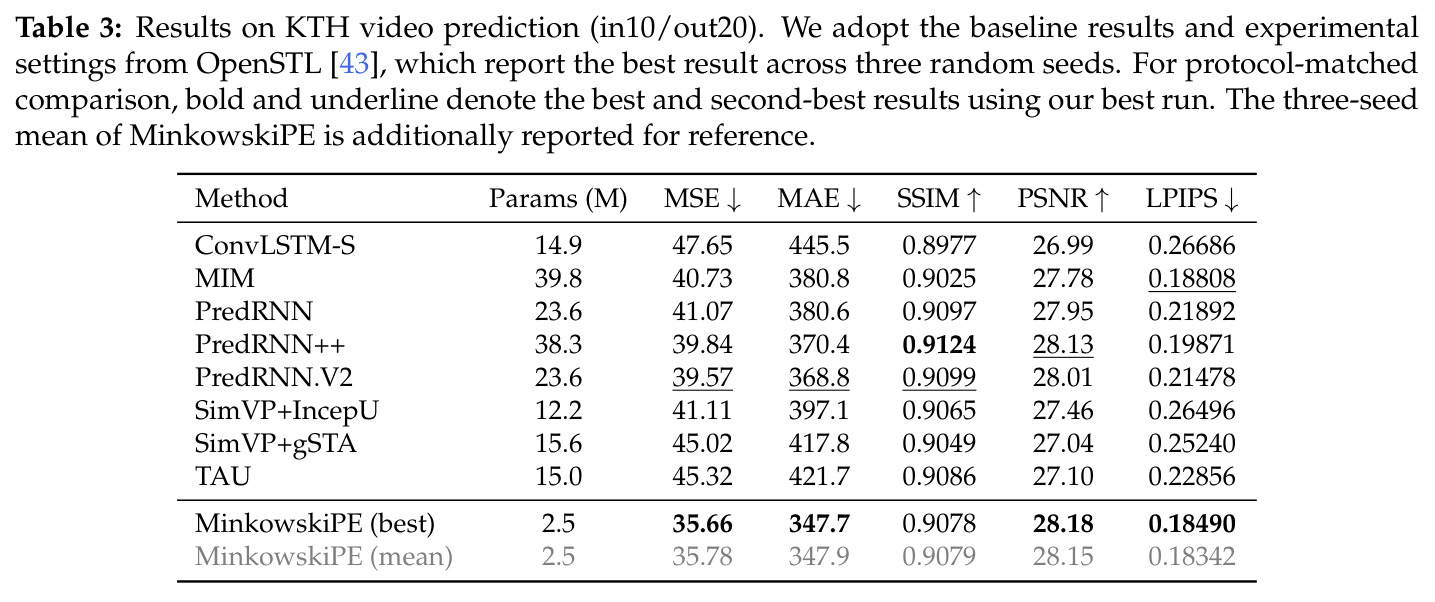
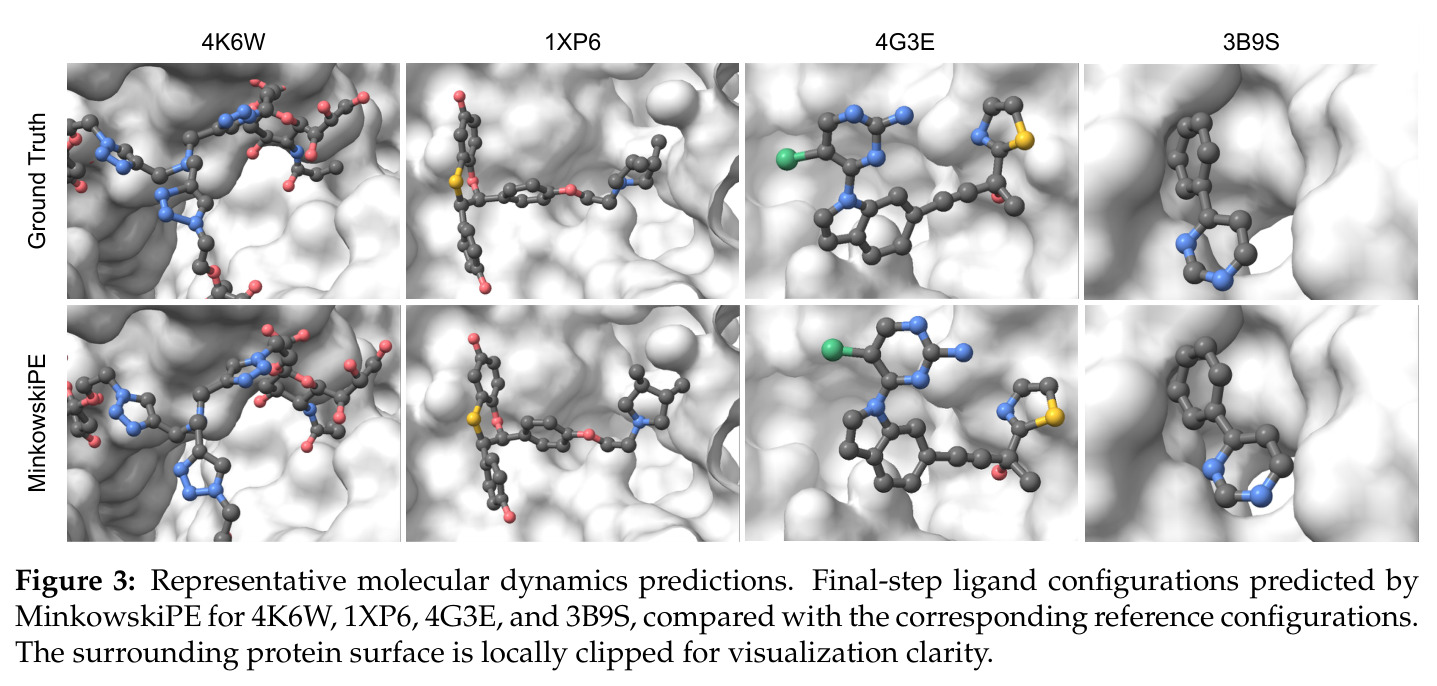
三组实验结果如下。(1) 分子动力学单轨迹(MISATO,10 个体系,10 帧预测 20 帧,对比 VerletMD、GNN-MD、NeuralMD-ODE/SDE、DenoisingLD、BioMD):MAE/Matching/Stability 共 30 项评估中 17 项最优、26 项前二,并在 4K6W、1XP6、4G3E、3B9S 四个体系上三项全最优(如 3B9S Matching 0.071 优于 BioMD 的 0.095,Stability 100.000)。(2) 多轨迹(MISATO-100/1000/Full,80 帧预测 20 帧):9 项评估全部最优,如 MISATO-1000 上 MAE 4.367 对最强基线 DenoisingLD 的 4.467、Stability 86.01 对 85.39,且数据规模增大时优势保持。(3) KTH 视频预测(OpenSTL 协议,128×128,10→20 帧):仅 2.5M 参数取得 MSE 35.66、MAE 347.7、SSIM 0.9078、PSNR 28.18、LPIPS 0.18490,五项中四项最优,对逐指标最强基线分别降 MSE 9.9%、MAE 5.7%、LPIPS 1.7%,参数量约为最低 MSE 基线 PredRNN.V2(39.57、23.6M)的十分之一,三种子均值 35.78 仍优于全部基线。(4) 消融:移除 MinkowskiPE 后 MISATO-1000 的 MAE 恶化 2.7%、Matching 3.9%、Stability 降 1.2%;KTH 的 MSE 恶化 5.7%、MAE 3.6%、LPIPS 恶化 4.5%,证明增益跨两个时空域且归因于位置编码本身。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 分子动力学单轨迹预测(MISATO 10 体系,in10/out20) | MAE / Matching / Stability,共 30 项评估 | 17 项最优、26 项前二;4K6W/1XP6/4G3E/3B9S 三指标全最优(3B9S Matching 0.071、Stability 100.000) | VerletMD、GNN-MD、NeuralMD-ODE/SDE、DenoisingLD、BioMD(最优单项如 NeuralMD-ODE 的 4ZX0 MAE 1.878) | 30 项中 17 项第一,Structural 指标(Matching/Stability)优势尤其明显 |
| 分子动力学多轨迹预测(MISATO-100/1000/Full,in80/out20) | MAE ↓ / Matching ↓ / Stability ↑(9 项) | 全部 9 项最优:MISATO-1000 MAE 4.367、Matching 0.415、Stability 86.01 | DenoisingLD(MISATO-1000:MAE 4.467、Matching 0.430、Stability 85.42) | MAE 降低约 2.2%,且随训练轨迹规模增大优势保持 |
| KTH 视频预测(OpenSTL 协议,in10/out20,128×128) | MSE ↓(另 MAE/SSIM/PSNR/LPIPS) | 35.66(best,2.5M 参数),三种子均值 35.78 | PredRNN.V2 39.57(23.6M 参数,最低 MSE 基线) | MSE 降 9.9%、MAE 降 5.7%、LPIPS 降 1.7%,参数量约 1/10 |
| 受控消融(同架构,仅去掉 MinkowskiPE) | MISATO-1000 三指标 + KTH 五指标 | KTH MSE 35.78、LPIPS 0.18342;MISATO-1000 MAE 4.367 | No PE:KTH MSE 37.93、LPIPS 0.19203;MISATO-1000 MAE 4.488 | MSE 改善 5.7%、MAE 3.6%、LPIPS 4.5%;MD 侧 MAE 2.7%、Matching 3.9%、Stability 1.2% |
局限与改进
作者承认的局限:一是几何偏置固定而非从数据学习,不同应用可能需要不同的几何归纳偏置;二是当前构造依赖学习的标量投影加单参数洛伦兹变换,更一般的多参数构造要求各坐标方向的洛伦兹生成元相互对易,约束很强、表达力受限(附录 A);三是实验只覆盖分子与视觉两类预测任务,具身动力学、天气预报、生成模型等待验证。我的补充观察:(1) 单轨迹设定并非全面领先,如 4ZX0 的 MAE 1.982 略逊于 NeuralMD-ODE 的 1.878、6B7F 的 3.899 逊于 NeuralMD-SDE 的 3.842,说明闵可夫斯基先验在部分体系上不占优;(2) 投影矩阵 W 跨所有层和头共享,虽然省参数,但也剥夺了不同层学习不同时空权衡的自由度,作者未做共享 vs 每层独立的消融;(3) KTH 对比采用 OpenSTL 的基线报告值,骨干架构与本文 8 层卷积编解码 Transformer 不同,比较并非严格同构;(4) 论文未讨论 $\cosh\rho$ 在大位移/长序列下的数值溢出风险及训练开销对比。
独立分析的弱点
弱点一:标量投影 $\rho_i=w^\top x_i$ 把 $D$ 维时空坐标压缩为单一标量参数,每个二维特征块只能感知相对位移在单一学习方向上的投影,时间-空间的混合比例完全由 $w$ 的方向决定。改进方向:在对易生成元约束内构造结构化多参数方案,例如混合 boost 与平面内旋转的可交换组合,或对不同特征块强制不同的时间/空间纯方向。弱点二:数值稳定性,$\cosh\rho$ 随 $|\rho|$ 指数增长,长序列或坐标尺度大时可能溢出,论文未给出限幅或归一化策略,可直接引入 $\rho$ 的 soft-clamp 或对坐标做可学习缩放。弱点三:验证范围窄,KTH 场景简单(单色背景人行走)、分辨率低,位置编码的几何优势在复杂场景(自驾、天气)下是否保持未知,应在 OpenSTL 的其他数据集或 WeatherBench 上补测。弱点四:缺少与主流位置编码的横向对比,表 4 只对比'有/无位置编码',未在同架构下比较 RoPE、可学习相对 bias、欧氏 3D RoPE 等,无法回答'为什么必须是闵可夫斯基几何而不是更简单的选择',这是论证链条上最需要补的一环。
未来方向
作者提出的方向:(1) 扩展到具身动力学、天气预报和生成模型;(2) 探索数据自适应的几何结构,即学习度规而非固定 $\eta=\mathrm{diag}(-1,+1,\cdots)$;(3) 设计满足对易约束的更强多参数洛伦兹构造;(4) 附录 C 的 Galilean 不变性障碍提示可寻找非酉或无穷维表示下的精确伽利略编码。基于成果可延伸的方向:(1) 混合几何编码——空间维度用欧氏旋转(RoPE)、时间维度用洛伦兹 boost,检验两者组合是否互补;(2) 可学习几何——让 $W$ 逐层独立甚至让度规符号模式可学习,研究模型是否自发恢复接近闵可夫斯基的结构;(3) 应用到分子生成扩散模型的注意力层(如 BioMD 类框架),检验对采样质量和物理合理性的影响;(4) 理论上分析洛伦兹编码的时间外推性质——对超出训练范围的时间步长是否比欧氏旋转更稳健,这与其'相对位移驱动'的形式天然契合;(5) 把事件坐标框架扩展到不规则采样数据(变帧率视频、分子模拟变步长),这是绝对坐标编码难以处理而事件视角自然支持的设定。
复现评估
正文未见明确的开源代码链接,这是复现的主要不确定因素。有利条件:MISATO 是公开数据集,KTH+OpenSTL 是标准基准且基线数字直接引用 OpenSTL 报告,基线侧复现成本低;方法实现本身简单——一个 $D\times P$ 共享投影矩阵加逐元素 cosh/sinh 变换,几十行代码可嵌入现有 Transformer,无需修改注意力核;论文报告三随机种子均值/最优并声明实验细节在附录 B,协议交代较清楚。算力需求不大:KTH 模型仅 2.5M 参数、8 层全局 Transformer,16×16 潜网格上单卡可训练;MD 侧单轨迹需按 10 个体系各训一个模型,多轨迹训练 MISATO-100/1000/Full 三个规模,总开销中等。难度评估:实现核心模块容易(半天级),完整复现三组实验工作量中等,主要成本在 MISATO 六个基线的复现与调参;建议读者先在小规模 KTH 上验证消融差值(MSE 约 2 点的差距),再决定是否投入 MD 实验。
论文图表
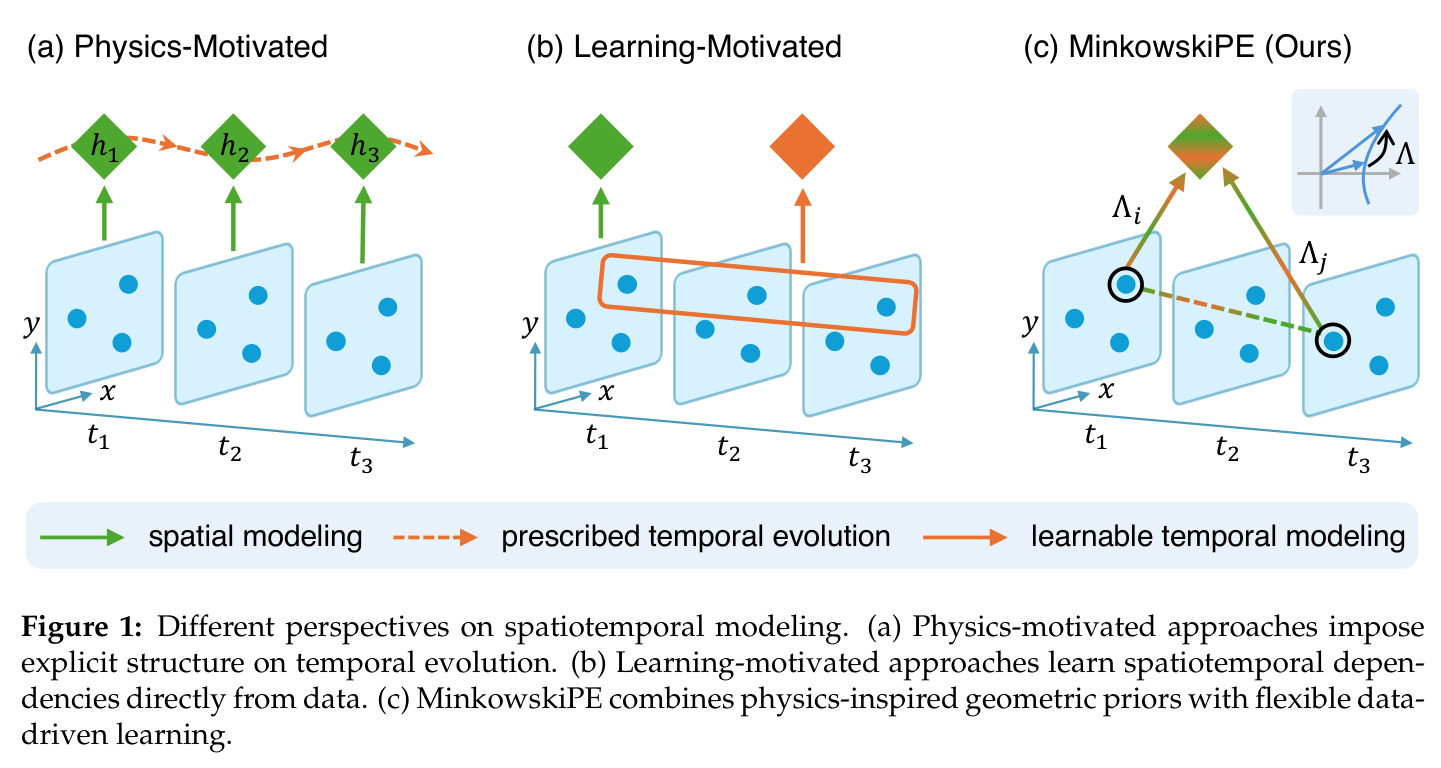
三栏对比图:(a) 物理驱动范式,时间轴上 $h^{(1)},h^{(2)},h^{(3)}$ 按规定的传播/演化机制推进;(b) 学习驱动范式,直接从数据学习时空依赖;(c) MinkowskiPE 范式,坐标 $(x,t_1),(x,t_2),(x,t_3)$ 各自参数化洛伦兹变换 $\Lambda$ 作用于特征,兼顾几何先验与可学习性。
这张图一图道尽论文的定位:MinkowskiPE 不规定时间如何演化(区别于物理驱动),也不让时空耦合完全隐式(区别于学习驱动),而是在位置表示层面注入几何先验,是理解全文动机的钥匙。