LoCA:让地理空间位置编码器支持多模态 LoCA: Enabling Multi-Modality in Geospatial Location Encoders
两阶段对比对齐,把坐标变成融合S1/S2影像与元数据的高秩多模态位置嵌入
前置知识
位置编码器 (Location Encoder)
将经纬度坐标 $(\varphi, \lambda)$ 直接映射为高维向量的函数 $f_c:\mathbb{S}^2\to\mathbb{S}^{d-1}$,典型实现是球谐特征加 SIREN 正弦网络。推理时不需要任何影像,输入坐标即得嵌入,可用于土地覆盖、气候、人口等下游预测。它与“观测嵌入”(对每张影像或网格单元给一个向量,如 AlphaEarth 的年度嵌入产品)相对,是定义在整个地球球面上的连续函数。
本文的全部理论与方法都围绕“什么才是好的坐标到向量函数”展开,LoCA 的最终形态就是一个只吃坐标的 256 维位置编码器。
对比学习与 InfoNCE
通过拉近正样本对、推远负样本对学习表征;InfoNCE 在数学上等价于“1 个正样本 + $K-1$ 个负样本”的分类交叉熵。其渐进(无限 batch)最优解是把嵌入的边缘分布推成球面 $\mathbb{S}^{d-1}$ 上的均匀分布 $\sigma$(Wang & Isola 2020)。CLIP 式双塔损失即对称化的 NT-Xent。
Theorem 1 证明位置编码器在几何上无法达到该均匀最优,这是全文动机的核心;LoCA 使用的 DHEL/MV-DHEL 也是对比损失的改进版本。
对齐与均匀性 (Alignment & Uniformity)
刻画对比学习最优解的两个量:对齐项 $L_{align}$(正样本对嵌入的期望距离,越接近 0 越好)与均匀性(嵌入在球面上的分散程度)。理想解为正对完全重合 $f_c(c)=f_I(I)$ 且边缘分布均匀。论文用余弦相似度和 $L_{align}$ 数值量化跨模态共对齐程度。
Stage 1 的目标就是制造“共对齐”的目标空间(实测 cos=0.94、$L_{align}=0.12$,而独立预训练的两个编码器只有 0.50/1.00),理解这两个量才能看懂实验验证部分。
Lipschitz 映射与 Hausdorff 维度
Lipschitz 映射满足 $\rho_Y(f(x),f(x'))\le L\,\rho_X(x,x')$,不能放大距离;Hausdorff 维度 $\dim_H$ 用集合直径的 $s$ 次幂覆盖来定义内蕴维度,对不规则集合同样适用。关键性质是 Lipschitz 映射不能增加 Hausdorff 维度:$\dim_H f(A)\le\dim_H A$。
Theorem 1 的第一步就是用它证明位置编码器的像至多 2 维(无论架构或带宽 $L$ 多大),这是“位置编码器与对比学习几何不相容”这一核心论断的数学根基。
有效秩 (Effective Rank)
Roy & Vetterli (2007) 提出的指标:对嵌入协方差矩阵的奇异值归一化后计算熵的指数,衡量表征实际占用了多少个线性无关方向。它是线性可分性和线性探针质量的标准代理指标(RankMe 等工作已验证)。
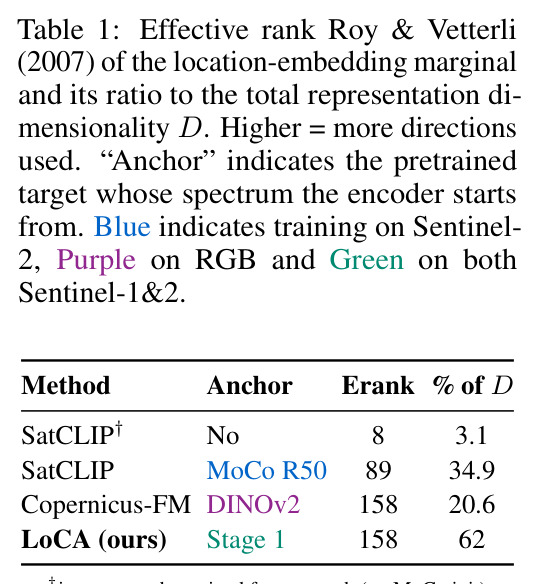
论文的第二个核心要求“高有效秩”以此量化:LoCA 占满 158/255 维(62%),而从零联合训练坍缩到 8(3.1%),Table 1 是全文最关键的证据表格之一。
DHEL 与 MV-DHEL(多视角对比学习)
DHEL 是把对齐与均匀性优化解耦的超球能量对比损失,在同类目标中有效秩最高;MV-DHEL 是其多视图扩展,用单一统一目标同时处理 $M$ 个视图,最优值随视图数增长而不发生维度坍缩。它避免了逐模态 InfoNCE 项叠加造成的梯度冲突和损失项数随模态数平方增长的问题。
LoCA 两个阶段分别用 DHEL(2 视图)与 MV-DHEL(4 视图)训练,是方法的直接构件,也是它声称可扩展到任意模态数的原因。
Sentinel-1 / Sentinel-2
欧洲哥白尼计划的两大成像卫星。Sentinel-2 是光学多光谱卫星(12 波段、10 米分辨率),Sentinel-1 是 C 波段 SAR 雷达卫星(VV/VH 双极化,全天候穿云)。两者感知地物的物理机制互补(光谱反射 vs 雷达后向散射),但独立预训练的两个编码器嵌入空间相差一个任意正交变换、互不共对齐。
Stage 1 联合训练这一对模态正是为了制造“共对齐且高秩”的目标空间,这是 LoCA 与 SatCLIP(仅用 Sentinel-2)的本质差别。
线性探针 (Linear Probe)
冻结预训练编码器,只在其输出的嵌入上训练线性分类/回归模型来评估表征质量;线性可读的特征才是下游能广泛利用的特征。通常与 MLP 探针对比,以判断信息是否只是被非线性变换掩盖。
这是本文下游评估的核心协议;LoCA 的线性探针在 12 个可探针任务中 8 个最佳,直接支撑其“高有效秩使位置信息线性可达”的主张。
研究动机
现代地理空间应用(野火预报、物种分布建模、土地覆盖分类)需要一个“输入任意经纬度就能查询”的通用位置向量,但现有两条路线都不理想。第一条是卫星基础模型的预计算嵌入产品:AlphaEarth 融合光学/雷达/LiDAR/气候再分析发布 10m 分辨率的 64 维年度嵌入,Copernicus-FM 提供 0.25° 网格的 768 维多传感器平均嵌入,TESSERA 发布 Barlow Twins 预训练的年度 int8 嵌入。它们本质是观测快照——绑定特定发布网格与观测窗口,无法在网格之外或窗口之外返回向量,且同一位置随所提供影像不同会得到不同向量。第二条是对比式位置编码器(SatCLIP、GeoCLIP、CSP),虽把坐标变成真正可查询的函数,但只与单一影像模态对齐(SatCLIP 用冻结的 Sentinel-2 编码器、GeoCLIP 用 CLIP 自然图像),无法利用多传感器的互补信息。
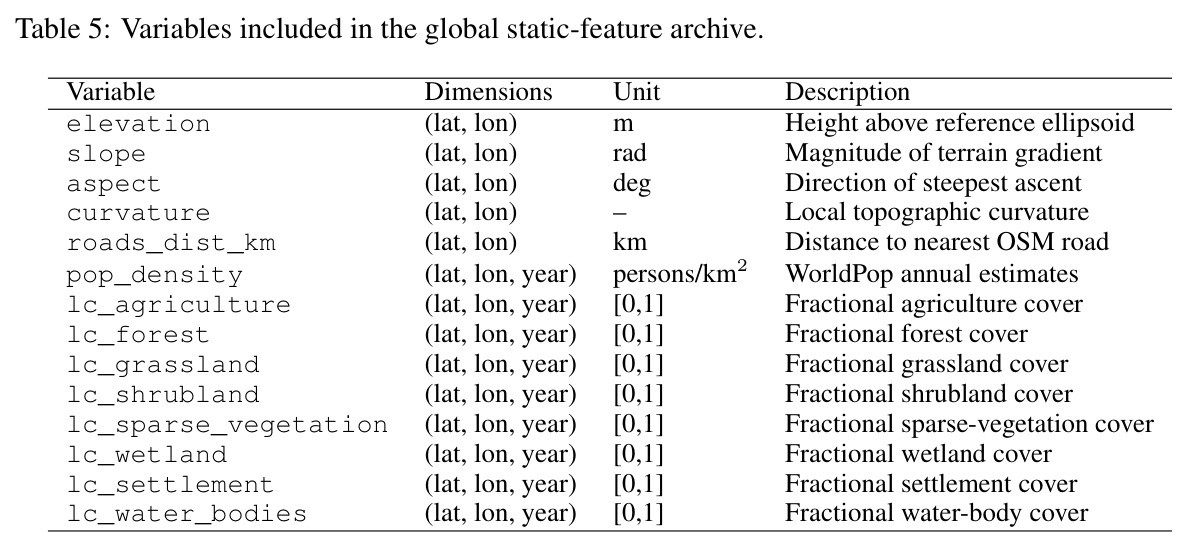
本文的目标是本文要构建一个只依赖经纬度 $(\varphi,\lambda)$ 即可查询的通用位置编码器,其嵌入空间融合 Sentinel-1 SAR 与 Sentinel-2 光学两种影像模态以及 14 个静态地理元数据变量(高程、坡度、坡向、曲率、道路距离、人口密度、8 个土地覆盖分数),同时规避联合对比训练的谱坍缩。具体分三层:第一,从理论上证明位置编码器与对比学习的几何不相容性,并解释现有方法为何在实践中仍然有效;第二,推导出多模态目标空间必须满足的两个可检验要求——跨模态共对齐与高有效秩;第三,提出 LoCA 两阶段训练流水线,在覆盖土地覆盖、野火、长期气候、地球物理、社会经济、生物多样性六大类的 17 个任务上取得最多的任务第一名。
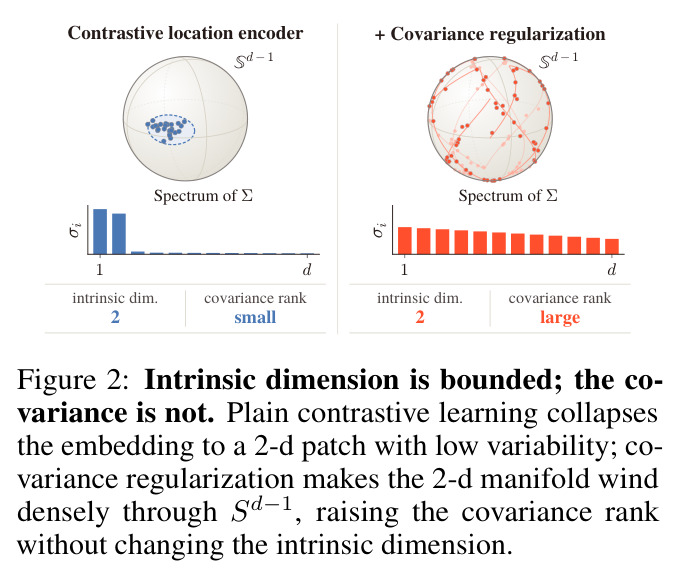
与已有工作不同的是,作者没有直接堆叠多模态对比损失,而是先追问“什么样的目标空间才配得上被坐标适配”。他们首先证明 Theorem 1:Lipschitz 位置编码器 $f_c:\mathbb{S}^k\to\mathbb{S}^{d-1}$ 的像的内蕴维度至多 $k$(坐标 $k=2$、嵌入 $d-1=255$ 时,即 255 维球面上的一张 2 维曲面),其输出分布 $\nu$ 与均匀目标 $\sigma$ 互奇异,因此对齐对的损失严格高于自由最优 $L_\tau^{free}$;随后重新解读 SatCLIP/GeoCLIP:冻结的图像编码器实为一个协方差正则化器,提供高秩目标点云让这张 2 维曲面“折叠”其上。由此自然导出多模态扩展的两个结构要求,并实测独立预训练的 S1/S2 编码器不共对齐($L_{align}=1.00$、cos=0.50),MLP 适配器只能吸收逐模态的正交变换却无法制造本来不存在的对齐——这解释了为何 SatCLIP 无法通过简单冻结两个独立编码器扩展到多模态。
核心方法
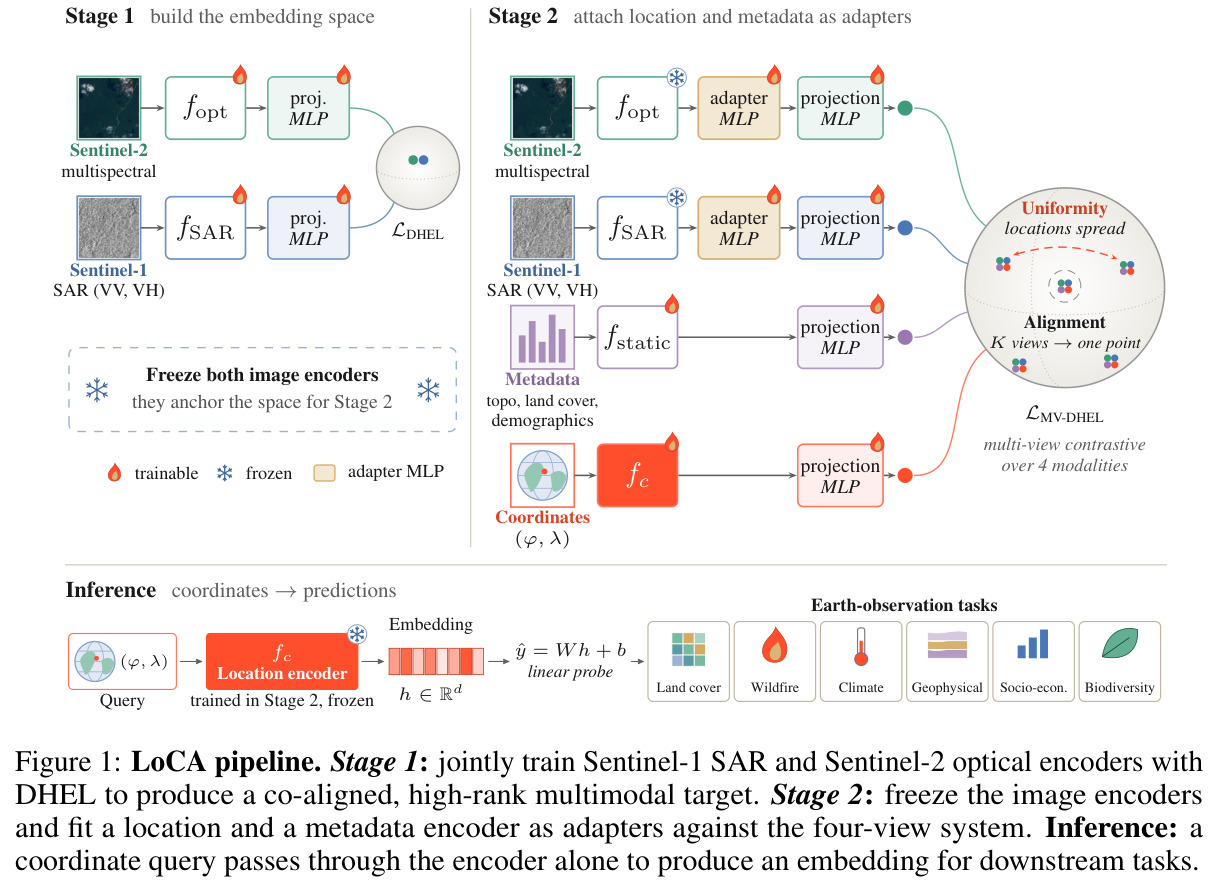
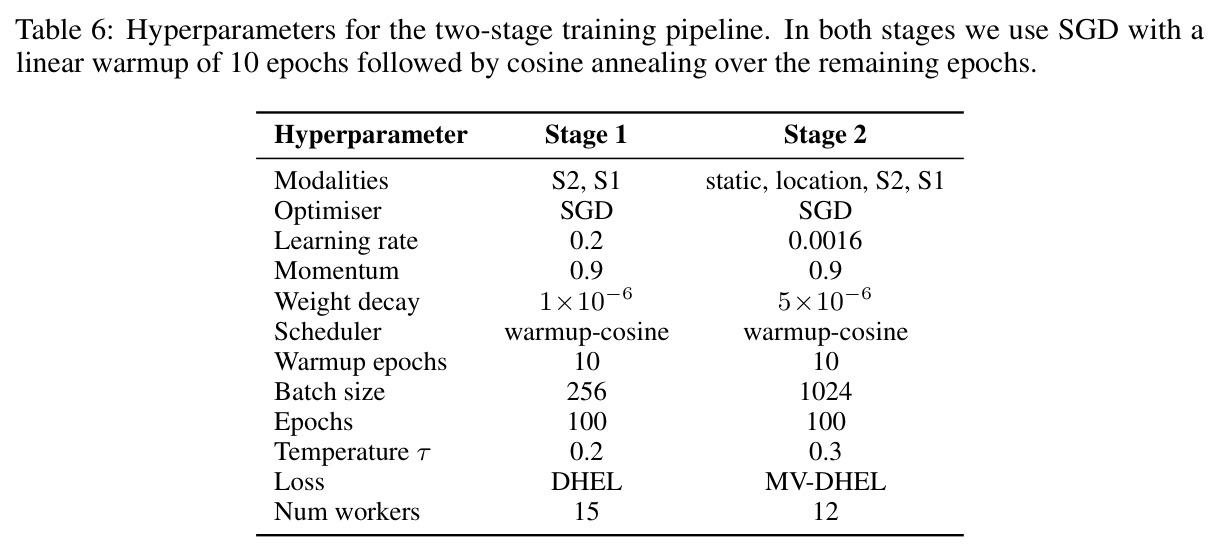
直觉上,LoCA 把位置编码器当作“坐标索引的查找表适配器”:关键不在位置编码器本身,而在它适配的目标点云必须共对齐且高秩。技术路线分两阶段。Stage 1 用 DHEL 损失端到端联合训练 Sentinel-2 与 Sentinel-1 两个 ResNet-50 编码器(各接 2 层投影头 256→128,$\tau=0.2$,SGD lr 0.2、batch 256、100 epochs,单卡 H100 约 14 小时):联合训练使配对输入被拉到同一点成为损失最优解的性质,从而得到跨模态共对齐;DHEL 又强制表征占满可用维度,得到高秩目标。Stage 2 冻结两个图像骨干(嵌入预计算并缓存,不再前向),每个模态接 2 层 MLP 适配器(2048→256),并新初始化位置编码器(球谐 $L=40$ 映射到 1600 维、2 隐层宽 256 的 SIREN,输出 256)与元数据编码器(3 层 MLP:14→256→256→256),用 MV-DHEL 对“元数据+坐标+S2+S1”四视图系统对比训练($\tau=0.3$,lr 0.0016、batch 1024、100 epochs,单卡 A100 约 5 小时)。推理时坐标过位置编码器即得 256 维嵌入。
核心创新是把“位置编码器为什么有效”的理论重释转化为多模态构造原则。已有方法(SatCLIP/GeoCLIP)本质上是 LiT(Locked-image Tuning)式适配:对比目标只是拟合坐标索引查找表的代理,冻结图像编码器充当协方差正则化器。本文指出把这个范式扩展到多模态,目标空间必须满足两个可检验条件:(i) 跨模态共对齐——不同模态在配对样本上的标签点必须逐点一致,这样 $f_c$ 对每个坐标只需满足一个约束而非 $M$ 个相互矛盾的约束;(ii) 目标具有高有效秩——因为对齐迫使 $f_c(c_i)\approx y_i$,低秩目标的谱坍缩会传染给位置编码器,这正是 MIM 类基础模型(方差集中在少数方向)不能直接当锚的原因。Stage 1 的联合对比训练恰好同时满足两条:共对齐是损失最优解的结构性质,DHEL 则保证高秩。这是与“为每个模态加一个 InfoNCE 项”的已有多模态扩展(如 TIGeR 用 6 个损失、GAIR 用逐模态对齐)在思想层面的本质区别。
方法步骤详情
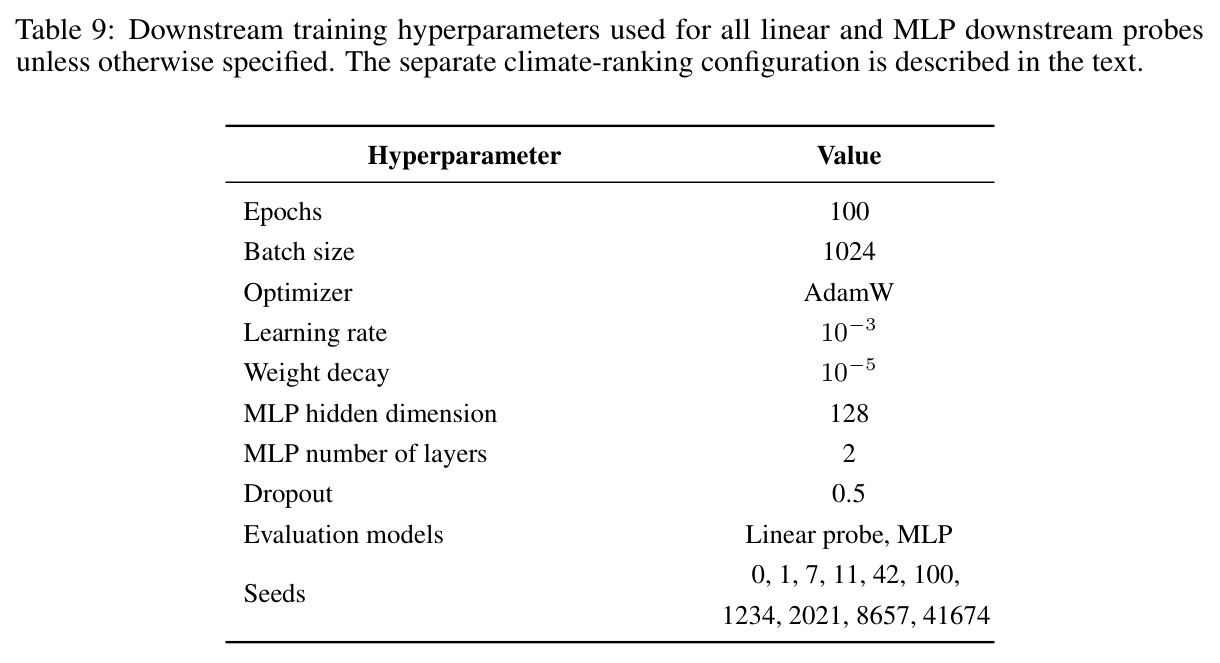
第一步,数据构造:从 SatCLIP 的 GeoParquet 索引采样 10 万个 Sentinel-2 L2A 影像(256×256、12 波段、10m/px,全波段缺失或全零像素超 10% 即拒收),±6 天窗口内匹配同址 Sentinel-1 GRD(VV+VH 双通道 224×224);同时构建全球 0.01°(约 1km)网格、6.48 亿点的 14 变量元数据档案(8 个土地覆盖分数、人口密度、道路距离、高程/坡度/坡向/曲率),圆-圆重叠率至少 75% 才归属,平均每影像约 5 个元数据点。第二步,Stage 1:S2/S1 两个 ResNet-50 端到端 + DHEL 损失(2 视图时解析退化为 DHEL)。第三步,Stage 2:冻结骨干、丢弃 Stage 1 投影头,接适配器(2048→256),位置编码器与元数据编码器随机初始化,MV-DHEL 对齐全部模态对(均匀性按视图计算),嵌入 $\ell_2$ 归一化;每个图像组内随机抽元数据点形成多视图样本。第四步,推理与评估:$(\varphi,\lambda)$ 过球谐+SIREN 得 256 维向量,冻结后训练线性探针、2 层 MLP 或 LightGBM 排序器(气候任务)。
技术新颖性
新颖性有三层。其一,理论结果本身是新贡献:Theorem 1 给出三重结论($\dim_H f_c(\mathbb{S}^k)\le k$、$\nu\perp\sigma$、对齐 Lipschitz 对的损失严格大于 $L_\tau^{free}$),Corollary 1 更证明对整个带宽 $L$ 的 SatCLIP 函数族取 infimum 仍严格高于自由最优——证明用 Arzelà–Ascoli 建立函数族紧性,再用 Kantorovich–Rubinstein 对偶与 Portmanteau 定理建立损失泛函的弱连续性,这套测度论工具在位置编码文献中前所未见。其二,“协方差正则化器”的概念性重释:把看似成功的对比位置编码训练重新归类为 LiT 式适配,并指出几何(内蕴维度恒为 2)与谱(协方差秩可任意高)的解耦,解释了从零联合训练的 SatCLIP 有效秩仅 8/255(3.1%)这一现象。其三,工程上用单一 MV-DHEL 目标替代逐模态损失叠加(TIGeR 需 6 项、项数随模态数平方增长且梯度冲突),任意模态数无修改扩展,并给出可操作的判据(共对齐+高有效秩)供后续工作检验目标空间是否合格。
实验结果
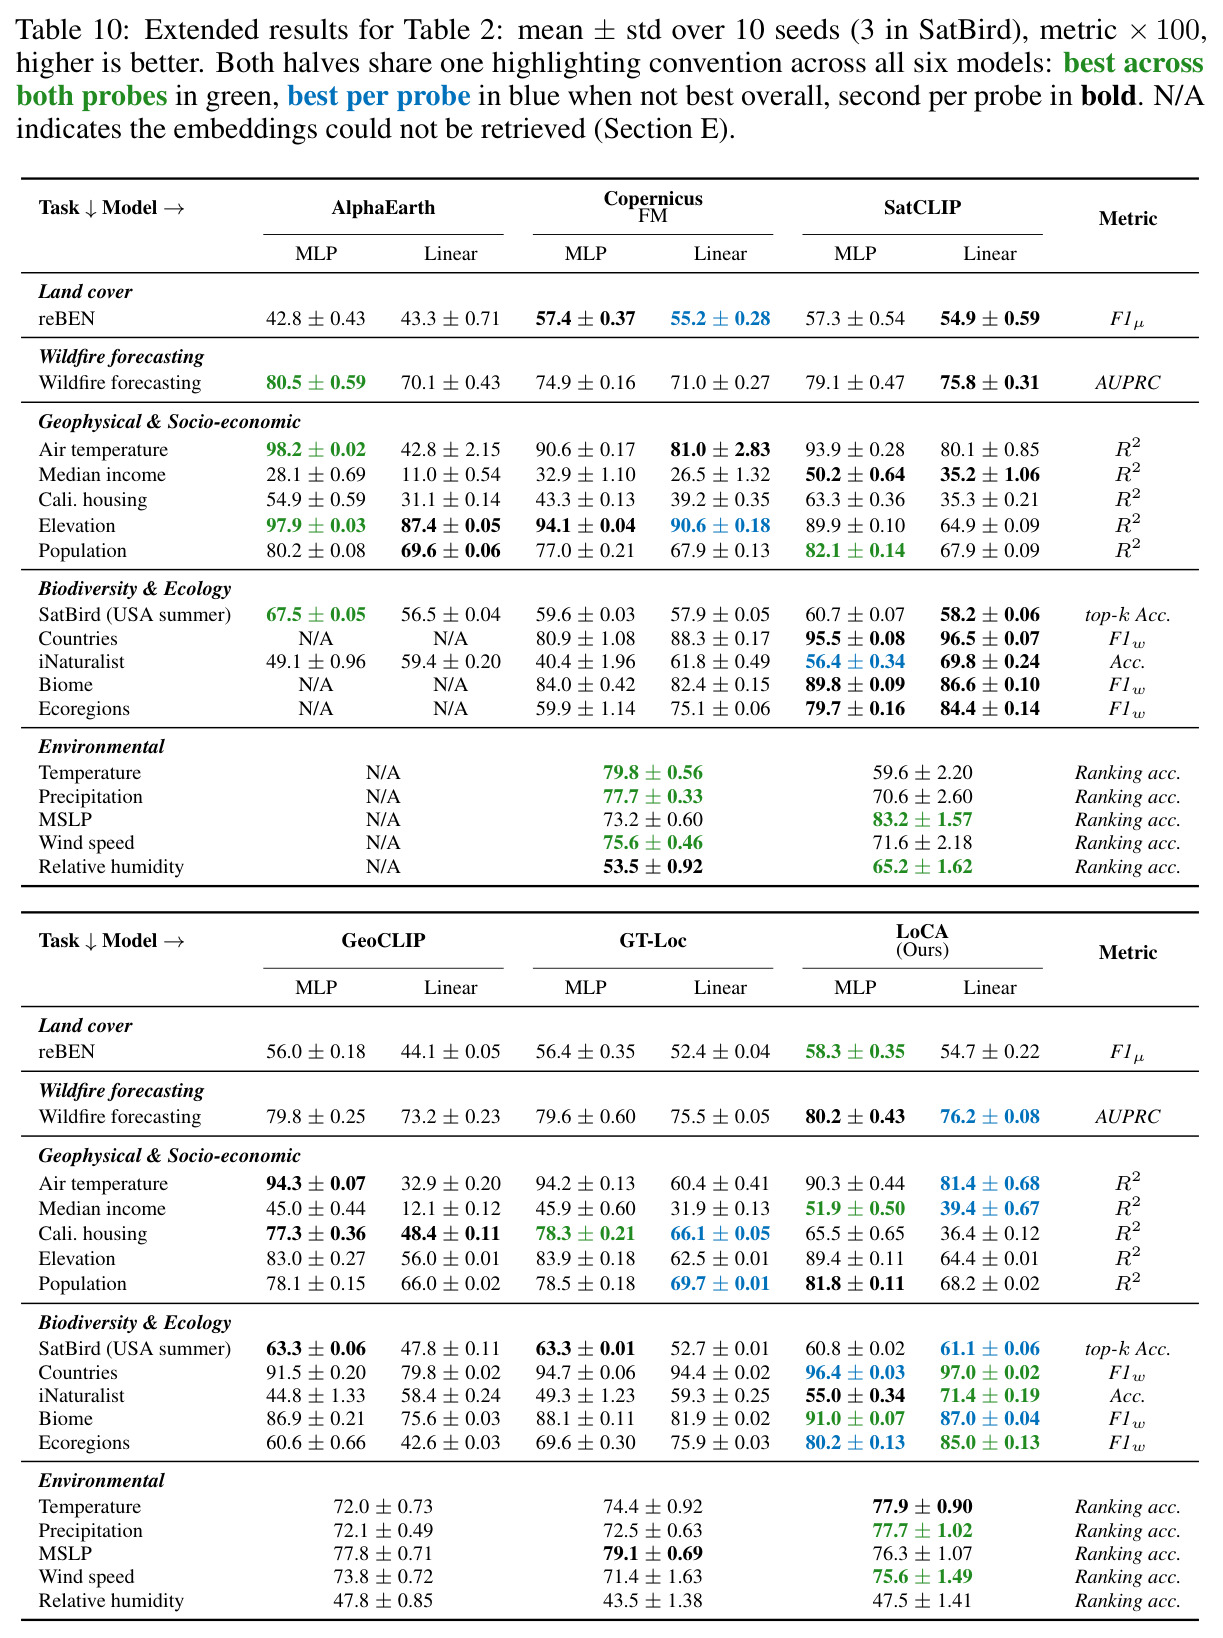
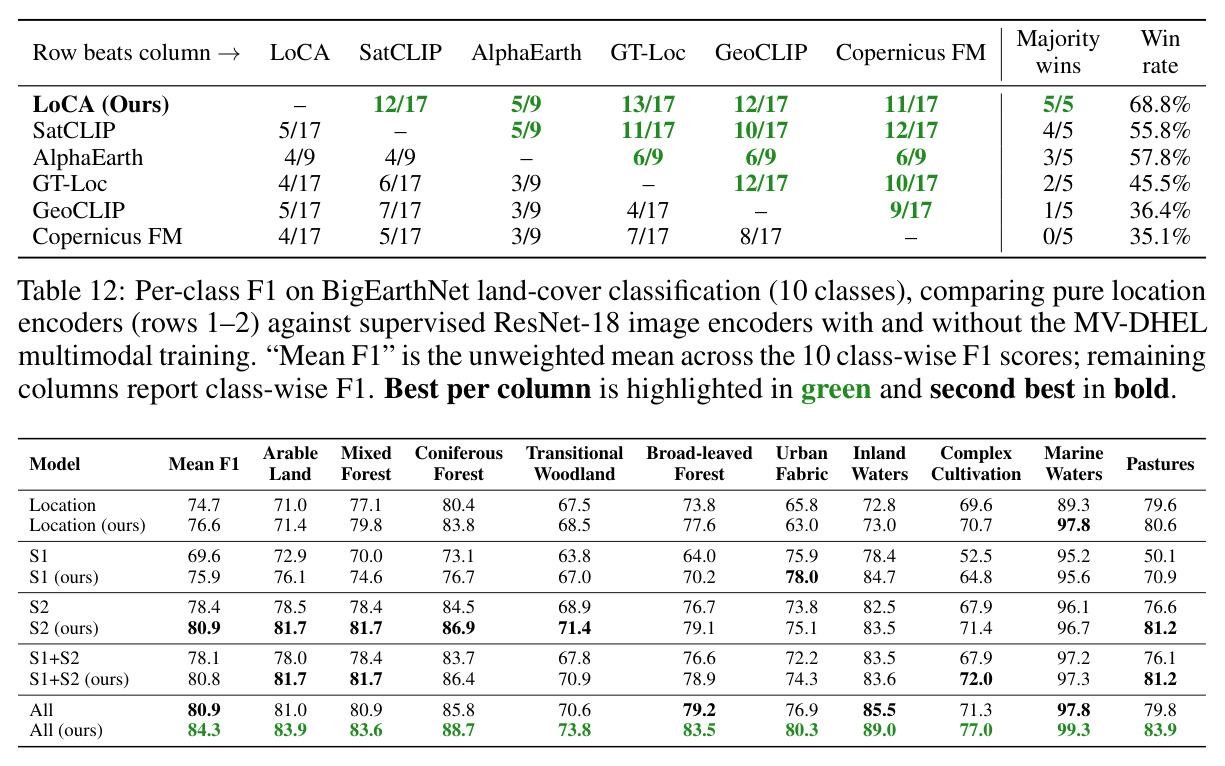
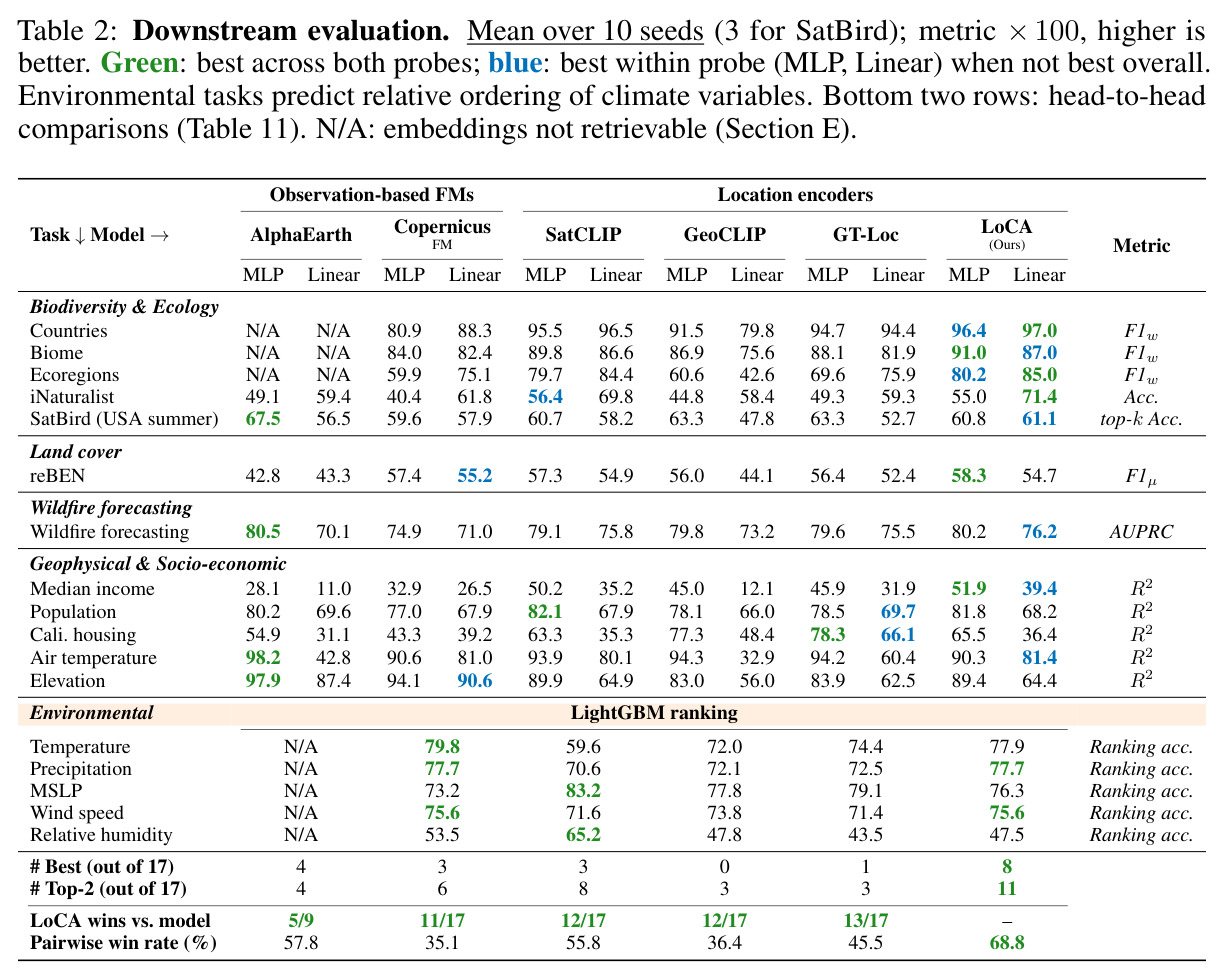
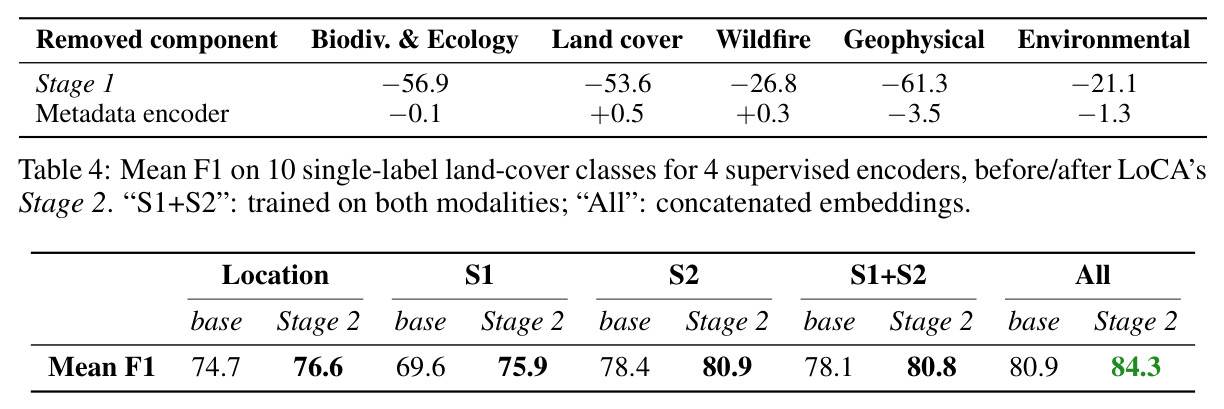
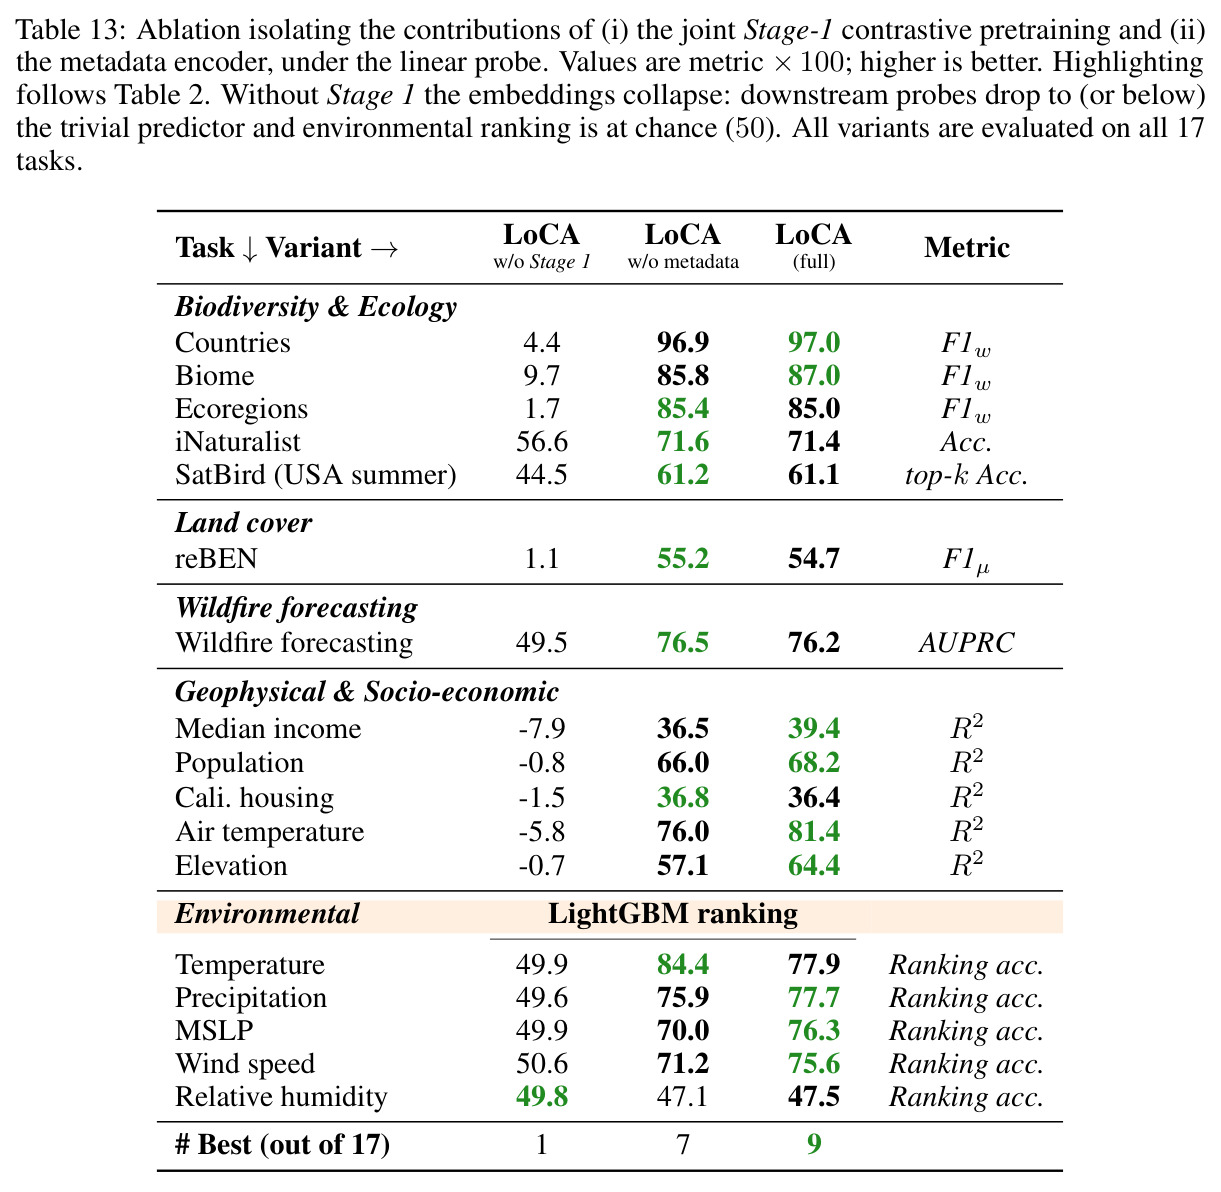
17 个任务(每任务 10 种子、SatBird 3 种子)上 LoCA 8 项第一、11 项前二,两两胜率 68.8%(对 SatCLIP 12/17、GT-Loc 13/17、GeoCLIP 12/17、Copernicus-FM 11/17、AlphaEarth 5/9),是唯一在多数共享任务上击败所有对手的编码器。生态与土地覆盖最强:Countries 97.0、Biome 91.0、Ecoregions 85.0(线性)与 iNaturalist 线性 71.4 均全场最佳,reBEN micro-F1 58.3 超 SatCLIP 的 57.3;野火 AUPRC 80.2 仅次于 AlphaEarth 的 80.5;社会经济中 Median income $R^2$ 51.9 第一、Population 81.8 紧随 SatCLIP 的 82.1,气温线性探针 81.4 全场最佳(MLP 90.3 落后 AlphaEarth 的 98.2),说明位置信息在 LoCA 嵌入中线性可达;气候排序在坐标类编码器中领先(温度 77.9、降水 77.7、风速 75.6),但 MSLP 76.3 落后 SatCLIP 的 83.2。机制验证:Stage 1 共训的 S1/S2 编码器 cos=0.94、$L_{align}=0.12$(独立预训练仅 0.50/1.00);在 343,928 个 0.25° 网格点上有效秩 158/255(62%),约为 Copernicus-FM(20.6%)的 3 倍、SatCLIP(34.9%)的 1.8 倍,从零联合训练坍缩至 8(3.1%)。消融:去掉 Stage 1 全线崩塌(reBEN 54.7→1.1、气温 $R^2$ 81.4→−5.8、五个气候排序降至约 50 的随机水平);去掉元数据编码器仅地球物理 −3.5%、环境 −1.3%;替换实验中 MV-DHEL 适配使有监督编码器全部提升,四模态拼接平均 F1 从 80.9 升至 84.3。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 总 head-to-head 对比(17 任务,取各模型最佳探针) | 两两胜率 | 68.8%(唯一对所有对手都占多数胜) | SatCLIP 55.8%、AlphaEarth 57.8%、Copernicus-FM 35.1% | 比最强基线高约 11 个百分点 |
| reBEN 土地覆盖多标签分类 | micro-F1 ×100 | 58.3(MLP)/ 54.7(线性) | SatCLIP 57.3 / 54.9;AlphaEarth 42.8 / 43.3 | 较最强基线 +1.0 |
| Countries 国家分类 | weighted F1 ×100 | 97.0(线性) | SatCLIP 96.5、GT-Loc 94.4 | +0.5 |
| iNaturalist 物种分类 | Accuracy ×100 | 71.4(线性) | SatCLIP 69.8、GT-Loc 59.3 | +1.6 |
| Median income 县级收入回归 | R² ×100 | 51.9(MLP) | SatCLIP 50.2、Copernicus-FM 32.9 | +1.7 |
| 野火危险预报(Mesogeos) | AUPRC ×100 | 80.2(MLP,第二名) | AlphaEarth 80.5、GeoCLIP 79.8 | 落后第一名 0.3 |
| 气候排序 Temperature/Precipitation/Wind | Pairwise 排序准确率 ×100 | 77.9 / 77.7 / 75.6(坐标类编码器最佳) | Copernicus-FM 79.8 / 77.7 / 75.6(需多模态影像才能取嵌入) | 仅凭坐标追平或接近需影像的基线 |
| 嵌入空间利用率(343,928 个 0.25° 网格点) | 有效秩 / 总维度 | 158/255(62%) | SatCLIP 89/255(34.9%)、Copernicus-FM 158/255(20.6%)、从零联合训练 8/255(3.1%) | 利用率是 SatCLIP 的 1.8 倍、从零训练的约 20 倍 |
局限与改进
作者承认三条局限:LoCA 无时间维度,季节性与短期动态只能间接捕捉;Stage 1 仅用 Sentinel-1 与 Sentinel-2 两种传感器(框架本身可吸收更多模态);坐标类基准对空间自相关敏感,需分块或留出区域评估(列为未来工作)。我的补充观察:(1) 元数据编码器收益不均衡——土地覆盖、野火任务移除后反而 +0.5/+0.3,温度排序也从 77.9 升到 84.4,说明 14 个粗粒度元数据与影像信息重叠较多、对细粒度任务是噪声;(2) 相对湿度排序仅 47.5%,不仅低于 50% 随机线,也远落后 SatCLIP 的 65.2%,说明 LoCA 并非在所有气候变量上都占优;(3) Cali housing(65.5 vs GT-Loc 78.3)与 SatBird(61.1 vs AlphaEarth 67.5)暴露了在依赖视觉先验或年度观测细节的任务上,纯坐标函数存在信息天花板;(4) 理论只覆盖 Lipschitz(及 Hölder 指数 $\alpha>k/(d-1)$)编码器,且严格损失间隙仅在“对齐对”上成立——非对齐稳定均衡(模态间隙)可能取更低值,理论与实际训练动力学之间的联系仍是经验性的。
独立分析的弱点
弱点一:静态性。模型对同一位置在夏/冬、灾前/灾后无法区分,而野火预报、物种分布本质上时间敏感;改进方向是把坐标扩展为 $(\varphi,\lambda,t)$ 并引入时间编码器视图,仍用 MV-DHEL 单目标训练。弱点二:Stage 1 传感器覆盖窄,仅 S1 GRD 与 S2 L2A,缺 LiDAR、气候再分析、高光谱;AlphaEarth 在 SatBird 的领先(67.5 vs 61.1)可能正来自多源融合,可按框架追加视图。弱点三:尺度单一,S2 采样为 256×256@10m(覆盖半径约 1.28km),无法同时编码街区级与区域级模式;可借鉴 Sphere2Vec 多尺度球面编码。弱点四:元数据与影像信息冗余(土地覆盖分数 vs S2 光学影像),推理端额外引入 14 变量依赖,却在 17 任务中只改善 9 个;可做变量筛选或学习式门控。弱点五:理论—实践间隙,严格损失间隙只对对齐对成立,实际训练(有限温度 $\tau$、有限 batch)到达的是非对齐均衡;应补充“接近对齐”时的间隙速率分析。弱点六:部分气候变量失效(相对湿度 47.5%),可能因长期气候均值主要由纬度带决定而嵌入流形只有 2 个内蕴自由度;可在 Stage 1 分布上对气候敏感区域加权采样。
未来方向
作者提出的方向:引入时间信息、气象变量与更丰富的土地覆盖元数据;利用“可无修改吸收任意多模态”的框架性质扩展到其他传感器;发展分块或留出区域的评估协议解决空间自相关。基于成果可延伸:(1) 时空位置编码——把 SeasFire/Mesogeos 的时序数据作为 Stage 1 的新视图,得到 $(\varphi,\lambda,t)$ 函数,直接服务次季节野火预报;(2) 用生成式 EO 基础模型(如 TerraMind)的嵌入做 Stage 2 目标,检验“MIM 目标低秩”论断是否在生成式目标中消失;(3) 理论推广——作者已提示 $\alpha$-Hölder 映射满足 $\dim_H f(A)\le\dim_H A/\alpha$,可系统刻画非 Lipschitz 类,并研究模态间隙下非对齐均衡的损失景观(Cai et al. 2026);(4) 跨模态检索——LoCA 作为坐标→嵌入函数,可与图像嵌入做零样本地理定位;(5) 表征压缩——62% 的有效秩暗示 256 维存在冗余,可结合 slimming 研究嵌入裁剪;(6) 增量模态接入——冻结已训好的 Stage 2 系统再挂载新传感器视图,避免全量重训,这对持续扩建设计很有价值。
复现评估
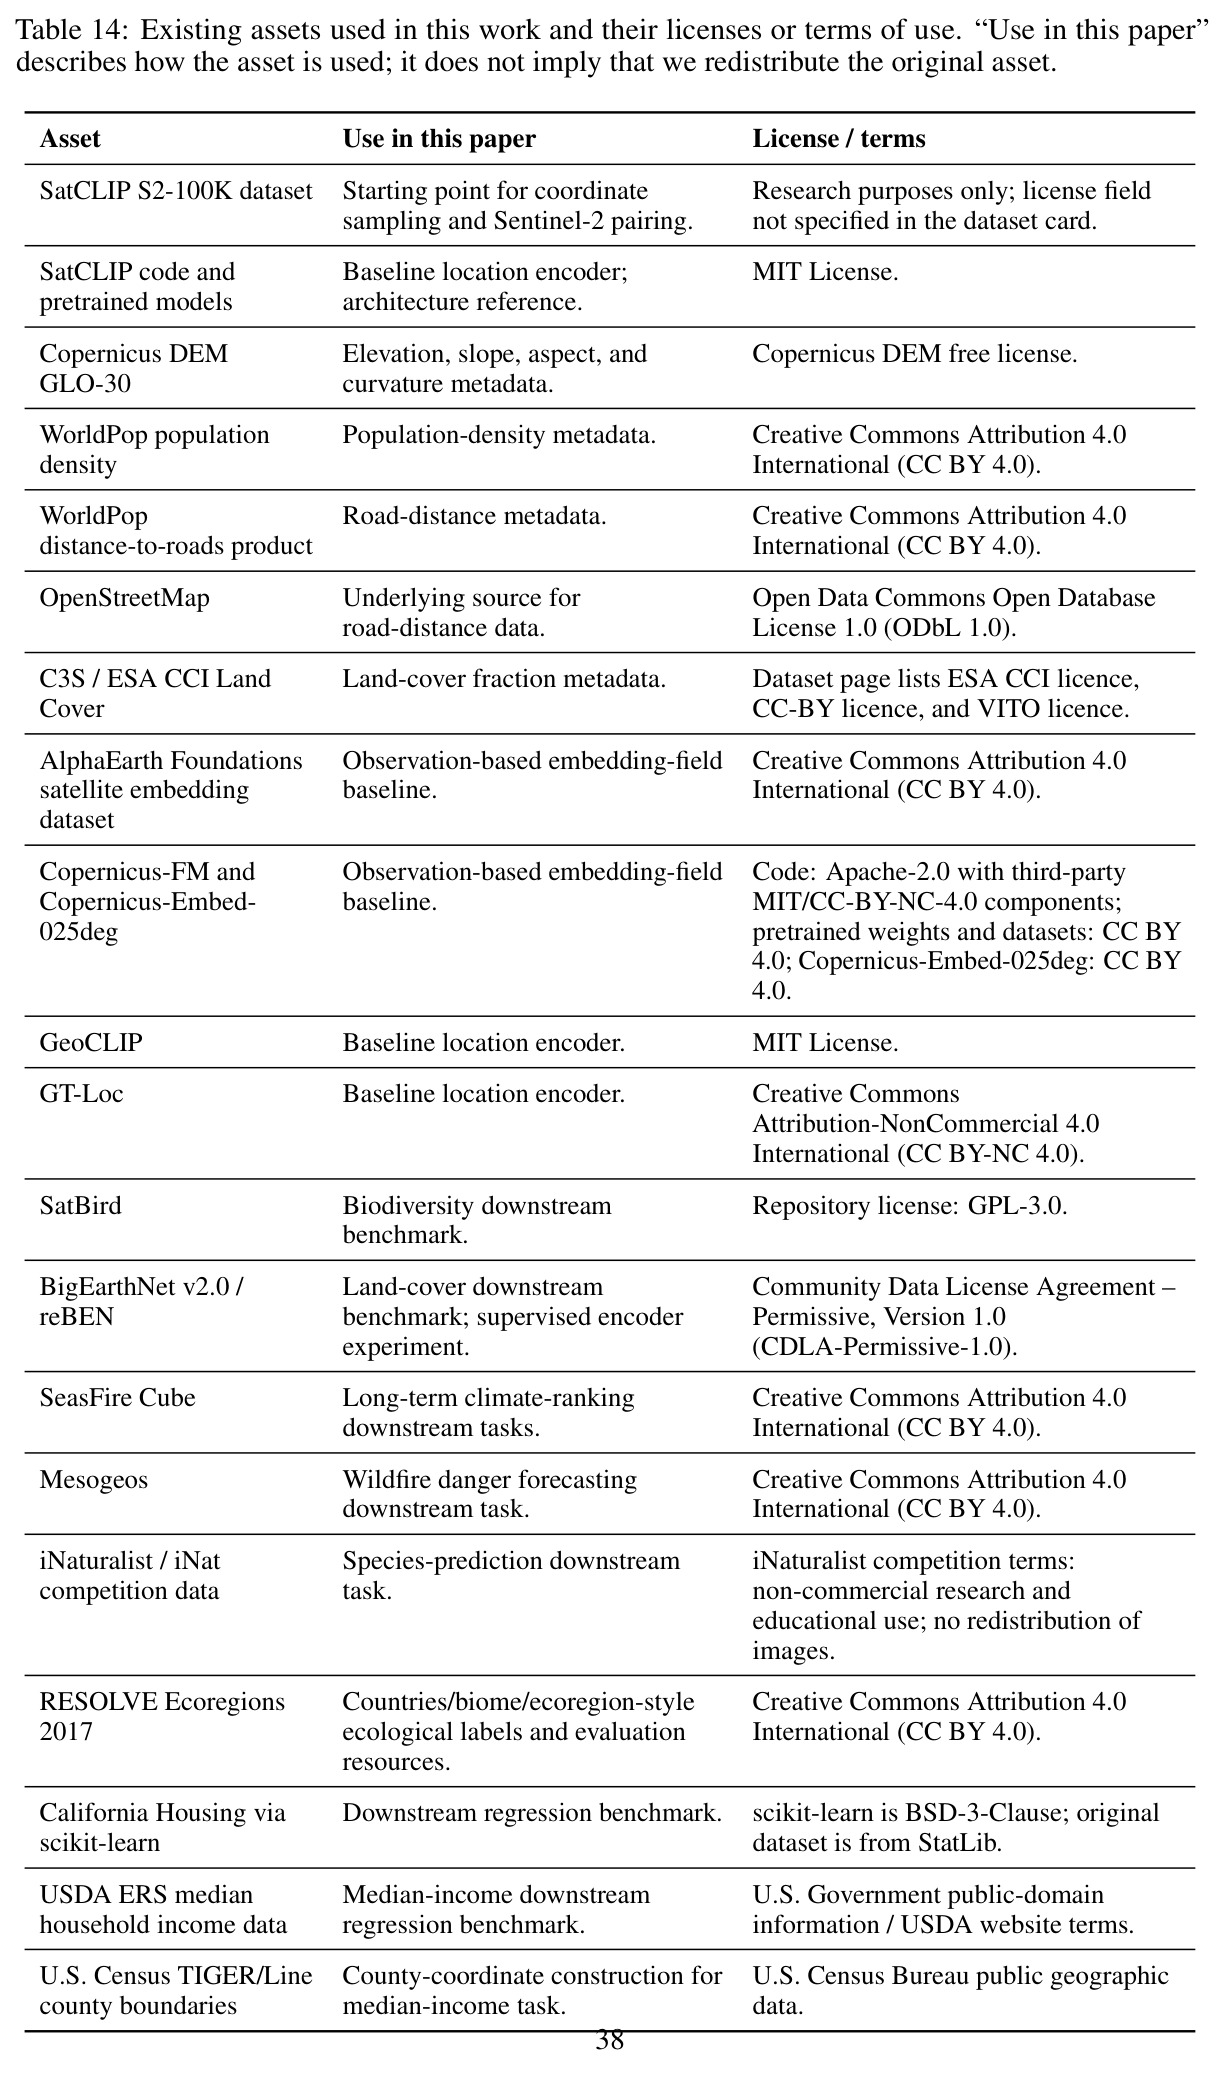
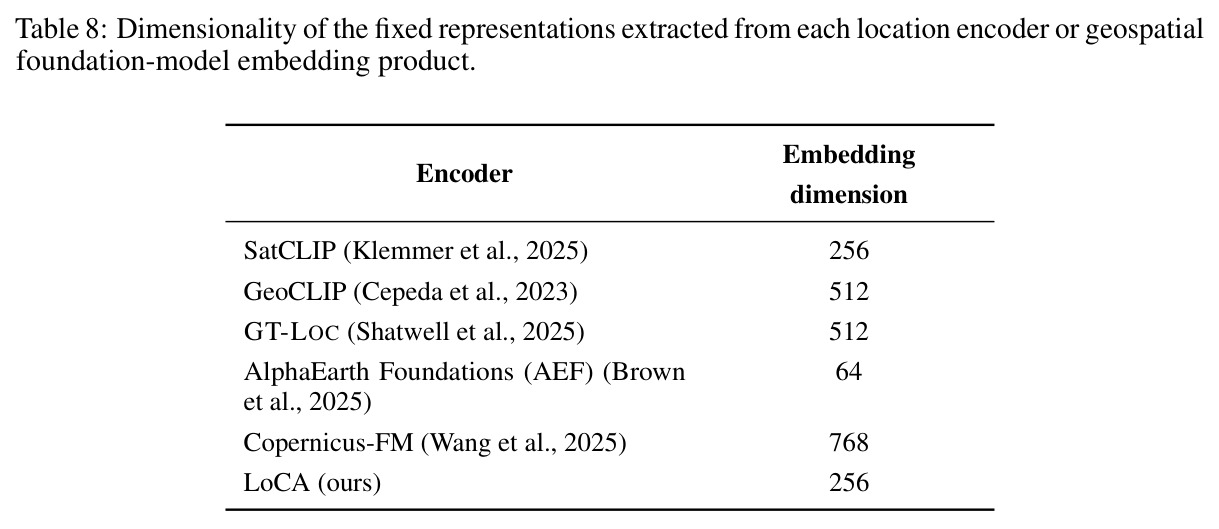
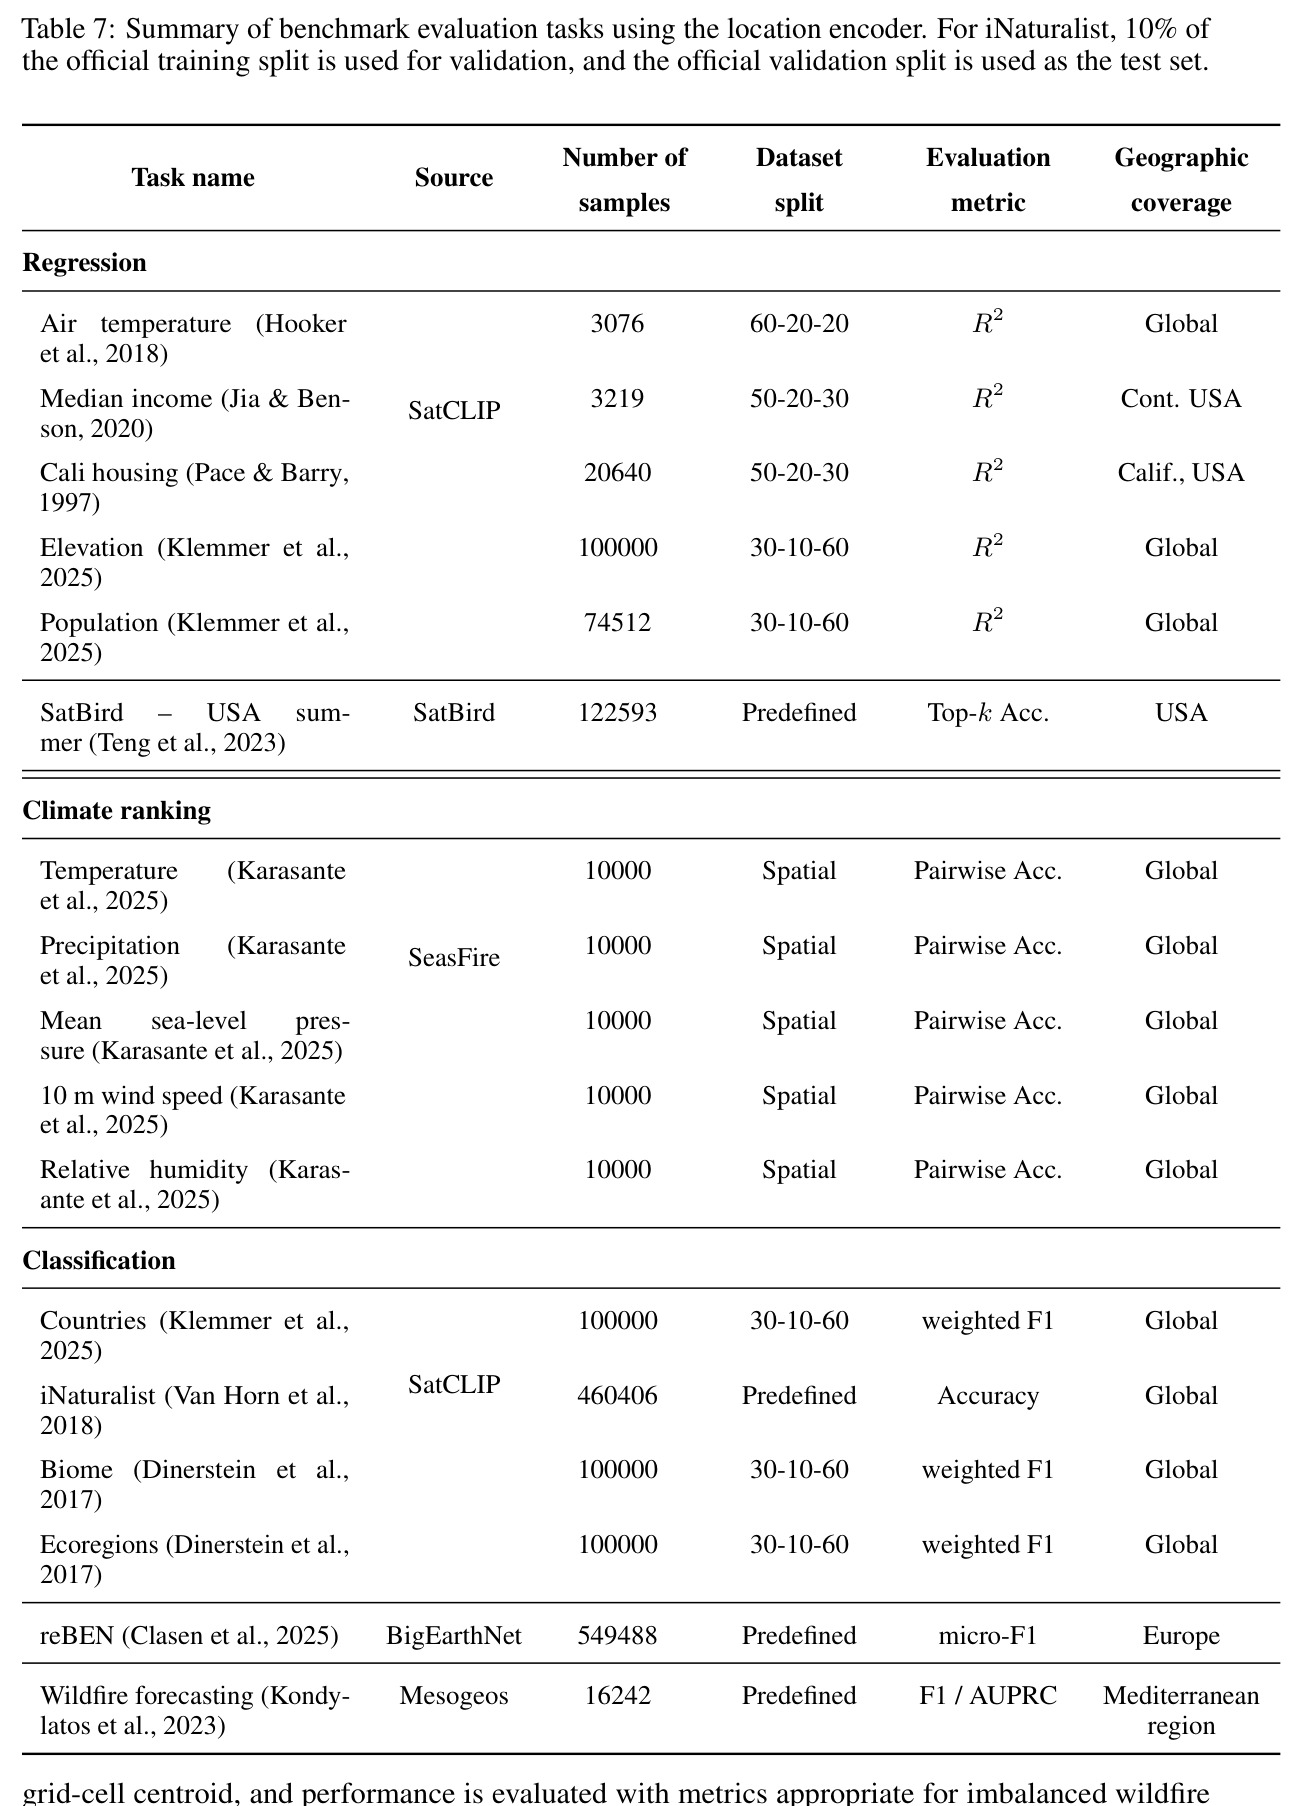
复现条件总体较好。代码与预训练权重承诺公开(github.com/eleannavali/LoCA,脚注仓库为 LoCA2026),实现基于三个公开仓库:SatCLIP 代码库(位置与 S2 编码器)、torchgeo(S1 编码器)、Multi-View CL 框架(MV-DHEL)。算力门槛低:Stage 1 单卡 H100-64GB 约 14 小时,Stage 2 单卡 A100-40GB 约 5 小时,端到端约 19.5 小时,单机单卡即可复现。数据需自建:10 万对 S2/S1 配对影像从 GeoParquet 索引采样并按 ±6 天窗口匹配(附录 C.2 给出完整质检规则),元数据管线(Copernicus DEM GLO-30、WorldPop 人口/道路、OSM、C3S 土地覆盖)有逐变量说明,Table 14 列出全部第三方资产许可。下游协议完整:17 任务的数据源、样本量、划分、指标、超参(Table 7/9)、种子清单(10 种子,SatBird 3 种子)、嵌入维度(Table 8)均披露,并给出 torch.manual_seed(42) 与确定性 CUBLAS 配置。难度评估:理论数值验证容易;全流程复现的主要工作量在 Sentinel 数据下载与时空对齐管线而非训练本身,中等偏上但完全可行。
论文图表