CoWindow Attention:完全因果覆盖是一种集体属性 CoWindow Attention: Full Causal Coverage Is a Collective Property
把长程历史按KV头互补划分、集体覆盖全部因果历史,以稀疏成本逼近全注意力质量。
前置知识
GQA(分组查询注意力)
多头注意力的变体:$H_q$ 个查询/输出(QO)头共享 $H_k$ 个键值(KV)头,QO 头 $h$ 使用 KV 头 $h_k=\lfloor hH_k/H_q\rfloor$ 的键值张量。KV 头数量远小于 QO 头,KV cache 与显存成倍下降,而每个 QO 头仍用不同查询计算注意力权重。共享同一 KV 头的一组 QO 头自动共享同一可见键集合。
CoWA 的三种窗口以 KV 头为单位分配:共享近窗/sink 窗、互补长程窗都绑定在 KV 头上,QO 头组继承其可见键集;张量并行与 KV cache 也按 KV 头分片。不理解 GQA 就无法理解窗口分配、并行策略与缓存划分三者的关系。
FlashAttention 与 online softmax
IO 感知的精确注意力实现:把 Q、K、V 分块(tiling)后在 SRAM 中融合计算 QK 与 PV,用 online softmax 逐块维护运行最大值 $m$ 与分母 $\ell$,并对累计输出 $O$ 做 $\exp(m_{old}-m_{new})$ 重缩放,避免物化 $n\times n$ 注意力矩阵,大幅减少 HBM 读写。
CoWA 的前向(Algorithm 1)与反向(Algorithm 2)kernel 正是'稀疏块遍历 + online softmax'的扩展;论文的延迟/内存对比都以 FlashAttention 为稠密基线,读懂算子级实验需要这一背景。
Attention sink 与滑动窗口注意力(SWA)
实证发现自回归模型会把大量注意力质量倾倒到序列开头少数 token(sink)上,它们充当稳定 softmax 的'锚点';SWA 则把每个头的视野限制为最近 $w$ 个 token,训练推理都只用局部窗口,效率高但切断了对远距离内容的直接访问。
CoWA 直接继承这两个机制:所有 KV 头共享近对角窗口与前缀 sink 窗口;SWA 是论文的局部基线(8K 联想召回仅 5.34%),理解它们才能理解 CoWA 窗口设计的来源与对照意义。
张量并行(TP)与 KV 头分片
大模型训练/推理的模型并行方式:注意力头被切分到多个 GPU,每个 rank 持有一部分 KV 头,KV cache 也按头划分存储;rank 间通过集合通信同步部分结果。TP 下的注意力效率取决于各 rank 能否独立计算本地头的稀疏模式。
CoWA 用全局 KV 头索引 $h_{global}=rH_k^{local}+h_{local}$ 计算窗口断点,保证互补长程窗口跨 TP rank 不重叠,这是其 7.4×/8.6× 算子加速与 KV cache 按 rank 天然分区的前提。
联想记忆召回(Associative Recall)
衡量检索能力的合成任务:序列开头连续放置若干随机 key-value 对(如 256 对),后缀中的查询位置重复某个 key,模型须从上下文找回对应 value。绑定关系是随机的,无法靠语义捷径作答,准确率直接反映注意力机制存取任意 token 绑定的能力。
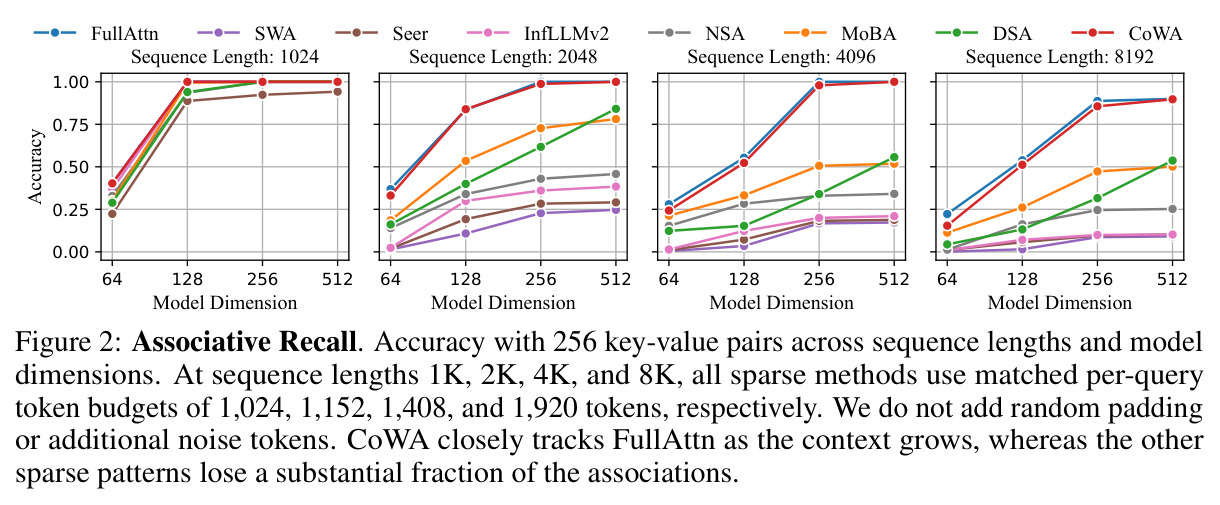
论文用它完成两组关键实验:窗口匹配消融(Table 1)隔离'互补分配'的因果贡献,受控对比(Figure 2)在匹配 token 预算下量化各稀疏方法的召回损失,是理解本文证据链的核心。
缩放律(Scaling Laws)与计算最优训练
描述语言模型质量(困惑度)随参数量、数据量与训练 FLOPs 幂律提升的经验规律;计算最优训练按给定算力选择模型大小与 token 数。评估时通常绘制困惑度对累计训练 FLOPs 的曲线,比较不同架构在同算力下的质量-效率权衡。
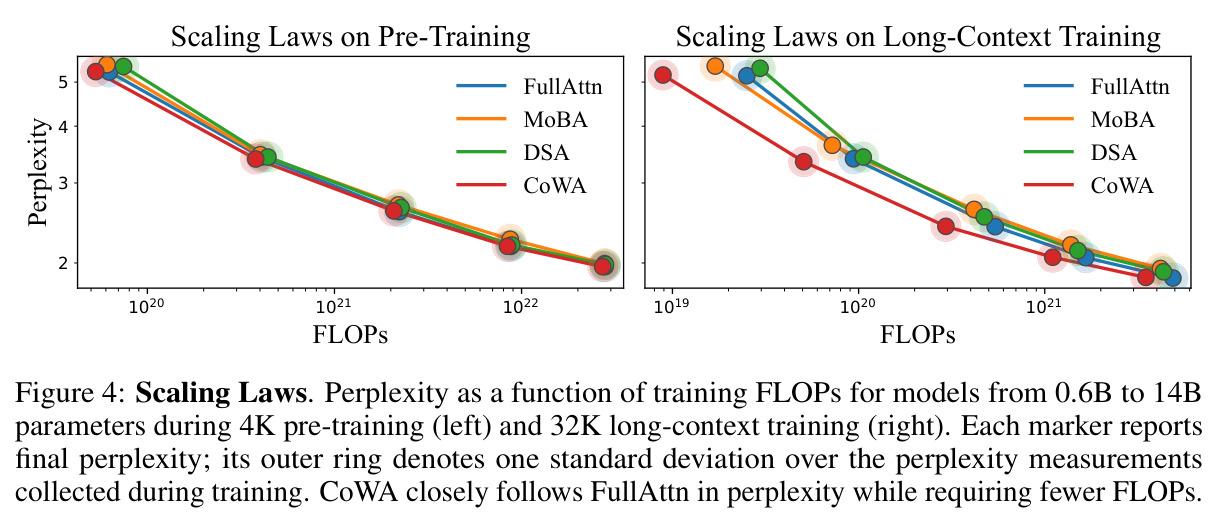
论文在 0.6B–14B 五个规模、4K 预训练 + 32K 长上下文两阶段上比较 CoWA 与基线(Figure 4);'FLOPs 更少、困惑度持平'的核心结论正是用这一范式表达的。
研究动机
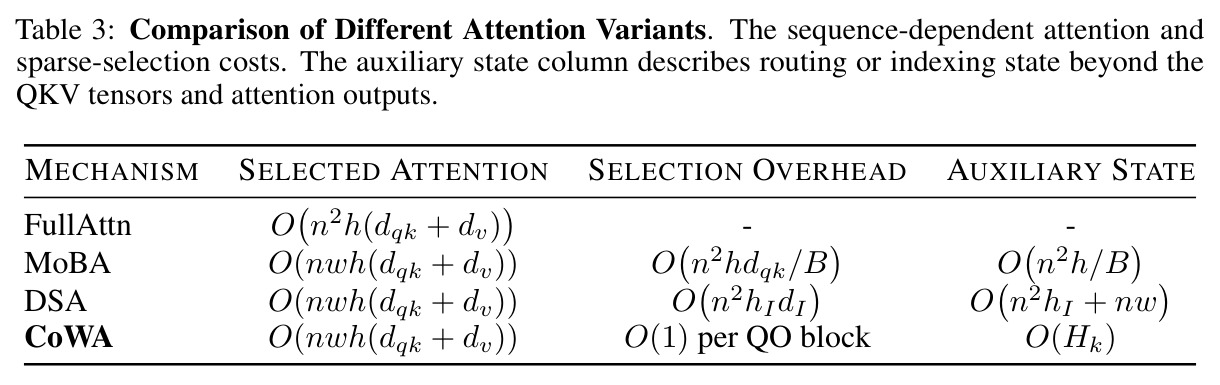
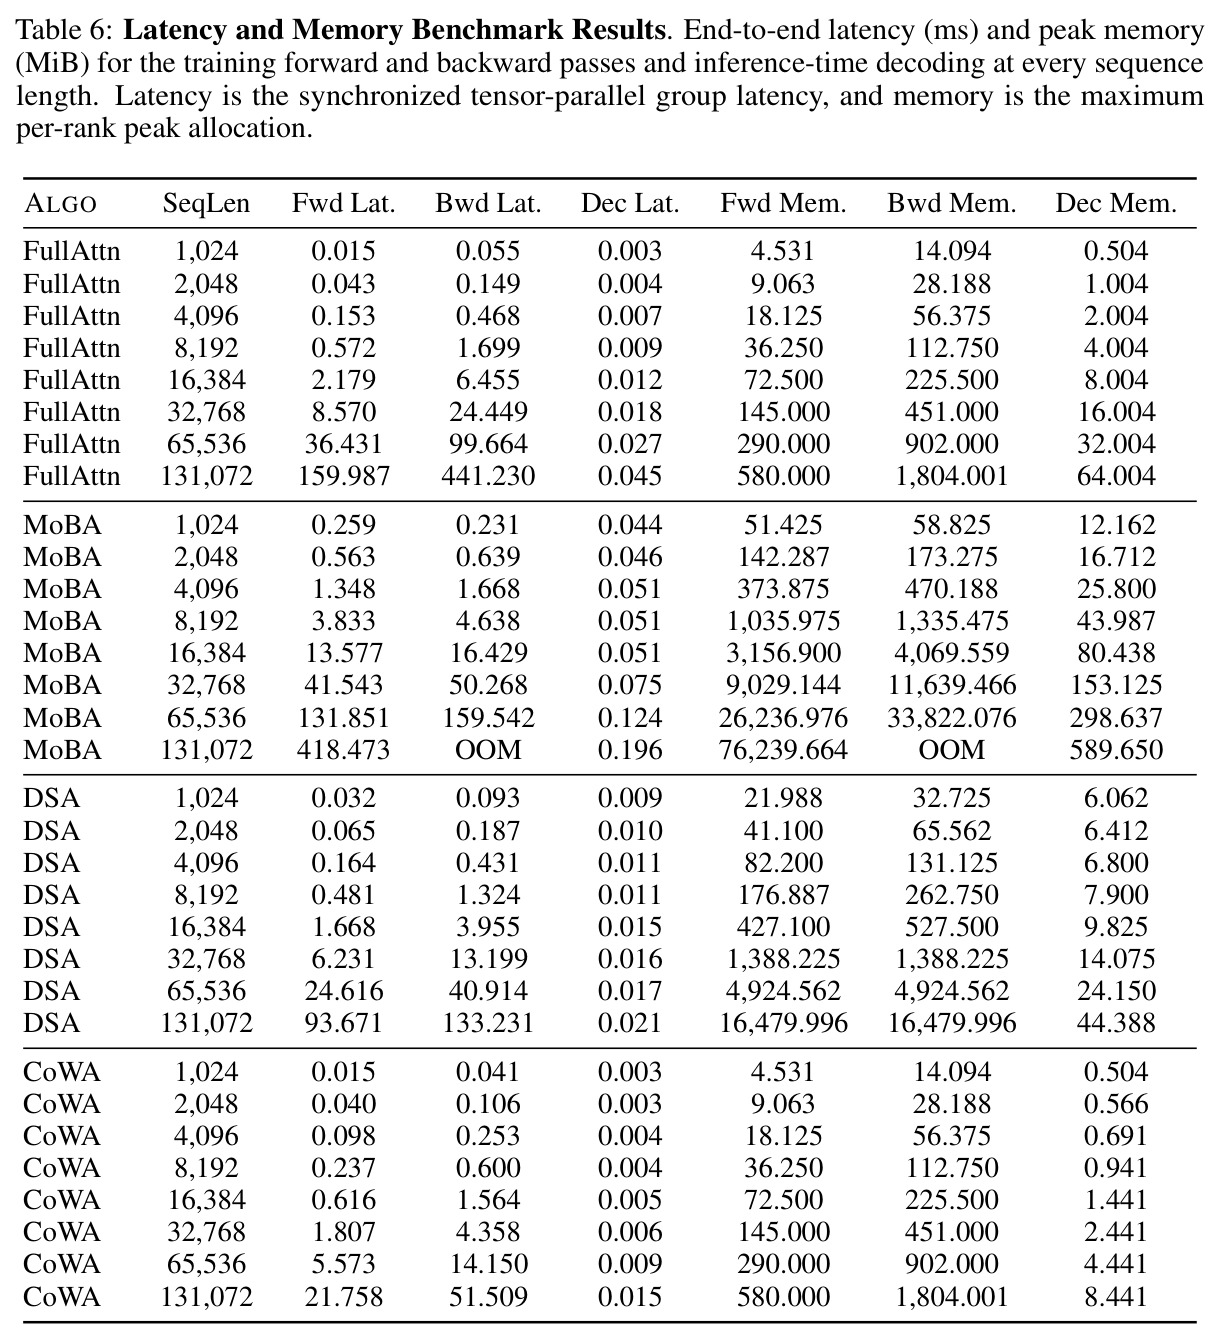
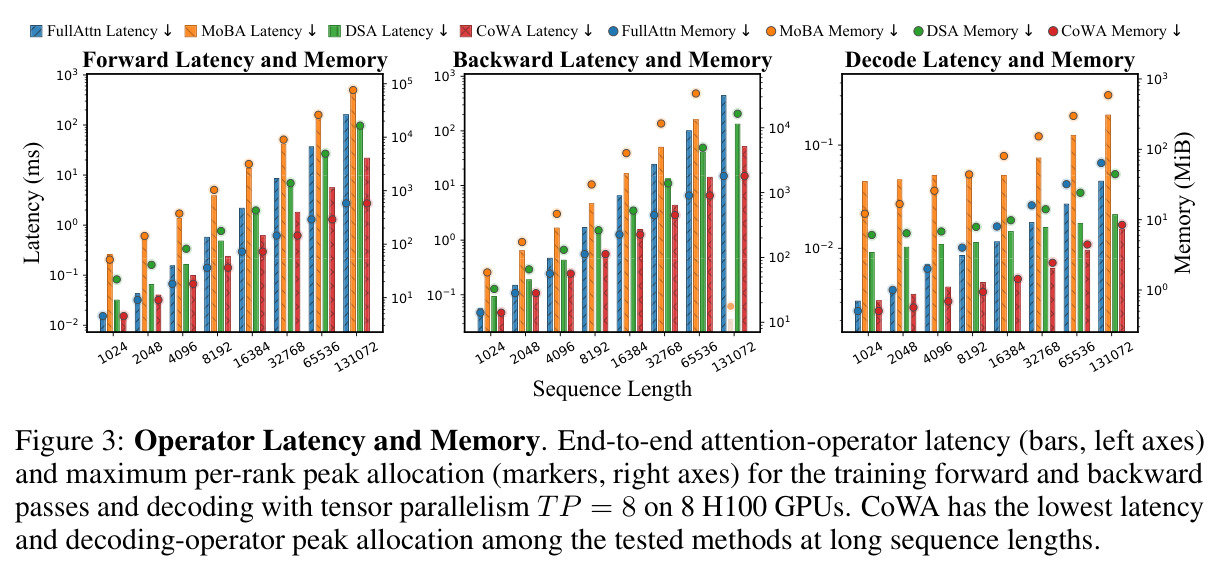
上下文长度正从数千 token 扩展到数十万(长文档理解、多轮推理、仓库级代码生成),注意力成为主要瓶颈。FlashAttention 解决了 IO 效率,但不改变注意力模式:全注意力(FullAttn)中每个头都重复访问完整因果前缀,长程 query-key 连接在所有头上大量复制。实测 128K 序列、TP=8 时 FullAttn 前向 159.99ms、反向 441.23ms。已有稀疏方案各有缺陷:SWA 对每头施加同样的有限视野,8K 联想召回仅 5.34%;全局 token/固定块模式只保留预定的稀疏长程路径;MoBA、DSA、NSA 等动态方法靠内容相关打分或路由选择 token/块,引入了独立的'选择问题'——MoBA 要做块池化、路由、TopK(选择开销 $O(n^2 hd_{qk}/B)$),DSA 的 lightning indexer 要给所有 query-key 对打分($O(n^2 h_I d_I)$),MoBA 在 128K 反向甚至 OOM;这些辅助结构还破坏了让稀疏注意力廉价的规则窗口结构。
本文的目标是本文目标是设计一种结构化注意力架构:每一层的头集合整体上仍能直接访问全部因果历史——每个因果位置至少被一个头看到(collective coverage),但每个头对远距离 token 保持稀疏;注意力模式完全由位置定义,无需学习路由器或索引器;训练与推理使用同一套窗口规则;窗口分配与 KV 头张量并行天然对齐。最终在保持语言建模困惑度、知识/推理评测和长程检索(RULER)性能的同时,显著降低训练 FLOPs 与训练/推理延迟。
与已有工作不同的是,以往稀疏注意力把'看到什么'当作每个头自身的属性:要么同质地限制视野(SWA),要么让各头基于内容各自选择(MoBA/DSA/NSA)。而已有对注意力头分工的观察(局部头/长程头、attention sink、头坍缩)暗示访问历史的职责天然是异质的。SPAttention 曾把因果距离区域分配给 MHA 头,但缺乏长上下文 GQA、自回归解码与张量并行执行的系统研究与评估。CoWA 的独特切入是把'完全因果覆盖'重新表述为头集合的集体属性,在 GQA 下用互补 KV 头窗口实例化,并通过窗口匹配消融把'互补性'与'窗口更大'剥离开来做因果验证,再以算子基准和缩放律系统量化收益。
核心方法
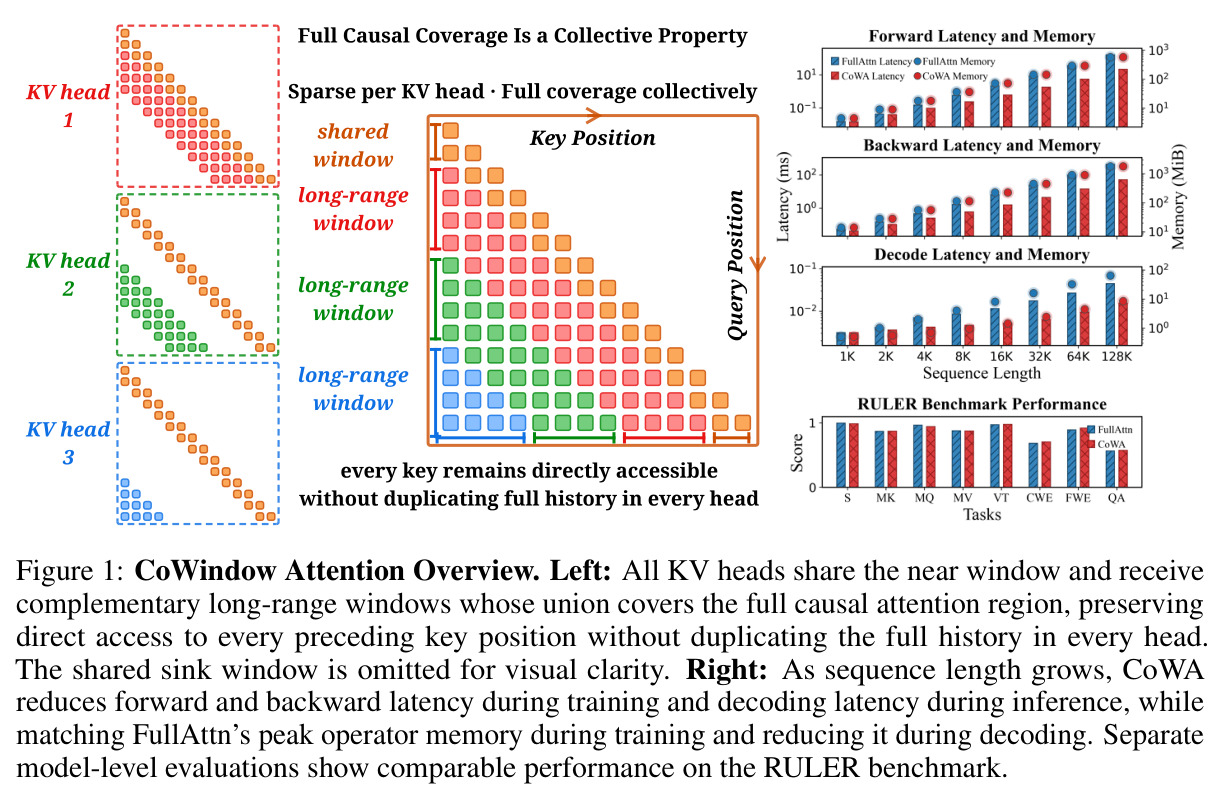
直觉:既然注意力头天然分工(有的专注局部、有的负责长程),让每个头都复制完整历史就是浪费。CoWA 给每个 KV 头分配三个窗口:所有头共享的近对角窗口 $W_{near}$(保留对最近上下文的直接访问)、共享的前缀 sink 窗口 $W_{sink}$(保持序列开头可见),以及头独有的长程窗口——把剩余因果距离 $[w_{near},\,N_k-w_{sink})$ 均匀切成 $H_k$ 段,断点 $b_{h_k}=\lfloor h_k L/H_k\rfloor$,$L=\max(N_k-w_{sink}-w_{near},0)$,每个 KV 头认领一段。三个窗口的并集覆盖完整因果前缀,即 $\bigcup_{h_k}A_{h_k}(i_q)=\{i_k:\delta(i_q,i_k)\ge 0\}$。技术路线上,窗口规则纯由位置决定,kernel 按头、按块只遍历可见块;输入/输出投影端到端训练,让模型学会跨头整合不同头取回的信息。
核心创新是把'完全因果覆盖'从头个体属性变为头集合的集体属性:单个头只看'近窗+sink+一段长程',但所有头的并集等于完整因果前缀。与 SWA 的本质区别:SWA 所有头的并集仍只有近窗,远距离内容不可直接访问;与 BigBird 式全局 token 的区别:长程访问是整段连续区间而非预定的稀疏点;与 MoBA/DSA/NSA 的本质区别:不依赖内容相关选择,没有路由器/索引器及其 FLOPs(每 QO 块仅 $O(1)$ 的范围计算),训练与推理模式完全一致。Table 1 的消融给出了因果证据:在每头窗宽完全匹配的条件下,8 个 KV 头使用 1/2/4/8 个不同长程窗(集体覆盖率 12.5%→100%)时,8K 召回从 21.32% 单调升至 89.73%——收益来自'互补分配'本身,而不是'某个头窗口更大'。
方法步骤详情
(1) 定义右下对齐因果距离 $\delta(i_q,i_k)=i_q+(N_k-N_q)-i_k$,训练与推理(含变长 prefill 与自回归解码)统一使用,$\delta\ge 0$ 即因果可见。(2) GQA 映射:QO 头 $h$ 使用 KV 头 $h_k=\lfloor hH_k/H_q\rfloor$ 的键值与窗口。(3) 构造可见键集 $A_{h_k}(i_q)=W_{near}\cup W_{sink}\cup W_{long}$:近窗 $\{0\le\delta< w_{near}\}$,sink 窗 $\{i_k< w_{sink},\ \delta\ge 0\}$,长程窗 $\{w_{near}+b_{h_k}\le\delta< w_{near}+b_{h_k+1}\}$。(4) 前向(Algorithm 1):QO 头 × QO 块并行,由窗口四元组 $(w_{sink},w_{near},b_{h_k},b_{h_k+1}-b_{h_k})$ 直接算出可见 KV 块集 $J_{h_k}(i)$,块外跳过,块内做 online softmax,仅跨界块需要 mask。(5) 反向(Algorithm 2):按 KV 块遍历逆关系 $I_{h_k}(j)$,用保存的 logsumexp $\ell$ 精确重构概率,AtomicAdd 汇聚 $dQ/dK/dV$,得到算子的精确梯度。(6) 解码:$N_q=1$,$\delta=N_k-1-i_k$,每步按当前 KV 长度更新断点,split-KV 程序并行再合并部分 softmax 状态。(7) 张量并行:全局头索引 $h_{global}=rH_k^{local}+h_{local}$,各 rank 只存本地 KV 头,窗口互补性跨 rank 保持。
技术新颖性
新颖性体现在三层。概念层:首次把'覆盖是集体属性'作为设计原则系统论证——用受控消融(Table 1)隔离互补性变量,用受控联想召回(Figure 2)在匹配 token 预算下与其他稀疏方法正面对比,而非只提出一种新模式;相比思想相近的 SPAttention(缺长上下文 GQA、解码与 TP 的系统实现),CoWA 补齐了从训练到部署的全链路。算法层:位置定义的稀疏使选择开销降为每 QO 块 $O(1)$、辅助状态仅 $O(H_k)$(Table 3),而 MoBA 为 $O(n^2 hd_{qk}/B)$、DSA 为 $O(n^2 h_I d_I)$;KV 头级总可见键数 $H_k(w_{sink}+w_{near})+L$ 相对稠密的 $H_k N_k$ 消除了跨头重复的长程连接。系统层:一套窗口规则同时驱动训练前向/反向、prefill、解码;窗口与 KV 头分片对齐,稀疏模式是训练架构的一部分(natively trainable),不是推理近似。
实验结果
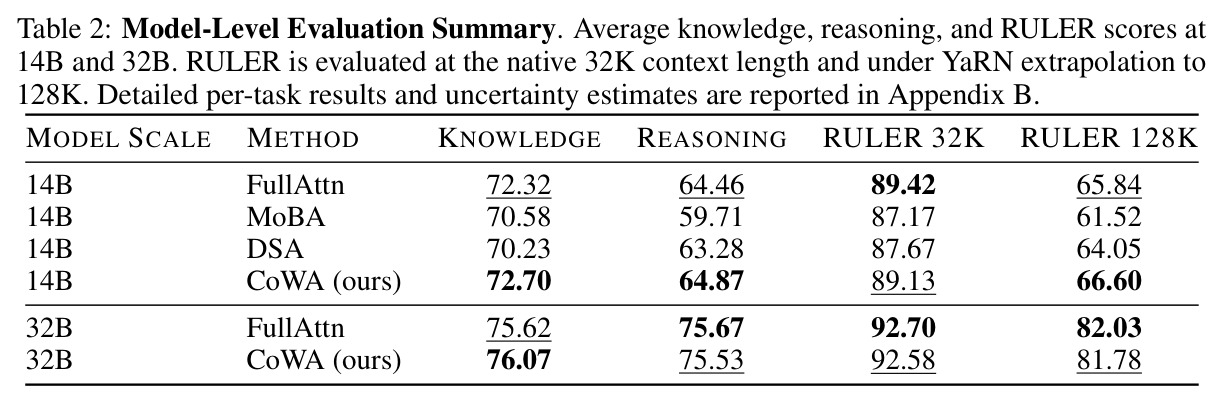
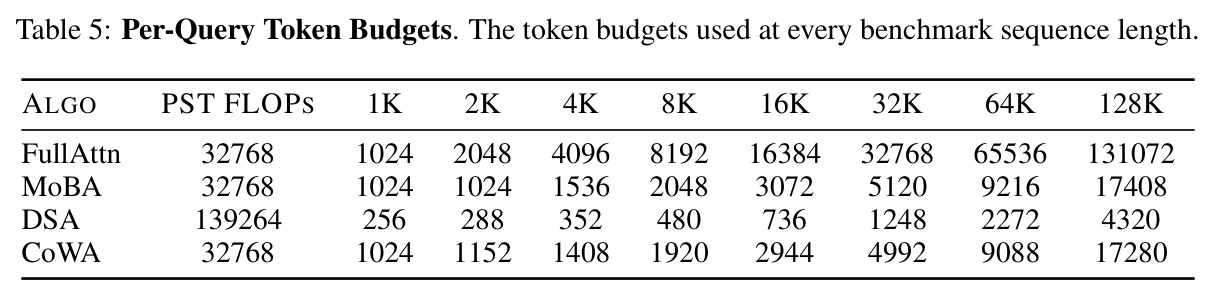
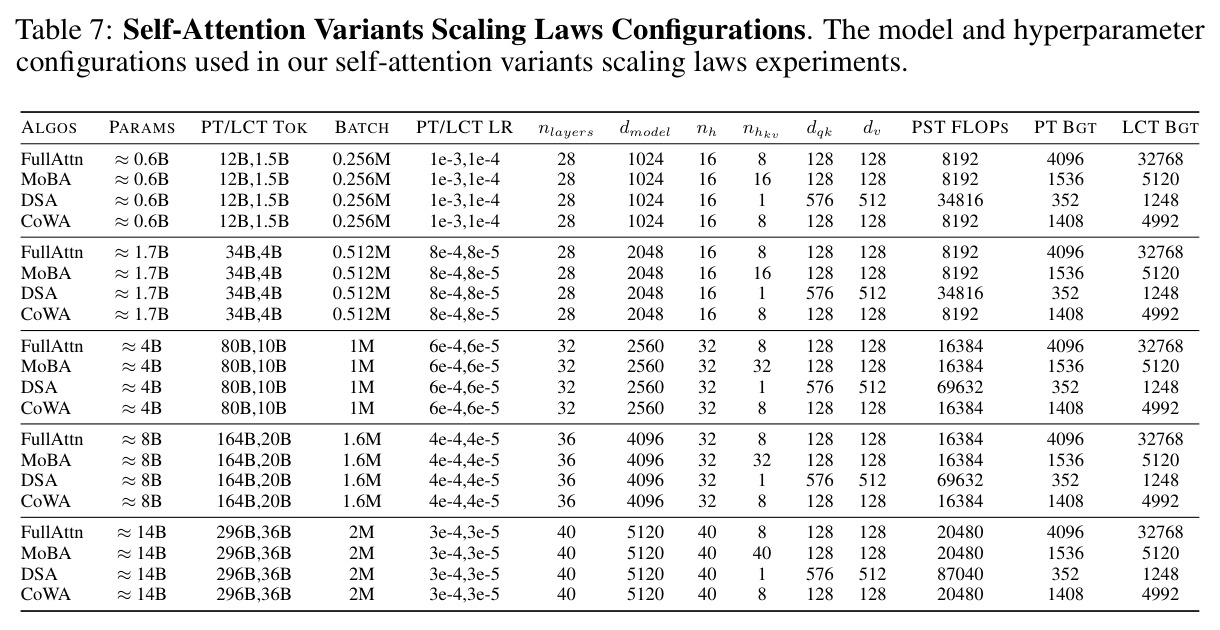
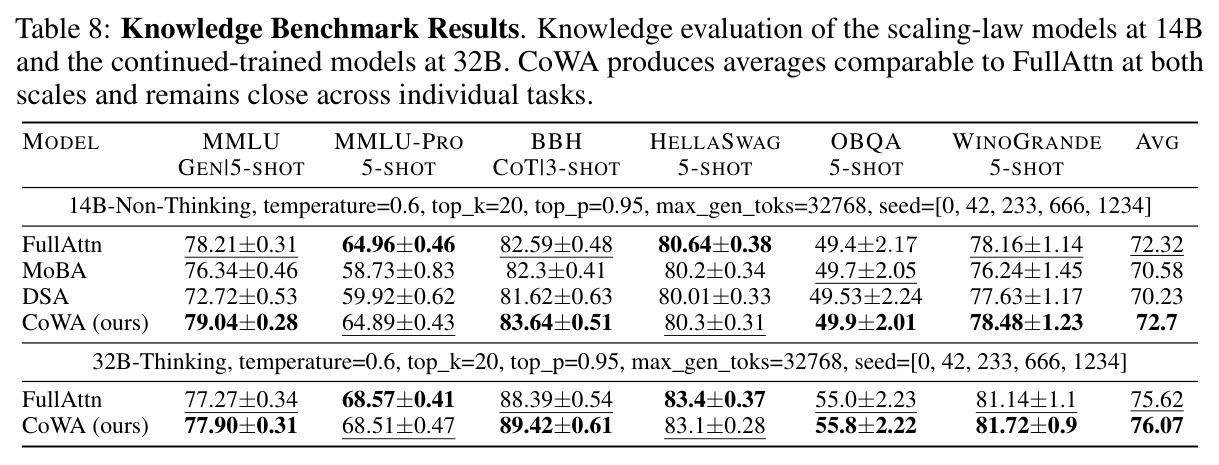
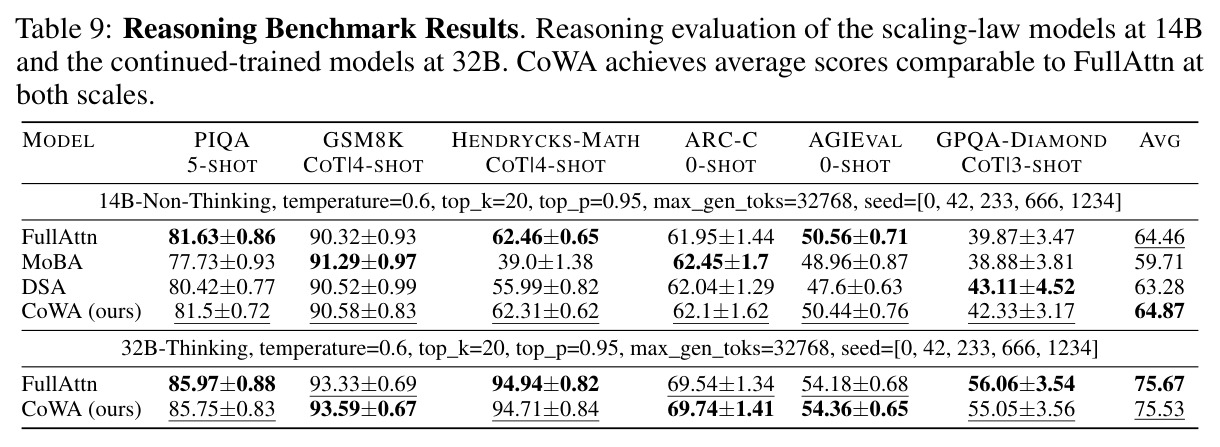
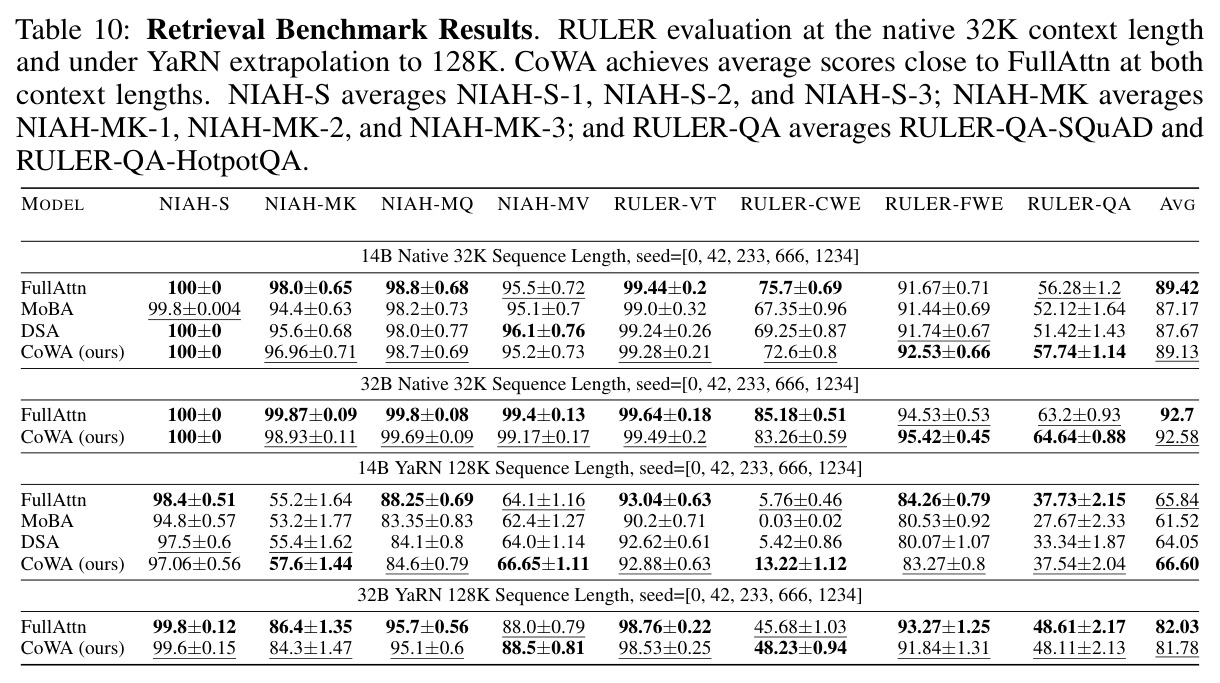
论文用五组实验支撑结论。(1) 窗口匹配消融(Table 1,8K,$d_{model}=512$):每头窗宽相同、只改长程窗互补度,覆盖率 12.5%/25%/50%/100% 对应 8K 召回 21.32%/32.92%/52.32%/89.73%,单调上升;CoWA 89.73% 几乎追平 FullAttn 的 89.97%,SWA 仅 5.34%。(2) 受控联想召回(Figure 2,256 个 KV 对,序列 1K–8K,模型维 64–512,稀疏方法匹配预算 1,024→1,920 token):8K/512 维下 CoWA 89.73%,DSA 53.71%、MoBA 50.12%、NSA 25.23%,SWA/Seer/InfLLMv2 停在 10% 左右;增大模型维度救不回其他稀疏方法的损失。(3) 算子基准(Figure 3,128K,TP=8,8×H100):CoWA 前向 21.76ms、反向 51.51ms、解码 0.015ms,对比 FullAttn 的 159.99/441.23/0.045ms,即 7.4×/8.6×/3.0× 加速;解码算子峰值内存 8.4MiB,比 FullAttn 低 7.6×;MoBA 128K 反向 OOM。(4) 缩放律(Figure 4,0.6B–14B,128×H100):14B 时 4K 预训练 FLOPs 省 3.1%、32K 长上下文省 28.5%,困惑度与 FullAttn 差 <0.01;每查询平均选中键数 $\bar{s}=1040.17$(4K)/2930.08(32K)。(5) 模型级评测(Table 2):14B 知识 72.70 vs 72.32、推理 64.87 vs 64.46、RULER-32K 89.13 vs 89.42、YaRN-128K 66.60 vs 65.84;32B 继续训练后为 76.07/75.53/92.58/81.78 vs 75.62/75.67/92.70/82.03,总体持平。
局限与改进
作者承认:完全覆盖只保证'直接访问',不保证每个头产生与 FullAttn 相同的头特定交互与输出;等宽长程分配使训练时各头工作量不均(早位置受因果裁剪与重叠影响),等面积分配留作未来工作;跨头分解要求 $H_k>1$,$H_k=1$ 时退化为稠密注意力;固定 $H_k$ 下全序列注意力仍是平方复杂度,只是常数更小;窗口感知的 KV offloading/预取尚未实现,TP>$H_k$ 时会复制逻辑 KV 头。我的补充观察:其一,模式静态、与内容无关,若某查询需要密集访问多个分属不同头的远距区间,单头各自只能取回一段,整合负担转移到投影层与上层——14B 下 RULER 的 NIAH-MQ 84.6 低于 FullAttn 的 88.25,而 CWE 反而 13.22 vs 5.76,说明存在任务级权衡而非全面持平;其二,联想召回是合成任务,真实长文档上的收益还需更多验证;其三,与 MoBA/DSA 的对比采用近似 FLOPs 匹配(PST FLOPs 对齐、不含路由开销),并非严格等算力;其四,实验规模止于 14B/32B 与 128K 上下文。
独立分析的弱点
第一,静态位置窗口对内容不敏感:若某查询需要密集访问多个分属不同头的远距区间,各头只能取回自己那一段,组合负担压在投影与上层——改进方向是引入轻量的断点调度学习(仍保持规则结构),或按层交错断点偏移使不同层的集体覆盖更均匀。第二,训练负载不均:sink/近窗每个头都要算,长程窗只归一头,且早位置的因果裁剪让远端窗头闲、近端窗头忙——改进方向是等面积分配或按期望工作量的调度(作者已列为未来工作)。第三,每头仅一段连续长程窗,无法在同一头内覆盖两个分离的远距区间,多针检索场景可能受限——可扩展为每头多段窗口或可学习断点。第四,$w_{near}$、$w_{sink}$ 与每查询预算(如 32K 下 4,992)是手工超参,不同规模/数据是否需要不同配置缺乏研究——可随缩放律自适应或训练中退火。第五,依赖自定义 Triton kernel,生态接入成本高——可与 FlexAttention/FlashInfer 集成降低使用门槛。
未来方向
作者明确提出的方向:窗口感知的 KV cache offloading 与预取以减少 HBM 常驻 KV 存储;训练阶段的等面积(负载均衡)长程分配。基于本文成果可延伸:与 KV cache 压缩/量化/检索正交组合进一步降显存(作者指出这些方向与本设计正交);跨层使用不同断点偏移实现更均匀的集体覆盖;把每头单段长程窗推广为多段或可学习断点;在 >32B 规模与 >128K 上下文验证缩放趋势是否保持;把'集体覆盖'原则迁移到多模态 Transformer、线性注意力混合架构或 MoE 注意力;从理论上刻画'集体覆盖 + 端到端投影训练'能保留 FullAttn 的哪一类计算,为窗口设计给出原则性指导。
复现评估
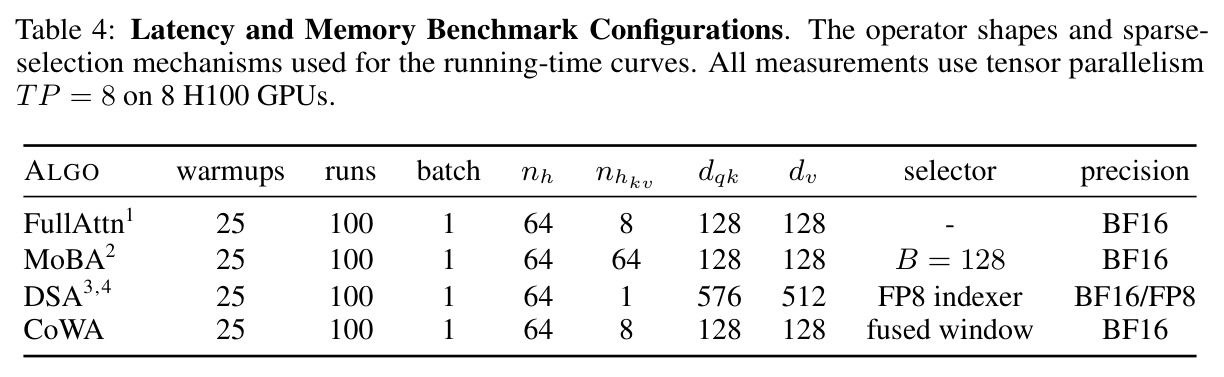
复现条件较好。代码已在 flash-sparse-attention 仓库开源;附录 A 极为详尽:Table 4/5 给出算子基准的形状、精度、选择器与每档序列长度的 token 预算,Table 7 给出 0.6B–14B 全部架构与超参(层数、隐层、头数、学习率、batch、PT/LCT token 数),训练 seed=42,评测用 5 个 seed(0/42/233/666/1234)报告均值与标准差;联想召回提供完整构造(256 个 KV 对、250K 训练/1K 测试样本、100 epochs、$p(t)\propto t^{a-1}$ 采样);数据(SmolLMCorpus)与 tokenizer(Qwen3)公开。算力门槛:算子基准需 8×H100(TP=8);0.6B 档(12B token 预训练)中小团队可复现;完整缩放律需 128×H100;32B 继续训练(64B token、32K 序列)门槛最高。总体小规模复现难度中等,全量复现成本高但信息完备。
论文图表
控制变量实验:8 个 KV 头的每头窗宽完全相同,只改变不同长程窗口的数量(1/2/4/8 个,集体覆盖率 12.5%/25%/50%/100%),报告 1K–8K 联想召回准确率。8K 下覆盖率递增对应 21.32%→32.92%→52.32%→89.73% 的单调提升;CoWA(8 窗)89.73% 几乎追平 FullAttn 89.97%,SWA 仅 5.34%。
全文最关键的因果证据:把'互补分配'与'窗口更大'两个因素剥离,证明收益来自集体覆盖本身,直接回答'为什么是集体属性'这一标题问题。
前向伪代码:QO 头 × QO 块两级并行;由窗口四元组 $(w_{sink},w_{near},b_{h_k},b_{h_k+1}-b_{h_k})$ 计算可见 KV 块集 $J_{h_k}(i)$,按序仅访问这些块,块内计算 $S=QK^ op$ 并在边界做因果/窗口 mask,用 online softmax($m$、$\ell$ 状态)累计输出 $O$,最后归一化并返回 logsumexp。
CoWA 的工程核心:展示位置定义稀疏如何直接嵌入 FlashAttention 式 kernel——可见块在 QK 计算前就被跳过,这是 7.4× 前向加速的实现基础。
反向伪代码:QO 头 × KV 块并行,遍历前向可见集的逆关系 $I_{h_k}(j)$;用前向保存的 logsumexp $\ell$ 精确重构概率 $P=\exp(S-\ell)$,计算 $dP$、$dS$ 并更新 $dV$、$dK$,对来自多个 KV 块/同组 QO 头的贡献用 AtomicAdd 汇聚,返回精确梯度。
证明 CoWA 是可端到端精确训练的算子而非近似:梯度的数学正确性 + 稀疏遍历共同支撑'原生可训练稀疏注意力'的主张与训练实验的可信度。