SLCA-GRPO:解决工具调用强化学习中的跨段信用错误归因 SLCA-GRPO: Resolving Cross-Segment Credit Misattribution in Tool-Calling RL
把工具段与总结段的优势组内归一化并分段路由,消除GRPO信用混淆
前置知识
GRPO(组相对策略优化)
一种 on-policy RL 算法:对每个指令采样一组(G 条)轨迹,用组内奖励的均值和标准差把奖励归一化为优势 $\hat{A}_i=(R_i-\mu_g)/(\sigma_g+\epsilon)$,从而无需训练价值网络。它默认把这一个轨迹级标量优势广播给轨迹中的所有 token。
本文诊断的对象和改造的基线正是 GRPO,SLCA 的全部改动都发生在其优势计算环节,理解 GRPO 的归一化机制才能看懂污染从何而来。
优势函数与信用分配
优势函数衡量某个动作/ token 相对组内期望的好坏;信用分配问题是决定轨迹最终回报应归功或归咎于哪些具体 token 或步骤。奖励在任何聚合之后再算优势,噪声就会扩散到所有 token 上。
论文的核心论点:GRPO 把总结段奖励的波动混入工具 token 的优势(跨段信用错误归因),SLCA 就是要在归一化和路由两步把这个通道切断。
工具调用智能体的异构输出
LLM 智能体通过生成结构化工具调用(函数名 + 参数)与环境交互,最后生成面向用户的自然语言回答,一条轨迹 $y=y^{tool}\oplus y^{sum}$ 里结构化片段与自由文本交错出现。
这种天然的两段式异构结构是本文分段路由的前提:没有清晰的结构边界,就无法把不同来源的奖励锁定到对应的 token 集合上。
过程奖励与结果奖励
结果奖励只在轨迹终点判断最终答案对错,信号稀疏;过程奖励对中间步骤(这里是工具调用是否正确、高效)给出稠密打分。两者常被简单相加成 $R_{total}=R^{tool}+R^{sum}$ 后再统一估计优势。
HierR 分层奖励把两类信号分开生成,但关键在于 SLCA 证明:奖励分开还不够,必须在优势估计前阻止二者聚合,否则污染仍在。
PPO-clip 目标
PPO 用重要性比率 $\rho_{i,t}=\pi_\theta/\pi_{old}$ 的截断限制单次更新幅度:$J=\mathbb{E}[\min(\rho\hat{A},\text{clip}(\rho,1-\epsilon,1+\epsilon)\hat{A})]$,通常再加 KL 惩罚约束对参考模型的偏移。
SLCA-GRPO 的最终训练目标就是把 PPO-clip 中的统一优势替换成分段路由后的 $\hat{A}^{SLCA}_{i,t}$,算法主体(截断、KL)完全不变。
工具环境模拟器
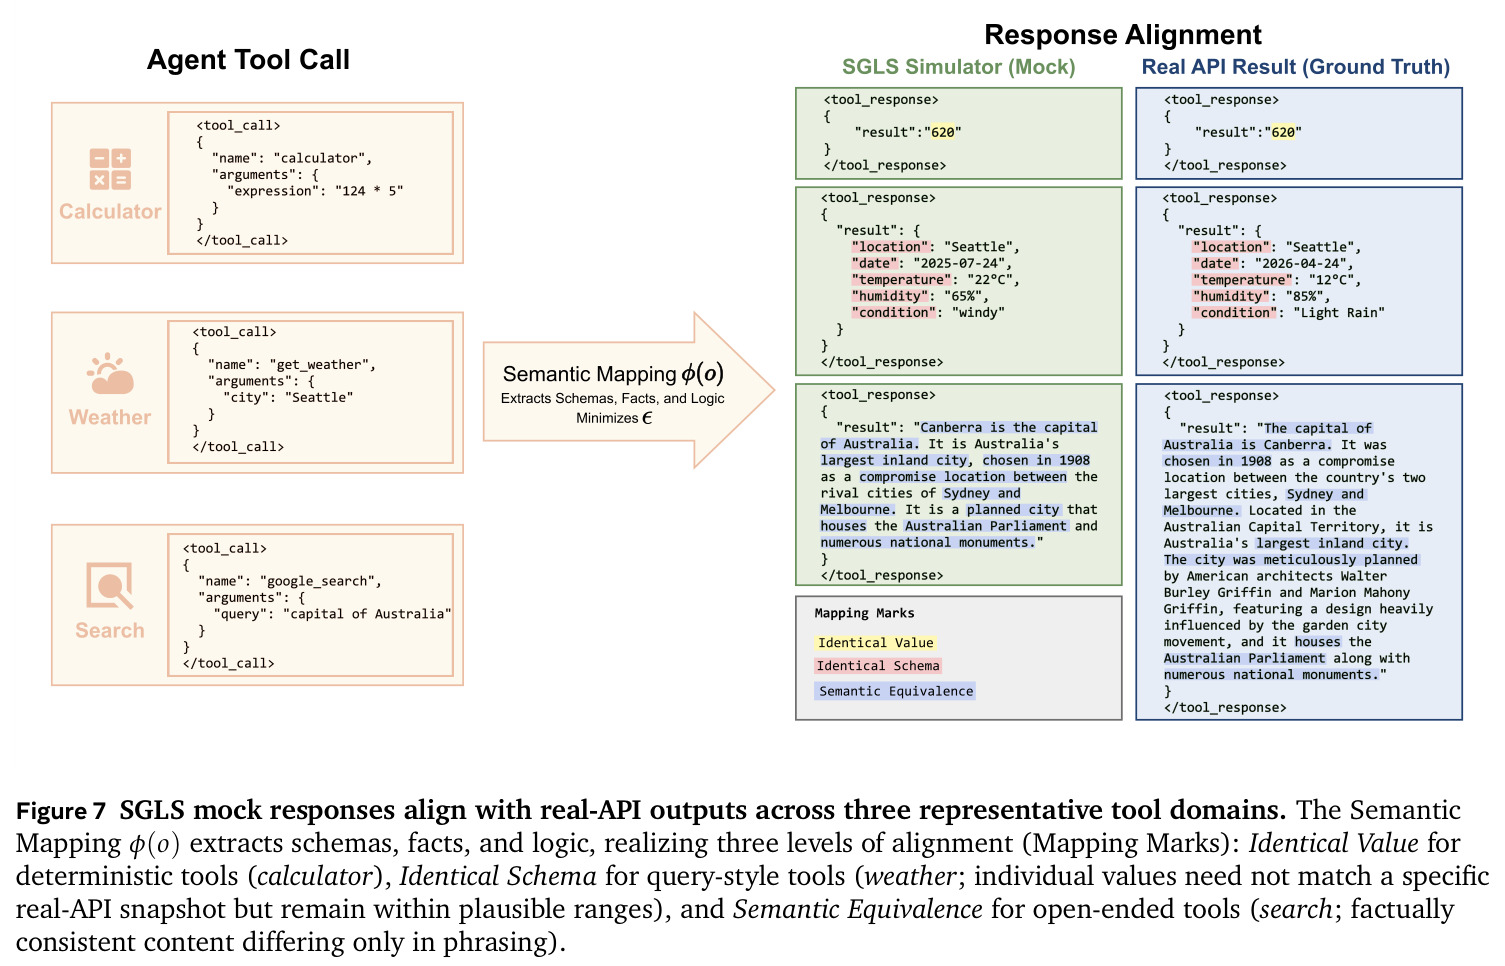
RL 训练工具智能体需要海量环境交互,真实 API 昂贵、不稳定且难以批量获取。LLM 模拟器依据工具 schema 生成合理且格式一致的模拟响应,让策略能大规模试错。
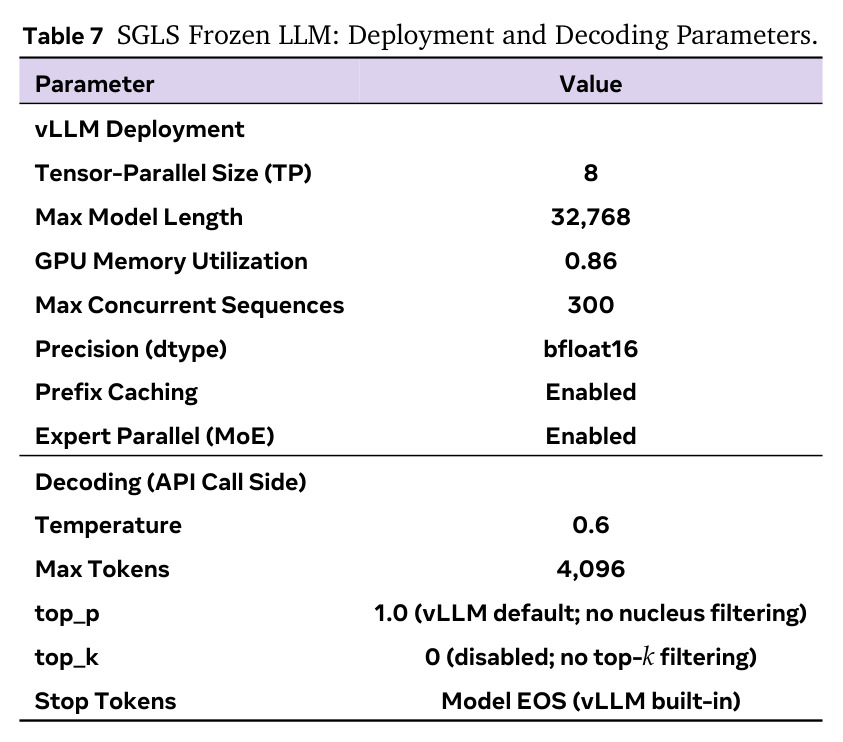
论文的 SGLS 用 schema 做确定性校验加冻结跨家族 LLM mock,是可扩展探索的基础设施,也是消融实验的组成部分之一。
研究动机
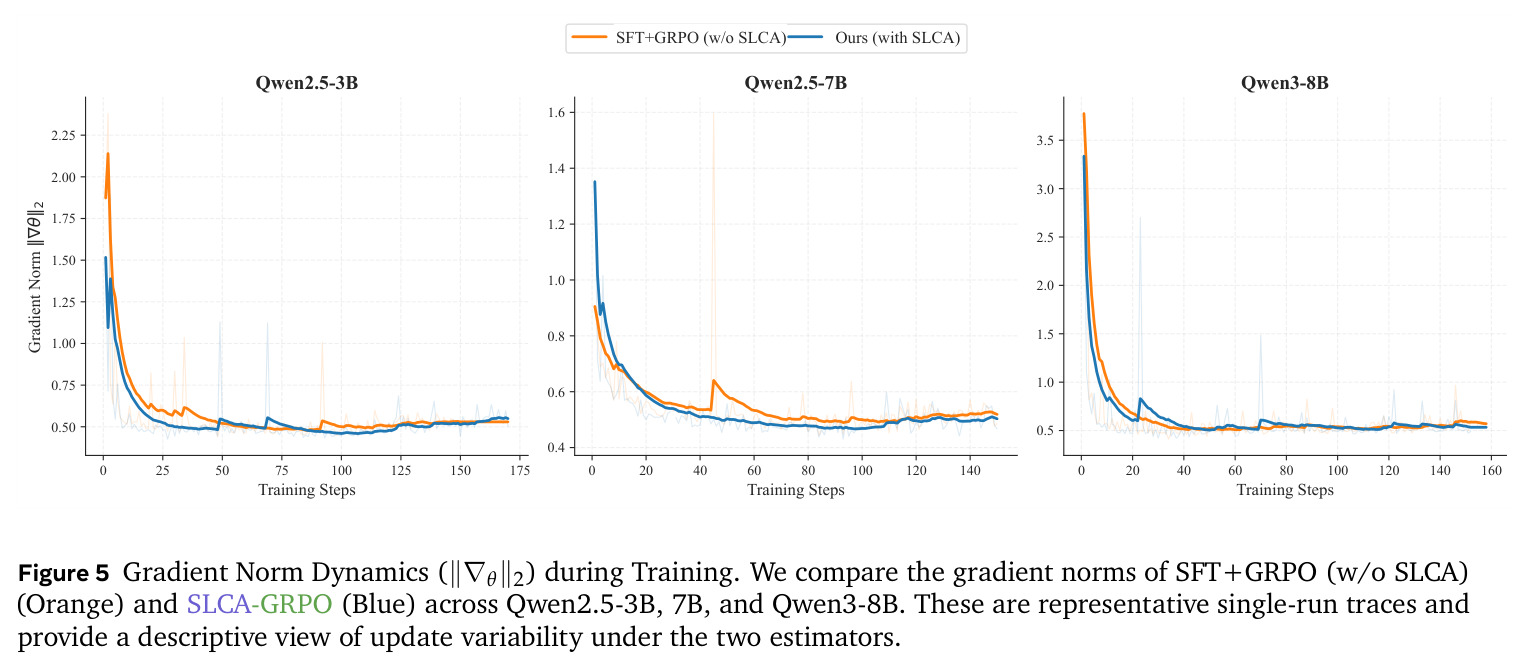
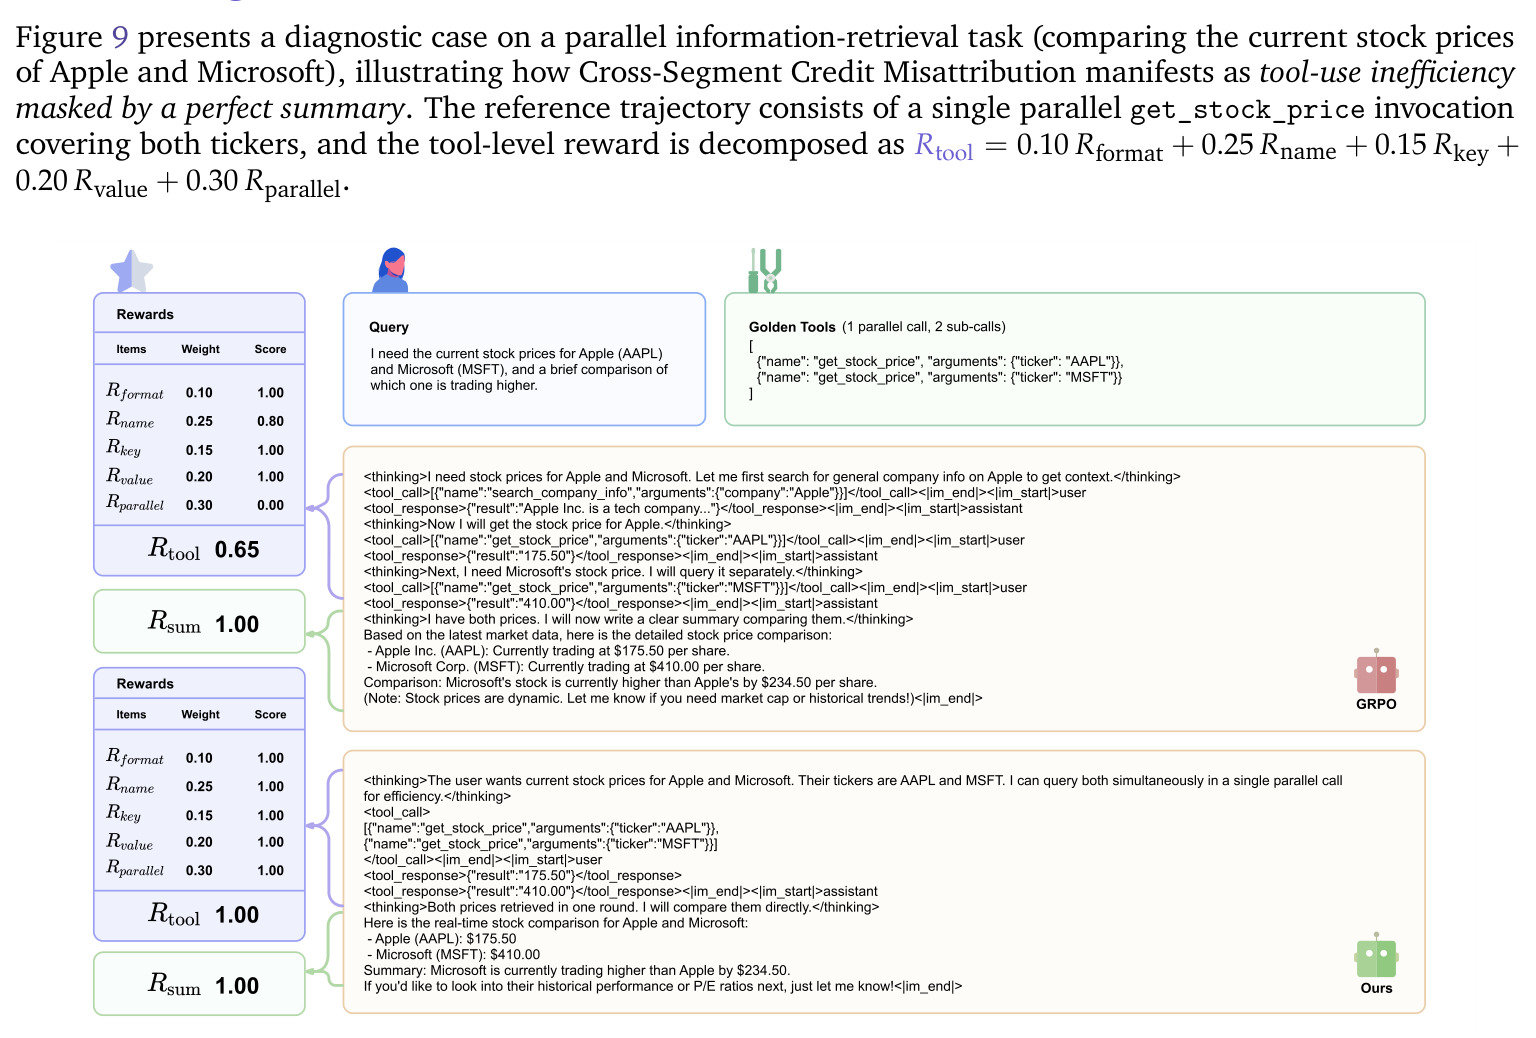
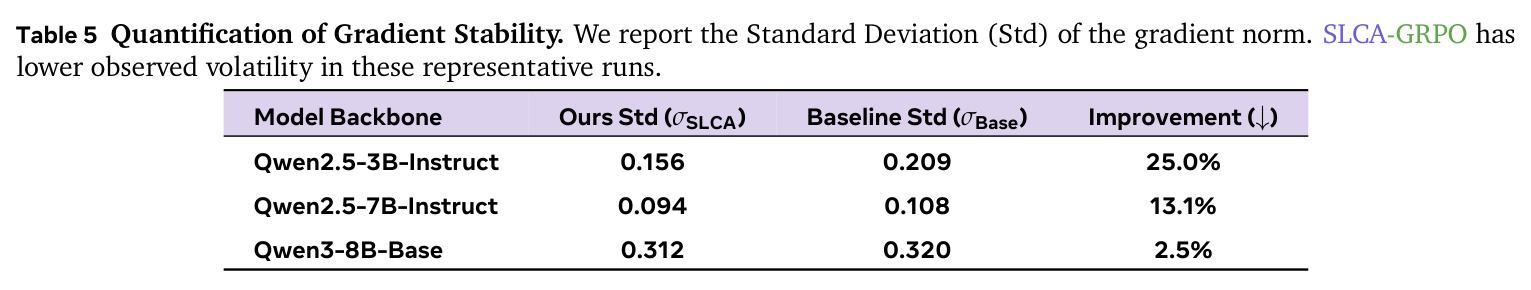
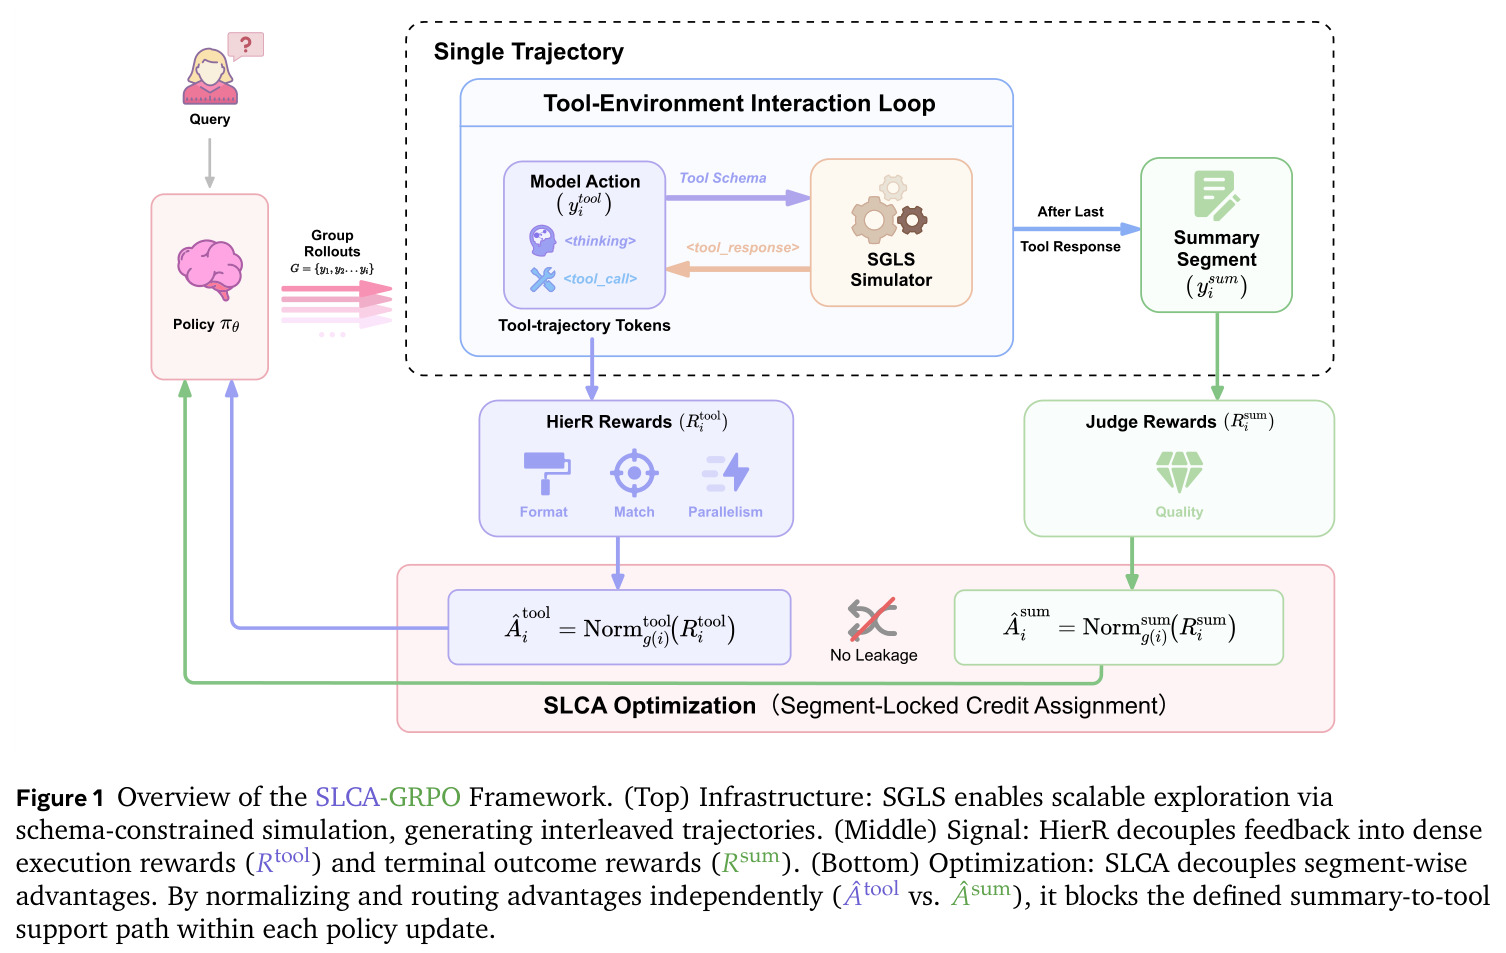
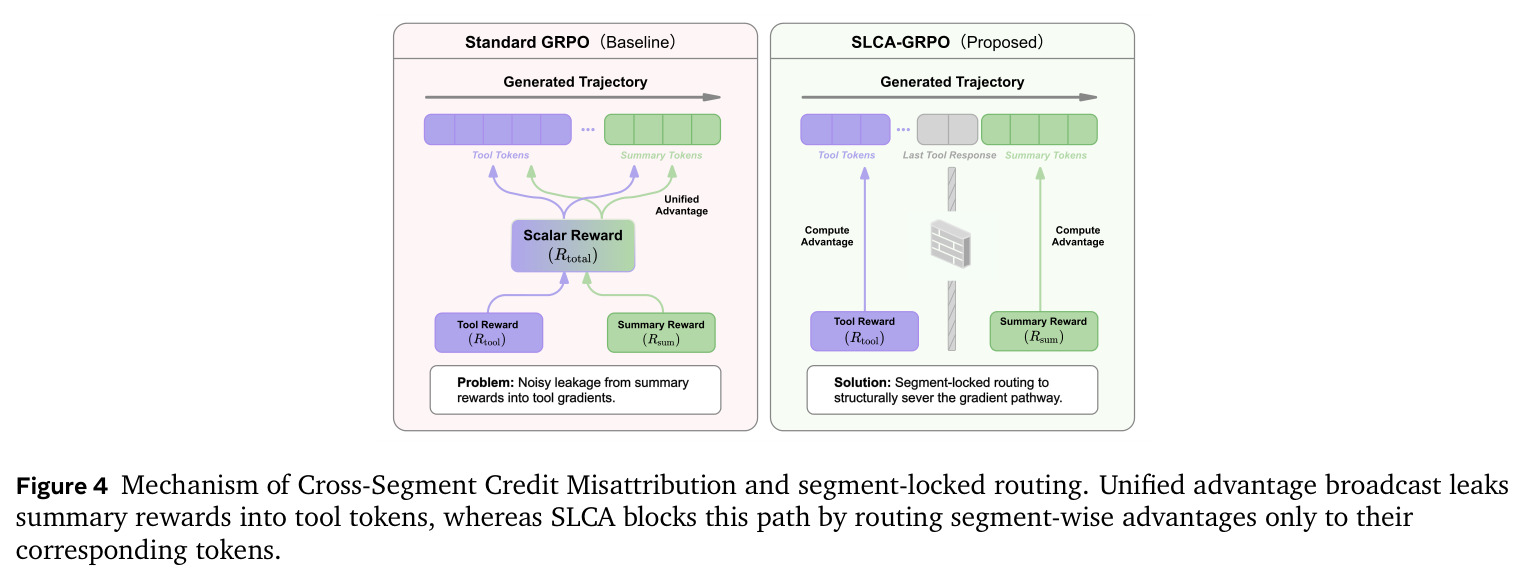
工具调用智能体的输出是异构的:一条轨迹 $y=y^{tool}\oplus y^{sum}$,前面是推理链与结构化工具调用,最后是面向用户的自然语言总结。标准 GRPO 把整条轨迹的统一标量优势广播给所有 token,于是总结奖励的波动会直接泄漏进工具决策 token 的梯度,造成跨段信用错误归因。论文的诊断案例显示:一次多余的工具调用配上正确的送达总结会被整体奖励,而证据正确的工具轨迹配上错误的退款结论反而被惩罚;梯度诊断还发现训练不稳定尖峰出现时,工具与总结的梯度方向接近正交——不稳定来自优势污染而非梯度方向冲突。已有方案都没有堵住这条通道:VinePPO、GiGPO、SPO 只做时间步级信用但仍保留聚合的 $R_{total}$;ToolPO 加入局部工具奖励,总结噪声仍能到达工具 token;RLTR 干脆把规划器与总结器拆成两个模型,放弃了统一骨干。
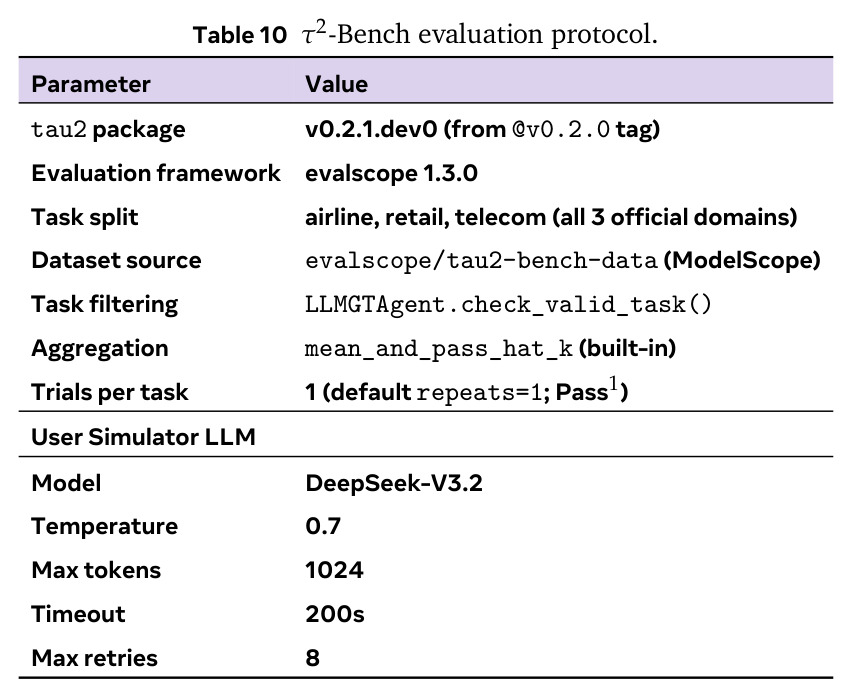
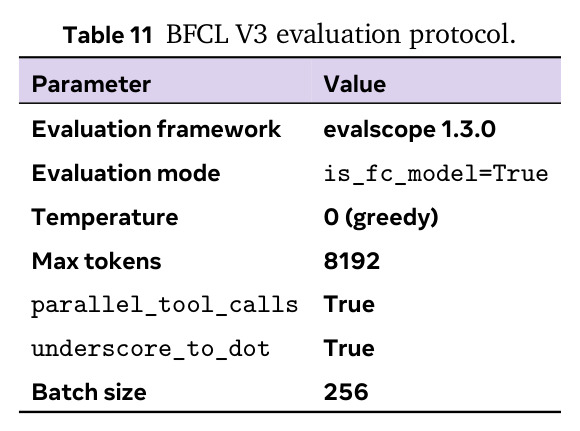
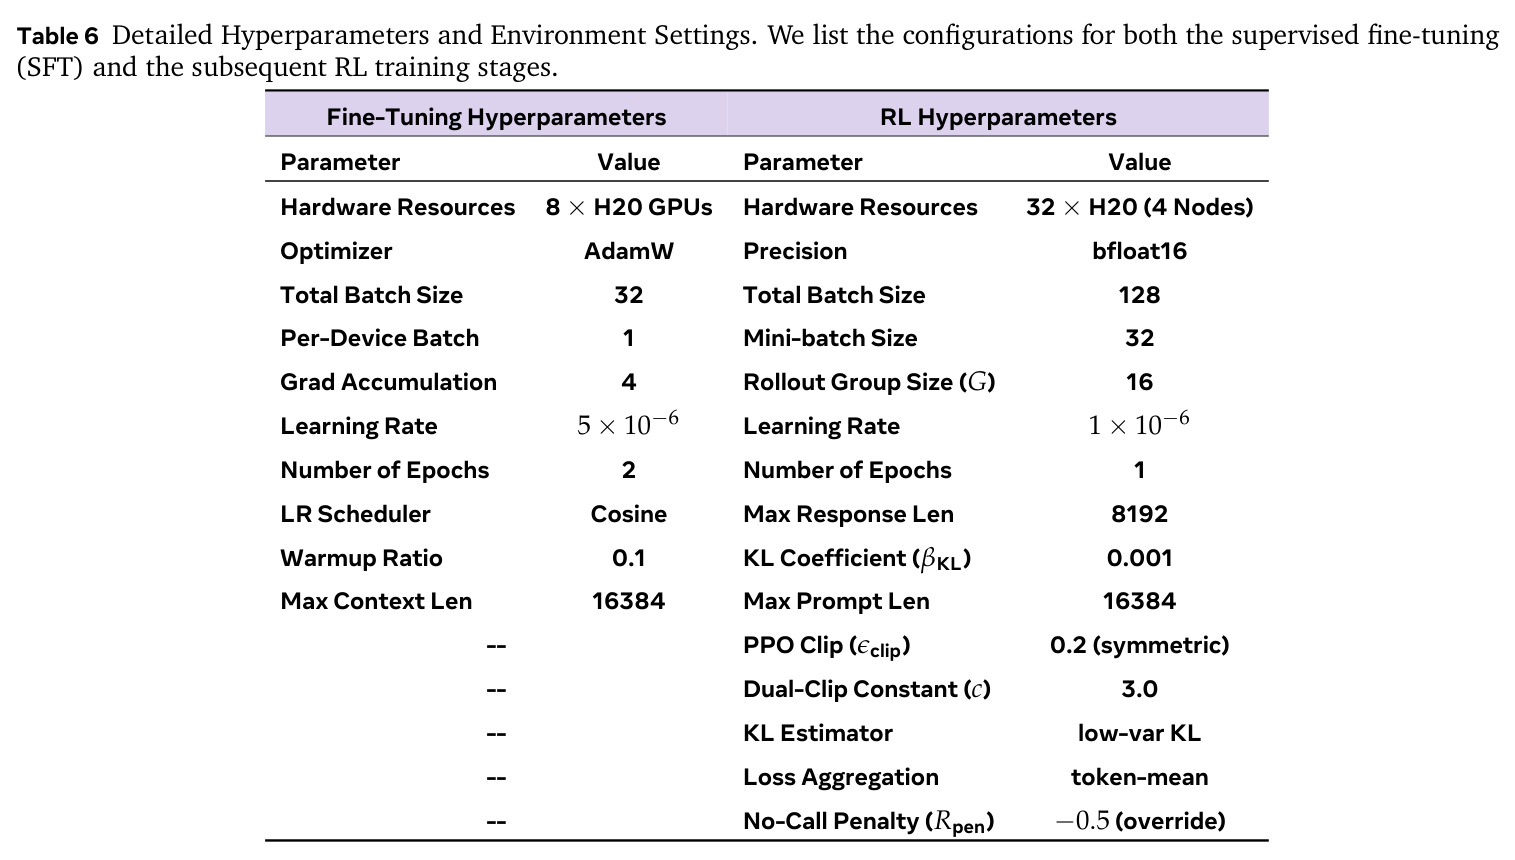
本文的目标是目标是结构性地消除跨段优势污染:在不增加任何额外 rollout、不拆分模型、保持单一统一策略的前提下,让工具 token 只由执行质量更新、总结 token 只由回答质量更新,并验证这种校正能转化为跨规模、跨基准的可测量收益。具体量化目标是在完全匹配的训练预算下(同数据划分、同 SFT 初始化、同 SGLS 环境与 mocker 配置、同 HierR 奖励定义、组大小 $G=16$、单个 RL epoch、三个 run 取均值),相对匹配的 SFT+GRPO 在域内 Toucan-Test、跨分布的 BFCL V3、协作鲁棒的 τ2-Bench 上取得一致提升,同时降低工具调用冗余与成本。
与已有工作不同的是,本文的独特切入是沿结构轴做信用分配。现有方法几乎都沿时间轴细化(VinePPO/SPO/GiGPO 把轨迹按步骤分组),但它们在优势估计前仍保留 $R_{total}$,总结噪声照样进入每一步;SLCA 沿「执行 vs 表达」这条与时间轴正交的结构轴,在同一条 rollout 的组内分别归一化并路由优势,因此与时间轴方法理论上可组合而非互相替代。作者还明确这是偏方差的取舍:SLCA 不否认工具调用对最终答案的因果作用,而是假设稠密的执行奖励是更新工具 token 的低方差且信息充分的信号,总结奖励只负责训练表达段。相比之下,加性方案(ToolPO)在估计前混合信号,分离式方案(RLTR)牺牲统一骨干,SLCA 是首个在统一策略内、零额外 rollout 成本下按结构段锁定信道的方案。
核心方法
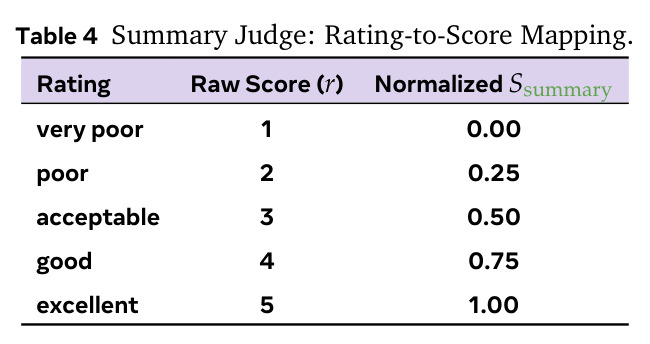
直觉上,轨迹天然分成「干活」和「汇报」两段,那就把奖励、优势、梯度全部按段切开。技术路线四步:(1) 结构显式化:用梯度掩码 $m_{i,t}$ 区分可学习 token 与冻结的环境上下文,确定式地把可学习 token 切成工具段 $T^{tool}$(最后一次工具响应前的全部学习 token)与总结段 $T^{sum}$(最后一段连续学习 token);(2) 分段奖励:HierR 把回报分解为 $R(y)=R^{tool}+R^{sum}$,前者是稠密 schema 匹配过程分 $S^{process}$,后者是终局 LLM 裁判总结分 $S^{summary}$;(3) 分段优势:SLCA 在组内分别归一化 $\hat{A}^{tool}_i=(R^{tool}_i-\mu^g_{tool})/(\sigma^g_{tool}+\epsilon)$($\hat{A}^{sum}_i$ 同理),再按 token 所属段路由;(4) 训练环境:SGLS 用 schema 约束的 LLM 模拟器替代真实 API,最终以带 KL 惩罚的 PPO-clip 目标训练统一策略。
核心创新是分段锁定的优势路由:把 GRPO 的单一标量优势替换成按 token 语义角色分配的 $\hat{A}^{SLCA}_{i,t}$——工具 token 拿 $\lambda_{tool}\hat{A}^{tool}_i$,总结 token 拿 $\lambda_{sum}\hat{A}^{sum}_i$,环境 token 为 0。它只改变每个 token 挂的标量优势,不改模型结构、不需要从中间状态重采样。理论上每步更新满足优势隔离:$\partial g^{SLCA}_{tool}/\partial R^{sum}=0$,即工具 token 的梯度与总结奖励完全无关;局部 score-function 分析进一步表明 SLCA 从工具更新中移除了一个正的总结噪声方差项,并在符号冲突场景下保住工具执行方向。与已有方法的本质区别在于:PRM、ToolPO 等加性方案在优势估计之前就聚合 $R_{total}$,污染通道依然存在;SLCA 同时在归一化(分开算均值方差)和支持域(token 只接收本段优势)两个层面切断污染,这是「聚合后再细分」的方法在结构上做不到的。
方法步骤详情
(1) 采样:每条指令 $x$ 在 SGLS 中生成 $G=16$ 条轨迹,schema 确定性校验拦截非法调用、冻结跨家族 LLM mock 生成合理响应;(2) 掩码:可学习 token 置 $m_{i,t}=1$,环境 token 置 0;(3) 分段:最后一次工具响应后的最后一段连续学习 token 为总结段,其余学习 token 归工具段;(4) 打分:$R^{tool}_i=S^{process}(y^{tool}_i)$ 覆盖格式、金标匹配,$R^{sum}_i=S^{summary}(y^{sum}_i\mid y^{tool}_i,o_i)$ 由 LLM 裁判打分;(5) 路由:组内分别归一化后按式 (3) 构造 $\hat{A}^{SLCA}_{i,t}$,并用存在性过滤等机制处理稀疏轨迹;(6) 更新:以 $\sum m_{i,t}\min(\rho\hat{A}^{SLCA},\text{clip}(\rho,1\pm\epsilon)\hat{A}^{SLCA})$ 的 PPO-clip 目标更新,外加 $\beta$ KL 惩罚。
技术新颖性
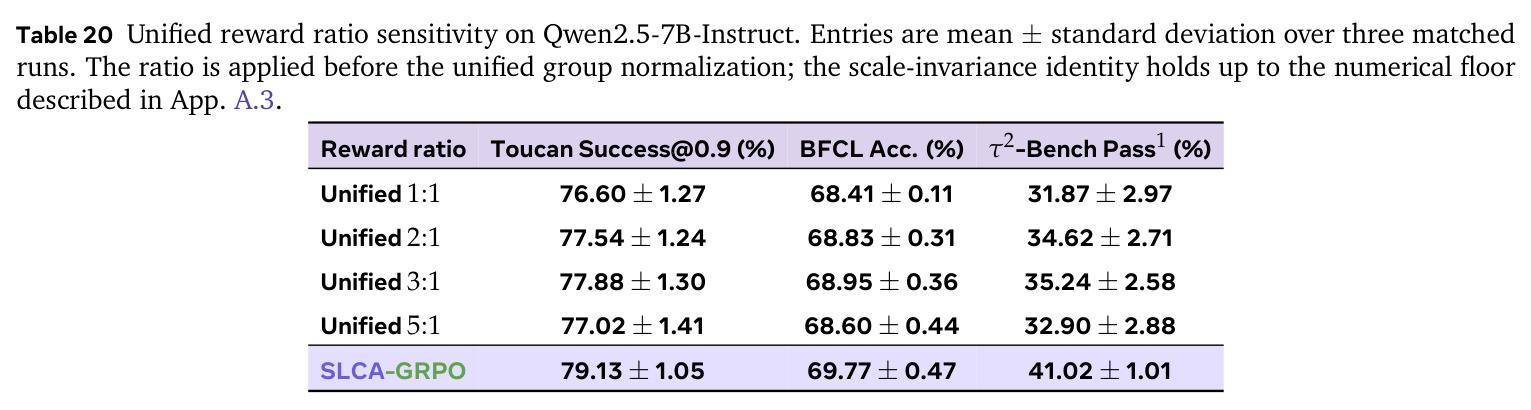
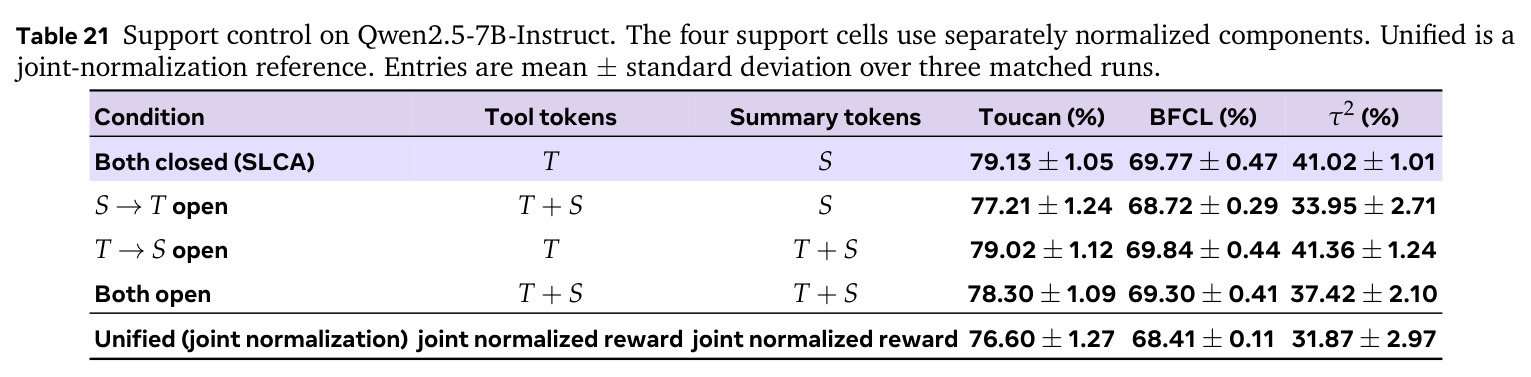
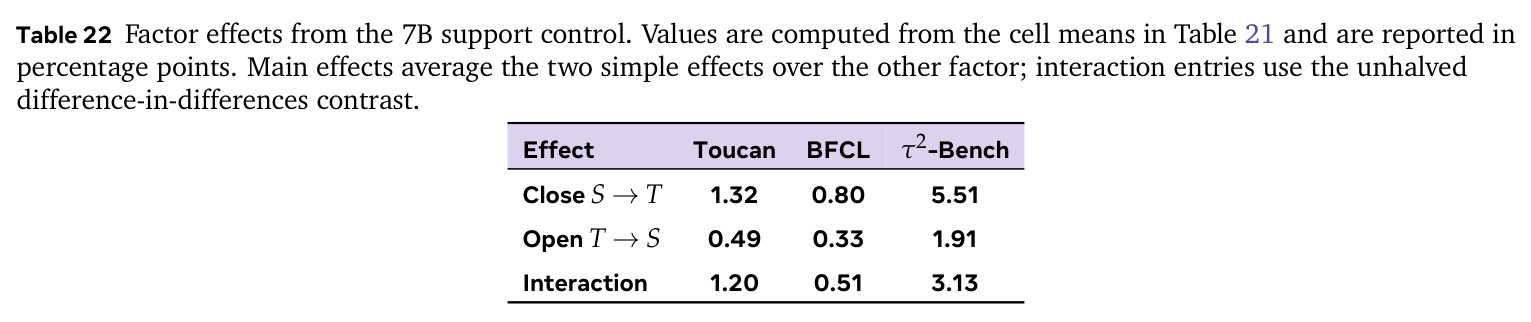
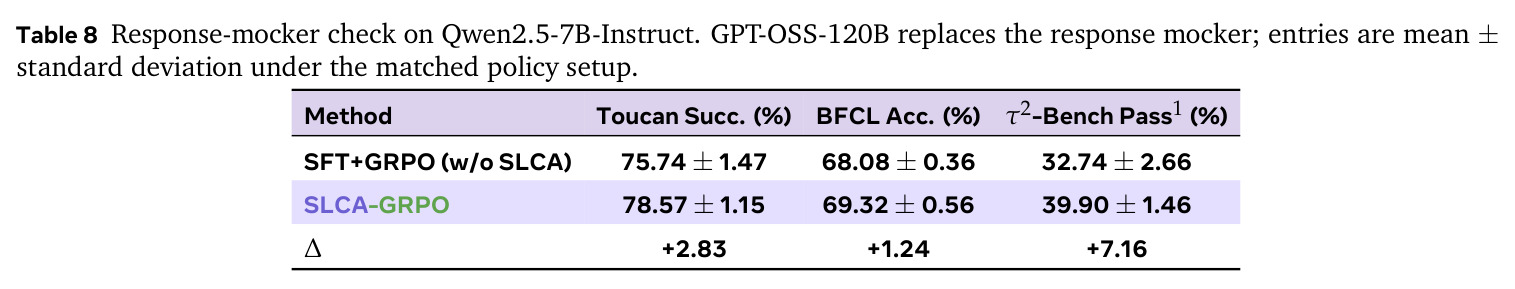
新颖性有三层。问题层面:首次把跨段信用错误归因定义并论证为工具调用 RL 的结构性失败模式,并用梯度诊断把病因定位到优势污染而非梯度方向冲突(不稳定尖峰时工具/总结梯度方向接近正交)。方法层面:SLCA 是轨迹内估计器,在同一条 rollout 组内完成分段归一化与路由,零额外 rollout 成本,与需要中间状态重采样的 VinePPO/SPO 形成鲜明对照;且它作用的结构轴与时间轴正交,论文明确两者可叠加。系统层面:配套的 SGLS 把 schema 当作控制平面,使模拟器能为信用分配分析提供分段反馈,HierR 保证路由两端信号语义可分;理论部分给出每步隔离保证 $\partial g^{tool}/\partial R^{sum}=0$。实验设计上也很严谨:附录 D.9 的支持域对照和 D.8 的统一奖励比例扫描专门把「归一化变化」与「支持域变化」两个纠缠因素分开度量,奖励协议敏感性检查(二值 $R^{succ}$、GPT-OSS-120B mocker)说明增益不绑定单一奖励形式。
实验结果
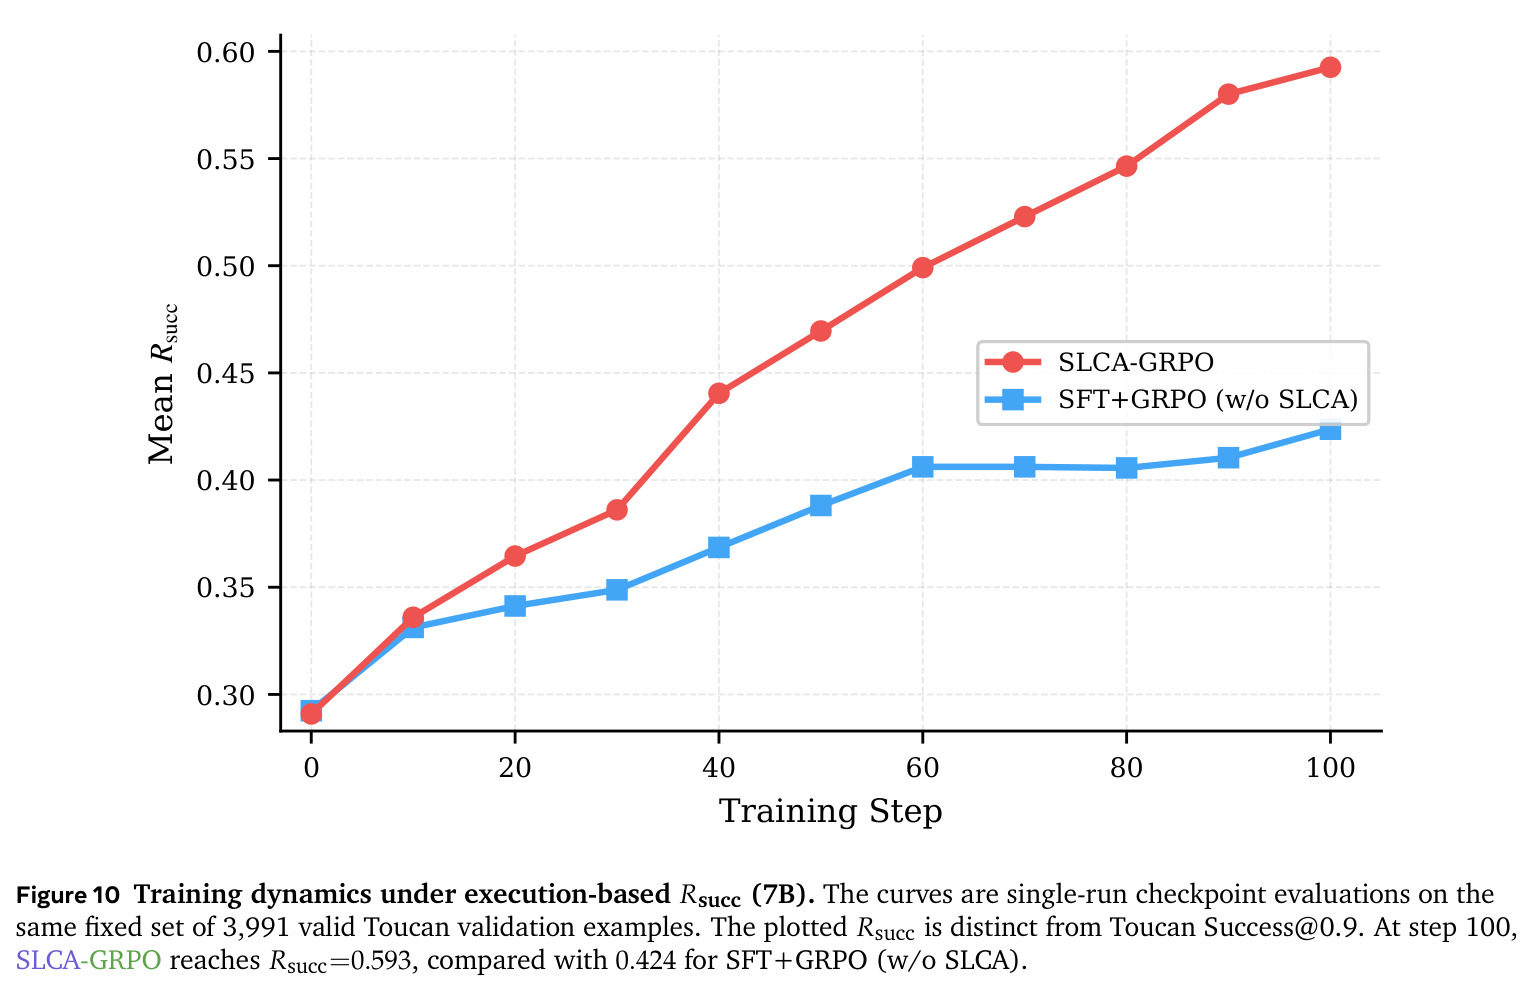
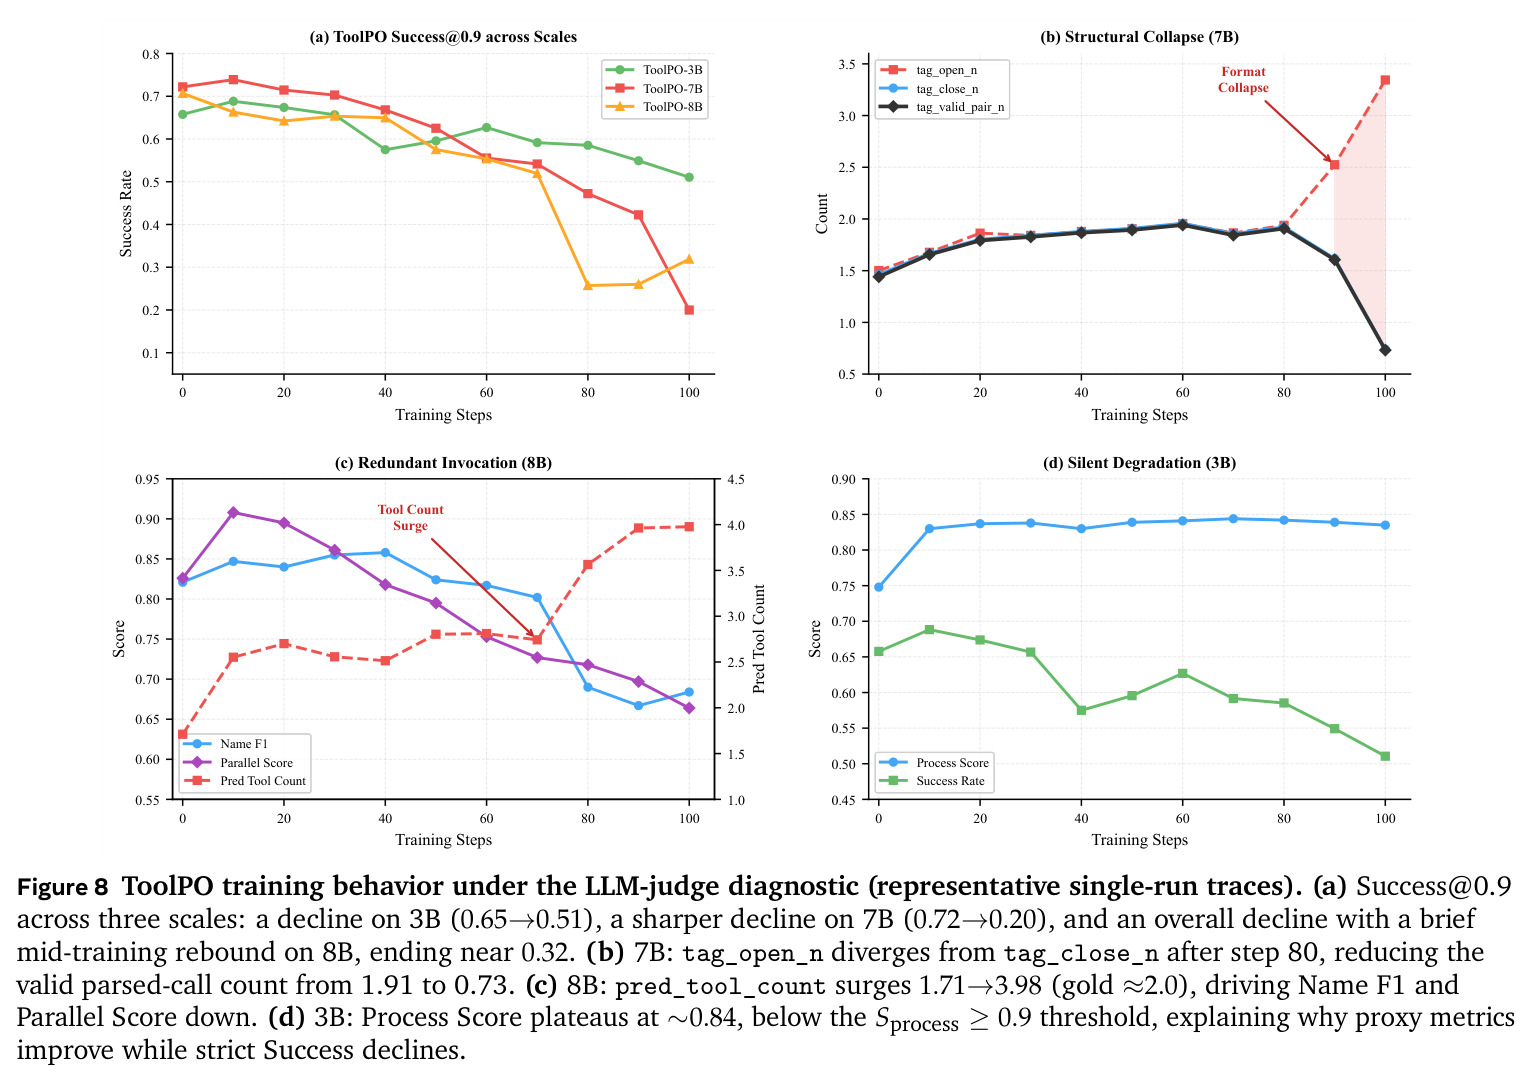
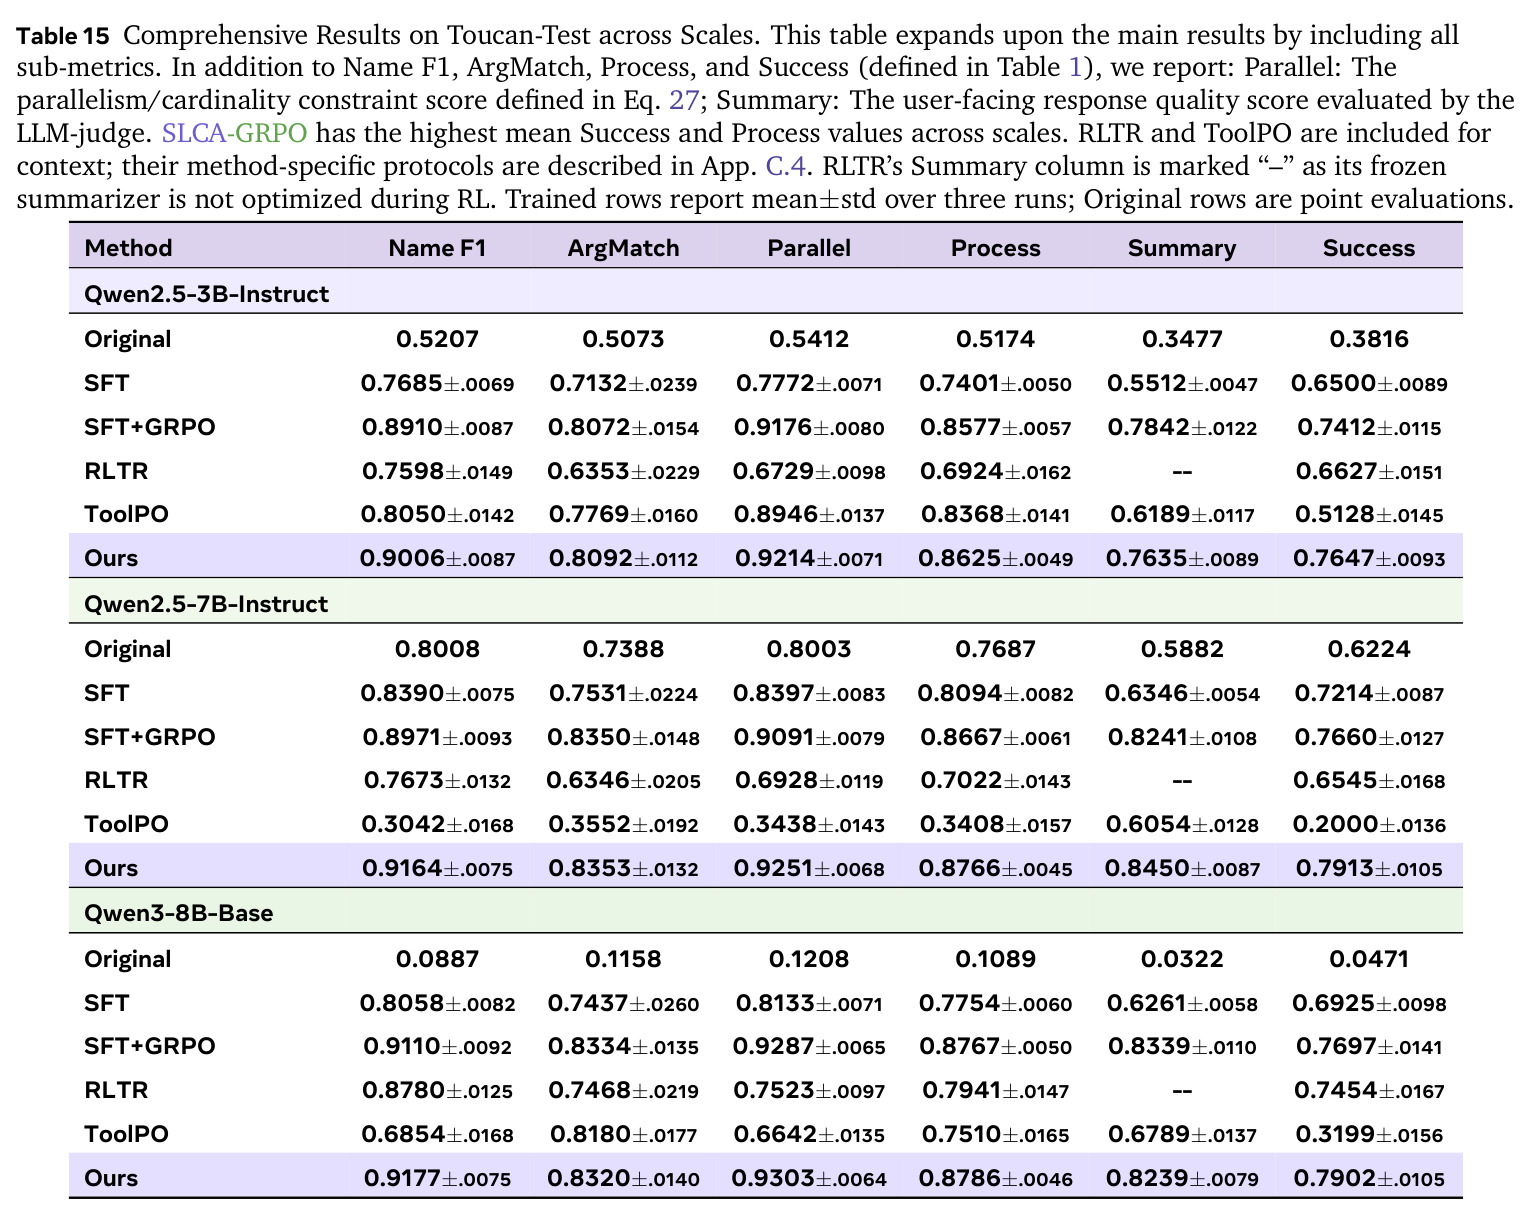
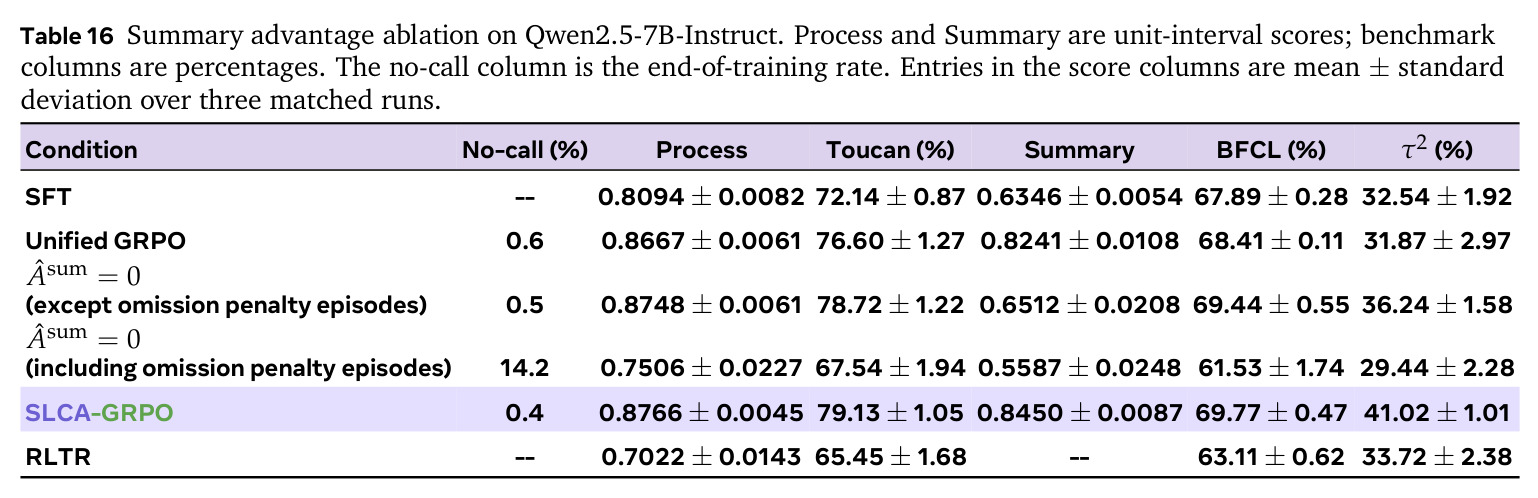
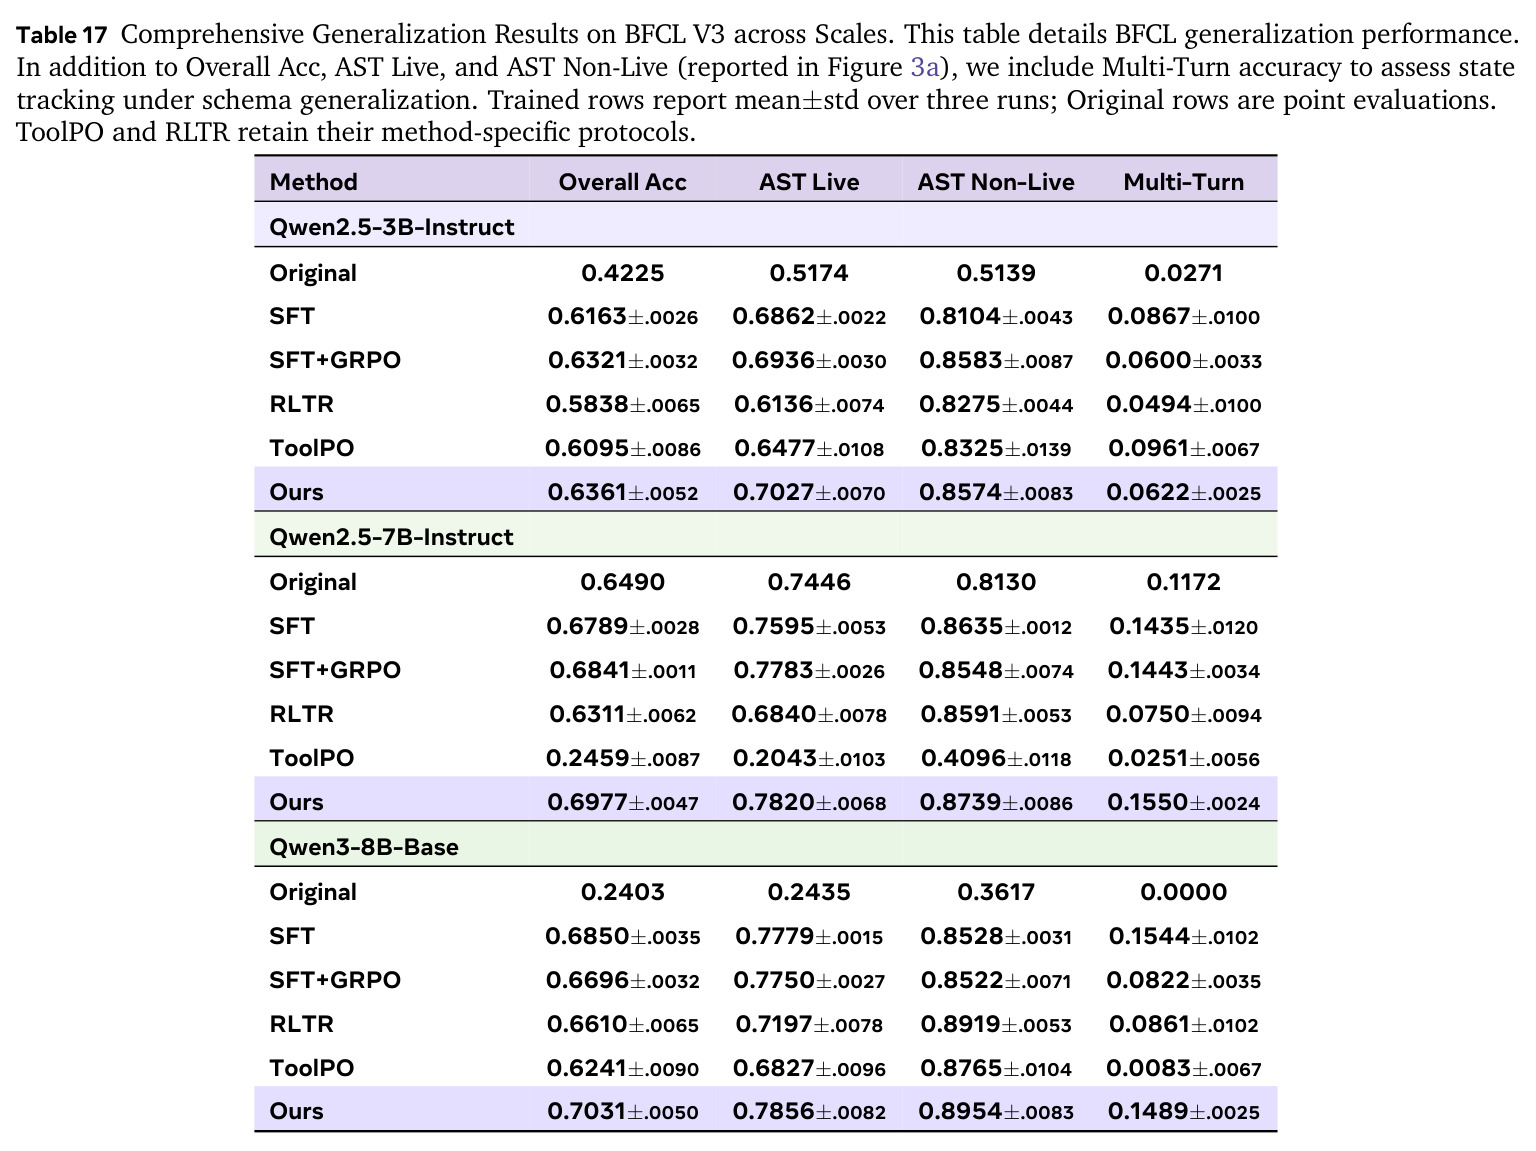
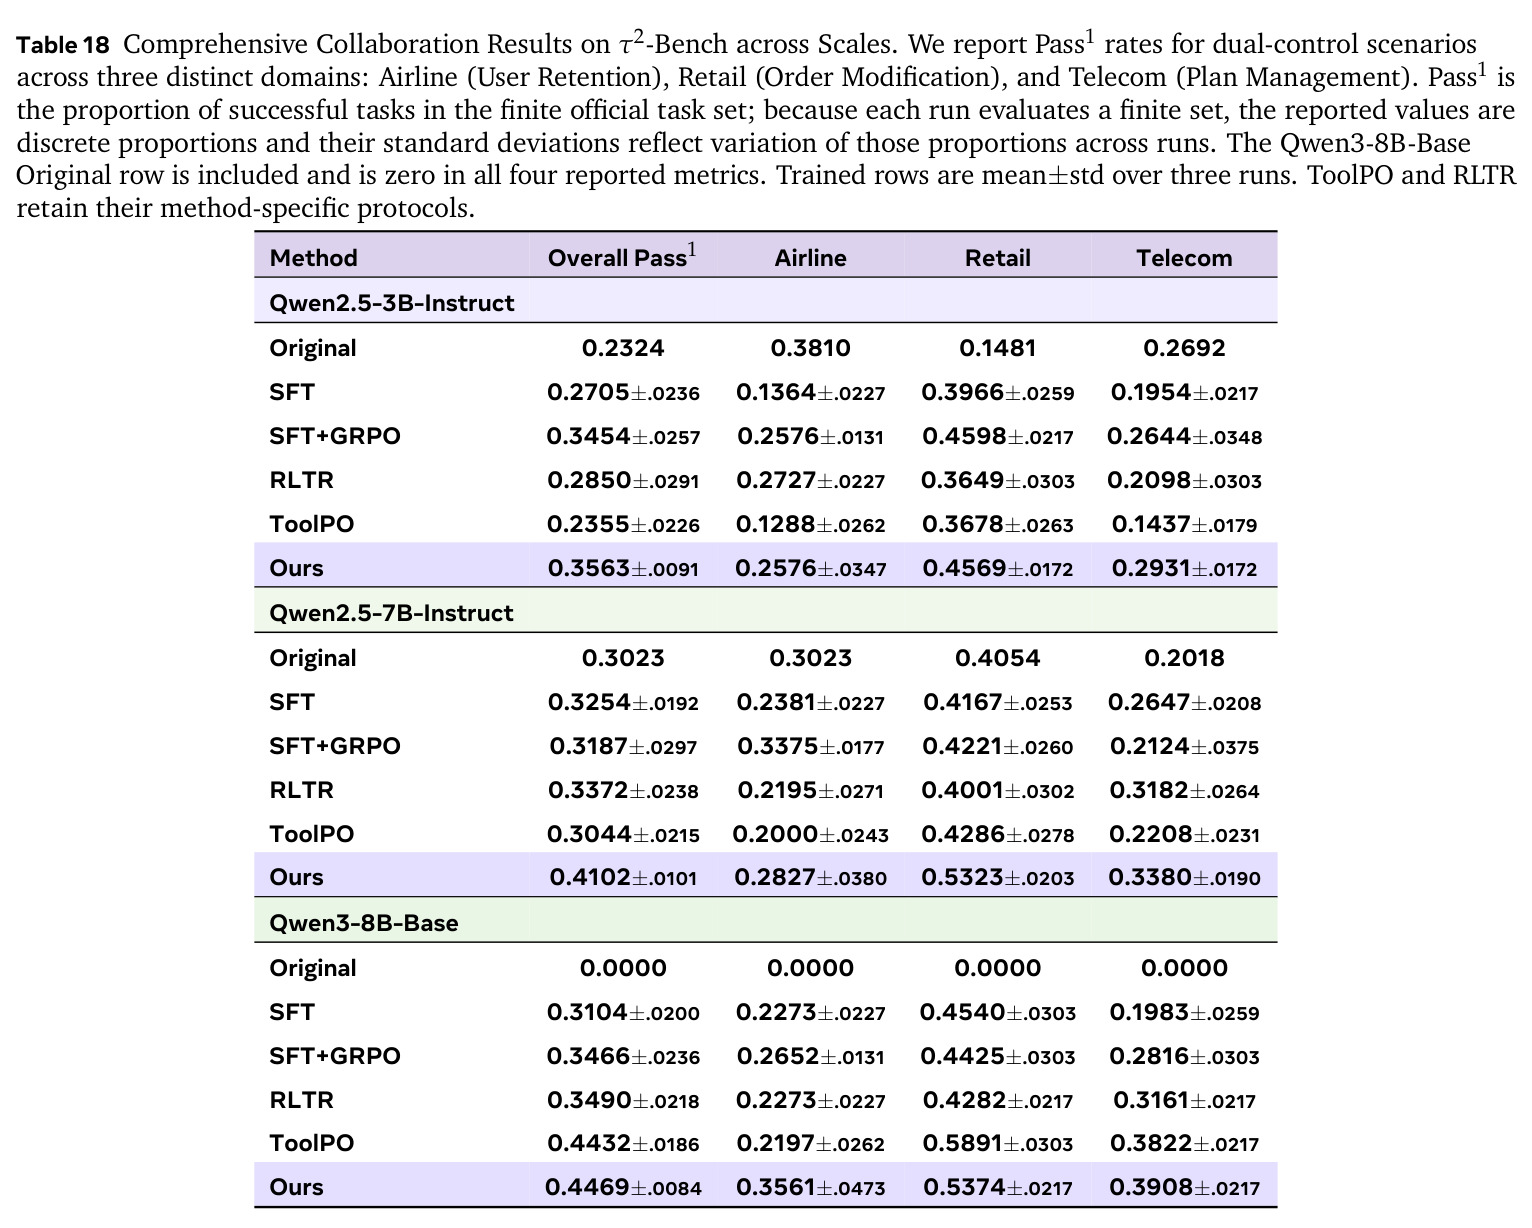
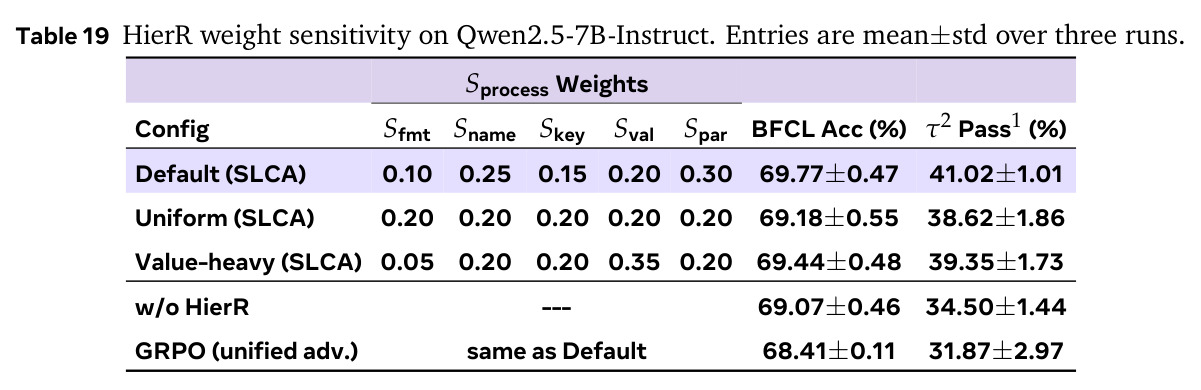
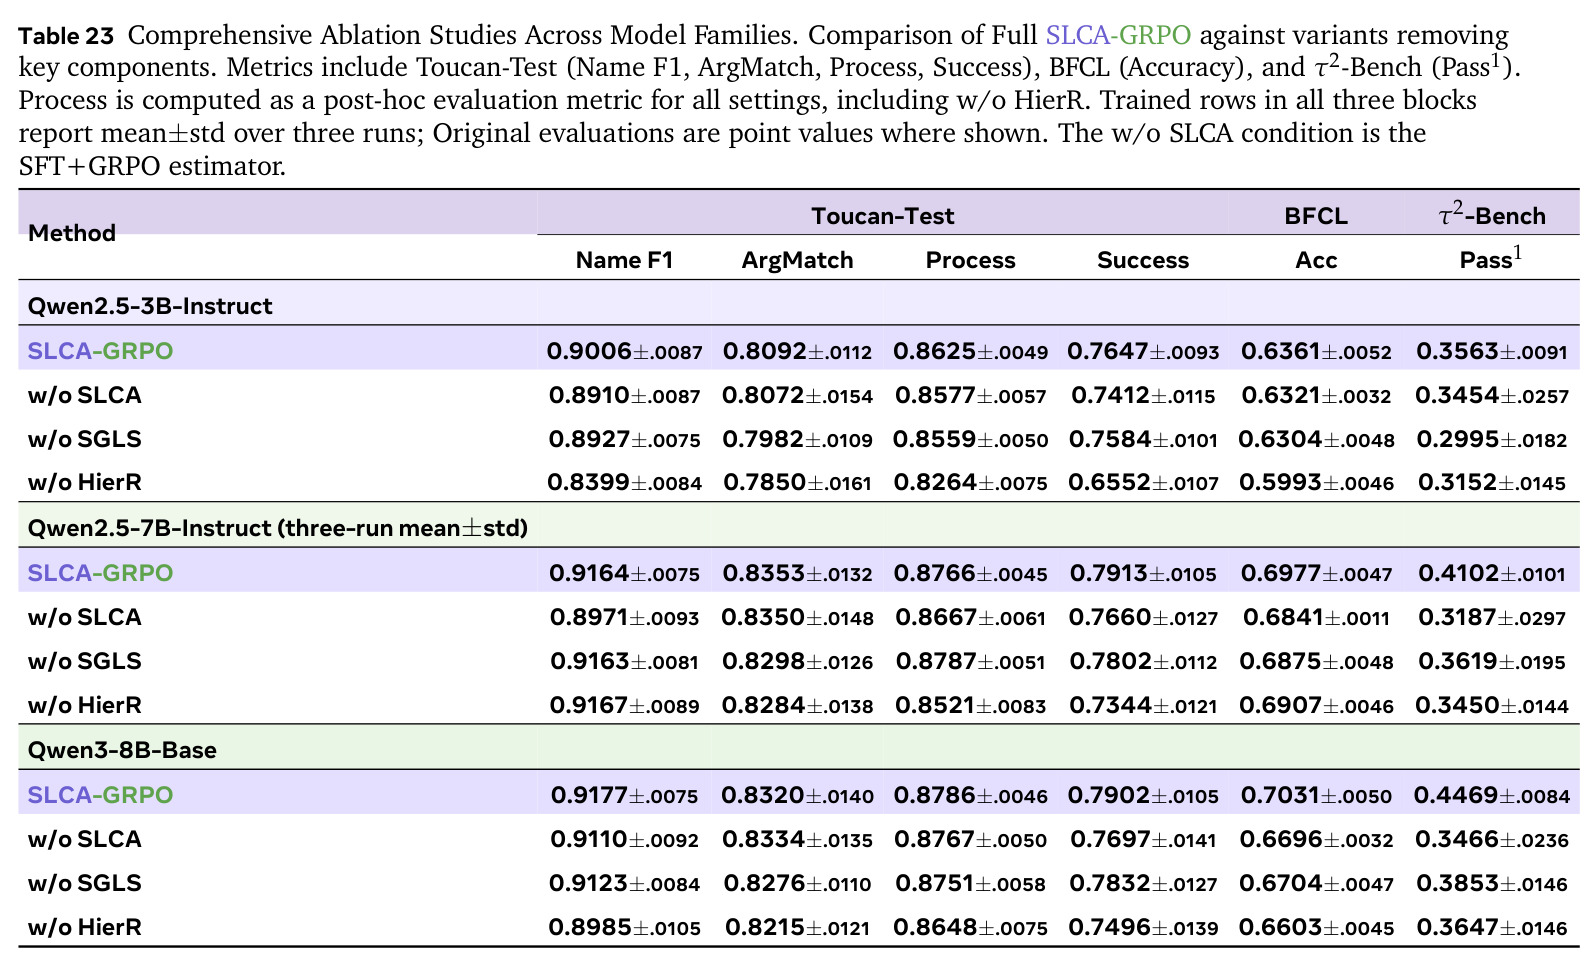
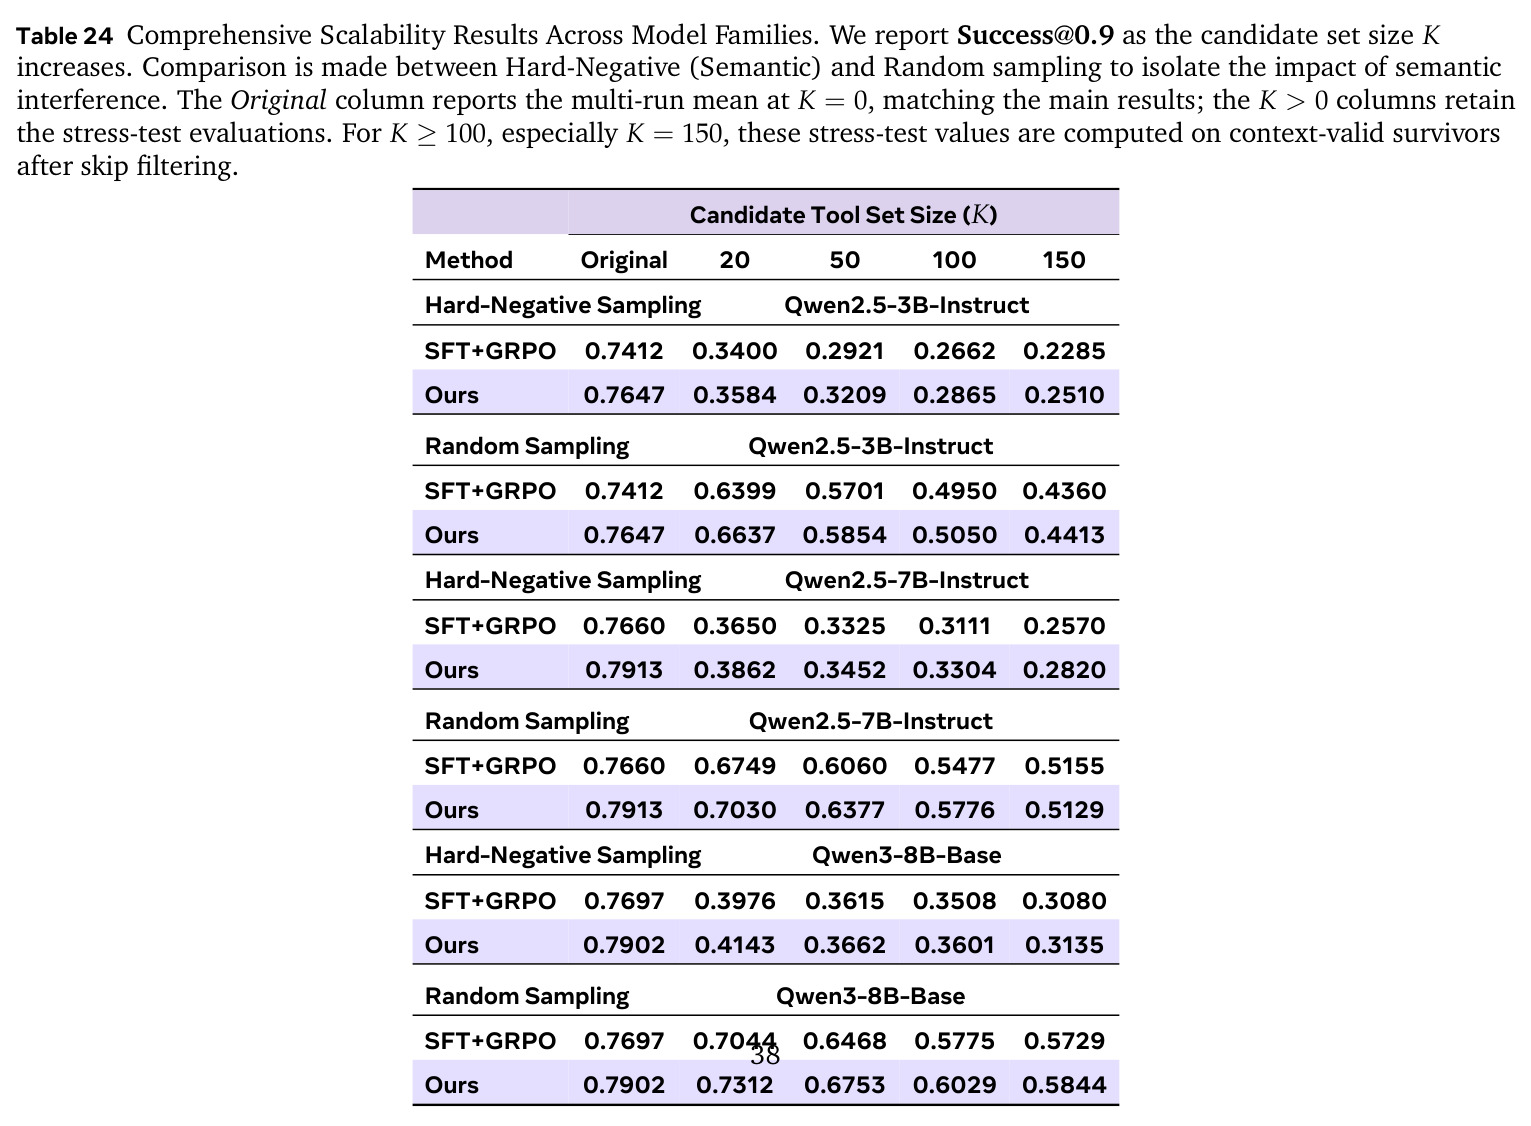
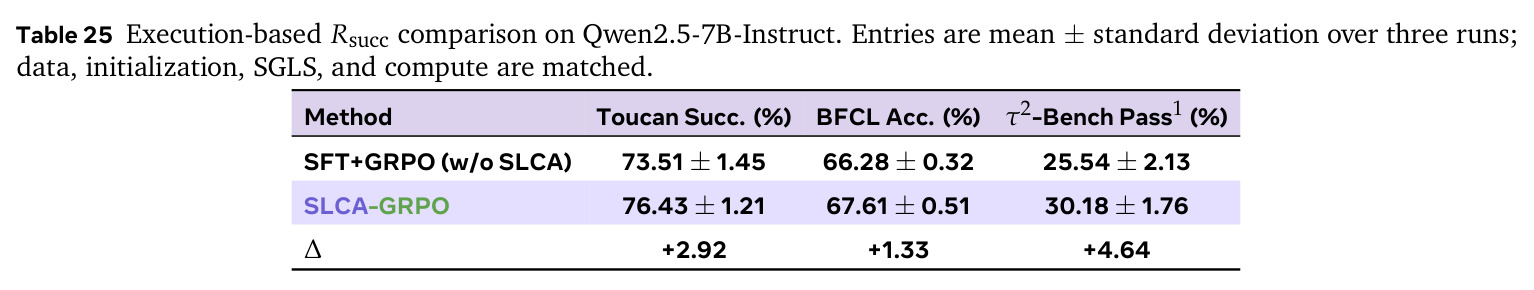
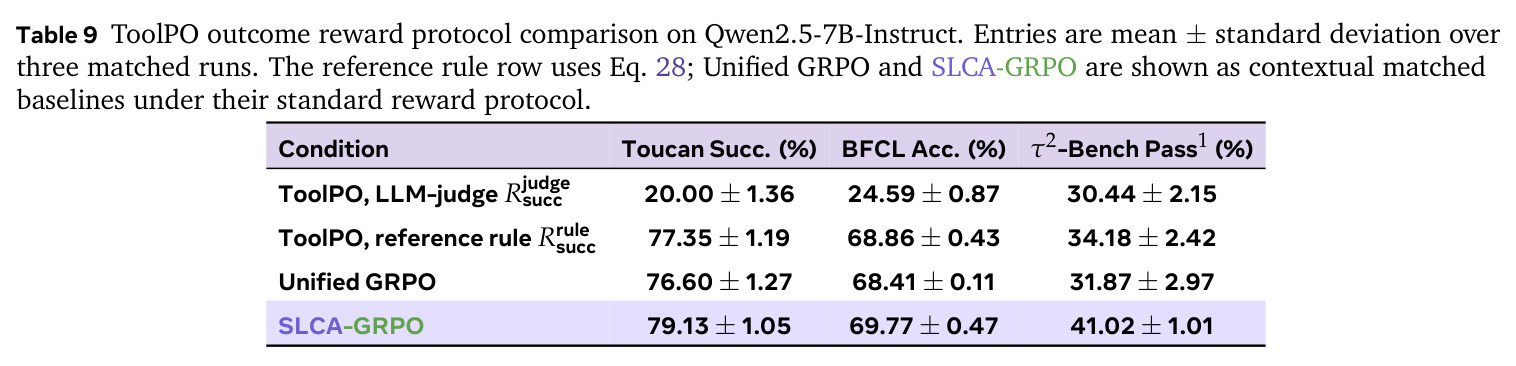
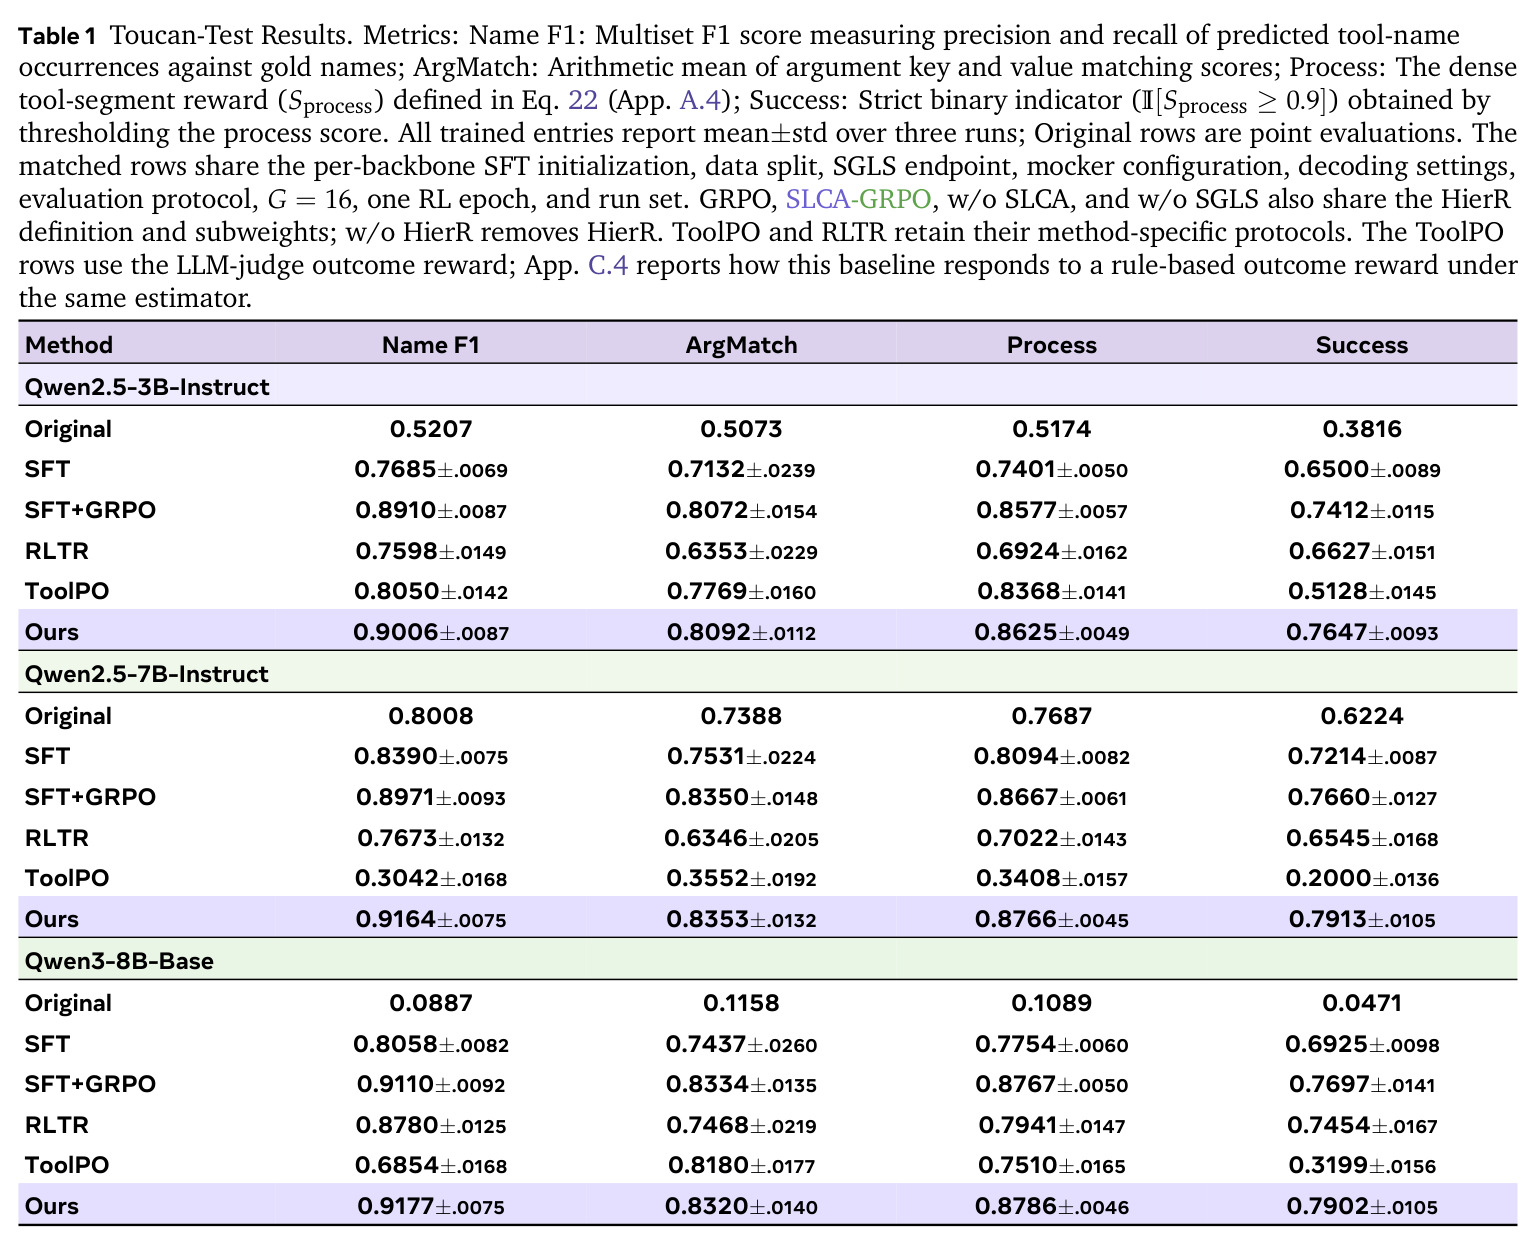
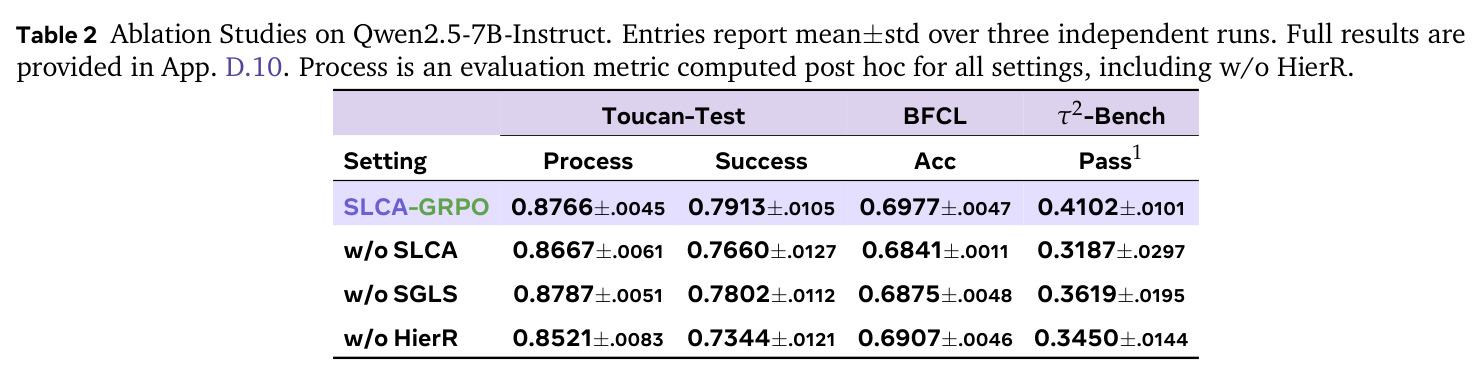
域内主结果(Toucan-Test,三 run 均值):7B 上 SLCA-GRPO Success@0.9 达 0.7913±.0105,比匹配 GRPO 的 0.7660 高 2.53 pp,Name F1 0.9164、Process 0.8766 亦全面领先;3B +2.35 pp、8B +2.05 pp。OOD:BFCL V3 单轮 Overall 上 7B 0.6977 对 0.6841(+1.36 pp),8B 70.31% 对 66.96%(+3.35 pp);τ2-Bench Pass^1 上 7B 0.4102 对 0.3187(+9.15 pp),8B +10.03 pp、3B +1.09 pp。消融(7B):w/o SLCA 掉 2.53 pp 且 τ2 跌至 0.3187;w/o HierR 的 Success 最低 0.7344;w/o SGLS 主要伤 OOD。训练动态上 SLCA 以更少平均工具轮次取得更高成功率,GRPO 轨迹变长而无增益(表演式执行);7B 的 ToolPO 在 40 步后下降、80 步后发散,Success 仅 0.2000。
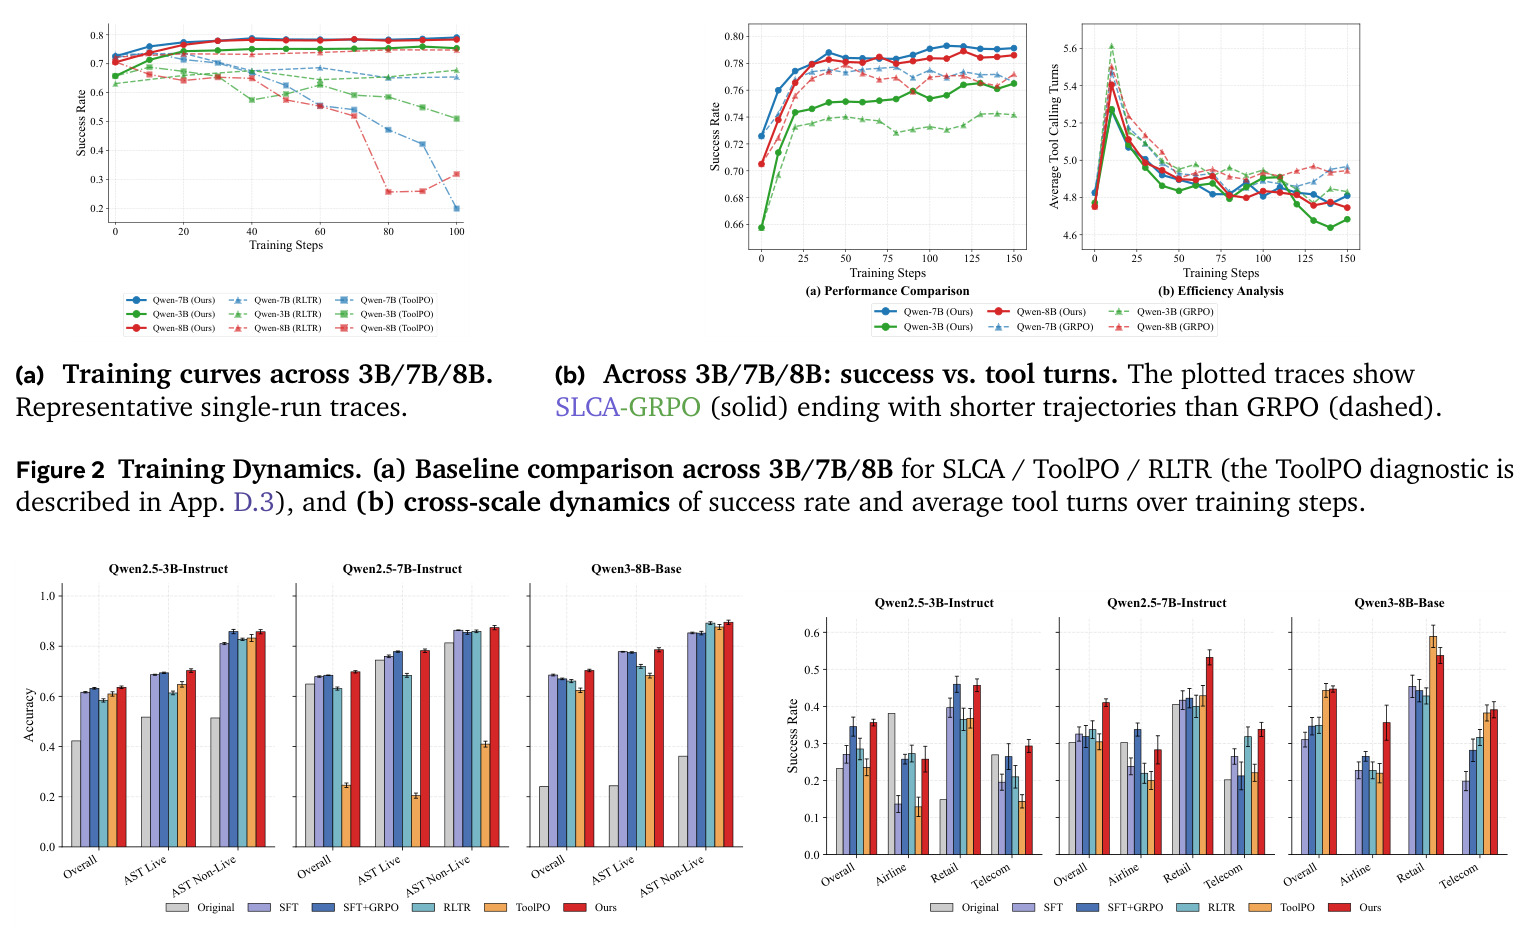
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 域内工具调用 Toucan-Test(Qwen2.5-7B-Instruct) | 严格 Success@0.9 | 0.7913±.0105 | SFT+GRPO 0.7660±.0127 | +2.53 pp |
| 域内工具调用 Toucan-Test(Qwen2.5-3B-Instruct) | 严格 Success@0.9 | 0.7647±.0093 | SFT+GRPO 0.7412±.0115 | +2.35 pp |
| 域内工具调用 Toucan-Test(Qwen3-8B-Base) | 严格 Success@0.9 | 0.7902±.0105 | SFT+GRPO 0.7697±.0141 | +2.05 pp |
| BFCL V3 单轮(Qwen2.5-7B-Instruct) | Overall Accuracy | 0.6977±.0047 | SFT+GRPO 0.6841±.0011 | +1.36 pp |
| BFCL V3 单轮(Qwen3-8B-Base) | Overall Accuracy | 70.31±0.50% | SFT+GRPO 66.96±0.32% | +3.35 pp |
| τ2-Bench 协作鲁棒(Qwen2.5-7B-Instruct) | Overall Pass^1 | 0.4102±.0101 | SFT+GRPO 0.3187±.0297 | +9.15 pp |
| τ2-Bench 协作鲁棒(Qwen3-8B-Base) | Overall Pass^1 | 三 run 均值领先 | SFT+GRPO | +10.03 pp |
局限与改进
作者承认的局限:分段假设要求工具调用与自由文本有清晰边界,行内代码生成等场景需要学习式分割;$S^{process}$ 依赖与金标轨迹的匹配,当存在多条同样有效的 API 计划时会低估替代方案;Toucan 严格 Success@0.9 只是对 Process 分的阈值化,不是独立的任务结果标签;$\hat{A}^{sum}$ 在总结 token 内部仍带组内分组偏差,显式子分组会使组规模指数级缩小;SLCA 给所有工具 token 同一个标量 $\hat{A}^{tool}$,不区分同一条链中正确的第 1 步和失败的第 2 步(时间信用问题未解,与 VinePPO/GiGPO/SPO 的组合未测);实验最大 8B,且全部依赖 SGLS 模拟环境,缺少真实 API 直接对比。我的补充观察:τ2-Bench Pass^1 绝对值最高仅约 41%,说明长程双控协作远未解决;BFCL 增益较小(7B +1.36 pp)且评估排除了相关性检测、限于单轮;主表的 ToolPO 用 LLM 裁判结果奖励(7B 上崩溃到 0.20),该基线的强度值得警惕。
独立分析的弱点
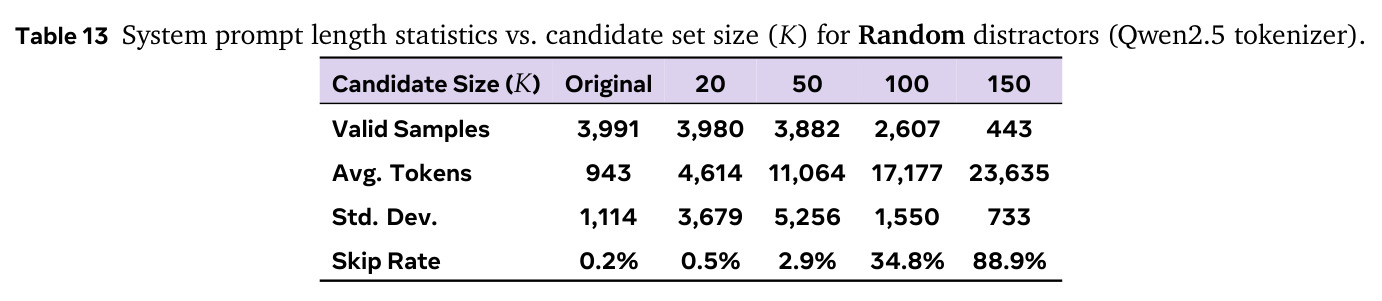
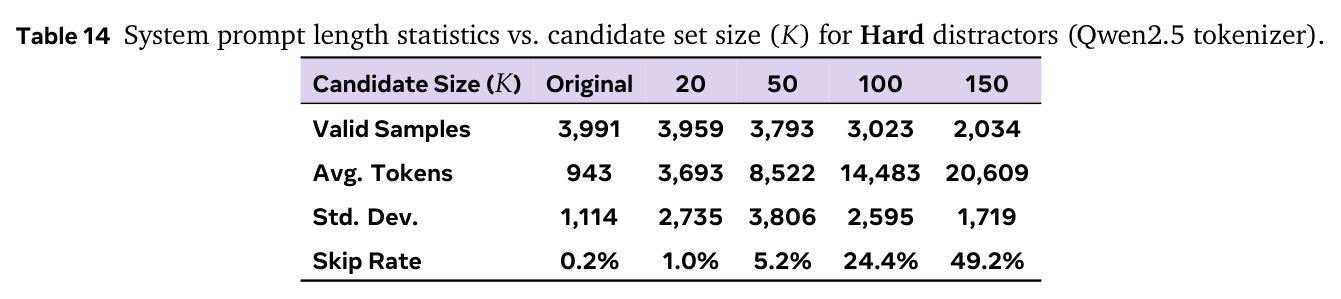
第一,金标匹配式过程奖励 $S^{process}$ 可能惩罚同样正确的替代工具序列,当一个问题存在多条等价 API 计划时奖励系统性偏低;改进方向是把匹配目标从单条金标轨迹扩展为等价计划集合,或更多使用论文附录 D.12 已验证的执行式/二值 $R^{succ}$ 判定。第二,工具段内部没有时间信用,正确的第 1 步会被同段失败的第 2 步拖累;改进方向是在每个结构段内部再套 GiGPO 式步级分组,形成结构×时间二维分组。第三,总结段内部 $\hat{A}^{sum}$ 仍带组内偏差,长回答与短回答被同一标量驱动;可按查询难度或回答长度做分层子组。第四,整套训练依赖 SGLS 模拟分布,真实 API 的行为(报错方式、延迟、频率限制)在 schema 外可能系统性偏移;应加入小规模真实 API 校准和模拟保真度度量。第五,分段规则是确定式的,遇到「回答中继续调用工具」等交织输出会失效,需要轻量 learned segmenter 或流式分段;同时这些弱点在更大候选工具空间(论文测到 K=150)和更长训练下的放大程度也值得做敏感性分析。
未来方向
作者提出的方向:与时间信用方法(VinePPO/GiGPO/SPO)组合,在结构段内部再做时间归因——两者轴正交,组合是自然延伸;更大规模训练(目前最大 8B)以及与真实 API 的直接对比;对无清晰边界的场景引入学习式分割;用显式子分组缓解总结段的组内偏差。基于成果可以进一步延伸:把结构段路由推广到其他异构输出 RL 场景,例如「推理链+代码」「检索+作答」「多轮对话+结构化表格」——凡是输出可分成执行段与表达段的任务都可套用;研究 $\lambda_{tool}$、$\lambda_{sum}$ 的自适应调度或随训练退火;利用 SGLS 的 schema 控制平面自动生成对抗性 schema 变体,系统测试 OOD;把 HierR 扩展为执行式验证器与 LLM 裁判的混合形式,降低对金标匹配的依赖;理论上把目前的每步隔离保证 $\partial g^{tool}/\partial R^{sum}=0$ 升级为对整个优化过程的偏差-方差刻画,并分析与符号冲突条件失效的边界。
复现评估
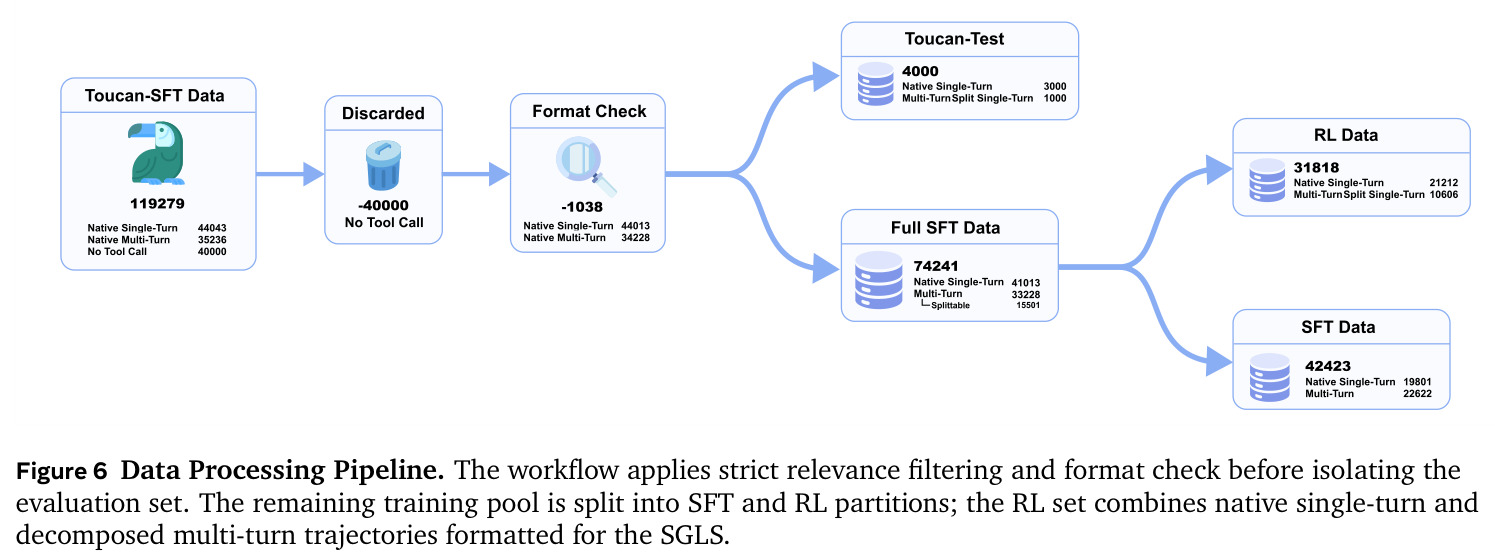
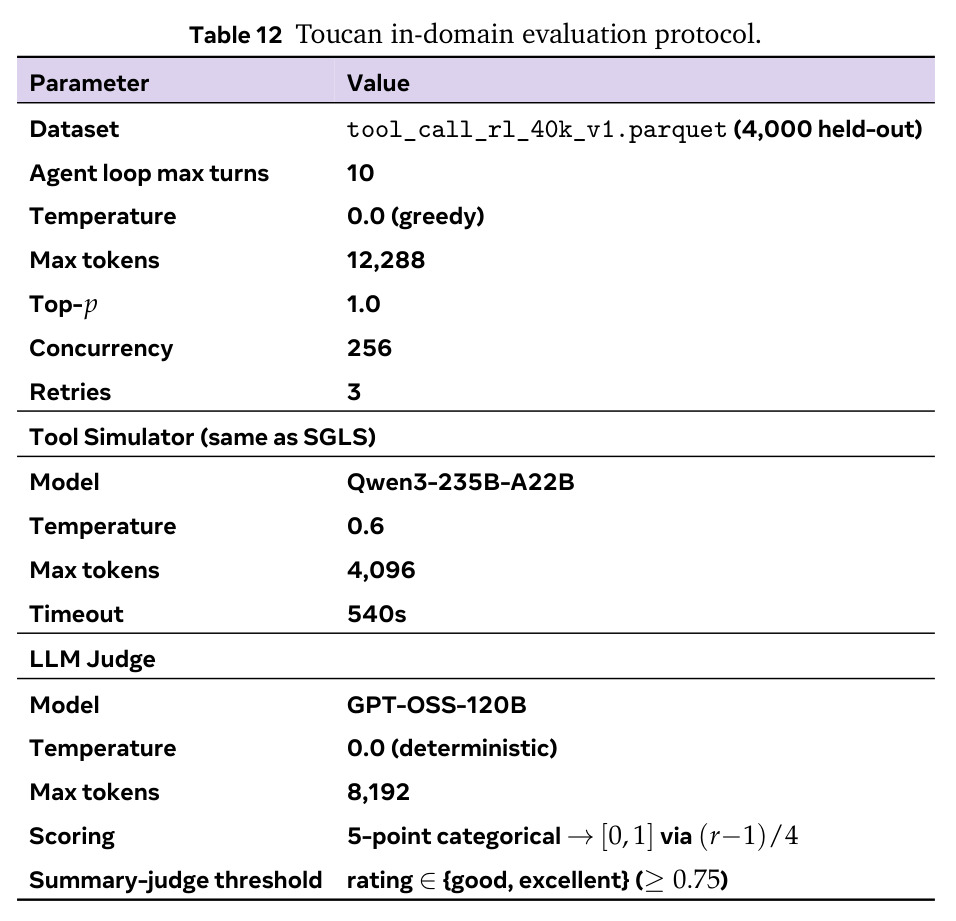
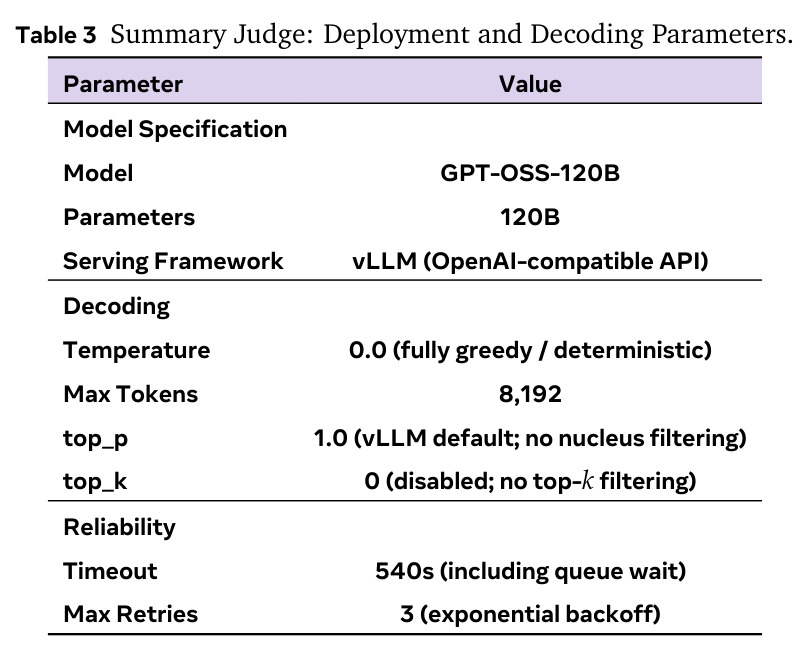
开源较好:代码在 github.com/SLCA-GRPO/SLCA-GRPO,数据集在 huggingface.co/datasets/YanZhanPKU/SLCA-GRPO-Datasets。协议完整:Toucan-1.5M 多阶段过滤后得 42,423 条 SFT 与 31,818 条 RL 样本,Toucan-Test 留出 4,000 条;骨干为 Qwen2.5-3B/7B-Instruct 与 Qwen3-8B-Base;组大小 $G=16$、单个 RL epoch、三 run 均值±标准差,各基线共享同 SFT 初始化、SGLS 端点、mocker 配置与解码设置。门槛:(1) 算力——3 个 7~8B 级模型的 RL 训练且每配置三 run,需多卡 GPU;(2) LLM 依赖——SGLS mock 与 $S^{summary}$ 裁判均用冻结 LLM(文中提及 GPT-OSS-120B 做检查),推理成本不低且对裁判版本敏感;(3) HierR 子权重、过滤管线、漏调惩罚路由等细节分散在附录,需仔细对齐。总体中等偏上难度:数据代码可得,卡点在算力与裁判一致性。
论文图表