面向演化中多智能体团队的组相对技能信用分配 Which Agent's Skill Should Change? Group-Relative Credit Assignment for Evolving Multi-Agent Teams
同题多次团队执行互为对照,把成败归因到智能体技能,指导免训练的技能库演化
前置知识
GRPO(组相对策略优化)
一种强化学习算法:对同一问题采样一组(多条)回答,用组内奖励均值作基线、标准差作归一化,按 $A=(r-\bar r)/(\sigma+\epsilon)$ 计算组内相对优势,无需训练独立的价值网络就能得到细粒度学习信号。由 DeepSeekMath 提出,后被扩展为免训练版本(Training-Free GRPO)。
GRSE 的名字与核心机制直接来自 GRPO:它把组内对比从参数梯度搬到行为层面,为批评家提供对比基础。读懂公式 (2) 的相对优势定义和分组采样设计都依赖这个背景。
信用分配(Credit Assignment)
多智能体系统共享一个团队级结果(成功或失败),信用分配要回答:这个结果该归因到哪个智能体的哪步行为。多智能体强化学习中的经典做法是差分奖励或反事实基线——把某个智能体的行为替换掉,观察结果如何变化,以 isolating 其真实贡献。
本文把「哪个智能体的技能该改」形式化为信用分配问题;只有理解反事实对比的思想,才能领会为什么同一问题的多次执行能定位到真正的责任方。
技能库(Skill Library)
以自然语言书写的可复用流程文件(名称+描述+正文),作为提示注入智能体的系统提示中。模型参数完全不变,只修改技能文本就能改变智能体行为;技能可被精炼、合并、剪枝或新造。因此信用是「可执行的」——定位到责任后就能直接修订对应技能。
本文的演化对象就是技能文件:实验中 Agent 1 的检索技能与 Agent 2 的回答技能质量直接决定团队成败,所有归因与编辑操作都作用在技能库上。
结构化失败诊断与引用校验
把「为什么失败」写成固定 schema:智能体、技能、八类失败类型之一(技能未遵循/技能缺陷/能力缺失/交接错误/证据缺失/答案格式/工具失败/归因不确定)、失败步骤引用、成功对照引用、修改建议和动作。系统自动校验引用的 rollout 索引、智能体归属与动作一致性,不合法的诊断被退回重写。
这是 GRSE 让归因「可验证、可执行」的关键机制,也是消融实验中移除后掉 1.0 F1 的组件;不懂它就看不懂批评家提示词(图 12)与鲁棒性分析。
研究动机
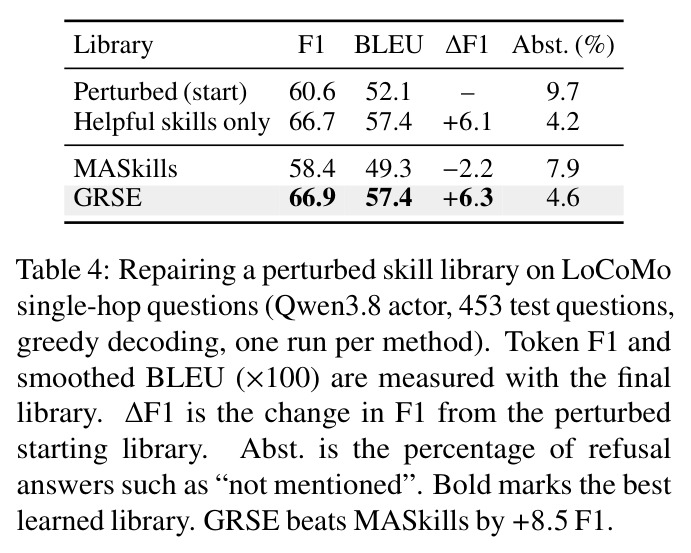
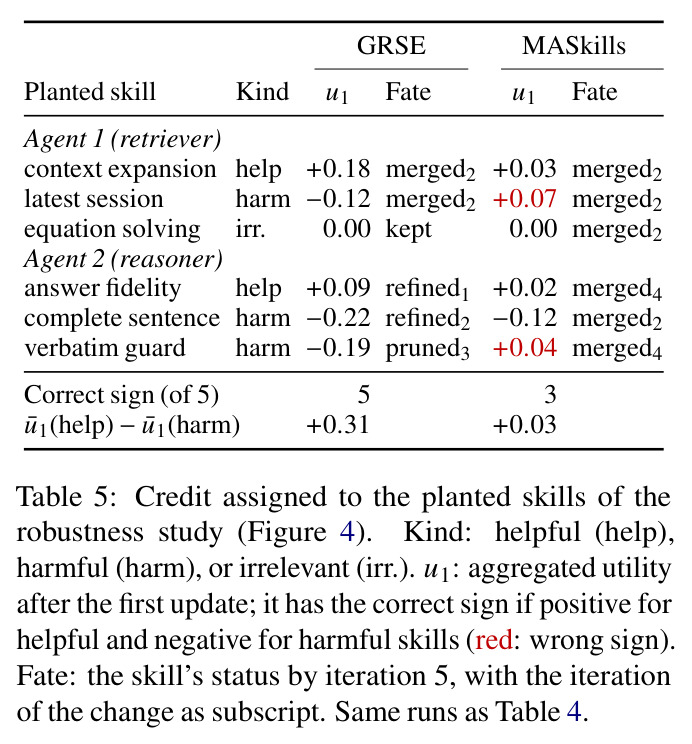
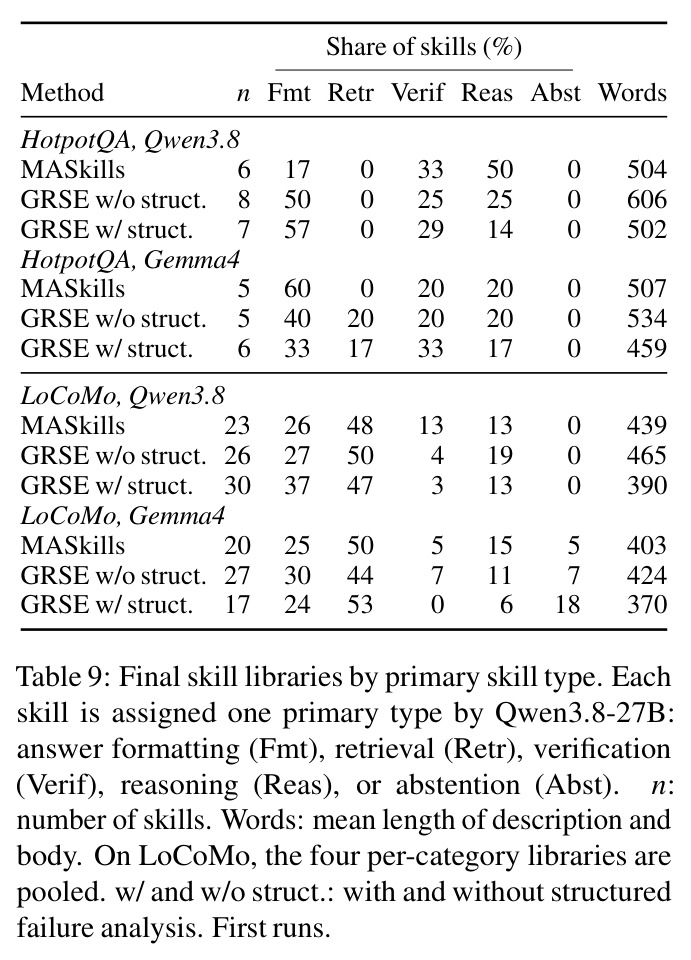
协作式 LLM 智能体团队(例如一个负责检索证据、一个负责推理作答)只能靠共享的团队结果(最终答案的 F1)来改进,而现有经验/技能学习方法的信用分配过于粗糙。最接近的 SOTA 方法 MASkills 对每条轨迹孤立评估技能贡献:只要技能出现在某条成功轨迹里就记正分,「在场」被当成了「有责」。这带来两个层面的失败。一是归因错位:错误浮现的位置不等于责任所在的位置,例如推理智能体答「not mentioned」,但真正的问题可能是检索智能体的 grep 关键词没有召回包含答案的轮次——该改的是检索行为,而不是回答行为。二是坏技能反而被奖励:在论文的鲁棒性实验中,MASkills 把一个人为植入的有害技能 verbatim-evidence-guard(要求证据逐字包含答案否则弃答)的效用估计从第 1 轮的 0.04 一路升到第 3 轮的 0.12,持续精炼而不删除,最终在受污染技能库上把 F1 从起点 60.6 拉低到 58.4(−2.2),连起点都没保住。
本文的目标是作者的目标是:在模型参数与智能体角色完全冻结、行为只由可编辑的自然语言技能库定义的前提下,构建一个免训练框架,把团队的成败可靠地归因到「哪个智能体的哪个技能」,并让归因满足四个性质:(1) 有对比依据——同一问题的多次完整团队执行互为反事实基线,只有解释了结果差异的行为才获得信用;(2) 可验证——每条归因绑定失败类型、引用的失败/成功执行步骤和修改动作,系统做引用合法性检查;(3) 可聚合——跨问题按「支持该归因的不同问题数」加权,避免把同一问题的重复执行当作独立证据;(4) 有安全阀——每次技能库更新都要在验证集上过门槛,归因错误的更新不会被保留。最终在 HotpotQA 与 LoCoMo 上验证这套信用能否转化为更高的团队得分和更健康的技能库。
与已有工作不同的是,对比的思想已有先例,但用法都不同:Training-Free GRPO 把组内对比蒸馏成整体经验上下文;SkillCAT 对比同任务成败对、SkillCome 结合组内对比与失败记忆——它们比较的是结果或优化的是被对比的配置本身,都不把结果定位到「具体智能体—具体技能—引用步骤」;MARL 的差分奖励能做归因但需要训练策略参数。GRSE 的独特切入是:技能库保持固定,对比的是团队行为本身——同题、同技能库下的 $G$ 次完整执行,高优势与低优势执行之间的行为差异就指向决定结果的行为。这让「在场≠有责」迎刃而解:有害技能在成功与失败执行中都出现,无法解释组内结果差异,因而拿不到正分。
核心方法
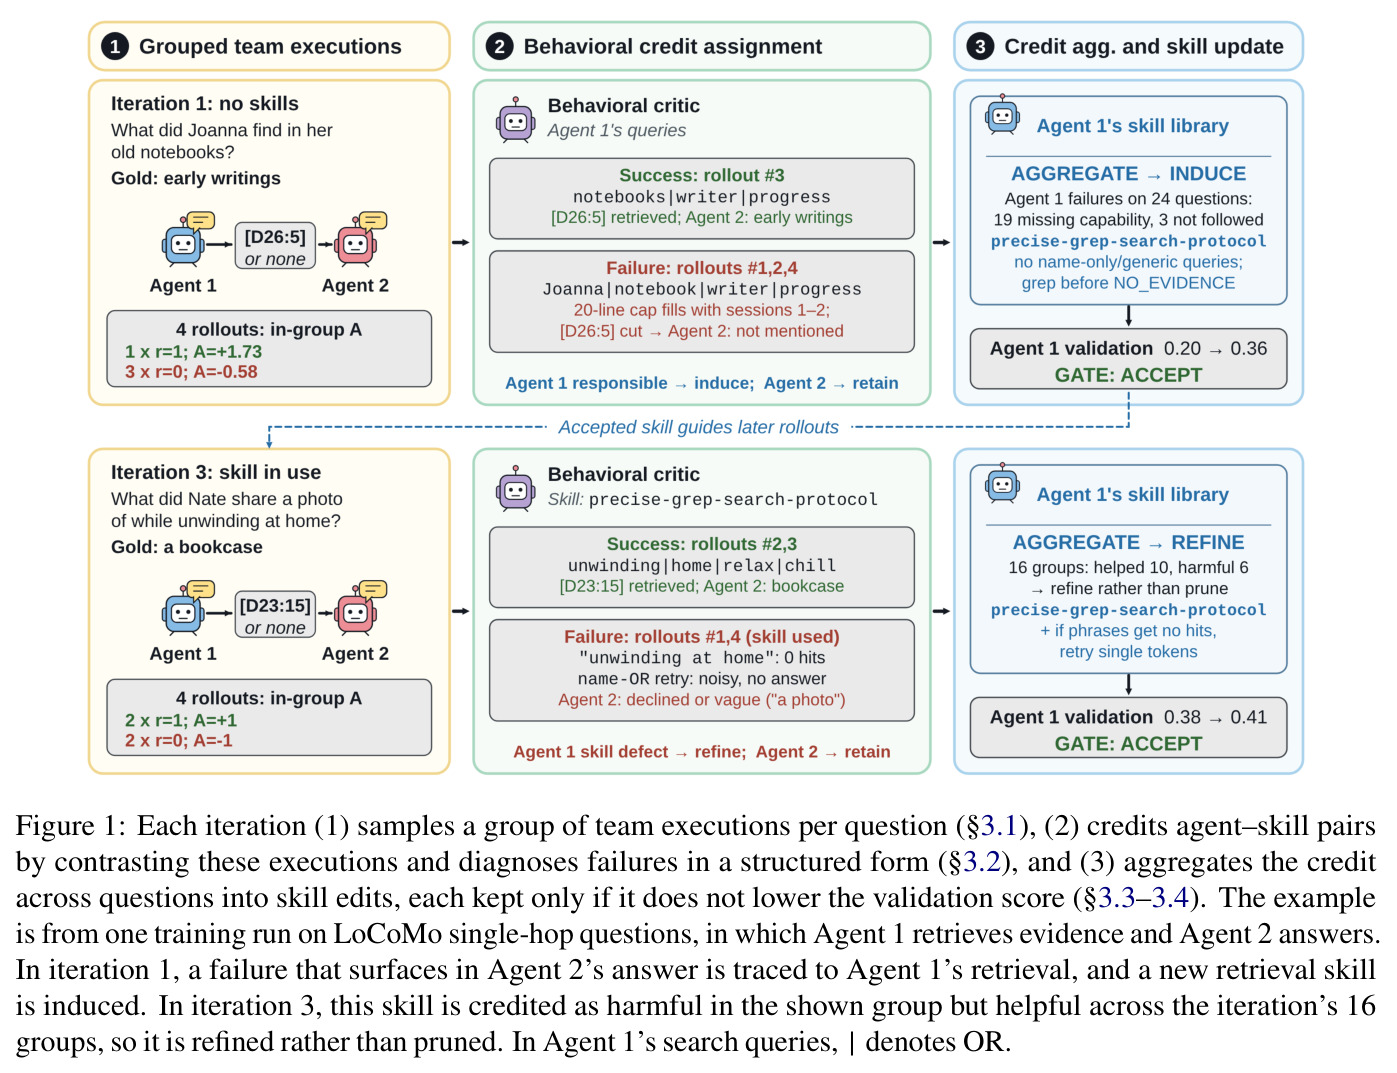
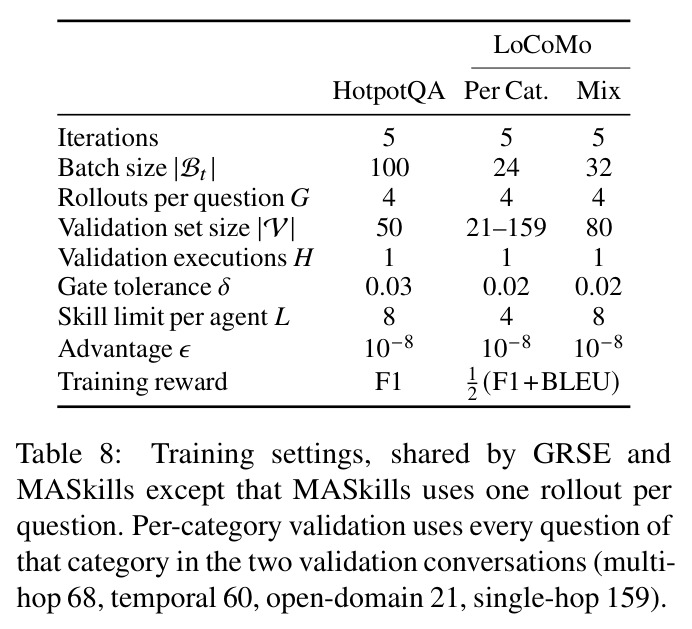
GRSE(Group-Relative Skill Evolution)是一个免训练框架:LLM 参数与角色冻结,每个智能体的行为由技能库 $K_t=(K_t^1,\dots,K_t^N)$ 定义,靠迭代修订技能文本进化。直觉是:想知道谁的技能该改,就让团队对同一问题跑几次,比较成功与失败执行差在哪里。每个迭代三步。第一步分组采样:对批次 $B_t$ 中每个问题 $q$,在相同技能库下采 $G=4$ 条完整团队轨迹,计算奖励 $r_q^g\in[0,1]$ 和组相对优势 $A_q^g=(r_q^g-\bar r_q)/(\sigma_q+\epsilon)$(当 $\sigma_q\le\epsilon$ 时置 0)。第二步组相对批评家:一个固定 LLM(Qwen3.8-27B)一次读入全部 $G$ 条执行,逐智能体对比行为与交接,输出技能信用(helped/redundant/harmful/neutral 加效用分 $u\in[-1,1]$)、智能体级反馈和结构化失败诊断(八类失败类型+引用步骤+修改动作),并通过引用校验。第三步跨问题聚合与技能演化:把信用聚合为编辑方向,驱动精炼/归纳/合并/剪枝四个算子;候选库在验证集上打分,只有不低于 $b_t-\delta$ 才被接受,如此运行 $T=5$ 轮。
核心创新是把 GRPO 的「组内相对优势」从参数优化搬到行为信用分配层面。关键洞察:组内所有执行共享同一问题与同一技能库,因此高、低优势执行之间的差异只能来自行为本身——这就是天然的反事实基线。它解决了两件已有方法做不到的事。第一,归因能越过「错误浮现的位置」:图 1 的例子里 Agent 2 在 4 次执行中 3 次答「not mentioned」,但其行为正确,决定性差异是 Agent 1 的搜索查询只在成功执行中召回答案轮次——批评家逐智能体对比后把责任判给 Agent 1 的检索。第二,归因可验证、可执行:结构化诊断把每条归因绑定到失败类型(8 选 1)、引用的失败/成功步骤($L^-$ 必须引用非满分执行、$L^+$ 必须引用满分执行)和修改动作(refine/induce/none),引用越界、动作与技能轨迹不符或工具失败/归因不确定的诊断只允许 no-edit。与 MASkills 的本质区别就在信用来源:单条轨迹孤立看,「在场」就得分;一组对比看,只有解释了结果差异的行为才得分。
方法步骤详情
完整流程(算法 1)如下。第 1 步:从训练集采批次 $B_t$(HotpotQA 每批 100 题,LoCoMo 24–32 题),对每题在固定库下采 $G=4$ 条团队轨迹(温度 1.0 保证多样性),奖励 $r_q^g=R(q,\tau_q^g)$(HotpotQA 用 token F1,LoCoMo 用 F1 与平滑 BLEU 的均值)。第 2 步:按公式 (2) 计算相对优势;全组同分($\sigma_q\le\epsilon$)的组默认保留,因为它们仍显示哪些行为一贯失败或成功。第 3 步:批评家读入全部执行,输出公式 (3) 的 $\mathcal{C}^q$(每相关智能体-技能对至多一条信用)、$\mathcal{B}^q$(智能体级反馈与归纳证据)和 $\mathcal{D}^q$(结构化诊断 $d=(i,k,z,L^-,L^+,e,\Delta,a)$)。第 4 步:引用校验——失败引用须指向非满分执行、成功对照须指向满分执行、refine 动作要求被引用技能确实出现在该执行的技能轨迹中,违规诊断退回重写一次。第 5 步:跨问题聚合(公式 4、5)——已有技能合成编辑方向 $\Gamma_i^k$,归纳模式 $p=(i,z,k,a)$ 按「支持它的不同问题数」$w(p)$ 排序。第 6 步:技能演化(公式 6)——按调度 $\Omega$ 应用算子(每轮精炼+归纳,每 2 轮合并,每 2–3 轮剪枝),库上限 $L=8$ 或 4。第 7 步:验证门(公式 7、8)——候选库在验证集上每题执行 $H=1$ 次取均值,仅当 $\tilde s_i^t\ge b_t-\delta$($\delta=0.03$ 或 0.02)才替换该智能体的库,逐智能体独立判定,共 $T=5$ 轮。
技术新颖性
技术新颖性有三点。其一,把「对比」用作技能层面的归因器而非优化信号:训练无关的对比方法(Training-Free GRPO、SkillCome、CANTANTE)要么把组内反馈蒸馏成整体经验文本,要么优化被对比的配置;GRSE 保持技能固定、对比行为,把结果差异定位到智能体-技能对并附引用步骤,这在 LLM 团队设定里是新的。其二,归因的可验证性设计:结构化诊断 schema 加引用约束(失败引用非满分执行、成功引用满分执行、refine 必须指向技能轨迹中实际被使用的技能)加动作一致性检查,把「批评家说了什么」变成「批评家能证明什么」——消融显示去掉结构化诊断平均掉 1.0 F1。其三,「不同问题数」加权的跨问题聚合:按支持归因的去重问题数计权,避免同一问题的 4 条重复执行被算成 4 份独立证据,统计上保守而正确。此外,它刻意复用 MASkills 的技能表示与编辑算子、只替换信用来源,使贡献归因非常干净:性能差异几乎可以完全归于信用分配机制的改进。
实验结果
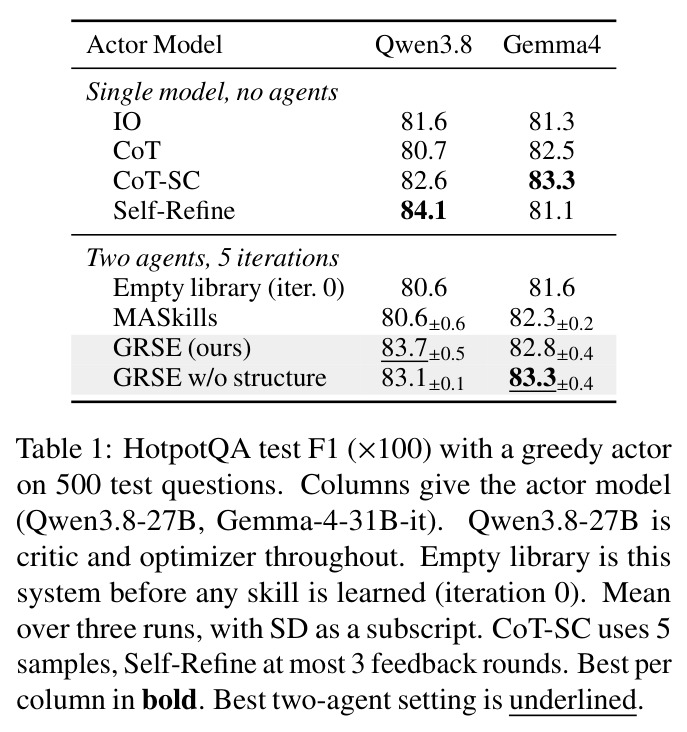
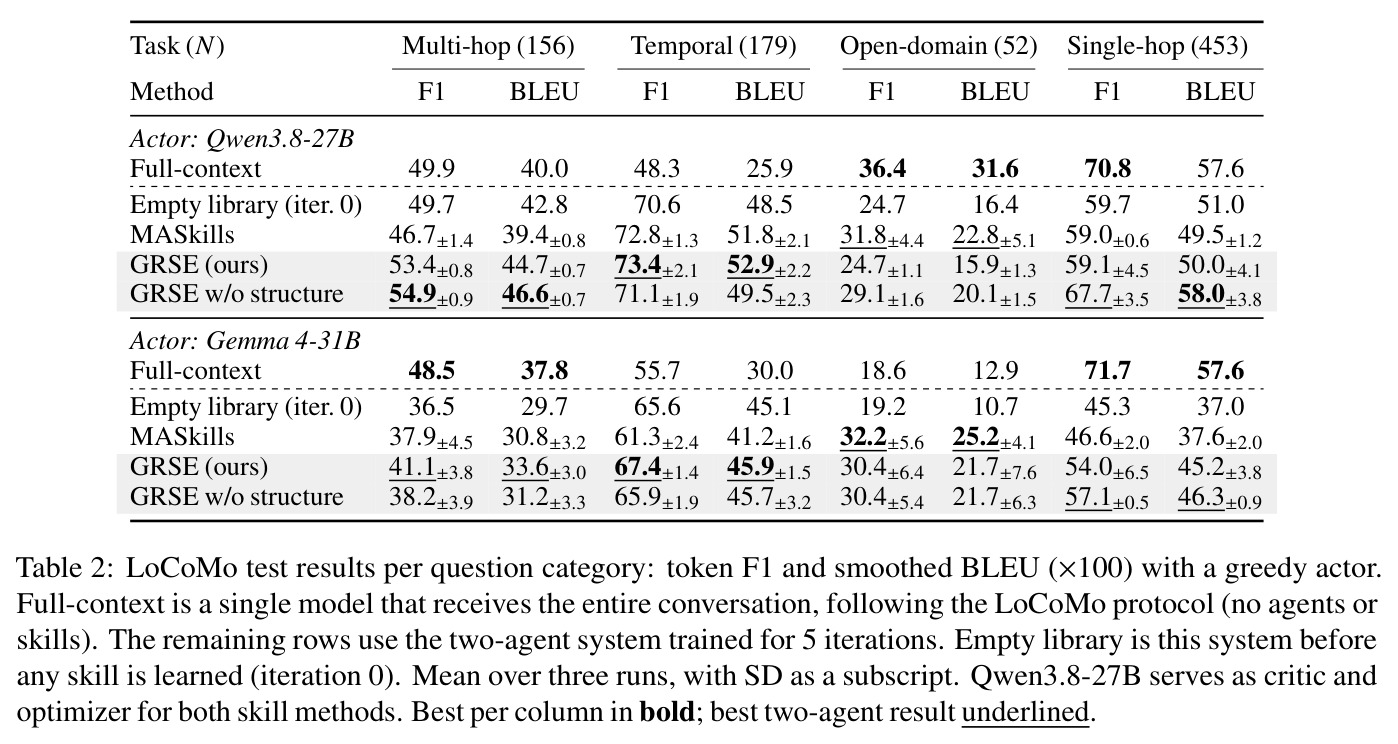
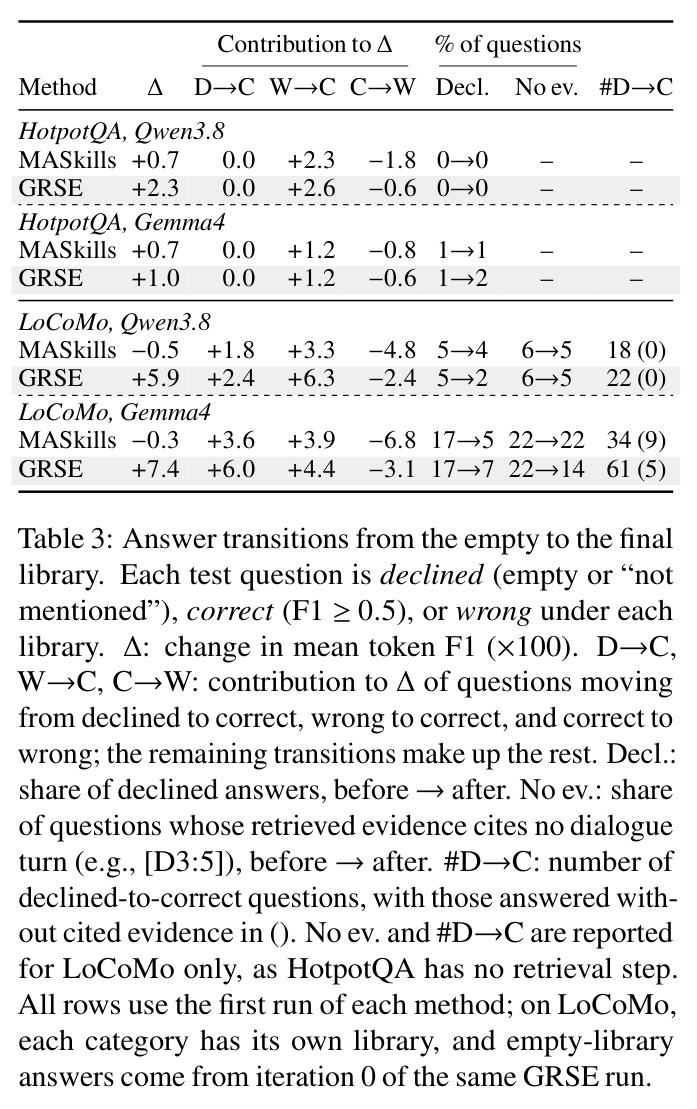
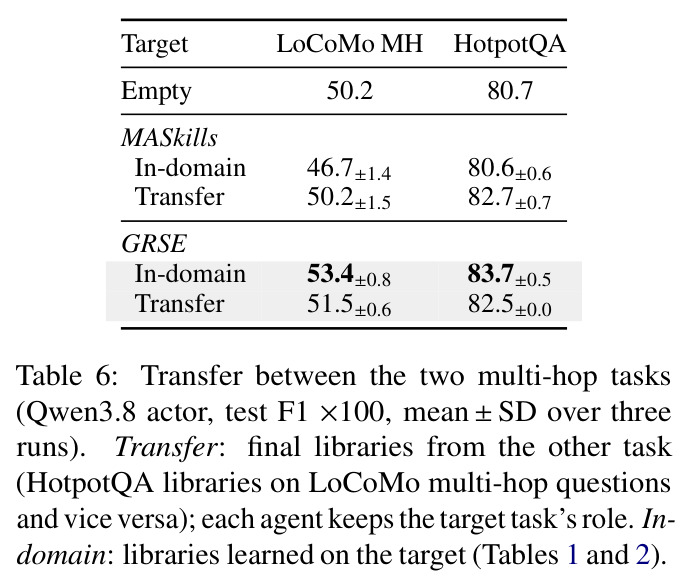
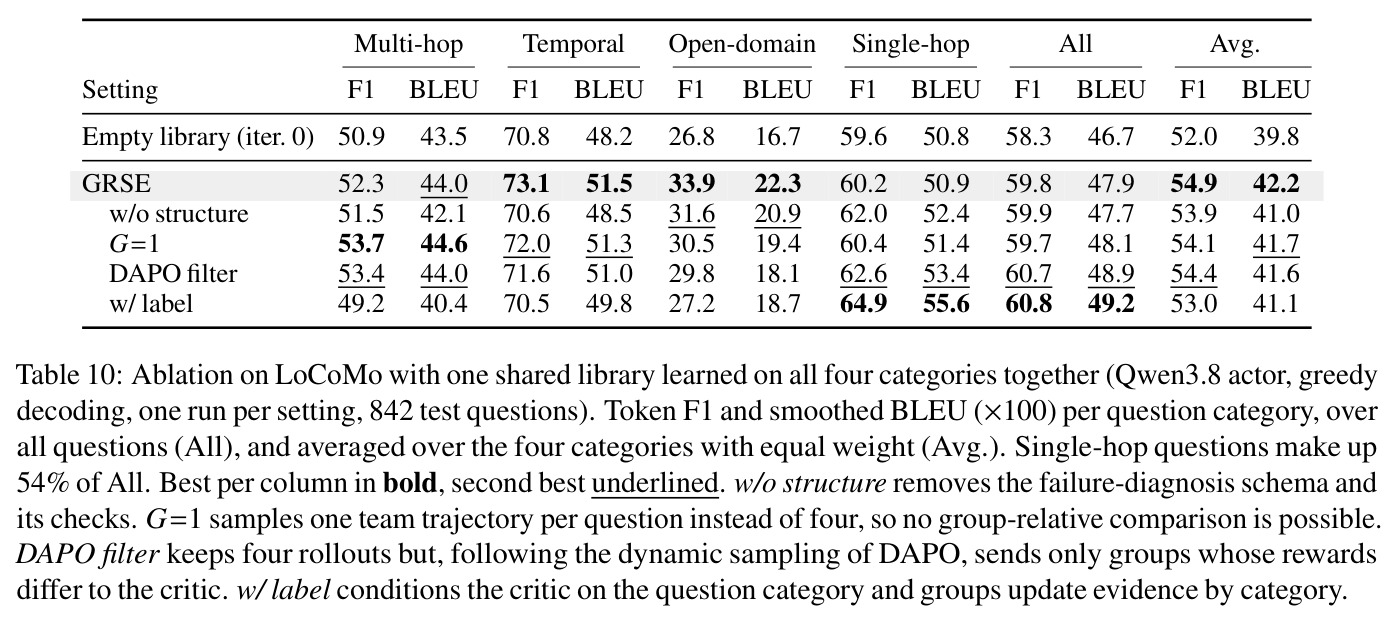
HotpotQA(500 测试题):GRSE 以 Qwen3.8-27B 为执行者取得 83.7±0.5 F1,比 MASkills 的 80.6±0.6 高 3.1 分,距最强单模型基线 Self-Refine(84.1)仅 0.4;Gemma-4-31B 执行者下 82.8 vs 82.3(+0.5)。LoCoMo(840 测试题、四类):GRSE 在除开放域外的所有类别超过 MASkills,multi-hop 提升最大——Qwen3.8 下 F1 53.4 vs 46.7(+6.7)、BLEU +5.3;Gemma4 下 +3.2 F1、+2.8 BLEU;temporal 两执行者均全场最高(73.4 / 67.4 F1)。而 MASkills 在 Gemma4 的 temporal(−4.3 F1)和 Qwen3.8 的 multi-hop(−3.0 F1)上甚至低于空库。答案状态转移分析(Table 3)揭示收益来源健康:MASkills 打破的正确答案是 GRSE 的 2–3 倍(LoCoMo Gemma4 上 C→W 为 −6.8 vs −3.1),其「无引用证据」比例停在 22%、34 个弃答转对的题里 9 个无证据;GRSE 把该比例降到 14%、61 个转对题里仅 5 个无证据——收益来自更好的检索而非瞎猜。鲁棒性实验(Table 4/5):从植入有害技能的污染库出发,GRSE 把 5 个植入技能的效用符号全判对(help−harm 效用差 0.31),第 3 轮剪除有害弃答规则后恢复到 66.9 F1(对照「仅有用技能」66.7,即 +6.3),弃答率 9.7%→4.6%;MASkills 判错 2 个符号(差仅 0.03),反而把有害技能效用从 0.04 升到 0.12,最终 58.4(−2.2),比 GRSE 低 8.5 F1。迁移实验(Table 6):GRSE 的库跨任务迁移仍高于空库(+1.3 / +1.8 F1),域内再加 +1.9 / +1.2;MASkills 域内库反而低于其迁移库(−3.5 / −2.1)。消融(Table 10):完整 GRSE 类均 F1 54.9 最优;去结构化诊断 −1.0、$G=1$ −0.8、DAPO 过滤 −0.5(开放域 −4.1)、加类别标签因偏向占 54% 的 single-hop 使类均最低(53.0)。
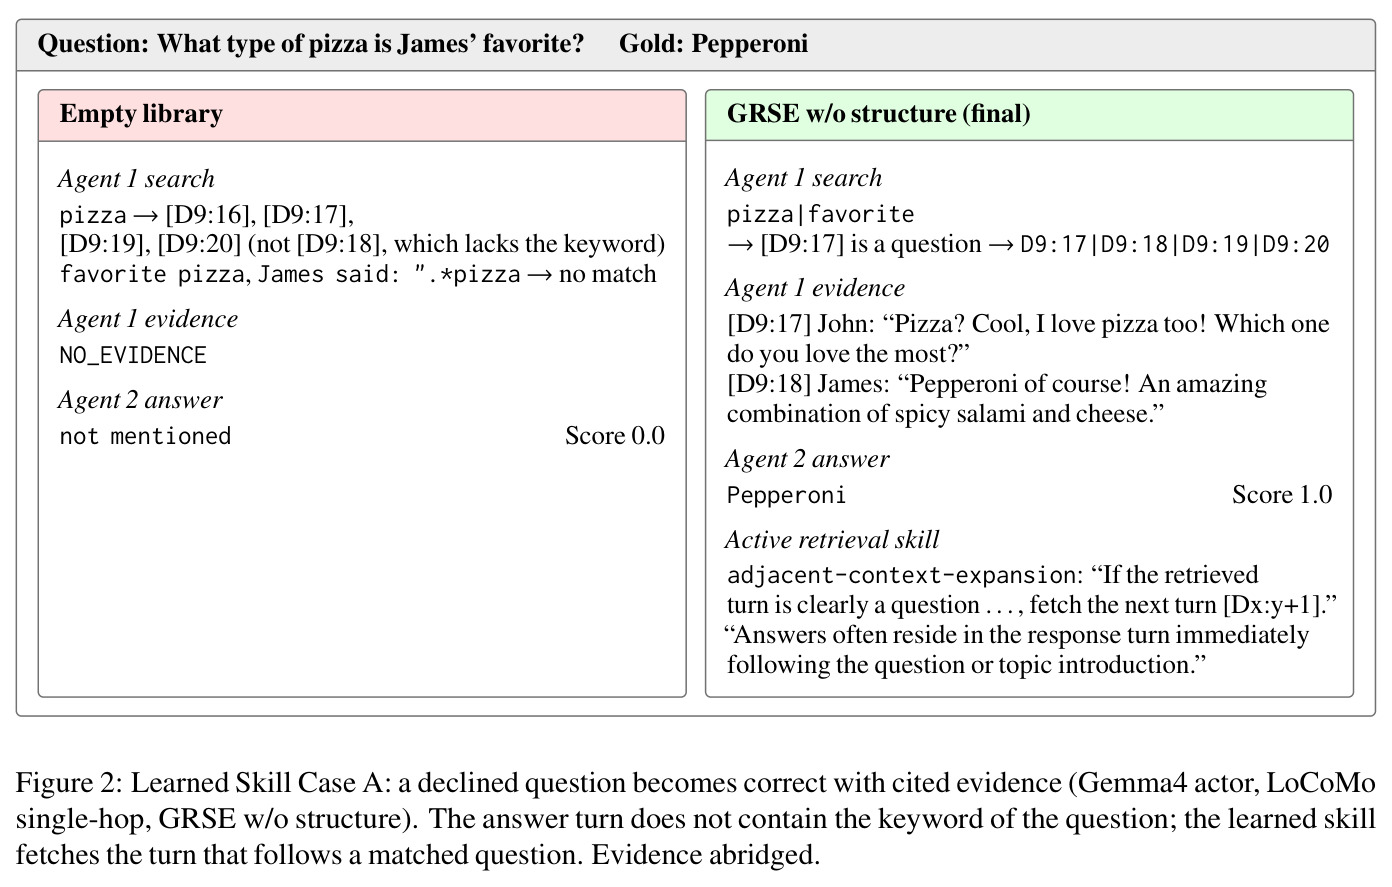
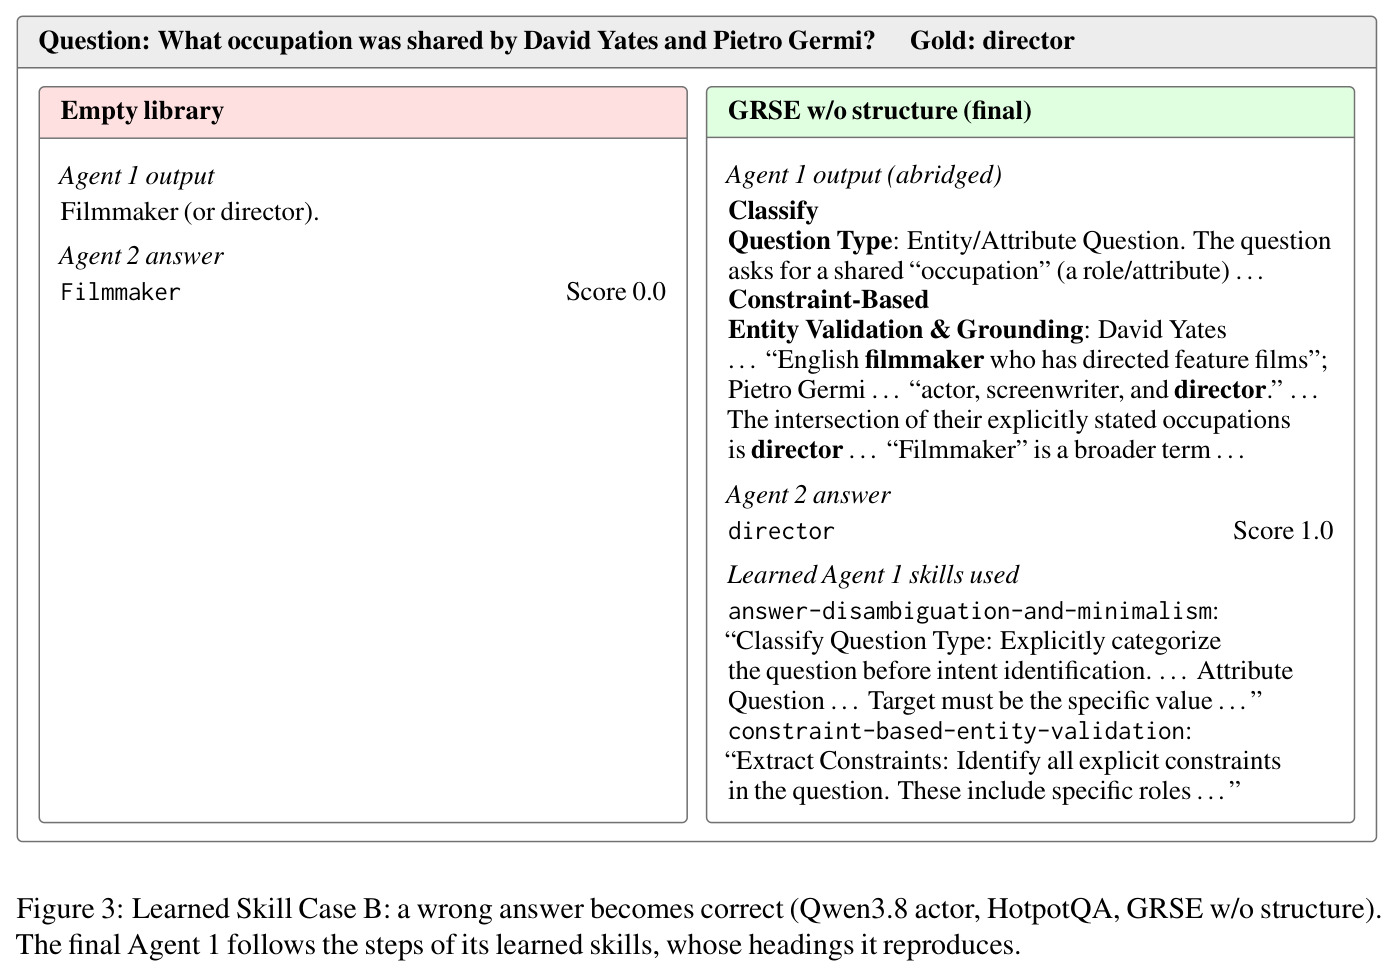
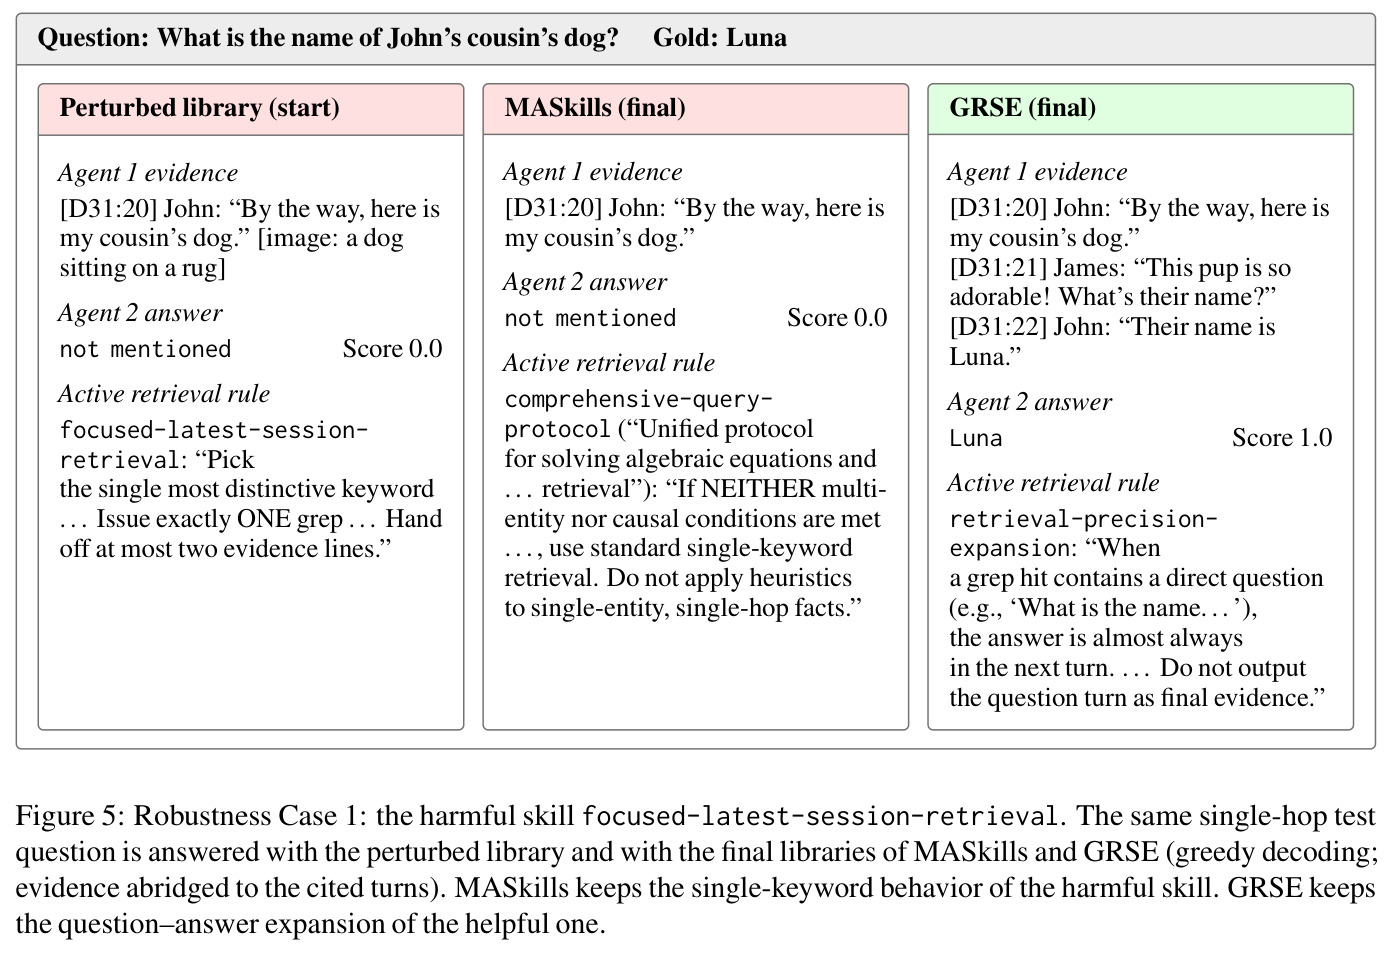
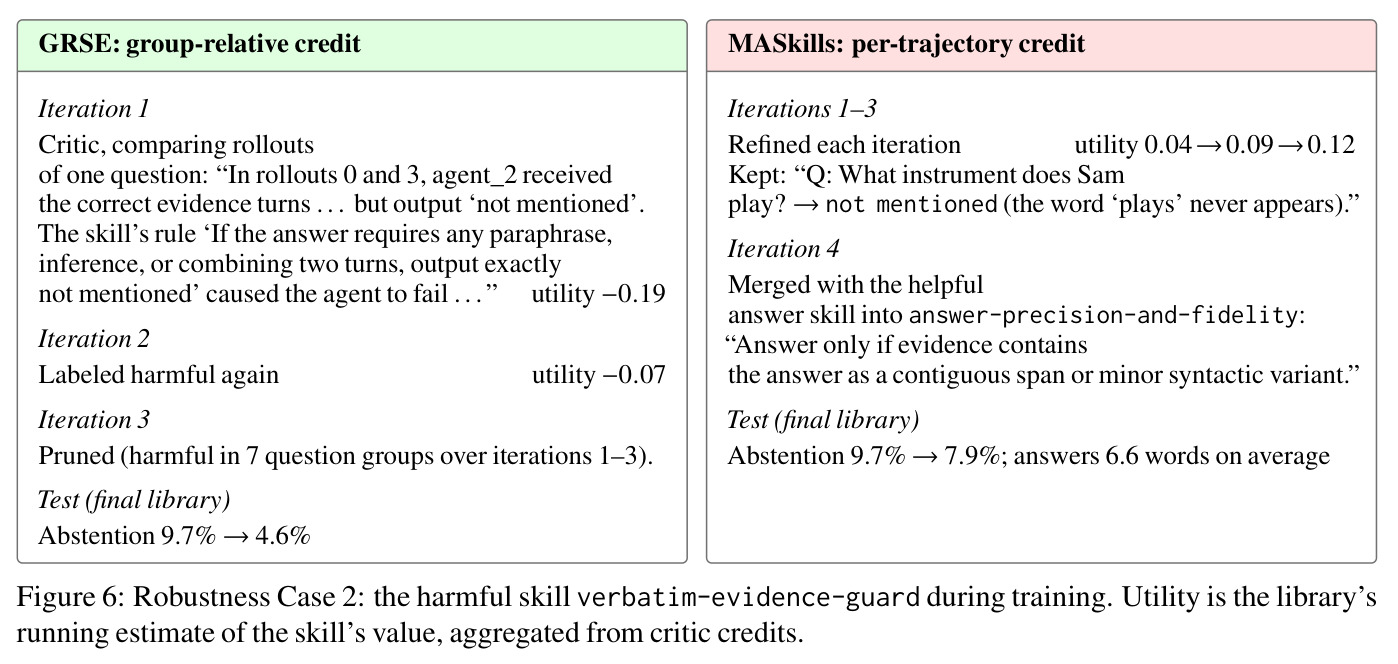
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HotpotQA 多跳问答(distractor-hard,Qwen3.8-27B 执行者) | 答案 token F1 ×100 | 83.7±0.5 | MASkills 80.6±0.6;空库 80.6;最强单模型 Self-Refine 84.1 | 较 MASkills +3.1 F1,距单模型上界仅 0.4 |
| HotpotQA(Gemma-4-31B-it 执行者) | 答案 token F1 ×100 | 82.8±0.4 | MASkills 82.3±0.2;空库 81.6 | +0.5 F1 |
| LoCoMo multi-hop(Qwen3.8-27B) | token F1 ×100(平滑 BLEU ×100) | 53.4±0.8(44.7±0.7) | MASkills 46.7±1.4(39.4±0.8);空库 49.7(42.8) | +6.7 F1(BLEU +5.3),为所有类别中最大增益 |
| LoCoMo multi-hop(Gemma-4-31B) | token F1 ×100 | 41.1±3.8 | MASkills 37.9±4.5 | +3.2 F1(BLEU +2.8) |
| LoCoMo temporal(两个执行者) | token F1 ×100 | 73.4±2.1(Qwen3.8)/ 67.4±1.4(Gemma4) | MASkills 72.8±1.3 / 61.3±2.4 | +0.6 / +6.1 F1,均为该方法在同类别最高 |
| 鲁棒性:修复受污染技能库(LoCoMo single-hop,453 题) | token F1 ×100(起点 60.6,弃答率 9.7%) | 66.9(+6.3,弃答率降至 4.6%) | MASkills 58.4(−2.2,弃答率 7.9%);「仅有用技能」参考 66.7 | 较 MASkills +8.5 F1,并恢复到干净库水平 |
| 技能效用符号判定(5 个植入的有用/有害技能) | 符号正确数 / help−harm 效用差 | 5/5 正确,差 0.31 | MASkills 3/5 正确,差 0.03 | 全部判对且区分度约 10 倍 |
| 消融:LoCoMo 四类共享库(842 题) | 四类平均 F1 ×100 | 54.9(空库 52.0) | w/o structure 53.9;G=1 54.1;DAPO filter 54.4;w/ label 53.0 | 完整版最优,结构化诊断贡献约 1.0 F1 |
局限与改进
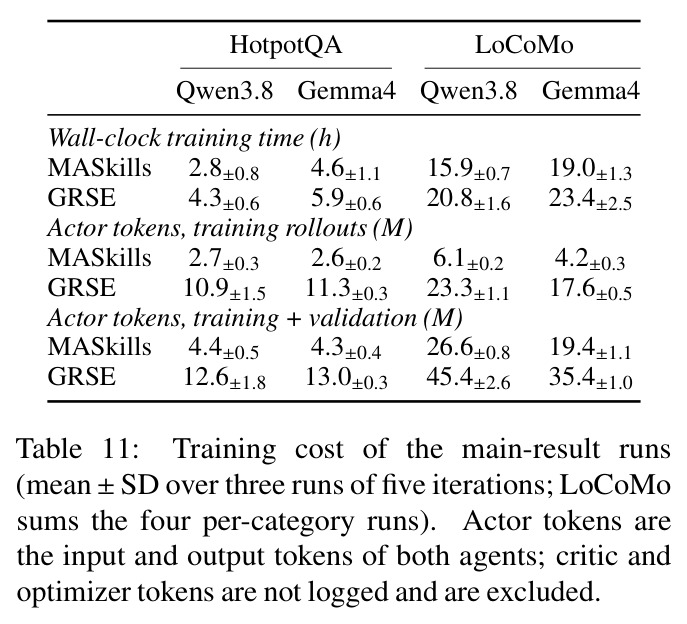
作者承认的局限:GRSE 用训练算力换信用精度——每题执行 $G=4$ 次使训练 rollout 的 actor token 开销达 MASkills 的 3.8–4.3 倍(如 LoCoMo Qwen3.8:23.3M vs 6.1M),含验证后总开销约 1.7–3.0 倍(45.4M vs 26.6M),墙钟时间因组内并行约 1.2–1.5 倍;好在推理时不增加任何开销。实验覆盖面有限:只有两个智能体的顺序通信团队、两个问答基准、一个批评家模型;开放域(仅 52 题)上 MASkills 更好,且该小类方差很大(GRSE ±6.4 F1)。我自己的观察:(1) 引用校验只保证「引用存在且动作一致」,解释本身仍是观察性的,批评家的因果判断没有被独立验证;(2) 验证门每题只执行 $H=1$ 次且容差 $\delta$ 只有 0.02–0.03,接受/拒绝决策可能被采样噪声支配;(3) 奖励只有最终答案的 F1/BLEU,交接质量、证据精度等中间行为没有直接信号,全靠批评家的文本判断;(4) 批评家与优化器固定为 Qwen3.8-27B,而执行者之一也是 Qwen3.8,存在自评偏差风险,论文未检验。
独立分析的弱点
独立分析四个弱点。第一,批评家单点依赖:所有信用来自一个固定 LLM,它的归因错误(如误判失败类型)会系统性传导进技能库;论文用「不确定即 no-edit」兜底,但没有多批评家交叉验证或回放检验。改进方向:引入多个异构批评家投票,或对关键归因做最小干预回放(替换被指控的技能重跑该组)验证因果。第二,组大小 $G=4$ 固定:对简单问题浪费算力,对难题统计功效不足;等奖励组虽保留但没有对比。改进:按验证集难度自适应 $G$,或改进 DAPO 式动态采样——注意消融显示照搬 DAPO 过滤会在开放域掉 4.1 F1,说明等奖励组的一致性信号确实有用,需要更精细的利用方式。第三,验证门偏弱:$H=1$ 次执行加小容差的门槛在几百题的验证集上噪声不小,可能偶然保留有害更新或拒绝有益更新。改进:只在「被编辑技能相关的问题子集」上做多次执行的定向检验。第四,评测域窄:责任结构只有「检索→回答」两级,更长工具链、并行或辩论式通信中的信用分配未验证,8 类失败类型也明显偏 QA 场景,直接迁移到代码/工具任务需要重新设计。
未来方向
作者提出的方向:扩展到更大的团队、非顺序通信、更长的工具密集型任务,以及不同的批评家模型。基于其成果可延伸的方向:(1) 与参数级训练结合——技能演化收敛后,用定位到的责任智能体-技能对指导选择性 RL 微调,让信用同时驱动文本与参数两层更新;(2) 终身技能库维护——Table 5 显示效用估计能在线追踪技能价值,可发展为持续学习中的技能生命周期管理,自动修剪随分布漂移而退化的技能;(3) 把引用校验从「形式检查」升级为「因果检查」,对争议归因做反事实回放;(4) 跨团队技能迁移——Table 6 已证明库可跨任务无损迁移,可研究技能的通用性分级、去重与组合机制;(5) 与自动化失败归因文献(如 Who&When 基准)结合,用真实系统的失败日志大规模检验归因精度;(6) 人在环审核——技能是可读的自然语言,可让领域专家审查高影响编辑后再部署,这对医疗等高风险场景(作者来自 Mayo Clinic,动机应在于此)尤其有价值。
复现评估
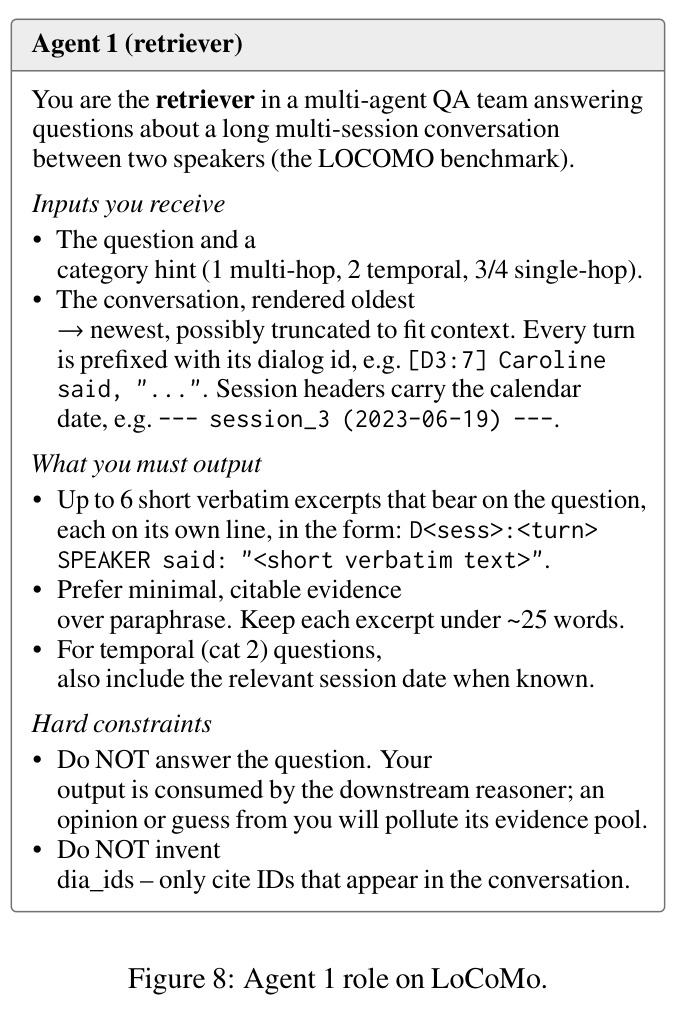
复现条件较好。代码开源(github.com/yananma1029/GRSE-Skills);数据全部公开:HotpotQA distractor-hard(CC BY-SA 4.0,100/50/500 划分)与 LoCoMo(CC BY-NC 4.0,2/2/6 对话划分,固定 seed 42);模型全部开放权重(Qwen3.8-27B 与 Gemma-4-31B-it),用 vLLM 0.29 部署,每个模型 2 张 RTX A6000(张量并行 2、65K 上下文),没有任何重量级训练。超参数完整披露(附录 Tables 7/8):$G=4$、$T=5$、$\delta=0.03/0.02$、库上限 8/4、算子调度、训练奖励定义,以及全部角色/批评家/算子提示词(附录 Figures 7–13)。成本方面:单次训练约 2.8–23.4 小时、总 actor token 约 4.4M–45.4M,一般实验室可负担。总体难度中等偏易:主要工程量在 vLLM 服务、JSON 模式批评家调用和技能文件格式处理;需注意论文报告的是三个随机种子的均值±标准差,结果对批评家输出质量敏感,批评家较弱时归因精度和稳定性可能明显下降(作者也承认部分运行与其他任务共享服务器,时间测量是近似的)。
论文图表
数据与模型的完整配置:HotpotQA distractor-hard 100/50/500 划分(测试索引 150–649);LoCoMo 2/2/6 对话划分(固定 seed 42,开放域 2/2/5),测试含 156 multi-hop、179 temporal、52 open-domain、453 single-hop;模型为 Qwen3.8-27B(同时任批评家/优化器)与 Gemma-4-31B-it,均给出 HuggingFace 修订号。
复现实验的输入清单:固定划分与模型版本号是结果可比性的基础,也说明「无对话跨划分泄漏」的实验卫生。