当用户改变主意时:测量并修复LLM智能体中的意图漂移 When Users Change Their Minds: Measuring and Repairing Intent Drift in LLM Agents
提出INTENTFLUX基准量化意图漂移,STATEFORGE显式状态折叠部分修复损失
前置知识
意图漂移 (Intent Drift)
在多轮人机交互中,用户会逐步提出、修改甚至撤回需求(如先要求用 Python 实现、后改用 Rust,或先附加约束、后又撤销)。意图漂移指一种特定失败模式:已被新意图取代的过时需求仍然影响智能体的最终回答或工具调用。它与单纯的遗忘不同——智能体记住了信息,但记错了哪部分仍然有效。
这是全文的研究对象。理解'过时信息继续影响输出'与'一般性多轮遗忘'的区别,才能理解本文为何要专门构造基准来隔离测量它。
可执行任务与原生评分器 (Executable Tasks & Native Graders)
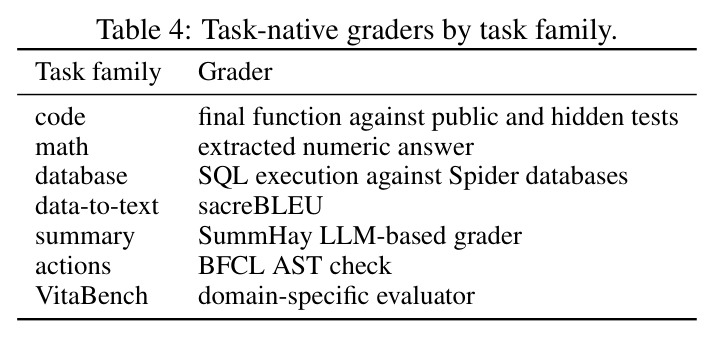
指带有客观判分机制的任务:代码通过测试用例、数学核对数值答案、SQL 在数据库上执行比对、工具调用用 AST 检查、data-to-text 用 sacreBLEU 等。INTENTFLUX 把这类任务改造成多轮对话后仍保留其原始评分器,使得最终答案可以被严格打分 $s_i \in [0,1]$,避免依赖主观 LLM 评判。
本文所有结论的可靠性都建立在'最终任务可验证'之上:只有 grader 客观,'服从了诱饵约束'才能被精确地判定为失败。
CAR 与 IDG 指标
CAR (current-ground-truth-intent alignment rate) 是在当前真实意图 $G^\star$ 下获得满分($s_i = 1$)的案例比例;clean 条件直接给出 $G^\star$,drift 条件需从演化对话中恢复它。IDG (intent-drift gap) 定义为 $\mathrm{IDG} = \mathrm{CAR}(\mathrm{clean}) - \mathrm{CAR}(\mathrm{drift})$,即同一案例配对下两种条件的差值,配合配对 bootstrap 置信区间报告。
论文的核心证据都以 clean–drift 配对的 IDG 形式呈现,读懂这两个指标才能理解所有主表的数字含义。
状态折叠 (State Folding)
与历史压缩(摘要、压缩上下文)不同,状态折叠是把编辑历史解析为一个显式的'当前活跃需求集合':删除或替换某个意图项时,不仅移除该项,还一并移除由它推导出的中间结论与计划。它回答的是'哪些信息仍然有效',而历史压缩只回答'保留哪些信息'。
STATEFORGE 的核心机制以及'压缩 harness 为何无效'的论证都依赖这一概念区分,是理解第 6、7 节的关键。
在线策略蒸馏 (OPD) 与思维蒸馏 (Thinking Distillation)
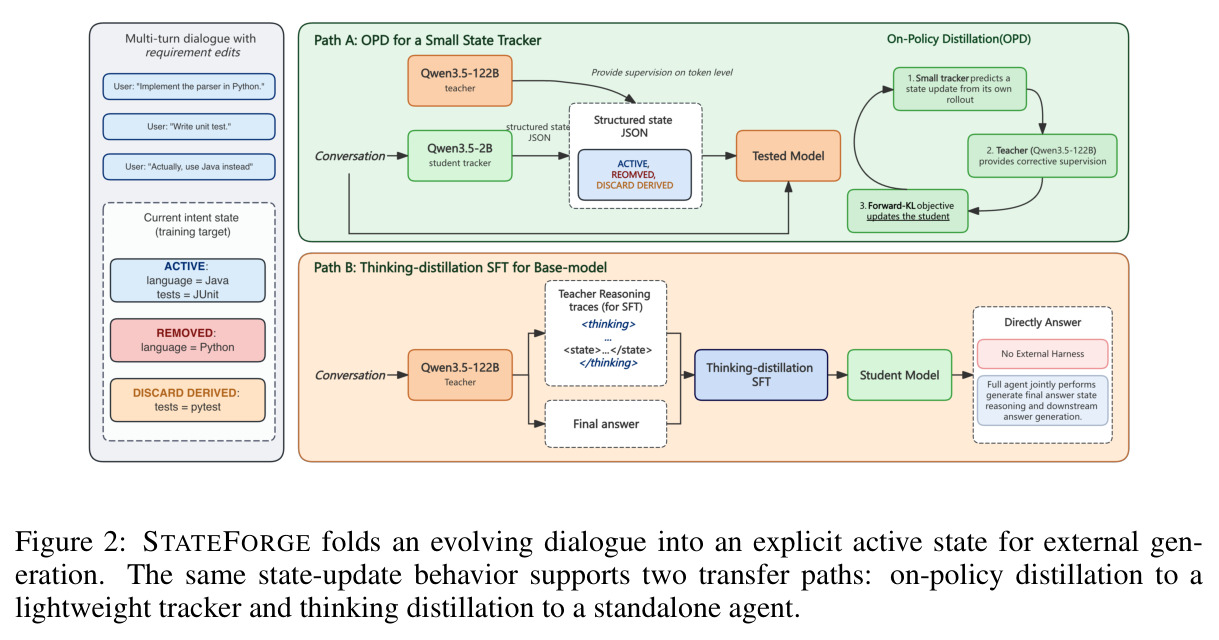
OPD (on-policy distillation) 让学生模型在自己的 rollout 上对齐教师输出(本文用于训练 2B 小型 tracker);思维蒸馏则把教师 rollout 中显式的状态更新推理过程蒸馏进一个独立智能体的思考链(本文用于 35B 全智能体)。二者对应'模块化 tracker'与'内化到基座'两条不同的部署路线。
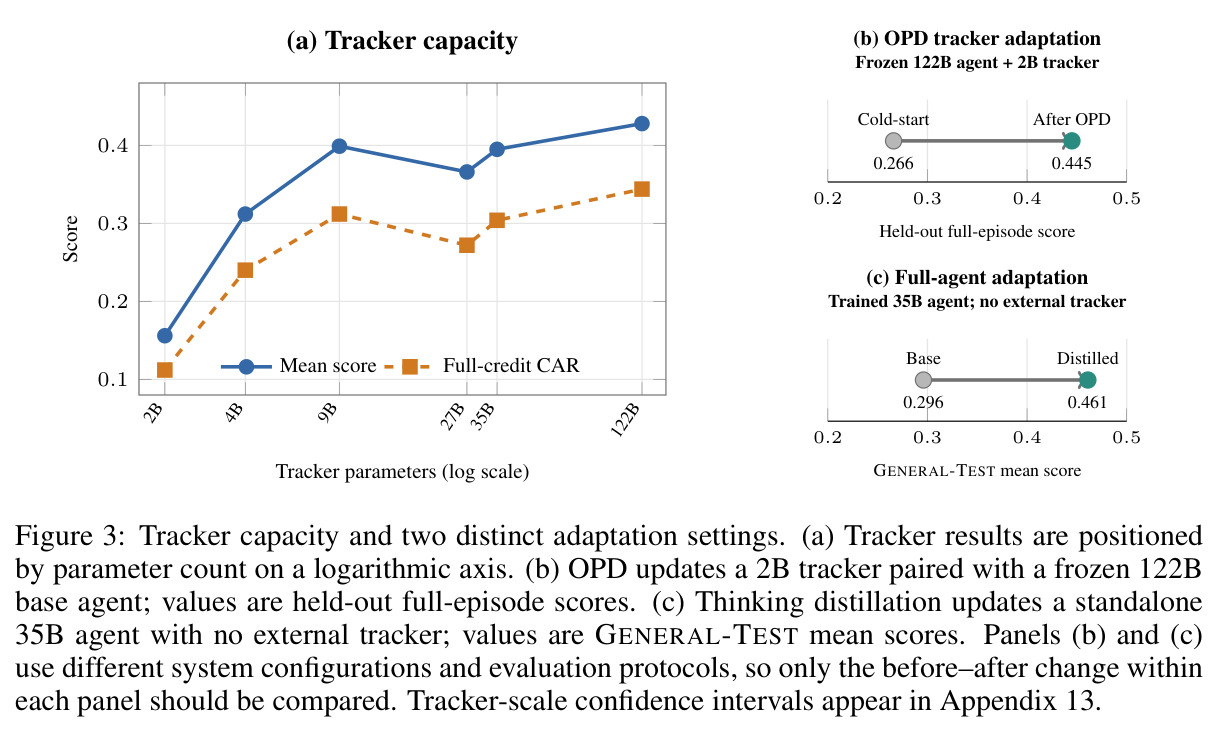
第 7.2–7.3 节的两条迁移路径是论文的修复方案主体,分不清这两条路径就无法理解 Figure 3 三个子图的实验设置差异。
研究动机
LLM 智能体通常在多轮交互中工作:用户先提出任务,随后修改参数、撤回约束、最终要求执行。此时智能体必须判断哪些需求仍然活跃。已有评测只覆盖了这个问题的不完整侧面:分片指令设置(Laban et al., 2025 的 'LLMs Get Lost in Multi-Turn Conversation')表明模型在信息逐步披露时丢失任务,演化意图评测(Tack et al., 2026)加入了参数揭示、修改与任务切换,但它们都只测量智能体是否最终完成了演化后的任务,无法区分'过时意图继续影响输出'与其他多轮错误(如遗忘、压缩损失、长对话退化)。研究这一失败模式需要同时具备两样东西:已知的最终意图,以及使用过时信息就必然改变任务结果的构造。例如用户先要求用 Python 写函数、后改口用 Rust,若模型最终交付 Python 代码,任务即失败——但现有基准无法把这类失败从其他失败中剥离出来单独计数。
本文的目标是本文要建立意图漂移的可测量、可复现的科学定义与评测协议:构造 INTENTFLUX 基准,把可验证的源任务(代码、数学、SQL、data-to-text、摘要、工具调用)转换为带受控意图编辑的多轮对话,同时保留源任务原生评分器,使得'使用过时意图'能通过任务成败被直接度量;用难度分层(variant/decoy 预算 $b \in \{1,3,5\}$)与 case 配对的 clean–drift 对照量化 8 个主流模型的漂移幅度;再诊断现有历史压缩 harness 是否足够,并提出显式状态维护方法 STATEFORGE 修复损失,最后探索两条可部署的迁移路径。
与已有工作不同的是,本文的独特切入有三点。第一,构造上的'评分器后果性'(grader-consequential):变体 (VARIANT) 是稍后被替换的合理替代值,诱饵 (DECOY) 是稍后被撤回的合理约束,且诱饵只在'服从它会改变源任务评分器判定'时才保留——这使过时信息的使用不是词面不匹配而是必然导致任务失败。第二,诊断视角的区分:既有 harness 评测回答'多轮是否完成',INTENTFLUX 回答'失败是否源于过时意图'。第三,修复思路的区别:历史压缩问'保留什么信息',而作者提出状态折叠问'什么信息仍然有效'——显式删除被取代项及其派生结论,而非指望生成器在压缩历史中自行甄别。
核心方法
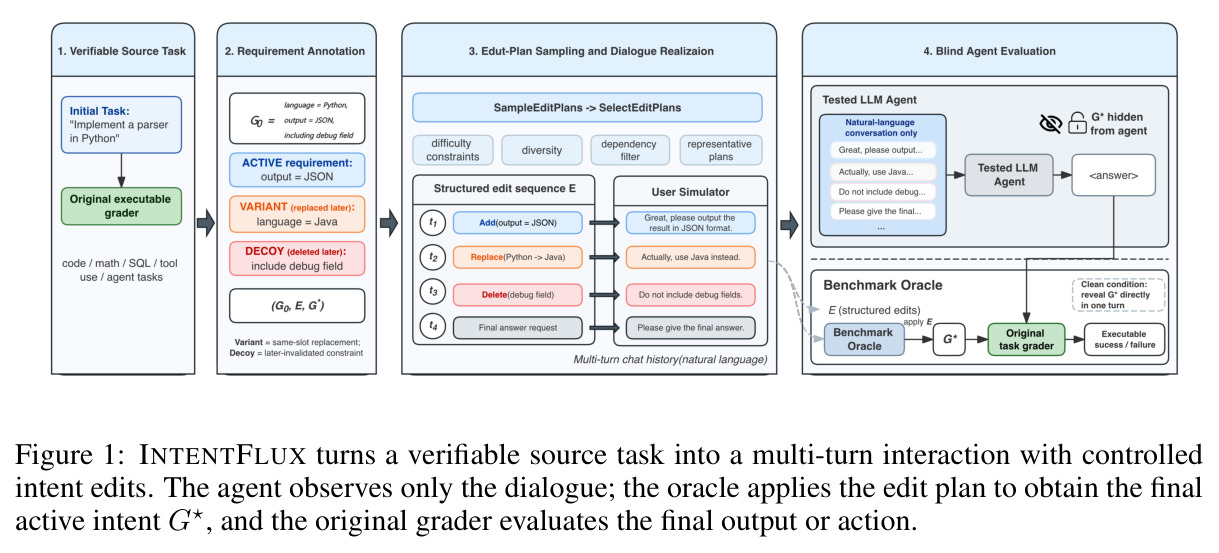
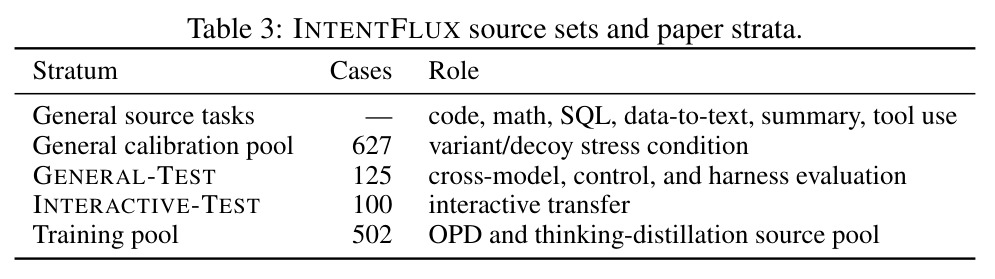
直觉上,一个任务的意图可以表示为有限个原子自然语言目标的集合 $\mathcal{G} = \{g_1, \ldots, g_n\}$;用户改主意就是一个编辑序列 $\mathcal{E} = (e_1, \ldots, e_K)$ 作用在初始意图 $\mathcal{G}_0$ 上,经 ADD、DELETE、REPLACE 三种算子得到最终活跃意图 $\mathcal{G}^\star$:$\mathrm{REPLACE}(g, g')$ 将状态从 $\mathcal{G}_t$ 变为 $(\mathcal{G}_t \setminus \{g\}) \cup \{g\'}$。技术上,INTENTFLUX 把每个可执行源任务分解为有序原子 shard 并转化为 $\mathcal{G}^\star$ 中的目标,再注入变体(被替代的候选值)与诱饵(被撤回的约束)构造漂移轨迹;用户模拟器(DeepSeek-V4-Flash)逐轮把编辑实现为自然语言,oracle 应用编辑序列得到 $\mathcal{G}^\star$,源任务原生评分器对最终输出打分。数据分为 627 任务校准池、502 任务训练池、125 任务固定测试集 GENERAL-TEST 和 100 任务的 INTERACTIVE-TEST(VitaBench 实时工具环境)。
核心创新有两层。基准层面:过时信息是受控注入且评分器后果性的——变体占据活跃意图项的位置后被替换,诱饵是合理但会被撤回的约束,且只保留'服从即改变 grader 判定'的诱饵,从而把'用了过时信息'变成可从任务成败直接读出的事件;同时用户模拟器在最后一轮只发出中性请求,不复述 $\mathcal{G}^\star$,避免泄漏答案。方法层面:STATEFORGE 把意图状态维护与下游求解分离——一个模型驱动的 tracker 在每个用户轮次后把观察到的编辑折叠为显式活跃状态,删除被取代意图项的同时级联删除由它们推导出的中间结论(状态区分'直接陈述的意图项'与'派生结论'两类);更新后的状态插入在可缓存的历史与当前输入之间,另配格式 tracker 维护输出约定、门控器检查并触发重生成。这与滚动摘要(Deep Agents)和两阶段压缩(OpenHarness)的本质区别在于:压缩保留信息但不裁决有效性,折叠显式裁决。
方法步骤详情
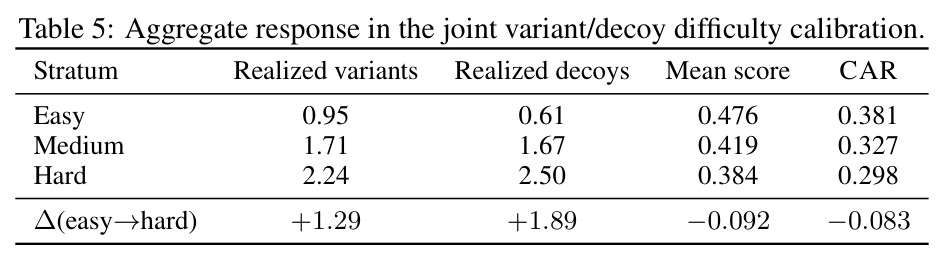
流程分五个阶段。(1) 源任务处理:把 LiveCodeBench、GSM8K、HumanEval、Spider、ToTTo、SummHay、BFCL 的每个问题分解为原子 shard(改动它就会改变所需输出或动作),映射为目标意图填充 $\mathcal{G}^\star$,保留源评分器(测试用例/数值比对/SQL 执行/sacreBLEU/SummHay 裁判/AST 检查)。(2) 标注与采样:人工标注行为改变型变体、合理诱饵及语义依赖约束,在依赖约束下采样编辑计划;难度预算 $b$ 限制每个目标的变体数与可用诱饵数(easy/medium/hard 分别为 1/3/5),实际实现均值如 hard 层为 2.24 变体、2.50 诱饵。(3) 对话实现:模拟器为每个活跃目标维护编辑队列、另设诱饵队列,逐轮选取可行编辑表达为自然话语,保序但允许跨目标交错;对话长度从 easy 的 13.2 轮增至 hard 的 37.1 轮。(4) 评测:oracle 应用编辑得 $\mathcal{G}^\star$,同一源案例配对构造 clean 条件(直接给出 $\mathcal{G}^\star$),原生评分器返回 $s_i \in [0,1]$,报告满分率 CAR 与 case 配对 IDG 及 bootstrap 置信区间。(5) STATEFORGE:每用户轮后 tracker 折叠状态,生成时把状态置于缓存历史与当前输入之间,门控器对输出约定做终检。迁移阶段:OPD 在冻结 122B 基座下训练 2B tracker(1 轮迭代从 0.266 到 0.445);思维蒸馏让 35B 智能体从教师 rollout 中内化状态折叠,脱离外部 harness 达到 0.461。
技术新颖性
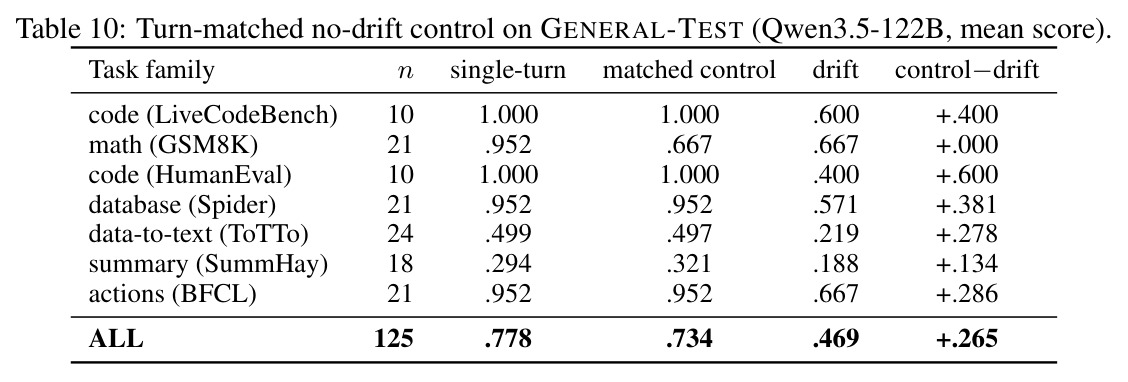
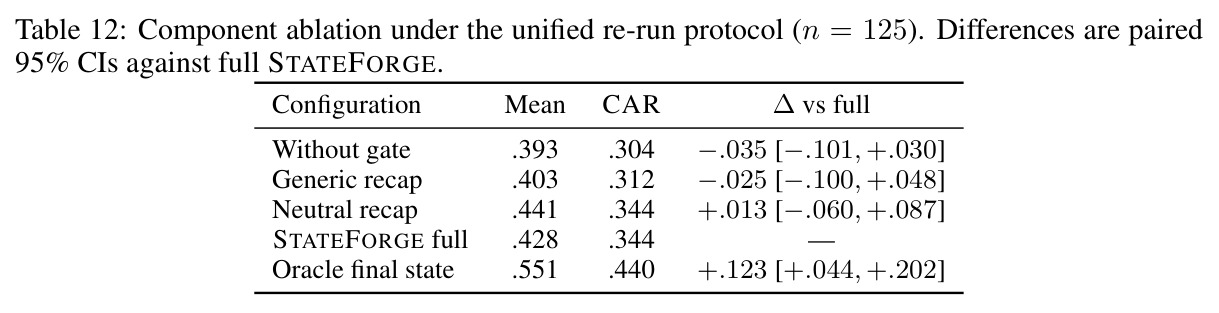
技术新颖性体现在四个方面。其一,诱饵的评分器后果性筛选是新的构造原则:此前演化意图工作(EvolIF、InterruptBench、Tack et al.)不保证'服从过时信息必然改变任务判定',本文保留诱饵前先验证其会翻转 grader 结论,使漂移可从任务成败推断。其二,状态折叠与历史压缩的概念区分被形式化并实验验证:压缩后的历史可能同时保留被替代值与其替换值,甚至保留由过时意图导出的局部自洽结论,本文首次把'级联删除派生结论'作为显式机制提出。其三,实验设计的严谨性:case 配对的 clean–drift 对照、长度匹配的无漂移对照(0.734 vs 漂移 0.469,排除轮数解释)、组件匹配的重跑消融(recap 基线在调用数与 token 预算上对齐全 harness),这种自我设限的归因纪律在基准论文中少见。其四,两条互补迁移路径的系统对比:模块化路径证明 9B tracker 与 122B 统计无差别,内化路径用思维蒸馏把行为吸收进 35B 智能体,为'状态维护应该是外挂模块还是模型能力'提供了首个量化证据。
实验结果
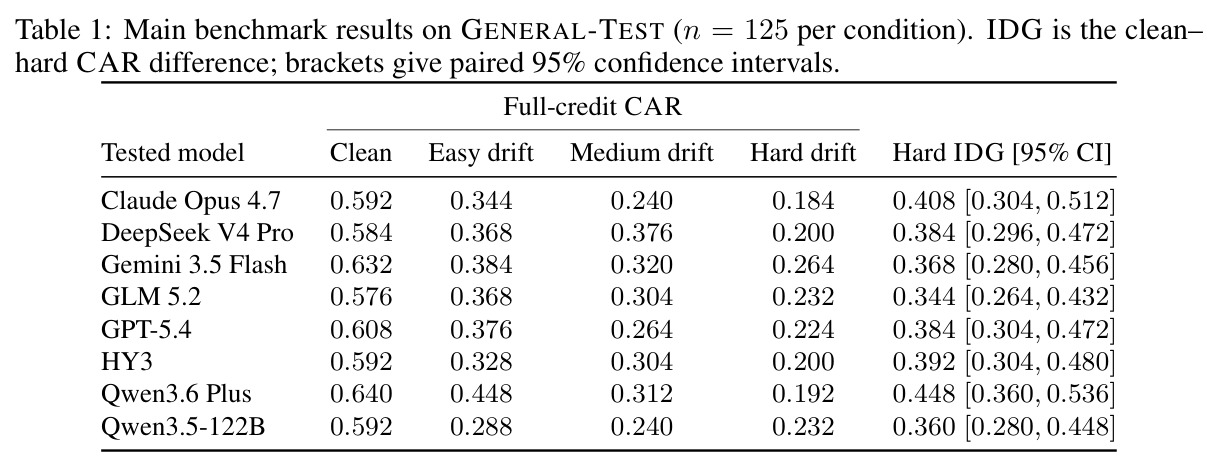
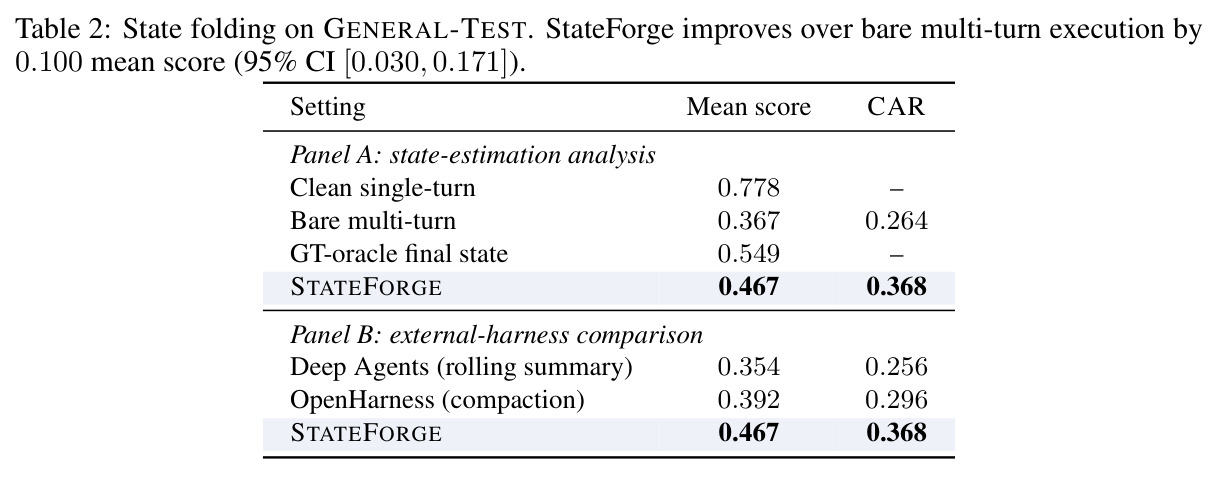
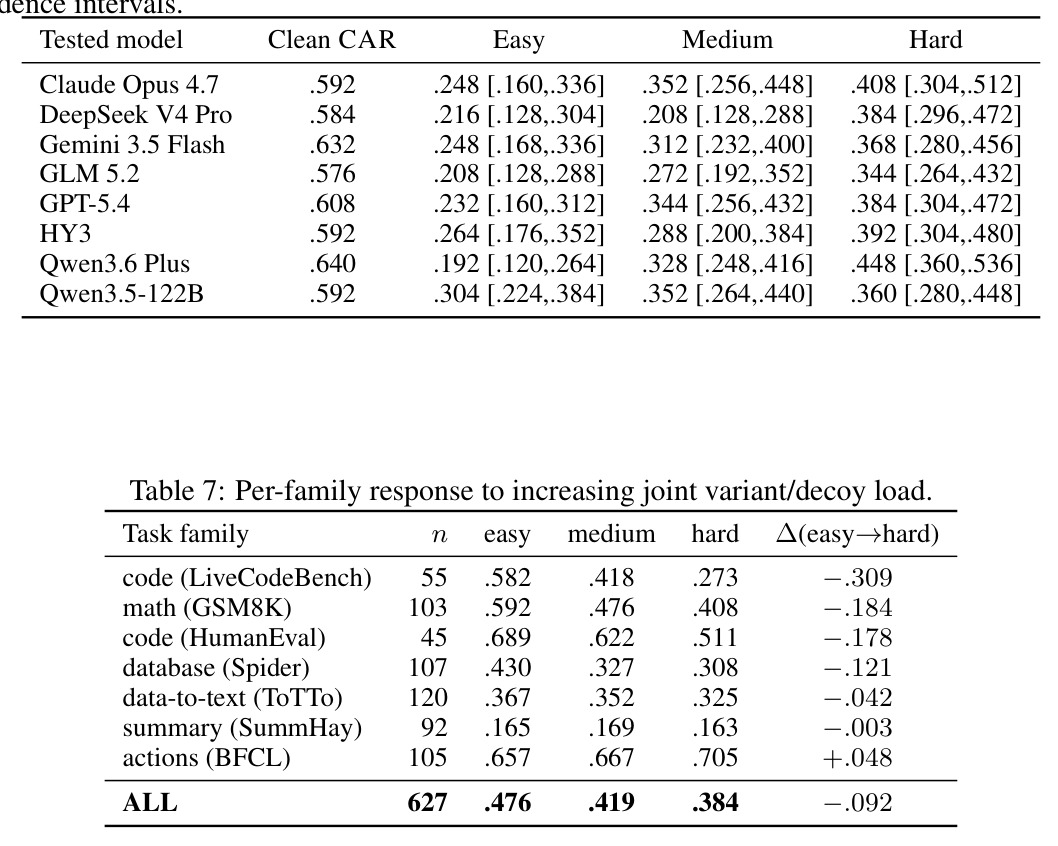
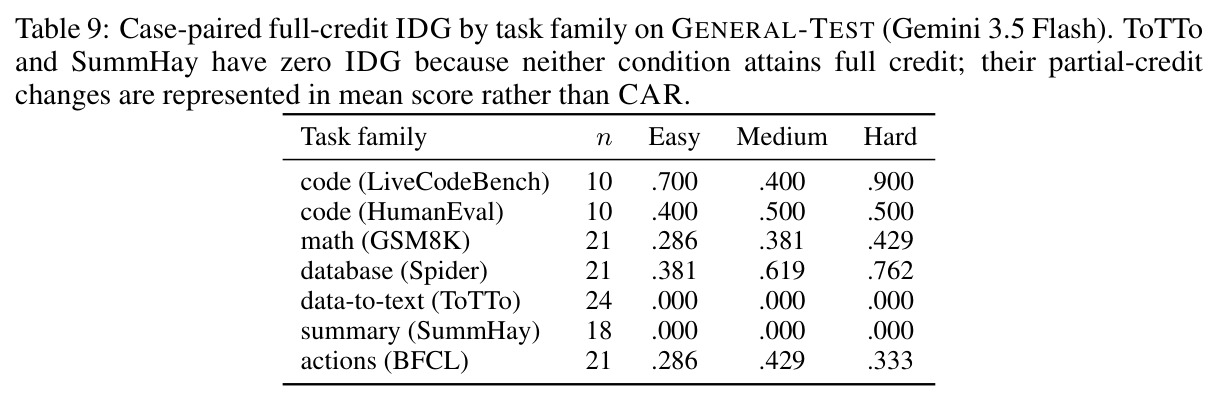
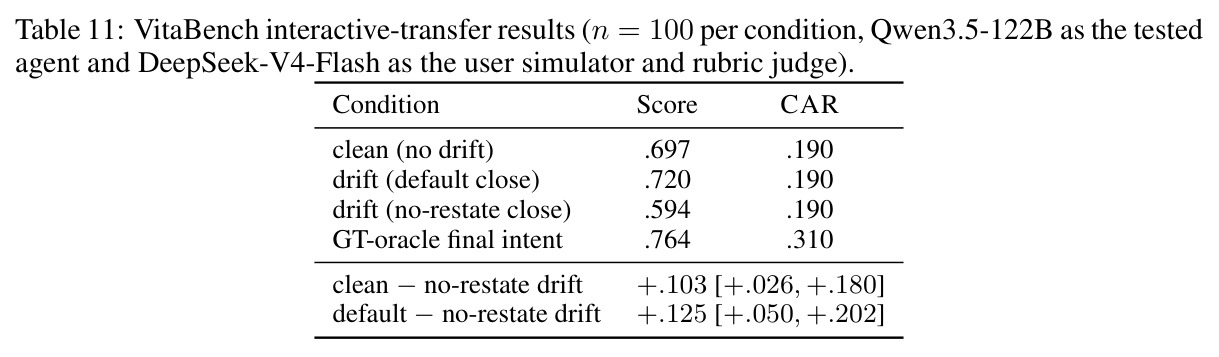
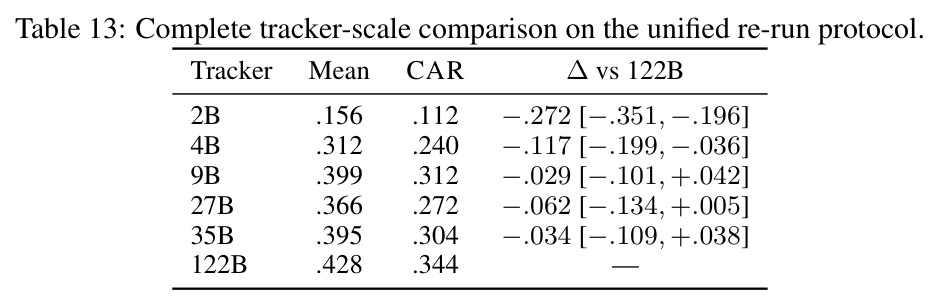
第一,漂移普遍且随负载加重:627 任务校准中平均分从 easy 0.476 降到 hard 0.384(相对下降 19.3%),CAR 从 0.381 降到 0.298。第二,8 个主流模型全部呈现正 IDG(Table 1):Claude Opus 4.7 clean CAR 0.592 降至 hard 0.184(IDG 0.408 [0.304, 0.512]),Qwen3.6 Plus 的 hard IDG 最高达 0.448,DeepSeek V4 Pro 为 0.384。第三,长度不是解释:轮数匹配的无漂移对照得 0.734,接近单轮 0.778,远高于漂移条件的 0.469(差 0.265)。第四,任务族异质(Table 7):LiveCodeBench 跌幅最大(-0.309)、GSM8K -0.184、HumanEval -0.178、Spider -0.121,而 BFCL 反常上升 +0.048,SummHay 停在 0.16 左右的地板。第五,交互迁移成立:VitaBench 上不复述最终意图时评分 0.594 对 clean 0.697(-0.103),而默认收尾复述会掩盖差距(0.720)。第六,压缩无效(Table 2 Panel B):Deep Agents 0.354、OpenHarness 0.392 均不高于裸多轮的 0.367。第七,STATEFORGE 有效但只部分修复:平均分 0.367 升至 0.467(+0.100,CI [0.030, 0.171]),CAR 0.264 升至 0.368;给真值最终状态升到 0.549,仍低于单轮 0.778,残余 0.229 差距说明状态估计错误只是部分原因。第八,状态维护不需要大模型:9B tracker(.399)与 122B(.428)统计无差别,2B/4B 显著更差;OPD 一轮迭代把 2B tracker 从 0.266 提到 0.445(超过同协议下 122B 的 0.428);思维蒸馏使独立 35B 智能体从 0.296 升至 0.461,但 clean 条件从 0.745 微降至 0.718。第九,消融的诚实结论(Table 12):与 token/调用数对齐的 generic recap(.403)和 neutral recap(.441)与全系统(.428)的配对差异置信区间均含零,只有 oracle 状态显示 +0.123 [0.044, 0.202] 的显著增益。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GENERAL-TEST 漂移条件任务求解 (n=125, Qwen3.5-122B) | case 配对平均分 / 满分率 CAR | STATEFORGE: 0.467 / 0.368 | 裸多轮 0.367 / 0.264;Deep Agents 滚动摘要 0.354;OpenHarness 压缩 0.392;真值状态 oracle 0.549;单轮 clean 0.778 | 较裸多轮 +0.100 (95% CI [0.030, 0.171]),较最强压缩 harness +0.075 |
| GENERAL-TEST hard 难度跨模型验证 (8 模型) | hard 条件满分率 CAR 与 case 配对 IDG | 基准本身无'本方法',报告漂移幅度:Qwen3.6 Plus hard CAR 0.192 / IDG 0.448 [0.360, 0.536] | 各模型自身 clean CAR 0.576–0.640;8 模型 hard CAR 0.184–0.264 | 全部 8 模型 IDG 为正(0.344–0.448),证明漂移是普遍失败模式而非个别模型缺陷 |
| 模块化 tracker 训练 (冻结 122B 基座 + 2B tracker) | held-out 完整回合得分 (tracker 训练协议) | OPD 后 2B tracker: 0.445 | 冷启动 2B tracker 0.266;同协议 122B tracker 0.428 | +0.179,一轮 OPD 即超过 122B 参考 tracker |
| 全智能体内化 (35B 独立智能体, 无外部 harness) | GENERAL-TEST 漂移条件平均分 | 思维蒸馏后: 0.461 | 蒸馏前 35B 基座 0.296;clean 条件 0.745 (蒸馏后 0.718) | +0.165,代价是 clean 条件下降 0.027 |
| VitaBench 实时工具环境交互迁移 (n=100) | rubric 评分 (partial credit) | 不复述最终意图的 drift 条件: 0.594 | clean 无漂移 0.697;默认收尾(复述意图)drift 0.720;真值意图 oracle 0.764 | clean 与 no-restate 差 +0.103 [0.026, 0.180],证实漂移效应延伸到真实工具调用场景 |
局限与改进
作者承认的局限:校准把变体与诱饵预算耦合为联合负载 $b \in \{1,3,5\}$,只能支持联合陈旧信息负载的结论,无法给出变体与诱饵的分离因果效应;长度对照只排除轮数,消息顺序与编辑措辞仍是构造的固有属性;外部 harness 对比与 INTERACTIVE-TEST 各只用一个被测模型(Qwen3.5-122B),且前者基于重放轨迹;组件消融在 $n=125$ 下无法把显式状态表示从对齐的 recap 基线中分离出来;INTENTFLUX 把意图建模为有限原子目标集合,只覆盖有可执行或可分解意图结构的任务。我补充观察:IDG 度量的是'从对话恢复最终意图'的总损失而非单一因果因子,作为诊断指标其归因能力有限;BFCL 反常上升 +0.048 暴露 AST 检查可能对 slot 绑定错误不敏感;SummHay 长期处于低分地板使 IDG 恒为 0,属于天花板/地板效应而非真正鲁棒;用户模拟器审计仅 100 条话语样本,模拟器措辞本身是协议的一部分;蒸馏带来的 clean 性能回退(0.745→0.718)提示内化与通用能力之间存在权衡。
独立分析的弱点
弱点一:核心系统贡献的证据强度不足。Table 12 显示在调用与 token 对齐后,简单的 neutral recap(.441)甚至点估计高于 STATEFORGE 全系统(.428),置信区间重叠,这意味着'显式状态表示优于匹配回顾'并未被证明,论文的修复叙事主要靠 oracle 行撑起。改进方向:扩大到 500+ 案例或多种子重复,并对 tracker 错误做逐案例误差分解,找出显式状态在哪些编辑类型上真正超越 recap。弱点二:BFCL 的反常上升(+.048)与 REPLACE 失败模式(新值绑错函数调用 slot)说明 AST 级评分对'语义正确但绑定错误'不敏感,可能系统性低估工具调用漂移。改进方向:引入 slot 级对齐诊断并计入部分惩罚。弱点三:单模拟器(DeepSeek-V4-Flash)单裁判的协议使结论依赖特定模型的措辞风格,96%/97% 的保真度/连贯性审计仅基于 100 条样本。改进方向:跨 2–3 个模拟器复现关键表格并扩大人工审计。弱点四:GSM8K 在长度对照中出现提前承诺失败(对照 0.667 vs 单轮 0.952),暗示第一轮即给出完整任务反而诱发轻率作答,这对 clean 条件本身的有效性是个隐患。弱点五:状态折叠只在小规模任务集合上验证,37.1 轮的 hard 对话已是上限,数百轮真实长会话下的 tracker 漂移未测。
未来方向
作者指向的方向:(1) 因子化实验设计,把变体、诱饵、轮数、措辞的边际效应分离;(2) 两条迁移路径的 scaling 行为——2B tracker 的 OPD 与 35B 智能体的思维蒸馏都只有单点训练,数据规模与模型规模的响应曲线未知;(3) 状态表示升级:trace 检查表明漂移不只是保留已删内容,还包括把新值绑到错误槽位,因此需要表达意图项身份与依赖关系的状态结构,而非扁平目标列表。我基于成果延伸:(4) 把状态折叠与 RAG/长期记忆系统结合——Uddin et al. 的记忆失效基准与本文机制天然互补,折叠器可作为记忆写入门控;(5) 在线学习闭环:OPD 用可执行失败做监督的思路可推广到部署后持续收集漂移案例自训练 tracker;(6) 将 INTERACTIVE-TEST 的'收尾复述泄漏'问题形式化为评测协议规范,提醒所有交互式基准检查自己是否无意中供给了被测状态;(7) 探索推理时算力分配:门控重生成与状态验证可以做成自适应触发,平衡延迟与准确率。
复现评估
复现难度中等偏高但路径清晰。有利条件:论文声明提供匿名化 artifact,包含完整模型配置、vLLM 部署细节、种子与 bootstrap 设置;主被测模型 Qwen3.5-122B-A10B-FP8 可本地 vLLM 部署,模拟器/裁判 DeepSeek-V4-Flash 为商用 API,评测端算力需求主要是 125 案例 × 多条件的推理。不利条件:基准构造流程重——需要 gpt-4.1 做构造、人工标注每个变体/诱饵/语义依赖三元组、下游审计恢复 95% 的 $\mathcal{G}^\star$,复现者若要自建同等质量数据需可观的标注预算;OPD 训练 2B tracker 与思维蒸馏 35B 智能体涉及 502 任务训练池上的策略采样与蒸馏训练,需要多卡 GPU 集群;模拟器审计、单模型限制等协议选择也要求复现者严格对齐(如收尾不复述 $\mathcal{G}^\star$)。若只复现评测(拿现成构造数据跑 STATEFORGE 与压缩基线),一周内可完成;若连数据构造带训练全链路复现,预计需要数周与专业团队。
论文图表
8 个模型在 easy/medium/hard 三个难度的 case 配对 IDG 及 95% 置信区间,全部为正且大多随难度增长,如 Claude Opus 4.7 从 easy 0.248 增至 hard 0.408。
比 Table 1 更细的配对证据:每个模型在每个难度的漂移量及其显著性,排除总体均值掩盖个别模型行为的可能。
8 模型 × 3 难度的原始'平均分/CAR'网格,如 Claude Opus 4.7 从 easy .444/.344 降至 hard .268/.184,Qwen3.5-122B 三层均约 .24-.29 明显低于其他模型。
不经 CAR 二值化的原始分数视图,确认退化模式不依赖把连续任务分折算为满分率的处理方式。