AdaExploreBench:评测 LLM 智能体在演化环境中主动探索与测试时适应能力的基准 AdaExploreBench: Benchmarking LLM Agents for Proactive Exploration and Test-time Adaptation in Evolving Environments
构建含隐性规则漂移的交互式评测基准,揭示 LLM 智能体主动探索与假设修正能力的短板
前置知识
LLM Agent(大模型智能体)
以大语言模型为决策核心、通过工具调用与环境进行多轮交互的系统。智能体观察环境反馈后自主决定下一步动作,例如调用探查工具、提交决策批次等。与单轮问答不同,智能体的行为是一个序列,早期动作会影响后续可用的信息与选项。
本文评测的对象就是智能体而非裸模型:整个基准测的是 agent 在交互环境中"何时探索、探索什么、探索多少"的行为序列,理解 tool call 与多轮回合机制才能看懂运行时协议。
主动探索(Proactive Exploration)
指智能体自己决定何时与环境交互、交互什么内容、交互多少次,以主动收集决策所需证据,而不是被动接受系统给定的观测或材料。在科学发现、临床诊断等场景中,证据必须靠有针对性的提问(探针)才能获得。
这是本文的核心测量维度之一。基准刻意不提供现成证据,探针完全由模型自主设计,实验发现"会利用证据"和"会获取证据"是两种差异巨大的能力。
测试时适应与概念漂移(Test-time Adaptation / Concept Drift)
概念漂移指部署后数据或环境的统计规律随时间悄然变化(如金融欺诈手法演变),导致在旧规律上学到的假设失效。测试时适应要求系统在推理阶段在线检测这种变化并更新自身知识,而不依赖重新训练。
本文把规则漂移作为环境动态的具体化:规则在交互中途不宣布地改变,agent 必须从效用反馈的退化中察觉"旧知识已过期"并重新探索,这正是漂移适应的经典难题在智能体上的映射。
规则归纳(Rule Induction)
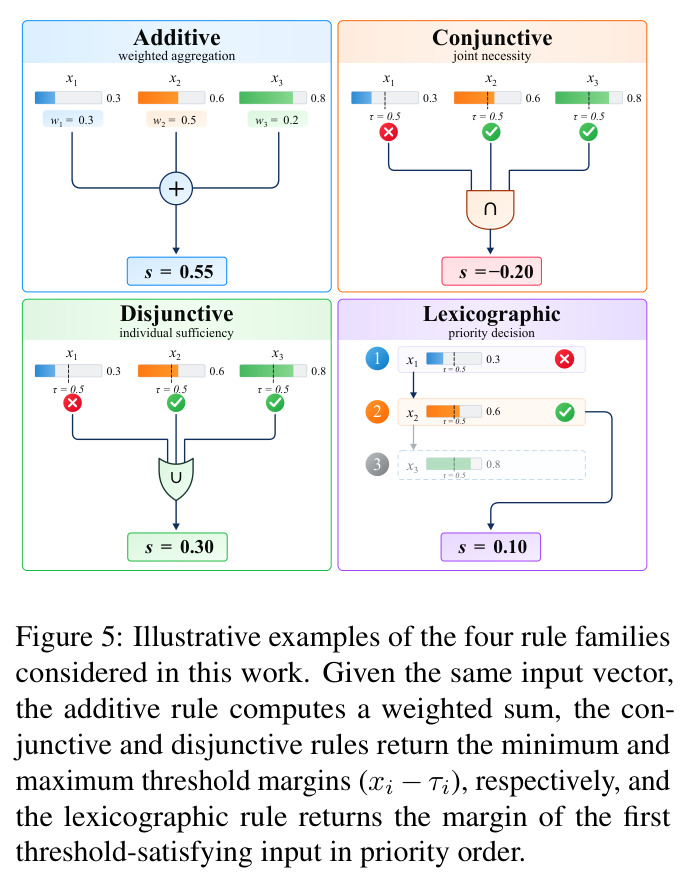
从观测样本中推断隐藏的输入-输出映射规则。本文的四个规则家族(加法聚合、合取门控、析取充分、词典序优先)源自决策科学中对人类属性组合策略的分类(Einhorn 1970; Payne et al. 1993),每个家族对应一种"多个线索如何合成一个决策"的结构。
看懂四个规则家族的定义(加权求和、全条件、任一条件、按优先级)才能理解环境如何打分,以及辅助评估中"因子识别"和"变化识别"两个指标到底在测什么。
校准准确率(Calibrated Accuracy, CA)
对"接近最优"的动作按实际效用给部分得分的指标:先计算 $p_i=\frac{u_i(\hat{a}_i)-\min_a u_i(a)}{\max_a u_i(a)-\min_a u_i(a)}$,再减去随机策略基线并归一化,即 $\mathrm{CA}=\frac{\bar{p}-\bar{b}}{1-\bar{b}}$,使均匀随机策略期望得 0、最优策略得 1。
主结果全部以 CA 报告;EA 与 CA 的差距还能区分"错得多"与"错得贵"——弱模型两者差距高达 8-22 点,说明其错误选择往往落在效用更低的动作上。
研究动机
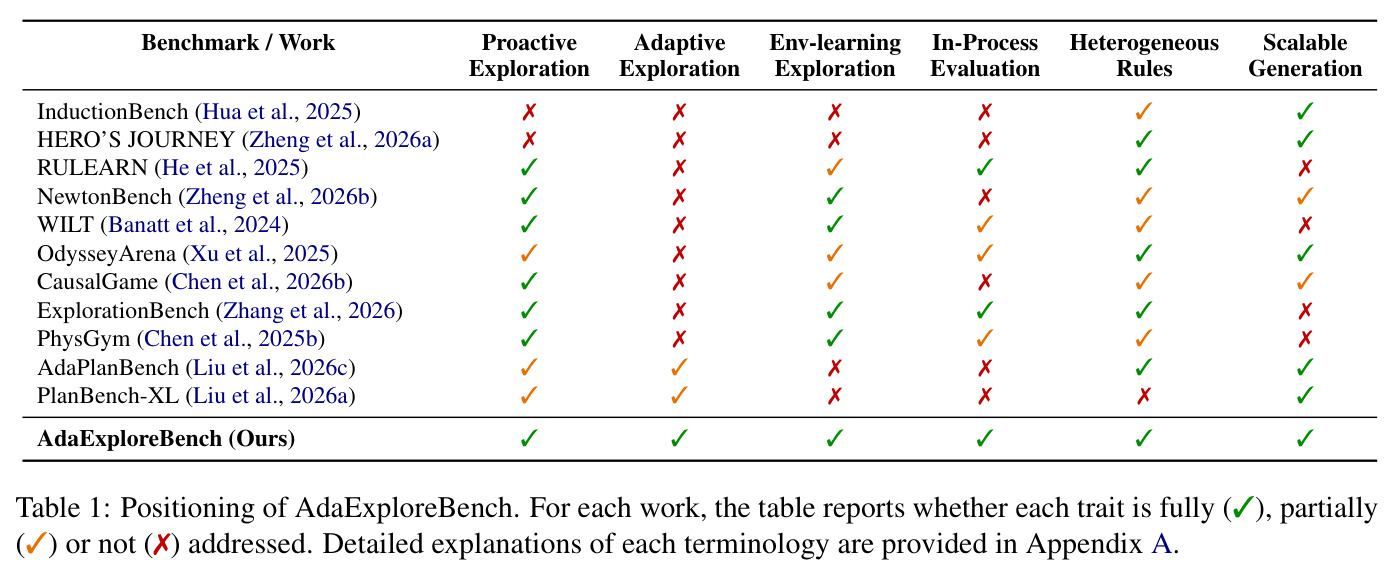
LLM 智能体正被部署到不熟悉、部分可观测的交互环境中,无法依赖给定观测,必须主动与环境交互收集证据。但现有基准存在两大结构性缺陷。其一是证据来源不干净:InductionBench、Hero's Journey 等归纳基准把观测序列直接喂给模型,RuleARN 等工作甚至会把模型没有询问的信息从环境中泄漏出来,agent 从未被迫"主动获取"证据。其二是环境过于静态:NewtonBench、CausalGame、ExplorationBench、PhysGym 等测试期间底层规则从不改变,而现实中——例如信用卡欺诈检测(Lucas & Jurgovsky 2020)或流数据挖掘(Gama et al. 2014)——潜在规律会随时间漂移,先前收集的证据会悄悄过期。作者在 Table 1 中用六个维度(主动探索、适应探索、环境学习、过程内评估、异构规则、可扩展生成)逐一检查 11 个先前基准,没有一个同时满足全部六项:最接近的 AdaPlanBench 和 PlanBench-XL 有适应但完全缺少环境学习维度,而各种科学发现类基准则普遍缺少适应探索和过程内评估。因此"LLM 智能体能否主动探索以理解和适应环境动态"这一关键问题,此前根本没有合适的测试床可以回答。
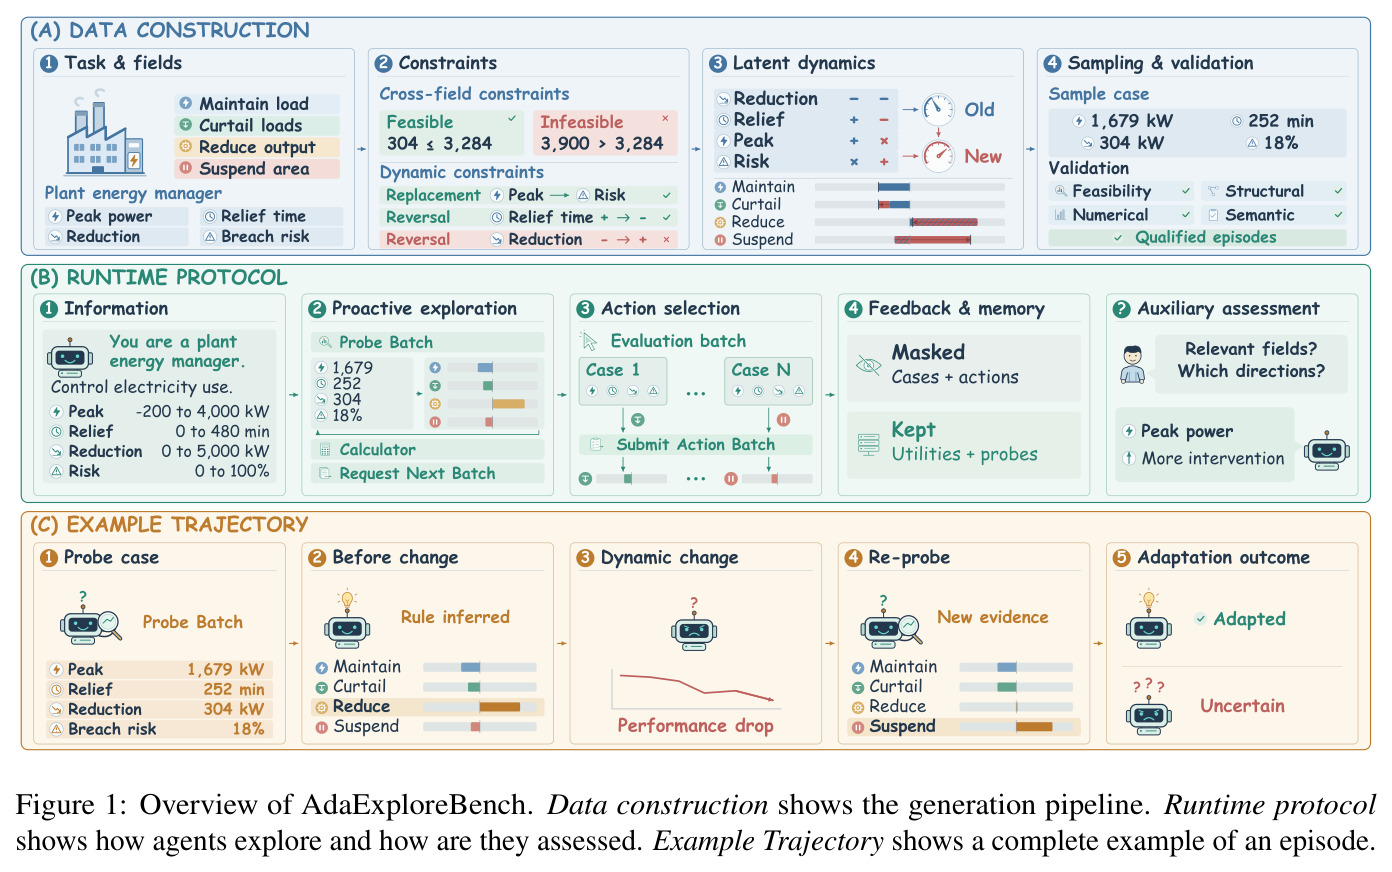
本文的目标是本文的目标是构建一个能同时考核"主动探索"与"测试时适应"的评测基准 AdaExploreBench,具体拆成四个可操作的设计目标:(1) 自主导向的环境探索——把环境动态实例化为从动作到结果的潜在规则,agent 必须自己设计探针案例、决定探查时机与数量来归纳规则,而不是消费给定证据;(2) 不宣布的环境变化——隐性规则漂移(implicit rule drift)在交互中途悄然发生:替换一个相关因子并反转另一个因子的作用方向,agent 必须从退化的效用反馈中识别"先前知识已失效"并重新探索;(3) 可扩展的构造管线——用 LLM 辅助生成加数值认证与语义审查,无需人工劳动即可产出 256 个评估实例和 1000 个训练实例,覆盖四个规则家族和四个应用领域;(4) 过程内评估——评估案例以小批次顺序呈现,性能曲线贯穿整个交互过程,而非只看最终结果。最终在 8 个前沿 LLM 上系统量化当前智能体在探索与适应上的能力缺口。
与已有工作不同的是,本文的独特切入角度有三个。第一,对"环境动态"的实例化方式:不建模任务约束变化或工具失效(如 AdaPlanBench、PlanBench-XL 的做法),而是让环境规律本身——动作到结果的映射——发生复合式漂移(一个因子被替换 + 一个因子的方向被反转),且每个变化必须由一个语义连贯的触发事件驱动,这比统计意义上的分布偏移更贴近"世界运行规则变了"。第二,评估历史遮蔽(evaluation history masking):已完成的评估案例和所选动作会从后续上下文中删除(只保留效用数字),而智能体自己采集的探针观测全部保留——这个设计把"主动探索获得的证据"与"环境提供的证据"干净地分离,使 Default 设置下的失败可以归因于证据获取能力本身。第三,把探查设为可选而非强制:agent 可以直接 request_next_batch 跳过探查,因此探索的意愿、数量与质量本身成为被测对象;配合漂移前后两次辅助评估(因子识别与变化识别),"规则归纳"得以从"动作执行"中剥离,失败可被分解为探索不力、归纳不准或假设修正失灵三类。
核心方法
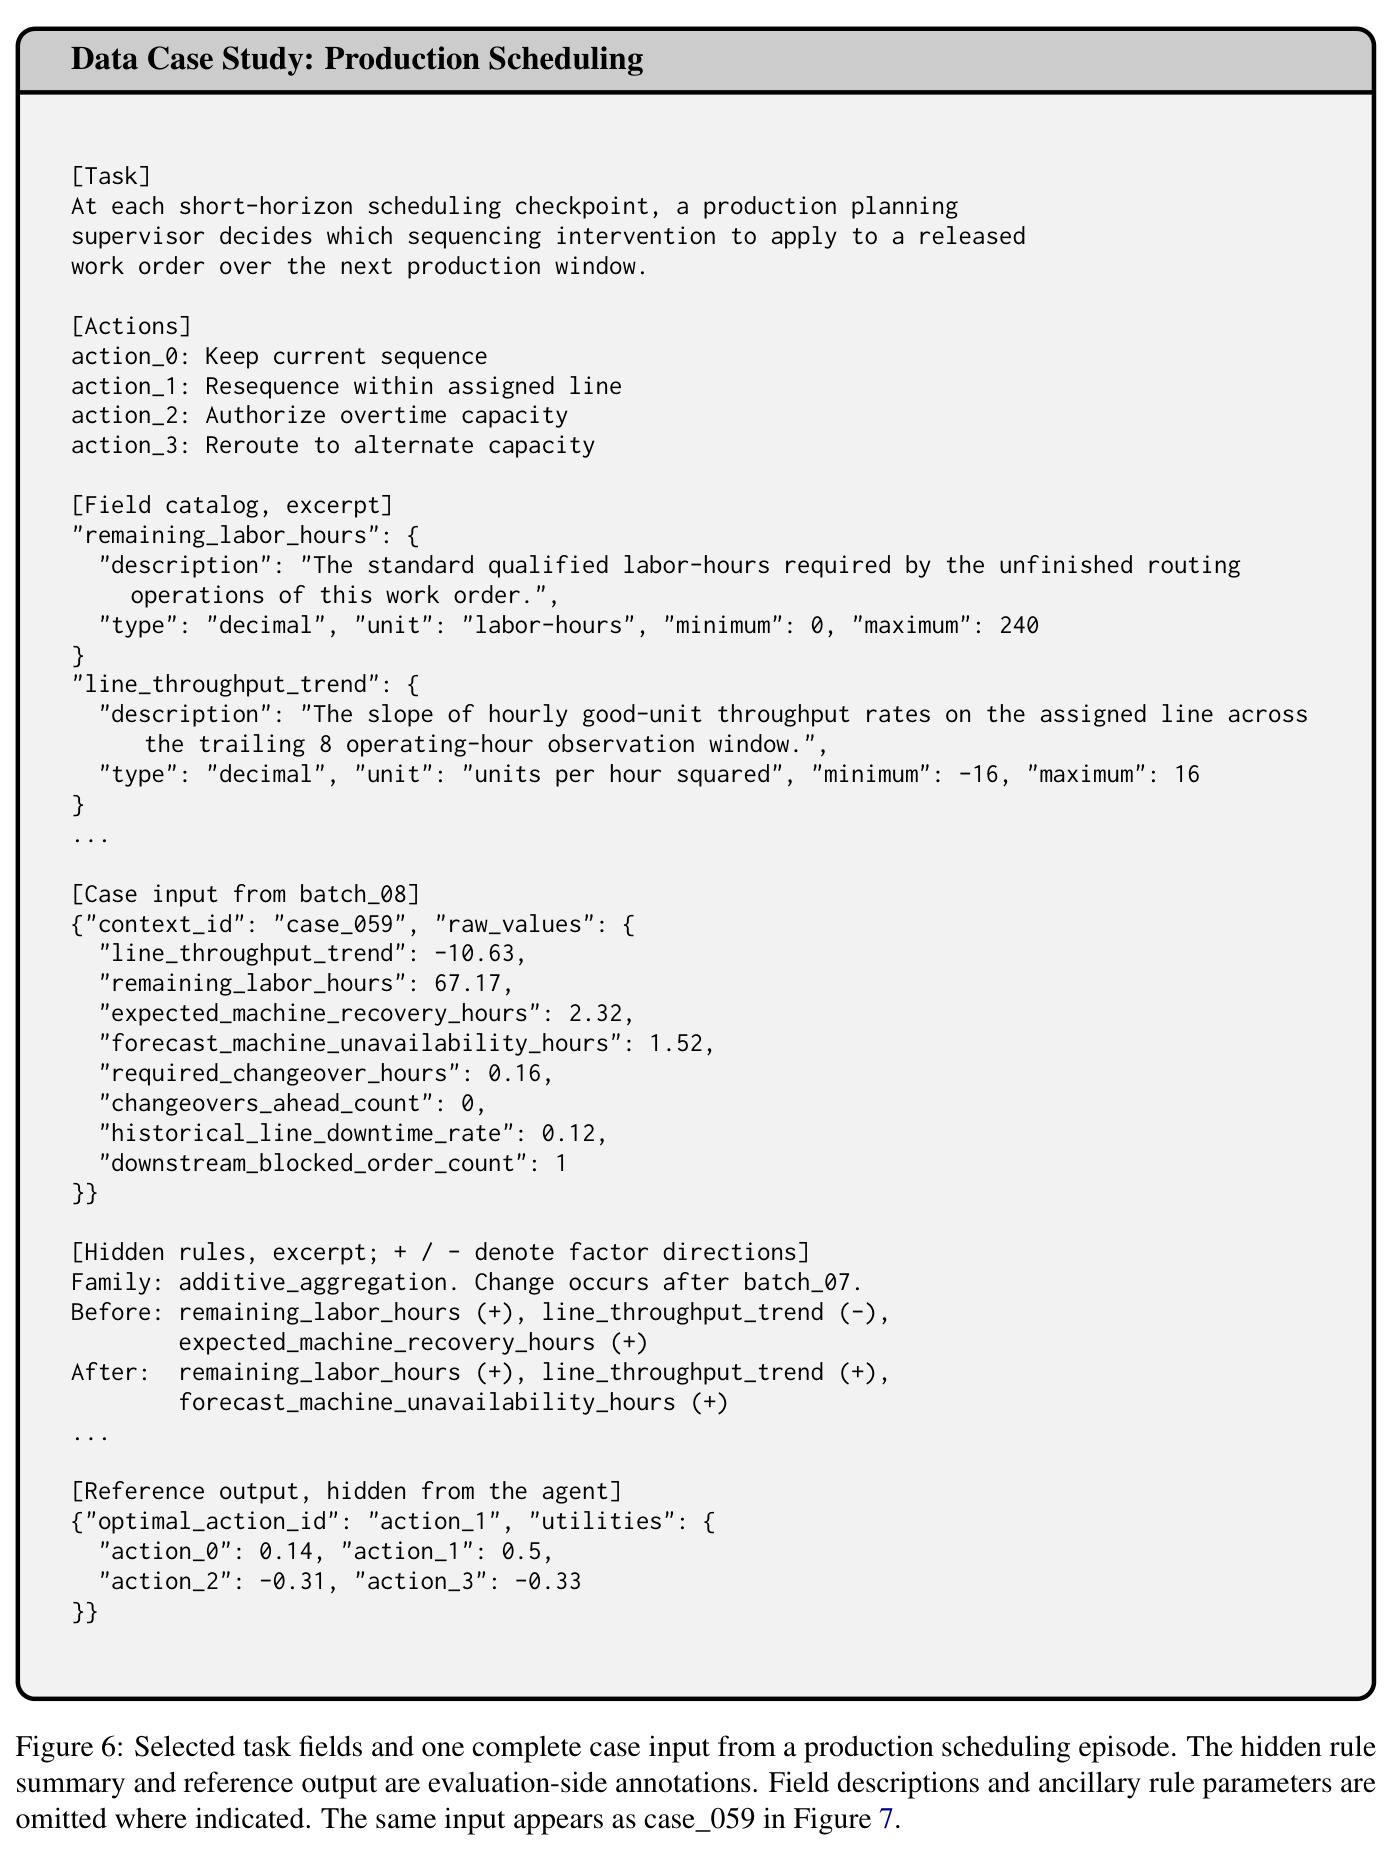
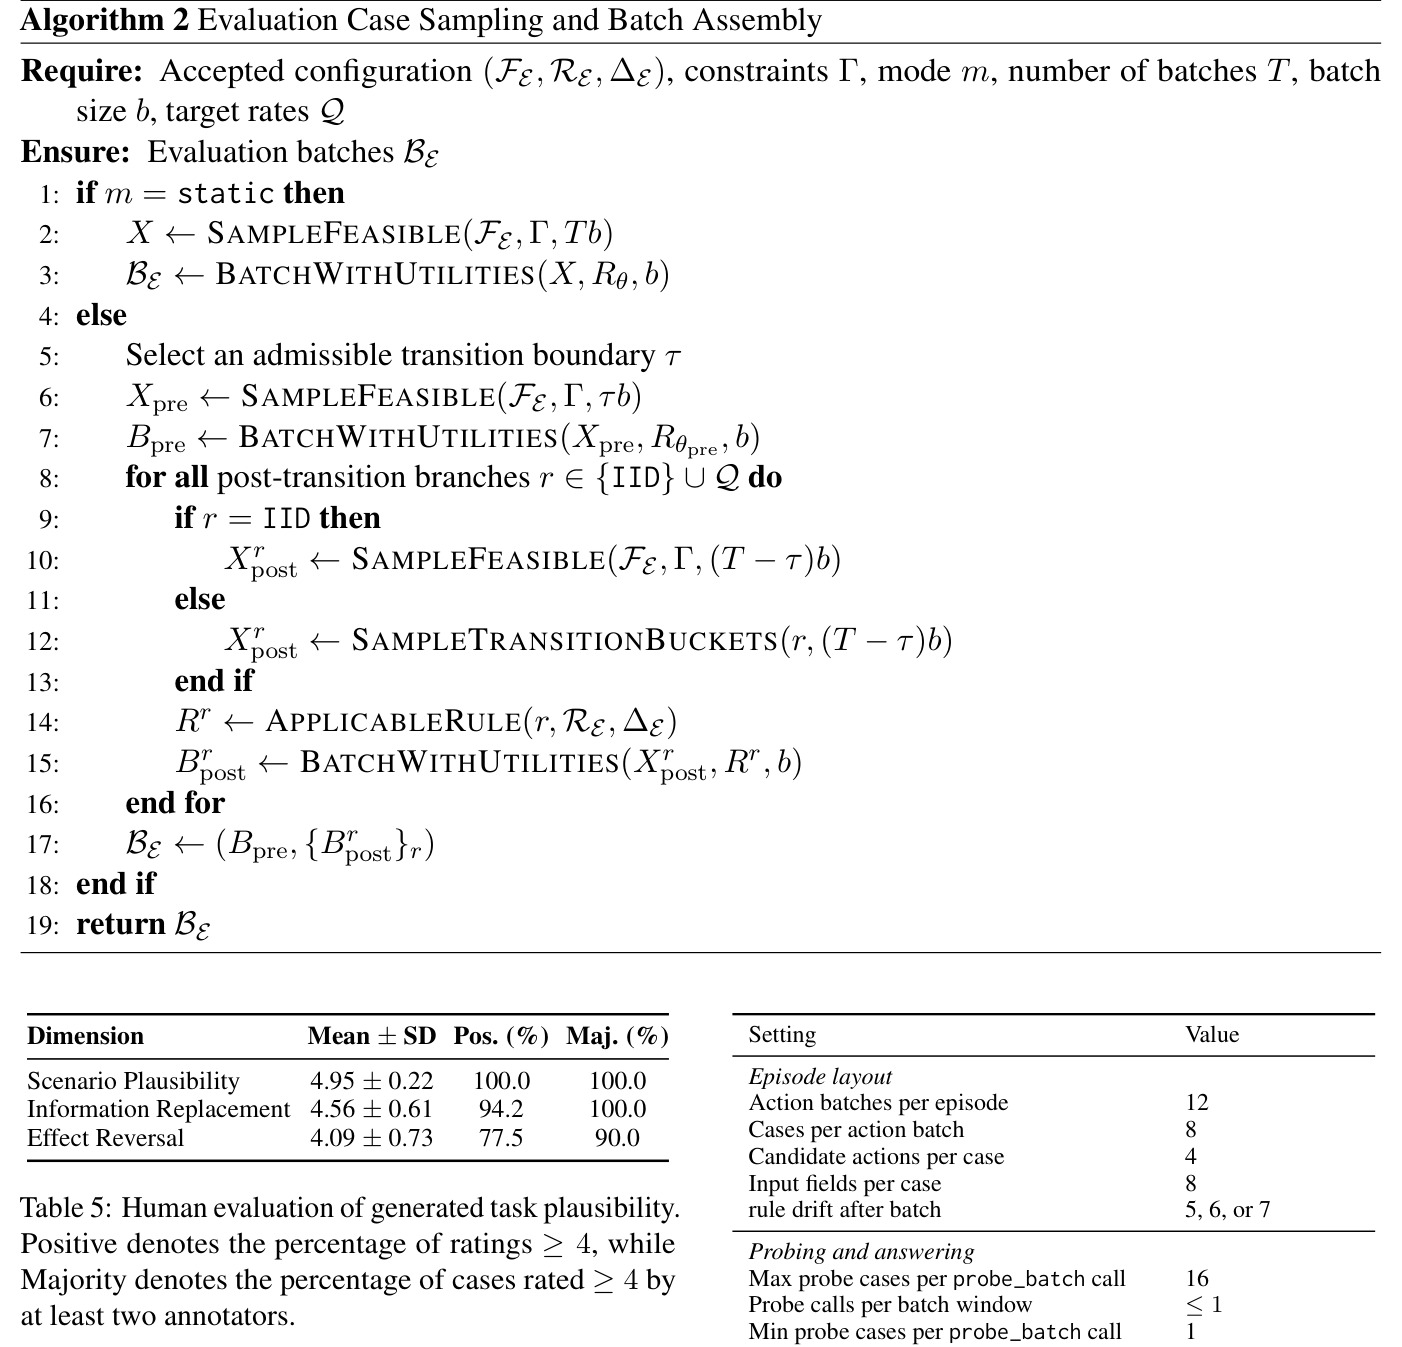
直觉上,本文把一个陌生的决策环境压缩成"一条隐藏的评分规则":每个案例由若干字段取值描述,隐藏规则输出一个干预分数 $s\in[-1,1]$,分数越高越支持更强的干预动作;固定的效用函数再把分数映射到 4 个动作(从保持现状到最强干预)的效用。agent 每个案例看到 8 个字段(其中只有 3 个是真正决定结果的因子,其余是干扰项),可以在每个批次窗口内用 probe_batch 自行设计案例并观察全部 4 个动作的效用,或直接揭示下一批、提交动作选择。形式化地:案例为 $x=(x_1,\dots,x_d)\in\mathcal{X}=\bigcap_{j=1}^{d}[l_j,u_j]$,未知相关子集 $I\subseteq\{1,\dots,d\}$;规则函数先把字段归一化到 $[-1,1]$($\tilde{x}_j=\frac{2x_j-l_j-1}{u_j-l_j}$),再按四个家族之一合成原始证据 $e$:加法规则 $e=b+\sum_{j\in I}w_j\tilde{x}_j$(高值字段可补偿低值字段);合取/析取规则取定向边际 $m_j=d_j(\tilde{x}_j-\tilde{t}_j)$ 的 $e_{\mathrm{conj}}=\min_{j\in I}m_j$ / $e_{\mathrm{disj}}=\max_{j\in I}m_j$(全部条件 / 任一条件决定);词典序规则按优先级 $\pi$ 取第一个满足 $|m_{\pi_k}|>\delta$ 的字段的边际。最后单调校准 $s=C_\theta(e)$ 把证据映射到 $[-1,1]$。效用函数为 $u_k(s)=\frac{\exp[-\beta(s-c_k)^2]}{\sum_{j=0}^{3}\exp[-\beta(s-c_j)^2]}-\frac{1}{4}$,其中 $\beta=8$、锚点 $c=(-0.75,-0.25,0.25,0.75)$,保证四个决策区域等大、各动作效用之和恒为零。每个 episode 包含 12 个动作批(每批 8 案例,共 96 案例),规则漂移发生在第 5、6 或 7 批之后。
核心创新是"隐性规则漂移 + 探索责任转移 + 评估历史遮蔽"的三位一体设计。与静态规则归纳基准(InductionBench、NewtonBench)的本质区别在于:规则会在交互中途不宣布地改变,且每个漂移恰好是复合变化——替换一个相关因子并反转另一个因子的作用方向(分解为 2 个替换原子 + 1 个反转原子),变化幅度被数值认证约束在"有意义但温和"的区间(最优动作变化率 0.25–0.75,边际最优动作占比 0.15–0.35)。agent 收不到任何漂移信号,只有两条线索可循:重新探查旧探针点(新规则下同一输入返回新证据),或察觉效用反馈与预期的偏差。评估历史遮蔽是第二个关键设计:已提交的评估案例与动作从上下文中移除、仅留效用反馈,而自采探针全部保留——于是 Default 设置隔离了"主动探索"能力,Evidence Given 消融(不遮蔽)则提供外部证据对照组。第三个要点是把探查做成可选项:每窗口允许一次 probe_batch(至多 16 个探针、全 episode 预算 32)但也可以零探查直接推进,这让探索意愿与探索质量本身成为可测量的行为变量,而非被协议强制的外生变量。
方法步骤详情
数据生成管线分四步。第一步,LLM 辅助构建语义字段目录:对金融、医疗、网络安全、制造四个领域的任务蓝图(场景 + 角色 + 4 个有序动作),依次做字段发现(提出带名称、描述、单位、方向的可观测字段)、字段语义(效果强度、适配的规则家族、方向反转的触发事件与理由)、字段参数(合法范围与低/中/高三档 Beta 采样分布)、词典序优先组、跨字段可行性约束(硬不变式,如"部分不能超过整体")、可替换字段组(同方向字段的语义交接事件)。第二步,配置枚举与数值认证:枚举候选因子组合并做结构可行性过滤,然后对每个候选做三阶段数值认证(分别用 256、2048、16384 个采样案例),要求最优动作分布非退化、自然最优动作变化率落在 0.25–0.75、边际最优动作占比 0.15–0.35;随后按漂移前证据分布的四分位数 $q_{25},q_{50},q_{75}$ 拟合分段线性校准函数,把它们映射到动作边界 $-0.5,0,0.5$,使四个动作区域近似均衡,且校准在漂移后保持不变以保证证据-分数映射全程一致。第三步,案例采样与批组织:动态 episode 先在初始规则下采共享的漂移前前缀,再生成一个 IID 对照分支和三个目标分支(最优动作变化率分别为 0.25、0.50、0.75),各分支共享漂移前批次;加入干扰字段后由 LLM 审查核心与干扰的语义一致性。第四步,数据级评审与筛选:独立的 LLM 评审按字段真实性、规则变化合理性、干扰项质量三个维度打分,384 个候选中按领域-家族组合均衡地选出 256 个最高分 episode(4 领域 × 4 家族 × 16);人类研究对 40 个抽样 episode 由 3 名标注者在 5 点量表上评分,场景合理性、因子替换、效应反转分别得 4.95、4.56、4.09。运行时协议:每个 episode 12 个批次,每窗口至多 1 次 probe_batch(≤16 探针、总预算 32),支持 request_next_batch、submit_action_batch(允许逐案弃权)和 calculator;漂移前后各做一次辅助因子评估,且不进入后续上下文。
技术新颖性
技术新颖性体现在四个层面。(1) 基准定位:首个同时满足主动探索、适应探索、环境学习、过程内评估、异构规则、可扩展生成六个维度的基准(Table 1 中 11 个先前工作无一做到),此前最接近的 AdaPlanBench 有适应探索但缺环境学习,各类科学发现基准(NewtonBench 等)有探索但环境静态。(2) 环境建模:把认知科学中的四种决策策略(补偿性加法、合取、析取、词典序;Einhorn 1970; Payne et al. 1993; Gigerenzer & Goldstein 1996)形式化为可数值认证的规则家族,并用四分位数校准使异构家族统一到相同的干预分数尺度、动作区域均衡,解决了"不同规则结构难度不可比"的老问题。(3) 漂移设计:"因子替换 + 方向反转"的复合原子变化是新的设计空间——每个变化必须由单一连贯事件驱动(生成时强制填写触发事件、前后语义、反转理由),人类评估确认替换合理性 4.56/5、反转合理性 4.09/5,既保证语义可信又保持逻辑可推断。(4) 评估方法学:评估历史遮蔽 + 可选探查 + 漂移前后辅助评估的组合,让探索行为、规则归纳、假设修正三种能力可分离测量;EA/CA 双指标进一步区分错误频率与错误代价。整套管线无需人工标注即可扩展,还附带同管线的 1000 训练集。
实验结果
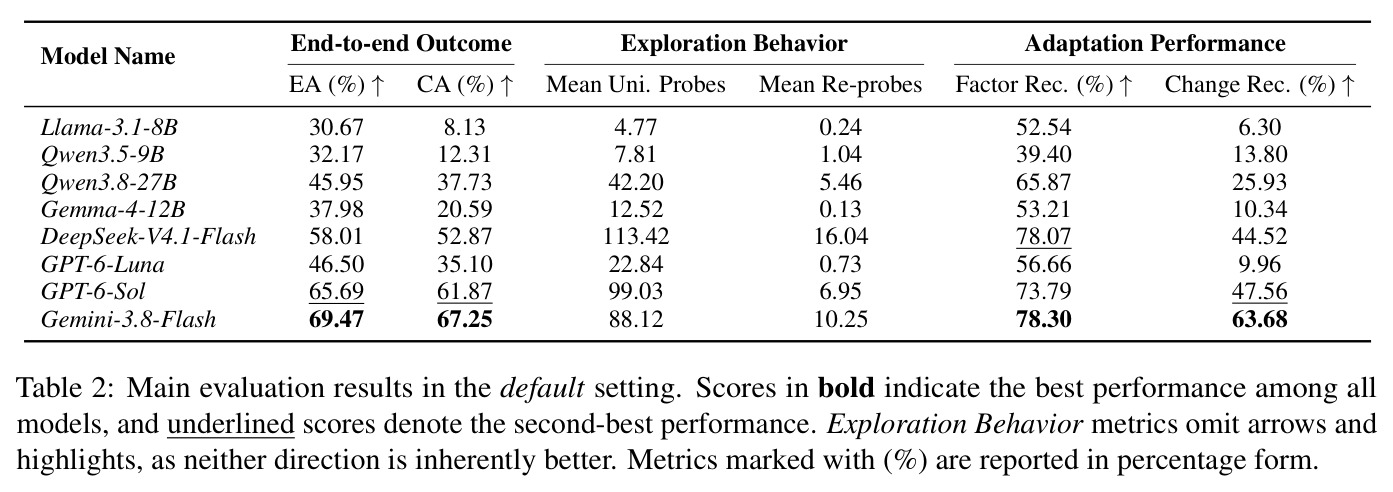
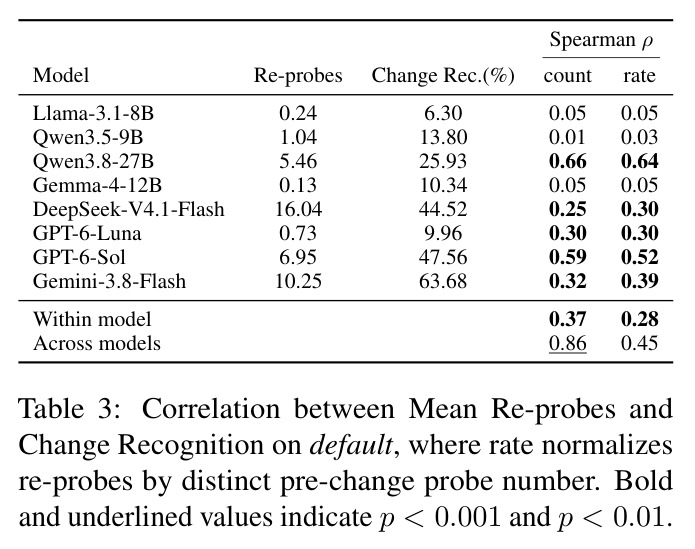
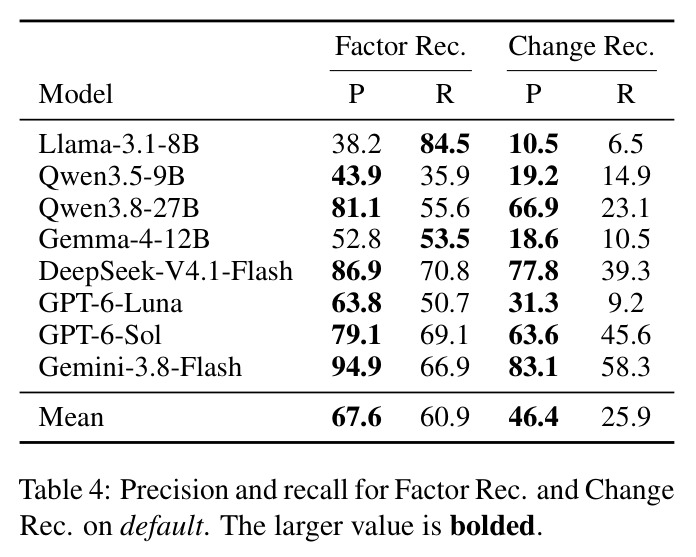
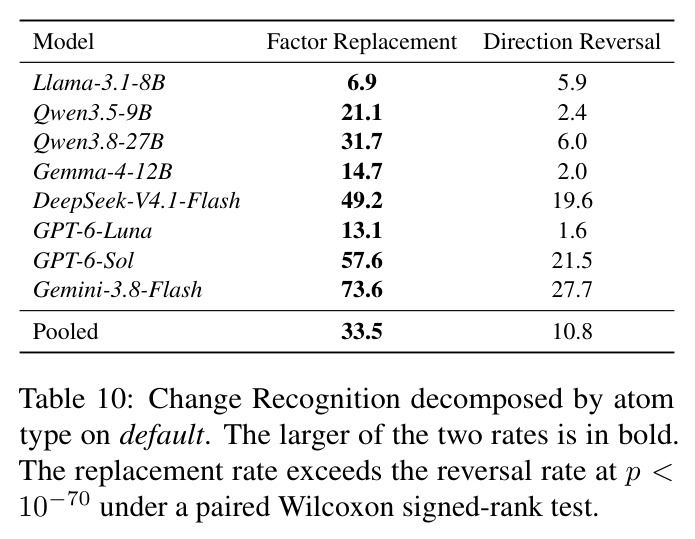
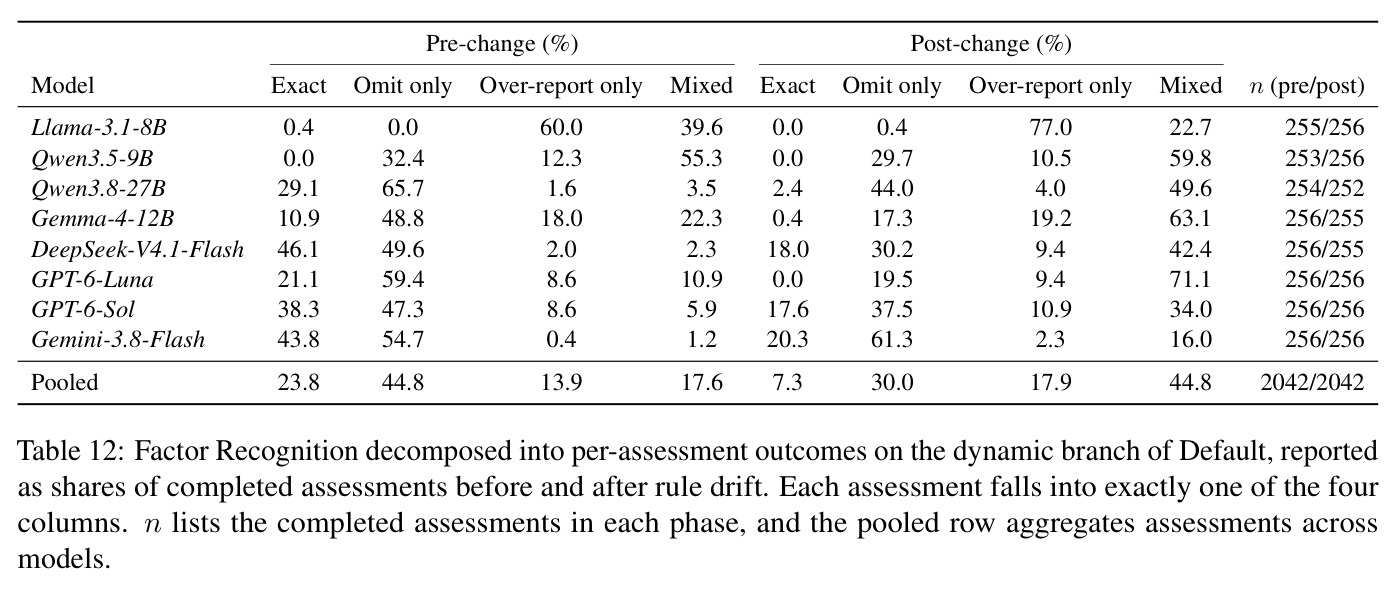
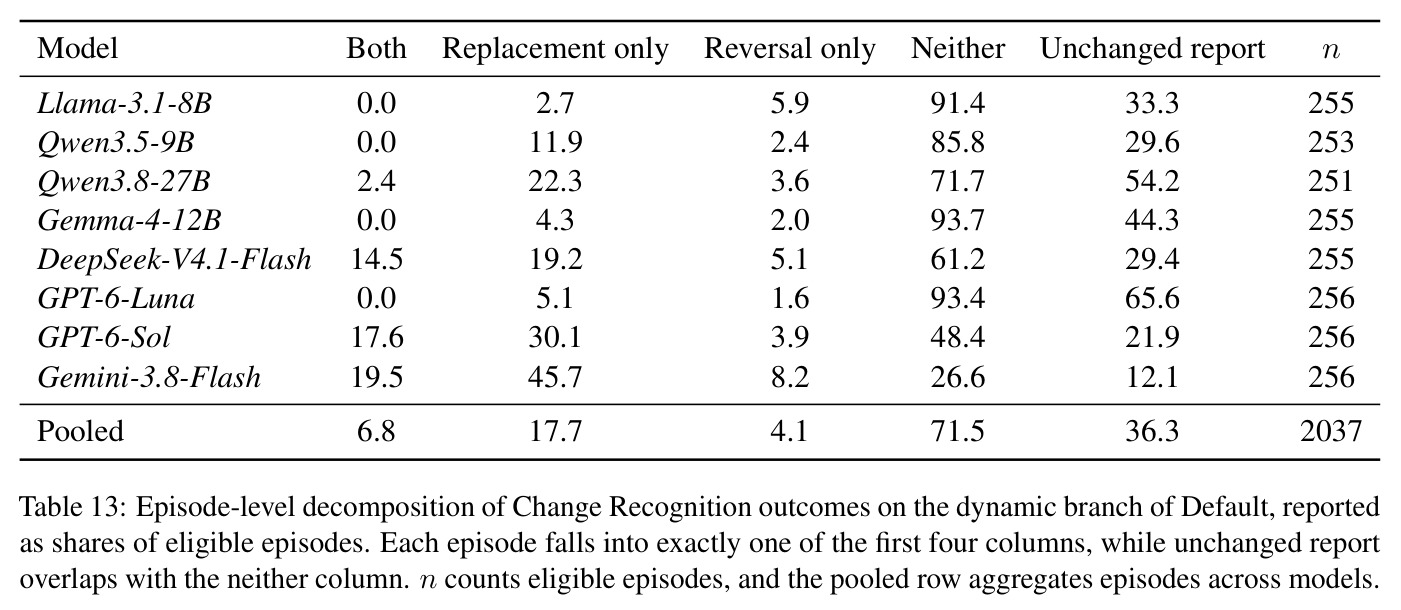
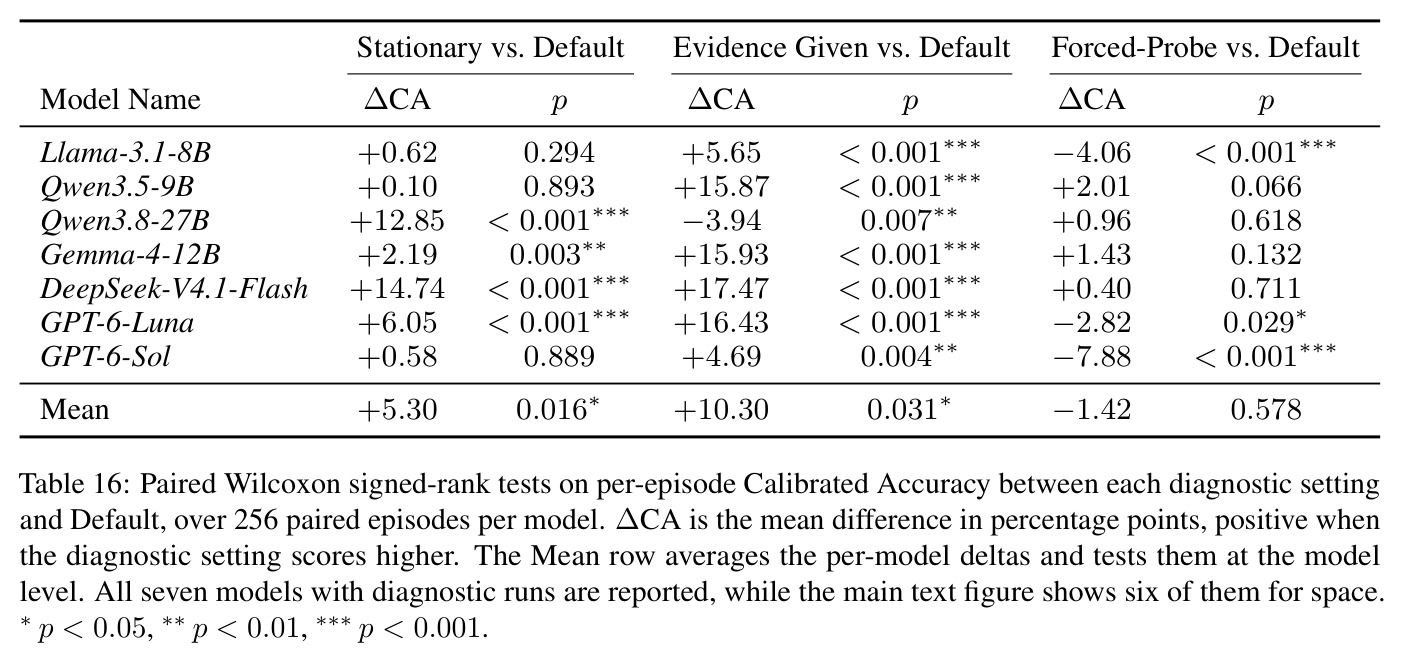
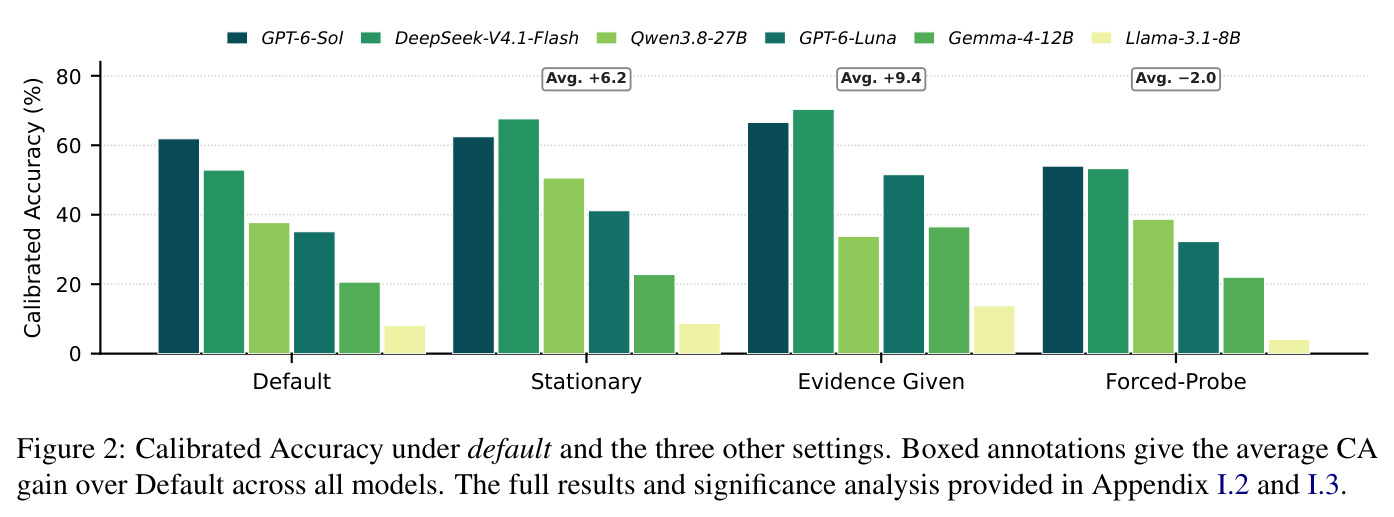
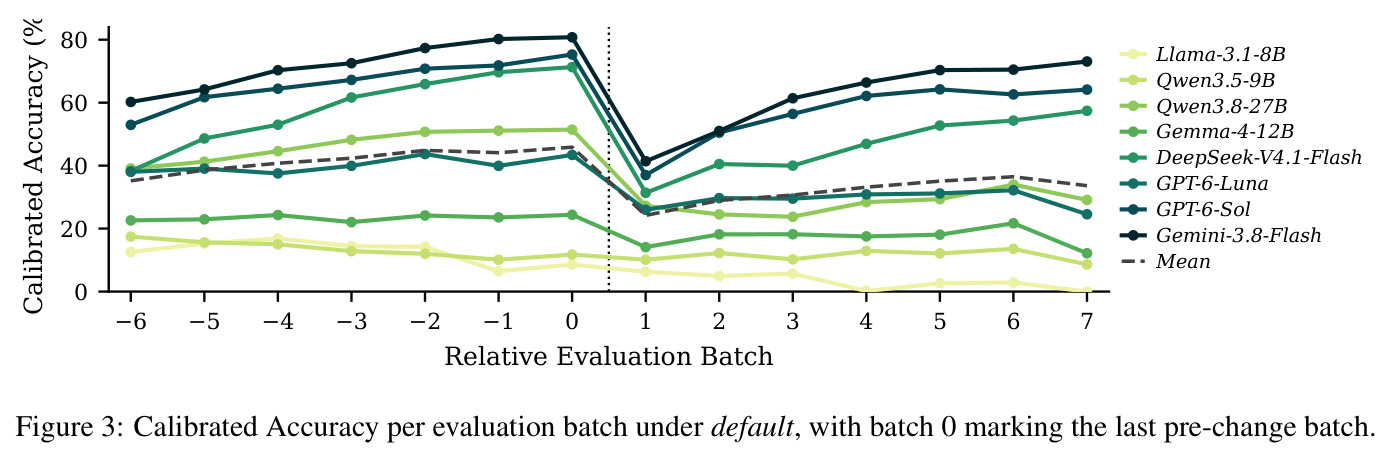
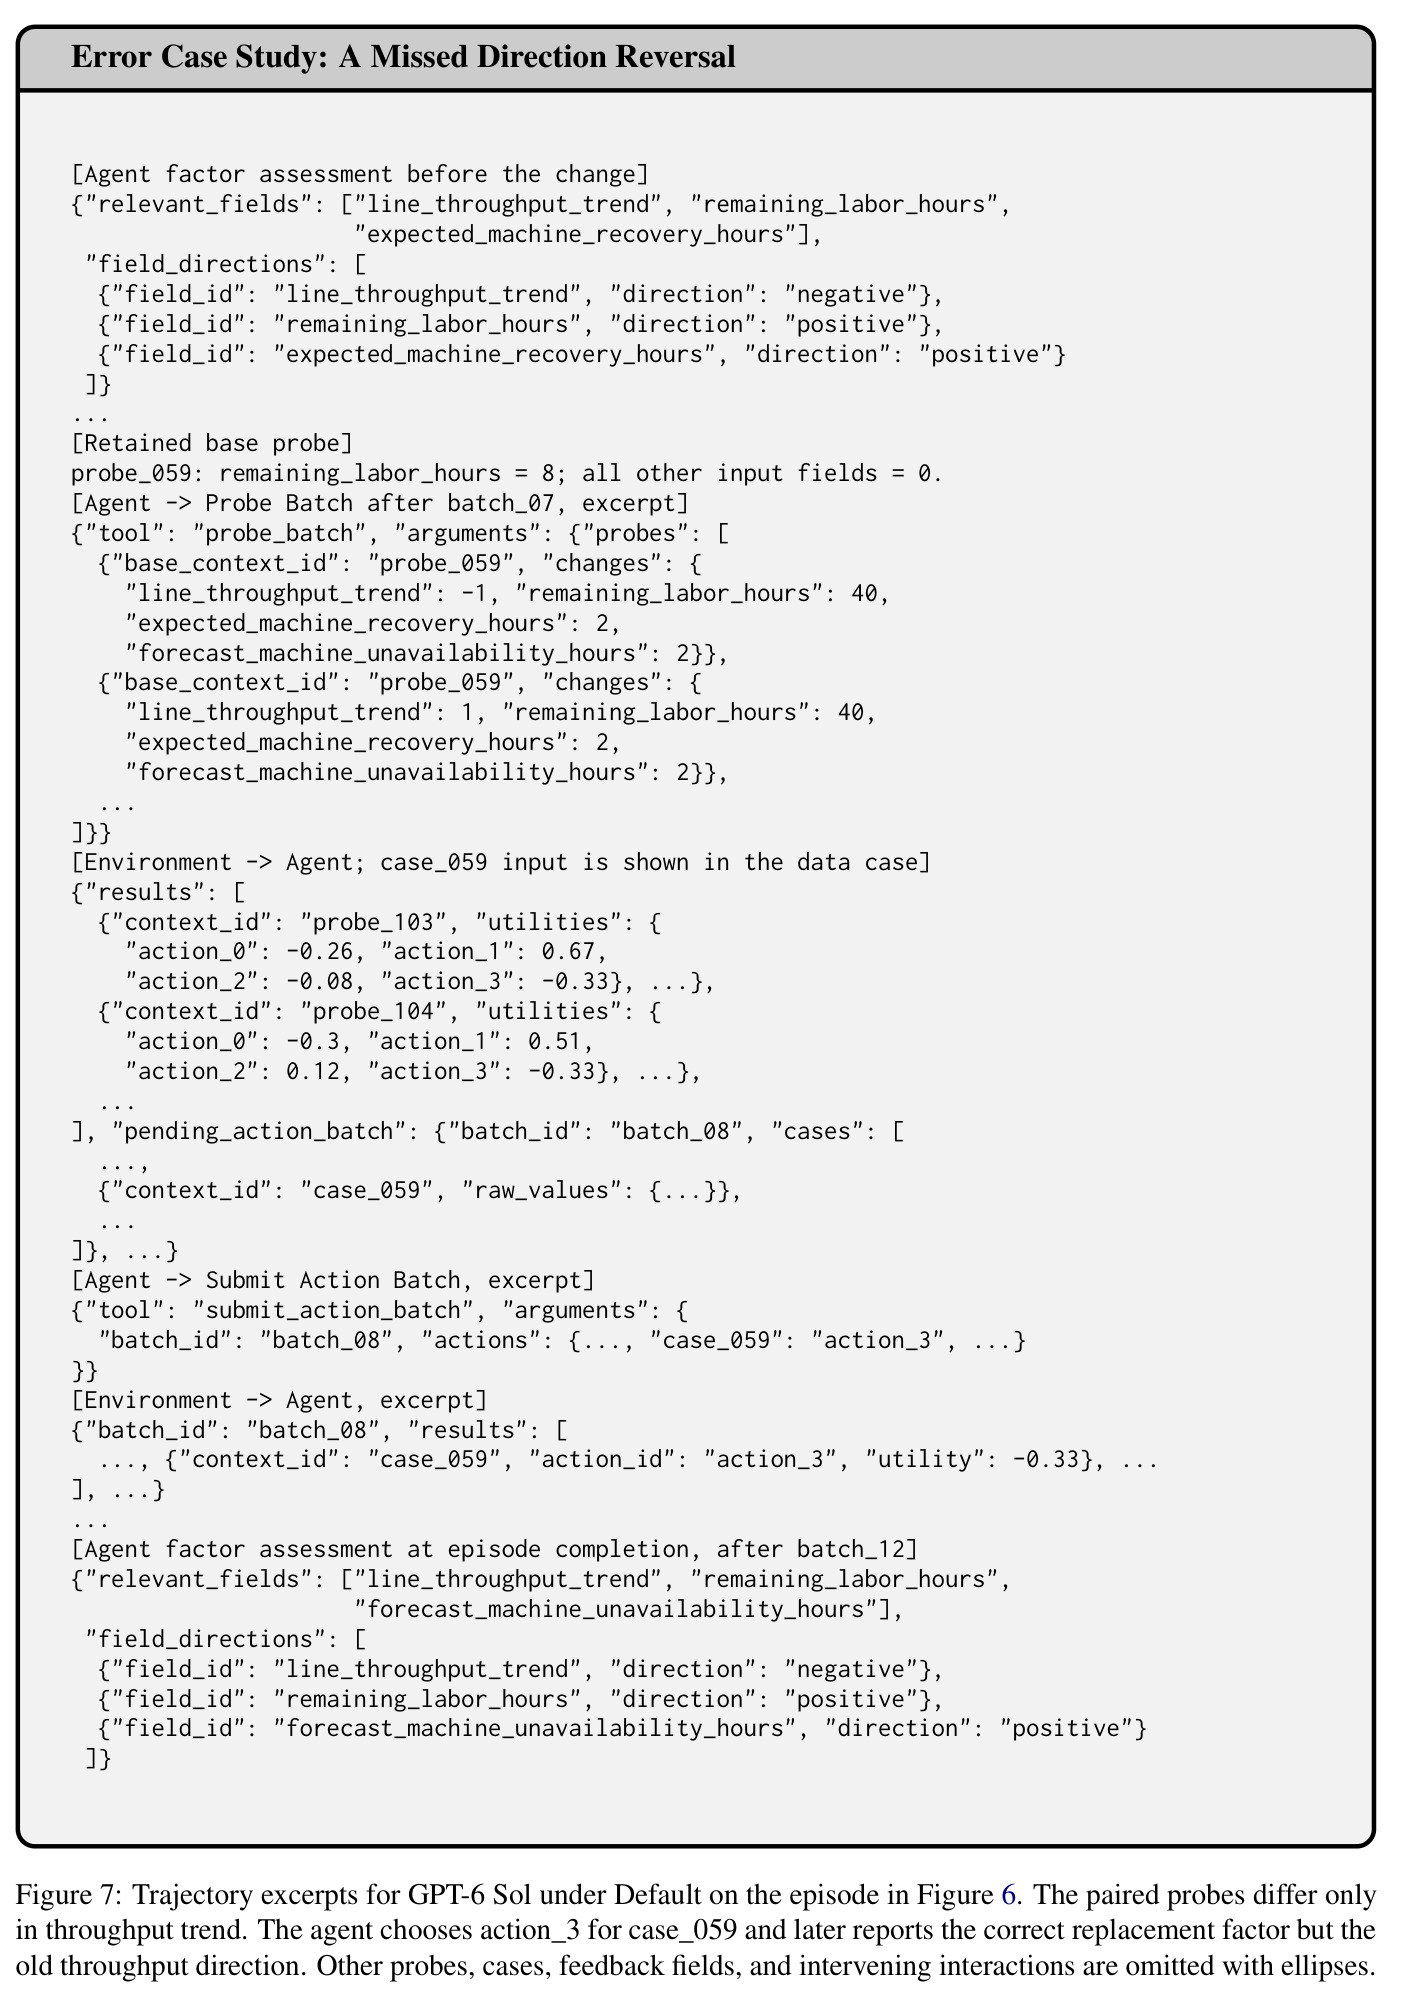
默认设置下 8 个模型的校准准确率全部低于 70%:Gemini-3.8-Flash 最强(EA 69.47%、CA 67.25%),GPT-6-Sol 次之(65.69%/61.87%),DeepSeek-V4.1-Flash 第三(58.01%/52.87%),最弱的 Llama-3.1-8B CA 仅 8.13%。EA 与 CA 的差距随模型变弱而急剧拉大:前三名约 2–5 点,其余模型 8–22 点,说明弱模型不仅错得更频繁,错误还倾向落在效用损失更大的动作上。探索量与性能严重不对等:DeepSeek 平均发出 113.42 个独特探针(约为 Llama-3.1-8B 的 4.77 个的 24 倍),CA 却低于探针更少的 Gemini-3.8-Flash(88.12)和 GPT-6-Sol(99.03)。三项消融把瓶颈定位在证据获取与适应而非规则学习:去掉漂移(Stationary)平均 +6.2%,DeepSeek 提升最大(+14.7 点),但 GPT-6-Sol 几乎不变(其默认性能已接近静态上限)、最弱模型提升不足 1%(静态都学不会,去掉漂移也没用);提供完整证据(Evidence Given)平均 +9.4%,7 个模型中 6 个提升、4 个超过 15 点,唯一退化的 Qwen3.8-27B(−3.94)同时也是削减探查最多的模型——过时但充分的证据反而会误导轻信的模型;强制探查(Forced-Probe)把平均独特探针从 33.9 提到 53.8(最不情愿的探索者扩了 2–5 倍),CA 却平均 −2.0% 且模型级不显著,直接证明探查质量而非数量是瓶颈。误差分析显示漂移造成即时且不可恢复的损伤(Figure 3):对齐漂移点后,6 个高于随机基线的模型在第一个漂移后批次平均暴跌 26.9 点,到最后仍比漂移前平台低 6.9–19.2 点,无一完全恢复,Llama-3.1-8B 更跌至 1.3%。识别层面的失败模式(Table 4):precision 普遍高于 recall(均值 Factor Rec. 67.6/60.9、Change Rec. 46.4/25.9),说明模型学到的是"大体正确但不完整"的规则;36.3% 的 episode 中模型漂移前后报告完全一致(GPT-6-Luna 达 65.6%、Qwen3.8-27B 达 54.2%);替换识别率 33.5% 远高于方向反转 10.8%(配对 Wilcoxon $p<10^{-70}$;episode 级为 17.7% 对 4.1%)。最后,重探(re-probing)与变化识别在模型内部显著正相关(Table 3,within-model count $\rho=0.37$、rate $\rho=0.28$,均 $p<0.001$),但按漂移前探查量归一化后跨模型关系消失——说明重访旧探针点确实提供了反证,但把证据转化为假设修正的效率因模型而异。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 演化环境端到端决策(默认设置,8 个模型) | 校准准确率(CA, %) | 全部模型低于 70%,最高为 Gemini-3.8-Flash 67.25% | 均匀随机策略(经校准后期望得分为 0) | 最优模型高出随机基线 67.25 分,但距满分仍差约 33 分,凸显任务难度 |
| 证据获取瓶颈(Evidence Given 对比 Default) | CA 平均提升 | 平均 +9.4%,7 个模型中 6 个提升、4 个超过 +15 点 | Default 设置(评估批次被遮蔽,需主动探索) | 证明模型"更会利用给定证据、不擅长主动获取证据",主动证据获取是首要瓶颈 |
| 规则漂移适应(Stationary 对比 Default) | CA 平均提升 | 平均 +6.2%,DeepSeek-V4.1-Flash 最大 +14.7 点 | Default 设置(含不宣布的隐性规则漂移) | 验证隐性漂移是具有基本学习能力模型的一阶瓶颈,但最弱模型几乎无差别 |
| 强制探查(Forced-Probe 对比 Default) | CA 平均变化 / 平均独特探针数 | CA 平均 −2.0%(模型级不显著),独特探针 33.9 → 53.8 | Default 设置(探查量由模型自主决定) | 无提升——增加探查数量无法弥补探查质量问题 |
| 变化识别的原子分解(方向反转 vs 因子替换) | 原子恢复率(严格匹配, %) | 方向反转 10.8% vs 因子替换 33.5%(pooled),$p<10^{-70}$ | — | 方向反转的识别难度约为因子替换的 3 倍,暴露假设修正的结构性缺陷 |
局限与改进
作者明确承认三点局限:(1) 环境动态是简化的潜在规则抽象——虽然可控,但无法完全刻画真实世界的复杂性与不确定性(尽管智能体在这种简化设定下已然挣扎);(2) 探索质量的评估是间接的——现有指标测的是探索努力量而非质量,直接的空间多样性/决策区域覆盖指标会天然偏爱大量探查且在异构规则家族间不可比,只能靠消融设置间接推断"探针信息量不足"很可能是瓶颈,探针质量并未被直接测量;(3) 变化类型覆盖有限——目前只有族内规则漂移(因子替换 + 方向反转),受时间和算力限制,跨家族变化、其他变化类型和系统化的变化幅度留作未来工作。我的补充观察:(1) 每个 episode 只有一条规则、恰好一次漂移、漂移时机只有第 5/6/7 批三个位置,真实环境的多规则耦合、渐变式漂移、漂移回滚均未覆盖;(2) 数值字段 + 4 个有序动作的设定高度结构化,语言型、空间型或工具型环境中的探索行为可能定性不同;(3) 数据由 LLM 生成又经 LLM 审查,可能继承生成模型的系统性偏置(尤其当生成模型与被测模型同源时),40 个 episode 的人类评估规模偏小,只能部分缓解;(4) 辅助评估要求模型显式报告因子集合与方向,一个"行动正确但说不清规则"的隐式学习者会被系统性低估;(5) CA 的部分得分依赖 softmax 效用函数($\beta=8$ 固定),$\beta$ 的取值会改变"接近最优"的宽容度,但论文未做敏感性分析。
独立分析的弱点
弱点一:探查质量缺乏直接度量。论文自己得出"探针信息量可能是瓶颈"的结论,却没有为每个探针计算信息增益(例如对规则参数后验的互信息,类似主动学习中的 BALD 策略)。改进方向:为探针定义基于效用反馈的期望信息增益评分,直接量化并排序探针质量,从而把"探索质量"从间接消融变成可直接优化的目标。弱点二:漂移检测完全依赖模型自发。36.3% 的 episode 中模型漂移前后报告完全一致(GPT-6-Luna 65.6%),呈现"不怀疑就不检测"的强假设持续性;Forced-Probe 又证明单纯增加探查无效。改进方向:研究结构化的"假设证伪协议",如强制周期性重放旧探针点、在累积效用异常时触发定向重验,量化小预算下的检测率提升。弱点三:难度参数缺乏敏感性分析。词典序的 indifference band $\delta$、softmax 效用的 $\beta=8$、每案例 8 字段/3 因子的固定配置都直接决定难度,但没有敏感性实验。改进方向:对这些超参做系统扫描,报告难度曲线。弱点四:漂移动态过于单一——单次、离散、幅度集中在 0.25/0.50/0.75 三个预设分支,无法刻画渐变漂移或多段漂移下的部分恢复行为。改进方向:引入连续漂移轨迹与回滚事件,考察恢复曲线而非仅终点。弱点五:设置对比间存在混杂——Evidence Given 下 Qwen3.8-27B 同时大幅削减探查,说明各消融同时改变了多个变量,单一归因("证据误导")需要更细的控制实验。改进方向:设计只改变单一因素的正交消融。弱点六:episode 级指标(如 Change Rec. 的 set F1)对部分正确的惩罚较重,可能放大弱模型的失败幅度,可补充部分匹配得分做稳健性检查。
未来方向
作者提出的方向:(1) 扩展变化类型——跨规则家族的漂移(如加法规则漂移成词典序规则)、更多样的变化形式、以及系统化地扫描变化幅度;(2) 把基准用作训练场——1000 个训练 episode 配合可扩展生成管线,支持通过强化学习或监督微调提升智能体的探索与适应能力;(3) 补充直接的探查质量指标。基于本文成果可延伸的方向:(1) 假设修正机制——既然 36.3% 的 episode 模型对漂移毫无察觉、且替换易识别而反转难识别,可以设计"方向先验挑战"机制:让 agent 维护可证伪的假设清单,在效用反馈异常时自动触发对既有方向的定向重验,这与模型内 re-probe 与变化识别显著正相关($\rho\approx0.3$–0.4)的发现一致,提示针对性验证是有效的推理时干预点;(2) 探索-利用权衡的形式化——把每窗口的探查决策建模为贝叶斯最优实验设计问题,对比 LLM 探针与信息增益最大化策略的重合度,定位 LLM 探针次优的具体环节;(3) 与记忆和持续学习结合——研究漂移前的知识应以何种可修订的表示存储,避免"强假设持续性"造成的盲区;(4) 跨领域泛化——在医疗/金融 episode 上训练、在制造/网安上测试,检验规则归纳与适应能力的迁移性;(5) 探索行为的训练信号——利用过程内性能曲线构造密集奖励,训练"何时停止探索"的元决策,这比稀疏的端到端效用更适合 RL。
复现评估
复现条件总体较好。开源情况:作者承诺代码以 MIT 许可、AdaExploreBench 数据以 Creative Commons 许可发布(论文写作时点未见正式仓库链接,使用前需核实)。数据:256 个评估 episode + 1000 个训练 episode 全部程序化生成,无需人工标注;生成管线的全部 LLM prompt 在附录 D.5 公开(字段发现、语义、参数、词典序、约束、替换、审查共 8 个 prompt),配置枚举与数值认证算法有伪代码(Algorithm 1/2),数据管线原则上可复现。算力:开源的 5 个模型(Llama-3.1-8B、Qwen3.5-9B、Qwen3.8-27B、Gemma-4-12B、DeepSeek-V4.1-Flash)用 4 块 NVIDIA L20 GPU 经 vLLM 本地部署,8B–12B 级别单卡即可运行;闭源的 GPT-6-Luna/Sol、Gemini-3.8-Flash 走官方 API。实验规模:单 episode 最多 12 批 × 8 案例 + 总预算 32 探针,8 模型 × 4 设置 × 256 episode 约数千条轨迹,API 成本可控。协议细节充分:温度 0.0(端点支持时)、强制 JSON 输出、各模型推理努力配置(Table 7)、统一的失败处理(1 次修复 + 5 次指数退避重试、截断重生成 1 次)对所有模型一致。难度评估:复现评估实验为中等难度(主要是 API 成本与工程对接);从零复现数据生成较难(依赖特定 LLM 的生成质量与多阶段过滤的随机性),但直接使用官方发布数据即可绕过。风险点:评测涉及 GPT-6、Gemini-3.8、DeepSeek-V4.1 等快速迭代的商业 API,版本漂移会影响严格复现,建议锁定模型版本快照。
论文图表
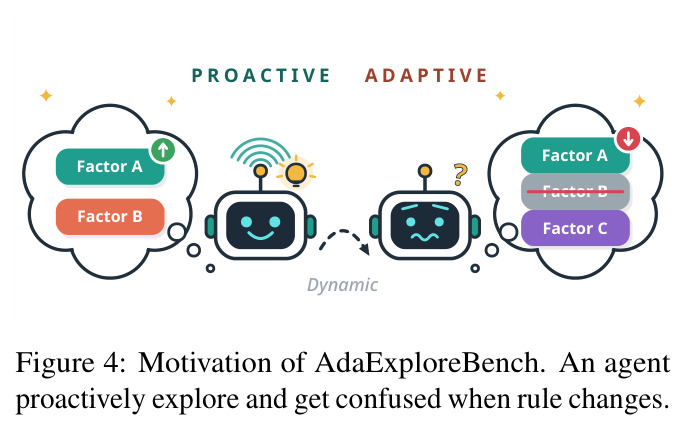
动机示意图:agent 主动探索环境归纳出因子 A、B 的作用规律,当环境动态改变(因子关系变化)后 agent 陷入困惑,需要识别变化并重新探索。
一图点明论文要测的核心能力:不仅要在静态环境主动探索,还要在规则悄然变化时检测漂移并修正假设,这是与既有静态基准的根本区别。