FlowState:将执行状态作为长程 LLM 智能体的记忆 FlowState: Execution State as Memory for Long-Horizon LLM Agents
把执行状态升级为可跨请求复用的记忆,兼顾长程任务成功率与Token效率
前置知识
ReAct 执行循环
LLM 智能体的经典执行范式:模型在每一步交替产出推理、工具调用与最终回复,工具执行返回观测后进入下一步,一个请求由若干这样的决策步组成。本文设定下,请求 $q_k$ 包含 $T_k$ 个 ReAct 决策步,每步对应一次模型调用,策略 $\pi_\theta$ 固定不变。
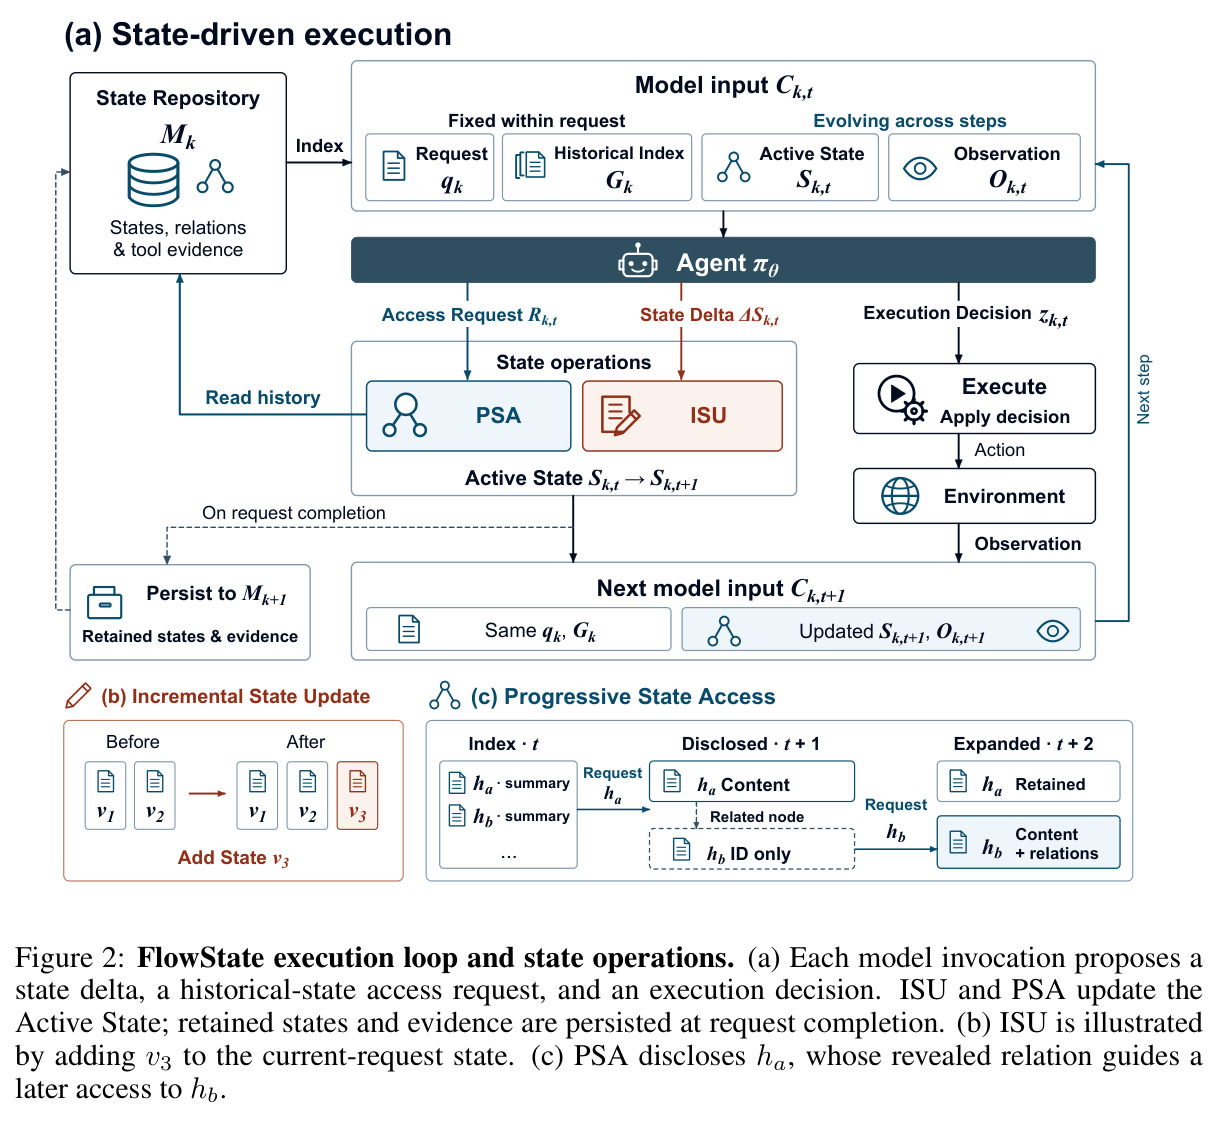
FlowState 的 ISU 与 PSA 都嵌入这个循环内:每步模型输出三元组 $y_{k,t} = (\Delta S_{k,t}, R_{k,t}, z_{k,t})$,理解执行循环才能理解状态操作与动作决策如何交织进行。
信念状态(Belief State)
部分可观测序贯决策(POMDP)中,信念状态把动作-观测历史概括为当前决策所需的最小信息,并根据新动作与观测递归更新;任务型对话中的对话状态跟踪(DST)是其特例,随对话进程维护用户目标与槽位信息。
FlowState 的活动状态 $S_{k,t}$ 本质上是信念状态思想在 LLM 智能体上的延伸,但它进一步把这一状态持久化为可跨请求回访的记忆单元,这是理解论文定位与相关工作对比的关键。
智能体长期记忆与 RAG
将历史信息存入外部存储、决策时检索注入上下文的技术路线,代表工作包括 MemGPT(分层记忆管理)、Mem0(生产级记忆)、A-Mem 与 Zep(图谱记忆)、ReasoningBank(经验记忆)。核心难点是检索时机与检索内容同当前决策的匹配。
本文的 PSA 与一次性 RAG 检索不同:访问由推理中涌现的信息缺口驱动、由已披露状态的关系链逐跳引导。对比理解这一差异,才能把握 FlowState 相对记忆系统的创新点。
上下文压缩与状态跟踪
全量历史会推高 Token 成本并淹没关键信息;压缩式方法把交互历史维护成紧凑的工作表示,如 ZipAct 将历史压缩为目标状态、世界状态、约束状态三类紧凑表示,还有 StateAct、LedgerAgent、AgentFold 等工作。代价是反复压缩可能丢弃后续才需要的细节。
FlowState 的核心动机正是绕开「保留 vs 压缩」的权衡:持久层保留全量状态与原始工具证据,上下文层只放索引与摘要,按需披露。理解这一权衡是读懂论文问题陈述的前提。
研究动机
长程任务要求智能体跨步骤、跨请求地复用早期交互信息,而现有三类方案各有硬伤。全上下文方法保留完整交互历史:在 MemoryArena 捆绑购物任务上成功率 SR 仅为 0.00%、进度分 PS 仅 21.11%,Token 消耗高达 52.65M,关键细节(如 80 美元的取消费条款)容易被长上下文淹没。压缩式状态跟踪(ZipAct)把历史压成紧凑状态,但反复压缩会丢弃后续才需要的细节,其在团队旅行规划上 PS 仅 3.81%。外部记忆系统(ReasoningBank、BM25、Mem0)依赖检索补回历史,但何时检索、检索什么往往到推理中才显现,未被检索到的政策证据 E4 直接导致决策错误。论文图 1 的酒店案例极具代表性:用户预订 200 美元的酒店 A 并备注「若 B 更便宜则改订」,数日后 B 降至 160 美元,看似省钱,实则忽略 A 的 80 美元取消费,改订总成本 240>200,三类基线分别因信息被淹没、压缩丢失、检索不到而失败。
本文的目标是本文目标是让执行状态本身成为统一的记忆表示:既作为当前请求的工作表示支撑决策,又作为跨请求持久化、可按需回访的记忆单元。具体而言,FlowState 要在同一个执行循环内完成三件事:其一,通过增量状态更新(ISU)基于新输入与执行反馈维护当前状态,避免每步重建整个状态;其二,通过渐进状态访问(PSA)随推理进展逐步披露历史状态及其引用的原始工具观测,而非一次性检索;其三,请求结束时把新增状态与更新后的索引持久化到状态仓库,供未来请求复用。量化目标是在相同骨干模型下同时改善性能与效率:相比 DeepSeek-V4-Flash 全上下文基线,MemoryArena 平均成功率提升 4.55 个百分点、τ³-Bench 平均通过率提升 13.95 个百分点,同时总 Token 消耗分别下降 43.2% 和 40.6%。
与已有工作不同的是,本文的独特切入是把「状态跟踪」与「长期记忆」两条研究路线统一起来。已有工作要么维护紧凑执行状态(ZipAct、StateAct、LedgerAgent),要么做外部记忆存储检索(MemGPT、Mem0、A-Mem、Zep),直接叠加的混合方法 ZipAct+BM25 表现不稳定——九项指标中仅在数学 PS 上超过两个单独组件。FlowState 的关键洞察是:检索的时机与内容应由执行状态的关系结构在推理中逐步揭示。历史状态节点保留语义类型、节点间关系与对原始工具观测的引用,实现「持久保留」与「上下文可见」的分离。与并行工作 MAGE(层级状态树加活动路径上下文)不同,FlowState 的节点可跨请求独立寻址,披露关系时并不暴露邻居节点全文,访问路径随推理逐跳展开,使新信息能触发对旧决策的重新评估。
核心方法
直觉上,FlowState 把智能体每一步积累的工作记忆升级为可持久化、可回访的记忆单元。技术路线由三个组件构成:持久状态仓库 $M_k$ 存放全部历史请求、状态节点及其关系,由运行时维护但不直接放入模型上下文;历史状态索引 $G_k = \mathrm{Index}(M_k)$ 只含每个状态的语义 ID 与一句话摘要,随请求进入上下文;活动状态 $S_{k,t}$ 包含当前请求新建的状态与已披露的历史状态,是决策的工作区。执行循环中,第 $t$ 步的模型输入为 $C_{k,t} = \mathrm{Serialize}(q_k, O_{k,t}, G_k, S_{k,t})$,模型输出三元组 $y_{k,t} = (\Delta S_{k,t}, R_{k,t}, z_{k,t})$,不可同时为空:$\Delta S_{k,t}$ 是候选状态增量,$R_{k,t}$ 是历史访问请求,$z_{k,t}$ 是执行决策。ISU 把验证后的增量提交到活动状态,PSA 把验证过的历史节点内容与关系从 $M_k$ 披露进 $S_{k,t+1}$;请求结束时按 $M_{k+1} = \mathrm{Persist}(M_k, q_k, S_{k,T_k+1}, O_k)$ 持久化。
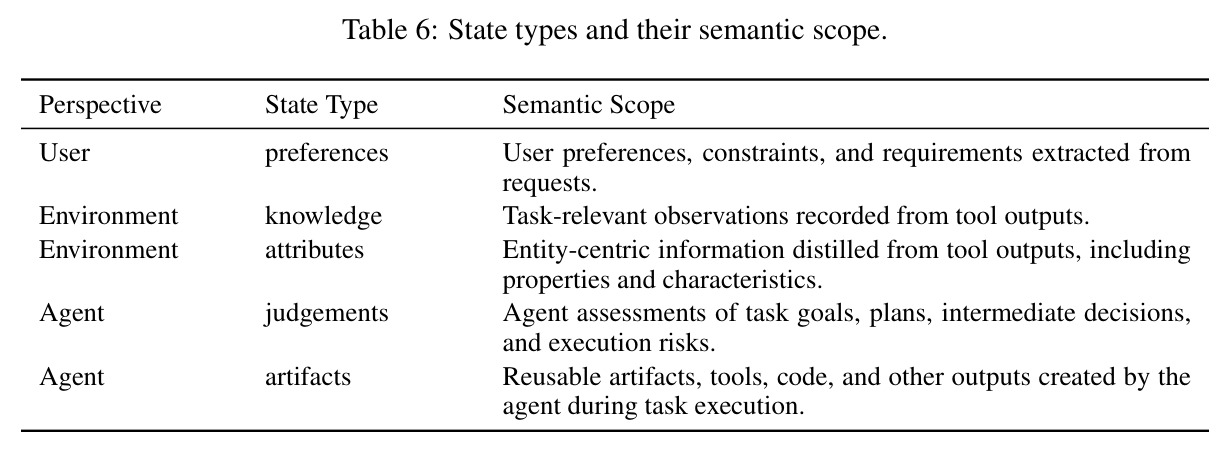
核心创新是把执行状态本身当作记忆:状态节点不仅服务当前决策,还跨请求存活、可通过 PSA 回访。与压缩式方法(ZipAct)的本质区别在于「持久保留」与「上下文可见」的分离——历史状态全文永远保存在 $M_k$,模型上下文只有索引中的 ID 与摘要,需要时才披露全文。与 RAG 的本质区别在于访问由推理中的信息缺口驱动、由已披露状态的关系链引导,而非一次性相似度检索;且披露某节点的关系边(supports、derives、follows、supersedes 四种类型)并不暴露邻居节点内容,模型可沿关系链逐跳深入到原始工具观测证据。节点按信息来源与角色分为五种语义类型:preference(用户偏好约束)、knowledge(工具观测)、attribute(实体属性)、judgement(智能体评估决策与风险)、artifacts(可复用产物)。历史状态不可删除或改写,修正只能新增节点并用 refs 链接,防止记忆被无声篡改。
方法步骤详情
每步执行的输入输出如下:(1) 序列化 $C_{k,t}$,包含请求 $q_k$、最近观测 $O_{k,t}$、索引 $G_k$ 与活动状态 $S_{k,t}$;(2) 模型采样三元组 $y_{k,t}$;(3) ISU 验证:Add 需未用过的语义 ID,Update/Remove 只能作用于当前请求创建的状态,引用须解析到有效节点,非法操作剔除后提交得中间态 $S_{k,t}^{+}$;(4) PSA 验证:只有满足 $\hat{R}_{k,t} \subseteq R_{k,t} \cap (\mathrm{IDs}(G_k) \cup \mathrm{ToolRefs}(S_{k,t}))$ 的请求才被披露;(5) 合并得 $S_{k,t+1}$,当步披露的内容下一步起才可用,依赖它的动作需置 $z_{k,t} = \emptyset$ 推迟一步;(6) $z_{k,t}$ 为环境动作则执行并获新观测,为最终回复则结束请求;(7) 请求完成后 Persist 把新状态(记录源请求)及其引用的原始工具结果写入 $M_{k+1}$,Index 重建 $G_{k+1}$。生成参数 temperature 0.1、top_p 1.0、max tokens 32768、关闭思考。
技术新颖性
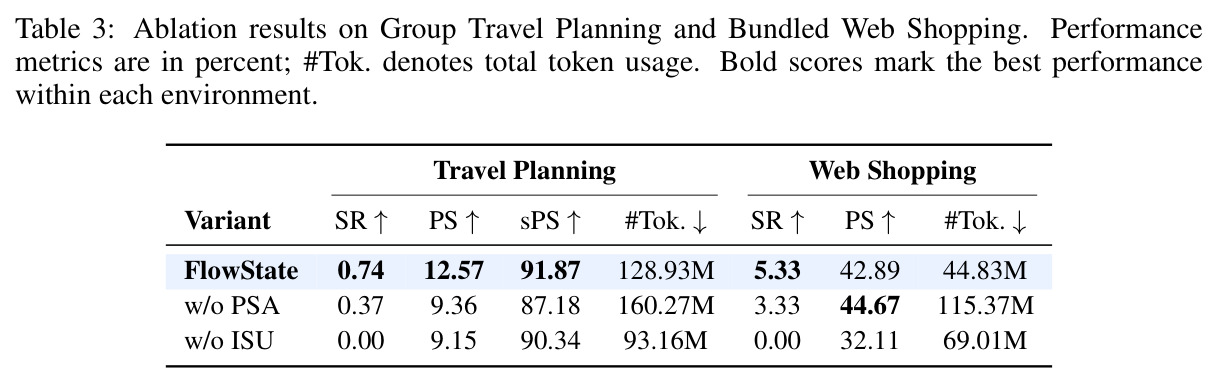
技术新颖性体现在四点。第一,状态节点可跨请求独立寻址并保留证据引用,使记忆从事后检索的经验摘要升级为执行过程的直接产物——「状态即记忆」,统一了工作记忆与长期记忆两套机制,消除状态跟踪与检索系统之间的接口损耗。第二,关系边作为可扩展的访问路径:披露目标节点时同时返回其关系类型与邻居 ID,模型可在后续步骤沿链回访取消条款 C2、政策证据 E4 等,支持多跳证据链组装,这正是图 1 案例中正确决策的来源。第三,执行规则 $P$ 提供运行时护栏,Validateupd 与 Validateacc 拒绝非法操作(如改写历史状态、越界访问),以规则而非模型自律保证状态一致性。第四,消融实验证明两组件互补:去掉 ISU 后购物与旅行的 SR 均降为 0.00%;去掉 PSA 后旅行 PS 从 12.57 降至 9.36 且 Token 从 128.93M 升至 160.27M,说明按需披露同时服务性能与效率。
实验结果
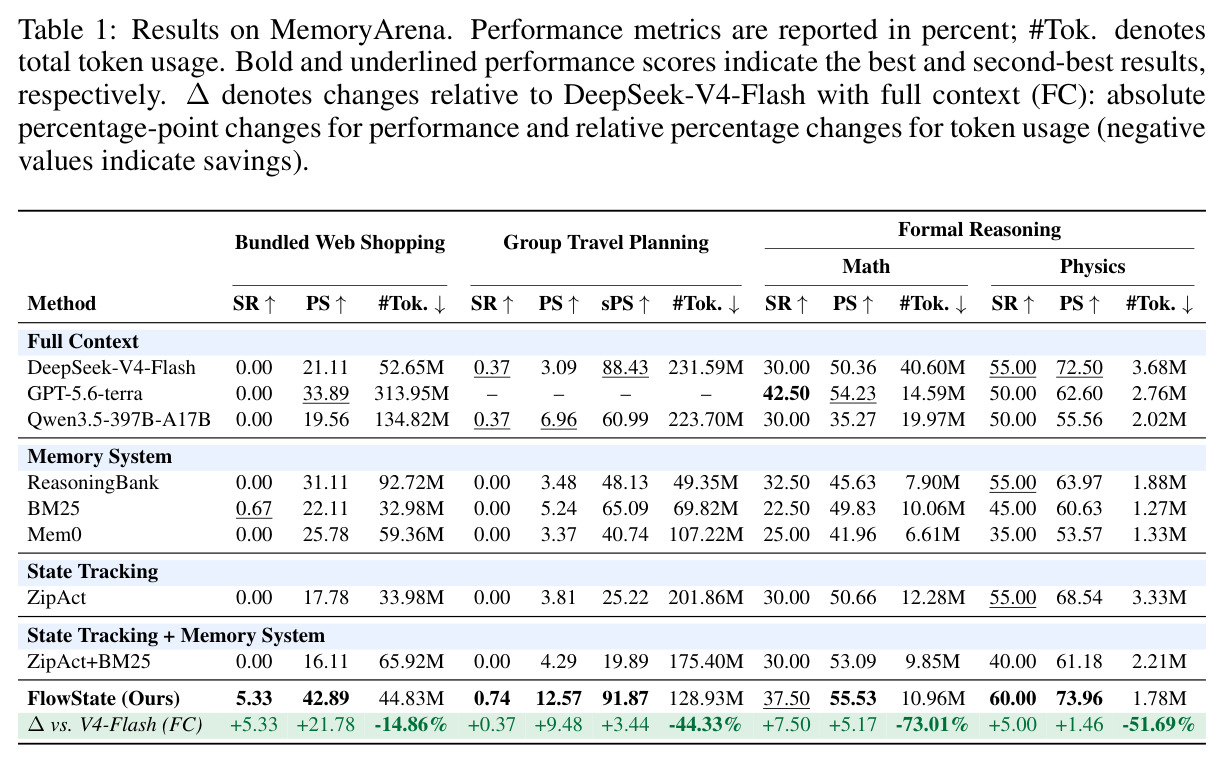
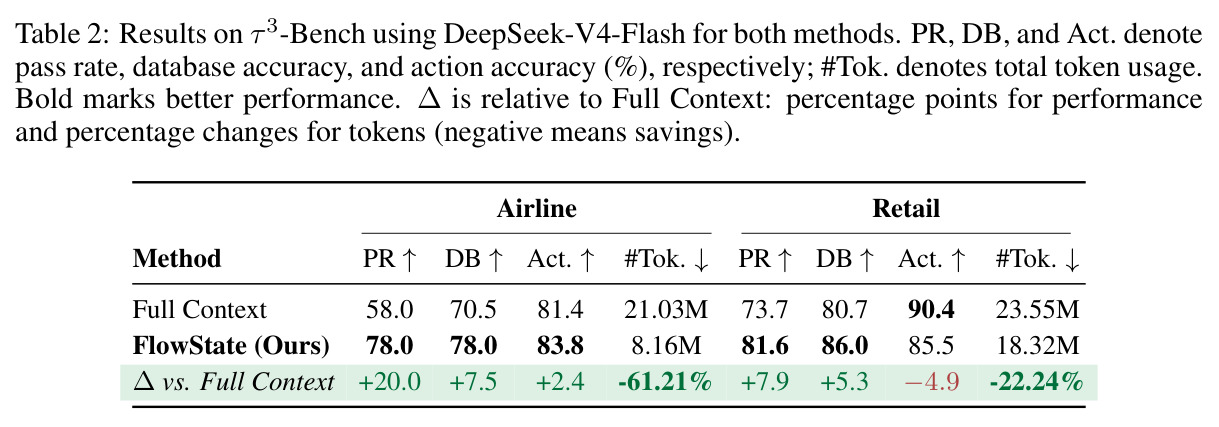
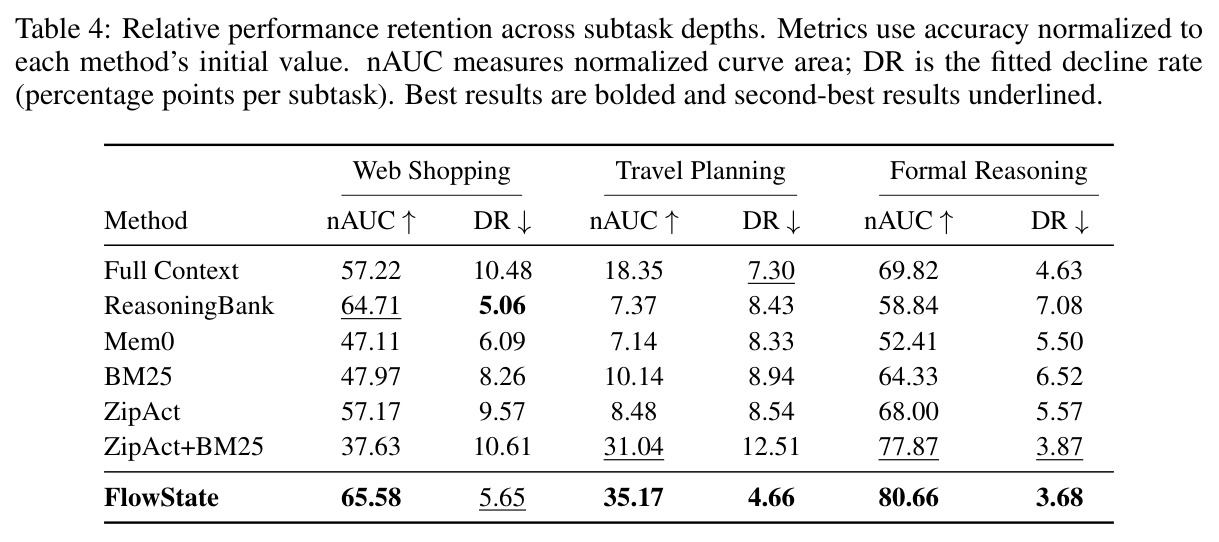
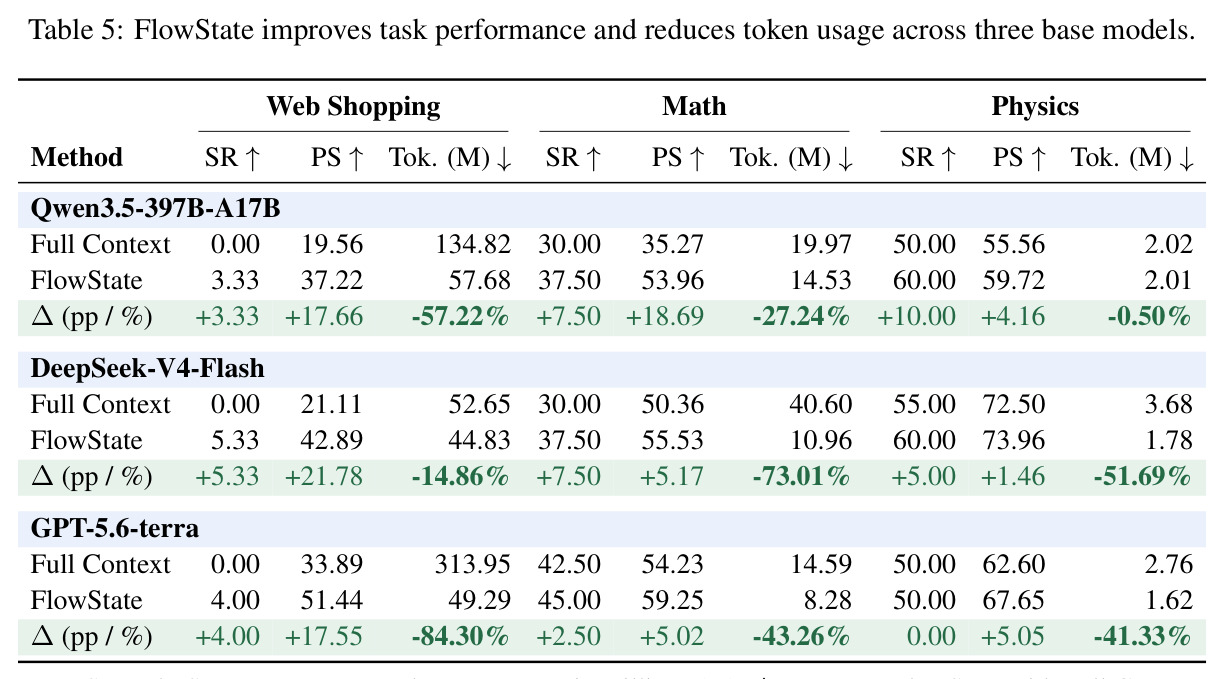
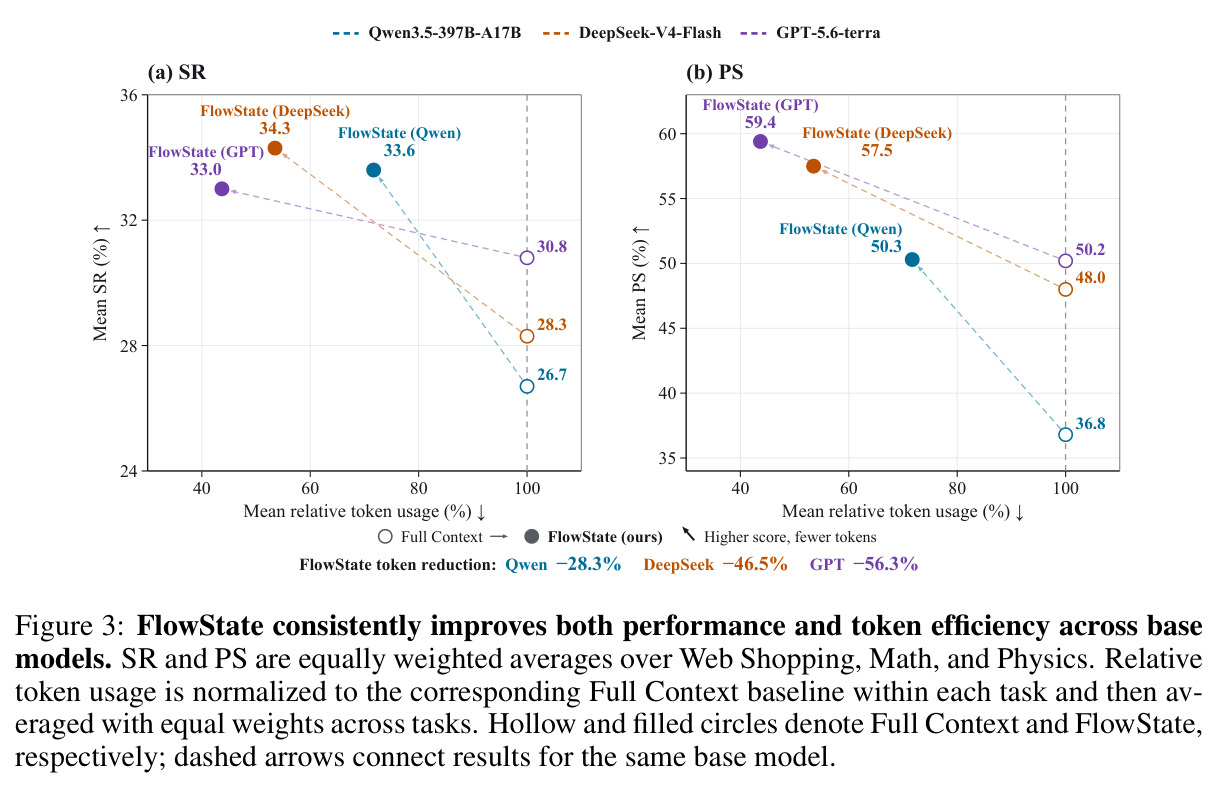
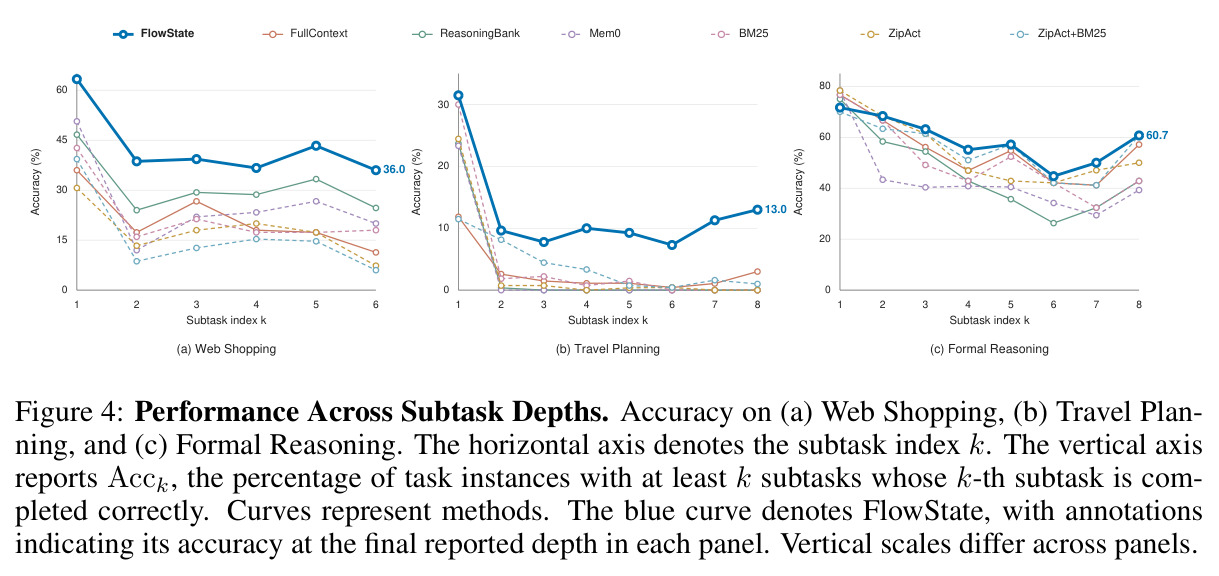
主实验用 DeepSeek-V4-Flash 对比全上下文、记忆系统(ReasoningBank、BM25、Mem0)、状态跟踪与混合方法。MemoryArena 四环境中 FlowState 九项性能指标八项领先:捆绑购物 SR 5.33%(基线≤0.67%)、PS 42.89%(超最强记忆基线 11.78pp)、Token -14.86%;团队旅行 SR 0.74%、PS 12.57%(超最佳基线 5.61pp)、sPS 91.87、Token -44.33%;数学 SR 37.50%、PS 55.53%、Token -73.01%;物理 SR 60.00%、PS 73.96%、Token -51.69%;且九项指标全部超过 ZipAct+BM25。τ³-Bench 上航空 PR 78.0 对 58.0(+20.0pp)、Token -61.21%;零售 PR 81.6 对 73.7(+7.9pp)、Token -22.24%,但动作准确率降 4.9pp。跨模型实验(表 5)九个组合 PS 全升、Token 全降:GPT-5.6-terra 购物 Token 省 84.30%,三模型平均降幅 28.3%–56.3%。消融(表 3)与深度分析(表 4)显示 ISU/PSA 互补,三个领域 nAUC 均最高(65.58/35.17/80.66)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MemoryArena 捆绑网络购物 | 成功率 SR / 进度分 PS / Token | SR 5.33%,PS 42.89%,Token 44.83M | 全上下文 DeepSeek-V4-Flash:SR 0.00%,PS 21.11%,Token 52.65M | SR +5.33pp,PS +21.78pp,Token -14.86% |
| MemoryArena 团队旅行规划 | SR / PS / 软进度分 sPS | SR 0.74%,PS 12.57%,sPS 91.87,Token 128.93M | 全上下文:SR 0.37%,PS 3.09%,sPS 88.43,Token 231.59M | SR +0.37pp,PS +9.48pp,sPS +3.44,Token -44.33% |
| MemoryArena 形式推理(数学与物理) | SR / PS / Token | 数学 SR 37.50%、PS 55.53%、Token 10.96M;物理 SR 60.00%、PS 73.96%、Token 1.78M | 全上下文:数学 SR 30.00%、PS 50.36%、Token 40.60M;物理 SR 55.00%、PS 72.50%、Token 3.68M | 数学 SR +7.5pp、Token -73.01%;物理 SR +5.0pp、Token -51.69% |
| τ³-Bench 航空域 | 通过率 PR / 数据库准确率 DB / Token | PR 78.0,DB 78.0,Token 8.16M | 全上下文:PR 58.0,DB 70.5,Token 21.03M | PR +20.0pp,DB +7.5pp,Token -61.21% |
| τ³-Bench 零售域 | PR / DB / 动作准确率 / Token | PR 81.6,DB 86.0,动作准确率 85.5,Token 18.32M | 全上下文:PR 73.7,DB 80.7,动作准确率 90.4,Token 23.55M | PR +7.9pp,DB +5.3pp,Token -22.24%;动作准确率 -4.9pp(唯一下降指标) |
局限与改进
作者承认的局限:零售场景动作准确率下降 4.9pp(90.4 降至 85.5),说明状态抽象可能丢失细粒度动作历史;捆绑购物上 w/o PSA 变体的 PS 反而更高(44.67 对 42.89),说明全量历史披露并非总是有害,按需披露的收益存在任务依赖;因标注问题排除了 Progressive Web Search 环境,结论限于五个环境;购物与旅行的 SR 绝对值仍很低(5.33%、0.74%),任务远未解决;伦理声明指出真实部署需访问控制、信息溯源与敏感数据保留策略。我的补充观察:PSA 的召回质量完全依赖索引摘要,摘要遗漏的关键属性可能导致相关历史永不回访;框架未内置记忆时效判断,supersedes 关系靠模型自觉维护,未解决 STALE 指出的旧记忆失效问题;$M_k$ 随请求无限增长,缺乏清理与淘汰机制;每步输出四块结构化 JSON 对指令遵循能力要求较高,弱模型下的鲁棒性未报告。
独立分析的弱点
弱点一:历史状态只增不改,修正靠新增节点加 refs 链接,长会话中冲突判断节点不断累积,模型需自行辨别哪条仍然有效,多目标干扰场景下易出错;改进方向是引入时间戳与置信度元数据、自动矛盾检测与软删除。弱点二:PSA 依赖 ID 加摘要的索引,摘要未提及的槽位(如取消费 80 美元)可能使相关状态永不被访问;改进方向是索引附带关键属性槽位或支持谓词查询。弱点三:零售动作准确率下降 4.9pp 表明 judgement/artifact 抽象丢失了动作序列细节;可对最近 $K$ 步保留原始轨迹缓冲,兼得压缩与保真。弱点四:Token 报告只有总量,未分解 ISU 与 PSA 各自的开销收益,购物上 w/o PSA 的 115.37M 反高于完整版 44.83M 的机理缺少归因分析;建议补充逐组件 Token 审计。弱点五:每步强制输出 state_focus、state_delta、tool_calls、assistant_message 四块 JSON,解析失败与重试成本未报告;可为状态操作引入更宽松的增量协议或由小模型托管状态维护。
未来方向
作者提出的方向:把 FlowState 与策略学习结合,使状态操作从提示规则内化为习得行为;面向真实用户部署时的数据访问控制、信息溯源校验与敏感信息保留策略;承诺在合适时机开源完整源码。基于成果可延伸的方向:(1) 结合 STALE 与 MINTEval 的失效检测,为状态节点增加时效元数据与自动过期机制;(2) 把 ISU/PSA 操作序列作为训练数据,蒸馏小型状态管理模型降低主模型负载与延迟;(3) 与 MAGE 的层级状态树互补,探索树形组织加类型化节点的混合记忆表示;(4) 多智能体场景下共享 $M_k$ 的权限模型与状态合并协议;(5) 把索引升级为支持结构化谓词查询的第二层检索;(6) 在论文因标注问题排除的 Progressive Web Search 等开放环境中验证泛化性;(7) 与 KV cache 复用等系统工程结合,把状态增量作为压缩目标进一步降低推理成本。
复现评估
复现可行性中等偏上。有利条件:附录 B.3 完整给出 FlowState、全上下文、记忆系统、状态跟踪四套提示模板(含四块输出协议与状态规则);附录 B.4 以数学形式定义执行规则;附录 B.5 披露基准版本(MemoryArena 6cd9de1、τ³-Bench v1.0.1 fc0055d)、基线实现来源(ReasoningBank/BM25 用 MemoryArena 官方实现,Mem0 8d6c001、ZipAct f025804 从公开代码复现)与生成参数(temperature 0.1、top_p 1.0、max completion tokens 32768、禁用思考);任务规模明确(150 购物、270 旅行、40 数学、20 物理、50 航空、114 零售)。不利条件:FlowState 自身代码「将在合适时间发布」,尚未开源;主模型 DeepSeek-V4-Flash 与 GPT-5.6-terra 为闭源 API,全上下文基线 Token 消耗巨大(购物达 313.95M),完整复现需可观预算;用开源权重模型(Qwen3.5-397B)可部分降低成本。
论文图表
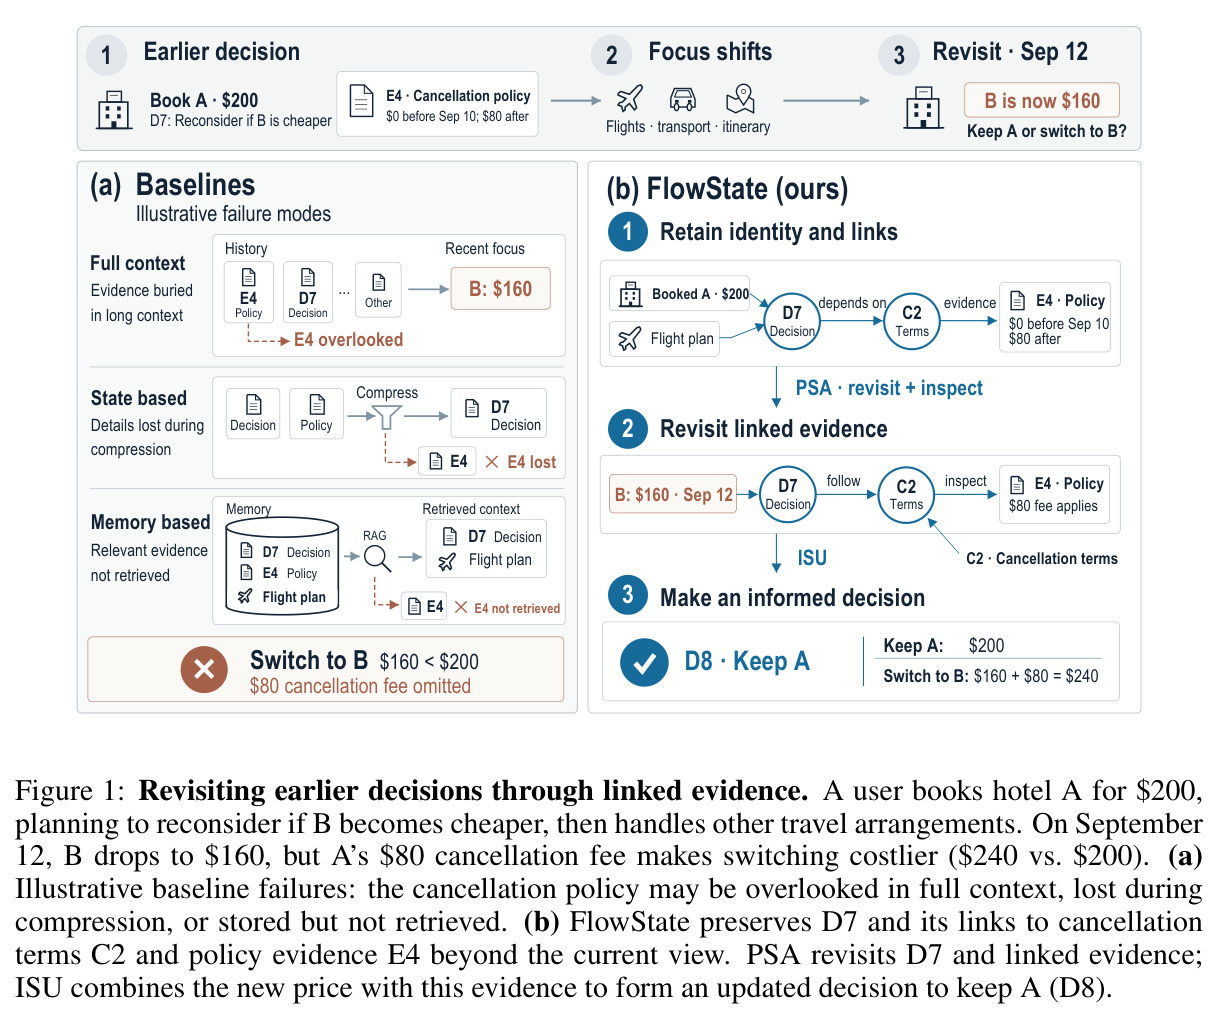
酒店预订案例图。用户预订 200 美元的酒店 A 并计划「若 B 更便宜则改订」,随后处理其他行程;9 月 12 日 B 降至 160 美元,但 A 有 80 美元取消费,改订总成本 240 美元高于保留 A 的 200 美元。(a) 展示三类基线的失败模式:全上下文中取消政策被长上下文淹没、状态压缩中政策证据 E4 丢失、记忆检索中 E4 未被召回,均导致错误改订;(b) 展示 FlowState:D7 决策及其与取消条款 C2、政策证据 E4 的链接被持久保留,PSA 回访 D7 及关联证据,ISU 结合新价格形成「保留 A」的更新决策 D8。
这是全文的动机图,用具体案例讲清三类基线在「历史信息需要重新变得相关」时的不同失败方式,以及「状态即记忆加关系链回访」如何做出正确决策,是理解 ISU/PSA 设计意图的最直观入口。