论LLM强化学习中训练-推理失配的起源与演化 On the Origin and Evolution of Training-Inference Mismatch in LLM Reinforcement Learning
把训练-推理失配精确拆成数值差异与策略滞后,据此提出DLC:中心化+裁剪+按ESS重同步
前置知识
On-policy 与 off-policy 训练
On-policy 强化学习假设用于计算梯度的样本来自当前策略本身,此时策略梯度估计无偏。Off-policy 指样本来自另一个分布 $q$(如旧策略或数值上略有偏差的推理引擎),需要用重要性权重 $p/q$ 或裁剪来修正分布差异。本文的关键观察是:LLM 训练中采样与梯度由两套系统计算,名义上 on-policy 的训练实际上总是 off-policy。
整篇论文的核心工作就是把这种隐性 off-policy 程度精确拆开、分别度量动力学并按来源分工修正,不理解 on/off-policy 之分就无法理解问题的本质。
策略梯度与 score 函数
score 是对数概率对参数的梯度 $s_t = \nabla_\theta \log p_\theta(y_t|h_t)$,REINFORCE 型更新为 $\mathbb{E}[A_t s_t]$。On-policy 时 score 在分布下的期望为零(由概率求和为 1 保证),因此只依赖优势均值的更新项(漂移)理论上是零;分布一旦偏离,均值不再为零,就产生系统性偏置,甚至构成对 $\mathrm{KL}(q\|p_\theta)$ 的梯度。
论文的漂移项、中心化项、残差偏差全部用 score 的期望与协方差表述,式 (1) 和式 (4) 的推导都建立在这套记号上,不懂 score 无法读懂数学主体。
PPO 裁剪与参考策略
PPO 把比值 $p_\theta/p_{ref}$ 裁剪在 $[1-\varepsilon, 1+\varepsilon]$ 内以限制单步移动,verl 还支持双裁剪上界 $c=3$。参考策略 $p_{ref}$ 放在哪里决定比值里包含什么:参考取采样器权重时,策略滞后进入比值、数值差异留在外;参考取每批之前的训练器权重时,两个成分都不进比值,裁剪形同虚设。
论文用参考策略的位置统一解释了 PPO 在量化下崩溃、在陈旧下反而存活这一已知矛盾现象,而采样器参考的裁剪比值正是 DLC 裁剪项的直接来源。
GRPO 与组中心化
GRPO 对同一提示采样一组响应,用奖励减去组均值得到优势 $A_t$,无需 critic。组中心化保证每个提示的优势均值为零,但单个前缀上的期望优势 $\bar a = E_q[a]$ 仍不为零——通往正确答案的前缀为正、出错之后为负——因此漂移项 $\bar a \bar s$ 恰恰在携带学习信号的前缀上最大。
本文所有实验都在 GRPO 设定下进行(组中心化优势、奖励 ±1),而组中心化消不掉前缀级漂移正是需要 score 中心化这类修正的根本原因。
有效样本量 (ESS)
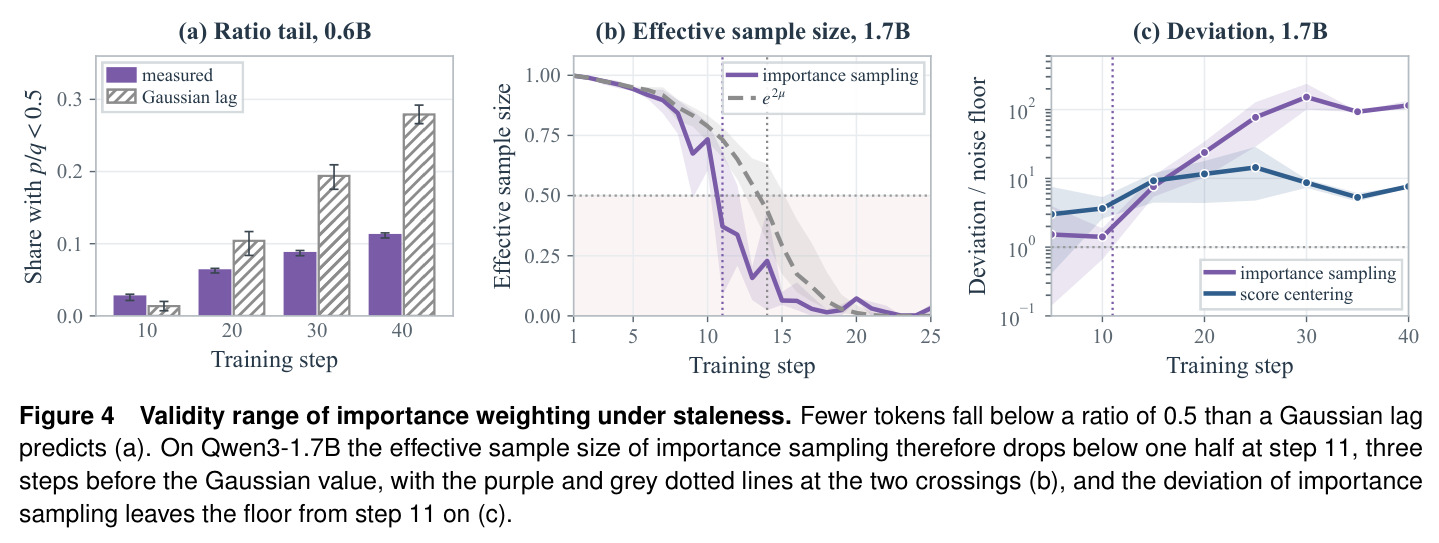
重要性权重 $\rho$ 的有效样本量为 $1/E_q[\rho_t^2]$,衡量加权后样本的等效独立数量:权重越分散 ESS 越小、估计方差越大。对高斯分布的滞后,ESS 等于 $e^{2\mu}$($\mu$ 为平均滞后)。ESS 跌破 1/2 意味着超过一半的等效信息量已损失,被截断的 token 开始给更新注入偏差。
ESS < 1/2 是 DLC 触发重同步的判据,也是论文定位重要性加权失效点(Qwen3-1.7B 第 11 步)的核心度量,贯穿第 6、7 节的论证。
推理引擎数值差异与量化
vLLM 等推理引擎使用自己的 kernel 与数值精度(如 FP8 块量化权重、动态量化激活、FP8 KV cache),与 BF16 训练器在完全相同的权重下也会算出不同的 token 概率,实测约每 token 0.02 nats。工程侧修复包括 batch-invariant kernel、FP16 训练、FP32 LM head、MoE router replay 等,但很难完全消除。
数值差异是失配的两个来源之一,其在整个训练期间近似恒定的动力学性质,决定了它只需中心化而不需要在线加权的修正策略。
研究动机
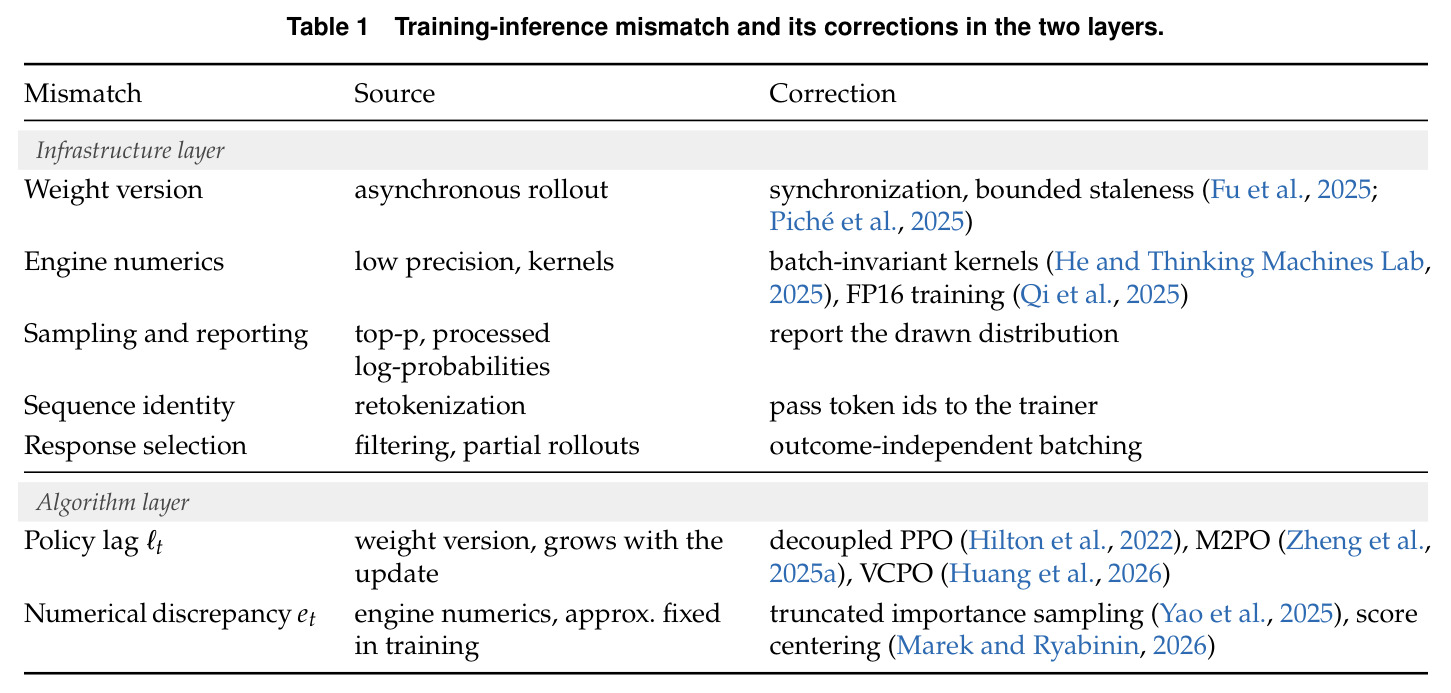
LLM 强化学习训练在工程上把采样与训练拆成两套系统:vLLM 等推理引擎采样响应,FSDP 等训练器计算梯度。两套系统即使权重完全相同,由于 kernel 与数值精度不同,算出的 token 概率分布 $q$ 与 $p$ 也不一致(Yao et al., 2025 实测 vLLM 与 FSDP 有差异),FP8 量化采样器进一步拉大差距;AReaL、PipelineRL 等异步系统又叠加第二个来源——采样器保留上一次同步的旧权重,梯度却按新权重计算,训练数据实际上变成了 off-policy。已有三类修正(截断重要性采样、score 中心化、PPO 裁剪)的效果强烈依赖失配来源:Marek & Ryabinin (2026) 显示量化采样器下 score 中心化最好、PPO 直接崩溃;陈旧采样器下 score 中心化反而落后于重要性采样,PPO 却能存活。哪种失配性质决定哪种修正,此前没有理论解释,实践者只能凭经验试错。
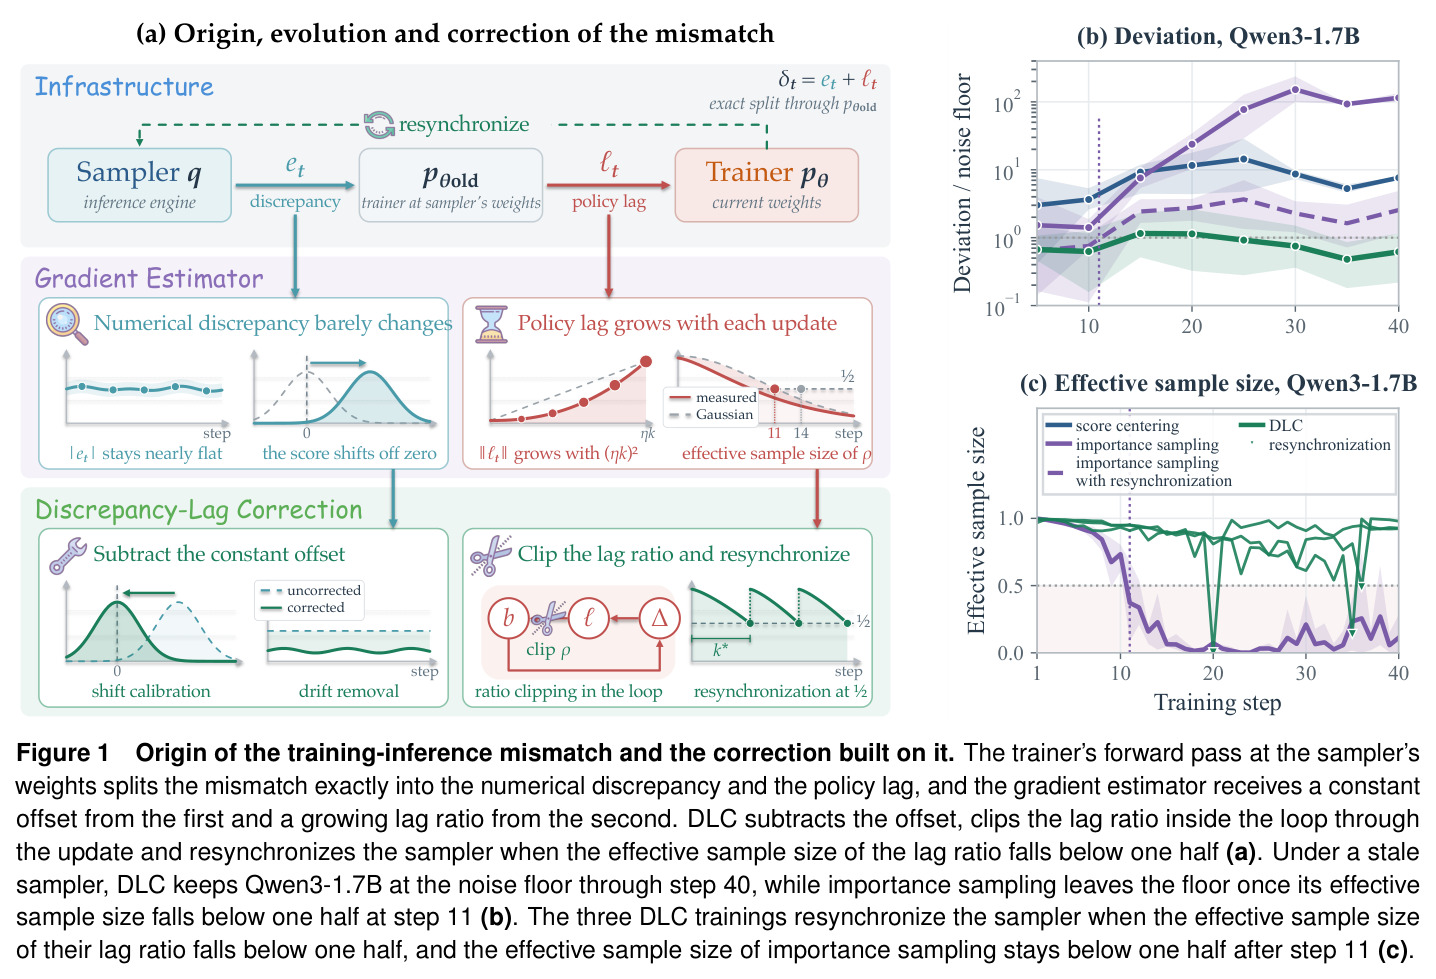
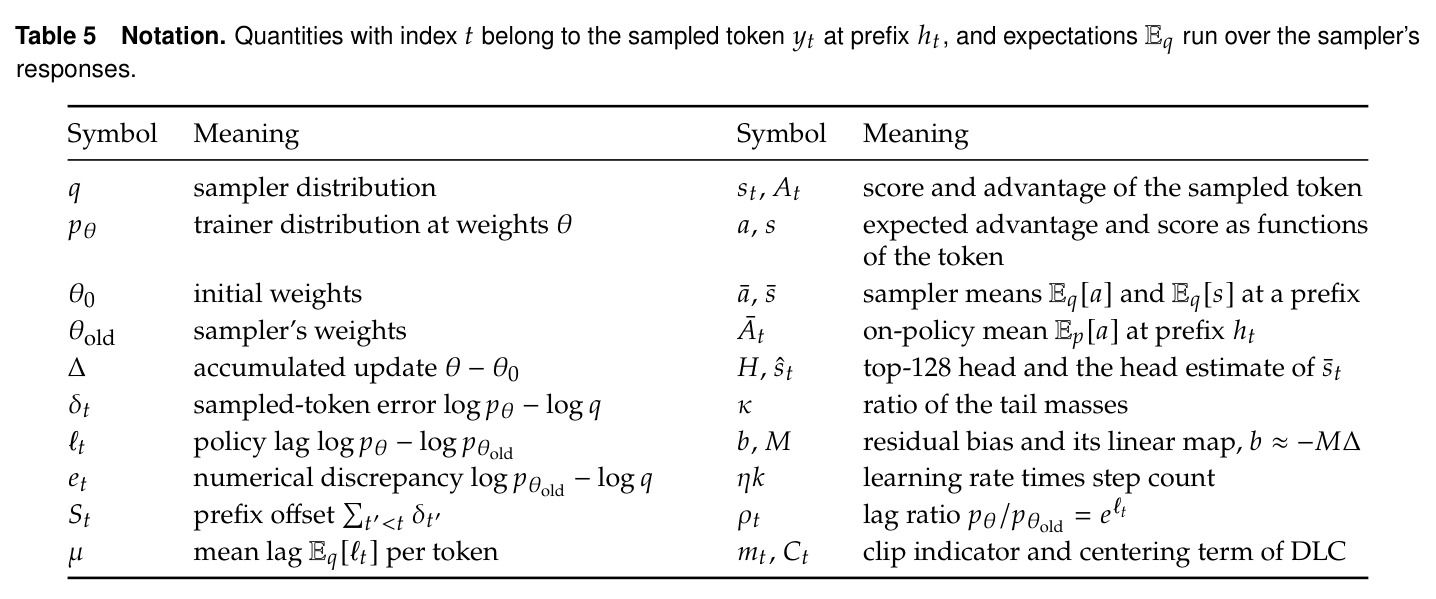
本文的目标是论文要回答的问题是:失配源的什么性质决定了它需要哪种修正。技术路线分三步:第一,在采样器权重 $\theta_{old}$ 处额外做一次训练器前向,把每个被采样 token 的误差 $\delta_t = \log p_\theta(y_t|h_t) - \log q(y_t|h_t)$ 精确拆成数值差异 $e_t$ 与策略滞后 $\ell_t$;第二,沿 40 步训练追踪两者的动力学,证明 $e_t$ 近似恒定(量化约 0.02 nats/token),而 $\ell_t \approx \Delta^\top s_t$ 随累计更新 $\Delta$ 增长,其残差偏差进入下一步更新形成正反馈回路;第三,从这套解释推导出按来源分工的修正方法 DLC——对恒定差异做中心化、对滞后比例做裁剪、在有效样本量跌破 1/2 时重同步采样器——目标是让陈旧采样器下的训练偏差保持在噪声地板两倍以内,并阻止按采样器前缀测量的偏差所探测不到的训练崩溃。
与已有工作不同的是,已有工作把失配当单一对象处理:截断重要性采样、M2PO、VCPO 的权重都以 $p/q$ 为分母,数值差异与策略滞后被同一个比值混在一起加权;GAC、SAT、GMC-GRPO 分析更新方向但不做中心化,也没把滞后与数值差异分开。Guan et al. (2026) 虽给出了重要性比例在采样器权重处的因子分解,但对两个因子用同一套加权。本文的独特之处有三:一是拆分是精确恒等式而非近似,靠 $\theta_{old}$ 处的第三次前向逐 token 实现;二是首次把滞后放进训练回路里追踪,指出中心化会留下与滞后成正比的 token 项 $(A_t-\bar A_t)\ell_t$ 形成自放大回路;三是按「谁能移除它」把修正分配到算法层与基础设施层——算法够不着的部分(滞后超有效性范围后)交还给基础设施做重同步,由此得到中心化+裁剪+重同步的 DLC 组合。
核心方法
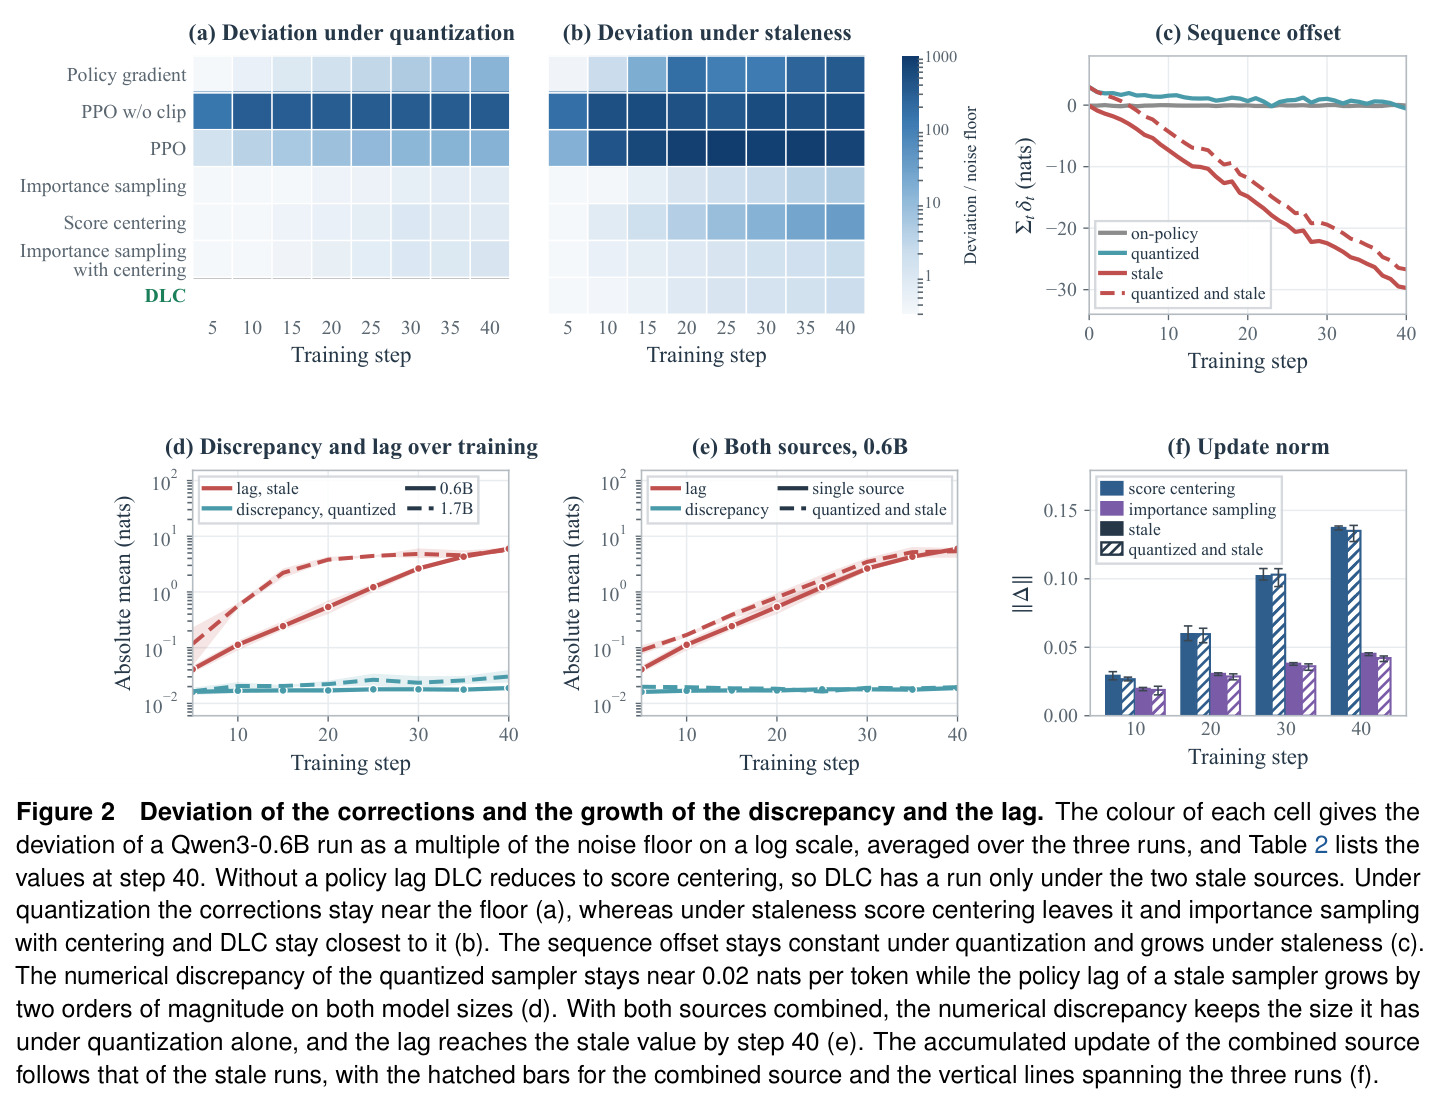
直觉上,失配到达梯度时是两个动力学截然不同的成分:引擎数值差异在训练期间几乎不变(量化采样器约 0.02 nats/token),给每步更新加一个近乎固定的偏置,中心化即可去掉其主要部分;策略滞后由训练器自己的更新造成,$\ell_t \approx \Delta^\top s_t$ 随累计更新增长(陈旧采样器每步约 0.7 nats,40 步内长两个数量级),其残差偏差进入下一步更新形成闭环。技术上 DLC 每步:在采样器权重 $\theta_{old}$ 做一次训练器前向得到滞后比例 $\rho_t = e^{\ell_t}$;对滞后比例做 PPO 式裁剪以切断回路;再从更新中减去其在采样器下的期望(中心化项 $C_t$)以消除数值差异漂移;当 $\rho$ 的有效样本量跌破批的 1/2 时复制训练器权重给采样器。实验在 verl + vLLM 上用 Qwen3-0.6B/1.7B 于 Countdown(奖励 ±1,64 提示 × 8 采样,SGD 学习率 $10^{-2}$,40 步,每配置 3 次)验证,采样器设 BF16 参考、FP8 量化、64 步同步陈旧、量化加陈旧四种。
核心创新是「按失配成分分配修正」的精确拆分与比值分母选择。训练器在采样器权重 $\theta_{old}$ 处的前向把误差拆成 $\delta_t = \ell_t + e_t$,这是恒等式而非近似,对应重要性比例 $p_\theta/q = (p_\theta/p_{\theta_{old}})(p_{\theta_{old}}/q)$ 的对数分解。本质区别在分母:重要性采样与 VCPO 以 $q$ 为分母,截断和加权同时作用于两个成分;以每批前训练器为参考的 PPO 分母是 $p_{batch}$,两个成分都不进比值,因此量化下崩溃(699× 噪声地板);DLC 与采样器参考 PPO、M2PO 一样以 $p_{\theta_{old}}$ 为分母让比值只含滞后,再用中心化项 $C_t$ 单独消掉数值差异的漂移。论文还刻画漂移项 $\bar a \bar s = -\bar a \nabla_\theta \mathrm{KL}(q\|p_\theta)$:期望优势为正的前缀上漂移会把训练器向采样器蒸馏,恰发生在携带学习信号的前缀上;中心化去掉漂移但留下滞后驱动的回路项,由裁剪与重同步解决。
方法步骤详情
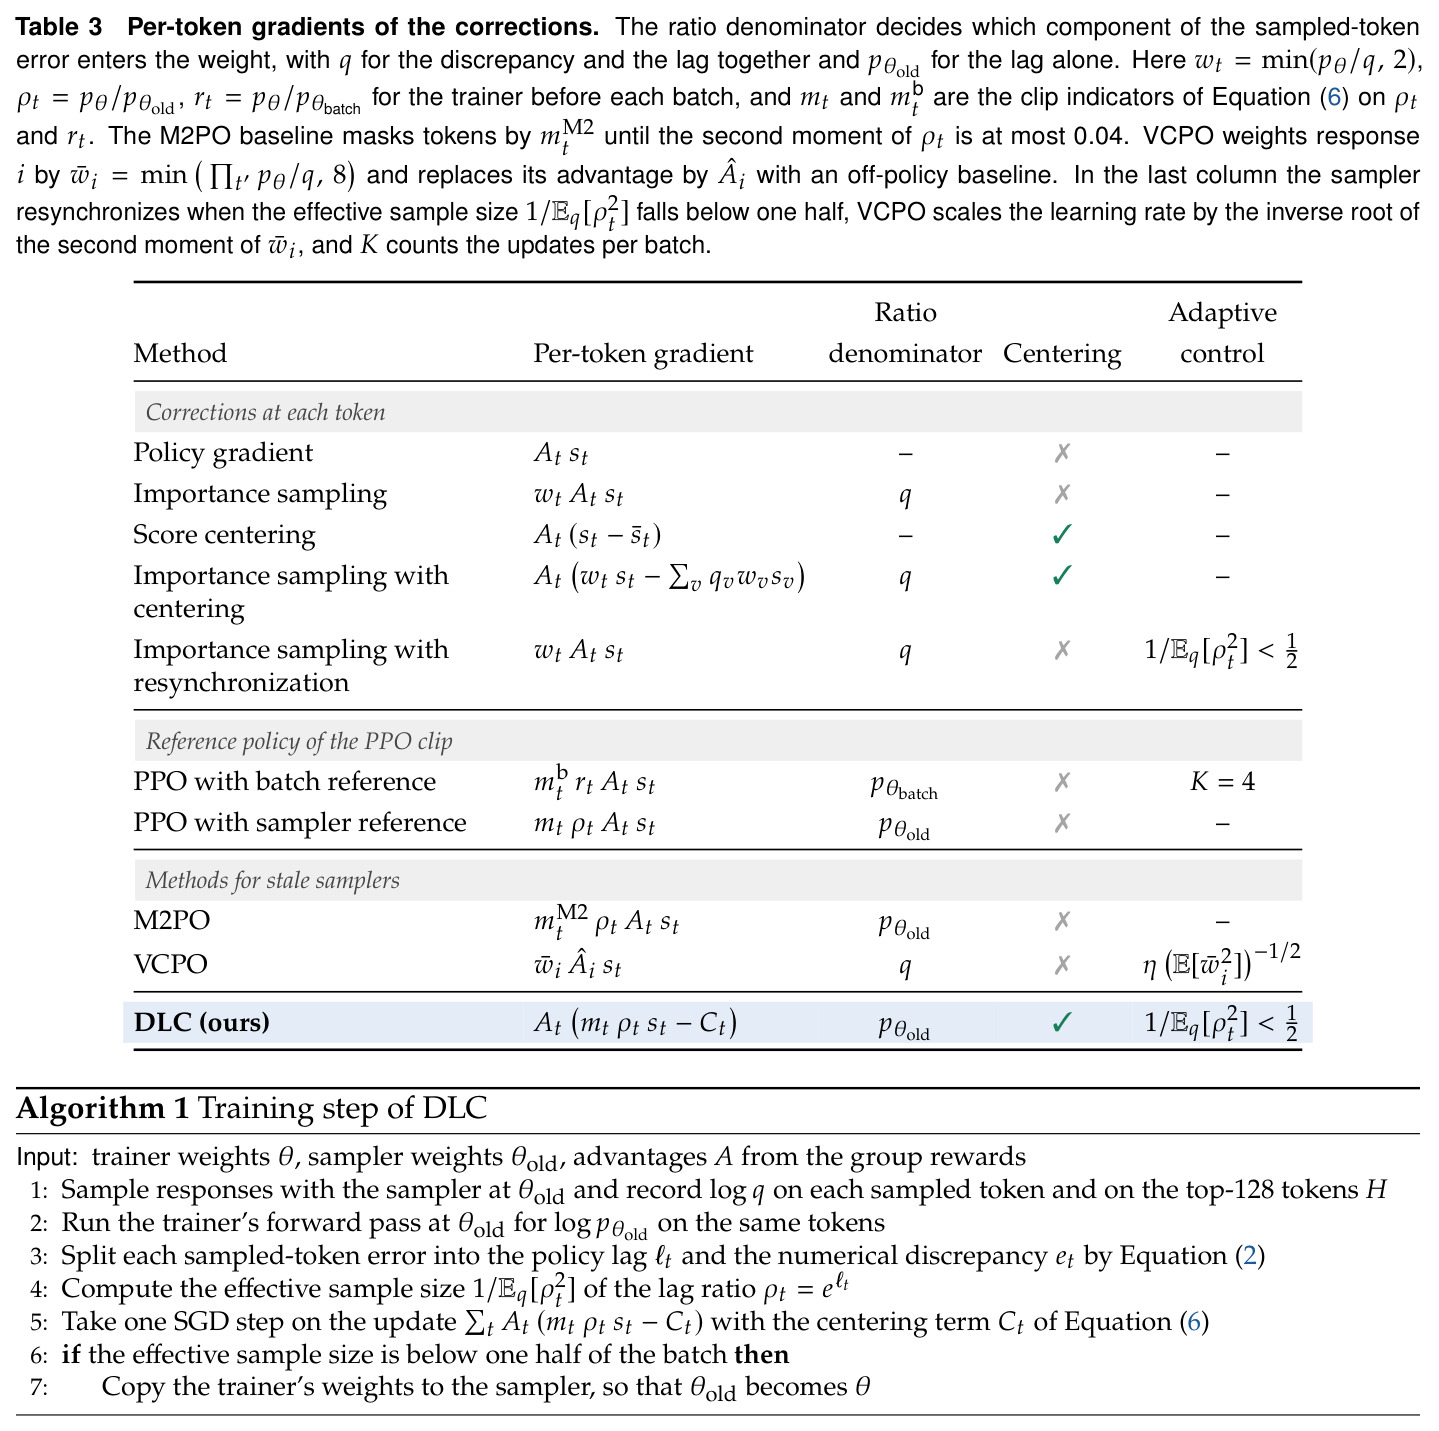
算法 1 给出 DLC 的一个训练步,输入为训练器权重 $\theta$、采样器权重 $\theta_{old}$、组奖励优势 $A$。第 1 步:采样器采样响应,记录每个被采样 token 的 $\log q$ 及 top-128 头部 $H$ 的 log-prob。第 2 步:训练器在 $\theta_{old}$ 做一次前向得 $\log p_{\theta_{old}}$。第 3 步:按式 (2) 把误差拆成 $\ell_t$ 与 $e_t$。第 4 步:计算滞后比例 $\rho_t = e^{\ell_t}$ 的有效样本量。第 5 步:对更新 $\sum_t A_t(m_t \rho_t s_t - C_t)$ 做 SGD,裁剪指示 $m_t$ 用 $\varepsilon = 0.2$、双裁剪上界 $c = 3$,中心化项 $C_t = \sum_{v \in H}(q_v m_v \rho_v - \kappa p_\theta(v)) s_v$,$\kappa$ 为尾部质量比,使常数优势贡献为零、数值差异漂移消失。第 6 步:若有效样本量低于批的 1/2,复制训练器权重使 $\theta_{old} \leftarrow \theta$。相对重要性采样加中心化,每步只多一次前向。
技术新颖性
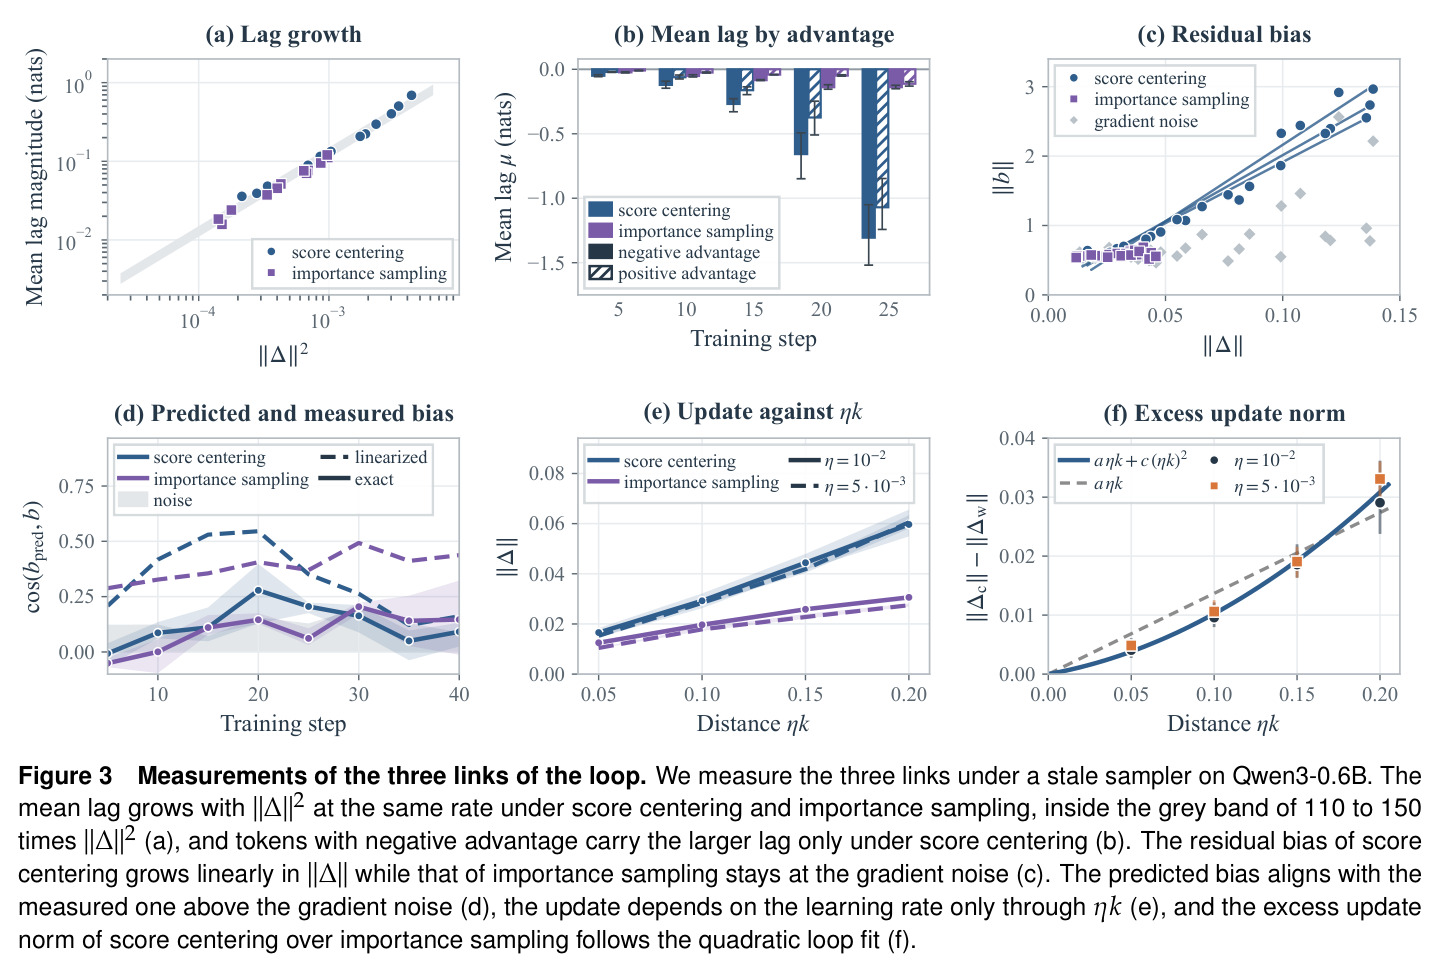
新颖性有三点。其一,统一已有方法并给出归约:当 $\theta = \theta_{old}$ 时滞后比例恒为 1、裁剪不激活,DLC 退化为 score 中心化;当 $q = p_{\theta_{old}}$ 且裁剪不激活时退化为采样器参考 PPO——三个方法是同一框架在不同失配源下的特例,表 3 用每 token 梯度和分母把所有修正放进一张表比较。其二,回路的量化刻画:score 中心化相对重要性采样的超额更新范数 $E = \|\Delta_c\| - \|\Delta_w\|$ 用 $E = a\eta k + c(\eta k)^2$ 拟合,二次系数 $c = 0.52$、$R^2 = 0.987$(六次分别拟合二次项均为正),且对 $\eta k$ 的依赖与异步 GRPO「同步间隔 × 学习率」稳定性边界一致。其三,有效性范围判据:把重要性加权的失效点定位在滞后比例的有效样本量跌破 1/2 之处,并以此触发重同步;Qwen3-1.7B 上实测比高斯预测 $e^{2\mu}$ 提前三步(第 11 步对第 14 步),因为重尾比例集中在少数 token 上。
实验结果
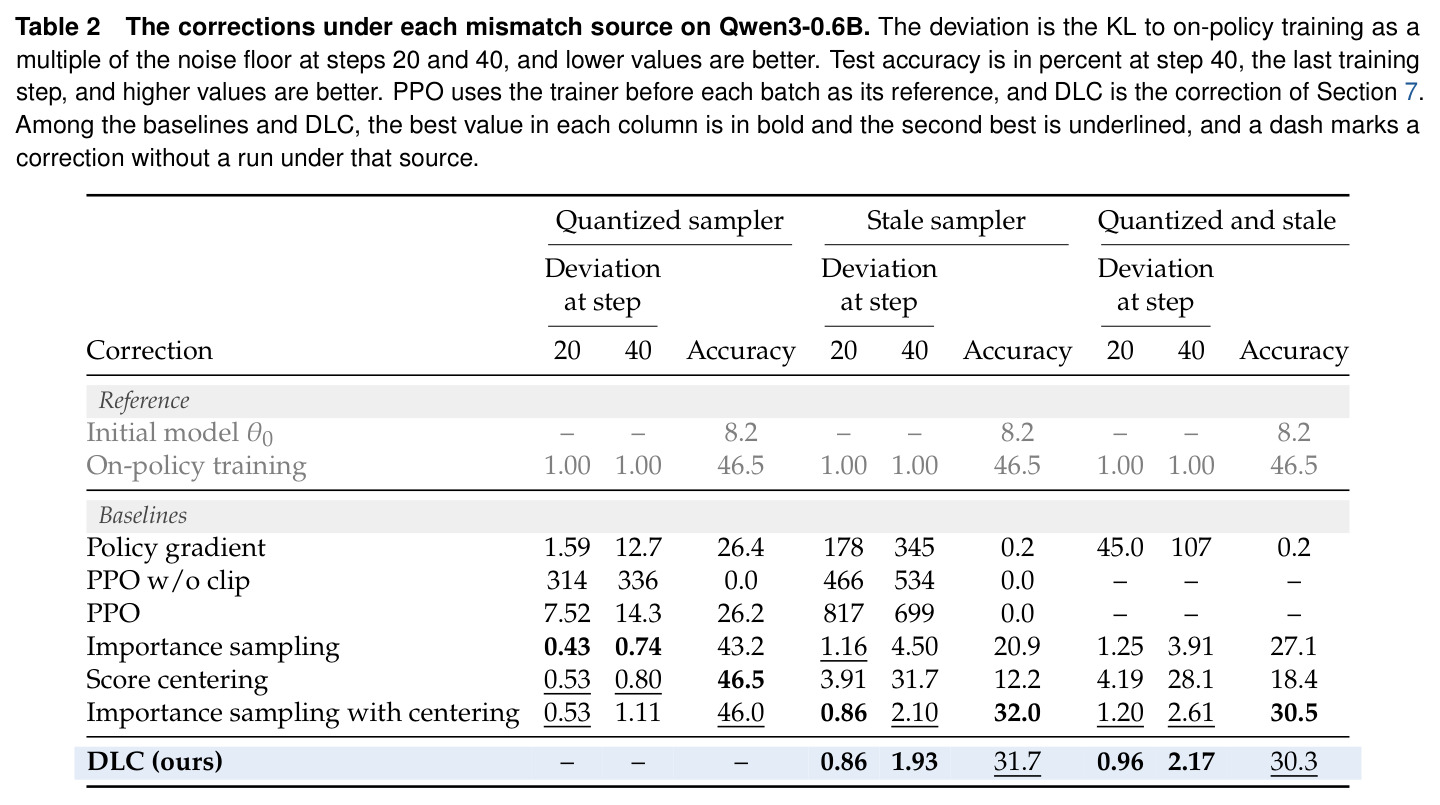
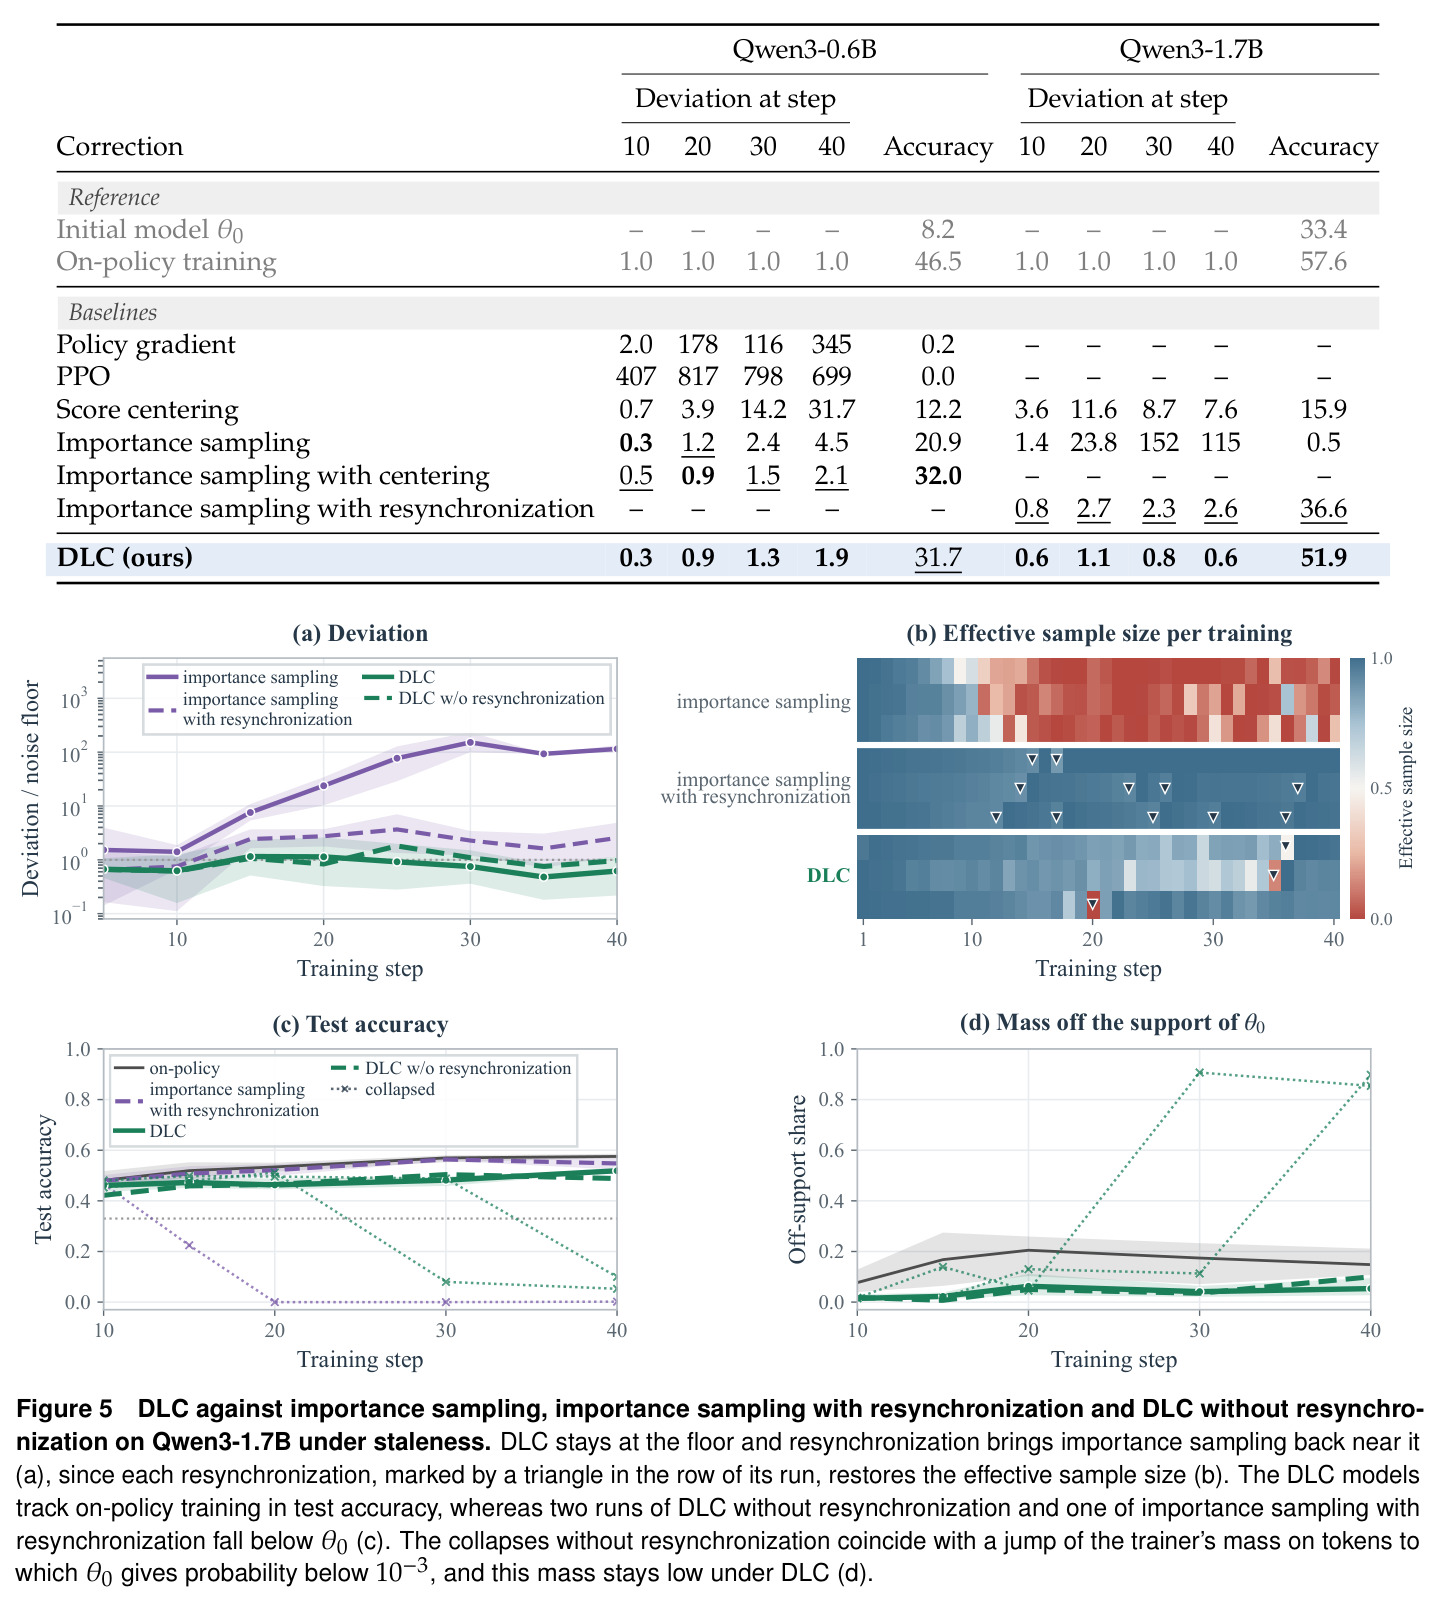
论文在 Qwen3-0.6B/1.7B 上以 40 步训练、3 次运行系统对比,偏差为对 on-policy 模型的 KL 除以噪声地板。表 2 复现来源依赖:量化下 score 中心化 0.80× 地板、准确率 46.5% 追平 on-policy,而策略梯度 12.7×、PPO 14.3×;陈旧下 score 中心化恶化到 31.7×(准确率 12.2%),重要性采样 4.5×(20.9%),PPO 高达 699×(0.0%),DLC 1.9×(31.7%)。拆分动力学:量化误差恒定约 0.02 nats/token,陈旧滞后每步增长约 0.7 nats。回路证据:score 中心化的残差偏差随 $\|\Delta\|$ 线性增长($R^2$ 0.95–0.99),第 40 步达梯度噪声 2.5 倍;预测偏差与实测余弦达 0.55(噪声仅 0.07)。有效性范围:Qwen3-1.7B 上重要性采样的有效样本量第 11 步跌破 1/2,偏差同时离开地板、第 30 步达 152×。表 4:1.7B 上 DLC 稳定在 0.6–1.1× 地板、准确率 51.9%(on-policy 57.6%),每次运行仅重同步一次(第 20/35/36 步);重要性采样加重同步 2.6×、36.6%(一次崩溃)。崩溃诊断:无重同步的 DLC 崩溃时 off-support 质量约 90%(此前 ≤14%),与准确率下跌的 Spearman 相关 0.80,而采样器前缀上的偏差探测不到。附录的 Qwen3-8B 与连续异步实验中 DLC 分别保持约 3× 与 1.2× 地板。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Countdown RL 训练(Qwen3-1.7B,陈旧采样器) | 偏差:对 on-policy 模型的 KL / 噪声地板(第 40 步,越低越好) | DLC:0.6× | 重要性采样 115×;score 中心化 7.6× | 比重要性采样低约 190 倍,比 score 中心化低约 12 倍 |
| Countdown 测试准确率(Qwen3-1.7B,陈旧采样器) | 测试集准确率 %(第 40 步,越高越好) | DLC:51.9% | on-policy 57.6%;重要性采样加重同步 36.6%;重要性采样 0.5% | 比最佳基线高 15.3 个百分点,与 on-policy 差距 5.7 个百分点 |
| Countdown RL 训练(Qwen3-0.6B,陈旧采样器) | 偏差(× 噪声地板,第 40 步)与测试准确率 | DLC:1.9×,准确率 31.7% | 重要性采样+中心化 2.1× / 32.0%;score 中心化 31.7× / 12.2%;PPO 699× / 0.0% | 偏差并列最优,准确率与最佳基线基本持平 |
| Countdown RL 训练(Qwen3-0.6B,量化采样器) | 偏差(× 噪声地板,第 40 步) | DLC 在纯量化源下约化为 score 中心化:0.80×,准确率 46.5% 追平 on-policy | 策略梯度 12.7× / 26.4%;PPO 14.3× / 26.2% | 验证「恒定数值差异只需中心化」的来源依赖结论 |
局限与改进
局限有几方面。作者承认的:实验限于 40 步短训练(靠共享 checkpoint 回放保证测量不崩溃)、Countdown 单任务 ±1 奖励、非思考模式;超参($\varepsilon = 0.2$、头部 128、阈值 1/2)未扫描;重同步靠整份权重复制实现,大模型上的停顿成本未评估。我观察到的:偏差指标定义在采样器前缀上,对训练器移向采样器罕见 token 的偏移不敏感,需要补充 off-support 份额这类第二指标才能预警崩溃;滞后的一阶回路分析只在滞后约 1 nat 内有效,第 20 步后滞后集中于极少数 token(1% 的 token 承载 11% 总滞后),该 regime 缺乏理论;1/2 阈值是经验判据,与不稳定起点之间没有因果推导;中心化项依赖引擎报告真实采样分布、传 token id 等基础设施对齐假设,对 top-p 截断、重分词等未对齐配置的鲁棒性未知;也未与 M2PO、VCPO、GAC 做实验对比,只在表 3 做了解析比较。
独立分析的弱点
独立分析三点弱点。第一,重同步是最重的组件:把整份训练器权重复制给采样器相当于一次完整检查点传输,在百亿级模型或多机 vLLM 部署下会造成明显停顿,且论文只给出「边生成边更新权重」的设想而未实现,改进方向是增量式/流式权重同步或按响应接纳(admission control)替代整批重同步。第二,中心化项 $C_t$ 依赖采样器报告的 top-128 头部概率与尾部质量比 $\kappa$,当引擎只提供经 top-p 处理的概率或头部覆盖不足时尾部估计会失真——而这正是论文自己列为基础设施层失配的情形,改进方向是让引擎直接上报实际抽样分布或自适应调整头部大小。第三,有效性阈值 1/2 与裁剪范围 $\varepsilon = 0.2$ 都来自 0.6B/1.7B 上的经验观察,滞后增长率(每步约 0.7 nats)在不同模型规模、序列长度、奖励结构下如何缩放没有答案,改进方向是推导 $\ell_t$ 增长率与学习率、模型宽度的标度律,让阈值能按配置自动整定,而非固定常数。
未来方向
作者明确提出的方向:对边生成边更新权重的采样器,把裁剪参考改为每个 token 的生成时权重,用「按有效样本量决定是否接纳一条响应」替代整批重同步;以及与 M2PO 类二阶矩掩码的组合探索。基于成果可延伸的方向:把 off-support 份额做成在线崩溃预警器,与偏差指标一起部署监控;研究基础设施层数值修复(batch-invariant kernel、router replay)收敛后,算法层修正还剩多少必要工作,即两层的成本收益分工;把回路分析推广到滞后超过 1 nat 的非线性区,或推广到 PPO/GRPO 之外带 critic 的方法;用 DLC 的因子分解视角重新审视 GSPO 的序列级裁剪——序列级比值同样可拆成滞后与差异两个因子,可能解释其经验表现;最后在多任务混合奖励与更长训练(数百步)下验证 1/2 阈值与重同步频率的迁移性。
复现评估
可复现性较好。代码开源在 https://github.com/Skylanding/Training-Inference-Mismatch,训练框架是社区标准的 verl + vLLM,模型 Qwen3-0.6B/1.7B/8B 与 Countdown 任务均公开可得。实验规模小:每配置 3 次运行、40 步、64 提示 × 8 采样,小模型单机多卡即可完成;附录 B 给出训练配置、失配源与测量协议,离线测量用固定 checkpoint 与固定探测前缀,便于逐点复现图表。实现 DLC 的关键工程改动是把训练器在 $\theta_{old}$ 的前向与 top-128 log-prob 管道接进 verl,难度中等;论文未说明 GPU 数量、随机种子与代码许可证,需要自行确认。总体评估:熟悉 verl 的团队预计数天可复现主要表格,完全复现图 3 的回路测量(残差偏差、余弦对齐、二次拟合)需要额外实现离线测量代码,工作量更大。
论文图表
DLC 单步伪代码:采样并记录 $\log q$ 与 top-128 头部 → 训练器在 $\theta_{old}$ 前向 → 按式 (2) 拆出 $\ell_t$ 与 $e_t$ → 计算滞后比例的 ESS → 对 $\sum_t A_t(m_t \rho_t s_t - C_t)$ 做 SGD → ESS 低于批的 1/2 时把训练器权重复制给采样器。
它把方法浓缩成七行可实现的流程,明确 DLC 相对重要性采样+中心化只多一次前向的成本结构,是复现者和工程落地者最先要看的部分。