在线策略蒸馏能容忍多大的训练–推理失配 How Much Training-Inference Mismatch Can On-Policy Distillation Tolerate?
量化 OPD 失配预算:首层 KV cache 保 BF16 即可安全用 FP8,提速 1.62 倍
前置知识
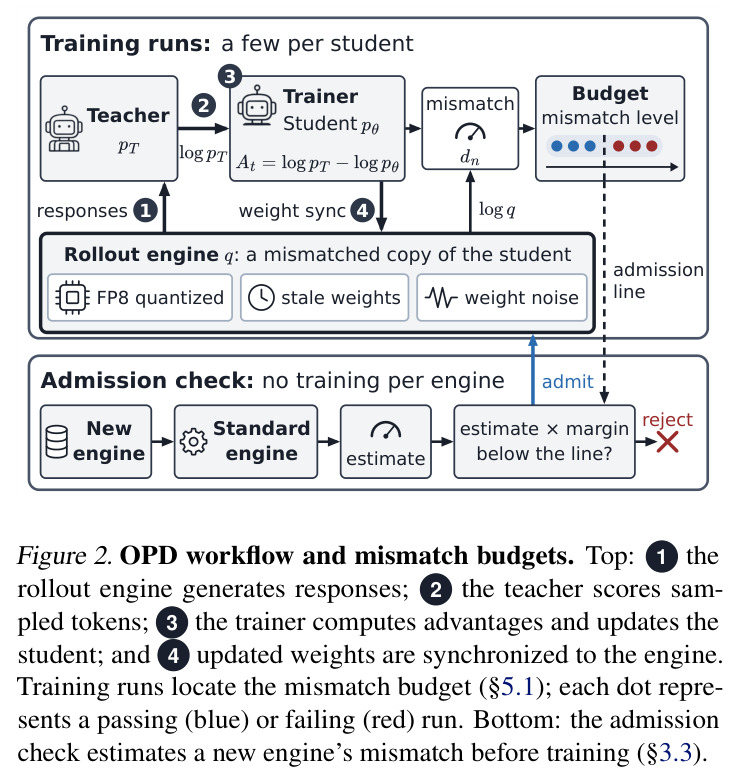
在线策略蒸馏(On-Policy Distillation, OPD)
学生模型自己采样响应,由一个固定的更强教师对每个 token 打分,优势定义为 $A_t = \log p_T(y_t|y_{<t}) - \log p_\theta(y_t|y_{<t})$,再用策略梯度 $P_t A_t \nabla_\theta \log p_\theta(y_t|y_{<t})$ 更新学生。它与 RL 后训练的唯一区别在优势来源:RL 用整条响应的 0/1 奖励,OPD 用教师与学生对数概率的逐 token 差。一旦学生匹配教师,每个 token 的优势为零,更新自动消失。
本文的研究对象就是 OPD。正是“目标处更新为零”这一结构,使 OPD 对失配的容忍机制与 RL 有本质区别,是全文所有分析的出发点。
训练–推理失配(training–inference mismatch)
生成 rollout 的推理引擎(如 vLLM)产出的下一 token 分布 $q$,与训练器中被训模型的分布 $p_\theta$ 不一致。来源有三类:推理与训练 kernel/数值的固有差异、引擎权重的量化、异步训练导致的陈旧权重。本文把失配统一量化为引擎实际访问前缀上的每 token KL 散度,单位 nats/token。
全文要回答的核心问题就是“失配有多大、OPD 能容忍多少”,这个变量贯穿度量、预算、准入检查三个部分。
KL 散度与 held-out KL
KL 散度 $\mathrm{KL}(p\|q)=\sum p \log(p/q)$ 衡量两个分布的差异。本文用两种 KL:一是引擎与训练器分布的逐 token KL 作为失配度量;二是 held-out KL——学生在 530 道保留数学题(AIME24+MATH-500)上对教师的平均每 token KL,作为训练质量指标。标准训练把 7B 学生的 held-out KL 从 0.0965 降到 0.0481。
判定一个 rollout 配置“通过/失败”的质量规则完全建立在 held-out KL 的相对变化 $\Delta(c)$ 上(阈值 $\tau=0.20$),是理解所有实验结论的标尺。
量化与 KV cache(FP8/NVFP4)
量化把模型权重、激活或 KV cache 从 16-bit BF16 压到 8-bit FP8 甚至 4-bit NVFP4,让同样显存容纳更多并发 rollout 并加速生成。KV cache 缓存已生成 token 的 key/value 向量,是长响应推理的显存大头。Engine-only 指只量化 rollout 引擎,训练器与教师仍保持 BF16。
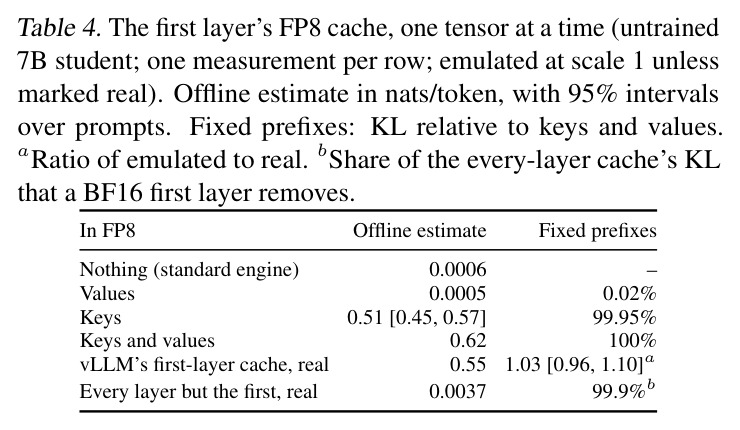
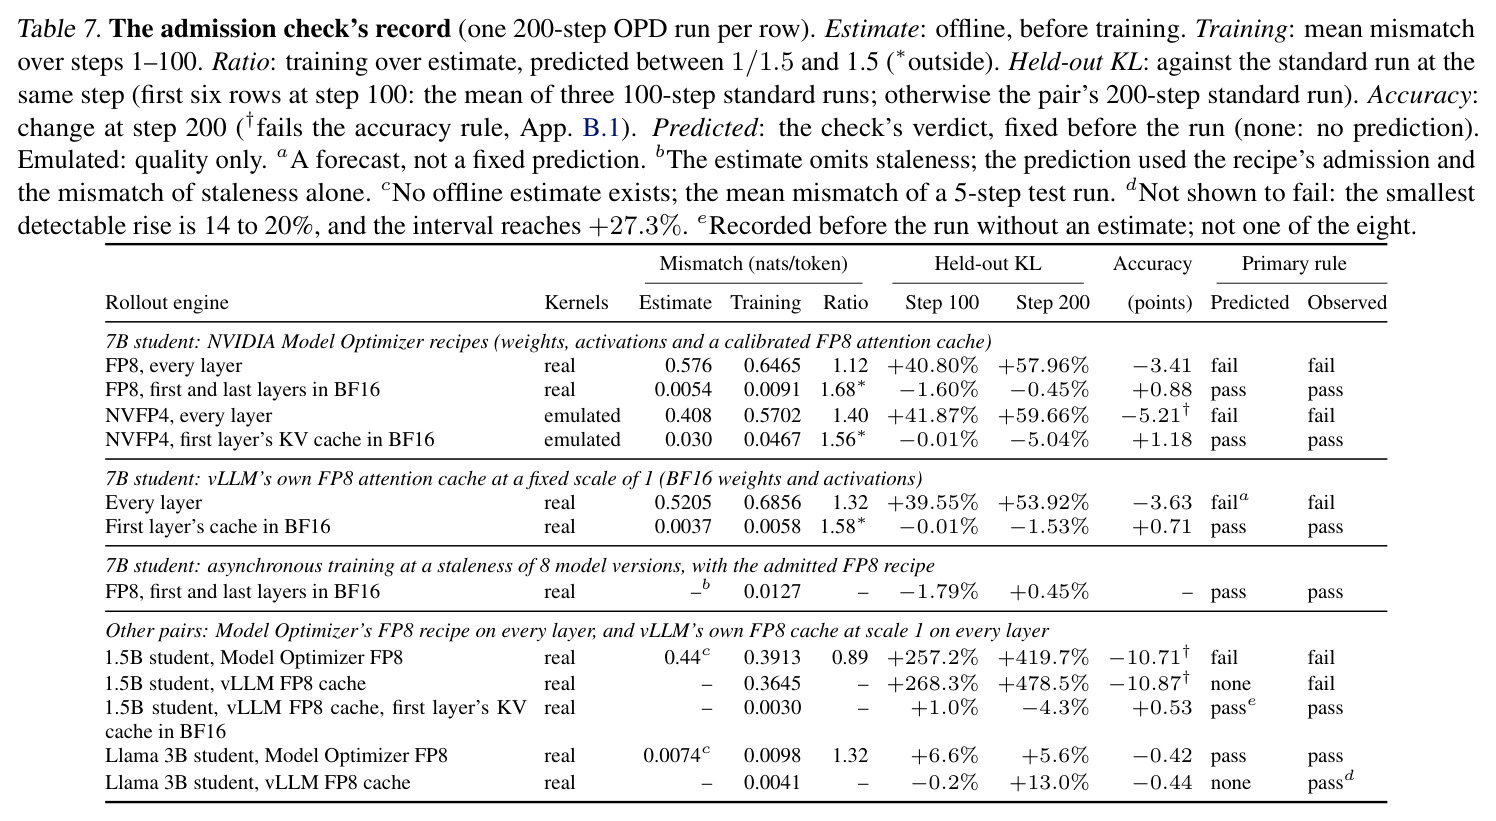
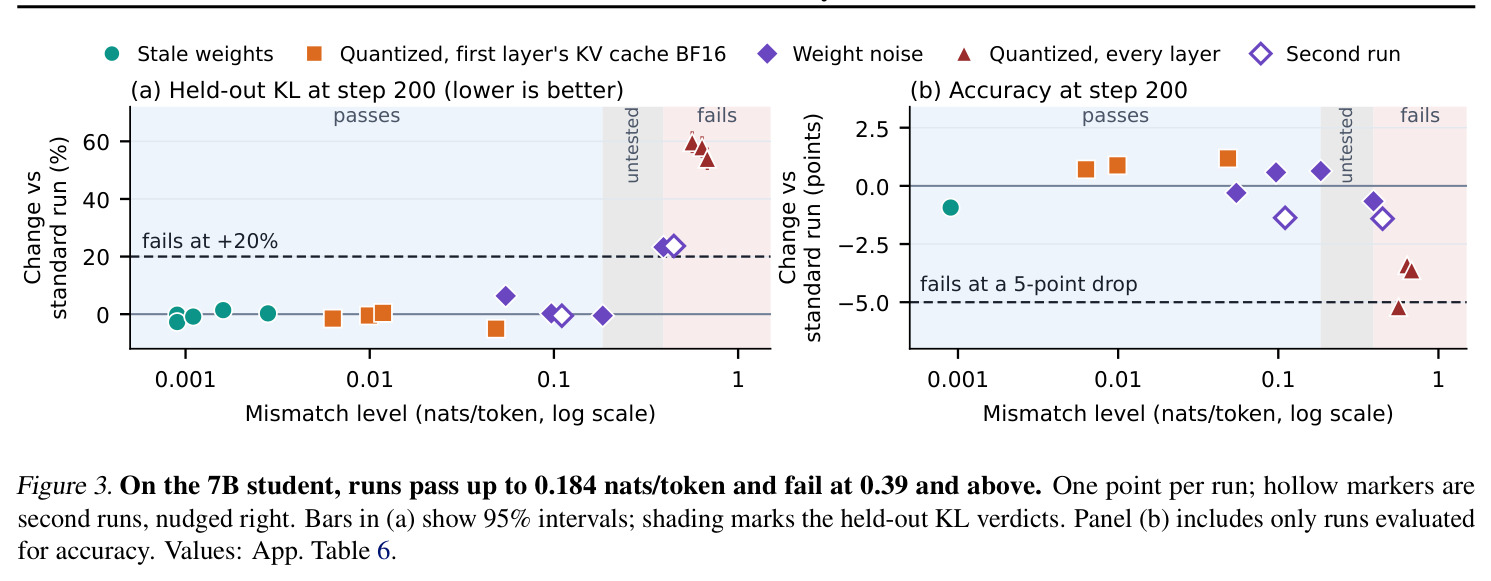
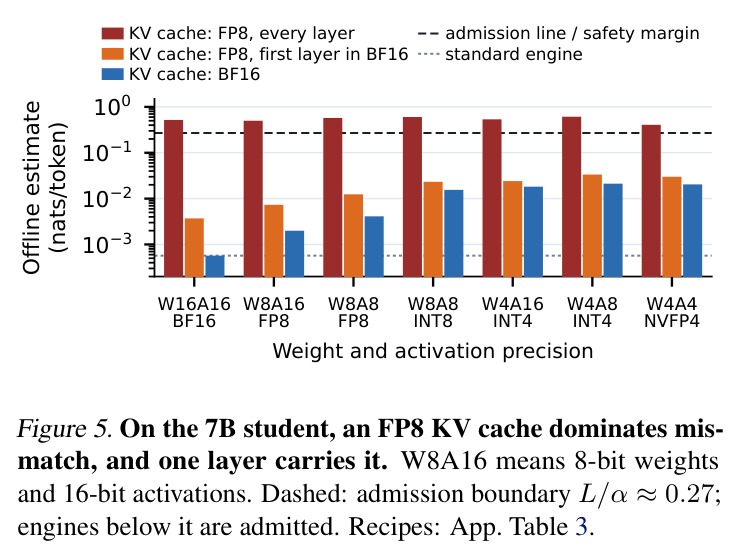
量化是失配的最大来源。本文的关键发现之一是:7B 学生上首层 KV cache 贡献了 FP8 cache 失配的 93–99%,只保一层 BF16 就能把失配估计从 0.52 降到 0.0037。
异步 rollout 与权重陈旧度(staleness)
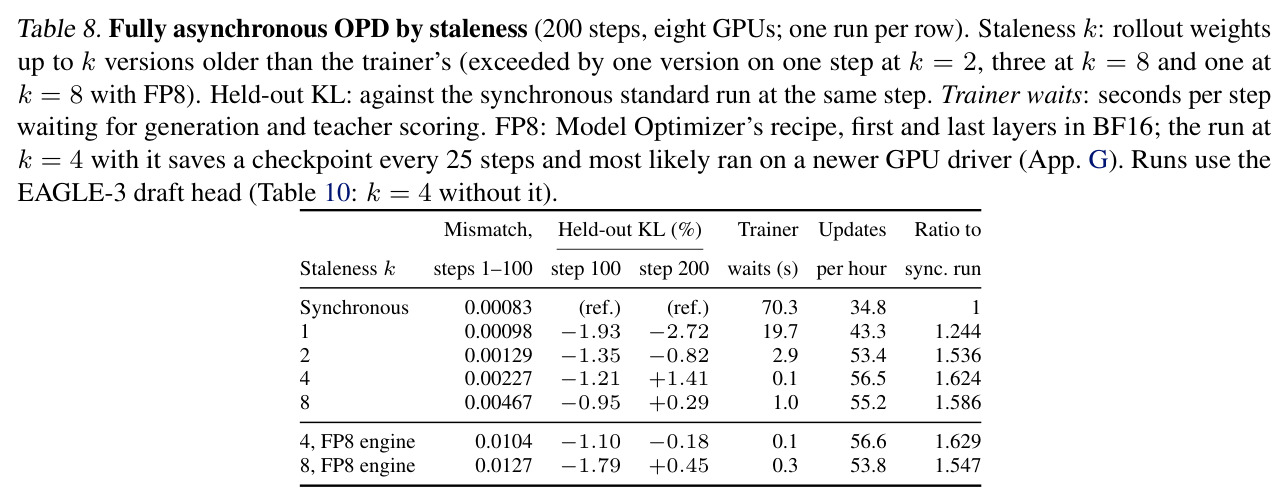
让生成与训练重叠执行:引擎不等训练器更新完就开始生成下一批响应,因此使用的是落后 $k$ 个版本的旧权重。这消除了训练器等待 rollout 的空闲时间,代价是引擎分布与当前学生进一步偏离。本文用 verl 的全异步模式测试 $k \in \{1,2,4,8\}$。
异步与量化是两大 rollout 提速手段。实验显示陈旧 8 个版本的失配仅 0.0028 nats/token、完全安全,说明“版本数”本身不能预测风险。
REINFORCE 与 GRPO
两种策略梯度 RL 方法。REINFORCE 直接用整条响应的原始奖励作为每个 token 的优势($A_t = R$);GRPO 对同一 prompt 的一组响应做组内归一化。理论上 RL 更新只在模型“完全按自身分布采样”时无偏,因此引擎分布稍有偏差就会引入系统性偏移,甚至累积到训练崩溃。
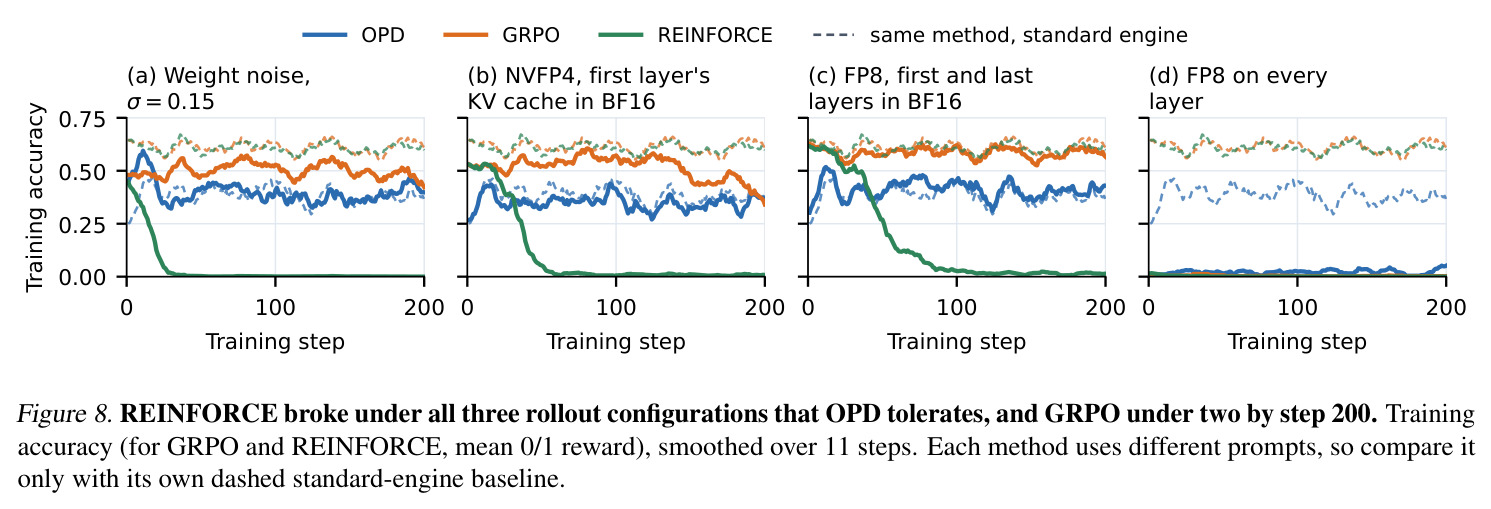
论文 §5.5 用同样安全的引擎配置对照训练 RL:REINFORCE 与 GRPO 分别在约 12 倍和 60 倍标准失配处崩溃,而 OPD 稳如泰山——这一对比是理解 OPD 特殊容忍性的关键参照系。
研究动机
OPD 的主要成本在 rollout 生成:在 7B 学生上,rollout 生成加教师打分占每个训练步时间的 76%(附录表 10)。为了让 rollout 更便宜,实际系统普遍采用两种手段:一是量化推理,把引擎权重与 KV cache 存成 FP8 甚至 4-bit,让同样显存容纳更多并发响应;二是异步 rollout,让生成跑在训练前面,引擎使用落后一两个版本的旧权重。代价是引擎与被训模型不再一致——即训练–推理失配。RL 后训练领域已经证明这种失配能彻底摧毁训练:即使标准 vLLM 引擎因 kernel 与数值差异带来的微小失配也可能让 RL 失败,因此社区发展出截断重要性采样、token 掩码、score centering 等 per-token 校正,以及要求逐位一致的精确匹配 kernel。生产级 OPD 管线(Xiaomi、Yang et al.、NVIDIA 等)也照搬了这些补救。但 OPD 的更新结构与 RL 不同,失配对它的影响从未被系统测量;而且不同失配源的计量单位互不兼容(量化按 bit 数、异步按版本数),没有共同尺度可以比较风险;逐个验证引擎是否安全又需要完整训练——一次 200 步训练在 8 张 GPU 上要 5.5 到 6 小时,逐一试错成本过高。
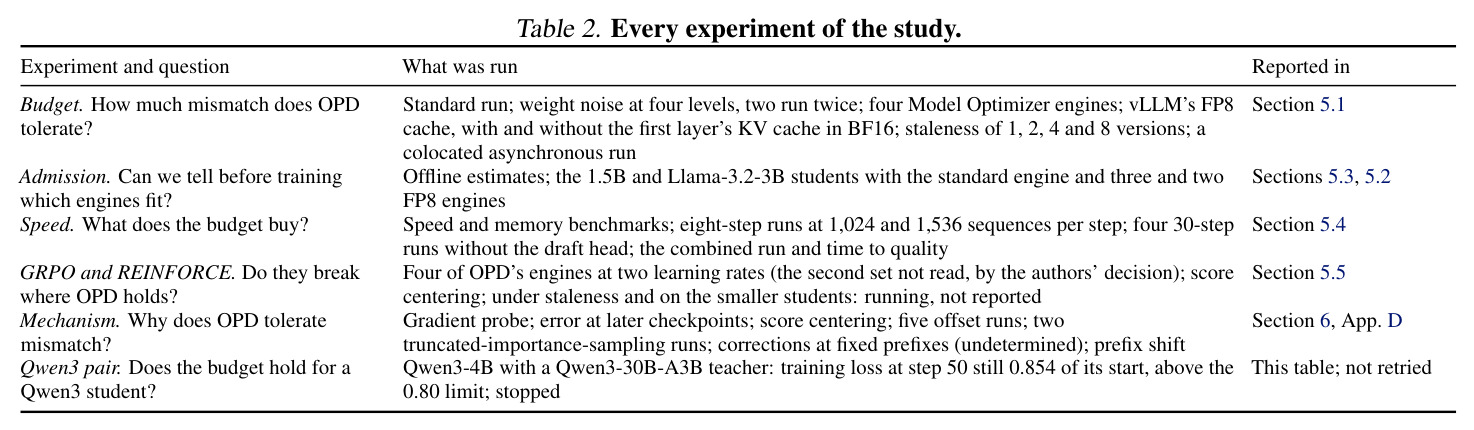
本文的目标是本文要回答三个问题:(i) 跨不同 rollout 引擎与学生模型,OPD 到底能容忍多大失配?(ii) 能否在训练前就识别出安全的 rollout 配置,并用它们降低 rollout 成本?(iii) 失配如何影响 OPD 的更新,从 RL 继承的 per-token 校正能否缓解?为此需要建立统一的失配度量(引擎访问前缀上的每 token KL,nats/token),定义并经验刻画 OPD 的“失配预算”——不显著损害训练质量所能吸收的最大失配;给出分钟级而非小时级的准入检查来筛查新配置;量化量化与异步带来的真实收益(KV cache 容量、吞吐、达到目标质量的时间);并从更新结构上解释 OPD 与 RL 容忍度的差异。
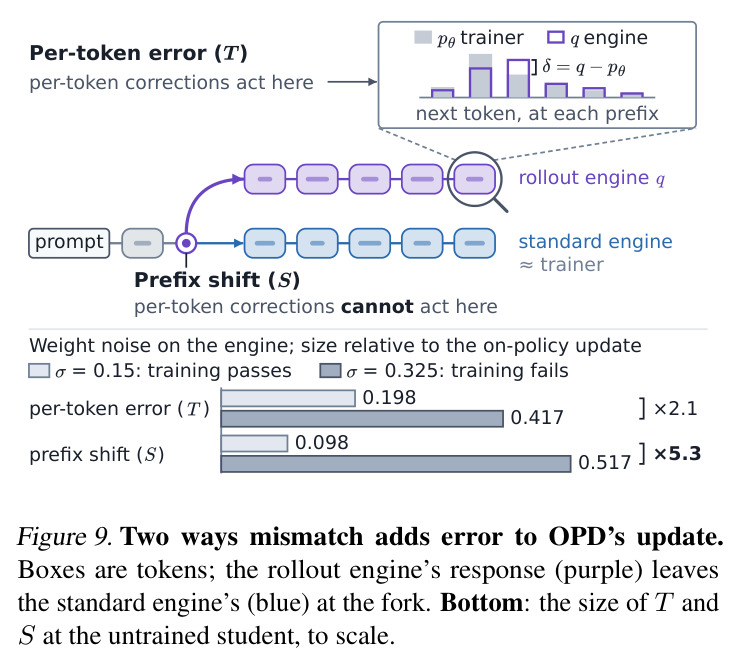
与已有工作不同的是,本文的独特切入有三点。第一,首次把异质失配源——数值差异、三种生产级量化 recipe(Model Optimizer FP8、NVFP4、vLLM FP8 KV cache)、1 到 8 个版本的权重陈旧度、受控高斯权重噪声——放在同一个 nats/token 尺度上测量比较,并证明“bit 数或版本数都不决定风险,失配总量才决定”。第二,提出预算-准入两段式工作流:用少数几次完整训练校准一个学生专属的失配预算,之后对任意新引擎只需离线估计失配加安全边界即可放行或拒绝,6 个配置的筛查在单张 GPU 上 24 分钟完成。第三,通过把 OPD 更新误差分解为 per-token 误差与前缀偏移(prefix shift),发现失配伤害的很大一部分来自“引擎走到了不同的部分响应上”,这是任何逐 token 校正原理上都无法修复的——从机制上解释了为什么照搬 RL 的补救措施对 OPD 无效。
核心方法
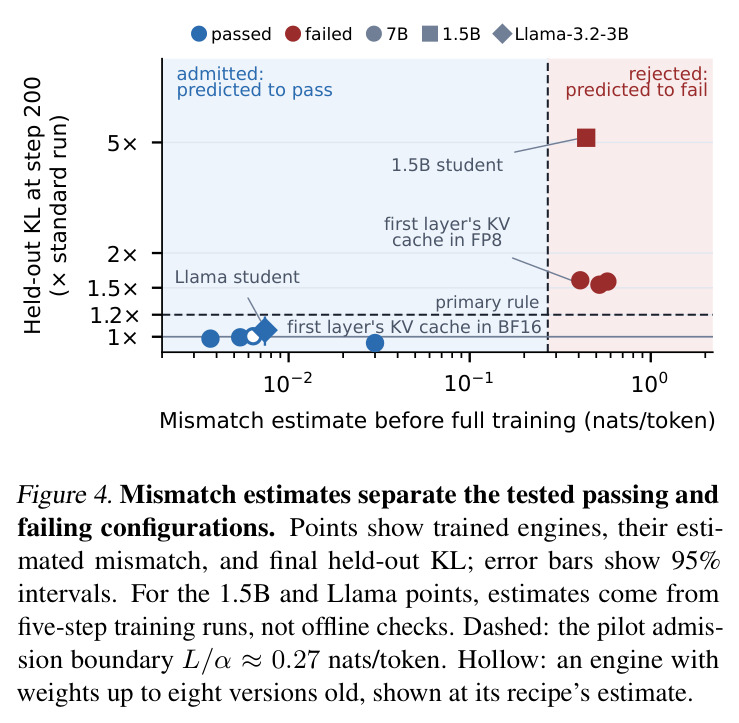
直觉是:与其强求 rollout 引擎与训练器逐位一致(需为每个模型和 GPU 类型重建 kernel,代价高昂),不如测量清楚“不一致多少是安全的”,把失配当作可以花销的预算。技术路线分三步。第一步,统一度量:训练第 $n$ 步在引擎采样的 $N_n$ 个 token 上计算 $d_n = \frac{1}{N_n}\sum_t [\log q(y_t|y_{<t}) - \log p_\theta(y_t|y_{<t})]$,即引擎分布 $q$ 与训练器分布 $p_\theta$ 在引擎实际访问前缀上的每 token KL 估计(nats/token);整个训练(默认 200 步)的平均值记为该配置的失配水平 $D(c)$。标准 BF16 vLLM 引擎自身就有 $D(0)=0.0008$。这个度量同时覆盖陈旧权重(此时 $q$ 是旧模型)。第二步,经验预算:用同一学生配不同 rollout 配置各跑 200 步,以 held-out KL 相对变化 $\Delta(c) = \frac{\sum_{x\in H} K_x(c)}{\sum_{x\in H} K_x(0)} - 1$ 配合阈值 $\tau$ 与配对 bootstrap 判定通过/失败,得到预算区间 $B_{\text{emp}}(\tau) = [\max_{c \in P_\tau} D(c),\ \min_{c \in F_\tau} D(c)]$。第三步,准入检查:候选引擎生成少量响应,用标准 BF16 引擎对同样 token 重打分得到离线估计 $\hat D(c)$,若 $\alpha \hat D(c) < L$ 则放行,全程无需教师打分或训练。
核心概念是“失配预算”(mismatch budget):OPD 能在不显著损失训练质量的前提下吸收的失配总量。与已有工作的本质区别在于视角:RL 文献把失配当作“必须消除或逐 token 修正的偏差”,走精确匹配 kernel 或重要性加权的路线;本文证明 OPD 的目标是匹配教师——学生与教师一致处每个 token 的优势为零、更新消失,且固定引擎下期望 OPD 梯度恰好等于目标 $\frac{1}{2}\,\mathbb{E}[(\log p_\theta - \log p_T)^2]$ 的梯度——引擎只决定“在哪些前缀上练习”,不改变优势的定义,因此必然存在一个可测量、可预算的安全余量。第二个关键洞察是失配的绝对量决定命运,而非配置形式:陈旧 8 个版本只有 $D=0.0028$,安全;每层 FP8 量化达 $D=0.56{-}0.68$,致命——尽管后者看起来是“标准做法”。第三个洞察是结构归因:7B 学生上首层 KV cache 贡献了 FP8 cache 失配的 93–99%(keys-only 仿真把该层效应的约 82% 归因于 key 舍入),只保留首层 BF16 就能把离线估计从 0.52 压到 0.0037,把“看似危险”的 FP8 变成“完全安全”。
方法步骤详情
完整流程如下。(1) 训练设置:每个学生从自身 RL 微调版蒸馏 200 步,每步对 8 道 DAPO-Math-17k 题各采 8 条响应,温度 1,单响应上限 16384 token,AdamW 学习率 $10^{-6}$;测试床为两节点共 8 张 GH200,一节点放教师,另一节点放训练器与 4 个 rollout 副本;rollout 用 vLLM 加 EAGLE-3 投机解码头,训练用 verl+FSDP。(2) 校准预算:对 7B 学生跑 17 个配置——3 种量化 recipe(NVIDIA Model Optimizer FP8、NVFP4 仿真、vLLM FP8 KV cache)各有“全层量化”与“首层/首尾层保留 BF16”变体,陈旧度 $k \in \{1,2,4,8\}$,高斯权重噪声 $\sigma \in \{0.0665, 0.15, 0.234, 0.325\}$,以及量化+异步组合;1.5B 与 3B 学生另加 3 和 2 个 FP8 配置。训练中按式 (2) 记录 $d_n$,在 530 道 held-out 题上评 held-out KL。(3) 判定规则(预先注册):$\Delta(c) \ge 0.20$ 且 95% 配对 bootstrap 区间不含零即失败;accuracy 规则(掉至少 5 点)仅作辅助。(4) 准入检查:候选引擎对 16 道数学题各生成 2 条响应,标准 BF16 引擎用相同学生权重重打分 $M$ 个 token,按式 (5) 得 $\hat D(c)$;安全余量 $\alpha = 1.5$ 来自 100 步 pilot(训练中失配至多为离线估计的 1.47 倍),准入线 $L = 0.41$ 来自 pilot 的通过水平,即放行条件 $\hat D(c) < L/\alpha \approx 0.27$。(5) 对照实验:REINFORCE 与 GRPO 用同样的 4 个引擎配置各训 200 步,崩溃判据(accuracy 掉 5 点、熵或长度崩溃并经 held-out 确认)也预先固定。
技术新颖性
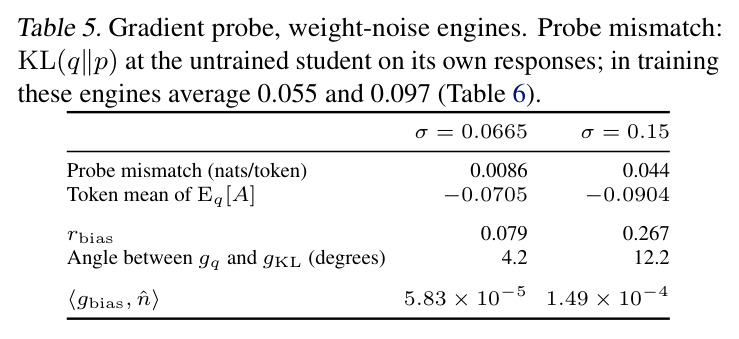
技术新颖性体现在四个层面。(1) 度量统一性:首个把异质失配源放进同一 nats/token 尺度的测量框架,并实证 bit 宽与版本数不能预测风险——NVFP4 加首层 BF16 KV cache 的 $D=0.0485$ 通过,vLLM FP8 全层量化的 $D=0.6803$ 失败,而二者的“名义精度”只差 4 bit。(2) 工程-科学闭环:不止报告“FP8 没问题”,而是给出可操作的准入协议并验证其全部 8 个预先固定的决策与真实训练结果一致,5 个来自纯离线检查。(3) 机制层面的新发现:对 logits 的梯度偏差项 $g_z^{\text{bias}} = \delta \odot A - p_\theta(\delta^\top A)$(其中 $\delta = q - p_\theta$ 是引擎偏差,$A = \log p_T - \log p_\theta$ 是师生对数比)随学生逼近教师而消失(上界 $2\|\delta\|_1 \|A\|_\infty$),而 REINFORCE 中用常数奖励 $R$ 替代 $A$ 得到的误差 $R\delta$ 不消失——这从数学上解释了 OPD 与 RL 的容忍度鸿沟;进一步把更新误差分解为 per-token 误差 $T$ 与前缀偏移 $S$,发现从 $\sigma=0.15$ 到 $\sigma=0.325$,$S$ 增长 5.3 倍(0.098→0.517)远超 $T$ 的 2.1 倍(0.198→0.417)。(4) 有价值的负结果:score centering 与截断重要性采样在 OPD 上不仅无效还略有害,纠正了从 RL 管线照搬惯例的行业做法。
实验结果
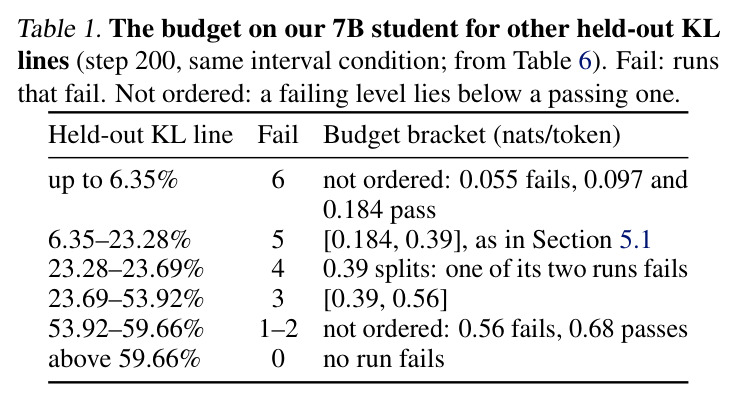
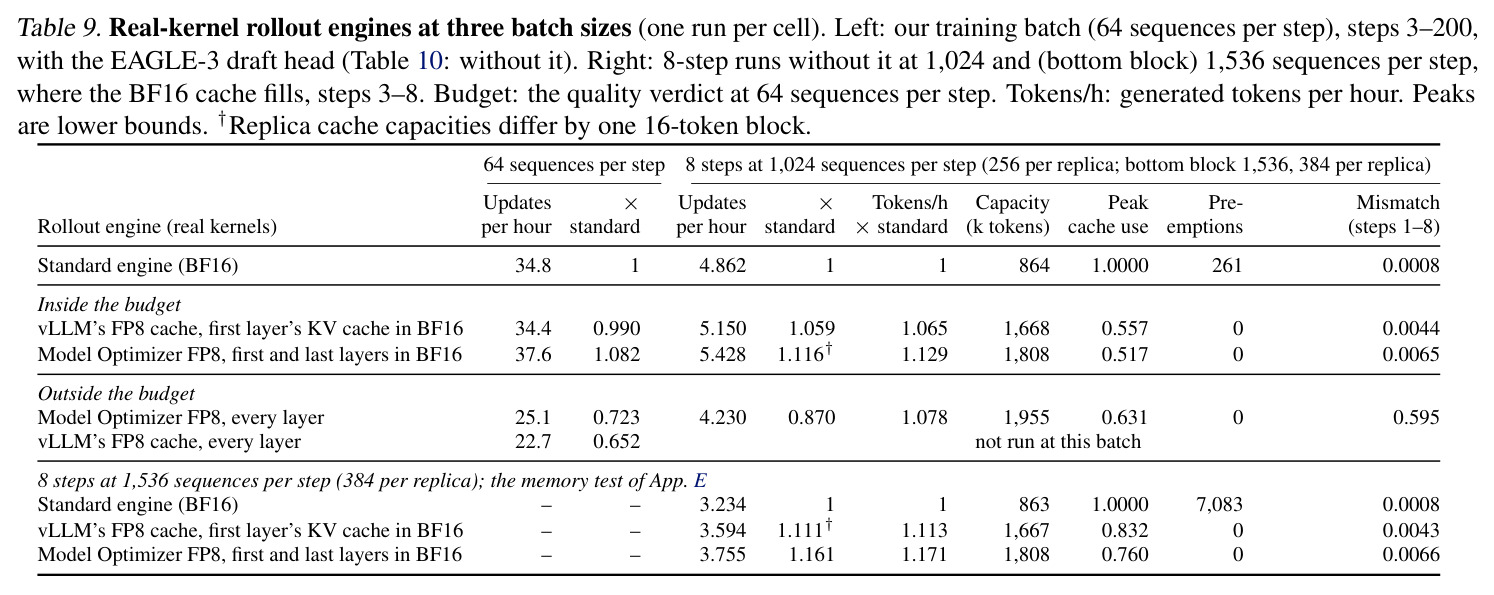
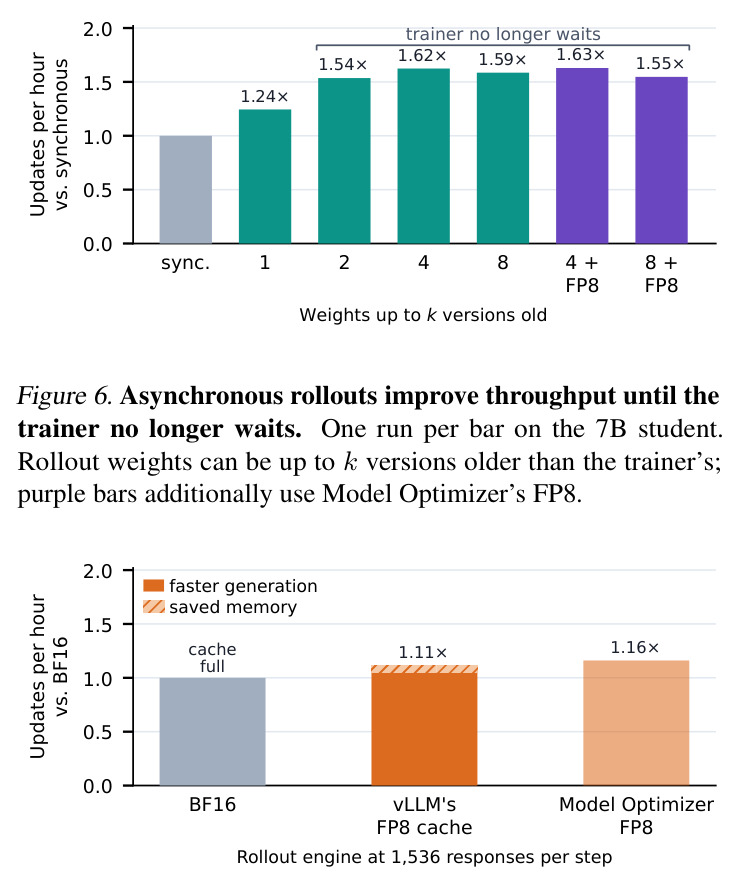
(1) 7B 失配预算:12 个 $D \le 0.184$ nats/token 的配置——超过标准引擎失配 0.0008 的 200 倍——全部通过,$\Delta$ 落在 $[-5.0\%, +6.4\%]$,其中失配最高的两个通过配置最终 held-out KL 与标准跑相差不足 0.5%;两个 $\sigma=0.325$ 的噪声跑 $D \approx 0.39$ 失败,$\Delta \approx +23\%$;三个全层量化配置 $D = 0.56{-}0.68$ 失败,$\Delta = +54{-}60\%$、accuracy 掉 3–5 点,全层 FP8 下 rollout 答案几乎从第一步就从不正确(图 1)。经验预算区间为 $B_{\text{emp}}(0.20) = [0.184, 0.39]$ nats/token。(2) RL 对照:同样引擎下 REINFORCE 在约 12 倍、GRPO 在约 60 倍标准失配处崩溃;三个 OPD 通过配置中 REINFORCE 的 6 次运行全部崩溃(噪声掉 21 点、NVFP4 掉 59 点、FP8 掉 63 点),GRPO 崩 2 次;score centering 能救 RL(REINFORCE held-out accuracy 在 step 100 提升 61 点、GRPO 在 step 200 提升 16.5 点)。(3) 模型依赖性:Llama-3.2-3B 全层 FP8 只有 $D \approx 0.01$ 且通过($\Delta = +5.6\%$);1.5B 学生全层 FP8 的 $D = 0.36{-}0.39$ 导致 $\Delta = +420$ 到 $+479\%$、accuracy 掉约 11 点——7B 预算绝不可跨模型迁移。(4) 效率收益:FP8 KV cache(首层 BF16)容量至少是 BF16 的 1.93 倍;Model Optimizer FP8 加 $k=8$ 异步比同步 BF16 提前 1.62 倍达到相同 held-out KL(最终 accuracy 60.5% 对 61.5%),在“90% KL 改进”目标下 $k=4$ 提前 1.69 倍;纯异步吞吐在 $k=4/8$ 平台期为 1.62 倍/1.59 倍,组合 FP8 为 1.63 倍/1.55 倍;内存受限的 1536 响应/步批量下 BF16 cache 溢出驱逐重算,FP8 获 1.11 倍/1.16 倍吞吐。(5) 准入检查:8 个预先固定的决策全部与实际结果一致(5 个来自离线检查),6 个配置 24 分钟单卡完成,对比一次全训练 5.5–6 小时 8 卡;但训练中失配可达离线估计的 1.56–1.68 倍、超过 pilot 余量 1.5,且 pilot 门 $L=0.41$ 偏松——0.39 噪声在其下方却失败,回溯性收紧到 $L=0.184$ 更稳。(6) 机制分析:固定前缀上更新误差在 step 200 缩到未训练时的 0.11–0.13 倍,但更新本身缩得更快,误差/更新比从 0.93 升至 1.88,说明失配的影响在训练后期反而更大;前缀偏移 $S$ 的增速(5.3 倍)远超 per-token 误差 $T$(2.1 倍),而 per-token 校正只能作用于 $T$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 7B 学生 OPD 失配预算(量化/噪声/异步共 16 配置 18 跑) | held-out KL 相对变化 $\Delta$(阈值 $\tau=0.20$,配对 bootstrap) | $D \le 0.184$ nats/token 全部通过($\Delta \in [-5.0\%, +6.4\%]$),$D \ge 0.39$ 失败($\Delta \approx +23\%$) | 标准 BF16 引擎自身失配 $D(0) = 0.0008$ nats/token | OPD 可容忍超过 200 倍标准引擎的失配而不掉质量 |
| 达到同步训练同等 held-out KL 的墙钟时间(Model Optimizer FP8 + $k=8$ 异步) | wall-clock 加速比(含生成、教师打分与存档) | 提前 1.62 倍达标,最终 accuracy 60.5% vs 61.5%;90% KL 目标下 $k=4$ 提前 1.69 倍 | 同步 BF16 训练 | 1.62–1.69 倍提速 |
| FP8 KV cache 显存容量(首层保留 BF16,7B 学生) | 可容纳 KV-cache token 数 | $\ge 1.93 \times$ BF16,真实 kernel 失配仅 0.0043 nats/token | BF16 KV cache | 容量提升 93% |
| 同等失配下 RL 与 OPD 的稳定性对比(7B,REINFORCE/GRPO) | 崩溃时的失配倍数(相对标准引擎失配 0.0008) | OPD 稳定至 >200 倍;在 OPD 通过的 3 个配置上 6 次 RL 运行 5 次崩溃(accuracy 掉 15–63 点) | REINFORCE 约 12 倍处崩溃、GRPO 约 60 倍处崩溃 | OPD 容忍度约为 REINFORCE 的 17 倍、GRPO 的 3 倍以上 |
| 新 rollout 配置的准入筛查 | 筛查耗时与硬件 | 6 个配置 24 分钟 / 1 GPU;8 个预先决策全部命中真实结果 | 逐候选完整训练:5.5–6 小时 / 8 GPU | 时间与硬件节省约 2–3 个数量级 |
| 内存受限 rollout 批量(1536 响应/步,24 倍于训练批量) | 每小时优化器更新数(相对同步 BF16) | vLLM FP8 cache 1.11 倍、Model Optimizer FP8 1.16 倍 | BF16 cache 溢出,必须驱逐并重算运行中的响应 | 1.11–1.16 倍 |
局限与改进
作者承认的局限:失配预算是经验区间而非精确阈值,其数值依赖学生模型、训练设置与质量阈值 $\tau$(如 $\tau=0.25$ 时区间变为 $[0.39, 0.56]$);NVFP4 用 BF16 仿真,只测质量不测速度;准入检查是筛选而非保证,训练中失配可升至离线估计的 1.56–1.68 倍、突破 pilot 余量 $\alpha=1.5$,且 pilot 门 $L=0.41$ 被证明过松;每个新学生都需要重新校准预算。我自己的观察:(1) 任务覆盖窄——只测数学推理、200 步训练,代码生成或智能体任务响应更长、前缀分叉更多,前缀偏移误差可能占比更高,结论未必外推;(2) 样本量小——多数配置只跑一次(仅 4 个配置跑两次),run-to-run 波动最高 1.5%,处于通过边缘的结论(如 NVFP4 的 $-5.04\%$)相对脆弱;(3) 噪声模型与真实量化误差结构不同——固定方向高斯扰动是理想化探针,噪声-预算映射未必代表真实 FP8 recipe 的行为;(4) prefix shift 只有分解与测量,没有修复手段——作者估算重加权整条响应以触及 $S$ 在最小噪声下也需要约 $10^{27}$ 条响应/有效样本,实际对策仍然空缺;(5) 首层敏感性的机理解释(key projection bias、无 QK-norm)仅基于两个模型族三个学生,泛化到其他架构(如 MoE、GQA 变体)尚未验证。
独立分析的弱点
(1) 校准成本高:每个新学生都要用多次 200 步完整训练定位预算,每次 5.5–6 小时 8 卡,对小团队不现实。改进方向:研究预算与可离线测量的架构特征(QK-norm 有无、key projection bias、层数与宽度、首层 key 范数)之间的预测关系,做缩放律式的预算外推,把校准降到一次甚至零次训练。(2) 失配度量依赖引擎访问的前缀分布,训练中会漂移( admitted 引擎实测达估计的 1.56–1.68 倍),静态准入线不安全。改进方向:把 $d_n$ 监控做成自动节流器,超线时自动把引擎切回 BF16 或强制权重同步。(3) 修复手段缺位:既然 per-token 校正无效且整条响应重加权需 $10^{27}$ 样本,应设计前缀级干预——例如在引擎采样轨迹的高熵分叉点回退标准引擎重采,或对前缀做分组重要性修正。(4) 任务域窄:数学题响应结构单一。改进方向:在长程代码/智能体任务上复测,前缀偏移占比可能反转“FP8 安全”的结论。(5) NVFP4 仅仿真:真实 Blackwell kernel 的数值行为与速度不同,预算结论需硬件实测确认。
未来方向
作者提出的方向:采用更保守的准入线(回溯性 $L=0.184$)并配合训练中失配监控;进一步刻画前缀偏移误差的理论性质。基于本文成果可延伸的研究:(1) 预算预测模型——利用本文的梯度探针与单张量量化误差测量(表 4/5)训练一个从架构到预算的预测器,免除逐模型训练校准;(2) 把“预算内吞吐最大化”形式化为自动混合精度 recipe 搜索问题,联合选择每层权重/激活/KV cache 精度;(3) 检验 RL 的其他失配对策(本文只测了 score centering 一种)以及预算框架能否为 RL 定出类似的容忍区间;(4) 训练端量化:本文训练器保持 BF16、只量化引擎,训练器与引擎同时低精度化的一致性预算是开放问题;(5) MoE 与超长上下文下 KV cache 量化预算的变化——前缀更长意味着 prefix shift 权重更大;(6) 与 exact-matching(逐位一致)kernel 的系统成本-收益对比,找出“预算管理 vs 精确匹配”的决策边界;(7) 把准入检查扩展到在线场景:训练中持续重估 $\hat D$ 并动态调整异步深度。
复现评估
开源情况良好:代码在 github.com/benyucong/train-inference-mismatch-opd,包含引擎及其仿真、训练 launcher、离线失配估计、梯度探针、速度基准、held-out 评测与全部数据准备脚本;判定规则在附录 B 中以带日期的只增计划预注册,可信度高。数据与模型全部公开:学生为 DeepSeek-R1-Distill-Qwen-1.5B/7B 与 Llama-3.2-3B-Instruct,教师为 Skywork-OR1-Math-7B、JustRL-DeepSeek-1.5B、GT-Llama-3.2-3B-Instruct-MATH,训练集 DAPO-Math-17k,评测集 AIME24/25、MATH-500、AMC23。算力门槛较高:需两节点共 8 张 GH200(软件栈 verl+FSDP、vLLM 0.19.1、PyTorch 2.10、CUDA 13.2),一次 200 步 OPD 跑 5.5–6 小时,完整 7B 矩阵 17 个配置约需上百 GPU·小时;RL 对照各占一节点。已知细节坑:EAGLE-3 投机解码头的公开配置缺 max position embeddings 字段,需手动设为 131072;NVFP4 为仿真实现;部分表格数字为手工抄录,少数分析脚本注明“评审后发布”。总体复现难度中等偏高:核心科学结论(预算区间)只需 1–2 次 200 步训练即可验证,但完整矩阵复刻需要 GH200 级算力与分布式框架运维经验。
论文图表
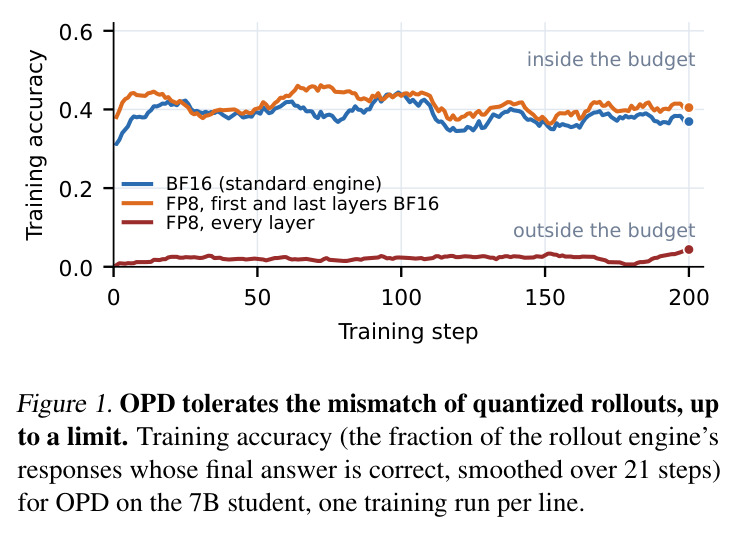
7B 学生上的训练 accuracy 曲线(rollout 引擎给出正确最终答案的比例,21 步平滑),每个训练 run 一条线:BF16 标准引擎、首尾层保留 BF16 的 FP8、每层全 FP8。预算内的 FP8 曲线与标准引擎逐格重合,预算外的全层 FP8 几乎从不答对、训练失败。
用一张图直观呈现全文核心现象——“预算内无损、预算外崩溃”,是理解失配预算概念的最佳入口。
示意图: rollout 引擎的响应(紫)在某个分叉点离开标准引擎的轨迹(蓝),把更新误差分解为两部分——$T$(per-token 误差,引擎在访问前缀上给出不同的下一 token 分布,per-token 校正可作用)与 $S$(prefix shift,引擎走到了完全不同的前缀,per-token 校正无法触及)。下方数字:从 $\sigma=0.15$(通过)到 $\sigma=0.325$(失败),$T$ 从 0.198 增至 0.417(2.1 倍),$S$ 从 0.098 增至 0.517(5.3 倍)。
解释了为什么 RL 的 per-token 校正救不了 OPD:失配加深时误差增长主要来自校正机制原理上够不到的前缀偏移,是 §6 机制分析的核心图。