面向泛化任务与运动规划问题的编码智能体 Coding Agents for Generalized Task and Motion Planning Problems
编码智能体自动合成泛化TAMP程序,全面超越手工规划器
前置知识
任务与运动规划(TAMP)
机器人完成抓取、搬运等任务时需同时做两类决策:离散层面选哪个操作(抓哪个物体、挪开哪个障碍),连续层面算出无碰撞且满足运动学约束的轨迹。TAMP把两者耦合求解:符号规划器搜索操作序列,再调用采样器与运动规划器验证几何可行性,任一步失败即回溯。即使状态完全可观测、以对象为中心描述,该问题在计算上仍然困难。
本文的研究对象就是TAMP,理解离散决策与几何/运动学/动力学约束的紧耦合为何导致长时域、稀疏奖励、极小的可行动作区域,才能明白手工工程为什么昂贵、泛化为什么困难。
泛化TAMP(Generalized TAMP)
同一环境会生成大量参数各异的实例(对象数量、布局、几何不同)。泛化TAMP利用实例间的规律,学习一次即可复用于新实例:例如可复用的采样器、可行性预测器、搜索启发式或状态-动作抽象,把计算成本从"每个实例重新规划"降到"每个实例快速决策"。
本文的核心问题是:编码智能体能否替代以往需要TAMP专家手工完成的"发现规律并工程化"的过程,这正是标题中generalized一词的含义,也是评估中对象数量递增设定的由来。
编码智能体
以前沿LLM为内核、配备执行环境的系统:能读写文件、执行命令、运行自己写的代码并根据输出迭代修改,Claude Code与Codex是代表。与单次问答的LLM不同,智能体能在固定预算内自主决定做什么实验、写什么测试、如何修改程序,形成探索-反馈-修正的闭环。
论文的主角是未经任何TAMP定制的现成智能体(Claude Code跑Opus 5、Codex跑GPT-5.6 Sol与GPT-6 Astra),理解它与静态LLM调用的区别是读懂Q3"agentic优势"分析的前提。
MDP与模拟器访问
环境建模为有限时域马尔可夫决策过程 $M = \langle S, A, P, R, \rho, H \rangle$:状态全可观且以对象为中心,奖励稀疏(仅指示目标达成),初始分布 $\rho$ 生成对象数量与布局各异的实例。综合阶段智能体只能通过 reset()(采样 $s_0 \sim \rho$)和 step()(执行 $a_t$ 得到 $s_{t+1}$)接口访问模拟器,服务端实现在容器外不可见。
论文的"生成性访问"设定(可任意设状态、跑自定义测试)以及"程序实现策略 $\pi$"的接口约定,全部建立在这个形式化之上。
程序化策略与测试时冻结
智能体最终交付一个Python类,含 reset()(回合初始化)与 get_action()(根据交互历史 $h_t$ 计算 $a_t = \pi(h_t)$)两个方法。程序一旦冻结,评估时不再调用任何LLM,在100个综合阶段未见过的实例上运行,每实例限时 $\tau = 60$ 秒。
"学习时可用LLM、测试时纯程序"是实验设计的支柱:它既解释了毫秒级决策的效率数据,也是论证智能体在做物理推理而非记忆的关键设计。
KinDER与PDDLStream基准
KinDER是为物理推理设计的TAMP基准,含25个环境,分Kinematic2D、Dynamic2D、Kinematic3D、Dynamic3D四族(动态族涉及接触、速度与摩擦,需要清扫、倾倒、投掷等行为),其中19个环境有不同对象数量的变体。PDDLStream把符号规划与连续采样结合,提供Packing、Blocked、Rovers三个LLM已被证明表现不佳的经典域。
28个环境的构成、哪些环境有官方规划器(16个)、对象数量增长实验,都来自这两个基准,是解读三张结果表的基础。
研究动机
任务与运动规划(TAMP)即使在完全可观测、以对象为中心的状态下依然困难:离散决策(操作哪个对象、用哪个工具、追求哪个子目标)与连续的几何、运动学、动力学约束紧耦合,碰撞约束随对象数量增长,可行动作可能只占动作空间的极小区域,且时域长、奖励稀疏。泛化TAMP试图利用实例间规律降低新实例的规划开销——学习可复用的采样器、可行性预测器、搜索启发式或抽象——但现有方法都需要大量TAMP专属工程:基准提供的规划器依赖专家手写的谓词、操作符、采样器和技能。与此同时,让LLM直接在TAMP系统内做几何与物理决策已被证明效果差:Mendez-Mendez在PDDLStream上的系统性研究和KinDER基准原文都显示,即便把相关几何信息放进提示,LLM仍然表现糟糕。这就留下一个悬而未决的问题:编码智能体在SWE-bench等软件工程基准上进步飞快,这种能力究竟能否迁移到TAMP所要求的物理推理上?正反两种答案对领域都有重大意义——成功意味着大幅削减TAMP的领域工程,失败则暴露当前智能体的具体局限。
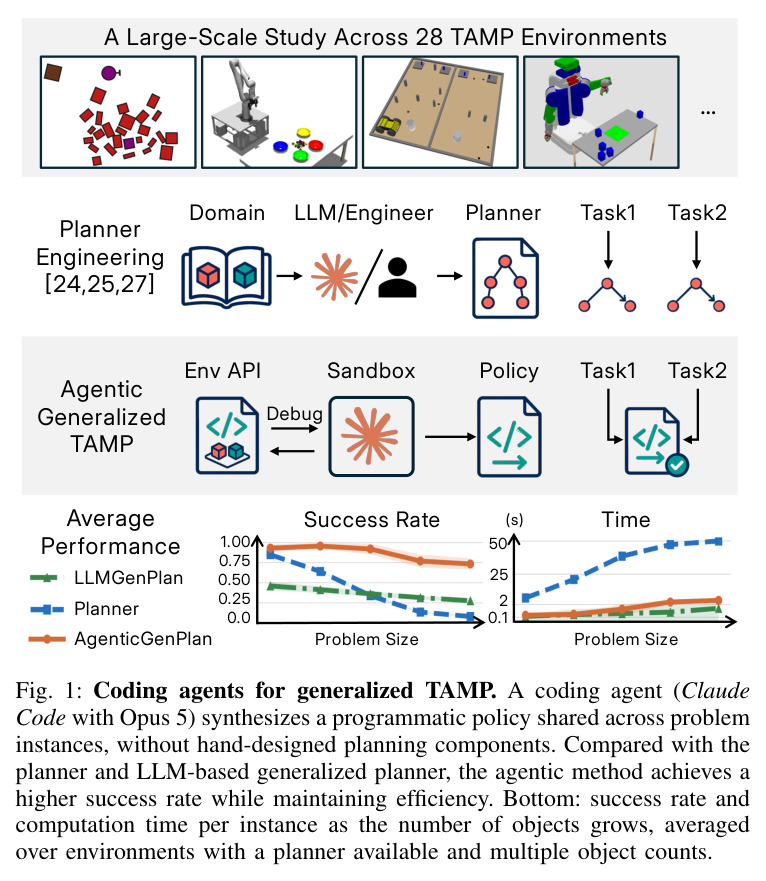
本文的目标是本文要对"现成编码智能体能否胜任泛化TAMP"做一次大规模、系统性的实证研究(称为AgenticGenPlan)。实验规模为:28个模拟环境(KinDER的25个环境覆盖运动学/动力学与2D/3D的四个组合族,外加Packing、Blocked、Rovers三个PDDLStream域)、7种程序综合方法、每种方法每个环境5次独立运行、每个所得程序在100个保留实例上评估,共980个程序、98,000个评估回合。主设定刻意保持"裸沙箱":智能体只拿到任务描述和模拟器访问权限,没有任何手写的TAMP谓词、操作符、采样器或技能,每环境每方法每次运行预算20美元;程序冻结后在未见实例上评估,测试时完全不调用LLM。论文围绕五个问题组织:Q1智能体能否写出泛化程序、Q2发现了什么策略、Q3"agentic"交互带来什么优势、Q4合成程序的效率如何、Q5提供环境源码是否有帮助。
与已有工作不同的是,此前的证据方向矛盾:一方面编码智能体在软件工程任务上快速进步(SWE-bench、SWE-agent),另一方面LLM被嵌入TAMP框架做几何决策时表现糟糕。本文的独特切入在于不把LLM当作TAMP系统中某个可替换的部件(任务规划器、连续采样器或约束生成器),而是给智能体一个只有Python解释器的沙箱加reset/step模拟器接口,把"发现环境规律并工程化成程序"的整个过程交给它自主完成。与最接近的先行工作相比:Mendez-Mendez的系统性研究在求解问题时查询LLM,本文是综合时交互、测试时零LLM;LLMGenPlan虽使用执行反馈,但LLM不能运行代码、只能收到预定义反馈;RHO、ASPIRE、MEMENTO等agentic策略综合工作使用Robosuite、LIBERO等通用操控基准,而非TAMP特有的物理推理挑战。98,000回合的评估规模与无源码主设定均属首次。
核心方法
方法的整体直觉是:与其让TAMP专家手工设计领域抽象,不如让编码智能体像工程师一样在模拟器里"做实验",再把学到的规律固化成可复用的程序化策略。技术路线上,每个环境配置一个沙箱Docker容器(独立文件系统、无网络,经红队测试验证隔离),智能体收到任务描述 $d$(环境名、观测与动作空间、目标,以及"对象数量可变、解法必须支持任意合法数量"的说明和评估时限 $\tau = 60$ 秒),加一个模拟器客户端类——实现 reset()(采样 $s_0 \sim \rho$)、step()(状态转移)和把状态渲染成图像等辅助函数,服务端实现在容器外不可见。主设定下沙箱里只有带NumPy/SciPy的Python解释器;"+source"设定额外放入环境源码,智能体可直接读目标判定、调用逆运动学求解器。智能体在20美元预算内自主决定跑什么实验、写什么测试、如何迭代,最终交付实现 $\pi$ 的Python类(reset与get_action方法),冻结后评估。基线包括提供手工谓词/操作符/采样器/技能的官方TAMP规划器(16个环境)、LLMGenPlan(统一用Opus 5、无工具、只见预定义反馈)和取其首个程序的One-shot。
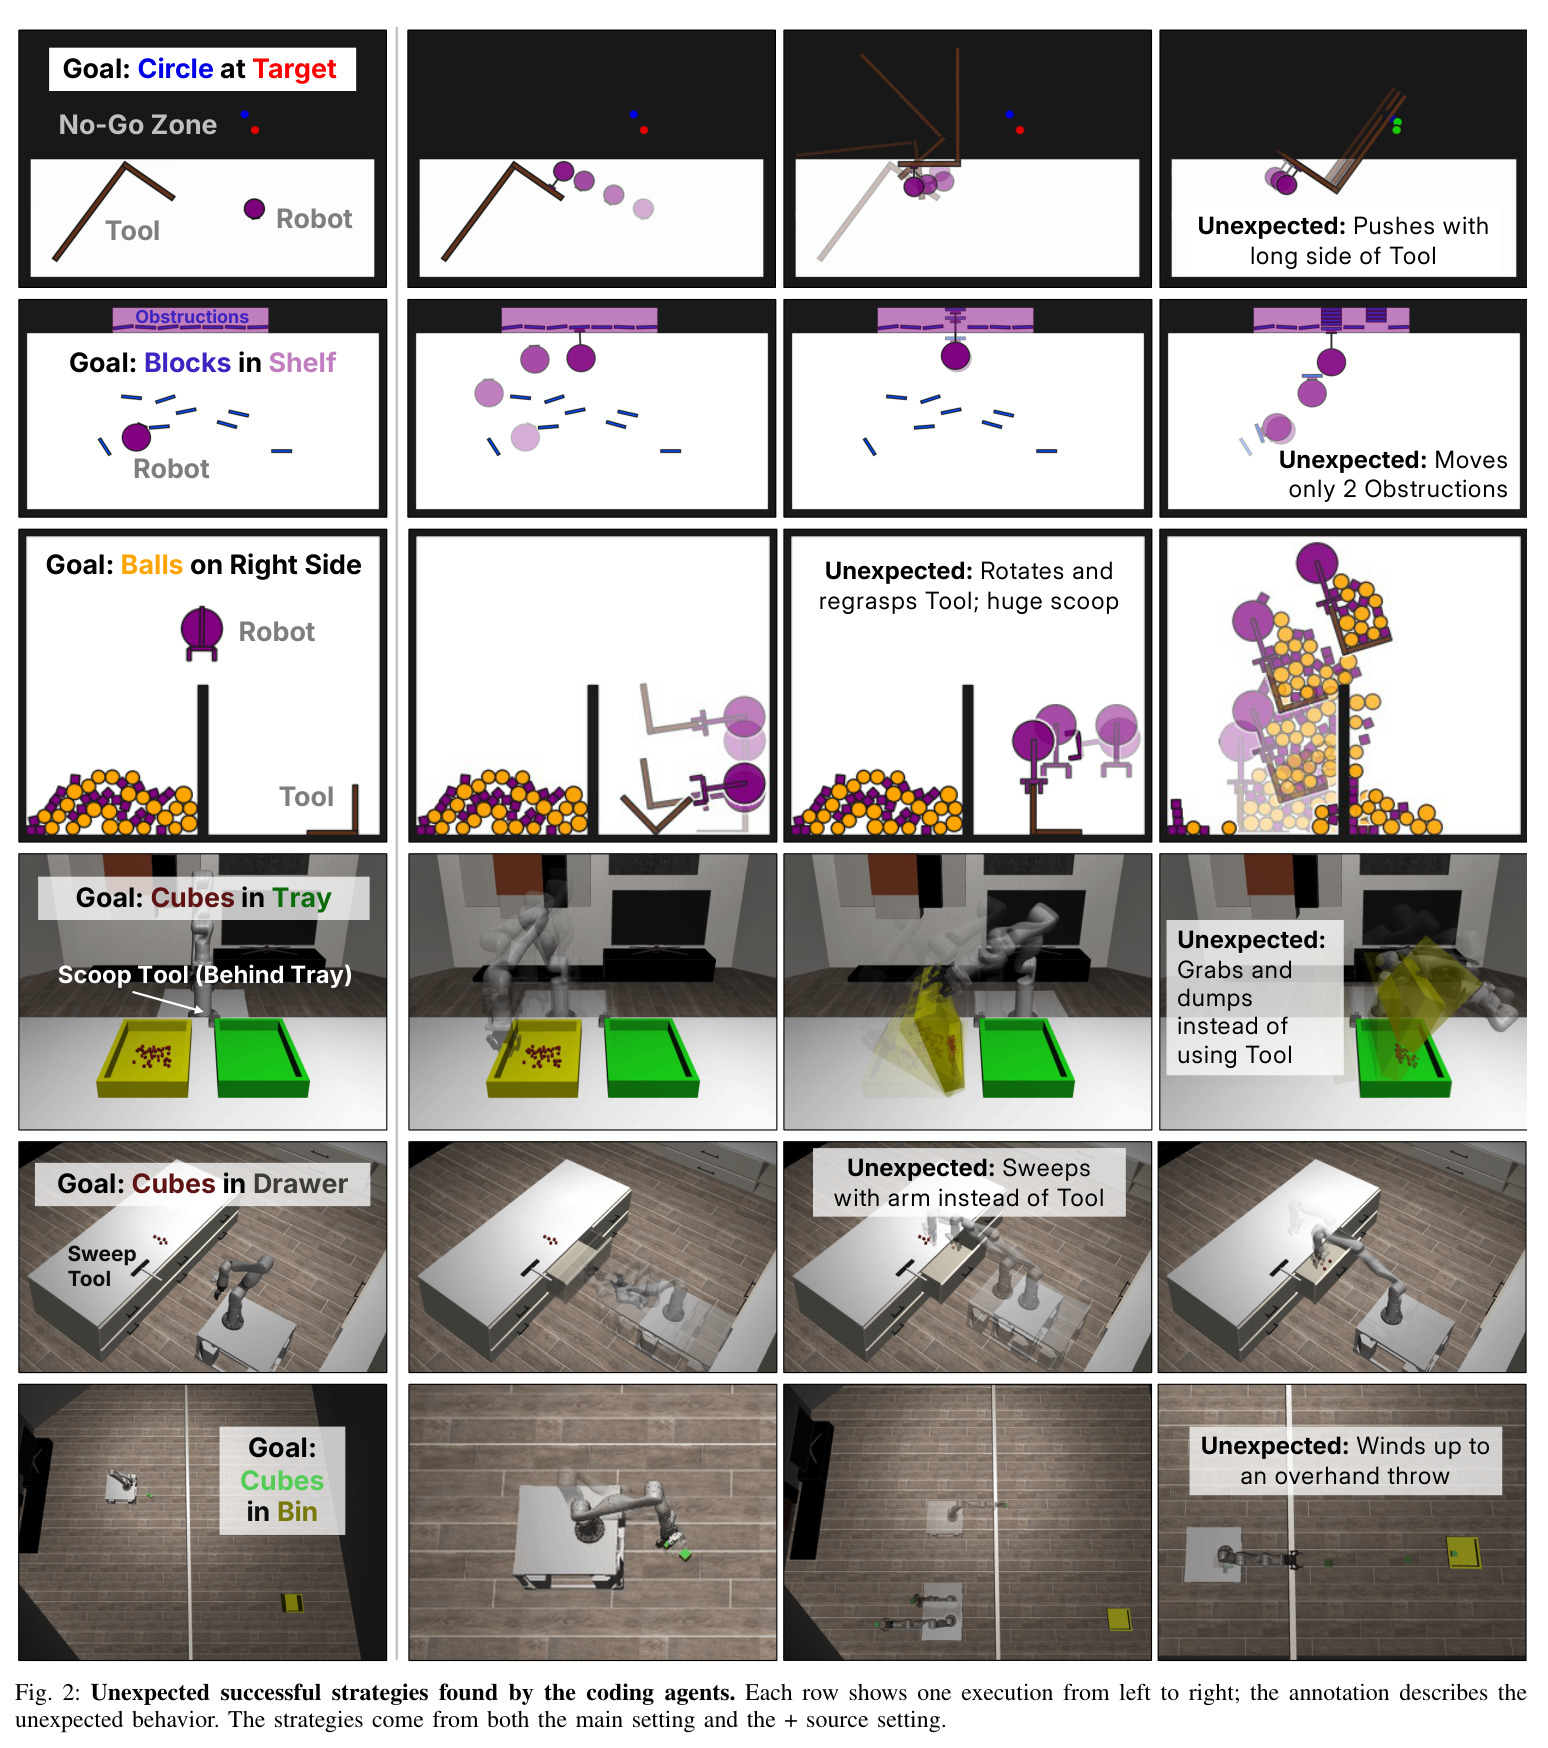
核心创新是把泛化TAMP所需的领域工程整体交给现成编码智能体的交互式综合,而不是发明新的规划算法或提示模板。与已有方法的本质区别有三点。第一,学习与测试彻底解耦:智能体在20美元预算内用模拟器交互校准物理模型、测试边界情况、迭代修订程序,产出单一Python程序后冻结,测试时零LLM调用,因此每个动作决策只需毫秒级计算。第二,对模拟器的"生成性访问":不同于LLMGenPlan只能收到预定义反馈(异常栈、无效动作、未解实例及种子),智能体可以写任意自定义测试、重置到特定状态、检查状态内部信息,自主选择实验方向。第三,完全不约束解法的内部结构:程序可以是搜索、优化、采样或任务专用过程的任意组合,甚至允许发现论文作者都未预料的非常规操作策略(如放弃工具改用手爪清扫),评估目标只有一条——在时限内解出尽可能多的未见实例。这使本文成为对"通用编码能力是否等价于物理工程能力"这一命题的受控检验,而非又一个LLM+TAMP系统。
方法步骤详情
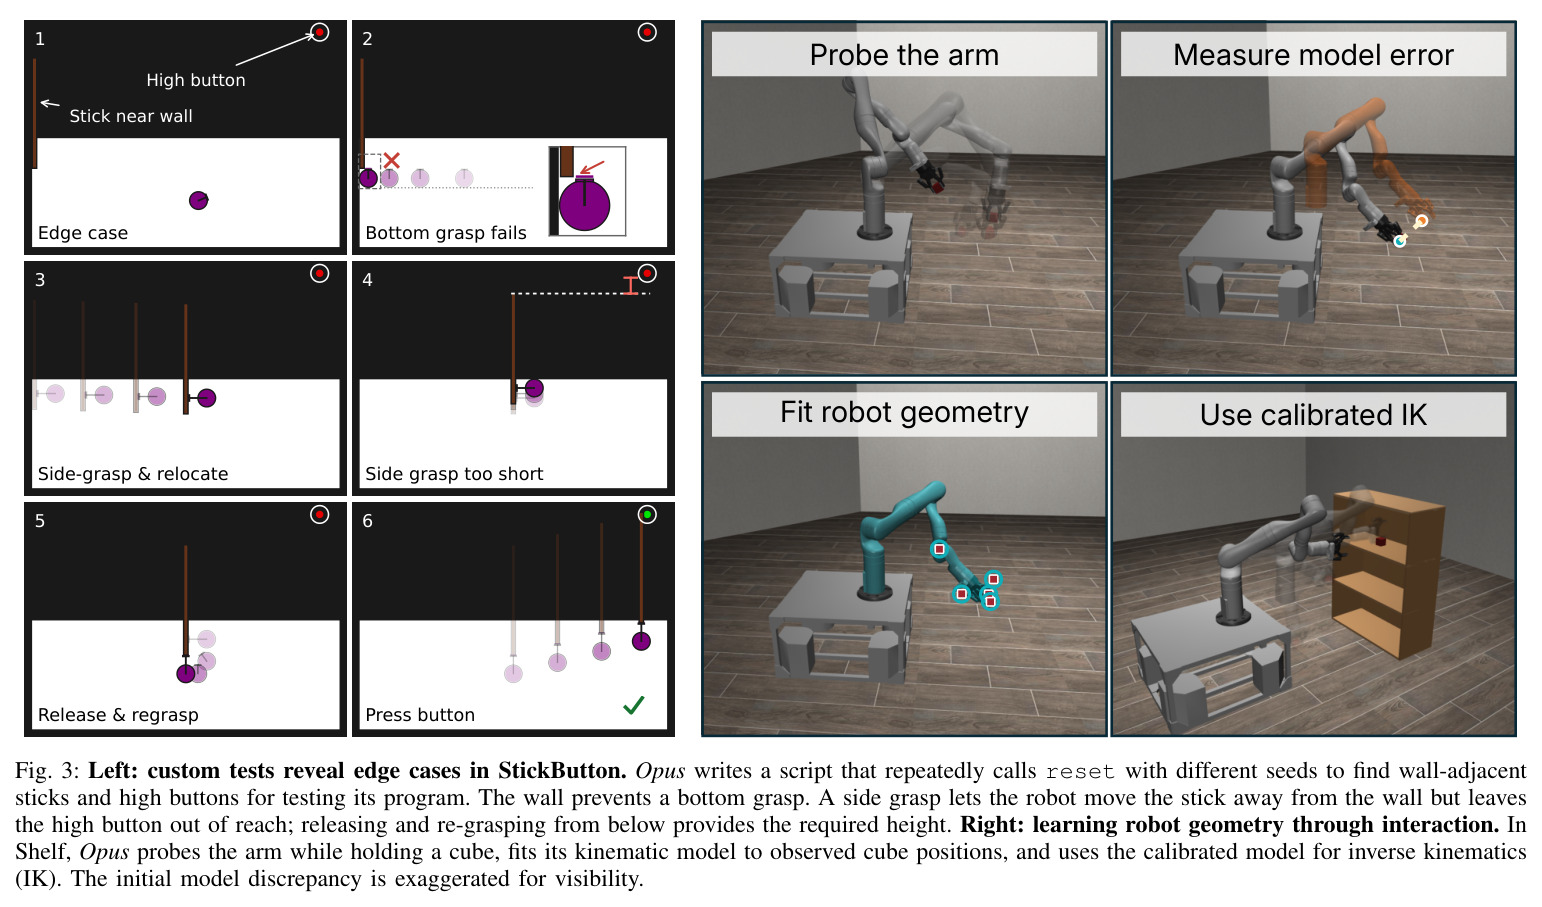
实验流程分五步。第一步,环境搭建:选取KinDER的25个环境(Kinematic2D、Dynamic2D、Kinematic3D、Dynamic3D四族,动态族需要接触/速度/摩擦推理,典型行为有清扫、倾倒、投掷;19个环境有对象数量变体),加Packing、Blocked、Rovers三个PDDLStream域,共28个,其中16个有官方规划器作基线。第二步,综合:每方法每环境独立运行5次,每次预算20美元,所有基线统一用Opus 5以便公平对比。第三步,交互式开发:智能体可写自定义测试(如在StickButton中用不同种子反复reset,收集墙边棍、高按钮等边界情况)、拟合物理模型(如在Shelf中用6个参数拟合机械臂安装与抓取偏移,把RMSE从38.9mm降到1.8mm),并被要求把每版程序commit到git仓库以便回放演化。第四步,评估:每环境生成100个随机种子的保留实例并验证综合阶段未用过这些种子,每实例限时60秒,统计成功率与每动作策略计算时间(不含综合开销和环境推进时间)。第五步,对照与消融:与规划器、LLMGenPlan、One-shot比较,另设"+source"变体给Claude Code/Opus 5与Codex/GPT-6 Astra完整环境源码作为参考。
技术新颖性
技术新颖性体现在评估设计而非新算法。此前LLM+TAMP的工作把语言模型嵌入固定抽象:Text2Motion用语言引导任务规划,LLM3用运动失败引导修订,PRoC3S生成经约束求解的参数化程序,MOPS搜索轨迹优化约束,OWL-TAMP用视觉语言模型生成约束——它们都预设了TAMP的表示框架。LLMGenPlan虽综合可复用程序但非agentic:LLM不能运行代码、不能自选实验。RHO(策略库反思式进化)、ASPIRE(技能发现修复复用)、MEMENTO(记忆引导进化)最接近,但其基准是通用操控而非TAMP物理推理。本文首次做到三点:(1)在无源码、无手工抽象的主设定下检验现成编码智能体,只给任务描述和reset/step接口,智能体必须从奖励和渲染图像反推目标与成功条件;(2)以28环境、7方法、每格5次运行、每程序100实例共98,000回合的规模做系统比较,并给出规划器、LLMGenPlan、One-shot三重参照;(3)用git提交回放程序演化,从日志定性分析物理推理过程,并以"任何已发表解法中都不存在"的意外策略作为反记忆化证据。
实验结果
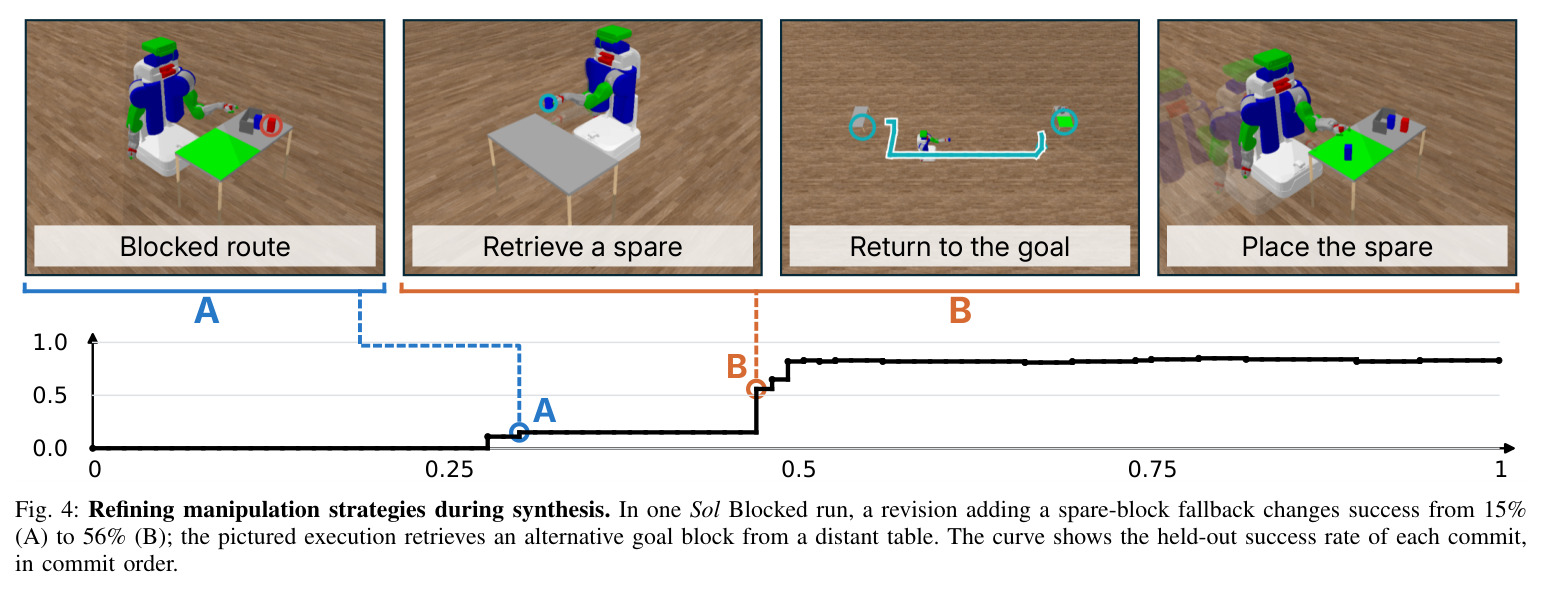
Q1泛化能力:在16个有规划器的环境上,三种智能体配置的平均成功率全部超过手工规划器的47%——GPT-6 Astra达95%、Opus 5达82%、GPT-5.6 Sol为56%;Astra在15/16个环境超过规划器,Opus为12个,Sol为9个。分族看Astra:Kinematic2D 99%、Dynamic2D 97%、Kinematic3D 93%、最难的Dynamic3D 65%、PDDLStream接近100%。Q2策略发现:图2记录了旋转工具再抓取、放弃工具改用手爪逐个推方块、掀翻托盘、手臂直接扫、过手投掷等未见于文献的成功策略。Q3交互优势:Shelf中Opus用6参数拟合机械臂模型使RMSE从38.9mm降到1.8mm再解逆运动学;BalanceBeam中一次Sol修订使成功率6%到64%;Blocked中Sol加入备用方块回退后15%到56%,最终达83%。Q4效率:主设定Opus平均11.7ms/动作、Astra 1.3ms/动作;14个含多对象数量环境上,Opus与Astra程序平均每实例2.1秒和0.5秒,规划器需29秒。Q5源码:+source把Opus从74%提到84%、Astra从86%提到95%,而同样有源码同预算的LLMGenPlan只有28%,但源码程序更慢(42.5ms与50.4ms/动作)。智能体对比:Astra在20/28个环境均值超Opus(其中11个靠一致性,Shelf上Opus各run从0%到100%波动而Astra不低于98%);Opus在22/28个环境超Sol。失败集中在接触丰富的Dynamic3D:ConstrainedCupboard主设定最高仅29%,SweepIntoDrawer Opus与Sol均为0,大规模清扫/倾倒仍基本未解决。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 16个有手工规划器的TAMP环境平均成功率(每环境100个保留实例) | 成功率 | AgenticGenPlan GPT-6 Astra:95%;Claude Code Opus 5:82% | 手工工程TAMP规划器:47% | +48个百分点(约2倍),且无需任何手工谓词/操作符/采样器/技能 |
| 28环境平均成功率(+source设定) | 成功率 | Opus + source:84%;GPT-6 Astra + source:95% | LLMGenPlan(同模型Opus 5、同20美元预算、同样含源码):28% | Opus + source 在27/28个环境上更高,差距主要归因于agentic交互 |
| 每实例策略计算时间(14个有规划器且含多对象数量的环境) | 秒/实例 | Astra程序0.5秒;Opus程序2.1秒 | 手工规划器29秒 | 计算量少约一个数量级以上(Astra约58倍),且成功率随对象数增长保持更高 |
| 每动作策略计算时间(15个各方法均有满分run的环境) | ms/动作 | Astra 1.299ms;Opus 11.741ms | 对应+source变体:Astra 50.392ms;Opus 42.480ms | 无源码综合迫使智能体把所学蒸馏成自包含代码,快约3到39倍 |
| PDDLStream三域(Packing/Blocked/Rovers) | 成功率 | GPT-6 Astra:1.00/0.99/1.00 | PDDLStream规划器与LLMGenPlan约0.74-0.86,One-shot仅0.12-0.26 | 接近满分,而此前研究表明LLM在这些域表现不佳 |
局限与改进
作者承认的局限:设定假设完全可观测、以对象为中心的状态与综合期的模拟器访问,因此不涉及感知不确定性,结论不能直接外推到真实机器人的部分可观测场景;模型训练数据不公开,无法完全排除预训练时见过基准代码的风险——作者以综合日志中的大量探测、测试与修订,以及"任何已发表解法中都不存在"的意外策略(图2)作为反记忆化的间接证据。我的补充观察:其一,泛化的定义仅限于同一环境内对象数量与布局的变化,没有测试跨环境或跨任务家族的组合泛化;其二,20美元/环境/方法/次运行的预算乘以5次运行和28个环境,意味着完整复现需要数千美元的前沿模型API开销,且结论绑定特定模型版本(Opus 5、GPT-5.6 Sol、GPT-6 Astra),模型迭代后数字会漂移;其三,部分接触丰富的Dynamic3D环境主设定下仍近乎失败(ConstrainedCupboard Opus 8%、SweepIntoDrawer Opus 0%、SweepSimple Opus 0%),说明物理推理的硬骨头还在;其四,60秒时限与模拟器无限重置的廉价性,同真实机器人的实时性与样本成本差距很大。
独立分析的弱点
独立分析的弱点:(1)物理合理性缺失——智能体发现的"掀翻托盘""过手投掷"等策略在刚体模拟器里有效,落到真实世界的柔性、摩擦与不确定性下可能脆弱,改进方向是引入域随机化和真机验证环节;(2)训练数据污染只能间接排除,改进方向是构造发布后无法泄露的程序化生成环境家族,并报告跨家族零样本迁移成绩;(3)评估只看成功率与时间,未度量程序鲁棒性(对环境外扰动的敏感性)、安全性与可解释性,run间方差已经暴露问题(Opus在Shelf上0%到100%的波动),建议增加扰动鲁棒性基准与失败模式分类学;(4)主设定下部分环境系统性失败(Opus在SweepIntoDrawer全部5次运行为0),单纯加大模型未必能解决接触动力学,可把经典规划器作为可调用工具暴露给智能体做混合求解;(5)无源码与有源码程序的测试时开销差近40倍(Astra 1.3ms对50.4ms/动作),论文缺少对"综合成本-测试成本"权衡的统一度量框架;(6)只覆盖两家厂商三种模型与harness的组合,无法区分模型能力与harness工程的贡献,应加入开源模型对照。
未来方向
作者提出的方向与可延伸的工作:作者在结论中指出,这些结果把LLM泛化规划的承诺扩展到带几何、运动学、动力学约束的环境,并把编码智能体确立为TAMP未来研究的重要基线;局限部分暗示下一步是把设定推广到感知不确定的场景。基于本文成果可延伸:(1)agentic综合与经典TAMP规划器混合——智能体学到的采样器、启发式(如校准过的逆运动学模型、回退策略)可以反哺PDDLStream,换取完备性保证;(2)程序蒸馏与实时化:研究如何把20美元综合预算产出的程序压缩部署到毫秒级实时控制器,并检验仿真到真实的迁移差距;(3)对象数量外推的系统研究:论文显示智能体能处理超出原基准的对象数(如八块方块的Shelf),值得量化程序化策略的外推边界及其失效模式;(4)把近十万回合的交互日志用于过程监督:把"模型校准""边界测试"等有效交互模式变成可训练、可奖励的技能;(5)跨环境技能库:将ASPIRE式技能发现与复用嫁接到本文的无源码设定,检验一次综合的成果能否迁移到全新环境家族,这将从"单环境泛化"推进到"跨环境泛化"。
复现评估
复现评估:论文明确承诺开源全部代码,包括给智能体的完整提示词;环境基于公开的KinDER(RSS 2026)与PDDLStream官方实现,这是复现的有利条件。算力与成本方面:综合阶段需调用Claude Code(Opus 5 high)与Codex(GPT-5.6 Sol medium、GPT-6 Astra high)的API,每环境每方法每次运行预算20美元,仅复现主设定三种配置就约需3×28×5×20=8,400美元,加+source与基线更多;评估阶段98,000回合跑在简化模拟器上,普通多核CPU即可完成,每实例限时60秒。工程难度中等:需要正确搭建Docker沙箱隔离(论文做了红队测试,复现者应重做安全验证)、随机生成评估种子并验证综合期未泄露。主要风险是结果对模型版本强敏感——模型一更新,成功率分布就会变化;论文的git提交回放机制(每版程序先commit再测试)为追踪程序演化提供了很好的可追溯性。总体判断:数据与提示齐全,数千美元预算即可复现主结论,但精确复刻数字需要锁定相同模型版本与推理配置。
论文图表
15个环境(Kinematic2D、Dynamic2D、Kinematic3D三族)上8种方法的成功率:Planner、One-shot Opus 5、LLMGenPlan Opus 5、三种主设定AgenticGenPlan(Sol/Opus/Astra)及两种+source变体。每格为5次运行均值,下方[min–max]给出run间波动,加粗标出主设定行的最佳均值与最佳max,横线表示KinDER未提供该环境的规划器。Astra几乎全面领先且多数接近满分,One-shot几乎全零,+source变体把多数环境推到接近100%。
支撑"三种智能体配置全部超过47%的手工规划器均值"这一头条结论的核心定量表;min-max区间还揭示了稳定性差异,如Opus在Shelf上0%到100%的巨大波动而Astra全部不低于98%。
延续Table I的协议,报告10个Dynamic3D环境(BalanceBeam、ConstrainedCupboard、Dynamo、Rearrange、ScoopPour、Shelf、SortClutteredBlocks、SweepIntoDrawer、SweepSimple、Tossing)与3个PDDLStream域(Packing、Blocked、Rovers,规划器即PDDLStream本身)的成功率。Astra在Dynamic3D平均65%,PDDLStream接近满分;最难的接触丰富环境仍有明显缺口(ConstrainedCupboard主设定最高29%、SweepIntoDrawer Opus与Sol为0),+source设定显著补齐这些短板。
清晰划出方法的能力边界:运动学类接近满分、静态可推理的动力学类很高、而需要大规模清扫/倾倒许多小物体的接触丰富任务仍基本未解决,是理解65%这个弱项数字和源码价值的关键表。
在四种配置各自都至少有一次运行达到100%保留集成功的15个环境上,比较每动作策略计算时间(各方法只在其满分运行上平均,方括号为跨环境均值的范围):主设定Opus 11.741ms[0.041–109.403]、Opus+source 42.480ms[0.056–381.509]、Astra 1.299ms[0.033–6.047]、Astra+source 50.392ms[0.053–477.045]。
量化Q4效率问题并揭示"信息-效率"权衡:无源码综合迫使智能体蒸馏出紧凑的自包含控制(Astra仅1.3ms/动作,多为闭式解),而有源码程序倾向在决策时调用环境实现(运动规划、碰撞检查),慢一个数量级以上。