词类作为 SAE 潜空间中的涌现范畴 Parts-of-Speech as Emergent Categories in SAE Latent Space
词性信息可从 SAE 潜变量高效恢复,但由分布式特征组承载,而非一对一的语法原子特征。
前置知识
稀疏自编码器(SAE)
SAE 是挂在 LLM 内部激活上的小型自编码器:编码器把稠密的残差流向量(如 LLaMA-3 的 4096 维)映射到更高维空间(本文扩展 32 倍至 131,072 个潜变量),解码器再重构原激活,训练时强制稀疏——每个 token 只允许少数潜变量激活。理想情况下每个潜变量对应一个更可解释的特征方向,是当前机制可解释性做「特征发现」的主流工具。
本文的全部分析对象就是 SAE 潜变量的激活模式:探测、排序、覆盖与验证都在这个稀疏空间上进行,不理解 SAE 的编码—稀疏—重构结构就无法理解实验设计。
探测分类器(probing classifier)
在冻结的模型表示之上训练一个简单(通常是线性)分类器,用语言学标签(如词性)做监督:若分类效果好,说明该信息以线性可解码的形式存在于表示中。但控制任务与信息论研究表明,高探测精度并不代表模型在计算中真的使用该信息,因此探测只回答「信息在不在」,回答不了「如何组织」。
本文第一步用 one-vs-rest 线性探测验证可恢复性,其核心贡献恰恰是明确超越探测精度、转而分析信息的组织方式,不了解探测范式的局限就看不出本文的推进点。
开放类与封闭类词性
词性按词汇成员能否自由增减分为开放类与封闭类:名词、动词、形容词、副词等开放类成员庞大且形态、语义多变;限定词、连词、代词、助动词等封闭类成员固定、词形稳定且常绑定特定句法位置。这是传统语言学的经典区分。
论文最核心的实证发现之一是:封闭类由紧致、选择性强的潜变量组支持,开放类则依赖更大更弥散的特征组,且紧致度梯度其实反映的是词形变异度而非抽象程度。
单语义性假设(monosemanticity)
机制可解释性中的理想化假设:模型内部每个潜变量(或 SAE 特征)最好只编码一个明确概念,即「一个单元 = 一个特征」。若成立,可解释性可归结为逐个解读潜变量;若不成立(特征多义、分布式编码),单潜变量解读就会误导。近年多项工作对该假设提出质疑。
本文检验的正是「一个词性 ↔ 一个潜变量」的一元映射是否成立,结论是词性由紧致但成组的潜变量涌现式支持、且跨类有重叠,直接回应了单语义性争论。
L1 正则化逻辑回归
在逻辑回归目标中加入权重绝对值之和的惩罚项,如 $\mathcal{L} = -\sum_i \log p(y_i|x_i) + \lambda \|\beta\|_1$,使多数系数被压为精确零,从而在高维空间中自动完成特征选择,产出稀疏、可解读的权重向量 $\beta$。
本文的探测分类器与「特征显著度」排序都建立在 L1 系数上:正系数潜变量构成每个词性的候选特征组,是整个定位流程的入口。
残差流(residual stream)
Transformer 中每个 token 位置的表示主通道:词嵌入先写入残差流,随后每层的注意力与 MLP 输出依次叠加其上,最后一层(unembedding 之前)的残差流即该位置的最终表示。SAE 通常挂在残差流的特定层位上做编码。
论文从 LLaMA-3-8B 第 30 层(MLP 之后、输出层之前)的残差流提取激活,并在附录证明结论在第 2、15 层等浅中层同样稳定成立。
研究动机
SAE 已成为解读 LLM 内部表示的主流工具,但一个根本问题悬而未决:潜变量空间里到底以什么形式存在理论语言学意义上的范畴?已有证据互相矛盾。一方面,Kantamneni 等(2025)在 113 个二分类任务上发现基于 SAE 潜变量的探测并不稳定优于简单基线,SAEBench(Karvonen 等,2025)也表明标准 SAE 代理指标的增益难以迁移到下游任务;另一方面,Marks 等(2025)用 SAE 特征成功构建了主谓一致的因果电路,Engels 等(2025)又证明并非所有语言模型特征都能用单一线性方向表示。更关键的是,传统探测范式(Tenney 等证明低层编码形态句法信息)只能回答「POS 信息是否存在于激活中」,无法回答它如何被组织——是某个单一潜变量对应一个词类,还是一组特征共同承载?已有针对 SAE 的语言学分析要么只处理孤立现象(主谓一致),要么只看粗粒度属性(语言身份),始终缺少对经典形态句法范畴在潜空间中组织方式的系统检验。
本文的目标是本文选择词性(POS)作为受控测试床来回答「语言学范畴在 SAE 潜空间中如何组织」。POS 离散、有独立完善的人工标注(Universal Dependencies 的 17 个 UPOS 标签)、语言学上可解释,且开放类与封闭类在词汇能产性、频率和句法功能上差异明显,是检验「局部化特征 vs 分布式表示」的理想对象。具体目标分解为三个研究问题:RQ1——POS 范畴是否显式编码在 SAE 潜变量激活中(可恢复性);RQ2——这种编码在潜空间中如何组织,是一对一的原子潜变量还是结构化的特征组、每组多大(定位与紧致度);RQ3——识别出的潜变量组在 held-out 语料和受控最小模板数据上是否保持激活、是否类别特异(稳定性与系统性)。最终要产出经过验证的、大小可量化的 POS 相关潜变量组。
与已有工作不同的是,本文的独特切入是把分析单位从「探测准确率」下移到「单个稀疏潜变量」层面,将可解释性证据链拆成可恢复性 → 定位 → 稳定性三个解耦阶段。方法上不再满足于二值探测得分,而是把 L1 探测器的正系数当作特征显著度信号,进而定义覆盖率 $Cov_c(k)$ 与达到 95% 覆盖所需的最小潜变量数 $k^\star_c$,并对每个类别独立设阈值,避免开/封闭类在相关潜变量数量和系数分布上的系统性差异扭曲比较;再用各类最小特征组的并集 $L^\star$ 做多分类压缩测试。评估上引入 180 词的最小模板受控集以剥离词汇记忆与上下文混杂,用共激活矩阵与区分度 $D(c)$ 量化类别特异性,并以随机标签控制和随机特征替换控制排除两个关键混淆。「语言学理论驱动 + 潜变量粒度的组织分析」这一组合在既有 SAE 文献中是缺失的。
核心方法
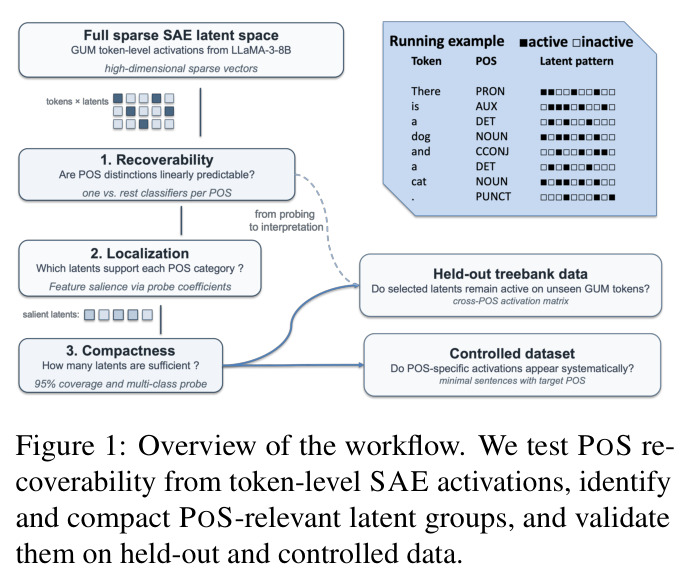
直觉上,如果某个词类真的局部化在少数潜变量中,那么线性探测器的权重应集中在少数正系数特征上;只用这批特征就应能覆盖该类绝大多数 token 并支撑多分类;反之,若信息弥散在整个空间,紧致子集的性能会大幅崩塌。技术路线是一条四步流水线:以 LLaMA-3-8B 为对象,取第 30 层残差流(MLP 之后)的激活,经 EleutherAI 的 32 倍扩展 SAE 编码为稀疏潜变量向量;将 subword 与 GUM 树库的 UD token 按字符区间对齐(取最左 subword 为锚点),在全树库中出现过的 130,246 个潜变量上构造 $N \times 130{,}246$ 的稀疏特征矩阵 $X$,其中 $x_{i,j}$ 为潜变量 $j$ 在 token $i$ 上的激活强度、否则为零;然后依次做 one-vs-rest L1 探测(RQ1)、系数显著度排序与覆盖率分析(RQ2)、held-out 与受控数据验证(RQ3)。这套设计把「信息是否存在」「信息在哪里」「信息是否稳定」三个问题分离开来。
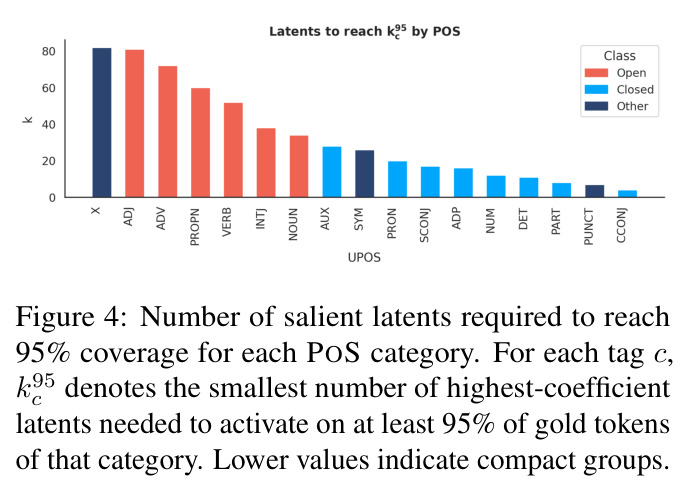
核心创新在于把探测分类器当作「特征显著度机制」而非分析终点。与先前工作只报告探测准确率、或只看 top-activating examples 不同,本文利用 L1 正则化产生的稀疏系数为每个词性排出支持其判别的潜变量列表,再以覆盖率定义类别支持组的最小规模 $k^\star_c = \min\{k : Cov_c(k) \ge \tau\}$($\tau = 0.95$),且对每类独立设阈值而非全局 top-k,避免开放类与封闭类在特征数量和系数分布上的差异扭曲比较。另一关键区别是验证逻辑:识别出的紧致特征组并集 $L^\star$ 若只承载词汇记忆,在 held-out 数据上应失效;若只捕获位置线索,在受控模板中就会崩塌。首 token 扰动实验(句首加「1.」后激活整体迁移)进一步定位了位置型伪影。这使「分布式但可局部化的特征组」这一结论具备了可证伪的支撑。
方法步骤详情
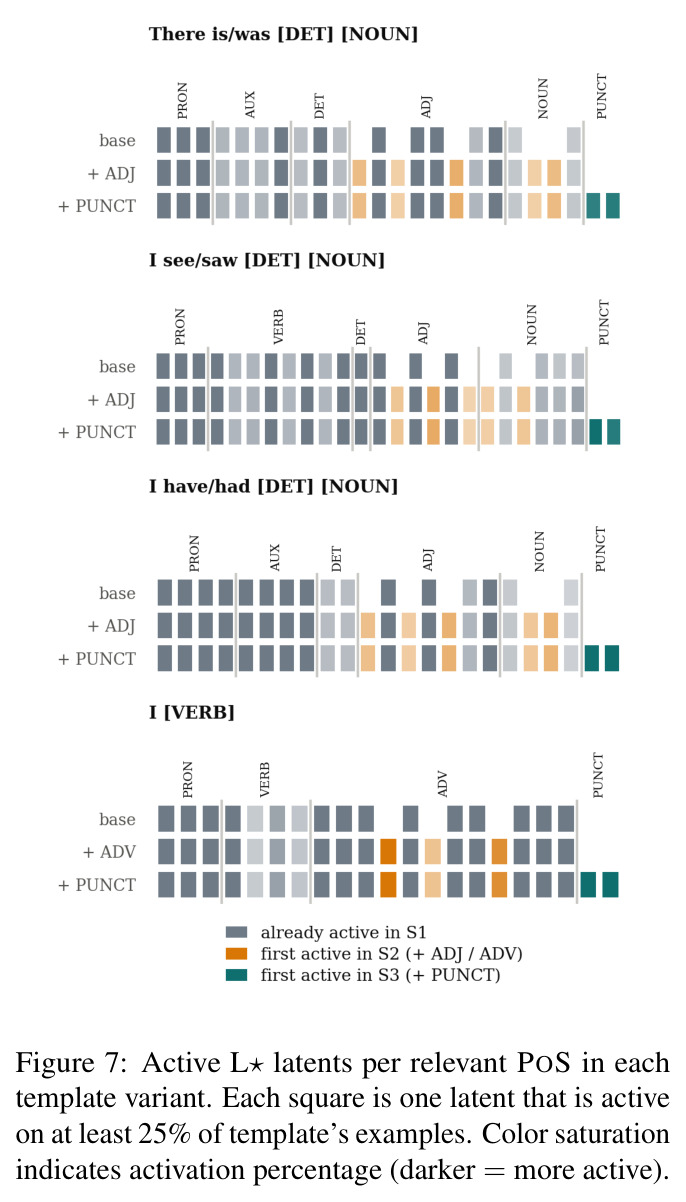
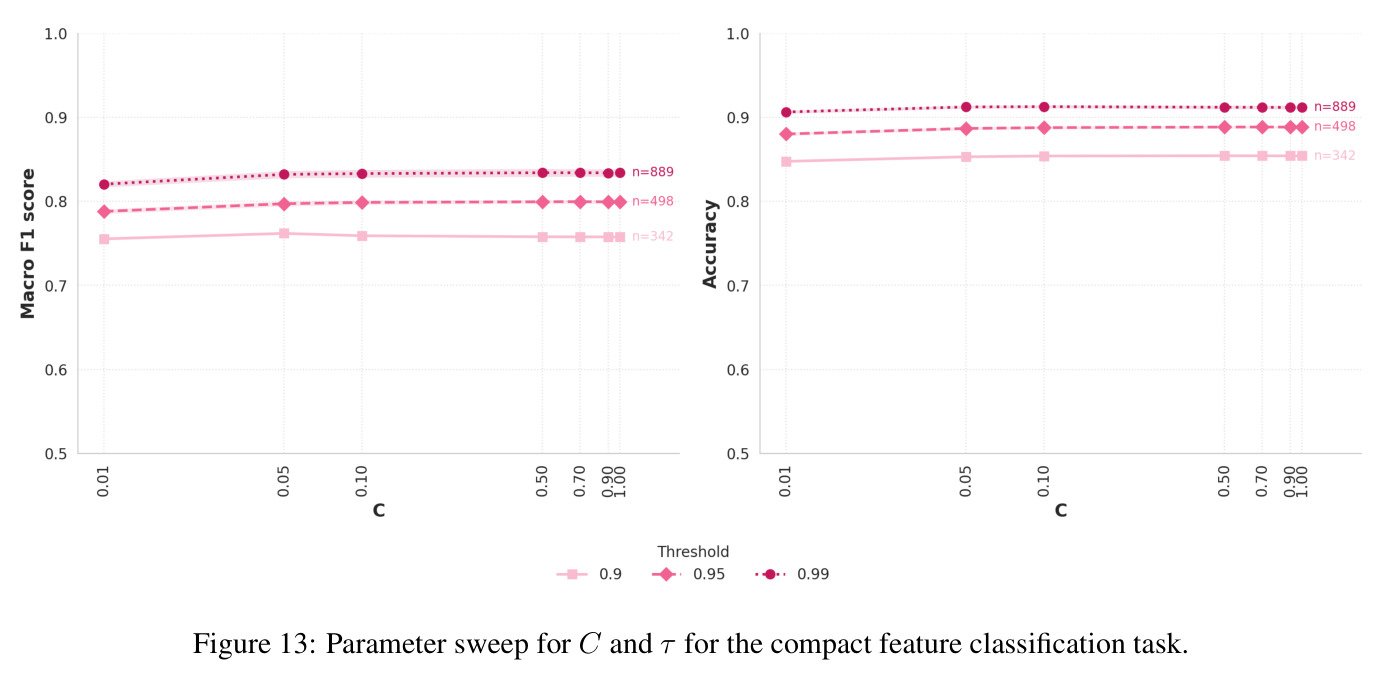
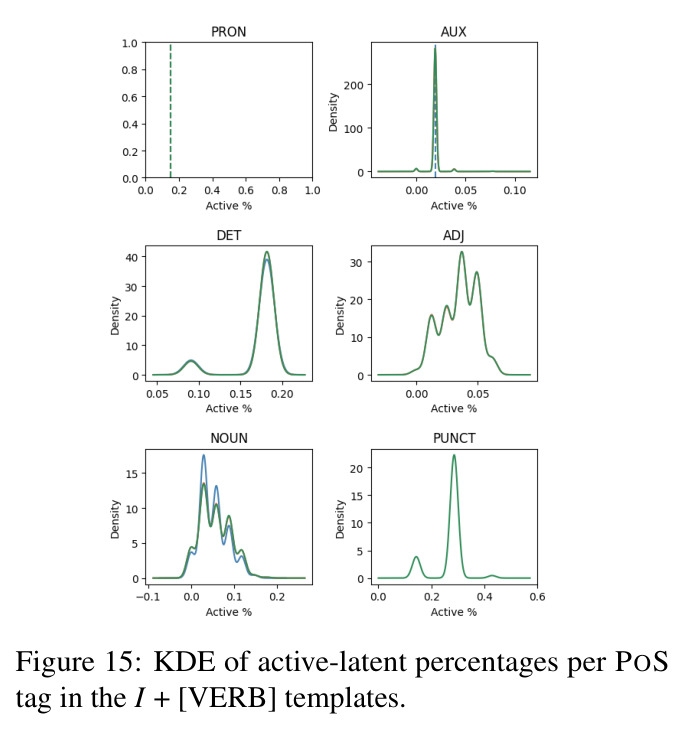
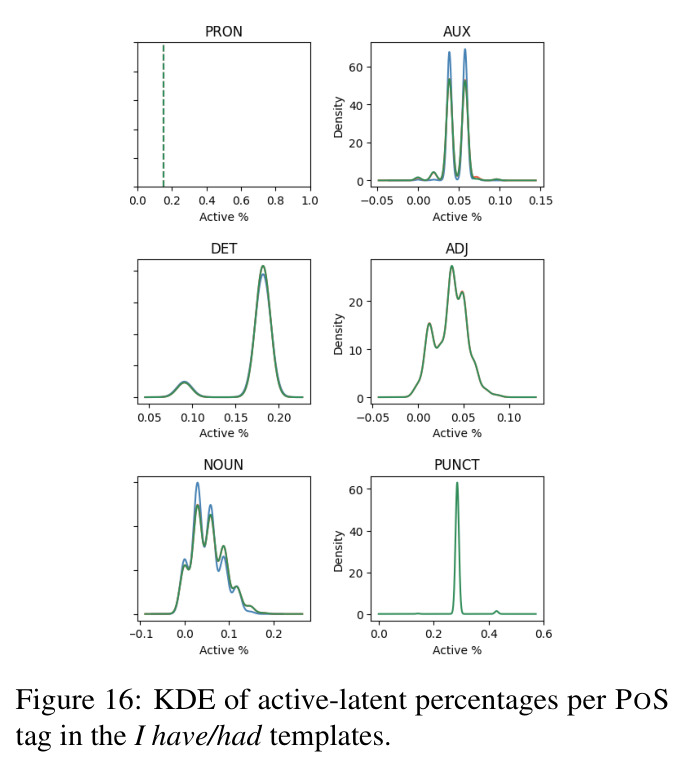
第一步,数据准备:GUM 树库(UD 英语标注)共 14,353 句、252,284 个 token,覆盖全部 17 个 UPOS,训练切分作发现集、测试切分留作验证;另构建 180 词受控集——160 个名词覆盖多种语义类别(动/静指称各半),20 个高频动词(10 规则、10 不规则),嵌入 "I see/saw [DET] [NOUN]"、"There is/was …"、"I + 动词" 等最小模板,各配形容词/副词与标点变体。第二步,激活提取:取 LLaMA-3-8B 第 30 层残差流激活,经 SAE 编码得到每个 subword 激活的潜变量及强度,再按字符区间重叠对齐到 UD token(取最左 subword 为锚点,避免子词平均稀释类别信号)。第三步,稀疏矩阵:对全树库至少激活一次的潜变量取并集,得 $X \in \mathbb{R}^{N \times 130246}$,$x_{i,j}$ 为激活强度。第四步(RQ1):每类训练一个 one-vs-rest L1 逻辑回归($C=0.1$,balanced 类权重),5 折交叉验证测 F1。第五步(RQ2):按正系数排序得显著度列表,计算覆盖率 $Cov_c(k) = \frac{1}{|T_c|}\sum_{t \in T_c} \mathbb{1}[\exists \ell \in L_c^{(k)} : a_\ell(t) > 0]$ 与 $k^\star_c$,取并集 $L^\star = \bigcup_c L_c^{(k^\star_c)}$,仅用它训练多项逻辑回归多分类。第六步(RQ3 与控制):不重训,直接在测试集上测共激活矩阵 $M_{c,c'}$ 与区分度 $D(c)$,在受控集做伪多标签评价,并运行随机标签控制、原始激活基线与随机特征替换(0/25/50% 重叠)。
技术新颖性
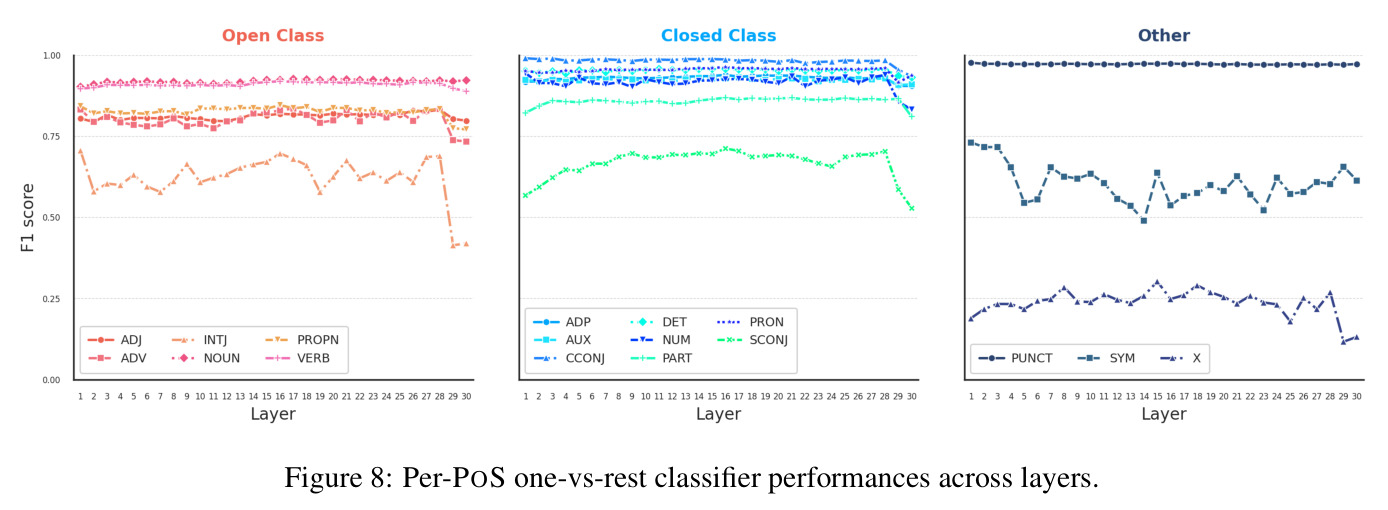
技术新颖性体现在五点。其一,把 probing 与 SAE 特征分析衔接起来:探测系数作为潜变量显著度的桥梁,将「信息存在」推进到「信息如何组织」,填补了 Kantamneni 等对 SAE 实用性的质疑与 Marks 等因果电路工作之间的空白。其二,覆盖率—紧致度框架:$Cov_c(k)$ 与 $k^\star_c$ 把「特征组大小」变成每个类别一个可比较的数,使「开放类需要更大特征组」成为可量化命题。其三,双数据源验证:自然语料(发现集上选特征)与最小模板受控集(验证加性激活、排除词汇记忆)互补,并用首 token 扰动识别位置伪影。其四,层稳定性分析:在第 2、15、30 层重复主要实验,发现特征组规模与 $L^\star$(530 → 501 → 498)跨层稳定,随深度只是「再分配」而非质变。其五,立场克制:作者明确不声称 SAE 探测优于稠密探测,而是强调 SAE 的独特价值在于分解与定位——这种方法论自觉在同类工作中少见。
实验结果
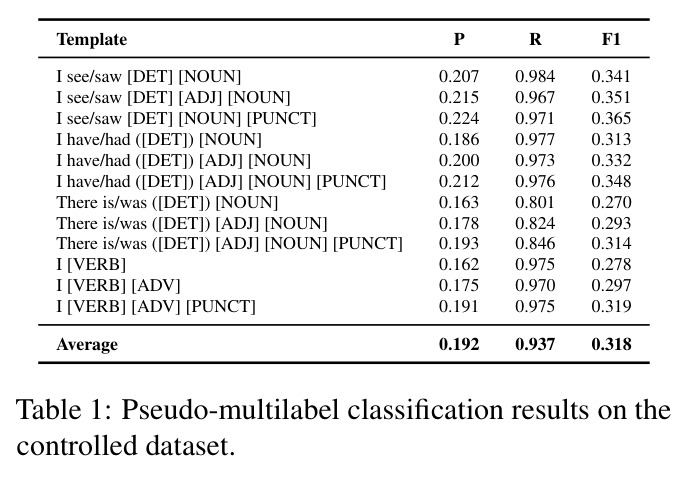
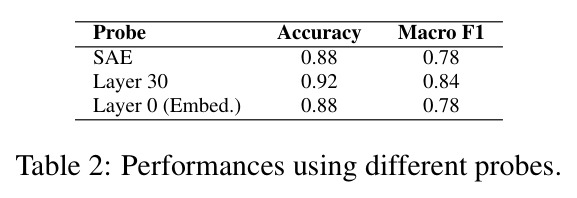
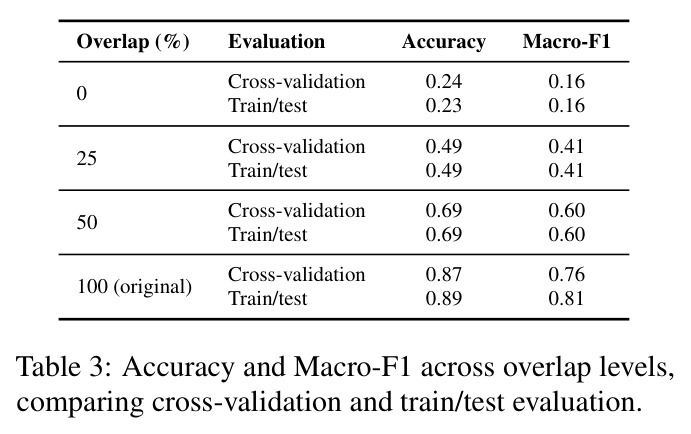
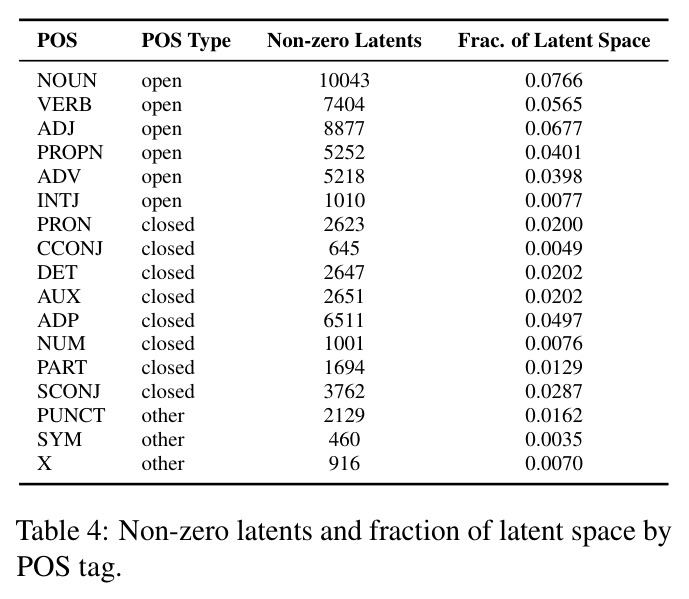
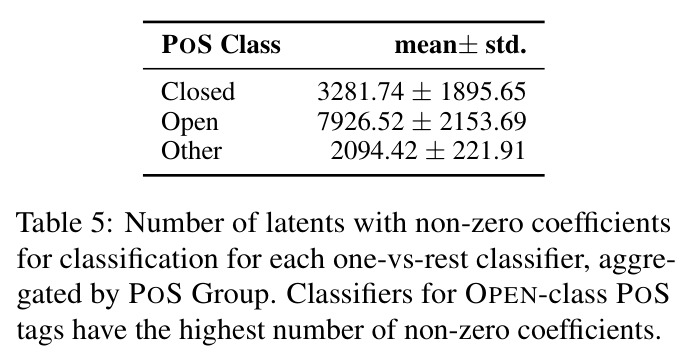
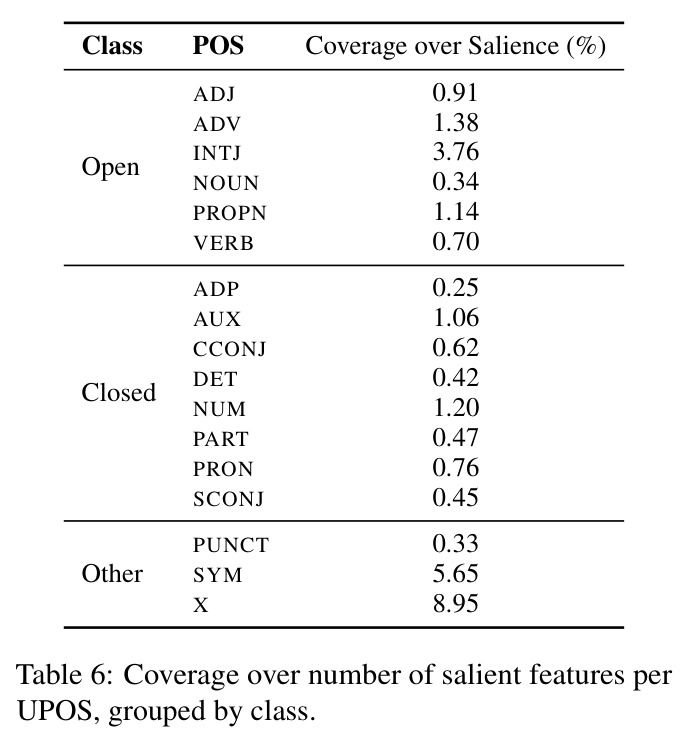
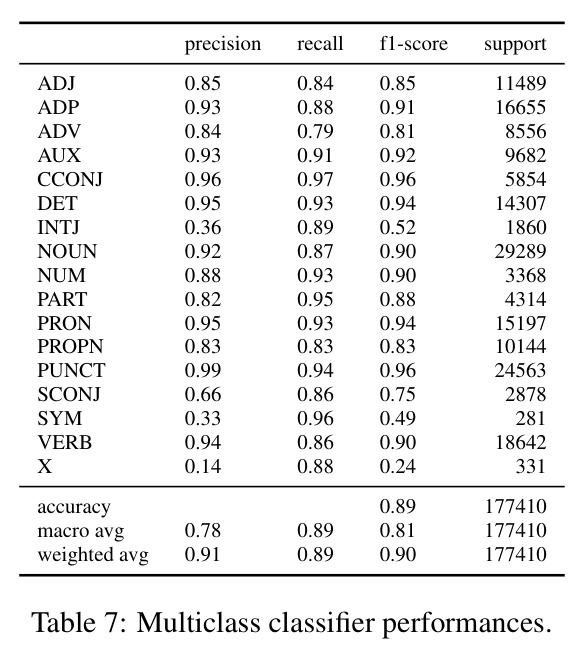
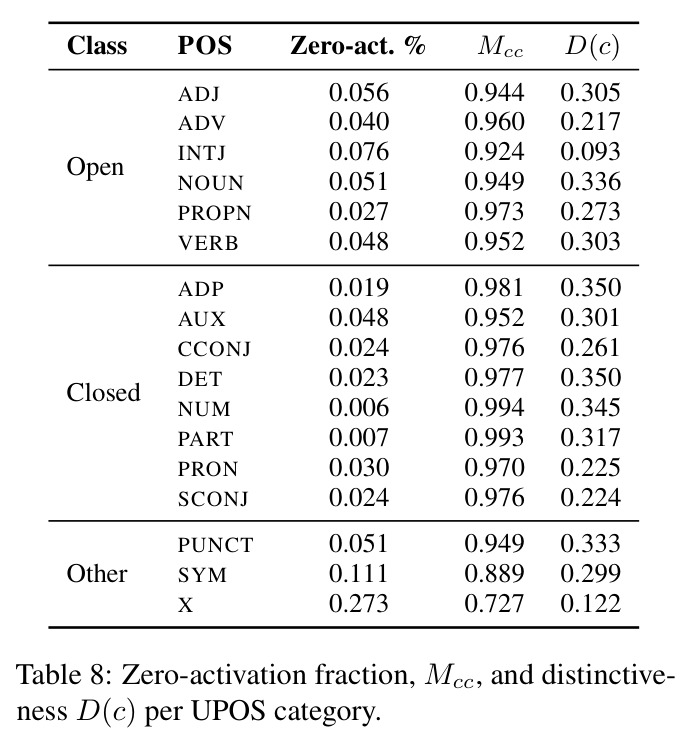
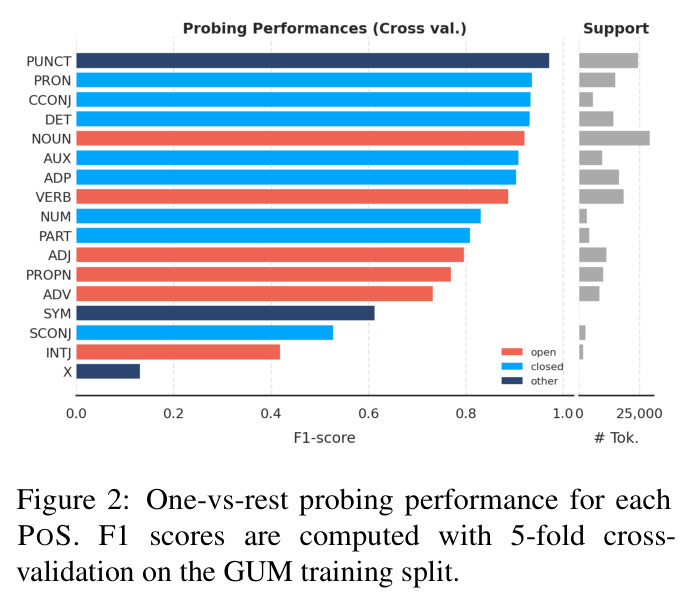
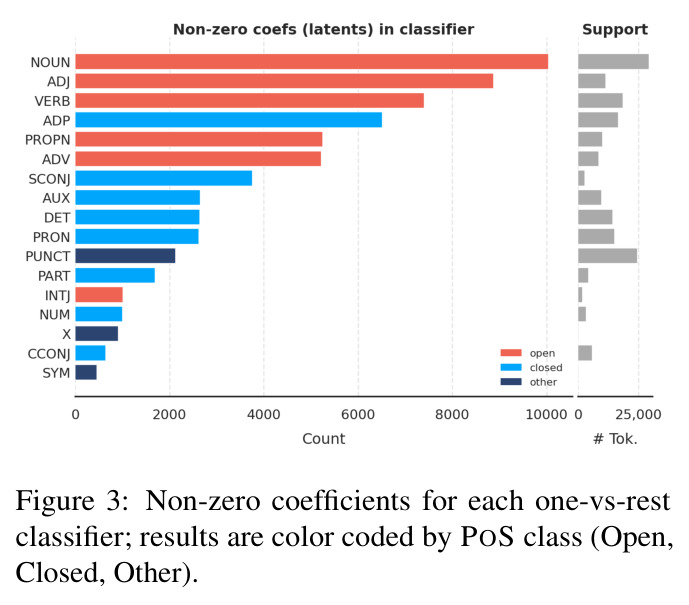
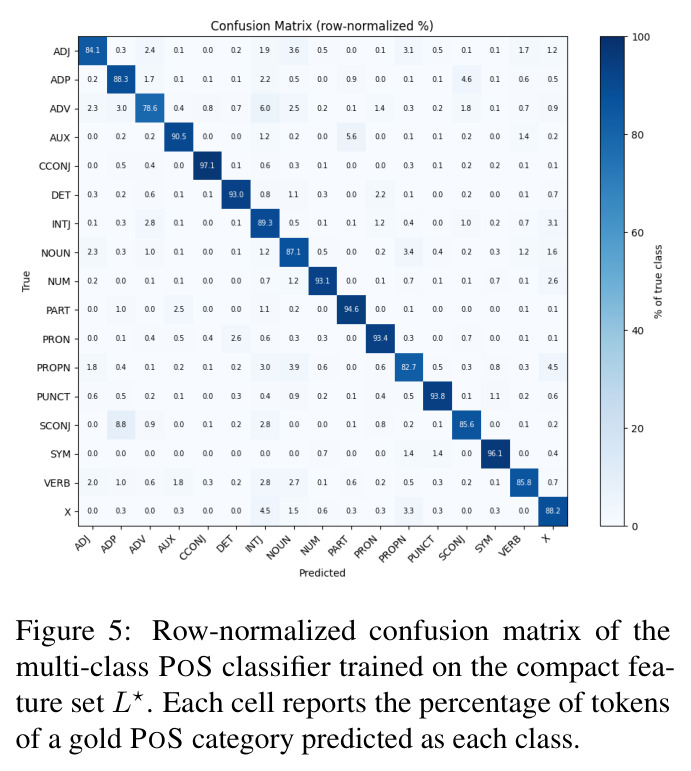
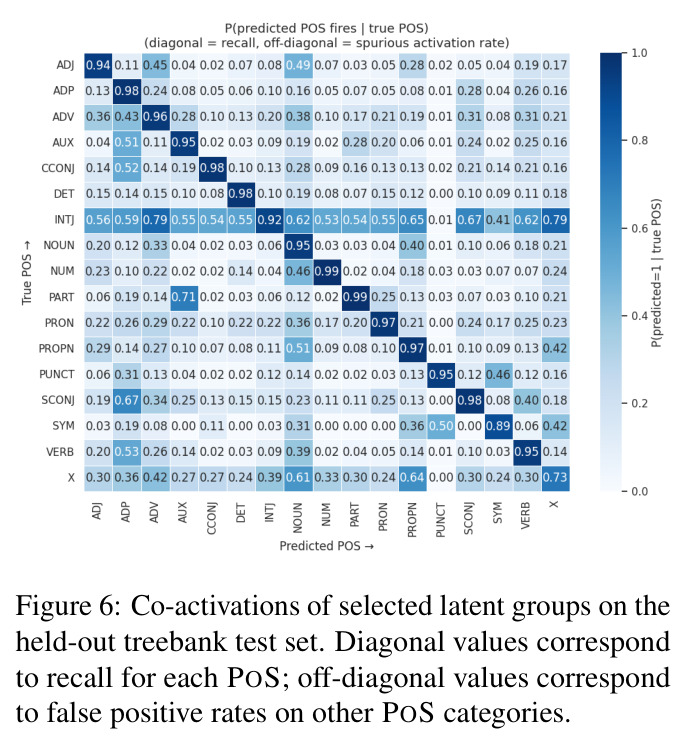
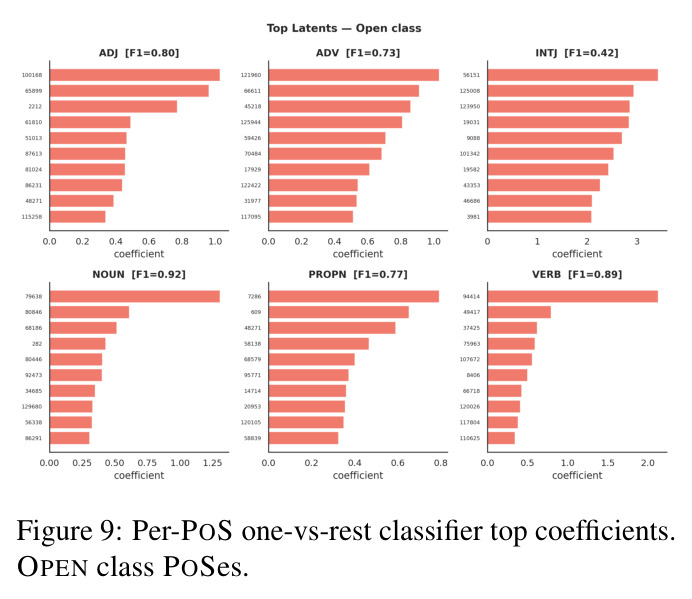
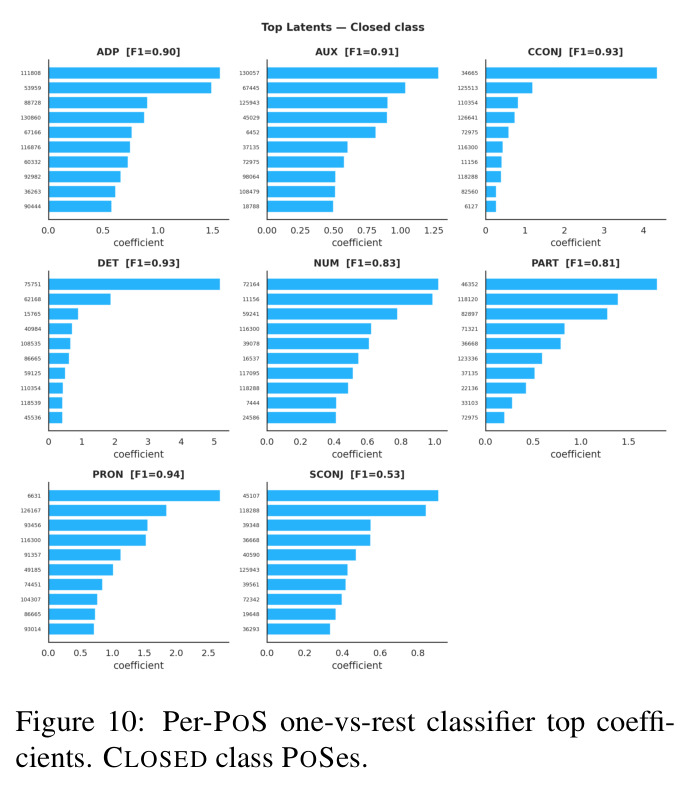
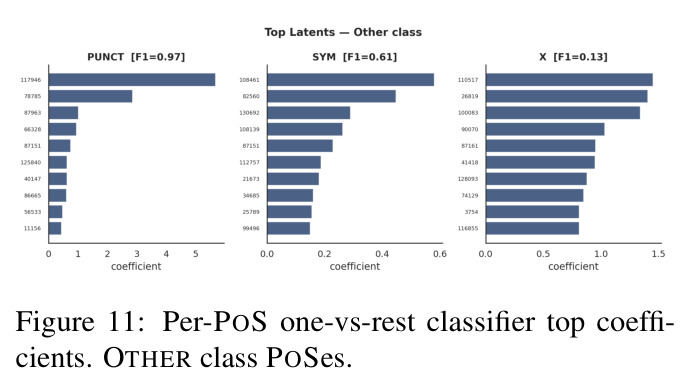
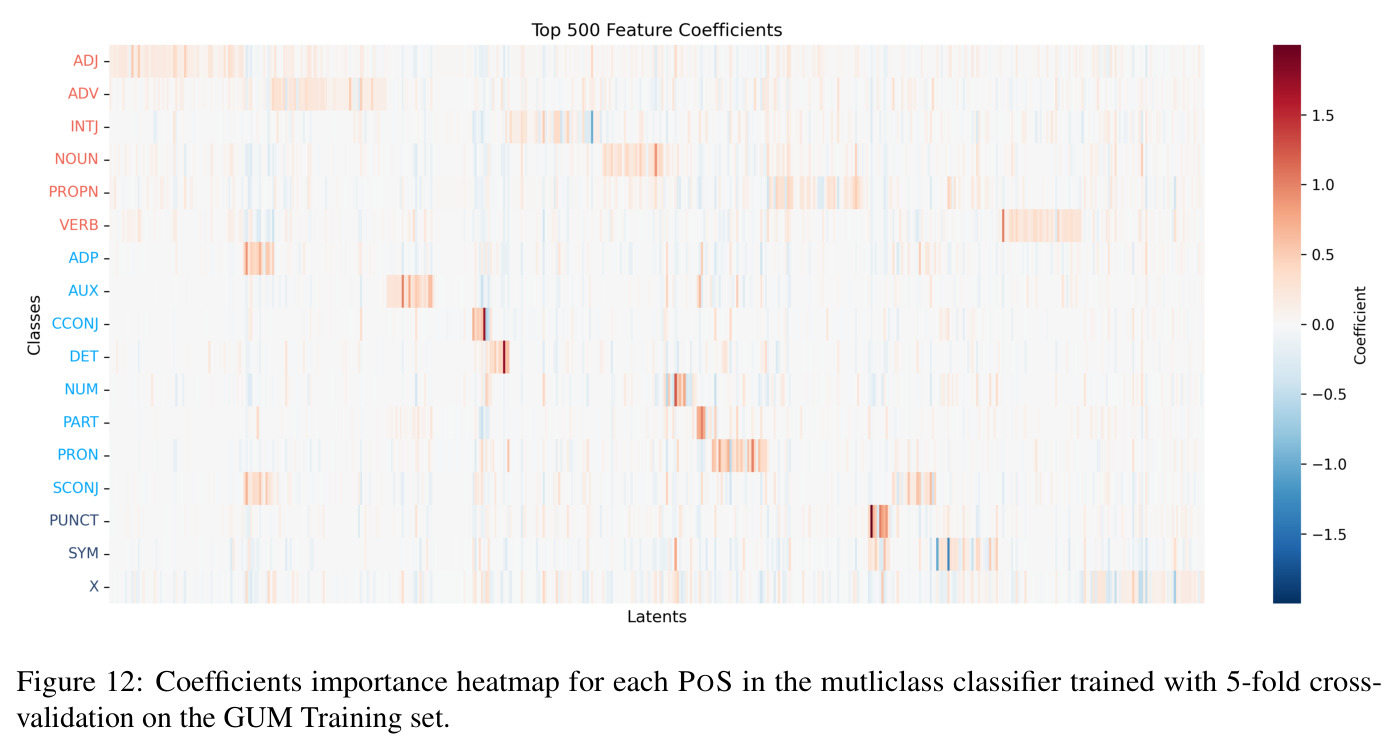
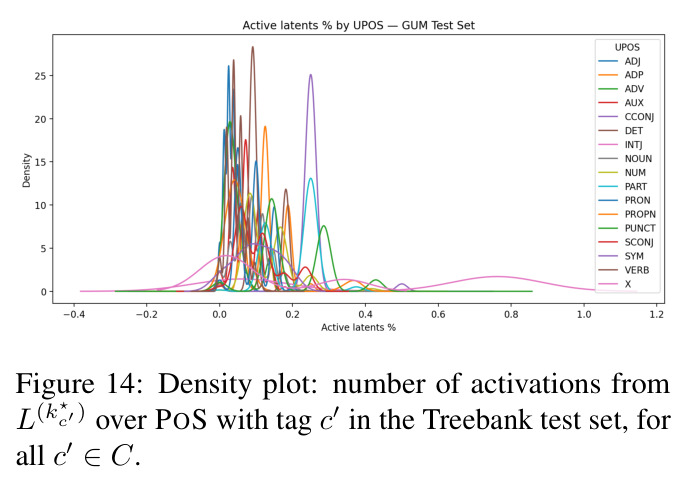
RQ1:全部 17 个 UPOS 的 one-vs-rest 探测(5 折交叉验证)大多获得高 F1,词性信息在 SAE 激活中高度可恢复,但性能不均——封闭类与 PUNCT 最易恢复,开放类中 NOUN/VERB 最好,SYM/X 因支持极少而最差。RQ2:组织呈类别依赖的分布式局部化——非零系数潜变量数开放类平均 $7926.52 \pm 2153.69$(NOUN 10043、ADJ 8877、VERB 7404),封闭类仅 $3281.74 \pm 1895.65$(CCONJ 只有 645);仅 498 个潜变量的紧致集 $L^\star$(12% 跨类共享)训练的多分类器在测试集达 Accuracy 0.89、Macro F1 0.81,不逊于全 SAE 表示(0.88/0.78)。系数分布显示封闭类有支配性单一潜变量(DET 的 latent 75751 系数约 5.5、PUNCT 的 117946 约 5.5),开放类中仅 VERB 有主导特征(94414,约 2.2)。RQ3:held-out 共激活召回多数 $\ge 0.95$(NUM 0.994、DET 0.977),但区分度 $D(c)$ 均值仅 0.27($\sigma=0.07$,机会水平 0.06);受控集伪多标签平均 P 0.192 / R 0.937,即高召回低精度,证实「激活稳定但跨类部分重叠」。控制实验:随机标签探测仅 0.54 Accuracy / 0.42 Macro F1,与真实标签的 0.88/0.97 相差 34–37 点,排除词汇记忆主导;随机替换 $L^\star$ 特征使准确率从 100% 重叠的 0.87–0.89 单调跌至 0% 重叠的 0.23–0.24。附录的层分析显示第 2/15/30 层间 $L^\star$ 为 530/501/498、Macro F1 为 0.77/0.79/0.81,结论跨层稳定。
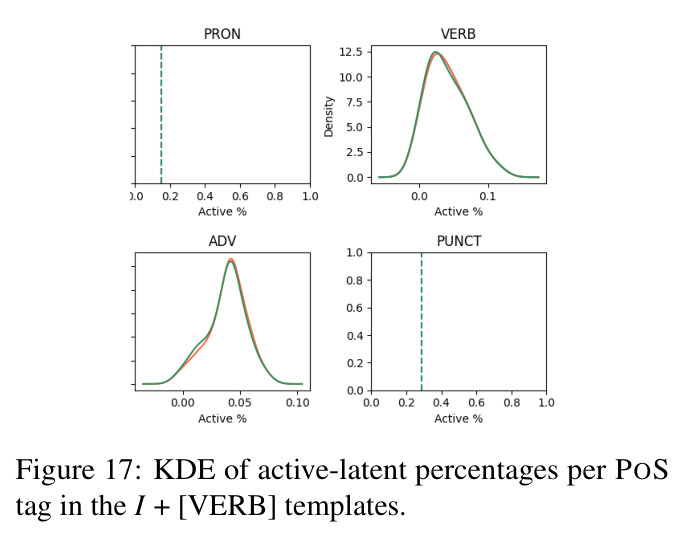
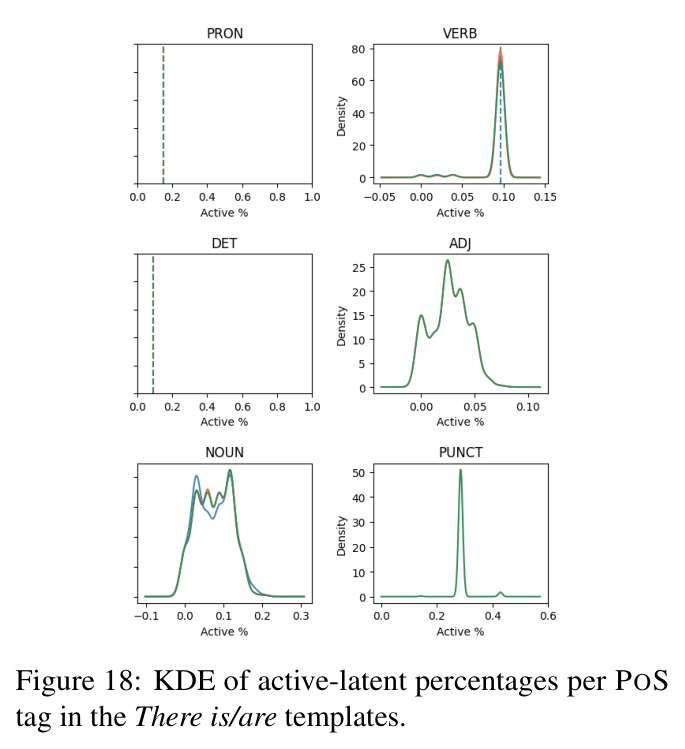
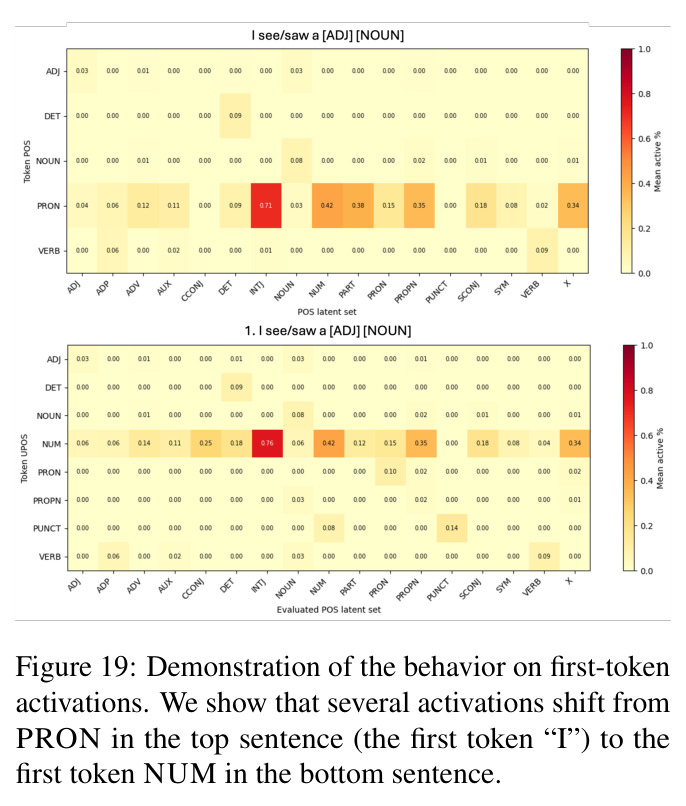
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| POS one-vs-rest 线性探测(GUM 5 折交叉验证) | Accuracy / Macro F1 | SAE 潜变量:0.88 / 0.78(且特征被分解、可定位) | 第 30 层原始残差流 0.92 / 0.84;第 0 层词嵌入 0.88 / 0.78 | 性能与稠密探测相当,但 SAE 用约 8 倍更少的特征,提供分解与定位能力(作者明确不声称探测性能更优) |
| 仅用 498 个紧致潜变量的多分类 POS(GUM 测试集) | Accuracy / Macro F1 | 0.89 / 0.81 | 全 SAE 表示(130,246 维稀疏空间):0.88 / 0.78 | 用不足 0.4% 的潜变量保持并略超全表示性能,证明 POS 信息高度集中于紧致特征组 |
| 受控数据伪多标签验证(180 词最小模板) | Micro P / R / F1 | 平均 0.192 / 0.937 / 0.318(如 "I see/saw [DET] [NOUN]" 为 0.207/0.984/0.341) | 均匀共激活的机会水平(区分度 $D=1/17 \approx 0.06$) | 高召回(0.80–0.98)证实特征组在简单语法句中稳定激活;低精度揭示跨类共享与 first-token 伪影 |
| 随机标签控制(检验词汇记忆混淆) | Accuracy / Macro F1 | 真实标签探测:0.88 / 0.97 | 随机 UPOS 标签探测:0.54 / 0.42 | 34–37 点差距表明 POS 可恢复性不能归因于词形记忆 |
| $L^\star$ 特征随机替换(0/25/50/100% 重叠) | Accuracy(CV 与 train/test 两种评测) | 100% 重叠:0.87 / 0.89 | 0% 重叠(全随机):0.24 / 0.23;25%:0.49;50%:0.69 | 性能随真实特征比例单调恢复,证明 $L^\star$ 潜变量确为 POS 相关 |
| held-out 共激活的类别特异性 | 区分度 $D(c)$(均值) | $\mu = 0.27$($\sigma = 0.07$) | 均匀共激活机会水平 0.06($1/17$) | 约为机会水平 4.5 倍,但远低于完全排他($D=1$),量化了「稳定但部分共享」 |
局限与改进
作者承认的局限:研究只覆盖 POS 这一个语言学抽象层面,更细粒度的形态特征、依存关系、语义角色与语篇现象中潜变量的组织方式可能不同;仅分析了单一模型 LLaMA-3-8B、单一公开 SAE 和一个主层位,模式可能依赖模型、层选择、SAE 训练流程与稀疏度机制,需要跨模型、跨层、跨 SAE 变体的比较;定位流程依赖线性探测系数作为显著度信号,$\ell_1$ 正则虽鼓励稀疏可解读,但系数只是预测性证据而非因果证据,尚需干预实验确认模型是否真正使用这些潜变量做形态句法加工;受控数据集刻意做得很小且只覆盖名词/动词相关构式。我的补充观察:UD 标注惯例本身塑造了结果——INTJ 吸收 like、well、God 等语用词导致高伪激活,SYM/X 支持数仅 281/331,其低 F1 更多反映标注与数据稀疏而非模型能力;$k^\star_c$ 的紧致度排序可能主要反映词形变异度而非抽象程度(作者也承认 DET 紧致只因 the 不变形);最左 subword 锚点策略对多子词词形的形态信息提取可能引入偏差。
独立分析的弱点
独立分析的弱点:(1)相关性不等于使用——即便 $L^\star$ 预测性强,也无法排除这些潜变量只是模型计算过程的「读出阴影」;改进方向是在 SAE 解码端做因果干预,抑制或放大 $L^\star$ 并观察主谓一致等下游行为的因果变化。(2)单一层位与单一 SAE——主结果集中在第 30 层与 EleutherAI TopK SAE,不同训练方法(JumpReLU、Gemma Scope、Llama Scope)与稀疏度下的组织方式未必一致;应在多个公开 SAE 套件上系统重复覆盖分析。(3)位置与词形线索纠缠——$D(c)=0.27$ 与「first-token」伪影表明潜变量组部分编码位置和正字法线索而非纯句法功能;改进是构建位置受控的模板并系统变换首 token。(4)类别规模混淆紧致性解释——$k^\star_c$ 排序可能主要反映类型库存规模(DET 紧致只因词形少),需匹配 type-token 比的对照语料来分离「词汇变异」与「范畴抽象」。(5)受控集仅 180 词、只涉名词/动词,无法检验全部 17 类的加性行为,应扩展到从句、被动、并列等复杂构式。
未来方向
作者提出的方向:把分析扩展到更细粒度的形态特征、依存关系、语义角色和语篇层面,这些层面的潜变量组织可能呈现不同模式;比较多个模型、多个层和多种 SAE 变体以检验普适性;研究类型学上多样的语言——在形态丰富的语言中,词性与形态的纠缠方式会显著不同。基于本文成果可自然延伸的研究:其一,将 $L^\star$ 潜变量组当作词性的「潜空间签名」,用于跨模型比较或训练动态分析(观察语法范畴何时在训练中涌现);其二,结合因果干预(sparse feature circuits 式的激活 patching)检验模型是否真正调用这些特征执行语法计算;其三,深入刻画跨类共享潜变量(如 72975 同时出现在 AUX/CCONJ/PART、86665 出现在 DET/PRON/PUNCT)是否对应多功能词的多路复用机制;其四,把覆盖—紧致度框架推广到命名实体、语义角色等其他范畴体系,为 SAE 训练建立「范畴保真度」评估指标。
复现评估
复现条件在可解释性论文中属于较好水平。开源情况:代码与数据托管于 GitHub(colinglab/pos-sae-latents),token 级 SAE 激活(对齐 UD POS 标签)发布于 HuggingFace(colinglab/UD_English-GUM-Latents_Meta-Llama-3-8B_L30),180 词受控集亦公开;所有底层工件均公开——LLaMA-3-8B(Llama 3 Community License)、EleutherAI/sae-llama-3-8b-32x(配合 Sparsify 库)、GUM 树库(主要为 CC BY 4.0)。算力门槛低:激活提取只需单张 A100 80GB(每层约 0.16 GPU 时);探测分类器用 scikit-learn 跑 CPU,GUM 训练集一次完整 5 折交叉验证约 4 小时(全部 CPU 核)。难度评估:流程描述完整($C=0.1$、$\tau=0.95$、L1 逻辑回归、最左子词对齐等超参与细节齐全),且发布的激活数据可绕过最耗时的提取步骤,中等偏低难度即可复现主要结果;主要不确定性在于 SAE checkpoint 的具体版本与字符对齐的边界情形。整体而言,这是一篇数据、代码、模型三层全开源的工作,独立复现或在其上做扩展实验的可行性都很高。
论文图表