反思大模型在线蒸馏 II:一条训练样本 Rethinking On-Policy Distillation of Large Language Models II: One Training Example
单条样本即可逼近全量数据在线蒸馏收益:OPD 数据过剩而算法饥饿
前置知识
在线蒸馏
On-policy 蒸馏(OPD)是一种知识蒸馏范式:学生模型自己采样生成 rollout,教师模型在学生实际访问到的每个前缀状态上提供完整的下一 token 分布,形成 token 级密集监督。其目标是最小化每个访问状态上的 KL 散度 $\mathcal{L}_{\text{OPD}}(\theta)=\mathbb{E}_{x\sim\mathcal{D},\,y\sim\pi_\theta}\sum_i \mathrm{KL}(\pi_\theta(\cdot|s_i)\,\|\,\pi_T(\cdot|s_i))$,实践中用逐 token 优势 $A^i=\log\pi_T(y_i|s)-\log\pi_\theta(y_i|s)$ 估计。与 SFT 的固定参考答案、RL 的结果奖励不同,OPD 的信号不依赖轨迹最终对错。Qwen3、GLM-5、DeepSeek-V4、Kimi K3 等前沿后训练均采用。
本文全部问题设定、实验与度量(状态覆盖、吸收率)都建立在 OPD 的机制之上,不理解 OPD 就无法理解「一条样本为什么够」这一核心问题。
RLVR(可验证奖励强化学习)
RLVR 用可验证的最终结果(如数学答案对错)作为奖励训练模型,奖励是轨迹级的稀疏标量,常用 GRPO 算法:对同一查询采样一组 rollout,按组内相对优势更新。一旦模型对训练题几乎全部答对,组内结果无差异、优势归零,训练信号即枯竭。已有 one-shot RLVR 工作证明单条题目也能支撑上千步训练,是本文实验设计的先例。
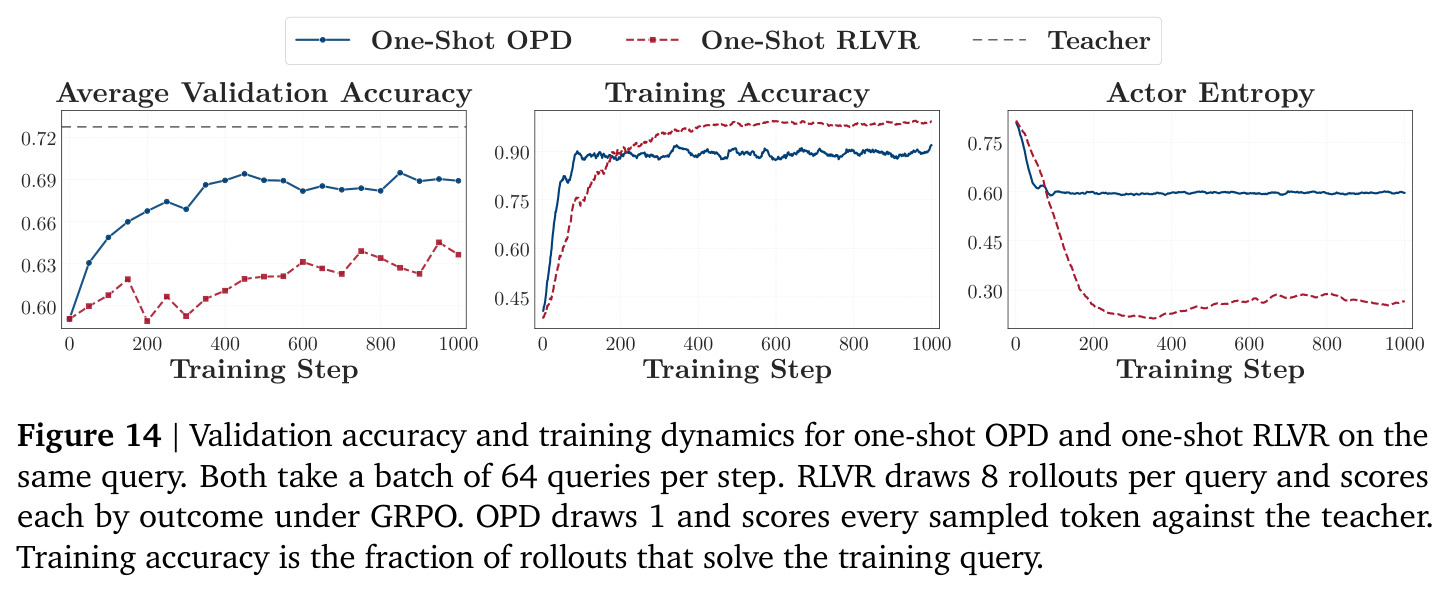
论文第 7.2 节在同一查询上做 one-shot OPD 与 one-shot RLVR 的受控对照,理解 RLVR 稀疏结果奖励的失效方式,才能看懂 OPD 密集信号优势的对比结论。
状态
论文中「状态」指自回归生成的上下文 $s_i=(x,\,y_{<i})$:查询 $x$ 加上已生成的前缀 $y_{<i}$。OPD 的目标函数定义在每个状态上,教师在每个状态处给出下一 token 分布监督。由于每个生成 token 都产生一个新前缀,一条查询的 64 条 rollout、每条数千 token,就能产生数万个带监督的状态——这是「单条查询监督天然过剩」直觉的基础。
「状态覆盖」是本文解释数据侧现象的核心度量,全部论证围绕「查询诱导了哪些状态」而非「收集了多少题」展开。
KL 散度与 top-k 优势估计
KL 散度衡量两个分布的差异。OPD 在每个访问状态上对齐学生与教师的下一 token 分布,除采样 token 估计外还有 top-$k$ 形式:保留学生最高概率的 $k$ 个 token,按学生概率加权教师-学生对数概率差(本文数学域取 $k=16$),以牺牲分布尾部换取更低方差。论文的对齐诊断(距离、吸收率、top-16 overlap 比率、overlap-token 优势)都由两策略的对数概率差计算而来。
读懂实验设置中「数学用 top-16 优势、其余用采样优势」的区别,以及各对齐指标的含义,都必须先掌握这两种估计器。
多教师在线蒸馏(MOPD)
MOPD 在一次训练中让单个学生同时学习多个领域(数学、代码生成、指令遵循),每条查询被路由到对应领域的专家教师,Qwen3、DeepSeek-V4 等前沿后训练采用此形式。它比单域 OPD 更接近真实生产流水线,但也让数据需求问题更复杂:每个领域各需要多少查询?
第 6 节把 one-shot 结论推广到 MOPD,证明每域 16 条语义多样查询即可匹配全量,是结论走向实用数据配方的关键一步。
研究动机
On-policy 蒸馏(OPD)已成为 Qwen3、GLM-5、DeepSeek-V4、Kimi K3 等前沿模型后训练的标配组件,但现有研究几乎全部集中在算法层面——更新几何、可学习 token 分析、失败模式修复——训练数据如何塑造 OPD、数据与算法如何交互此前完全空白。实践中 OPD 通常用上万条查询训练数百到上千步:数学域的 DAPO-Math-17K 有 1.7 万题,却没有人回答「到底需要多少数据」这一最基本的问题。RLVR 一侧已有 one-shot RLVR 实验证明单条题目可持续训练上千步,但 OPD 在学生访问的每个 token 前缀都获得教师分布的密集监督,与 RLVR 的稀疏结果标量奖励机制截然不同,其数据下限可能完全不同——这一关键问题从未被验证。
本文的目标是本文用「数据最小化极限」的受控实验回答单一问题:为什么 OPD 在仅一条训练样本上反复训练数百步仍能持续提升、并取得大幅收益?标准训练把「能学多久」(算法吸收监督的速度)与「能提升多少」(少量数据为何供足监督)这两个效率维度纠缠在一起,把数据压到最小即可解耦二者。具体目标包括:验证 one-shot OPD 现象在数学推理、代码生成、指令遵循、智能体工具调用四个任务域和 Qwen、Llama、OLMo 三个模型家族上是否稳健;从数据侧提出状态覆盖度量、从算法侧提出吸收率度量,给出机理解释;进而推广到多教师蒸馏(MOPD),并用内容空白模板、域外 WildChat 查询和 one-shot RLVR 同题对照做极限压力测试。
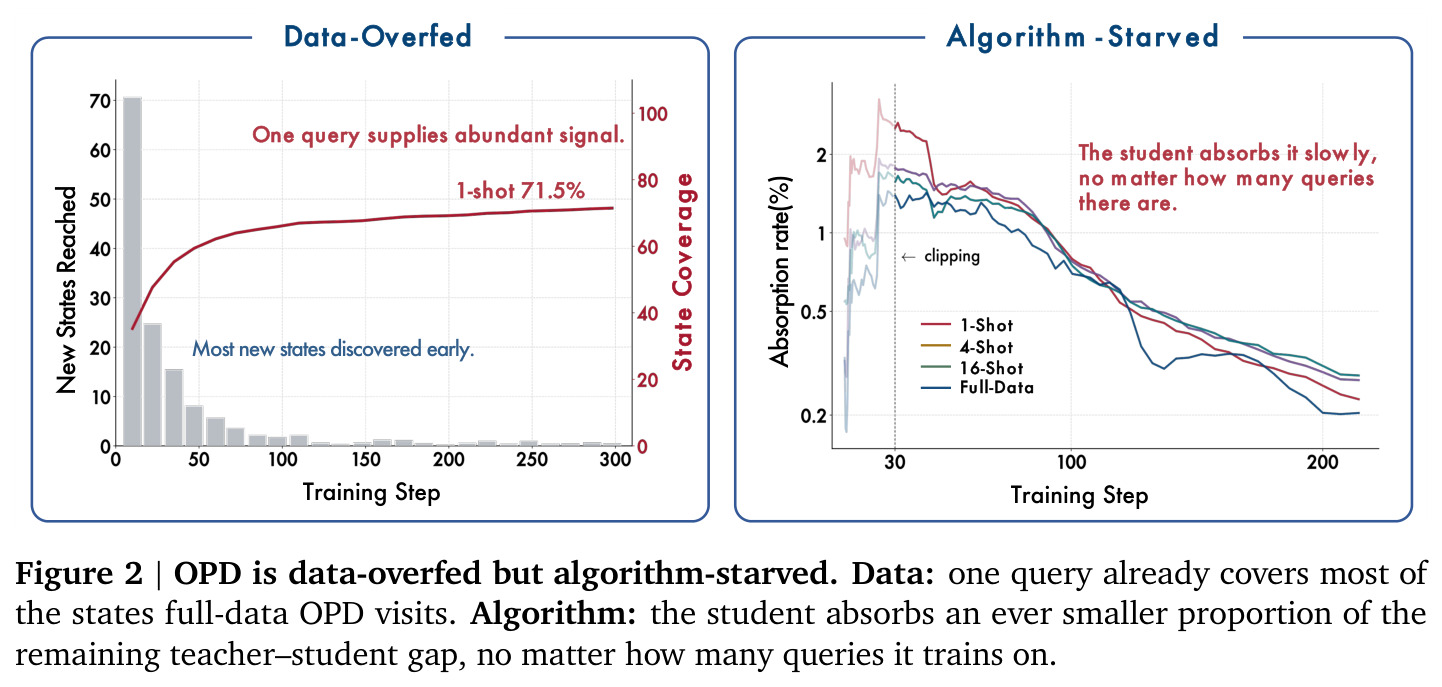
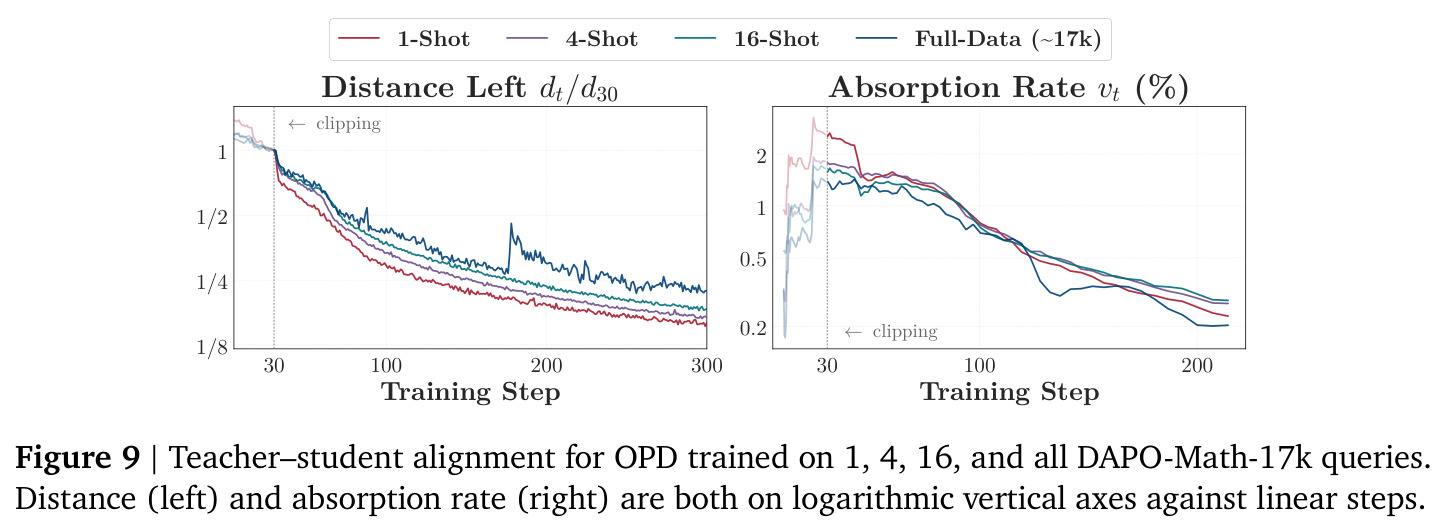
与已有工作不同的是,独特切入是把 one-shot RLVR 的实验透镜首次迁移到 OPD,并发明两个新度量来解耦数据与算法的贡献。数据侧提出「状态覆盖」:把全量 OPD 访问的状态用教师末层隐向量 $h_T(s)$ 表示,PCA 降维后用 $K$-means 聚成 $K=200$ 簇,报告某设置触达的簇比例,把「数据价值」从题目数量/质量重新定义为诱导的状态空间广度。算法侧提出「吸收率」 $v_t=(d_t-d_{t+1})/d_t$,其中 $d_t$ 是学生在步 $t$ 访问状态上教师-学生对数概率差的平均幅值,刻画每次更新消除剩余差距的比例。由此得出「OPD 数据过剩而算法饥饿」的新框架:数据设计问题从「收集多少题」转变为「输入诱导哪些状态」。
核心方法
直觉上一条查询只有一个训练信号,但 OPD 的监督单位是状态:学生自采样 rollout 的每个 token 前缀 $s_i=(x,y_{<i})$ 都配一份教师分布,每步 64 条 rollout × 数千 token 即产生数万个带监督的状态,单条查询的信号天然过剩。技术路线分三步:(1) 极限实验——在数学、代码、指令遵循、智能体四个域用单条查询训练 300–1000 步,与全量数据(17K 题)对比;(2) 数据侧——定义状态覆盖(教师末层隐向量 + PCA + $K$=200 聚类),从轨迹多样性(固定 1/4/16/64 条离策略轨迹)和查询多样性(BGE-M3 语义聚类取 1/4/16 条代表)两个方向做因果消融;(3) 算法侧——追踪教师-学生距离 $d_t$ 与吸收率 $v_t$ 随 1/4/16/全量查询的变化,再用固定状态(离策略)训练检验「新鲜状态供给」是否是长训练的原因。
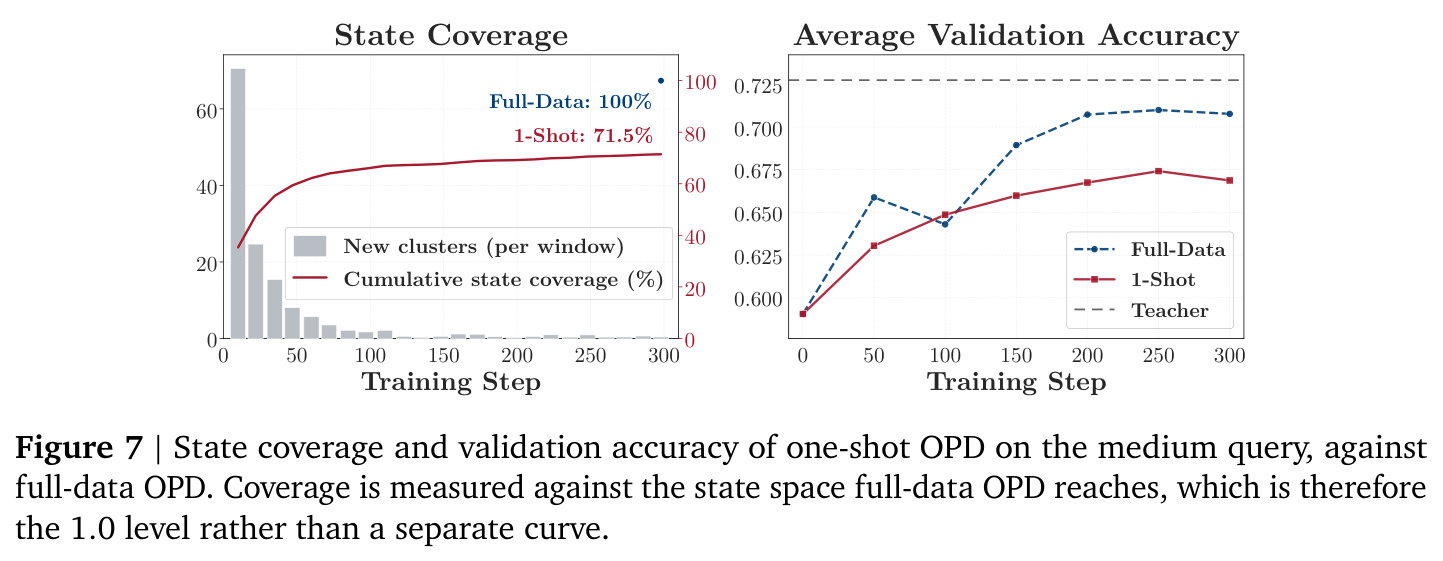
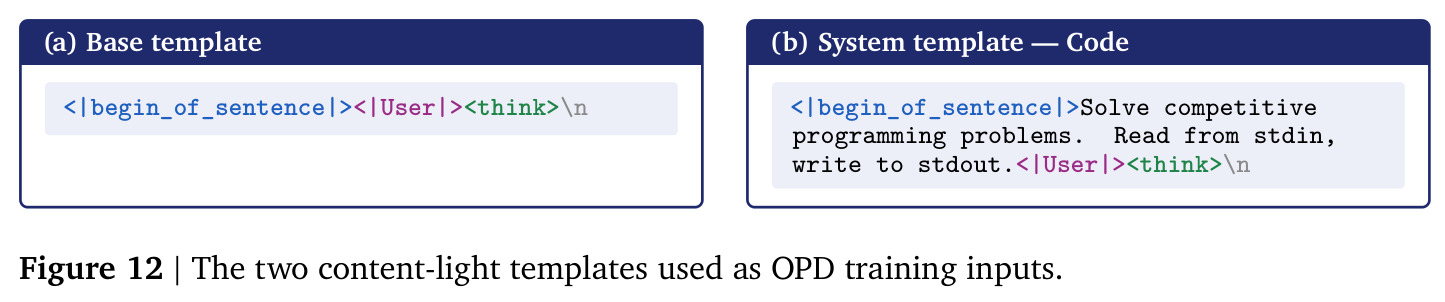
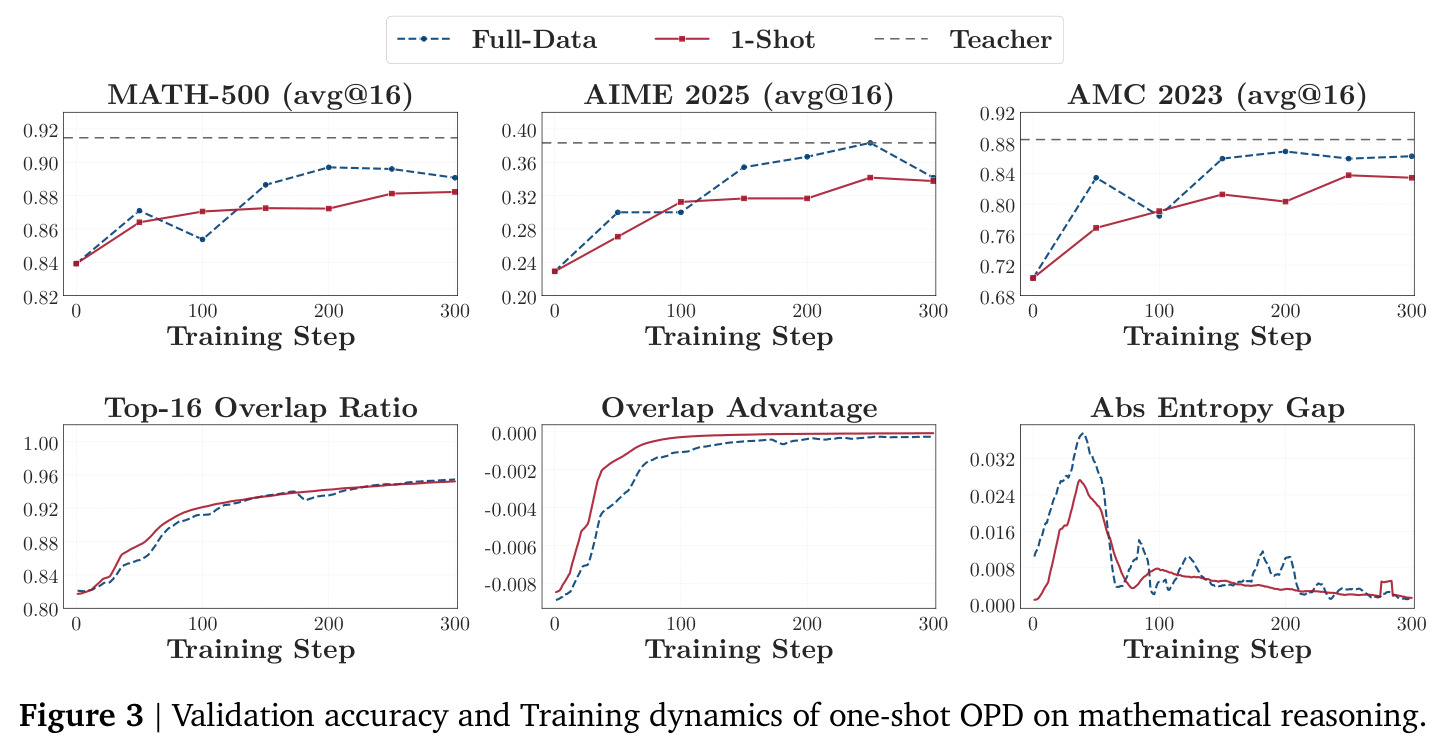
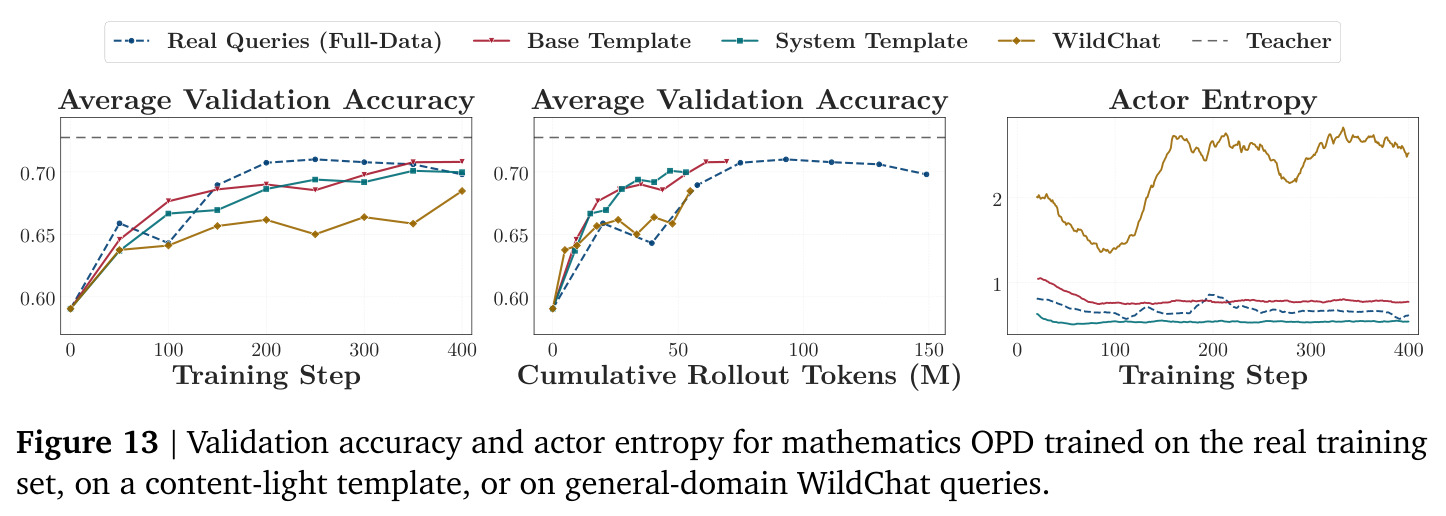
核心创新是视角转换:OPD 消耗的资源是状态而非查询,结论为「数据过剩、算法饥饿」。数据侧,单条查询的 rollout 已覆盖全量 OPD 状态空间的 71.5%(前 100 步即达 65.9%),16 条语义多样查询达 98.9% 并完全追平全量训练——这解释了为什么极少的数据就能带来大幅提升。算法侧,吸收率(每次更新消除剩余师生差距的比例)在 1 条和 1.7 万条查询上以几乎相同的节奏衰减:四组设定 300 步内同样消除步 30 距离的 78%–84%,即训练节奏是 OPD 算法的属性而非数据集属性。与已有方法的本质区别在此显现:one-shot RLVR 的结果奖励在题目几乎全解后即枯竭,而 OPD 的 token 级信号全程存在,同一查询训练 1000 步后 OPD 关闭 72% 的师生差距、验证收益超过 RLVR 两倍。更极端的发现是空白模板与域外 WildChat 也能逼近真实查询基线,说明输入的价值主要是「启动学生推理」而非提供任务内容。
方法步骤详情
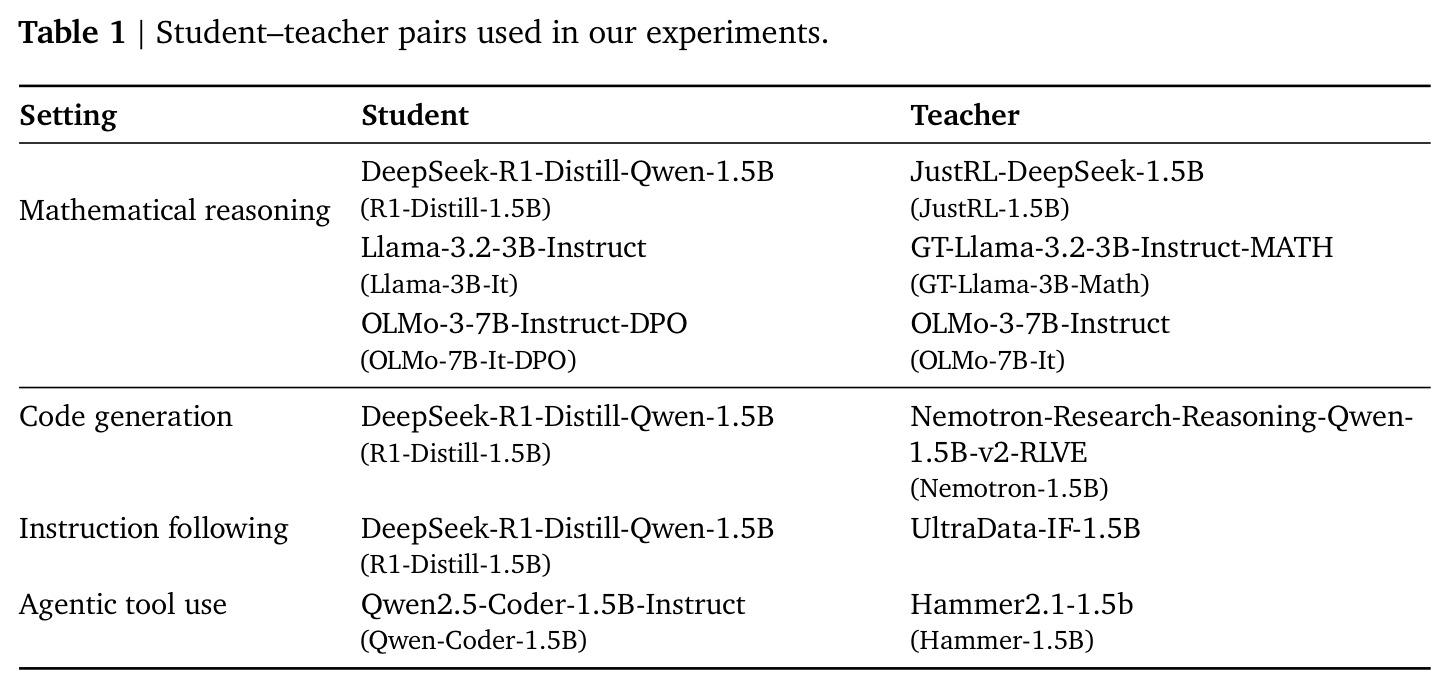
配置:数学域学生 R1-Distill-1.5B 配教师 JustRL-1.5B,另加 Llama-3B、OLMo-7B 两个家族对照;代码域配 Nemotron-1.5B,指令遵循配 UltraData-IF-1.5B,智能体域 Qwen-Coder-1.5B 配 Hammer-1.5B;数据集为 DAPO-Math-17K、Open-R1 Codeforces、UltraData-SFT-2605、xLAM-60K,one-shot 选初始通过率 8/8、4/8、0/8 的易/中/难三题。训练基于 veRL:每步 64 条 rollout,AdamW 学习率 $10^{-6}$,数学用 top-16 优势、其余用采样 token 优势;评估覆盖 MATH-500/AMC/AIME、LCB v6、Multi-IF、BFCL v3。分析流程:难度/长度/温度稳健性消融 → 构建覆盖参考空间(教师隐向量、PCA、$K$=200)→ 轨迹/查询多样性因果消融 → 自步 30 起追踪 $d_t$、$v_t$ → 固定状态离策略对照 → MOPD 与模板/WildChat/RLVR 对照推广。
技术新颖性
新颖性有四点。其一,首次把训练数据作为变量研究 OPD:已有工作(更新几何、可学习 token、失败模式)全部默认训练集给定,本文第一次把它推到单样本极限。其二,提出状态覆盖度量(教师末层隐向量 + PCA + $K$=200 语义聚类),把数据价值量化为诱导状态的广度,并用双重消融(固定查询变轨迹数、语义聚类变查询数)建立了覆盖与精度的因果联系而非仅相关。其三,吸收率分析证明 1 条与 17k 条查询的对齐节奏一致,把「能学多久」归因于算法而非数据,这一反直觉结论重定义了 OPD 的训练瓶颈。其四,内容空白模板与 WildChat 域外聊天查询(19.3 万条中仅 0.17% 数学相关、2.63% 代码相关)也能驱动 OPD,挑战「任务内容必需」的默认假设,与 Self-Instruct、Magpie 等合成数据路线互补——OPD 连查询内容都可放松。
实验结果
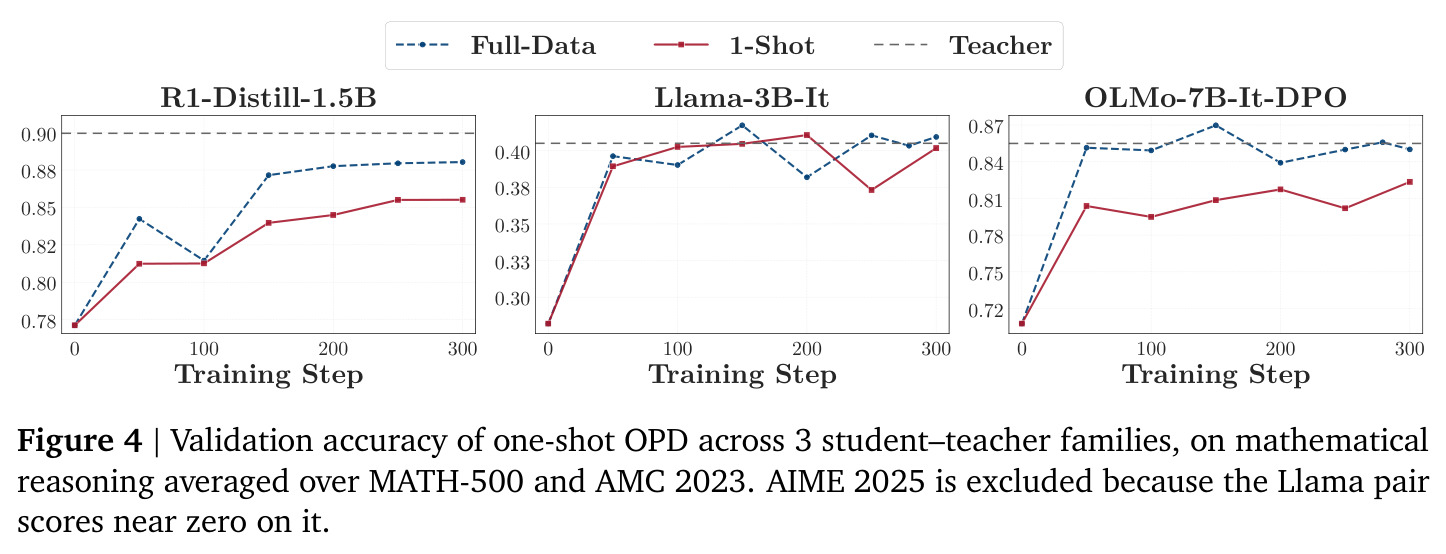
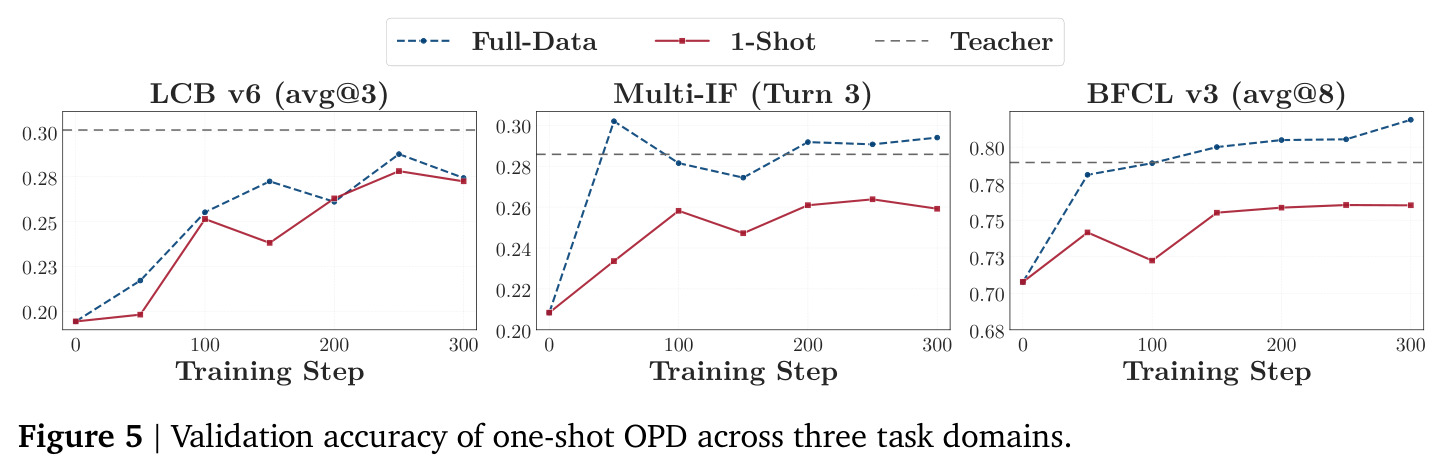
核心发现:(1) 数学域 one-shot OPD 300 步达 68.5(全量 69.8、初始 59.1),恢复师生差距 69%、全量增益 87%;1000 步 68.4 vs 72.1,仍恢复 72%。(2) 跨家族:R1-Distill 77.1→85.5、Llama-3B 28.2→40.2、OLMo-7B 70.8→82.4。(3) 跨域:代码/指令遵循/智能体分别恢复 73%/66%/64% 差距;从未解出的难题与全对简单题同样有效,长度上限与温度均不影响增益。(4) 数据侧:单查询覆盖 71.5% 状态空间,16 条语义多样查询达 98.9% 并追平全量;固定轨迹 1→64 条精度单调升。(5) 算法侧:四组数据规模 300 步内同样消除步 30 距离的 78%–84%;固定状态离策略训练仍增益约 200 步。(6) MOPD:全量 43.5→52.8,16-shot 达 52.9、恢复 101%。(7) 空白模板与 WildChat 逼近真实基线且只用 1/3–1/2 rollout token;同题对照 OPD 千步关闭 72% 差距,收益超 RLVR 两倍。
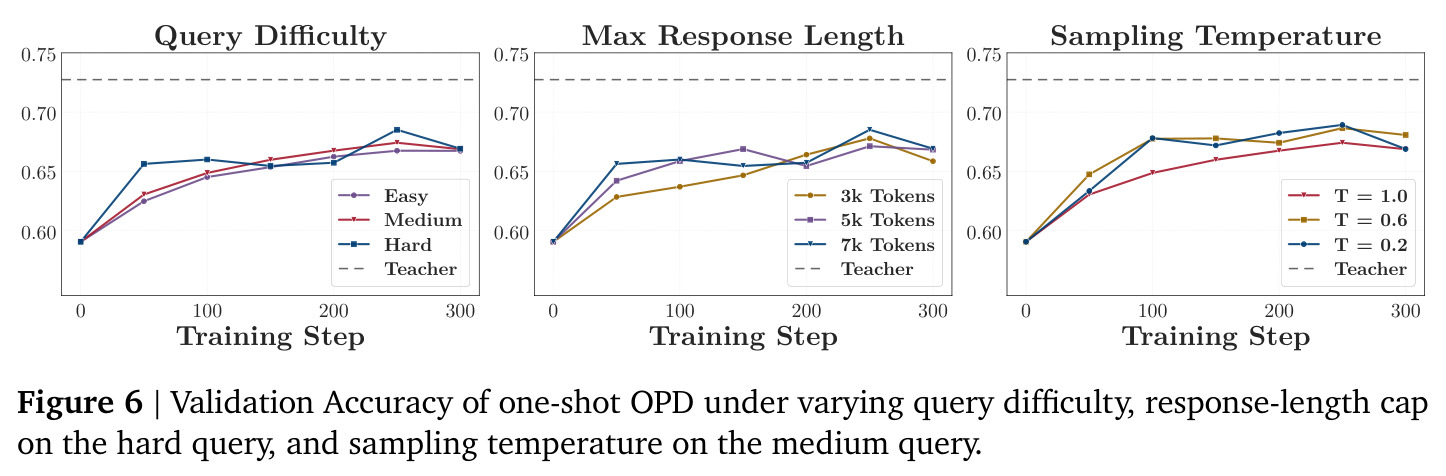
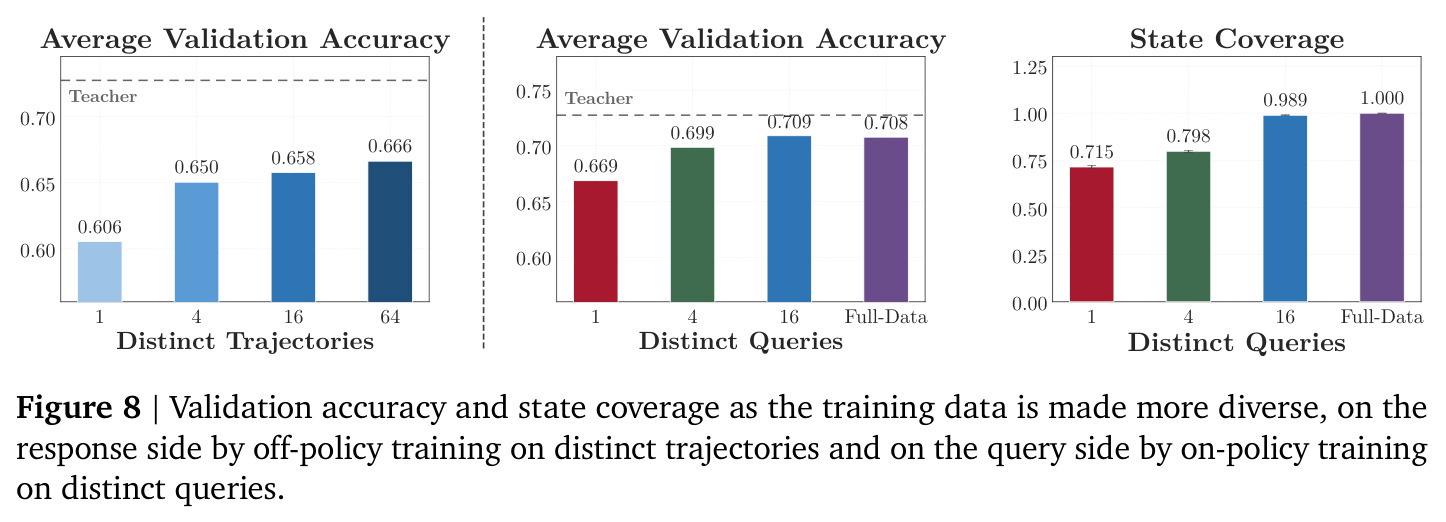
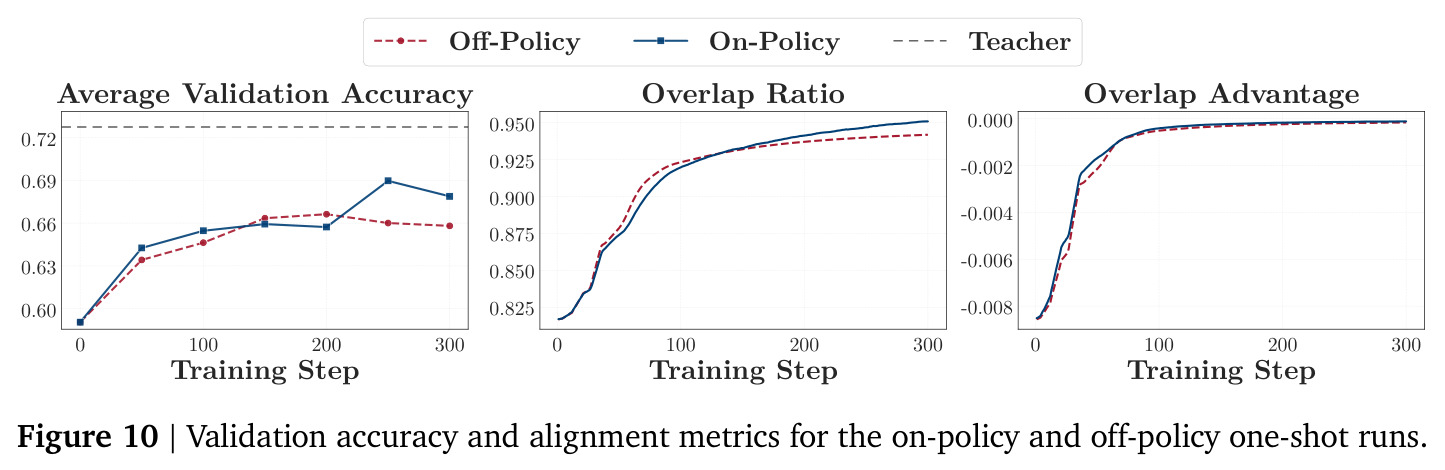
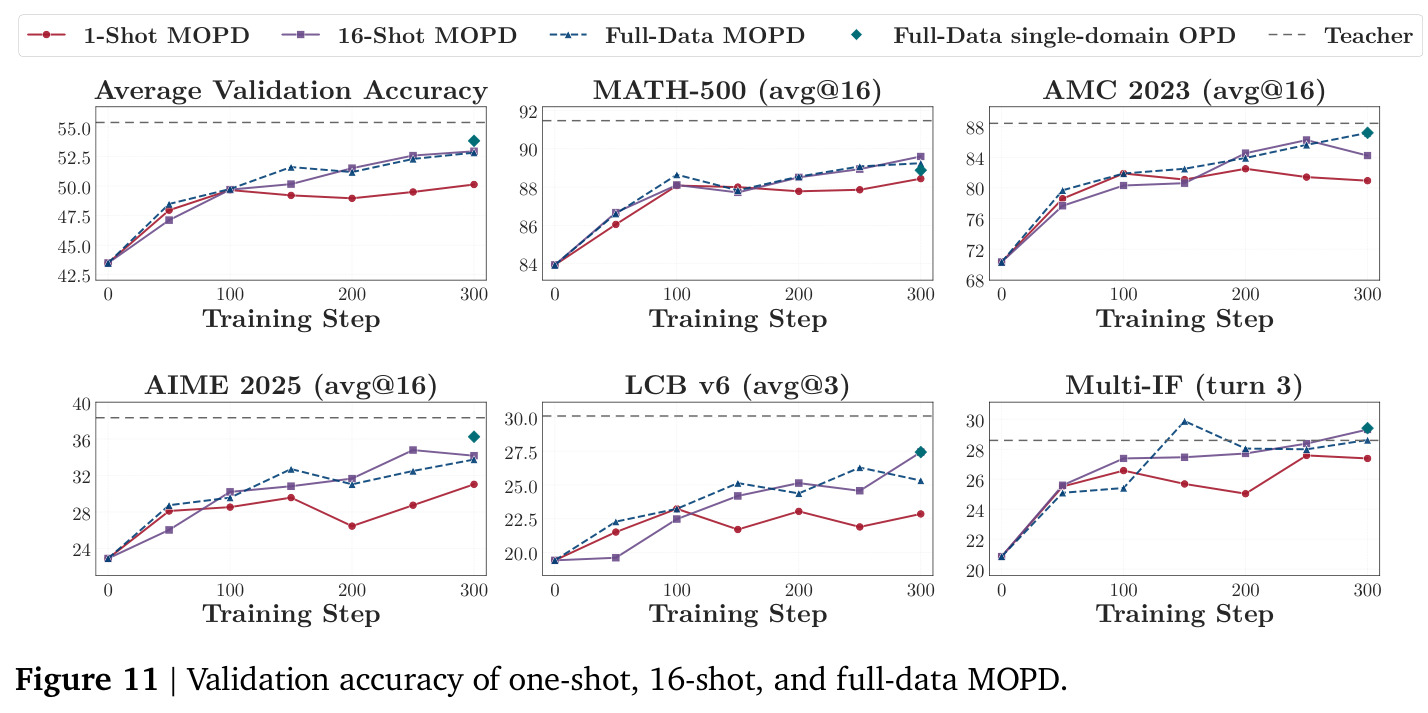
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(MATH-500/AMC 2023/AIME 2025) | avg@16 宏平均准确率 | One-shot OPD 68.5(300 步);1000 步 68.4 | 全量 17K OPD 69.8(300 步)/ 72.1(1000 步);学生初始 59.1 | 恢复全量增益的 87%(300 步)/ 72%(1000 步) |
| 数学推理跨家族(MATH-500+AMC 2023 平均) | 最终检查点准确率 | R1-Distill 85.5 / Llama-3B 40.2 / OLMo-7B 82.4 | 学生初始 77.1 / 28.2 / 70.8 | +8.4 / +12.0 / +11.6 |
| 代码生成 | LiveCodeBench v6 avg@3 | One-shot OPD 持续提升 | 全量 OPD | 恢复师生差距的 73% |
| 指令遵循 | Multi-IF 第三轮得分(8 语言平均) | One-shot OPD 持续提升 | 全量 OPD | 恢复师生差距的 66% |
| 智能体工具调用 | BFCL v3 avg@8 | One-shot OPD 持续提升 | 全量 OPD | 恢复师生差距的 64% |
| 状态覆盖分析(数学域) | 200 簇触达比例 | 1-shot 71.5%;16-shot 98.9% | 全量(held-out)100% | 16 条查询即追平全量覆盖与精度 |
| 多教师蒸馏 MOPD(三域混合) | 平均验证准确率(300 步) | 16-shot MOPD 52.9;1-shot 50.1 | 全量 MOPD 52.8;学生初始 43.5;分域全量 OPD 均值 53.8 | 恢复全量 MOPD 增益的 101%(分域 93%/136%/109%) |
| One-shot OPD vs One-shot RLVR(同题对照) | 1000 步验证增益与师生差距恢复 | OPD 关闭 72% 师生差距 | One-shot RLVR(GRPO,8 rollouts/query) | OPD 验证收益超过 RLVR 两倍 |
局限与改进
作者承认的局限:状态覆盖是语义级代理指标,以全量 run 构建的参考空间为基准,只能报告「触达了全量空间的多少」而非绝对覆盖,且 200 个簇等权——不考虑访问频率和簇内剩余教师信号量;吸收率由什么决定仍是未知;MOPD 实验仅 3 个域各 1 名教师,多样性结论能否随教师数量增长而推广尚不清楚。我的补充观察:(1) 规模受限——学生/教师均在 1.5B–7B 之间,对前沿规模模型是否成立未验证;(2) 数学域用 top-16 优势、其他域用采样优势,两种估计器混用导致跨节比较的绝对精度不完全同构(作者注明略有差异);(3) 覆盖测量依赖教师隐向量与聚类质量($K$=200、PCA),测量本身可能引入偏差;(4) 实用上,估计新查询的覆盖目前需要先跑一次全量 OPD,「按覆盖选数据」的准则尚不可直接使用;(5) OPD 上限受教师分布约束,与 RLVR 对比时作者点到即止,未讨论超越教师或教师集成的可能。
独立分析的弱点
(1) 覆盖度量等权缺陷:一个只被访问一次且教师信号稀薄的簇与高频高信息簇同价,可能高估低质查询的价值。改进:按访问频率或簇内平均师生 KL 加权,构造「信息加权覆盖」。(2) 覆盖不可在线估计:参考空间需先跑完整全量 OPD 并抽取教师末层隐向量,实际数据选择场景成本过高。改进:让教师直接从查询预测其诱导簇分布(作者已提此方向),或用嵌入相似度做廉价代理并校准。(3) 规模与任务外推有限:未测 7B 以上学生、长上下文与更复杂智能体任务。改进:在 7B–32B 上复验吸收率是否随规模变化,观察「算法饥饿」是否加剧。(4) 天花板受限于教师:OPD 训练目标是匹配教师分布,无法超越教师;部署中教师选择成为新瓶颈。改进:OPD 后接 RLVR 微调,或多教师集成估计上界。(5) 崩溃边界刻画不足:以 后立即闭合的模板会塌缩为不可训练的元回复,说明「启动推理」的最低必要条件尚未系统化。改进:系统扫描模板/查询属性,建立最小充分条件理论。
未来方向
作者提出三个方向:(1) 按状态覆盖选择数据——若能不经全量 run、直接从查询本身估计其诱导覆盖,覆盖即可成为数据选择准则;(2) 提升步效率——在 per-token 差距的信任域内把同一 batch 复用多个 epoch,或按教师剩余信号量加权 token,直接攻克「算法饥饿」这一瓶颈;(3) 扩展设定——更多教师与领域的 MOPD、更大规模学生、智能体工具使用和长上下文等数据最昂贵的场景。基于本文成果还可延伸:把「每域 16 条语义多样查询」配方在生产级 MOPD 流水线中做成本-收益验证;研究吸收率的决定因素(优化器、学习率调度、架构、师生规模比)以设计加速收敛的更新规则;既然数据只需启动推理,「教师选择」成为数据设计的核心,可研究教师能力与多样性如何决定状态空间质量;状态覆盖还可用于课程学习排序与师生分布不匹配的诊断工具。
复现评估
复现条件较好。代码开源(GitHub:Thinking-Space/One-Shot-OPD);数据全部公开(DAPO-Math-17K、Open-R1 Codeforces、UltraData-SFT-2605、xLAM-60K、WildChat);模型均为公开权重(R1-Distill-Qwen-1.5B、Qwen2.5-Coder-1.5B-Instruct、Llama-3.2-3B-Instruct、OLMo-3-7B 及对应教师)。训练基于 veRL 框架,1.5B 级模型、batch 64、学习率 $10^{-6}$、300–1000 步,单节点多卡即可完成主实验,超参数在附录表格给出。难点有三:状态覆盖分析需先跑一次全量 OPD 构建参考空间并抽取教师末层隐向量;对齐指标估计有细节约定(自步 30 起、在几何窗口 $[t/1.4,\,1.4t]$ 上估计 $v_t$),需按附录 C.1 实现;数学域与其余域使用不同优势估计器,复现绝对数字时要做节内同构比较。总体复现难度中低,算力需求中等,结论有多组对照支撑,稳健性较高。
论文图表
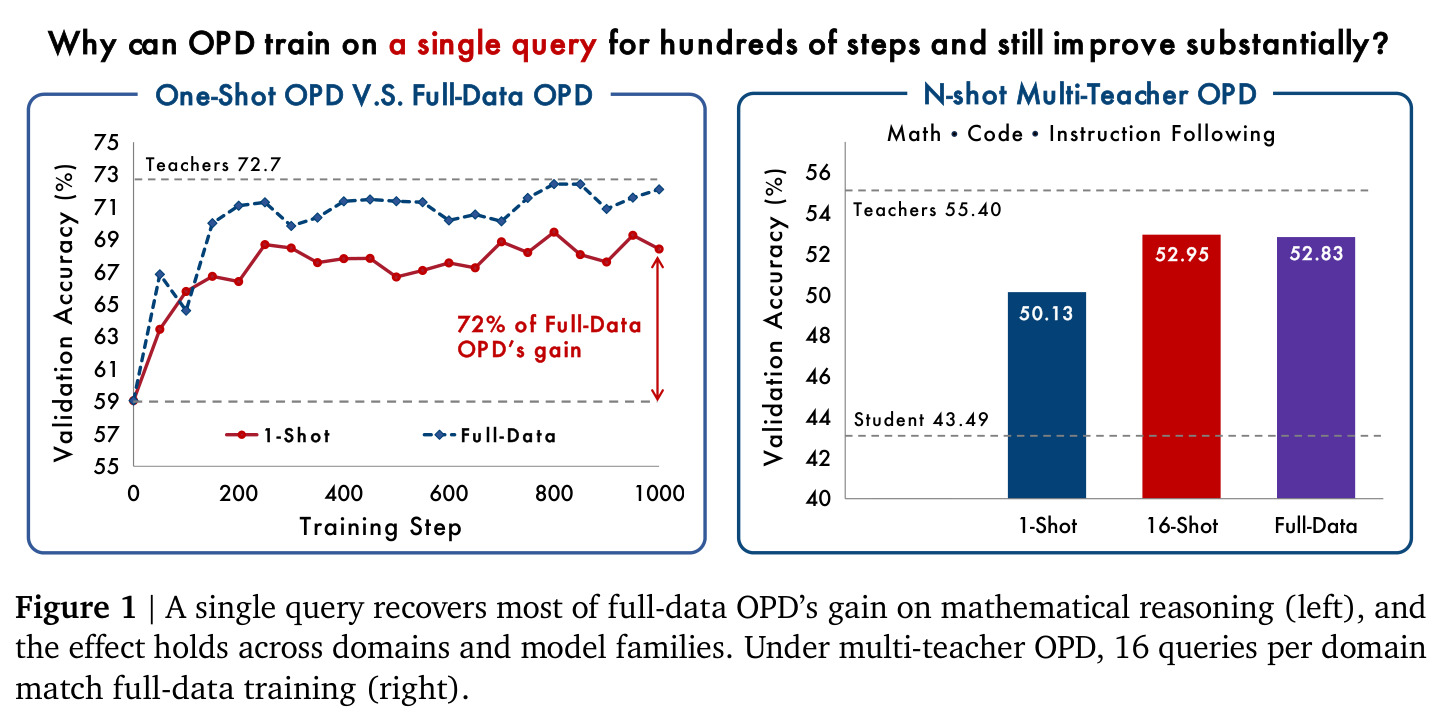
左图:数学推理上单查询(1-Shot)与全量数据(Full-Data)的训练曲线几乎重合,1000 步时教师 72.7、全量 72.1、one-shot 68.4,单查询取得全量 72% 的增益。右图:多教师设定下数学/代码/指令遵循三域混合训练,学生初始 43.49,每域 16 条查询达 52.95,教师 55.40,逼近全量水平。
一图概括全文两大核心结论:one-shot 现象本身,以及「每域 16 条查询」的实用数据配方,是论文的电梯陈述。