StableVQ:稳定向量量化分词器训练的实用准则 StableVQ: Practical Guidelines for Stable Vector-Quantized Tokenizer Training
解耦编码器与码本的训练目标,用三项免参数技术实现稳定且满利用率的VQ训练
前置知识
向量量化(VQ)与 VQ-VAE
VQ-VAE 用编码器把图像映射为连续特征图 $z=E(x)\in\mathbb{R}^{H\times W\times d}$,再对每个空间位置在可学习码本 $\{e_k\}_{k=1}^K$ 中做最近邻查找 $k^*=\arg\min_k\|z_{ij}-e_k\|_2^2$,用选中的码字替换该特征,从而把图像压缩成离散 token 序列,供自回归或掩码生成模型使用。
本文的全部讨论都围绕 VQ 训练的损失分解与码本行为展开,不理解量化查找与码本更新机制,就无法看懂论文对失败模式的诊断。
码本坍缩
训练中大多数码字从未被选中(每步只有被选中的码字收到梯度,作者称之为梯度稀疏),模型容量被严重浪费。表现为利用率长期低迷或中途骤降,是 VQ 训练最著名的病症,催生了码字重置、低维嵌入与归一化、软化分配、共享投影等大量补救方案。
StableVQ 的核心目标就是把'满利用率'从脆弱的启发式结果变成可保证的性质,理解坍缩机理是读懂三个组件动机的前提。
直通估计器(STE)
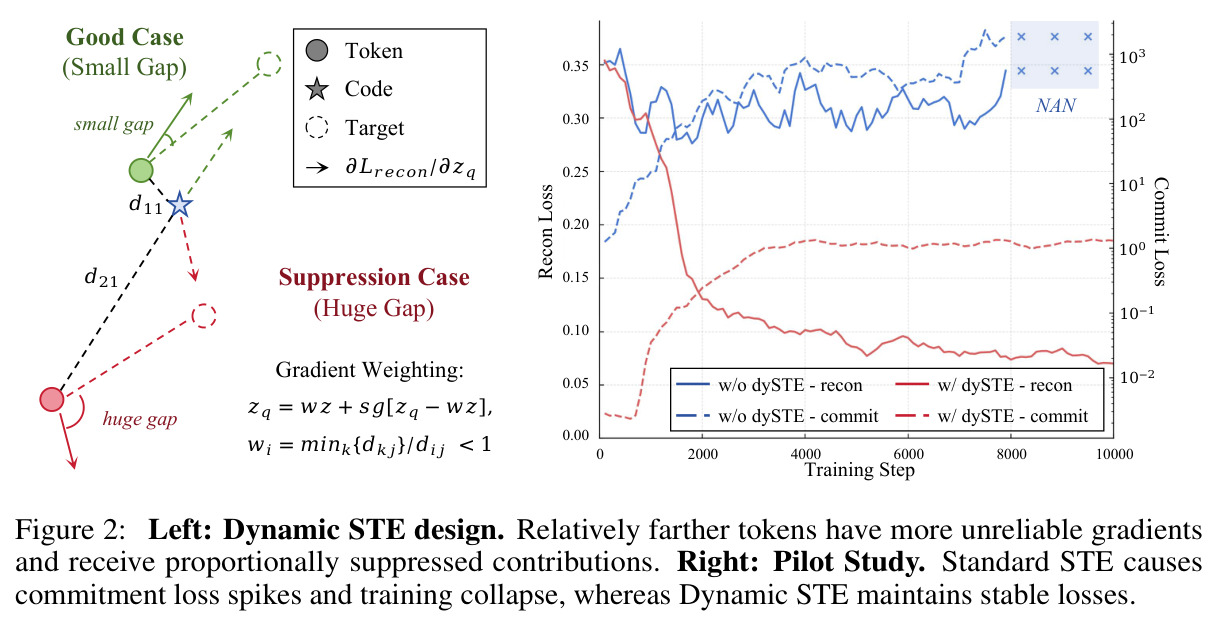
argmin 量化操作不可微,STE 用恒等近似 $\partial\mathcal{L}/\partial z_{ij}\approx\partial\mathcal{L}/\partial\hat{z}_{ij}$ 让重建梯度绕过量化直接回传给编码器。它简单有效,但当 token 被分配到很远的码字时,这个梯度是对真实重建方向的失真估计,可能毒化编码器训练甚至引发 NaN。
Dynamic STE 正是对标准 STE 的按质量加权改造,是本文三大组件之一,必须先懂 STE 的原理与缺陷才能理解其修正逻辑。
共享投影码本
把码字重参数化为 $\tilde{e}_k=f_\theta(e_k)$,$f_\theta$ 是所有码字共享的可微函数(如 VQGAN-LC 的仿射变换、SimVQ 的线性层、FVQ 的 ViT Block)。任一码字被选中时梯度都会经 $f_\theta$ 影响全部码字,把 VQ 训练变成投影码分布与编码器输出分布的分布对齐问题。
StableVQ 明确构建在这条技术路线之上,所有实验均以共享投影方法 SimVQ、FVQ 为基线,不了解它就无从理解对比与改进点。
研究动机
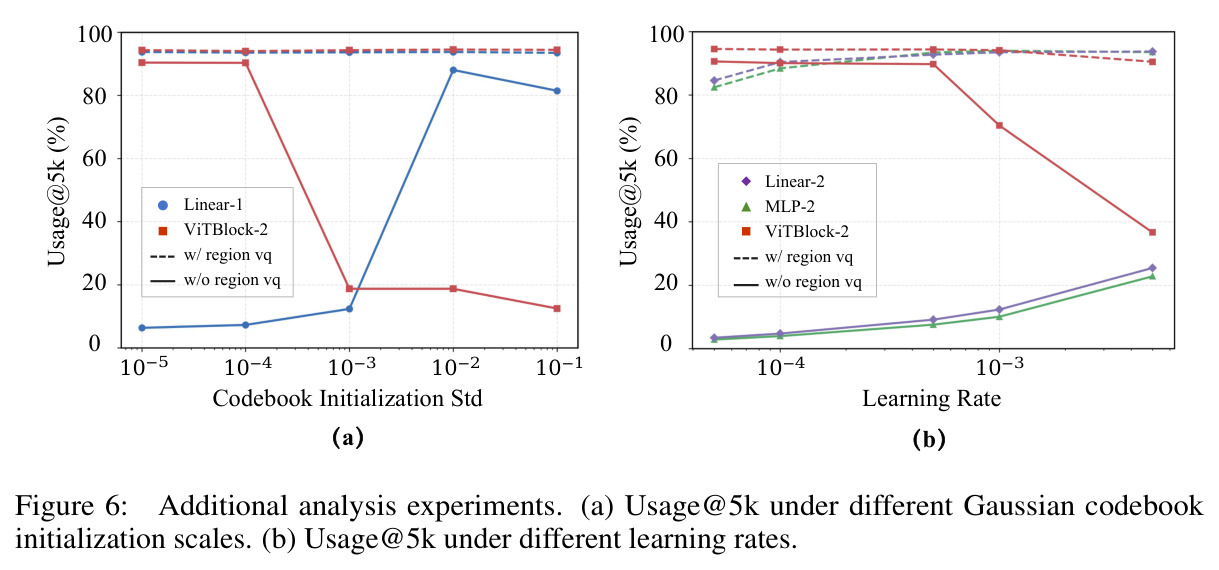
向量量化是自回归与掩码图像生成模型视觉分词器的基石,但训练长期不稳定:收敛对初始化极其敏感、码本可能长期停滞在低利用率、训练中途还会突发利用率坍缩甚至 NaN 崩溃。近期共享投影方法(SimVQ、FVQ、VQ-STE++)通过 $\tilde{e}_k=f_\theta(e_k)$ 让梯度传播到所有码字,大幅提升利用率,却仍未解决稳定性问题。论文归纳出三类典型失败模式:(a) 码分布尺度远小于 token 分布时,系统陷入持续低利用率,commitment loss 尖峰可升级为 NaN 梯度;(b) 码分布尺度远大于 token 分布时,利用率快速上升后训练信号饱和,大量码字永久死亡(Table 1 中 LlamaGen 的 16,384×256 码本利用率仅 0.29%);(c) 尺度发散时,错误的 STE 梯度会放大而非纠正偏差,形成正反馈导致瞬时坍缩。作者指出这些失败的共同根源是 Encoder–Decoder 与 Codebook 训练相互纠缠,谁都无法独立履行自己的职责。
本文的目标是本文的目标是让 VQ 分词器训练摆脱对脆弱的模块间配合与启发式设计的依赖,实现有原则的稳定训练。具体而言:其一,让每个模块(Encoder–Decoder 与 Codebook)都能独立、可靠地完成自己的学习目标,而不是靠偶然配合才让系统工作;其二,方法必须轻量、不引入任何可学习参数,可直接叠加在现有共享投影码本之上;其三,在不同码本规模(16,384 到 262,144)与不同初始化设置下都保持 100% 码本利用率和领先重建质量,让单一线性投影就足以达到 SOTA,消除对投影器架构设计(如 FVQ 要求码本大小为完全平方数)和启发式初始化的依赖,从而把 VQ 的完整表达潜力释放出来。
与已有工作不同的是,本文的独特之处在于用'关注点分离'的软件工程视角重新诊断 VQ 训练:不把不稳定当作量化范式的固有限制,而是视为模块职责失守的症状。此前的 Wasserstein VQ 等工作只分析 token 分布与码分布之间的静态关系,本文进一步考察训练过程中分布关系如何动态演化、由什么驱动,把三种失败模式统一追溯到'纠缠的训练掩盖了各模块的潜在功能障碍'这一结构性根源——纠缠使得每个模块的缺陷都被对方的补偿行为遮蔽,只有当训练压力最大时才集中爆发。这一角度让三项干预(修正 Encoder 目标的 Dynamic STE、重构 Codebook 目标的 Region VQ Loss、承认两者需要不同优化动力学的 Decoupled Schedule)全部从第一性原理推导出来,而非启发式补丁。
核心方法
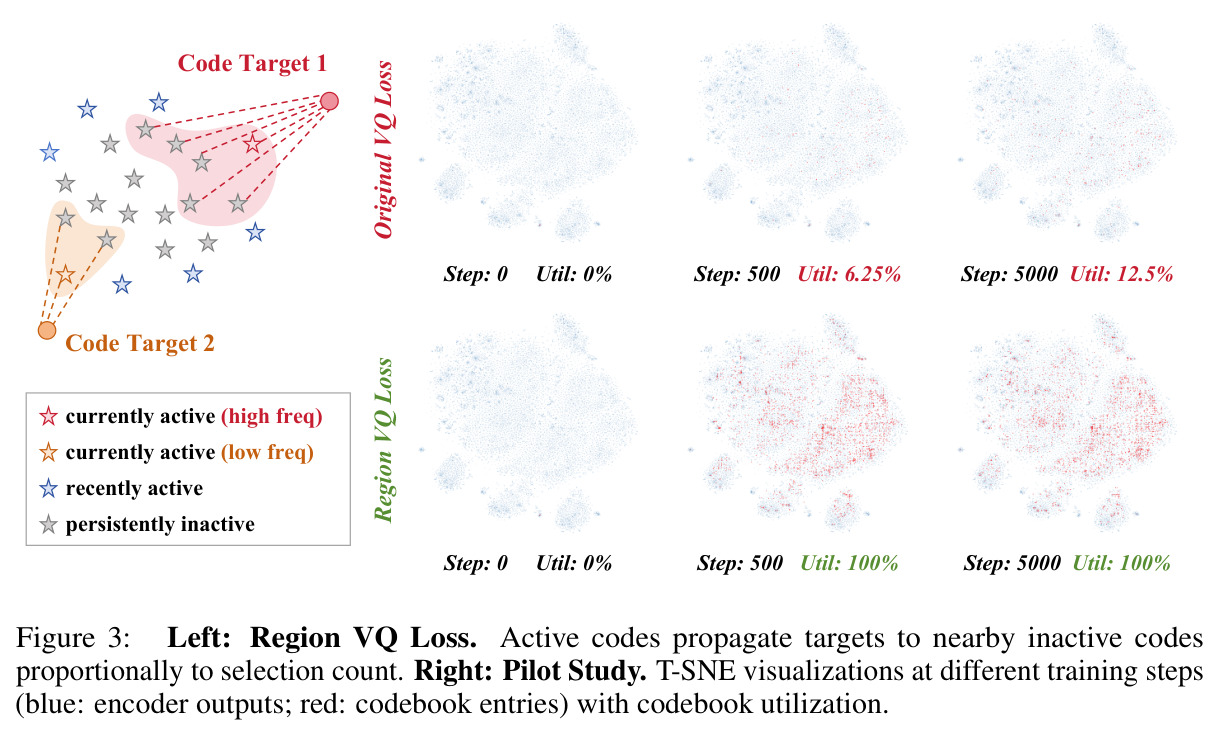
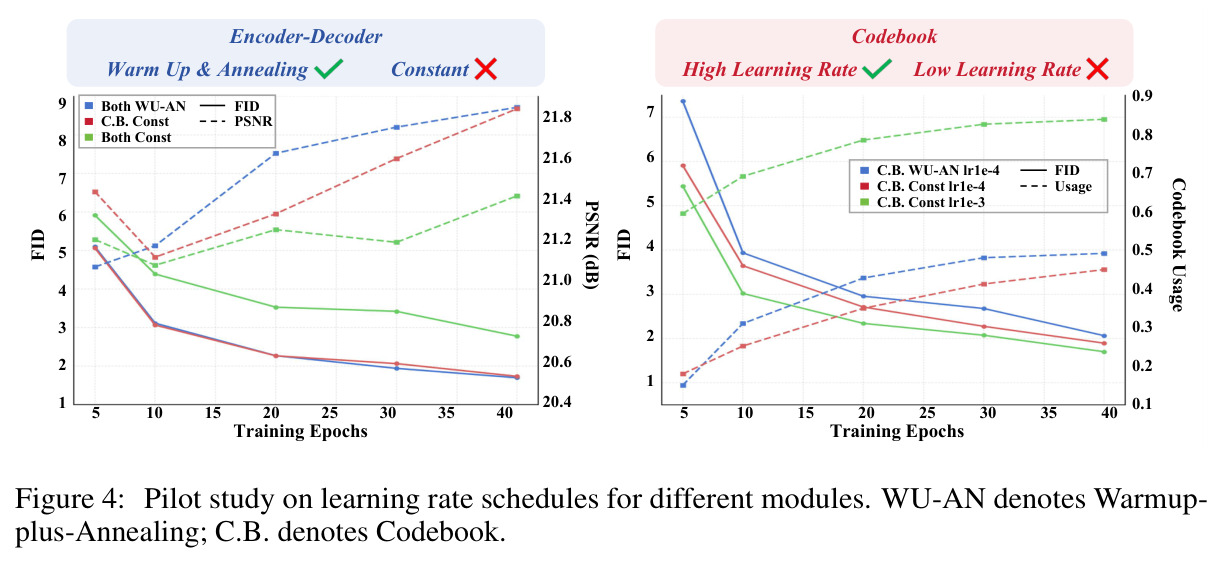
StableVQ 建立在共享投影码本之上,直觉是:让每个模块独立胜任本职工作,系统级稳定便会自然涌现。技术路线分三步。其一,Dynamic STE 修正 Encoder 的学习目标:标准 STE 用 $\partial\mathcal{L}/\partial z_{ij}\approx\partial\mathcal{L}/\partial\hat{z}_{ij}$ 把重建梯度穿过量化层,但当 token 被分配到很远的码字时该梯度不可靠,会与 commitment loss 冲突甚至引发 NaN;Dynamic STE 按 token 到其码字的相对距离加权衰减这些不可靠梯度。其二,Region VQ Loss 重构 Codebook 的学习目标:标准 VQ loss 只直接监督当前被选中的码字,多数码字缺少明确目标;Region VQ 让活跃码字按选中次数把目标传播给邻近不活跃码字,使每个码字都有明确学习方向。其三,Decoupled Schedule 为两模块分配独立学习率调度:Encoder–Decoder 用 warmup 加退火,Codebook 用恒定高学习率。三个组件全部免参数、无阈值超参。
核心洞察是'纠缠掩盖功能障碍':现有训练中,Encoder 的 STE 梯度在量化误差大时变成毒药,Codebook 在标准 VQ loss 下缺乏全量监督,两者却靠彼此的振荡侥幸协作——一旦训练压力增大(码本初始化过小、过大或分布突变),协作即告破裂,系统崩溃。与已有方法的本质区别在于:SimVQ 靠恒定学习率维持满利用率但牺牲退火带来的质量(rFID 仅 2.89),FVQ 靠精心设计的两层 ViT Block 投影器维持利用率且码本大小必须是完全平方数,都是在架构或调度上做启发式补偿;StableVQ 则直接给每个模块一个自洽的学习目标——Encoder 在离散正则下稳健优化重建空间,Codebook 独立保证完整追踪 encoder 输出分布——并用动态加权让干预在训练健康时自动失效:当所有 token 都良好匹配码字时 $w_{ij}\approx 1$,Dynamic STE 退化为标准 STE。
方法步骤详情
基础设定:编码器 $E$ 把图像映为特征图 $z=E(x)$,每个空间位置最近邻查码本得 $\hat{z}_{ij}=e_{k^*_{ij}}$,总损失 $\mathcal{L}=\mathcal{L}_{recon}+\beta\|z-\text{sg}[\hat{z}]\|_2^2+\|\text{sg}[z]-\hat{z}\|_2^2$,码字经共享投影 $f_\theta$ 重参数化。第一步 Dynamic STE:计算权重 $w_{ij}=\text{sg}[d^*_{k^*_{ij}}/\|z_{ij}-f_\theta(e_{k^*_{ij}})\|_2^2]\in(0,1]$,$d^*_k$ 为码字 $k$ 到批内最近 token 的最小平方距离,再以 $\hat{z}_{ij}=w_{ij}\cdot z_{ij}+\text{sg}[\hat{z}_{ij}-w_{ij}\cdot z_{ij}]$ 调制直通梯度:最佳匹配 token 保留完整梯度,其余按相对量化误差衰减。第二步 Region VQ Loss:用长度 $W$ 的 FIFO 队列划分窗口活跃集 $A_t$ 与持续不活跃集 $N_t$,被选码字集 $S_t$ 按配额 $q_k\propto n_k$ 把目标传播给最近的 $q_k$ 个不活跃码字,损失为 $\mathcal{L}_{code}=\frac{1}{|M_t|}\sum_{k\in M_t}\|f_\theta(e_k)-\text{sg}[t_k]\|_2^2$。第三步 Decoupled Schedule:Encoder–Decoder 用 warmup+退火(峰值 $10^{-4}$),Codebook 用恒定 $10^{-3}$。
技术新颖性
技术新颖性体现在三点。(1) Dynamic STE 的权重 $w_{ij}$ 以'批内该码字的最佳匹配 token'为参照,保证最佳匹配 token 获得完整梯度、其余按相对量化误差衰减,天然自失活且无需人工阈值,是对 STE 的首个按样本量化质量的动态调制方案。(2) Region VQ 把逐点对齐升级为分布对齐:用 FIFO 窗口区分'当前活跃/最近活跃/持续死亡'三类码字,只向真正需要救援的码字注入目标,并让活跃码字按使用频率分配传播配额 $q_k\propto n_k$——这避开了'所有码字都取最近 token 当目标'这一朴素方案的两大缺陷(方向错误、计算浪费)。(3) Decoupled Schedule 首次用受控消融证明退火调度只属于 Encoder(把 Codebook 换成恒定学习率不掉点),把先前'利用率与质量不可兼得'的矛盾归因于调度耦合。全部组件零新增参数,单层线性投影即可达到 SOTA。
实验结果
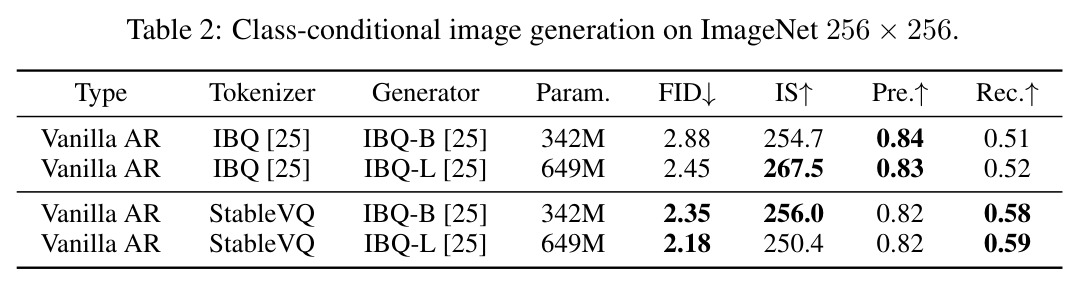
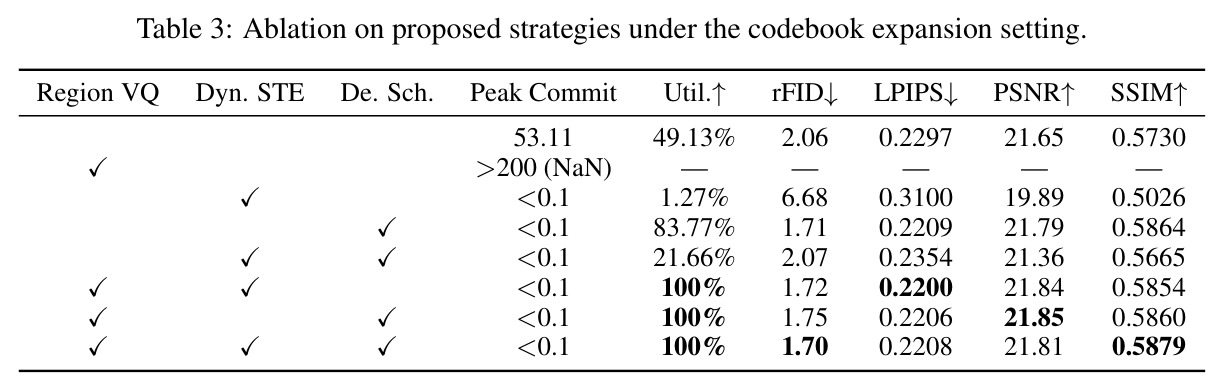
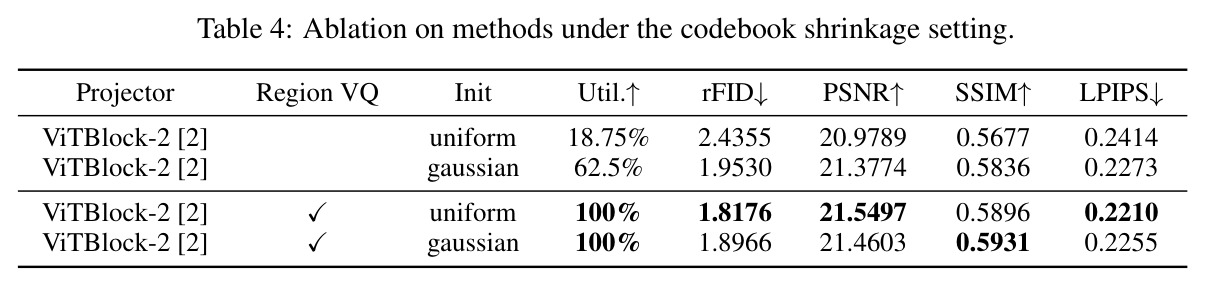
主实验在 ImageNet 256×256、VQGAN 式编解码器(下采样 16,每图 256 token)上进行。重建(Table 1):StableVQ 仅用单层线性投影,40 epoch 时 16,384×256 码本 rFID 1.22、262,144×256 码本 rFID 1.05、LPIPS 0.1947,利用率均 100%,优于 FVQ 的 1.70/1.29(需两层 ViT Block 投影器)与 SimVQ 的 2.89/3.16;120 epoch 后大码本 rFID 降至 0.92。鲁棒性 UR-AUC:StableVQ 60.59±1.52,远超 FVQ 8.08±0.24 与 SimVQ 2.17±0.32(Figure 5),可在各种码本-token 失配下快速恢复满利用率。生成(Table 2):StableVQ token 训练类条件 AR transformer,IBQ-B 生成器 FID 2.88→2.35,IBQ-L 2.45→2.18,召回率 0.51/0.52→0.58/0.59。消融(Table 3,码本扩张):仅 Region VQ 会 NaN(峰值 commitment >200),仅 Dynamic STE 利用率 1.27%,仅解耦调度 83.77%,Region VQ+Dynamic STE 达 100%,三项齐全 100% 且 rFID 1.70、SSIM 0.5879。消融(Table 4,码本收缩):FVQ 均匀/高斯初始化利用率仅 18.75%/62.5%,加 Region VQ 后双双 100%。隔离实验(Figure 2/3):冻结码本时标准 STE 发散到 NaN;冻结编码器时标准 VQ loss 5000 步利用率仍停在 12.5%,Region VQ 500 步即满利用。
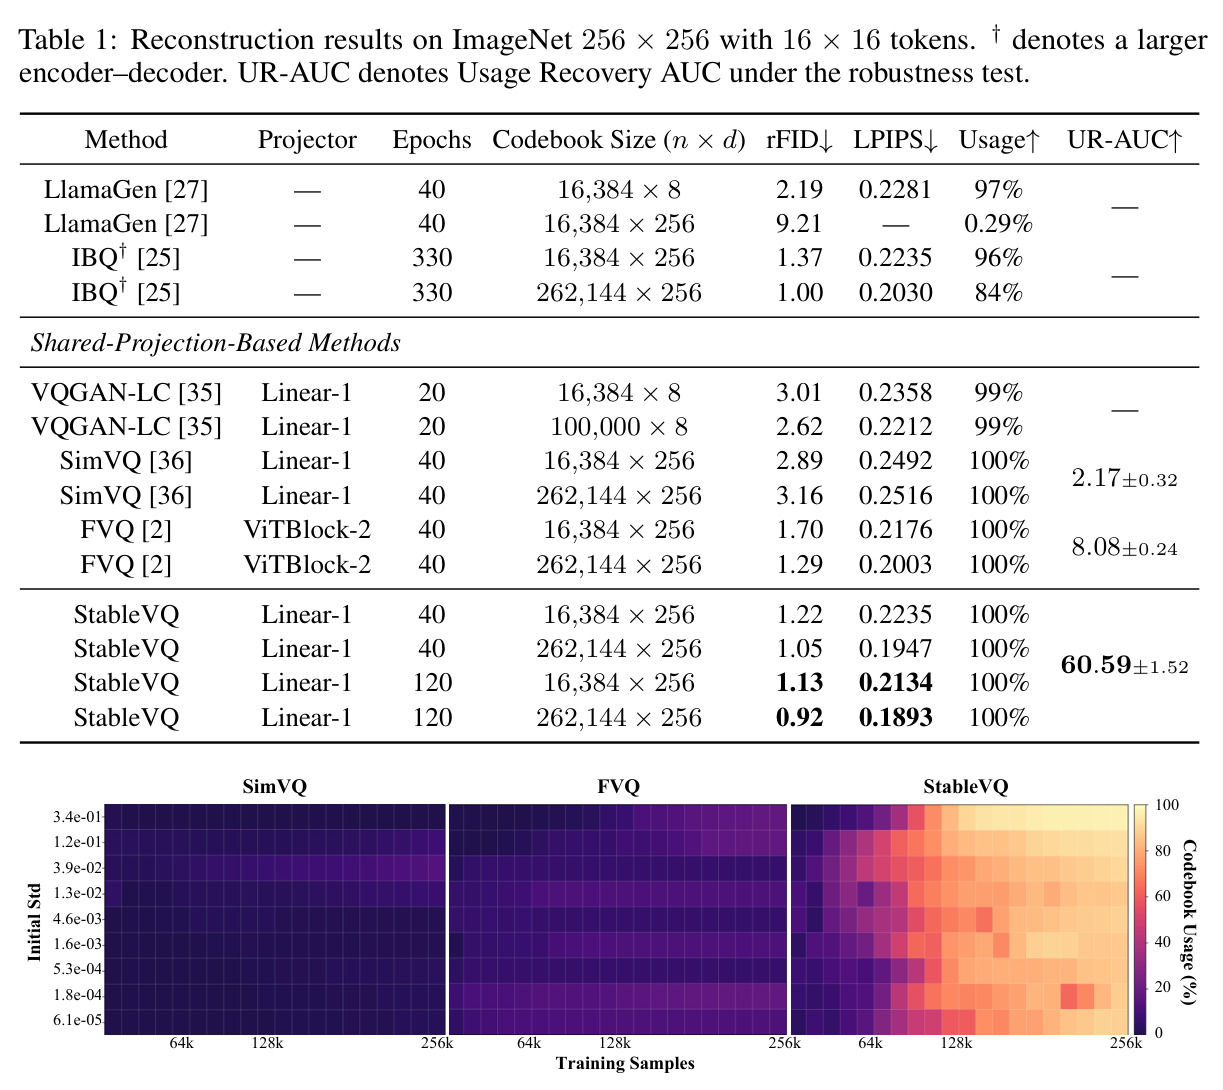
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet 256×256 图像重建(262,144×256 码本,40 epoch) | rFID↓ | 1.05 | FVQ 1.29 / SimVQ 3.16 | 较 FVQ 降低约 18.6%,较 SimVQ 降低约 66.8%,且仅用单层线性投影 |
| ImageNet 256×256 图像重建(16,384×256 码本,40 epoch) | rFID↓ | 1.22 | FVQ 1.70 / SimVQ 2.89 | 较 FVQ 降低约 28.2%,较 SimVQ 降低约 57.8% |
| 码本-token 分布失配下的鲁棒性测试 | UR-AUC↑ | 60.59±1.52 | FVQ 8.08±0.24 / SimVQ 2.17±0.32 | 约为 FVQ 的 7.5 倍、SimVQ 的 28 倍 |
| ImageNet 256×256 类条件生成(IBQ-L 生成器,649M 参数) | FID↓ | 2.18 | IBQ tokenizer 2.45 | 降低 0.27,召回率 0.52 提升至 0.59 |
| 码本利用率(含扩张/收缩/失配等困难设定) | Usage↑ | 100%(各设定均满利用) | FVQ 收缩设定下 18.75%–62.5% | 任意初始化与码本规模下均可保证满利用率 |
局限与改进
局限方面:作者承认框架目前主要在 ImageNet 256×256 的重建与类条件生成上验证,未涉及更高分辨率、视频 tokenizer 或多模态场景,而动机部分恰恰提到了多模态语言模型;作者也说明基线 SimVQ/FVQ 为自行复现并用在线重建管线评估,可能与其他报告数字有出入。我的观察是:Region VQ 需要 FIFO 队列维护活跃窗口,并为每个活跃码字在不活跃集中做近邻检索,262,144 规模码本下的额外计算与显存开销正文未量化;解耦调度引入了码本学习率这一新超参(文中固定为 $10^{-3}$),对不同架构/分辨率的迁移性未系统消融;FIFO 窗口长度 $W$ 的敏感性也主要放在附录;生成实验只覆盖 vanilla AR,未测掩码生成模型。此外失败模式分析虽有洞察,但 Region VQ 的目标传播在 token 分布剧烈漂移时是否会传播过时目标,正文未讨论。
独立分析的弱点
独立分析的弱点:其一,Region VQ 的目标传播假设'邻近码字应当接收相似目标',在高度各向异性的隐空间中欧氏近邻未必是正确的接收者,可能把码字推向错误区域,改进方向是用 encoder 特征相关性、余弦相似度或马氏距离替代欧氏距离来选择接收者。其二,持续不活跃码字能否被救活,部分取决于其初始化位置是否落在 token 分布的可达范围内,文中未讨论初始化策略与目标传播的交互,可在传播时对长期死亡码字附加受控噪声探索。其三,冻结模块的 pilot study 隔离了变量,但真实联合训练中 Dynamic STE 对远距离 token 的梯度抑制可能拖慢 encoder 收敛,文中缺少端到端收敛速度的对比曲线。其四,UR-AUC 的失配设定是人工构造的尺度失配,真实训练中的漂移形态更复杂,可补充自然漂移(如训练中途更换数据增强、引入新域数据)的恢复实验。其五,判别器沿用前人设计,其对整体稳定性的贡献未与三组件解耦。
未来方向
未来方向:作者明确提出要把 StableVQ 扩展到更苛刻的场景——视频 tokenizer(时序维度的分布漂移更剧烈,Decoupled Schedule 思想或需推广到编码器/解码器/码本三组模块)、多模态语言模型的视觉端、更大码本与更高分辨率。基于本文成果还可延伸:把 Region VQ 的目标传播推广为基于最优传输的码本-编码器分布对齐,获得理论保证;研究模块化调度解耦在 GAN 式双系统共训练(生成器/判别器不同 lr 调度)中的普适性;把 Dynamic STE 的相对距离加权思想迁移到残差量化(RQ)、多阶段量化与有限标量量化(FSQ);理论层面刻画'模块职责分离'与收敛性、稳定性边界的关系;最终可探索完全免 STE 的离散梯度估计(如 Gumbel-softmax 变体与本文加权的结合),从根上缓解量化不可微问题。
复现评估
复现评估:提供的正文中未给出明确的开源代码链接,但论文结构对复现较友好——附录 A 含完整相关工作,附录 C 含完整生成基线对比,附录 E 给出 UR-AUC 鲁棒性测试的计算细节,消融表给出了全部组件组合的完整指标(rFID/LPIPS/PSNR/SSIM/利用率),便于逐步对齐。复现需要 ImageNet 全量数据与可观算力:主结果训练 40–120 epoch 的 VQGAN 式模型,属于单机多卡 GPU 数天到数周的量级,整体难度中等偏高。有利因素是方法本身免参数、实现都不复杂:Dynamic STE 加权约十几行代码,Region VQ 需要 FIFO 队列与近邻检索,Decoupled Schedule 只需把优化器分成两组各配调度。不利因素是 SimVQ/FVQ 基线为作者自行复现(并采用在线重建评估而非保存-重载管线),第三方对齐结果时可能存在偏差;判别器与训练管线的细节需依赖所引用的前人配置。
论文图表
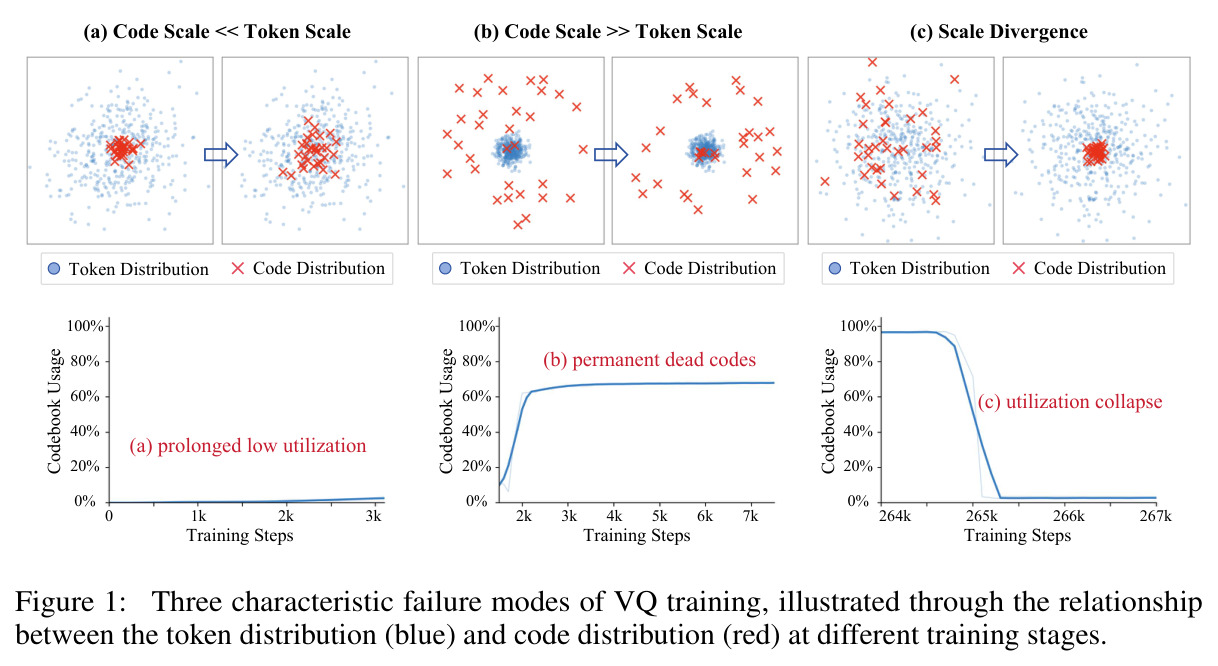
三列并列展示:(a) 码尺度远小于 token 尺度导致持续低利用率;(b) 码尺度远大于 token 尺度导致大量永久死码;(c) 尺度发散导致利用率瞬时坍缩。每列下方配有对应的码本使用率随训练步数变化的曲线,标出失败发生的位置。
这是全文的问题诊断图:三类失败模式分别对应三个组件的设计动机——Dynamic STE 针对 commitment 尖峰与 NaN,Region VQ 针对死码与低利用,Decoupled Schedule 针对追踪失败,看懂此图才能理解方法部分的逻辑主线。