离散视觉Token的语义无损表示:因子化向量量化FVQ Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?
有效比特预算而非量化误差决定离散视觉token的语义容量,FVQ追平连续表示
前置知识
向量量化(VQ)
把连续特征向量用有限码本(codebook)中最近的码字替换,只保留码字下标作为离散 ID。训练目标是让码本覆盖特征分布,重建误差为特征与最近码字的距离平方。它是离散视觉 token 的基础操作,本文的全部讨论都围绕「量化引入的误差到底是否损失语义」这一根本问题展开。
本文挑战的第一个假设就是「量化误差必然导致语义损失」,不熟悉 VQ 就无法理解这一反直觉发现。
残差向量量化(RVQ)与乘积量化(PQ)
RVQ 用多个码本逐级量化残差:第一个码本拟合主成分,后面的码本拟合剩余误差,信息逐级递减;PQ 把特征按通道切成多组并行量化,组越多每组维度越窄。两者是现有多码本方案的代表,用于扩大比特预算 $B = L\log_2 C$,也是本文分析高预算饱和现象的对照对象。
论文的核心实验对比 RVQ/PQ 与 FVQ 在 8 到 16 码本时的表现分化,不理解两者的信息递减机制就看不懂饱和原因。
紧框架(tight frame)
线性代数概念:一组变换 $A$ 满足 $A^\top A = \rho I$ 时称为紧框架,意味着所有方向被均匀缩放、没有任何方向被丢弃,且可用共轭算子 $\rho^{-1}A^\top$ 从投影完美重建原向量。FVQ 用它保证多个投影视图「合起来」在量化前信息无损,分解本身零失真。
FVQ 的三个技术组件(投影、量化、合成)全部建立在 $A^\top A = \rho I_D$ 这个条件上,是读懂方法章节数学推导的前提。
视觉-语言模型与 next-token 预测
VLM 把视觉输入转成 token 序列与文本一起送入 LLM。若视觉也用离散 token 表示,则图文共享同一套 next-token 预测目标,可以继承 LLM 成熟的架构与缩放配方——这是离散视觉路线的核心动机。VLM 直接消费离散索引而非重建特征,这正是量化误差不一定传递到语义的原因。
本文用多模态理解得分作为语义保真度的代理指标,这一做法完全依赖 VLM 的评测体系,也解释了为何重建 MSE 与下游表现脱钩。
比特预算(bit budget)
表示一个信号所需的比特数。本文定义离散表示每 patch 比特预算 $B = L\log_2 C$($L$ 个码本、每个大小 $C$):增加码本数量线性涨比特、增加码本大小只对数涨比特,因此扩 $L$ 是更高效的缩放维度。原始 RGB 图像和连续特征同样是有限比特编码,三者可放在同一框架下比较。
「有效比特预算决定语义容量」是全文的核心命题,Fig. 2 右半部分和 Table 2 的所有缩放实验都以此变量为横轴。
研究动机
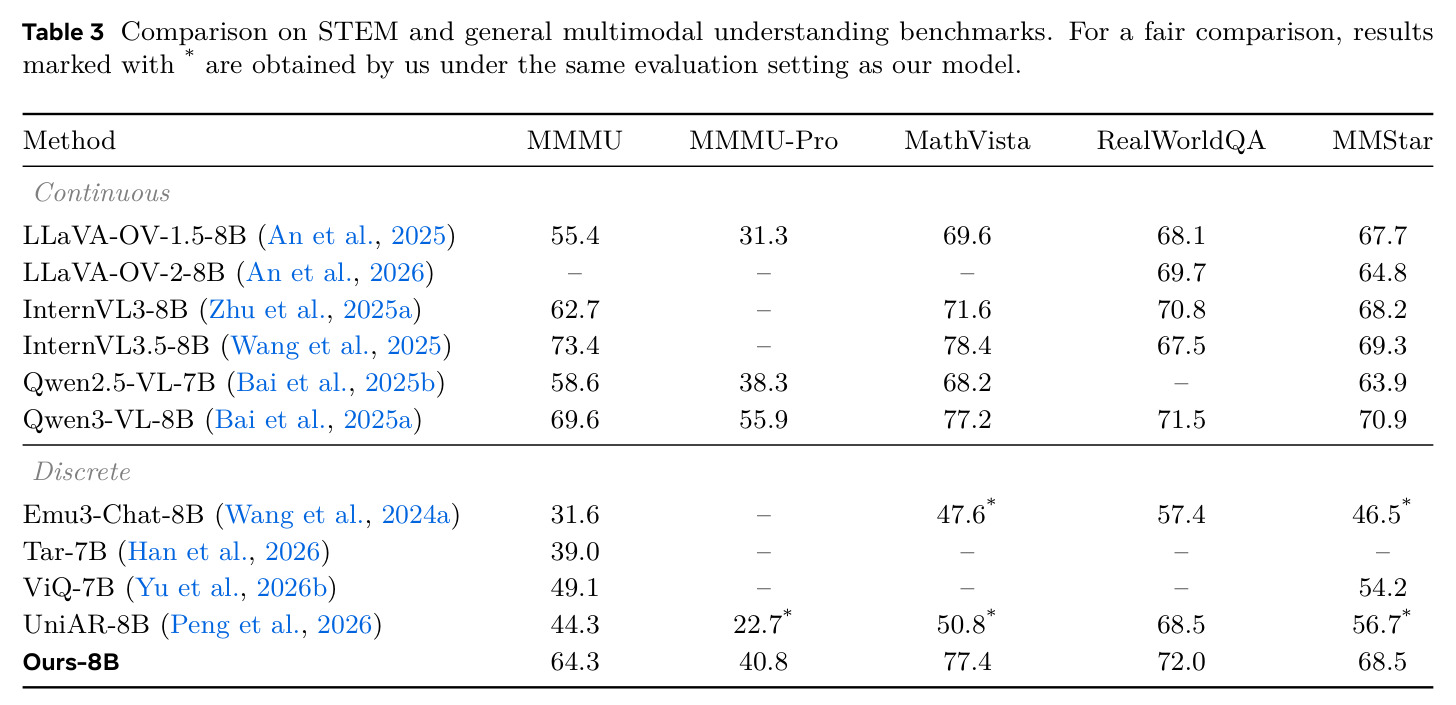
多模态模型正朝着用离散视觉 token 统一视觉与语言的方向发展(如 Emu3、UniAR),希望继承 LLM 成熟的架构与 next-token 训练范式。但社区普遍假设:把连续视觉特征量化到有限码本必然引入量化误差,而量化误差必然造成语义损失,因此连续表示被视为离散表示的内在性能上限。这一假设的后果非常具体:离散表示模型在多模态理解上大幅落后——论文对比中 Emu3-Chat-8B 的 MMMU 仅 31.6、UniAR-8B 仅 44.3,而连续表示的 Qwen3-VL-8B 达到 69.6;在 OCR 等细粒度任务上差距更大,Emu3 的 CharXiv 推理分只有 14.1、OCRBench 687,远低于连续模型。研究者普遍将原因归结为量化丢弃高频细节,认为离散路线天生不适合精细视觉理解,连最新的 UniAR 也未能逼近连续旗舰模型。
本文的目标是本文想回答一个根本问题:离散视觉 token 到底能不能作为语义无损的视觉信号表示?如果能,决定语义保真度的真正因素是什么?具体目标分三层:第一,用多模态理解性能作为语义保真度的代理指标,检验「量化误差必然导致语义损失」这一公认假设是否成立;第二,从第一性原理出发,把原始图像、连续特征、离散表示统一看作数字系统中的有限比特编码,检验有效比特预算是否才是决定语义容量的关键变量;第三,针对现有量化器(RVQ/PQ)在高比特预算下饱和的问题,设计一个能随码本数量持续扩展、每个码本持续获得有效信息的量化器 FVQ,并在工业规模数据上训练 8B 模型,验证离散表示能否真正追平 Qwen3-VL 这样的连续旗舰模型——包括其长期短板 OCR 与文档理解。
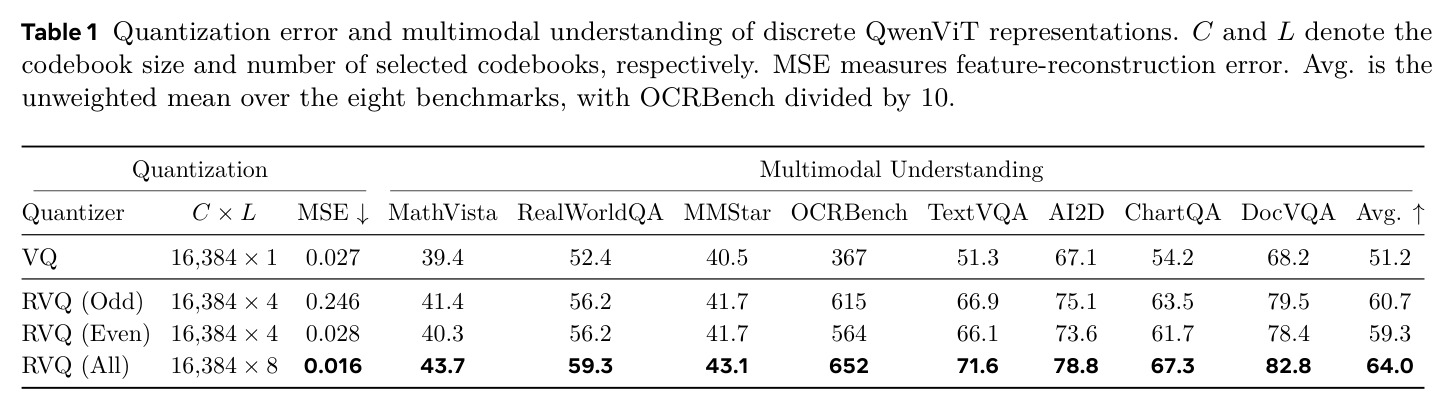
与已有工作不同的是,独特之处在于换掉了衡量「语义损失」的标尺。此前所有工作都用特征重建误差(MSE)来评价量化器好坏,本文的对照实验直接证伪了这一标尺:只保留 RVQ 奇数组的表示 MSE 高达 0.246(VQ 只有 0.027),8 基准理解得分却从 51.2 涨到 60.7,反超 9.5 分。作者随后回到第一性原理:数字 RGB 图像本身就是有限比特的离散信号,冗余极高,其语义原则上可以用远少于原始比特数的编码表示,因此「离散必然有损」并非先天成立。由此提出有效比特预算 $B = L\log_2 C$ 这一定量框架——码本数量 $L$ 线性增加比特、码本大小 $C$ 只对数增加比特——并把「新增比特是否仍携带新信息」作为量化器的设计准则。这一视角既解释了 RVQ/PQ 的饱和现象,也直接导出了 FVQ 的三个设计原则。
核心方法
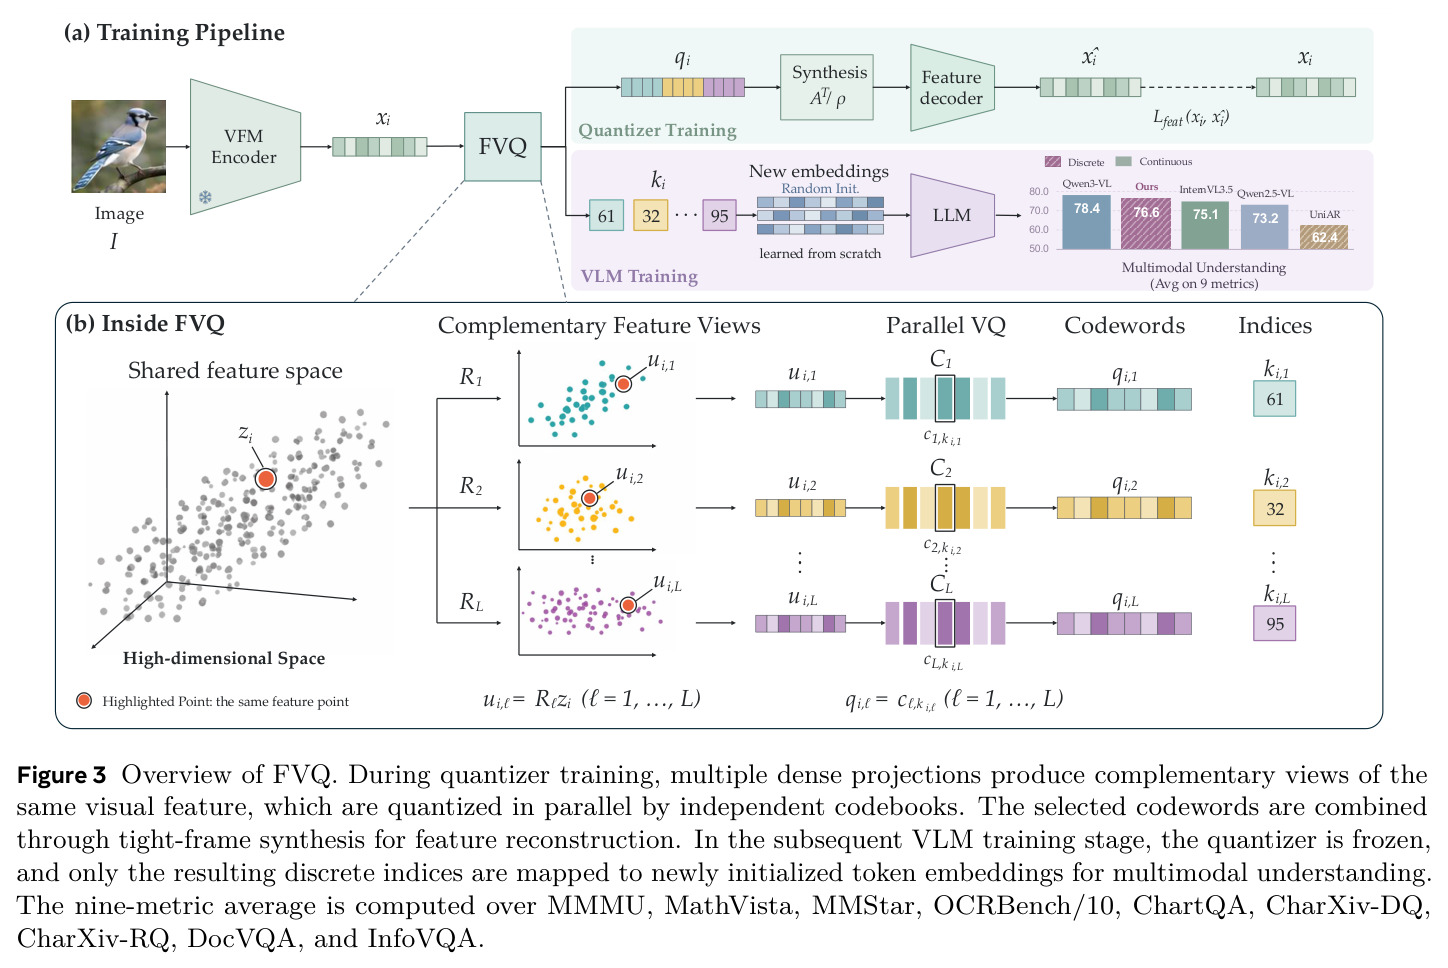
FVQ 的直觉是:让每个新增码本都看到「全特征的另一个互补视图」,而不是像 RVQ 那样只看到越来越小的残差、或像 PQ 那样只看到越来越窄的通道切片。技术路线上,对每个视觉 patch 的投影 VFM 特征 $z_i \in \mathbb{R}^D$,用 $L$ 个稠密投影矩阵 $R_\ell \in \mathbb{R}^{d\times D}$(输入维度 $d$ 固定,不随 $L$ 变化)生成 $L$ 个视图 $u_{i,\ell} = R_\ell z_i$;所有投影堆叠成分析算子 $A$ 并施加紧框架约束 $A^\top A = \rho I_D$($\rho = Ld/D$),保证视图各向同性、集体保持特征几何。每个视图用独立码本并行最近邻量化得到离散索引;tokenizer 训练时用合成算子 $\rho^{-1}A^\top$ 从码字重建特征——由于 $A^\top A = \rho I_D$,分解本身零失真,误差只来自码字替换。下游 VLM 训练时量化器冻结,离散索引映射到新初始化的 token embedding 进入语言模型。
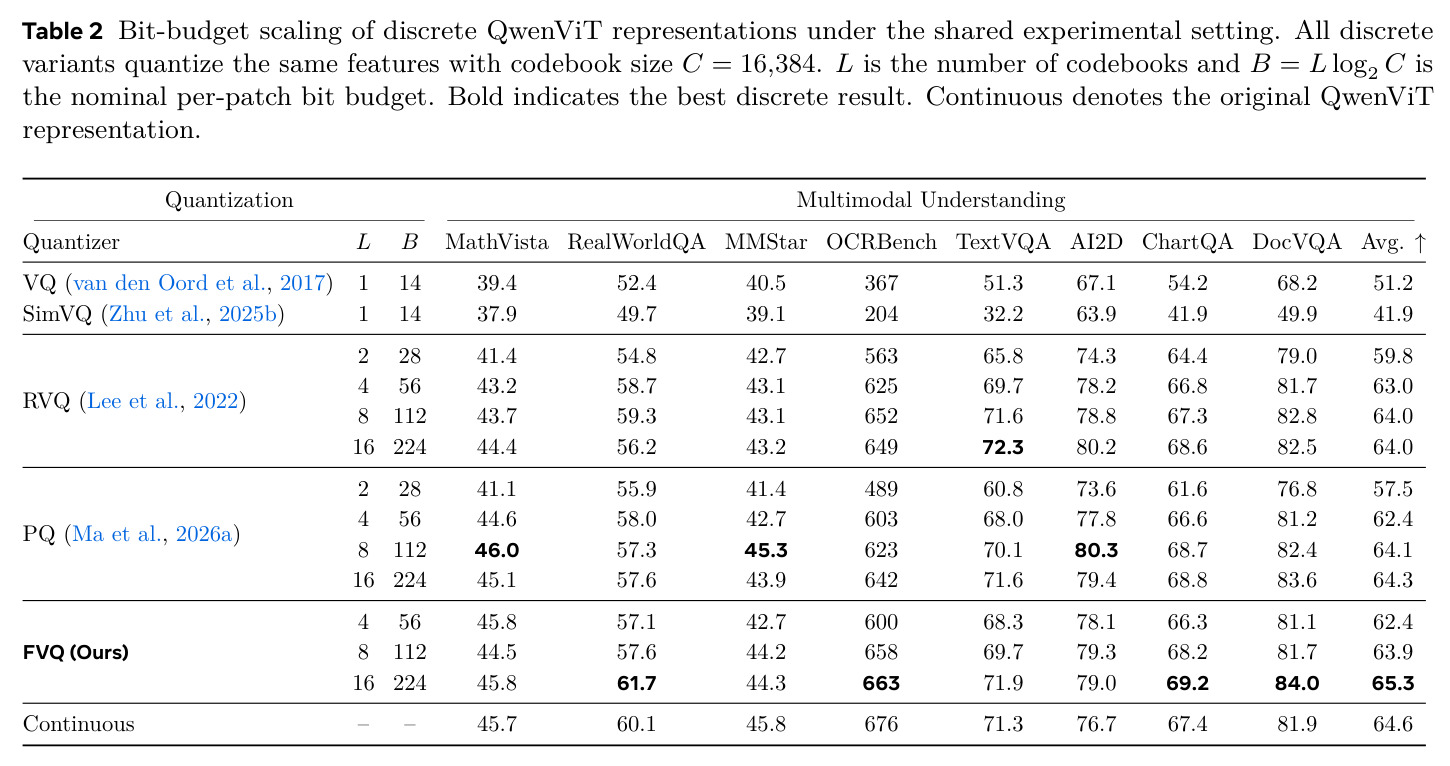
核心创新是与 RVQ/PQ 在「如何切分信息」上的本质区别。RVQ 把特征分解为逐级残差,第 $k$ 个码本只编码前 $k-1$ 个码本没拟合完的残余,信息量随级数递减;PQ 把 $D$ 维特征切成 $L$ 个通道组,码本越多每组越窄,单个码本能看到的信息结构性萎缩——这正是两者在 8 到 16 码本(112 到 224 bits)时增益趋零、理解分停在 64.0/64.3 的原因。FVQ 反其道而行:所有 $L$ 个码本地位对称(独立并行量化),每个码本的输入都是全 $D$ 维特征经稠密投影后的固定 $d$ 维视图,增加码本只是增加一个视图而非切窄视图;紧框架条件进一步保证任意方向都不会被所有视图同时丢弃($\|Az_i\|_2^2 = \rho\|z_i\|_2^2$)。于是名义比特预算随 $L$ 线性增长时,每个码本携带的信息不结构性衰减:实测 16 码本 FVQ 达到 65.3 分,超过连续 QwenViT 的 64.6,而 RVQ/PQ 分别饱和在 64.0/64.3。
方法步骤详情
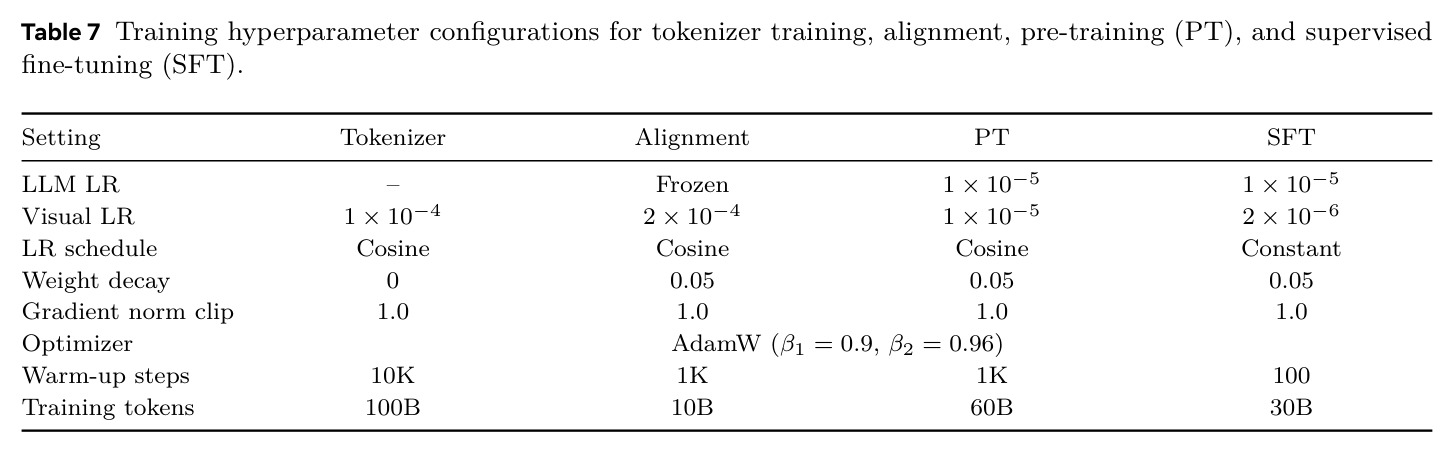
训练分四阶段。阶段一(量化器训练,100B tokens):冻结视觉编码器(主实验为 Qwen3 ViT),只训练码本:特征 $z_i$ 经固定投影得 $L$ 个视图,在大小 $C=16{,}384$ 的码本里最近邻查找 $k_{i,\ell}=\arg\min_j\|u_{i,\ell}-c_{\ell,j}\|_2^2$,再用 $\hat z_i=\frac{1}{\rho}\sum_\ell R_\ell^\top c_{\ell,k_{i,\ell}}$ 重建并优化特征 MSE 损失;投影由固定高斯矩阵 QR 分解构造并乘 $\sqrt{\rho}$,全程不学习。阶段二(对齐,10B tokens):量化器与 LLM 均冻结,只训练新初始化的视觉 token embedding 和 merger,把离散 ID 对齐到语言嵌入空间。阶段三(预训练,60B tokens,8K 上下文、1024px):联合优化 LLM、视觉 embedding 与 merger。阶段四(SFT,30B tokens,16K 上下文、2048px)。LLM 用 Qwen3-8B,标准 1D RoPE、去掉 ViT 的 DeepStack,保持纯 next-token 预测。每 patch 输出 $L$ 个索引,主模型 $L=16$,即每 patch 224 bits。
技术新颖性
技术新颖性有三点。第一,把量化器的评价标准从重建误差换成有效比特预算与下游理解,这一概念性修正本身是贡献——它解释了为什么单码本 SimVQ(41.9 分)与 RVQ(64.0 分)可以有巨大性能差,也让「加码本」从启发式变成有明确收益边界的缩放维度。第二,紧框架分析-合成对的设计:投影固定为满足 $A^\top A=\rho I_D$ 的列正交矩阵,使量化前的分解零失真、失真全部来自码字量化,且每个特征方向被均匀缩放;相比依赖 straight-through 估计的 VQ-VAE 或查询转换的 SimVQ,它给了多视图量化一个干净的线性代数保证。第三,实证层面首次在工业规模(合计约 200B tokens 训练数据)上证明离散表示可以与 Qwen3-VL 竞争,包括此前被认为离散路线不可能做好的 OCR、图表与文档任务(CharXiv 甚至反超连续模型 86.1 对 83.0)。作者也明确定位 FVQ 是缓解饱和的「一种途径」而非唯一方案,措辞克制、留出设计空间。
实验结果
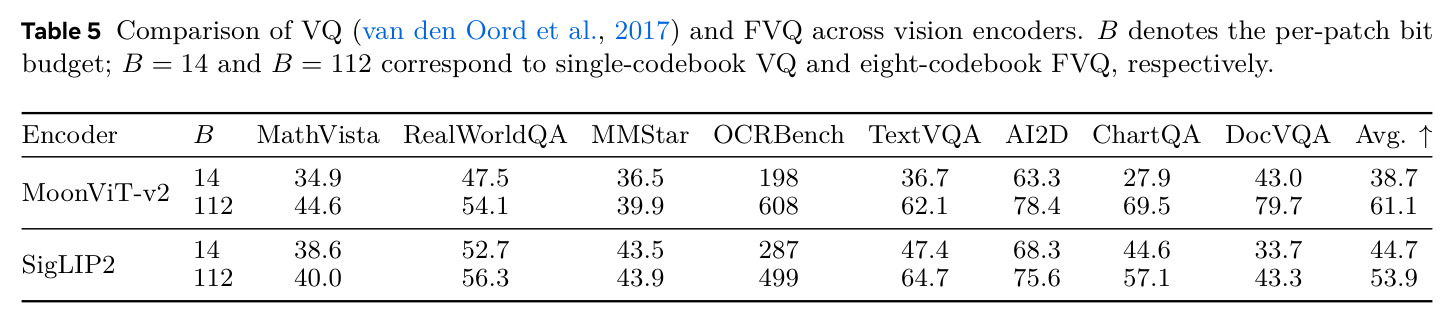
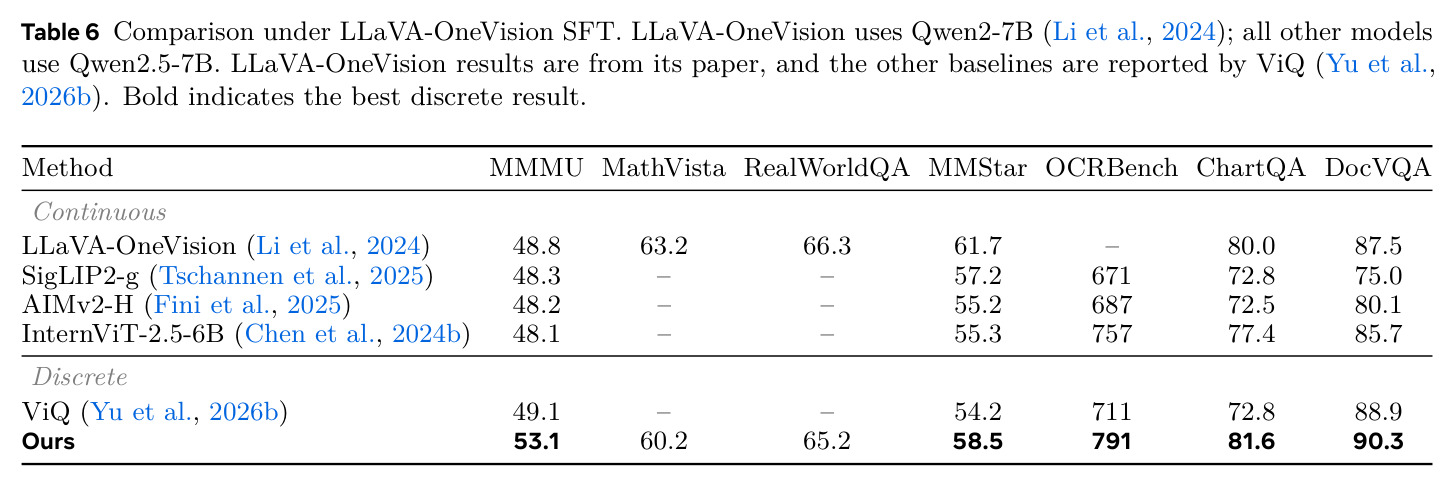
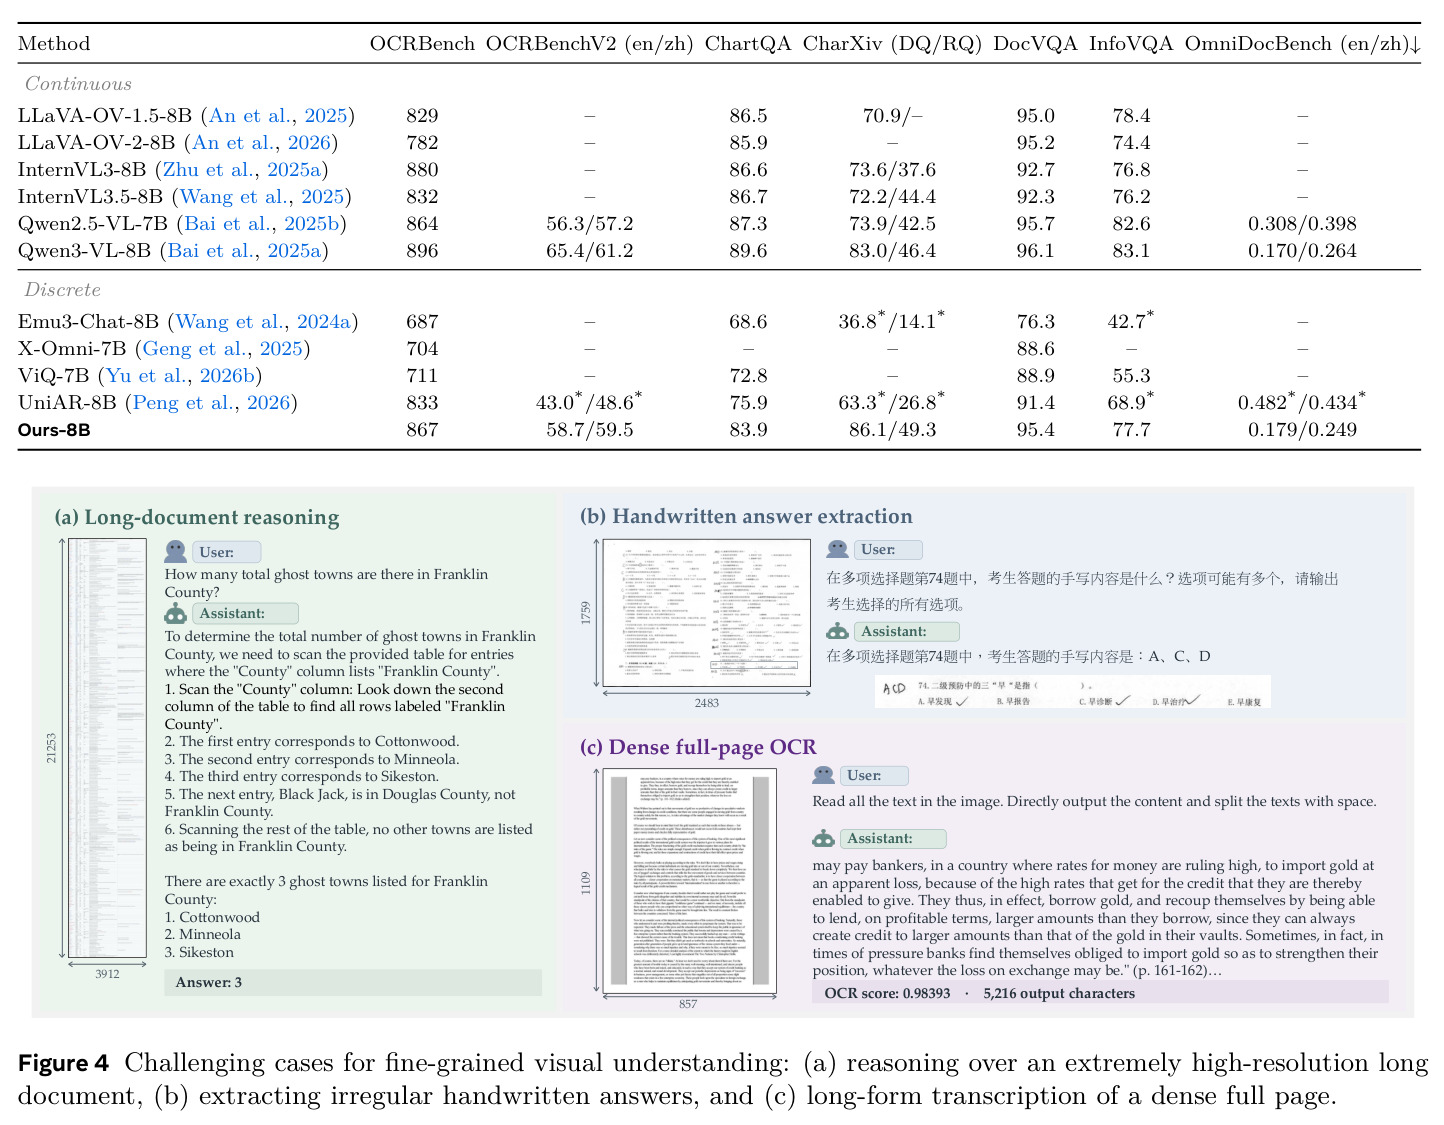
核心发现有四组实验支撑。(1)证伪量化误差标准(Table 1):RVQ 奇数组 MSE 0.246 远差于 VQ 的 0.027,8 基准平均分却 60.7 对 51.2 反超 9.5 分;偶数组 MSE 0.028 与 VQ 几乎相同,却得 59.3——重建误差与语义保真完全脱钩。(2)比特预算缩放(Table 2):固定 $C=16{,}384$,VQ(14 bits)51.2 分;RVQ 从 2 码本 59.8 升到 8 码本 64.0 后,16 码本原地踏步;PQ 饱和在 64.3;FVQ 一路升至 16 码本 65.3,超过连续 QwenViT 的 64.6;OCRBench 从 VQ 的 367 涨到 663。(3)工业规模主模型(Table 3/4):8B 模型 9 指标平均较 UniAR 相对提升 22.8%、较 Emu3-Chat 提升 59.2%;MMMU 64.3(UniAR 44.3)、MathVista 77.4 反超 Qwen3-VL 的 77.2、RealWorldQA 72.0 全场最佳;OCRBench 867(Qwen3-VL 896)、OmniDocBench 0.179/0.249(0.170/0.264),CharXiv 86.1/49.3 反超 Qwen3-VL 的 83.0/46.4。(4)泛化与消融(Table 5/6):MoonViT-v2 平均分 38.7→61.1、SigLIP2 44.7→53.9;仅用 LLaVA-OneVision SFT 时 MMMU 53.1、DocVQA 90.3,仍优于 ViQ 的 49.1/88.9。Fig. 4 极端案例(21,253×3,912 像素长表推理、手写多选识别、5,216 字符整页转写 OCR 得分 0.98393)进一步坐实细粒度理解能力。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多模态理解(8 基准平均) | 8 基准平均分 | FVQ 16 码本 65.3(224 bits) | 连续 QwenViT 64.6;RVQ-16 64.0;PQ-16 64.3 | 首次超过连续表示,+0.7 分且未饱和 |
| 通用多模态理解(MMMU) | 准确率 (%) | 64.3 | UniAR-8B 44.3;Emu3-Chat 31.6;Qwen3-VL-8B 69.6 | 较 UniAR +20.0,逼近最强连续模型 |
| 数学推理(MathVista) | 准确率 (%) | 77.4 | Qwen3-VL-8B 77.2;UniAR-8B 50.8 | 反超连续 SOTA +0.2 |
| 现实场景理解(RealWorldQA) | 准确率 (%) | 72.0 | Qwen3-VL-8B 71.5;InternVL3.5-8B 67.5 | 全场最佳,+0.5 |
| 文字识别(OCRBench) | 分数 (满分1000) | 867 | Qwen3-VL-8B 896;UniAR-8B 833;Emu3-Chat 687 | 较 Emu3 +180,离散模型中最佳 |
| 图表理解(CharXiv DQ/RQ) | 准确率 (%) | 86.1 / 49.3 | Qwen3-VL-8B 83.0 / 46.4 | 双项反超连续旗舰 +3.1/+2.9 |
| 文档解析(OmniDocBench en/zh) | 编辑距离 (越低越好) | 0.179 / 0.249 | Qwen3-VL-8B 0.170 / 0.264;UniAR 0.482 / 0.434 | 中文更优,英文与旗舰基本持平 |
| 跨编码器泛化(8 基准平均) | 平均分 | MoonViT-v2 61.1;SigLIP2 53.9(FVQ-8) | 单码本 VQ:MoonViT-v2 38.7;SigLIP2 44.7 | +22.4 / +9.2,证明结论不依赖特定编码器 |
| 轻量设置对比(LLaVA-OneVision SFT) | MMMU / DocVQA | 53.1 / 90.3 | ViQ 49.1 / 88.9;LLaVA-OneVision 48.8 / 87.5 | 排除工业数据后 FVQ 量化器本身仍最优 |
局限与改进
作者承认的边界:FVQ 被定位为「缓解饱和的一种途径」而非最优方案;投影矩阵固定不可学习;部分探索实验基于 Qwen3-1.7B 小模型。我自己的观察有五点:第一,序列成本被淡化——每 patch 从 1 个 token 变成 $L=16$ 个 token,注意力序列近似膨胀 16 倍,论文未报告训练/推理吞吐、显存与延迟,也未与「同等算力加大连续模型」对比;第二,视觉嵌入表膨胀为 $L\times C = 16\times16{,}384$ 约 26 万个 embedding,参数与优化压力增加;第三,连续表示在 MMMU(69.6 对 64.3)、MMStar(70.9 对 68.5)、OCRBench(896 对 867)仍领先,「追平」主要是 8 基准平均意义上的;第四,实验只覆盖理解任务,未验证图像生成、视觉思维链等离散 token 的传统优势场景,「离散是否有独立价值」未闭环;第五,评测的连续基线去掉了 DeepStack、改用 1D RoPE,虽保证训练设置公平,但与官方 Qwen3-VL 的差异使「打平旗舰」的表述需谨慎解读。
独立分析的弱点
独立分析几个具体弱点。其一,计算可扩展性:$L=16$ 意味着视觉 token 序列约 16 倍长,在 2048px 高分辨率文档场景注意力开销巨大,而所有对比均未控制推理算力;改进方向是视图间 token 合并、分组注意力或层次化聚合后再进 LLM。其二,固定随机投影可能次优:QR 分解的高斯矩阵与 $d$、$\rho$ 均为超参数,无数据驱动选择机制;可让投影可学习并保持正交约束(如 Stiefel 流形上的可微优化),或训练中联合微调。其三,码本利用率未报告:$C=16{,}384$ 的大码本有 codebook collapse 风险,论文以「大码本难优化」为由固定 $C$,但未给出各码本的利用率曲线;应补充利用率监控与死码重置。其四,缺少生成与效率基准:离散 token 的卖点是统一理解与生成,本文未测文生图或图像编辑;应把 FVQ 接入统一模型验证双向能力。其五,any-resolution tokenizer 与 2048px 最大分辨率本身可能贡献部分 OCR 增益,应增加同分辨率连续基线的对照消融,剥离量化器与分辨率策略各自的作用。
未来方向
作者提出的延伸方向隐含在结论中:把离散表示作为大规模原生多模态基础模型的可扩展接口。基于此可延伸的具体方向包括:(1)缩放律研究——系统绘制 $L$、$d$、$C$ 与数据量对理解性能的缩放曲线,寻找 FVQ 自身的饱和点,检验 448、896 bits 时能否继续超越连续表示;(2)统一理解-生成模型——FVQ 的对称码本天然支持从索引经合成算子解码回特征,可接入扩散或自回归图像生成头,验证「同一套 token 既看又画」;(3)视觉思维链——背景中提到离散 token 可作为视觉思维链与中间语义表示,高比特预算是否让中间推理更可靠值得实验;(4)语义压缩下限——既然原始信号冗余高,可研究「每 patch 多少 bits 足够」的信息论下界,反过来指导连续编码器的压缩与蒸馏;(5)端到端联合训练——目前量化器冻结、投影固定,未来可让投影、码本与 LLM 联合优化,或让 LLM 自回归地生成离散视觉 token;(6)更低维度与蒸馏——研究能否用更小的 $d$ 或更少码本蒸馏出同性能 tokenizer,降低部署成本。
复现评估
复现条件分层评估。代码与项目主页已公开(github.com/hustvl/FVQ),这是复现的基础。核心发现层(第 2 章的比特预算缩放与误差-语义解耦实验)相对便宜:共享设置主要基于公开的 LLaVA-OneVision 数据,量化器训练 50B tokens、对齐约 4B tokens,探索实验用 Qwen3-1.7B,单节点多卡(约 8×A100/H100 量级)数天内可完成,普通实验室可以复现 Table 1/2 的趋势。主结果层(8B 工业模型)成本高:四阶段合计约 200B tokens(100B+10B+60B+30B),训练对象为 Qwen3-8B,需要数百卡周级别的集群资源以及 STEM/OCR/图文交错等混合数据的工程准备,普通团队难以完整复现,只能依赖其公开权重或缩减规模验证。评估侧所有基准(MMMU、MathVista、OCRBench、OmniDocBench、CharXiv 等)均为公开基准,论文标注了哪些对比数字是作者自测(带 *),协议透明。总体判断:趋势可复现、SOTA 数字难复现,开源程度在同级别工作中属于较好水平。
论文图表
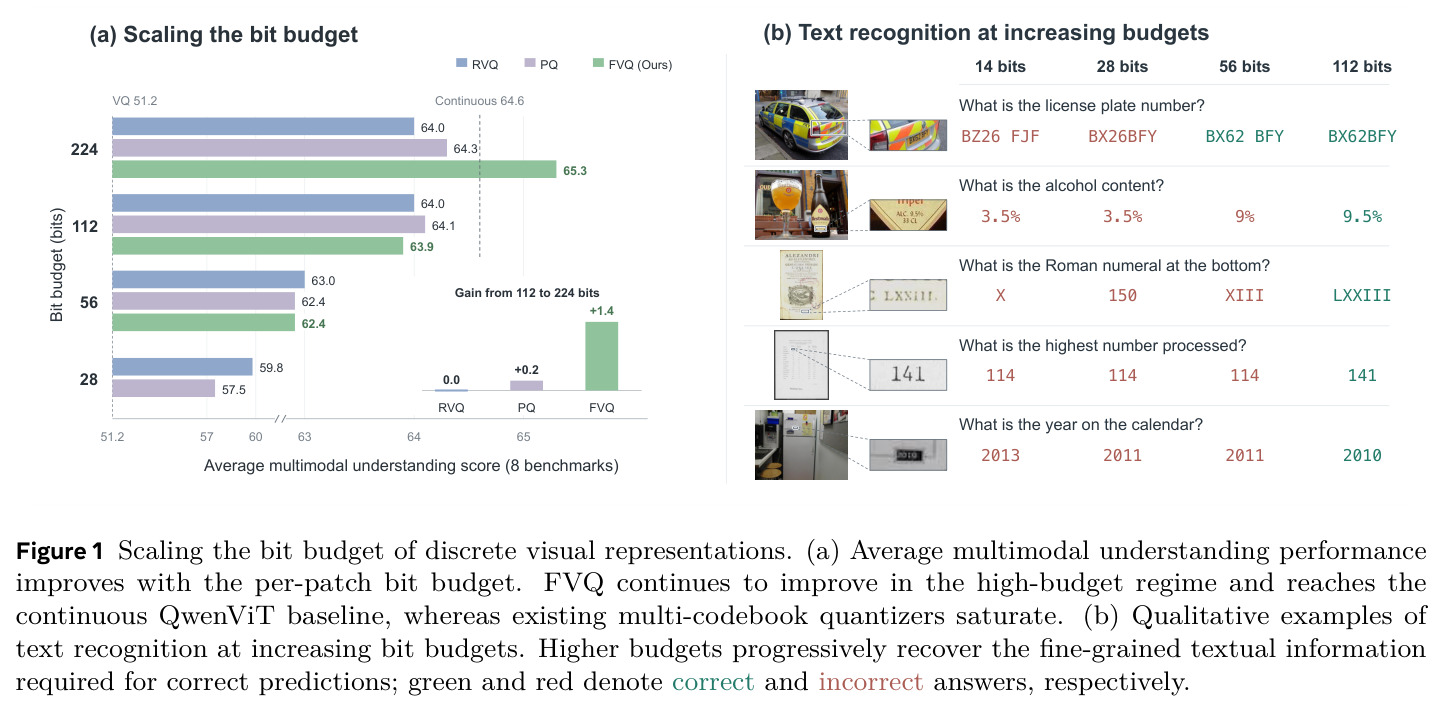
(a) 8 基准平均多模态理解分随每 patch 比特预算(14→224 bits)的缩放曲线:RVQ 与 PQ 在 112 bits 后饱和(64.0/64.3),FVQ 一路升到 65.3 并追平连续 QwenViT 基线 64.6;(b) 车牌号、酒精度、罗马数字、日历年份等文字识别随预算增加(14→112 bits)逐步恢复细粒度信息的定性对比,绿色为正确、红色为错误。
一图浓缩全文两个论点:比特预算决定语义容量、FVQ 解决高预算饱和。Fig. 1(b) 直观展示 OCR 从「必失」到「可恢复」的过程,是说服读者接受核心主张的第一张图。
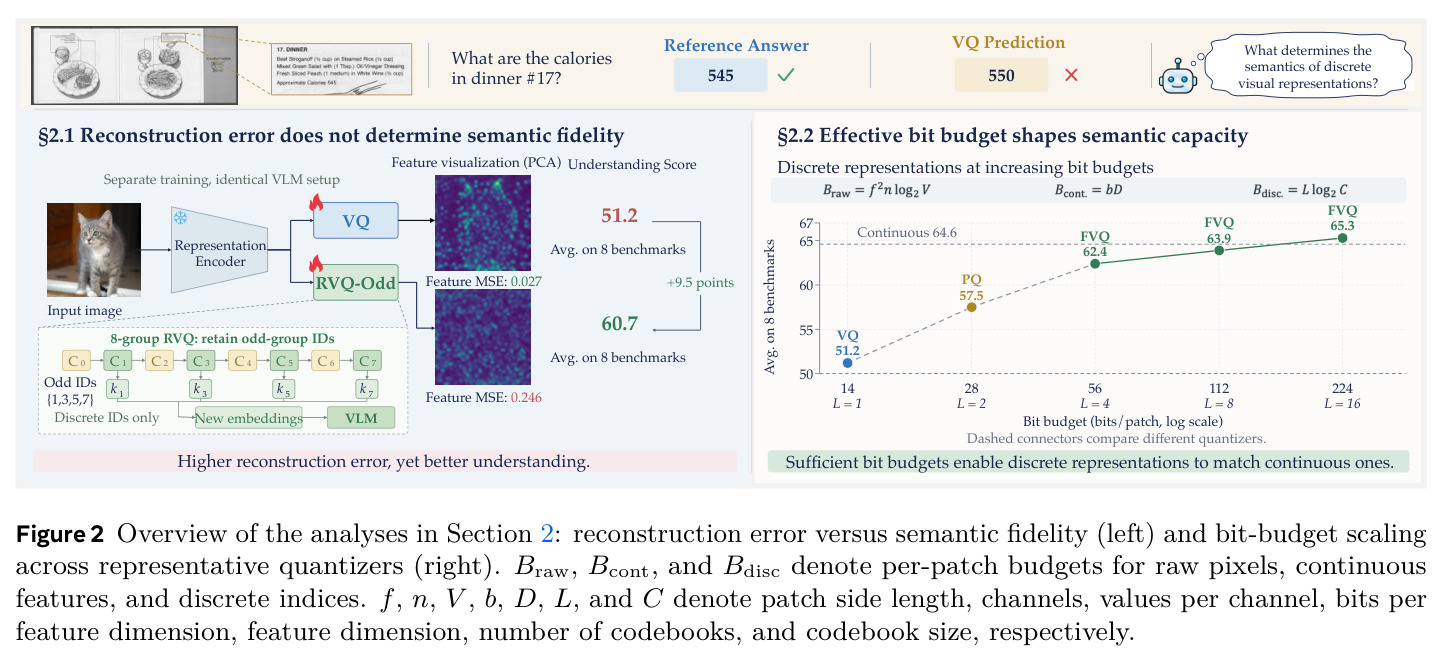
第 2 章两个分析的总览。左半:奇偶 RVQ 组对照实验流程(保留奇数组 ID、换新 embedding 进 VLM)与 PCA 特征可视化,标注「重建误差更高(MSE 0.246 对 0.027)但理解更好(60.7 对 51.2,+9.5 分)」;右半:raw pixels、连续特征、离散表示各自的每 patch 比特预算 $B_{raw}$、$B_{cont}$、$B_{disc}$,以及 FVQ/VQ 在不同预算下的得分曲线(VQ 51.2 到 FVQ 65.3,连续 64.6)。
是两个核心 Finding(误差不决定语义、比特预算塑造容量)的总入口图,理解论文论证结构必看。