跨阵营指责:丹麦议会中的政治对照与责任归因 Blaming Across the Aisle: Political Contrasting and Blame Attribution in the Danish Parliament
微调分类器分析丹麦议会近30年发言:指责2016年后加速上升,右翼极端党尤甚
前置知识
政治对照(political contrasting)
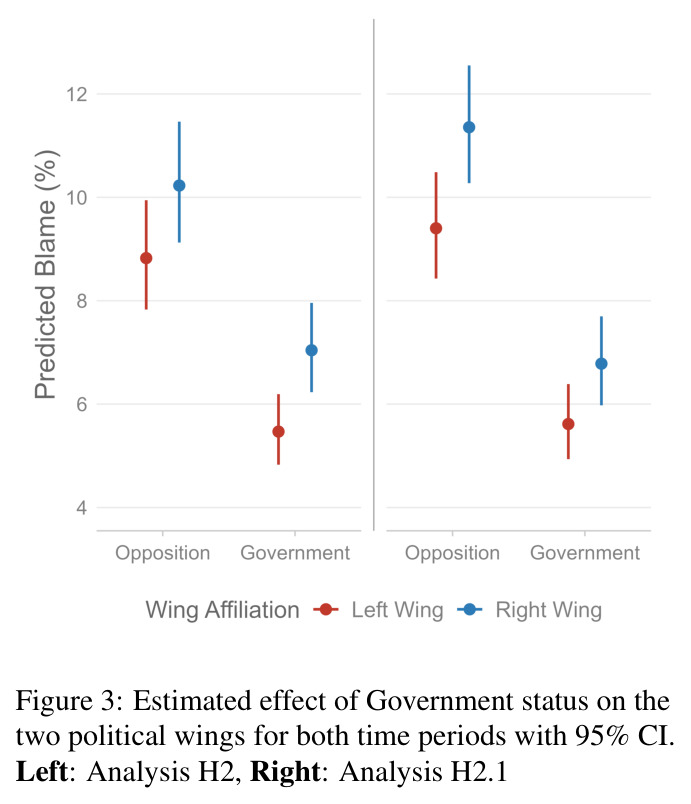
源于道德心理学「指责即规范信号」理论的修辞策略:在野政党置身执政党对立面,指责对手能同时凸显其施政失败并划清自身立场,因而有最强的指责激励;执政党需为治理结果负责,指责易被反噬,故系统性更少指责。论文用政府身份的二值变量来操作化这一构念。
这是论文的核心理论构念,H2/H2.1 中政府身份的负效应(执政者指责仅为在野党的 60-62%)就是对它的直接检验,不理解它就无法解读结果章节。
零样本 NLI 分类器(DEBATE)
将文本分类转化为自然语言推理任务:把候选标签写成假设句模板,让模型判断「文本是否蕴含该假设」,输出各标签概率。DEBATE 是基于 DeBERTa-V3 微调、专为政治文本设计的零/少样本分类器(Burnham 等,2026),但仅支持英语且输入限 512 token。
论文用它对 50 万句机器翻译成英语的丹麦语句自动打银标,是整条弱监督管线的源头;其英语中心的偏差与翻译噪声直接决定最终模型的上限。
DIAL(一致性递增数据集)
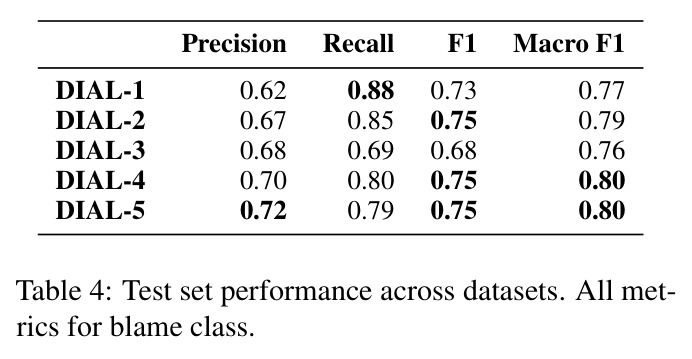
用同一零样本模型的 5 个不同提问模板(T1-T5)对每句分别打标,「至少 n 个模板一致」才计为正例,从而得到从最宽松 DIAL-1(指责率 1.71%)到最保守 DIAL-5(0.50%)的五套银标数据。标签保守度不再靠主观拍板,而由人工金标上的下游性能经验决定。
这是方法新颖性的核心:论文据此证明最保守的 DIAL-5 训练出的模型宏 F1 最高(0.80)且精确率/召回率最均衡,为弱监督学习的标签质量选择提供了可复制方案。
LoRA 微调与 focal loss
LoRA 冻结预训练权重、只训练低秩增量矩阵(本文 rank=64、alpha 缩放=128)以极小算力完成微调;focal loss 通过 $(1-p_t)^\gamma$ 因子降低易分样本的损失权重、聚焦难样本($\gamma=2.0$ 固定),并配合类权重的三种缩放(原始、2/3 次幂、平方根)应对正例仅 0.5% 的极端类别不平衡。
BlameBERT 就是 307M 参数的 mmBERT 用这套技术在 2 万句银标上训练而成;理解它才能明白为何 20 分钟微调的模型能在该任务上超过 9B 大模型的零样本表现。
负二项混合效应模型
针对过度离散计数数据的回归模型:$Y_{it} \sim \mathrm{NegBin}(\mu_{it}, \phi)$,对数链接下以 $\log(S_{it})$ 作 offset($S_{it}$ 为该党当月发言句数),从而建模指责「率」而非绝对量;党级随机截距 $u_i \sim N(0, \sigma^2)$ 吸收政党异质性,嵌套模型用似然比检验(LRT)逐级比较。
论文所有实质结论(香蕉形时间趋势、政府抑制效应、wingness 交互)都由这套模型给出,不熟悉 offset 与随机效应就无法正确解读结果中的系数含义。
Chapel Hill 专家调查(CHES)与 wingness
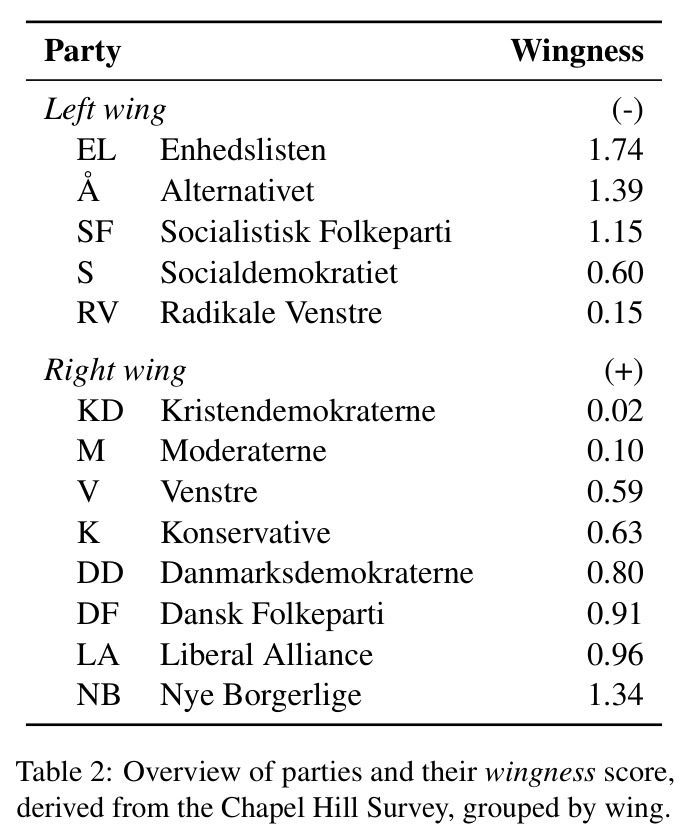
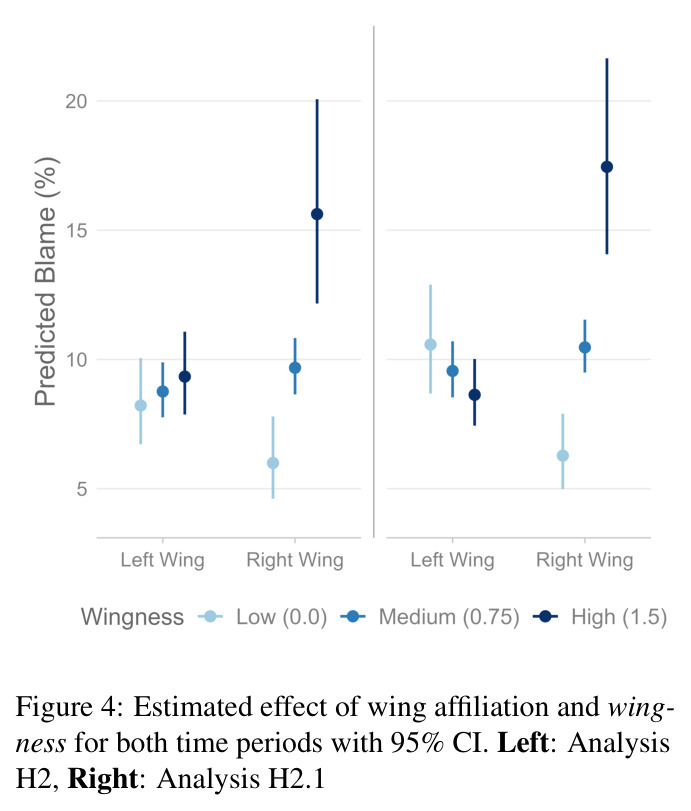
CHES 是专家对欧洲各政党左-右意识形态位置打分的调查。论文取其 lrgen 变量做 z 标准化:负值为左翼、正值为右翼,零点为样本均值;wingness 定义为标准化得分的绝对值 $|z_i|$,即政党离意识形态中心的距离(如 EL 1.74 最左、NB 1.34 最右)。
翼别、wingness 及其与政府身份的交互是论文的核心自变量;Table 2 的 13 党打分与「右翼极端党指责增幅最大」这一不对称结论都建立在这个测量之上。
研究动机
公众与媒体普遍认为政治话语正变得愈发敌对,但严格的实证证据却很稀缺:现有研究大多基于社交媒体(如 Twitter 上的政治不文明行为研究),而更具制度分量的议会话语相对被忽视。跨欧洲议会的情感分析发现负面与中性情绪占主导、正面情绪始终最少,情绪变化反映的是各国具体政治环境;针对丹麦与荷兰党内演讲的研究则发现情绪唤起随时间上升但整体效价保持稳定——说明政治语言的「强度」在增加,但方向性变化尚不明确。更关键的是,情绪与归责并非同一概念:一句话可以充满负面情绪却不向任何行为者指派责任,而已有研究几乎都用情感或不文明程度作为代理指标。在丹麦国内,「议会语气是否变硬」本身就是媒体争论话题(TV2 曾列举证据称「语气一直这么硬」),双方各执一词,缺乏覆盖数十年的系统性量化证据来裁决。
本文的目标是本文的具体目标有三层。第一,为丹麦语这一低-中资源语言构建首个政治语境归责检测模型 BlameBERT,用标注高效的弱监督管线替代昂贵的人工标注,并通过人工金标测试集验证其有效性(宏 F1 0.80)。第二,将模型应用于丹麦议会 1997 年 10 月至 2026 年 2 月共约 29 年、近 500 万句发言,量化归责率的长期演变轨迹。第三,用多层统计模型检验两个假设:H1——丹麦议会的归责率随时间上升,尤其近年(2019-2026)显著加剧;H2——在野身份(政治对照)与意识形态极端性(wingness)提高归责率,且这些效应在近年间增强。最终目标是判断「政治话语变硬」的公众感知究竟是修辞神话,还是可测量的、在意识形态上不对称的结构性转变。
与已有工作不同的是,本文的独特切入有三点。其一,概念角度不同:不从「不文明」或「负面情感」入手,而是抓住归责这一兼具因果归因与负面情绪的修辞性言语行为,并从道德心理学的规范信号理论(指责即表明自己恪守、对方违反规范)推导出「政治对照」与「翼度」(wingness)两个可检验的结构性预测,使理论与可计算变量一一对应。其二,方法论上避免循环论证:模型标签只依据句子文本中的语言标记,而非「哪些党通常爱指责」的先验,因此统计模型中政治自变量与指责测量相互独立,估计更干净。其三,资源角度:丹麦语缺乏现成归责标注,作者设计了「机器翻译 + 零样本 NLI + 多模板投票」的弱监督管线,为低-中资源语言的同类研究提供了可复制模板,并首次系统比较了嵌入模型、生成式 LLM 与微调小模型在成本与效果上的权衡。
核心方法
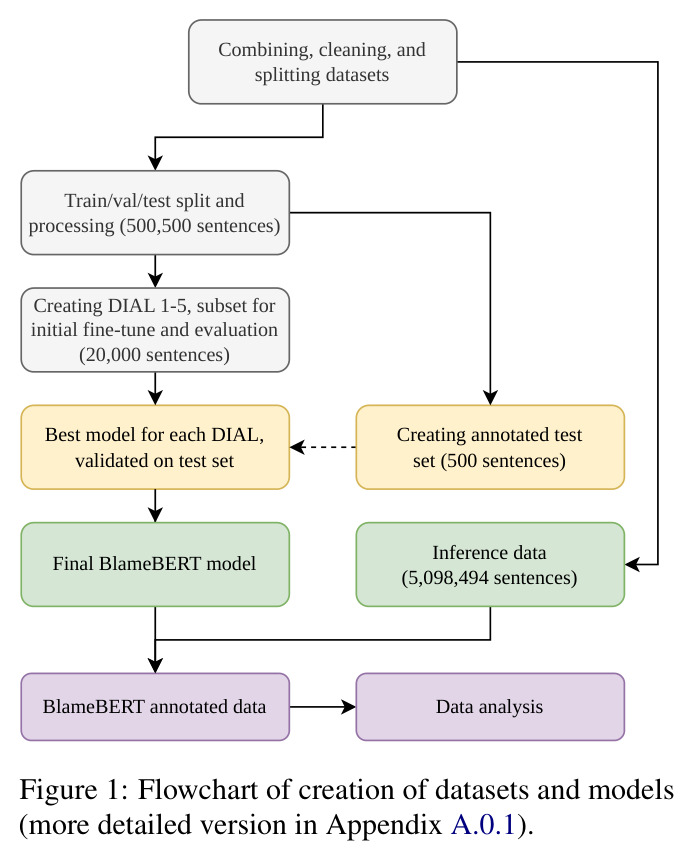
方法的直觉是:与其花大钱人工标注,不如让在政治文本上预训练过的英语零样本分类器当「标注员」,再用少量人工金标检验它教出的学生是否可靠。技术路线分四步。第一步数据构建:合并 ParlSpeechV2(1997-10 至 2018-12)与作者从丹麦议会 SFTP 抓取的新数据(至 2026-02),用 DaCy 切句清洗得 5,598,994 句(保留 85%),其中 500,500 句做训练/验证/测试,5,098,494 句留作推断。第二步银标生成:训练句用 Opus-MT 译成英语,经 DEBATE 零样本分类(5 个模板 × blame/praise/neutral 三标签),按模板一致票数构建 DIAL-1~5 五套递增保守的数据集。第三步模型训练:对每套 DIAL 的 20,000 句做 LoRA 微调 mmBERT(307M 参数,focal loss,网格搜索),按验证 MCC 选模,在 424 句人工金标上测试,DIAL-5 模型胜出,即 BlameBERT(宏 F1 0.80)。第四步统计建模:推断集全量分类后按党×月聚合计数,用带 offset 的负二项混合效应模型估计时间、政府身份、翼别与 wingness 的效应,并以阈值敏感性和主题控制检验稳健性。
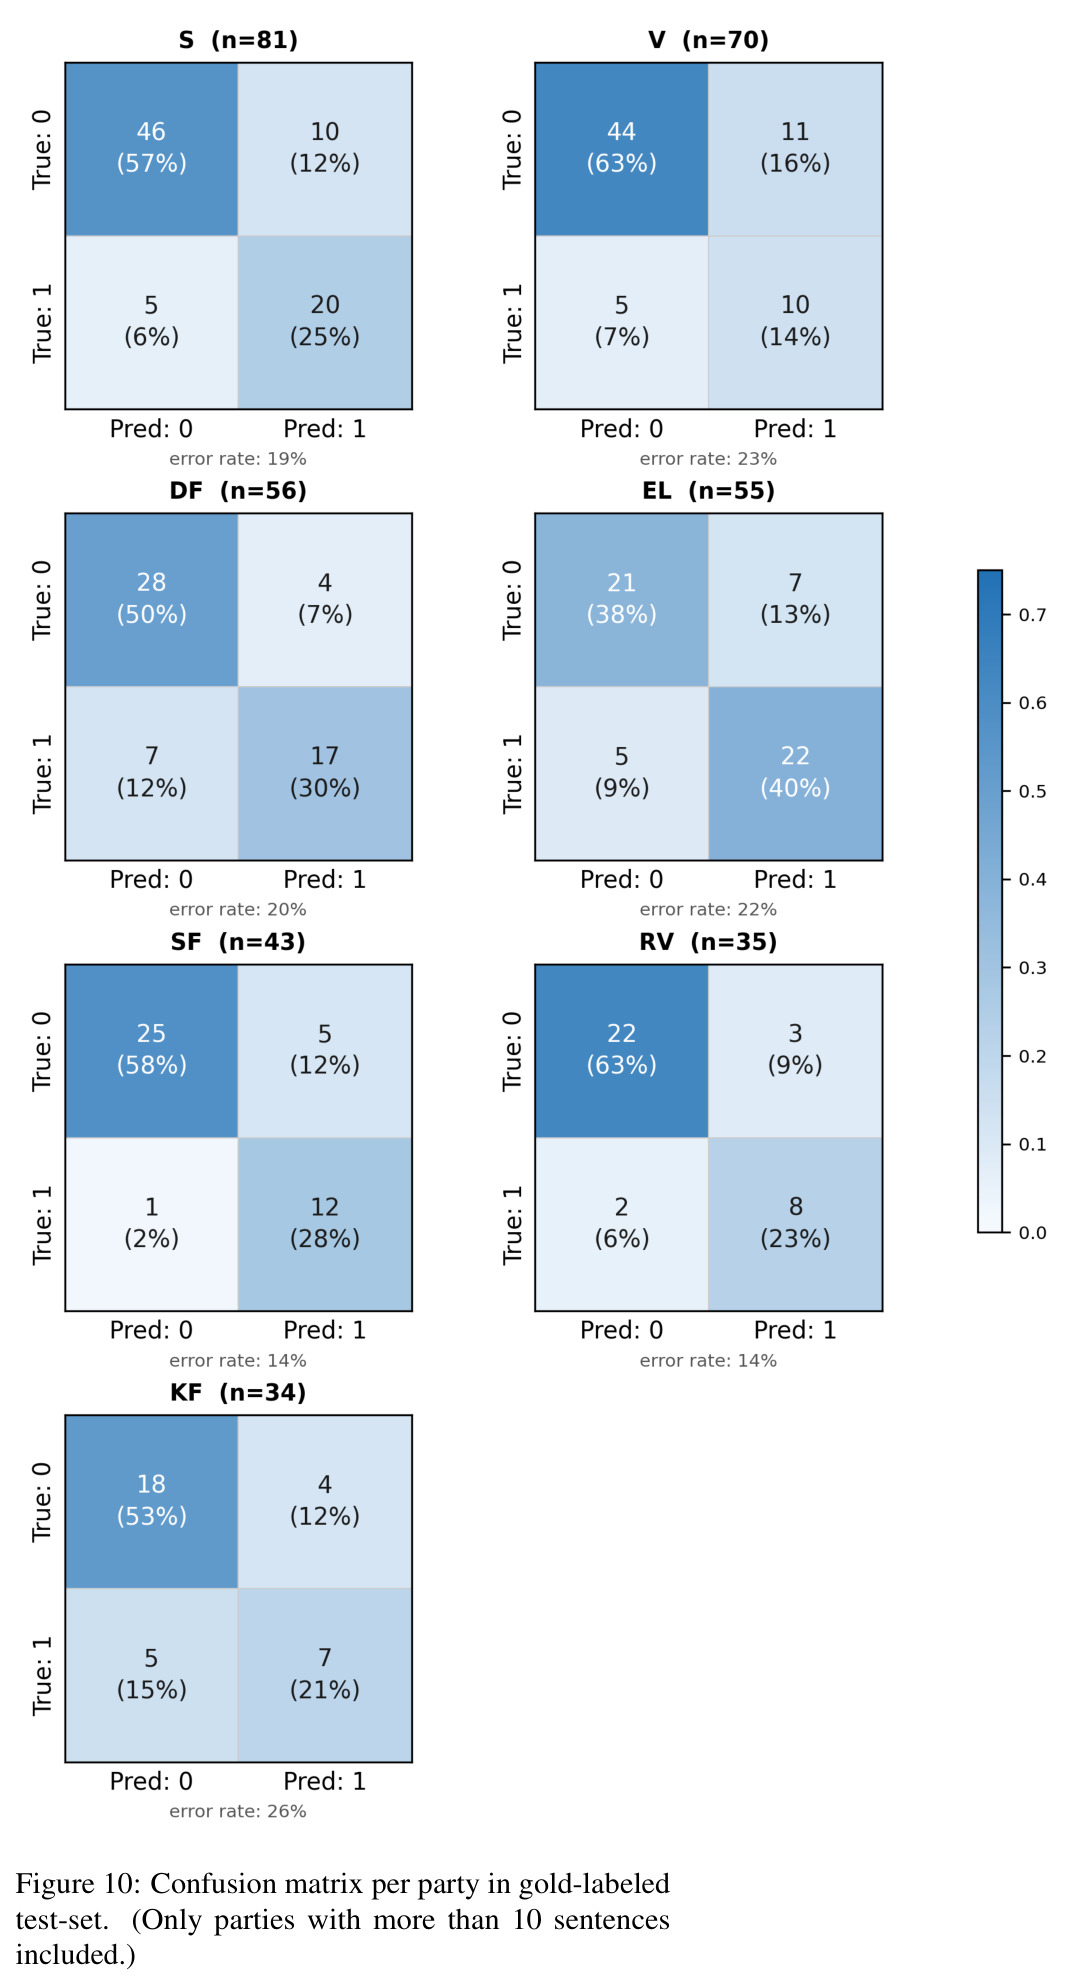
核心创新是「弱监督标签 + 下游金标验证」的标注高效管线,以及把分类器与统计推断严格分离的设计。与已有工作的本质区别在于:第一,传统归责/不文明检测需人工标注数千句,而本文用 DEBATE 的 5 个不同假设模板对同一批句子投票,构造出一致性要求从松到严的 DIAL-1~5(指责率从 1.71% 递减到 0.50%),把「标签该多保守」变成一个可用下游性能回答的经验问题——结果是 DIAL-5(仅 0.50% 正例率)训练的模型在金标上宏 F1 最高(0.80),精确率/召回率权衡最好(0.72/0.79)。第二,不是简单相信零样本模型的输出,而是通过 424 句双人标注(IAA 84.8%,Cohen's κ=0.676)的人工测试集量化误差,并检查误差是否存在党派系统性偏倚(未发现,见附录混淆矩阵)。第三,指责的测量完全由语言标记驱动,与统计模型中的政治自变量(政府身份、翼别、wingness)正交,避免了「用党派先验标注、再发现党派差异」的循环论证,这也是作者强调的方法论底线。
方法步骤详情
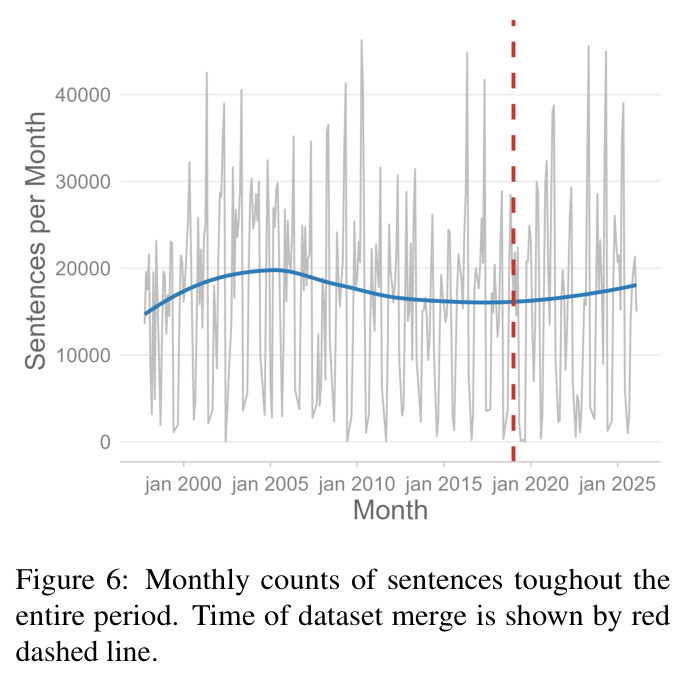
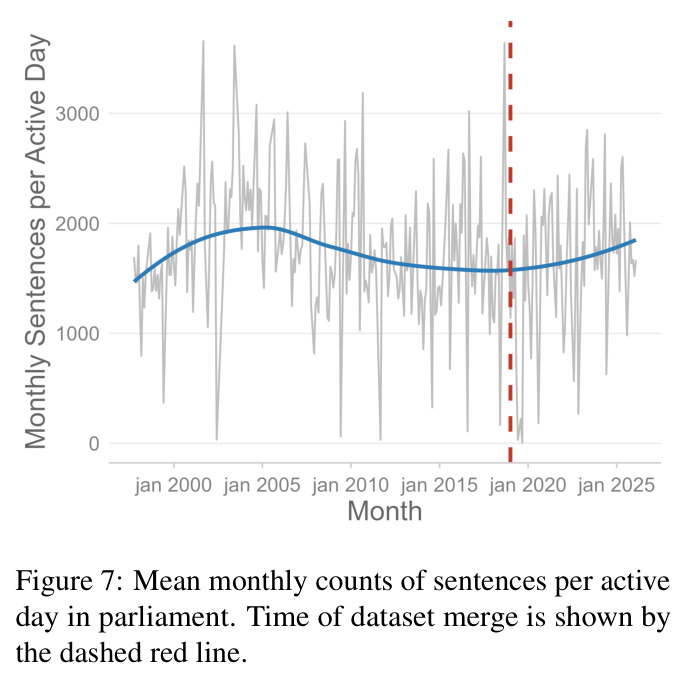
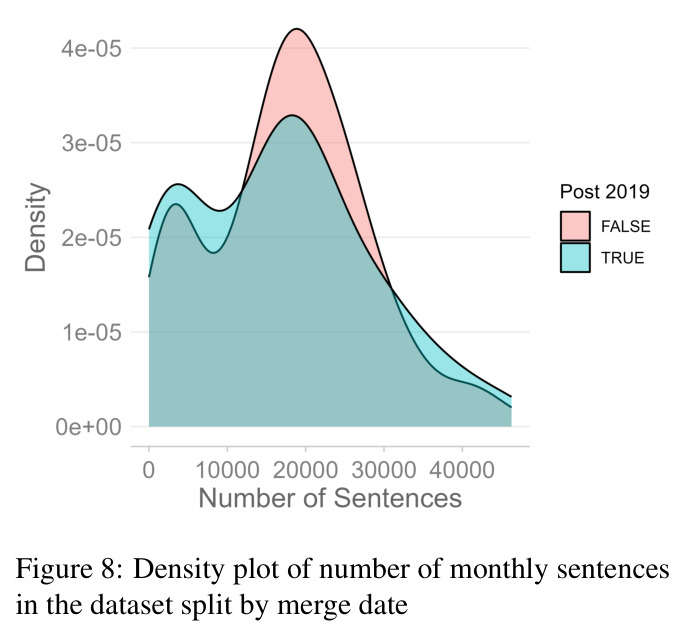
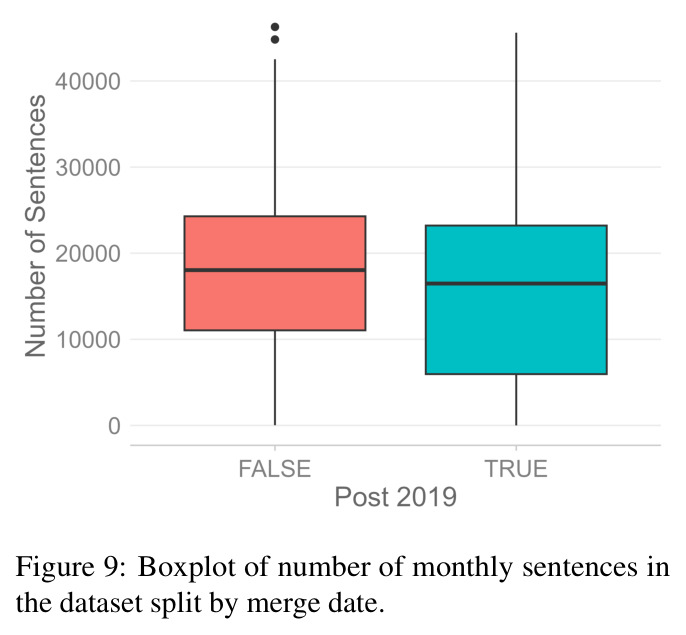
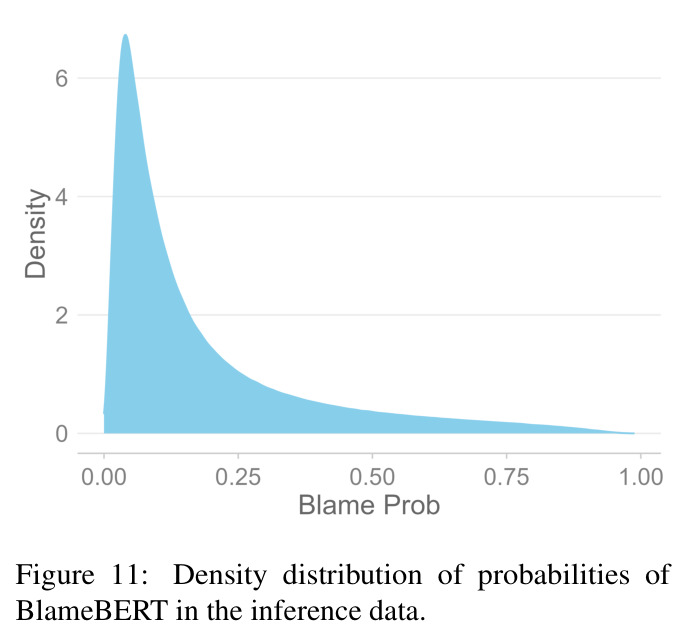
①数据构建:合并 ParlSpeechV2 与议会 SFTP 新数据(1997-10 至 2026-02),剔除主持人发言,DaCy 切句并删去少于 5 字符或含括号的句子,得 5,598,994 句(保留 85%);随机抽 500,500 句做训练/验证/测试,5,098,494 句留作推断;KS 检验证实合并点无断点(D=0.0847,p=0.810)。②银标生成:训练句经 Opus-MT 译成英语,DEBATE 按 5 个模板对 blame/praise/neutral 三标签打分,P(blame)≥0.80 且为最大者判为指责,标签映射回丹麦语原句;按「至少 n 个模板一致」构建 DIAL-1~5,指责率从 1.71% 递减至 0.50%。③训练:每套 DIAL 取 20,000 句(正例全部上采样),LoRA(rank 64、alpha 128)微调 mmBERT,focal loss(γ=2.0、类权重三种缩放),学习率 {1e-5, 1e-4, 5e-4} 网格搜索、线性衰减,按验证 MCC 选模。④金标评估:两位作者盲标 424 句一致样本(IAA 84.8%,κ=0.676,148 正例),DIAL-5 模型胜出(宏 F1 0.80,P 0.72/R 0.79),定名 BlameBERT。⑤统计推断:剔除已消失政党与无党派发言后剩 4,938,119 句(96.9%)、13 个政党;按 CHES lrgen 标准化得分定翼别(负=左、正=右),|z| 为 wingness;推断集按党×月聚合为 2,529 个观测(近年 810 个),拟合含 offset $\log(S_{it})$ 与党级随机截距的负二项混合效应模型,LRT 逐级比较;辅以阈值敏感性分析(τ=0.625/0.75/0.875)和 ManifestoBERTa 七大政策域的主题混淆检验。
技术新颖性
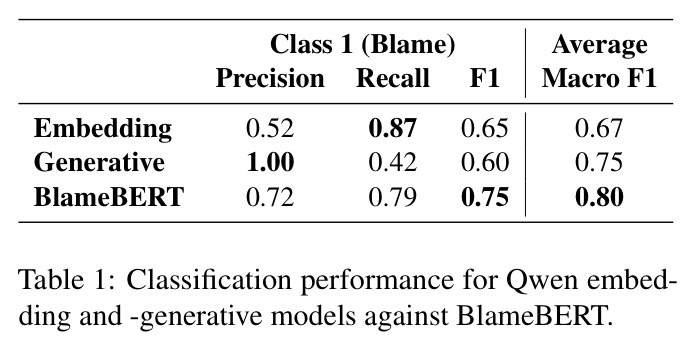
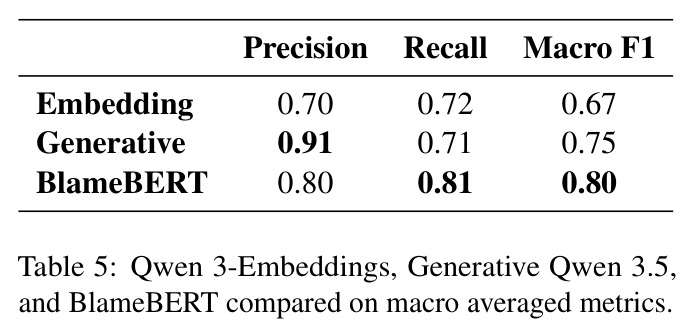
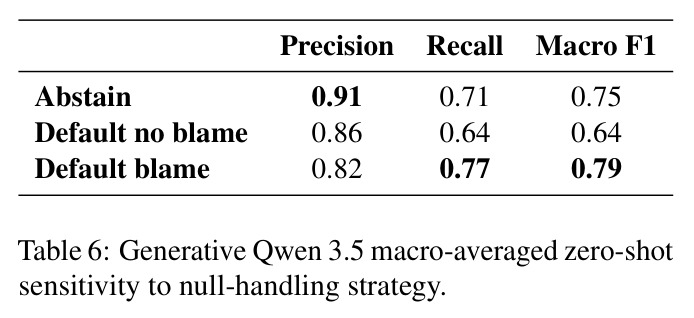
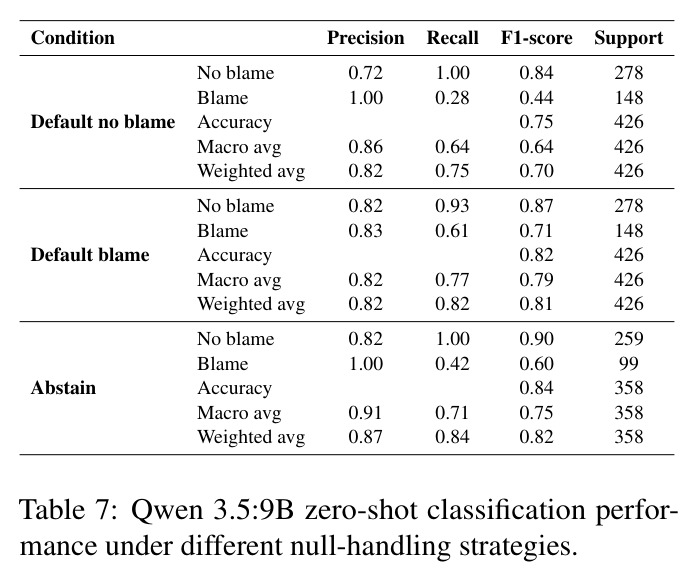
技术新颖性体现在四个层面。其一,任务层面:这是首个丹麦政治语境的归责检测模型,此前归责抽取研究集中于英语新闻(如 who-blames-whom 的实体级情感抽取)。其二,标签策略层面:DIAL 递增一致性设计把弱监督中「标签保守度」的超参数选择转化为由金标下游性能驱动的经验决策,事实证明优于直觉上选标签最多的宽松策略。其三,基线层面:系统对比了嵌入锚点法(Qwen3:0.6B,宏 F1 0.67)、约束解码的生成式 LLM(Qwen3.5:9B,abstain 策略宏 F1 0.75、但 16% 输出为空、以精确率 1.00 换召回率仅 0.42)与 307M 的微调 mmBERT(0.80),并给出真实算力成本(生成式基线约 19 小时 RTX 4070 Super vs 微调 20 分钟 + 单张 L40 推理数分钟),为低资源场景提供了「小模型+弱监督」胜过「大模型零样本」的实证案例。其四,推断层面:用计数回归加 offset 处理发量差异,并以阈值敏感性、主题混淆(ManifestoBERTa 七大政策域)和合并点连续性检验三重稳健性检查支撑结论。
实验结果
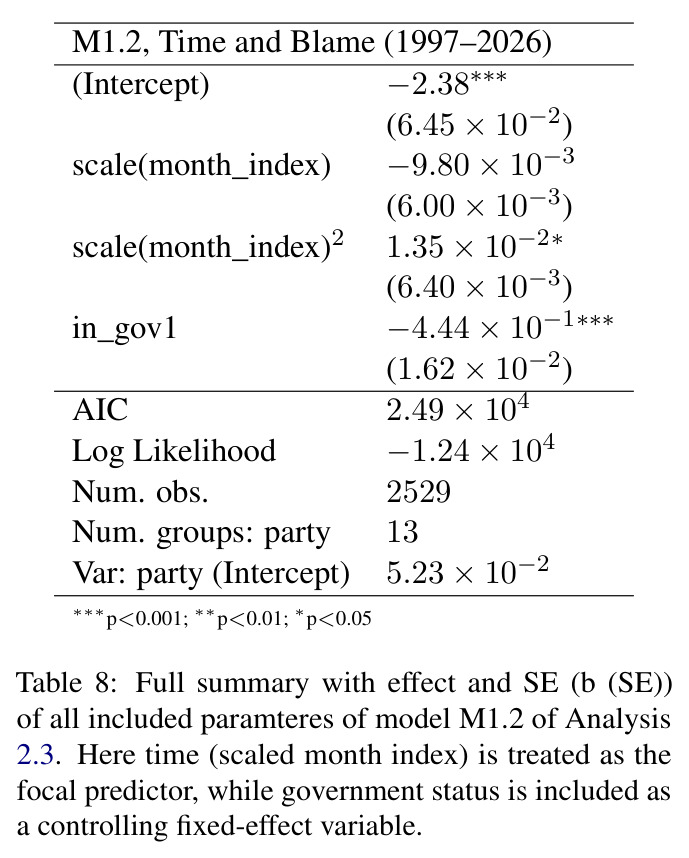
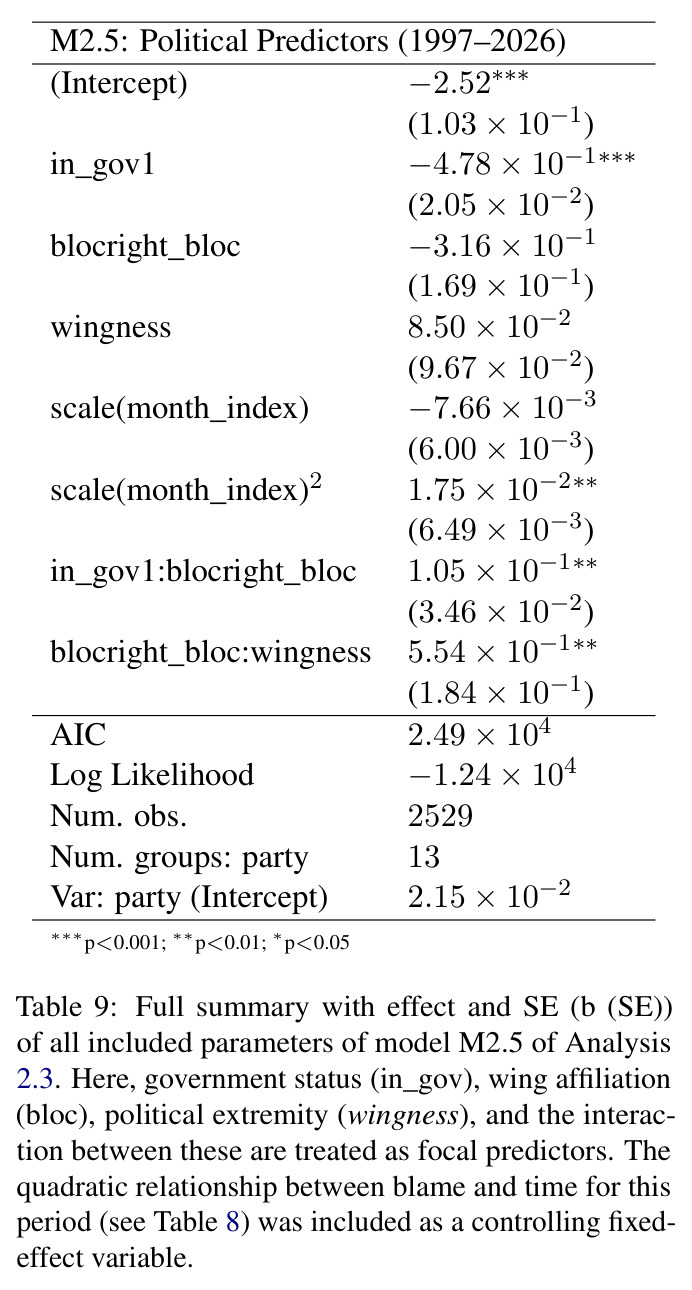
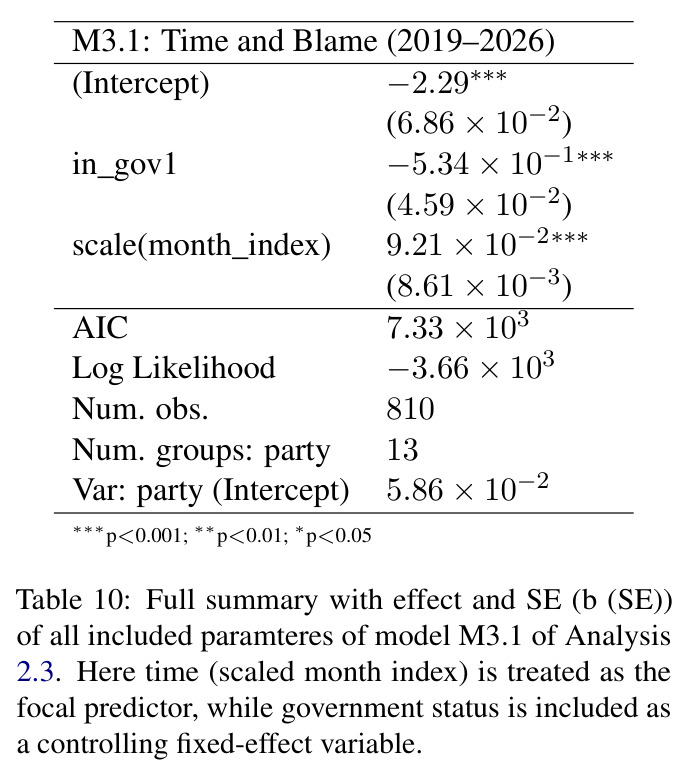
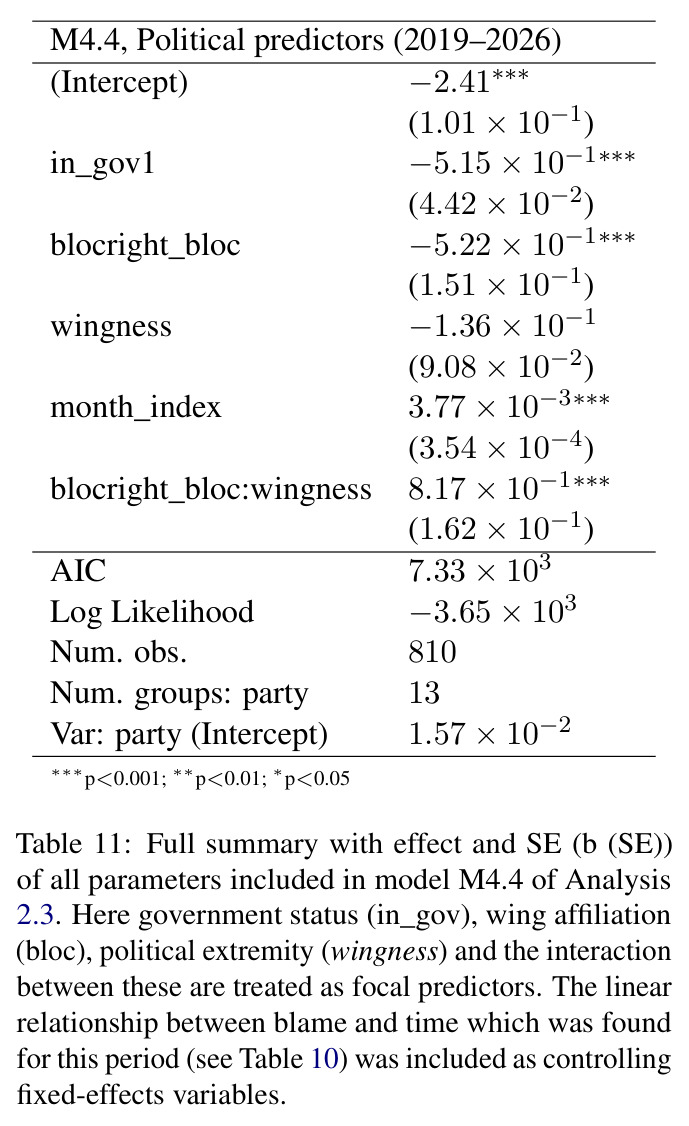
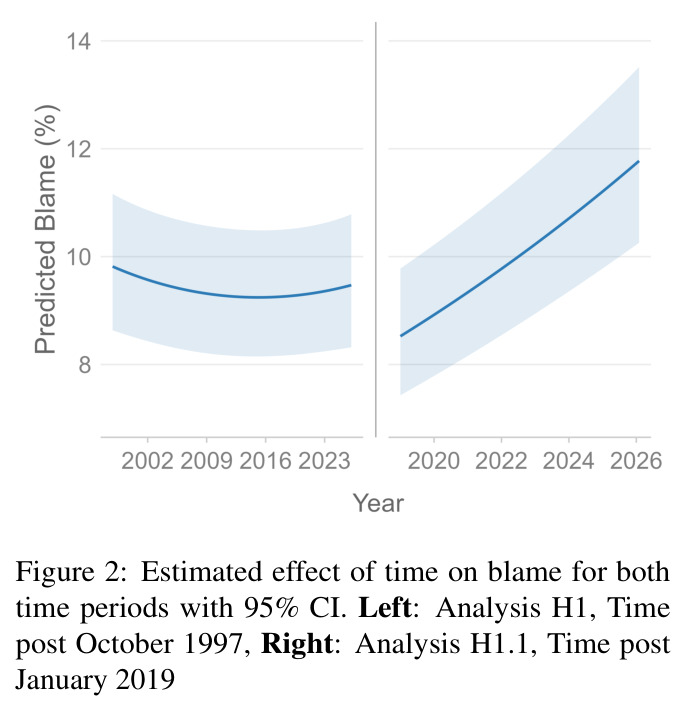
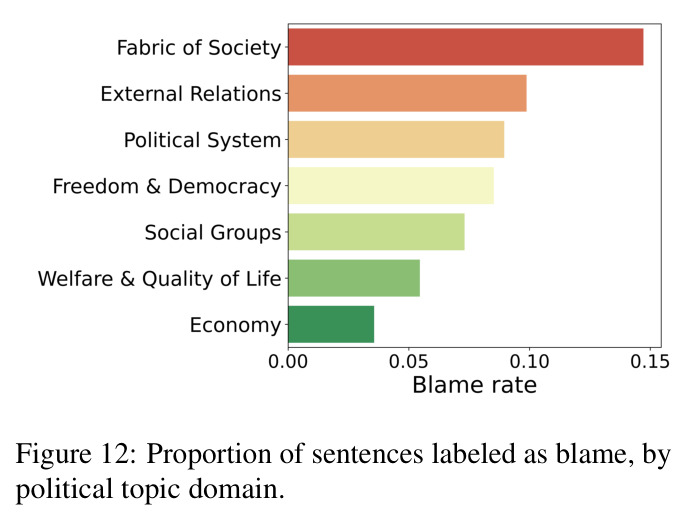
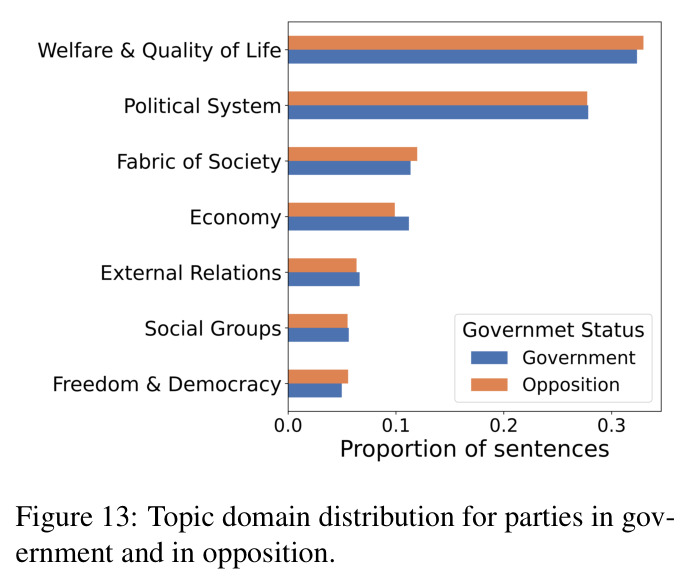
①时间趋势(H1,1997-2026):二次项显著为正(b=0.0135,p=.0347),线性项不显著,归责率呈「香蕉形」轨迹——先降至约 2016 年 4 月的全局最低点,再加速上升,作者将拐点与 2015 年丹麦移民危机后的修辞硬化相联系。②近年趋势(H1.1):2019-2026 线性项显著为正(b=0.0921,SE=0.0086,z=10.7,p<.001)。③政治对照(H2,M2.5):政府身份强烈抑制指责(b=-0.478,z=-23.3,p<.001),左翼执政党指责仅为左翼在野党的约 62%;该抑制效应在右翼弱约 11%(Gov×右翼交互 b=0.105,p=.00236);翼×wingness 交互显著(b=0.554,p=.00265)——右翼每 +1 wingness,指责相对左翼多增约 74%。④近年(H2.1,M4.4):政府效应更强(b=-0.515,执政者指责仅为在野党的 60%)且跨两翼通用(Gov×翼交互不再改善拟合);但翼×wingness 交互增强至 b=0.817(z=5.05):右翼每 +1 wingness 指责激增 126%,显示指责修辞的「意识形态硬化」集中于右翼。⑤敏感性:阈值 τ 从 0.50 提至 0.875(指责率 8.5%→0.4%),核心效应方向与显著性基本保持,唯 H2 的 Gov×翼交互在 τ=0.875 失去显著性(p=.340)。⑥主题混淆检验:「社会结构」域指责率是「经济」域的 3 倍多,但执政/在野党议题分布几乎相同,控制主题后政府效应几乎不变(相对概率 67.5%→66.3%)。⑦模型对比:BlameBERT 宏 F1 0.80(P 0.80/R 0.81)优于 Qwen3 嵌入 0.67 与 Qwen3.5:9B 生成式 0.75,且逐党混淆矩阵无系统性误差。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 丹麦议会归责句二分类(424 句人工金标测试集) | Macro F1 | BlameBERT(DIAL-5 微调 mmBERT)0.80 | Qwen3.5:9B 生成式零样本 0.75(abstain 策略);Qwen3:0.6B 嵌入锚点 0.67 | 较生成式基线 +0.05,较嵌入基线 +0.13 |
| 归责类(正类)识别 | F1 | 0.75 | 生成式 0.60;嵌入 0.65 | +0.10 以上 |
| 归责类识别的精确率-召回权衡 | Precision / Recall | 0.72 / 0.79 | 生成式 1.00 / 0.42(严重漏报);嵌入 0.52 / 0.87(大量误报) | 三者中唯一均衡的模型 |
| 弱监督标签保守度选择(五套 DIAL 对比) | Macro F1(金标测试集) | DIAL-5:0.80(P 0.72 / R 0.79) | DIAL-1(最宽松):0.77(P 0.62 / R 0.88) | 宏 F1 +0.03,精确率 +0.10 |
| 约 510 万句推断集的部署成本 | 推理耗时 / 参数量 | 307M 参数;微调约 20 分钟,单张 L40 推理数分钟 | Qwen3.5:9B 在 RTX 4070 Super 上约 19 小时 | 数量级的效率优势 |
局限与改进
作者承认的局限:其一,标签管线多步引入噪声——丹麦语先机器翻译成英语再用以英语为主的 DEBATE 打标,翻译可能扭曲信号,对反讽、间接修辞和丹麦语特有习语尤甚,且银标中的系统偏差会被微调模型继承而非纠正。其二,翼别与 wingness 是时间不变量、仅覆盖 13 个政党,这些估计的有效样本量更接近 13 而非 2,529,标准误需谨慎解读;两变量又同源于 CHES 的 lrgen,存在信息泄漏。其三,丹麦少数派政府传统下,「支持党」常为政府法案投票却被二值变量当作在野党(2022 年跨阵营政府部分缓解了这一点)。其四,模型只识别「是否指责」,不识别指责对象——一个党可能高指责但矛头指向欧盟、疫情或全球市场而非国内对手,这与理论强调的「跨阵营对照」是不同现象。其五,近年模型(2019-2026)样本较小且被疫情与多次政府更迭干扰。我补充的观察:金标集仅 424 句且标注者是论文作者本人而非独立第三方,κ=0.676 只是中等一致,说明归责构念边界本身模糊;统计模型未传播分类不确定性,可能低估标准误;单一国家的发现(尤其右翼不对称性)能否外推到其他议会制国家仍是开放问题;论文也未对 500 万句推断集做人工抽检来直接估计部署精度。
独立分析的弱点
弱点一:银标存在双重噪声(机器翻译+英语中心的零样本模型),宏 F1 上限 0.80,对反讽类修辞脆弱。改进方向:用丹麦语原生 LLM 或多语言 NLI 模型直接在原文标注,或用主动学习让金标反哺校准。弱点二:没有指责对象,无法直接检验「跨阵营指责」这一核心理论——目前只能说明「在野时指责更多」,却不知道矛头指向谁。改进方向:叠加实体级指向抽取,升级为「谁指责谁」的定向网络。弱点三:13 个政党上的翼别/wingness 推断功效有限,且 CHES 分数时间不变。改进方向:引入动态意识形态测量(如用演讲嵌入随时间估计党派位置),或跨国联合建模扩大政党样本。弱点四:支持党被误编码为在野党,可能稀释政府效应。改进方向:增加「正式支持党」类别或以预算协议签署界定执政集团。弱点五:生成式基线仅用 9B 模型与温度 0 的简单约束解码,16% 空输出说明提示工程不足,基线偏弱削弱对比结论。改进方向:更大模型、few-shot 示例或微调过的生成式基线。弱点六:分类不确定性未进入统计模型,轻度零膨胀也未处理。改进方向:用测量误差模型或多重插补把标签概率传播到回归层。
未来方向
作者提出或暗示的方向:将指责的「指向对象」纳入分析(区分指向国内对手还是欧盟等外部目标);把框架移植到其他低-中资源议会(ParlSpeech V2 覆盖九国,天然适合比较研究);进一步检验极端右翼党是否「拖着」温和政党一起加码指责(作者引用 Hinterleitner 2020 提出这一竞争动态假说但未验证)。基于本文成果可延伸的方向:其一,因果识别——利用丹麦频繁的政府更迭与 2022 年跨阵营大联合政府做断点或差分设计,把「政治对照」从相关推向因果;其二,把分类概率作为测量层并入统计模型(贝叶斯测量误差模型),消除阈值化带来的信息损失;其三,与情感极化、政治信任的调查数据链接,检验议会修辞硬化是否外溢到社会层面(作者在结论中明确暗示这一民主后果);其四,议题×指责的细粒度分析——论文只聚合到七大政策域,56 个细主题及「移民」等争议议题值得单独建模;其五,将 DIAL 弱监督管线固化为多语言可复用工具包,服务其他小语种议会研究。
复现评估
复现条件相当好。代码在 GitHub 公开(github.com/Lundsfryd/BlameBERT),BlameBERT 模型与 folketinget 数据集发布在 Hugging Face(Lundsfryd/BlameBERT、runetrust/blame-folketinget-dk),实验用 Weights & Biases 追踪并提供公开链接,附录给出完整回归系数表(表 8-11)与阈值敏感性分析(表 12)。数据方面 ParlSpeech V2 公开可下载,2019 年后的议会记录来自丹麦议会 SFTP 服务器(公开渠道)。算力门槛低:LoRA 微调约 20 分钟,500 万句推断在单张 L40 上数分钟完成;唯一昂贵的是 Qwen3.5 基线(RTX 4070 Super 上约 19 小时),但复现核心结论并不需要它。需注意的坑:DEBATE 零样本标注依赖 Opus-MT 翻译质量与 DEBATE 权重可用性;金标仅 424 句,第三方自行标注可能因构念定义差异(κ=0.676)出现数值偏差;R 端分析依赖 glmmTMB 与 CHES 2024 数据的特定处理(wingness 计算已在 GitHub 给出)。总体而言,这是计算社会科学论文中复现性较高的工作,中等投入(单 GPU、数天工作量)即可完整复现。
论文图表
附录中更细粒度的处理流程:合并数据 → DaCy 切句 → 去除低质量句与主持人发言 → 划分数据 → Opus-MT 翻译 → DEBATE 定位指责 → 标签映射回丹麦语 → 构建 DIAL 与金标集 → 微调 mmBERT → 得到 BlameBERT → 推断与分析。
复现所需的每一步操作细节都在此图中,与方法复现评估直接相关。
在 τ=0.50/0.625/0.75/0.875 四个阈值(指责率 8.5%/4.8%/2.1%/0.4%)下重拟合各分析最优模型的系数对照:几乎所有效应方向与显著性保持,唯一例外是 H2 的 Gov×翼交互在 τ=0.875 失去显著性(b=0.076,SE=0.079,p=.340)。
结论稳健性的关键证据,同时标明了唯一需要谨慎解读的效应。