动态民主同意:面向公众信任、政治传播与政策反馈的系统动力学框架 The Mechanics of Democratic Dominance: A System Dynamics Paradigm for Dynamic Consent Engineering
把伯内斯公关八步法与S-E-E-D反馈模式融合,建模政治支持与制度信任的动态演化
前置知识
系统动力学(System Dynamics)
一种研究复杂系统的建模方法学:把系统表示为存量(随时间累积的量)、流量(改变存量的速率)、反馈回路与时滞,用微分方程或仿真观察行为模式(指数增长、振荡、S形、崩溃)。它不追求逐点预测,而是解释系统结构如何产生可辨识的行为模式。
本文的全部数学表达、因果回路图和九张模拟图都建立在系统动力学的存量-流量与反馈语言之上,不懂这套语言就无法理解 DDC 框架。
强化回路(R)与平衡回路(B)
反馈回路的两种基本类型:强化回路(Reinforcing)自我放大,微小增长被不断复制,产生指数增长或崩溃;平衡回路(Balancing)寻求目标或承载上限,把系统拉回设定值。复杂系统的行为由多个回路的相对强度和主导权转移共同决定。
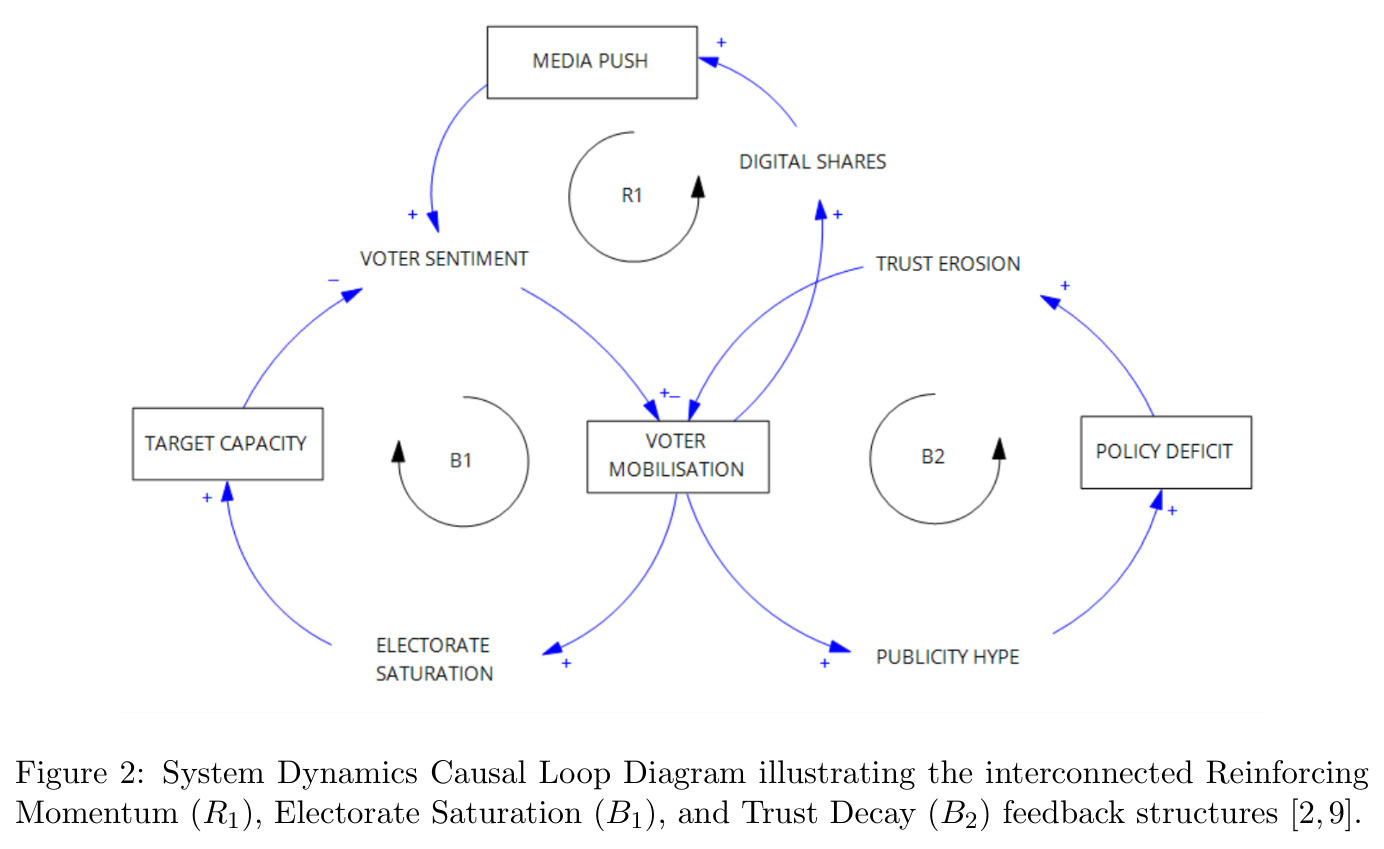
DDC 把政治支持分解为三条回路:R1 病毒式动量、B1 人口饱和天花板、B2 信任衰减,全部结论都源于这三条回路的相互作用。
逻辑斯蒂增长与承载能力
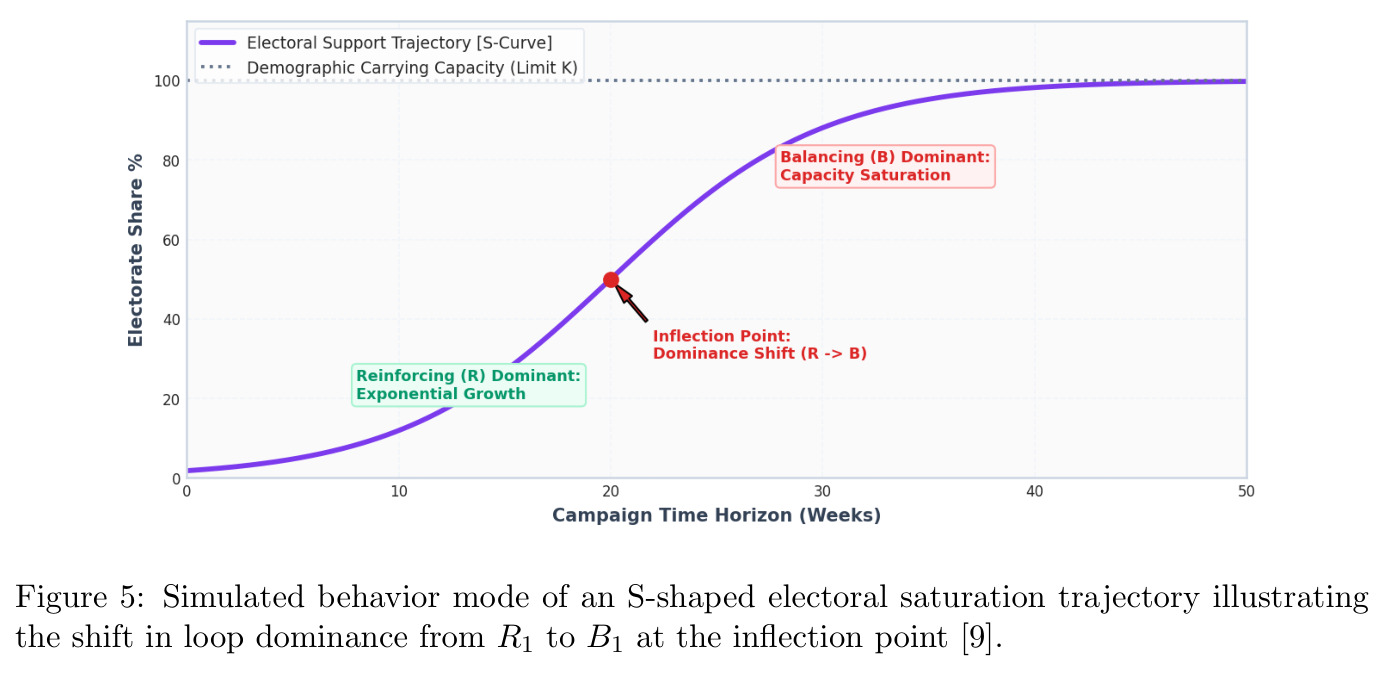
种群或采纳量在资源受限环境中的经典增长模式:$\frac{dS}{dt}=gS(1-S/K)$,初期近似指数增长,接近承载能力 $K$ 时增速归零,形成 S 形曲线,拐点处增长主导权从强化机制转到限制机制。
论文用式(7)的 logistic 形式建模选举饱和,并把传统固定的 $K$ 替换为随制度信任变化的动态上限 $K_{\text{eff}}(t)$。
时滞与信息平滑
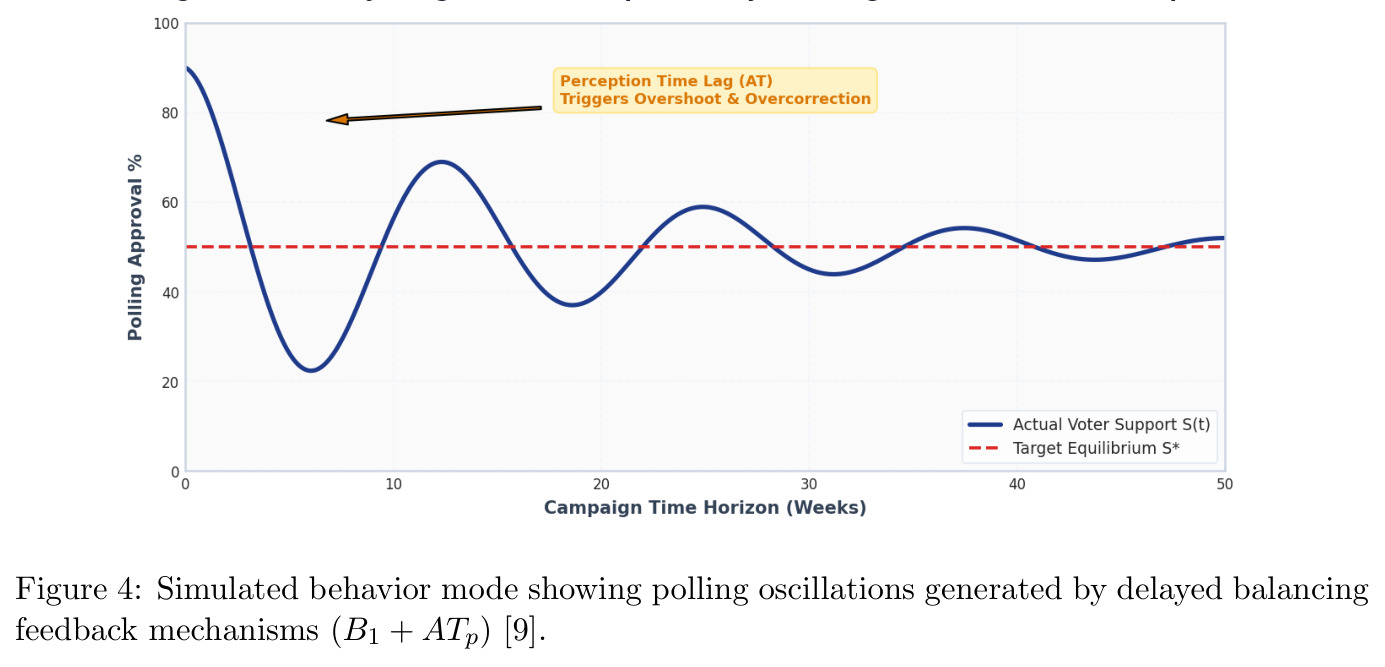
决策者往往无法即时观测真实状态,只能基于被平滑的感知信息行动:感知存量 $P(t)$ 以时间常数 $AT_p$ 向真值 $S(t)$ 收敛,即 $\frac{dP}{dt}=\frac{S-P}{AT_p}$。一阶系统叠加时滞即成二阶系统,增益超过临界值后产生欠阻尼振荡——这是过度反应的数学根源。
论文把'民调延迟导致竞选超调与摇摆选民疲劳'归因于感知时滞 $AT_p$,并给出振荡判别条件即式(6)。
伯内斯《同意的工程》
Edward Bernays 提出的公关奠基理论:民主治理中需要持续、科学地培育公众同意,核心原则是 deeds explained by words(用言辞解释行动);并给出定义目标、研究公众、修正目标、决定策略、设定主题、蓝图组织、编排时序、执行战术的八步规划流程,以及人力、智力、金钱三大资源约束。
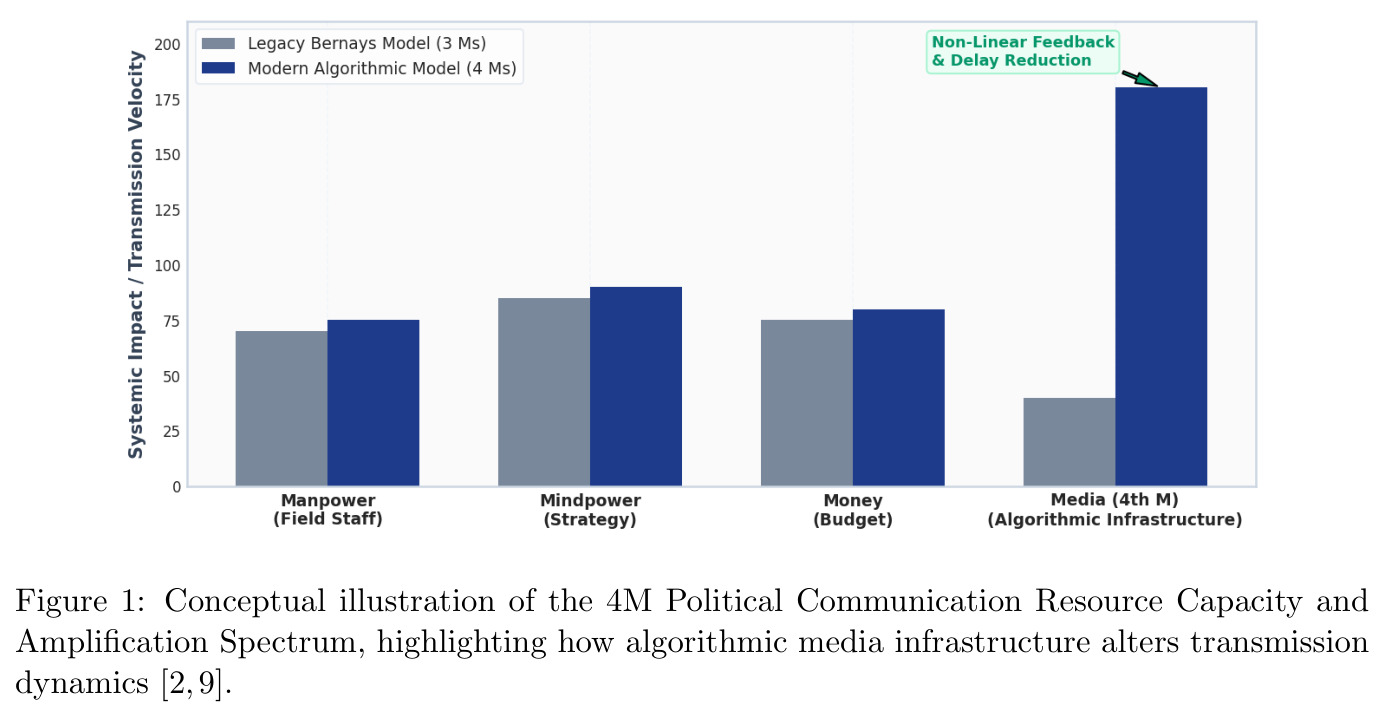
DDC 的定性蓝本:八步流程被逐一映射到系统动力学变量,三大资源被扩展为纳入算法媒体的 4M 范式。
回路主导权转移
系统在任一时刻的行为由相对最强的反馈回路支配;随着状态量接近上限,强化回路的影响力衰减、平衡回路接管,系统从指数增长转为渐近饱和。这是结构影响力在回路间的转移,不是回路本身的物理消失或转换。
论文用主导权转移解释 S 形曲线拐点(图 5),并主张竞选应据此从'选民获取'切换到'联盟保留'策略。
研究动机
主流政治传播研究长期依赖事件驱动或近似线性的模型:竞选广告、辩论表现、政策公告被当作一连串孤立输入,默认每个输入都会产生成比例、即时且可叠加的支持度变化。这类静态假设造成作者所称的'说服-反馈鸿沟':真实的舆论生态是由自增强加速、结构性平衡约束、信息时滞与动态饱和边界共同支配的互联系统,线性模型对此完全失明。具体后果有三类:一是面对延迟到达的民调数据过度加码投放,引发超调、摇摆选民疲劳与反对阵营的反向动员;二是把传播声量当作政策缺口的替代品,短期热度透支制度公信力,支持度随后加速塌缩;三是在接近选民基数上限后继续按早期经验追加曝光预算,遭遇收益递减的平台期。作者指出,忽视这些系统性质,会让政治组织系统性地暴露于选民疲劳、政治波动与制度公信力侵蚀之下。
本文的目标是本文的目标是构建一个名为'动态民主同意'(Dynamic Democratic Consent, DDC)的概念框架,把三类长期分离的知识放进同一分析架构:其一,Bernays 关于持续科学培育公众同意的定性公关学说;其二,系统动力学 S-E-E-D 框架的定量反馈建模语言(Snowball 雪球增长、Equilibrium 均衡约束、Elastic 弹性时滞、Dominance 主导权转移);其三,政策反馈与制度信任研究的长时段视角。具体任务包括:把 Bernays 八步规划流程逐一映射到反馈结构与动力学变量上;将人力、智力、金钱三大资源扩展为纳入算法媒体基础设施的 4M 范式;给出可操作的四步诊断流水线;用模拟参考行为模式展示框架如何解释动量饱和、振荡调整与信任侵蚀。作者明确声明这是探索性而非预测性框架,实证估计、案例检验、敏感性分析与伦理评估留待后续工作。
与已有工作不同的是,两个母学科各自成熟,交叉地带却近乎空白:政治传播学已深入研究媒介框架、议程设置与计算宣传,政策反馈研究也揭示了政府行动如何重塑公民认同与信任;系统动力学在组织管理与公共政策中有成熟应用。但作者指出,把政治传播规划、政策反馈、制度信任与系统动力学行为模式整合进统一分析架构的工作仍然稀缺——公关文献讲流程不讲反馈结构,系统动力学文献建模政策却不建模传播工程。本文的独特切入是双重桥接:纵向把 Bernays 的定性八步'翻译'成 $S^*$、$AT_p$、$K_{dem}$、R1→B1 等动力学操作;横向把算法媒体基础设施作为条件性第四资源引入,认为它压缩感知时滞、放大反馈强度,但其效应受平台架构、受众网络碎片化、语境噪音与对手反制信息的调节,是条件性放大器而非确定性引擎。
核心方法
直觉上,论文主张把政治支持理解为'存量'而非'事件流':支持度 $S(t)$、感知支持 $P(t)$ 与制度信任 $T(t)$ 是三个随时间累积的水池,竞选活动只是改变流入流出速率的动作。技术路线分四层。第一层定义变量与量纲:$S$、$P$ 为百分比存量,$T$ 为 0–100 的信任指数,$S^*$ 为目标支持率,$K_{dem}$ 为人口承载上限,$AT_s$、$AT_p$ 以周为单位,$g$、$\alpha$、$\beta$ 为速率参数。第二层写出模块化参考方程:式(1) $\frac{dS}{dt}=gS(t)$ 刻画 R1 主导的指数动员;式(2) 目标寻的调整;式(3) 感知平滑;式(4) 二阶延迟响应;式(7)(8) 信任调制的 logistic 饱和;式(10) 信任存量动态。第三层把八步公关流程映射为三阶段规划工作流。第四层给出四步诊断流水线,并用九张模拟图逐一展示各行为模式。
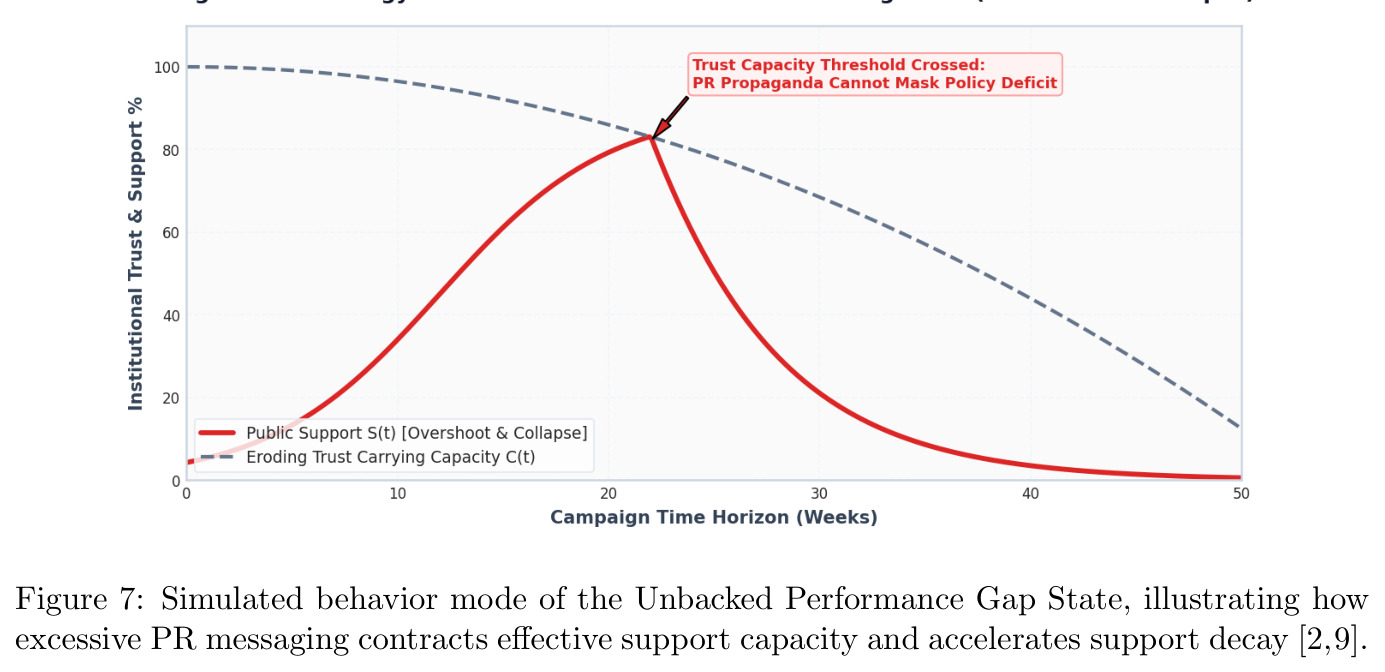
核心创新是把'信任'内生化为调制支持容量的动态存量,而非外生的背景变量。式(8) 定义有效支持上限 $K_{\text{eff}}(t)=K_{dem}\cdot[\lambda+(1-\lambda)T(t)/100]$,其中 $\lambda\in[0,1]$ 是低信任下仍可触达的人口比例:信任越低,可动员的天花板越收缩;一旦天花板跌破现有支持水平,系统将出现任何传播手段都无法阻止的加速流失。这与既有方法的本质区别在于:传统竞选分析把传播与治理绩效分开处理,DDC 则通过 B2 回路让'承诺与兑现的缺口'直接侵蚀容量上限,把 Bernays 'deeds before words' 的格言变成一条可仿真的负反馈。第二个创新是把算法媒体作为条件性第四资源:它不改变增长结构本身,而是压缩感知时滞 $AT_p$、放大 R1 强度,实际效应取决于平台架构、受众网络碎片化与对手反制信息。
方法步骤详情
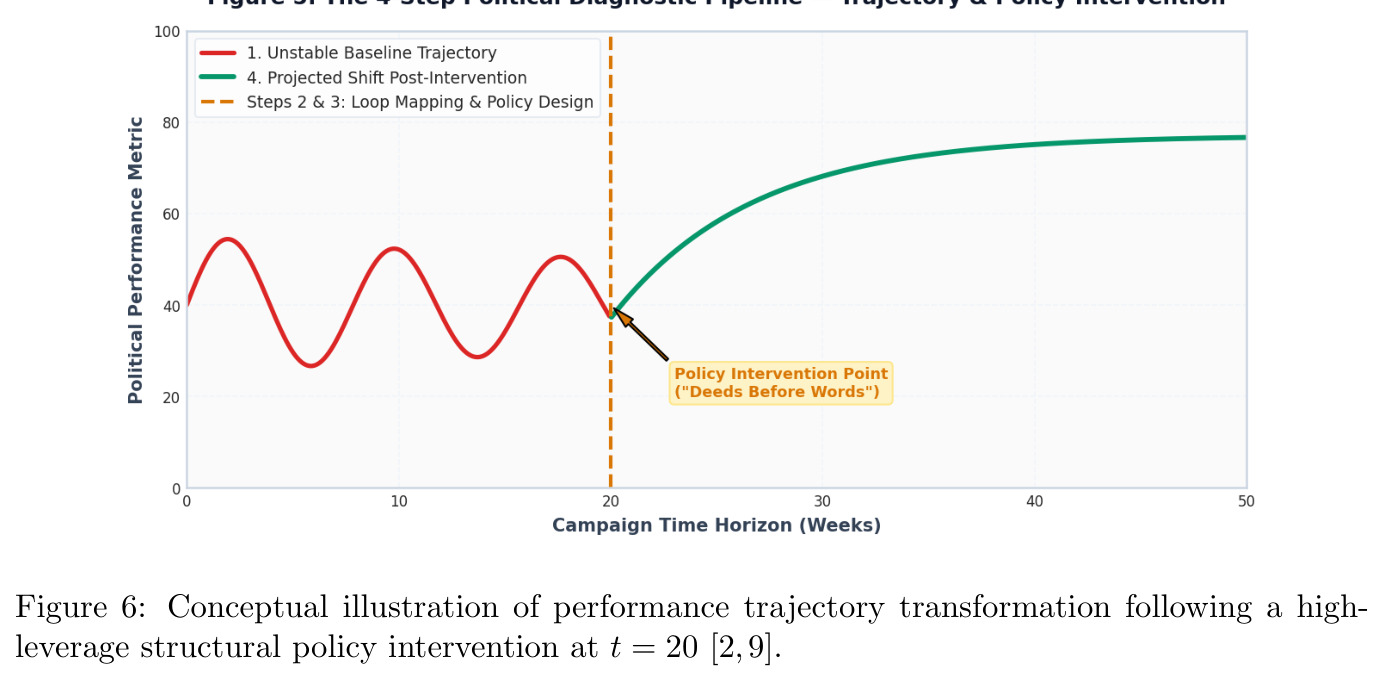
方法分两条线。规划线是三阶段八步。阶段 I 系统校准:第 1 步定义参考目标 $S^*$;第 2 步研究公众,测量感知时滞 $AT_p$;第 3 步按人口承载上限 $K_{dem}$ 修正目标,防止愿望式越界。阶段 II 系统架构:第 4 步规划主导权转移 R1→B1,从获客转向联盟稳定;第 5 步设计高共鸣主题符号作为 R1 触发器;第 6 步按 4M 蓝图配置四种资源。阶段 III 时滞与执行控制:第 7 步编排时序并预留时间、资金、人力安全余量;第 8 步跨渠道实时执行并依情绪反馈调整。诊断线是四步流水线(式 9):轨迹审计(判断激增、平稳、振荡或衰退)→回路映射(定位 R1、B1 还是未管理的 $AT_p$)→政策设计(遵循 deeds before words,修复交付而非加码宣传)→投影偏移(检验干预如何改变主导权)。数学上建立式(1)–(10):指数增长、目标寻的、感知平滑 $\frac{dP}{dt}=\frac{S-P}{AT_p}$、二阶响应 $\frac{dS}{dt}=\alpha(S^*-P)-\beta S$、稳态、振荡条件与信任调制饱和。
技术新颖性
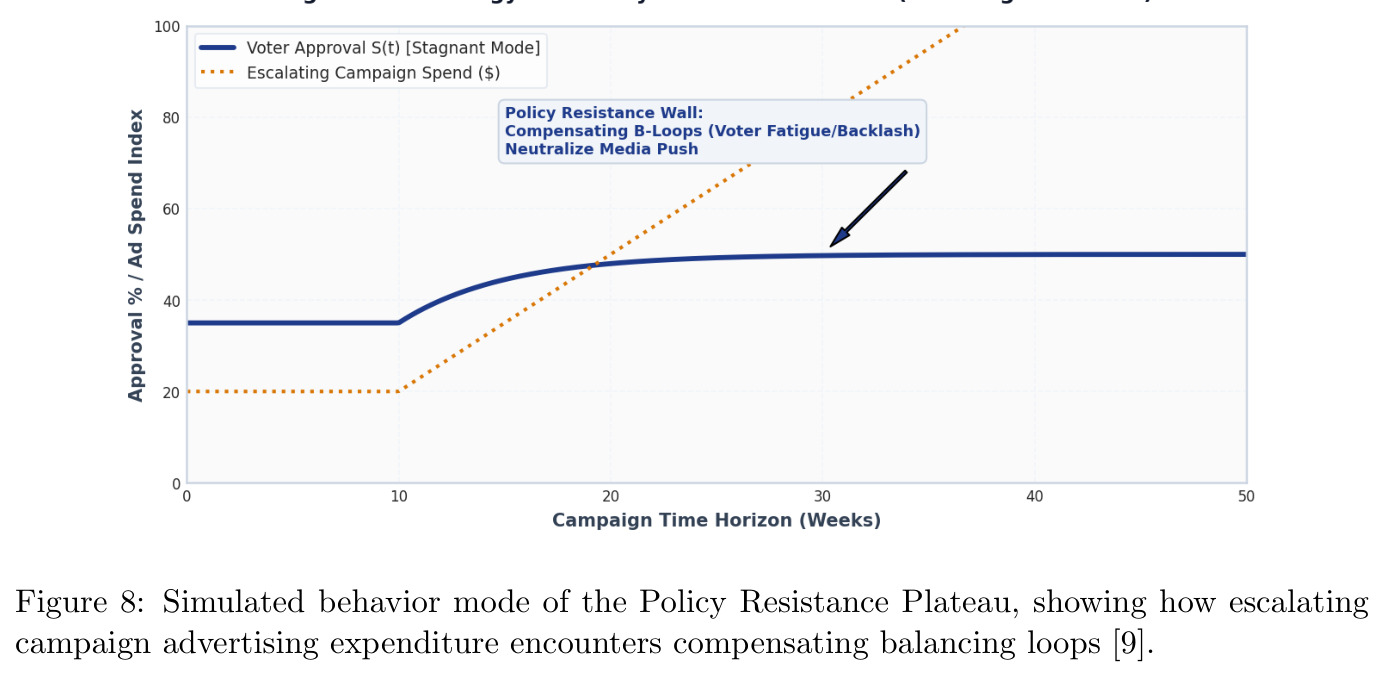
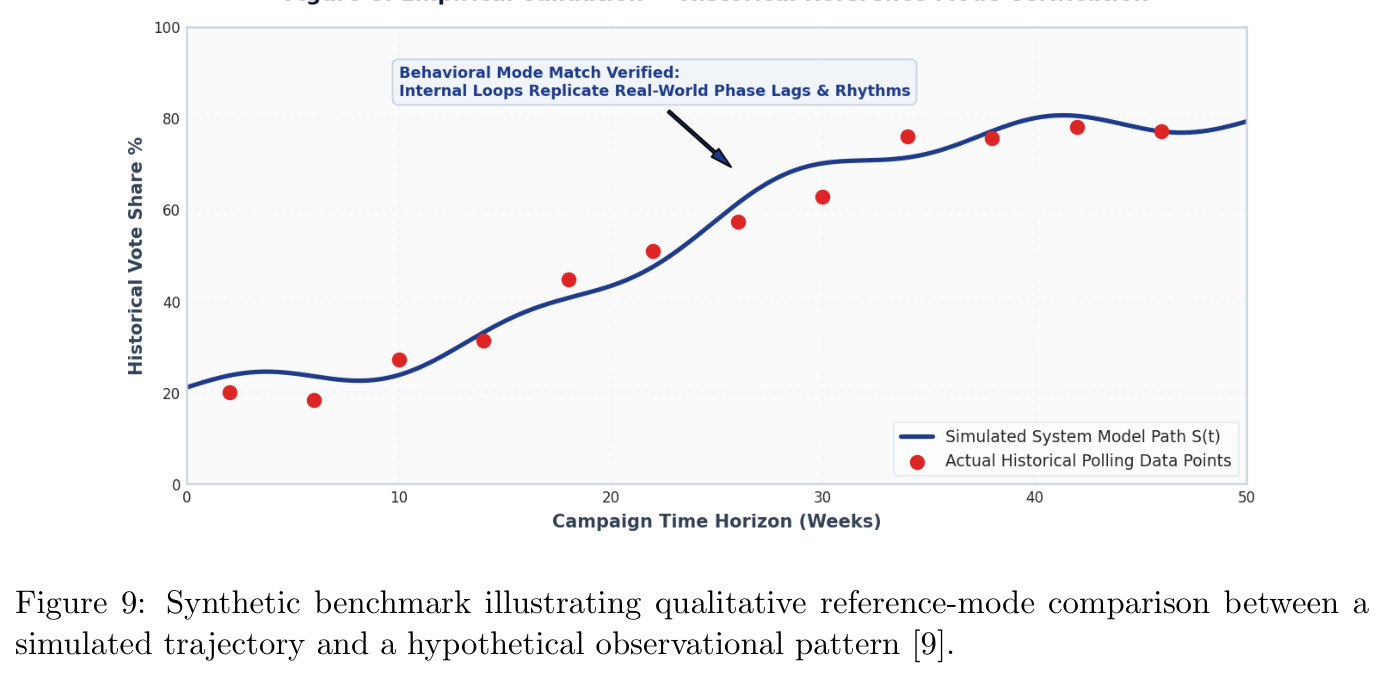
新颖性体现在四个方面。第一,翻译层的系统性:此前 Bernays 八步法只以流程图形式存在于公关实践中,论文首次给出逐步到动力学变量的完整映射表(表 2),例如'决定策略'对应'主导权转移规划 R1→B1','编排时序'对应'感知时滞 $AT_p$ 与弹性管理'。第二,结构创新:$K_{\text{eff}}(t)=K_{dem}\cdot[\lambda+(1-\lambda)T(t)/100]$ 的信任-容量耦合是新的函数构造,把分散在政策反馈文献中的定性结论压缩为单一可仿真机制。第三,失败模式分类学:'未支撑绩效差距'与'政策阻力平台'被定义为两种可诊断的病理,分别对应 B2 失控与补偿性平衡回路激活,而非笼统的'竞选失败'。第四,方法论自觉:论文明确把九张模拟图定位为'参考行为模式'而非预测,并示范参考模式验证程序,与计量经济学的统计拟合范式划清界限。
实验结果
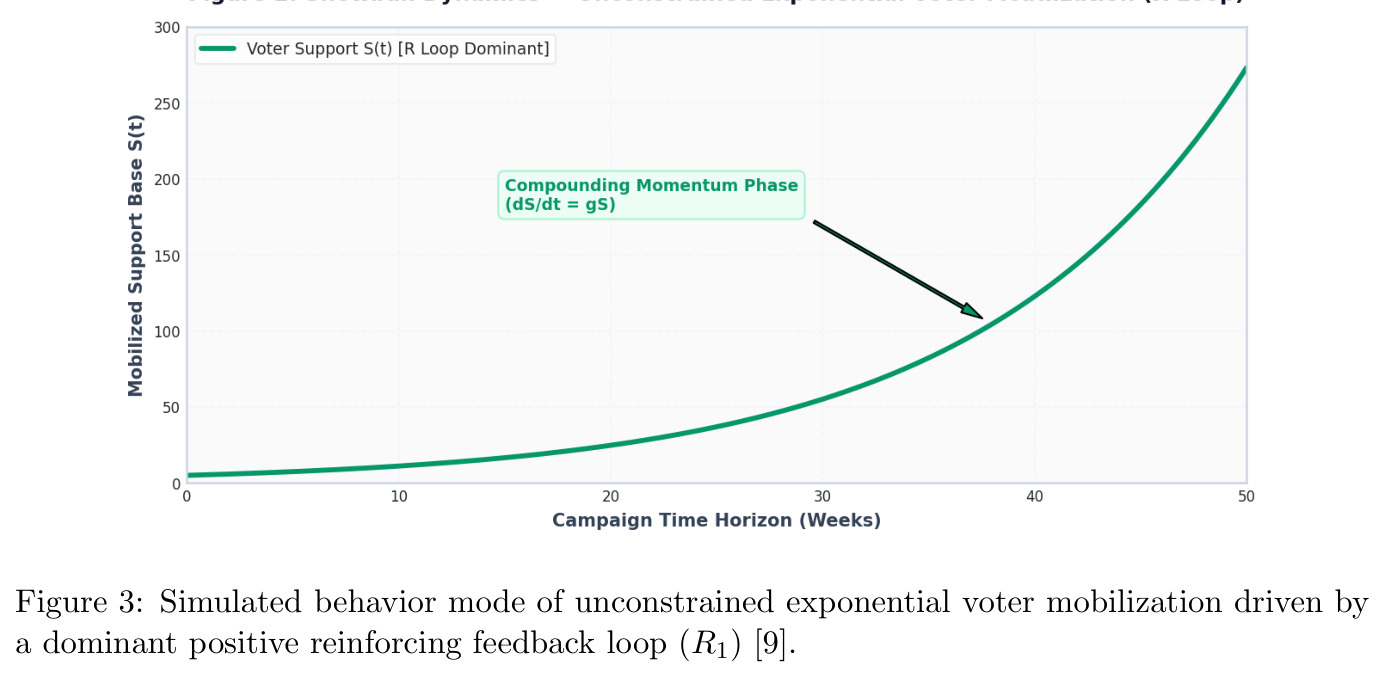
本文结果为一组模拟参考行为模式与解析条件。(1) 雪球:式(1) $dS/dt=gS(t)$ 产生先缓后陡的指数动员曲线(图 3)。(2) 稳态缺口:式(5) 给出 $S_{eq}=\alpha/(\alpha+\beta)\cdot S^*$,流失率 $\beta$ 造成持续缺口,除非 $\alpha\gg\beta$。(3) 振荡:参数满足 $(\beta AT_p-1)^2<4\alpha AT_p$(式 6)时,对延迟民调的激进反应产生超调振荡(图 4)。(4) 饱和:信任调制 logistic 给出 S 形轨迹,拐点即 R1→B1 主导权转移(图 5)。(5) 干预:$t=20$ 处降低 $AT_p$、调低 $\alpha$、降低 $\beta$ 并提高信任形成率后,振荡转为向更高水平收敛的平滑曲线(图 6)。(6) 失败模式:宣传透支信任使 $T(t)$ 衰减、$K_{\text{eff}}$ 收缩到支持水平之下,支持随之塌缩(图 7);仅加码广告则遭补偿回路,收益递减锁死在低平台(图 8)。(7) 参考模式验证:图 9 按相位滞后、拐点等特征与合成基准比对。
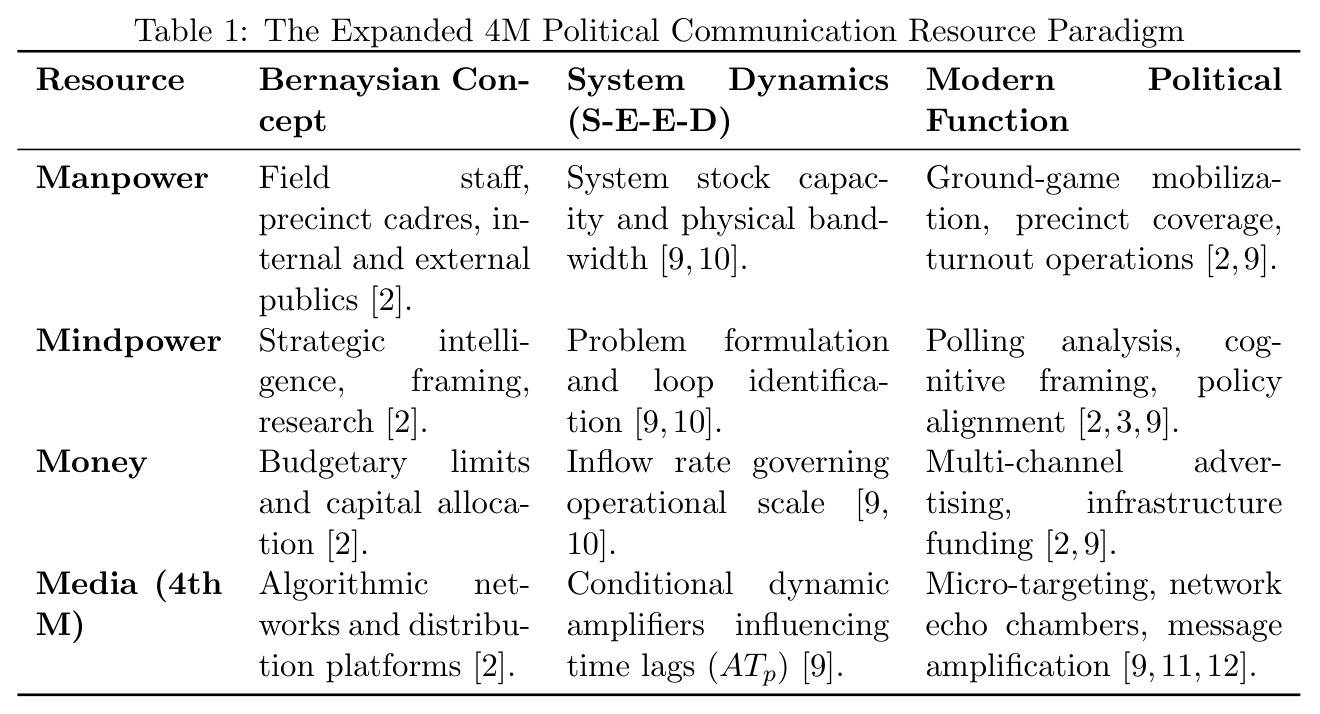
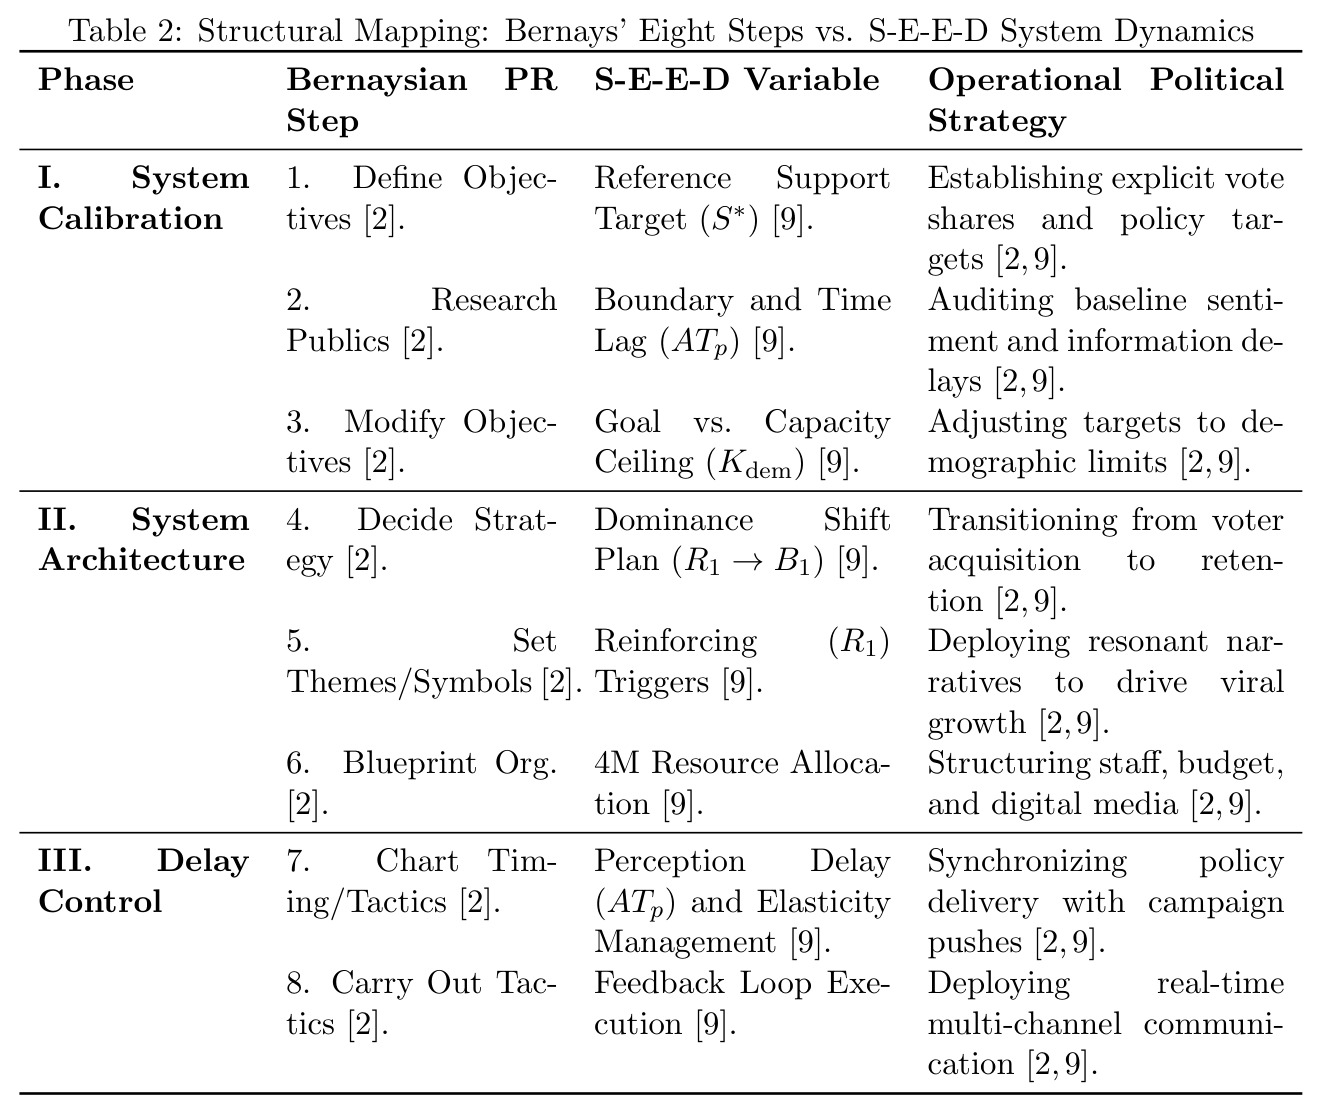
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 无约束动员行为复现(Snowball 模式) | 行为模式定性匹配 | 式(1) $\frac{dS}{dt}=gS(t)$ 生成指数增长曲线(图 3) | 事件驱动线性模型(输入-输出成比例,无复利结构) | 引入自我强化的复利动态,能解释竞选早期热度加速现象 |
| 民调振荡生成与判别(Elastic 模式) | 欠阻尼条件 $(\beta AT_p-1)^2<4\alpha AT_p$ | 满足条件时产生超调-回调振荡(图 4),不满足时单调收敛 | 一阶无时滞模型(式 2,只会平滑趋近目标) | 新增二阶时滞振荡行为类,并给出可检验的参数不等式 |
| 稳态支持缺口 | 解析稳态 $S_{eq}$ | $S_{eq}=\frac{\alpha}{\alpha+\beta}S^*$,恒低于目标除非 $\alpha\gg\beta$ | 无流失理想模型($S_{eq}=S^*$) | 量化自然流失造成的持续缺口及其纠正条件 |
| 结构性干预效果(四步诊断流水线) | t=20 干预前后轨迹形态 | 振荡转为向更高水平的平滑目标寻的收敛(图 6) | 干预前的不稳定振荡轨迹 | 演示降低 $AT_p$、调 $\alpha$、降 $\beta$、提高信任形成率的联合稳定化效果 |
| 参考模式验证 | 定性特征匹配(相位滞后、增长率、拐点、平台) | 模拟轨迹与合成基准逐特征定性一致(图 9) | 无(本文首次示范该评估程序) | 提供不依赖统计拟合的模型评估流程,但基准为合成数据 |
局限与改进
作者承认七条边界:概念性非实证(参数未经计量估计);选民同质假设(抹平人口、意识形态与地区异质性);制度结构简化(单一组织视角,省略多党博弈与议会讨价还价);媒体变异性的抽象化(把算法媒体当作抽象乘子);内生性与因果识别缺失(传播、绩效、支持、信任互相决定);函数形式依赖(logistic 与线性信任-容量关系只是众多可能之一);行为与测量效度未验证。我的补充观察:其一,信任形成率与侵蚀率的具体函数始终未给出,式(10) 只是占位符,$T(t)$ 的演化实际上不可计算;其二,$\lambda$ 与各时间常数没有任何量级指导,图 6 那样的干预效果完全由未公布的参数选择决定;其三,欠阻尼条件(式 6)只对线性二阶系统成立,与式(7)的非线性饱和结构并不完全自洽;其四,框架没有处理对手的策略适应——对方同样会学习与反制,这不是单向的反馈工程;其五,基于合成基准的参考模式匹配在方法论上难以证伪。
独立分析的弱点
独立分析四个弱点。第一,无任何经验锚定:$g$、$\alpha$、$\beta$、$AT_p$、$\lambda$ 全部无量级依据,稳态缺口 $S_{eq}=\frac{\alpha}{\alpha+\beta}S^*$ 的政策含义(例如 $\alpha$ 需为 $\beta$ 的多少倍才可接受)无法量化,改进方向是用 ANES 等选举调查数据或自然实验做参数校准。第二,信任-容量关系的线性形式过强:$\lambda$ 线性插值意味着信任从 40 涨到 60 与从 80 涨到 100 的容量效应完全相同,这与'低信任时信任更稀缺'的直觉相悖,可引入 S 形或阈值函数并做敏感性分析。第三,单一行为者假设:反对党、媒体与平台监管者都被压缩进抽象的'补偿回路',无法解释军备竞赛式动态,改进方向是扩展为多主体博弈或对抗性系统动力学。第四,参考模式验证的判定标准主观:何为'节律相似'没有操作化定义,可借鉴形式化的模式匹配方法(如特征距离度量、贝叶斯模型比较)使该程序可检验、可证伪。
未来方向
作者提出的后续方向包括:完成完整的存量-流量集成模型(现有方程刻意保持模块化、未合并);用具名选举数据集估计参数;对替代假设做敏感性分析;比较竞争性模型结构;跨政治与制度情境评估框架的解释或预测价值;以及系统性的伦理评估。基于本文成果还可延伸:一是补微观基础,把同质存量 $S(t)$ 展开为异质主体的网络扩散模型,让 R1 的'数字转发'具有真实的传染结构,并与 $AT_p$ 的信息瀑布时滞对接;二是用平台 A/B 实验或自然实验实证估计感知时滞 $AT_p$ 与反应增益 $\alpha$——这恰是式(6)振荡条件中可测量的两个量;三是把媒体维度拆解为平台级参数(推荐算法反馈增益、内容审核制度),检验'条件性放大器'命题;四是与因果推断设计结合,正面解决作者承认的内生性问题;五是开发基于四步流水线的诊断工具,把'回路映射'半自动化,供竞选分析实际使用。
复现评估
复现门槛总体低但精确复现不可能。开源情况:论文未提供代码或仿真工程,也没有附参数表。数据情况:全部曲线为作者自造的模拟或合成数据,不依赖任何真实数据集——这反而是障碍,因为没有任何数值参数($g$、$\alpha$、$\beta$、$AT_p$、$AT_s$、$\lambda$、$K_{dem}$、$S^*$ 的取值)被公布。算力需求:九张图都是低维常微分方程的数值积分,任何笔记本用 Python 的 SciPy solve_ivp 几秒内即可完成。难度评估:概念与方程层面完全可复现——式(1)–(10) 足以重建各行为模式的定性形态;但逐像素复现图 3–9 不可能,图 6 中 $t=20$ 干预的具体参数调整幅度、图 9 合成基准的生成方式均未说明。总体属于'低算力、中难度':复现行为模式容易,复现精确图形与任何定量结论(本文其实没有)则无从谈起,这也再次印证其纯概念定位。
论文图表
符号表:$S(t)$ 选民支持存量(百分比)、$P(t)$ 感知支持信息存量、$T(t)$ 制度信任存量(0–100 指数)、$S^*$ 参考目标、$K_{dem}$ 人口承载上限、$K_{\text{eff}}(t)$ 信任调整后的有效上限、$\lambda\in[0,1]$ 低信任下可及比例、$AT_s$/$AT_p$ 以周为单位的调整与感知时滞、$g$ 增长率、$\alpha$ 竞选反应增益、$\beta$ 支持流失率(速率量纲均为 1/周)。
读懂数学部分(式 1–10)与模拟图的必备字典,$\lambda$ 与两个时间常数是框架最有特色的新参数。