RULER:面向 SVG 生成的实例感知量规奖励 RULER: Instance-aware Rubric Rewards for SVG Generation
为每条指令生成六项实例感知量规奖励,结合 GRPO 训练 8B 模型,SVG 质量比肩超大基础模型
前置知识
SVG(可缩放矢量图形)
基于 XML 文本的矢量图形格式,文件本身就是由 path、rect、circle 等图元组成的代码,由渲染引擎(如 CairoSVG)执行成位图。它分辨率无关且结构化,『生成一张图』因此变成『生成一段代码』,质量既取决于代码也取决于渲染后的视觉结果。本文任务即从自然语言指令直接生成 SVG 代码。
RULER 的整条流水线(生成代码→渲染→逐项评分)都建立在 SVG『代码可执行、可渲染』的特性上;不理解代码与渲染结果之间的鸿沟(断路径、空白渲染、碎片伪影),就无法理解标量指标为何失效、为什么需要基于渲染图像的奖励。
GRPO(组相对策略优化)
DeepSeekMath 的无价值模型强化学习算法:对每 prompt 采样 $G$ 个输出并计分,用组内均值和标准差归一化为相对优势 $A_i=(R_i-\mathrm{mean})/(\mathrm{std}+\epsilon)$,再 PPO 式更新;无需 critic,组内质量排序即学习信号。
RULER 的整个训练管线就是 GRPO:六项量规奖励让同组内不同 rollout 各有强弱,天然提供了 GRPO 所需的组内奖励差异;论文 §3.4 的优势公式和附录 A 的全部训练超参都基于该算法。
奖励黑客(Reward Hacking)
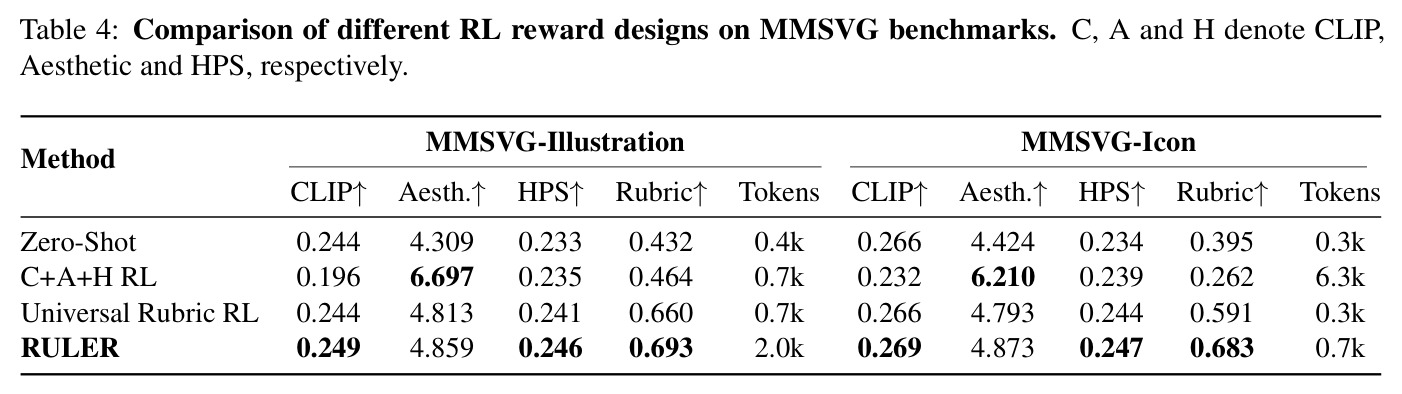
强化学习中目标错位的经典现象(Goodhart 定律):当奖励只是真实目标的代理时,策略会钻代理指标的空子刷高奖励而非真正提升质量,典型行为包括专攻易操纵的指标、生成退化重复模式、利用分类器盲区。论文中 C+A+H 联合奖励把美学分从约 4.4 刷到 6.7 而实际质量崩塌,就是教科书式的奖励黑客。
奖励黑客是本文提出实例感知量规奖励的直接动机:Table 4 中 C+A+H 基线的失败案例和 Figure 4 中 Rubric-S 的文本捷径黑客是理解『为什么需要多轴分解 + 实例感知才能抑制黑客』的关键证据。
VLM-as-Judge 与量规评估
用大型视觉语言模型代替人类给候选输出打分的范式;rubric 评估进一步把『给个总分』拆解为若干明确评估项逐项打分,每项配有 0.9-1.0、0.7-0.8 等连续分数段评分指南。LLM-Rubric 等工作已在文本评估中验证该原语,其可靠性取决于量规设计是否与人类真实标准对齐。
RULER 的评估体系(GPT-5-mini + 通用量规打分作为论文主指标)和奖励体系(Qwen3-VL-8B + 实例感知量规逐项打分)都建立在这个原语上;理解它是把握 §3.2 人类对齐实证分析和 §3.3 评审设计的前提。
标量图像指标(CLIP / Aesthetic / HPS)
三种常用自动图像指标:CLIPScore 度量文本与图像嵌入的相似度;Aesthetic Score 是在 CLIP 特征上用人工美学评分微调的回归头;HPS 用人类成对偏好数据训练的偏好模型。三者均在写实自然图像上校准、输出单一标量,曾被广泛用作文本到图像任务的评估与 RL 奖励。
它们正是本文要推翻的评估范式和基线奖励黑客的来源:论文用 900 个人工标注样本证明它们在风格化矢量内容上与人类的相关性仅 0.55-0.61(量规达 0.79),Figure 1 还给出了破碎 SVG 反而得高分的具体反例。
研究动机
开放式 SVG 生成是典型的『一条指令、无数有效渲染』任务:给定『一只极简猫头的单色蓝色轮廓』,不存在唯一标准答案,评估和训练都缺乏忠实信号。现有自动指标(CLIPScore、Aesthetic Score、HPS)均在写实自然图像上校准,迁移到风格化矢量内容时系统性失效:Figure 1 的蓝色相机 emoji 例子中,一幅路径破碎的坏 SVG 拿到 CLIP 0.23、Aesthetic 4.84,反而不低于忠实版本的 0.18 和 4.93,而人眼明显更喜欢后者——指标直接排错了序。更糟的是,这些有缺陷的指标恰是 RL 训练唯一现成的奖励来源:论文实验显示用 CLIP+Aesthetic+HPS 联合奖励训练时,策略专门刷美学分类器,把它推高到 6.697,但 CLIP 反而从 0.244 跌到 0.196,MMSVG-Icon 上的 Rubric 分从 0.395 崩到 0.262,甚至低于零样本,平均序列长度从 0.3k 爆炸到 6.3k token——模型靠密集重叠笔画和重复装饰路径欺骗分类器;SFT 则退化为克隆数据集模板、无法泛化。评估与训练两端同时缺乏忠实信号。
本文的目标是本文要为开放式 SVG 生成建立一个『不依赖 SVG 真值对、不需要人类偏好标注、却与人类判断高度对齐』的自动质量评估原语,并把它重新用作密集的强化学习奖励信号,把通用 LLM 训练成强大的 SVG 生成模型。具体分两步走:第一步,先通过 900 个人工标注样本的实证分析验证多轴量规评分在样本级相关性(Spearman $\rho$)和成对排序一致性(Goodman-Kruskal $\gamma$)上都远超标量指标,确立量规评分作为开放式 SVG 质量的可靠评估器;第二步,提出 RULER,把每条指令转化为横跨语义、视觉、风格三轴的六项定制量规,用 GRPO 驱动 Qwen3-8B 策略优化,目标是在 MMSVG-Illustration 和 MMSVG-Icon 的 Rubric 分上全面超越专用 SVG 专家模型、比肩大得多的 DeepSeek-V3,同时在 CLIP/HPS 等传统指标上保持竞争力、不触发奖励黑客。
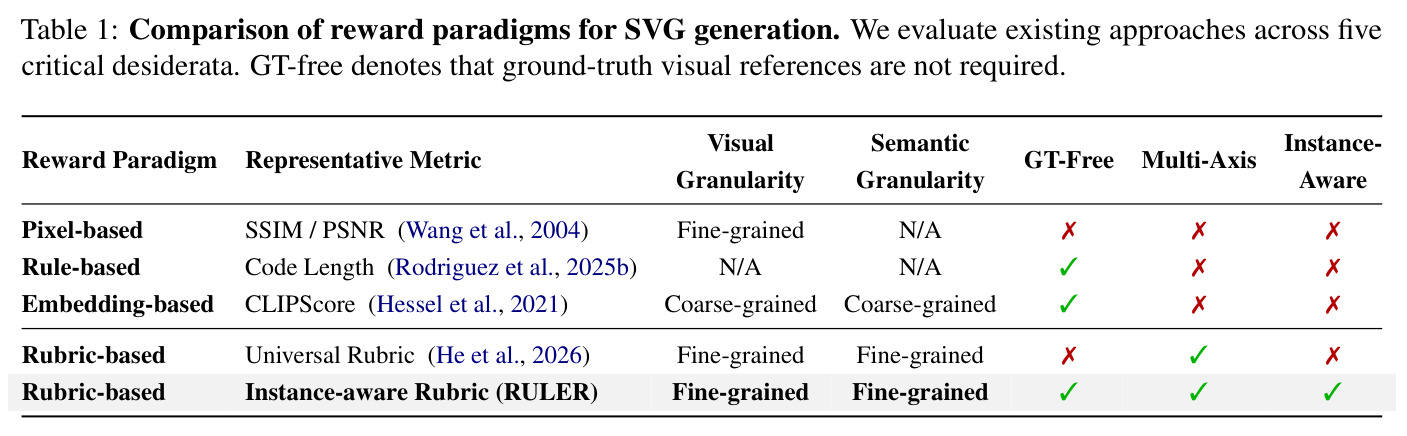
与已有工作不同的是,本文的独特切入角度是『实例感知(instance-aware)』。作者先设立视觉粒度、语义粒度、GT-free、多轴、实例感知五个必要条件,系统盘点既有奖励范式(Table 1):像素类指标(SSIM/PSNR)需要参考图,不是 GT-free;规则类(代码长度)只看代码不看渲染;嵌入类(CLIPScore)虽 GT-free 但只有粗粒度且易被钻空子;新近的通用量规(He et al. 2026)虽细粒度多轴,却把『同一张通用检查表』套在所有 query 上,无法表达 prompt 特有的正确性标准——极简图标和细节丰富的插画本就该用不同判据。RULER 是唯一同时满足全部五个条件的范式:量规条目按具体指令定制(如要求『蓝色机身、黄色镜头、闪光灯』可见),同时量规完全由文本生成、无需任何参考 SVG。方法层面还首次把量规奖励从可验证性较强的文本域(RaR、RGR-GRPO 等)搬到开放式视觉代码,用『理想 SVG 锚点 → 开放式判据』两段式设计解决无真值条件下的量规构建。
核心方法
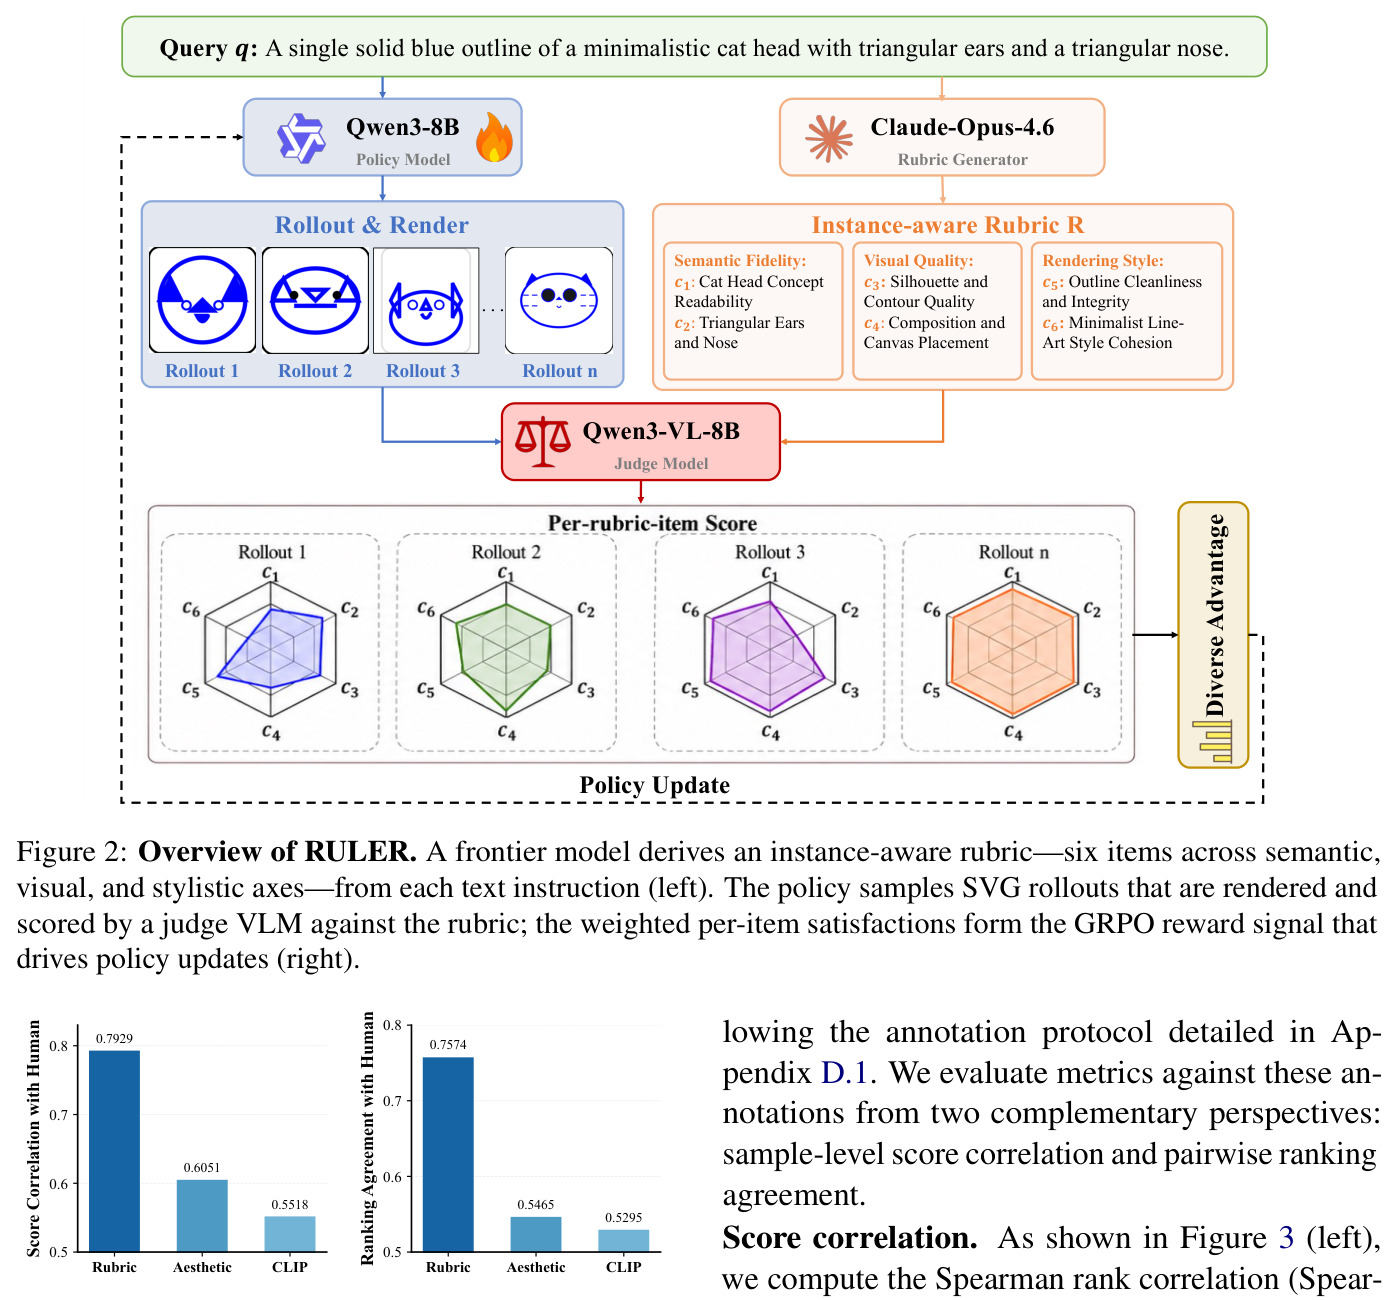
直觉上,RULER 的核心是把『这张 SVG 好不好』这种模糊的整体判断,改写成『这条指令要求的具体各点做到了没有』:先把文本指令拆成六条明确、可独立评判的标准,再让 VLM 对渲染结果逐项打分,加权合成奖励——把不可验证的视觉判断变成一组可验证的子目标。技术路线分两阶段:离线阶段由前沿模型(Claude-Opus-4.6)对每条指令先生成一个理想 SVG 作为质量锚点,再据此派生六项实例感知量规条目(语义轴两条、视觉轴两条、风格轴两条),经格式与质量过滤后构成 30,737 条 prompt-量规训练集(Icon 19,531 条 + Illustration 11,206 条);量规一次性生成后缓存,RL 过程中不再查询生成器。在线阶段用 GRPO 训练 Qwen3-8B 策略:每条指令采样 8 个 rollout,用 CairoSVG 渲染成图像,由冻结的 Qwen3-VL-8B 评审对照量规逐项打分,加权归一成奖励 $R$,再按组内相对优势更新策略。整个框架中评估原语(量规打分)和训练信号(同一量规的加权 satisfaction)是同一个东西。
核心创新点是把奖励构造成『实例感知 + 多轴 + 加权 + 可验证』的结构 $R(I_{gen}) = \frac{\sum_{k=1}^{6} w_k s_k}{\sum_{k=1}^{6} w_k}$,与已有方法的本质区别有三。其一,对标量奖励:每条量规项只针对单一可观察维度、可独立判断、惩罚一类不同失败,权重固定为 (5,5,5,4,5,5),优化器无法靠专攻某一维(如美学分)拉高总奖励,从机制上切断奖励黑客通道。其二,对配对参考:量规纯由文本生成,按『设计意图』而非像素或路径约束打分,prompt 明确禁止把量规写成重建检查表(不要求精确几何、颜色、部件数),保留文本到 SVG 的一对多开放性——不同形状、配色、布局都能得高分,理想 SVG 只在构建量规时充当锚点、评分时评审看不到它。其三,对通用量规:每项的标题、描述和评分指南都为该指令量身定制,例如相机例子要求『明显蓝色的机身、清晰黄色的镜头、可见的闪光灯』,prompt 特有语义要求由此成为显式奖励信号。与 GRPO 结合时,同组内不同 rollout 往往在六个项上各有胜负,天然提供丰富的组内奖励差异。
方法步骤详情
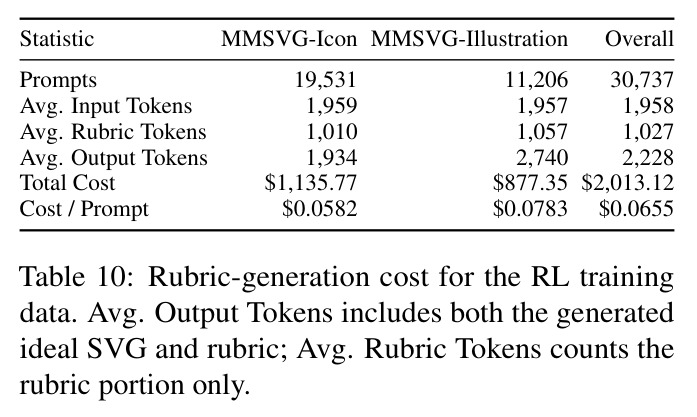
第一步,量规生成:Claude-Opus-4.6 先生成理想 SVG 为参照(评分时不可见),再输出六项量规 $C_Q=\{(c_k,w_k)\}$——语义轴 $c_1$ 概念可读性、$c_2$ 主要部件与线索,视觉轴 $c_3$ 轮廓形态、$c_4$ 构图画布,风格轴 $c_5$ 渲染完成度、$c_6$ 风格凝聚性,权重 (5,5,5,4,5,5),每项附评分指南。第二步,过滤:剔除格式不合格者,再用 Qwen3-VL-8B 给理想 SVG 打分、移除奖励低于 0.9 的量规,得 30,737 对数据。第三步,rollout 与渲染:Qwen3-8B 每条指令采 $G=8$ 个 rollout,CairoSVG 渲染成 512×512 图像。第四步,评分:冻结的 Qwen3-VL-8B 评审逐项输出 $s_k\in[0,1]$,加权归一为奖励。第五步,GRPO 更新:优势 $A_i=(R_i-\mathrm{mean})/(\mathrm{std}+\epsilon)$,学习率 $1\times10^{-6}$、熵系数 0.001、无 KL,batch 128,8 张 H800。
技术新颖性
技术新颖性有三层。评估层面:首次对开放式 SVG 的评估给出系统性实证刻画——900 个由三个能力梯度模型生成、10 人标注的样本上量规评分取得 $\rho=0.7929$、$\gamma=0.7574$,填补自然图像指标域偏移失效后的评估空白。奖励层面:首次把量规奖励从文本域搬到开放式视觉代码——此前 LLM-Rubric、RaR、RGR-GRPO 都依赖文本域中部分可验证的正确性,而视觉代码没有唯一真值,本文的『理想 SVG 锚点 → 开放式判据 → 评分时不给锚点』设计兼顾实例特异性与解的开放性,是无真值量规构建的关键技巧。粒度层面:用通用量规与实例感知量规的对照实验(Table 4,差距 +0.033/+0.092)直接量化『按 query 定制』的价值,而非停留于概念主张。工程细节也体现方法论自觉:生成 prompt 强制六轴正交、禁止『整体美感』式兜底项、评分指南必须写可见证据差异而非『部分满足』式模糊措辞,评审 prompt 明确『不是空白』『勉强能认出』不得高于 0.6,抑制 VLM 评审的打分膨胀。
实验结果
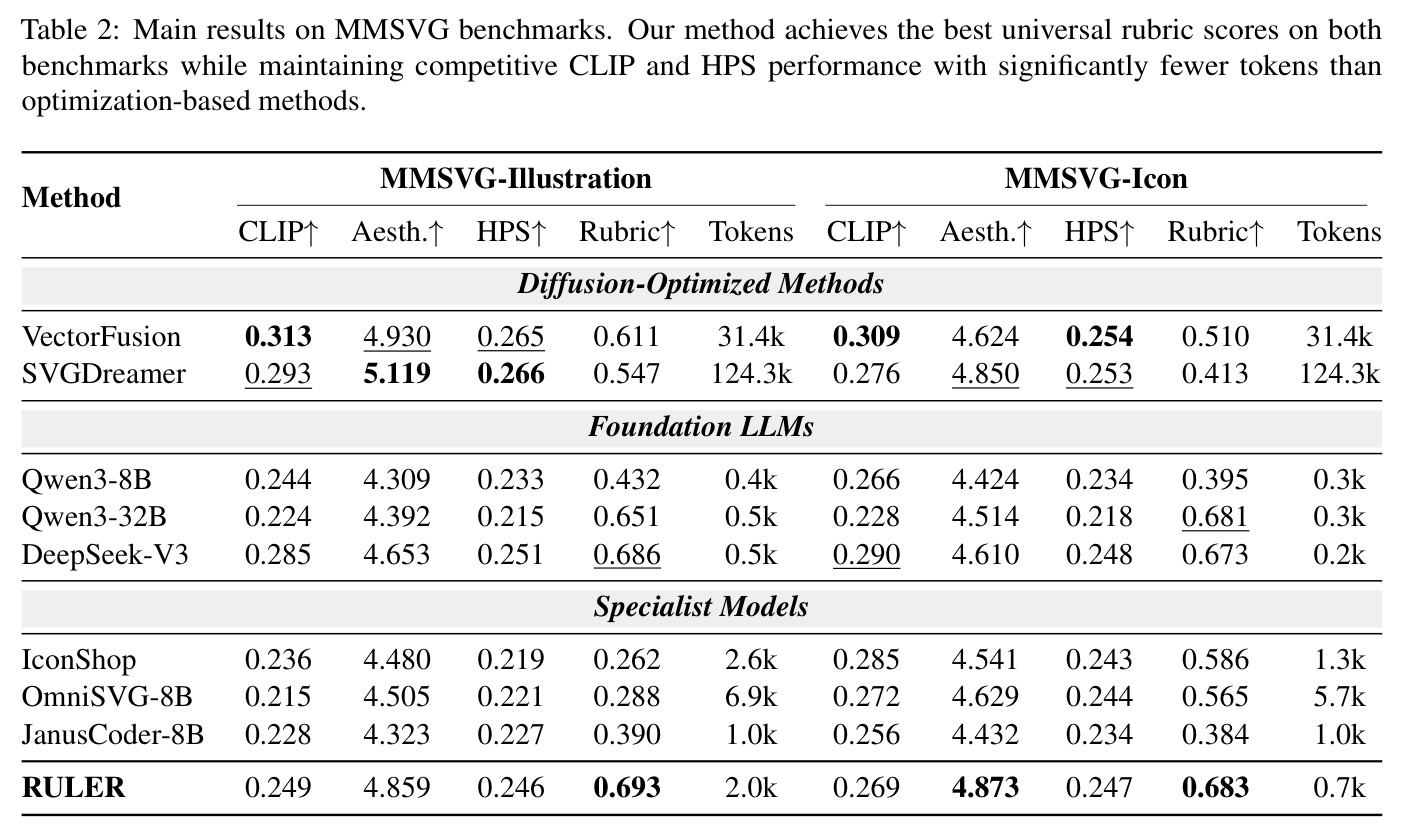
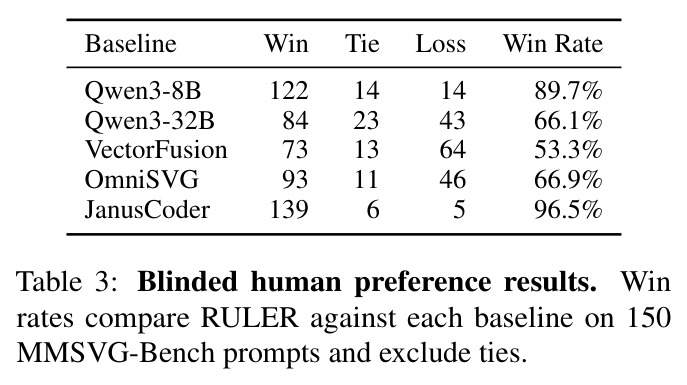
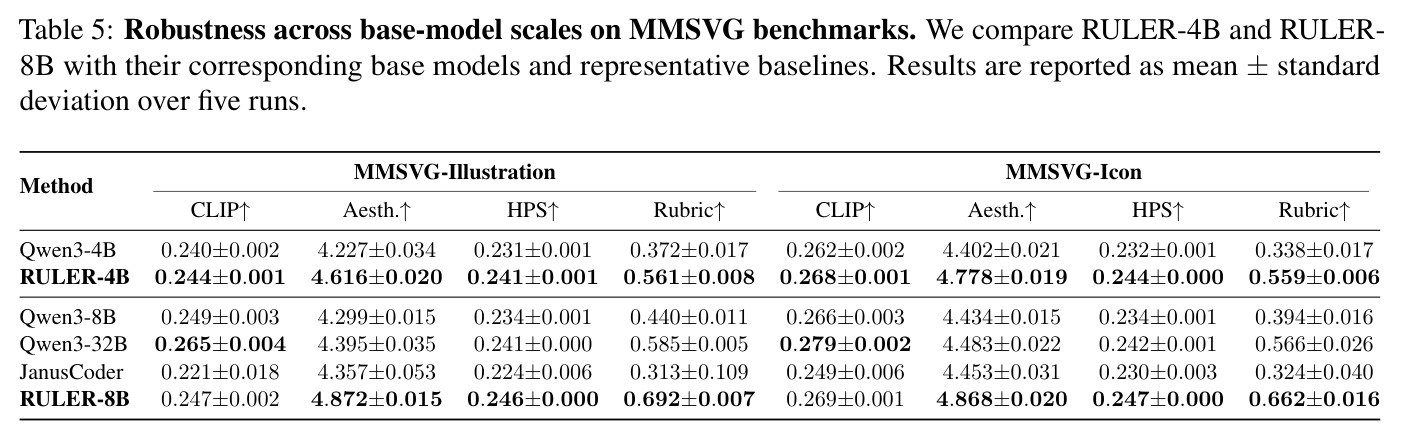
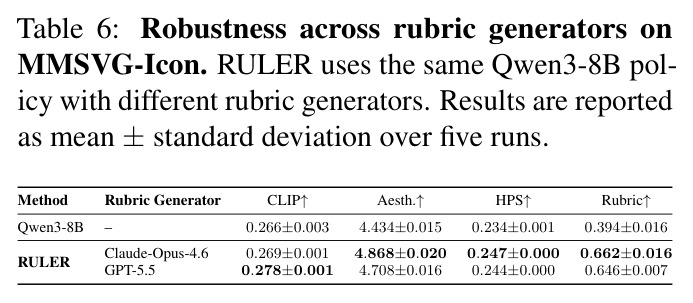
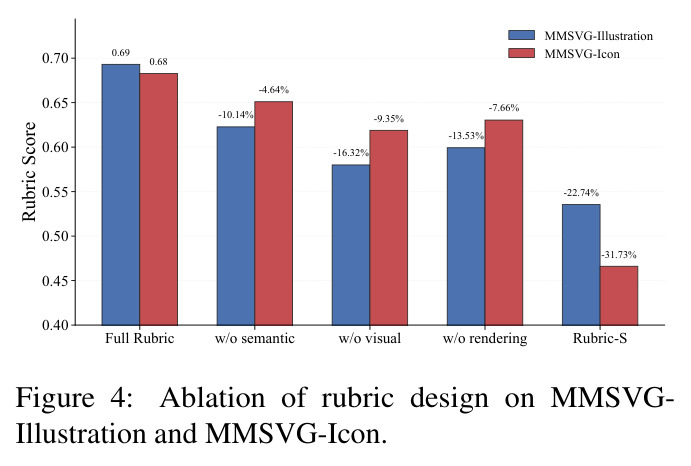
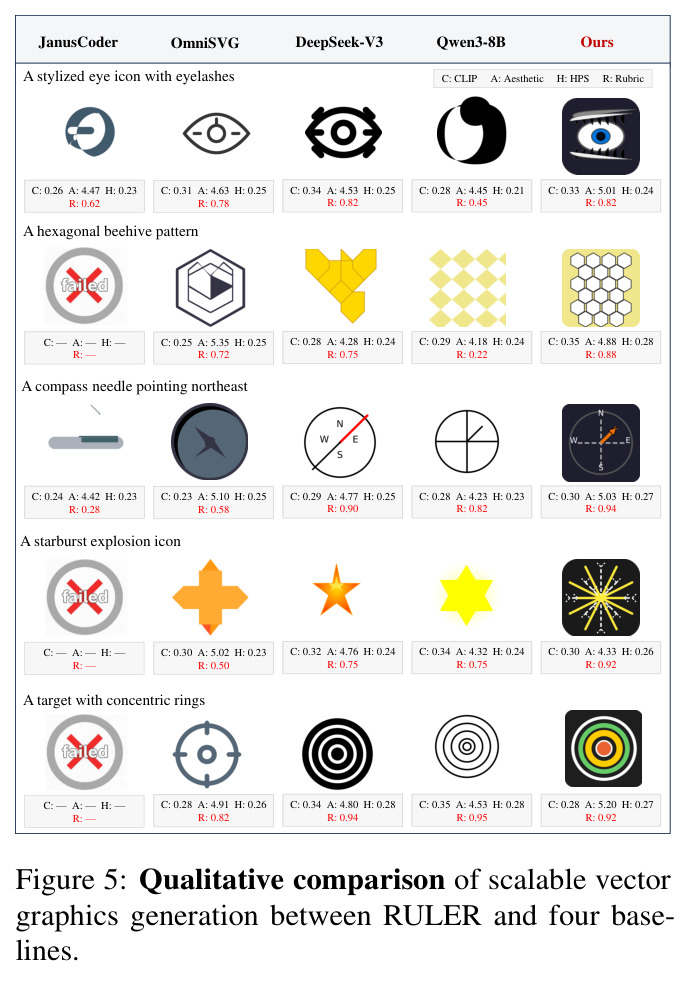
评估上,900 个人工标注 SVG 表明量规评分与人类高度对齐($\rho=0.7929$、$\gamma=0.7574$),远超 Aesthetic 与 CLIP(0.55-0.61)。Illustration 上 Rubric 达 0.693(基座 0.432),超过 VectorFusion、Qwen3-32B、DeepSeek-V3 等基线,Icon 上 0.683;每样本仅 2k/0.7k token,VectorFusion 需 31.4k、72.1 分钟。150 条 prompt 的人类盲评中,RULER 对五基线非平局胜率 89.7%–96.5%。奖励对照中,C+A+H 联合奖励黑客化(Icon Rubric 崩至 0.262、序列长 6.3k);通用量规 0.660/0.591;RULER 0.693/0.683 最优。消融中去视觉轴伤害最大(→0.580),去风格/语义轴次之;更严格的 Rubric-S 反掉至 0.536 并诱发文本捷径。RULER-4B 亦把基座 0.372 提至 0.561、逼近 Qwen3-32B;换 GPT-5.5 生成量规仍 0.646。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放式 SVG 生成(MMSVG-Illustration) | Universal Rubric 分数 | 0.693 | Qwen3-8B 零样本 0.432;最强基线 DeepSeek-V3 0.686 | 较基座 +0.261(约 +60%),超过全部 9 个基线 |
| 开放式 SVG 生成(MMSVG-Icon) | Universal Rubric 分数 | 0.683 | Qwen3-8B 零样本 0.395;DeepSeek-V3 0.673 | 较基座 +0.288(约 +73%) |
| 指标与人类评分对齐(900 样本) | Spearman ρ | 0.7929(量规评分) | Aesthetic 0.6051;CLIP 0.5518 | +0.1878 ~ +0.2411 |
| 指标与人类成对排序一致性(300 组三元组) | Goodman-Kruskal γ | 0.7574(量规评分) | Aesthetic 0.5465;CLIP 0.5295 | +0.2109 ~ +0.2279 |
| 人类盲评 vs JanusCoder(150 prompt) | 非平局胜率 | 96.5% | JanusCoder(vs Qwen3-32B 为 66.1%,vs VectorFusion 为 53.3%) | 对全部五基线均 >50%,最高 +46.5pp |
| 4B 小模型 RL 训练(MMSVG-Illustration) | Rubric 分数(5 次运行均值) | 0.561±0.008(RULER-4B) | Qwen3-4B 零样本 0.372±0.017;Qwen3-32B 0.585 | +0.189,逼近 32B 模型 |
局限与改进
作者承认三点局限:其一,框架依赖两个外部模型——生成量规的前沿模型和打分的 VLM 评审,奖励质量可能继承其偏见、偏好与失败模式,评审可能高估表面线索(如密集细节)或低估细腻的风格质量,在训练分布外的 prompt 上尤甚;其二,RL 计算成本显著上升,每步都要渲染采样 SVG 并逐项查询评审,远贵于 CLIP 或代码规则类奖励,离线量规生成也花了 2,013 美元;其三,语义/视觉/风格的三轴固定分解只是一种『有用』的分解,未必穷尽,可能无法覆盖所有合理的艺术意图或领域特定偏好。我补充两点观察:一是潜在的评价循环性——论文主指标(通用量规分)与训练目标(实例感知量规奖励)高度同构,虽评估用了独立的 GPT-5-mini 评审和 150 条人类盲评,但人类评估规模小、每对仅评一次、标注者仅 3 人,外部效度仍可加强;二是评估局限于图标与插画两类中等复杂度内容,多物体复杂场景、含文字 SVG、图表类内容的泛化完全未测,量规六项(尤其风格轴)对这类内容的适用性存疑。
独立分析的弱点
独立分析有四个弱点。其一,评审单点依赖:奖励完全来自单一冻结的 Qwen3-VL-8B,评审的系统性偏差(如偏爱高饱和色、细节密度)会被策略直接放大为生成偏好,论文未对评审偏差本身做审计;改进方向是多异构评审集成加权、对低一致度样本做仲裁或人工复核。其二,量规离线缓存不随策略进化:量规在训练前一次性生成并固定,当策略能力提升后部分判据可能『变简单』而失去梯度信号,新出现的失败模式却无对应条目;改进方向是按训练动态周期性重生成量规或自适应调整六项权重,形成课程式奖励。其三,缺乏显式长度与复杂度正则:RULER 输出 token 数比基座多(2.0k vs 0.4k),可能混入必要细节之外的冗余笔画,论文未做长度-质量帕累托分析;改进方向是在量规中加入精细的效率/简洁项,或对每项 satisfaction 与序列长度做相关性诊断。其四,Rubric-S 的文本捷径黑客归因不完整:作者只报告了『更严格反而更差并触发渲染文字』的现象,未剥离五项结构、去掉风格轴、固定 -2 权重惩罚项三个变化各自的贡献;改进方向是设计正交解耦的消融,弄清到底是结构变化还是惩罚项诱发了新的钻空子通道。
未来方向
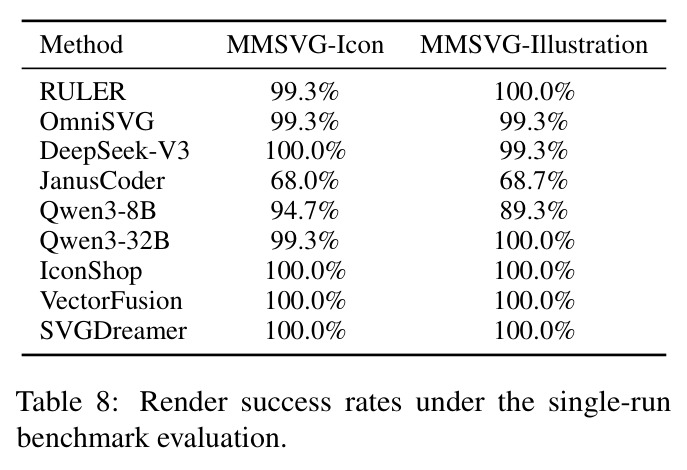
作者明确提出的方向是把量规设计扩展到交互式、人类可引导、领域自适应的设定,让分解轴和判据可按领域或用户意图调整。在此基础上可延伸:(1) 评审自蒸馏——用实例感知量规评分数据微调小型开源 VLM 评审或专用评分头,把每步渲染加评审的开销降低一个数量级,解决可扩展性;(2) 把『实例感知量规 + GRPO』范式迁移到其他缺乏绝对真值但有可执行渲染通道的视觉代码域,如 GUI/HTML 代码、TikZ 与绘图代码、图表生成、3D 场景代码;(3) 过程化奖励——SVG 代码天然有图元/分组/图层结构,可对中间渲染状态逐步评分,缓解序列级奖励的 credit assignment 稀疏问题;(4) 把渲染成功率显式并入奖励——人类盲评中渲染失败直接判负,而当前奖励对空白渲染只有过滤没有惩罚项;(5) 在线/课程式量规生成,随策略能力动态提升判据难度,形成 self-paced RL;(6) 评审鲁棒性研究——系统测量策略在训练时未见过的评审模型族上的表现,量化对评审的过拟合程度,这对所有 VLM-as-reward 工作都有普遍意义。
复现评估
复现条件较好但有门槛。开源情况:论文承诺公开代码、已生成的量规和处理的训练数据(项目页 hangyuran.github.io/RULER),训练栈全部开源——VERL 框架 + vLLM rollout + Qwen3-8B 策略 + 开源 Qwen3-VL-8B 评审 + CairoSVG 渲染,附录 A 完整给出训练超参,附录 H 公开全部 prompt 模板。门槛在于:算力需单节点 8 张 H800 80GB;默认量规生成器 Claude-Opus-4.6 是闭源 API,但换 GPT-5.5 仅小幅下降(0.662→0.646),生成器特异性低;离线量规生成 30,737 条 prompt 花费约 2,013 美元(输入 60.18M + 输出 68.49M token,约 $0.0655/条);训练总时长未报告。综合评估:复现难度中等——流程清晰、数据可重建,但完整复现需要相当 GPU 与 API 预算;务实路径是缩小规模(1-2k prompt、4B 策略)先验证量规奖励相对 C+A+H 的优势能否复现。
论文图表
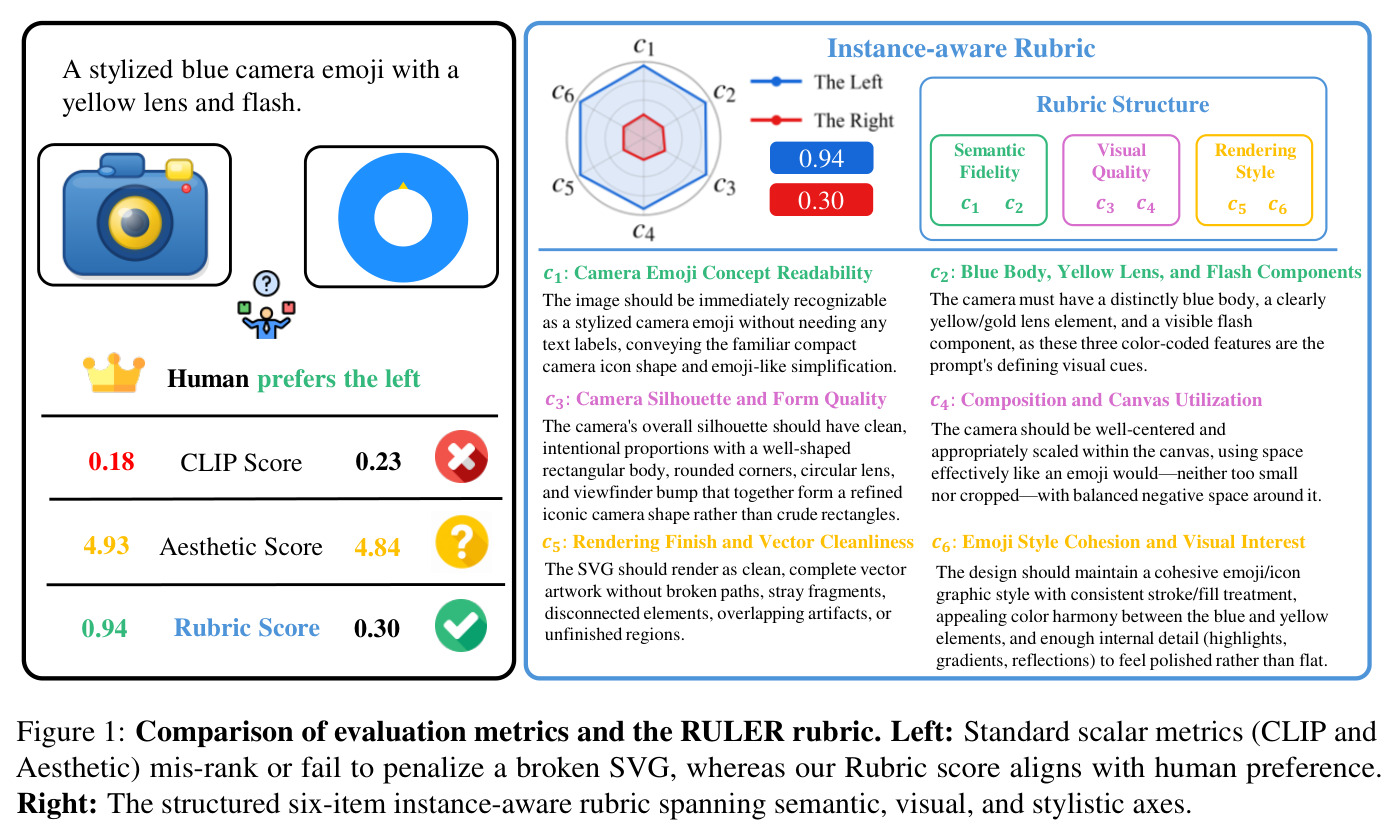
左侧是风格化蓝色相机 emoji 的对照案例:忠实版本得 CLIP 0.18、Aesthetic 4.93、Rubric 0.94,破碎版本得 CLIP 0.23、Aesthetic 4.84、Rubric 0.30——标量指标对破碎 SVG 不惩罚甚至排错序,而 Rubric 分与人类偏好(人类选择左图)一致。右侧展示该指令的六项实例感知量规全文:c1 相机 emoji 概念可读性、c2 蓝机身/黄镜头/闪光灯三大部件、c3 轮廓与形态质量、c4 构图与画布利用、c5 渲染完成度与矢量整洁性、c6 emoji 风格凝聚性,每项附带针对性的具体评分描述。
一张图同时完成两件事:暴露标量指标在风格化矢量内容上的域偏移失效(论文动机的具象化),并直观展示『实例感知量规』长什么样(方法形态的预览),是理解全文的最佳入口。
两组柱状图对比三种自动指标与人类判断的对齐程度:左图是 900 个样本上的 Spearman 等级相关,量规评分 0.7929 对 Aesthetic 0.6051 和 CLIP 0.5518;右图是 300 组三元组(900 个成对比较)上的 Goodman-Kruskal γ 排序一致性,量规 0.7574 对 Aesthetic 0.5465 和 CLIP 0.5295。
这是论文『先验证评估、再转化为奖励』路线的实证基石:没有这组数据,后续用量规做 RL 奖励和主评估指标的选择就失去依据;它把『现有标量指标不可信』从定性抱怨变成了定量结论。