GAE:面向三维一致世界生成的几何原生潜空间 GAE: Learning a Geometry-Native Latent Space for 3D-Consistent World Generation
把几何基础模型特征重参数化为紧凑潜空间,让感知与生成共享同一状态
前置知识
几何基础模型(DUSt3R / VGGT / DA3)
一类前馈神经网络,从一张或多张图像直接回归深度图、相机内外参和点图(point map),并把所有视图对齐到统一的 3D 坐标系,无需逐场景优化。Depth Anything 3(DA3)是其中的代表:其编码器输出四个层级的特征金字塔,再由一个密集预测 Transformer(DPT)头解码为深度、相机射线和点图。这些模型在多视角几何估计上已接近甚至超过传统 SfM/MVS 流水线。
GAE 的整个潜空间就来自冻结的 DA3 编码器特征,且几何读出复用其冻结 DPT 头。不理解“冻结编码器 + 冻结解码头”这一结构,就无法理解 GAE 为什么能保证潜变量的几何可读性。
流匹配(Flow Matching)与 DiT
流匹配学习一个速度场,把高斯噪声沿线性路径 $\bar z_t=(1-t)\bar z_{gt}+t\epsilon$ 连续输运到数据分布,训练目标是回归速度 $u_t=\epsilon-\bar z_{gt}$,采样时用 Euler 等 ODE 求解器积分。网络实现通常采用 DiT 式 Transformer(如 DDT 双塔结构),配合 classifier-free guidance(CFG)提升条件服从度。
GAE 的第二阶段就是在其几何原生潜空间里训练一个条件流模型,文生图、相机控制视频、新视角合成三个任务共享同一套权重。本文所有生成实验的对比协议都围绕这套流模型展开。
表征自编码器(RAE)与潜空间可扩散性
传统 latent diffusion 用像素 VAE 压缩外观;RAE 则直接用冻结的预训练表征(如 DINOv3)作为生成状态。“可扩散性”刻画一个潜空间是否适合做生成输运:包括传输平滑度 $\rho$(类内/场景内方差占比,越低越好)、协方差条件数 $\kappa$ 与有效秩(衡量各向异性和维度利用),以及语义邻域一致性 LNC、空间结构 LDS/SRSS 等结构指标。
本文的核心论点是“潜空间决定生成质量”,全文论证都建立在这套诊断指标上:先测表征(Table 1/2),再做受控生成对比,证明表征性质能预测下游表现。
表征对齐(REPA / C-RADIO / DINOv2 蒸馏)
REPA 证明用预训练自监督教师对齐扩散模型的中间表征能大幅加速训练。C-RADIO 是聚合多个视觉基础模型的蒸馏教师,提供语义组织良好的逐位置 token;DINOv2 是自监督 ViT,其特征保留良好的成对相似度结构(图像内空间邻域关系)。对齐可以施加在去噪器内部特征(REPA 做法),也可以直接施加在自编码器潜变量上。
GAE 用两级对齐塑造潜空间:逐 token 对齐 C-RADIO($\mathcal{L}_{tok}$)改善传输平滑度,匹配 DINOv2 成对相似度($\mathcal{L}_{struct}$)保住空间关系结构。二者缺一会导致潜空间塌缩,这是方法的关键设计。
Plücker 射线相机条件
用每个像素的光线表示相机位姿:方向 $d$ 与矩 $m=o\times d$ 组成 Plücker 射线 $(d,m)$,对整个图像网格形成空间射线场。SCoPE 式设计把射线嵌入 DiT 的 query/key 自注意力,使 token 间的交互显式依赖于对应相机光线;再附加对数尺度通道 $s=\log(\|m\|+\epsilon)$ 保留公制平移幅度,实现尺度可控的相机条件。
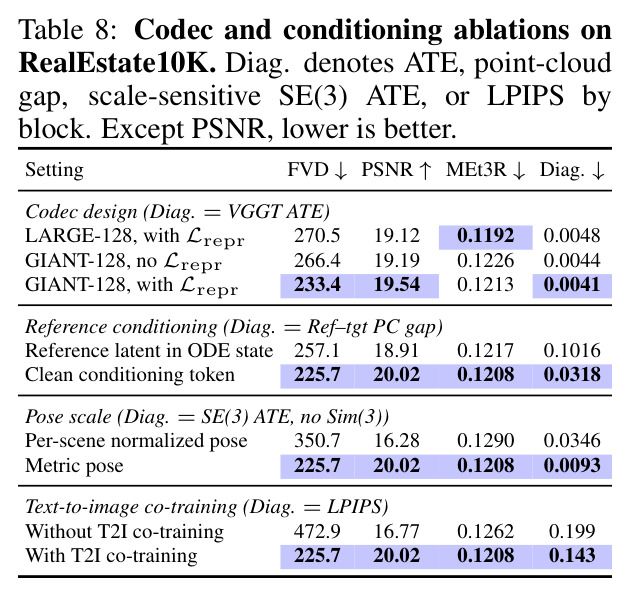
这是 GAE 实现精确相机轨迹控制的机制。消融显示:改用逐场景归一化位姿会丢失平移尺度,无 Sim(3) 对齐的 SE(3) ATE 从 0.0093 恶化到 0.0346,说明公制射线条件至关重要。
研究动机
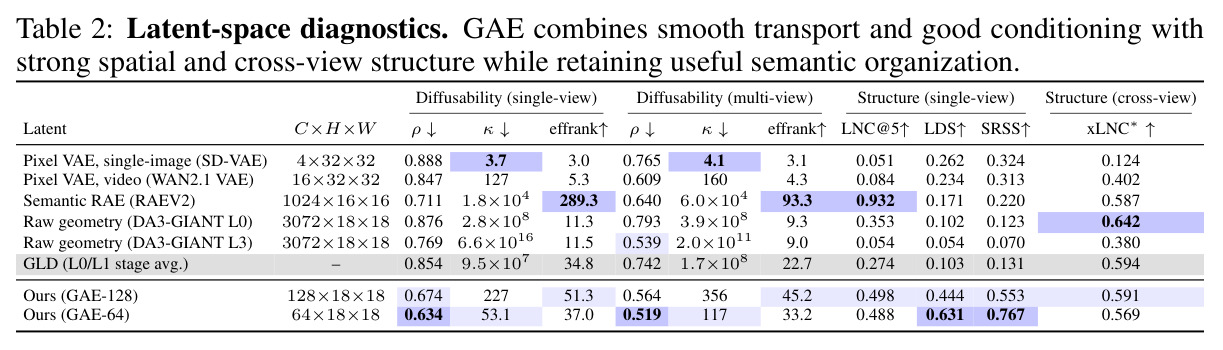
视频生成器能产出逼真帧,却保不住一致的 3D 场景:从生成帧恢复的几何会漂移,相机轨迹也会偏离指定路径——作者概括为“感知能读出的几何,生成还写不出来”。若视频生成要充当世界模型的基础,其帧必须描述一个持久场景。现有补救(相机控制如 CameraCtrl、特征对齐如 Geometry Forcing、几何奖励后训练如 VGGRPO、RGB 与几何潜空间耦合等)本质上都是把几何作为附加输出或控制信号,叠加在外观主导的像素/语义潜空间之上。而反过来直接用几何基础模型特征做生成也行不通:作者以 DA3-GIANT 为受控案例诊断发现,其单层特征虽有 3072 通道,有效秩却只有约 11,条件数高达 $10^8\sim10^{16}$,绝大多数通道近乎失效;且没有任何单一层级能同时保留语义、空间与跨视角结构——浅层 L0 跨视角检索最强(xLNC* 0.642)但传输平滑度差($\rho=0.876$),深层 L3 更平滑($\rho=0.769$)却几乎丢失空间结构(LDS 仅 0.054、SRSS 仅 0.070)。
本文的目标是本文要学习一个“几何原生”的紧凑潜空间,作为感知与生成的共享接口。具体目标有三条原则:(1) 保留感知模型(DA3)已经编码的几何信息;(2) 让外观与几何统一在同一个紧凑表示中,由单一潜变量同时解码出 RGB、深度、相机射线与点图;(3) 把这个表示组织得适合生成输运,使一个标准条件流模型(而非级联)就能在其上完成文生图、相机控制视频与参考图新视角合成。最终让生成器演化的状态本身就是可被几何基础模型直接读取的 3D 状态。
与已有工作不同的是,与既有工作的独特差异在于视角转换:几何不是被“加到”外观潜空间上,而是生成状态本身由几何基础模型导出。最近的 GLD 直接对 DA3/VGGT 的多层特征建模,需要级联多个流模型逐层生成并传播层级;隐式黎曼流匹配则在四层归一化特征的乘积流形上演化,两者都直接生成高维骨干特征。GAE 的切入点是:在冻结的 DA3 编码器与冻结的几何头之间插入一个可学习的瓶颈,把整个层级重参数化为单一欧氏紧凑潜变量(64/128 通道)——几何头永不更新,从而“压缩后的信息必须仍能被原 DA3 接口读出”成为硬约束;再用 token 级与关系级两种对齐把层级组织成平滑可输运的生成状态。
核心方法
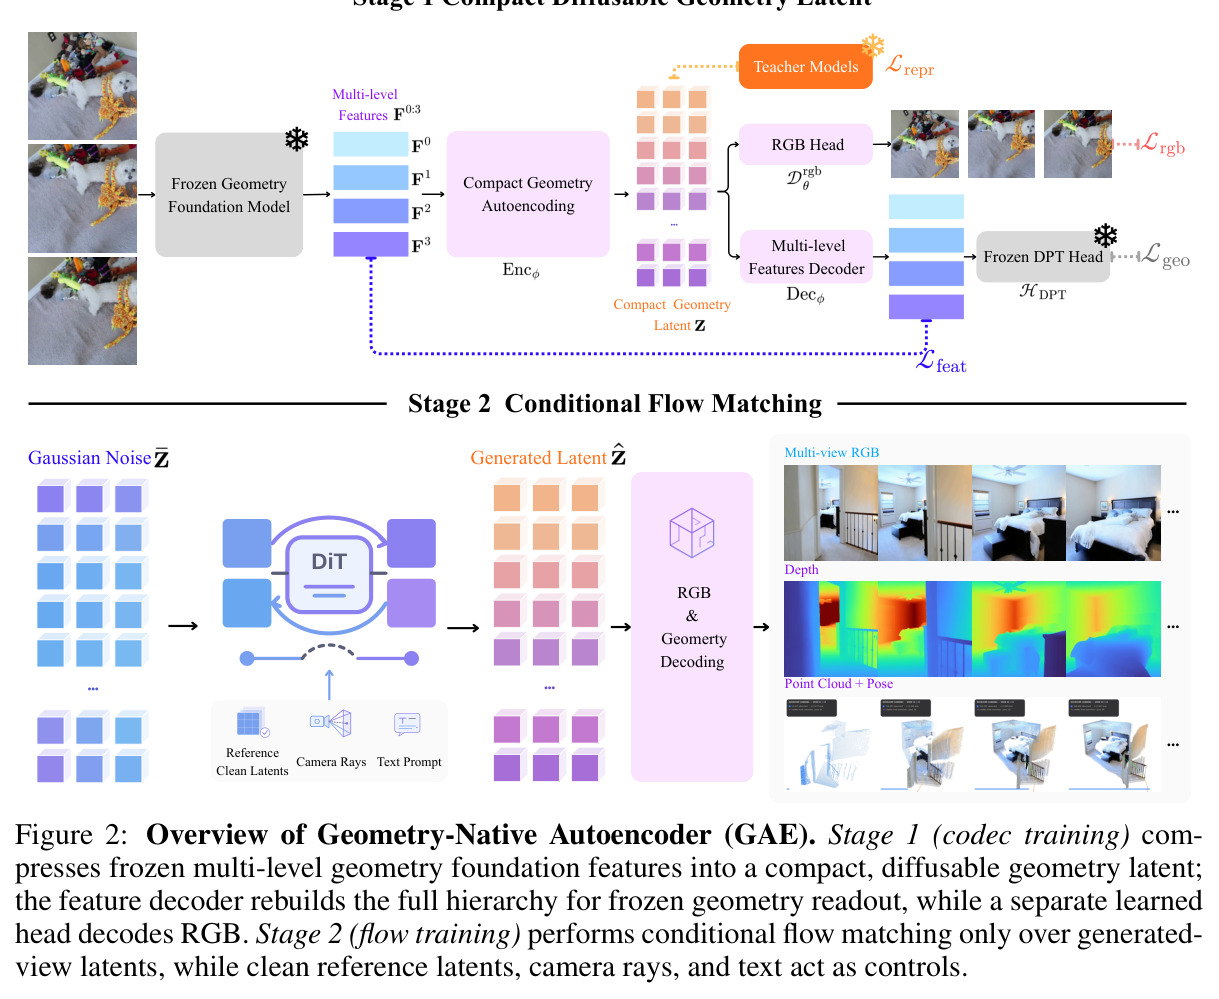
直觉上,与其让生成器在像素潜空间里靠数据先验“猜”出 3D 一致性,不如直接在几何基础模型的特征空间里做生成——几何信息本来就在那里,只是参数化方式不适合生成。技术路线分两阶段。Stage 1 训练编解码器 $A_\phi=(\mathrm{Enc}_\phi,\mathrm{Dec}_\phi)$:冻结 DA3 编码器输出四层特征,逐层做固定通道统计归一化后按通道拼接成融合张量 $X_v\in\mathbb{R}^{C_x\times h_p\times w_p}$,编码为 $C_z\in\{64,128\}$ 通道的网格潜变量 $z_v$;解码时一次性重建完整四层层级,冻结的 DPT 头 $\mathcal{H}_{DPT}$ 从重建层级读出深度/射线/点图,另一个学习到的 RGB 头 $D^{rgb}_\theta$ 从同一潜变量渲染外观。Stage 2 冻结全部编解码器,把后验均值按训练集统计标准化,训练一个 0.93B 参数的 DDT 式 DiT 条件流模型,一次前向联合生成所有目标视角的潜变量,再分别解码为 RGB 与几何。
核心创新有三点。其一,瓶颈位置的选择:把它放在“冻结编码器—冻结几何头”之间,几何头在整个训练中永不适配重建特征,这迫使压缩必须保留原始 DA3 界面可读的几何信息,从机制上杜绝解码器“绕道”适配信息损失——几何监督目标也是冻结头作用于原始特征的伪标签,保持接口一致。其二,统一状态:RGB 与几何是同一潜变量的两种读出(式7 $\hat I_v=D^{rgb}_\theta(z_v)$、$\hat G_v=\mathcal{H}_{DPT}(\mathrm{Dec}_\phi(z_v))$),而非两个耦合的潜空间,外观与几何的一致性由构造保证。其三,两级表征塑造:仅做重建的瓶颈虽紧凑良态,但传输平滑度与语义邻域仍弱;逐位置对齐 C-RADIO($\mathcal{L}_{tok}$)改善 $\rho$ 与 LNC,却会摧毁成对空间结构(LDS/SRSS 骤降到 0.02/0.03);再在后验空间直接匹配 DINOv2 成对相似度($\mathcal{L}_{struct}$)恢复关系几何。这与 REPA 监督去噪器内部表征不同——GAE 直接塑造生成所用的潜变量本身。
方法步骤详情
完整流程如下。① 输入 $V$ 个视图,冻结 DA3 编码器给出四层 patch token $\{f_{v,\ell}\}_{\ell=0}^3$,$N=h_pw_p$。② 用固定训练集逐通道统计量 $m_\ell,s_\ell$ 归一化每层,reshape 成空间网格后按通道拼接为 $X_v$(式3),逐层归一化防止高方差通道主导。③ 卷积金字塔加空间自注意力的编码器输出 $(\mu_v,\log\sigma_v^2)$,训练时重参数化采样 $z_v=\mu_v+\epsilon_v\odot\exp(\frac{1}{2}\log\sigma_v^2)$,流训练与推理用确定性后验均值,通道压缩到 $C_z\in\{64,128\}$。④ 解码器重建归一化层级 $\hat F_{0:3}$,冻结 DPT 头输出几何 $\hat G_v$,RGB 头输出 $\hat I_v$;总损失 $\mathcal{L}_{codec}=\mathcal{L}_{feat}+\lambda_{kl}\mathcal{L}_{kl}+\mathcal{L}_{rgb}+\mathcal{L}_{geo}+\mathcal{L}_{repr}$,几何监督为冻结头对原特征的伪标签。⑤ 表征塑造:$\mathcal{L}_{tok}=\frac{1}{VN}\sum 1-\langle g_\eta(\mu_{v,i}),\hat c_{v,i}\rangle$ 对齐 C-RADIO token,$\mathcal{L}_{struct}$ 匹配 DINOv2 成对相似度,$\mathcal{L}_{repr}=\lambda_{repa}(\mathcal{L}_{tok}+\lambda_\mu\mathcal{L}_{struct})$,$\lambda_{repa}=0.25$、$\lambda_\mu=8.0$,教师训练后丢弃。⑥ 冻结编解码器,标准化后训练条件流:线性路径 $\bar z_t=(1-t)\bar z_{gt}+t\epsilon$,采用 clean-latent 预测再转速度(式16)。条件包括:参考图干净潜 token(仅用参考集编码以避免集合编码的训推错配,赋 $t=0$ 前置参与自注意力但在预测头前移除)、公制 Plücker 射线($d,\hat m,s=\log(\|m\|+\epsilon)$)经 SCoPE 调制 q/k 注意力、冻结 Qwen3-0.6B 文本特征经交叉注意力;三路条件独立 dropout(0.10/0.05/0.05)使单一权重覆盖纯文本、相机控制、参考条件多 regime。⑦ 推理从 $\bar z^{(1)}\sim\mathcal{N}(0,I)$ 用 50 步 Euler、CFG=2 积分到 $t=0$,反标准化后按式2 一次解码出 RGB 与几何。
技术新颖性
相对三条既有路线,GAE 的新颖性清晰可辨。对像素 VAE(SD-VAE、WAN2.1 VAE):潜变量原生几何可读,深度与位姿是解码产物而非事后估计。对语义 RAE(RAEV2):在语义组织之外保留了跨视角对应与几何结构。对直接建模几何骨干特征的尝试(GLD 的层级级联、隐式黎曼流匹配的乘积流形):GAE 证明无需级联或非欧流形——一个学习到的欧氏紧凑重参数化就能让标准流模型胜任,且几何解码在推理时完全免训练(冻结头)。“冻结几何头 + 伪标签监督”是防止信息静默丢失的关键机制设计。此外,Table 1 的三步诊断本身就是对表征对齐文献的重要补充:逐位置对齐与关系结构保持不可互相替代,$\mathcal{L}_{tok}$ 单独使用会把 LDS 从 0.240 打到 0.020、SRSS 从 0.300 打到 0.030,必须配合 $\mathcal{L}_{struct}$ 修复到 0.444/0.553——这解释了许多“对齐了却不好生成”的现象。
实验结果
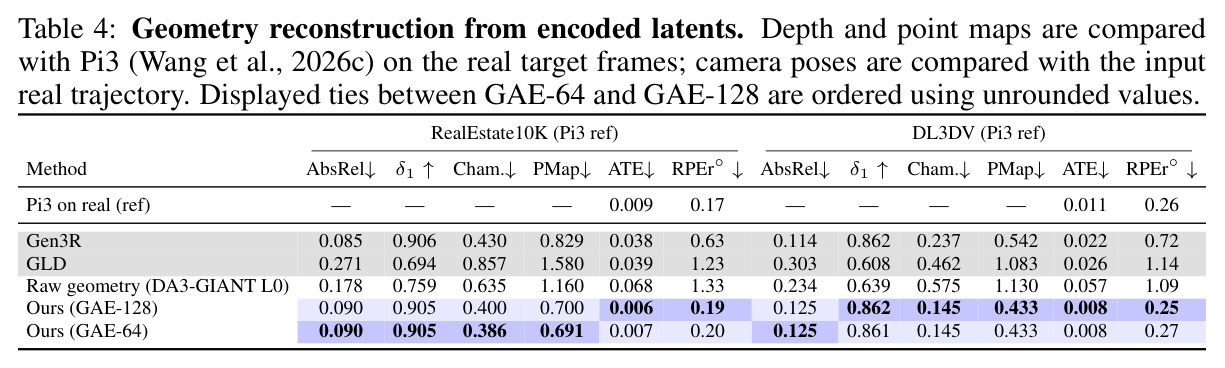
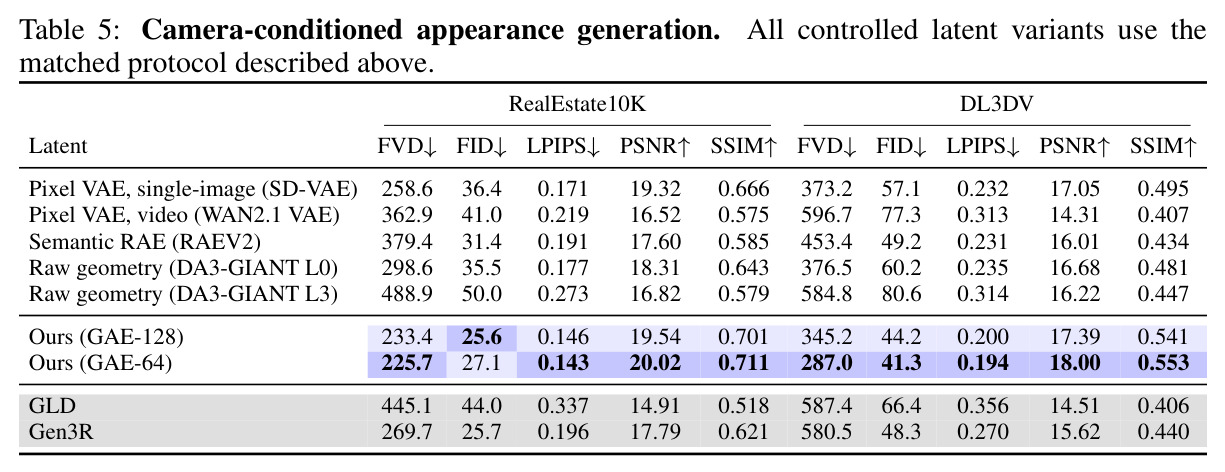
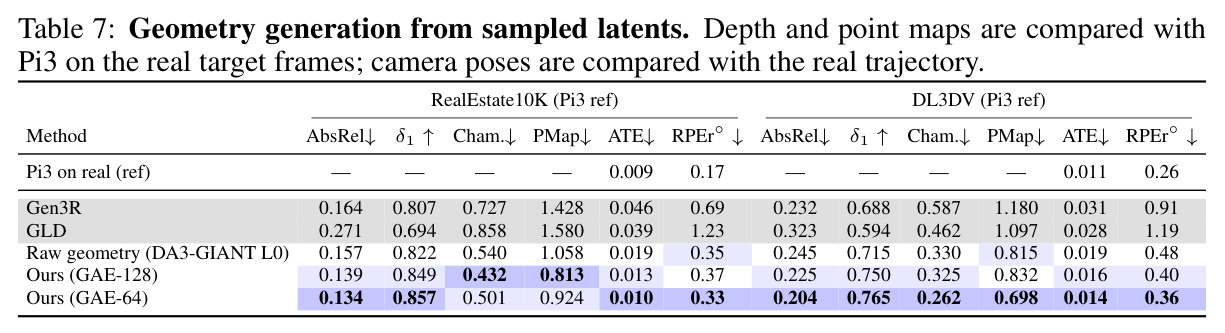
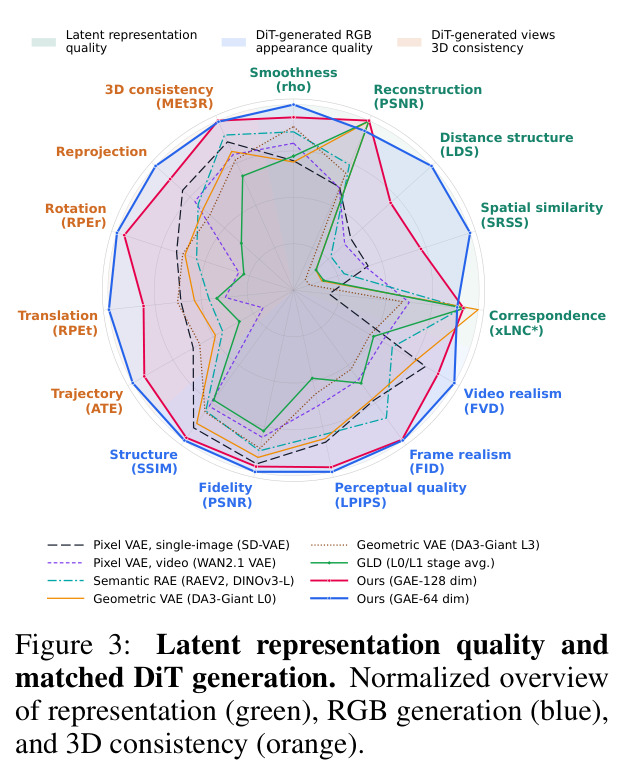
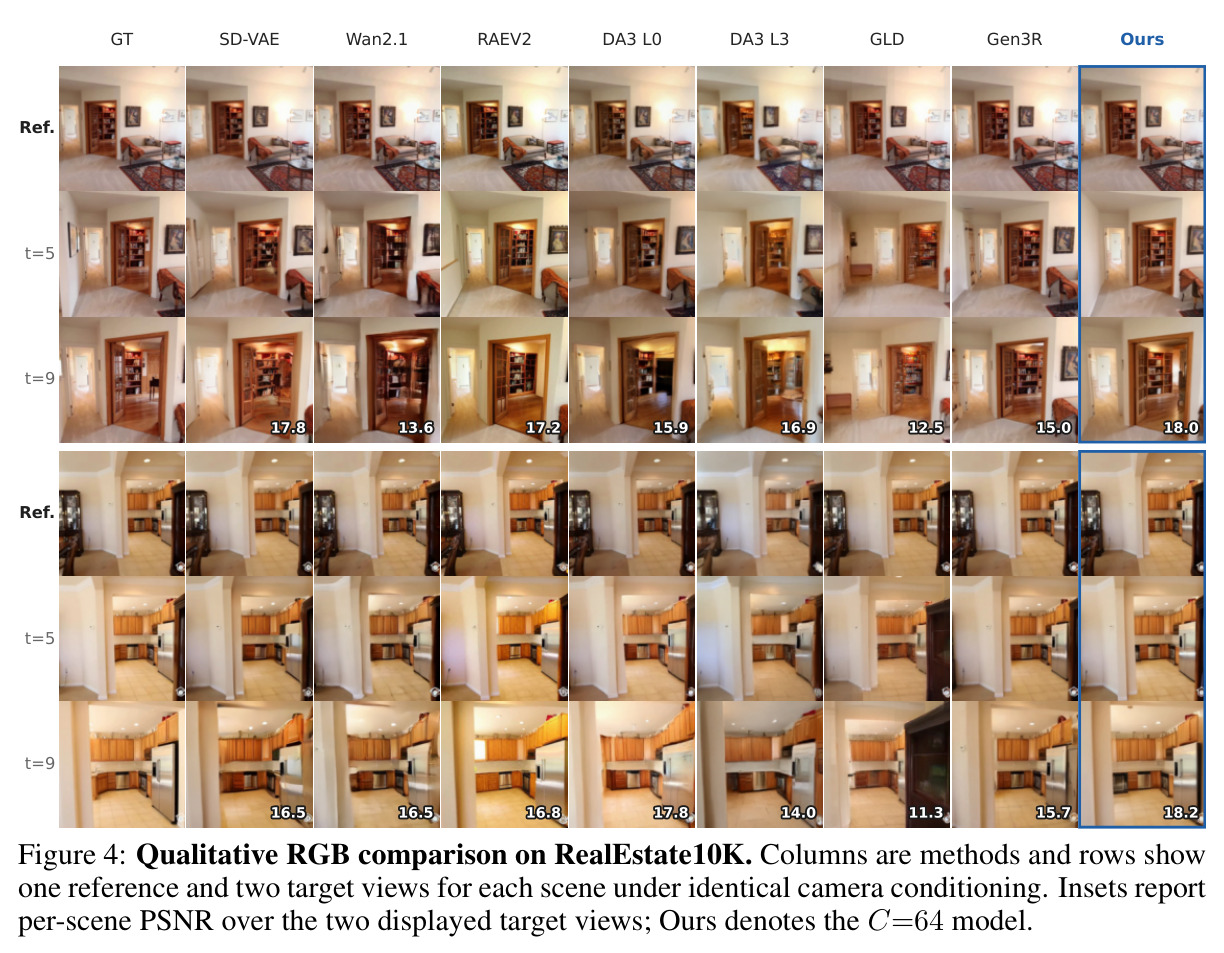
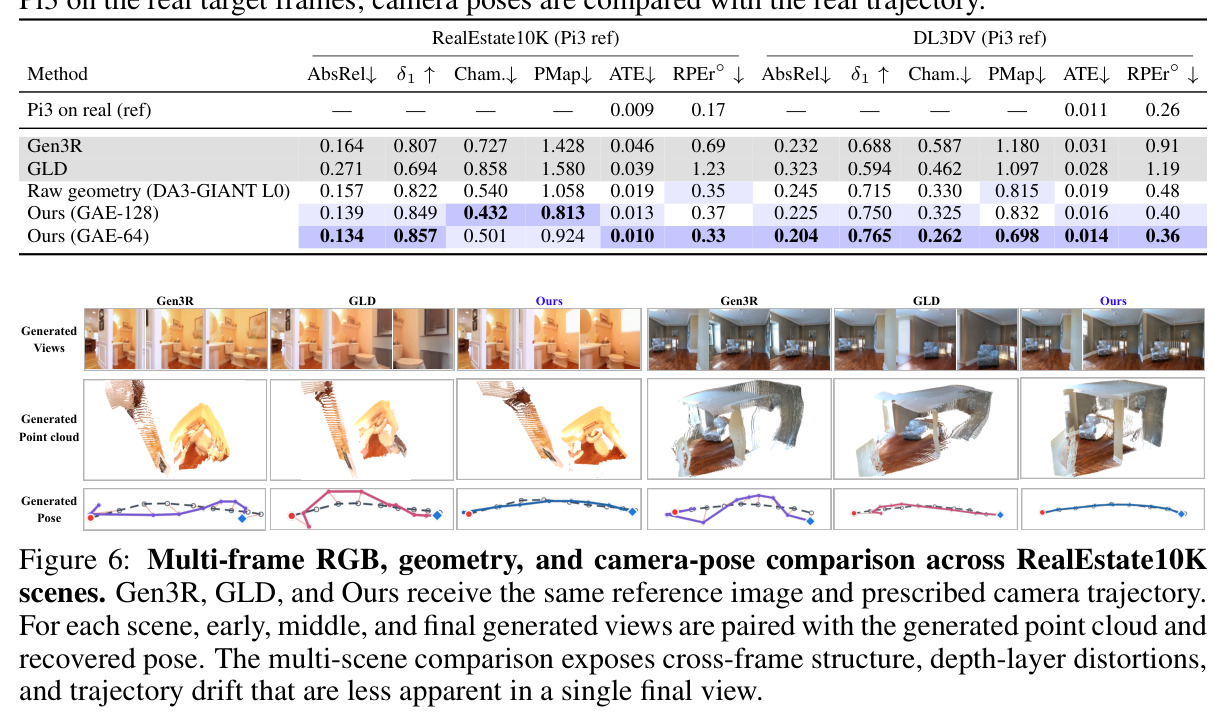
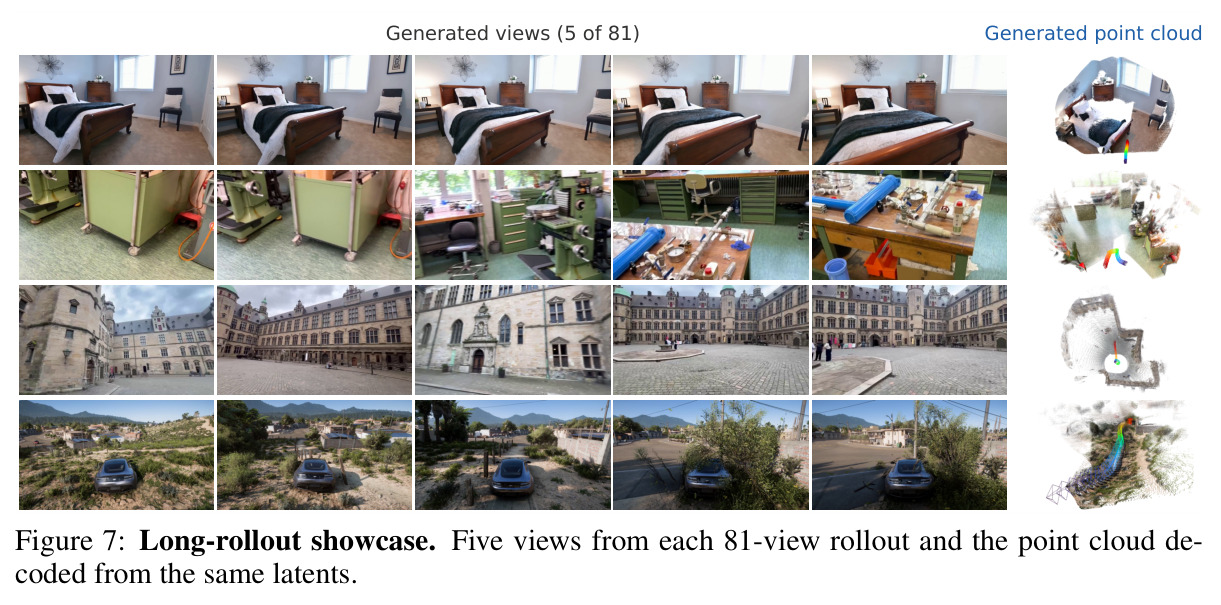
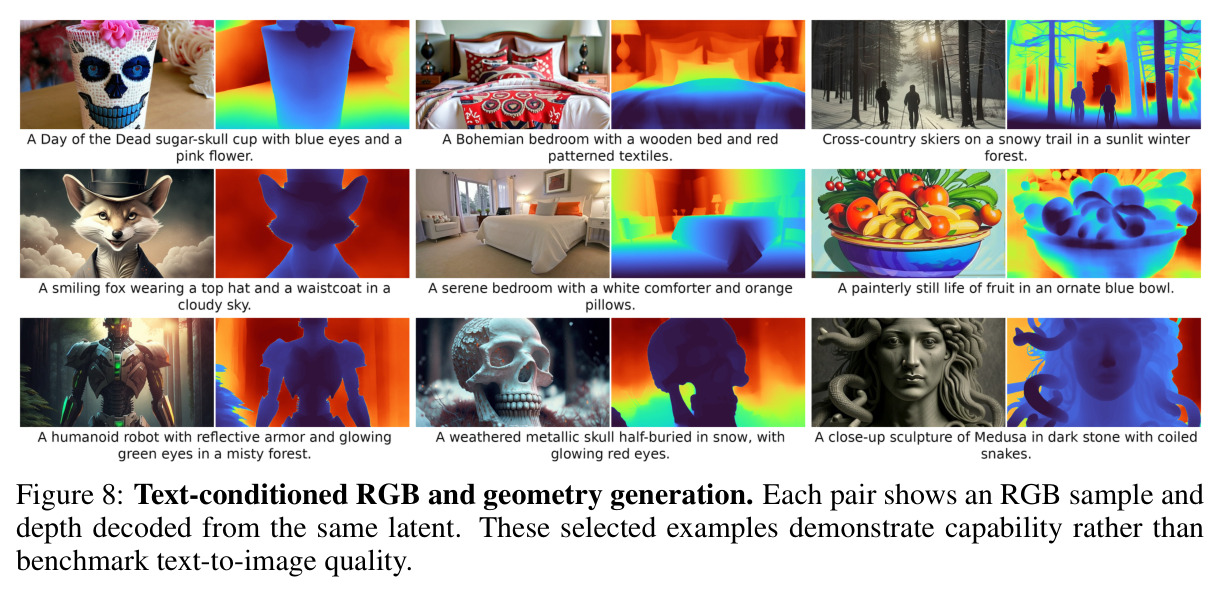
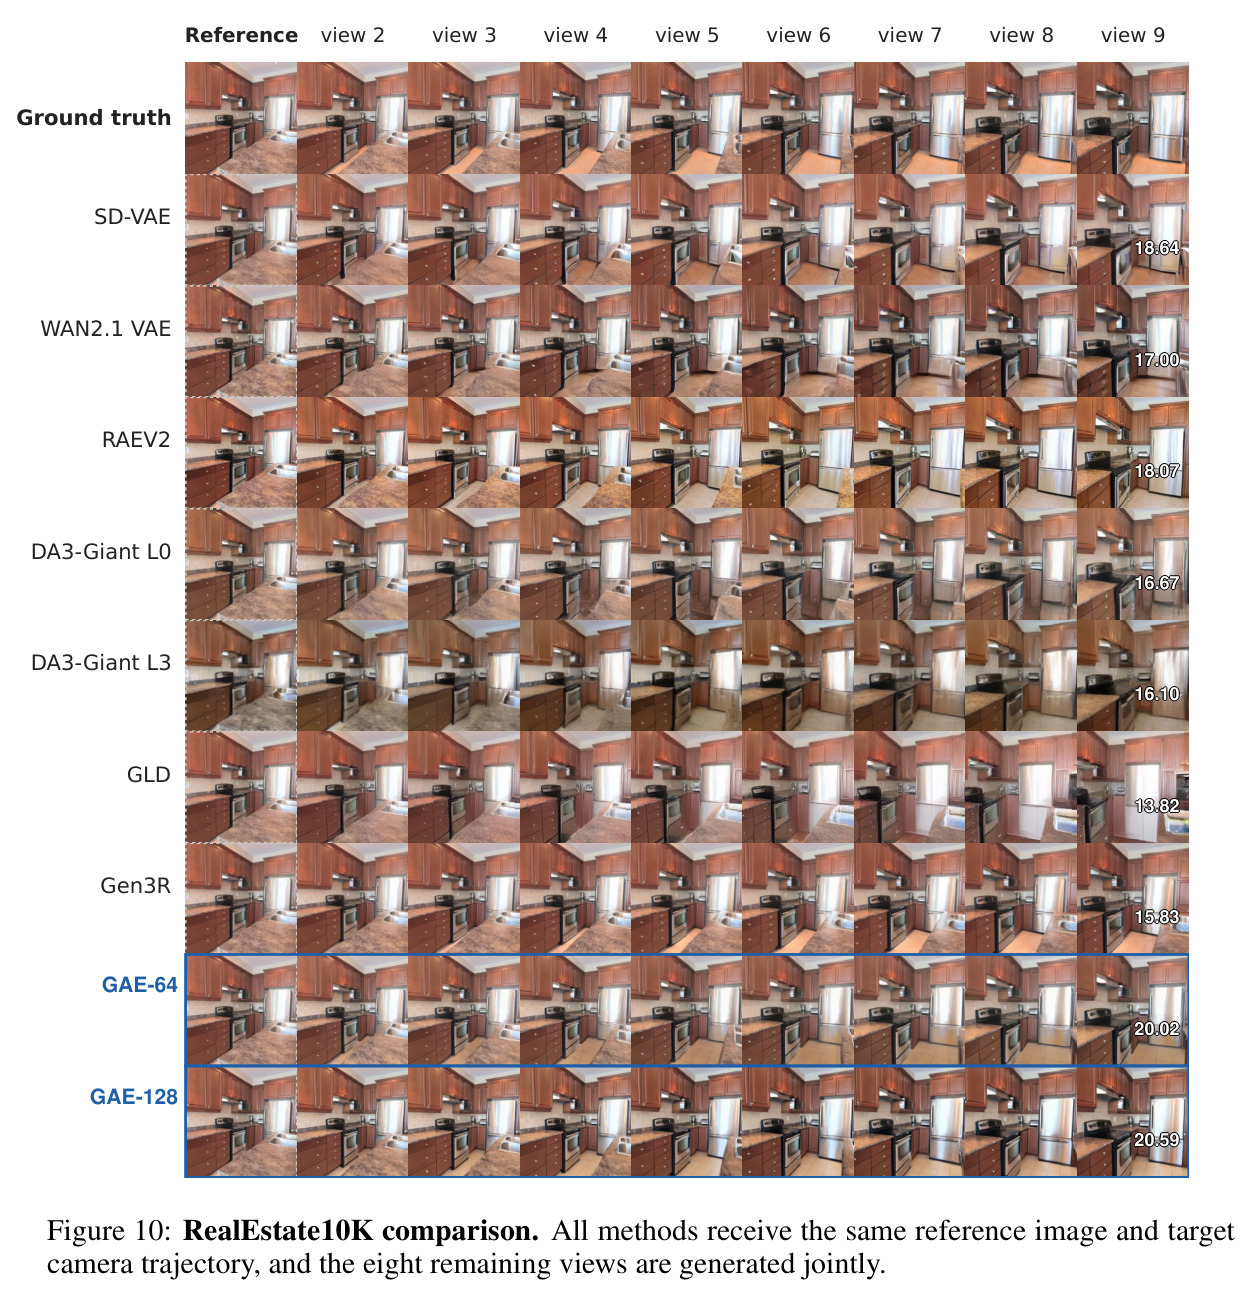
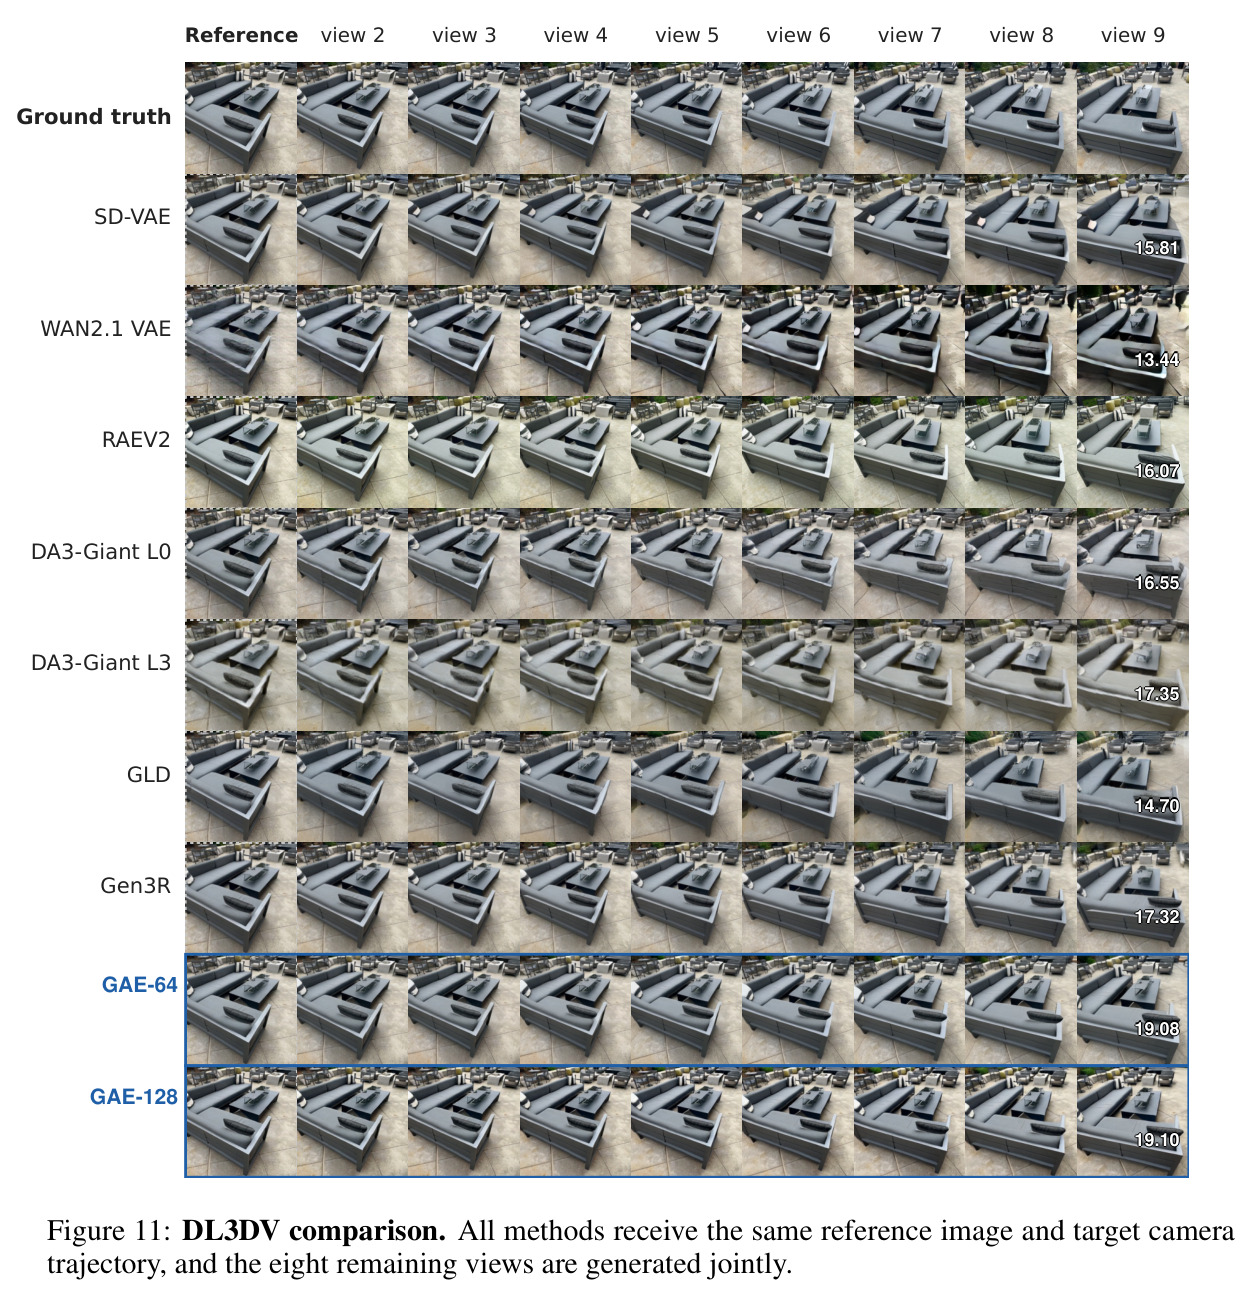
潜空间诊断(Table 2)显示 GAE 兼得各家长:原始 DA3-GIANT L0 条件数 $2.8\times10^8$、有效秩仅 11.3,GAE-128 将其降到 $\kappa=227$、有效秩 51.3,同时 LDS 从 0.102 提升到 0.444、SRSS 从 0.123 到 0.553,跨视角 xLNC* 0.591 基本保留 L0 的 0.642。重建质量(Table 3/4):GAE-128 单视图 PSNR 28.76/LPIPS 0.036、多视图 PSNR 34.78/rFVD 4.3,以 24 倍更少的通道追平或超过原始 3072 通道 L0(rFVD 76.2);几何重建 AbsRel 0.090、$\delta_1$ 0.905、相机 ATE 0.006、RPEr 0.19°,大幅优于 raw-L0 基线(ATE 0.068)及外部系统 Gen3R(0.038)、GLD(0.039)。受控生成对比(同流模型、同训练预算、同采样协议):GAE-64 在 RealEstate10K FVD 225.7、DL3DV FVD 287.0,较最强非 GAE 受控潜空间(SD-VAE 的 258.6/373.2)分别下降 12.7% 与 23.1%,PSNR 20.02、SSIM 0.711 同为最佳;外部系统 GLD(445.1)与 Gen3R(269.7)均被明显超过。3D 一致性(Table 6,VGGT 独立评测):GAE-64 在 RealEstate10K ATE 0.0034,较 SD-VAE 0.0072 减半(-52.8%),DL3DV 降 23.3%;MEt3R 0.1208(RE10K)/0.1347(DL3DV)为受控最佳,且 DA3 交叉验证结论一致。几何生成(Table 7):DL3DV 上 GAE-64 六项几何指标全部领先受控方法(AbsRel 0.204、Chamfer 0.262、PMap 0.698、ATE 0.014、RPEr 0.36°),参考基准是独立模型 Pi3 而非 DA3 自身。消融(Table 8):$\mathcal{L}_{repr}$ 使 FVD 从 266.4 降至 233.4;干净参考 token 使参考-目标点云差距从 0.1016 降至 0.0318;公制射线把无 Sim(3) 的 SE(3) ATE 从 0.0346 降至 0.0093;T2I 共训把 FVD 从 472.9 降至 225.7。最终模型还在 672×378 分辨率完成 81 视图长滚动(无跨视角融合的朴素点云拼接仍保持场景结构)与文本驱动 RGB+深度生成展示。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 相机控制视频生成(RealEstate10K,受控对比) | FVD | 225.7(GAE-64) | 258.6(最强非 GAE 受控潜空间 SD-VAE) | 下降 12.7%;对外部系统 Gen3R 269.7、GLD 445.1 优势更大 |
| 相机控制视频生成(DL3DV,受控对比) | FVD | 287.0(GAE-64) | 373.2(SD-VAE) | 下降 23.1% |
| 生成视图相机轨迹一致性(RealEstate10K,VGGT 独立评测) | ATE(Sim(3) 对齐后) | 0.0034(GAE-64) | 0.0072(SD-VAE);Gen3R 0.0090、GLD 0.0124 | 较最佳受控基线降低 52.8%(约减半) |
| 多视角特征一致性(RealEstate10K) | MEt3R | 0.1208(GAE-64) | 0.1263(RAEV2,受控次佳) | 降低约 4.4%,为受控最佳 |
| 潜变量几何重建(DL3DV 真实帧编码解码) | AbsRel / ATE | 0.125 / 0.008(GAE-128) | raw DA3 L0:0.178 / 0.068;Gen3R:0.114 / 0.022 | 较 raw-L0 的 AbsRel 降约 30%、ATE 降约 88% |
| 几何生成(DL3DV,以 Pi3 为独立参考) | Chamfer | 0.262(GAE-64) | raw DA3 L0:0.330;Gen3R:0.587 | 较 raw-L0 降 20.6%,较 Gen3R 降 55.4%;且六项几何指标全面领先 |
| 多视图 RGB 重建(五视频数据集平均) | rFVD | 4.3(GAE-128) | raw DA3-GIANT L0:76.2(3072 通道) | 通道数少 24 倍的同时 rFVD 大幅降低 |
局限与改进
作者明确界定了证据边界:受控对比固定在 252×252 分辨率、9 视图、每数据集 64 个held-out场景的评测池,使用更大规模数据、672×378 分辨率与 81 视图的最终模型只做定性展示(Fig.7/8),不进入量化排名;几何监督使用 DA3 冻结头作用于原特征的伪标签而非真值,几何质量上限同时受 DA3 与评测参考 Pi3 制约;公制 Plücker 射线的尺度通道依赖“有公制相机元数据可用”的假设。我的补充观察:评测域集中在室内/房产类静态场景(RealEstate10K、DL3DV、ScanNet++ 等),动态场景、大尺度户外与物体级生成均未验证;RE10K 上 12.7% 的 FVD 改进幅度相对温和,且 64 场景小评测池的统计稳定性存疑(GAE-64 与 GAE-128 在多个指标上互有胜负,未报告置信区间);整个框架强绑定 DA3-GIANT 及其 DPT 头,更换更强几何骨干需重训编解码器;81 视图长滚动只展示了定性点云,没有给出随帧数增长的误差曲线。
独立分析的弱点
①对 DA3 的强耦合:潜空间语义由 DA3 层级定义、几何读出被冻结头锁死,若 DA3 在水面、玻璃、动态物体等失效场景上出错,GAE 自身无从修复——改进方向是加入真值深度/位姿的辅助监督,或多个几何教师的集成读出。②教师选择与超参偏经验:C-RADIO 与 DINOv2 的组合、$\lambda_{repa}=0.25$ 与 $\lambda_\mu=8.0$ 均未做敏感性分析,换 backbone 后是否最优存疑——可基于可扩散性指标做自动教师搜索或自适应加权。③压缩有可见代价:GAE-64 相比 GAE-128 多视图 PSNR 从 34.78 降到 32.37、rFVD 从 4.3 升到 9.1,细粒度纹理损失可能影响对精度敏感的下游任务——可引入残差高频分支或非均匀通道分配。④参考条件机制要求推理时仅用参考集编码,多参考(1–4 张)与目标视角重叠度低时的性能未单独报告;⑤评测规模小:64 场景×9 视图的评测池使 FVD/ATE 的小差异(如 GAE 两个宽度间的排名互换)不宜过度解读,作者也未报告方差。⑥尺度依赖公制相机 sidecar,互联网视频等无位姿数据上如何获得尺度未讨论。
未来方向
作者指出的方向:把几何原生潜空间作为感知与生成的共享接口推广到更大规模、更高分辨率与更长序列(最终模型已示范 81 视图联合采样与文本驱动 RGB+几何生成)。基于其成果可自然延伸:①与自回归或扩散-forcing 式长视频框架结合,在共享潜空间中滚动生成并量化长时漂移;②潜变量本身含深度与位姿,天然适合作为规划状态——接入动作条件即可构建可交互世界模型,呼应 DINO-WM 一类特征世界模型但具备显式几何;③动态场景与 4D:把 DA3 替换为动态几何骨干(如 VGGT-Ω 类系统),潜空间加入时间维,即可生成动态 3D 内容;④几何驱动的内容编辑:在共享潜空间对深度/点图编辑后再解码 RGB,实现“先改几何、后得外观”的创作流程;⑤理论上刻画“逐位置对齐破坏成对结构”的现象,建立可扩散性与结构保持之间更普适的权衡分析,指导未来的潜空间设计。
复现评估
论文正文有 Project Page 链接但未明确承诺开源代码仓库,复现的第一道门槛是工程实现。依赖项均为公开模型:DA3-GIANT、C-RADIO、DINOv2、Qwen3-0.6B;训练数据 RealEstate10K、DL3DV、ScanNet++、MVS-Synth、SpatialVID、OmniWorld 均公开,但最终模型混入了“若干内部数据集”无法获得——好消息是所有量化结论都来自只用公开两数据集的受控对比,理论上可复现。算力方面:受控模型为 0.93B 参数 DDT 式 DiT,8 卡 GPU 训练 100k 步(BF16、AdamW、lr 1e-4 余弦退火),属中等投入;最终模型 80 卡、60k 步、672×378、81 视图,门槛显著更高。评测协议记述非常细致(50 Euler 步、CFG=2、Umeyama Sim(3) 对齐、Reproj@50、MEt3R 官方实现),七个诊断指标($\rho$、$\kappa$、有效秩、LNC@5、LDS、SRSS、xLNC*)定义完整且多数有公开实现。总体评估:对拥有 8×A100 级资源与几何基础模型使用经验的团队,复现受控实验可行;完整最终模型复现难度高,且两阶段训练的数据混合细节存在缺口。
论文图表
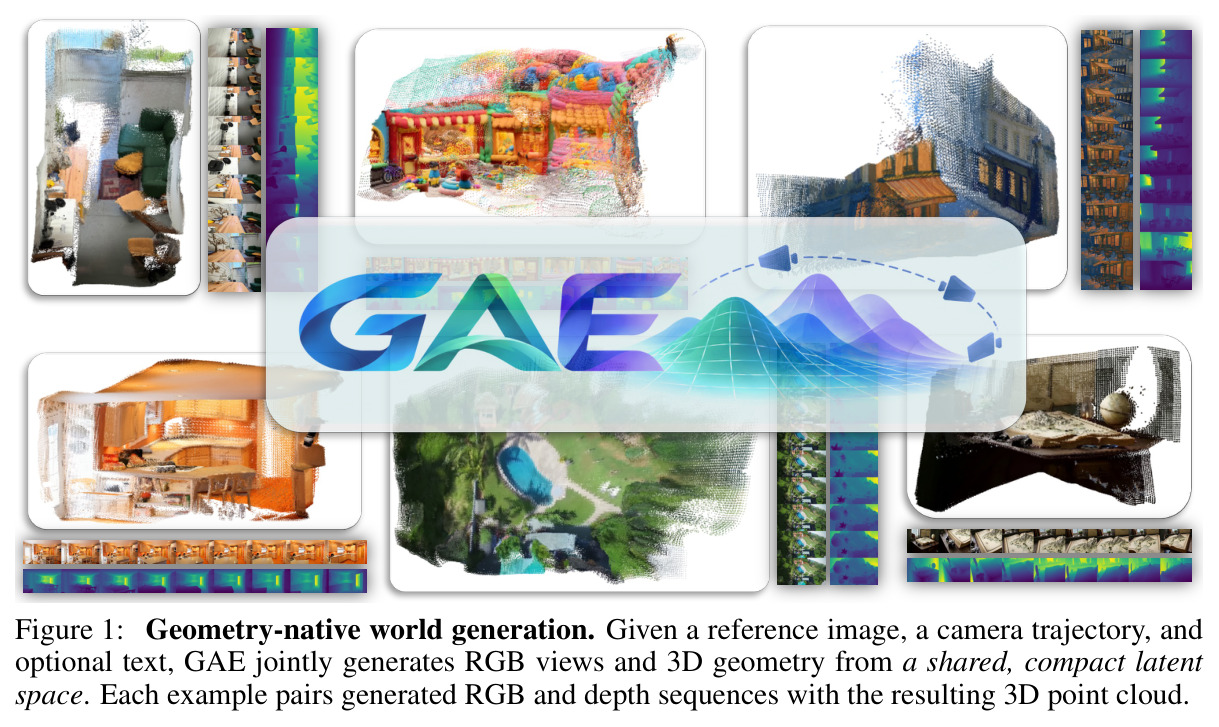
论文开篇展示图:给定参考图像、相机轨迹与可选文本,GAE 从共享紧凑潜空间同时生成多视角 RGB 序列、深度序列,以及拼合后的 3D 点云,展示三个真实场景的生成结果。
一图概括论文核心主张——单一潜变量同时可解码出外观与几何,是理解“几何原生世界生成”最直观的入口。
在 DA3-GIANT 上做三步潜空间塑造的消诊:原始 L0(ρ=0.876、κ=2.8×10⁸、effrank 11.3)经融合+重建后条件数降至 130、effrank 升至 58;再加 token 对齐使 ρ 降到 0.700 但 LDS/SRSS 崩到 0.020/0.030;最终 Ltok+Lstruct 恢复 LDS 0.444、SRSS 0.553 且保持低 ρ(0.674)。
这是本文最重要的机理发现:逐位置对齐与关系结构保持不可互相替代,直接支撑 Lrepr 双项设计的必要性。
编解码器独立于下游生成的 RGB 重建评测:GAE-128 单视图 PSNR 28.76/LPIPS 0.036/rFID 5.4,多视图 PSNR 34.78/LPIPS 0.014/rFVD 4.3,以 24 倍更少通道追平或超过原始 DA3 L0(28.64/0.038/25.3 与 34.70/0.014/76.2)。
回答“紧凑瓶颈是否丢失关键信息”的质疑,证明压缩没有牺牲外观保真度。
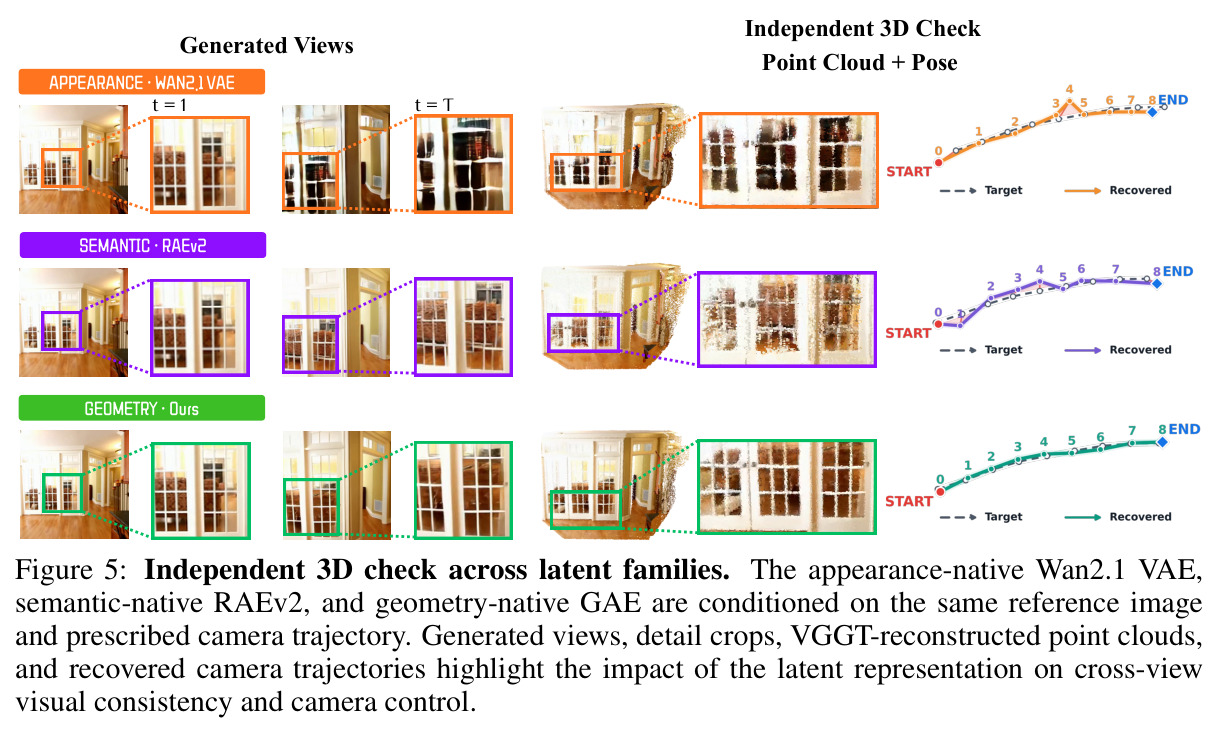
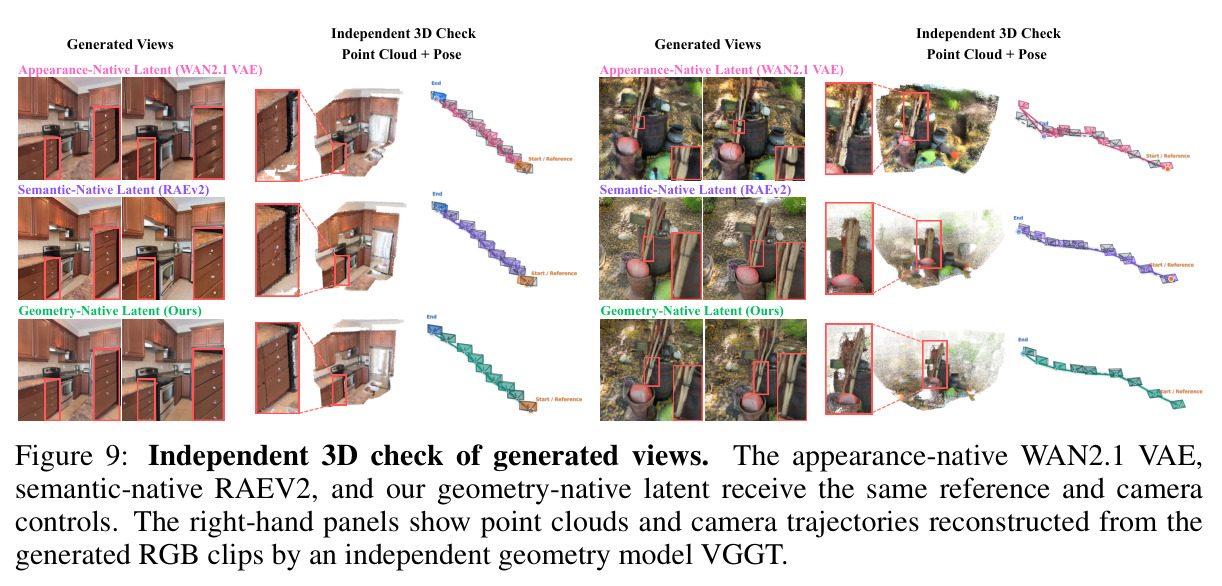
生成视图的 3D 一致性评测,用独立 VGGT 与 DA3 交叉验证:GAE-64 在 RE10K 的 VGGT ATE 0.0034(较 SD-VAE 0.0072 减半 52.8%)、DL3DV 0.0056(降 23.3%),RPEr 低至 0.380°/0.293°,MEt3R 0.1208/0.1347 为受控最佳;重投影误差 0.0068/0.0077 同样领先。
证明外观质量的提升没有以牺牲相机控制与多视角一致性为代价,是“3D 一致性”主张的主证据。