GeoVerse:几何潜空间中的世界一致新视角合成 GeoVerse: World-Consistent Novel View Synthesis in Geometric Latent Space
在DA3几何潜空间做扩散,注入Wan2.2视频先验与点云空间记忆,9秒生成世界一致新视角
前置知识
新视角合成(NVS)
给定一张或多张参考图像,渲染指定未见过相机位置下的照片级图像。经典路线是逐场景优化的 NeRF 与 3D Gaussian Splatting,新趋势是从大规模数据学习前馈网络,从稀疏视角直接预测高斯基元或目标视角。
本文的核心任务就是 NVS,且需要同时处理视角插值(忠实重建)与视角外推(生成补全)这一根本矛盾。
几何潜空间扩散(GLD)
GLD 把几何基础模型 DA3 的多层 Transformer 特征当作多视角扩散的原生潜空间,直接在指定目标相机处生成深度、射线图与 RGB。由于该空间在预训练时就带有跨视角注意力与几何监督,单次生成天然具有跨视角一致性。
GeoVerse 完全建立在 GLD 的几何潜空间之上,理解该空间如何编码几何对应是读懂方法的前提。
流匹配(Flow Matching)
一种生成建模范式:定义从噪声到数据的线性概率路径 $X_t=(1-t)F_1+t\epsilon$,训练网络预测速度场 $u_t=\epsilon-F_1$,从 $t=1$ 积分到 $t=0$ 即可把高斯噪声变换为目标分布的样本,是扩散模型的连续时间推广。
GeoVerse 的 Level-1 去噪器与级联都是多视角流匹配模型,少步蒸馏也基于流路径的分段 reflow。
ControlNet 与零卷积
ControlNet 用一条辅助分支处理条件信号,经零初始化的投影层 $Z_\ell$ 把残差加回主干:$h_{\ell+1}=B_\ell(h_\ell)+Z_\ell(c_{\ell+1})$。零初始化保证训练开始时不改变预训练主干,随后逐步学入条件影响。
GeoVerse 正是用这种结构把冻结的 Wan2.2 视频特征注入几何去噪器,是理解视频先验注入方式的关键。
Reflow 蒸馏
PerFlow 提出的分段再流方法:把从 $t=1$ 到 $t=0$ 的积分区间切成若干段,对每段用教师模型算出起点到终点的直线位移作为恒定速度目标,学生一次前向即可跳过教师的多次评估,实现少步生成。
本文靠 Level-1 的三段 reflow 蒸馏把去噪压到 3 步加 1 步级联,实现约 18 倍于 GLD 的加速。
Plücker 射线嵌入
用射线的矩 $d\times o$ 与方向 $d$ 组成的 6 维向量表示每个像素的相机光线,可编码相机的内外参信息,常作为空间条件嵌入到多视角生成网络中,使模型感知目标视点位姿。
GeoVerse 用 $\Gamma$(Plücker 射线嵌入)向去噪器与视频先验分支提供相机条件,是实现精确相机控制的基础。
研究动机
新视角合成需要在稀疏输入下同时完成两件相互冲突的事:对已观测区域做忠实重建,对未见区域做合理补全,还要保证跨视角的世界一致性。纯几何重建路线(NeRF、3DGS 及 MVSplat、AnySplat、WorldMirror 等前馈方法)受制于确定性几何形式,在大相机运动下外推未观测区域时缺乏生成想象力,常出现严重伪影、模糊与空洞。反过来,视频扩散模型(基于 Wan 等大模型)拥有海量视频语料学到的丰富外观先验,补全能力强,但直接或顺序应用于 3D 场景时跨帧不一致不断累积,长轨迹下产生漂移与结构崩塌。混合框架(Geometry Forcing、Gen3R)试图对齐视频扩散特征与 3D 表征,但仍背负稠密视频帧合成的沉重计算开销;GLD 把 DA3 的几何特征空间直接作为多视角扩散的潜空间,单次生成即有一致性,但训练分布只有 4 个数据集,在真实场景上的生成保真度与稳定性受限。
本文的目标是本文要构建一个同时满足四项要求的新视角合成框架:保持刚性 3D 几何一致性、具备强大的生成补全能力、支持长序列多轮扩展而不累积漂移、推理足够快以支撑实际应用。具体拆解为:在预训练 3D 基础模型 DA3 的几何潜空间中直接做多视角扩散;把 Wan2.2 VACE 视频生成模型学到的大规模外观先验注入几何潜扩散以增强结构补全与纹理保真;用全局空间记忆持续聚合观测与生成内容,重投影出目标对齐引导来锚定后续预测;通过 reflow 蒸馏把去噪压缩到 4 步,使单轮(6 个目标视角)推理从 GLD 的 169 秒级降到 10 秒以内,每轮额外扩展不再变慢。
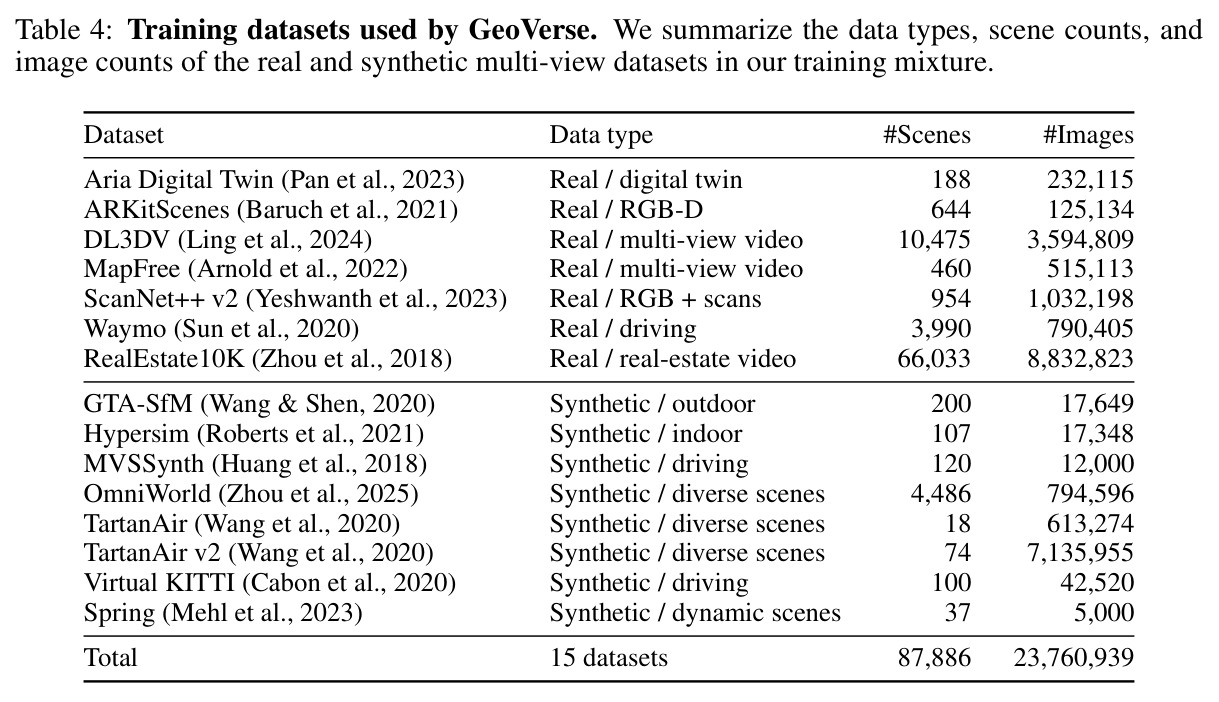
与已有工作不同的是,现有 NVS 工作要么在像素或视频潜空间生成(ViewCrafter、GEN3C、NeoVerse、Mirage、Lyra 2.0),要么在几何潜空间生成(GLD),两者各占一端。本文的独特切入是系统性的融合而非折中:不运行完整的视频采样轨迹,只做一次冻结 Wan2.2 VACE 的前向,抽取 blocks 0/5/10/15 的中间特征,经 ControlNet 风格零卷积残差送入几何去噪器,外观先验几乎零推理开销地进入几何潜空间;同时引入以彩色点云形式存在的持久空间记忆,把观测与生成内容统一到共享坐标系,重投影为目标视角的 RGB-D 引导与有效掩码——有效投影锚定已知结构,掩码区域放权给生成先验去补全未知。训练侧把几何语料从 GLD 的 4 个数据集扩展到 15 个真实与合成数据集(87886 个场景、约 2376 万张图像),补足训练分布这一 GLD 的短板。
核心方法
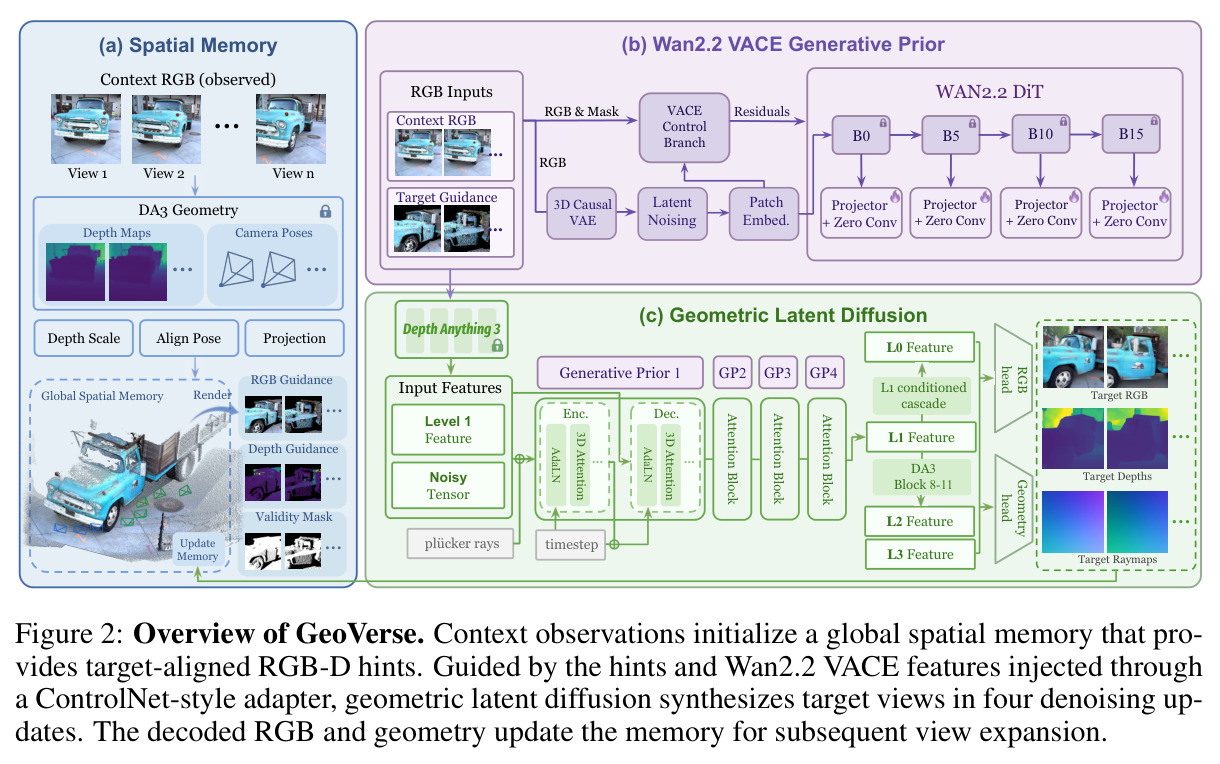
GeoVerse 建立在 GLD 的几何潜扩散之上,直觉是:DA3 的多层特征空间在预训练时即带跨视角注意力与深度/射线先验,适合作扩散潜空间保证一致性,但纯几何表征缺乏想象力,因此注入视频扩散模型的外观先验。流程上,输入上下文图像与空间记忆重投影的目标引导,拼成序列由冻结 DA3 编码至合成边界(Level-1,block $b_1=7$)得到条件特征,并以干净特征 $F_1$ 为流匹配起点,噪声路径 $X_t=(1-t)F_1+t\epsilon$。去噪器在 Plücker 射线嵌入 $\Gamma$、Wan 特征 $F_W$、投影深度与有效掩码等固定条件下预测速度场 $\hat{u}_t=v_\theta(X_t,t;F,\Gamma,F_W,D^{\text{proj}},V)$;得到的 $\hat{F}_1$ 驱动冻结的 Level-0 级联,剩余 DA3 blocks 前向得到多尺度特征,最后由 RGB 头与几何头解码目标图像与几何 $\hat{G}_T=\{\hat{D}_T,\hat{R}_T\}$,再反投影回点云记忆供下一轮扩展。
核心创新有三。其一,视频先验注入方式:与把视频模型当完整生成器(ViewCrafter、GEN3C)或做特征对齐(Geometry Forcing)不同,本文仅一次前向抽取冻结 Wan2.2 VACE 的 5120 维多层特征,经分辨率对齐模块与 ControlNet 式分支,以加性残差 $h_{\ell+1}=B_\ell(h_\ell;t,\Gamma)+Z_\ell(c_{\ell+1})$ 注入主去噪器——零初始化保证预训练能力不被破坏,视频特征在整个去噪过程中复用,几乎零推理开销。其二,全局空间记忆:以彩色点云 $M_r$ 在共享坐标系增量融合观测与生成内容,经深度感知点溅射(带置信度与 z-buffer)渲染出目标视角的 RGB-D 引导与有效掩码,有效区域锚定已知结构、掩码区域交由生成先验补全,多轮推理无累计漂移。其三,分段 reflow 蒸馏只作用于 Level-1 去噪器(级联与解码头不动),压缩到 3 步加 1 步级联,比 GLD 快约 18 倍。
方法步骤详情
完整流程分四步循环。第一步,初始化记忆:用 DA3 预测深度把 $N_C=2$ 张上下文图像反投影为带颜色与置信度的点集 $P_0$,构成记忆 $M_0$。第二步,构造条件:把上下文图像与记忆点溅射渲染出的目标引导及掩码 $V$ 拼成序列,冻结 DA3 编码到 Level-1 得条件特征;同时把序列喂给冻结 Wan2.2 VACE——仅在有效目标投影加 $\sigma=0.1$ 高斯扰动,VAE 编码后一次前向抽出 blocks $(0,5,10,15)$ 的特征 $F_W$。第三步,生成:Level-1 流匹配去噪器按 3 步蒸馏采样得到 $\hat{F}_1$,再以 1 步冻结 Level-0 级联恢复 $\hat{F}_0$,剩余冻结 DA3 blocks 前向得到其余层级,解码目标 RGB 与几何——共 4 步去噪,约 9 秒生成 6 个目标视角。第四步,更新记忆:预测深度经相机中心相似变换对齐尺度 $\tilde{D}^r_i=s^\star_r\hat{D}^r_i$ 后反投影为点集 $P_r$,按置信度与 z-buffer 融合进 $M_{r-1}$,回到第二步继续扩展。
技术新颖性
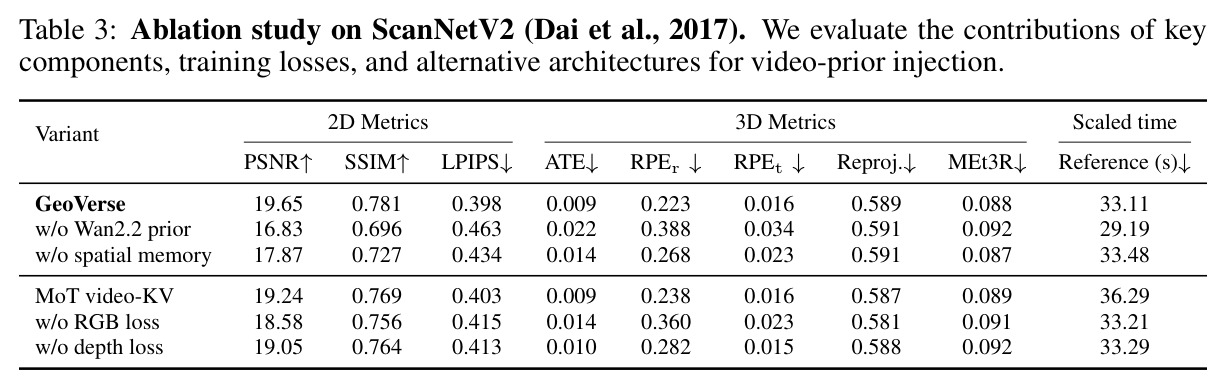
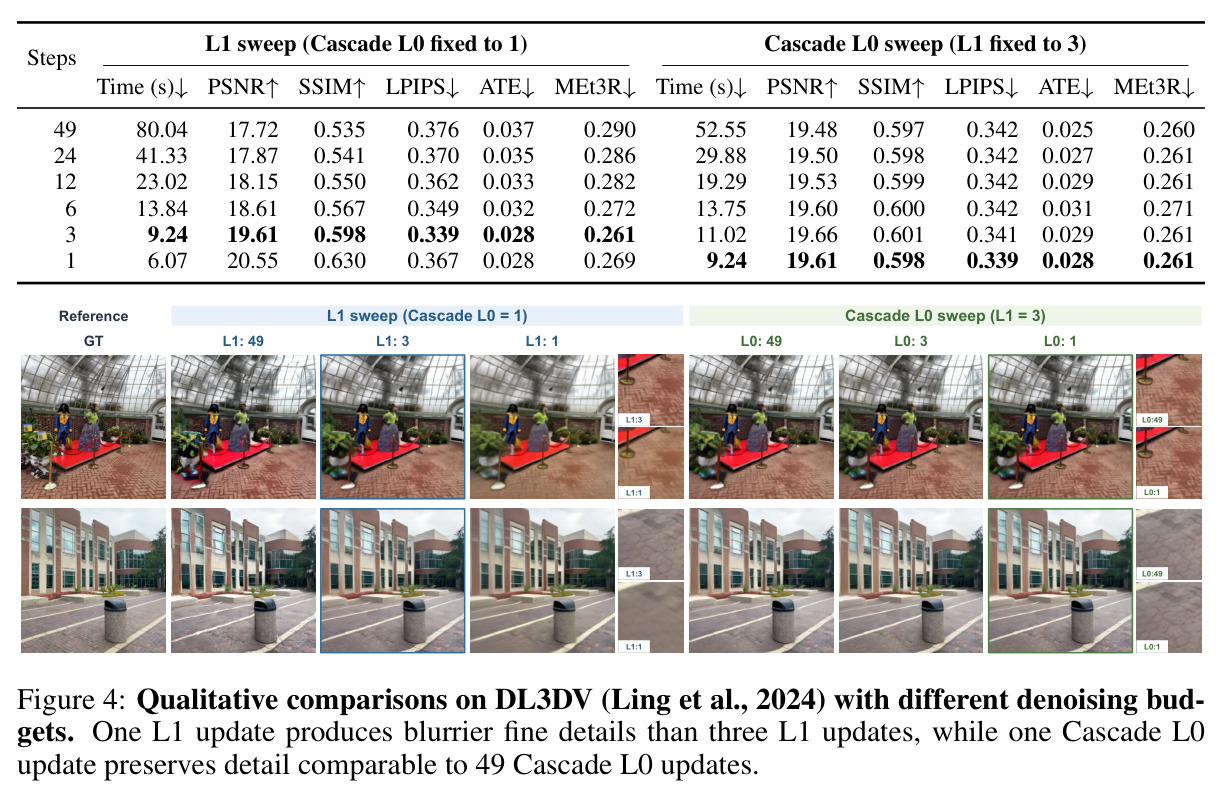
新颖性体现在架构组合与工程协同多个层面。第一,「冻结视频先验 + 几何潜扩散」的组合是新的:GLD 只用几何潜空间,受训练分布限制;GeoVerse 以零卷积 ControlNet 分支让 Wan2.2 特征可插拔进入,训练初期不干扰预训练去噪器,消融显示该先验带来 19.65 对 16.83 的 PSNR 提升,是贡献最大的组件。第二,空间记忆与几何潜扩散的耦合方式是新的:不同于 Mirage 的潜空间 3D 缓存或视频序列式记忆(ViewCrafter、GEN3C),记忆以像素级重投影的条件直接进入 DA3 编码器,形成「生成—反投影—再投影—再生成」闭环,ScanNetv2 三轮 PSNR 19.65 对 GLD 15.33 证明了价值。第三,训练规模跃升:15 个数据集、87886 个场景、2376 万张图像,按 RGB 帧数平方根概率采样,弱标注数据用 Pi3 估计位姿与深度补齐。第四,分层少步预算分析:L1 从 1 步到 3 步 LPIPS 0.367 改善到 0.339,L0 从 49 步压到 1 步仅 0.342 对 0.339,据此定出 3+1 的最优分配。
实验结果
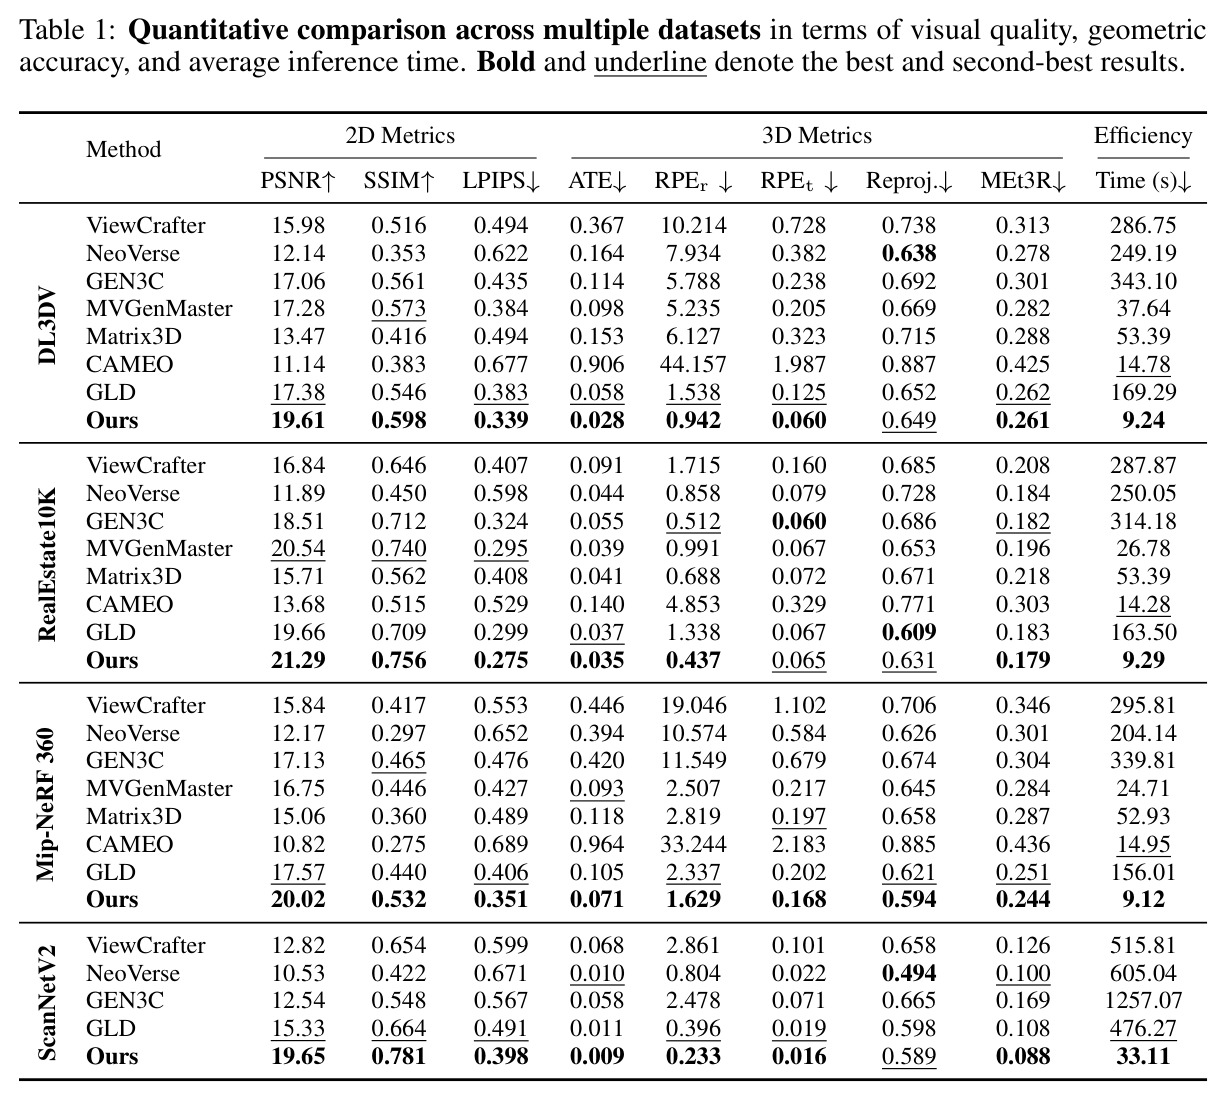
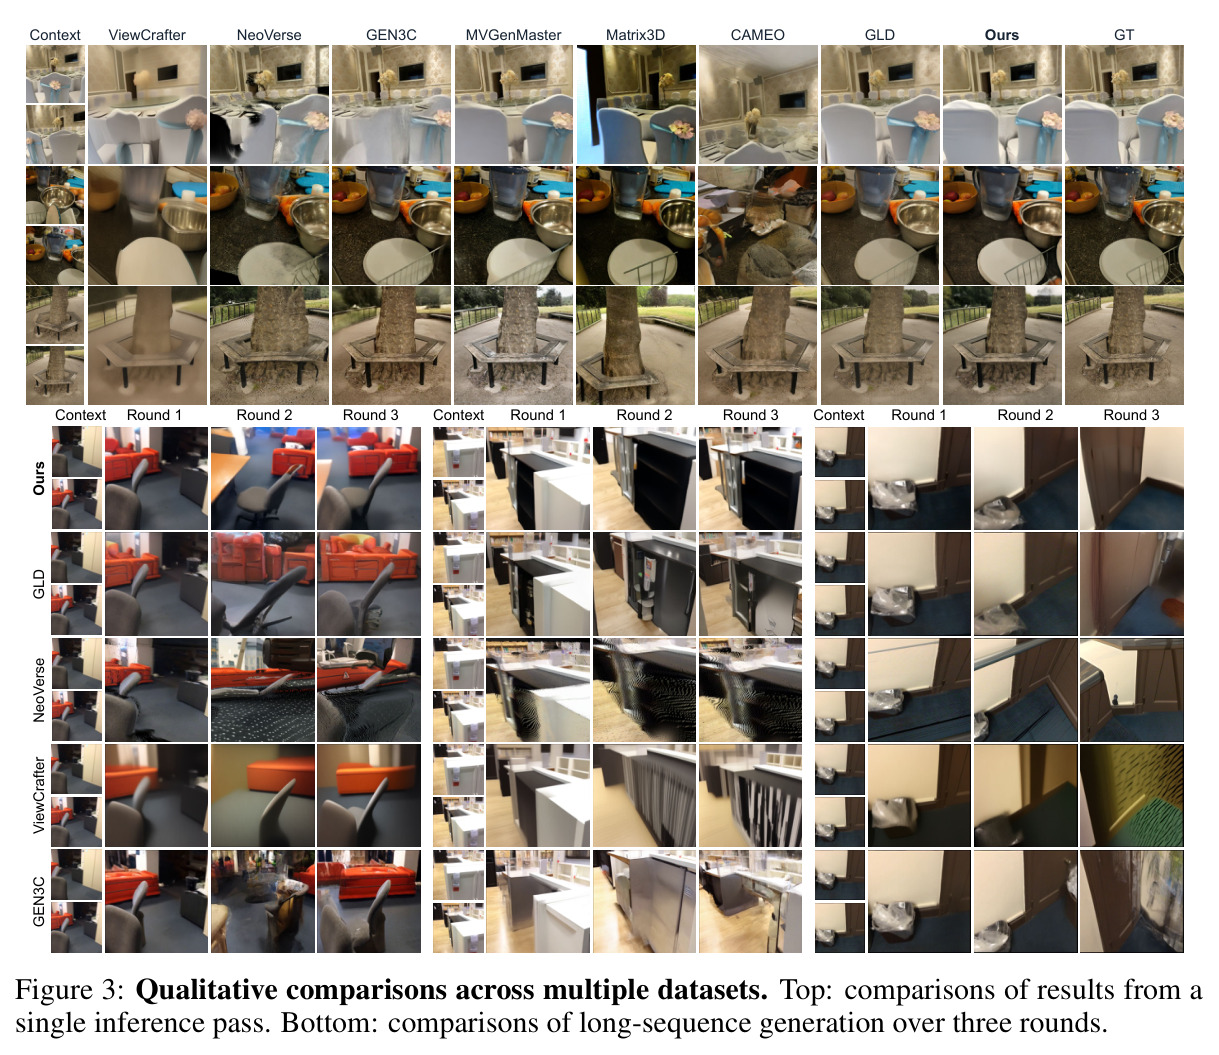
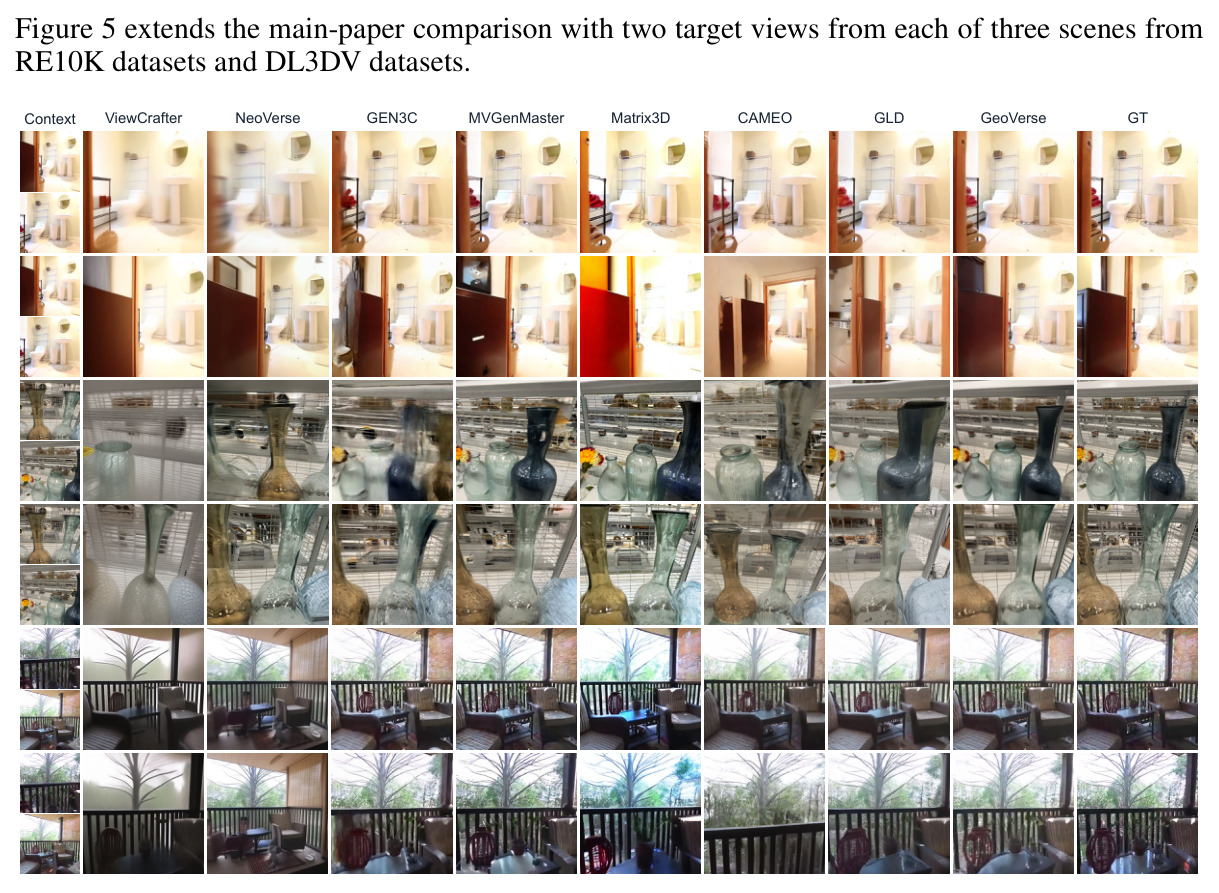
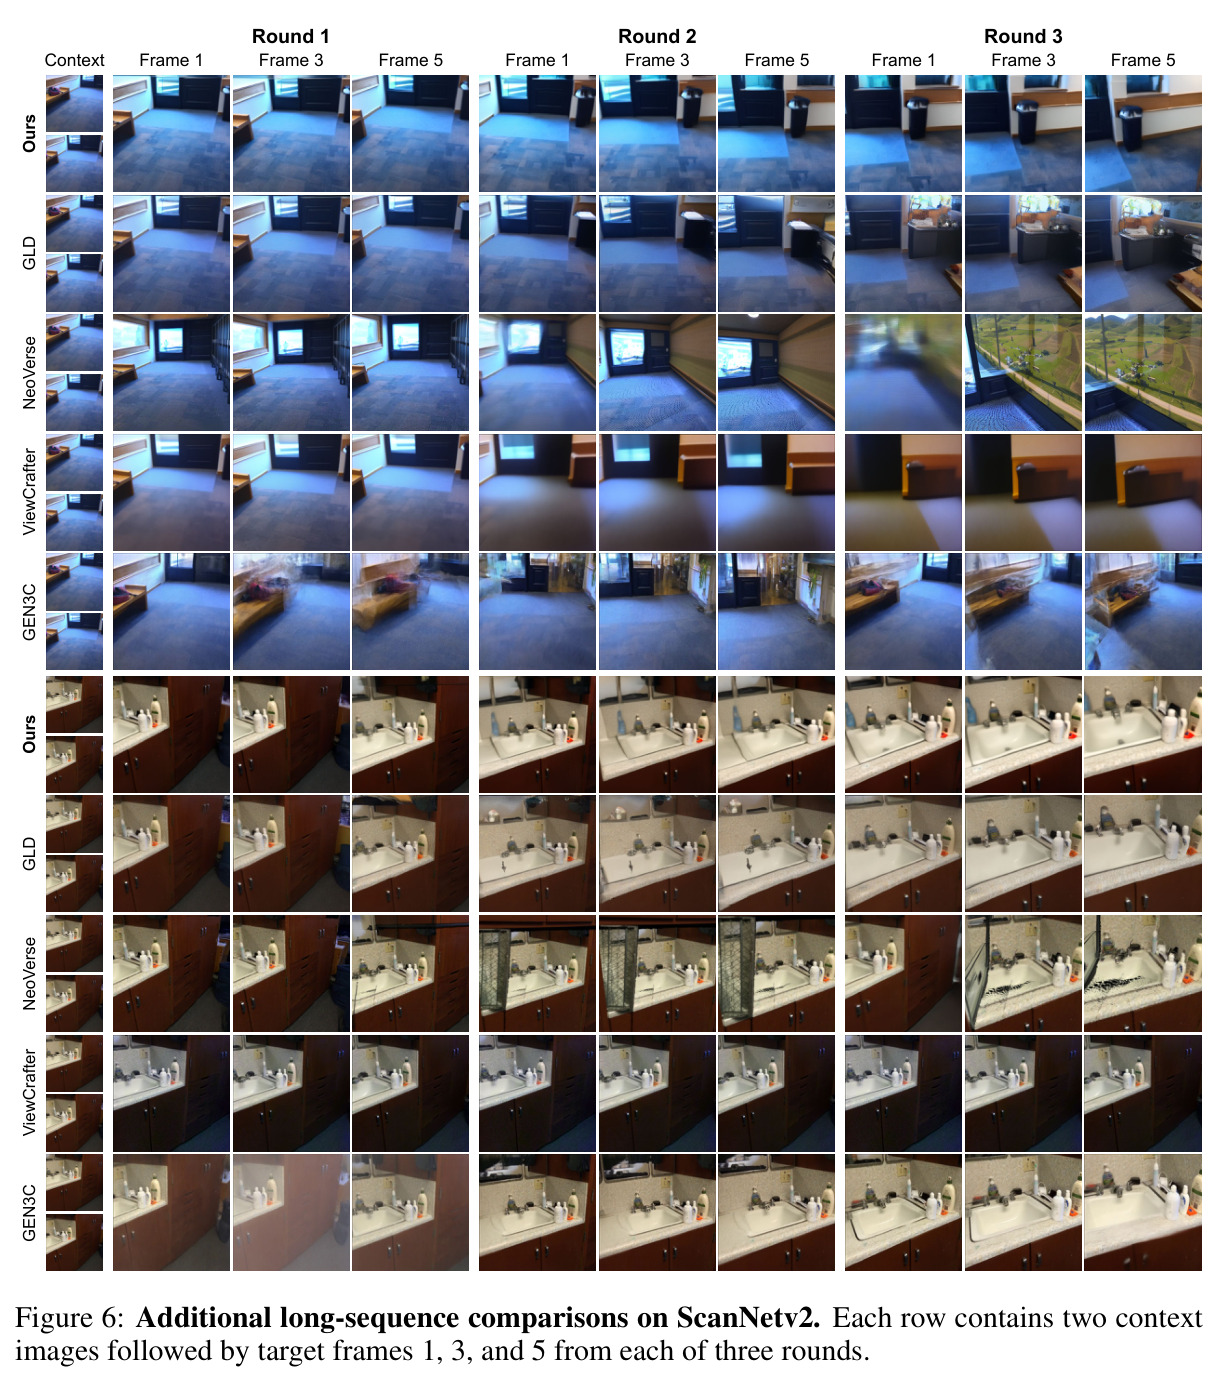
在域内 RealEstate10K、DL3DV 与域外 Mip-NeRF 360、ScanNetv2 上(每轮 2 上下文 + 6 目标视角),GeoVerse 对比 ViewCrafter、GEN3C、MVGenMaster、Matrix3D、CAMEO、GLD 等基线全面领先。视觉质量:DL3DV 上 PSNR 19.61 dB,较 GLD 的 17.38 提升 2.23 dB,LPIPS 0.339;Mip-NeRF 360 与 RealEstate10K 上 PSNR 分别 20.02、21.29(GLD 为 17.57、19.66)。几何一致性:DL3DV 的 ATE 0.028 优于 GLD 的 0.058;Mip-NeRF 360 的 ATE 从 0.105 降到 0.071,改善 32.4%;ScanNetv2 三轮 PSNR 从 15.33 升到 19.65。效率:单轮约 9.12–9.29 秒,比 GLD 快约 18 倍。少步分析表明 L1 需 3 步(1 步时 LPIPS 从 0.339 恶化到 0.367),L0 级联 1 步即够。消融:去 Wan2.2 先验 PSNR 跌至 16.83(影响最大),去空间记忆跌至 17.87,MoT 变体 19.24,去 RGB 损失 18.58,去深度损失 19.05。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DL3DV 新视角合成 | PSNR / ATE / 单轮耗时 | PSNR 19.61 dB,ATE 0.028,9.24 s | GLD:PSNR 17.38 dB,ATE 0.058,169.29 s | PSNR +2.23 dB,ATE 降低约 51.7%,加速约 18.3 倍 |
| RealEstate10K 新视角合成 | PSNR / LPIPS | PSNR 21.29 dB,LPIPS 0.275 | GLD:PSNR 19.66 dB,LPIPS 0.299 | PSNR +1.63 dB,LPIPS 降低 0.024 |
| Mip-NeRF 360 新视角合成(域外) | PSNR / ATE | PSNR 20.02 dB,ATE 0.071 | GLD:PSNR 17.57 dB,ATE 0.105 | PSNR +2.45 dB,ATE 降低 32.4% |
| ScanNetv2 长序列三轮生成 | PSNR / ATE / 累计耗时 | PSNR 19.65 dB,ATE 0.009,33.11 s | GLD:PSNR 15.33 dB,ATE 0.011,476.27 s | PSNR +4.32 dB,加速约 14.4 倍 |
局限与改进
作者承认两点局限。第一,峰值视觉保真度受 DA3 特征空间的外观容量约束:为追求速度采用紧凑特征条件化,精细纹理丰富度可能不及重型全尺度视频扩散模型,504×504 的训练/推理分辨率也低于部分视频方法。第二,多轮一致性依赖几何骨干与生成 RGB 的双重稳定:在无纹理或复杂区域,初始深度误差与生成外观漂移会通过空间记忆更新逐步累积,偶发跨视角对齐受损,记忆机制只能减缓而非根除漂移。我的补充观察:其一,点云记忆随轮数无限增长,大场景下的存储与溅射开销未量化讨论;其二,弱标注训练数据(RealEstate10K、Waymo)依赖 Pi3 估计的位姿与深度,先验误差可能被学入模型;其三,定量评估用 VGGT 估计位姿计算 ATE/RPE,评估链路本身引入不确定性;其四,消融中 MoT 变体的差距「需在同等训练设置下比较」,说明该结论尚未完全定论。
独立分析的弱点
第一,外观容量瓶颈:Wan2.2 仅作一次性冻结特征抽取(blocks 0–15),注入信息量有限,且 504×504 分辨率限制了高清应用;改进方向是对视频分支做轻量微调或可学习查询,并引入渐进式超分级联提高输出分辨率。第二,点云记忆的可扩展性:z-buffer 可见性判断基于可能有误的深度,无纹理区域易发生错误融合与结构重复;改进方向是引入哈希/八叉树稀疏存储、置信度时间衰减与记忆修剪,或改用可微 3D 表示(如 3DGS)承载记忆以支持在线优化。第三,尺度对齐鲁棒性:深度对齐仅用相机中心相似变换估计单一尺度 $s^\star$,在纯旋转运动或相机分布退化时尺度估计不稳,误差会传播进记忆;改进方向是联合光度—几何一致性的在线闭环校正。第四,感知指标优势微弱:MEt3R 上 0.261 对 GLD 0.262、Reproj. 上部分基线偶有更低值,「全面 SOTA」主要由 PSNR/ATE 支撑,解读时应结合感知指标谨慎评估。
未来方向
作者提出的方向:提升 3D 几何与光度联合稳定性,改进记忆更新机制以支撑更长轨迹;弥补紧凑特征条件化导致的外观容量差距。基于成果可延伸的方向:其一,把「几何潜扩散 + 空间记忆」范式迁移到可交互视频世界模型,论文也自述这是「构建多视角一致视频世界模型的稳健基础」;其二,将点云记忆升级为 3DGS 等可渲染可优化的场景资产,实现生成结果到可编辑 3D 资产的转换;其三,引入文本或语言条件实现可控的场景编辑与生成;其四,把 3+1 少步蒸馏策略推广到其他几何潜扩散模型;其五,与 SLAM 或在线重建结合,做实时扫描—补全一体化的具身与机器人应用;其六,重新审视 MoT 注意力注入——消融中 19.24 对 19.65 的差距可能在同等训练预算下消除,混合注入方案值得探索。
复现评估
复现难度较高。论文未声明开源代码或模型权重,仅给出项目页 geoverse-nvs.github.io,这是最大障碍。依赖组件方面:GLD 预训练模型、DA3-Base、Wan2.2-VACE-Fun-A14B(取低噪专家,保留 blocks 0–15)、Pi3(补齐弱标注数据位姿/深度)均公开,但组装训练管线工程量大。数据为 15 个公开数据集,共 87886 个场景、约 2376 万张图像,预处理(按帧数平方根采样、几何来源 2:1 混选、失败样本重采样)需大量存储与脚本开发。算力门槛:32 张 NVIDIA A800,适配 300k 迭代(lr $3\times10^{-5}$)加蒸馏 50k 迭代(lr $1\times10^{-5}$),全局 batch 32,AdamW、梯度裁剪 1.0、EMA 0.9995——学术实验室难以负担。若权重开源,推理部署则轻量:单轮 4 步去噪、约 9 秒生成 6 视角;评测协议(2 上下文 + 6 目标、VGGT 位姿、PSNR/SSIM/LPIPS/ATE/RPE/Reproj./MEt3R)描述清晰,可复现评测。
论文图表
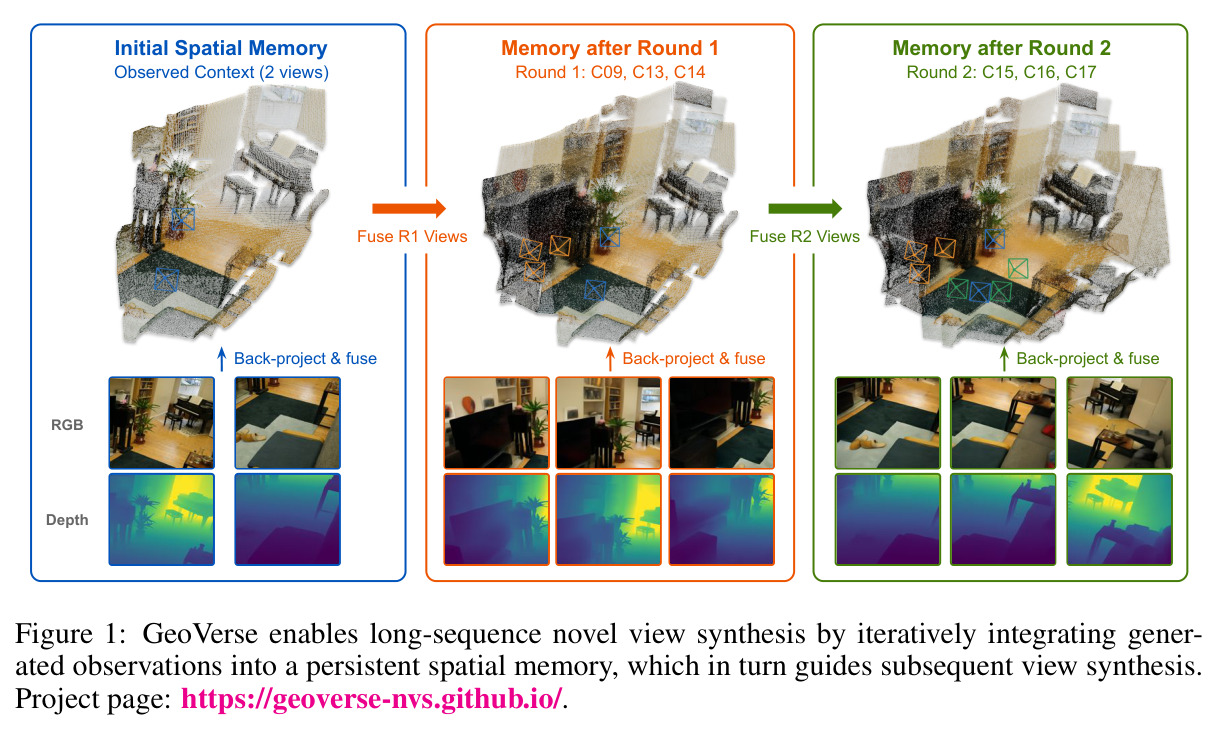
示意图展示从初始空间记忆出发的多轮扩展:初始只有 2 张观测上下文视图,第 1 轮生成 C09/C13/C14 并反投影融合进记忆,第 2 轮生成 C15/C16/C17 再次融合;每轮都用「反投影与融合」把新内容并入持久记忆,再用更新后的记忆引导下一轮生成。
这张图直观呈现了论文最核心的机制——持久空间记忆驱动的多轮一致扩展,是理解 GeoVerse 与单次生成方法(如 GLD)本质区别的入口。
消融表:左侧在级联 L0 固定 1 步时扫描 L1 步数(49→1),右侧在 L1 固定 3 步时扫描级联步数(49→1),报告耗时与 PSNR/SSIM/LPIPS/ATE/MEt3R。L1=3 时 9.24 秒、PSNR 19.61、LPIPS 0.339;L0=1 时耗时 9.24 秒、LPIPS 0.342,与 49 步的 0.339 几乎持平。
该表给出 3+1 预算分配的定量依据,同时揭示 PSNR 与感知质量的背离(L1=1 步 PSNR 最高但 LPIPS 最差),对理解加速与质量的权衡至关重要。