OmniEdu:面向学习与教学的开放式教育基础模型 OmniEdu: Open Foundation Models for Learning and Teaching
用能力导向的数据配方把通用大模型调成会解题、懂课程、能诊断、善引导的 K-12 教育模型
前置知识
指令微调(SFT)
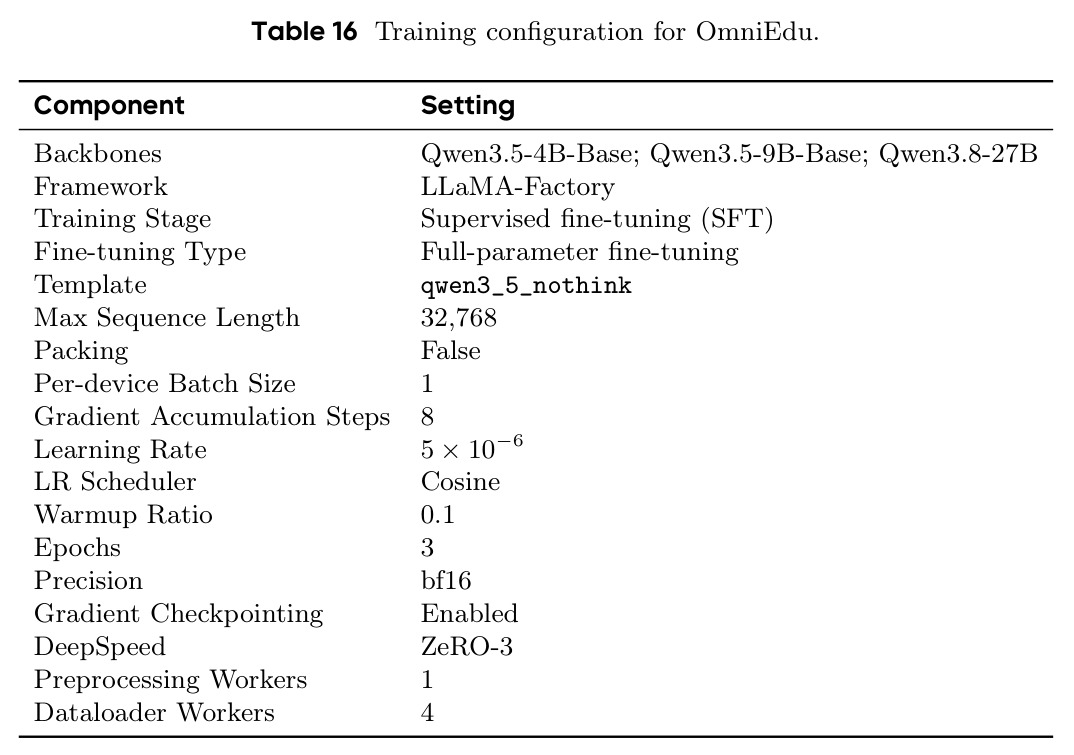
监督微调是在预训练模型基础上,用『输入-期望输出』成对样本继续训练,使模型学会按指令行事。本文对 Qwen3.5-4B/9B-Base 与 Qwen3.8-27B 做全参数 SFT:学习率 $5\times10^{-6}$、余弦调度、warmup 0.1、3 个 epoch、最大序列长度 32768、bf16 精度配合 DeepSpeed ZeRO-3,是论文把数据配方转化为模型能力的最终载体。
论文的全部贡献都通过 SFT 落地,理解超参与训练设置才能判断结果的可复现性,以及性能提升确实来自数据配方而非训练技巧。
数据中心后训练(Data-centric post-training)
指不靠单纯扩大数据规模,而是围绕质量、多样性与能力相关性来设计训练混合的方法论。LIMA 用约一千条精选样本即可诱导很强的指令遵循,AlpaGasus、Deita、LESS 分别研究 LLM 质量过滤与针对性数据选择。本文把这一思路系统搬到教育领域:先多级过滤再按能力配比组装语料。
OmniEdu 的核心主张是『数据构成是教育模型的第一设计轴』,不理解这个视角就看不出六阶段流水线每一步背后的动机。
k-center 贪心与句向量多样性选择
把每条样本用嵌入模型(本文用 BGE-M3)编码为向量后,k-center 贪心每轮挑选离已选集合最远的样本,从而在固定预算内最大化语义覆盖,避免随机子采样保留大量近重复样本。本文在初步压缩和最终 token 预算分配两个阶段都使用了该算法。
多样性选择是流水线从 121,318 条压到 60,951 条的关键手段,直接决定最终数据集的语义覆盖面与配比。
支架式教学(Scaffolding)
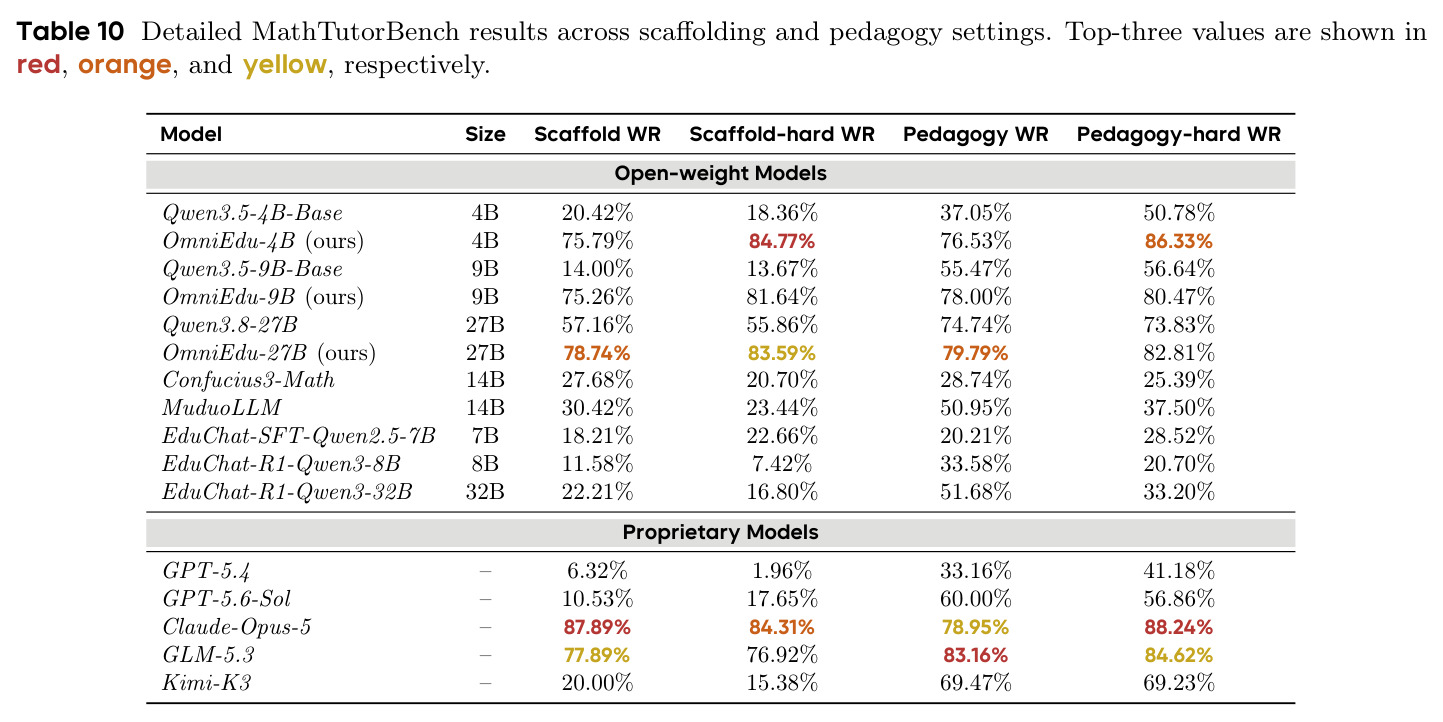
源自维果茨基最近发展区理论的教学策略:教师不直接给答案,而是提供提示、反问、回顾前置知识等临时支持,让学生自己完成推理后再逐步撤除支架。本文用 MathTutorBench 的 Scaffold 胜率来度量模型『忍住不给答案、引导推理』的能力。
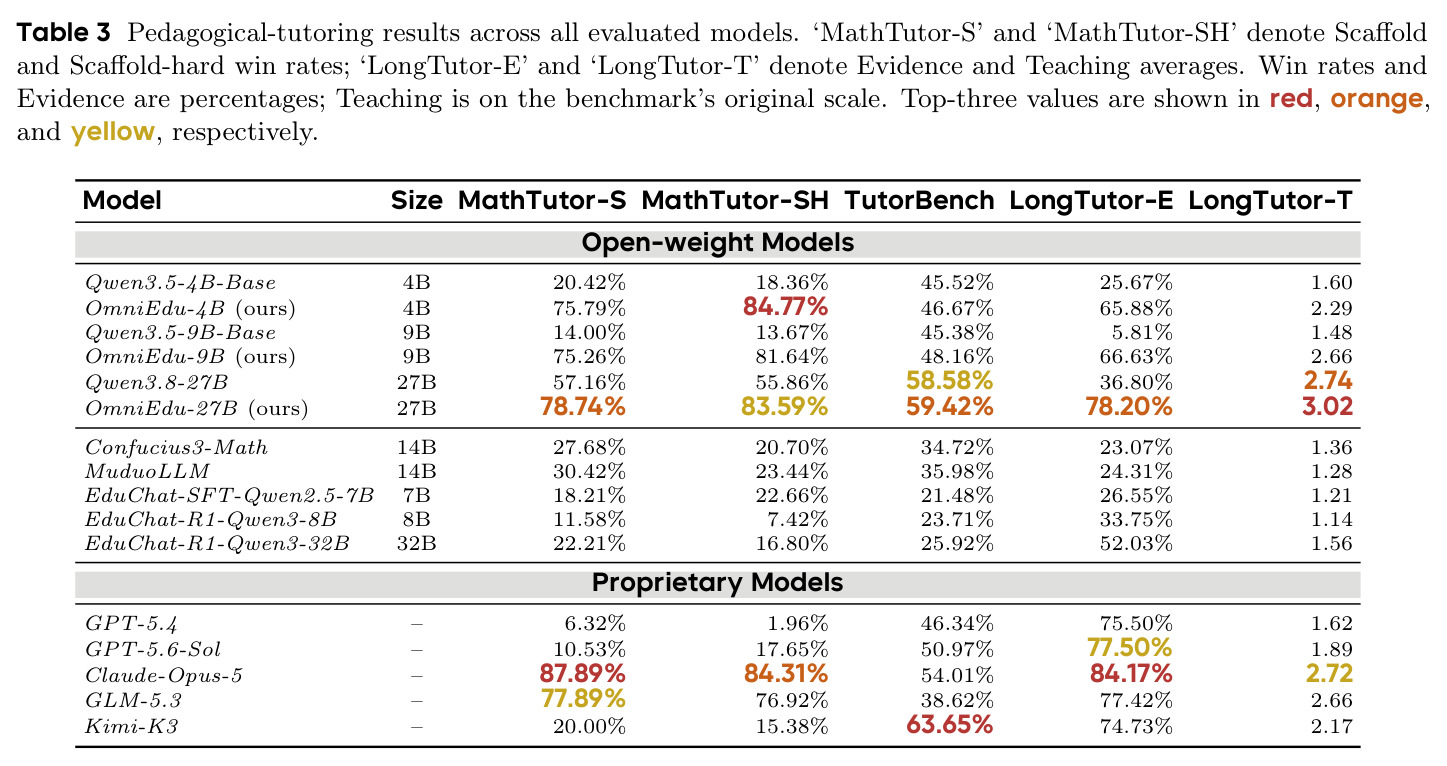
它是四能力中『教学行动与支架』的核心行为,也是微调后提升最显著的指标之一(4B 从 20.42% 升至 75.79%)。
胜率(Win Rate)与 LLM 评审
对开放式教学回复没有唯一标准答案,常用一个强裁判模型把候选回复与基准回复成对比较,统计候选被偏好的比例即胜率。本文的 MathTutorBench、TutorBench 以及 LongTutor 的 Teaching 维度都依赖这类基于评审的评估,衡量的是相对质量而非绝对正确性。
论文教学能力的主要结论建立在胜率上,理解其成对比较机制才能正确解读 78.74% 这类数字的含义与局限。
研究动机
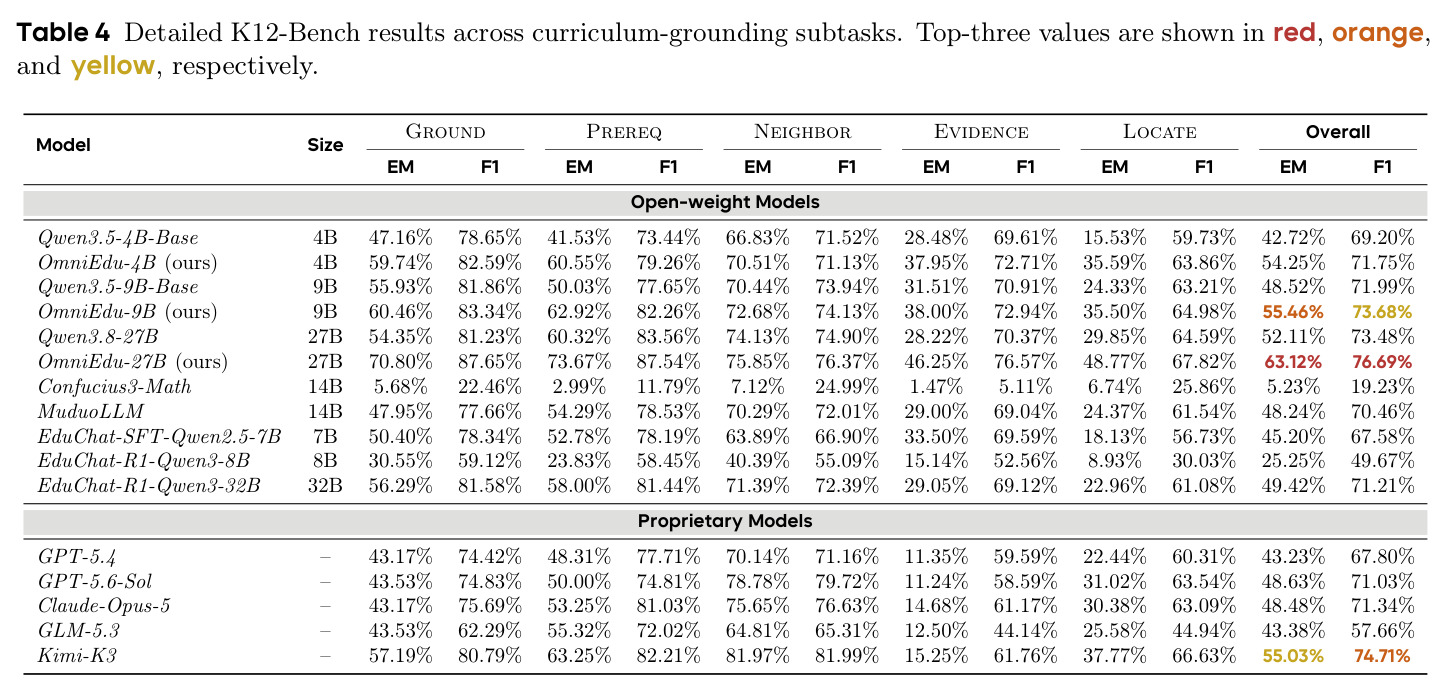
教育场景对语言模型的要求远不止答对题目:一个合格的学习/教学助手要能定位题目在课程体系中的知识点与前置关系、诊断学生出错背后的误区、并选择恰当的教学干预。但现有工作大多只覆盖单一环节——Confucius3-Math 专攻 K-12 数学解题,EduChat、MuduoLLM 面向问答与引导,而 LearnLM、ChatGPT Study Mode、Khanmigo 等前沿系统虽然纳入了教学法行为,却闭源或依赖产品级编排,能力难以复现。更关键的是,这些模型的训练数据通常按来源或学科组织,简短答案、课程关系、误区诊断、辅导对话被混在一起,既掩盖了每条样本要训练的回应策略,又让简单冗余的样本占据主导,造成『解题强、教学弱』的失衡。基线数据也印证了这点:即便是 32B 的 EduChat-R1,K12-Bench EM 也只有 49.42%,课程定位子任务 Locate 的 EM 仅 22.96%,而 MathTutorBench Scaffold 胜率普遍低于 31%。
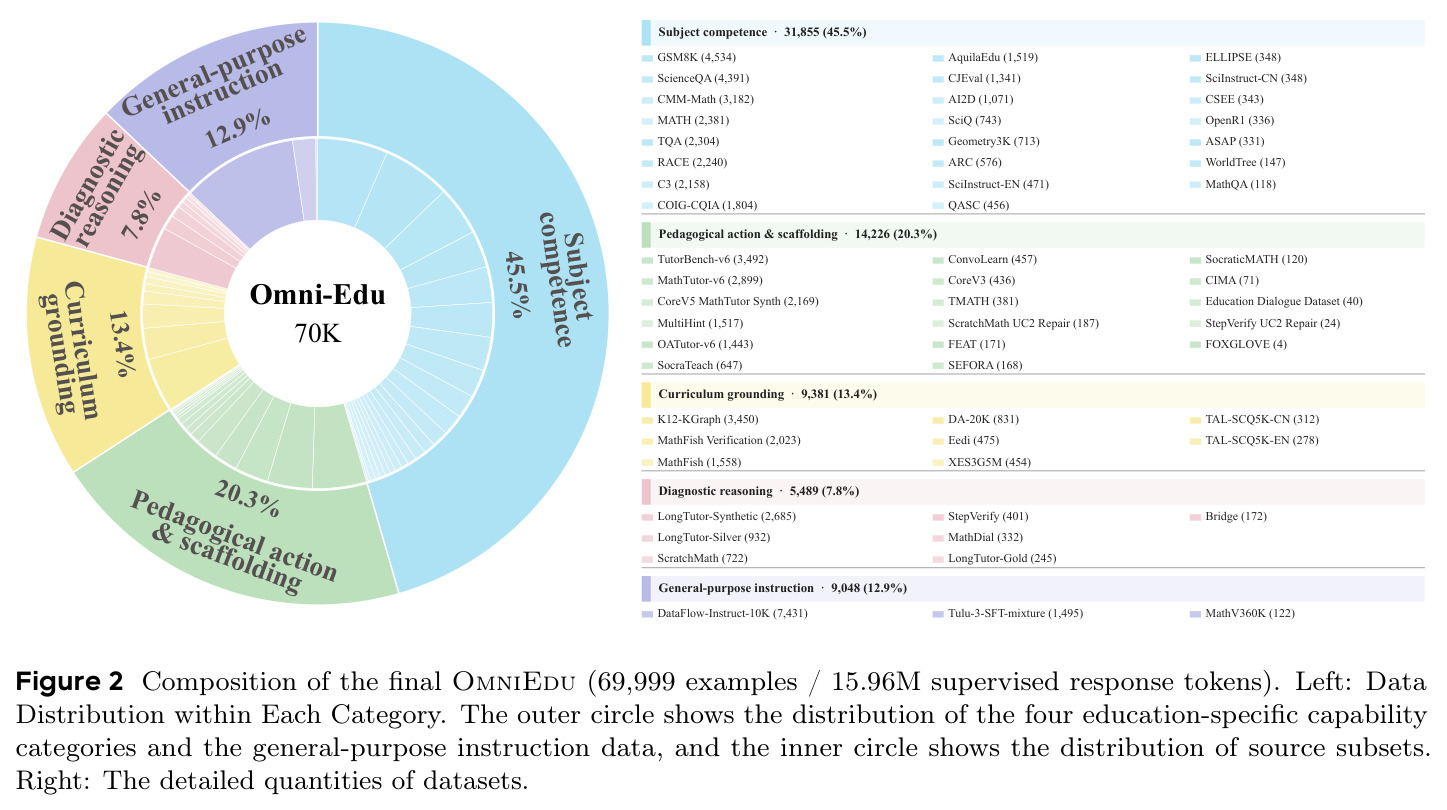
本文的目标是本文目标是构建一个开放的 K-12 教育基础模型家族,同时覆盖『学』与『教』的完整闭环:不仅解题正确,还要理解课程结构、诊断学习者困难、并执行合适的教学行为。具体拆成三件事:其一,提出学科能力、课程定位、诊断推理、教学行动与支架四能力分类法,作为数据构建与评估的统一语言;其二,建设一条可复现的能力导向数据流水线,从 100 多个数据源、约 134 万条教育样本中精选出 69,999 条、共 15.96M 监督响应 token 的高质量混合语料;其三,微调 4B、9B、27B 三个规模的开源权重模型,在课程定位、K-12 解题、教学辅导三类共 9 个教育基准上系统评估,并用 IFEval、GPQA、MMMU-Pro 三个通用基准检查专业化的副作用。
与已有工作不同的是,本文的独特切入是把教育模型的能力差距定义为一个『数据设计问题』而非数据规模问题。作者观察到教育指令数据本质上是异质的:一条简短答案、一条课程关系、一次误区诊断和一段辅导对话各自监督完全不同的行为,只按来源或学科混合会让模型无法分辨每条样本要训练什么策略。为此 OmniEdu 做了两件既有工作没做的事:一是给每条样本显式指派唯一的主能力标签和细粒度任务桶,使监督目标可审计、配比可控;二是借鉴 LearnLM 的教学法指令跟随思想,为每个任务桶配置 20 种系统指令模板之一,把『内容』与『期望回应行为』解耦——同一道题既可以训练直接作答,也可以训练暂扣答案做支架引导。此外用响应 token 预算而非样本条数做多样性选择,避免长辅导对话与简短答案在条数口径下互相挤压。
核心方法
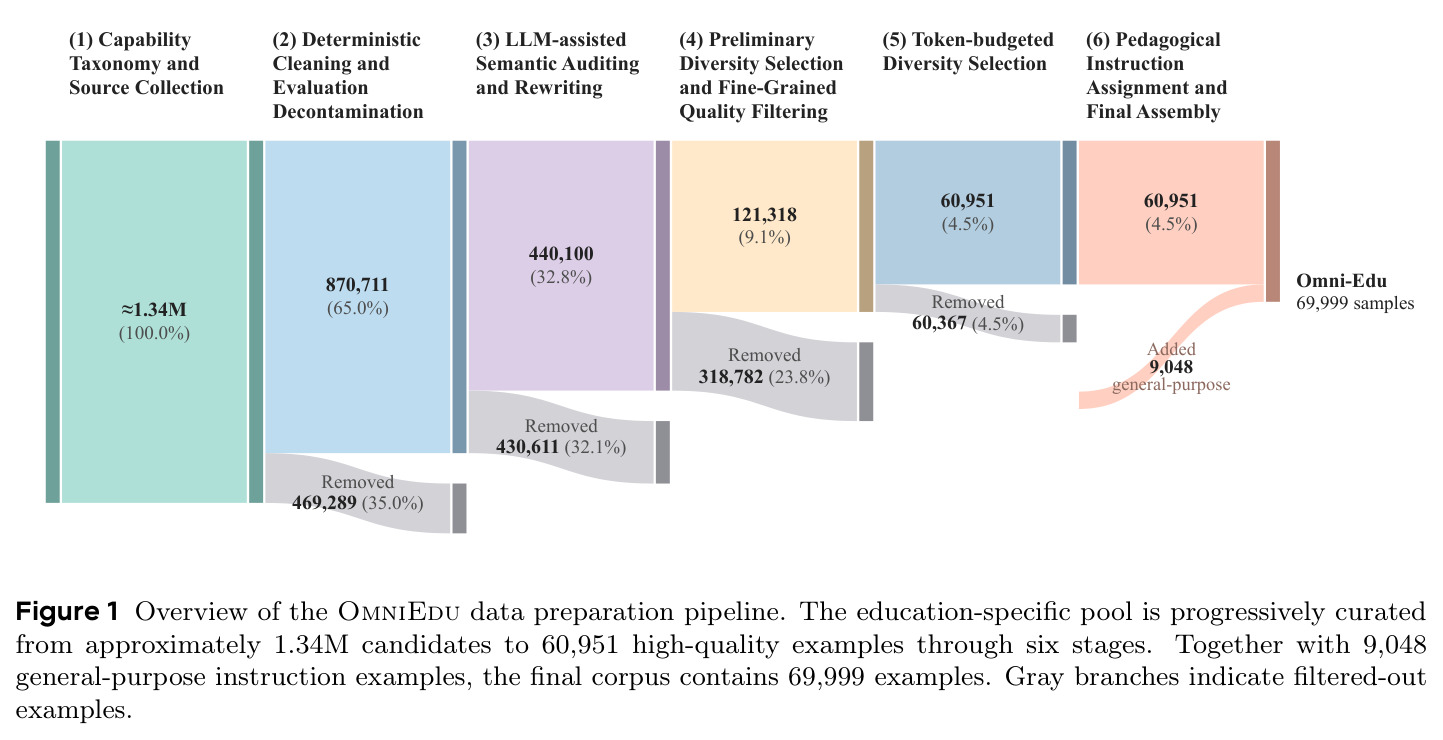
直觉上,这篇论文认为『给模型看什么样的教学示范』比『堆多少数据』更能决定教育能力:只要每条样本带着明确的能力目标和恰当的回应行为,约 7 万条数据就足以把通用模型改造成教育助手。技术路线分两步。第一步是六阶段数据流水线:从 100 多个数据源收集约 134 万条教育样本后,依次执行确定性清洗与评测去污染、LLM 辅助语义审计与改写、初步多样性压缩加细粒度质量打分、按 token 预算的桶内多样性选择、以及教学法指令分配,最终得到 69,999 条样本——教育专用 60,951 条(约 12.0M 响应 token)加通用指令 9,048 条。第二步是用 LLaMA-Factory 对 Qwen3.5-4B-Base、Qwen3.5-9B-Base、Qwen3.8-27B 三个基座做全参数 SFT(学习率 $5\times10^{-6}$、3 个 epoch、序列长 32768),得到 OmniEdu-4B/9B/27B,并在课程定位、K-12 解题、教学辅导三大类基准上与自家基座、开源教育模型和闭源前沿模型对比。
核心创新是『能力导向的监督组织方式』。与已有工作按数据来源或学科划分训练集不同,OmniEdu 先定义四种互补能力——学科能力(解题与讲解,占 45.5%)、课程定位(知识点/年级/前置关系/难度,占 13.4%)、诊断推理(从学生作答识别误区与缺失前置知识,占 7.8%)、教学行动与支架(选择并执行提示、反问、回溯前置或直接讲解,占 20.3%)——再把每条样本按主要监督目标归入唯一能力类,并进一步切成细粒度任务桶。在此之上最关键的一步是教学法指令分配:每条样本按其任务桶绑定 20 个系统指令模板之一,明确写出该回复应当直接作答、苏格拉底式提问还是诊断纠错。这使同一个模型能在不同指令下切换『答题者』与『辅导者』两种角色,而这正是此前把解题与辅导分开训练的系统所缺失的能力。
方法步骤详情
流水线共六步。第一步能力分类与源收集:整合 100 多个数据源,教育池约 134 万条。第二步确定性清洗与去污染:统一格式、去重、剔除缺失字段、校验答案一致性、过滤非 K-12 内容并删除与评测集重叠样本,剩 870,711 条。第三步语义审计:用 Qwen3.5-122B-A10B-FP8 打 0-100 可用性分并给出 keep/rewrite/remove 动作(≥85 保留、50-84 修复后复审计、<50 删除),剩 440,100 条。第四步先压缩冗余源(RACE 60,180→5,000、AquilaEdu 23,226→2,000、CJEval 17,178→2,000),再由 GPT-5.6-Terra 按 1-5 分维度打分,要求所有维度 ≥3 且关键维度 ≥4,剩 121,318 条。第五步按任务桶分配响应 token 预算,桶内用 BGE-M3 嵌入做 k-center 贪心选择,得 60,951 条、约 12.0M token。第六步按桶绑定 20 个系统指令模板之一,与 9,048 条通用样本合并成 69,999 条、15.96M token 的最终语料。
技术新颖性
技术新颖性体现在四个方面。其一,监督组织维度:以往教育模型(EduChat、MuduoLLM、Confucius3-Math)按任务或学科组织数据,本文首次以『能力』为一等公民组织教育后训练语料,并让同一分类法同时驱动数据构建与基准选择。其二,内容与行为解耦:通过 20 个任务级系统指令把『题目的内容』与『模型该表现的教学行为』分开控制,一条数据可服务多种教学法行为,该机制源自 LearnLM 但本文将其落实到开源数据集层面。其三,token 预算多样性:以监督响应 token 而非样本条数为预算单位做桶内 k-center 选择,解决长辅导对话与短答案在条数口径下互相稀释的问题。其四,全程保留来源与审计元数据,配合开源的审计 prompt 与打分规则,使 134 万到 7 万条的筛选过程可审计、可复现,这在教育数据集工作中并不多见。
实验结果
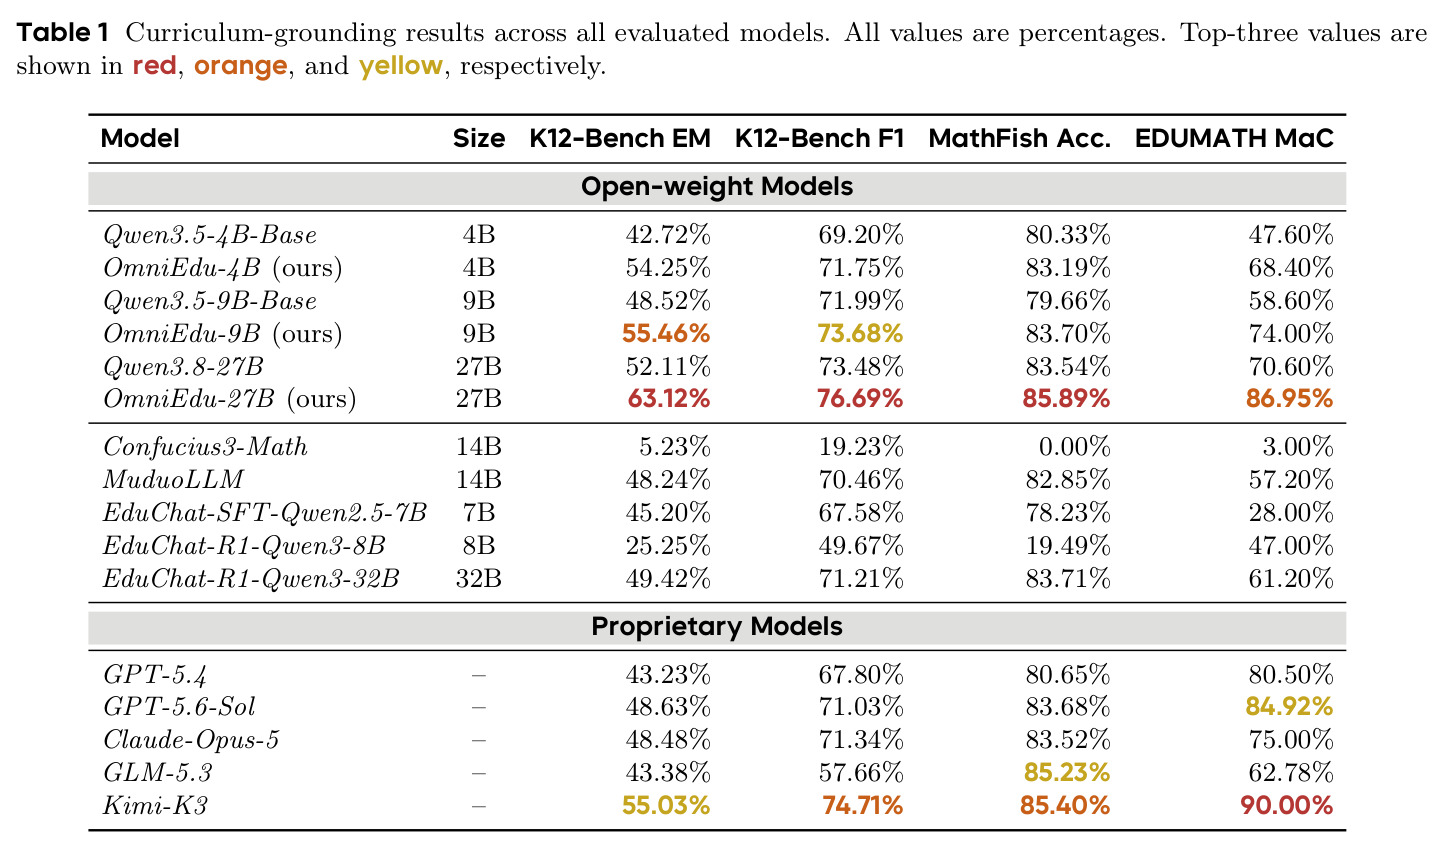
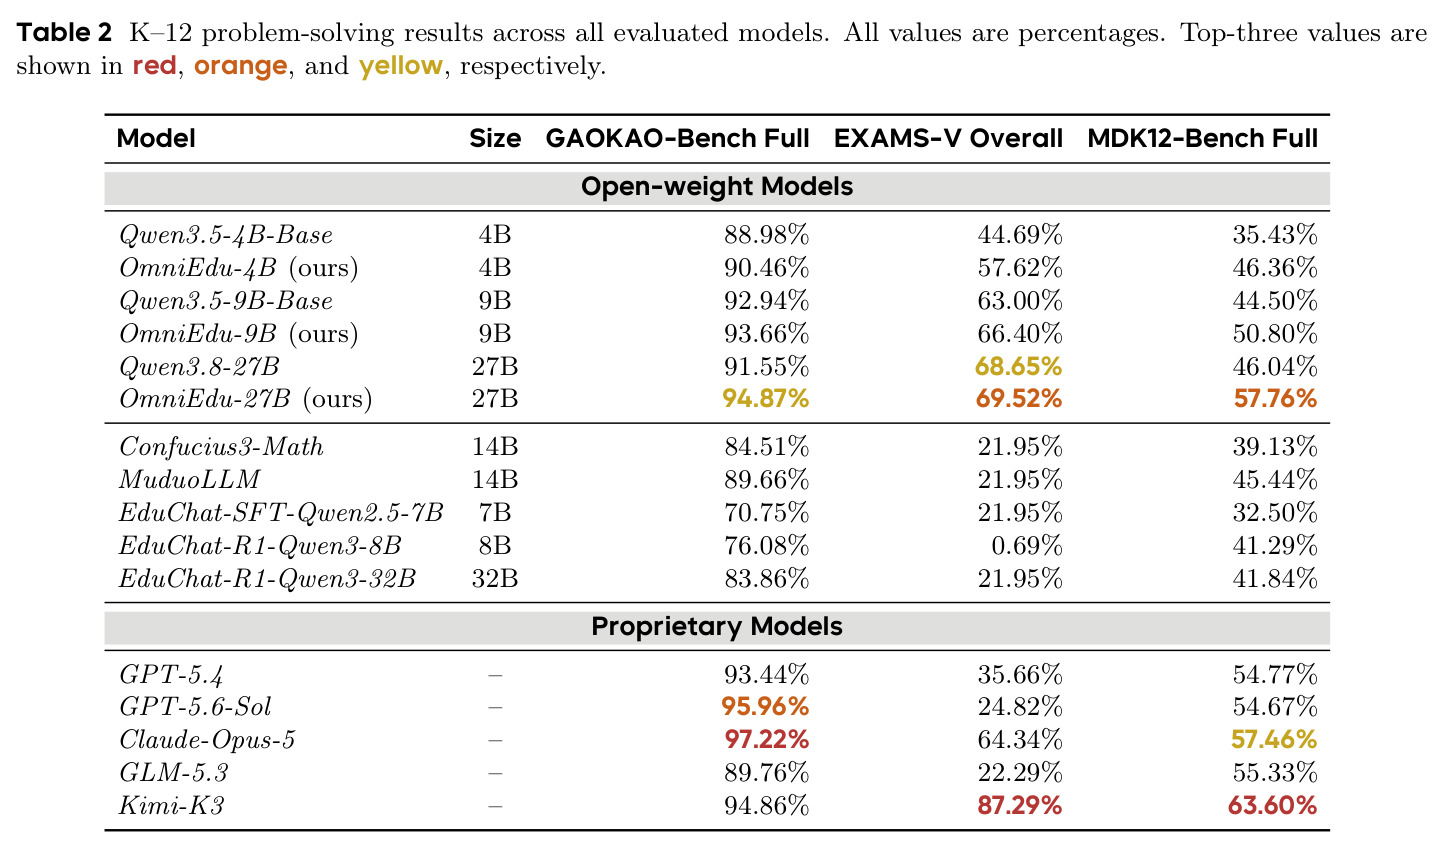
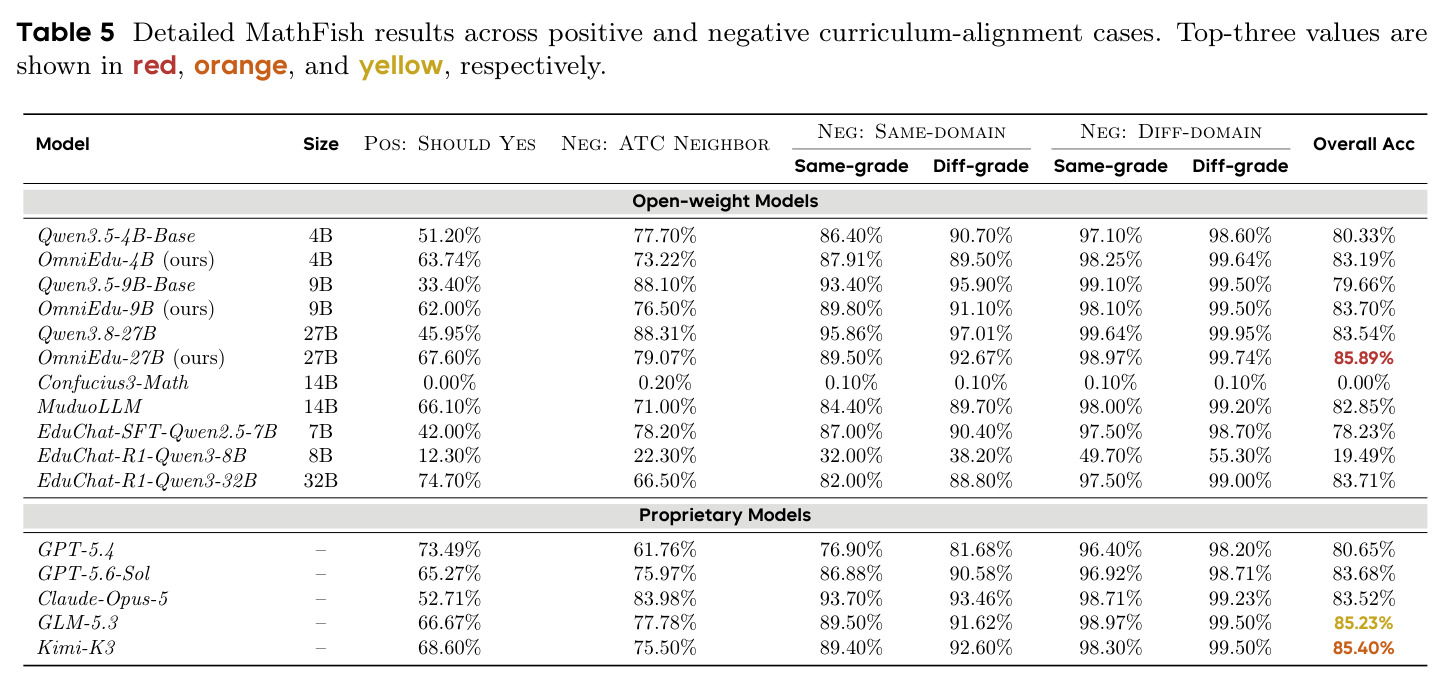
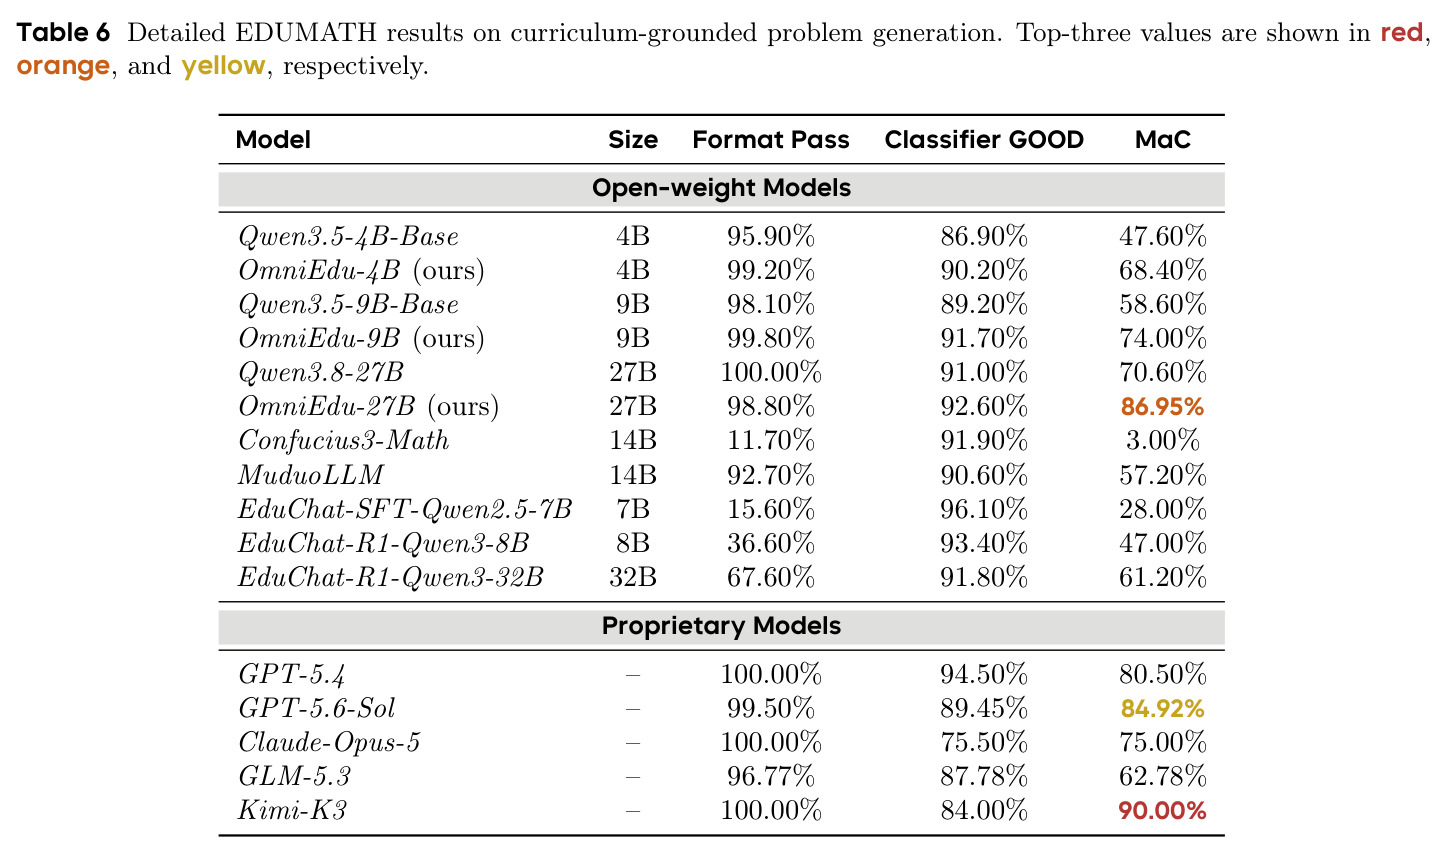
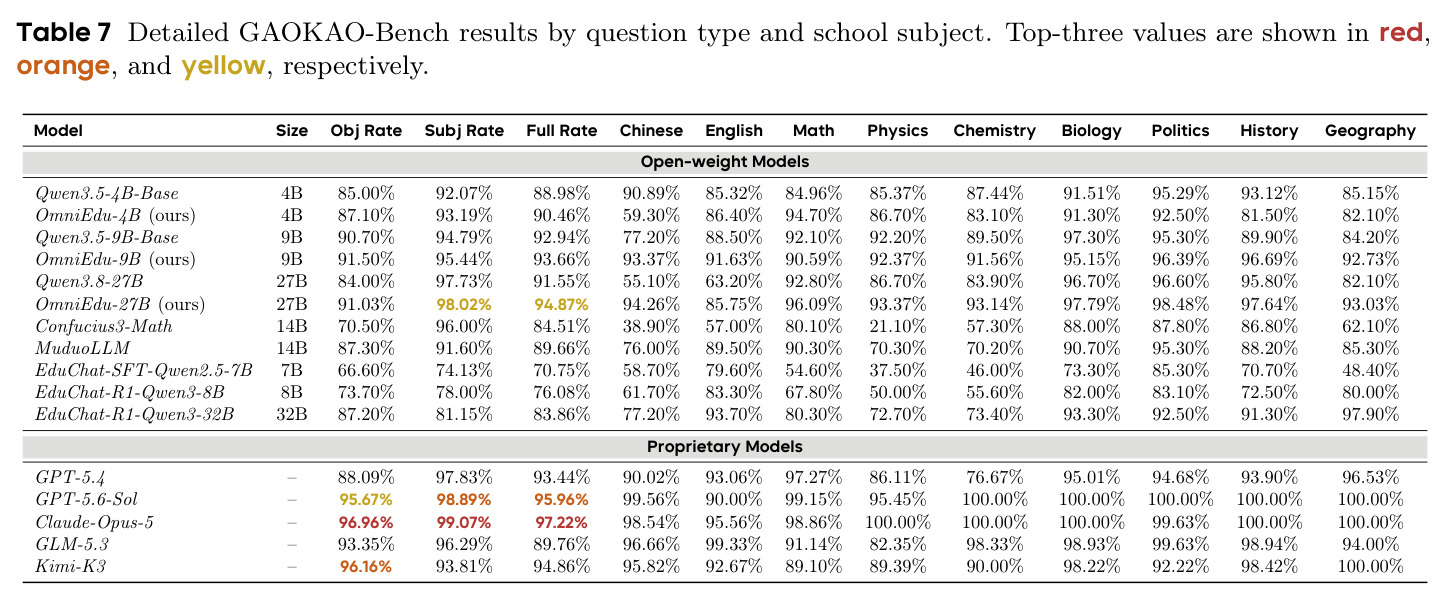
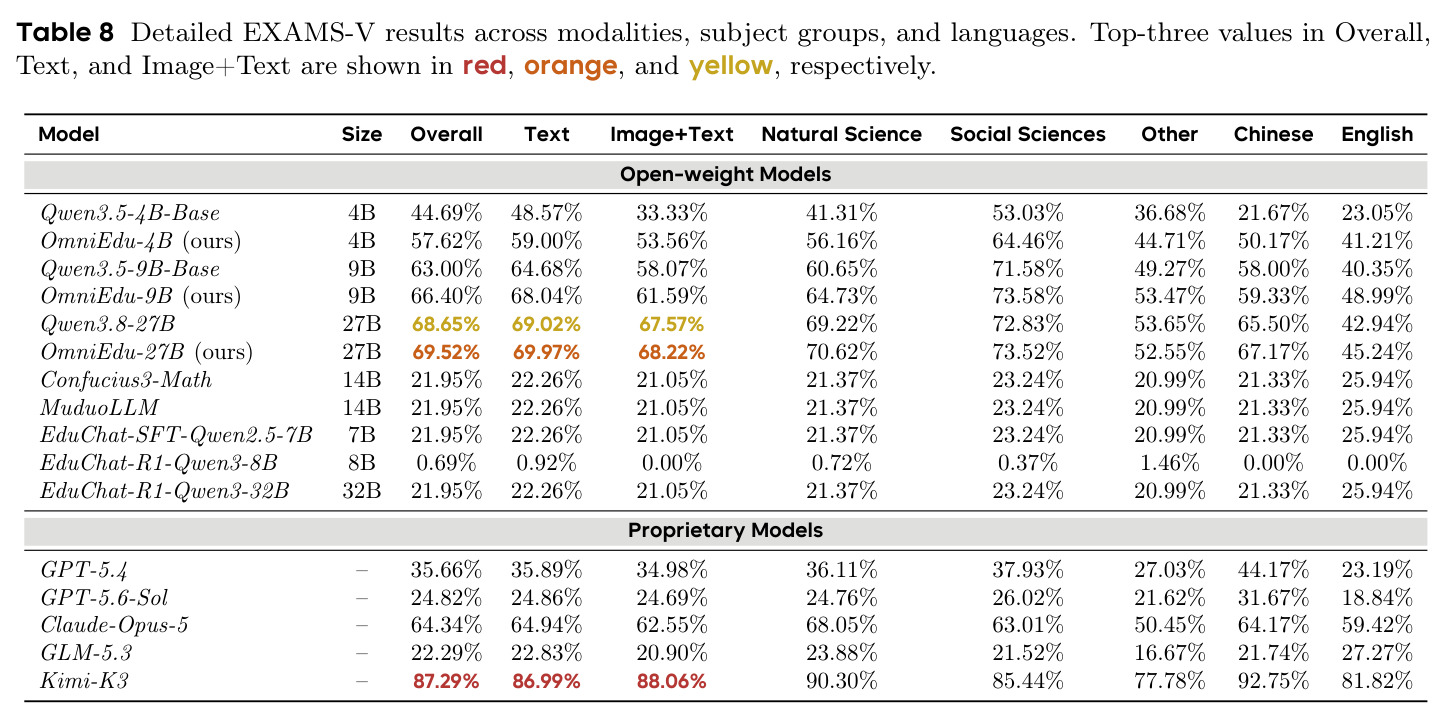
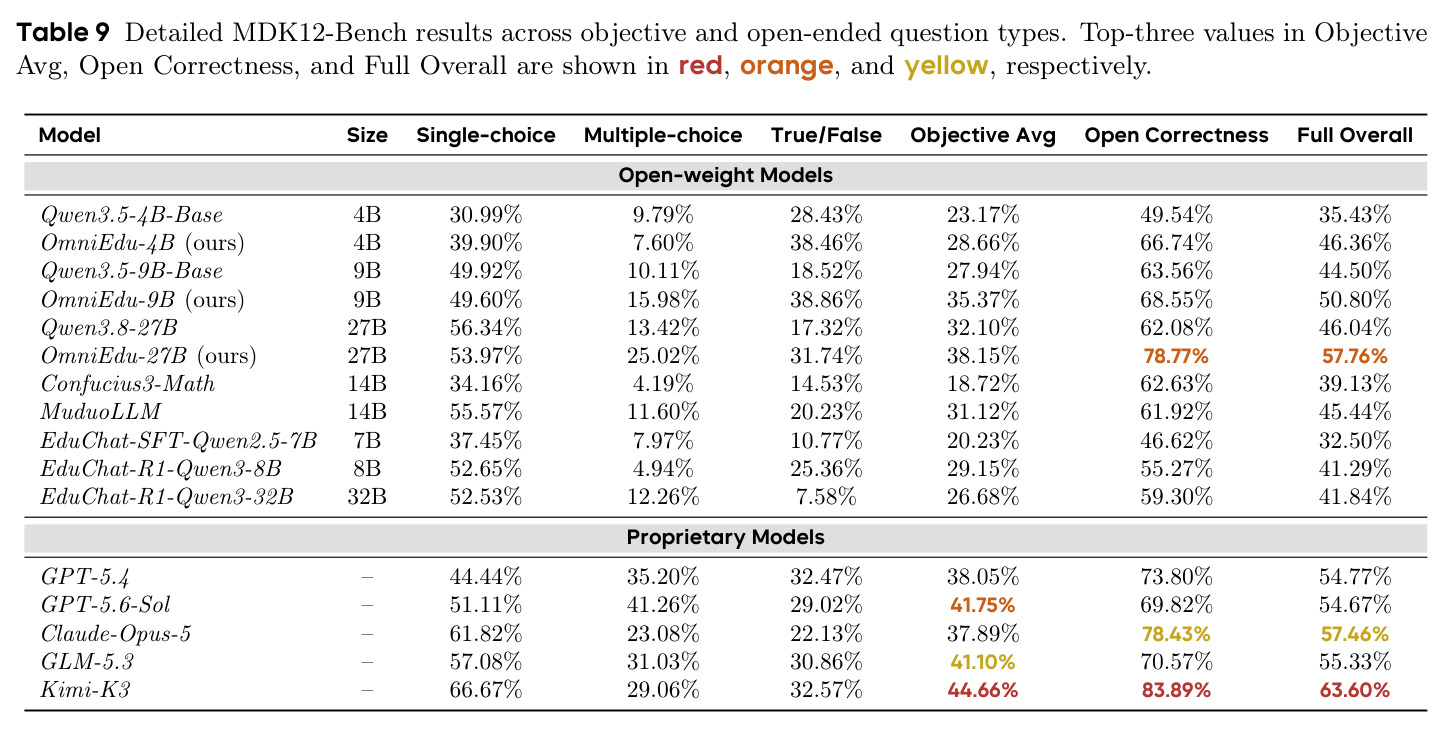
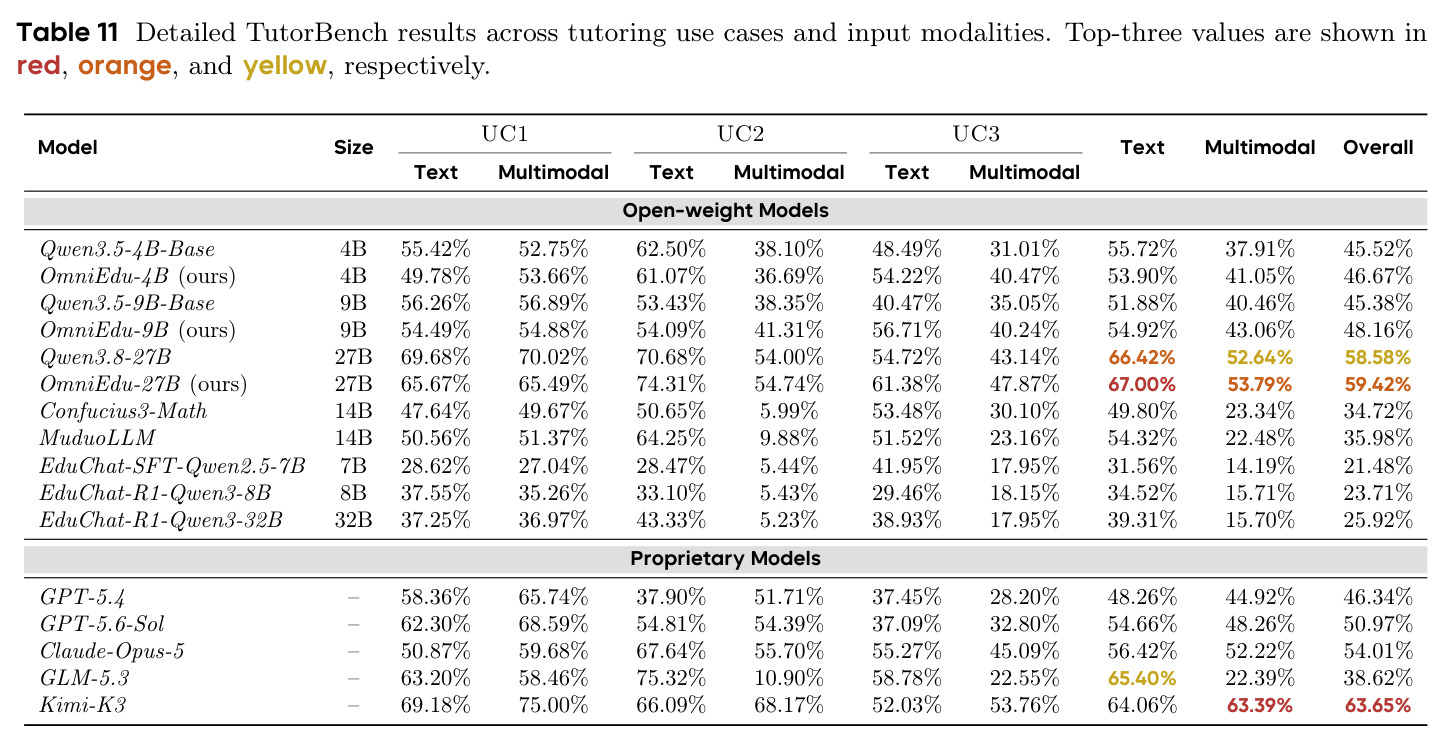
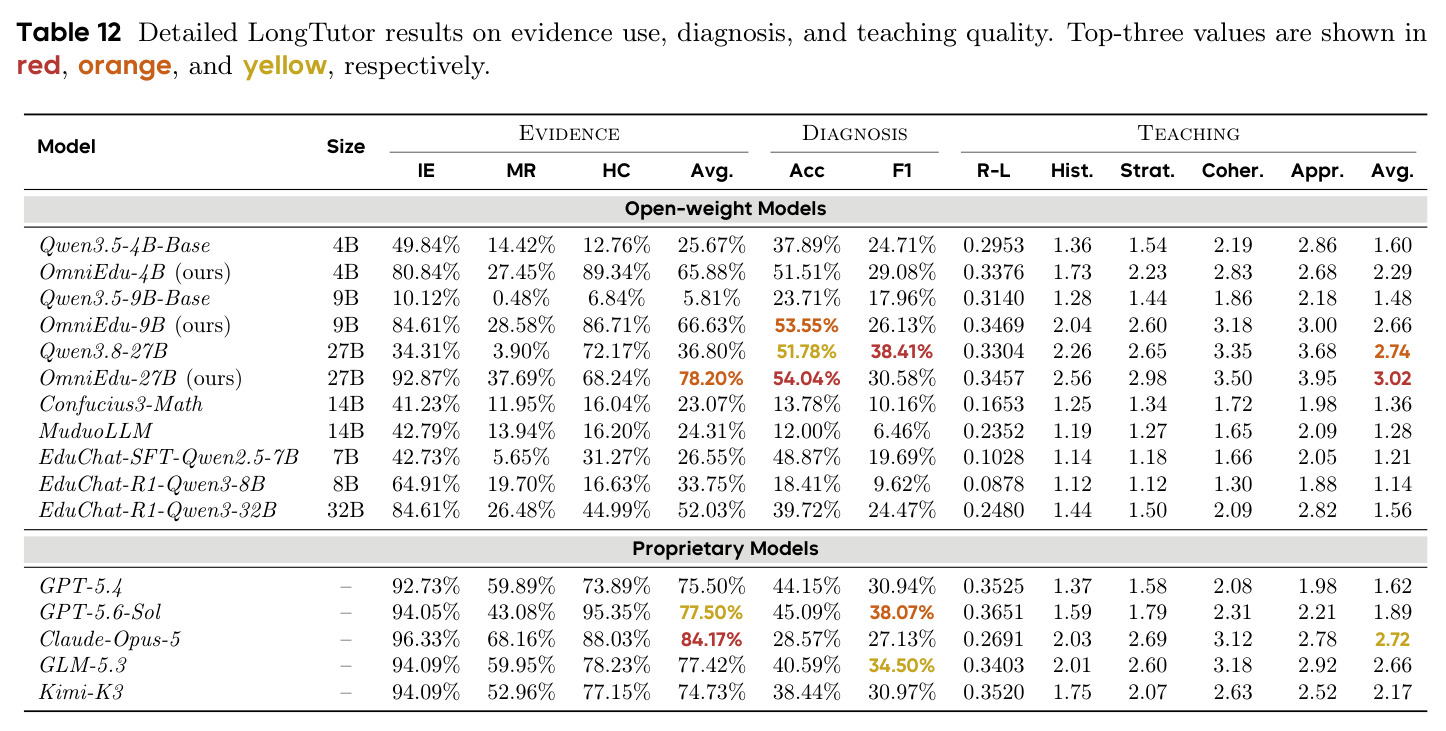
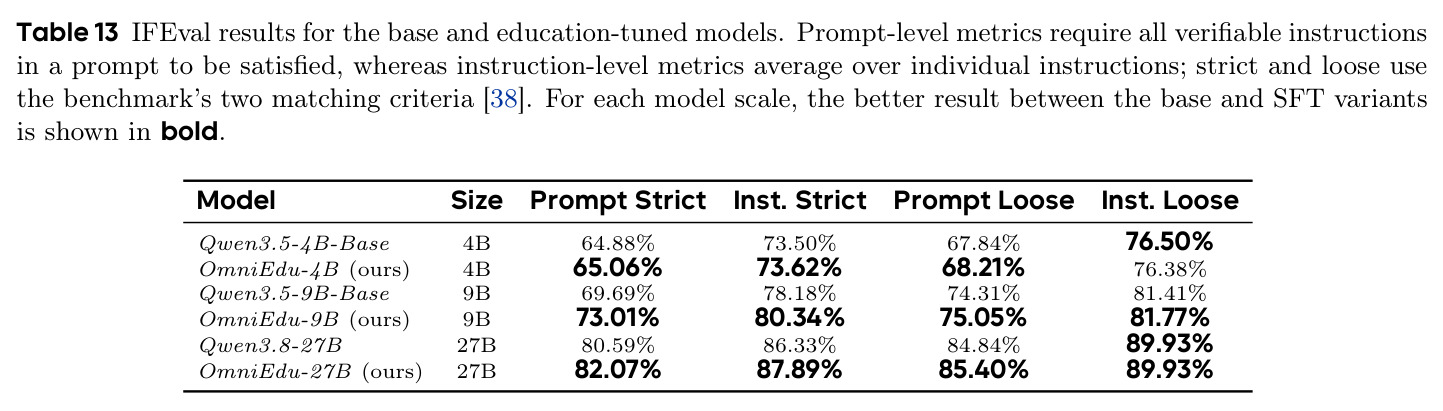
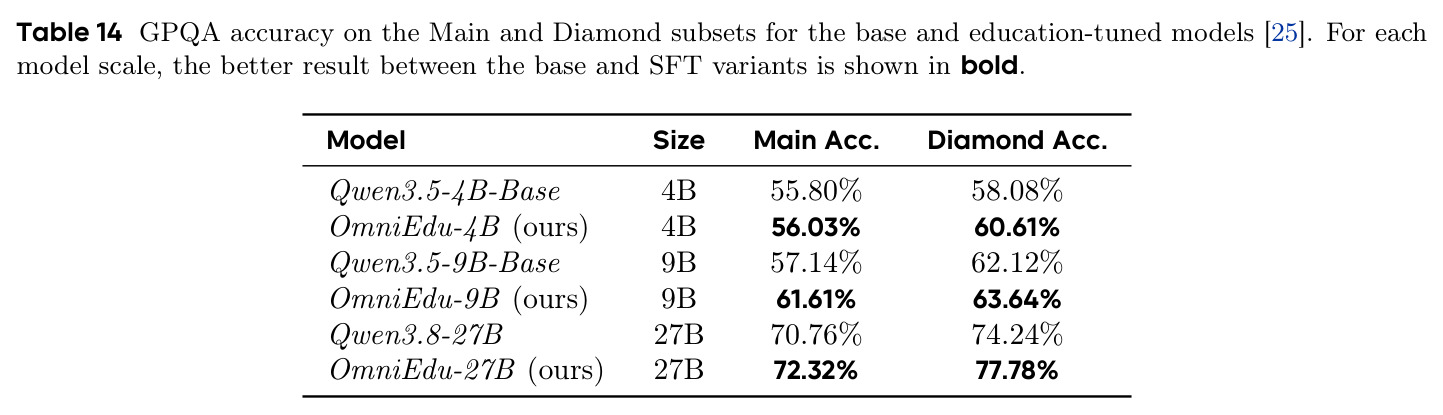
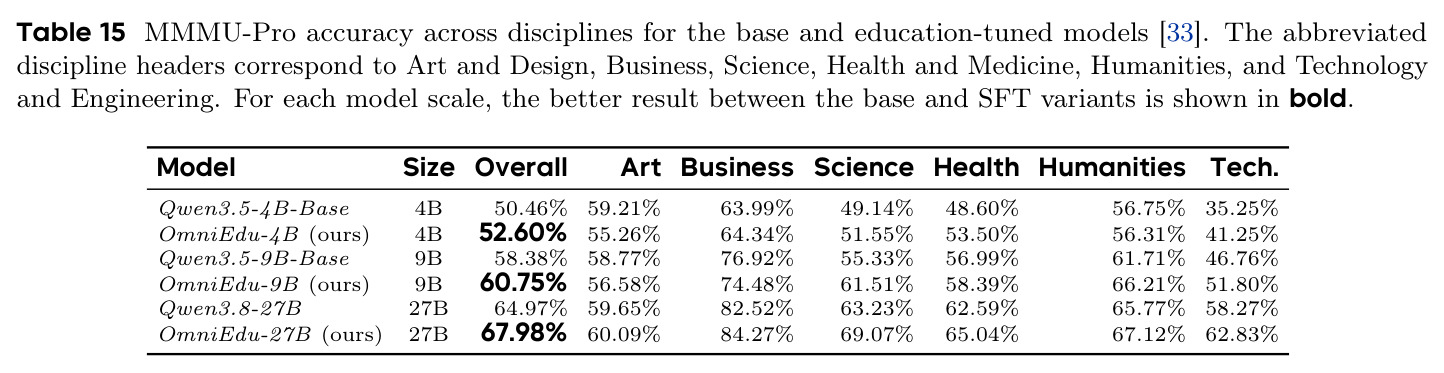
三条能力线在 4B/9B/27B 上全部一致受益。课程定位:OmniEdu-27B 在 K12-Bench 上 EM 52.11%→63.12% 全场最佳,MathFish 83.54%→85.89%,EDUMATH 的 MaC 三规模分别提升 20.80/15.40/16.35 个点,27B 达 86.95%,仅次 Kimi-K3 的 90.00%。K-12 解题:27B 在 GAOKAO-Bench 全分率 91.55%→94.87%,MDK12-Bench 总分 46.04%→57.76%(开放题 62.08%→78.77%),EXAMS-V 上 4B 从 44.69% 升至 57.62%。教学辅导提升最大:MathTutorBench Scaffold 胜率 27B 57.16%→78.74%,4B/9B 分别提升 55.37 和 61.26 个点;LongTutor 证据利用 27B 36.80%→78.20%,Teaching 均分 3.02 最佳。通用能力未退化:MMMU-Pro 27B 64.97%→67.98%,GPQA Diamond 74.24%→77.78%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| K12-Bench 课程认知(27B) | EM | 63.12% | Qwen3.8-27B 基线 52.11% | +11.01pp,居所有评测模型之首(次优 Kimi-K3 55.03%) |
| MathFish 课程标准对齐(27B) | Overall Accuracy | 85.89% | Qwen3.8-27B 基线 83.54% | +2.35pp,总体最佳;正例对齐 45.95%→67.60% |
| EDUMATH 课标对齐出题(27B) | MaC | 86.95% | Qwen3.8-27B 基线 70.60% | +16.35pp,仅次于 Kimi-K3 的 90.00% |
| GAOKAO-Bench(27B) | Full Rate | 94.87% | Qwen3.8-27B 基线 91.55% | +3.32pp,客观题 84.00%→91.03%、主观题 97.73%→98.02% |
| EXAMS-V(4B) | Overall Accuracy | 57.62% | Qwen3.5-4B-Base 44.69% | +12.93pp,图文题 33.33%→53.56% |
| MDK12-Bench(27B) | Full Overall | 57.76% | Qwen3.8-27B 基线 46.04% | +11.72pp,开放题正确率 62.08%→78.77% |
| MathTutorBench Scaffold(27B) | Win Rate | 78.74% | Qwen3.8-27B 基线 57.16% | +21.58pp;4B/9B 分别 +55.37pp/+61.26pp |
| LongTutor 证据利用(27B) | Evidence Avg | 78.20% | Qwen3.8-27B 基线 36.80% | +41.40pp,仅次于 Claude-Opus-5 的 84.17% |
| LongTutor 教学质量(27B) | Teaching Avg | 3.02 | Claude-Opus-5 为 2.72、基线 2.74 | 所有评测模型最佳,含四个闭源前沿模型 |
| TutorBench(27B) | Overall | 59.42% | Qwen3.8-27B 基线 58.58% | +0.84pp,居第二(Kimi-K3 为 63.65%),纯文本子项最佳 |
局限与改进
作者承认的局限:LongTutor 上知识状态诊断准确率最高也只有 54.04%,说明基于长历史的学习者建模仍然困难;EDUMATH 与 EXAMS-V 上前沿闭源模型仍占优(Kimi-K3 分别为 90.00% 和 87.29%,OmniEdu-27B 为 86.95% 和 69.52%);MMMU-Pro 各学科变化不一致,通用能力保持并非全面无害。我的补充观察:其一,4B 模型在 GAOKAO-Bench 的语文从 90.89% 跌到 59.30%、历史从 93.12% 跌到 81.50%,小模型上存在明显的学科回退,说明同一数据配比对不同规模模型的影响并不一致;其二,教学能力主要靠 LLM 评审的胜率衡量,裁判偏好可能系统性偏袒某种支架风格,且论文未报告裁判与被评模型的家族关系;其三,评测去污染只针对作者自用的评测集,与 K12-KGraph、EDUMATH 等第三方基准(同时也是训练数据来源)之间的泄漏风险需要读者自行留意;其四,诊断推理数据仅占 7.8%,却是四能力中最稀缺、最依赖真实学生作答的环节,数据瓶颈明显。
独立分析的弱点
独立分析的弱点:第一,缺数据配比消融——45.5% 学科、13.4% 课程、7.8% 诊断、20.3% 支架的配比是设计出来的,论文没有做去掉某一能力或改变比例的对照实验,无法回答『哪类数据贡献了哪项提升』,改进方向是 leave-one-capability-out 消融与配比搜索。第二,审计与打分依赖 Qwen3.5-122B-A10B-FP8 和 GPT-5.6-Terra 等强模型,会引入评审模型自身的偏差与幻觉,且对 134 万条样本的审计成本不低,可探索规则+小模型的级联过滤降低成本。第三,多模态监督极薄(MathV360K 仅 122 条),而真实 K-12 场景大量依赖手写拍照与几何图形,EXAMS-V 图文题的收益可能主要来自基座而非数据。第四,方法止步于 SFT,没有针对教学法偏好的 RLHF/DPO 阶段,Scaffold 胜率距 Claude-Opus-5 的 87.89% 仍有约 9 个点差距。第五,跨语言能力不均,EXAMS-V 上 27B 中文子集 67.17%、英文子集仅 45.24%,教育数据的中英平衡需要专门处理。
未来方向
作者方向上,论文暗示会把能力分类法与数据管线延伸到更多学科、学段与模态,并继续用通用基准监控专业化的副作用。基于本文成果可自然延伸的研究包括:其一,为诊断推理与支架质量构建基于教学 rubric 的偏好优化(RLAIF/DPO),把胜率指标转化为可优化的奖励信号,逼近甚至超越闭源系统的教学表现;其二,把知识状态诊断与知识追踪模型结合,用显式的学习者状态表示替代纯隐式历史建模,突破 54% 左右的诊断准确率瓶颈;其三,做能力级数据消融与自动配比优化,把『数据构成作为设计轴』从主张变成可搜索的优化变量;其四,扩展多模态输入(手写识别、函数图像、实验装置照片)并接入课程知识图谱(如 K12-KGraph)做课程推理联合训练;其五,在真实课堂或大样本学生人群中做学习效果对照实验,弥补目前完全依赖基准评审的评估空白;其六,研究同一语料在不同模型规模上的最优配比漂移,解释并修复 4B 模型的语文/历史回退现象。
复现评估
复现条件在同类工作中属于非常好的一档。代码与数据管线开源在 GitHub(haolpku/Omni-Edu),训练集发布在 HuggingFace(Omni-Edu 数据集),4B/9B/27B 三个模型权重全部开放,审计 prompt、打分 rubric、来源与许可元数据随数据集一并保留。训练配置完整公开:LLaMA-Factory 全参数 SFT,学习率 $5\times10^{-6}$、cosine 调度、warmup 0.1、3 个 epoch、bf16、开启梯度检查点、DeepSpeed ZeRO-3、每卡 batch 1 配梯度累积 8、最大序列长 32768、不使用 packing。主要成本在两处:一是对 134 万条样本运行 Qwen3.5-122B 级审计和 GPT-5.6-Terra 级打分的推理开销,若无同级模型则难以逐条复现筛选结果(但可直接下载发布好的最终数据集绕过这一步);二是 27B 全参数微调需要多卡集群。总体属于中等难度:用官方数据集加公开超参复现三个 SFT 模型直接可行,完整复现数据清洗流水线则需要可观的 GPU 或 API 预算。
论文图表