StudentBench:AI 辅导与人类辅导 GRE 学习增益等效性评测平台 StudentBench: AI and human tutoring yield equivalent GRE learning gains
2383人随机对照实验证实AI辅导GRE提分与专家等效,最佳模型成本低至1/918
前置知识
学习增益(Learning Gain)与前测–后测设计
先让学生做一份前测,再施以教学干预,最后做一份覆盖相同知识点、难度匹配的后测,学习增益定义为后测得分减前测得分:$g_i = y_i - x_i$(按答对百分比计,未作答按错误计,与 GRE 计分一致)。本文用 27 题的 GRE 式试卷(Quant 47 分钟、Verbal 41 分钟)量化这一增量,并用协方差调整各组前测基线差异后比较增益。
整篇论文的核心因变量就是这个指标:『AI 辅导是否等效于人类辅导』即指两组 $g_i$ 的统计等效性,所有关键数字(AI 13.9 对真人 15.6 个百分点、p=.015)都建立在这个设计之上。
等效性检验(TOST,双单侧检验)
传统假设检验只能『拒绝无差异』,无法『证明无差异』。TOST(Two One-Sided Tests)反过来操作:先设定等效边界(如 $\pm 0.25$ 个合并标准差),若 AI−人类差值的 90% 置信区间完全落入边界内,即可宣称两者统计等效。本文合并比较的边界折算为 $\pm 4.09$ 个百分点,还额外报告了更严格的 $\pm 0.20$ SD 界。
论文标题中的 equivalent 是严格的统计结论(p=.015)而非修辞;不理解 TOST 就会把『差值 −0.58 pp、p=.015』误读成普通的显著性检验。
ANCOVA(协方差分析)与聚类稳健推断
比较各组后测成绩时,用回归把前测分数及其平方项、试卷形式、科目纳入模型:$y_i = \beta_0 + \beta_1 x_i + \beta_2 x_i^2 + \sum_k \tau_k \mathbf{1}(A_i{=}k) + \epsilon_i$,以对照组为参考,估计各条件在『同一前测水平』下的期望后测成绩,从而校正随机分组后仍存在的基线不平衡(本文真人组前测均值碰巧低约 5 个百分点)。等效性检验还用 CR2 协方差与 Satterthwaite 自由度处理共享真人导师、重复被试造成的聚类相关。
论文所有增益差值(如 AI−对照 +6.15 pp)都是调整后的估计;合并比较的有效自由度只有 1.59,直接源于聚类结构,是评估结论稳健性的关键。
Bradley–Terry 模型
处理成对比较数据的统计模型:对象 $a$ 被偏好于 $b$ 的概率为 $\mathrm{logit}^{-1}(\theta_a - \theta_b)$,通过大量『二选一』评审可反推每个对象的强度参数 $\theta$ 并形成排行榜。本文 51 位专家对 LLM 教案与练习题做了 2,028 次盲评(平局剔除、强偏好权重为 2),用该模型拟合出备课(9,577 条评分)与练习设计(5,265 条)两个排行榜。
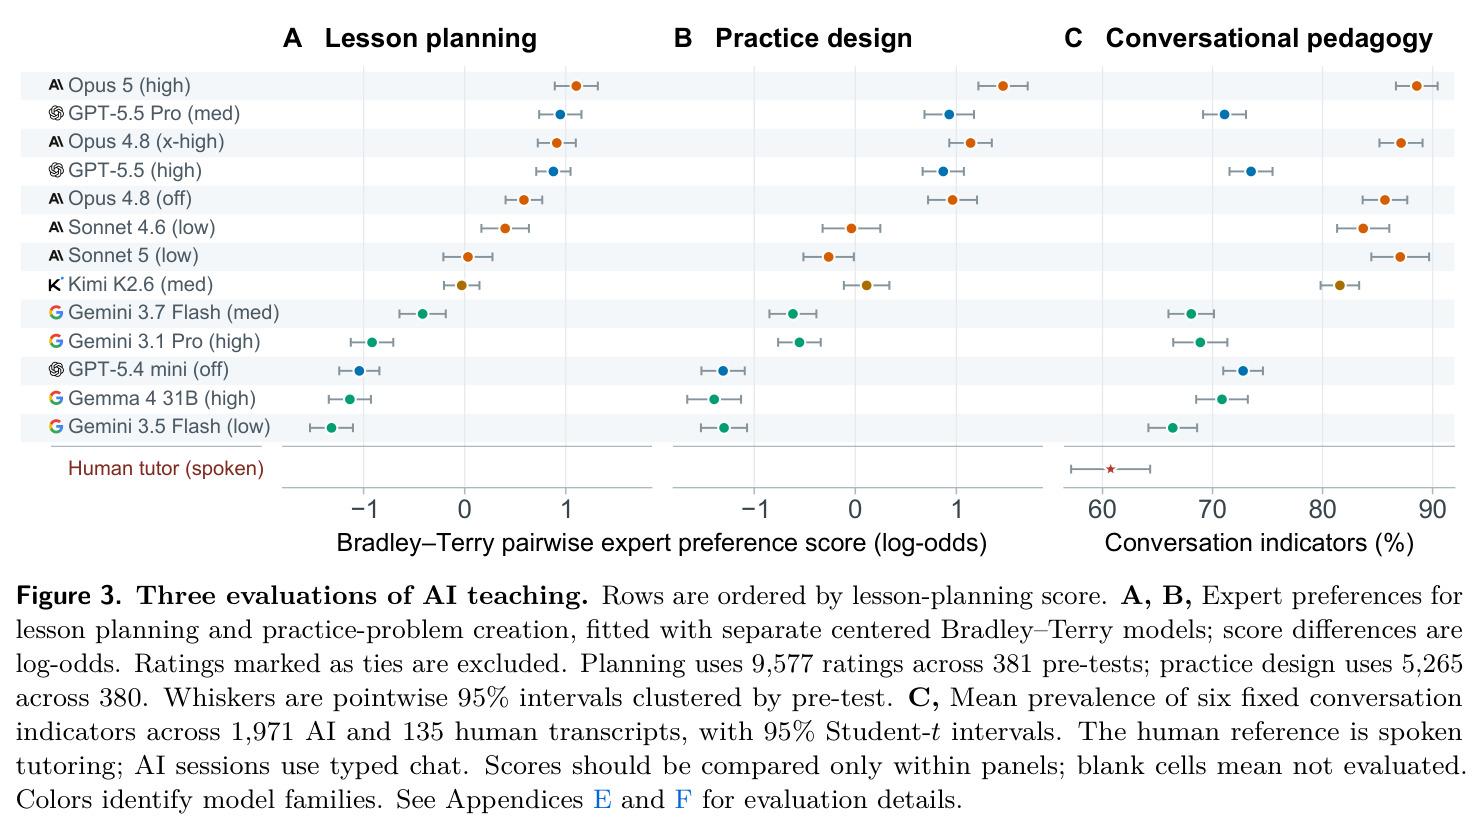
图 3A/3B 的分数就是 log-odds 尺度的 $\theta$ 差值;它是理解『Anthropic 模型在教学材料质量上被专家偏好』这一结论的统计基础。
Bloom 的『两个标准差问题』(Two-Sigma Problem)
教育心理学家 Bloom 在 1984 年发现:接受一对一辅导的学生成绩平均比传统课堂学生高约两个标准差,但一对一辅导成本高昂、无法规模化。如何把一对一辅导的效果以可负担的方式普及,是教育技术领域最著名的难题之一,催生了此后的智能辅导系统研究。
这是本文动机的理论起点:如果 LLM 辅导真能达到人类专家等效且便宜 918 倍,就等于给 two-sigma 问题提供了一个工程解,论文的成本-增益分析正是围绕这一点展开。
Pareto 前沿(Pareto Frontier)
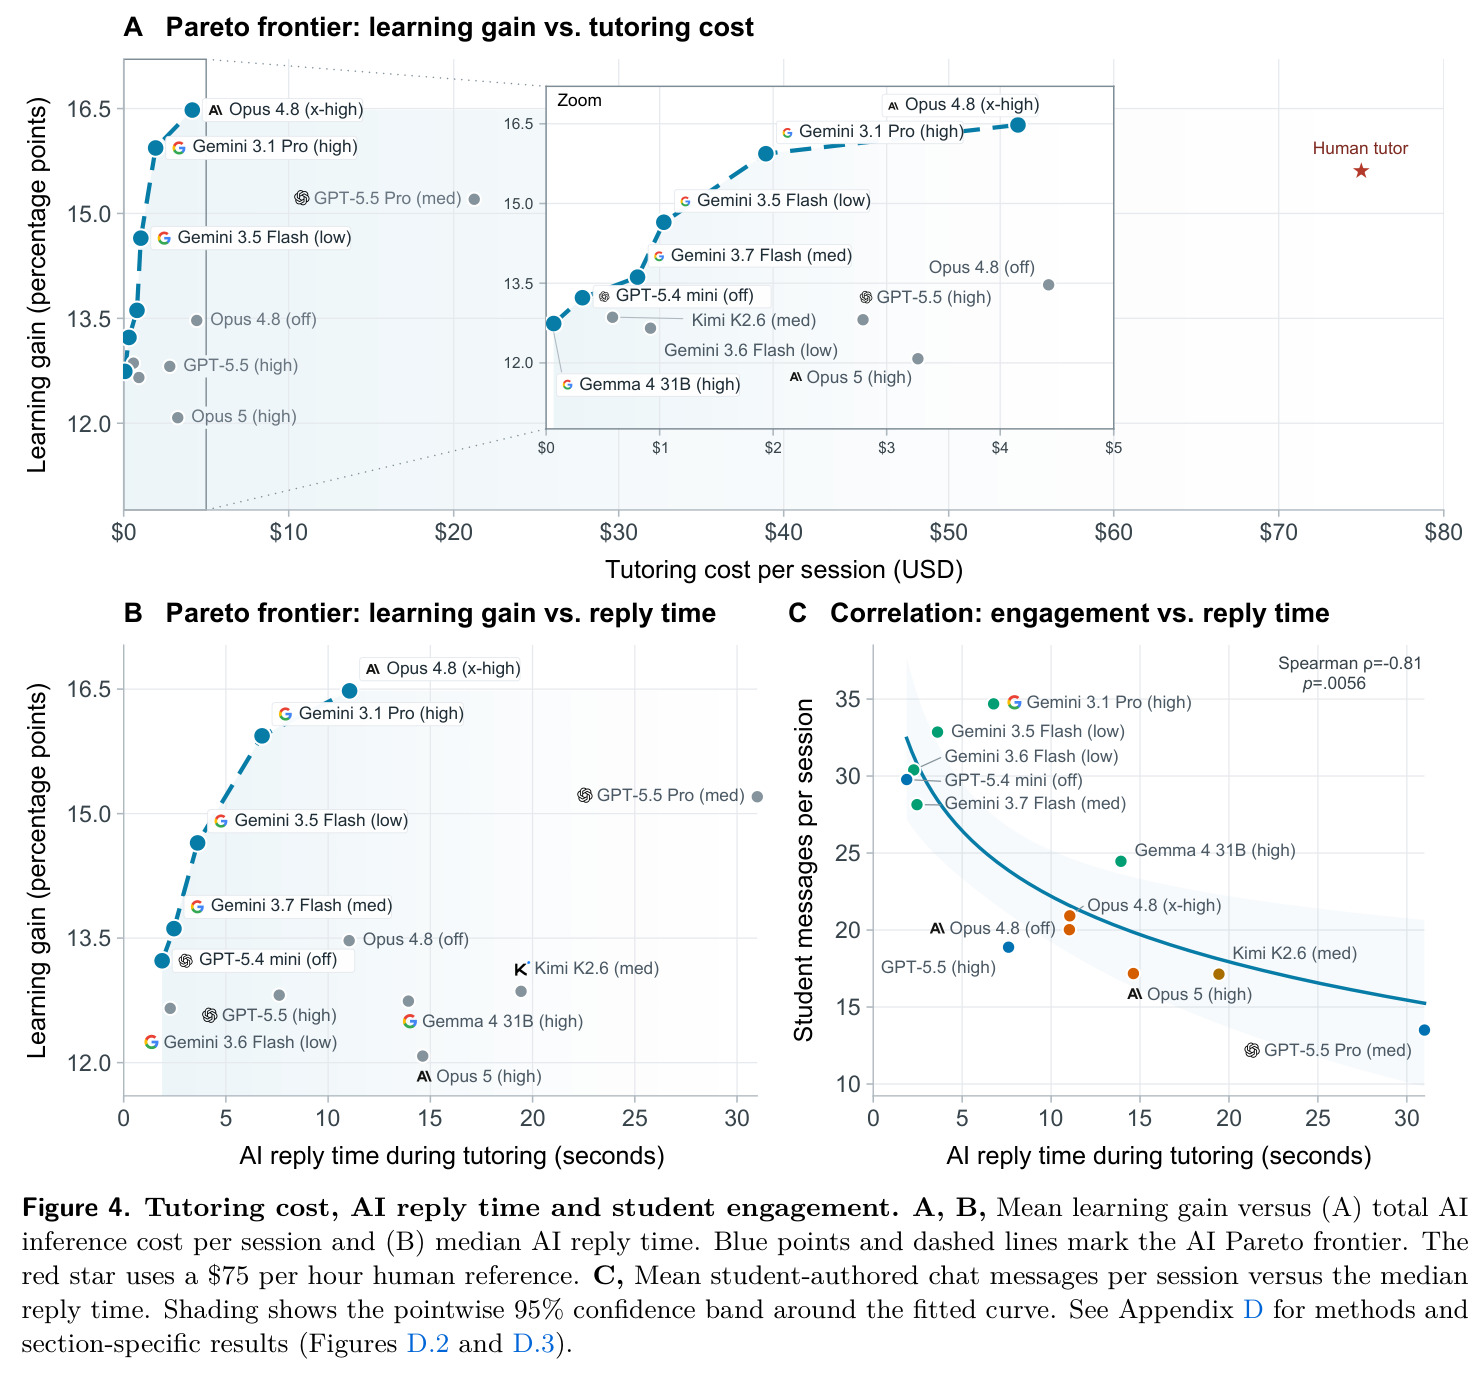
多目标优化概念:一个解处于前沿,当且仅当不存在另一个解在所有目标上不劣于它、且至少一个目标严格更优。本文在『学习增益–推理成本–回复延迟』三个维度为 12 个 AI 导师划定前沿,例如 Gemini 3.1 Pro 在增益、成本、延迟上全面优于 GPT-5.5 Pro,后者即被严格 Pareto 支配。
图 4 的核心信息就是成本与延迟两幅 Pareto 前沿图,它把『该用哪个模型做导师』从单一排行榜问题变成多维工程权衡问题。
研究动机
前沿 AI 研究的评测几乎都围绕模型自身能力(答题、代码、推理基准),极少衡量『模型能把人类提升多少』。教育侧,Bloom 的 two-sigma 问题指出一对一辅导收益巨大却因成本无法普及——真人 GRE 辅导市场价约 $75/小时。已有 AI 教育研究存在明显缺口:Kestin 等的物理辅导依赖高度结构化的专用系统,Wang 等研究的是辅助真人导师的工具,LearnLM 研究受导师监督的模型,而 TutorBench 和 INSIDE 分别依赖 LLM 裁判和模拟学生,没有一项在大规模真实学生、无辅助后测、与直播真人导师对比的设置下检验过自主通用 LLM 的教学效果。更棘手的是,Bastani 等发现无防护的 AI 帮助虽提升练习表现、却在随后的无辅助测试中降低成绩——AI 陪练可能制造『能力幻觉』。因此,AI 到底能不能真教会学生,缺乏可信的因果证据。
本文的目标是本文要构建 StudentBench——一套 AI 教学评测与公开数据收集平台(累计收集超 17.5 万条学生-AI 消息),并用它回答三个问题。第一,经一小时辅导,LLM 导师能否产生与专家真人辅导统计等效的 GRE 学习增益(是严格等效,而非仅仅『不显著更差』);第二,教学能力能否拆解为可比较的维度——备课、练习题设计、对话教学法——并形成足以区分模型的排行榜;第三,把成本与延迟纳入评测,提出『每提升 1 个百分点学习增益的美元成本』这一标准化单位,衡量 AI 辅导能否把个性化教学民主化。在作者提出的『递归人类自我改进(RHSI)』框架下,这构成其三条件中的第一条:技术确实能提升人类能力。
与已有工作不同的是,本文的独特切入有四点。其一,最小脚手架哲学:每个 AI 导师只用两条低指导提示词(备课+互动辅导),且不为任何模型调优提示,刻意测量『模型自身的教学能力』而非作者的提示工程或软件设计能力。其二,反污染测量设计:试卷由前 ETS/Kaplan 命题人全新撰写(旧 GRE 题可能已在 LLM 训练集中),并用 P→Q 与 Q→P 交叉平衡消除试卷难度差被误认为学习增益的风险。其三,统计与系统视角:用 TOST 正面证明『等效』而非只证『不差于』;把推理延迟当作一等公民指标,因为作者发现延迟经由学生参与度间接影响学习增益。其四,理论包装:把 AI 辅导实验嵌入 RHSI 议程,与 AI 的递归自我改进(RSI)形成对偶,主张衡量 AI 的标准应是其对人类智能的增益。
核心方法
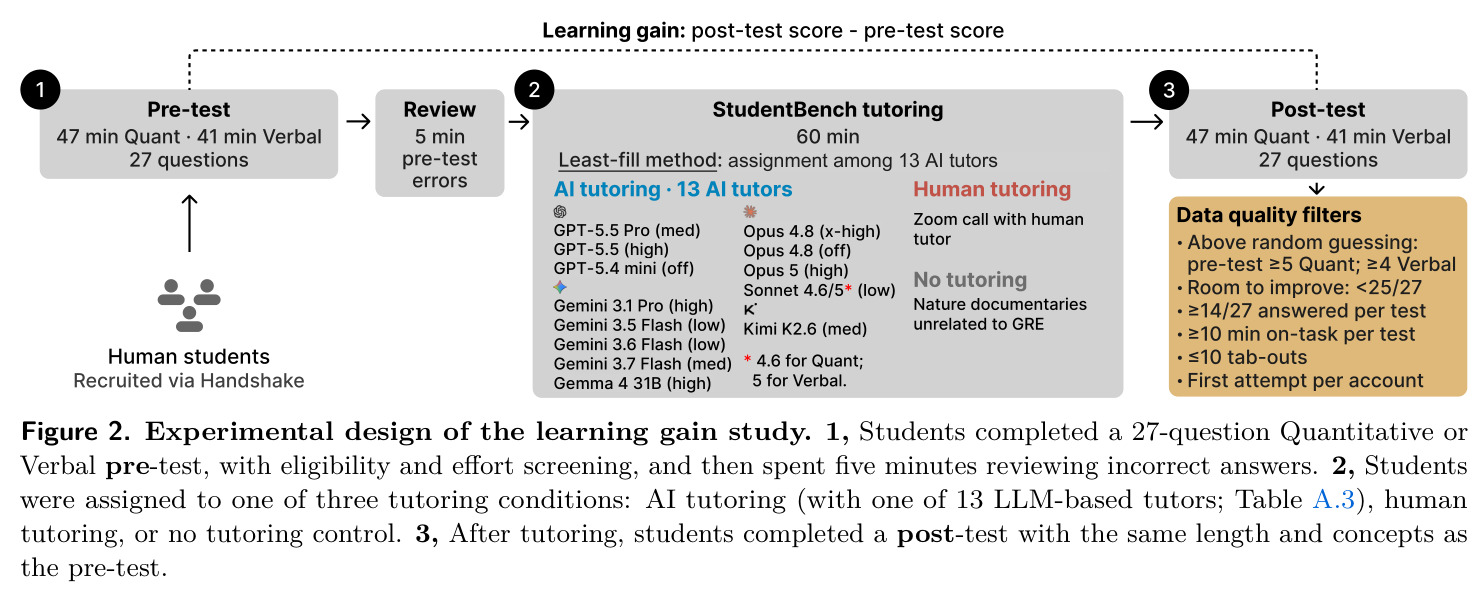
论文包含两项研究加一套机制分析。研究一(学习增益):通过 Handshake 平台随机邀请约 7 万名学生(完成酬劳 $50),2,383 名 18–67 岁(中位 21 岁)成人进入分析。流程为:27 题前测(Quant 47 分钟 / Verbal 41 分钟)→ 5 分钟订正错题 → 1 小时随机分配的干预(13 个 LLM 导师之一、真人导师 Zoom 一对一、或观看与 GRE 无关的自然纪录片作对照)→ 同长度同知识点后测。真人导师为每科 9 名前 ETS/Kaplan 员工或 5 年以上经验者;AI 导师收到学生完整前测记录但从未接触后测。经数据质量过滤(剔除低努力、快速提交、低于随机猜测、频繁切页等)后共 2,469 个 session。统计上用 ANCOVA 调整前测分、试卷形式与科目,TOST 检验等效性($\pm 0.25$ 合并 SD 界)。研究二(专家评审):51 位专家导师基于 381 份学生前测,对两两配对的 LLM 教案与练习题做了 2,028 次盲评(8 条标准),用 Bradley–Terry 模型生成排行榜。
核心创新是把『教学能力』变成模型的一等评测维度,且测的是真实学生在无辅助考试上的成绩增量,而非模型答题准确率或 LLM 裁判评分。三个设计决定体现这一点:(1) 最小脚手架——备课提示词只要求输出一份 JSON 教案(概念排序、时间分配、带解析的练习题),互动提示词只附学生前测记录,不给难度或技能标签,让模型自行诊断;(2) 等效性检验——用 $\pm 0.25$ 合并标准差边界内的 TOST 正面确立 AI 与人类等效;(3) 成本标准化——提出 $\bar{c}_i / \bar{g}_i$(平均会话推理成本除以平均学习增益)作为跨导师、并与人类参考价($75/小时)可比的统一单位。再叠加『延迟是一等公民』的视角:作者发现回复延迟→学生参与度→答对练习量→学习增益的关联链条,这解释了为何教学法排行榜接近垫底的廉价模型(Gemma 4 31B)也能达到与人类等效的增益。
方法步骤详情
第一步,命题:前 ETS/Kaplan 命题人创作 P、Q 两套新卷(各 27 题、七个领域),独立审核难度,并逐一配对前后测同难度、同题型、同子主题的题目。第二步,招募与筛选:Handshake 随机邀请约 7 万人(酬劳 $50),要求首次参加、前测答对 5–24 题(Quant)/ 4–24 题(Verbal)、至少 14 题非空、在题至少 10 分钟、切页不超 10 次。第三步,前测与 5 分钟订正。第四步,随机分组:AI 组按 least-fill 在 13 个导师间均衡分配且学生不知分到哪个模型;真人组 Zoom 一对一;对照组看纪录片。第五步,AI 辅导:备课请求输入完整前测记录(题目、学生答案、正确答案、用时),输出含概念优先级与练习题的 JSON 教案;随后一小时互动教学,提示词禁止猜测后测以防 reward hacking。第六步,后测与数据清洗,剩 2,469 个 session。第七步,统计与评测:ANCOVA+HC3、CR2+Satterthwaite 自由度的 TOST;专家评审用 Bradley–Terry;对话用 6 条确定性规则评分;成本按 96.7% 覆盖率的 API 计费记录核算。
技术新颖性
相对已有工作的技术新颖性:(1) 规模与对象——首个 2,383 人、13 个自主通用 LLM 导师对直播真人导师、以无辅助后测为终点的随机对照研究;TutorBench 用 LLM 裁判评专家编写的学生人设对话,INSIDE 模拟学生代码提交,均无真实学习结果作为终点。(2) 反污染命题——全新撰写试题加 P→Q / Q→P 交叉平衡,直接回应 LLM 训练数据渗漏对评测效度的威胁。(3) 成本维度——918× 的成本比与成本-增益 Pareto 前沿在教育 AI 评测中罕见,把『教育民主化』从口号变成可度量、可比较的指标。(4) 延迟链条——首次把推理延迟、学生参与度、练习正确量与学习增益连成经 Holm 校正的关联链(均 p<.002),为『为何小模型也能教得好』提供机制假说,也说明静态能力榜与真实教学效果可能脱节。(5) 理论框架——RHSI 把教育 AI 与智能增强(IA)议程连接,主张 AI 与人类能力可以互惠地递归提升。
实验结果
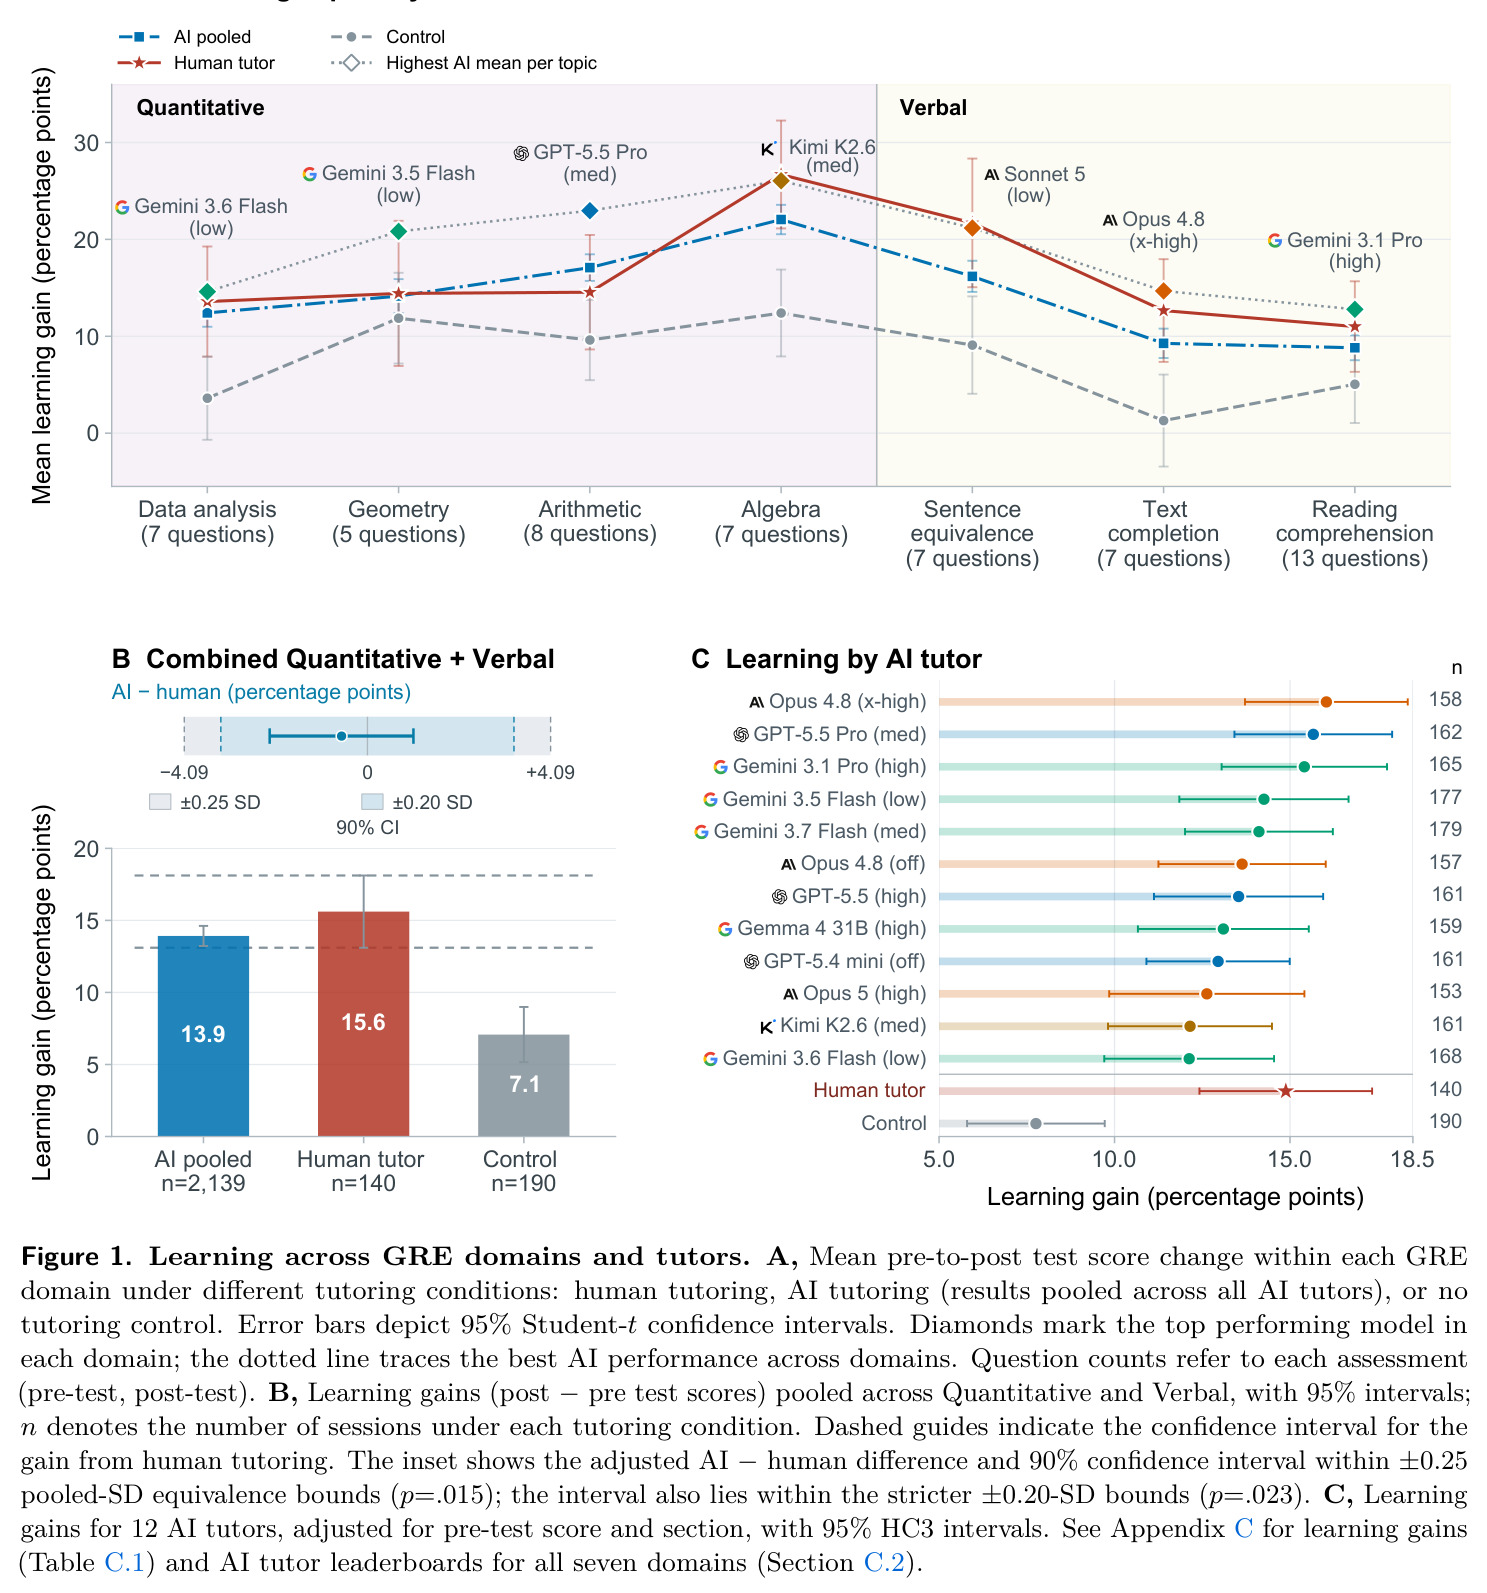
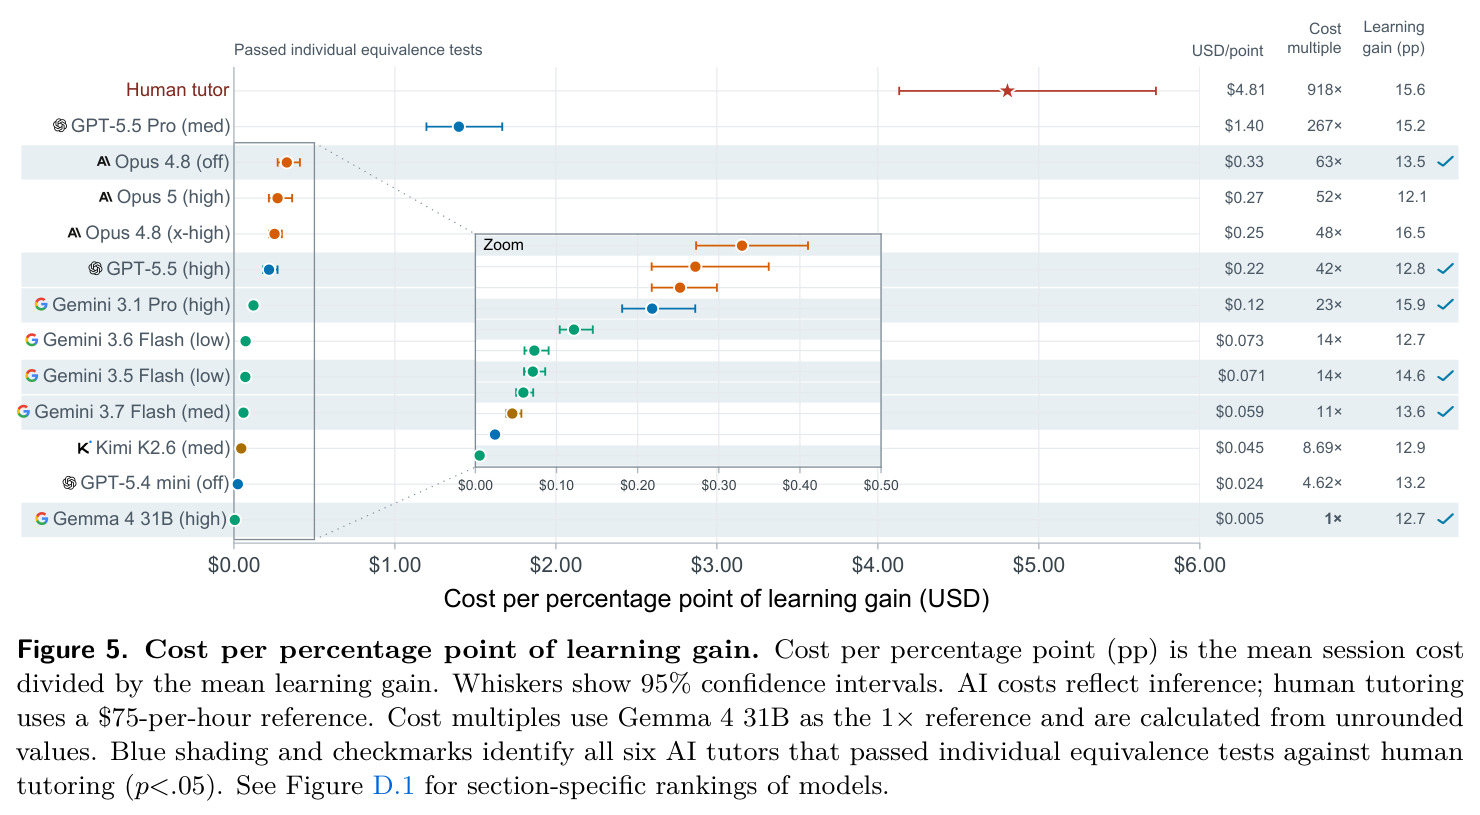
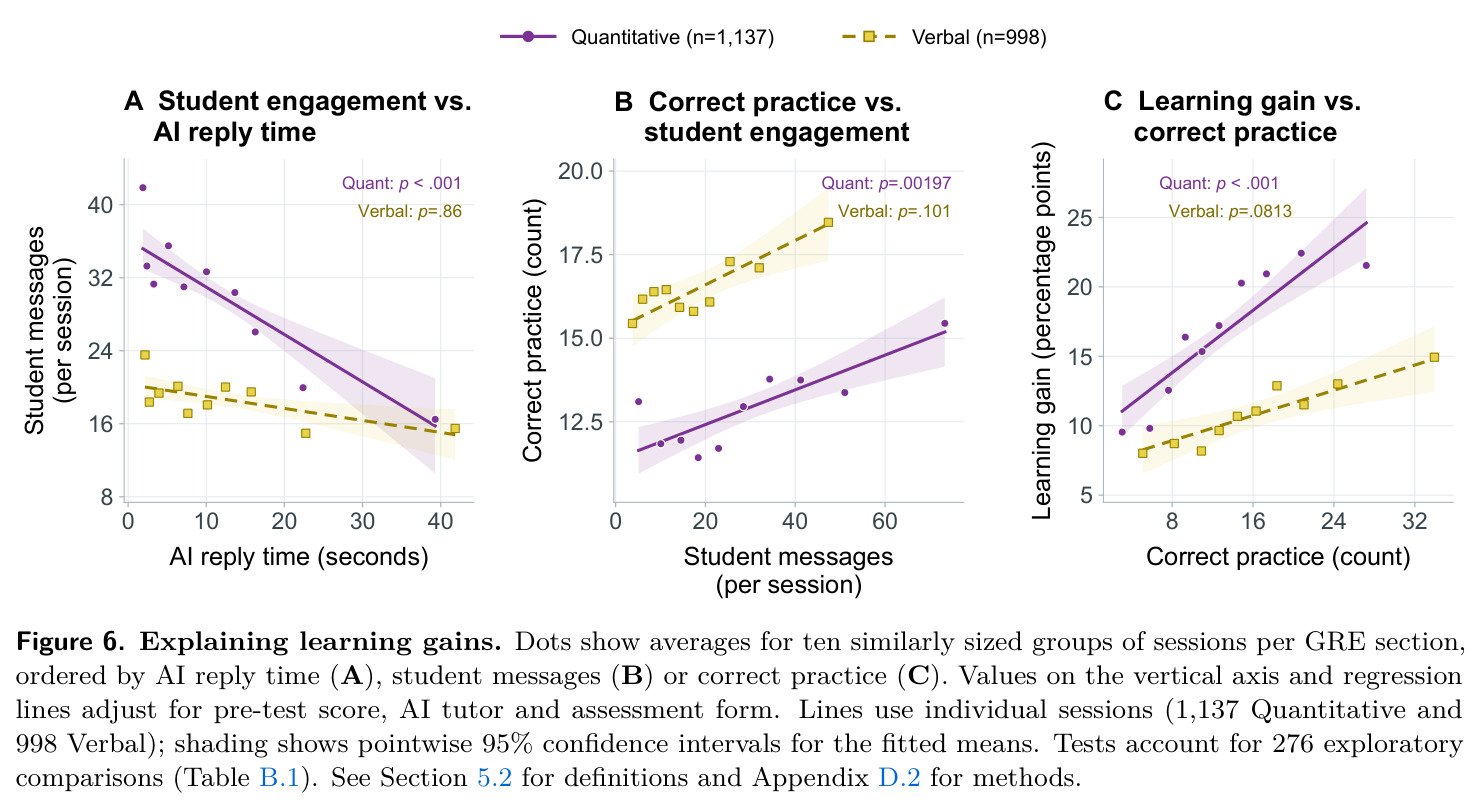
研究一(n=2,469):合并两科后 AI pooled 与真人辅导统计等效——调整后差值 −0.58 pp(90% CI [−2.18, 1.03]),TOST p=.015(±0.25 SD 界即 ±4.09 pp),更严 ±0.20 SD 界下亦成立(p=.023)。原始平均增益 AI 13.9、真人 15.6、对照 5.0 pp;相对对照,AI +6.15 pp、真人 +7.04 pp(均 p<.001),约合多答对 1.5–2 题。7 个 GRE 子领域中 5 个的最佳 AI 超过真人(Quant 四域占三),Verbal 整段仍以真人最高。12 个 AI 导师间差异不显著(p=.755),最高 Opus 4.8 (x-high) 16.0 pp,真人 14.9、对照 7.8。六个 AI 导师通过单独等效检验,其中 Gemma 4 31B(12.7 pp,p=.044)每百分点成本 $0.0052 对真人 $4.81,便宜 918 倍;会话推理成本跨 $0.067–$21.24。研究二:51 位专家完成 2,028 次两两盲评,Anthropic 系在三个教学榜均领先;五榜 53/55(96.4%)模型对区间不重叠,对话行为按厂商家族聚类。机制链(Quant,n=1,137):回复每慢 10 秒消息少 5.19 条、每多 10 条消息正确练习多 0.52 题、每多 10 题增益多 5.62 pp(均 p<.002),Verbal 均不显著。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GRE 合并学习增益:AI pooled 对真人辅导 | 调整后 AI−人类差值(百分点,90% CI)与 TOST 等效性 | −0.58 pp [−2.18, 1.03],p=.015(±0.25 SD 界);±0.20 SD 界下 p=.023;原始均值 AI 13.9 pp 对真人 15.6 pp | 专家真人辅导(140 个 session,调整后较对照 +7.04 pp) | 统计等效(整条置信区间落入 ±4.09 pp 边界内),无显著差异 |
| GRE 合并学习增益:AI 辅导对无辅导对照 | 调整后增益差(百分点,95% HC3 CI) | +6.15 pp [4.08, 8.21](Quant +6.86 [4.02, 9.69];Verbal +5.47 [2.46, 8.47]) | 无辅导对照(仅 5 分钟订正前测 + 观看无关教育视频,增益 7.8 pp) | 约多答对 1.5–2 题(27 题制),p<.001 |
| 每百分点学习增益的成本 | USD/pp(会话平均推理成本 ÷ 平均学习增益) | Gemma 4 31B $0.005/pp(会话成本 $0.067,p=.044 通过等效检验);12 个 AI 导师区间 $0.024–$1.40/pp | 真人辅导 $4.81/pp($75/小时市场参考价) | 918× 成本优势(Gemma 4 31B);GPT-5.5 Pro 亦达 267× |
| AI 回复延迟与学生参与度的关联 | Spearman ρ(12 个 AI 导师,导师级) | ρ=−0.81,p=.0056(回复时间从 1.9s 的 GPT-5.4 mini 到 31.0s 的 GPT-5.5 Pro);Quant 中每慢 10 秒每 session 少 5.19 条学生消息(p<.001) | 无(首次建立的观察性关联,无外部基线) | 不适用——贡献在于首次把延迟接入『参与度→练习→增益』链条 |
| AI 教学能力专家两两评审(备课与练习设计) | Bradley–Terry 成对偏好分数(log-odds) | Opus 5 (high)、GPT-5.5 Pro (med)、Opus 4.8 (x-high) 位居前列;Anthropic 系在三个教学排行榜全部领先 | 13 个 AI 导师互比,另有真人(口语辅导)作为教学法参照 | 五排行榜上 53/55(96.4%)模型对置信区间不重叠,区分度极强 |
局限与改进
作者承认的局限:只测即时增益、未追踪数月后的保留(纵向研究招募与随访成本高,且模型迭代太快会使结果过时);被试全为能读写英语的成人 Handshake 用户(中位 21 岁,83.3% 为 18–24 岁);三个教学排行榜基于专家评审与对话行为而非学习量本身;缺少『自主刷题』对照条件,无法分离与 AI 互动相对自己练习的净增益。我补充的观察:真人臂很小(140 个 session、每科 9 名导师、最大聚类含 102/140 个 session),合并比较的有效自由度仅 1.59,附录 B.3 显示若去掉前测调整、仅按增益分组聚类,则两科均无法建立等效——即 Quant 等效结论依赖模型设定;个体导师等效检验未做跨导师多重校正;pooled 层面 Verbal 等效未达成(p=.085),真人保有 Verbal 优势;6 条教学法规则未经效度验证;学生的『我不同意此答案』按钮只记录异议而非核实错误;AI 为打字聊天而真人为口语视频,模态不对等;$75/小时的参考价有任意性。
独立分析的弱点
(1) 真人臂统计功效不足:140 个 session、7 个连接聚类、df=1.59 使置信区间偏宽,等效结论对小样本近似敏感;改进方向是扩大真人臂或采用被试内交叉设计。(2) 单次一小时 session 无法回答保留与迁移:增益可能一周内消退,改进是加入 1 周/1 月延迟后测。(3) Verbal 未达等效:AI 在文本填空、句子等价、阅读理解上仍落后真人,改进是设计证据定位、苏格拉底式提问等针对性脚手架或专门微调。(4) 排行榜与学习脱节:Gemma 4 31B 的专家评分与教学法指标接近垫底却增益等效,说明五个排行榜测的未必是『教学有效性』,改进是以学习增益为外部效标重新验证并加权教学指标。(5) 延迟链条是观察性的:模型质量与延迟高度相关、混杂无法排除,改进是对同一模型随机注入 0–30 秒延迟做因果 A/B 实验。(6) 结论时效性强:模型价格与能力月度剧变(论文自述 Gemini Flash 的 Terminal-Bench 从 76% 升至 89%、token 价格腰斩),任何静态榜单都会过期。(7) 人群同质:结论外推到 K-12、非英语学习者、在职成年人存疑。每个弱点都对应一个可执行的后续实验。
未来方向
作者明确提出的方向:纵向保留研究(检验 AI 辅导后数月的成绩保持与迁移);把评测范式推广到 SAT、MCAT 等其他标准化考试;跨语言、跨设备、跨教育环境的部署测试;验证教学法指标与实际学习的因果关系。基于本文成果可自然延伸的:(1) 语音模式 AI 导师实验,弥合打字与口语辅导的模态差(作者已注明现评测基于打字聊天);(2) 把延迟-参与度-练习-增益链条升级为因果干预研究;(3) 利用 IRT 能力估计做导师-学生匹配——论文已发现 Gemini 系模型对前 25% 高能力学生的增益最高,值得系统化;(4) 成本-质量前沿的在线路由:按预算动态把学生分配到最便宜的『等效合格』导师;(5) 在公开平台上建立持续更新的教学能力榜,纳入尚未评测的 GPT-6 Astra、Claude Fable 5.1、Grok 4.6、Gemini 3.8 Flash 等新模型;(6) 检验 RHSI 的第二、第三条件——善用 AI 者是否学得更好、学得更好者是否更善用 AI,从而完成『递归人类自我改进』的完整论证。
复现评估
开源情况良好:数据在 HuggingFace(handshake-ai-research/studentbench),复现全部图表的代码在 GitHub,平台 studentbench.org 对公众开放;成本方法透明——164,237 次 API 请求中 96.7% 有计费或用量记录,缓存折扣等重构假设随数据发布;研究获 BRANY SBER IRB 批准(26-206-2643),公开数据匿名化且不含音视频。复现瓶颈不在算力(AI 推理每 session 仅 $0.067–$21.24,Gemma 4 31B 全程不足 7 美分)而在人力与招募:需约 7 万人邀请规模、$50/被试酬劳、前 ETS/Kaplan 命题人撰题、每科 9 名资深真人导师及 51 位评审专家。统计管线(ANCOVA/TOST/CR2/Bradley–Terry/Holm)在附录 B、D、E 中文档详尽。总体评估:跑通代码与提示词容易;完整复刻研究难度中上、需机构与预算支持;在新模型上增量复用平台(让新模型上榜)成本很低,这正是平台化设计的价值。
论文图表
列出各条件的前测均值与标准差及 P→Q / Q→P 试卷顺序的会话数:Quant 中 AI 1,139 个 session(前测 50.21)、真人 61(45.17)、对照 91(52.99);Verbal 中 AI 1,000(46.35)、真人 79(41.44)、对照 99(47.29)。
它披露了一个关键事实:真人组前测均值在两科都碰巧低约 4–5 个百分点(随机分组下偶然发生),这正是所有比较必须用 ANCOVA 调整前测分的原因,也是理解结论不偏袒 AI 的重要证据。
列出 13 个 AI 导师(12 个模型,Opus 4.8 在 off 与 x-high 两个推理档各测一次;Sonnet 在 Quant 用 4.6、Verbal 用 5):模型名、API 端点(如 gemini-3.1-pro-preview、gpt-5.5-pro、claude-opus-5、gemma-4-31b-it、moonshotai/kimi-k2.6)及各科样本量(每格约 71–97)。
它定义了『AI 导师』这一自变量的精确含义——模型加推理配置的组合,并给出样本量分布,是复现研究和解读排行榜时映射模型名称的必备对照表。
六行对照表:AI−对照在 Quant 为 +6.86 pp [4.02, 9.69]、Verbal +5.47 [2.46, 8.47]、合并 +6.15 [4.08, 8.21],均 p<.001;真人−对照在 Quant +6.27 [1.72, 10.82](p=.0069)、Verbal +7.52 [3.17, 11.87]、合并 +7.04 [3.88, 10.20]。
它把『等效于真人』放到绝对标尺上:两种辅导都比对照高约 6–7.5 个百分点(约 1.5–2 题),说明等效不是『两者都无效』的平庸结论,而是两种干预都真实有效的强声明。
12 个 AI 导师合并两科的调整后学习增益及 95% HC3 区间与样本量:Opus 4.8 (x-high) 16.0 [13.7, 18.4]、GPT-5.5 Pro 15.7、Gemini 3.1 Pro 15.4、Gemini 3.5 Flash 14.3、Gemini 3.7 Flash 14.1、Opus 4.8 (off) 13.6、GPT-5.5 13.5、Gemma 4 31B 13.1、GPT-5.4 mini 13.0、Opus 5 12.6、Kimi K2.6 12.2、Gemini 3.6 Flash 12.1;真人 14.9 [12.4, 17.3]、对照 7.8 [5.8, 9.7]。
这是模型排名的权威数字表:区间大量重叠(导师间总体差异 p=.755),说明不能简单宣称某个模型『最能教』,但能看出最便宜的 Gemma 4 31B(12.7 pp 原始均值)与最贵的 GPT-5.5 Pro 差距很小。
图 6 三条关联链的精确系数表(β 为每 10 秒/10 条消息/10 题的效应量,95% HC3 区间与 Holm 校正 p 值):Quant 中回复时间→学生消息 β=−5.19 [−7.09, −3.29](p<.001)、消息→正确练习 0.52 [0.29, 0.75](p=.00197)、正确练习→增益 5.62 [3.97, 7.26](p<.001);Combined 三条均显著(−3.46、0.53、3.82);Verbal 三条均不显著(p=.86/.101/.0813)。
它是延迟-参与-练习-增益机制的完整证据表,把 Figure 6 的图形信息落到可引用的系数与区间,并清晰展示该链条的学科不对称性(仅 Quant 显著)。
专家盲评使用的八条标准:A 概念相关性(针对前测错误选概念)、B 概念分组(相关主题一起教)、C 概念优先级(高影响概念先教)、D 时间分配(按错误、难度与收益分配)、E 练习对齐(匹配学生错误与水平)、F 难度适当、G 示例准确性(题目、解析与答案正确)、H 应试策略(应对 GRE 题型与时间压力);A–D+H 归入备课榜(图 3A),E–G 归入练习设计榜(图 3B)。
它定义了『教学材料质量』的测量工具:没有这八条标准,Bradley–Terry 排行榜就无从谈起;也展示了作者如何把模糊的『教得好』拆成可评审的维度。
六条对话教学法指标的确定性检测规则:脚索信号(导师回复回指学生消息含至少两个实义词并带引导语)、要求解释(至少一个提问要求给出理由或解释)、互动提问(至少四条导师消息含问号或邀请回应)、早期尝试请求(前五条导师消息中至少一条请学生先试做)、回复后长解答(学生发言后出现至少 140 词的含解答线索的消息)、推理检查(至少两个提问含检查推理或策略的线索)。
对话教学法排行榜完全由这些规则驱动;规则透明、可复现,但作者也坦承未验证其与学习增益的关系——这是解读图 3C 时必须知道的效度边界。
326 个 session 的提示词试点:五种备课/辅导提示词组合下的平均增益——最小/最小 14.27 pp(81 session)、最小/扩展 12.06、中间/中间 10.19、扩展/最小 11.71、扩展/扩展 8.85(54 session);对三个模型分别看,最小提示词均更高。但后续非同期的 Opus 5 与 Gemini 3.6 Flash 队列中扩展提示词反而高出 3.61 与 4.62 pp(均不显著)。
它披露了主研究为何选择低指导提示词的证据与不确定性,是评估『最小脚手架』设计决策是否偏向某些模型的关键敏感性材料,也提示提示词效应本身不可忽略。