神经谱容量:仅凭网络规格度量与设计架构 Neural Spectral Capacity: Measuring and Designing Architectures from Network Specification Alone
从权重矩阵谱容量导出闭式架构评分,动态规划秒级完成架构搜索与LLM剪枝
前置知识
Marchenko–Pastur 律
随机矩阵理论的核心定理:当矩阵 $W\in\mathbb{R}^{m\times n}$ 的元素独立同分布、均值为零、方差为 $s^2$ 时,其归一化奇异值平方的经验分布在维度趋于无穷时收敛到一个确定极限分布 $f_{\mathrm{MP}}(\lambda;\gamma)$,其中 $\gamma=\min(m,n)/\max(m,n)$。因此无需真正实例化矩阵、无需做 SVD,就能从维度和方差解析地算出谱相关量的期望。
本文正是利用这一定律,把“需要 SVD 的谱容量”变成仅依赖 $(m,n,s)$ 的闭式表达式,是 NSC 能“只看规格、不碰网络”的数学基石。
训练无关代理(training-free proxy)
NAS 中一类在初始化阶段就给架构打分的指标,如 SNIP、SynFlow、NASWOT、W-PCA、ZeroLM,无需训练即可预测训练后性能。但它们都要实例化随机初始化网络,在采样输入上做前向/反向传播测激活、梯度或注意力,得分还依赖 (架构, 输入) 的具体选择。
NSC 的定位就是替代这类代理,论文全部实验以它们为基线;理解其成本结构(实例化+前向)才能体会 NSC 在速度与可优化性上的优势。
信道容量与互信息
信息论中把权重矩阵 $W$ 视作线性高斯信道 $y=Wx+z$,互信息 $I(x;y)=\frac{1}{2}\ln\det(I+W^\top W)=\frac{1}{2}\sum_i\ln(1+\sigma_i^2)$,$\sigma_i$ 为奇异值。它衡量该矩阵最多能传输多少信息,由完整奇异值谱决定而非参数量决定。
NSC 把单矩阵谱容量定义为去掉常数因子的对数行列式,这是“容量”一词的来源,也解释了为何秩-1 截断会让 LLaMA FFN 矩阵的 $\psi$ 从约 3174 跌到 2.5。
多重选择背包与动态规划
背包问题指在总成本不超过预算 $B$ 的约束下,从每组互斥选项中各选一项,最大化价值之和。当价值与成本都可按层分解时,动态规划可精确求解全局最优,且 DP 表格顺带给出所有 $b\le B$ 预算下的最优解。
NSC 逐层可加的结构使架构搜索恰好化归为该问题,得到 NSC-DP:CPU 上秒级返回代理目标下的全局最优架构,这是黑盒进化搜索原理上给不了的保证。
结构化剪枝
从预训练大模型中按结构单元(注意力头、FFN 中间维、LoRA 秩等)删除组件以满足部署预算。现有方法如 LLM-Pruner、Sheared LLaMA、SparseGPT、Wanda 都依赖预训练权重与校准数据来计算重要性分数。
论文 4.3 节把 NSC-DP 用于 LLaMA-7B 的 LoNAS 超网剪枝,展示“既不需要权重也不需要校准数据”的差异化卖点,是该方法的 LLM 规模落地场景。
研究动机
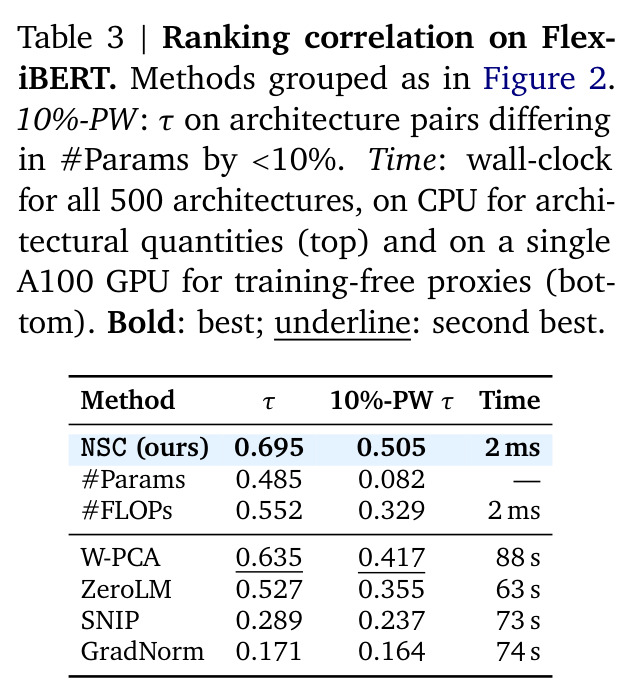
Transformer 设计与压缩本质上都是在预算下分配容量:预训练时要决定深度-宽度取舍、FFN 比例、注意力头共享(GQA/MQA)、MoE 逐层专家分配;后训练时结构化剪枝要反向决定保留哪些组件。从业者手头的标准度量只有 #Params 与 #FLOPs,它们分别刻画规模和计算量,对结构完全失明——参数预算相同的两个架构,无论深度-宽度、头数、FFN 配置差别多大,得分完全一样,训练后表现却差异显著。训练无关代理虽能区分架构,却有两个硬伤:其一,每次评估都要实例化随机初始化网络并在采样输入上前向/反向传播(W-PCA 在 FlexiBERT 上评 500 个架构需 88 秒 GPU),LLM 规模下实例化代价更高;其二,它们是整个网络的黑盒标量函数,约束优化只能靠进化或随机搜索返回“访问过的最好架构”,而非预算下可能取得的最好架构。
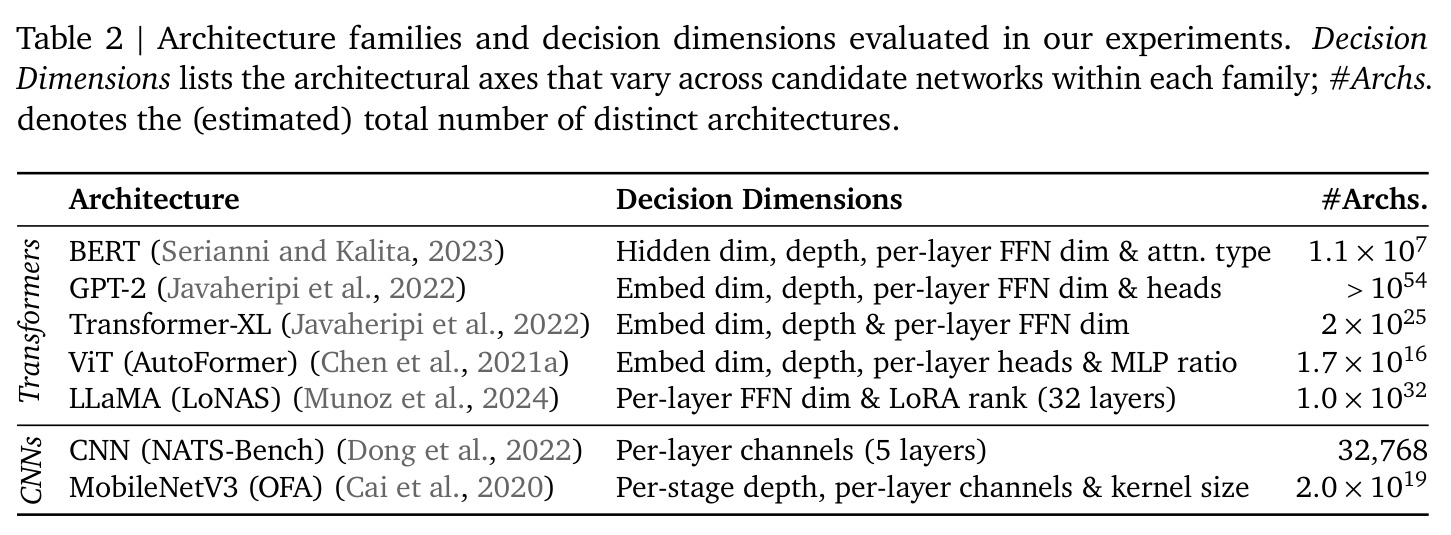
本文的目标是本文要构造一个像 #Params、#FLOPs 一样“输入规格、输出数字”的架构标量 NSC:确定性、无需实例化模型、无需输入数据、无需梯度、无学习超参数,但能感知尺寸与计算量看不见的结构信息(深度、头分配、FFN 比例)。更进一步,希望该标量具备逐层可加的代数结构,使资源约束下的最大化可以精确求解而非启发式采样——由此得到 NSC-DP 动态规划求解器,并在排序(七个 Transformer 与 CNN 架构族)、设计(Transformer-XL、AutoFormer)、压缩(LLaMA-7B 结构化剪枝至 5.7B)三个场景做端到端验证。
与已有工作不同的是,随机矩阵理论的已有工作都把 Marchenko–Pastur 律当作零模型或噪声判据:Martin & Mahoney 读训练后权重谱偏离 MP 律的重尾来诊断训练质量,但在 NSC 所处的初始化阶段该诊断按构造退化;Berlyand 等把 MP bulk 内的奇异值当噪声剪掉,恰好在初始化时把全部谱都判为噪声。NSC 的独特翻转是:把 MP 律用作确定性等价,直接对 MP 谱自身的容量 $\mathcal{I}(\gamma, Ms^2)$ 计数——谱不再是待诊断对象,而是把分数变成规格之良定义函数的桥梁。另一缺口是:现有标量没有一个同时满足“跟踪质量”与“可分解”——#Params 可加但不反映质量,训练免费代理反映质量但不可分解,NSC 二者兼得,从而独享精确动态规划这条优化通道。
核心方法
直觉上,一个权重矩阵能承载多少信息由其奇异值谱决定:把 $W\in\mathbb{R}^{m\times n}$ 看成线性高斯信道 $y=Wx+z$,互信息为 $\psi(W)=\sum_i\ln(1+\sigma_i^2)$——谱越饱满容量越大,秩-1 截断会让 LLaMA FFN 矩阵的 $\psi$ 从约 3174 跌到 2.5。难点是 $\psi$ 需要 SVD。技术路线分三步:其一,在标准随机初始化下用 Marchenko–Pastur 律证明 $\psi(W)/N$ 几乎必然收敛到只依赖维度与初始化方差的闭式 $\psi_{\mathrm{MP}}(m,n,s)=N\mathcal{I}(\gamma,Ms^2)$,$\mathcal{I}$ 为 MP 律的 Shannon 变换(Theorem 1);其二,多头注意力按头分解,与输出投影、FFN 矩阵层内求和得 $\Psi_l$,再跨层求和得 $\mathrm{NSC}(f)=\sum_l\sum_j\psi_{\mathrm{MP}}(m_{l,j},n_{l,j},s_{l,j})$,从规格以 $O(L)$ 算出;其三,利用可加性把预算约束下的最大化写成逐层背包,动态规划精确求解。
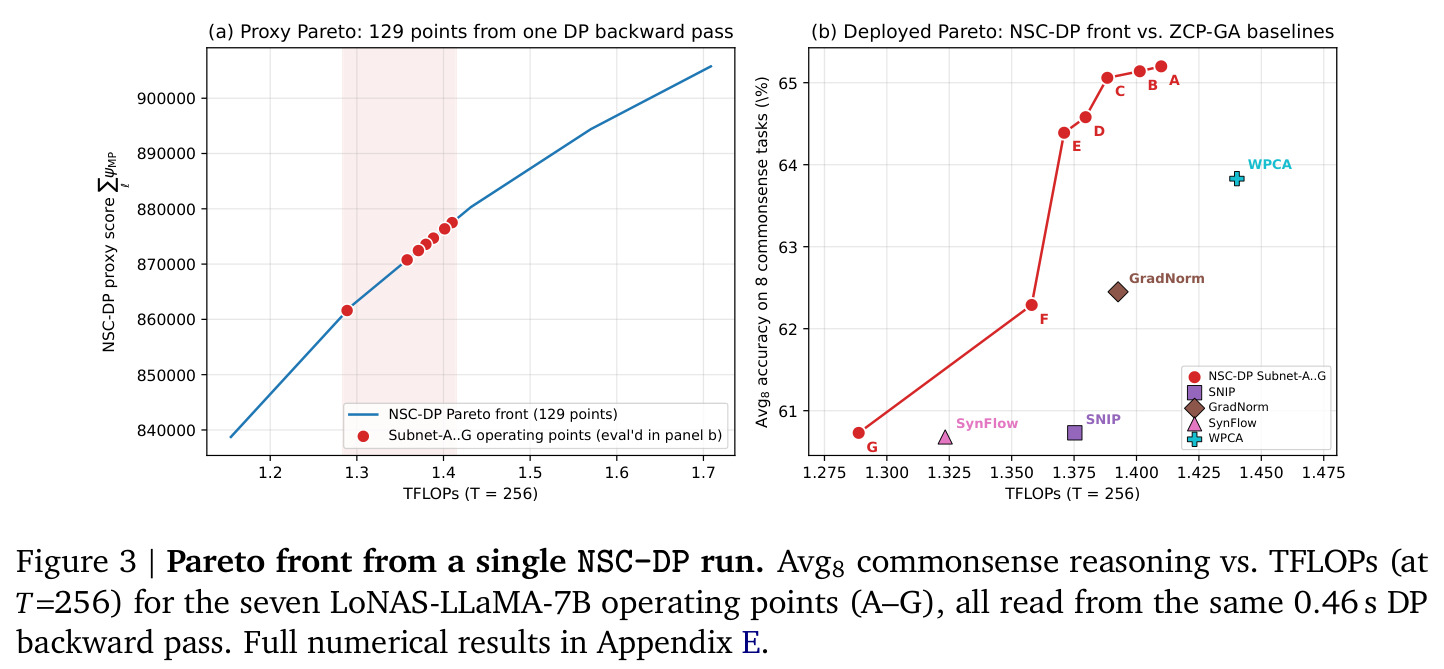
核心创新在于翻转 Marchenko–Pastur 律的角色:不是把随机谱当零模型去诊断网络,而是把 MP 律当确定性等价,直接取 MP 谱自身容量的解析式作为架构分数——Theorem 1 的极限泛函就是定义本身而非有限样本近似,谱容量因此成为规格 $(m,n,s)$ 的确定性函数,与具体权重实现无关。这带来两个竞争者不具备的性质:第一,在固定参数或计算预算下(候选架构的 #Params/#FLOPs 几乎相同),两个经典度量失去区分力,而 NSC 对深度、头分配、FFN 比例等结构选择敏感,能给出不同分数;第二,逐层可加性使 NSC 的资源约束最大化化归为有界/多重选择背包,NSC-DP 在单 CPU 核上秒级处理高达 $10^{32}$ 个候选的搜索空间并返回代理目标下的全局最优架构,这是把训练免费代理当黑盒适应度做进化/强化学习搜索在原理上给不了的保证。此外 DP 表格还免费编码所有 $b\le B$ 预算的最优值,一次运行即输出整条 Pareto 前沿。
方法步骤详情
第一步,规格解析:列出全部线性投影权重矩阵——多头注意力的每头 Q/K/V 投影(按头分解,头维 $d_h=d/H$,否则无法区分头数不同的架构)、注意力输出投影、FFN 矩阵;卷积 reshape 为 $\mathbb{R}^{c_{out}\times c_{in}k^2}$;嵌入、偏置、归一化排除。第二步,逐矩阵评分:$\psi_{\mathrm{MP}}(m,n,s)$ 中初始化方差由固定方案决定(Xavier 为 $s^2=2/(m+n)$,Kaiming fan-in 为 $s^2=2/n$),单次评估是一维数值积分约 10 微秒,并按 $(m,n,s)$ 元组缓存复用。第三步,聚合:层内求和 $\Psi_l=\sum_j\psi(W_{l,j})$(等价于块对角矩阵的容量),网络级再求和得 NSC。第四步,NSC-DP:外层枚举网络级决策 $g$(深度、嵌入维度),内层对层级决策 $x_l$(头数、FFN 宽度)解背包 $\max\sum_l\Psi_l(x_l;g)$ s.t. $\sum_l c_l(x_l;g)\le B$,DP 在 $O(L\cdot B\cdot|\mathcal{X}_l|)$ 内完成,回溯即得全局最优架构。
技术新颖性
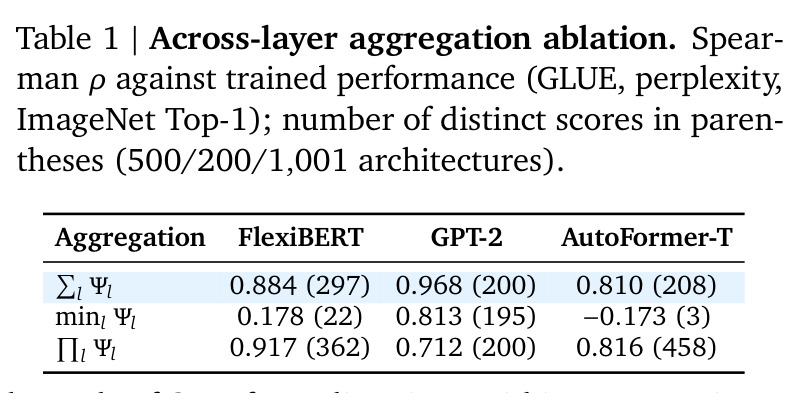
与训练免费代理(W-PCA、ZeroLM、SNIP、GradNorm 等)相比,NSC 不实例化网络、不看任何输入、不做前向反向,分数对规格确定——评估成本微秒级(FlexiBERT 500 架构仅 2ms,对手需 63–88 秒,快四个数量级),且分数函数可解析优化而非黑盒采样。与 RMT 诊断类工作(权重谱重尾、激活谱、bulk 内剪奇异值)相比,NSC 不分析已存在网络的谱,而是从规格合成容量,并把谱量转化为可精确优化的目标。聚合方式上,消融显示求和最优:min 规则在 FlexiBERT 的 500 个架构上只产生 22 个不同分数、在 AutoFormer-Tiny 上负相关($\tau=-0.173$),乘积规则也全面落后。精度上,$\psi_{\mathrm{MP}}$ 对 SVD 值的相对误差按 $O(1/\min(m,n))$ 衰减:$\min(m,n)=128$ 时低于 0.4%,1024 时约 $10^{-4}$;在 LoNAS-LLaMA-7B 超网全部 129 个 Pareto 最优子网上 $\tau=\rho=1.0000$,平均遗憾 0.039%,省 720 倍计算。
实验结果
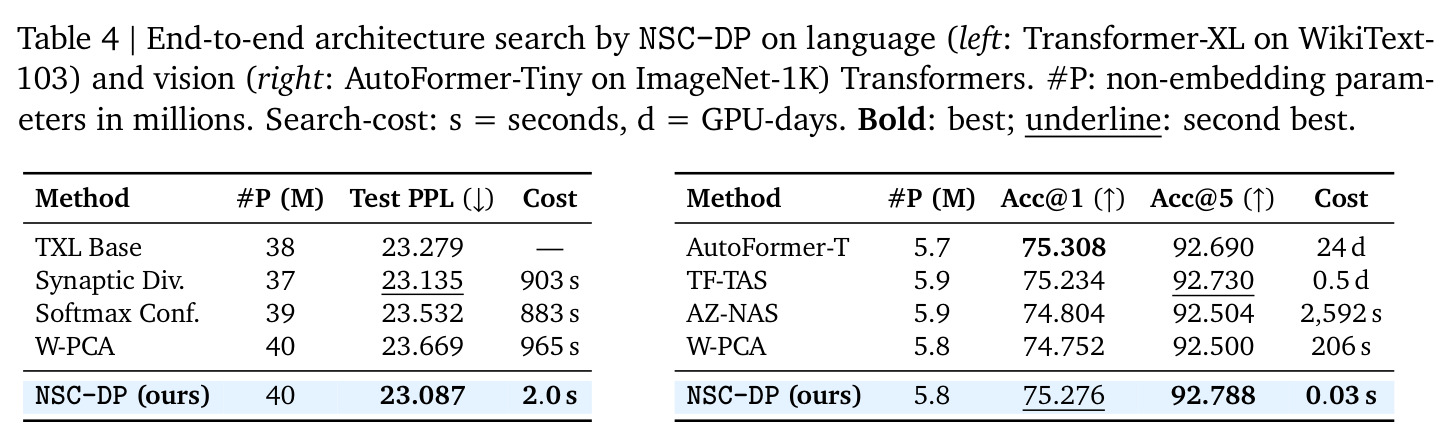
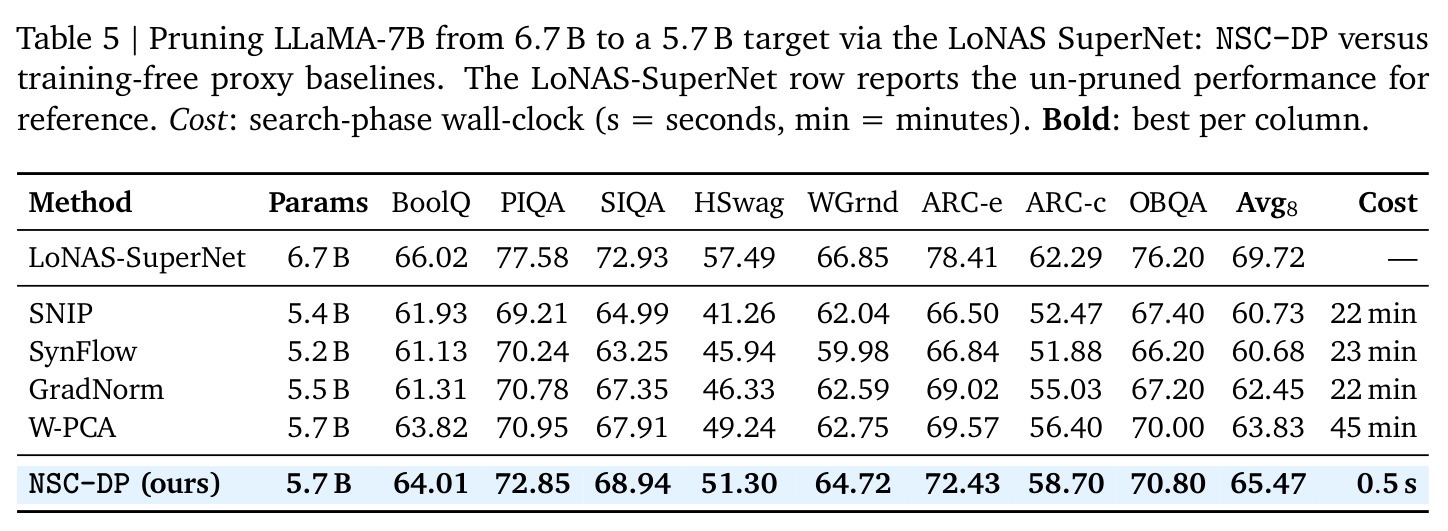
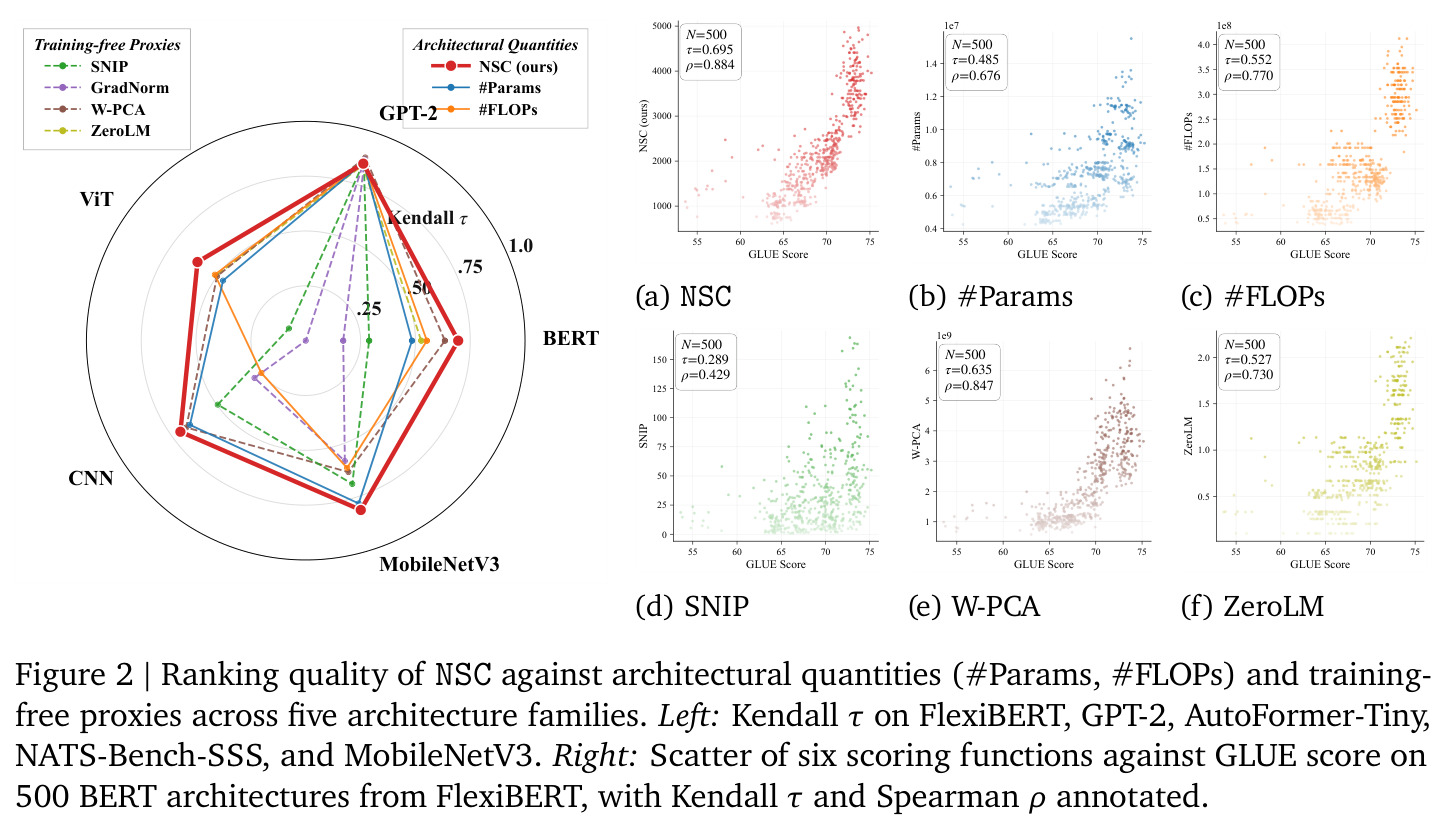
排序(§4.1):FlexiBERT 500 架构上 NSC 的 Kendall $\tau=0.695$,高于 #Params 0.485、#FLOPs 0.552、W-PCA 0.635、ZeroLM 0.527;在只比较参数量差 <10% 架构对的 10%-PW 控制下 #Params 崩到 0.082,NSC 保持 0.505,说明捕捉了尺寸之外的结构信息;该模式在 AutoFormer-Tiny(0.503 vs 0.322)、NATS-Bench-SSS(0.372 vs 0.116)、MobileNetV3(0.535 vs 0.414)同样成立,两个 CNN 族上 NSC 也居首。搜索(§4.2):Transformer-XL/WikiText-103 上 NSC-DP 以 2.0 秒 CPU 找到 PPL 23.087 的架构,优于 TXL Base(23.279)与最佳代理 Synaptic Diversity(23.135,903 秒);AutoFormer-Tiny 上达 75.276% Top-1,与 24 GPU 天的 oracle(75.308%)差 0.03 点内并超过全部启发式基线,搜索 0.03 秒。剪枝(§4.3):LLaMA-7B 剪至 5.7B,NSC-DP 八项常识推理平均 65.47,比最强基线 W-PCA(63.83)高 1.64 个百分点且每个单项占优,无需校准数据;搜索 0.46 秒,快约 5900 倍。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FlexiBERT 架构排序(500 个 BERT 架构) | Kendall τ 与 10%-PW τ(参数量差<10% 的架构对上的 τ) | NSC τ=0.695,10%-PW τ=0.505;500 架构 2ms(单 CPU 核) | #Params τ=0.485(10%-PW 崩至 0.082);最强代理 W-PCA τ=0.635(88 秒,A100 GPU) | 较 #Params 提 0.210,10%-PW 下领先约 6 倍;较 W-PCA 提 0.060 且快四个数量级以上 |
| Transformer-XL 架构搜索(WikiText-103 从零训练) | 测试困惑度 PPL(越低越好) | NSC-DP PPL 23.087,搜索 2.0 秒单 CPU 核 | 人工设计 TXL Base 23.279;最佳代理 Synaptic Diversity 23.135(903 秒) | PPL 降低 0.192,搜索快 400 倍以上 |
| AutoFormer-Tiny 视觉 Transformer 搜索(ImageNet-1K) | Top-1 准确率(%) | NSC-DP 75.276%,搜索 0.03 秒 | AutoFormer-T oracle 75.308%(24 GPU 天);启发式最佳 TF-TAS 75.234%(0.5 天) | 与天级 oracle 差 0.03 点以内并超过所有启发式基线,搜索成本降六个数量级 |
| LLaMA-7B 结构化剪枝至 5.7B(LoNAS 超网) | 八项常识推理任务(BoolQ/PIQA/SIQA/HellaSwag/WinoGrande/ARC-e/ARC-c/OBQA)平均准确率 Avg8 | NSC-DP Avg8 65.47,搜索 0.46 秒 CPU 单线程,无需校准数据 | 最强基线 W-PCA 63.83(45 分钟,需校准 mini-batch);未剪 LoNAS-SuperNet 6.7B 为 69.72 | 较最强基线 +1.64 个百分点且全部单项占优,速度约快 5900 倍 |
局限与改进
作者承认的局限:跨层求和是经验驱动的建模选择而非端到端互信息声明(层间串行、层内注意力与 FFN 块也串行,求和仅有表 1 消融与并联信道类比的支撑);图 1 的完美相关($\rho=1.00$)来自仅 10 个刻意拉开尺寸差距的 GPT-2 架构的小样本,大规模下 Spearman $\rho$ 落在 0.78–0.97;NSC-DP 的全局最优只是代理目标下的最优,不等于真实训练后性能最优;Theorem 1 要求 $\min(m,n)\to\infty$,极小矩阵下 MP 近似变松。我的补充观察:其一,比较架构要求全候选共用同一初始化协议,若不同架构用不同方案,$s$ 不再只由形状决定,排序可能改变(附录 H 显示大体保持但非严格不变);其二,NSC 立足随机初始化,对训练后权重分布(尤其大规模预训练后的重尾谱)为何仍有效只有 §4.3 的间接证据;其三,NSC-DP 要求 NSC 与资源都逐层可加,对延迟这类非加性资源或全局耦合约束不直接适用。
独立分析的弱点
第一,随机初始化假设与 LLM 剪枝场景有张力:§4.3 把 NSC 用于预训练好的 LLaMA-7B 超网,此时权重远非 i.i.d. 高斯,论文用 $\psi_{\mathrm{MP}}$ 与 SVD 值在 129 个子网上 $\tau=\rho=1.0000$ 辩护,但这只是超网内部的相关性,对任意预训练模型未证普适;改进方向是为训练后谱(重尾、快速衰减)建立规格化修正项。第二,求和聚合把串行链当并联处理,可能系统性偏好某些形状(附录 F.5 证明 TXL 上代理最优恰是均匀 FFN 分配),与真实最优的吻合只在少数基准上验证;可引入串行容量组合规则(如 Foggo & Yu 的串联公式)做对照消融。第三,代理上限:当 NSC 与真实性能排序不一致($\rho$ 低至 0.78 的情形)时,NSC-DP 返回的架构可能次优;可设计 NSC 粗筛加轻量代理精排的两阶段流程兜底。第四,非加性资源(推理延迟、显存峰值)无法直接进入背包约束,而现实部署常以延迟为硬指标,需要分段线性化或查表近似才能落地,论文未讨论。
未来方向
作者明确指出两条按构造即可延伸的轴:按头分解可直接为 MHA/GQA/MQA 分组策略评分,逐层可加和可直接为 MoE 的逐层专家分配打分。基于本文成果还可延伸:其一,把 MP 律替换为训练后谱的经验律或重尾修正,发展“预训练后规格评分”,服务持续剪枝与嵌套式(matryoshka)弹性架构设计;其二,DP 表已免费给出所有预算的 Pareto 前沿,可扩展为参数/FLOPs/延迟多资源背包,并与精度类代理联合成多目标搜索;其三,图 1 显示 $\psi_t$ 随训练单调上升且初始排序全程保持($\rho(\psi_0,\psi_T)=1.00$),可探索训练中段用 NSC 做早期架构评估或超网蒸馏进度监控;其四,从理论上刻画 NSC 与泛化、损失景观的关系——目前只有 $\partial\psi/\partial\sigma_i=2\sigma_i/(1+\sigma_i^2)$ 在 $\sigma_i=1$ 处取峰、与方差保持初始化谱主体位置吻合的部分机理解释,值得系统化。
复现评估
代码已开源(github.com/Optima-CityU/neural-spectral-capacity),复现门槛低:NSC 评分只需架构规格的矩阵维度与初始化方差,单 CPU 核即可——FlexiBERT 500 架构 2ms、TXL 搜索 2.0s、LLaMA-7B 剪枝 0.46s,无需 GPU、数据或模型实例化。基准全部公开:FlexiBERT、LiteTransformerSearch 的 GPT-2/TXL、AutoFormer-Tiny 超网、NATS-Bench-SSS、OFA 的 MobileNetV3、LoNAS 超网。需要算力的是验证环节:TXL 候选要在 WikiText-103 从零训练,AutoFormer 子网继承超网权重后在 ImageNet-1K 评估,剪枝后的 LLaMA-7B 要跑 BoolQ、PIQA、SIQA、HellaSwag、WinoGrande、ARC-E/C、OpenBookQA 八个 zero-shot 任务;基线代理在单张 A100 上评测。附录提供聚合消融、初始化鲁棒性、MP 逼近精度、Pareto 前沿等完整协议,整体复现难度中等偏低。
论文图表
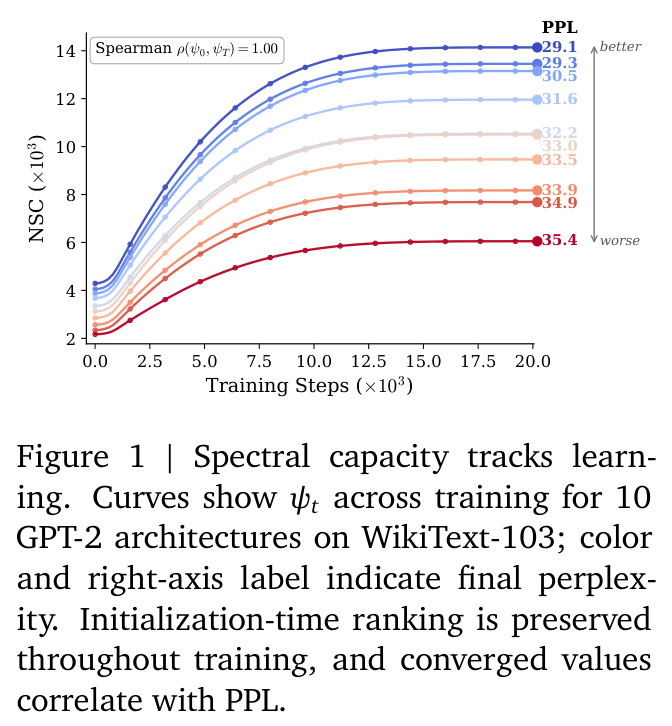
展示 10 个 GPT-2 架构在 WikiText-103 训练过程中谱容量 $\psi_t$ 的演化曲线,颜色和右轴标注最终困惑度(29.1–35.4)。三条关键观察:$\psi_t$ 随训练单调上升;$t=0$ 时的排序在整个训练过程中保持($\rho(\psi_0,\psi_T)=1.00$);收敛值 $\psi_T$ 与最终 PPL 完全相关。
这张图直接回应了最大的质疑——随机初始化权重的谱凭什么能预测训练后的性能。它给出了“初始排序全程保持”的经验证据和部分机理解释($\partial\psi/\partial\sigma_i$ 在 $\sigma_i=1$ 处取峰),是理解 NSC 有效性的动机性证据。