AutoCompress:硬件引导的自动化大模型压缩 AutoCompress: Automated Hardware-Guided Model Compression
把时延/吞吐/显存约束直接写进可微架构搜索,自动剪出达标模型
前置知识
结构化剪枝
以整个通道、注意力头、FFN 宽度、专家或层为单位删除参数,剪完的模型仍由规则稠密张量构成,可直接被推理引擎的高效 kernel 执行,从而兑现真实的时延与显存收益;区别于需要稀疏硬件支持的非结构化剪枝。通常先按激活重要性给组件排序,再保留前缀。
本文的搜索空间完全由结构化选项构成(隐藏宽度、Mamba 头数、专家数、FFN 宽度、删层),supernet 权重共享也依赖重要性排序,不懂结构化剪枝无法理解搜索空间设计。
可微架构搜索与 Gumbel-Softmax
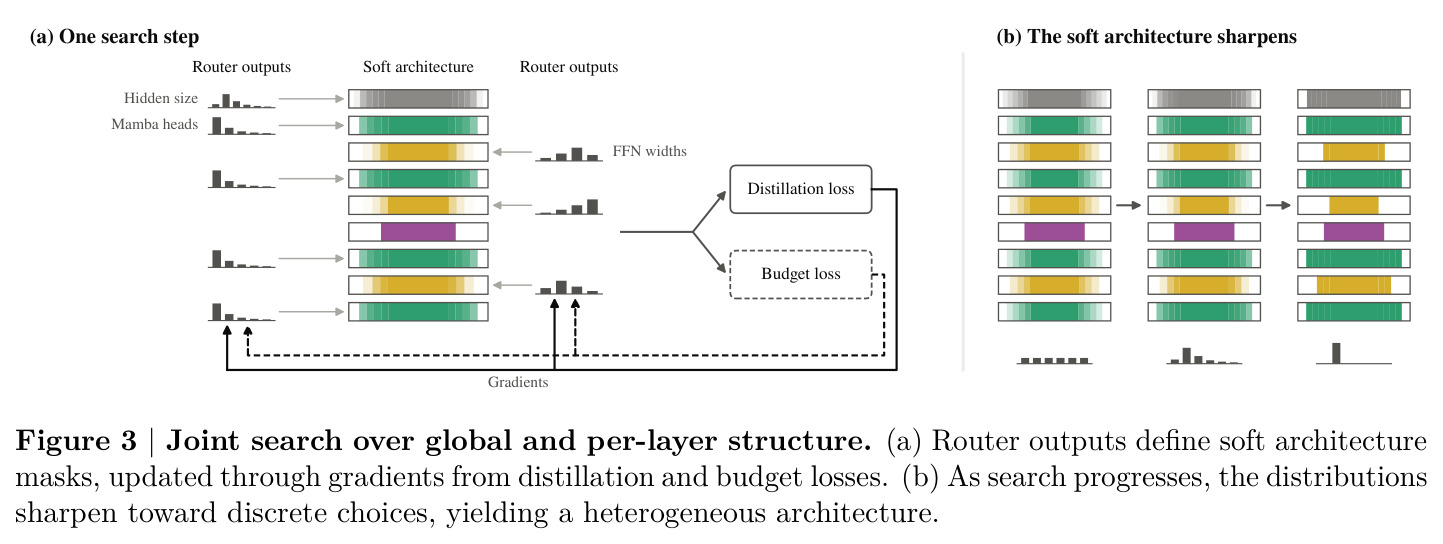
把离散架构选择松弛成连续分布以便梯度优化:对每个轴的 logits $z_c$,按 $y_c = \exp((\kappa_t z_c + g_c)/\tau_t) / \sum_j \exp((\kappa_t z_j + g_j)/\tau_t)$ 采样,$g_c$ 为标准 Gumbel 噪声。增大 logit 缩放 $\kappa_t$、降低温度 $\tau_t$ 会使分布逐渐锐化为 one-hot,训练后期即逼近离散架构。
论文的架构 router 正是用 Gumbel-softmax 在 250 步内把软架构锐化为离散选择($\kappa_t$ 从 1 升到 10、$ au_t$ 从 1.0 降到 0.05),这是读懂搜索机制的前提。
知识蒸馏(logit 蒸馏)
用冻结教师模型(此处为未剪枝父模型)的输出 logits 监督学生,损失为前向 KL 散度 $\mathcal{L}_{KD}$。剪枝后模型容量骤降,仅靠任务损失难以恢复;蒸馏让学生继承教师的概率结构,是 Minitron 一脉'先剪后蒸'流程中恢复质量的关键环节。
本文搜索与恢复两个阶段都以 $\mathcal{L}_{KD}$ 为质量信号,Table 3 中的 KD loss 是衡量架构优劣的核心指标。
Supernet 权重共享与重要性排序
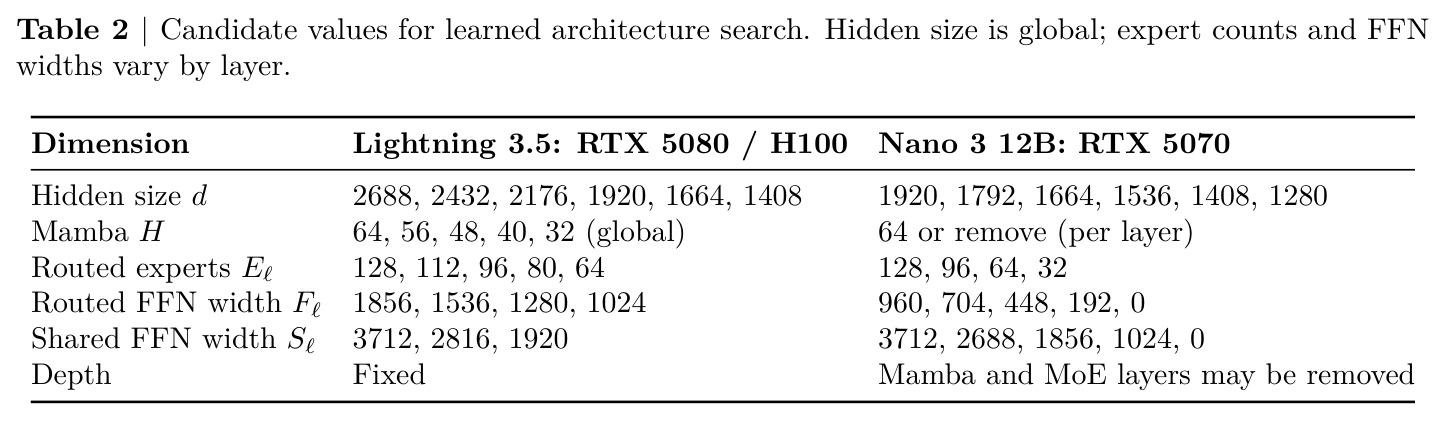
为让多个候选架构共用一套权重,先按激活重要性给父模型所有可剪组件(残差通道、Mamba 头、专家、FFN 通道)排序,并重排权重使最重要者在前。此后任意候选架构只取排序后权重的前缀子集,无需逐候选单独训练。Minitron 与本文均沿用此法。
这是在同一个 supernet 上评估 $10^{42}$ 量级候选的前提,也是恢复阶段'从排序父模型切出学生'的初始化方式。
MoE 与共享专家
混合专家层由 router 为每个 token 选 top-$k$ 个路由专家,另有常驻共享专家处理共性知识。服务成本上,路由专家数直接改变每 token 激活量与专家权重显存;论文实测隐藏宽度 2688 时共享专家宽度近乎减半每层仅省 7.5 ms 与 5 MiB,而 MoE 侧类似缩减省 33.7 ms 与 307 MiB。
本文搜索轴大量围绕 MoE(路由专家数、路由/共享 FFN 宽度),且专家掩码方式(输出掩码 vs top-k 分数掩码)是关键消融实验。
服务引擎成本模型
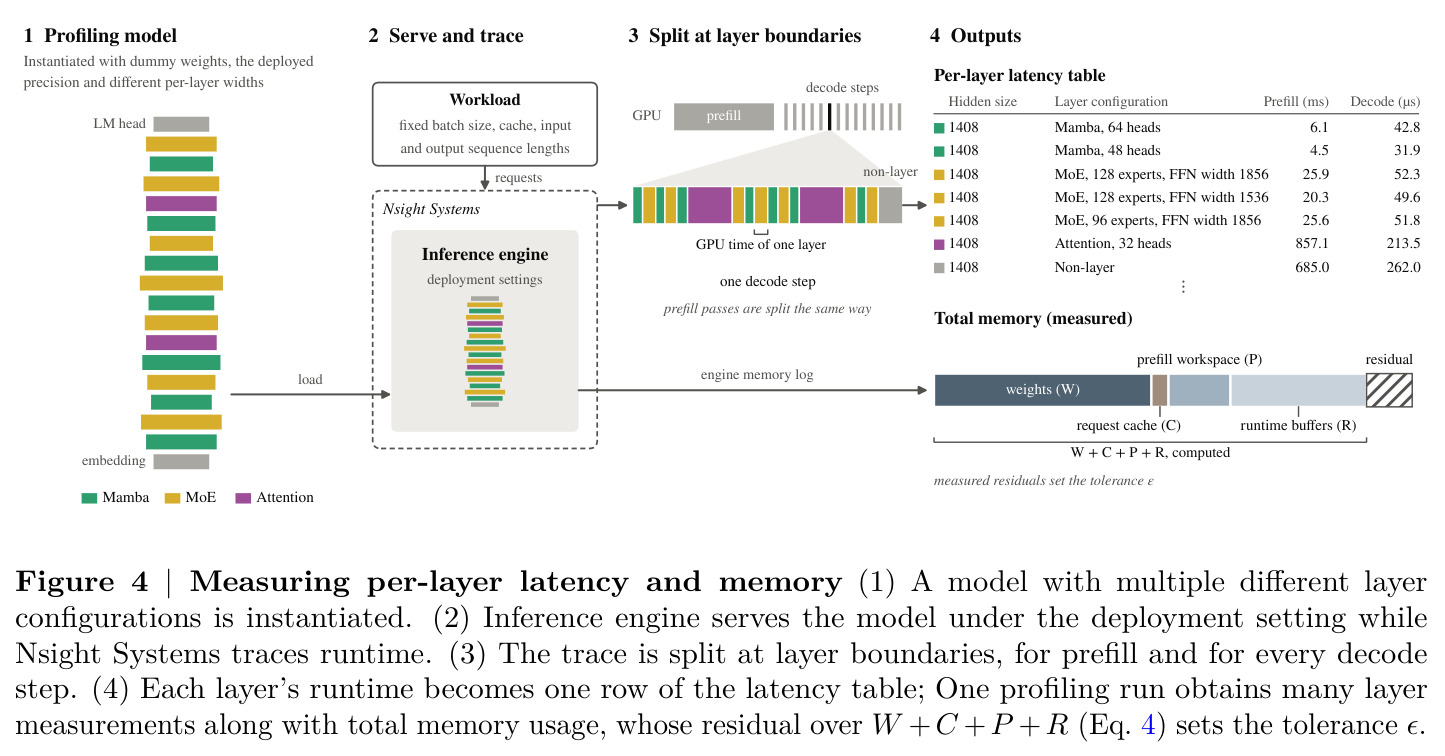
在目标推理引擎(本文为 vLLM 0.27.1)内按部署配置逐层实测 prefill/decode 耗时得到时延表,用 $\hat{T} = T_0 + \sum_\ell t_\ell$ 估计整模时延;显存按 $\hat{M} = W + C + P + R + \epsilon$ 分解为权重、请求缓存(KV 与 Mamba 卷积/SSM 状态)、prefill 工作区、运行时缓冲与未建模余量。
AutoCompress 的全部预算约束都由这套校准到目标硬件与工作负载的成本模型给出,是它与'按参数量剪枝'方法的本质分界。
研究动机
现有剪枝流程以参数量为目标:使用者需手动把时延、吞吐、显存约束翻译成'剪到多少 B',再在给定搜索空间内枚举。但参数量并非服务成本的好代理——Figure 1 中两个总参数同为 3.61B、激活同为 1.26B 的架构,窄而深者在 RTX 5070 上端到端时延 911 ms,比宽而浅者的 674 ms 高 35%;反过来在 H100 上,8.8B 与 19.3B 参数的模型吞吐几乎相同(7,355 对 7,375 tok/s)。只按权重加 KV cache 估算显存还会漏掉 prefill 工作区、MoE 矩阵乘工作区与运行时缓冲等真实分配。此外 Minitron 式统一层维度的搜索排除了各层容量异构分布的架构。结果是从'750 ms 时延、4 GiB 显存'这样的真实部署需求到最终剪枝配置之间仍依赖人工试错,且每次更换硬件或工作负载都要重来一遍。
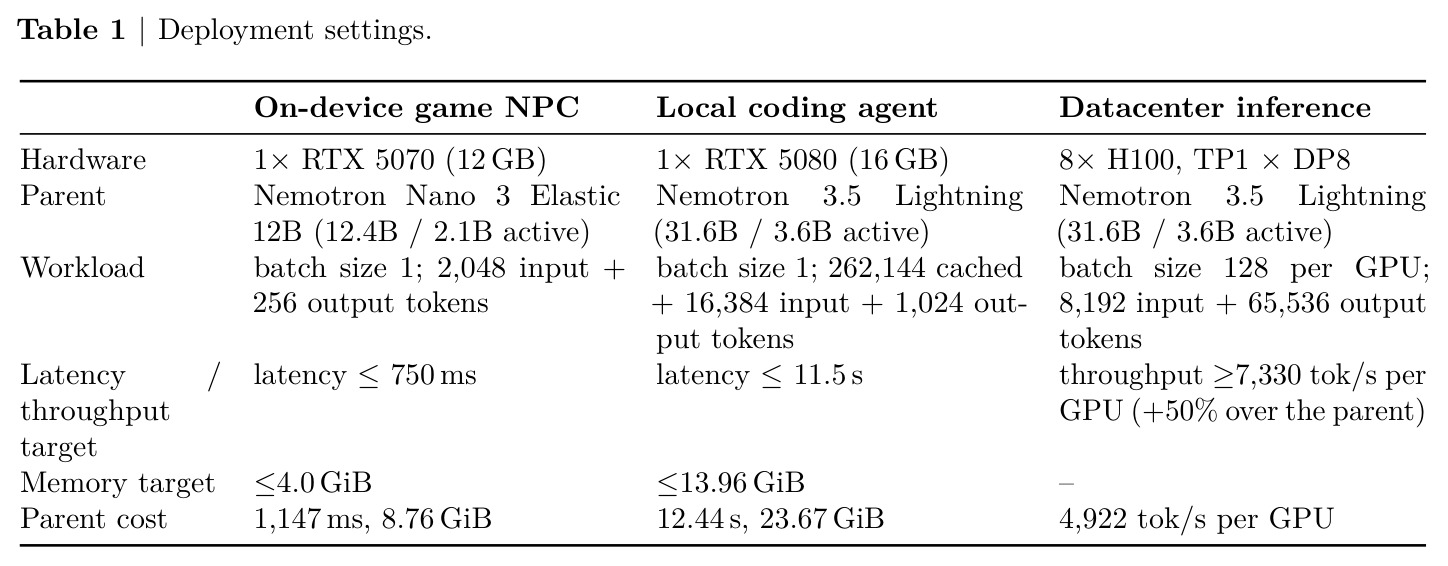
本文的目标是本文要让部署约束本身成为搜索目标:给定预训练父模型与部署目标 $\mathcal{D}$(硬件、精度、服务引擎配置、batch size、缓存前缀长度、输入/输出长度,以及时延上限/吞吐下限/显存上限的任意组合),AutoCompress 全自动产出独立小模型,在真实 GPU 上实测满足各项预算,同时尽量保留父模型精度,全程无需人工设计架构或换算参数预算。论文以三个差异极大的场景验证:RTX 5070 游戏 NPC(时延 ≤750 ms、显存 ≤4.0 GiB)、RTX 5080 本地编码代理(262,144 缓存前缀、时延 ≤11.5 s、显存 ≤13.96 GiB)、8×H100 数据中心批量服务(吞吐较父模型 +50%,即 ≥7,330 tok/s/GPU),并以 Nemotron 3.5 Super 120B→74B 的单 B200 BF16@128K 案例验证可扩展性。
与已有工作不同的是,独特切入点是'约束进搜索、成本出引擎'。相对 Minitron(统一层维度、参数量预算),本文在可微搜索中同时优化全局维度(隐藏宽度、Mamba 头数)与逐层维度(专家数、路由/共享 FFN 宽度,允许置零删层),得到异构架构;相对 Puzzle(固定隐藏维度、混合整数规划选块),本文支持隐藏维度剪枝并用 Gumbel-softmax 端到端可微地做选择;相对 ZipLM/SPRINT 等硬件感知方法,本文成本模型不是离线代理指标,而是直接在目标服务引擎 vLLM 内按目标工作负载与精度逐层实测校准,并用未参与建表的完整架构验证预测误差。预算损失还设计了 98%–100% 的死区,同时惩罚超支与过度浪费两个方向,迫使架构把预算用满而不越界。
核心方法
核心直觉:让候选架构在目标引擎上的时间与显存成本成为可微信号,与质量共同指导搜索,而非以参数量为代理。流程四步:(1) 成本建模——用含约 10 种层配置的哑权重短模型在 vLLM 服务一次,Nsight Systems 按层边界切分 trace,得到逐层 prefill/decode 耗时表与实测总显存,拟合 $\hat{T} = T_0 + \sum_{\ell} t_\ell$ 与 $\hat{M} = W + C + P + R + \epsilon$;(2) 按激活重要性排序并重排父模型权重构建 supernet,候选只取前缀子集;(3) 联合训练架构 router 与 supernet,目标 $\mathcal{L} = \mathcal{L}_{KD} + \alpha \sum_r [\max(0, \rho_r - 1) + \max(0, 1 - \delta - \rho_r)]$,$\rho_r$ 为预测成本与预算之比;(4) 取每门最高 logit 的选择,从排序父模型切出权重并蒸馏恢复。搜索空间达 $10^{42}$–$10^{52}$。
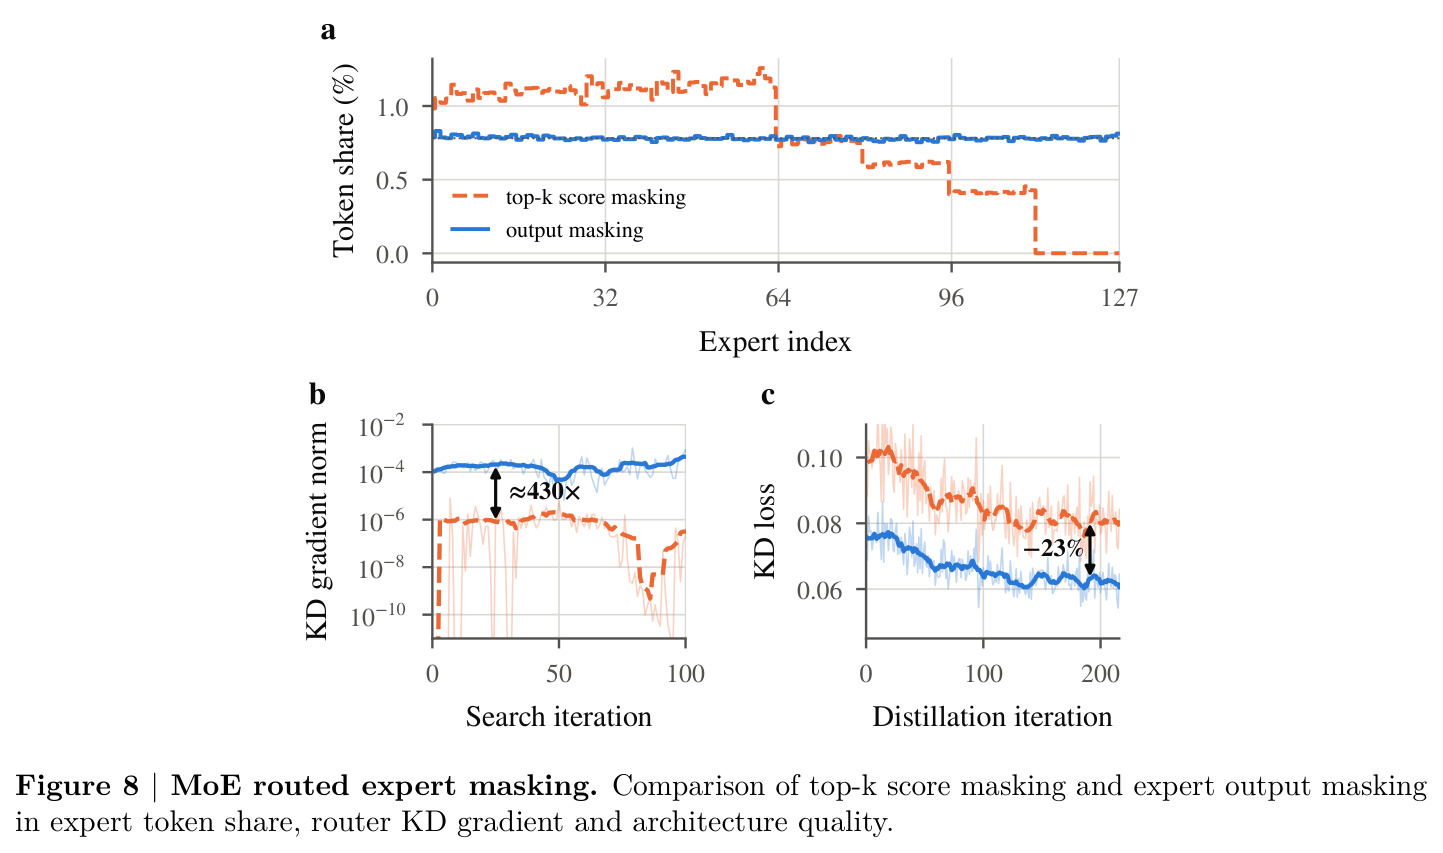
核心创新是把部署约束写进可微搜索的目标函数。其一,预算损失带死区:对每个受约束资源 $r$,$\rho_r$ 为预测成本除以预算,仅当 $\rho_r > 1$(超支)或 $\rho_r < 1-\delta$(浪费容量,$\delta=0.02$)时产生惩罚,98%–100% 区间零惩罚,推动架构'用满预算但不超支'。其二,成本信号来自服务引擎在环实测:时延按逐层耗时表相加,显存显式分解为权重 $W$、请求缓存 $C$(KV 与 Mamba 卷积/SSM 状态)、prefill 工作区 $P$、运行时缓冲 $R$ 加校准余量 $\epsilon_\mathcal{D}$,比 FLOPs 或参数量代理更贴近真实。其三,全局+逐层联合搜索允许层间异构与删层,这是均匀剪枝的 Minitron++ 做不到的。其四,MoE 专家采用输出掩码(在 top-$k$ 选择之后施加软掩码)而非路由分数掩码,保证低排名专家在搜索期仍有梯度流动。
方法步骤详情
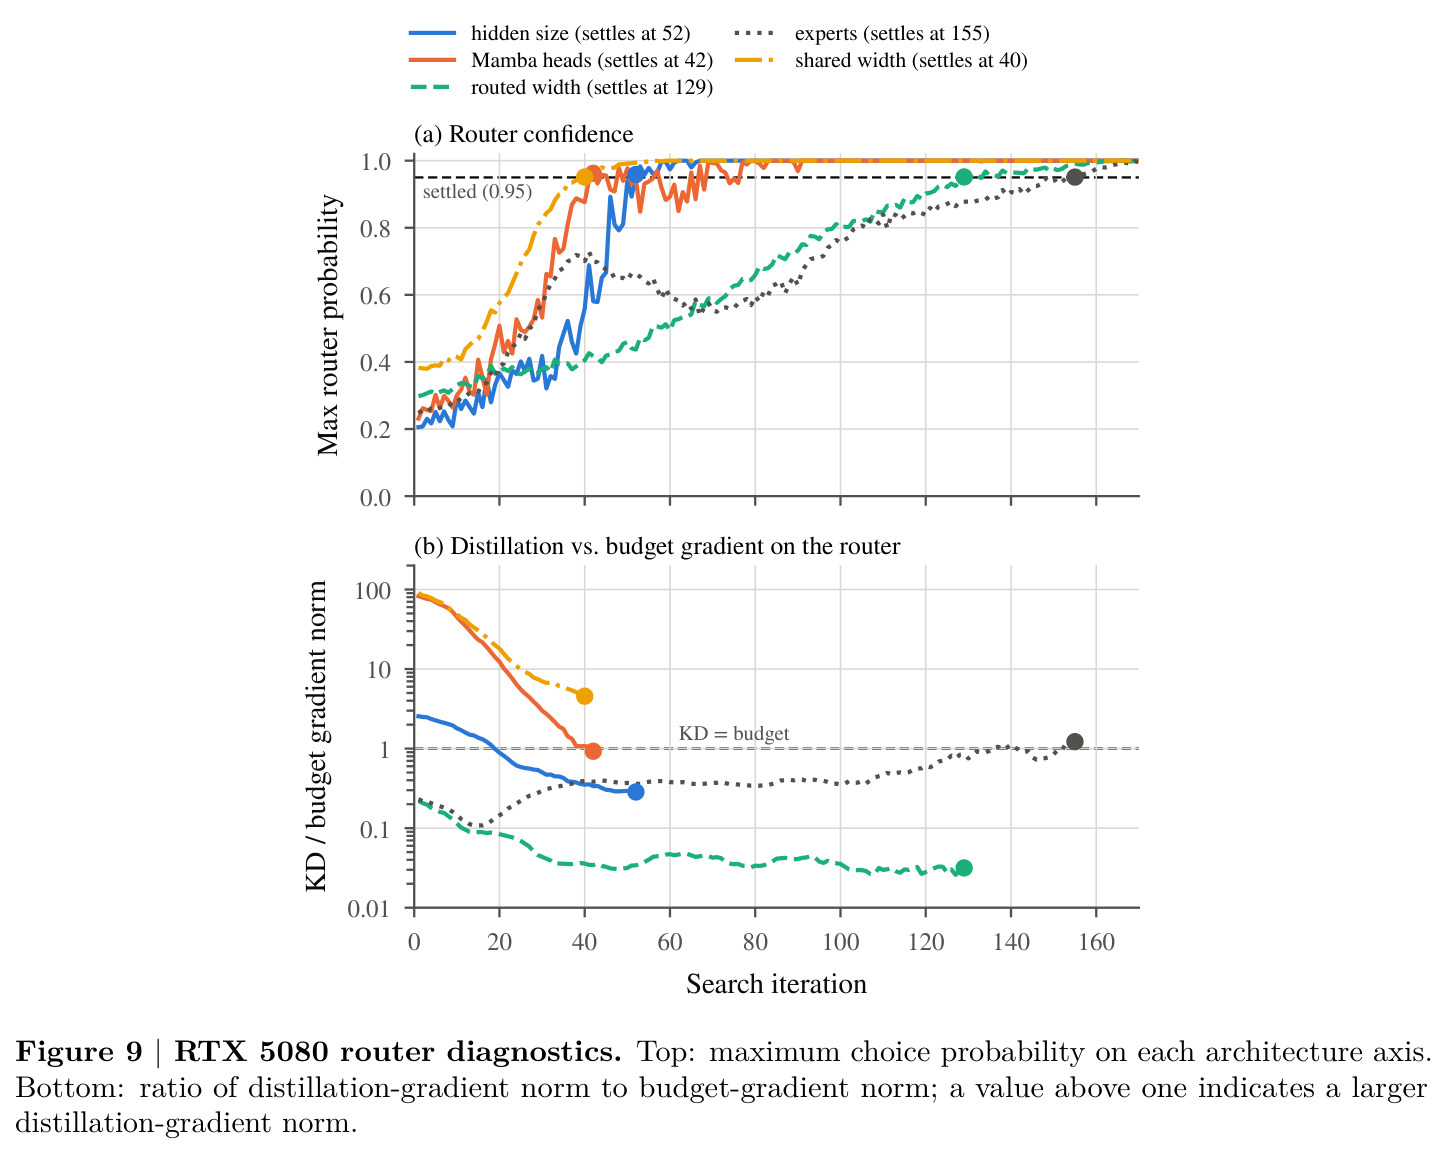
第一步成本建模:构造含约 10 种层配置的哑权重短模型,按部署同款引擎(vLLM 0.27.1)、精度、batch 与序列长度服务,用 Nsight Systems 在层边界切分 GPU 时间,得到逐层 prefill/decode 耗时表;总显存相对 $W+C+P+R$ 的残差定余量 $\epsilon$,无需额外运行。第二步:按激活重要性排序残差通道、Mamba 头、专家与 FFN 通道并重排权重,构建权重共享 supernet。第三步搜索 250 步:router 为两层 MLP(隐藏宽 256、输出层零初始化、无 warmup、LR $2\times10^{-3}$);每批 2048 条 8192 token 序列均分给 32 个采样架构;$\kappa_t$ 从 1 升到 10、$\tau_t$ 从 1.0 降到 0.05;每门对首选选择概率 ≥0.95 时提取(三目标分别在 170/249/179 步)。第四步:从排序父模型切出所选架构,用 30B(RTX 5070)或 10B(其余)token 的 logit 蒸馏恢复,与基线同数据同序同学习率。
技术新颖性
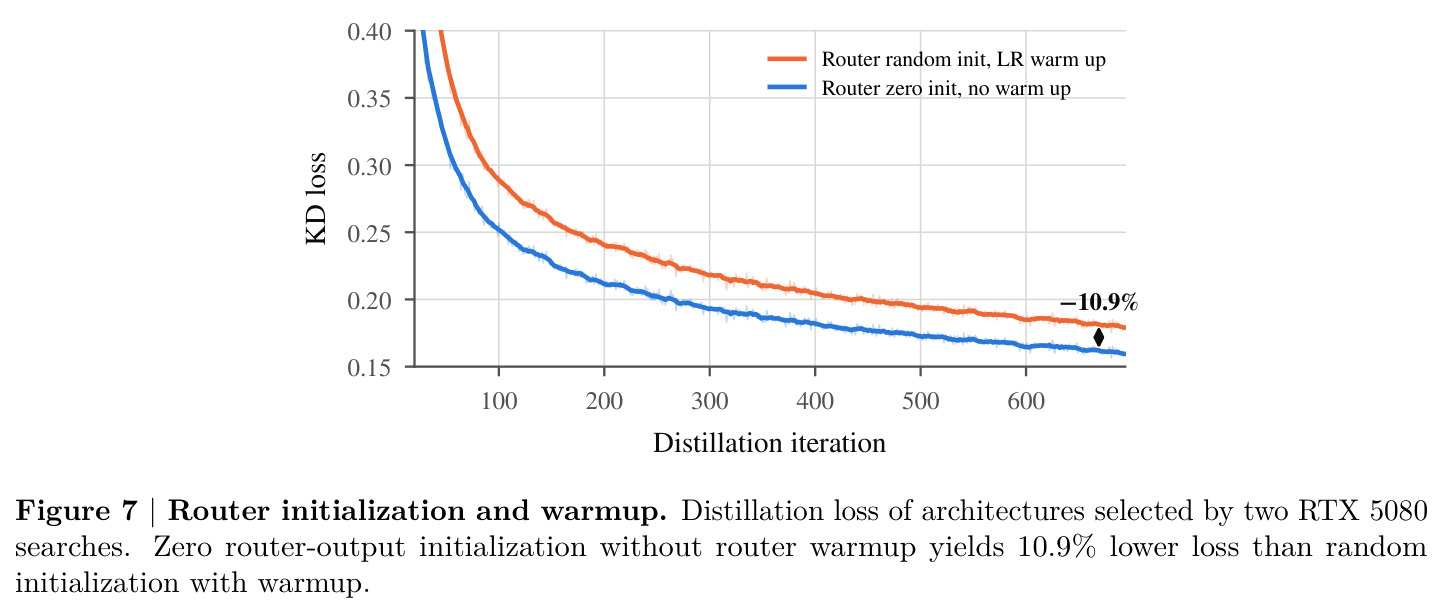
新颖性有三。一是搜索空间的完备统一:首个把隐藏宽度(全局)、Mamba 头数、每层路由专家数、路由/共享 FFN 宽度与删层纳入同一可微空间的工作——MoE 层路由宽度置零且共享宽度为正时退化为稠密 MLP,两者皆零即删层,删层与宽度剪枝共用一套掩码表示,组合空间达 $10^{42}$–$10^{52}$。二是服务引擎在环的成本模型:一次 profiling 即得整张逐层耗时表(摊薄测量成本),显存按分配规则显式建模工作区与缓冲并以校准残差兜底,附录在留出架构上验证精度,避免了 FLOPs 类代理在 MoE 与不同并行策略下的失真。三是搜索工程系统化:router 输出层零初始化消除初始偏好(消融显示 KD loss 低 10.9%)、专家输出掩码保证均匀路由与稳定梯度(KD loss 低 23%、router 梯度约放大 430 倍)、预算死区与 $\alpha$(H100 扫出 0.3,RTX 5070 用 1)共同实现 100% 预算符合率。
实验结果
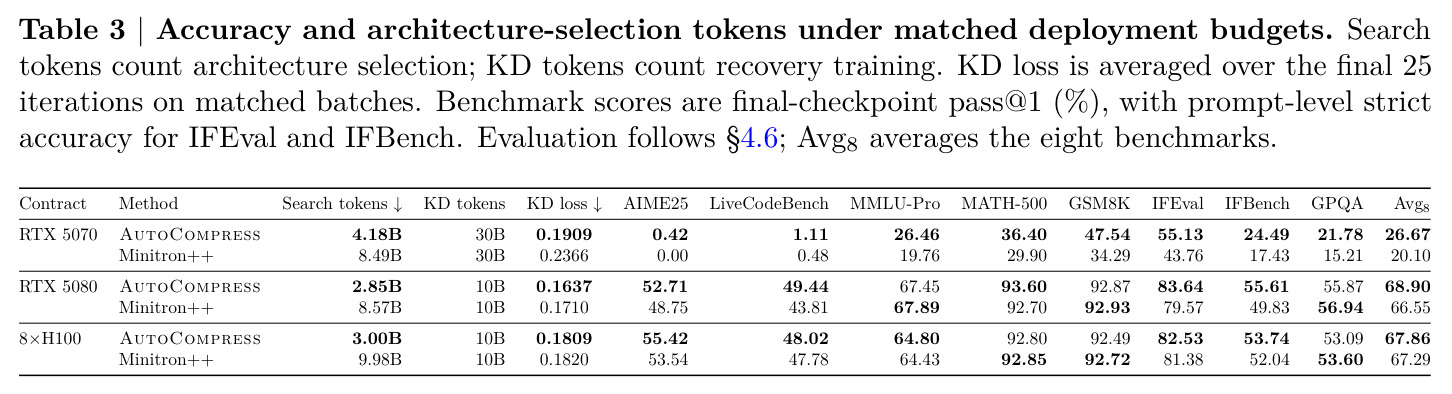
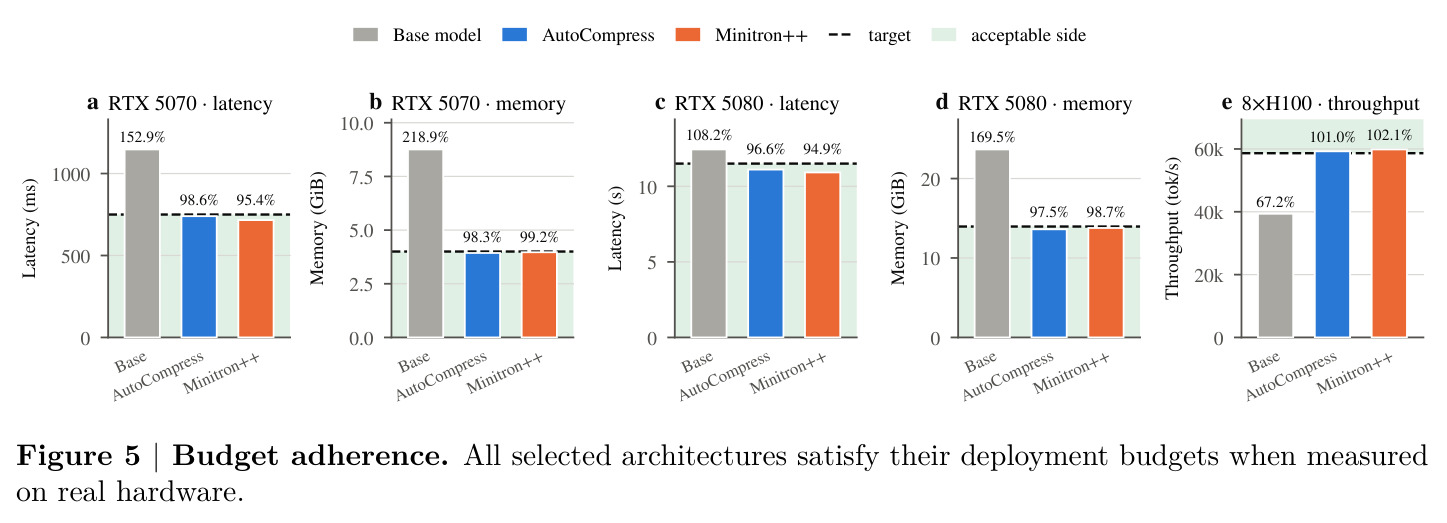
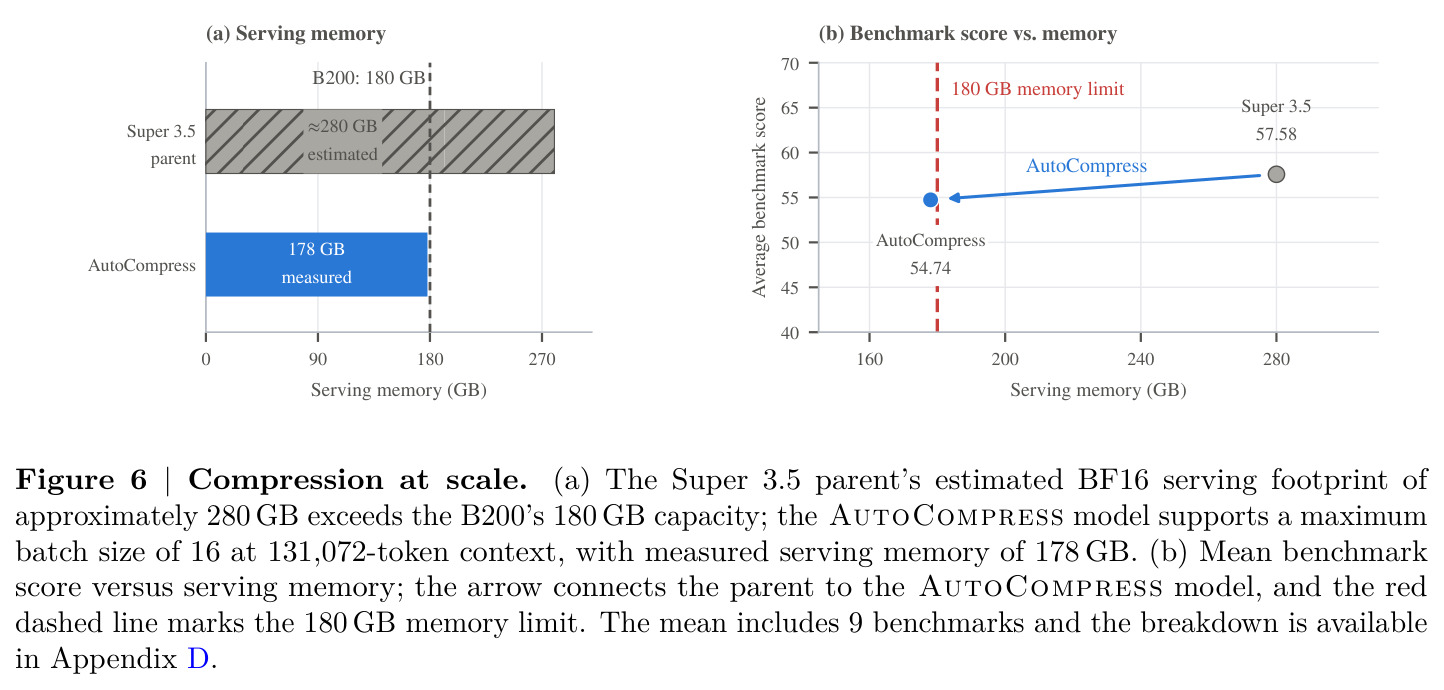
匹配恢复训练下,AutoCompress 八基准均值在 RTX 5070 达 26.67 对 20.10(+6.57 pp)、RTX 5080 达 68.90 对 66.55(+2.35 pp)、8×H100 达 67.86 对 67.29(+0.57 pp);架构选择 token 仅 4.18B/2.85B/3.00B(基线的 1/2.0–1/3.3)。实测全部达标:RTX 5070 学生 739.7 ms/3.93 GiB,RTX 5080 学生 11.1 s/13.61 GiB,H100 吞吐 +50.5%。规模案例:Super 3.5 从 120B 压至 74B,BF16@128K、batch 16 实测 178 GiB,九基准均值 54.74(父模型 57.58 的 95%),比 Nemotron 3 Super(45.44)高 9.30 分。消融:router 零初始化较随机初始化+warmup 使 KD loss 低 10.9%;专家输出掩码较 top-k 分数掩码低 23%;共享专家因远便宜于 MoE 侧(7.5 ms 对 33.7 ms/层)而保持满宽。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 游戏 NPC(RTX 5070,8 基准平均 pass@1) | Avg8 (%) | 26.67 | Minitron++ 20.10 | +6.57 pp,KD loss 低 19.3% |
| 本地编码代理(RTX 5080,8 基准平均 pass@1) | Avg8 (%) | 68.90 | Minitron++ 66.55 | +2.35 pp |
| 数据中心批量服务(8×H100,8 基准平均 pass@1) | Avg8 (%) | 67.86 | Minitron++ 67.29 | +0.57 pp |
| 架构选择成本(RTX 5070/5080/H100) | 搜索 token 数 | 4.18B / 2.85B / 3.00B | Minitron++ 8.49B / 8.57B / 9.98B | 减少约 2.0×–3.3× |
| 部署预算符合性(RTX 5070/5080 实测) | 端到端时延 / 显存 | 739.7 ms、3.93 GiB;11.1 s、13.61 GiB | 预算上限 750 ms、4.0 GiB;11.5 s、13.96 GiB | 全部达标且留有裕量 |
| 大规模压缩(Nemotron 3.5 Super,单 B200 BF16@128K) | 9 基准平均分 / 服务显存 | 54.74(74B,178 GiB,batch 16) | 父模型 57.58(120B,约 280 GB) | 保留约 95% 均分,参数减 38.3%,比 Nemotron 3 Super 高 9.30 分 |
局限与改进
作者承认的局限:加性时延估计假设层耗时独立可加,架构变化可能改变 kernel 选择、缓存行为与开销,故需在留出架构上验证误差;120B→74B 案例因训练成本(32 个 GB200 节点约 64 小时)未跑 Minitron++ 基线,该规模的相对增益未知;H100 上相对均匀剪枝的优势已缩至 +0.57 pp。我补充的观察:成本模型与 vLLM 0.27.1 强耦合,换引擎或大版本需重新 profiling;预算权重 $\alpha$ 靠 H100 扫参(0.3)后迁移到 RTX 5080,RTX 5070 又改回 1,缺乏自动整定机制;实验仅覆盖 Nemotron 系 hybrid Mamba-MoE 模型,未验证纯 Transformer 或其他家族;RTX 5070 场景绝对精度很低(Avg8 26.67,AIME25 仅 0.42、LiveCodeBench 仅 1.11),重度压缩下推理能力近乎丧失而论文未深入分析;恢复阶段仅用父模型输出 logits,没有中间层蒸馏;量化等部署维度未纳入搜索,'硬件引导'目前只覆盖结构维度。
独立分析的弱点
独立分析的弱点:(1) 加性成本模型忽略层间交互,删层或大幅改宽会影响 chunked prefill 边界与 kernel 选择,极端异构下误差可能放大,可引入交互校正项或服务期在线偏差修正;(2) 预算损失需人工调 $\alpha$ 与死区 $\delta$,紧预算场景只能靠加大 $\alpha$ 硬拉(RTX 5070 从 0.3 提到 1),可改用拉格朗日对偶自动整定;(3) 输出掩码使搜索期所有专家都参与前向,supernet 显存与耗时高于最终架构,可结合专家渐进冻结降低开销;(4) 蒸馏只对齐输出 logits,RTX 5070 上数学/代码能力崩塌(AIME25 0.42、LiveCodeBench 1.11)说明容量瓶颈落在推理链路,可加中间层蒸馏或按能力感知设置逐层最小宽度约束;(5) 每换一个硬件/负载就要重跑一次搜索(虽 push-button 但不跨目标共享),可扩展为一次搜索产出帕累托模型家族;(6) 并行布局(TP1×DP8、batch 128)仍是人工扫描选出,未进入搜索;未与量化、投机解码联合,压缩维度不完整。
未来方向
作者方向上的延伸:(1) 把量化位宽纳入搜索轴,做'结构×精度'联合优化,进一步压显存与时延;(2) 成本模型推广到其他引擎(TensorRT-LLM、SGLang)与并行策略,让 TP/EP 布局与 batch 大小也进入搜索;(3) 多目标一次搜索产出帕累托前沿模型家族,避免每个目标重跑;(4) 服务期在线反馈:用引擎实测持续校正加性模型偏差,实现增量式搜索。基于成果可延伸:(5) router 学到的软架构可服务于弹性推理——按负载在多个已提取架构间在线切换;(6) 与投机解码、KV 缓存量化组合,缓解 RTX 5070 场景的 decode 时延瓶颈;(7) 针对重度压缩下推理能力崩塌,研究能力保持约束,如对推理密集层设最小宽度、按基准弱项(AIME25/LiveCodeBench)加权蒸馏数据;(8) 把逐层耗时表方法推广到 kernel 选择感知的搜索,或多模态与扩散模型的部署感知压缩。
复现评估
复现评估:论文未提及开源代码、profiling 脚本或压缩后 checkpoint(NVIDIA 内部项目),这是最大障碍。基准全部公开(AIME25、LiveCodeBench v5、MMLU-Pro、MATH-500、GSM8K、IFEval、IFBench、GPQA-Diamond,推理模式 temperature 1.0、top-p 1.0),但蒸馏语料来源未指明。算力门槛很高:RTX 5070 搜索用 8 个 H100 节点(4 路 TP×8 路 EP),RTX 5080/H100 搜索用 32 个 H100 节点,120B 案例用 32 个 GB200 节点(128 GPU)约 64 小时,恢复另需 10B–120B 蒸馏 token。相对可复现的是成本模型方法论:单卡 + vLLM + Nsight Systems 即可按 Figure 4 流程构建逐层耗时表与显存分解,并在留出架构上验证误差,无需大算力;完整搜索与恢复管线基本只适合拥有大型集群的团队。总体判断:方法论可复现,端到端复现难度很高。
论文图表
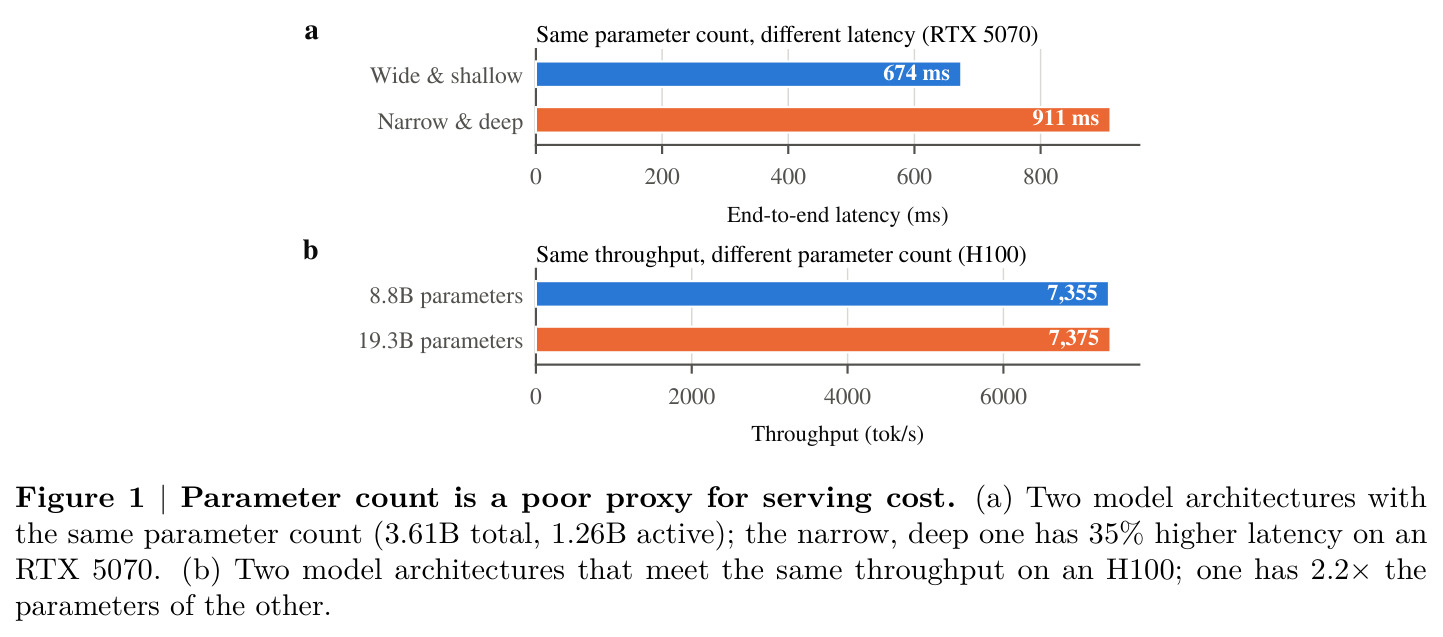
两幅对比图:(a) 总参数 3.61B、激活 1.26B 的两个架构在 RTX 5070 上,宽而浅者时延 674 ms,窄而深者 911 ms(高 35%);(b) H100 上吞吐几乎相同的两个架构(7,355 对 7,375 tok/s),参数量却相差 2.2 倍(8.8B 对 19.3B)。
全文立论的基础:证明参数量不能预测时延/吞吐,从而论证必须直接以部署成本为约束进行搜索。
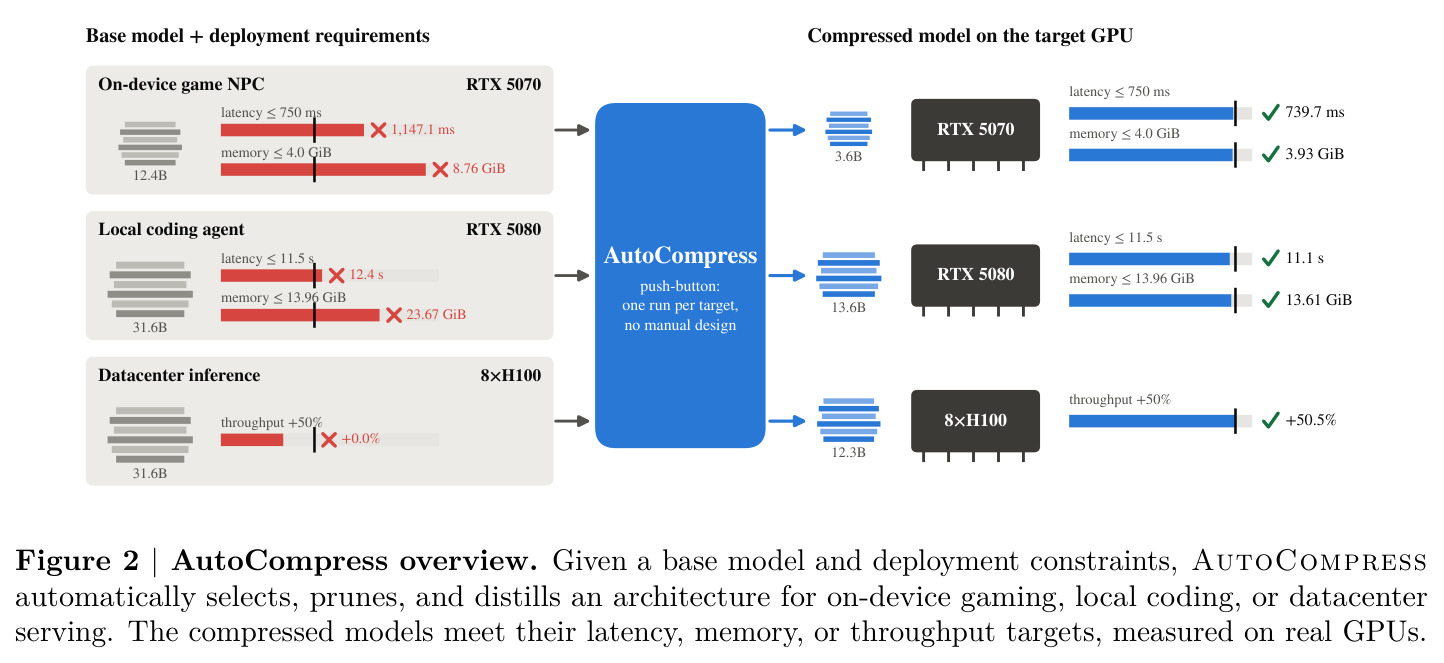
三行 push-button 案例:游戏 NPC 在 RTX 5070 上从 12.4B/1,147.1 ms/8.76 GiB 压到满足 750 ms/4.0 GiB 的 3.6B 模型(实测 739.7 ms/3.93 GiB);本地编码代理在 RTX 5080 上从 12.44 s/23.67 GiB 压到 11.1 s/13.61 GiB;数据中心在 8×H100 上吞吐 +50.5%,均每目标一次运行、无人工设计。
一图总览方法的输入、输出与三大部署场景的结果量级,是理解论文范围与承诺的入口。