阶梯式混合专家:分段级路由与可配置推理复杂度 Stepped MoE: Segment-Level Routing with Configurable Inference Complexity
单一模型分段路由专家,按设备选1-4B激活规模,延迟近稠密而精度更高
前置知识
混合专家模型(MoE)
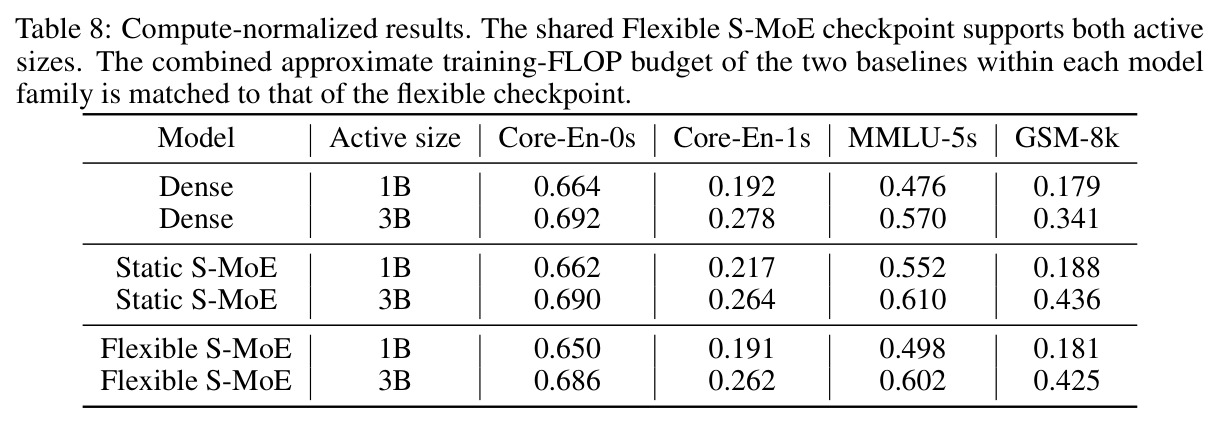
MoE 在 transformer 的 FFN 位置放置多个并行的'专家'子网络和一个轻量路由器:路由器为每个 token 计算专家分数,只激活 top-$k$ 个专家,其余参数在该次前向中不参与计算。这样模型总容量可以远大于每次前向的实际 FLOPs,实现'大容量、低计算'。但常规 MoE 逐 token 逐层路由意味着每一步解码激活的专家集合都不同。
本文的 Stepped MoE 正是对'逐 token 路由导致边缘设备 I/O 瓶颈'这一痛点的改造,理解常规 MoE 的路由粒度和换专家代价才能体会其改动动机。
指令跟随剪枝(IFP)
IFP 训练一个单独的小型剪枝预测网络,根据用户 query 一次性生成整套剪枝掩码;响应生成期间只有被选中的参数驻留 DRAM,等价于按 query 粒度的稠密推理。它解决了专家频繁换入换出的问题,但掩码在 hidden dimension 粒度生成、搜索空间巨大、无法使用稀疏 GEMM,且只能从稠密模型 upcycle 而不能从头预训练。
Stepped MoE 是对 IFP 的直接继承与改造:保留其'按输入固定子网络'的思想,但去掉独立剪枝器、把掩码粒度粗化到 expert 级。
SoftTopK 可微 top-k
top-k 选择本身不可导,因为排序是离散操作。SoftTopK 用连续松弛近似 top-k 指示掩码,使'选哪些专家'的决策能通过梯度回传参与端到端训练。本文用它把路由 logits 转成 $\{0,1\}$ 专家掩码,从而让掩码生成器与下一词预测损失联合优化。
这是本文能从头预训练(而非 IFP 式后处理 upcycle)的技术前提,也是'模型自身层充当路由器'能够被学出来的关键。
弹性/嵌套子网络
Slimmable Networks、Once-for-All、Matformer 等工作让一套共享参数同时支持多个容量档位:小档位网络是大档位的嵌套子集,训练时对每个档位都施加监督信号。推理时可按设备算力选择档位,无需部署多个独立模型。
本文把'一套参数多个尺寸'的思想引入 MoE,并用活跃规模 embedding 和 batch replication 解决多档共训时的欠拟合问题。
分组查询注意力(GQA)
GQA 让多个 query 注意力头共享较少数量的 KV 头,在保持注意力质量的同时减少 KV cache 的显存与带宽占用,是现代 LLM 的标准配置。本文模型使用 12 个 query 头和 12 个 KV 头的 GQA,模型维度 1536。
阅读架构超参数部分(层数、头数、维度)时需要知道注意力的具体实现,才能正确估算各档位的参数分布。
研究动机
大语言模型的推理成本已成为与训练同级的瓶颈。稀疏 MoE 让每个 token 只激活少数专家,但路由是逐 token 逐层进行的:每个解码步激活的专家集合都在变化,在 DRAM 受限的边缘设备上,系统必须不断把专家权重在磁盘与内存之间换入换出,本该计算受限的负载退化为 I/O 受限——因为磁盘到 DRAM 的带宽远低于加速器的算术吞吐。IFP 用一个额外的剪枝模型按 query 一次性选定子网络来规避 I/O,但带来四个新问题:需要训练和维护单独的 pruner 模型;在 hidden dimension 粒度生成掩码导致搜索空间爆炸、无法用稀疏 GEMM、mask predictor 规模失控;用户无法在推理时用输出质量换取推理速度;且只能从稠密模型 upcycle,无法从头预训练。
本文的目标是本文目标是构建一个统一的弹性稀疏架构,让单一模型同时适应部署约束与任务需求:用户可在推理时从同一个 12B 总参检查点中选择 1B、2B、3B、4B 四档激活参数量,按设备的 DRAM 和算力灵活权衡精度与延迟;同时消除传统 MoE 逐 token 换专家的 I/O 瓶颈,使各档位延迟接近同等计算量的 dense 模型;精度上要求超过同激活量的 dense 基线(知识密集型基准提升 2-5%),并尽可能逼近 vanilla MoE 的精度上界;最终在磁盘上只需存储一份共享参数,降低多尺寸模型的训练与部署技术债。
与已有工作不同的是,已有工作把弹性部署与稀疏激活当作两条独立路线:slimmable/Matformer 等弹性网络支持多尺寸但无输入自适应路由;MoE 有输入自适应但稀疏度固定且 I/O 昂贵;IFP 解决了 I/O 但粒度过细、需要独立剪枝器且不能从头训练。本文的独特切入是把三者统一进一个模型:用模型自身的前几层 dense 层充当专家选择器(无需额外 pruner);把剪枝粒度从 hidden dimension 粗化为 FFN expert 块;以 S 个 token 为段刷新全层专家选择,在 IFP 的'整 query 固定'与 MoE 的'每 token 变化'之间取得可调平衡;并用活跃规模 embedding 让同一模型感知当前稀疏档位,从而支持从头预训练和多档推理。
核心方法
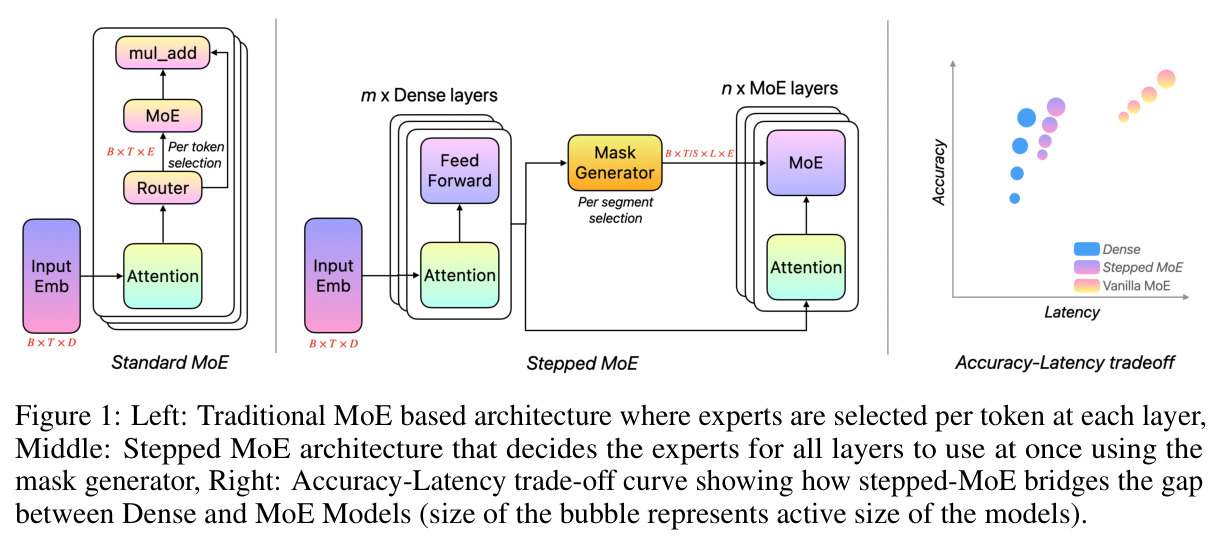
直觉上,作者把 56 层 transformer 劈成两段:前 12 层保持 dense,既负责理解上下文,又兼任'路由大脑';后 44 层换成 MoE 层(212 个专家、专家隐维 256、模型维度 1536、GQA 12 头)。mask generator 读取 dense 部分的输出 $z \in \mathbb{R}^{B \times T \times D}$,为后续每层生成路由 logits $g \in \mathbb{R}^{B \times T/S \times L \times E}$,经 SoftTopK 选出 top-$k$ 个专家得到 $\{0,1\}$ 掩码,每 $S$ 个 token 刷新一次。可学习的活跃规模 embedding $W_{k_i}$ 按当前预算加到词嵌入上($h_0 = \text{TokenEmb}(x) + W_{k_i}$),显式告知模型目标稀疏档位。推理时 dense 部分常驻 DRAM,所有层的专家一次选定,后层专家可在前层执行时异步从磁盘预取,实现计算与 I/O 重叠。
核心创新是与 IFP 的三点本质区别。其一,不训练独立的剪枝网络,而是复用模型自身 dense 前缀层的表征来生成专家掩码,路由与主干共享参数、联合优化,省去二次训练与部署开销。其二,把掩码粒度从 IFP 的 hidden dimension(数千维行/列)粗化为 FFN expert 块(每层 212 个专家),搜索空间大幅缩小且可用稀疏 GEMM 加速;段级掩码使掩码生成本身成为模型的一部分而非外挂预测器,这是能从头预训练的关键。其三,专家每 $S$ 步切换一次且所有 MoE 层一次选定,在 IFP'整 query 冻结子网导致质量下降'与 MoE'每 token 换专家导致 I/O 爆炸'之间取得可配置折中,并使 $k$ 成为运行时可调参数,单一模型覆盖 1-4B 四档激活规模。
方法步骤详情
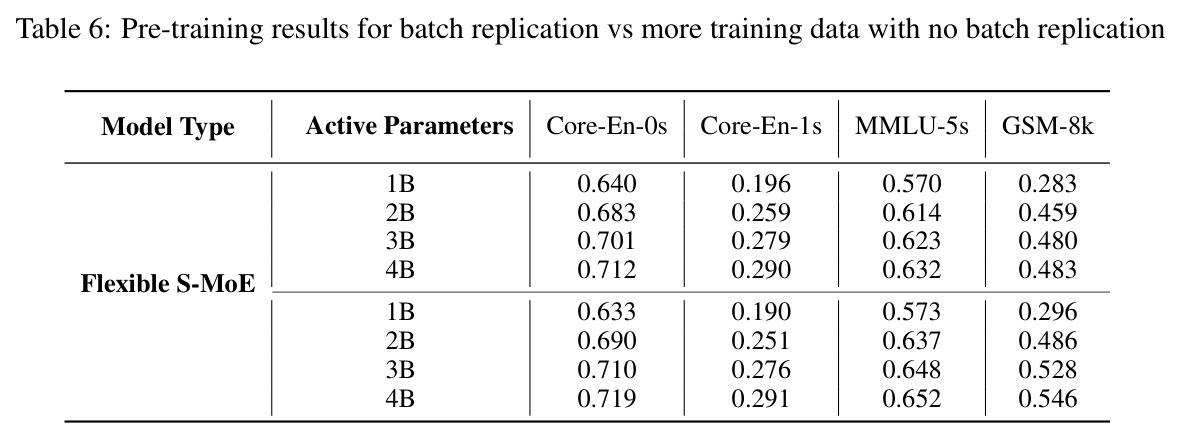
流程分三阶段。预训练:长度 $T$ 的 token 流经 12 层 dense 主干;按段长 $S$ 切分,用每段首个位置表征决定该段在全部 44 个 MoE 层的专家掩码(SoftTopK 可微 top-$k$);batch 内每样本复制 $n=4$ 份并分别赋予 1B/2B/3B/4B 的规模 embedding;损失 $\mathcal{L} = \frac{1}{nB}\sum_i \alpha_i \sum_j \text{CE}(y_j, f(W_i, x_j))$,$W_1 \subset W_2$ 表示稀疏配置权重是稠密配置的子集,$\alpha_i$ 对更稠密配置加权以补偿更新信号稀疏。SFT:短样本拼接至 16k、仅对目标 token 计损失、prompt 末 token 为 prompt 与第一响应段选专家、其后每段首 token 刷新保持因果性。推理:dense 部分常驻 DRAM,按设备容量选活跃规模,prompt 末 token 选定首批专家,每 $S$ 步刷新,后层专家异步预取。预训练 1T token、上下文 8192、batch 2048×4 复制。
技术新颖性
技术新颖性体现在四个层面。架构上:'dense 前缀兼任路由器'的方案在 MoE 文献中少见——DeepSeekMoE 的共享专家仍逐 token 路由,而这里路由信号是段级的、跨所有层一次性产生的,天然支持计算与 I/O 流水线并行。优化上:作者指出数学上更正确的做法是对低频激活专家使用不同学习率,但实现复杂,故用稀疏度损失缩放 $\alpha_i$ 作简化代理,并配合 batch replication、加权 CE、活跃规模 embedding 三件套系统性弥补'一套参数训四个模型'的欠拟合。可微性上:SoftTopK 让排序选择端到端可导,掩码生成与下一词预测联合训练,突破了 IFP 只能 upcycle 的限制。工程上:全部层专家一次选定使后层权重可与前层计算重叠加载,这是延迟曲线平坦的直接原因;段长 $S$ 被明确定位为可配置超参而非固定设计。
实验结果
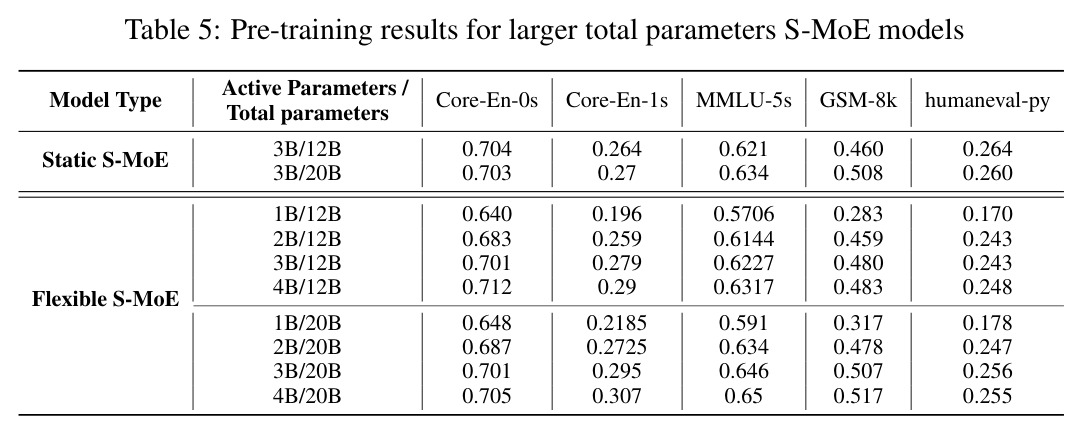
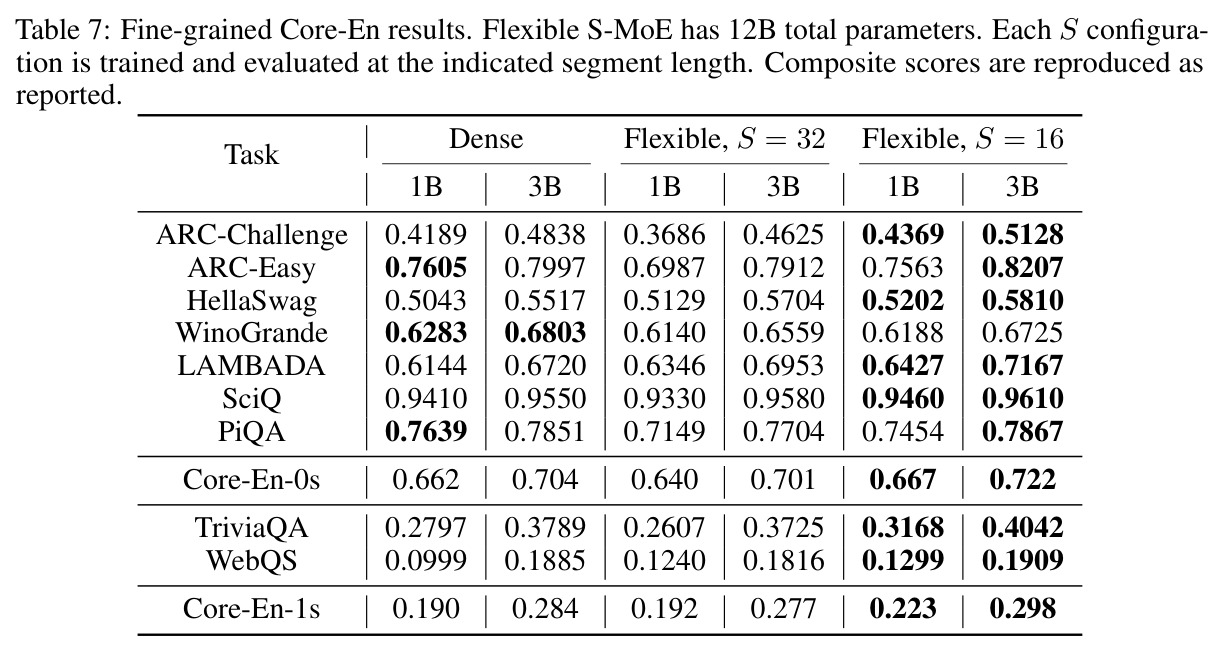
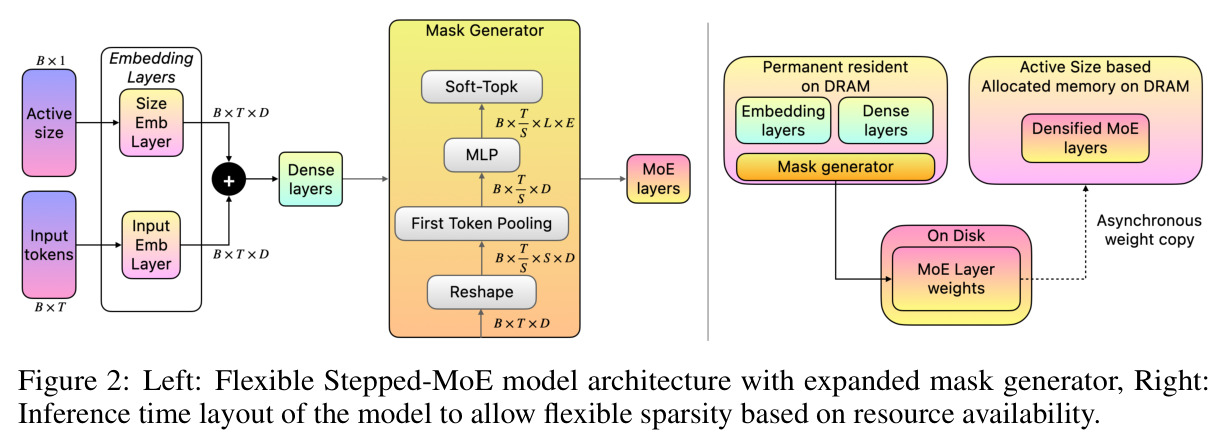
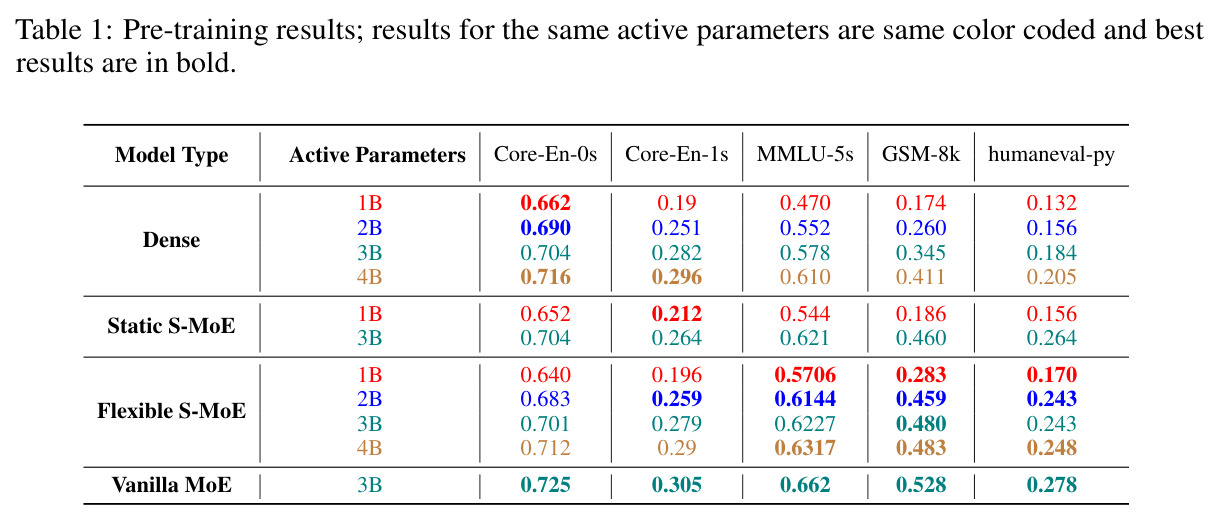
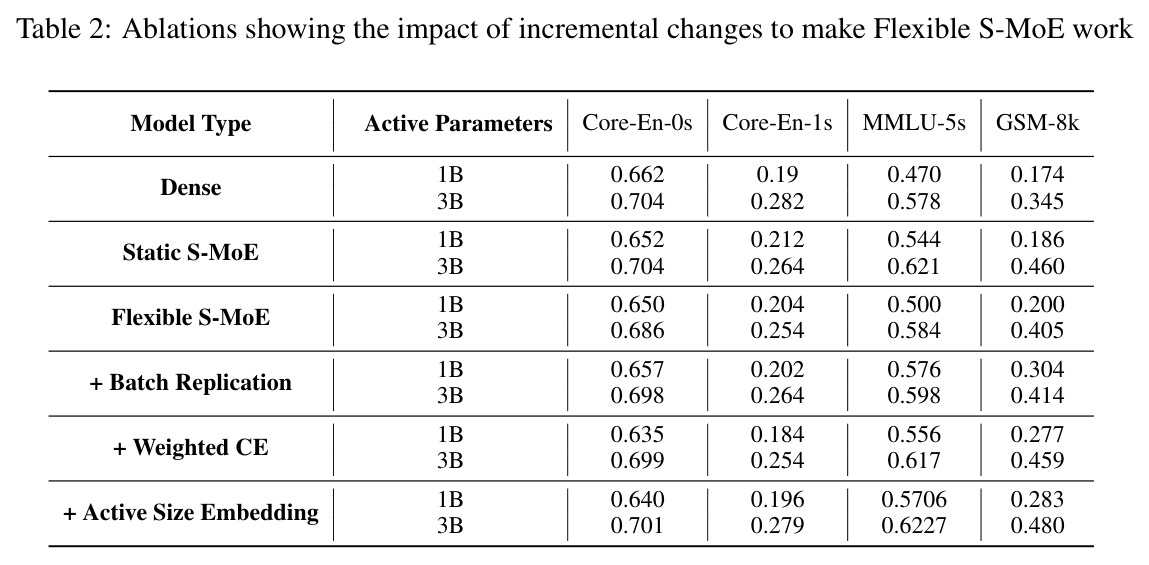
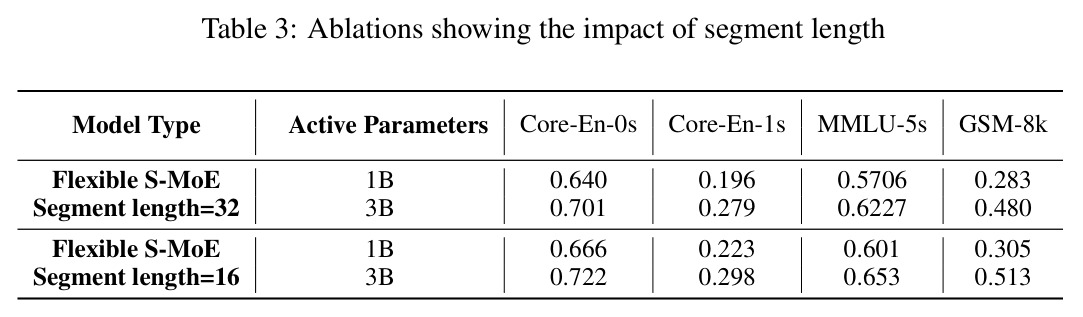
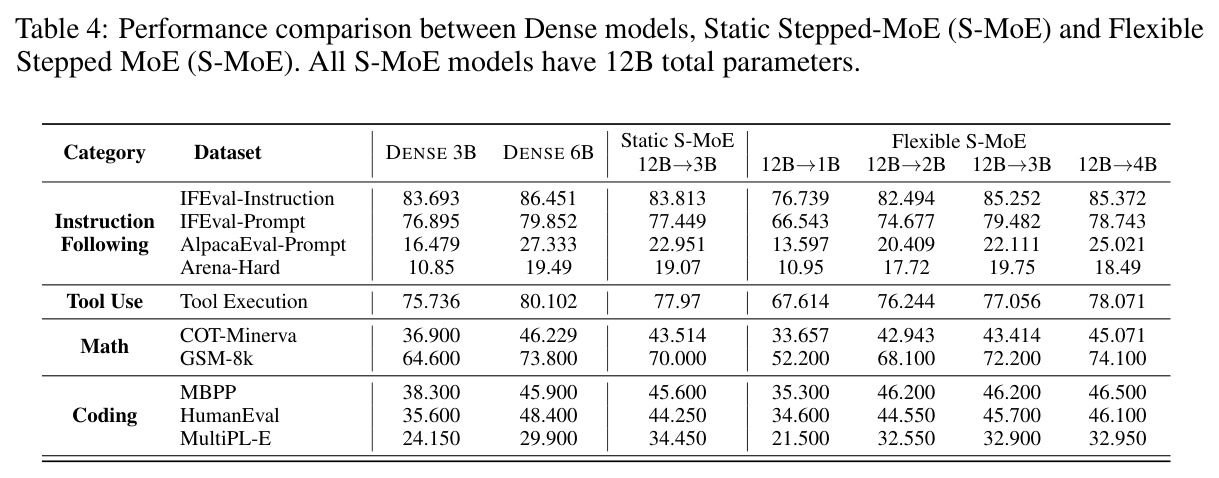
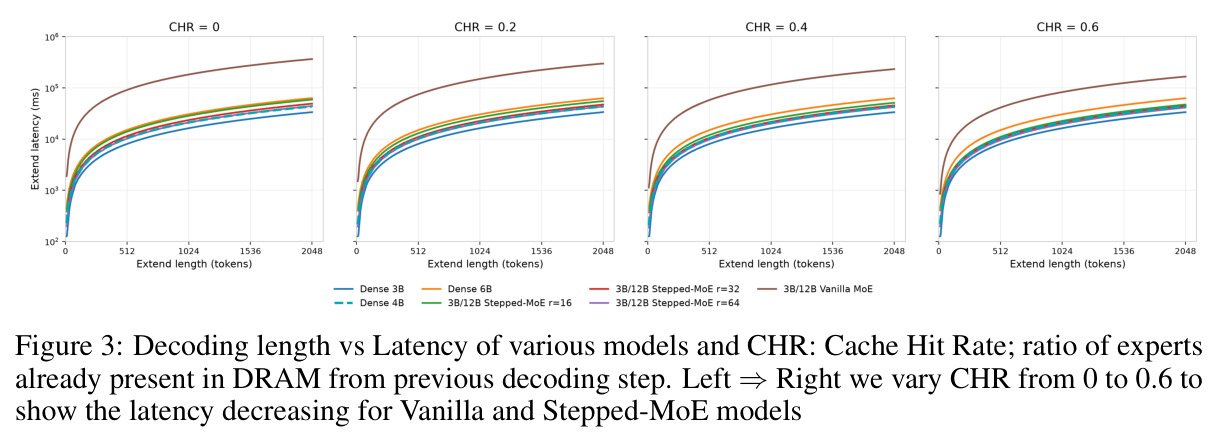
预训练(Table 1):Flexible S-MoE 多数档位超同激活量 dense——3B 档 MMLU 0.6227 对 0.578、GSM8K 0.480 对 0.345;唯 1B 档 Core-En-0s 落后(0.640 对 0.662),因 12 层 dense 开销层占其 21% 层数。Vanilla MoE 全面领先(MMLU 0.662)。消融(Table 2):Static→Flexible 使 3B MMLU 0.621→0.584;加 batch replication 回升 0.598,加权 CE 0.617,活跃规模 embedding 0.6227,反超 static。段长(Table 3):S=16 全面优于 S=32。SFT(Table 4):12B→4B 的 IFEval 85.372 超 Dense 3B 83.693,GSM8K 74.1 对 64.6,接近 Dense 6B;12B→1B 偏弱(GSM8K 52.2)。推理(Figure 3):各 CHR 下 vanilla MoE 延迟指数级高于 dense,Stepped-MoE 平坦,紧贴 3B dense 且快于 6B dense。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 知识理解(预训练) | MMLU 5-shot 准确率 | Flexible S-MoE 3B 活跃 0.6227,4B 活跃 0.6317 | Dense 3B 0.578,Dense 4B 0.610 | +4.5pp / +2.2pp(Vanilla MoE 上界 0.662) |
| 数学推理(预训练) | GSM8K 8-shot 精确匹配 | 3B 活跃 0.480 | Dense 3B 0.345,Vanilla MoE 3B 0.528 | +13.5pp(距上界 -4.8pp) |
| 代码生成(预训练) | HumanEval-python pass@1 | 3B 活跃 0.243 | Dense 3B 0.184,Vanilla MoE 3B 0.278 | +5.9pp |
| 指令跟随(SFT 后) | IFEval-Instruction 准确率 | 12B→4B 85.372 | Dense 3B 83.693,Dense 6B 86.451 | +1.7pp,接近 6B dense |
| 数学(SFT 后) | GSM8K 8-shot | 12B→4B 74.1 | Dense 3B 64.6,Dense 6B 73.8 | +9.5pp,超过 6B dense |
| 代码(SFT 后) | HumanEval pass@1 | 12B→4B 46.1 | Dense 3B 35.6,Dense 6B 48.4 | +10.5pp(略低于 6B dense) |
| 边缘设备推理延迟 | NPU 模拟器解码延迟(CHR 0→0.6) | Stepped-MoE 延迟平坦,紧贴 3B dense,快于 6B dense | Vanilla MoE 延迟指数级更高 | 大幅降低且对缓存命中率不敏感 |
局限与改进
作者承认的局限:未验证更长训练时间下的表现,预计 vanilla MoE 与 Stepped-MoE 的差距会随训练时长扩大;attention 参数被所有活跃档位共享,训练更久后可能饱和大尺寸模型的上限,作者建议用 early exiting 缓解;预训练 FLOPs 折算后约等于训练 4 个 dense 模型,训练配方有待优化。我的补充观察:与 vanilla MoE 的精度差距系统性存在(3B 档 MMLU 差 4pp、GSM8K 差 4.8pp),说明段级路由的表征损失是本质性的;12B→1B 档 SFT 后明显偏弱(GSM8K 仅 52.2,低于 dense 3B 的 64.6),最小档位价值存疑;段长消融只测了 16 和 32 两个点,最优工作区不明确;延迟结论来自 NPU 模拟器而非真实硬件,NAND 带宽建模假设的稳健性未验证;架构超参(212 专家、段长等)来自小规模实验,作者自己承认扩展到其他规模时可能改变。
独立分析的弱点
独立分析的弱点:第一,1B 档性价比低——12 层 dense 前缀占 21% 层数成为固定成本,1B 档 Core-En-0s 反而低于 dense,SFT 后 GSM8K 仅 52.2,改进方向是为小档位引入早退或允许小档共享更少 dense 层。第二,路由信号的因果性折中——SFT 用 prompt 末 token 决定整个 prompt 的专家、预训练用段首 token,这使掩码对段内上下文变化不敏感,长文档后段语义漂移时可能选错专家,可引入轻量的段内增量路由。第三,段长是全局静态超参,Table 3 显示 S=16 精度更高但 I/O 压力更大,理想方案是按设备带宽自适应或按上下文复杂度动态调整 $S$。第四,训练成本高——batch replication 使有效 batch 扩大 4 倍,训练 FLOPs 约等于 4 个 dense 模型,与'单模型省成本'的卖点部分抵消,可用课程式逐步增加档位来缓解。第五,评估全部在 Apple 内部数据与私有 SFT 混合上进行,缺乏与开源弹性 MoE(如 Matformer)的横向对比。
未来方向
作者提出的方向:引入 early exiting 让小激活模型提前退出,以突破 attention 参数共享带来的大档位精度瓶颈;让段长随上下文动态变化,在精度与 I/O 压力间自适应;扩展到更大的总参和激活规模观察 scaling trend,并评估该方法在服务器级模型上的可行性以缓解服务端 DRAM 需求;优化预训练配方以降低多档训练的 FLOPs 开销。基于其成果可延伸的方向:与量化结合,探索专家粒度的混合精度;把段级路由与 speculative decoding 或连续批处理结合,进一步压低真实设备延迟;研究掩码生成器的跨请求缓存策略(同 session 多轮对话复用专家集合);在真实手机/NPU 硬件上复现 Figure 3 的 profiling 并测量端到端首 token 延迟;以及把活跃规模 embedding 推广为连续标量,实现任意预算插值而非离散四档。
复现评估
复现评估:不乐观。这是 Apple 的预印本,未开源代码、权重、预训练语料与 SFT 数据配方(只给出比例:35% 指令跟随、20% 多语言、20% 数学、10% 代码、10% 工具、5% 安全及其他)。训练基于内部 AXLearn 框架和 JAX,用 1T token、上下文 8192、有效 batch 8192(2048×4 复制)、解耦权重衰减与简化 µParam 优化器,完整复现需要大规模 TPU 级集群,成本极高。可行性路径:论文对方法描述相当完整——损失公式(式 1-3)、段级掩码机制、SoftTopK、活跃规模 embedding、SFT 的因果性处理都写得很具体,架构超参(56 层、12 层 dense、1536 维、212 专家、专家隐维 256、GQA 12 头)齐全,可以在 100M-500M 级小模型上验证方法有效性;Table 2/3 的消融设计也可独立重跑。评估基准(ARC、HellaSwag、MMLU、GSM8K、HumanEval 等)均公开可用。综合判断:方法思路可部分复现验证,完整规模复现对学术界不现实。
论文图表