BI-Agent 与 BI-Bench:迈向端到端商业智能自动化 BI-Agent and BI-Bench: Towards Automating End-to-End Business Intelligence
首个端到端 BI 基准与工具增强加后训练的智能体,8B 小模型比肩前沿大模型
前置知识
端到端 BI 工作流
商业智能(BI)软件(如 Power BI、Tableau,全球超 10 万组织在用)帮用户用仪表盘做数据决策。传统流程固定四步:S1 检索相关表、S2 用专有 DSL 或 GUI 做数据变换、S3 定义表间连接关系、S4 才能查询分析与可视化。每步都需数据库与编程知识,对非技术用户是主要痛点。
本文定义的'端到端 BI'问题就是把这四步全部自动化,理解该人工流程是理解 BI-Bench 为何这样设计、BI-Agent 为何恰好提供 search/transform/join/analysis 四类能力的前提。
NL2SQL 与 BIRD/Spider 基准
NL2SQL 任务把自然语言问题翻译成 SQL,通常假设输入表已经清洗好、连接关系已建好,只覆盖数据分析这最后一步。BIRD 和 Spider(2.0)是该领域最权威的公开基准,榜首开源模型在 BIRD 上准确率已超 70%,常被当作'NL2SQL 已接近解决'的证据。
本文的核心对照就是:这些在 BIRD 上超 70% 的系统,搬到真实端到端 BI 场景后跌到 6%–26%。理解其设定差异(表是否就绪)才能体会 BI-Bench 补的这块空白。
表重塑变换与关系化
电子表格常见的透视表把月份等取值铺成列标题,形成'非关系'的交叉表,无法直接按月连接或聚合。unpivot、pivot、transpose、wide-to-long 等算子可把表还原成行列同质的规范关系表,这一过程称'关系化',属表级重塑变换,区别于逐行的过滤/字符串/算术变换。
这是 LLM 在本文中最大的失败点之一——模型既难识别需要重塑,也难正确执行(SQL 甚至没有原生算子)。transform 工具和大量实验都围绕它展开。
星型/雪花模式与连接预测
数据仓库中事实表居中、维表经外键环绕的星型/雪花/星座模式是 BI 项目典型结构。连接预测算法基于全表值重叠度等统计特征或全局模式结构,自动推断两表应按哪些列连接,结构感知方法在复杂模式上明显更准。
BI 项目平均含 12.75 条连接关系(最多 94 条),代理键取值相近极易误连,而 LLM 只能看到每表少量采样行、算不出全表值重叠,join 工具正是把这些经典算法接给模型用。
SFT 与 RLVR/GRPO
监督微调(SFT)在教师模型示范轨迹上做逐轮交叉熵训练;可验证奖励强化学习(RLVR)用可自动校验的结果作奖励;GRPO 对同一任务采样 $K$ 条轨迹,以组内 z-score $A_i = (r_i - \mu)/\sigma$ 为优势,并用 clip 约束策略更新幅度。
论文后训练框架一半是'执行校验通过才保留'的 SFT 蒸馏,一半是带部分得分与语法惩罚奖励的 GRPO;不懂这套术语就无法读懂 5.2 节的奖励设计和训练流程。
结果表匹配评测协议
判定正确要求输出表 $\hat{R}$ 与真值表 $R$ 形状一致(保证聚合粒度)且逐格相等,允许行列置换;数值经格式归一后用 np.isclose(rtol=1e-2, atol=0.5) 容差判等,None/NaN/空串统一视为缺失。同一查询可配多个语义等价真值兜底。
BI-Bench 的准确率指标和 RL 的可验证奖励都建立在 match($\hat{R}, R$) 之上,指标细节(粒度、容差、缺失值)直接决定实验结论与奖励信号是否可信。
研究动机
商业智能是数十亿美元规模的产业,Power BI 与 Tableau 被超过 10 万家组织用于日常决策。但传统 BI 工作流要求非技术用户先完成繁琐的数据准备:从平均 10.6 张(最多 52 张)、最多超 700 万行的原始表里挑出相关表;在专有 DSL(如 Power Query M)里编写行到行变换和透视表重塑;再为平均 12.75 条(最多 94 条)连接关系手工建模,其中代理键取值相近、极易误连;之后才谈得上分析。现有 NL2SQL 基准(BIRD、Spider)默认表已清洗、连接已建好,只覆盖最后一步分析;前沿 LLM 直接用 SQL 解端到端 BI 问题时准确率全部不足 50%(最好的 o4-mini 仅 48.2%),BIRD 榜首开源系统在真实 BI 数据上跌到 6%–17.3%。准备环节这个'最后一公里之前'的巨大鸿沟一直缺乏系统研究和评测。
本文的目标是本文目标是用 LLM 自动化'从原始表到答案'的完整 BI 流程,分三层推进。其一,构建第一个端到端 BI 基准 BI-Bench:从公开渠道爬取 3000 多个真实 Power BI 项目(.pbix 文件),从用户自建仪表盘中人工抽取并校验 100 对(业务问题 $q$,真值结果表 $R$),每条都配多个语义等价的真值以容忍合理的模式差异。其二,系统评测 24 个模型与系统(前沿闭源、开源 LLM、NL2SQL 系统、编码智能体),量化 LLM 在检索、变换、连接、分析各环节的能力边界。其三,提出 BI-Agent 框架:把数据管理社区成熟的搜索、变换、连接算法封装为智能体工具供 LLM 调用,并开发一套面向 BI 领域的训练轨迹自动合成方法,用 SFT 与 RL 后训练开源小模型,在大幅提升精度的同时把成本压到前沿模型的几十分之一。
与已有工作不同的是,已有工作的切入角度要么是纯 NL2SQL(假设数据就绪),要么是 Jupyter/科学文献风格的数据科学智能体(DSBench、DA-Code、KramaBench、REPRO-Bench 等),没有一条针对 BI 特有的挑战:半结构化透视表需要整表重塑、雪花式模式加代理键使连接预测困难、项目表多且大(极端案例一条查询要联合推理 38 张表)。本文的独特之处有三:一是评测数据完全取自真实用户仪表盘及其导出结果表,而非 LLM 合成查询,保真度高;二是把数据管理领域几十年积累的专用算法(变换预测、结构感知连接预测、表搜索)'工具化',与 LLM 推理循环做系统级协同设计,而不是让模型裸写代码硬扛;三是首次证明工具增强与领域后训练的增益可以叠加——8B 模型经 SFT+RL 后可比肩远大于自己的前沿模型,且收益能迁移到域外任务。
核心方法
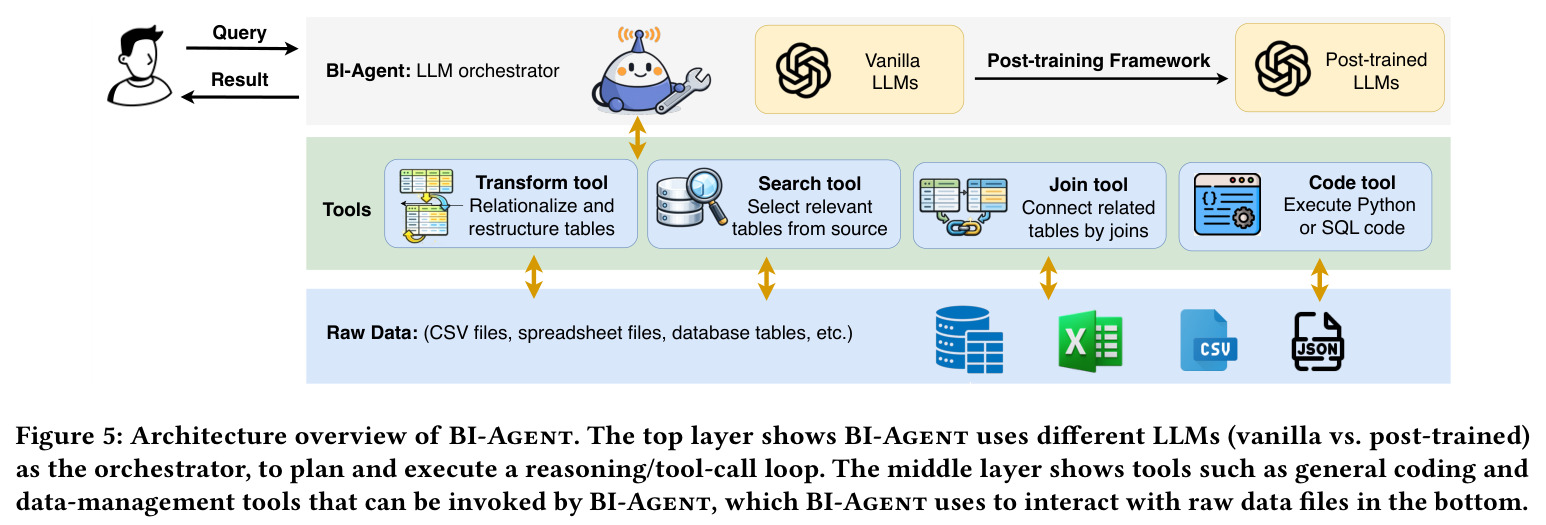
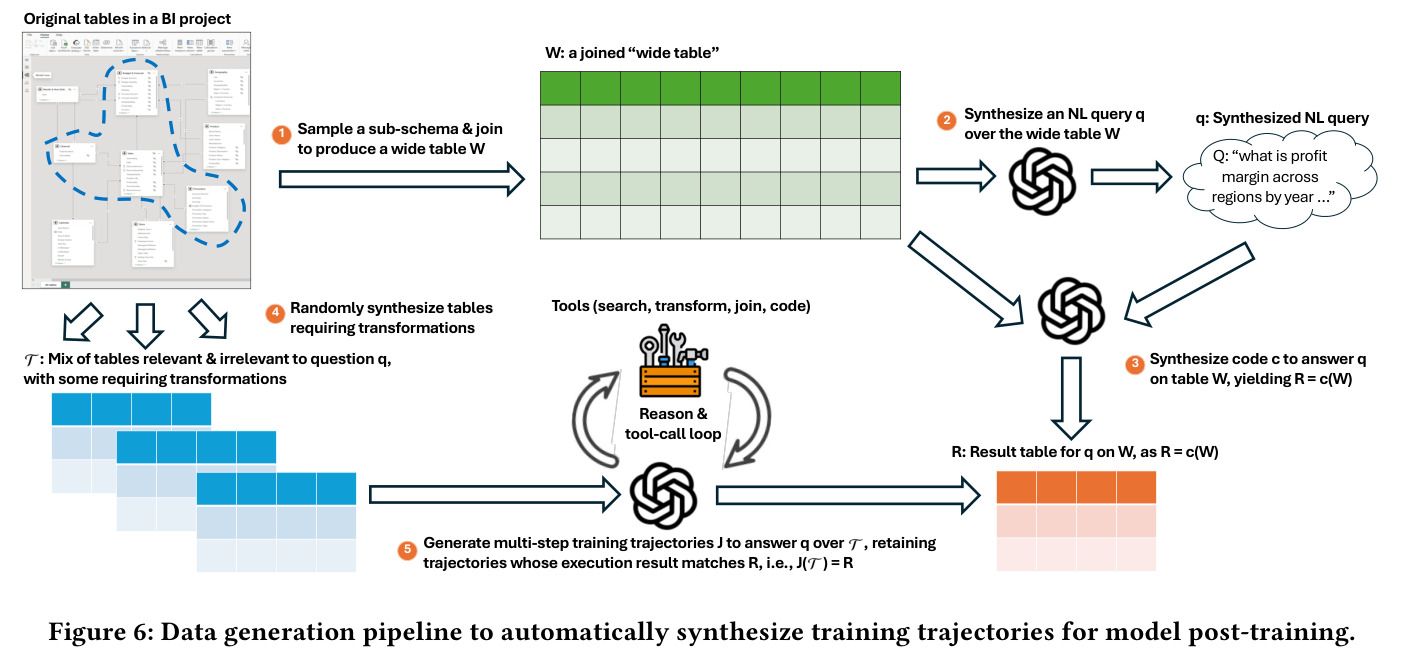
方法分'基准+智能体+后训练'三部分。直觉上:LLM 擅长理解业务问题与生成分析代码,但不擅长在脏表上做需要全局视野的数据管理决策,因此应把后者交给专用算法。BI-Agent 采用推理-工具调用循环架构(Figure 5):顶层是可替换的 LLM 编排器(原始或后训练模型均可);中层是四类工具——通用代码工具(执行 Python/SQL 并缓存变量)、transform 工具(用变换预测算法检测并施加 pivot/unpivot/transpose 等重塑)、join 工具(用面向雪花模式优化的连接预测算法返回候选连接)、search 工具(保守筛选与问题相关的表);底层是 CSV、电子表格、数据库等原始数据。后训练框架则自动合成训练任务:从真实项目的连接图采样子模式拼成宽表 $W$,让 LLM 在 $W$ 上合成查询 $q$ 与代码 $c$,执行得 $R = c(W)$;再混入无关表、施加逆重塑变换造出'脏'输入 $\mathbb{T}$,保留能精确复现 $R$ 的教师轨迹做 SFT,或以 $R$ 为可验证奖励做 GRPO 强化学习。
核心创新是'把难的数据管理步骤从 LLM 卸载给专用算法,再用可执行校验的合成数据教会小模型使用这些工具'。与已有方法的本质区别:NL2SQL 智能体只优化最后一步 SQL 生成,假设输入已是规范关系表;通用数据分析智能体给一个代码解释器就放手不管。BI-Agent 则针对 BI 的每种失败模式逐一配工具——LLM 缺乏表结构全局观就上 transform 工具、大表上算不出值重叠就上基于全表统计与全局模式结构的 join 工具、注意力被大量无关表稀释就上 search 工具。训练数据侧的妙处在于'先拼宽表再拆脏':在宽表 $W$ 上生成代码极易保证正确,从而自动获得可验证的 $(q, \mathbb{T}, R)$ 三元组和教师轨迹,全程零人工标注。奖励函数对'返回了表但不对'给部分分 $-0.5$、对产生语法错误的迭代罚 $-0.1n$,在早期几乎全错、奖励极稀疏的长视野任务里提供致密学习信号。工具增益与后训练增益被证明互补叠加。
方法步骤详情
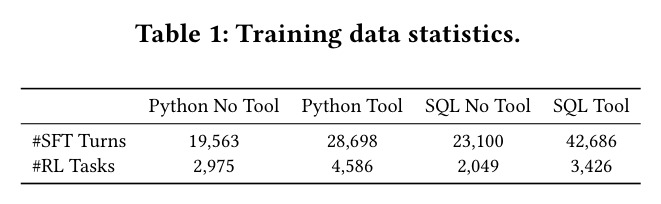
基准构建:爬取 3000+ 个公开 .pbix 项目,用 DAX-studio 与 RPA 抽取变换脚本、连接关系和仪表盘;随机采样语义清晰的可视化,把标题改写成自然语言查询 $q$(补全隐含过滤条件);经'导出数据'得到真值 $R$。人工复核叠加 LLM 交叉验证:前沿模型 10 次都做不对的 23.1% 案例触发复查,其中 14.4% 修复了抽取错误、5.2% 因歧义弃用,并增补语义等价真值,最终 100 条、耗时 400+ 人时。智能体执行:编排器先调 transform 检测并施加重塑,再调 search 筛相关表,然后调 join 获得连接列表,最后用代码工具迭代分析直到产出 $R$。数据合成:从连接图采样子模式拼宽表 $W$,LLM 生成 $q$ 与 $c$,执行得 $R = c(W)$,混入无关表并施加逆变换得 $\mathbb{T}$。GPT-4o 教师生成轨迹,仅保留执行结果精确等于 $R$ 者,切成逐轮 SFT 样本(四设置共 1.96 万–4.27 万轮)。2 张 H100 上 SFT 约 9 小时、RL 约 22 小时,总成本不足 200 美元。
技术新颖性
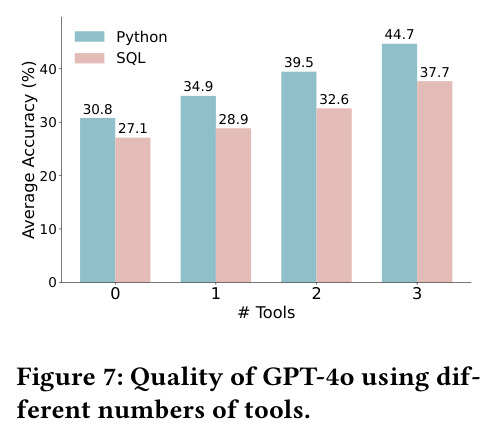
技术新颖性体现在四处。第一,基准层面:BI-Bench 是首个覆盖'检索-变换-连接-分析'全链条的 BI 评测,真值直接来自用户仪表盘导出,配套真值增补(同一查询允许多个语义等价的列组合)与双层防泄漏(项目级/表级去重,另有查询级相似度分离 $\rho = 99.72\%$、变换级仅 0.73% 越界的量化证明),这套方法论本身可复用。第二,系统层面:把变换预测、结构感知连接预测、表搜索等经典数据管理算法封装为工具接口,证明它们与 LLM 是互补而非替代关系,且工具之间存在'1+1>2'的协同——搜索缩小候选集让连接更准、变换规范化让分析更易,每加一个工具边际收益递增。第三,训练层面:'宽表合成+执行校验'把标注成本降为零,并首次展示工具使用与领域后训练的协同增益在域外任务(Spider 2.0)上依然成立。第四,奖励工程:消融显示去掉部分得分或语法惩罚,RL 都会退化到不如 SFT 初始化,说明面向长视野多步任务的奖励设计是成败关键。
实验结果
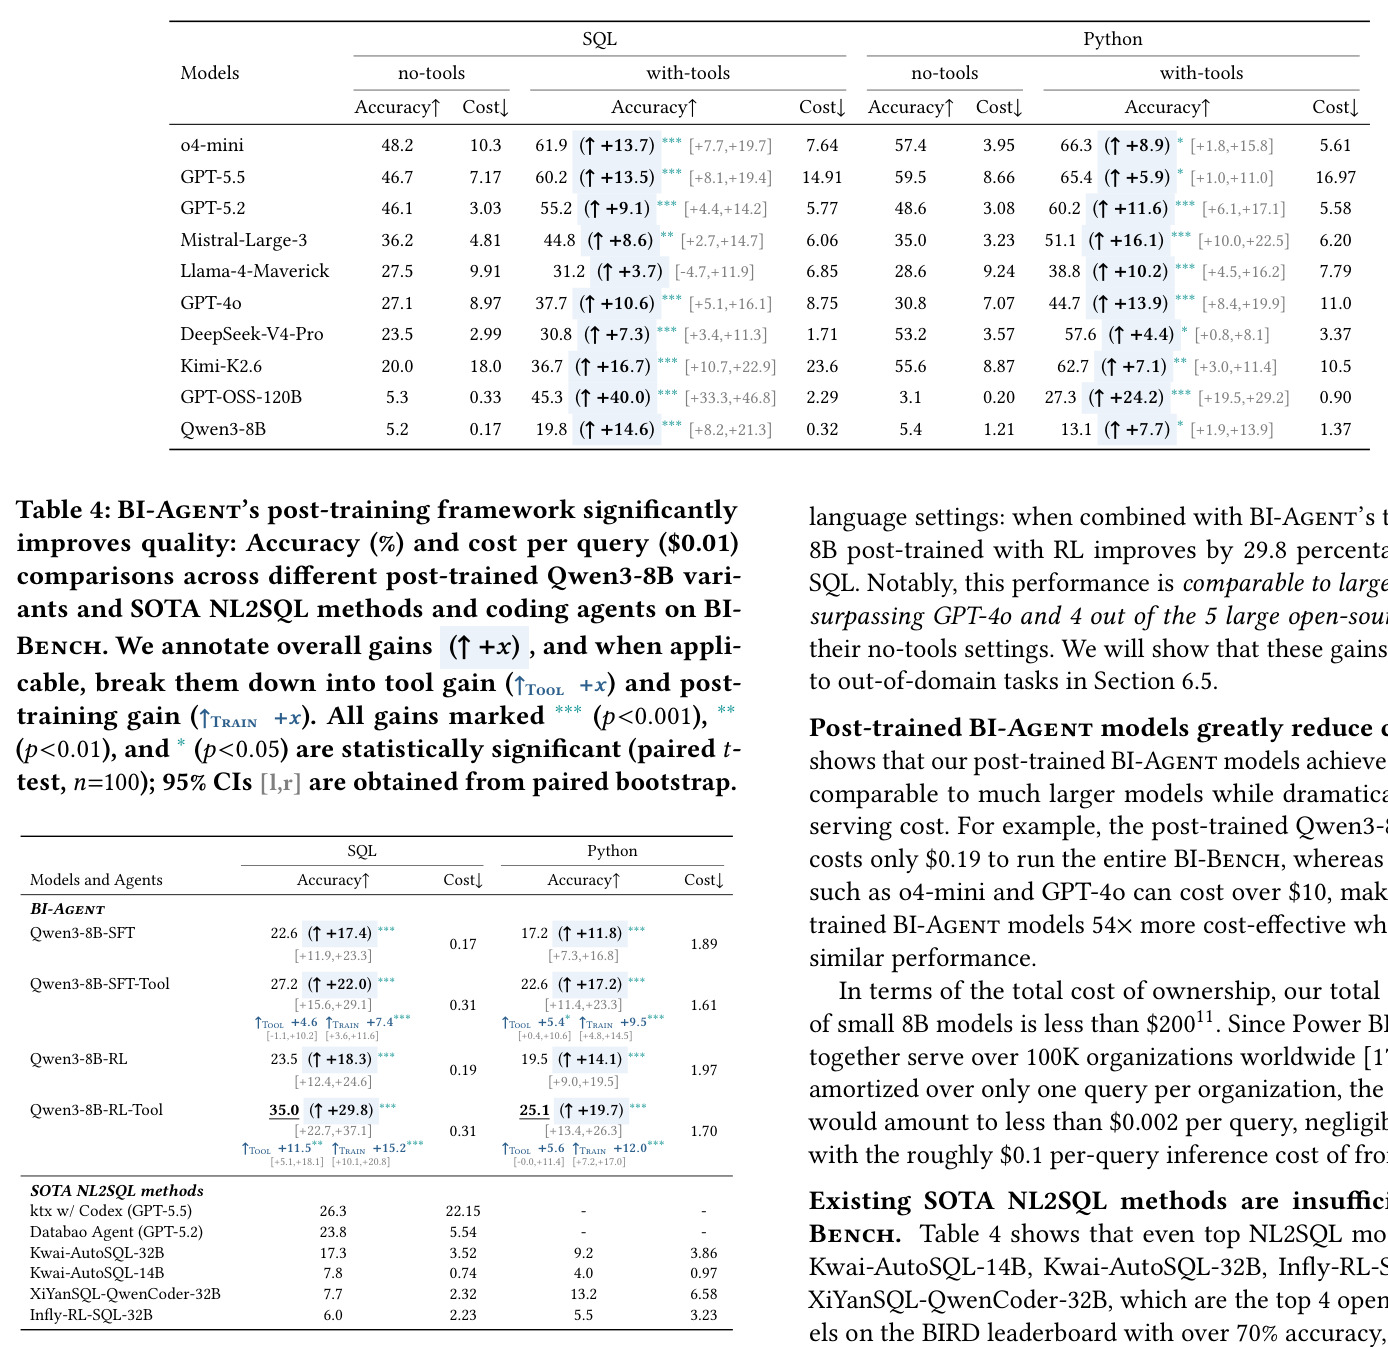
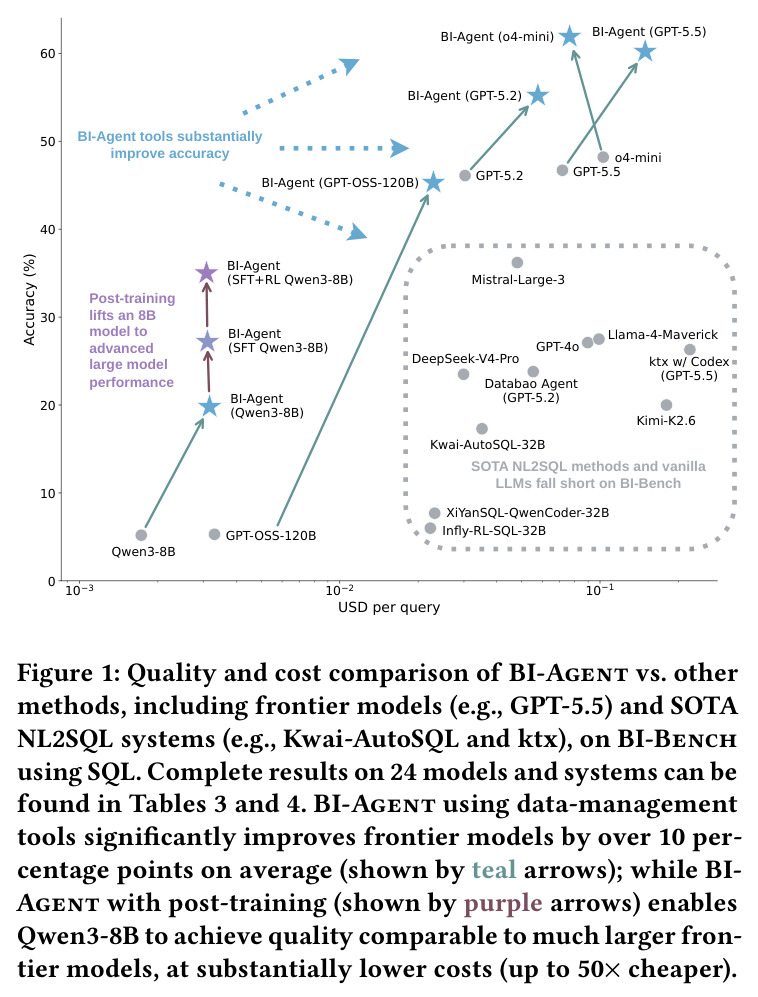
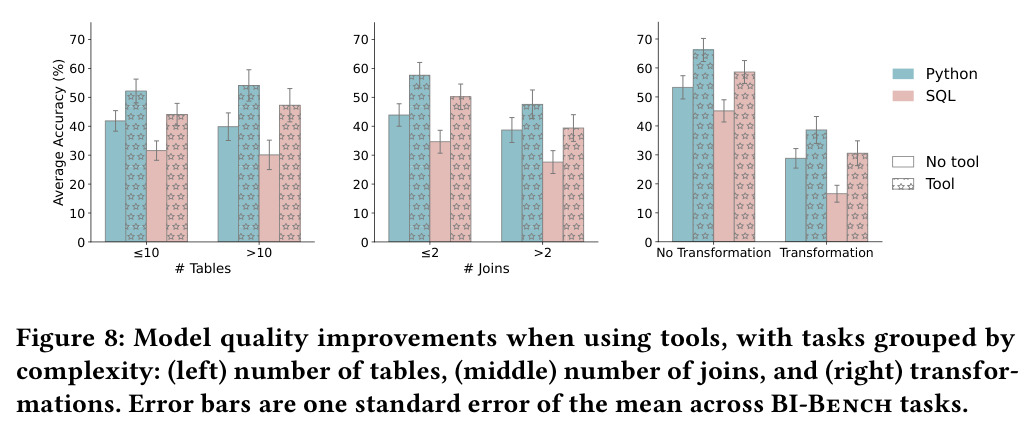
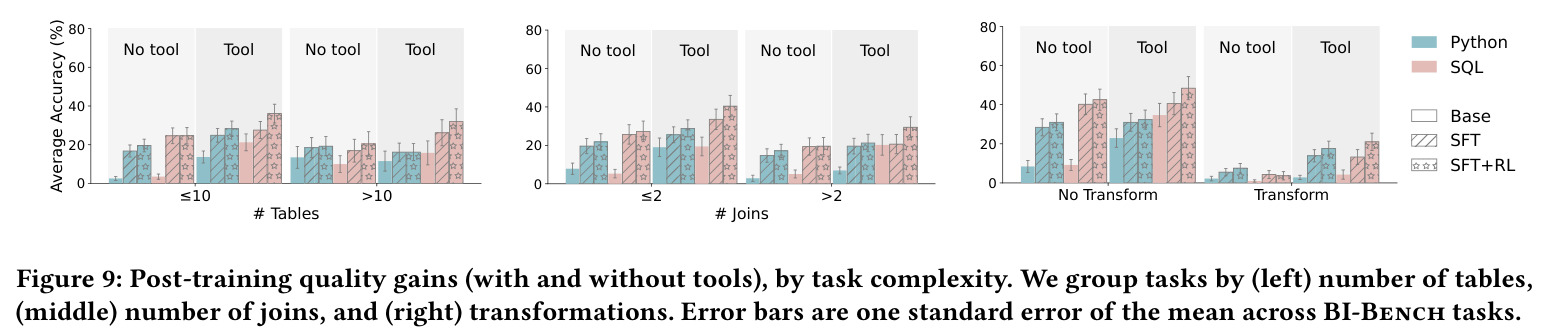
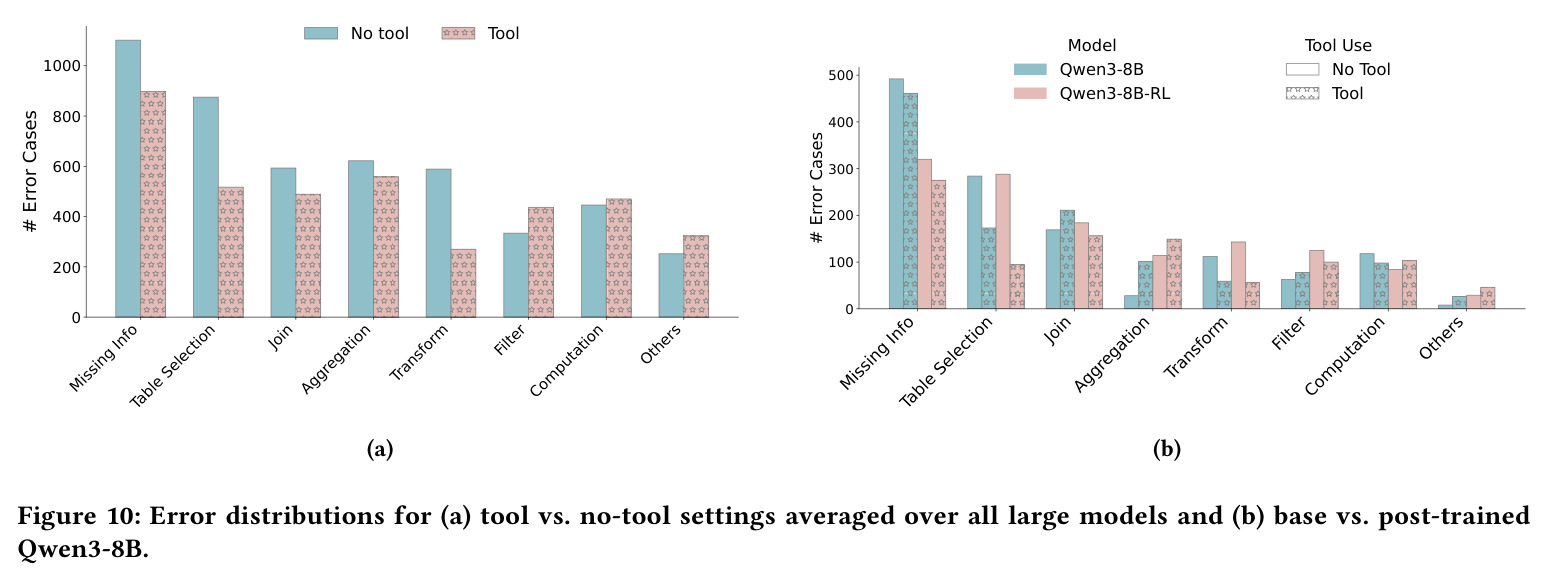
在 100 条 BI-Bench 查询上评测 24 个模型/系统(每设置重复 10 次并做配对显著性检验)。基线:最强的 o4-mini 裸 SQL 仅 48.2%,前沿模型全部低于 50%;BIRD 榜前四开源 NL2SQL 模型只有 6.0%–17.3%,Spider 2.0-lite 榜前二智能体也只有 26.3% 与 23.8%。工具增益:平均提升 SQL 14 个、Python 11 个百分点(19/20 组显著);GPT-OSS-120B 最猛,SQL 从 5.3% 升到 45.3%(+40.0)。后训练增益:Qwen3-8B-RL-Tool 在 SQL 下达 35.0%(较基线 5.2% 提升 +29.8,p<0.001),Python 下 25.1%,超过 GPT-4o 无工具水平及 5 个大开源模型中的 4 个。成本:其跑完整个基准仅 0.19 美元而 o4-mini/GPT-4o 超过 10 美元,性价比约 54 倍。错误上,工具使变换错误减 54.2%、选表错误减 40.9%,后训练再减选表 67%、变换 61%,但'信息缺失'仍是最大错误源。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端 BI,SQL + 数据管理工具(BI-Bench) | 准确率 (%) | BI-Agent + o4-mini:61.9 | o4-mini 裸 SQL(无专用工具):48.2 | +13.7 pp(p<0.001,95% CI [+7.7, +19.7]) |
| 端到端 BI,小模型 + 工具 + 后训练(BI-Bench, SQL) | 准确率 (%) | Qwen3-8B-RL-Tool:35.0 | Qwen3-8B 原始:5.2 | +29.8 pp(p<0.001),追平或超过 GPT-4o 无工具等大模型 |
| 端到端 BI,工具对弱编码强模型的修复(BI-Bench, SQL) | 准确率 (%) | GPT-OSS-120B + 工具:45.3 | GPT-OSS-120B 无工具:5.3 | +40.0 pp,约 8.5 倍(p<0.001) |
| SOTA NL2SQL 系统/智能体迁移到 BI-Bench(SQL) | 准确率 (%) | ktx w/ Codex (GPT-5.5):26.3;Databao Agent (GPT-5.2):23.8 | 同批系统在 Spider 2.0-lite 榜 >70%;BIRD 榜首开源模型 >70% | 为负迁移:在端到端 BI 上暴跌 45+ pp,凸显基准难度 |
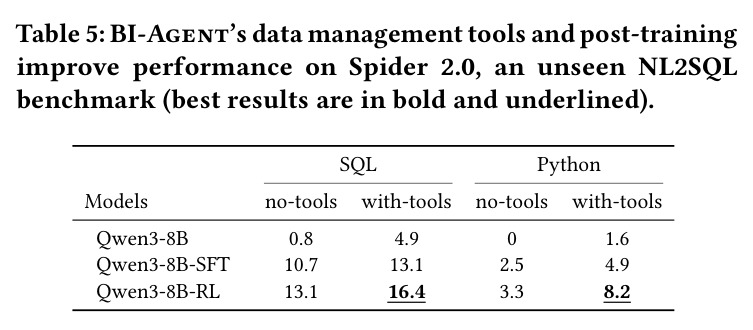
| 域外泛化:未见过的 NL2SQL 基准(Spider 2.0-lite, SQL+工具) | 准确率 (%) | Qwen3-8B-RL:16.4 | Qwen3-8B 原始:0.8 | 20.5 倍,证明 BI 领域后训练可迁移 |
| 成本:跑完整个 BI-Bench 的推理开销 | 美元/全基准 | Qwen3-8B-RL:0.19 美元(训练总成本 <200 美元) | o4-mini / GPT-4o:>10 美元 | 约 54 倍成本效益 |
局限与改进
作者承认的局限:BI-Bench 只有 100 条英文查询,虽与同类智能体基准(REPRO-Bench 112 条、KramaBench 104 条)规模相当,但统计功效有限,个别对比置信区间宽(如 Llama-4-Maverick 的 SQL 工具增益不显著);真值取自仪表盘导出,查询范围受限于用户做过的可视化,且只评结果表、不评可视化形式;评测假设单机 SQLite/CSV 本地执行,未覆盖云数仓与超大规模数据;'端到端'不含企业级 ETL、语义层建模与仪表盘搭建。我的补充观察:其一,错误分析显示'信息缺失'类错误在工具与后训练之后仍是最大来源,说明答案完整性问题并未解决;其二,工具依赖预测算法,一旦变换/连接预测错误会沿轨迹静默传播,框架缺少对工具输出的置信度提示或校验机制;其三,后训练仅在 Qwen3-8B 一个模型家族上验证,跨家族、跨规模的泛化未知;其四,奖励依赖可执行的真值表 $R$,难以直接迁移到没有确定性答案的开放式分析;其五,隐含过滤条件靠人工读可视化 DSL 补全,流程难以规模化扩展到数千条查询。
独立分析的弱点
弱点一:基准规模小且难度偏斜(最难题需 38 张表),100 条样本使中等模型间差异难以统计区分,可半自动扩充到千条量级并语义聚类去重。弱点二:信息缺失错误占比最高——模型常漏掉必要的行列或属性,而评测只在终局判对错,可加'答案完整性检查器'工具,对照查询谓词核对输出覆盖度并写入奖励。弱点三:工具错误静默传播:join/transform 预测不带置信度,错了模型往往照单全收,可让工具返回 top-k 候选及值重叠等支撑证据供模型复核。弱点四:后训练只试了 8B 一个规模、Qwen 一个家族,SFT 与 RL 的最优配比和缩放规律不明,应在 1.7B/14B/32B 及 Llama、Mistral 家族上重复实验。弱点五:SQL 缺少原生重塑算子,模型被迫写 UNION ALL 长链 workaround,可为 SQL 工具挂 UNPIVOT 方言扩展或在提示中注入方言支持。弱点六:评测要求精确表格匹配,语义等价但结构不同的答案仅靠人工增补真值兜底,可引入基于执行结果等价性或 LLM 评分的软匹配协议。
未来方向
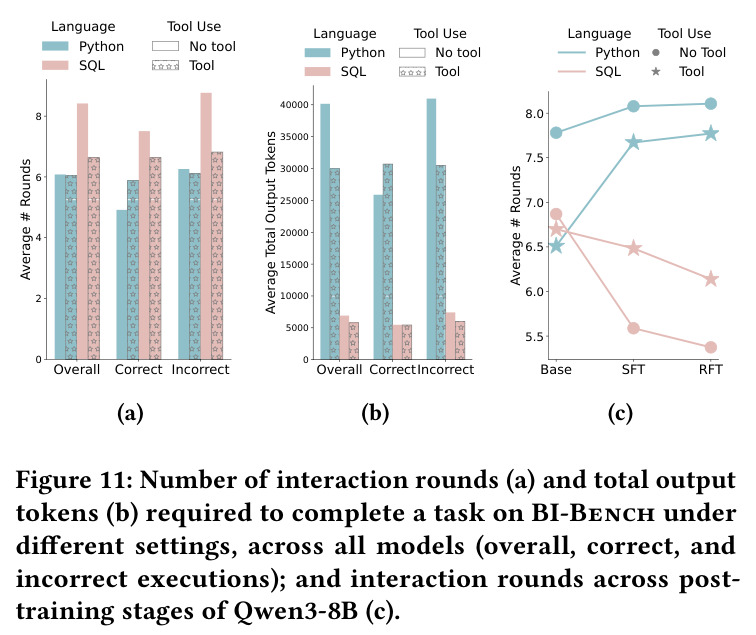
作者明确提出的方向:攻克占最大比例的'信息缺失'错误,让模型学会输出完整答案;现有四类工具并非穷尽,可继续纳入更多数据管理原语(如数据清洗、去重、缺失值填补——这些恰好对应错误分类中的 Deduplication/Missing-Value 类错误);以本文为跳板推动 LLM 驱动的 BI 走向实际应用。基于成果可延伸的方向:其一,交互式澄清——真实 BI 场景查询常有歧义(隐含过滤就是例证),可让智能体主动向用户确认过滤条件与聚合粒度;其二,从结果表走向可视化推荐与仪表盘生成,把'端到端'补完最后一环;其三,把'合成-执行校验-RL'范式迁移到 ETL 生成、数据清洗等相邻数据工程任务;其四,与企业语义层/指标层结合,让既有数据模型与 BI-Agent 工具互通;其五,奖励设计引入过程监督(对每步工具调用给中间奖励),进一步压低交互轮数(当前错误轨迹平均 7.1 轮 vs 正确 6.4 轮);其六,超 700 万行大表与流式数据上的工具效率优化,以及检索/建模/分析分工的多智能体架构。
复现评估
复现条件相当好。代码与数据已在 GitHub 开源(github.com/Hu-Chuxuan/bi-agent),含 100 条 BI-Bench 测试及真值表;训练数据可按论文流水线重新合成——共 7,985 条合成查询、四个设置约 1.96 万–4.27 万条 SFT 轮次与 2,049–4,586 个 RL 任务,论文还给出查询级($\rho = 99.72\%$)与变换级(0.73%)泄漏量化方法供自查。算力门槛低:后训练在 2 张 80GB H100 上完成,SFT 约 9 小时、RL 约 22 小时,折算不足 200 美元;评测端 Qwen3-8B-RL 跑完整个基准只要约 0.19 美元。实现细节充分:奖励函数、评测容差(np.isclose rtol=1e-2, atol=0.5)、显著性检验方案(配对 t 检验 + bootstrap + Benjamini-Hochberg 校正)均有交代。难点主要在 GRPO 对多轮工具调用轨迹的训练工程,以及第三方变换/连接预测算法的复现。总体属于中低难度、高确定性复现。
论文图表
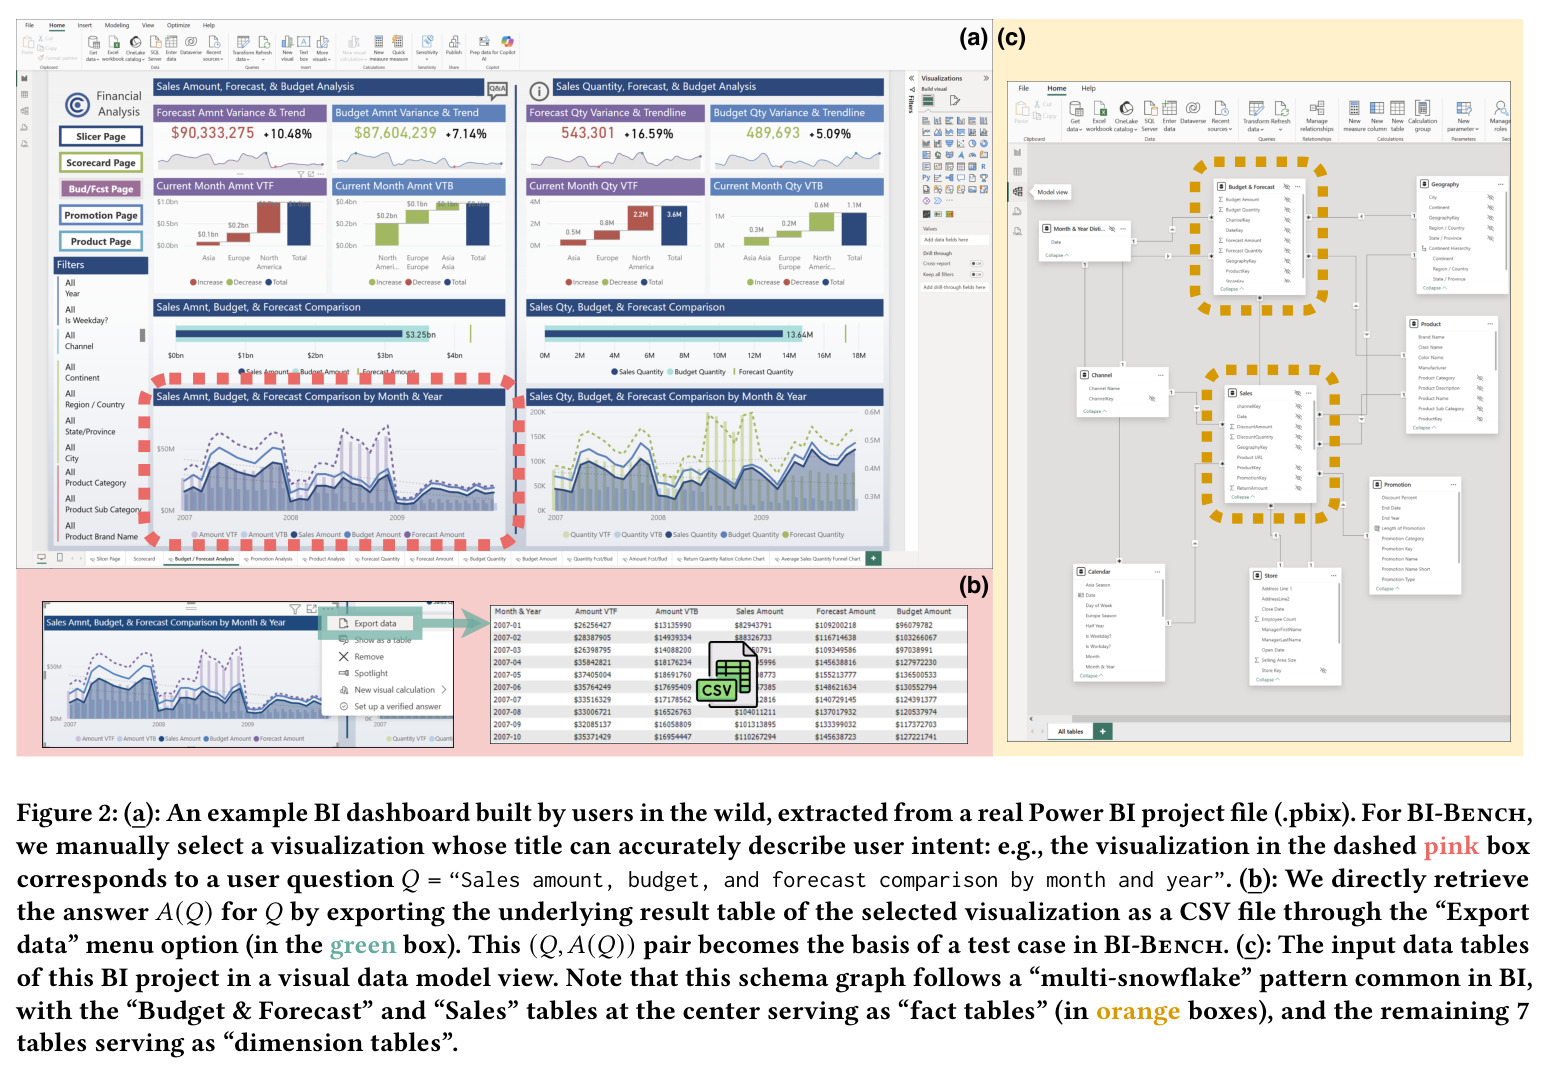
(a) 展示一个真实用户构建的 Power BI 仪表盘,粉色虚线框选中的可视化标题即业务问题 $q$='按月和年比较销售额、预算与预测';(b) 展示通过'Export data'菜单导出该可视化背后的结果表 CSV,作为真值 $A(q)$;(c) 展示项目的底层数据模型视图:'Budget & Forecast'和'Sales'两张事实表居中、7 张维表环绕的多雪花结构。
完整呈现 BI-Bench 测试用例的构造方式(问题来自可视化标题、答案来自导出表)以及真实 BI 项目'多雪花'模式长什么样,是理解基准构建方法与难度的入口。
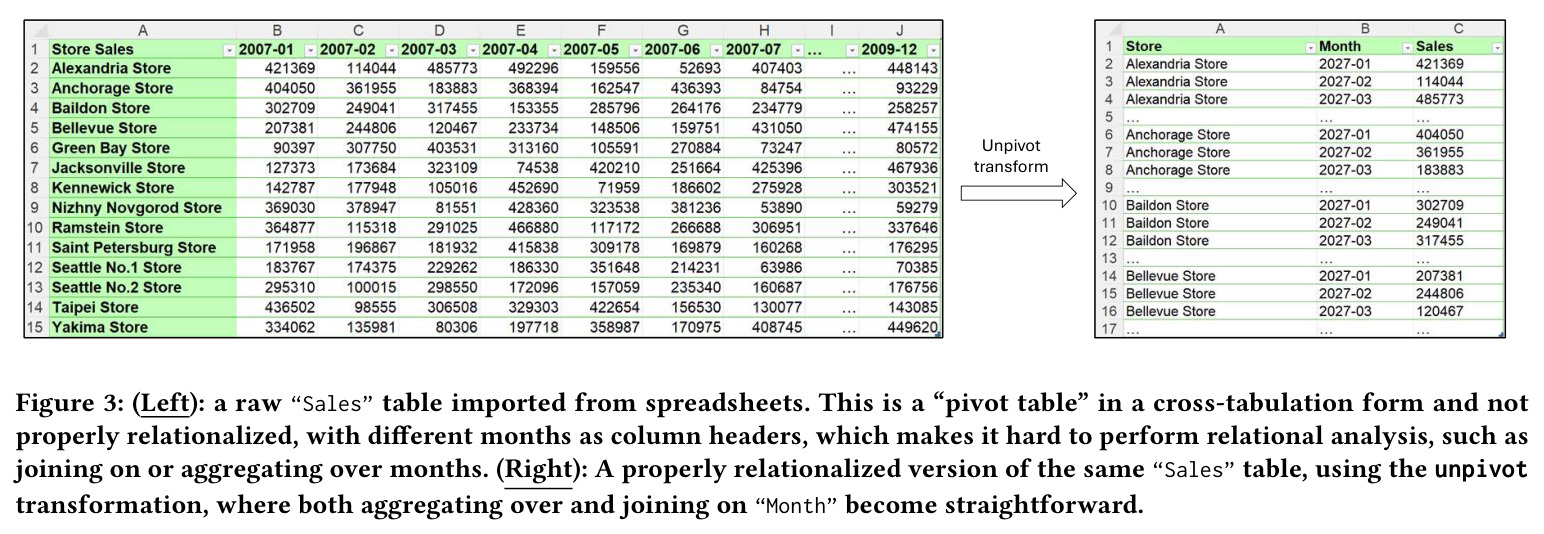
左表是从电子表格导入的透视表:月份(2007-01 等)被铺成列标题,无法直接按月连接或聚合;右表是经 unpivot 变换后的关系化版本,月份成为普通列值,聚合和连接都变成简单操作。文中配的 SQL UNION ALL 脚注说明不用 unpivot 时模拟逆透视多么笨拙。
用最小例子讲清'表重塑变换/关系化'这一 LLM 最大失败点的本质,是理解 transform 工具存在意义的关键。
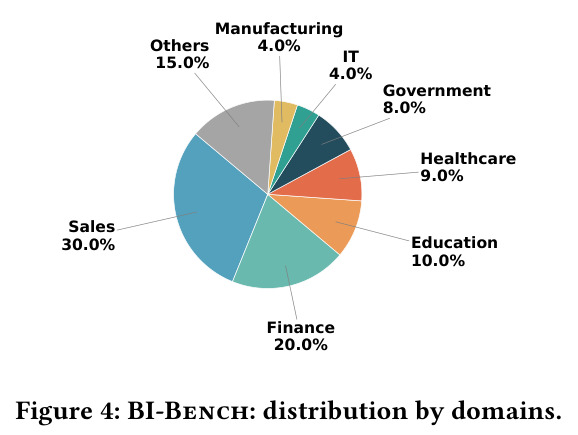
饼图显示 BI-Bench 100 条测试用例的行业分布:销售 30%、金融 20%、教育 10%、医疗 9%、政府 8%、IT 4%、制造 4%、其他(含体育、交通等)15%。
证明基准覆盖真实 BI 用户分析业务的广度,说明测试难度的多样性来源,也暗示方法需领域无关。
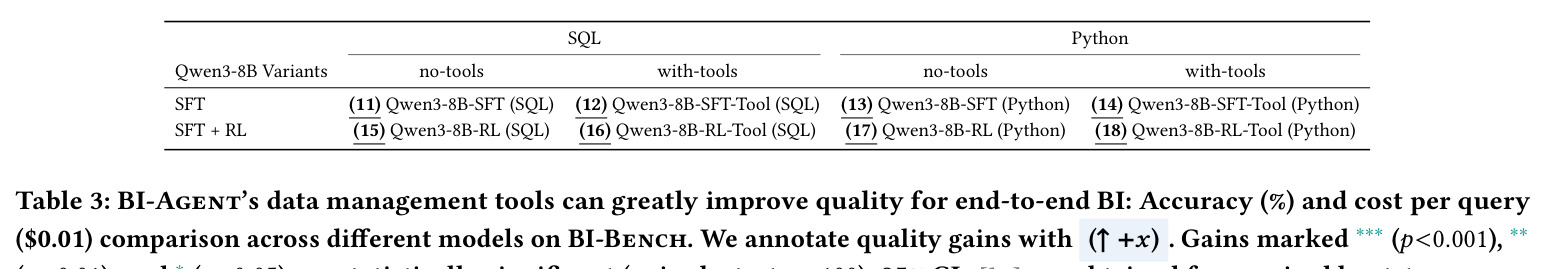
列出全部 8 个后训练模型变体的命名矩阵:SFT 与 SFT+RL(RL 从 SFT 检查点初始化)两种训练方式、有/无数据管理工具两种推理设定、SQL 与 Python 两种代码语言,编号 (11)–(18),例如 Qwen3-8B-RL-Tool (SQL)。
消融实验的坐标系:后文所有后训练结果都按此矩阵展开,理解它才能读懂 Table 4 的每一行。