SiliconBench:统一内存桌面设备上 LLM 服务的速度、内存与保真度评测基准 SiliconBench: Speed, Memory, and Fidelity for LLM Serving on Unified-Memory Desktops
首个联合评测九个 Apple Silicon 推理引擎速度、内存与保真度的审计基准。
前置知识
统一内存架构
Apple Silicon 和 NVIDIA DGX Spark 等桌面设备采用 LPDDR 低功耗内存,CPU 与 GPU 共享同一物理内存池,没有独立的显存。以 64 GB 的 Mac 为例,模型权重、KV 缓存与 macOS、浏览器、IDE 等前台应用共同竞争这 64 GB,可用池会随前台负载动态变化。
本文的核心命题 D2「内存纪律」完全建立在统一内存共享这一约束之上:推理引擎占用过多内存会挤压系统,触发页面压缩甚至请求失败,这是数据中心 HBM 显卡上不存在的问题。
连续批处理与 KV 缓存分页
连续批处理指请求可随时加入/离开当前批次,而非凑齐整批再算;PagedAttention 将 KV 缓存切成固定大小的块按需分配,像操作系统分页一样避免碎片。配合混合调度步,prefill 与 decode 可共用一次前向传播。这些是 CUDA 数据中心服务的标准技术。
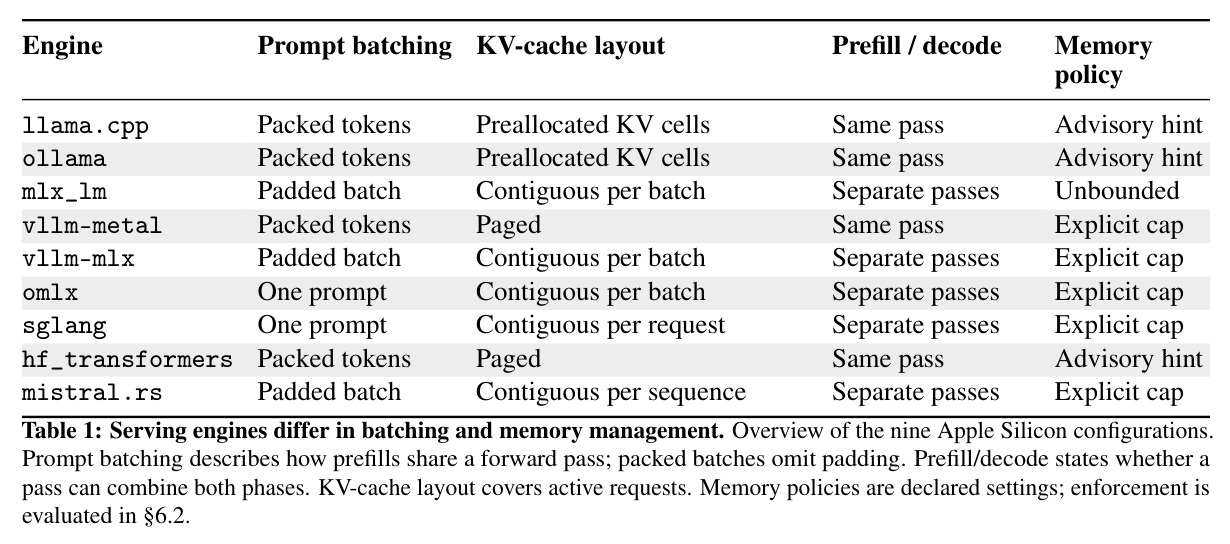
论文 Table 1 用「查询布局、KV 分配方式、调度步组成」三个维度刻画九个引擎的架构差异,并发扩展性(D1)的差距正是由这些实现选择决定的,不读懂数这些概念就看不懂实验设计。
张量并行与流水线并行
张量并行将单层权重矩阵切分到多台设备,每步都需要通信;流水线并行将不同层分配到不同设备,按阶段串行传递激活。多机互联带宽决定成败:Thunderbolt 5 RDMA 可达数十 GB/s,而普通 TCP 仅有几个 GB/s。
D3 多节点扩展是本文三大 desiderata 之一,结论「TP over RDMA 扩展、PP over TCP 倒退」直接来自这两种并行策略与传输层的组合对比。
TTFT(首 token 延迟)
Time-To-First-Token,从 HTTP 请求提交到流式返回第一个内容 token(含 reasoning 输出)的时间,由 prompt 处理(prefill)时间主导。Agent 场景中每次工具往返都要重算长上下文,TTFT 直接决定任务回合时长。
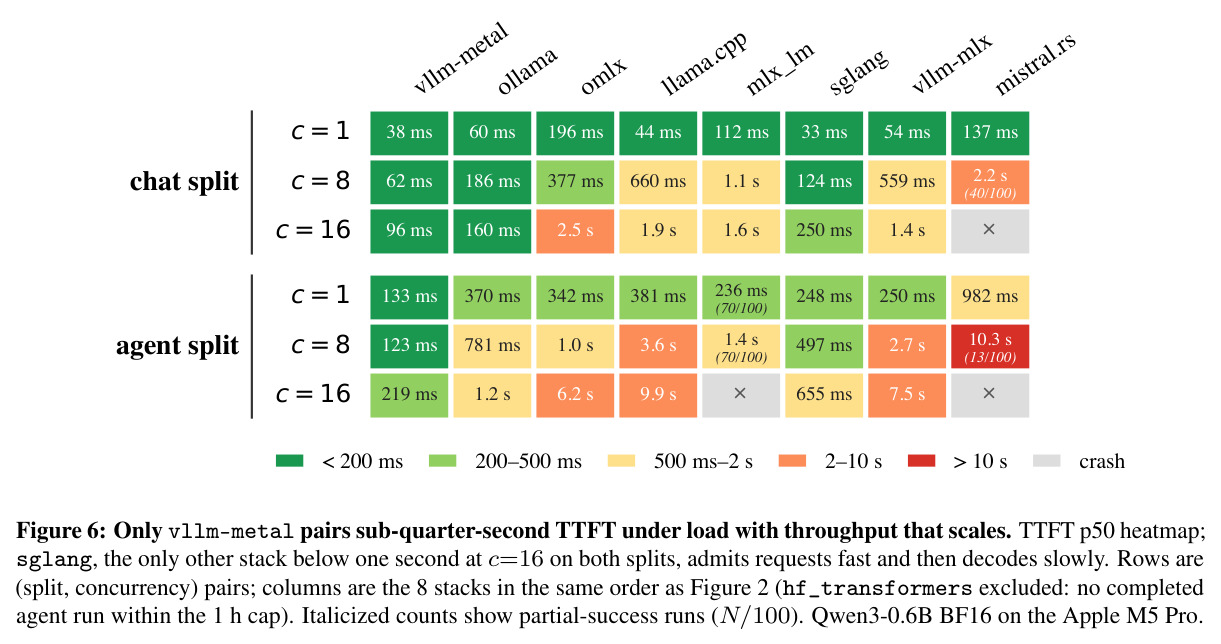
本文的核心工作负载是单用户 agent 同时发起 4–16 个并发请求、长上下文短回复,vllm-metal 凭借 packed prefill–decode 路径把 agent $c=16$ 的中位 TTFT 压到 219 ms,是区分各引擎的关键指标。
任务级保真度
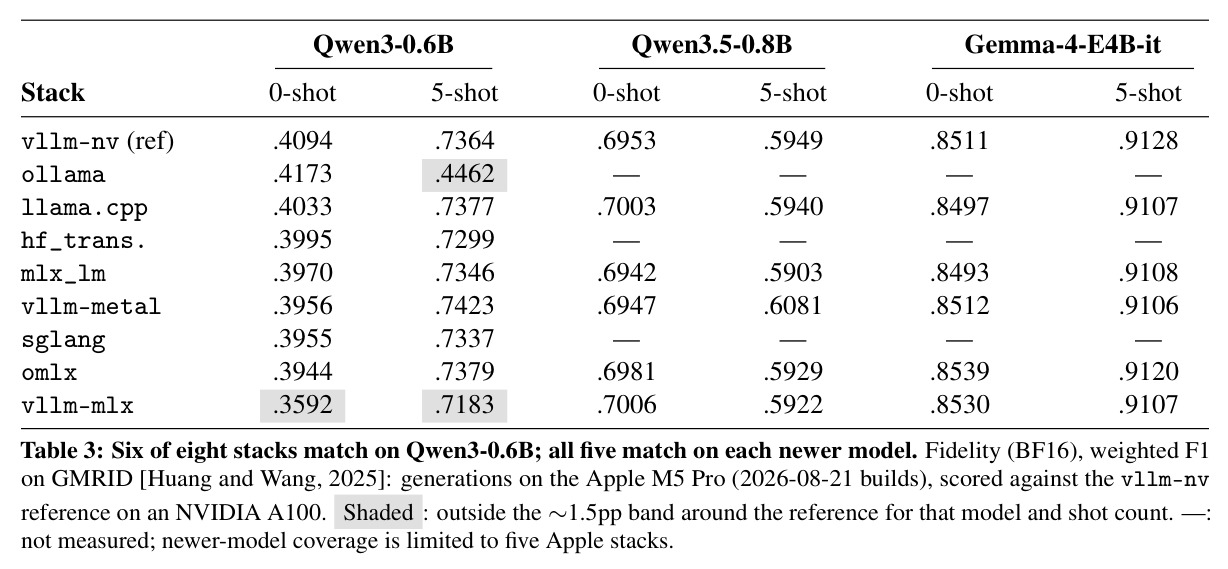
同一模型权重在不同推理引擎上因 kernel 非确定性、精度混合、chat 模板差异会产生输出漂移。任务级保真度用下游任务的加权 F1 来量化:在 GMRID 供应链事件分类任务(1146 条、8 类、0-shot/5-shot)上对比各引擎与 NVIDIA A100 参考实现。
本文发现仅看速度会漏掉两类隐性劣化:ollama 因 chat 模板问题 5-shot F1 落后参考约 30 个百分点,vllm-mlx 0-shot 低 5.0 个百分点——这些在吞吐榜上都不可见。
研究动机
统一内存桌面(Apple Silicon、DGX Spark)正成为本地 LLM 服务的主流平台:Ollama、llama.cpp、LM Studio 每年在 Mac 上有数十万次安装,mlx_lm 月下载量 145 万,mlx-community 社区已有 4710 个转换模型。但至少九个活跃开发的推理栈在这个硬件上竞争,用户几乎只按吞吐量选型,这掩盖了三个具体问题。其一,模型权重和推理缓存与 macOS 及前台应用共享内存,一个引擎可能吞吐排名靠前,却把内存吃到接近物理上限,导致前台应用卡顿或请求失败。其二,单个 coding agent 就会向本地服务器同时发出 4–16 个请求,缺乏连续批处理和内存纪律的栈会在并发下变慢甚至崩溃。其三,即使所有请求都完成,任务级质量也可能悄悄劣于参考实现:维护实验中 ollama 因 GGUF 裸导入丢失 ChatML 分隔符导致分类任务约 92% 解析失败,vllm-mlx 在零请求错误的情况下 0-shot F1 仍比参考低 5.0 个百分点。现有基准没有一项能在同一平台上联合评测速度、内存与保真度。
本文的目标是本文要构建 SiliconBench,一个面向统一内存桌面的联合审计基准:在九个 Apple Silicon 引擎上测量并发 chat 与 agent 服务的吞吐、延迟、内存占用和请求完成率,并用 NVIDIA A100 上的参考实现单独评估任务级保真度。作者提出三条解释框架 desiderata:D1 服务架构就绪度(支持新模型架构并在并发下高效服务)、D2 内存纪律(高效使用共享内存的同时为 macOS 和前台应用保留余量)、D3 多节点扩展(跨机器高效分布式推理)。同时配套 DGX Spark CUDA 参考赛道,通过三个共享引擎家族的桥接对锚定 Apple 结果,并建立一条结合受限 agent 修复与人工审核的持续维护流程,保证基准随软件演进而不过时。
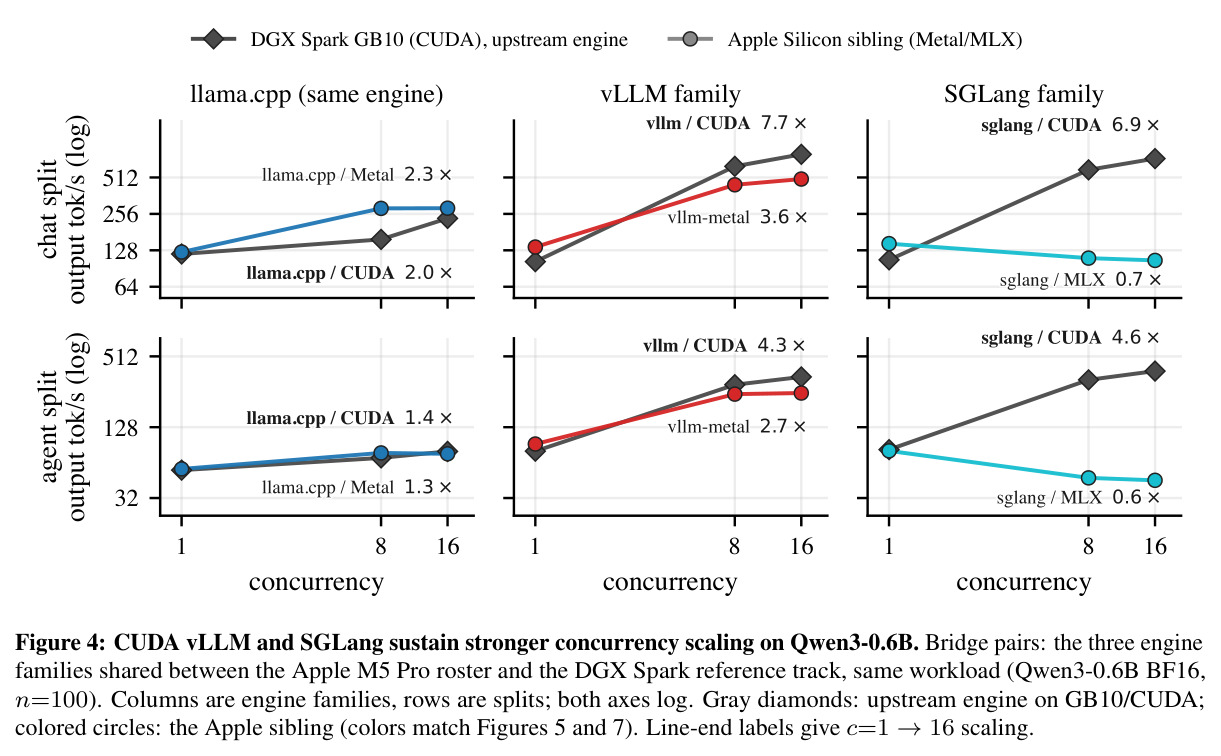
与已有工作不同的是,已有消费级硬件推理基准(Rajesh et al. 2025、Barrios 2026、Benazir & Lin 2025 等)主要在单一栈或狭窄硬件切片上测量吞吐和任务质量;多节点工作如 Petals、prima.cpp 面向异构集群而非审计并发服务。SiliconBench 的独特切入有三点:第一,在单一平台同时审计九个栈的三个维度,而不是只测速度;第二,通过 llama.cpp/vLLM/SGLang 三个桥接对把 Apple Silicon 与其 CUDA 同源引擎锚定在 DGX Spark 上,用相同 prompt、权重和并发网格区分「引擎差距」与「硬件差距」;第三,维护模式创新——prompt 集固定不动、框架适配器每两周由 Claude Code agent 在写白名单内更新、人工审核后才重新生成官方结果,从而把「基准过时」问题转化为受控的软件验证问题。
核心方法
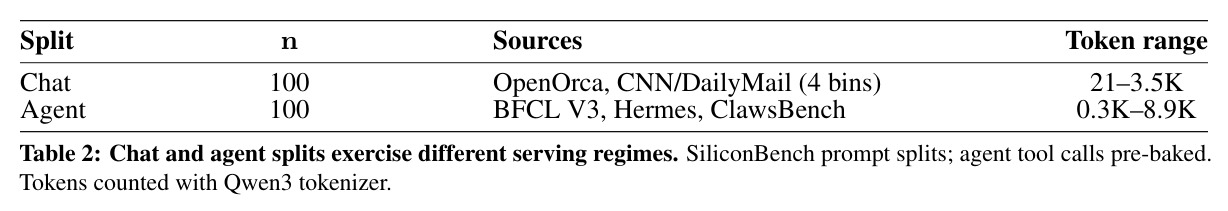
SiliconBench 的整体思路是「三透镜审计」:速度、内存、保真度分开测量、合并解释。直觉来自真实场景:单用户 agent 把一个任务扇出到 4–16 个并行请求,请求携带长上下文但只要短回复,每次工具往返都支付一次 TTFT。工作负载分两个 split 各 100 条:chat split 取自 OpenOrca 和 CNN/DailyMail(21–3.5K token,固定输出 64 或 256 token);agent split 取自 BFCL V3、Hermes、ClawsBench(0.3K–8.9K token,上限 256 token,工具调用预置)。并发扫描 $c \in \{1, 8, 16\}$,闭环发送、每级 3 条 warmup、温度为 0、要求非思考生成,每框架 1 小时墙钟上限。模型以 Qwen3-0.6B BF16 为九栈公共基线,用 Qwen3.5-0.8B(混合线性注意力)和 Gemma-4-E4B-it(多模态、跨层共享 KV)考察新架构支持。主审计硬件为 64 GB Apple M5 Pro(macOS 26.6),保真度用 GMRID 分类($N=1146$、8 类、0/5-shot)对 A100 参考核加权 F1。
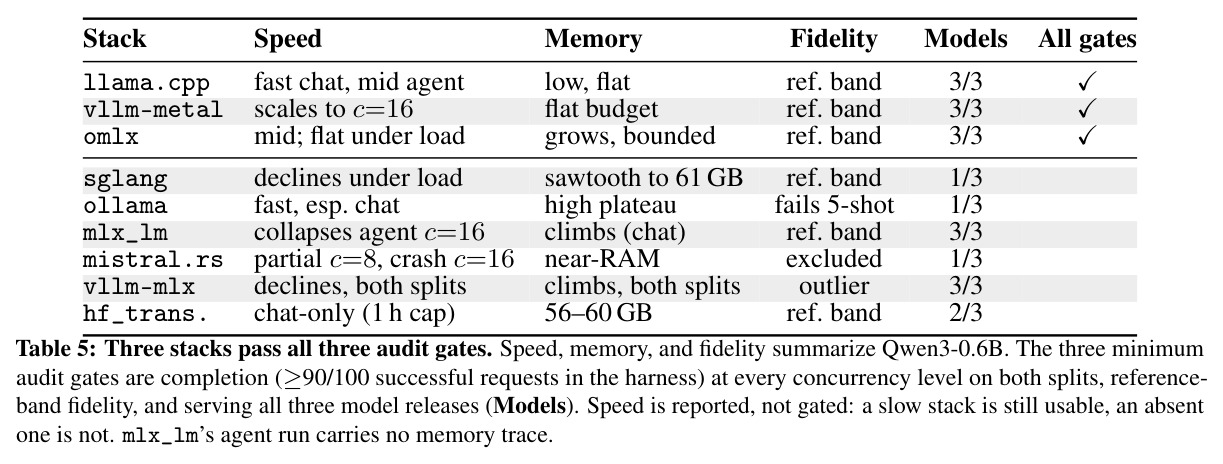
核心创新是把「引擎声明的配置」与「实测行为」分开审计,并用三条门槛把可用性下限与性能差异解耦。首先 Table 1 从查询布局(packed $N_q = \sum_{b=1}^{B} q_b$ 行 vs padded $B T_{\max}$ 行,$T_{\max} = \max_b q_b$)、活跃 KV 分配(分页/连续/预分配单元)、调度步组成(混合步/分离步)、内存策略(显式上限/建议提示/无界增长)四个维度刻画九个引擎,再验证这些声明是否兑现:例如 mistral.rs、vllm-mlx、sglang 都声明显式预算,实测却在吞吐下降时逼近物理内存。其次设立三条审计门槛——两个 split 上每个并发级完成率 $\geq 90/100$、保真度落在参考约 1.5 个百分点的带内、三个模型全部可服务——速度只报告不强制的门槛设计把「能不能用」与「快不快」分开。最后,内存纪律的判据不是「是否完成」而是「是否留有余量」,并首次提出部署悬崖概念:无 OOM 报错但 macOS 页面压缩使性能静默劣化 2.5 倍。
方法步骤详情
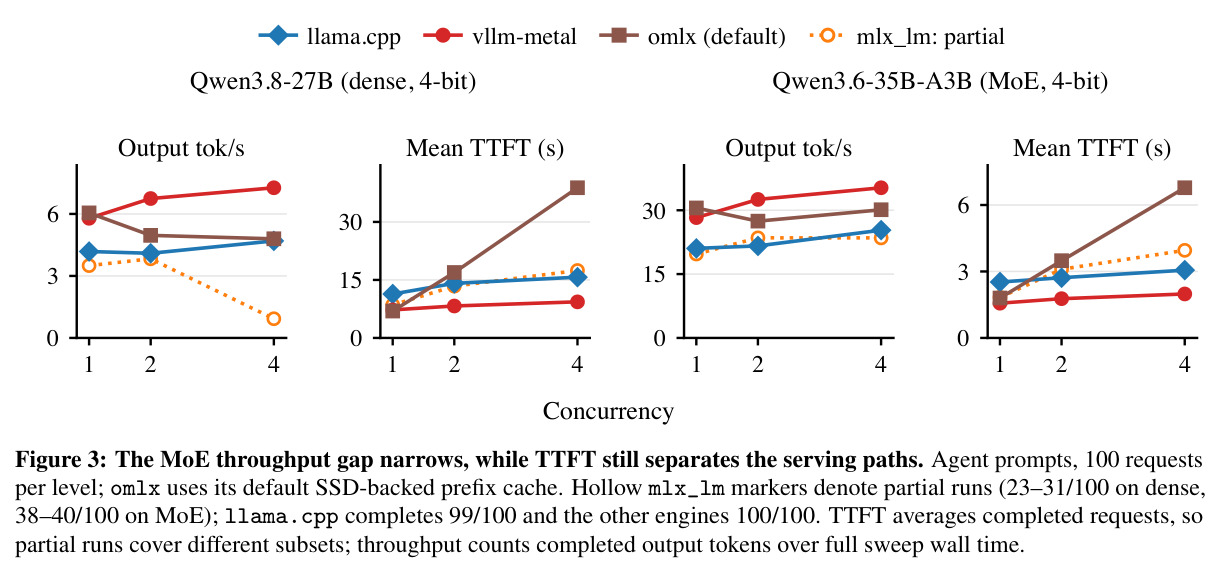
流程分七步。第一步,配置审计:记录每个引擎的批处理方式、KV 布局、prefill/decode 组合和内存策略(Table 1)。第二步,速度扫描:每个并发级 3 条 warmup 后闭环保持至多 $c$ 个在飞请求,吞吐为总生成 token 除以整轮扫描墙钟时间,TTFT 从 HTTP 提交计到首个流式内容或 reasoning 输出,失败请求仍计入墙钟。第三步,内存追踪:记录每级峰值系统内存和运行内轨迹。第四步,保真度测量:在 GMRID 上以 0-shot 和 5-shot 生成,与 A100 上 vllm-nv 参考同权重同精度对比加权 F1(2026-08-21 构建)。第五步,CUDA 参考:llama.cpp、vLLM、SGLang 三个家族在 DGX Spark GB10 上用相同 prompt、权重和并发网格测速度与延迟。第六步,扩展研究:Qwen3.8-27B(稠密 4-bit/8-bit)和 Qwen3.6-35B-A3B(MoE)在 M5 Pro 上测 $c=1/2/4$;两台 64 GB M4 Pro Mac mini 经 Thunderbolt 5 RDMA 对比 llama.cpp 的 PP-over-TCP 与 mlx_lm/EXO 的 TP-over-RDMA(Qwen3.5-35B-A3B 8-bit,512 输出 token)。第七步,维护流程:agent 只能写白名单内的适配器与模型配置,工作负载、评分、聚合由维护者控制,审核后才重跑官方结果。
技术新颖性
技术新颖性有四点。第一,多维联合审计本身是新的:此前没有基准在统一内存平台同时测并发扩展、内存余量和任务级保真度,本文证明三者排名互不一致——chat 吞吐并列第一的 ollama 在内存和保真度两项都不合格。第二,对 padded 批处理的量化分析:30K/5K/10 token 三段 prompt 实际仅 35010 个 token,但 padded 路径按 $[3, 30000]$ 布局横跨 90000 个位置,浪费 61% 的查询计算和 KV 内存 I/O,并首次给出「32 GB 上页面压缩致 2.5 倍减速、64 GB 上无惩罚」的部署悬崖实证。第三,桥接对设计:用 llama.cpp/vLLM/SGLang 三个共享引擎家族在 DGX Spark 上跑同 workload,使「Metal 后端缺内核」与「引擎本身不支持」可被区分(sglang 上游 CUDA 能服务两个新模型而 MLX 后端一个都不行)。第四,多节点受控对比:选一个单节点放得下的 35B 模型,把多机引擎效率与容量解锁场景解耦,得到 TP-over-RDMA 与 PP-over-TCP 的干净结论。
实验结果
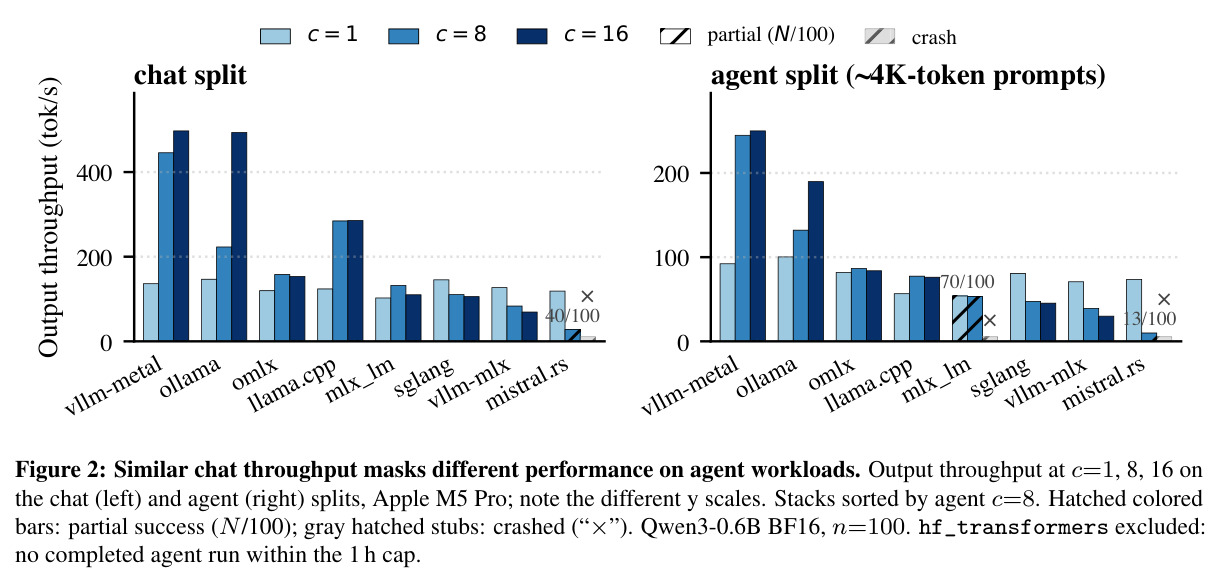
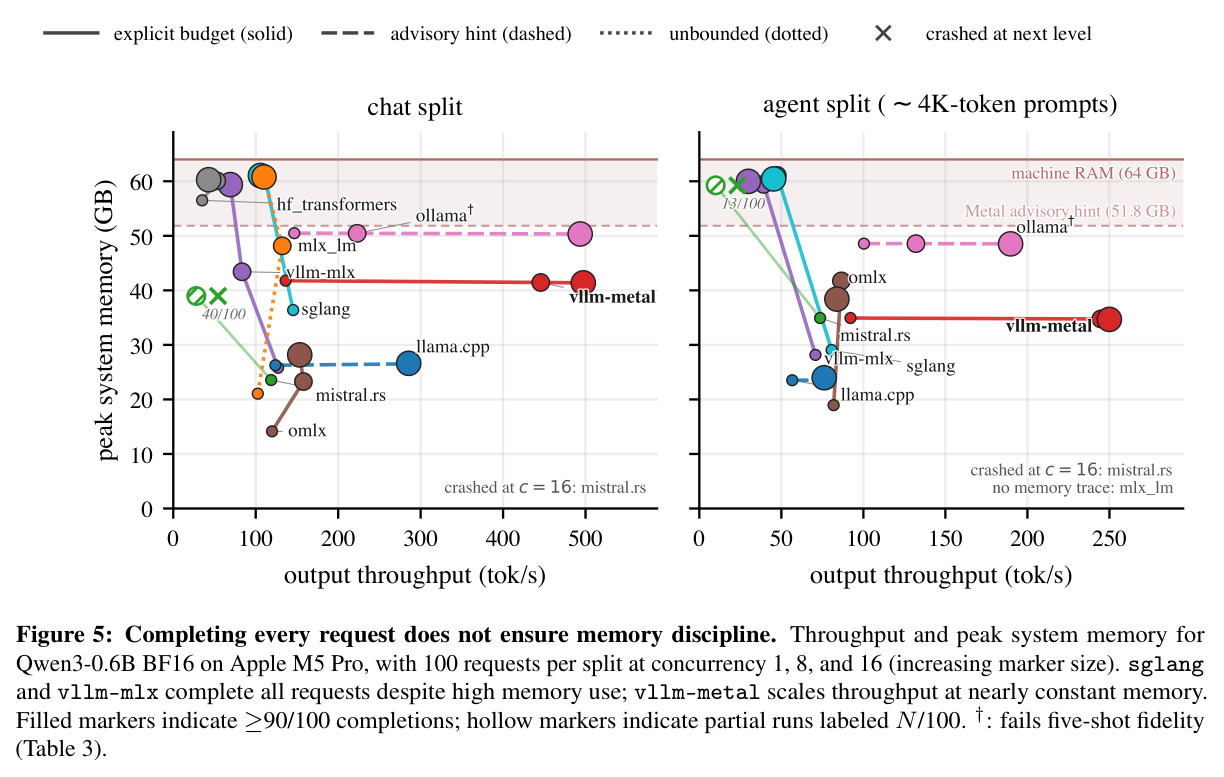
九引擎审计(Qwen3-0.6B BF16,M5 Pro)显示并发扩展差距巨大:vllm-metal 是唯一在两个 split 上都超 2 倍扩展的栈(chat 3.65 倍、agent 2.71 倍,$c=1 \to 16$),且是唯一在 agent $c=16$ 保持中位 TTFT 低于 250 ms 的栈(219 ms);chat $c=16$ 上它与 ollama 差距不到 1%,agent split 上领先 32%。批处理特性相同的 hf_transformers chat 仅扩展 1.23 倍且 agent 无法在 1 小时内完成,说明相同架构不保证性能。完成率上 6/9 栈全程 $\geq 90/100$:mlx_lm 在 agent $c=16$ 崩到 2/100,mistral.rs 崩溃。内存上 vllm-metal 峰值稳定在 34.7–34.9 GB,llama.cpp 几乎平坦,omlx 有界增长;ollama 从 $c=1$ 起占 Metal 建议提示的 94–97%,mistral.rs 在 agent $c=8$ 达 59.3 GB 却只完成 13/100,sglang 和 vllm-mlx 完成全部 600 请求但内存逼近物理容量,无界的 mlx_lm 为 7% 吞吐把 chat 内存占用翻了近三倍。保真度上 8 个 Qwen3-0.6B 栈中 6 个落在参考约 1.5 个百分点带内;ollama 5-shot 仅 0.4462(参考 0.7364),vllm-mlx 0-shot 0.3592 比参考 0.4094 低 5.0 个百分点;新模型上全部 5 个受测栈在 1.4 个百分点内。大模型研究中 MoE 吞吐差距收窄:omlx 在 $c=1$ 领先,vllm-metal 在 $c=4$ 优势 4%–17% 且平均 TTFT 最低。DGX Spark 上 CUDA vLLM 和 SGLang 达 4.3–7.7 倍扩展且 TTFT 平坦。多节点上 EXO TP-over-RDMA 两节点 decode 87.0 tok/s(1.30–1.37 倍),mlx_lm 1.28–1.32 倍,llama.cpp PP-over-TCP 倒退至 0.80–0.84 倍;prefill 因计算受限扩展更好(短上下文约 2 倍)。最终仅 llama.cpp、vllm-metal、omlx 通过全部三条审计门槛。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Chat 吞吐并发扩展(Qwen3-0.6B BF16,M5 Pro,n=100) | 输出吞吐扩展倍数(c=1→16) | vllm-metal 3.65× | hf_transformers 1.23×(相同 packed/分页/混合步特性) | 同为 packed+paged+mixed 实现,扩展性差距近 3 倍,说明实现质量决定性能 |
| Agent 吞吐并发扩展(约 4K token 长上下文) | 输出吞吐扩展倍数(c=1→16) | vllm-metal 2.71×,c=16 领先第二名 32% | 其余 padded/串行 prefill 路径增益不足 30% 或失败 | 唯一在两个 split 上扩展均超 2× 的栈 |
| Agent 首 token 延迟(c=16) | 中位 TTFT | vllm-metal 219 ms | sglang 655 ms(但吞吐从 80.6 跌至 45.3 tok/s),其余栈超过 1 s | 唯一兼具亚 250 ms TTFT 与增长中吞吐的栈 |
| 内存纪律(agent split 峰值系统内存) | 峰值内存 / 64 GB 物理容量 | vllm-metal 34.7–34.9 GB 且随负载平坦 | mistral.rs 59.3 GB(仅完成 13/100);sglang、vllm-mlx 锯齿逼近物理内存 | 在吞吐最高的同时保持最大内存余量 |
| 任务级保真度(GMRID 分类,Qwen3-0.6B,5-shot) | 加权 F1(vs A100 参考带约 ±1.5pp) | vllm-metal 0.7423(带内);ollama 0.4462(带外) | vllm-nv 参考 0.7364 | 暴露 ollama chat 模板导致落后参考约 30 个百分点的隐性劣化 |
| 两节点 decode(Qwen3.5-35B-A3B 8-bit,ctx 512,TB5 RDMA) | decode tok/s 与两节点加速比 | EXO TP 87.0 tok/s(1.30–1.37×) | llama.cpp PP-over-TCP 32.4 tok/s(0.80–0.84×,倒退 16–20%) | 证明 TP+RDMA 扩展、PP+TCP 倒退 |
局限与改进
作者承认的限制包括:主审计只用一台 Apple M5 Pro,硬件多样性不足;DGX Spark 参考只覆盖三个引擎家族且仅测速度与延迟;主审计锚定小模型,更大的稠密/MoE 研究只覆盖选定的引擎且使用了更新的构建和不同的 GGUF/MLX 量化格式,每个配置只测一次,无重复实验;保真度依赖单一分类任务且没有正式的运行间方差估计,约 1.5 个百分点的带不是形式化噪声估计,带内不排名;多节点只测两台机器且模型单机也放得下。我自己的观察补充如下:吞吐定义为总生成 token 除以整轮墙钟,部分完成的运行(如 mlx_lm 23–31/100)会系统性压低其吞吐,与完成率混淆;mlx_lm 合法的零内容工具调用被计为失败、而 ollama 的 agent 吞吐又把约 254 个空内容 token 计入产出,说明完成率和吞吐指标对「内容承载 token」不敏感,需要内容感知的记账;主 split 刻意排除了 10K 以上长上下文和 1K 以上长生成,而这正是本地 agent 即将高频遇到的场景;对前台内存需求动态变化的自适应未评估,D2 只测了静态负载。
独立分析的弱点
第一,保真度评估过窄:仅一个 8 分类供应链事件分类任务,无法暴露长文本生成、代码生成或指令跟随质量的引擎间差异,且作者未隔离 ollama 模板问题的根因。改进方向是加入多任务保真度套件(摘要 ROUGE、代码执行通过率)并做模板归一化消融。第二,指标记账语义不一致:mlx_lm 的 70/100 是合法工具调用被 harness 记为失败,ollama 的 agent 吞吐又把约 254 个空内容 token 计入产出,完成率和吞吐在 agent 场景下都需内容感知的重新定义。第三,单机单次测量:大模型配置每个只测一次且构建与量化格式不统一,4%–17% 的区间跨度和无方差估计使小差距不可解释,应至少重复 3 次并报告置信区间、统一量化格式。第四,内存评估是静态的:未测前台应用内存需求波动时引擎的自适应行为(如 Metal 建议提示的实时响应),可引入合成的前台内存压力进程做共评测。第五,多节点规模太小:两节点、单机可容纳的模型无法回答 D3 的原始动机「容量解锁」,也未测 vllm-metal 的 MLX ring PP 路径。
未来方向
作者方向上:把快照制维护跑成真正的双周节奏(目前 2026-04-11 至 04-23 的五次早期运行尚不能证明可持续性);通过社区 PR 扩大引擎与模型覆盖,特别是补上 DeltaNet 内核(mistral.rs)和 MLX 后端的混合 SSM 内核(sglang);扩展到 10K 以上长上下文和 1K 以上长生成两个被明确排除的 regime;评估引擎对前台内存动态的自适应。基于成果可延伸的方向:其一,把三透镜审计移植到 DGX Spark 和即将出现的其他统一内存平台,检验 desiderata 的平台普适性;其二,多节点研究扩展到超过单机内存的模型(如 70B+),考察 TB5 RDMA 下 TP 规模上限与 expert parallelism 跨 Mac Studio 集群;其三,用 Metal DSL 工具链(如 TileLang for Metal)的成熟度曲线预测新架构的支持滞后时间,把 D1 从静态覆盖审计变成预测模型;其四,把保真度从分类 F1 扩展为包含输出分布层面(logprob KL、token 级漂移率)的连续谱,配合正式的方差估计建立可排名的保真度度量。
复现评估
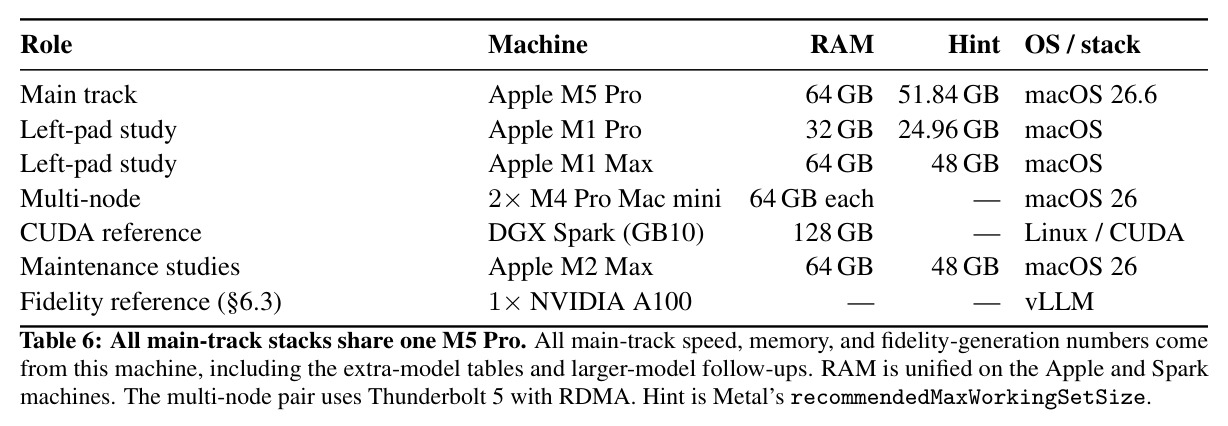
复现基础较好:基准代码、逐次运行结果和维护日志全部开源(github.com/WindChimeRan/SiliconBench2026),维护者 agent 指令固定在 commit 616aa51c,prompt 集、采样种子和数据集版本跨快照固定,保证性能差异来自框架变化而非数据漂移。硬件门槛是主要障碍:主审计需要 64 GB Apple M5 Pro(macOS 26.6),Figure 1 需要 32 GB M1 Pro 和 64 GB M1 Max,多节点需要两台 64 GB M4 Pro Mac mini 加 Thunderbolt 5 连接,CUDA 参考需要 DGX Spark GB10 和 NVIDIA A100。软件侧依赖锁在特定版本(如 MLX 0.31.x),论文已证明依赖更新随时可能破坏五个栈中的三个,复现者需按快照日期对齐构建版本(保真度用 2026-08-21 构建)。总体难度中等偏高:有一台 64 GB Apple Silicon 即可复现核心的九引擎审计和保真度部分,完整复现含 DGX Spark 和双 mini 多节点则需专门硬件。
论文图表
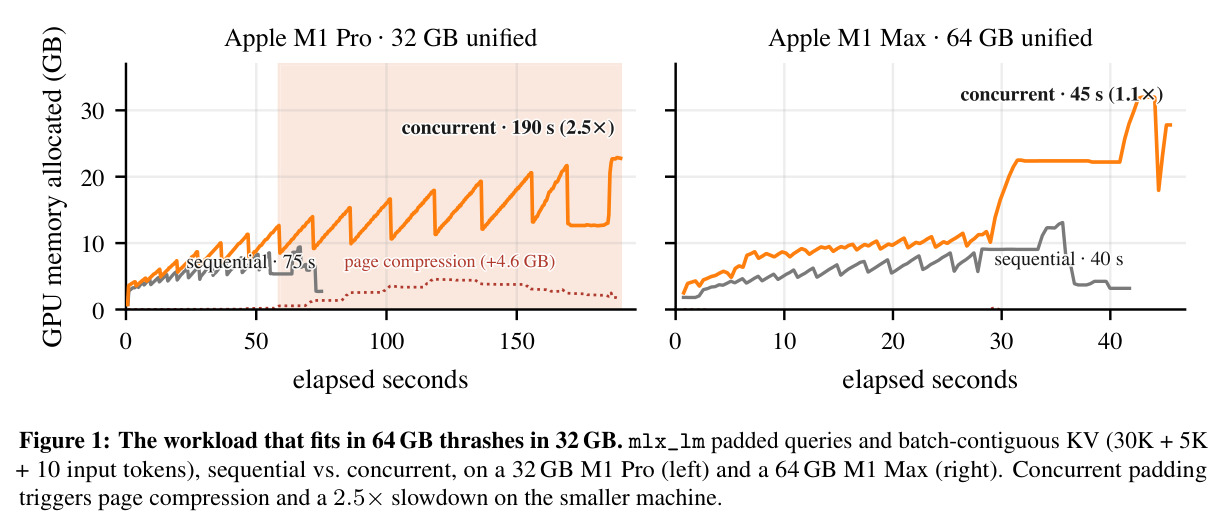
同一 workload(三段 30K/5K/10 token 的 prompt)先顺序后并发地跑在 32 GB M1 Pro 和 64 GB M1 Max 上并记录 GPU 内存轨迹。并发模式下 padded 批处理把 35010 个实际 token 撑到 90000 个位置,浪费 61%;在 32 GB 机器上浪费的内存推高系统内存压力,触发 macOS 对活跃 KV 缓存页的压缩,每个 decode 步都要先解压再压缩,墙钟时间变为顺序执行的 2.5 倍;在 64 GB 机器上同一代码毫无惩罚。
这是全文最重要的机制图:它用受控实验定义了「部署悬崖」——不是硬性 OOM 而是无报错的静默性能崩塌,直观解释了为什么统一内存平台上内存纪律(D2)与速度同等重要,以及为什么 padded 批处理是真实的工程债务。