EdgeKernelBench:面向边缘后端的统一 LLM 驱动内核生成基准 EdgeKernelBench: Unified LLM-Driven Kernel Generation for Edge Backends
统一IR基准+分层智能体LEKA,将边缘内核Fast@1.0从13.0%提升至43.5%
前置知识
中间表示(IR)与逐级下降
编译器把程序表示成一系列抽象层级递进的中间表示:高层 IR 贴近算法与计算图结构,低层 IR 贴近循环、内存与指令。逐级下降(progressive lowering)指编译器沿这些层级做语义保持的转换,每往下一级就固定一部分高层决策、打开更细的低层优化空间,MLIR 与 TVM 都是这个思路。
本文的核心设计——统一 Kernel IR 与 LEKA 的分层 agent——完全建立在多级 IR 与渐进下降之上,不理解这个概念就无法理解为什么每个 IR 层要配一个专属 agent、以及下降为什么交给编译器而不是 LLM。
TVM 编译栈(Relax 与 TIR)
TVM 是开源深度学习编译器。Relax 是其高层图 IR,负责算子图、融合边界与动态形状;TIR 是张量级 IR,用类 Python 语法表达循环、调度与内存访问。MetaSchedule 在 TIR 之上自动搜索调度(分块、布局、并行映射)并在真实硬件上反复编译测量候选调度。
论文以 TVM 0.23.0 实例化整个基准:LLM 在 Relax/TIR 层表达优化,LLVM/OpenCL/CUDA 目标代码由 TVM 下降生成,MetaSchedule 调优后的 TVM 还是全部性能对比的基线,不懂 TVM 就看不懂实验设置。
KernelBench 式评测协议
KernelBench 确立的内核生成评测惯例:以 PyTorch 程序为参考任务,按程序范围组织任务集,对生成的内核依次测量编译成功率(CSR/Compile@1)、功能正确率(FCR/Correct@1,输出需通过数值容差校验)和 Fast@p(正确且中位配对加速比超过阈值 p 的任务占比),另报几何平均加速比 GM。
EdgeKernelBench 显式沿用该协议,全文所有指标都由它定义;表 1、图 4、图 6 的每个数字都对应 CSR/FCR/Fast@1.0/GM 之一,先懂指标才能读懂结果。
算子融合、分块与内存层级
高性能内核的三类基本手段:融合把多个算子合成一个内核,避免中间张量写回全局内存;分块(tiling)把大循环切成能放进缓存/共享内存的瓦片以复用数据;内存层级优化决定数据放在寄存器、本地内存还是全局内存,并配合向量化、循环展开与寄存器分块(register blocking)。
LEKA 三个层级的 agent 分别主管这些手段的不同子集(L0 管融合与布局、L1 管循环与分块、L2 管指令级细节),论文所有案例的加速收益都来自这些具体技术,是读懂优化案例的背景知识。
边缘异构后端与生态碎片化
边缘设备没有统一软件栈:手机 CPU 用 LLVM 生成 ARM 代码,Jetson 这类嵌入式 GPU 走 CUDA,RK3588 的 Mali GPU 走 OpenCL C/SPIR-V。每种后端有自己的语言、接口和合法性规则(线程绑定、work-group 尺寸、地址空间声明),同一个计算在不同后端要写完全不同的程序。
碎片化正是论文的问题起点,也是它用统一 IR 取代逐后端原生代码的理由;三个评测设备(骁龙 8 Gen 3 手机、Jetson AGX Orin 64GB、RK3588)分别对应 CPU/LLVM、GPU/CUDA、GPU/OpenCL 三条执行路径。
LLM 智能体与候选树搜索
智能体把 LLM 放进生成、执行、观察反馈、再生成的循环中迭代改进。候选树搜索进一步保留每个历史候选及其验证结果作为分支,允许比较、回滚或从任意节点继续探索,而不是只追一条线性轨迹;谱系(lineage)记录让每个改进都可追溯到产生它的那一层决策。
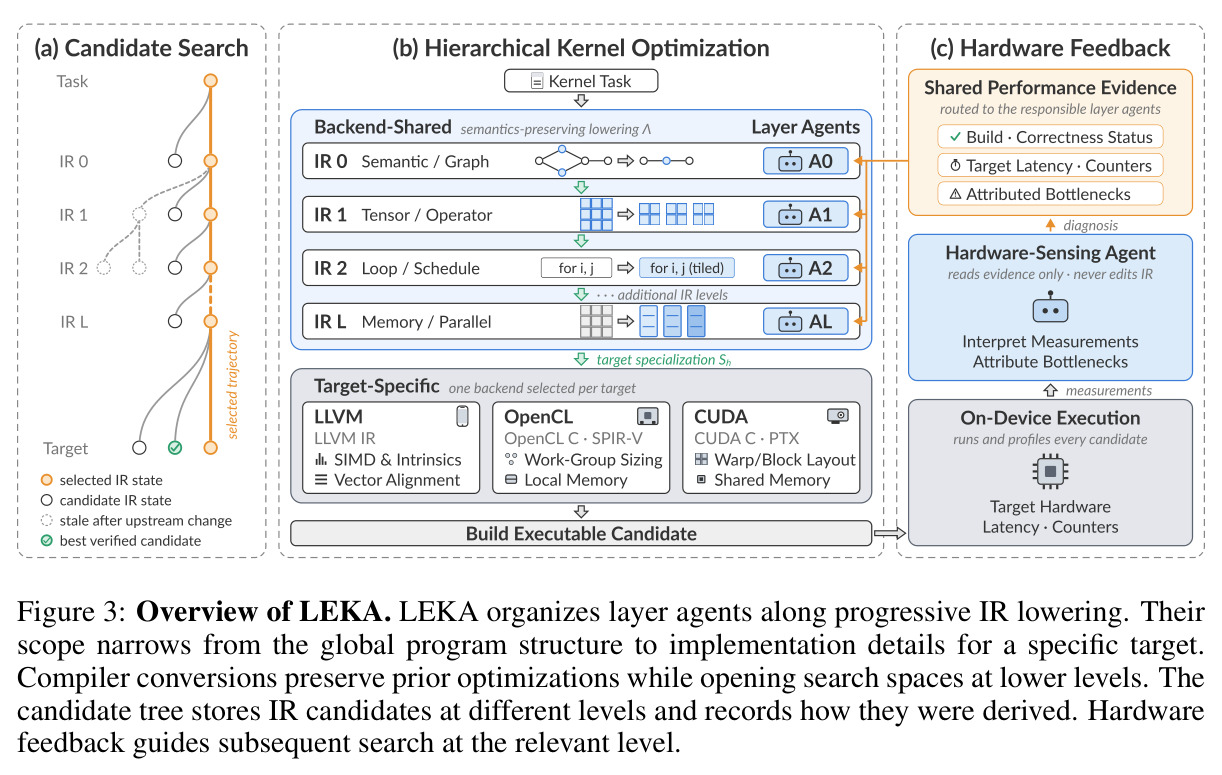
LEKA 的反馈回路就是一棵跨 IR 层级的候选树 $T_t=(V_t, F_t)$,图 3 中的活跃轨迹与硬件反馈路由机制都靠它实现,理解它是看懂 LEKA 架构图的前提。
研究动机
边缘部署需求(低延迟、少依赖网络、本地数据处理)持续增长,但 LLM 内核生成研究几乎全部面向服务器 GPU,直接搬到边缘会撞上三堵墙。第一,软硬件生态高度碎片化:服务器生成只需瞄准少数有成熟软件栈的主流加速器,而边缘横跨手机 SoC、开发板 GPU、各类厂商 runtime 与部署引擎;让模型直接写 CUDA/Triton 式原生代码,等于把可复用的计算与调度知识和单个后端的语言、接口、合法性规则绑死,换一个后端就要重新适应一套编程部署环境,知识难以跨设备迁移——已有跨平台基准显示,模型在训练语料少见的硬件上正确率会崩塌。第二,优化目标不同:服务器加速器显存充裕,优化几乎只看执行速度;边缘芯片要与系统其余部分共享算力和内存,内存容量直接决定模型能不能部署,必须在固定资源预算内同时权衡性能与内存。第三,基准缺位:KernelBench 系列针对服务器 GPU,MobileKernelBench 虽延伸到手机但公开任务以单算子及其属性变体为主,考察不了跨算子协同优化和图级资源规划。后果很具体:最强模型一次性生成在全部 650 个任务实例上拿到 64.5% 的 Correct@1,Fast@1.0 却只有 25.5%;Level 3 模型图任务上三个后端最高 Fast@1.0 落在 0.0%–4.0%,说明功能正确并不能转化为性能收益,一次性生成无法协调随程序规模增长的跨层耦合决策。
本文的目标是本文要为 LLM 边缘内核生成建立统一的生成、验证与度量基础设施,并证明分层优化能显著提升效果。具体目标有三。其一,设计统一 IR 部署框架:LLM 不再为每个后端写一份原生程序,而是在一份后端无关的统一 Kernel IR 中表达计算、调度与内存决策,由确定性的后端适配器逐级下降到 LLVM、OpenCL、CUDA 等目标,使优化意图跨设备复用,新后端只需新增适配器即可接入同一工作流而不改变任务契约与评测协议。其二,构建 EdgeKernelBench 分层基准:沿组合复杂度与应用领域两个正交轴组织 331 个带可追溯来源的 PyTorch 参考任务(Level 1 基本计算模式 128 个、Level 2 融合算子图 162 个、Level 3 紧凑模型图 41 个),覆盖移动与个人智能、具身机器人、智慧 AIoT 三类边缘场景,并把调度与内存决策纳入同一优化空间。其三,以 TVM 为参考编译栈,在 CPU/LLVM、GPU/CUDA、GPU/OpenCL 三条执行路径上实例化评测(合计 650 个任务实例),系统测量五个前沿 LLM 的能力边界与失败模式,并提出 LEKA 分层智能体,把 agent 子集上一次性生成的 Fast@1.0 从 13.0% 提升到 43.5%、Correct@1 从 42.0% 提升到 100.0%。
与已有工作不同的是,本文的独特切入在于把表示和决策同时变成一等公民。已有基准把原生代码当作评测产物,模型必须自己满足每个后端的语法与合法性规则;本文改用一份跨后端共享的统一 Kernel IR 作为 LLM 的输出接口,把可复用的计算/调度/内存知识与后端特定接口解耦,下降交给确定性适配器——这延续了张量编译器(TVM/MLIR)的多级 IR 思想,但把规则驱动的调度搜索换成 LLM 决策,因而能到达规则编码之外的变换,比如代数重写和编译器规则库中不存在的融合边界。任务设计上,它首次沿复杂度×应用双轴把边缘任务铺到模型图级别,补上了 MobileKernelBench 只测单算子的空档。智能体设计上,已有推理时优化方法(多角色迭代、进化搜索、移动框架内修复循环、生成-测试-精炼循环)大多把一个原生程序当作优化单元:奖励对整个程序打分,profile 只能告诉你哪个内核慢,却指不出是哪一层的决策出了错,算法、融合、线程映射、指令选择被纠缠在一起;LEKA 则给每个 IR 层配备专属 agent,并把每次设备测量归因后路由到拥有该决策的层——把反馈归因到决策粒度,这是与现有 LLM 内核优化工作最本质的区别。
核心方法
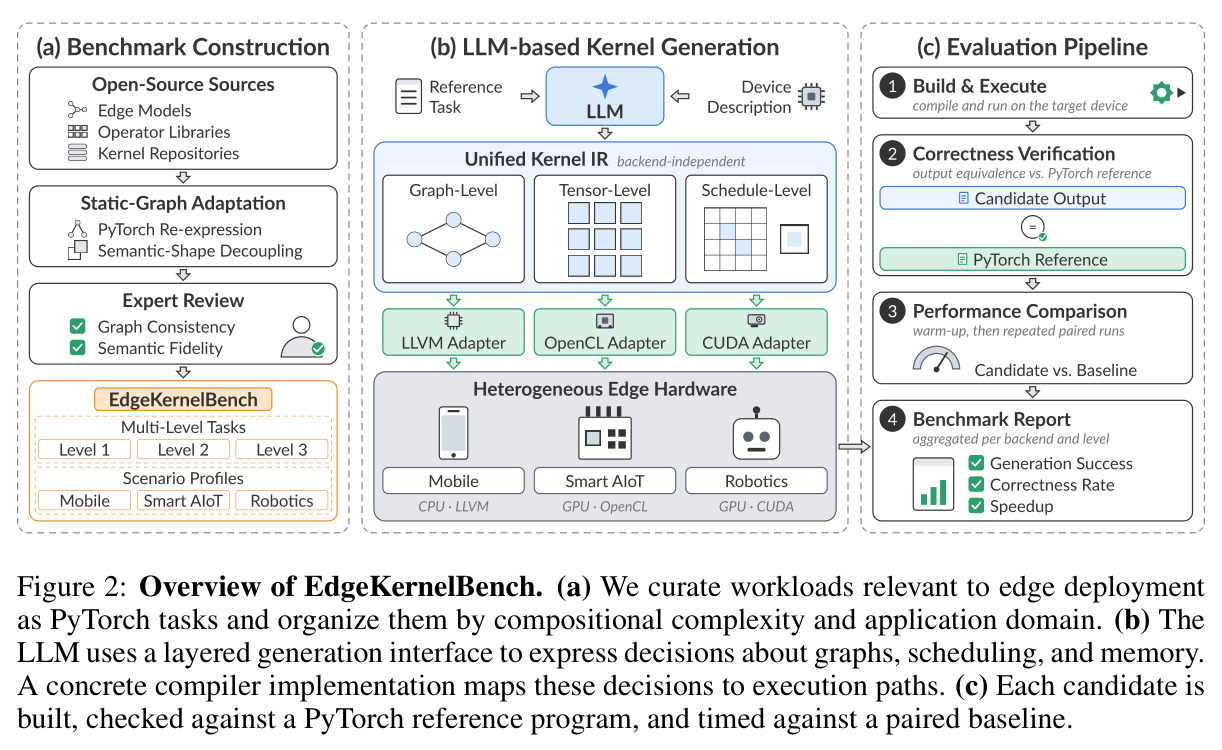
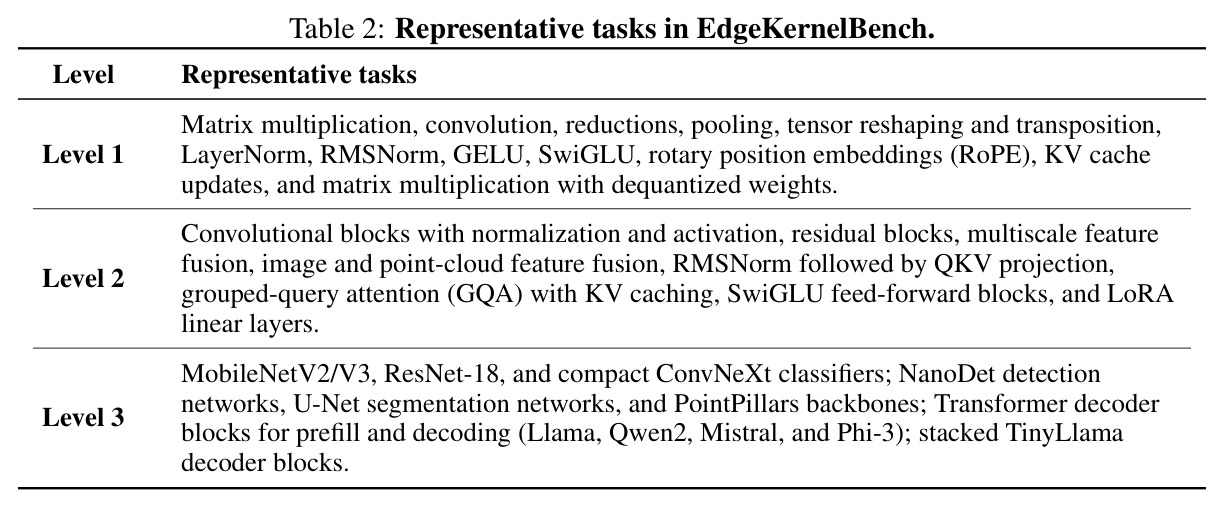
整体思路先给直觉:与其让模型一次写出针对某硬件的完整原生内核,不如让它把想怎么算、怎么调度、怎么省内存写进一份分层中间表示,接口转换交给编译器确定性完成;当任务复杂到一次写不对也写不快时,再让多个 agent 按 IR 层级分工、拿真实设备的测量反馈迭代。技术路线分两块。EdgeKernelBench 侧:任务从开源边缘模型、算子库、内核库中筛选,动态计算转静态、统一 PyTorch 接口、语义与形状解耦并经专家审查,形成 331 个规范任务,按应用域分为移动与个人智能 204、智慧 AIoT 228、具身机器人 218 实例,三后端合计 650 个评测实例(CPU/LLVM 91/93/20、GPU/CUDA 98/95/25、GPU/OpenCL 98/105/25,对应 L1/L2/L3);LLM 输入 PyTorch 参考程序和目标设备描述,输出统一 Kernel IR(图级+张量级+调度级),LLVM/OpenCL/CUDA 适配器逐级下降并部署,评测流水线依次做编译执行、与 PyTorch 参考的输出等价校验、预热后配对测速、按后端与层级汇总。LEKA 侧:维护候选树 $T_t=(V_t, F_t)$ 记录所有程序状态与转换,各层常驻 agent 在契约 $C_\ell$ 约束下优化,形式化为 $x_{\ell,t+1} = \mathcal{A}_\ell(x_{\ell,t} \mid q, h, C_\ell, \Pi_{\ell,h}(T_t, v_{\ell,t}), r_t)$,其中 $\Pi_{\ell,h}$ 投影出与当前层和目标设备相关的搜索历史与测量证据;跨层转换 $\Lambda_{\ell\to\ell+1}$ 由编译器确定性完成,只保语义、做合法化与接口转换,不搜候选;只读的硬件感知 agent 剖析候选、定位瓶颈层并输出报告 $r_t$,驱动下一轮迭代。
核心创新是决策与表示对齐,加上知识接口解耦,两点都和已有方法有本质区别。第一,输出接口层面:已有 LLM 内核生成(包括训练时 RL 微调和推理时 agent 迭代)几乎都把一份原生程序当作生成与优化单元,模型要同时满足每个后端的语言、接口和合法性规则,跨后端知识无法迁移;EdgeKernelBench 让 LLM 在统一 IR 中表达计算、调度与内存决策,确定性适配器负责下降,于是怎么优化可以跨后端复用,落到哪个后端变成纯工程问题,新后端通过适配器即可加入。第二,反馈归因粒度层面:把一个原生程序当优化单元时,奖励对整个程序打分、profile 只指出慢的内核而不指出错误的决策层级;LEKA 沿 IR 层级(L0 图/算法、L1 循环/调度、L2 目标源码)各设一个 agent,每个 agent 只看自己层暴露的优化空间,硬件感知 agent 把测量证据归因到具体层并路由给该层 agent,把耦合的跨层决策拆解成层内决策、把执行反馈归因到决策级别,同时降低了每次调用的上下文负担。此外,论文显式把调度与内存决策放进同一优化空间——融合与分解决定哪些中间张量被物化、存活多久,局部调度决定数据复用与临时存储——呼应边缘场景性能与内存必须联合权衡的需求,这是与只追速度的服务器基准在优化空间定义上的差异。
方法步骤详情
完整流程六步。第一步任务构建:从开源边缘模型、算子库、内核库选取代表性计算,将动态计算转成静态形式并统一为 PyTorch 接口(Model 类定义参考计算,get_inputs 提供输入,get_init_inputs 提供初始化参数),配以按应用场景组织的静态 shape profile(如 DIMENSION_0、CONFIGURATION_0 字段),最后人工审查图一致性与语义保真。第二步一次性生成:提示词包含系统指令(优化目标、表示语法、正确性要求、输出格式)、Device Hardware Profile(设备能力与资源约束)、一组示范样例和目标任务(PyTorch 参考与张量规格),模型返回一份完整可执行程序,不附带解释文字。第三步正确性验证:在目标设备上编译执行,用三个随机种子的输入与 PyTorch 参考比对,要求输出结构、形状、数据类型一致且数值差在任务容差内,只有通过检查的程序才进入测速。第四步配对测速:候选与基线在同一设备会话、相同输入与计时边界下预热后重复测量,用稳健变异系数 $\mathrm{rCV}(x)=\frac{1.4826\,\mathrm{median}_i|x_i-\mathrm{median}(x)|}{\mathrm{median}(x)}$ 把候选延迟、基线延迟、配对加速比三条序列都约束在 5% 以内,报告中位数配对加速比 $s_i = t_{\text{baseline},i}/t_{\text{candidate},i}$。第五步 LEKA 迭代(每任务预算 L1 90 分钟、L2/L3 各 155 分钟):L0 图/算法 agent 在 Relax 层改图拓扑、融合边界、数据布局与静态参数准备(如 NHWC 布局、1×1 卷积改写为矩阵乘);编译器 $\Lambda$ 语义保持地下降到 TIR;L1 调度 agent 改循环结构、并行映射、内存层级、数据访问,可联合优化局部算子区域;再下降为 CUDA C/OpenCL C/LLVM IR;L2 目标源码 agent 在保持调用接口的前提下改写计算体、指令组织、向量化与寄存器复用。第六步反馈闭环:硬件感知 agent(只读、永不编辑 IR)在目标设备上构建并剖析每个候选,测量延迟与硬件计数器,定位需要继续优化的层 $\ell_t$ 并写报告 $r_t$,对应层 agent 依据报告生成下一候选;候选树保留全部历史分支用于比较、回滚与继续搜索,上游变更后自动重建受影响的下游实现并保留最佳已验证完整程序。
技术新颖性
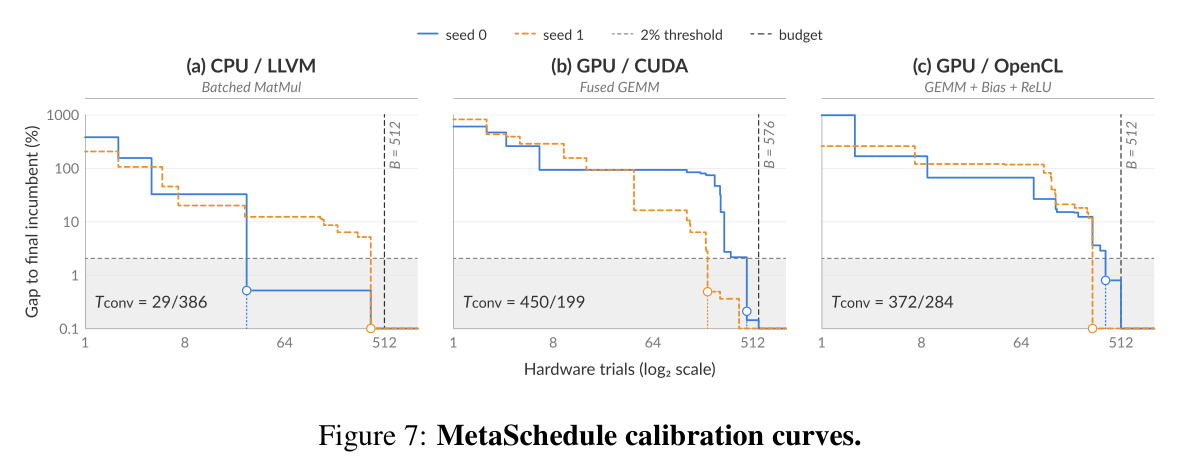
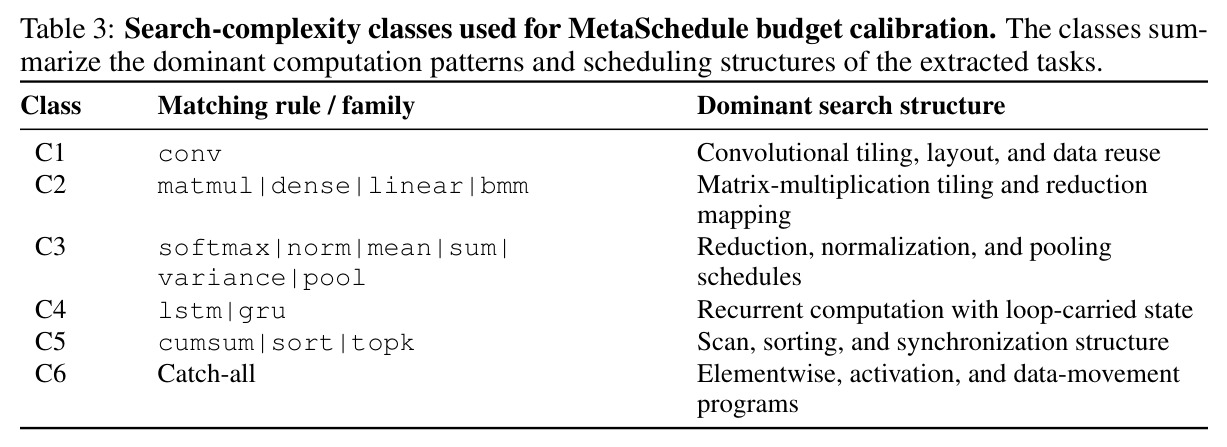
技术新颖性集中在四处。第一,这是首个系统性研究跨异构边缘后端 LLM 内核生成的工作:既有基准要么停留在服务器级硬件(KernelBench、TritonBench 及 NPU/TPU/多厂商扩展如 AscendKernelGen、KernelGenBench),要么推进到手机但只覆盖单算子及属性变体(MobileKernelBench);本文把复杂度轴推进到紧凑模型图、把应用轴铺满移动/机器人/AIoT,并保持 KernelBench 评测协议以便横向比较。第二,统一 IR 作为 LLM 输出接口:推理引擎把优化知识固化在专家手写内核与调度规则里(MNN、TensorRT、ExecuTorch),张量编译器靠规则定义的调度空间加成百上千次片上测量搜索(Ansor、MetaSchedule),两者都到不了编码之外的变换;本文让持有优化知识的 LLM 直接在 IR 上决策、编译器只做确定性下降与代码生成,兼得知识灵活性与部署可移植性。第三,分层 agent 架构:借鉴 MLIR 式渐进下降,把多级 IR 与 agent 分工结合,每层 agent 的上下文从全局程序逐级收窄到局部实现细节,在 LLM 内核优化文献中是新的组织方式——已有方法无论是 RL 微调(Kevin、AutoTriton、DICE)、多角色迭代(Astra)、进化搜索(AVO)还是修复循环(MobileKernelBench)都不按表示层级拆分决策与反馈。第四,公平的编译器基线:TVM 基线不是固定预算,而是按六类搜索复杂度分类、用收敛判据($\epsilon=0.02$、$W=100$)校准出的每类预算 $B_{b,c}=\max(64,\ 1.25\cdot\max T_{\text{conv}})$(取 64 的倍数),使 LLM 与调优编译器的比较有可信的参照系。
实验结果
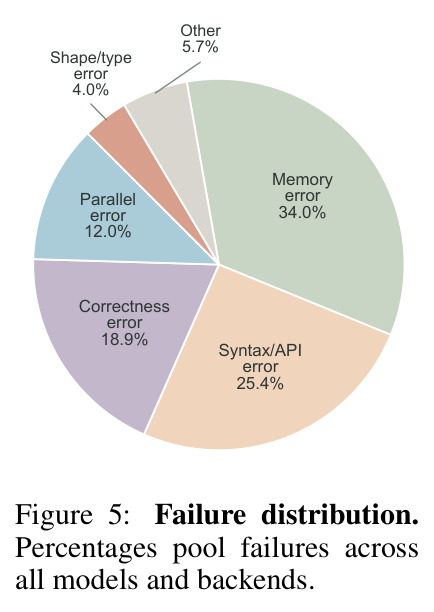
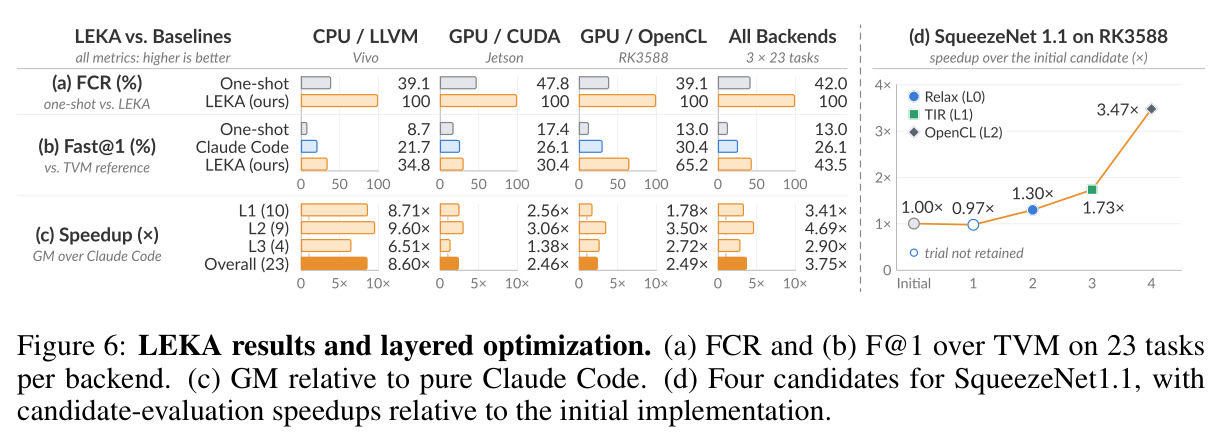
实验证据链覆盖一次性基线、生产引擎对比、失败分析和 agent 对比四个层面。(1) 一次性生成(650 实例、5 模型、3 后端,基线为 MetaSchedule 调优的 TVM):最强模型达到 73.5% Compile@1、64.5% Correct@1,但 Fast@1.0 仅 25.5%;最高 F@1 随层级骤降——Level 1 为 51.0%(GPT-5.6-sol,CUDA)、Level 2 降至 16.2%(Gemini,OpenCL)、Level 3 仅 4.0%(GLM-5.3,OpenCL),且 L3 上三个后端最高值都在 0.0%–4.0%。(2) 后端效应:CPU 正确率系统性高于 GPU——L1 最高 FCR 在 CPU 达 94.5%(DeepSeek),对比 CUDA 79.6%、OpenCL 73.5%,说明 GPU 的线程划分与并行映射更难写对;CUDA 的 F@1 整体高于 OpenCL,作者推测与训练语料中高质量 CUDA 代码更多有关。(3) 模型画像分化:GPT-5.6-sol 在多后端保持高 F@1;Gemini-3.7-Flash 擅长复杂任务(三个后端 L3 FCR 均最高,OpenCL L3 达 32.0%);DeepSeek-V4-Pro 在 CPU L2 上 FCR 75.3% 领先但对应 F@1 只有 3.2%(GPT 为 15.1%)——正确率高不等于跑得快。(4) 与生产引擎对比:对 MNN 3.3.0,F@1 峰值在 CPU L1 50.7%、GPU 31.6%,L2/L3 降至 14.9%/5.3%,高加速比集中在少数任务;对 TensorRT 10.3,最高 F@1 L1 43.2%、L2 5.3%、L3 0.0%,阈值 p=2 时最高任务占比仅 7.4%。(5) 失败构成(图 5):内存错误 34.0%(多为分配合法性而非容量不足)、语法/API 25.4%、正确性 18.9%、并行 12.0%;分层看(图 8)GPT 在 CPU 的失败里语法/API 占 54.0%、CUDA 上并行错误占 29.7%,Gemini 在两个 GPU 后端内存错误均过半,DeepSeek 在 OpenCL 上数值正确性错误占 32.5%。(6) LEKA(69 实例分层抽样,每后端 23 个即 10/9/4 个 L1/L2/L3,基座 GLM-5.3-Flash):CSR 60.9%→100.0%、FCR 42.0%→100.0%、F@1 13.0%→43.5%(对比一次性生成);与同预算同基座的 Claude Code 相比,F@1 26.1%→43.5%、总体 GM 3.8×;分层 GM 为 L1 3.41×、L2 4.69×、L3 2.90×,分后端总体 GM 为 CPU 8.60×、CUDA 2.46×、OpenCL 2.49×——L2 增益最大印证分层设计在多算子组合任务上的价值,L3 收窄暴露基座能力限制。(7) 案例佐证:SqueezeNet1.1@RK3588 逐层累计 1.30×→1.73×→3.47×;一次性生成中 Gemini 对 OpenCL ConvNeXt 块用两个内核(深度卷积+融合通道变换)达到 30.9×(18.0ms→0.6ms),而 GPT 全融合单内核仅 0.9×;Gemini 对 CPU 反量化+矩阵乘把零点校正与缩放移到归约之后,39.7ms(MNN)→2.1ms 即 19.0×,并为 2048×5632 权重矩阵省掉 44 MiB 浮点中间张量。
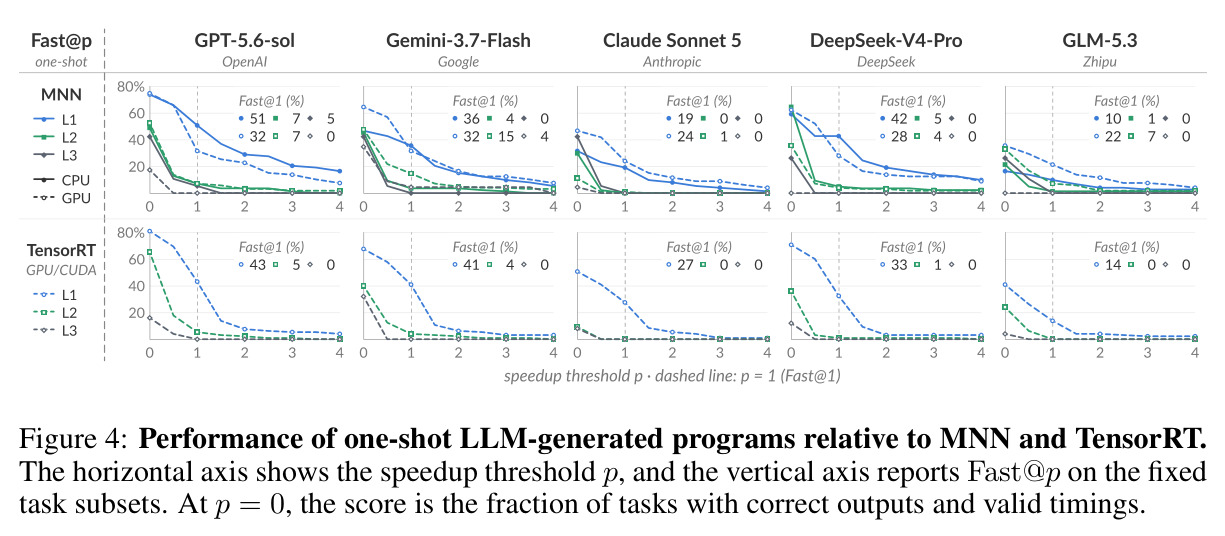
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 边缘内核一次性生成(650 实例全集,跨 5 模型 3 后端) | Fast@1.0(vs 调优 TVM) | 最佳模型 25.5%(Correct@1 64.5%、Compile@1 73.5%) | MetaSchedule 收敛校准调优的 TVM 基线 | 非提升项:功能正确率与加速率之间约 39 个百分点的落差,暴露一次性生成的性能天花板 |
| Level 1 单算子一次性生成(GPU/CUDA) | Fast@1.0 | 51.0%(GPT-5.6-sol) | 调优 TVM | 对比 Level 2 最高 16.2%、Level 3 最高 4.0%,量化复杂度上升带来的能力骤降 |
| Agent 评估子集(69 实例,基座 GLM-5.3-Flash) | Fast@1.0(vs TVM) | LEKA 43.5% | 一次性直接生成 13.0% | +30.5 个百分点(约 3.3 倍) |
| Agent 评估子集(同基座、同任务契约、同时间预算) | Fast@1.0(vs TVM) | LEKA 43.5% | 纯 Claude Code 26.1% | +17.4 个百分点;相对 Claude Code 的几何平均加速比 3.8× |
| Agent 评估子集(69 实例) | Correct@1 | LEKA 100.0%(CSR 亦从 60.9% 达 100.0%) | 一次性生成 42.0% | +58.0 个百分点,三后端全部 100% |
| 对比生产引擎 MNN 3.3.0(CPU/LLVM Level 1 固定子集,176 个 CPU 任务) | Fast@1.0 | 50.7%(最佳模型) | MNN 手写算子库 + 图优化(FP32) | 在半数基础算子上超过工业引擎;但 L2/L3 仅 14.9%/5.3%,大加速比集中在少数任务 |
| 对比生产引擎 TensorRT 10.3(GPU/CUDA 固定子集,215/218 任务可支持) | Fast@1.0 | 43.2%(Level 1 最佳模型) | TensorRT(FP32、禁用量化与 TF32) | Level 2 仅 5.3%、Level 3 为 0.0%;加速阈值 p=2 时最高任务占比仅 7.4% |
局限与改进
作者明确承认的局限写在附录 G:评测只覆盖 CPU/LLVM、GPU/CUDA、GPU/OpenCL,未包含 NPU 等专用加速器;每个任务只在单一处理器上执行,没有做 CPU+GPU 的协同划分(涉及跨计算单元的任务分配与资源共享),因此结论不能直接外推到 NPU 或异构执行场景。我自己的观察有五点。其一,agent 评估子集只有 69 个实例(每后端 23 个,Level 3 仅 4 个),LEKA 在 L3 的 GM 降到 2.9× 这一关键负结果的样本量太小,统计方差可能很大。其二,LEKA 与 Claude Code 的对比只用 GLM-5.3-Flash 一个基座(作者归因于推理预算约束),更强基座上分层架构是否仍有优势未知,作者也承认收益受基座能力约束。其三,尽管动机部分反复强调边缘要联合优化性能与内存,评测指标(Fast@p、GM)只度量延迟,没有任何内存占用维度,一个省内存但稍慢的实现会被判负,动机与指标之间存在脱节。其四,统一 IR 只在 TVM 一个编译栈上实例化,MLIR/IREE 等替代栈上的可移植性主张未经实验验证。其五,LEKA 每任务预算 90/155 分钟,远超一次性生成,虽然与 Claude Code 的对比是同预算公平比较,但论文没有报告 token 消耗或 LLM 调用次数,无法评估分层架构本身的效率代价。
独立分析的弱点
独立分析出五个弱点。第一,动机与指标错位:全文强调边缘内存紧张、需要性能-内存联合权衡,但 Fast@p 和 GM 都只看延迟,没有峰值内存、内存带宽利用率等指标,内存友好但慢 5% 的实现直接落败;改进方向是引入内存受限加速比或多目标 Pareto 前沿评测。第二,反馈归因依赖硬件感知 agent 的剖析质量,而边缘设备计时噪声大(为此引入 rCV≤5% 门槛),论文没有量化瓶颈归因的准确率,错误归因会把优化引导到错误的层浪费预算;改进方向是给归因输出加置信度校准,并用归因关闭/随机路由的消融实验验证其必要性。第三,一次性结果对后端语料熟悉度高度敏感——GLM-5.3 在 CPU 上 CSR 仅 61.5%,GPT 在 CPU 失败中语法/API 错误占 54.0%——说明基准分数部分衡量的是模型见过多少 TVM IR/OpenCL 代码,而非优化能力本身,可能系统性低估模型在不熟悉表示上的真实水平;改进方向是按表示统计模型的先验暴露度,或提供少量适配示例后再评分。第四,跨层协调机制描述较薄:上游变更后下游需重建,论文未统计重建频率与浪费的算力,也没有给出层间请求-协调失败或死锁时的处理策略;改进方向是把跨层契约形式化,报告跨层请求的成功率与成本。第五,L3 上 LEKA 增益收窄(GM 2.9×,且作者归因于基座对长依赖链大图的推理限制),说明分层只降低上下文负担、不增加模型能力;改进方向是在 L0 引入检索增强(相似模型结构的优化范例库),或对每层 agent 用层级别执行奖励做 RL 微调。
未来方向
作者在附录 G 提出的方向包括:用 MLIR 基础设施(如 IREE)暴露更细粒度的表示,支持不同的 agent 分工方式;系统比较不同层边界、上下文共享与跨层反馈机制,在收窄每个 agent 搜索空间与保留计算-内存-调度联合优化机会之间寻找平衡;把评测扩展到 NPU,研究专用算力与片上内存约束下的程序优化;在同一设备的 CPU+GPU 间联合优化计算划分、数据传输与同步,考察异构执行收益随负载与资源预算的变化。基于本文成果还可延伸出几条路线:把内存占用正式纳入奖励与指标,做性能-内存 Pareto 前沿评测,补上动机与指标的脱节;做跨后端知识迁移实验,检验同一份 IR 决策能否零样本落到训练时未见的新设备,直接验证统一 IR 的核心主张;对每层 agent 用层级别执行奖励做 RL 微调,把 Kevin/AutoTriton 式的训练时方法嫁接到分层接口上;让 LLM 与编译器搜索混合分工——LLM 负责代数重写与融合边界,MetaSchedule 搜局部调度;以及随基座能力增强,研究论文结尾提出的开放问题:层边界能否下移,即把更多指令级决策交给模型,以及如何设计帮助 agent 推理优化约束的 IR。
复现评估
复现条件中等偏上。有利因素:论文给出项目主页(pillor9.github.io/EdgeKernelBench/),全栈建立在开源的 TVM 0.23.0 上;任务是标准 PyTorch 语义模板加静态 shape profile,来自开源库的任务有来源与改编文档;评测协议写得非常细——三个随机种子校验、配对测量、rCV≤5% 稳定性门槛、Jetson MAXN 模式且 GPU 时钟校验约 1.3 GHz、RK3588 GPU 锁 1 GHz;TVM 基线的收敛校准公式($\epsilon=0.02$、$W=100$、预算取 64 的倍数、XGBoost 成本模型、梯度任务调度器、num_trials_per_iter=64)与 LEKA/Claude Code 的完整提示词模板(附录 F)全部公开;agent 预算(L1 90 分钟、L2/L3 各 155 分钟)明确。不利因素:需要真实边缘硬件——骁龙 8 Gen 3 手机(iQOO Neo9S Pro+)、Jetson AGX Orin 64GB、RK3588 开发板各一台,以及设备在环的自动化评测环境;一次性评测涉及 GPT-5.6-sol、Gemini-3.7-Flash、Claude Sonnet 5、DeepSeek-V4-Pro、GLM-5.3 等商业 API(各用默认推理设置);复现 LEKA 需 69 个任务 × 最多 155 分钟的真实设备在环迭代,纯 wall-clock 就需数天;论文正文未见明确的代码开源许可证声明,需以项目主页实际内容为准。总体判断:拥有边缘设备与 API 预算的团队复现表 1 主结果可行;完整复现 LEKA 实验工程量较大,但对单一后端做缩小版验证是现实的。
论文图表
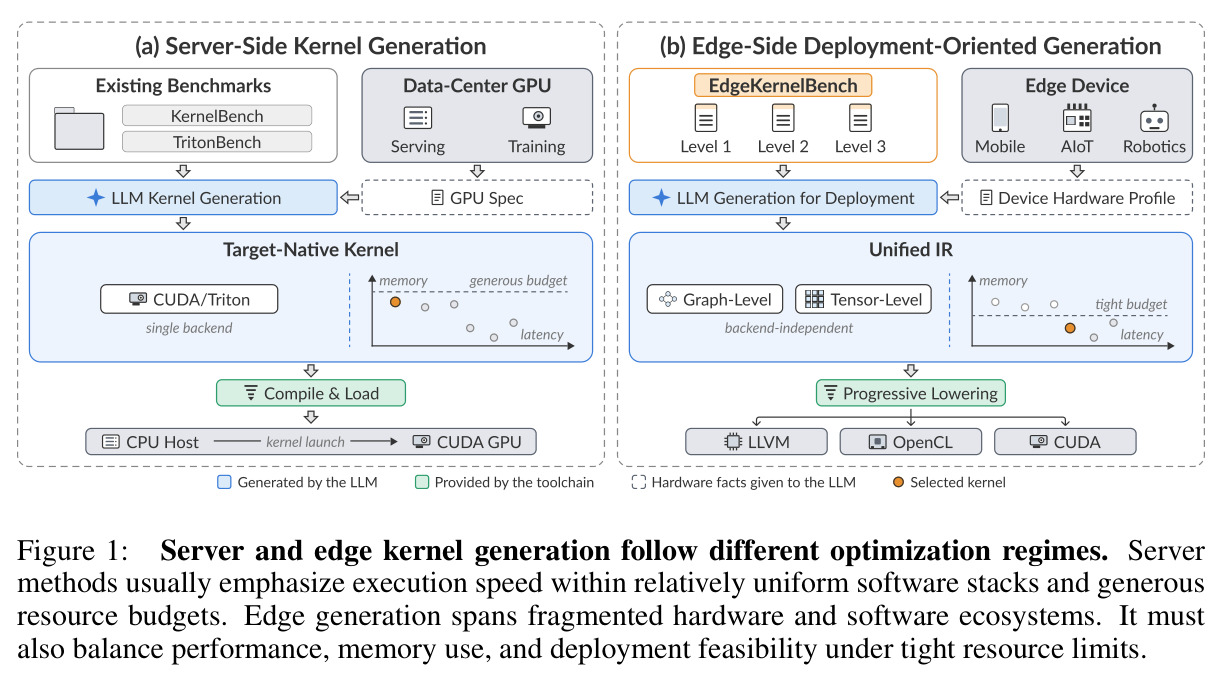
对比服务器侧与边缘侧内核生成的范式差异。左图(服务器):现有基准 KernelBench/TritonBench 面向数据中心 GPU,LLM 生成目标原生的 CUDA/Triton 代码,单一后端、内存预算充裕、CPU 主机只负责内核启动,优化重点只有执行延迟。右图(边缘):EdgeKernelBench 面向移动、AIoT、机器人设备,LLM 在设备硬件档案(Device Hardware Profile)辅助下生成后端无关的统一 IR(图级+张量级),经渐进下降到 LLVM/OpenCL/CUDA,内存预算紧张、需同时权衡延迟与内存。图例区分了 LLM 生成的部分与工具链提供的部分。
一图读懂论文的问题动机与总体设计:为什么边缘内核生成不能照搬服务器方法(碎片化生态+紧预算),以及统一 IR + 渐进下降如何把碎片化后端收敛到单一生成接口。
5 模型 × 3 后端的失败构成矩阵(每格为一类错误占该模型该后端失败的比例,行和为 100%)。关键读数:GPT-5.6-sol 在 CPU 上语法/API 错误占 54.0%、CUDA 上并行错误占 29.7%、OpenCL 上语法错误占 30.9%;Gemini-3.7-Flash 在 CPU 上内存错误占 56.2%,且在两个 GPU 后端内存错误均超过 50%;Claude Sonnet 5 在两个 GPU 后端内存错误同样过半(61.6%/66.5%);DeepSeek-V4-Pro 在 OpenCL 上数值正确性错误占 32.5%(能编译执行但输出超容差);所有模型在 CPU 上并行错误均为 0。
图 5 只给全局平均,这张分层图揭示模型×后端的差异化失败画像,说明失败原因高度依赖后端与模型组合,是设计后端特定反馈(而非通用反馈)的实证依据。
主结果表:5 个模型 × 3 个后端(CPU/LLVM、GPU/CUDA、GPU/OpenCL,任务数分别为 91/93/20、98/95/25、98/105/25)× 3 个层级,报告 CSR、FCR、Fast@1。代表性读数:DeepSeek-V4-Pro 在 CPU L1 上 FCR 94.5%(全场最高正确率);GPT-5.6-sol 在 CUDA L1 上 F@1 51.0%(单格最高加速率);L3 上最高 F@1 仅 4.0%(GLM-5.3,OpenCL),多数模型 L3 F@1 为 0;Claude Sonnet 5 在两个 GPU 后端的 L2 FCR 仅 9.5%–10.5%,与其 CPU 表现形成鲜明反差。
论文最重要的定量证据,支撑三大结论:能力随任务复杂度骤降、正确率与性能脱钩(DeepSeek CPU L2 FCR 75.3% 但 F@1 仅 3.2%)、后端生态显著影响生成质量。