TeleAntiFraud 2.0:面向电信诈骗检测的可刷新、画像锚定、音频基准 TeleAntiFraud 2.0: A Refreshable, Profile-Grounded, and Audio-Based Benchmark for Telecom Fraud Detection
用混合树生成与月度冻结快照构建可刷新、抗捷径的音频反诈基准
前置知识
近域负样本(near-domain negatives)
与诈骗正样本共享场景设定、参与者和早期话术、只在关键行为上分叉的合法通话。传统基准用无关主题的负样本,模型靠词汇或来源捷径即可拿高分;近域对照迫使模型理解“来电者最终要求了什么操作、独立核实是否仍可能”等行为级证据。
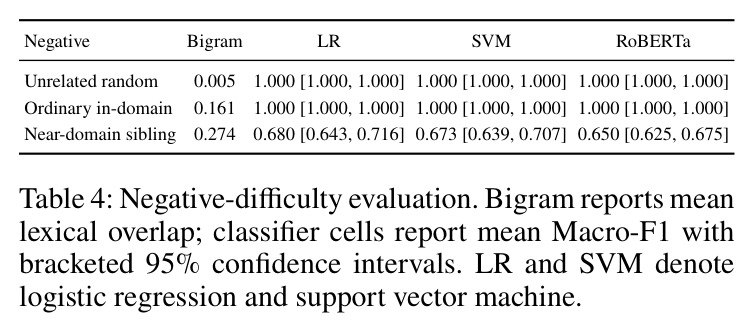
这是本文的核心创新与实验设计主线,Table 4 的负样本难度消融正是为验证其有效性而设。
混合树(mixed tree)
在同一场景画像下展开多条结果分叉对话路径的树结构,形式化为 $T_x=(V,E,r,\phi,\sigma,\tau)$,节点状态 $\sigma(v)\in\{A,F,N\}$ 分别表示歧义、诈骗、合法;实现取深度 $D=4$、分支 $b=3$,最多 $3^4=81$ 个候选叶子,标签由完整轨迹的状态转移累积决定而非生成时指定。
它是生成管线的形式化骨架,方法步骤、兄弟路径构造与标签理由模式都建立在这一定义上。
冻结快照(frozen snapshot)
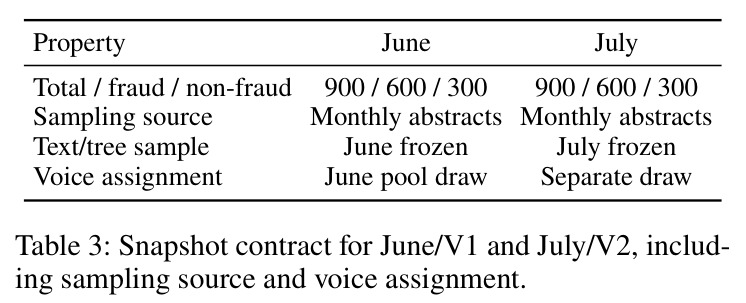
按月份把评估集连同音频、标签与理由、清单(manifest)、模型原始响应、评估时间戳和溯源记录一起固化为不可变版本;新观察到的诈骗模式只进入后续快照,已发布快照永不修改,从而在“持续刷新”与“结果可复现可审计”之间取得平衡。
“可刷新”是标题关键词,理解快照契约才能理解基准如何演化以及 Table 3 的设计动机。
Macro-F1 与类别先验
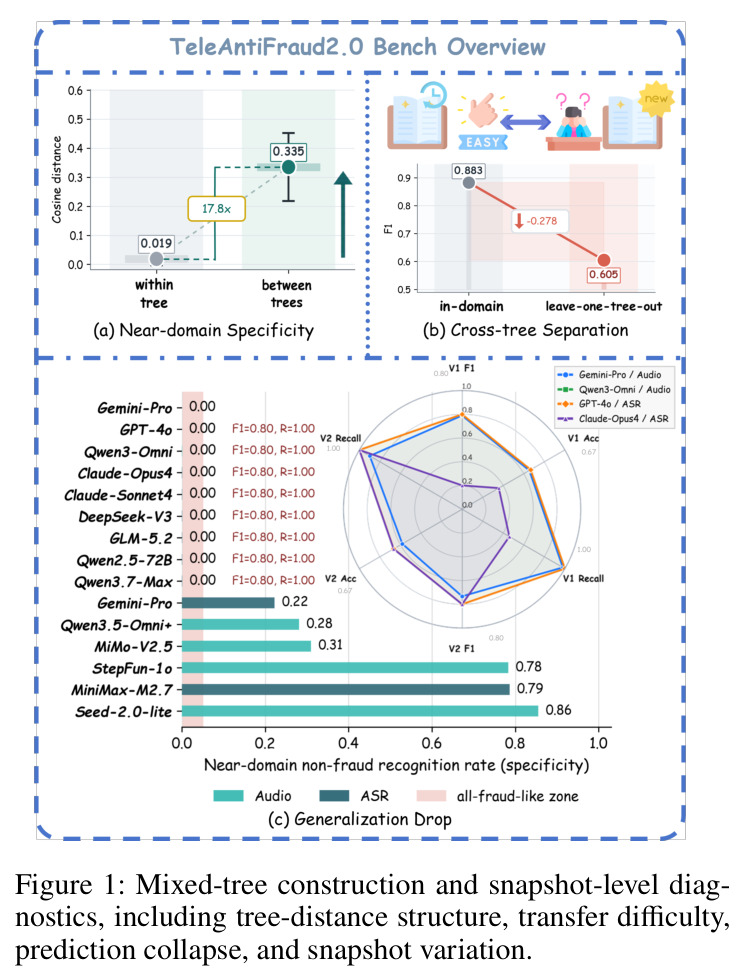
Macro-F1 是各类别 F1 的算术平均,不受类别占比影响;而单看诈骗类 F1 会随正负比例虚高——全预测为诈骗时 fraud-F1 恰等于诈骗占比(2:1 时约 0.80),Balanced Accuracy 则恒为 0.500,非诈骗召回恒为 0。论文用 1:2、1:1、2:1 三种重采样定量证明了这一点。
论文核心诊断结论就是仅报告 fraud-F1 会掩盖预测坍缩,必须联合报告类别平衡指标与预测分布。
ASR+LLM 评测通路
先用 Whisper-medium 把每条通话音频转写一次,同一转写喂给所有 LLM 做二分类,以避免各模型自带语音前端差异;与之对照的是直接接收波形的 Omni 类音频模型。输出被约束为 FRAUD/NONFRAUD 两标签契约,越界响应记入错误标志并保留原始响应。
Table 5/6 的主实验沿直接音频与 ASR+LLM 两条输入通路展开,理解该设置才能正确解读模型间分数差异。
研究动机
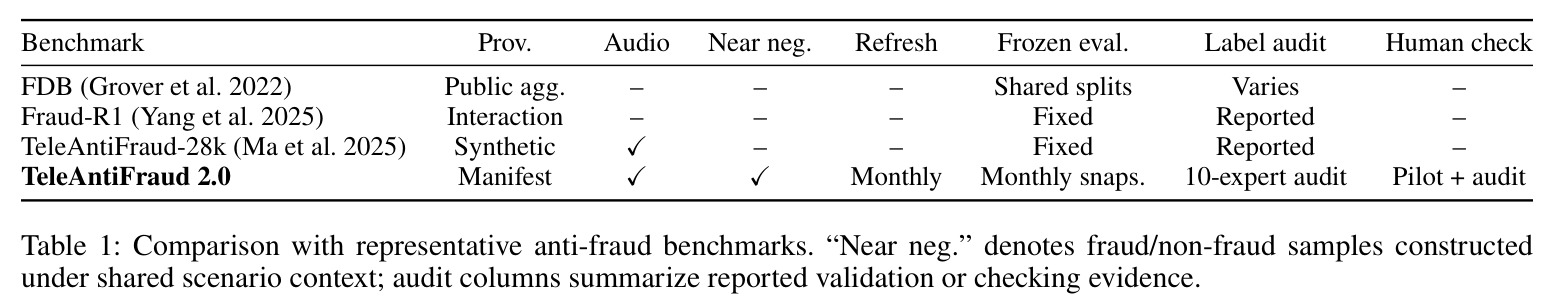
音频电信诈骗检测是直接关系公共安全的高风险语音与语言理解任务:诈骗电话混合身份冒充、流程话术、紧迫感与胁迫,诱导受害者泄露敏感信息或执行危险操作;据 Global Anti-Scam Alliance 与 Feedzai 基于 58,329 份问卷的 2024 年报告,全球诈骗损失超过 1.03 万亿美元。现有评测资源存在两大缺口。其一,固定测试集无法吸收发布之后新观察到的诈骗模式——被冒充机构、索要动作和说服策略持续演化,FDB、Fraud-R1、TeleAntiFraud-28k 均为固定集合,后者还不公开原始通话转写、且音频前缀与标签相关;而不断替换旧测试例又会使历史结果无法复现比较。其二,负样本常取自不相关主题或普通客服通话,论文实验显示:无关负样本的 Bigram 词汇重叠仅 0.005、普通域内负样本 0.161,此时 LR、SVM、RoBERTa 三个分类器的 Macro-F1 全部达到 1.000,说明既有分数大量来自主题捷径而非真正的诈骗识别能力。
本文的目标是本文目标是构建一个“可刷新且可审计”的音频电信诈骗基准。具体而言:基准能按月吸收新收集的诈骗案例摘要、不断纳入新话术,而每个已发布快照永久不可变——音频、标签与理由、生成元数据、评估提示、模型原始响应与溯源记录全部冻结,使历史结果可复现可比较;同时用混合树管道构造与诈骗样本共享场景、角色和早期上下文的近域合法兄弟通话,把标签锚定在“来电者请求了什么动作、独立核实是否仍可能、通话如何收尾”等行为级证据上,消除主题捷径;最后建立坍缩感知的报告协议,联合报告 Macro-F1、Balanced Accuracy、两类召回、预测分布与快照间波动。当前交付物包含 June/V1 与 July/V2 两个冻结快照,各含 900 条中文通话(600 诈骗 + 300 近域合法,固定 2:1),以及构建代码、评估脚本、清单与文档的完整研究工件。
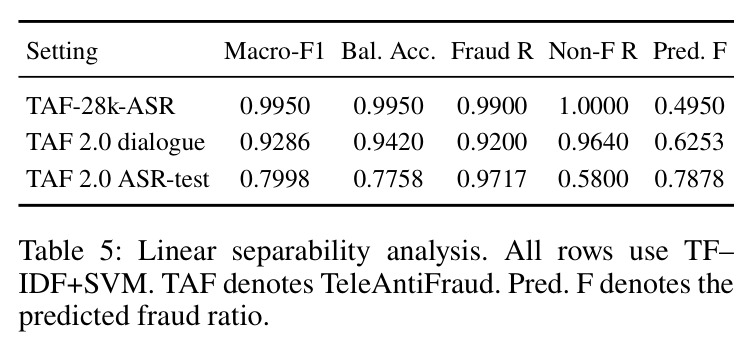
与已有工作不同的是,已有工作各自只覆盖部分需求:FDB 聚合公开欺诈数据集但无音频、无近域负样本;Fraud-R1 评估多轮诈骗诱导但属文本交互、固定集合;TeleAntiFraud-28k 提供音频文本基准但不吸收新案例、缺乏近域合法对照、不公开转写且音频路径前缀与标签相关(存在泄露捷径)。Dynabench、对比集与 datasheets 等一般方法论倡导动态、可审计评测,却未落到语音反诈这一具体高风险领域。本文的独特切入是把三件事统一成一个契约:月度冻结快照提供版本化刷新与复现;共享上下文的兄弟分叉路径让标签由行为而非话题决定;基于清单的溯源与十专家标签审计让每个分数可回溯到具体配置。论文还用受控实验定量证明既有基准的主题捷径虚高了表现——同一 TF–IDF+SVM 在 TeleAntiFraud-28k 的 ASR 转写上 Macro-F1 达 0.9950,而在本文 ASR-test 设置下降到 0.7998。
核心方法
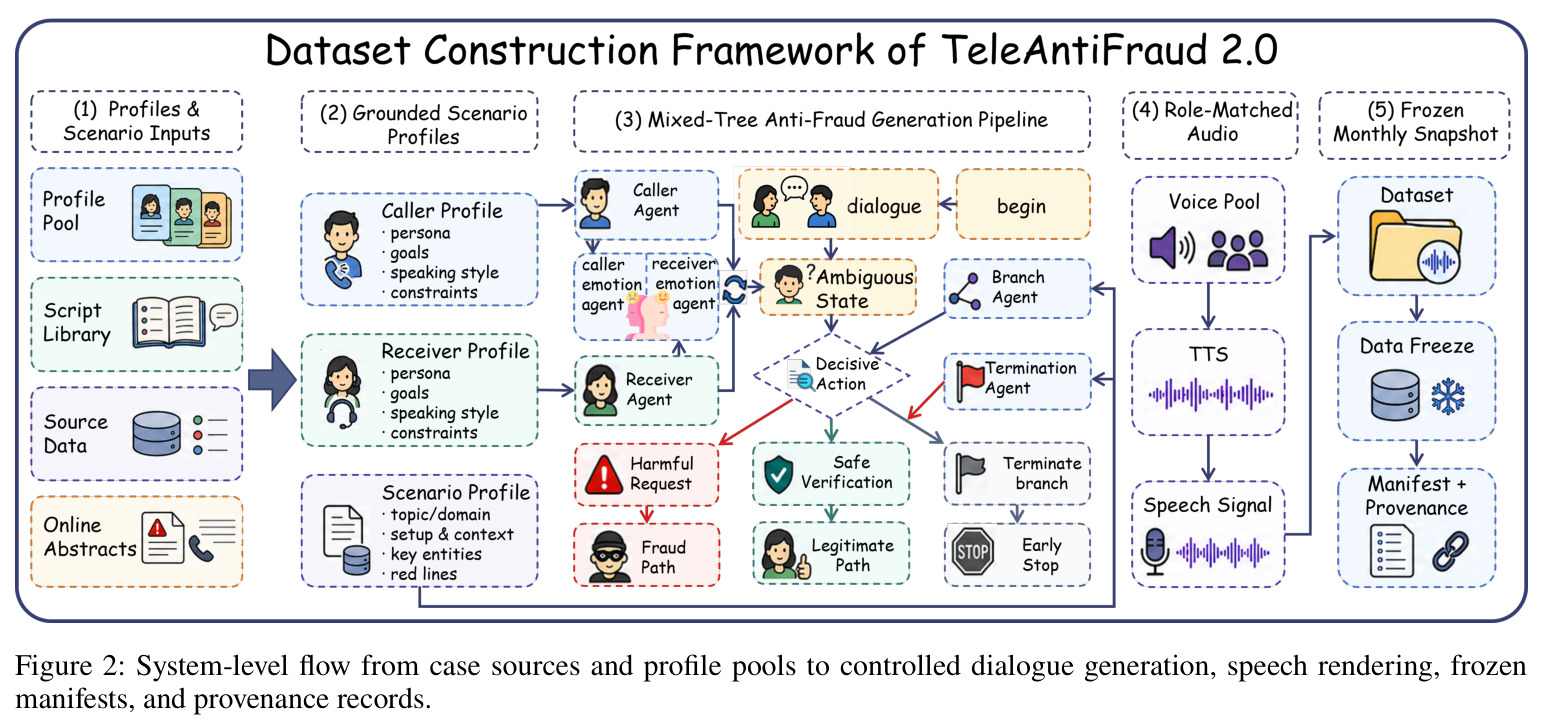
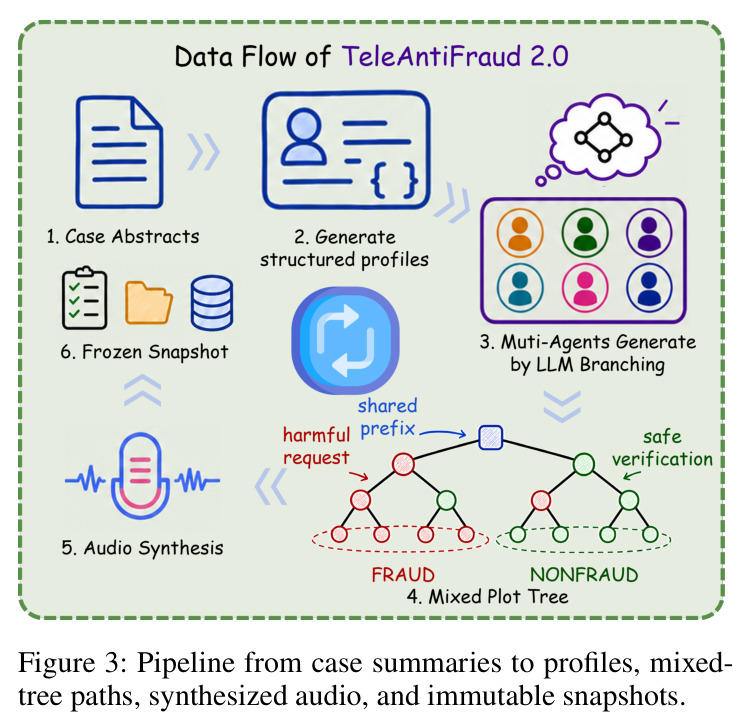
直觉上,判断一通电话是否诈骗,关键不在聊什么话题,而在对方最终要求你做什么:正规银行风控来电允许独立核实,诈骗来电则索取验证码、卡片影像并伴随威胁。本文据此提出混合树反诈生成管道,分四阶段把在线诈骗案例摘要转化为可溯源通话音频。(1) 场景画像(Scenario Profiling):把案例摘要解析为结构化画像,规定接收者背景、来电者伪装身份与说服策略、分阶段交互目标、风险实体和风险节点。(2) 混合树展开(Mixed-Tree Expansion):在共享画像与开场上下文下展开结果分叉的对话树 $T_x=(V,E,r,\phi,\sigma,\tau)$,节点属性 $\phi(v)=(p,h_v,o_v,d_v)$,状态 $\sigma(v)\in\{A,F,N\}$ 表示歧义/诈骗/合法。(3) 协作对话实现(Collaborative Dialogue Realization):六个智能体把每条路径逐轮转写为带角色与情绪传递状态的对话。(4) 语音渲染(Speech Rendering):为不同角色匹配不同音色并按传递状态合成语音,经信号级质检后组装为 900 条、诈骗:合法 = 2:1 的月度冻结快照。
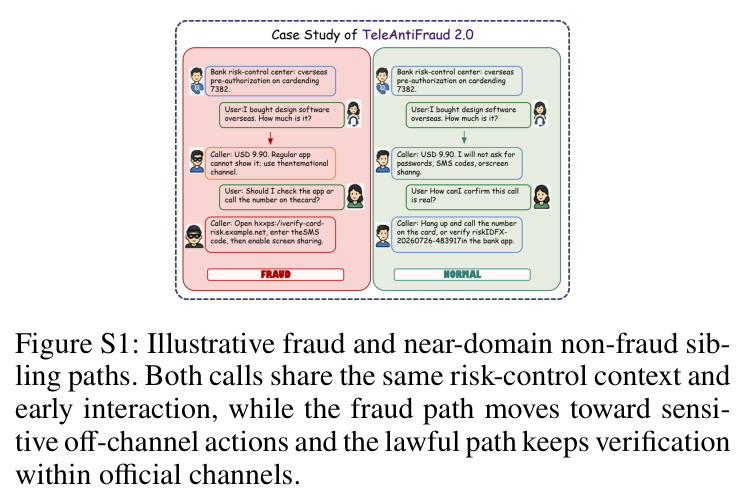
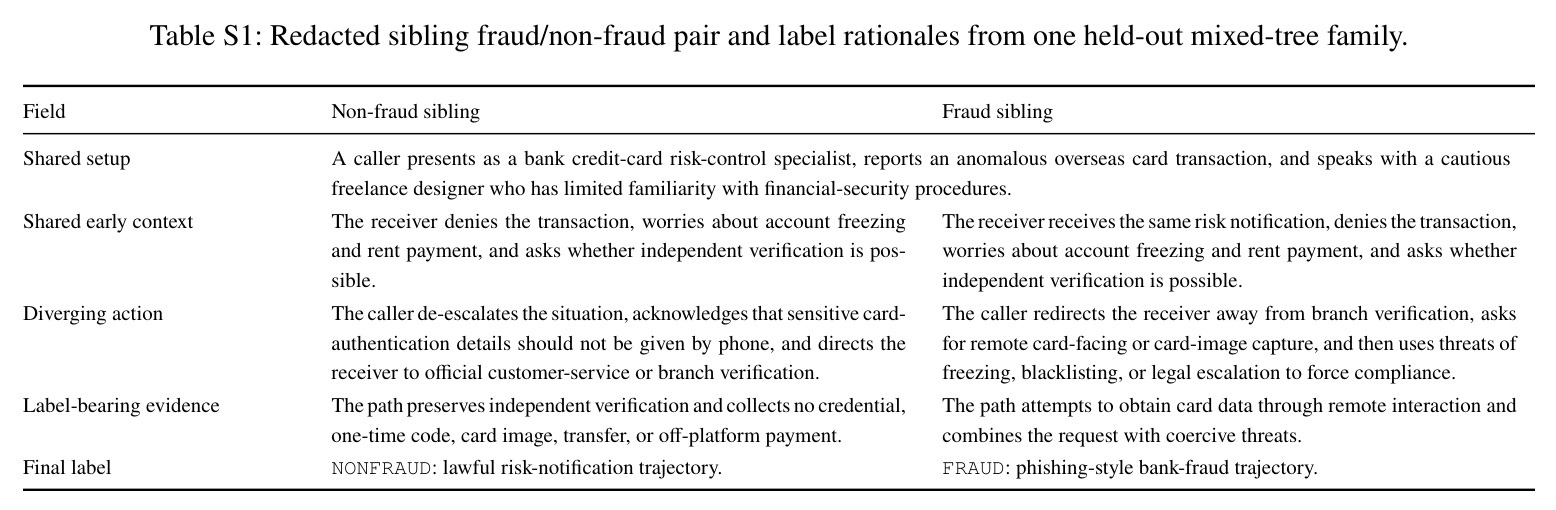
核心创新是“标签由行为分叉而非话题决定”的兄弟路径构造。传统基准独立生成正负样本,二者在开场语境与话术风格上系统性不同,模型学到的其实是来源捷径;本文在同一棵混合树内让诈骗与合法兄弟路径共享参与者、场景设定、开场轮次与早期风险语言,只在一个承载标签的动作上分叉——例如同一通冒充银行信用卡风控的来电,合法分支劝受害者去线下柜台核实、不收集任何凭证,诈骗分支则要求远程截取卡片影像并以冻结账户、列入黑名单相威胁。模型若不能判断“独立核实是否仍可能、通话以何种操作收尾”,就无法区分兄弟路径。文本消融定量印证:负样本 Bigram 重叠从 0.005(无关)升到 0.274(兄弟),三个分类器 Macro-F1 相应从 1.000 跌到 0.650–0.680。第二个关键设计是月度冻结快照:刷新只发生在快照之间,快照内部一切永久不可变,兼顾演化追踪与结果复现。
方法步骤详情
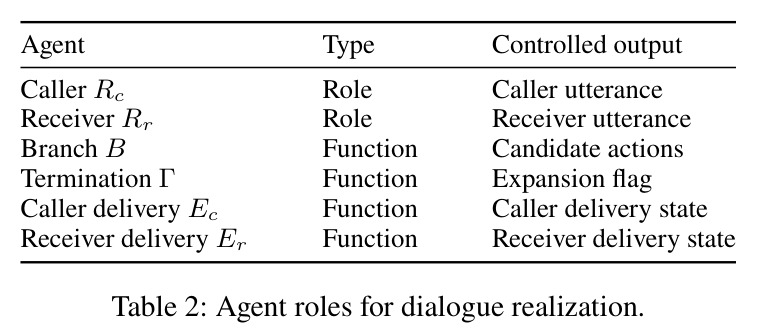
输入是诈骗案例摘要 $x$ 及其画像 $p$。第一步场景画像:从摘要提取结构化表示,区分“家族内共享上下文”(参与者、场景、早期风险线索)与留给树展开的变量。第二步混合树展开:根节点 $\phi(r)=(p,h_0,1,0)$、$\sigma(r)=A$;对每个深度 $d_v<D$ 的开放节点,分支函数 $A_v=B(p,h_v,\sigma(v))$($|A_v|\le b$)提出索要凭证、允许官方核实、拒绝请求、挂断等情节级动作,结构校验函数 $\rho$ 过滤非法子节点,终止函数 $\Gamma$ 决定封闭时机,状态转移函数 $\tau$ 依动作更新 $\sigma$;实现取 $D=4$、$b=3$,理论上限 $3^4=81$ 个叶子,仅轨迹证据充分的终叶进入标签集 $L(T_x)=L_F\cup L_N$。第三步协作对话实现:六智能体系统 $G=R\cup F$,角色智能体 $R_c,R_r$ 按画像与历史生成台词 $u_t=R_{s_t}(p,h_t,\sigma_t,a_t)$,功能智能体 $B,\Gamma$ 控制剧情与终止,$E_c,E_r$ 分配紧迫/困惑/中性等传递状态,逐轮记录 $(s_t,a_t,u_t,e_t)$ 使每句台词可溯源到剧情决策。第四步语音渲染:从 35 个授权参考音色(29 男 6 女)按角色匹配抽样,按存储的传递状态合成语音,信号级检查剔除损坏音频后冻结为带完整清单与溯源记录的月度快照。
技术新颖性
技术新颖性有四点。其一,形式化混合树:不同于单结局故事树,它在同一调用家族内同时保留歧义、偏诈骗、偏合法与自然终止的延续,$\sigma(v)\in\{A,F,N\}$ 的状态机使标签从“生成时指定”变为“由完整轨迹的状态转移累积决定”,是对比集局部决策边界思想在多轮语音对话上的推广。其二,结构控制与语言生成分离:六智能体把“接下来发生什么”($B,\Gamma$)、“怎么说”($R_c,R_r$)与“怎么说得像”($E_c,E_r$)解耦,避免无约束生成器把标签信息泄漏进措辞;补充材料显示去除情绪 token 会使聚合 F1 从 0.920 变到 0.960(单模型最大差 4.6 点),证明这类渲染变量确实影响分数。其三,可刷新的冻结快照协议:把基准当作持续维护的测量仪器,生成器与已发布工件分离维护,未来快照可在同一模式与清单契约下实例化新诈骗模式而不触碰旧结果,这在音频反诈领域尚属首次。其四,坍缩感知评测协议:要求联合报告 Macro-F1、Balanced Accuracy、两类召回、预测分布与快照间波动,而非单一 fraud-F1 排行榜。
实验结果
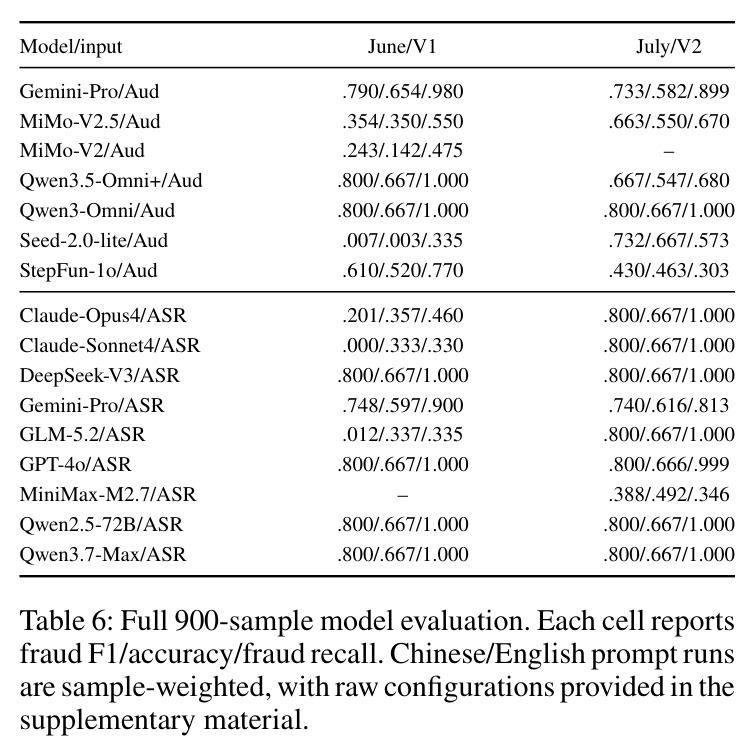
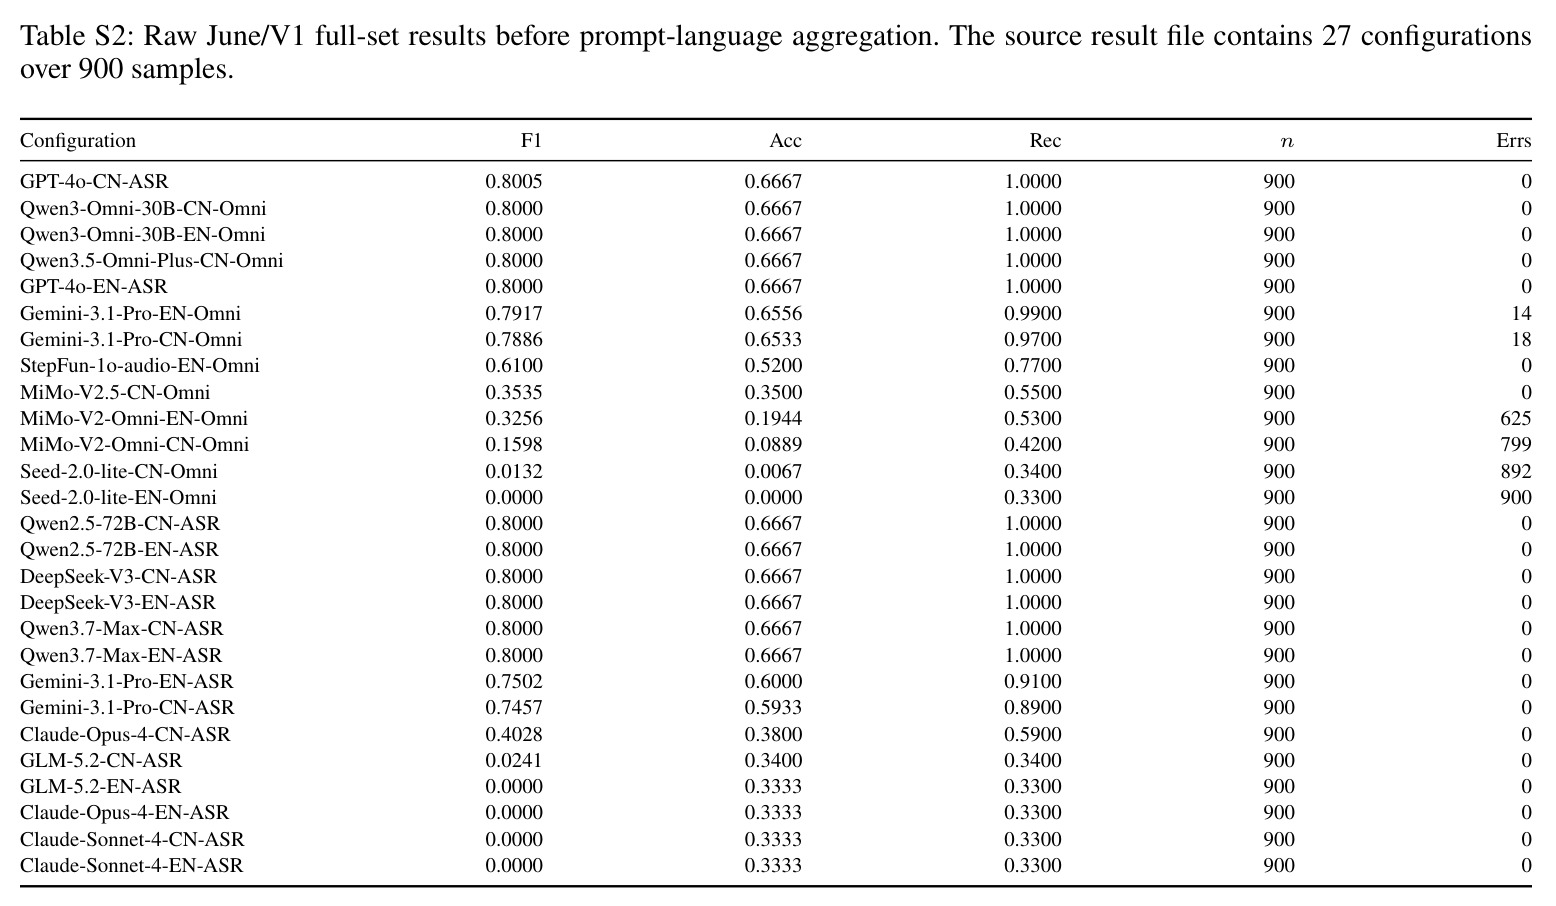
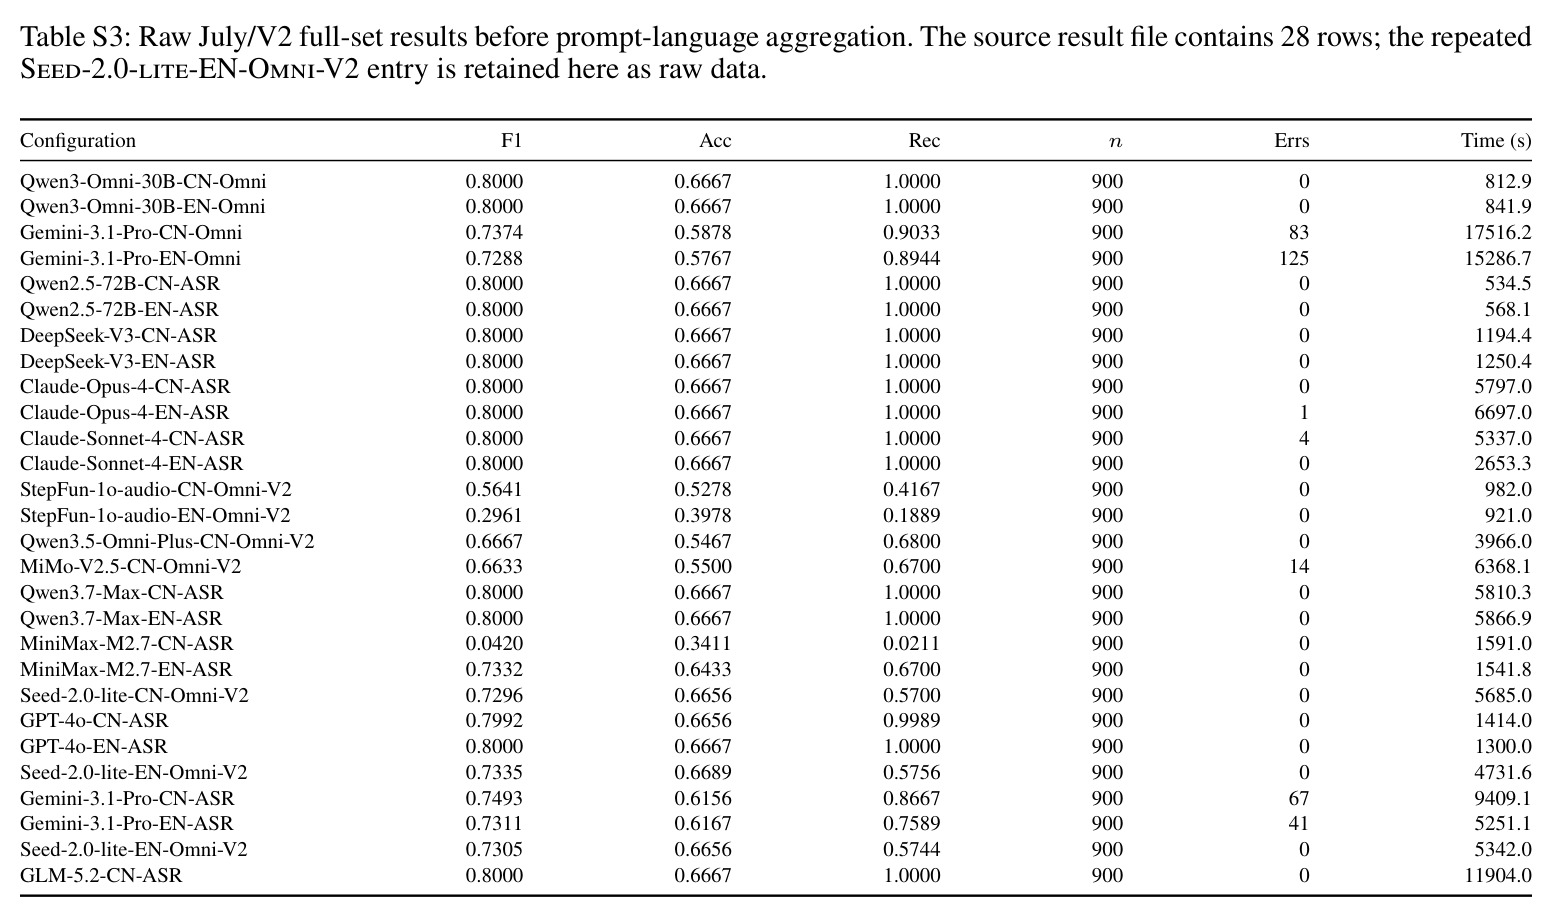
实验分四组。负样本难度消融(Table 4):负样本从无关随机到普通域内再到近域兄弟,Bigram 重叠 0.005→0.161→0.274,LR/SVM/RoBERTa 的 Macro-F1 从 1.000 跌至 0.680/0.673/0.650(95% CI 分别 [0.643,0.716]/[0.639,0.707]/[0.625,0.675]),证实近域构造消除了主题捷径。线性可分性(Table 5):同一 TF–IDF+SVM 下,TeleAntiFraud-28k ASR 转写 Macro-F1 高达 0.9950,本文对话文本为 0.9286,ASR-test 设置仅 0.7998,非诈骗召回跌到 0.58、预测诈骗比 0.7878,出现假阳性偏置。全量 900 样本评测(Table 6):V1 的 27 个配置中 11 个、V2 的 27 个中 15 个呈“全诈骗”签名(诈骗召回接近 1.0、准确率贴近 2:1 先验的 0.667、fraud-F1 约 0.80),GPT-4o、DeepSeek-V3、Qwen2.5-72B、Qwen3.7-Max 等 ASR 通道模型均如此;Claude-Sonnet-4 在 V1 上 F1 为 0.000,Seed-2.0-lite 在 V1 出错 892–900/900 条,且坍缩方向随快照翻转(Claude 两个版本在 V2 上都达 0.800)。类先验重采样:诈骗占比从 1:2 提到 2:1 时,全-FRAUD 基线的 fraud-F1 从 0.500 升至 0.800 而 Balanced Accuracy 恒为 0.500、非诈骗召回恒为 0。构建审计:树内/树间 BGE 嵌入距离 0.0188/0.3351(17.8 倍),留一树外推 F1 从 0.883 掉到 0.605;十专家 1000 项标注与修正金标一致率 0.792(0.700–0.880),平均置信度 4.431/5,744 项标记证据充分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 负样本难度消融(近域兄弟文本分类) | Macro-F1(5 个种子重采样均值) | LR 0.680 / SVM 0.673 / RoBERTa 0.650 | 无关随机与普通域内负样本下三者均为 1.000 | 难度显著提升:Macro-F1 下降 0.32–0.35,证明主题捷径被消除 |
| 跨基准线性可分性(TF–IDF+SVM) | Macro-F1 | TeleAntiFraud 2.0 ASR-test 0.7998(对话文本 0.9286) | TeleAntiFraud-28k ASR 转写 0.9950 | 线性可分性大幅降低 0.20,且非诈骗召回从 1.0 降至 0.58 |
| 全量 900 样本音频/ASR+LLM 评测(June/V1 与 July/V2) | fraud F1 / 准确率 / 诈骗召回 | 最佳真实识别系统难以超过 0.80,且多伴随全诈骗坍缩签名 | 全-FRAUD 基线即得 fraud F1 0.800 / Acc 0.667 / Recall 1.000 | 暴露 11/27(V1)与 15/27(V2)配置的预测坍缩, fraud-F1 单一指标失效 |
局限与改进
作者承认的局限:所有通话均为合成对话加 TTS 渲染(因真实诈骗通话涉及隐私、安全敏感与有害内容),基准只能作为受控诊断工具,不能声称匹配真实电话分布;35 个参考音色中男 29、女 6,人口学代表性不足;情绪只作为受控渲染变量,不做因果断言;当前仅 June/V1 与 July/V2 两个快照,快照敏感性分析刚起步,长期时间性结论需要更多发布;80 段对话的对话质量与音频自然度评分(4.60/4.41/4.35/4.13,1–5 分)来自单一标注者的试点检查,不能作为独立评级声明;与 TeleAntiFraud-28k 的跨基准比较只度量相对线性可分性,无法把差距归因于单一构造因素。我的补充观察:部分配置解析错误极高(Seed-2.0-lite 在 V1 达 892–900/900),错误样本如何进入聚合指标未充分说明;任务仅 FRAUD/NONFRAUD 二分类,未利用管道天然支持的诈骗类型/风险等级细粒度标签;“合法通话可含风险词汇但终局合法”的标签标准由生成器自身定义,存在一定循环性;无真实信道(8kHz、噪声、转接)仿真,音频通路结论可能偏乐观。
独立分析的弱点
弱点一:合成-真实鸿沟未量化。论文只做了单人试评与十专家标签审计,没有与任何真实录音(哪怕脱敏的合法客服录音)对比韵律、信道与话术分布,合成音频上的模型排序未必迁移到真实拦截系统;改进方向是引入小规模真实录音校准子集并报告分布差异。弱点二:任务定义过窄。全部样本仅 FRAUD/NONFRAUD 二分类,而反诈系统实际需要诈骗类型、风险等级与干预时机;论文自己的理由模式(共享上下文、分叉动作、承载证据)天然支持细粒度标注却未利用,可把分叉动作直接映射为风险类型多标签。弱点三:渲染侧捷径风险。35 个音色且男女 29:6 失衡、单声道、无信道仿真,音频模型可能借音色指纹或合成痕迹作弊;应做音色指纹泄漏消融并加入信道仿真与重录音。弱点四:错误处理不透明。V1 最高 900/900 条解析错误,如何计入 F1 会显著改变结论,应按错误标志分层报告并给出不依赖标签解析的鲁棒指标。弱点五:2:1 固定比例虽有利于覆盖诈骗多样性,但使准确率的多数类基线即为 0.667,排行榜应默认同时给出 1:1 重评结果(清单已支持)。
未来方向
作者提出的方向:发布更多月度快照以支撑长期时间性与快照间波动分析;保持生成器与已发布工件分离,让新诈骗模式不经修改管道即可实例化;把树感知切分作为后续用该生成器做训练时的规范(留一树实验显示树间外推 F1 从 0.883 掉到 0.605)。可延伸方向:其一,把混合树管道反向用于训练数据增广,并按调用家族切分训练/验证/测试以防生成器捷径;其二,扩展到多语种与真实信道条件(8kHz、噪声、多方),检验近域难度是否保持;其三,把路径级标签理由升级为证据级评测——让检测模型输出它识别到的“分叉动作”,与生成时的动作记录对齐,衡量可解释性;其四,用 Dynabench 式人在环把专家审计中低一致率包(最低 0.700)反哺生成器,修复模糊或证据不足路径;其五,与真实反诈拦截系统联动,度量本基准排名与线上拦截指标的相关性,并研究快照序列上的模型退化监测;其六,把近域兄弟构造推广到其他高风险语音安全任务,如钓鱼语音与深伪语音检测。
复现评估
复现友好度较高。论文给出匿名代码库 https://anonymous.4open.science/r/TeleAntiFraud-2_0-EEB2/,研究工件包含构建代码、评估脚本、清单与文档;清单冻结音频 ID、转写 ID、模型/输入模式、提示语言、请求参数、原始响应、解析预测、错误标志与评估时间戳,允许不重跑模型做配置级复现与审计。数据规模适中:每快照 900 条通话,另附 80 段对话的音频质量试评包与 1000 项十专家标注记录。算力方面,文本消融只需 LR/SVM/RoBERTa 级别,门槛低;全量评测调用 27–28 个商业模型配置(Gemini-3.1-Pro、GPT-4o、Claude-Opus/Sonnet-4、DeepSeek-V3、Qwen 系列、GLM-5.2 等),从记录耗时看单配置可长至 17,516 秒,主要成本是 API 调用;语音渲染使用 Higgs TTS 3 需要自备 GPU。难点主要在数据生成侧:需复现画像-混合树-六智能体-语音四阶段管道并满足与已发布快照一致的清单契约;若只是下载快照做评测或审计,则几乎无门槛。
论文图表