Épi:迈向持续、自我改进的自主研究智能体 Epi: Towards a Persistent, Self-Improving Agent for Autonomous Research
跨会话持久研究的智能体Épi,产出120项数学纪录并以64%成本胜过Codex
前置知识
自主研究智能体
能自主设计实验、运行代码、解读结果并修正方法的 AI 系统,如 FunSearch、AlphaEvolve、The AI Scientist-v2。它们将大模型的代码生成能力与可执行评估(编译运行、数值检查)结合,在明确目标函数下迭代搜索更好的构造或程序。与普通编码助手的区别在于:研究智能体要跨多次实验维护研究方向、证据链和决策理由,而非一次性完成任务。
本文的 Épi 就是一个自主研究智能体,全文讨论的持久性、记忆、分支与评审都是围绕这类系统跨会话长期工作的特有挑战展开的。
固定标尺与增益下界
论文提出的评估协议。标尺预先定义提交格式、可行性条件、目标函数、归一化方式和比较参考值,验证器据此统一检查所有候选。增益下界 $\delta>0$ 规定改进量 $\Delta(x) = b - f(x)$(最小化问题)必须满足 $\Delta(x) \ge \delta$ 才算有效改进,排除因报告精度或例行后处理造成的虚假进步。
这是理解 Épi 结果可信度的关键:所有 120 项纪录都在同一标尺和增益下界下验证,防止智能体自我评估时的奖励黑客行为。
Cohn–Elkies 线性规划界
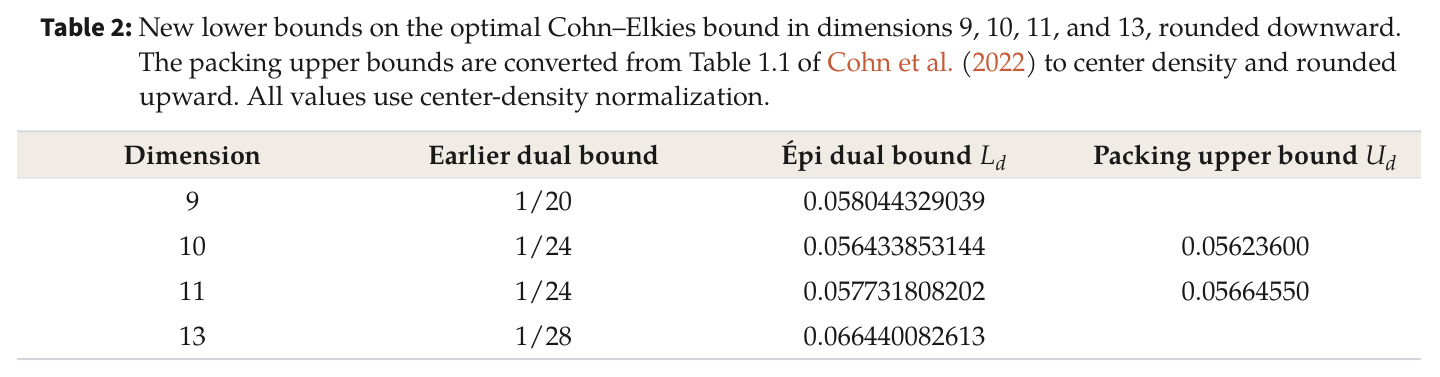
球堆积密度的上界方法:通过优化一个辅助函数(其傅里叶变换非负、在最小距离处非正)得到堆积密度上界。该方法是无穷维线性规划,Li (2022) 通过离散归约得到有限对偶问题,可给出该线性规划最优值的下界。若能证明此下界超过实际堆积密度的独立上界,则说明该方法在归一化下不可能取等,即方法本身有结构性局限。
论文最重要的理论结果之一就是用 Épi 的对偶证书证明 Cohn–Elkies 界在维度 10 和 11 不可能取等,理解这一背景才能看懂该结果的分量。
Tuza 猜想
1981 年提出的图论猜想:对任意有限简单图 $G$,删除所有三角形所需的最少边数(三角覆盖数 $\tau_\triangle$)不超过最大边不相交三角形数(三角打包数 $\nu_\triangle$)的两倍,即 $\tau_\triangle(G) \le 2\nu_\triangle(G)$。已知对二部图的类似关系成立(Kőnig 定理),图论中已证明该猜想对若干图族成立,如阈值图、无 $K_8$ 弦图。
Épi 给出了该猜想在新图族上的计算机辅助证明——8 顶点团部分的分裂图、至多三种三角形活跃邻域类型,这是理解论文从数值优化迈向数学证明的关键案例。
分层记忆与会话交接
借鉴人类记忆模型(Atkinson–Shiffrin),将智能体记忆分为短期(支撑当前研究)和长期(跨任务复用)两层。长期记忆存储可检索的经验条目:经验教训记录可复用发现,死胡同记录无效方案及放弃原因。会话结束时智能体写交接笔记说明当前状态和下一步,新会话只读取相关记忆条目和引用文件,而非回放全部历史。
这是 Épi 跨模型会话维持研究连续性的核心机制,也是它与单会话研究系统最本质的架构差异。
研究动机
现有自动研究系统(FunSearch、AlphaEvolve、The AI Scientist-v2)在单次模型会话内运转良好,但真实研究工作量往往远超一个会话能承载的规模。论文指出一旦调查跨越多个会话,智能体必须解决三个此前未被系统处理的问题。其一是研究连续性:继续一项调查需要访问运行中的任务、代码、中间结果以及早期决策的理由,Kosmos、InternAgent-1.5、ScienceFlow 虽各自保存共享状态或可恢复执行档案,但随着历史增长,如何在有限上下文中只挑选当前实验状态、相关教训和失败原因成为瓶颈。其二是从实验经验中学习:需要识别哪个选择产生了结果、方法在什么条件下适用、证据是什么,并把每条教训与条件和证据关联起来,MemoHarness 只在训练期构建记忆库、测试期复用,缺乏研究过程中的持续更新。其三是探索替代方案与回溯:单一方向只能覆盖方法空间的一部分,现有系统虽有树搜索或状态归档,但对可检验输出的研究,还需保留每个方案的实现与证据、在统一规则下比较候选、并在新发现使旧方向有用时恢复先前工作。
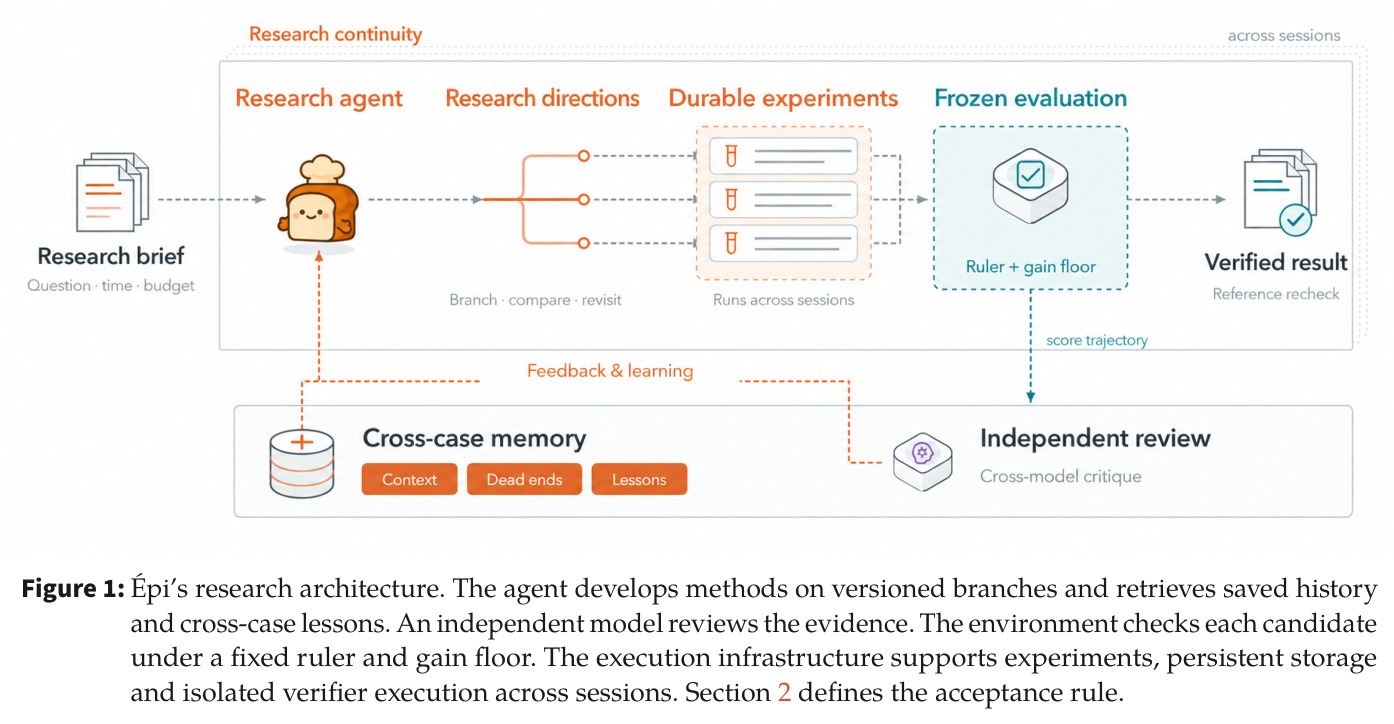
本文的目标是本文要构建一个持久且自我进化的自主研究智能体 Épi:它能在可验证的研究环境中跨越多个模型会话维持完整调查(一个完整的调查称为一个 campaign),通过层次记忆续接研究并检索早期经验,通过版本化分支开发替代方法并可回溯到已保存的实现,通过独立评审评估证据。所有分支在同一可行性检查、目标函数和比较值下评估;已验证的发现成为后续 campaign 的新参考或新任务。最终目标是产出可检验的研究成果——数值纪录、改进的构造、精确证书和计算机辅助证明——并让人类研究者能够检查方法如何演化、解释结果为何成立。
与已有工作不同的是,本文的独特切入角度是把持久执行、层次记忆、分支回溯与独立评审整合成一个闭环,并以固定标尺(ruler)加增益下界作为贯穿整个 campaign 的统一评价基础。与 Kosmos 的共享世界模型、ScienceFlow 的可执行状态归档、MemoHarness 的训练期记忆库不同,Épi 区分了会话内需要的实验状态与跨问题可复用的教训,明确存档被放弃的分支及原因;与 FunSearch/AlphaEvolve 只用测得性能引导程序生成不同,Épi 引入与开发智能体不同模型的独立评审者来审视研究方向,缓解自我纠偏的视角局限;其研究环境本身随已验证发现而演化——数值估计可以催生带证书表示和严格误差控制的认证任务。整个设计以连接自我改进与人类理解为宗旨:保留实现、实验产物与研究笔记,使结果可检查、可延伸。
核心方法
直觉上,Épi 像一位有实验室笔记本的研究者:实验在后台持续运行,每次坐下来(新会话)先翻看笔记和前辈留下的教训,再决定下一步。技术上,研究任务被定义为带参考结果 $b$、显式预算和可检验输出的问题:打包任务提交坐标与朝向,优化界提交对偶向量等证书,证明任务提交见证与论证。评估规则在搜索开始前固定——验证器先复现参考结果、测试输入校验、固定容差与增益下界 $\delta$。对最小化问题,改进定义为 $\Delta(x) = b - f(x)$,接受条件是 $V(x) = 1$ 且 $\Delta(x) \ge \delta$($\delta = 0$ 时要求 $\Delta > 0$);严格数值界还要求精确算术或控制误差的外向舍入。执行基础设施 Breadboard 提供隔离实验环境、跨会话长任务、代码与分支状态及实验输出的持久存储,并运行隔离验证器。实验中模型权重固定(GPT-5.6 Sol 与 GPT-6-Astra),改进完全来自经验反馈、检索记忆与独立评审。
核心创新是三大机制的耦合。第一,版本化分支与回溯:每个分支在版本化仓库中保存实现、测试和笔记,以 commit 保存变更,智能体可从早期 commit 开新分支、比较不同方法(如打包问题上一支精修坐标、另一支改变接触模式)后再分配算力,放弃分支时记录原因并保留备查。第二,层次记忆:短期记忆支撑当前调查,长期记忆在模型上下文之外的可检索存储中保存教训和死胡同;会话边界处写交接笔记,后续会话只接收相关记忆条目并按需打开引用文件,避免回放全部历史。第三,独立评审:用不同模型审阅分数轨迹、已尝试方案、检索到的发现、比较基线和资源使用,评估证据支持什么、智能体对进展的解读是否合理;评审者评估方向,隔离验证器按固定标尺检查有效性与增益。与已有系统的本质区别在于:这三种机制服务于同一套可验证协议,且环境随验证发现演化,使自我改进的产物(新纪录、新证书)直接成为下一代任务的参照。
方法步骤详情
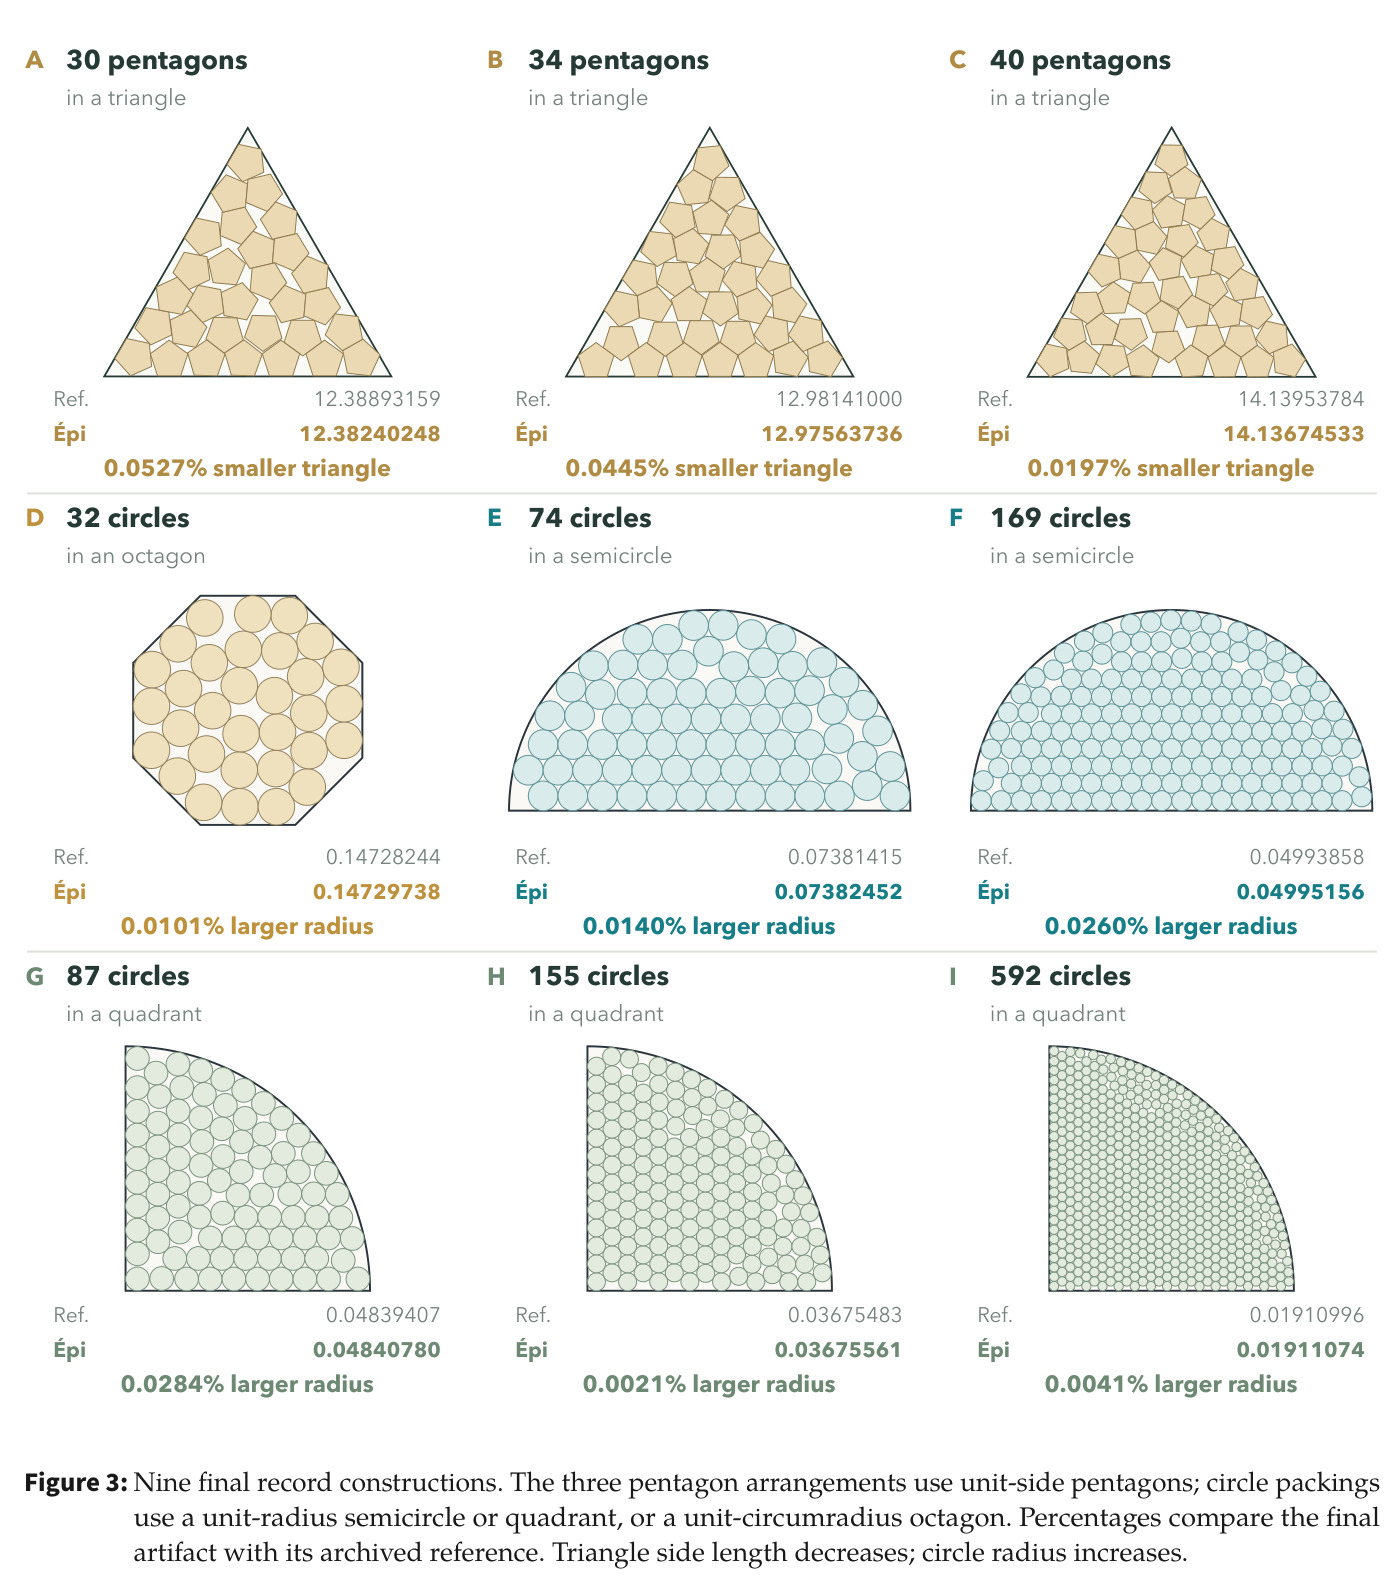
第一步,策展人提供问题与源材料(可含已发表构造作为初始参考),智能体自选方法与实验。第二步,环境预检:验证 scorer 能复现参考结果、测试输入校验、固定可行容差与增益下界并记录依据(如整数目标取单位粒度对应下界 1)。第三步,智能体在分支上开发方法并提交可检验对象:如 34 个单位边长正五边形放入等边三角形的任务,Épi 从 Friedman 的边长约 12.9814 的布置出发,联合精修中心与朝向,每次候选更新后检查包含与重叠。第四步,隔离验证器按固定标尺检查可行性与改进是否达到 $\delta$,几何构造查几何约束,数值界查证书与舍入方向,定理查有限检查加数学归约。第五步,会话边界写交接笔记与记忆更新(教训/死胡同),实验通过 Breadboard 跨会话运行。第六步,独立评审模型评估证据与方向,结论存档供后续会话使用。第七步,必要时回溯到旧 commit 或重访分支。第八步,验证后的发现设定新参考或催生下一 campaign 的新任务(如数值估计引出认证任务)。例如五边形案例最终边长 12.9756,降幅 0.0445%,全精度坐标随发布释放。
技术新颖性
技术新颖性体现在四个层面。协议层面:ruler 与增益下界把可行性约定、归一化、输入校验在搜索前显式化,消除不同文献数值不可比的隐患,并以固定标尺防止分数上升不代表任务本意的奖励黑客。架构层面:将记忆分为支撑当前调查的实验状态与跨问题复用的教训/死胡同两类,配合交接笔记实现有界上下文的续接,这是对长程智能体记忆的一次工程化细化。治理层面:评审者与开发者使用不同模型并记录评审者身份,把研究方向评估与产物验证分离,回应了自我纠偏研究和奖励黑客文献揭示的风险。认识论层面: Épi 明确要求把计算输出连接到可检查的数学论证——Tuza 定理案例中,560 个三型 profile 的精确覆盖/打包证书(共 18,444 个重数盒子)与 Zeng 截断引理的数学论证分离,独立检查器验证见证与完整 profile 枚举,从而把有限证书检查延展到任意重数的无限图族命题,示范了计算机辅助证明的证据结构。这种把自我改进与人类可理解性绑定的设计在同类系统中是少见的。
实验结果
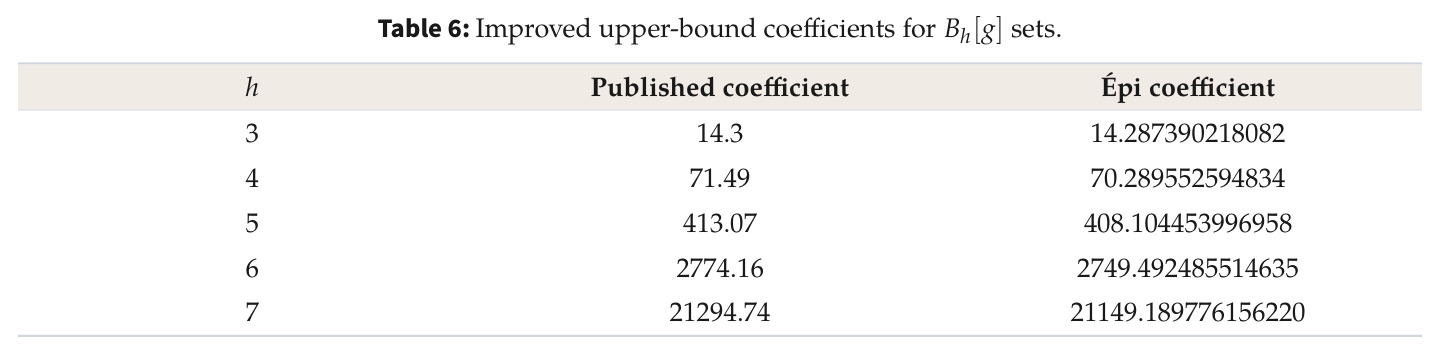
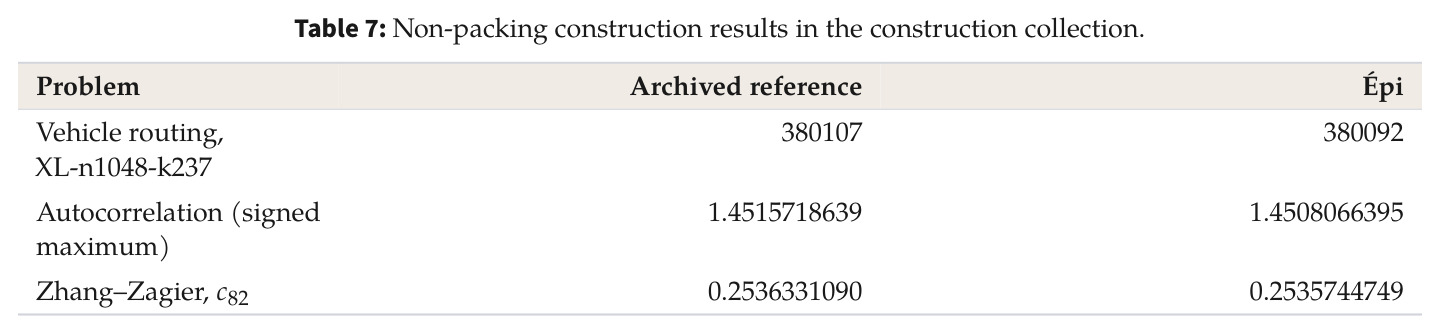
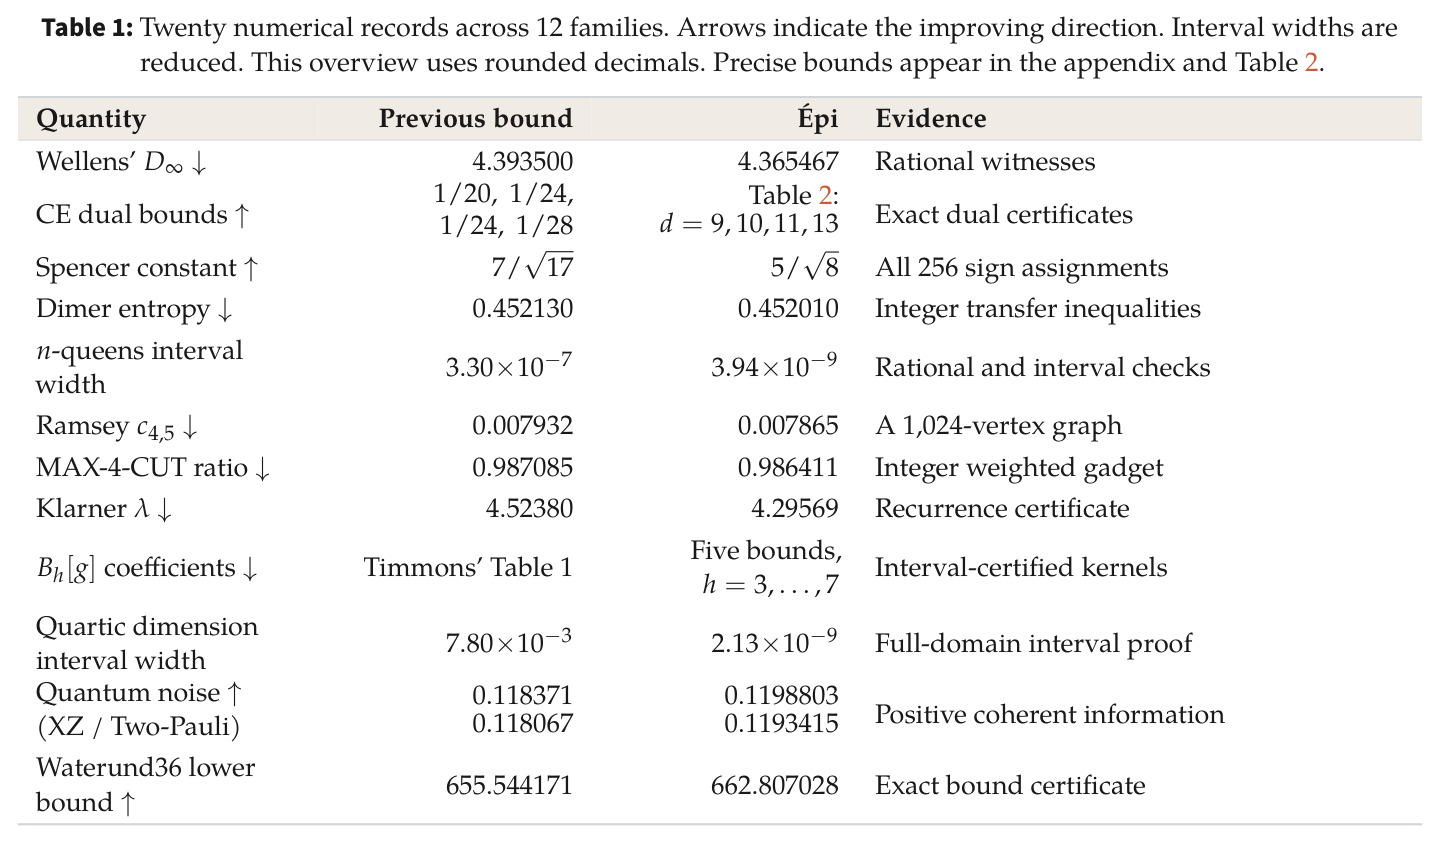
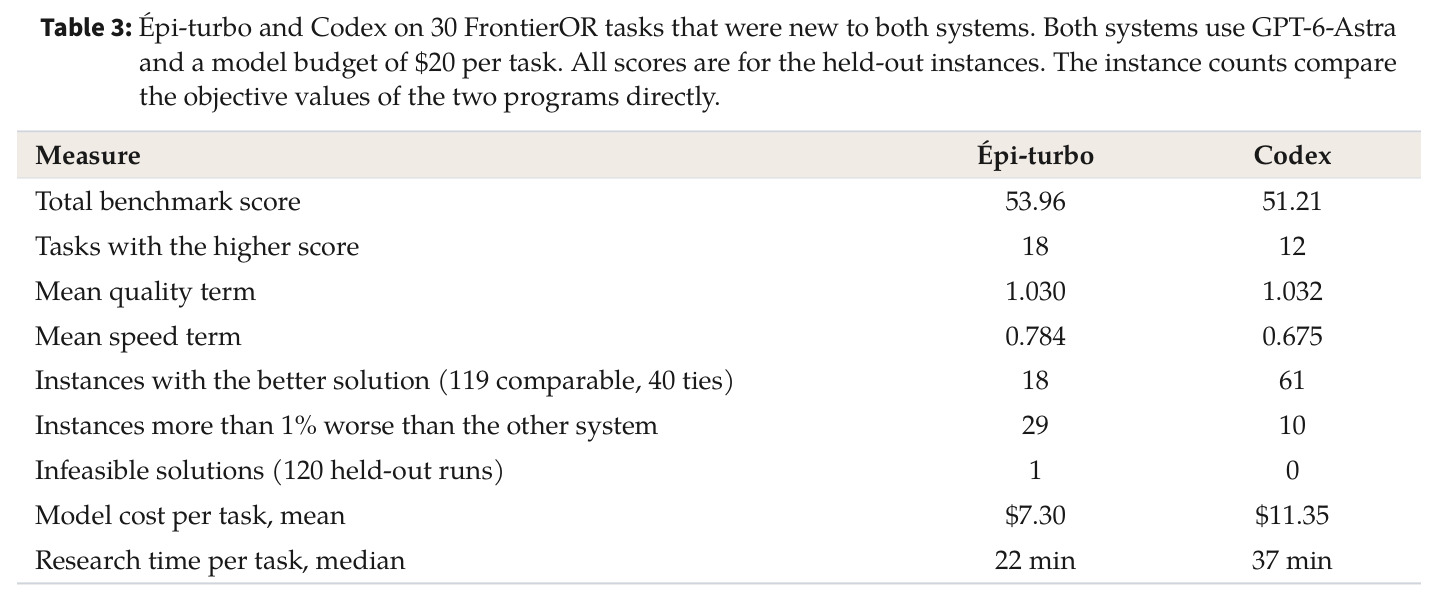
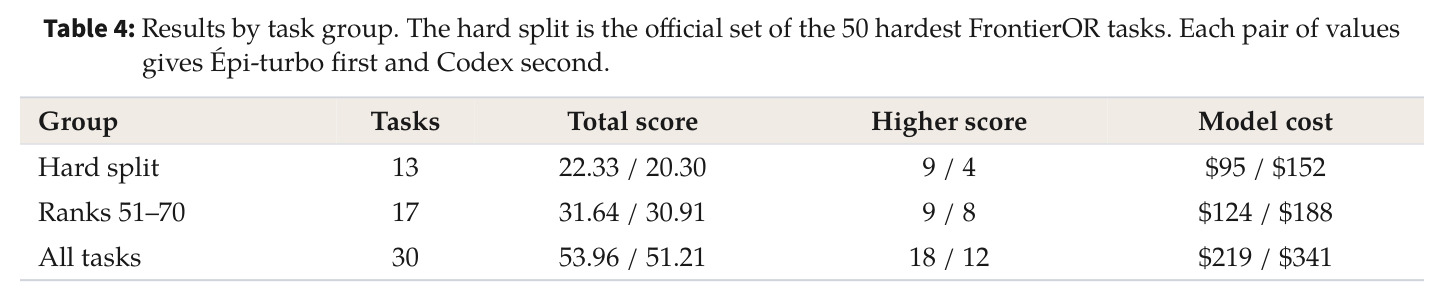
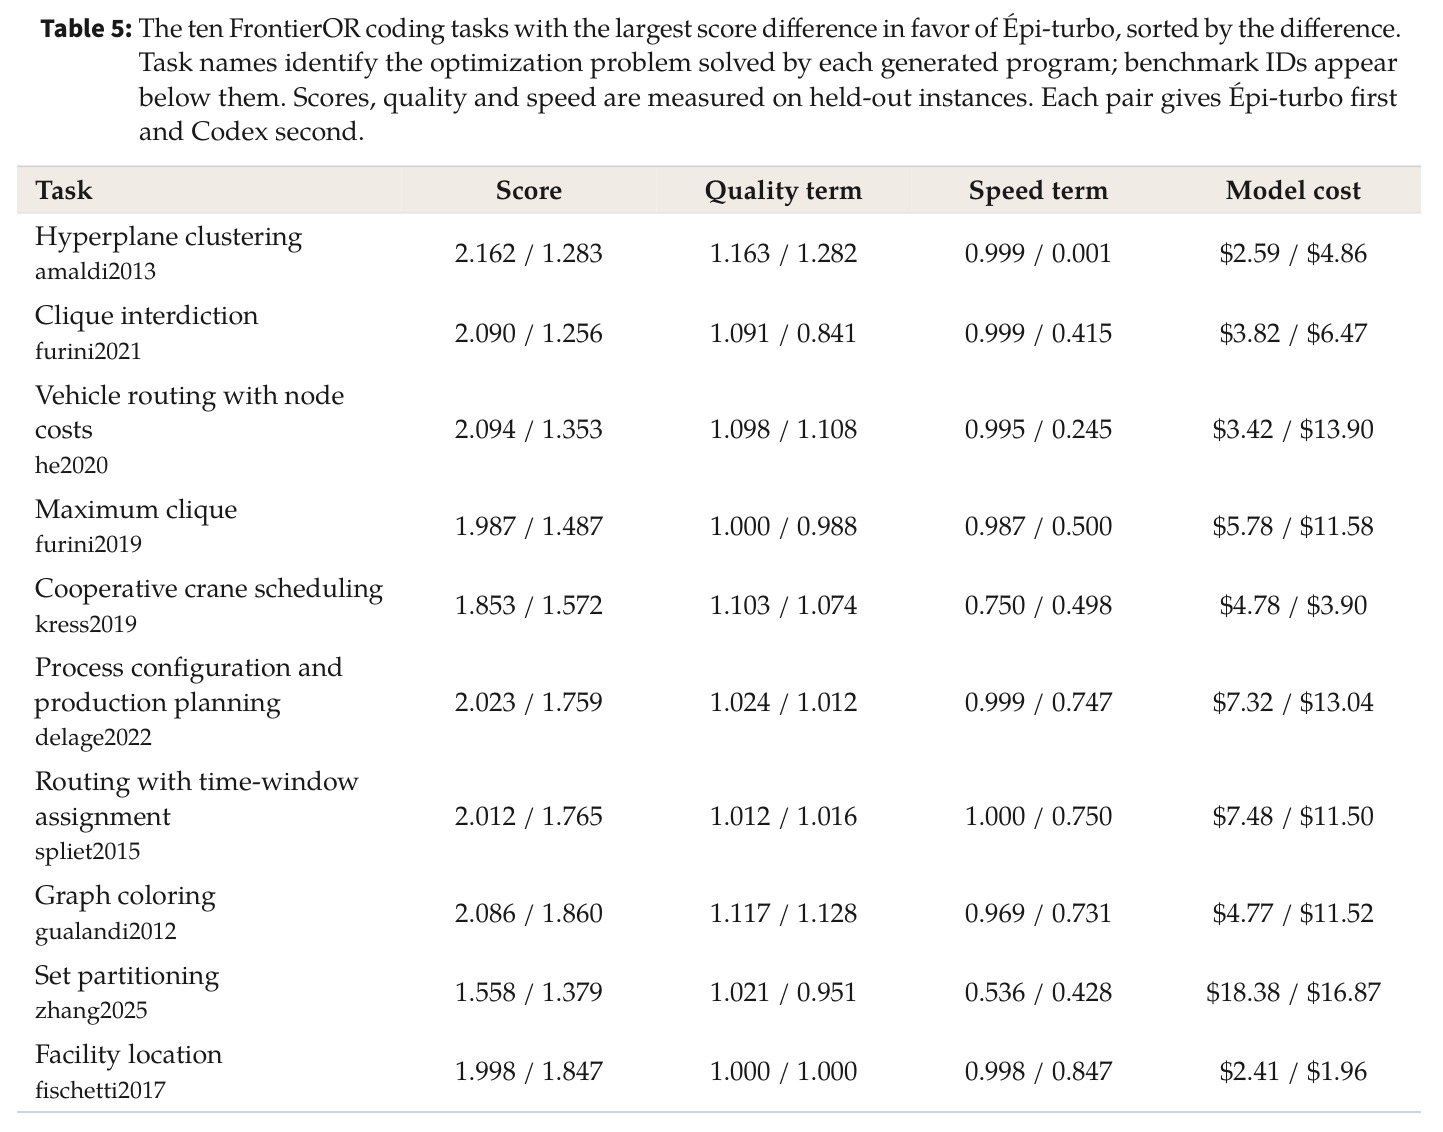
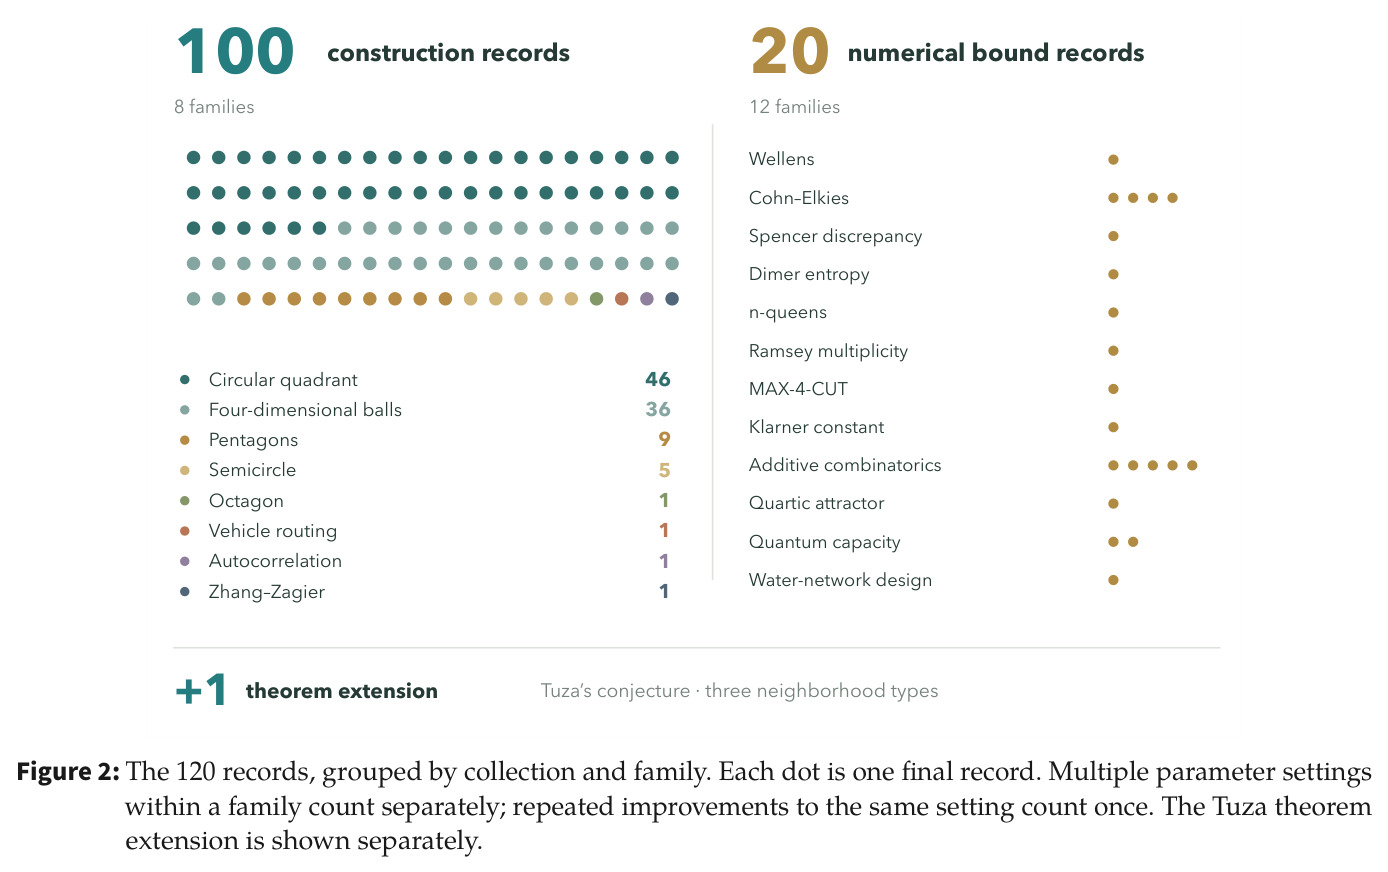
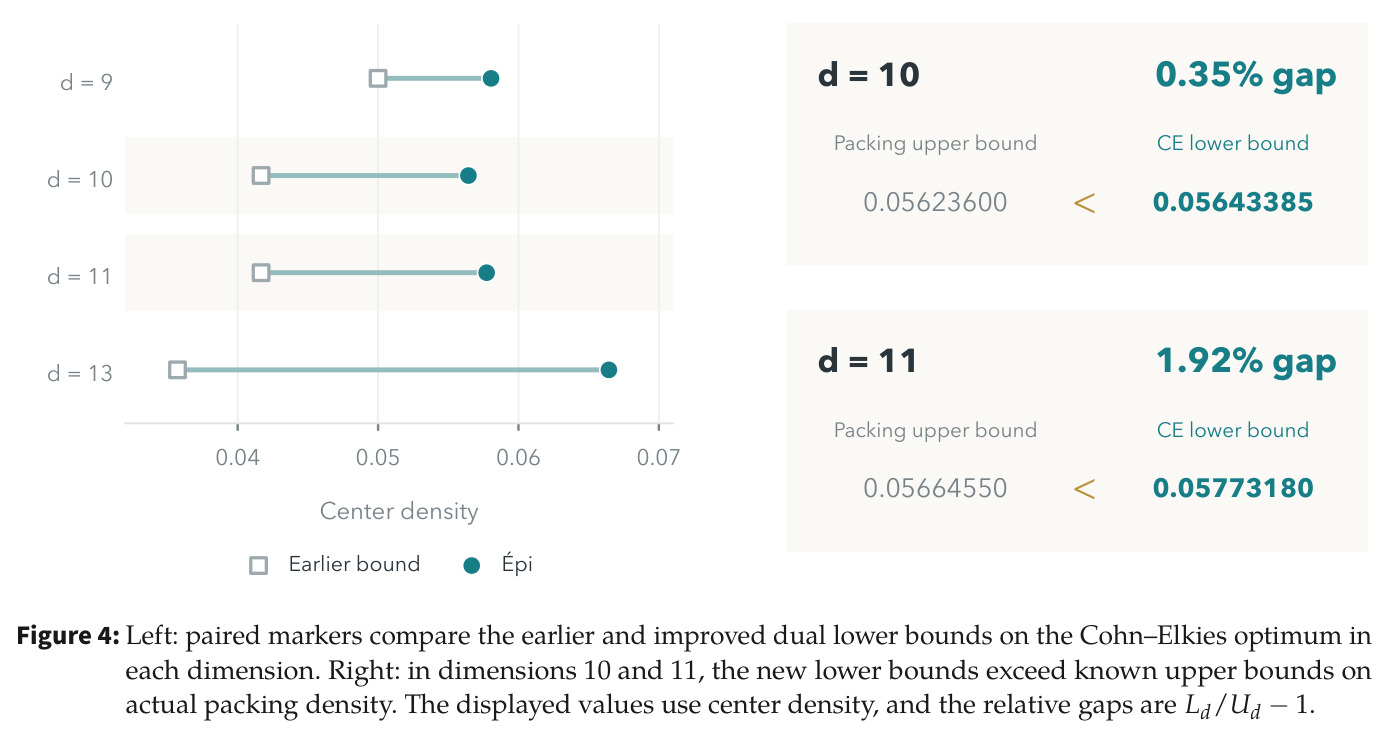
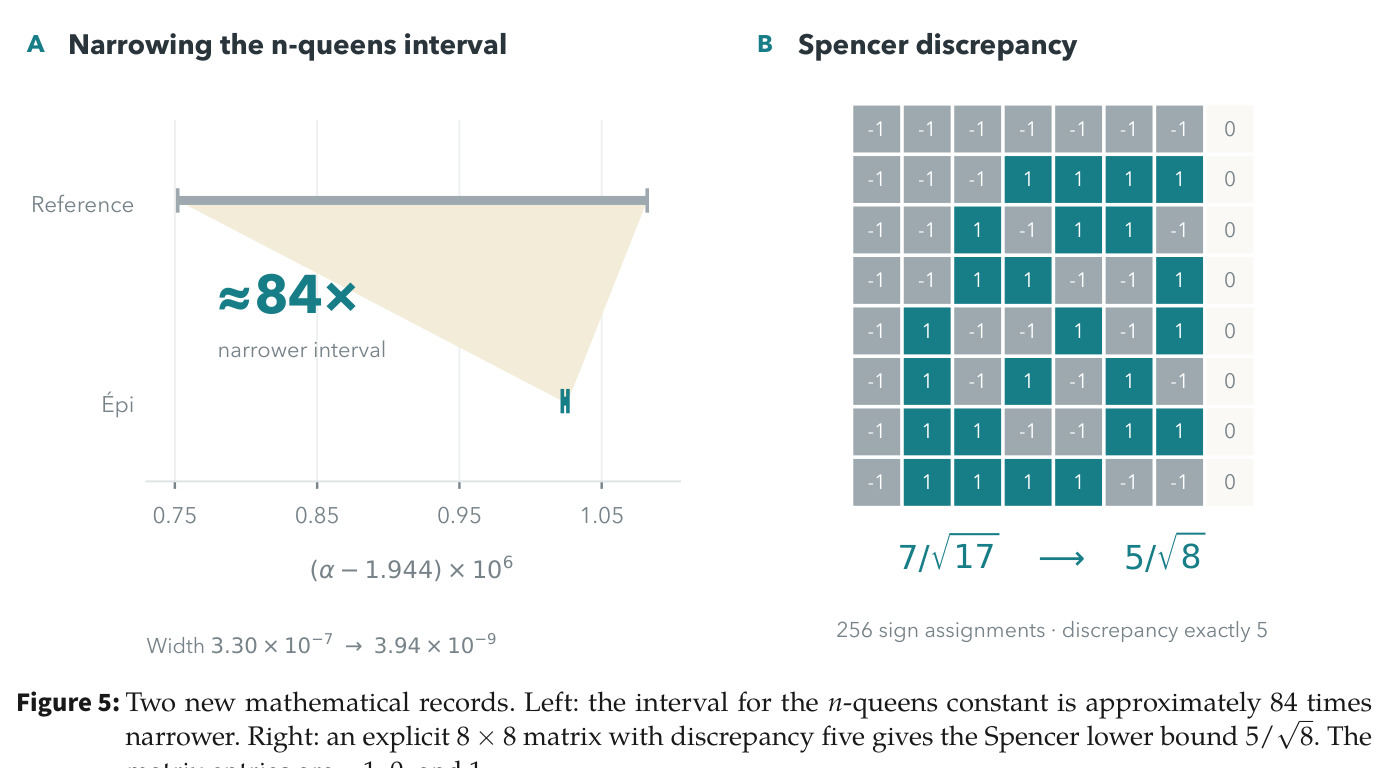
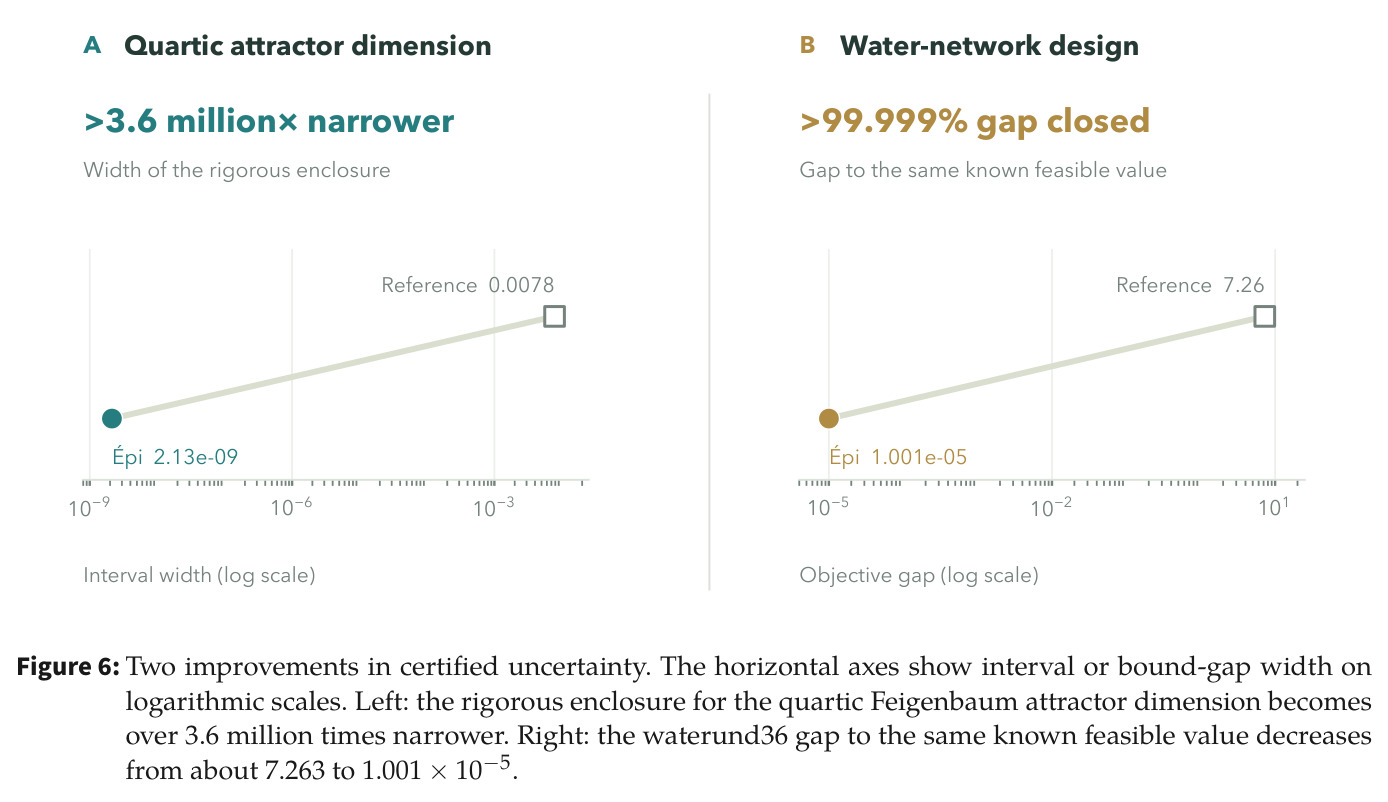
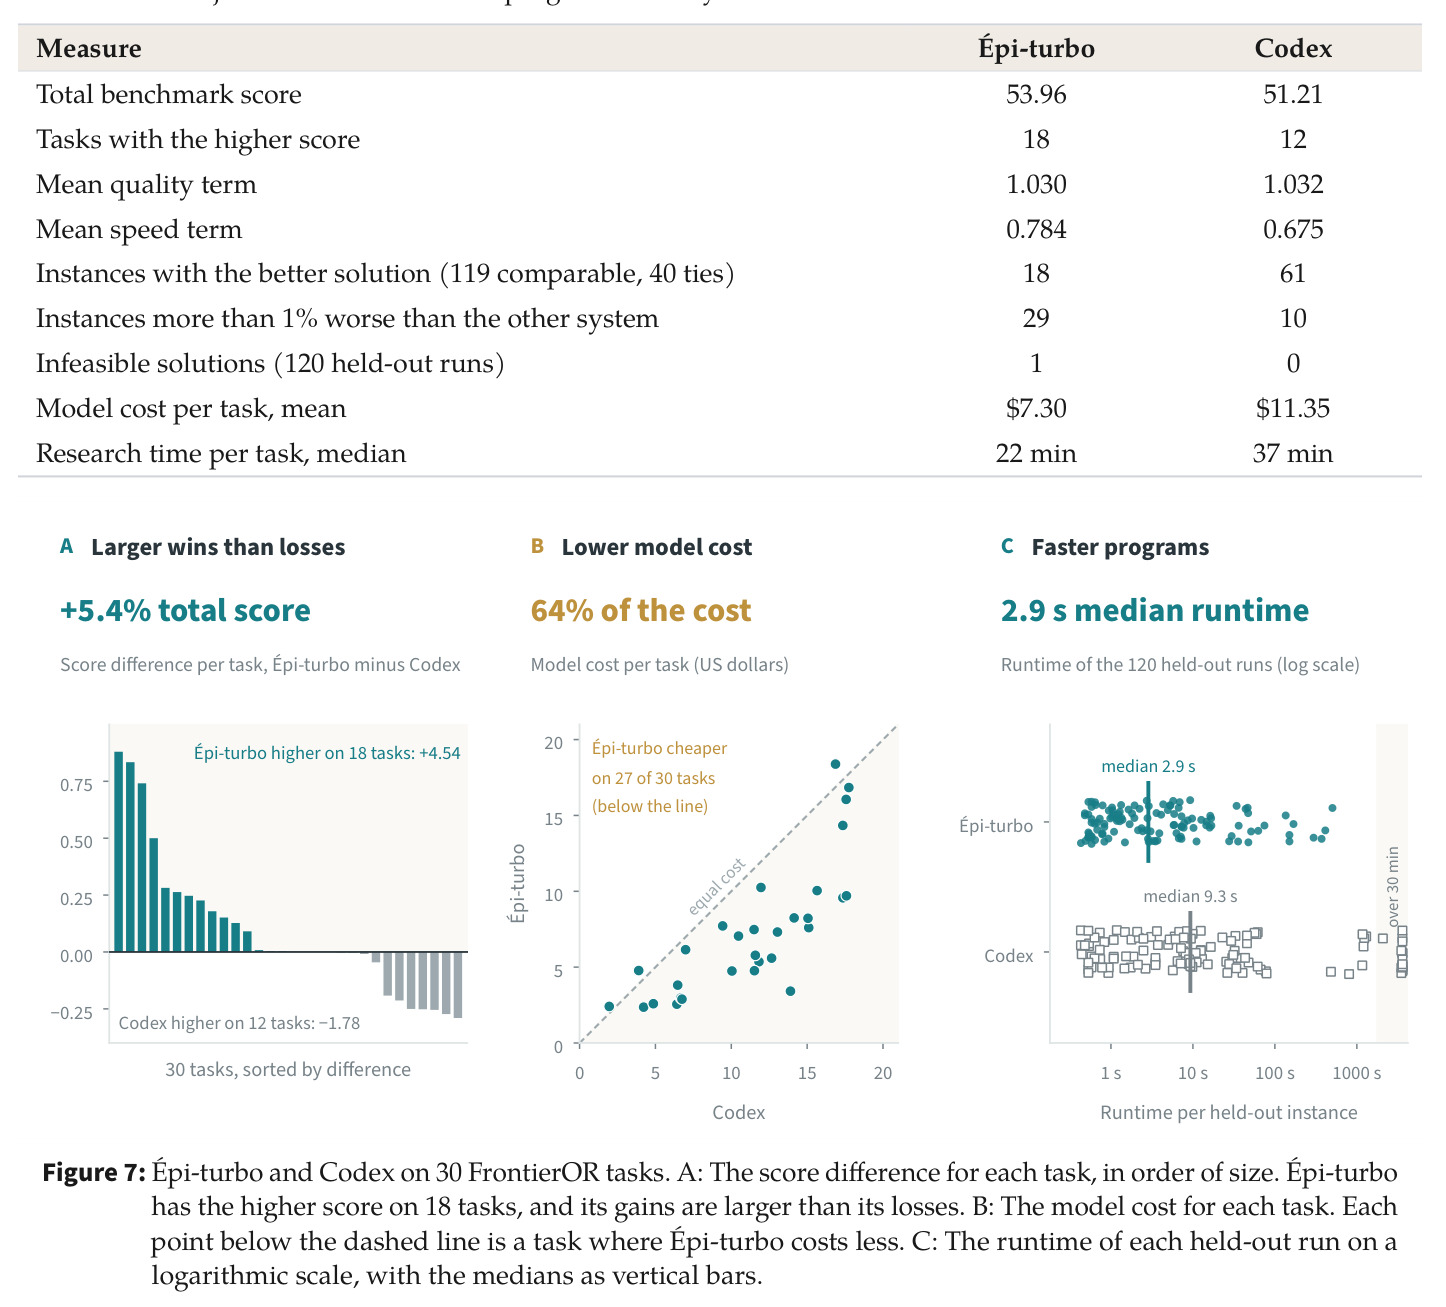
数天内用 GPT-5.6 Sol 与 GPT-6-Astra 运行,Épi 产出 120 项破纪录结果:12 族的 20 项数值界加 8 族的 100 项构造(97 项几何打包),外加 1 项 Tuza 定理扩展。代表性数值界:n-queens 常数区间收窄约 84 倍($3.30\times10^{-7} \to 3.94\times10^{-9}$);四次 Feigenbaum 吸引子维数区间收窄超 360 万倍($7.80\times10^{-3} \to 2.13\times10^{-9}$);Cohn–Elkies 对偶下界在 $d=10,11$ 超过堆积密度独立上界(分离 0.35% 与 1.92%),证明该 LP 界不可能取等;Spencer 常数由 $7/\sqrt{17}$ 提至 $5/\sqrt{8}$;MAX-4-CUT 硬度比改至 $\approx0.986411$;waterund36 关闭 99.999% 以上差距。构造代表:34 五边形入三角形从 12.9814 降至 12.9756(0.0445%)。定理:Tuza 猜想对 $K_8$ 分裂图、至多三种邻域类型成立(560 个 profile 证书、18,444 个重数盒子、任意重数)。算法设计:Épi-turbo 在 30 个 FrontierOR 任务总分 53.96 对 Codex 51.21(+5.4%),成本仅 64%,hard split 高 10%,程序中位运行 2.9 秒对 9.3 秒,各任务细节见表 3–5。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 30 个 FrontierOR 运筹优化编码任务(双方均为新任务,13 个 hard split) | 基准总分(质量项+速度项,held-out 实例) | 53.96(Épi-turbo) | 51.21(Codex,同一模型 GPT-6-Astra、同等推理强度、每任务 $20 预算) | +5.4% 总分,模型成本仅 64%(均值 $7.30 对 $11.35),18/30 任务分数更高,单任务研究中位时间 22 分钟对 37 分钟 |
| n-queens 常数 $\alpha$ 严格区间($Q(n) = (n/e)^{n(1+o(1))} \cdot e^{-\alpha+o(1)}$) | 区间宽度 | $3.94\times10^{-9}$($[1.9440010223327, 1.9440010262694]$,有理可行性检查+有向舍入) | $3.30\times10^{-7}$(Nobel et al. 2023 的 $[1.944000752, 1.944001082]$) | 约 84 倍收窄 |
| 四次 Feigenbaum 吸引子维数严格区间 | 区间宽度(全域区间证明) | $2.13\times10^{-9}$ | $7.80\times10^{-3}$ | 超过 360 万倍收窄 |
| Cohn–Elkies 线性规划最优值对偶下界($d=10, 11$) | 中心密度归一化下界 $L_d$ | $d=10$: 0.056433853144;$d=11$: 0.057731808202(精确对偶证书) | $1/24 \approx 0.0416667$(此前对偶界);堆积密度上界 $U_d$ 分别为 0.05623600 与 0.05664550 | 下界超过堆积上界,相对分离 $L_d/U_d - 1$ 约 0.35% 与 1.92%,证明该 LP 界在 $d=10,11$ 不可能取等 |
| Spencer 矩阵差异问题的普适常数下界 | 常数下界 | $5/\sqrt{8}$(显式 $8\times8$ 矩阵,差异恰为 5,256 个符号赋值穷举验证) | $7/\sqrt{17}$ | 约 $1.7678$ 对 $1.6977$,提升约 4.1% |
| MAX-4-CUT 计算硬度比(Nagda et al. 2025 gadget 框架) | 硬度比(越小越强) | $84931/86101 \approx 0.986411$(整数加权 gadget,LP 优化边权重) | $195581/198140 \approx 0.987085$ | 硬度界改进约 0.068%,可精确恢复验证 |
| waterund36 水网络设计(MINLPLib 非线性规划实例) | 全局下界(与已知可行值 662.807 的差距) | 下界 662.807028,差距仅约 $1.001\times10^{-5}$(精确有理不等式松弛证书) | 原列下界约 655.544,差距约 7.263 | 关闭 99.999% 以上的差距,认证现有网络的近似最优性 |
| 34 个单位正五边形装入等边三角形 | 最小三角形边长 | 约 12.97563736(联合精修中心与朝向) | 约 12.98141000(Friedman Packing Center) | 缩小 0.0445%,全精度坐标释放 |
| Tuza 猜想图族覆盖 | 已证明图族范围 | $|C| = 8$ 的分裂图且邻域类型至多 3 种(任意重数;560 个 profile 的精确证书 + 18,444 个重数盒子 + 截断引理) | Zeng (2026) 证明至多 2 种类型;Botler et al. (2021) 无 $K_8$ 弦图 | 首个覆盖 8 顶点团部分且超出现有 $K_8$-free 假设的无限图族计算机辅助证明 |
局限与改进
作者明确承认的限制包括:每个任务每个系统只运行一次(30 个 FrontierOR 任务为单次运行),因此不报告统计显著性,+5.4% 的总分差可能包含运气成分,其中 10 个任务两系统分差小于 0.01;30 个任务是从 180 个任务中按官方难度顺序选取并剔除了参考值不可靠者,任务子集的选择本身可能影响结论。质量项上两系统几乎持平(均值 1.030 对 1.032),总分优势主要来自速度项(0.784 对 0.675),而基准参考值来自商业求解器且部分较弱,速度项的权重使结果对基准设计敏感;Épi-turbo 的程序在 119 个可比实例中仅 18 个解更好(Codex 为 61 个、40 平局),实例级解质量上并不占优。数学纪录中相当一部分是百分之一量级的精化(如 155 圆入象限仅 0.0021%),依赖事先固定的容差与舍入约定。此外,数学 campaign 的计算预算按问题单独设置但未披露具体数值,也未能展示各机制(分支/记忆/评审)的消融分析。
独立分析的弱点
第一,机制贡献无法归因:论文未对分支、层次记忆、独立评审做消融,Épi-turbo 甚至因短任务上评审成本大于收益而将其关闭,5.4% 的提升来自哪个组件并不清楚,应做开关式消融报告边际收益。第二,单次运行缺乏统计功效:每任务只跑一次且不报告显著性,10 个任务分差小于 0.01,个别大分差(如超平面聚类 2.162 对 1.283)可能由方差主导,应多次运行给出置信区间。第三,实例级解质量并不占优:119 个可比实例中 Épi-turbo 仅 18 个更好(Codex 61 个),优势集中在速度项,说明其贡献更多是「知道何时停止」而非更强的优化能力,应显式研究停止准则。第四,计数规则由作者自定(每个参数设置计一次、中间改进不计),第三方无法审计全量尝试,应公开完整实验日志供独立核验。第五,0.002%–0.05% 量级的打包精化科学意义有限,更多是填充注册表,应优先选择能催生结构性洞见的任务。第六,验证器依赖环境预检(scorer 复现参考结果)的正确性,该步出错会传导至所有结论。
未来方向
作者在文中直接指出或暗示的方向包括:把研究环境的演化制度化——数值估计自然催生带证书表示与严格误差控制的认证任务,如 Cohn–Elkies 案例所示,这一模式可推广到更多「先估计、后认证」的问题族;把 MAX-4-CUT 的「固定 gadget 结构、在着色约束下 LP 优化权重」发展成可复用的自动化硬度改进流程;把 Épi-turbo 的预算预留与停止准则应用到更广的算法设计基准。基于其成果可自然延伸的方向有:在 $d=9,13$ 及更高维继续收紧 Cohn–Elkies 对偶界,检验分离现象的维度分布;把 Tuza 猜想推进到 8 顶点团部分四种及以上邻域类型,或去掉分裂图限制;对记忆与评审机制做受控消融并分析经验跨 campaign 迁移的成功率;建立一个公开排行榜,让 registry 参考值更新与 agent 产出的比较可追溯;以及探索把独立评审者的评估反馈用于在线调整分支间的算力分配。
复现评估
可复现性呈现明显的不对称:验证容易、重跑困难。验证端很友好——论文承诺释放全部最终构造与支持证书(GitHub + Blog),每个最终产物保留比较值、来源和舍入约定,witness 可独立机器检查,例如 Spencer 的 $8\times8$ 矩阵只需穷举 256 个符号赋值即可核实差异恰为 5,MAX-4-CUT 的整数加权边表可精确恢复比值,waterund36 的有理不等式证书可独立重放,这种「结果即证明」的设计使第三方无需复现 agent 行为即可确认 120 项纪录的真实性。但复现 agent 本身较难:执行基础设施 Breadboard 是否开源未在文中说明;使用 GPT-5.6 Sol 与 GPT-6-Astra 两代前沿模型,FrontierOR 实验每任务预算 $20(总模型成本约 $219+$341 对照),数学 campaign 的预算与算力未披露;ruler 配置、增益下界推导和任务指令的完整文本也需依赖发布物。因此结论是:数学与算法结果的复核成本低、可信度高,但完整重现研究过程需要同等基础设施与可观的 API 预算,属于中等偏高的复现难度。
论文图表