Wizard:基于智能体控制的实时任意世界操纵 Wizard: Manipulate Any World in Real Time via Agentic Control
智能体维护骨架/几何代理驱动视频生成,实现24FPS零样本可控游戏世界
前置知识
视频世界模型(Video World Model)
一种以视频生成为核心的环境模拟器:给定历史帧和当前动作(如鼠标键盘输入),模型预测下一帧画面,从而『生成』一个可交互的虚拟世界。代表工作如 GameNGen、Oasis 等,通常在特定游戏录像上训练,玩家输入被编码为条件信号引导扩散模型或自回归模型逐帧生成。
本文的基础设施就是视频世界模型,理解『帧+动作→下一帧』的交互范式才能明白 Wizard 把哪些环节抽出来交给了智能体。
智能体世界模型(Agentic World Model)
将世界状态维护、游戏逻辑、动作规划从视频生成中解耦出来的框架:一个(通常基于 VLM/LLM 的)智能体显式记录实体位置、血量、冷却等状态,把状态翻译成结构化中间表示(深度图、语义图、包围盒等),再交给视频模型渲染。这样规则执行不依赖像素级监督,状态可以精确持久。
Wizard 的整体架构属于这一类,但把中间表示从场景级推进到了关节级骨架,这是理解其创新定位的前提。
骨骼绑定与动作重定向(Rigging & Retargeting)
骨骼绑定是给角色网格建立关节层级骨架的过程;动作重定向是把源角色的骨骼动画(关节旋转序列)映射到目标角色骨架上,需按肢体对应关系匹配、按肢体长度缩放、用逆运动学保持脚踏实。本文用 UniRig 生成骨架,用语义肢体标签(左臂、右腿等)做跨角色对应。
Wizard 的细粒度角色控制完全建立在『任意图片→网格→骨架→可播放动作集』这条管线上,不懂重定向就看不懂动作从哪来。
一致性蒸馏与分布匹配蒸馏
扩散模型通常需要多步去噪,无法实时。一致性蒸馏训练学生模型一步/两步直接映射到数据分布,配合引导型因果教师和 EMA 目标;分布匹配蒸馏(DMD)则用冻结的教师分数网络和学习到的 critic 估计学生分数,让学生自回归 rollout 的输出分布逼近教师分布,弥补累积误差。
Wizard 的 24 FPS 实时生成(2 步去噪)全靠这套三阶段蒸馏流程,这是『质量换速度』的关键技术。
通道级条件注入与 KV 缓存流式生成
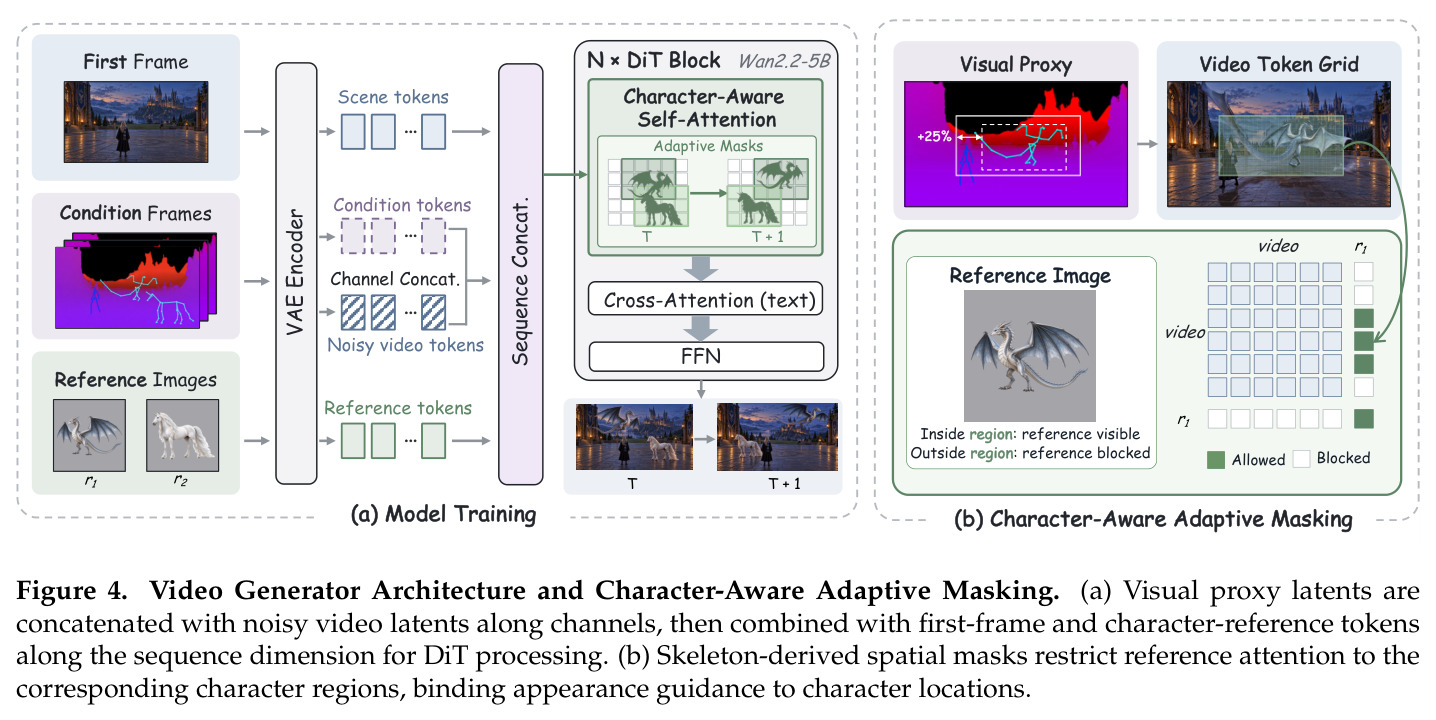
控制信号(如深度图)经 VAE 编码后与噪声视频潜变量在通道维拼接,用零初始化的条件嵌入层注入,保住预训练模型初始行为;自回归生成时用 KV 缓存保留最近 20 个潜帧加 1 个首帧 sink,使上下文长度有界、显存恒定,支撑无限长的流式推理。
这是本文把 Wan2.2-5B 改造成可控、可实时流式生成器的具体手段,涉及公式 (1) 的条件形式。
研究动机
现有游戏世界模型在控制灵活性、泛化性和实时性上都有关键缺口。动作条件模型(如 ReactiveGWM、SCOPE)把玩家锁死在预定义动作集里,只能执行训练时见过的操作;提示条件模型则依赖训练分布中的运动与技能模式,面对未见指令无所适从。为改善状态一致性和空间可控性,WorldMind、Marionette、GameDirector 等智能体框架用深度图、语义图、blockout 或带朝向的 3D 包围盒等结构化代理引导视频生成,但其演示大多停留在车辆驾驶和角色行走这类基础位移,对关节化角色动作(攻击、闪避、受击反应)支持非常有限;依赖游戏引擎的方案虽然提供了结构化控制,却因预定义场景和额外处理流程牺牲了场景灵活性与交互延迟。综合结果就是:玩家无法在一张任意新场景图里召唤任意新角色,并以骨架级精度操控它战斗。
本文的目标是本文要构建 Wizard,一个同时满足四个条件的智能体游戏世界模型:实时(以 24 FPS 流式生成)、精确(骨架级的角色运动控制)、零样本(泛化到训练中未见的场景、角色和动作,仅需用户给一张场景图和一张角色参考图)、机制一致(血量、相对距离、朝向、技能冷却等战斗状态被显式维护并强制执行规则)。玩家可以自由配置世界:召唤或移除角色、游玩中变换角色形态、用自然语言操纵场景几何(造楼梯、升起平台、翻转世界)。支撑目标的具体工程指标包括:初始化少于 5 分钟、推理仅 2 步去噪、KV 缓存有界以支持无限时长游玩。
与已有工作不同的是,本文的独特切入是把结构化控制代理从『场景级』下探到『关节级』。已有智能体框架的世界状态是地图、深度块或实体包围盒,角色只作为一个带位置的实体存在;Wizard 则把关节化骨架本身作为统一视觉代理的一部分——场景用几何代理(高度+深度通道),角色用带槽位与朝向编码的骨架,两者联合渲染成一个视频条件。更巧的是,骨架在训练数据里是真值、在推理时由智能体维护,这种『训练-推理共享结构』被用来构造角色感知的自适应注意力掩码,把参考图的外观引导精确绑定到对应角色区域。此外,它用『动作检索+重定向』而非动作集分类,天然支持任意体型新角色,这是与动作条件模型的本质分野。
核心方法
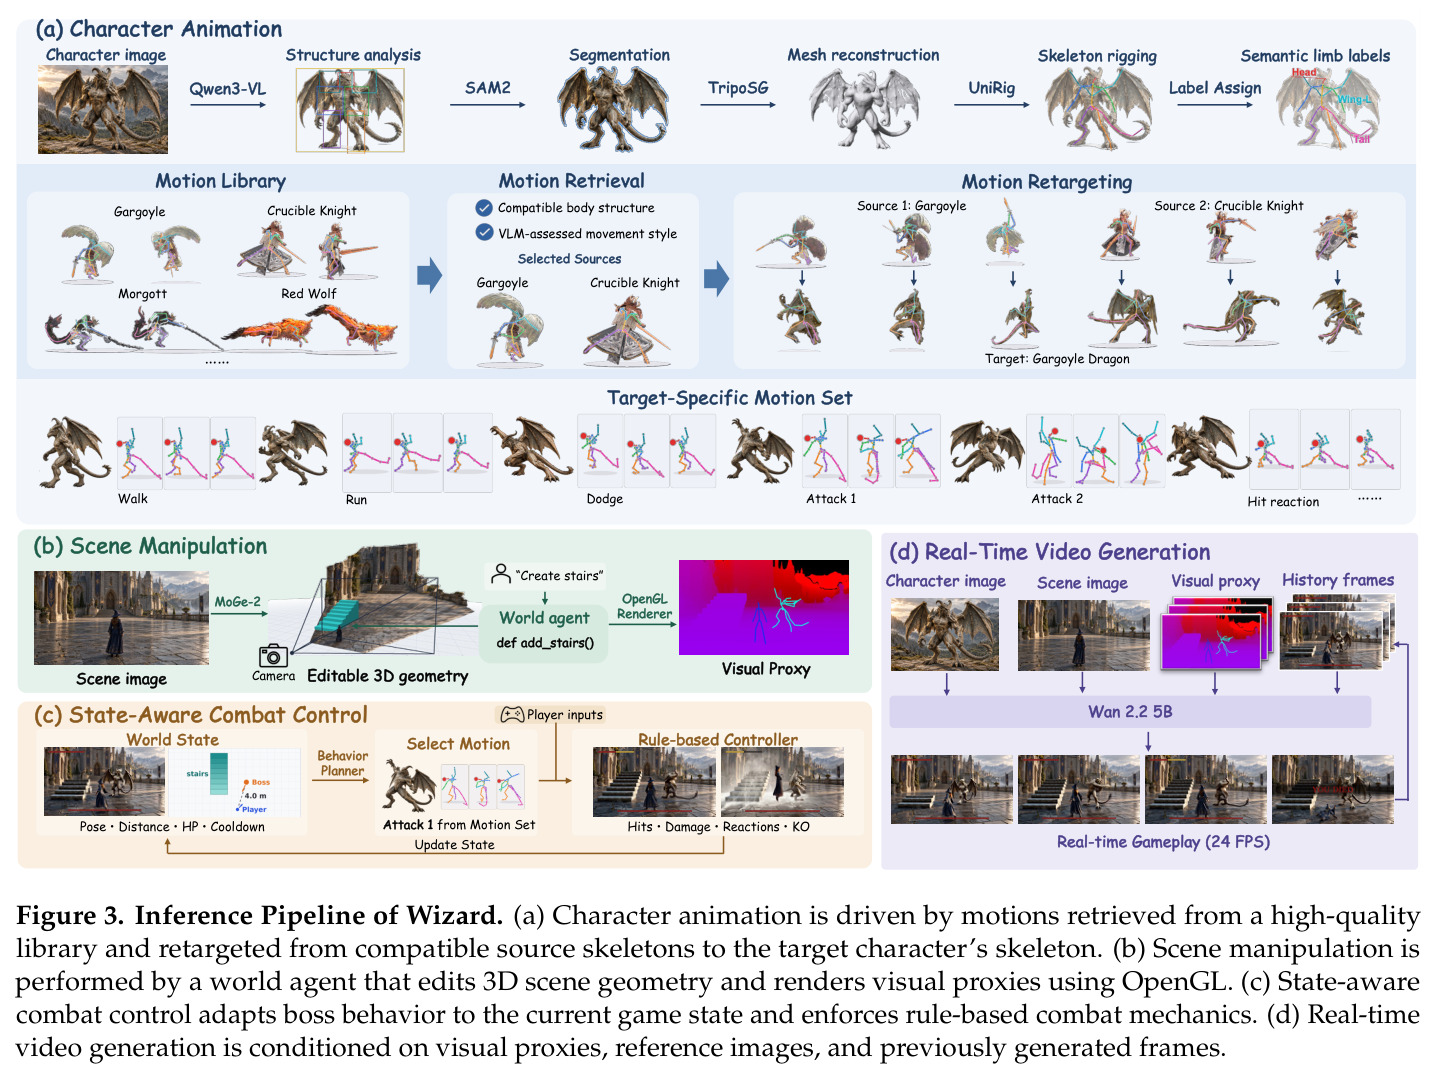
直觉上,Wizard 把传统游戏引擎『逻辑与渲染分离』的架构搬进了视频世界模型:一个智能体负责逻辑——维护世界状态、规划 BOSS 行为、执行战斗规则、编辑场景几何;视频模型只负责渲染——把结构化代理画面翻译成逼真帧。技术路线分四块。(1) 角色动画:用户给一张角色图,经 Qwen3-VL 结构分析、SAM2 分割、TripoSG 网格重建、UniRig 骨架绑定后,从多来源动作库检索风格匹配的动作并重定向,形成该角色专属动作集。(2) 场景操纵:MoGe-2 从场景图恢复 3D 点图与相机参数,构建背景网格加高度场,世界智能体把自然语言指令编译成几何算子程序修改场景。(3) 战斗控制:行为规划器依据状态(位置、朝向、血量、冷却)选动作,规则控制器用扫掠命中盒加无敌窗口判定命中。(4) 实时渲染:OpenGL 渲染统一视觉代理,基于 Wan2.2-TI2V-5B 的因果化蒸馏生成器以 24 FPS 自回归出画面。
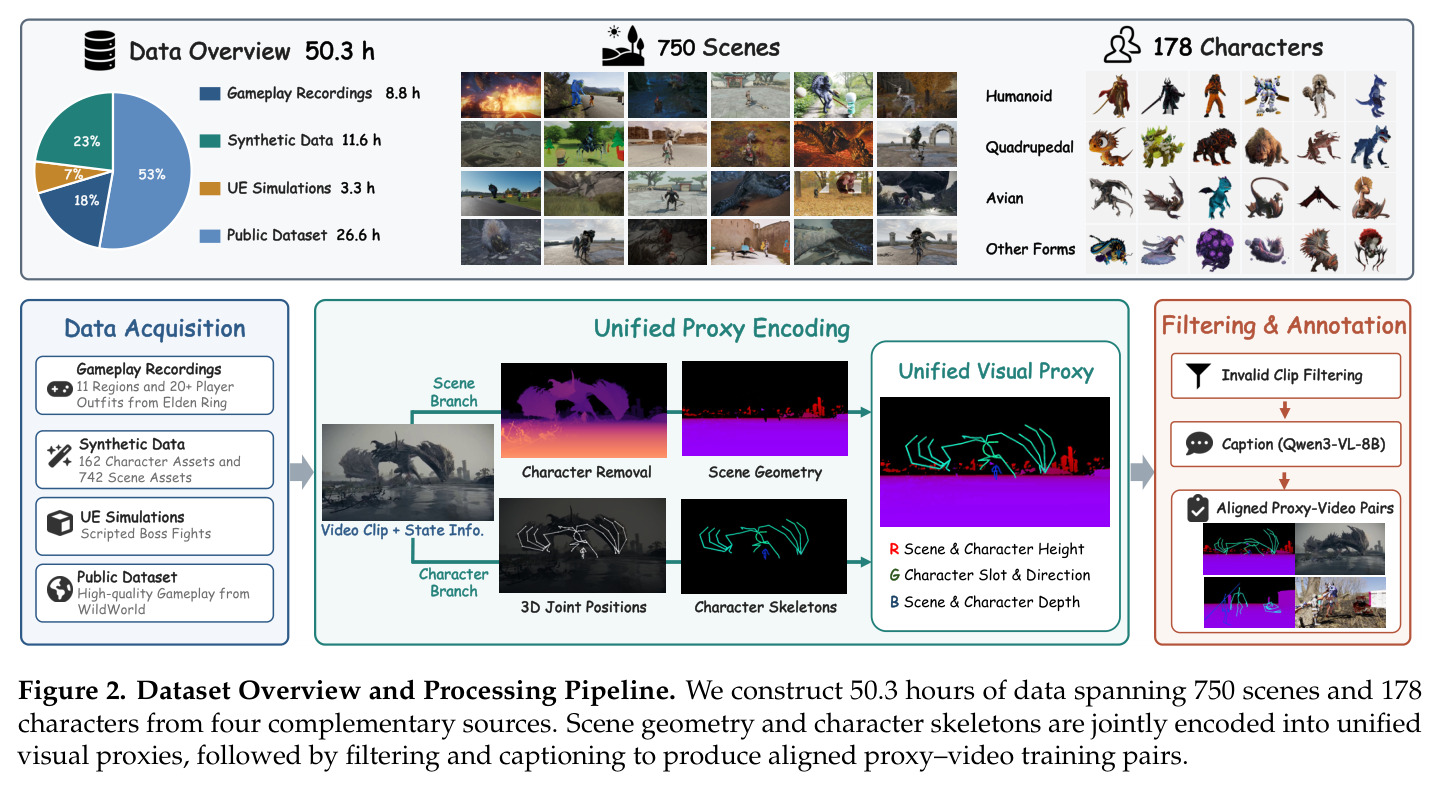
核心创新有三层,且彼此咬合。第一是统一视觉代理的通道编码:R 通道编码高度(角色骨架映射到 $[0,0.2]$、场景映射到 $[0.5,1]$),G 通道联合编码角色槽位与朝向(场景置 0),B 通道编码相机前向深度(越亮越近),骨架与场景深度每帧联合渲染以保留遮挡关系。槽位编码把角色实例与固定外观解耦——每个槽位链接一张参考图,外观从参考图恢复而非记在权重里,这正是零样本召唤新角色的机制基础。第二是角色感知自适应掩码:从骨架导出包围区域外扩 25% 得到 $\Omega_{k,\tau}$,自注意力中对参考 token 加掩码 $M_{ij}=-\infty$ 屏蔽非对应角色区域,把外观引导绑定到角色当前位置,随角色移动、出现、消失而更新。第三是动作检索-重定向:VLM 按体型兼容性与风格(凶悍、优雅、力量感)从多来源库挑选动作,按语义肢体链匹配重定向,使任意新形态角色无需定制动画脚本即可获得招式集。这与已有方法的本质区别在于:控制信号不再只是『约束生成』,而是智能体可编程操作的显式世界状态。
方法步骤详情
完整流程如下。(1) 角色初始化:输入角色图,Qwen3-VL 推断体型结构(四肢/翼/尾排布、解剖学左右),SAM2 分割,TripoSG 重建网格,UniRig 生成骨架,标注语义肢体标签。(2) 动作集构建:从 CombatMotion、WildWorld、Elden Ring 动作库检索体型兼容动作,VLM 评估风格是否适合目标外观;重定向时匹配肢体链、适配肢体长度、逆运动学保持触地,过滤穿模片段,形成目标专属动作集。(3) 场景初始化:MoGe-2 恢复点图与相机参数,构建背景网格加高度场,按粗糙度外推未知地形。(4) 游玩循环:世界智能体(Qwen3-VL-8B)把指令编译成几何算子程序改场景;行为规划器按状态(位置/朝向/血量/冷却)选动作,攻击前模拟挥击评估命中概率;规则控制器用扫掠命中盒检测命中并计入无敌帧,命中后扣血、触发受击,血量归零判负。(5) 渲染:ModernGL/EGL 离屏渲染视觉代理 $P$,生成器按 $\hat{X}=G_\theta(P, I_0, \{R_k\}; H_{<t})$ 出图,2 步去噪、KV 缓存 20 个最近潜帧加 1 个首帧 sink,24 FPS 流式输出。
技术新颖性
与已有技术的具体区别:相比 Marionette 的深度块代理和 WorldMind/GameDirector 的实体级状态,Wizard 把控制粒度下探到骨架关节层,并通过 G 通道槽位编码让角色外观与参考图动态绑定,从而支持运行时召唤、移除与变换;相比动作条件模型(ReactiveGWM、SCOPE)的离散动作 one-hot,Wizard 的动作是检索-重定向得到的连续骨架序列,天然覆盖未见角色;相比 SolarRenderer 这类只解决『代理→视频』实时渲染的并行工作,Wizard 补全了状态维护、规则执行与渲染的完整闭环;训练侧则用 50.3 小时多来源数据( Elden Ring 实机 8.8h、合成 11.6h、UE 3.3h、WildWorld 26.6h)换泛化。自适应掩码尤其新颖:它利用智能体维护的显式骨架状态在 DiT 自注意力中门控参考图注意力,是『智能体状态反哺生成架构』的新用法,而变换角色时屏蔽旧身份缓存 token 的设计进一步体现了这种耦合。
实验结果
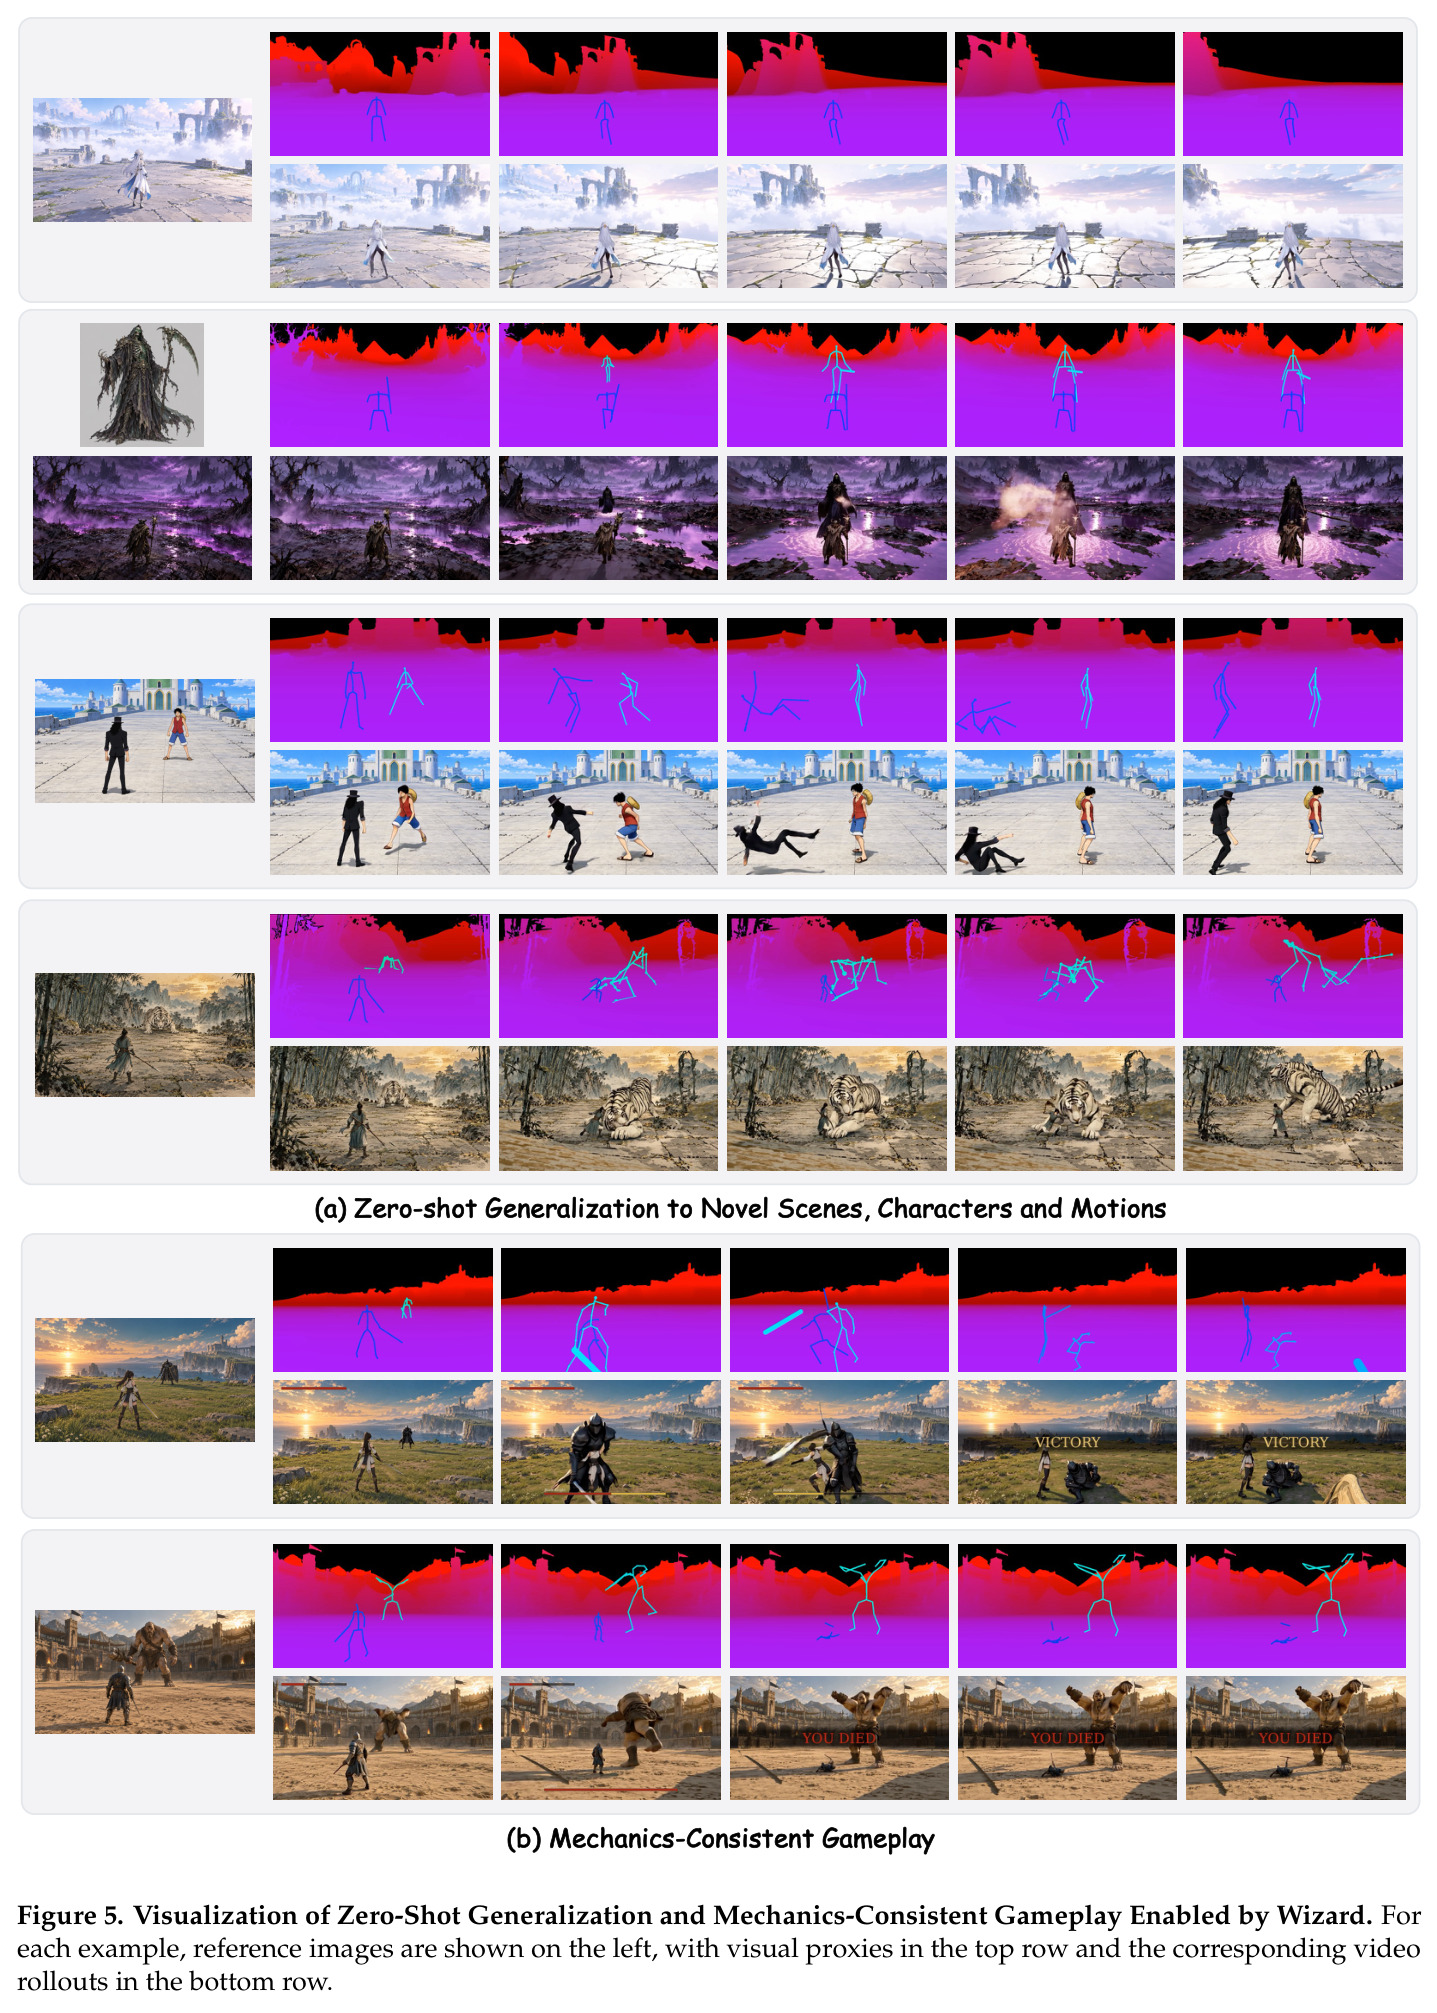
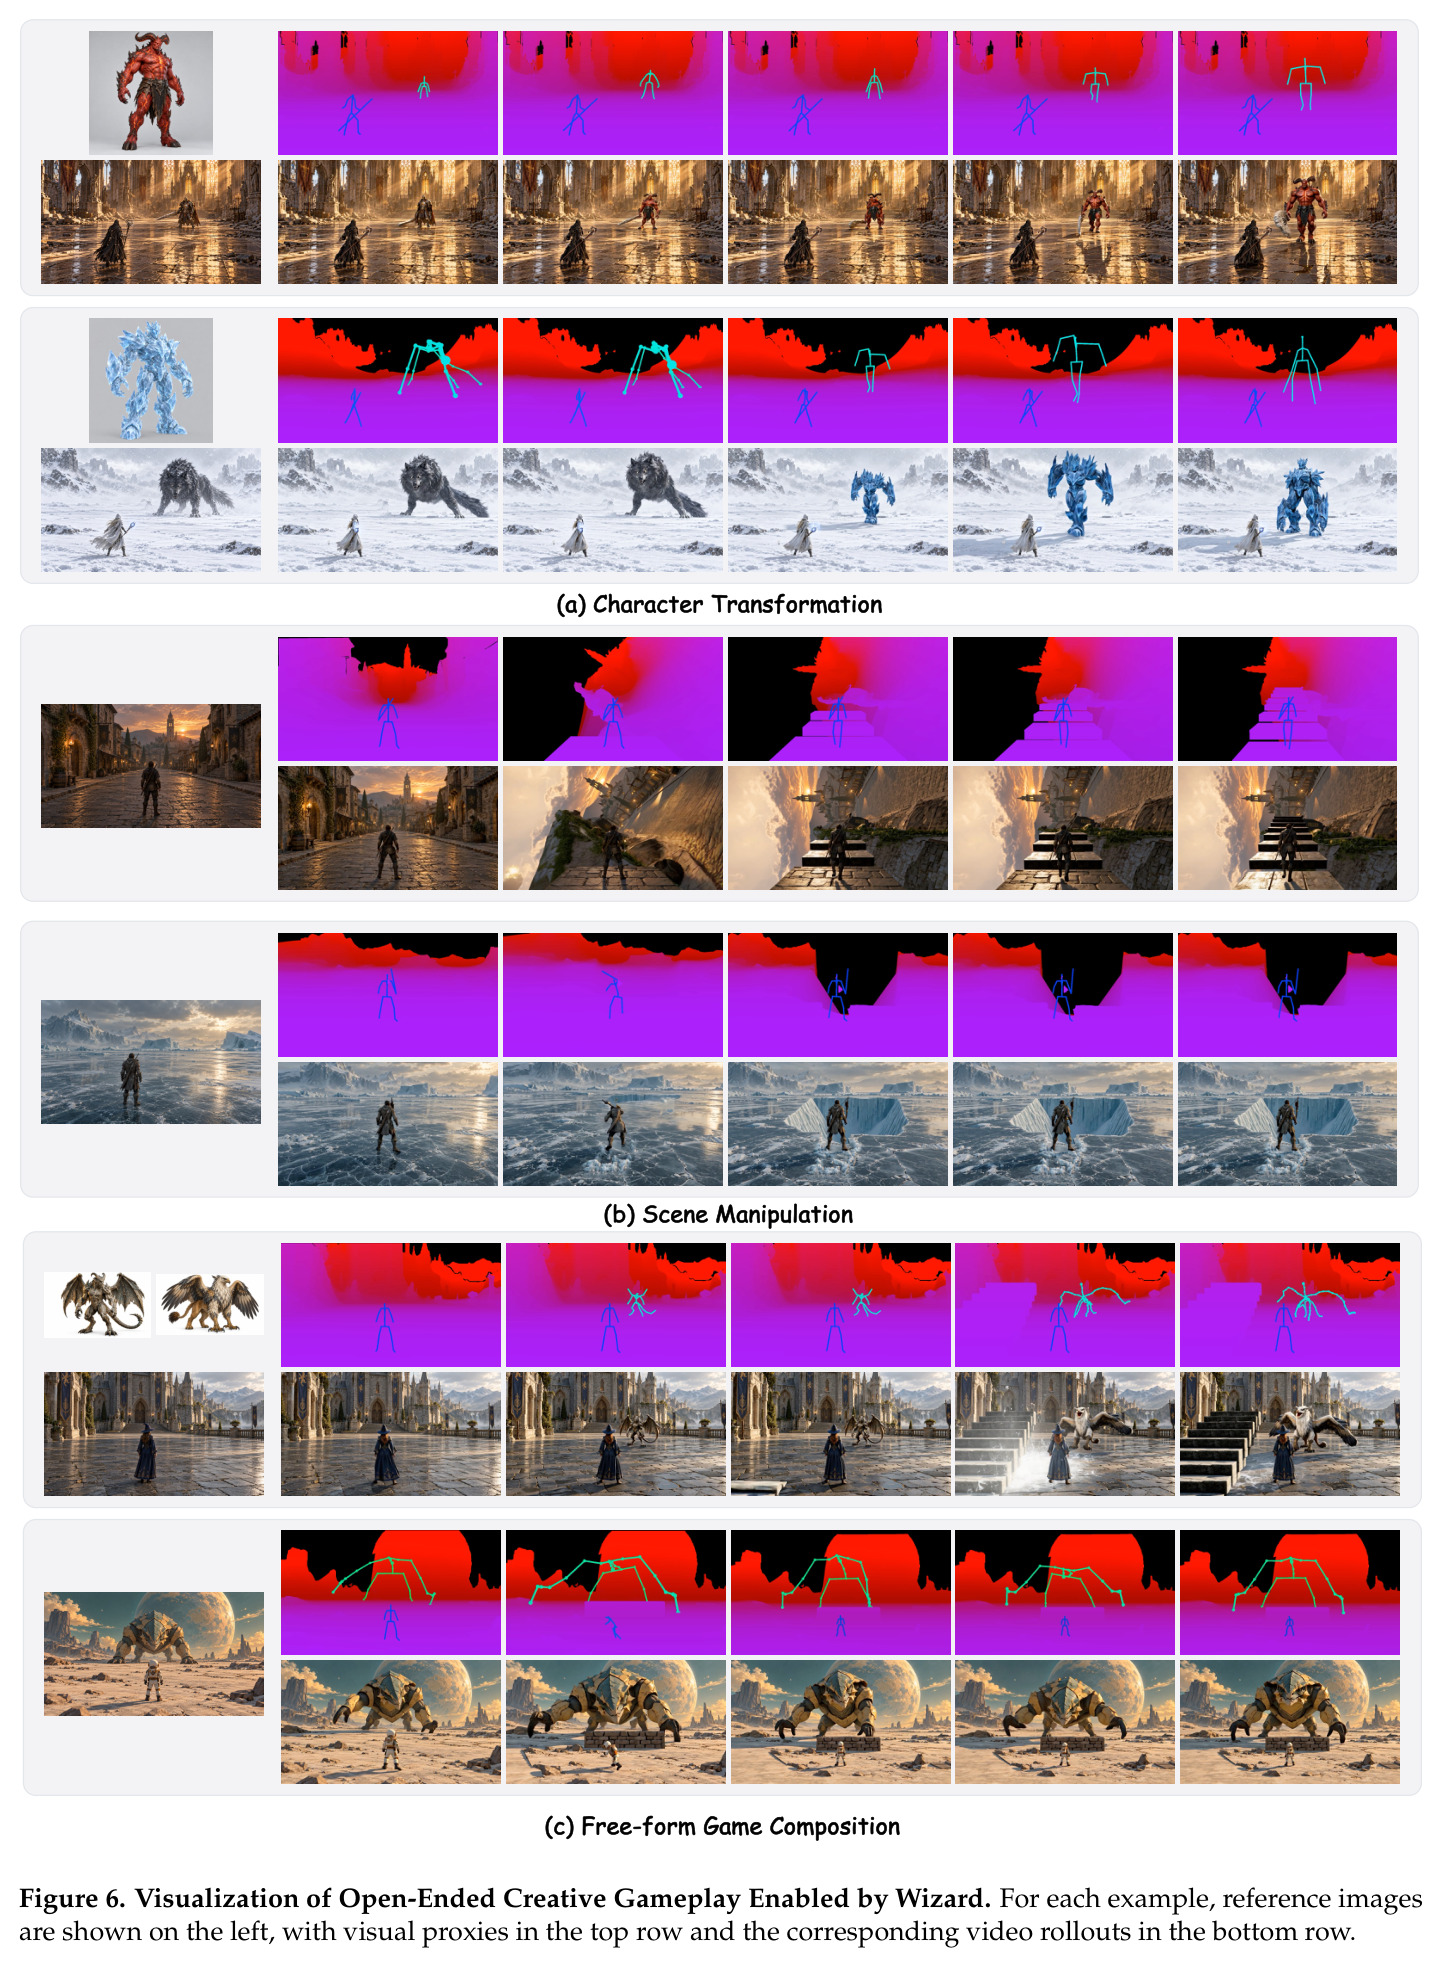
评估以定性演示为主(论文未提供 FVD 或人工评分等定量对比)。零样本泛化(Fig.5a):训练未见的场景图与角色图直接输入,智能体控制视觉代理生成实时战斗,代理中的角色姿态与空间关系被生成帧忠实复现,同一模型无需微调即覆盖人形、四足、鸟类等多形态角色与多样环境。机制一致玩法(Fig.5b):规则控制器在任一方血量归零时正确结束战斗并显示结果;命中扣血、血条更新、技能冷却、无敌帧均按规则执行,战斗逻辑完全独立于视频生成。开放创作(Fig.6):游玩中提供新参考图即可完成角色变换(同时屏蔽旧身份的缓存注意力);自然语言指令可造楼梯、升起平台、翻转世界;角色变换与场景操纵还能在同一局内组合。系统指标:初始化少于 5 分钟;推理 2 步去噪、KV 缓存 20+1 个潜帧,达到 24 FPS;训练使用 44,075 段对齐片段(121 帧@30fps 窗口,约 4 秒),流程为 30K 步双向微调、10K 步因果适配、500 步蒸馏后取 EMA 检查点;数据共 50.3 小时、750 场景、178 角色,合成数据用了 162 个角色资产和 742 个场景资产。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 实时交互生成 | 生成帧率 / 去噪步数 | 24 FPS,2 步去噪,KV 缓存有界(20+1 潜帧) | 未蒸馏的双向扩散模型(多步去噪,无法实时) | 经因果适配+一致性蒸馏+DMD 三阶段达到实时交互门槛 |
| 零样本泛化(新场景/角色/动作) | 定性可视化(Fig.5a) | 未见场景与角色参考直接驱动,代理姿态被忠实渲染 | 动作/提示条件模型受限于训练分布 | 无需微调即可泛化,覆盖多形态角色 |
| 角色身份保持 | 定性(参考图-生成帧外观对齐) | 骨架外扩 25% 的角色感知自适应掩码门控参考注意力 | 参考图 token 全局可见(无掩码) | 减少跨角色外观泄漏,支持召唤/移除/变换 |
| 战斗机制一致性 | 定性(Fig.5b 规则执行) | 命中判定、扣血、冷却、KO 全部由规则控制器执行 | 纯像素监督世界模型(无显式状态) | 战斗逻辑独立于生成,状态可精确持久 |
局限与改进
作者承认两点局限:其一,依赖动作库,对体型罕见的角色(非常规关节数量或排布)难以检索到兼容动作;其二,长时滚动中场景代理与生成视频的一致性会退化。我的补充观察:(1) 全文只有定性评估,没有 FVD、CLIP 相似度或人类偏好评分,也没有与 Marionette、GameDirector 的同条件对照,结论说服力打折扣;(2) 场景几何来自单目估计加高度场外推,输入视野之外的地形是智能体『编』的,代理与真实画面可能脱节,规则判定(命中盒对几何采样)也会随之失真;(3) KV 缓存只保留 20 个潜帧加 1 个 sink,长时记忆有限,久玩可能出现漂移;(4) 每样本最多 2 个角色参考,多人同屏或群战场景受限;(5) 数据高度偏重 Elden Ring 与 WildWorld 的暗黑奇幻风格,对现实场景、二次元等风格泛化存疑。
独立分析的弱点
弱点一:动作检索无兜底。当角色体型在动作库中没有兼容来源时整条动画链失效,改进方向是引入文本到动作生成模型(text-to-motion)作为检索失败的后备,或直接在骨架潜空间用扩散模型合成动作。弱点二:缺定量基准。应构建代理-视频对齐误差、参考图-生成帧角色 CLIP 相似度、规则违反率、长滚动一致性曲线等指标,与 Marionette/GameDirector 对照,否则『零样本泛化更强』只是视觉印象。弱点三:单目几何在反射、透明、天空区域不可靠,而高度场外推纯属猜测;可让生成帧周期性反哺场景几何(闭环修正),或允许玩家标注可通行区域。弱点四:命中判定依赖对生成几何的模拟挥击,BOSS『觉得能打中』但画面没打中的错位会破坏体验;可用轻量物理一致性损失约束生成帧与代理对齐。弱点五:两角色上限限制了多人玩法,槽位编码本身可扩展,瓶颈在参考 token 与掩码设计,值得做扩展实验。
未来方向
作者提出的方向:支持更灵活、更贴近真实游玩的角色动作(摆脱动作库),以及长滚动中维持场景外观一致。基于其成果可延伸:(1) 用可微分的动作生成模型替换检索库,实现自由招式与玩家自创动作;(2) 引入物体级物理状态(可推动、可破坏物体、攀爬)作为额外代理通道,从『战斗模拟』走向『物理世界模拟』;(3) 扩展到多人同屏(对接 WorldCast/Multics 一类多人世界模型)与更多角色槽位;(4) 把 Wizard 当作可配置模拟器,用强化学习在其中训练游戏策略——智能体维护的显式状态天然适合做 reward;(5) 联合生成音频与游戏 UI(血条、伤害数字、打击音效),向完整可玩游戏闭环推进;(6) 探索生成帧与代理之间的自校正机制,缓解长时漂移。
复现评估
复现难度:高。论文未提及开源代码、模型权重或数据集,项目页(wyzardwu.github.io/wizard/)仅为展示。数据获取本身就是高门槛:Elden Ring 需从游戏进程抓取相机内参、骨架状态与深度;合成管线依赖 Sketchfab/Quaternius/KayKit 的 162 个角色资产与 Poly Haven 的 742 个场景资产,还需 VLM 过滤无效渲染;WildWorld 需另行获取。算力方面:基于 Wan2.2-TI2V-5B(约 5B 参数,VAE 与 UMT5 冻结)在 44,075 段片段上做 30K 步双向微调、10K 步因果适配再加三阶段蒸馏,估计需要数十张 A100/H100 级 GPU 训练数周;24 FPS 实时推理也要求高端 GPU。工程细节(游戏进程抓取、UniRig 中轴拟合、ModernGL/EGL 离屏渲染、掩码调度)披露有限。个人研究者的务实路径是复用其两个核心思想——统一几何代理通道编码与角色感知自适应掩码——在小型可控视频模型上做消融验证。
论文图表
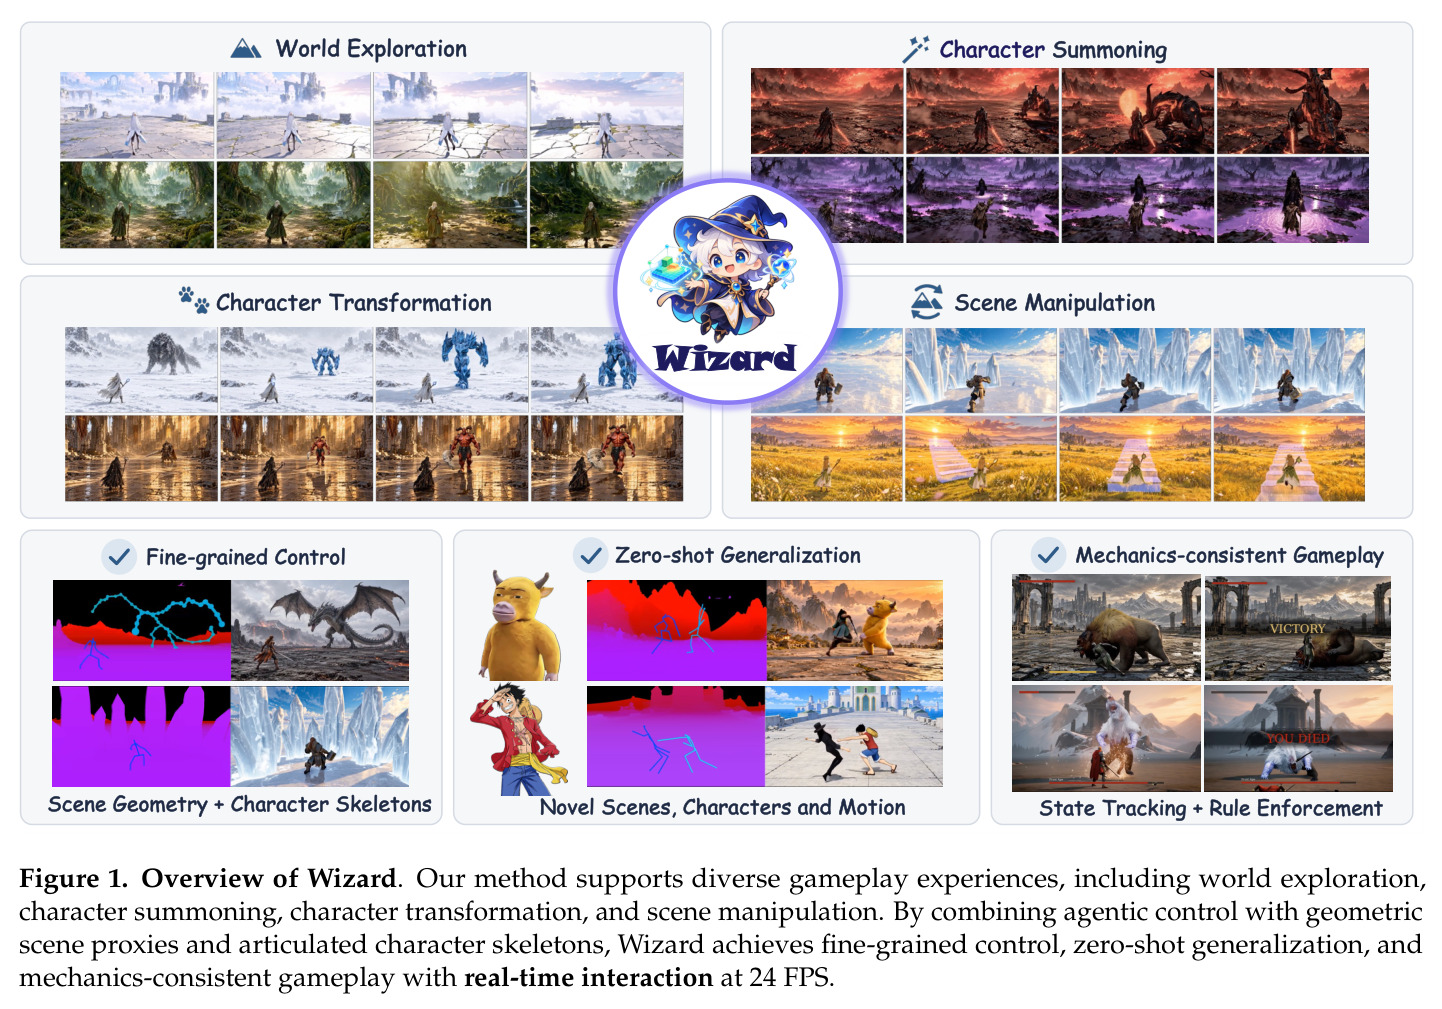
总览图:上方展示世界探索、角色召唤、角色变换、场景操纵四类玩法画面;下方以三大支柱总结方法——细粒度控制(场景几何+角色骨架)、零样本泛化(新场景/角色/动作)、机制一致玩法(状态跟踪+规则执行),并标注 24 FPS 实时交互。
一图看清 Wizard 的能力边界与三大设计支柱,是判断这篇论文『做了什么、强在哪』的入口。