World-in-Context:基于上下文条件化的交互式视频世界模型 World-in-Context: Interactive Video World Modeling with In-Context Conditioning
把视角、动作、相机控制统一为注意力空间内的token,5B模型视角切换率达93.8%追平22B模型
前置知识
交互式视频世界模型
一类根据用户输入(键盘动作、相机轨迹等)闭环生成未来视频帧的生成模型,相当于可交互的“视频版模拟器”:模型接收初始图像或文本与控制序列,动态预测用户操作后的视觉观察。代表工作包括 Genie 2、LingBot-World、YUME 1.5、Matrix-Game、EchoWM 等,通常以视频扩散或流匹配 Transformer 为骨干。
本文的问题设定、训练范式与 WBench 评测协议都建立在这类模型的标准框架之上,不了解该领域就无法理解其对比基线与指标含义。
流匹配(Flow Matching)
一种连续时间生成范式:在噪声与数据之间的线性插值路径上回归速度场 $v_\tau$,推理时沿 ODE 从噪声积分到数据。相比 DDPM 路径更直、采样更高效,Wan2.2、SD3 等新模型均采用。文中条件化形式为 $\hat{v}_\tau=\mathcal{F}_\theta([c;z_\tau];y,\tau)$,$\tau\in[0,1]$ 为扩散时刻。
World-in-Context 的骨干是流匹配 DiT(Wan2.2-TI2V-5B),理解速度场预测与条件 token 拼接方式是读懂其核心公式 (3)–(5) 的前提。
In-Context Conditioning(上下文条件化)
源自 LLM 上下文学习的思想:不为新任务引入新参数通路,而是把任务信息作为序列前缀放进共享上下文。本文将其迁移到视频生成——把视角/动作/相机控制统一编码为与骨干同维度的 token,前置拼接到视觉 latent 序列,在同一个自注意力空间内完成条件化。
这是本文方法的范式核心;它与 AdaLN 调制、加性注入、cross-attention 等专用条件通路的本质区别,正是全文论证与消融的重点。
RoPE 与 IT-RoPE
旋转位置编码(RoPE)用旋转矩阵作用于 query/key,使注意力得分只依赖相对位置,3D-RoPE 将其扩展到时空维度。本文提出的 IT-RoPE 进一步把累积控制迁移算子 $T^b_{i\to j}=\prod_{k=i+1}^{j}U^b_k$ 以门控、中心化残差形式注入时间注意力,让相距较远的帧也能感知中间控制演进。
IT-RoPE 是论文两大技术支柱之一,不理解 RoPE 的相对位置机制就无法理解公式 (9)–(10) 中时间注意力修正项的设计动机。
Plücker 坐标
用六维向量 $[\boldsymbol{d};\, \boldsymbol{o}\times\boldsymbol{d}]$(射线方向与其相对原点矩)参数化一条 3D 射线,是相机条件化的常用几何表示(CameraCtrl、CamCo 等)。对每个像素射线编码后,模型可获得连续且几何一致的相机视口信息,ViPE 等工具可从视频重建这些参数。
论文的相机 token $c_{\text{camera}}$ 直接建立在 Plücker 射线场加相对位姿与局部增量的三路投影之上,不懂该表示就读不懂公式 (8)。
FREE/FPP/TPP 视角模式
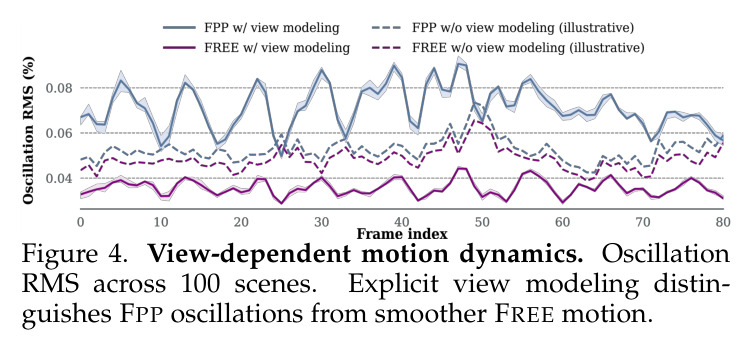
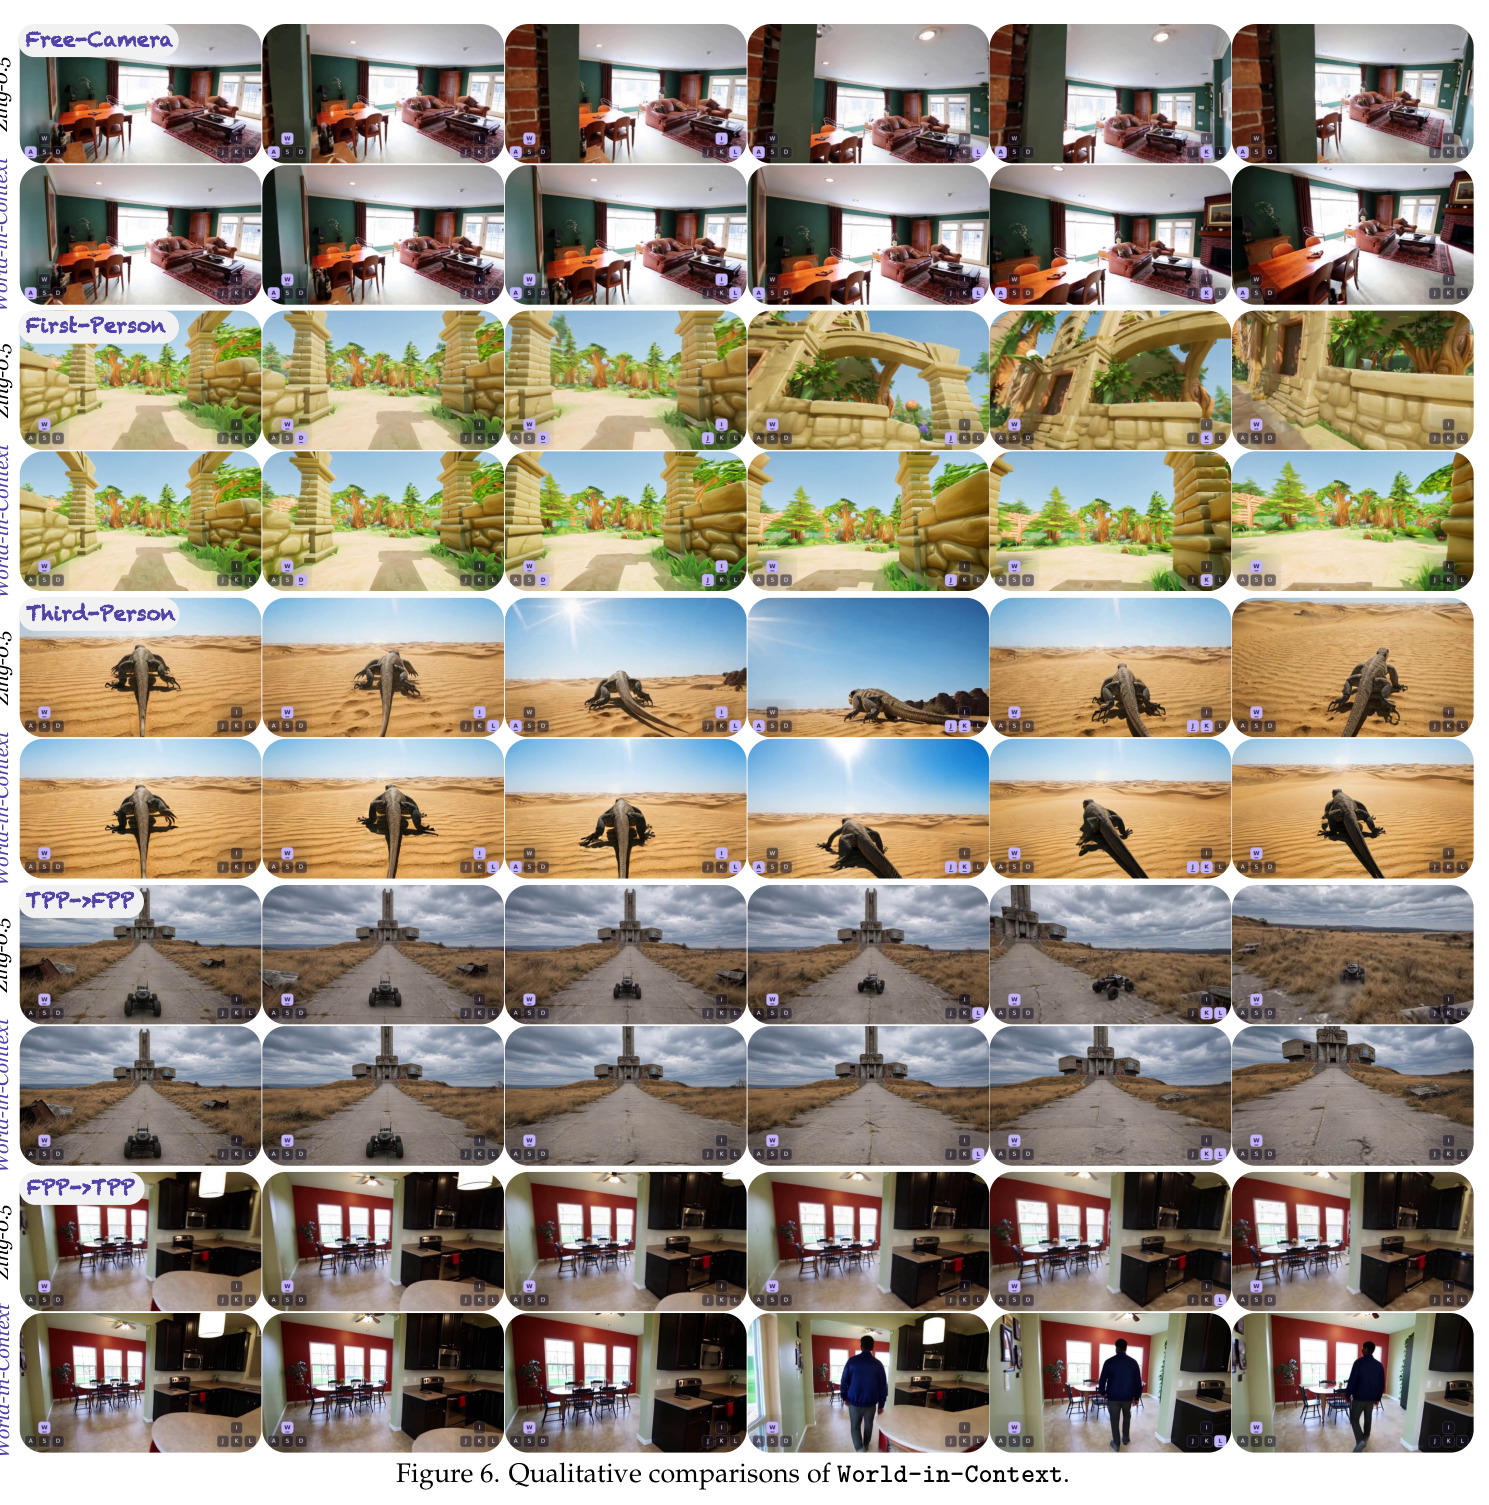
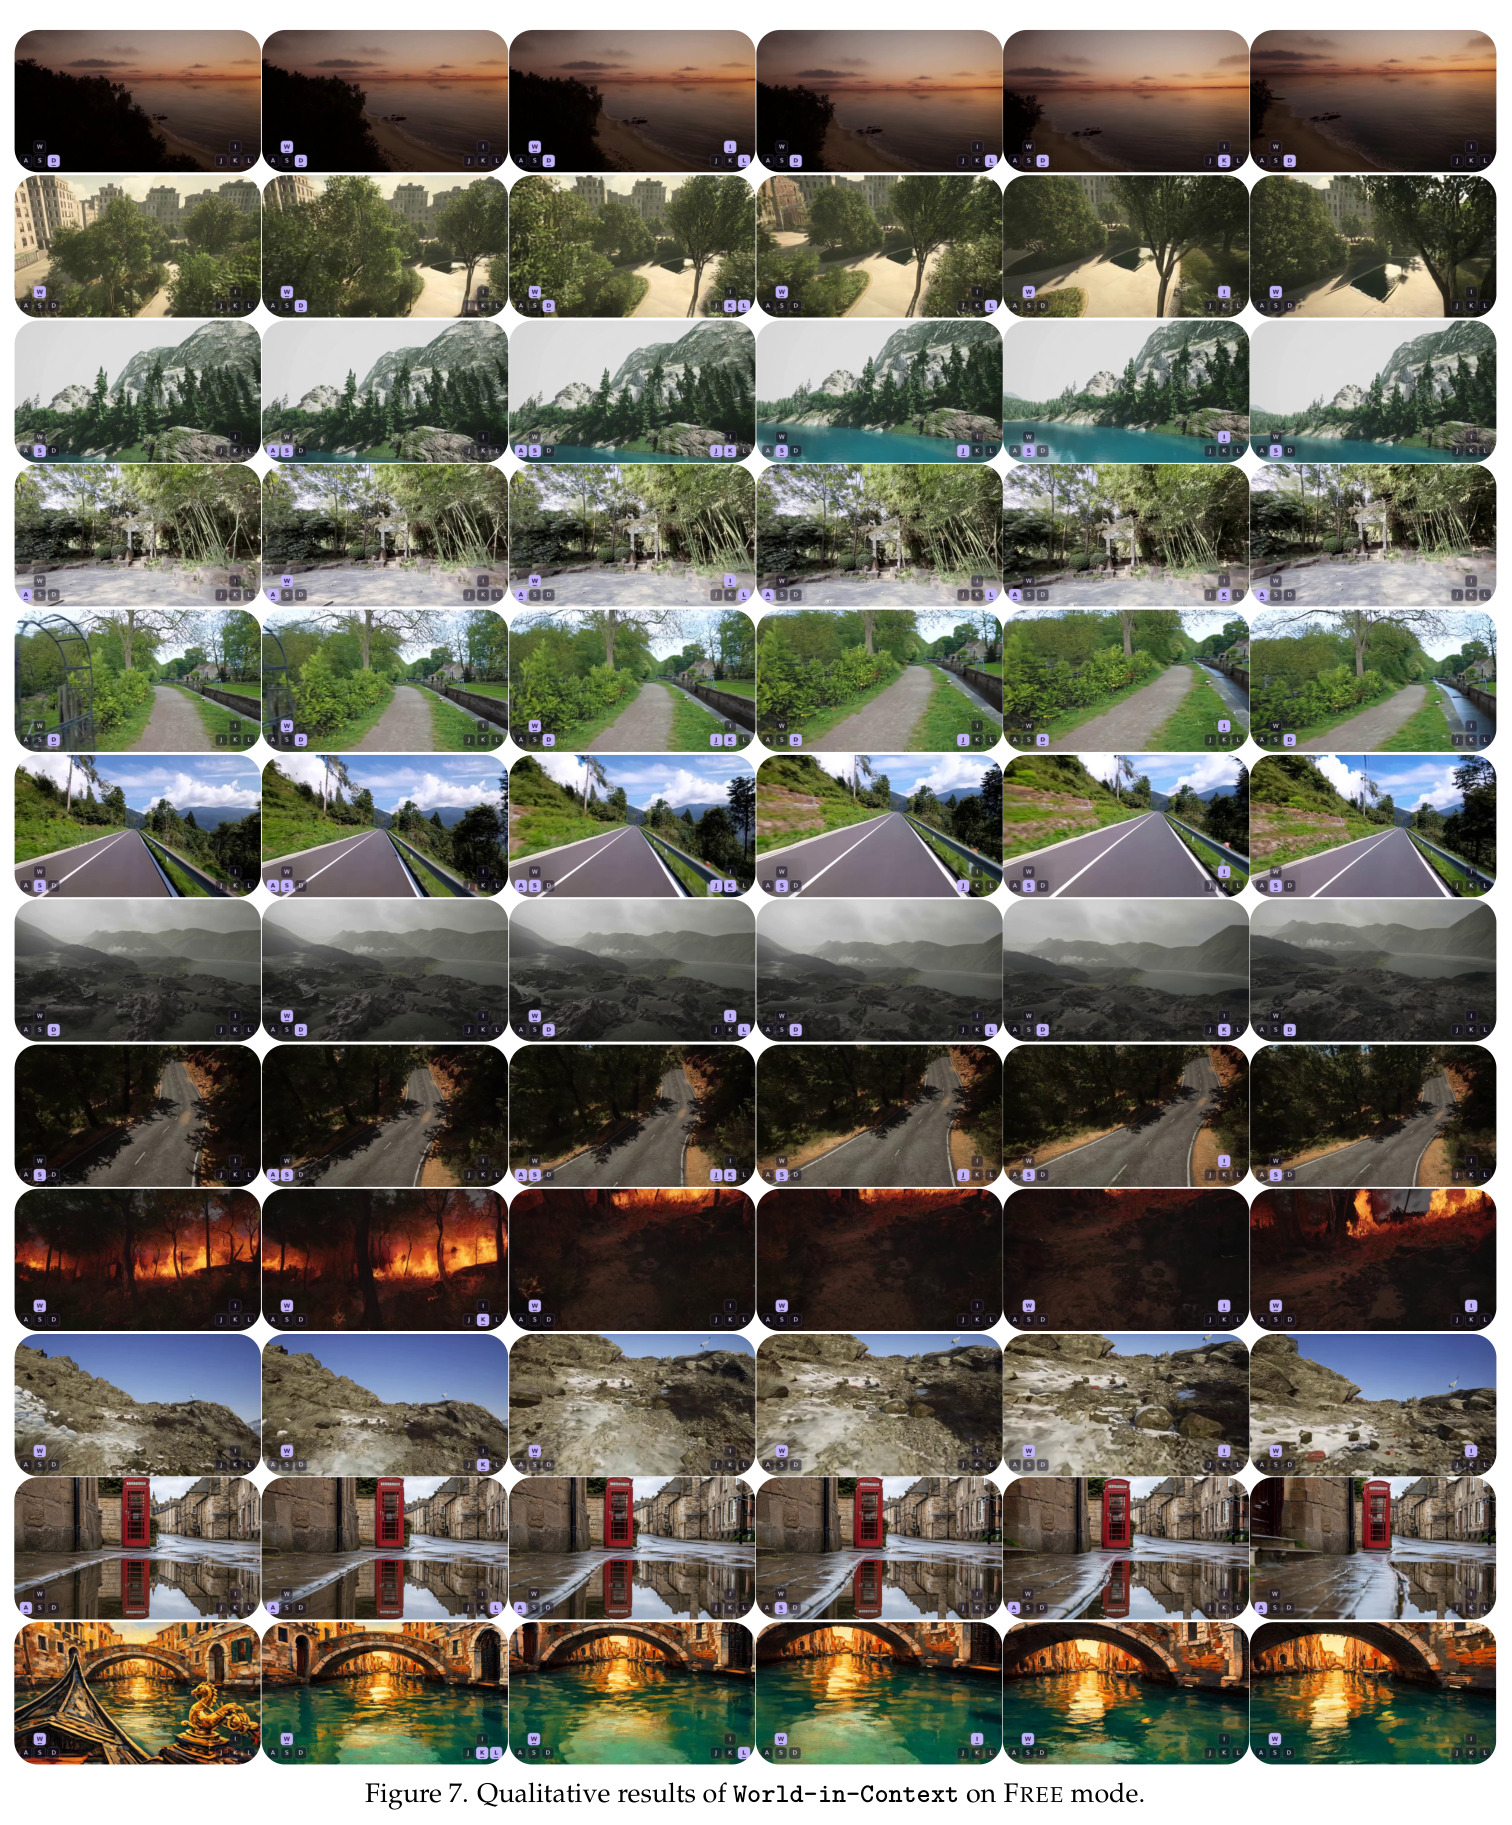
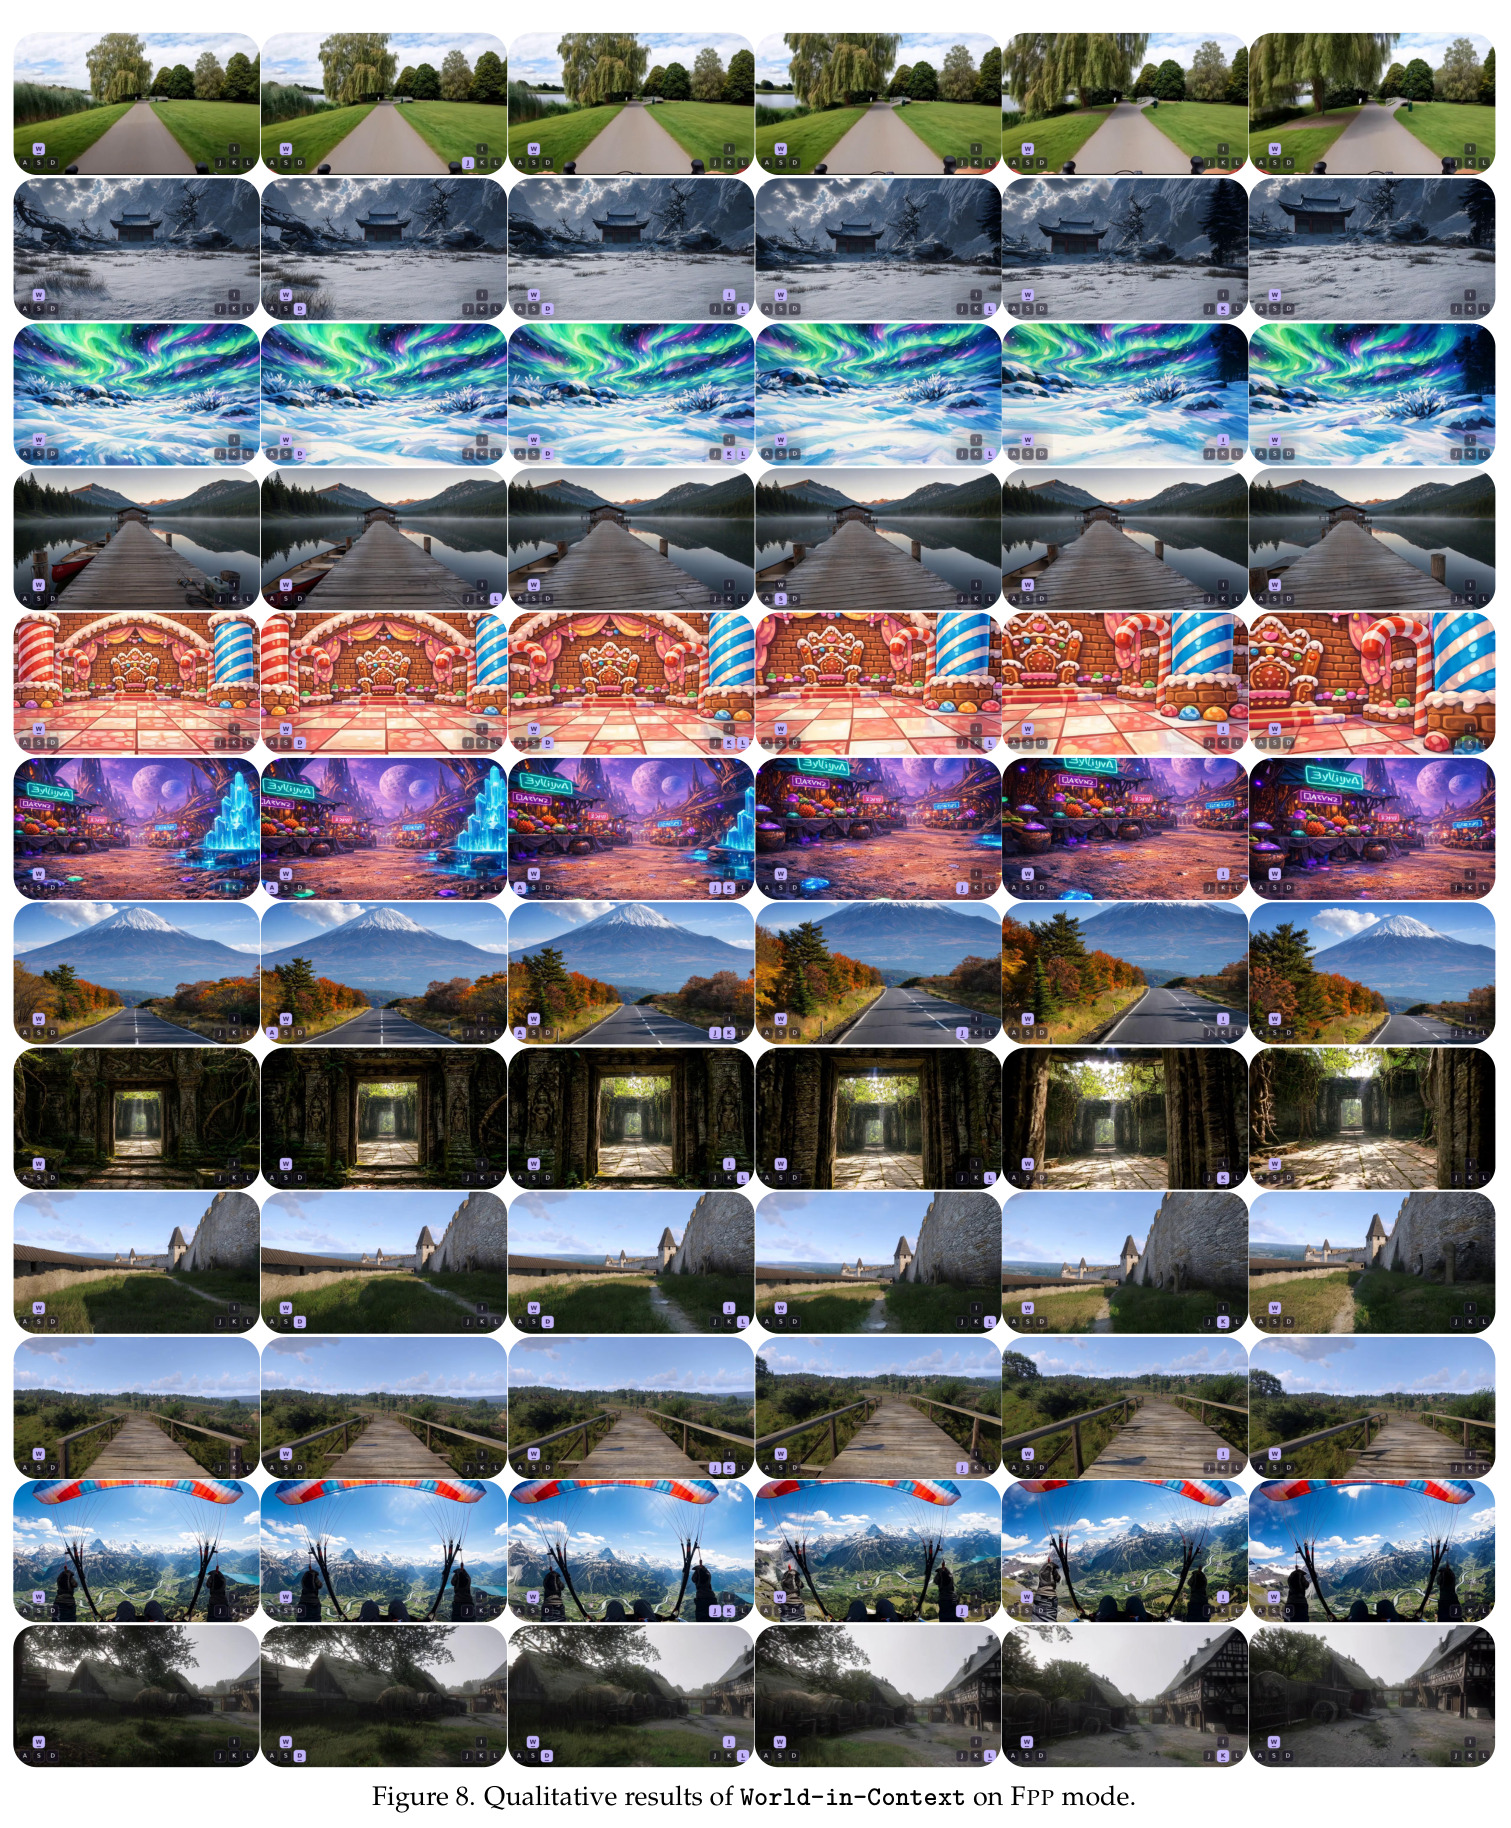
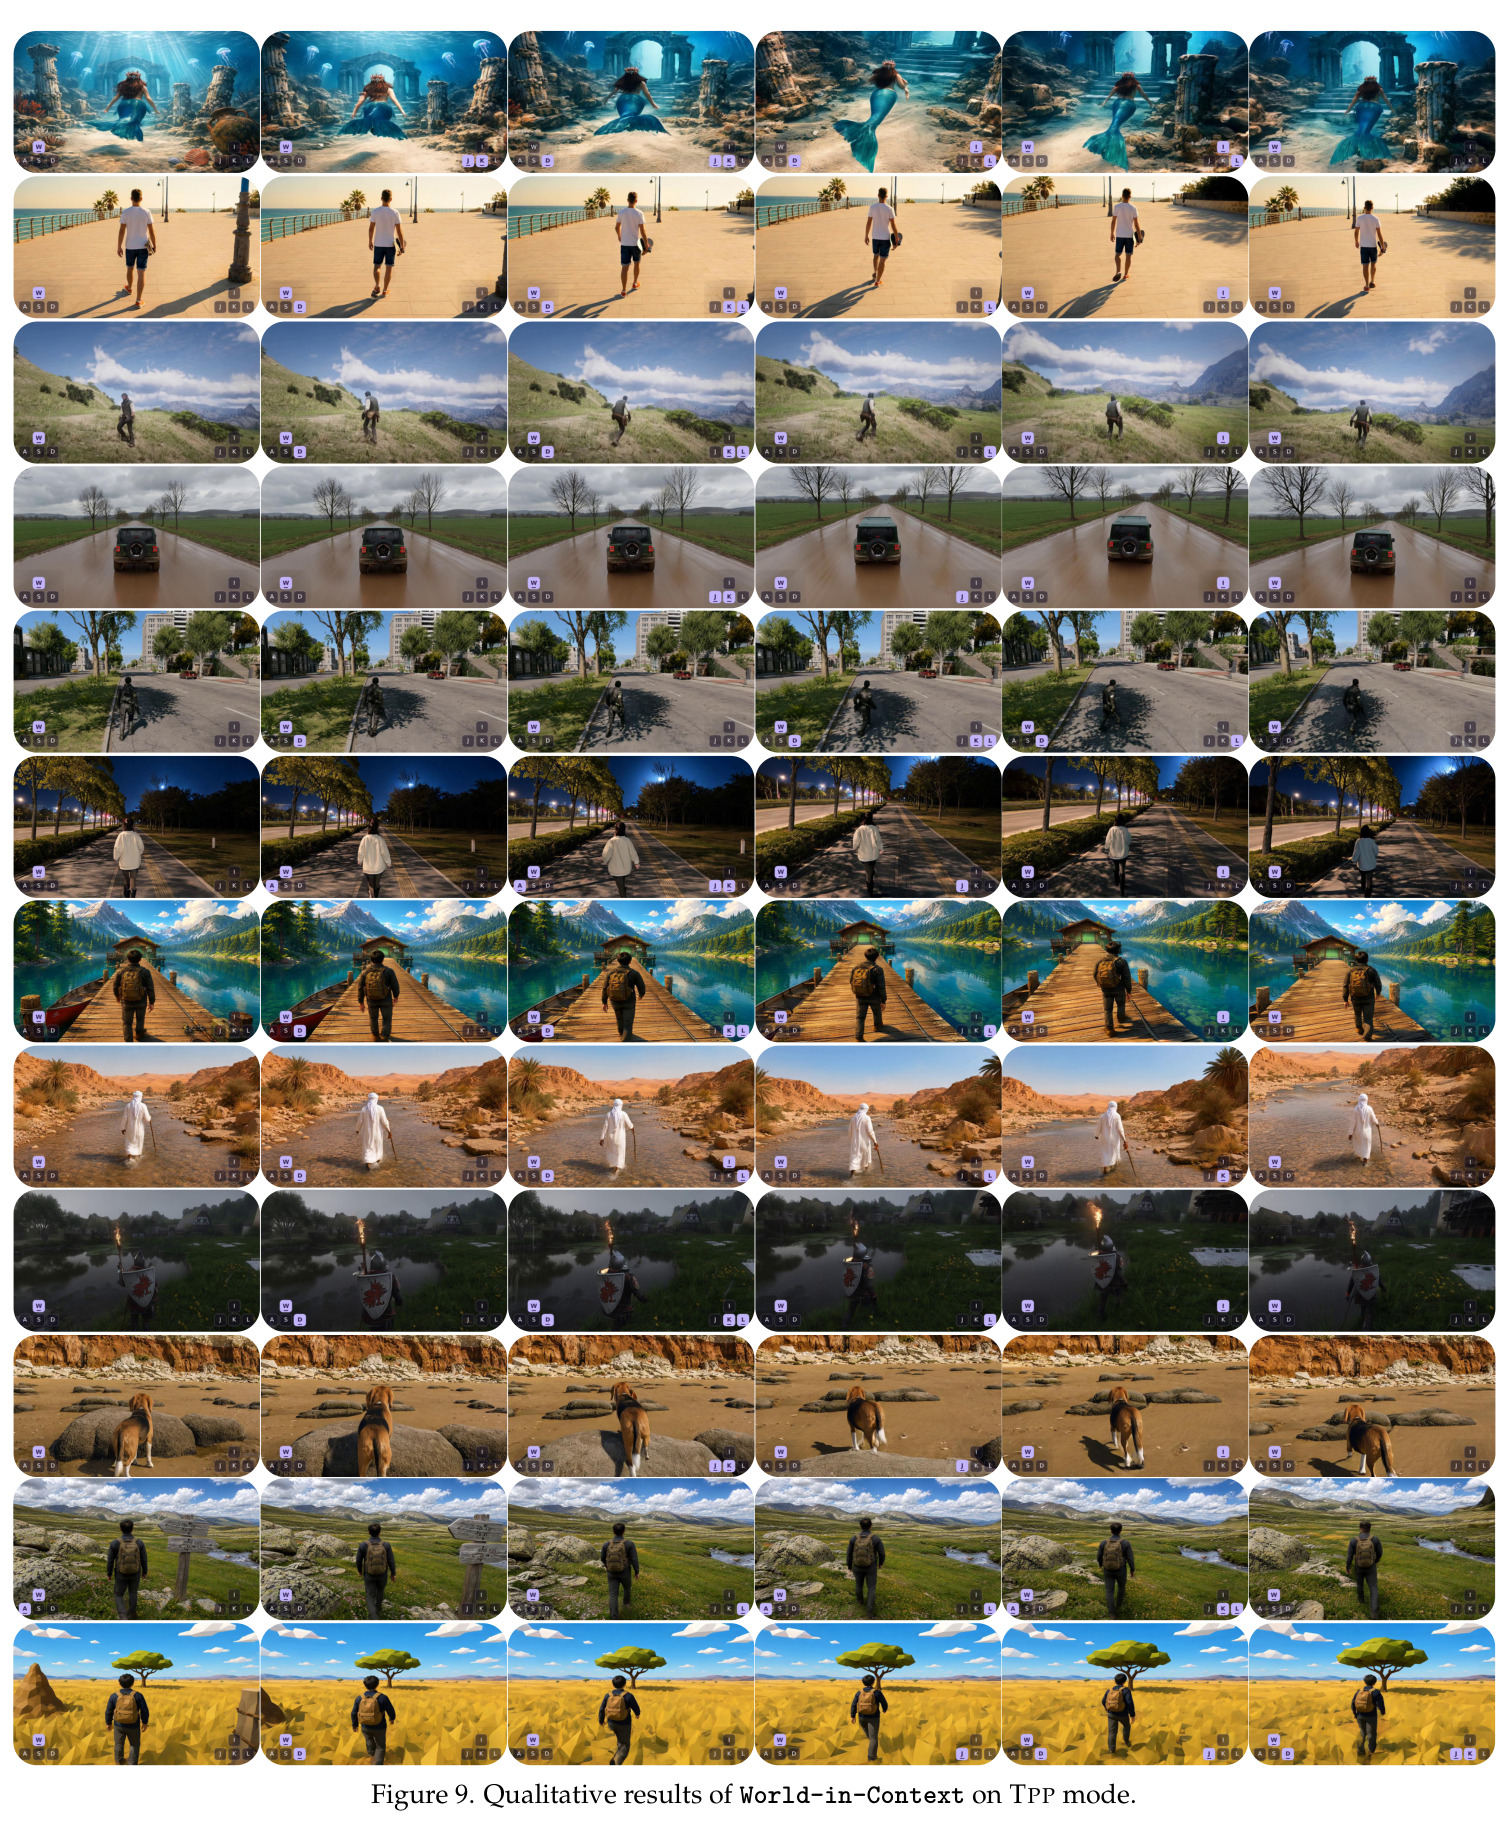
交互视频的三种观看视角:FREE 为自由漫游(无人机航拍式平滑轨迹),FPP 为第一人称(具身行走、带周期性头部摆动),TPP 为第三人称(外部角色跟随镜头)。同一几何轨迹在不同视角下意味着完全不同的运动语义,这是本文强调的关键观察。
视角模式的显式建模与 FPP↔TPP 视频中途切换(93.8% 成功率)是本文最重要的技术贡献与评测维度。
研究动机
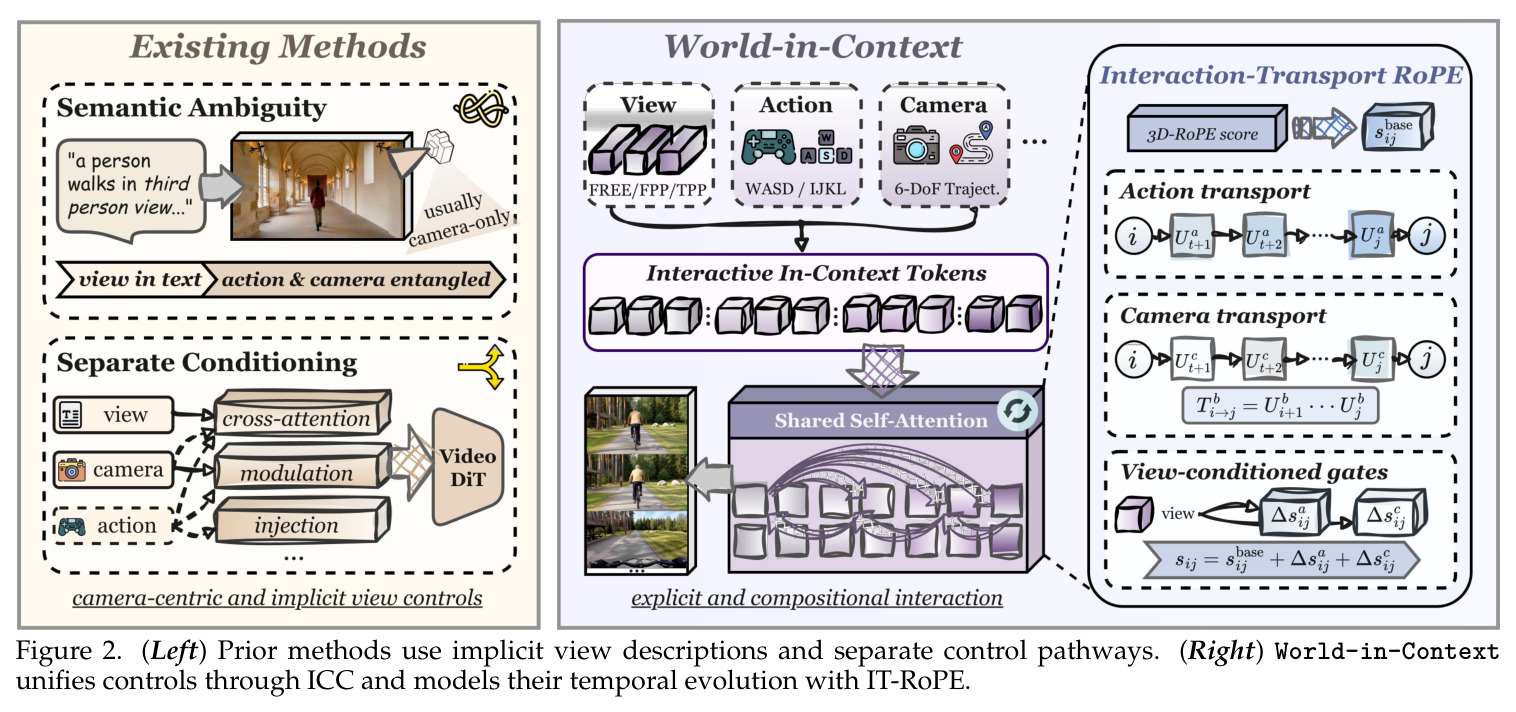
交互式视频世界模型正从被动生成走向闭环模拟(Genie 2、LingBot-World、YUME 1.5、Matrix-Game 等),用户通过控制输入驾驭动态视觉环境。但现有系统在两个基本维度上存在系统性缺陷。其一是视角模式歧义:FREE 自由漫游、FPP 第一人称、TPP 第三人称在交互数据中日益常见,然而 LingBot-World、EchoWM、Alaya-World 等主流模型只把视角信息隐式地塞进文本描述,还经常把 FREE 漫游与 FPP 控制混为一谈——事实上同一几何轨迹在不同视角下意味着完全不同的运动语义:FPP 呈现带周期性摆动的具身行走,FREE 则是平滑航拍轨迹,纯文本条件无法消解这种歧义。其二是动作-相机纠缠:CameraCtrl、DreamX-World 等绝大多数流水线仅依赖连续相机轨迹这一种控制信号,把角色动作与镜头运动当成同一自由度,而第三人称交互中二者本质上是独立通道;即便 ABot-World 等引入了离散动作,也是通过 AdaLN 调制、加性注入等孤立的架构分支路由,跨条件依赖只能被间接捕捉,控制组合越丰富协调越困难。
本文的目标是本文目标是建立一个统一的交互条件化框架,系统回答两个核心问题:世界如何被观看(视角模式),以及用户输入如何同时驱动角色动作与相机视口。具体包括四点:(1)把 FREE/FPP/TPP 视角从隐式文本提升为显式、逐帧对齐的离散 token,使模型能区分不同视角下的运动动力学,并支持视频生成中途的视角切换;(2)把离散角色动作与连续相机轨迹作为解耦但共存的自由度联合建模,厘清二者在局部指令保真与全局轨迹稳定上的分工;(3)不引入任何专用条件分支(AdaLN、cross-attention、几何 warping),仅靠共享自注意力空间原生捕捉跨条件依赖;(4)在 5B 规模、约 10 万段训练数据的适度预算下,达到与 22B 模型相当的导航能力,并大幅超越所有基线的视角切换成功率,同时可自然扩展到因果流式滚动与游戏级控制。
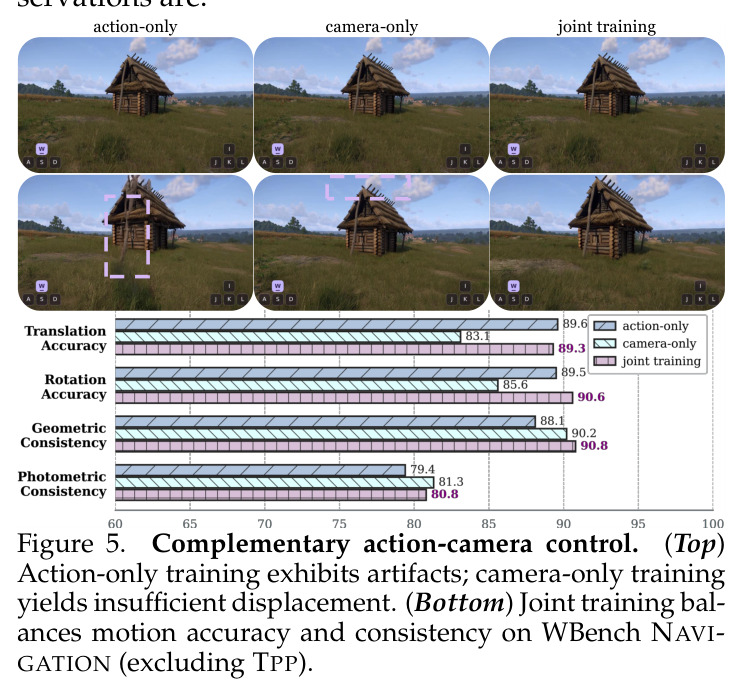
与已有工作不同的是,本文的独特切入角度是把多模态交互条件化重构为“上下文序列建模”问题。受 LLM 上下文学习与视觉 in-context 生成(Prompt Diffusion、OmniGen、IC-World)启发,作者不为任何控制设计专属通路,而是把视角、动作、相机统一投影为条件 token 序列 $c=[c_{\text{view}};c_{\text{action}};c_{\text{camera}}]$,直接前置到共享注意力流形中与视觉 latent 交互。其次,作者指出“逐帧给条件”仍不够——相距较远的帧之间发生了什么控制演进是隐式的,因此进一步提出 IT-RoPE,把沿时间累积的控制迁移算子显式参数化进时间注意力,区别于只编码相对时空坐标的标准 3D-RoPE。此外,本文首次系统量化了视角模式对运动动力学的调制(FPP 振荡 vs FREE 平滑)、仅用单视角数据即可涌现的视角切换,以及动作/相机在“局部响应性 vs 全局稳定性”上的互补分工,这些实证发现本身填补了领域空白。
核心方法
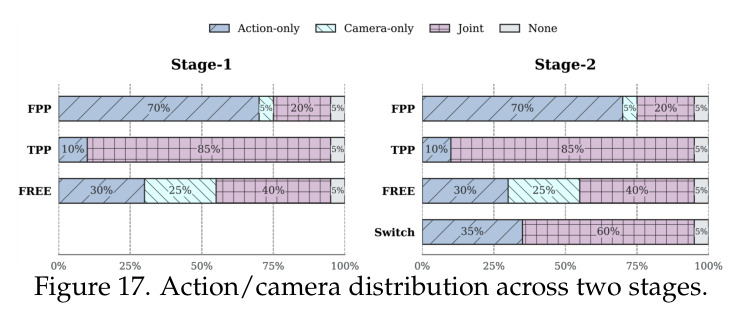
直觉上,World-in-Context 让扩散模型像阅读上下文一样“阅读”控制信号:交互输入不再是经旁路调制的外部信号,而是与视觉内容平起平坐的 token,共同参与自注意力。技术路线上,模型以 Wan2.2-TI2V-5B 流匹配 DiT 为骨干。设 $z_\tau$ 为扩散时刻 $\tau\in[0,1]$ 的视频 latent,$y$ 为纯世界状态描述文本(仅描述场景静态构成,动态全部交给控制 token),三类控制编码为条件序列 $c\in\mathbb{R}^{L_c\times D}$($D$ 为骨干隐藏维度),模型在拼接序列上预测速度场 $\hat{v}_\tau=\mathcal{F}_\theta([c;z_\tau];y,\tau)$。方法由三大支柱组成:(i)显式视角建模——离散视角 token 区分 FREE/FPP/TPP 并天然支持切换;(ii)动作-相机联合建模——子槽化动作 token 与 Plücker 相机 token 作为解耦共存的自由度;(iii)IT-RoPE——把累积控制迁移注入时间注意力,保证跨执行区间的时序连续性。训练采用两阶段课程与混合条件模式(action-only/camera-only/joint/unconditioned)。
核心创新有两点。第一是 In-Context Conditioning(ICC):与既有方法为每种控制设计专属参数通路(AdaLN 调制相机轨迹、加性注入离散动作、cross-attention 处理文本、位置注意力/warping 注入相机几何)不同,ICC 把所有控制统一成 token 序列前置进共享注意力流形,跨条件依赖被原生、直接地建模,无需任何附加模块——本质上是把“条件注入”问题转化为“上下文建模”问题,与 LLM 的 in-context learning 同构。第二是 Interaction-Transport RoPE(IT-RoPE):标准 3D-RoPE 只编码相对时空坐标,帧间控制演进是隐式的;IT-RoPE 为动作与相机维持双通道保序迁移路径,每个控制输入诱导一个正交步变换 $U^b_t$,区间 $(i,j]$ 的相对迁移 $T^b_{i\to j}=\prod_{k=i+1}^{j}U^b_k$ 是非交换乘积,天然保留控制执行顺序(可区分端点相同但路径不同的轨迹),并以门控 $g^b$、区间掩码 $m^b_{ij}$、中心化(减去单位矩阵 $I$)与零初始化尺度 $\lambda^b$ 的残差形式加到时间注意力分数上,训练初期严格保持预训练骨干行为。
方法步骤详情
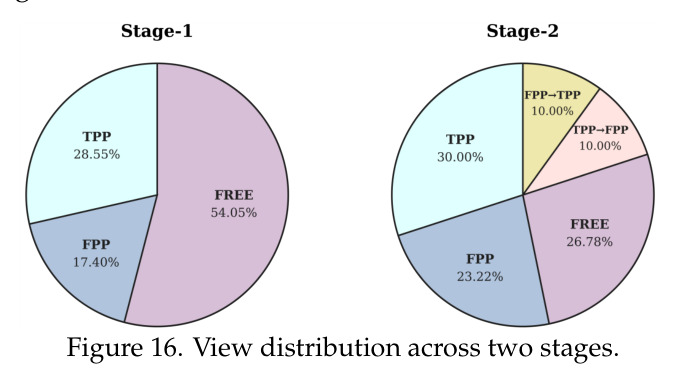
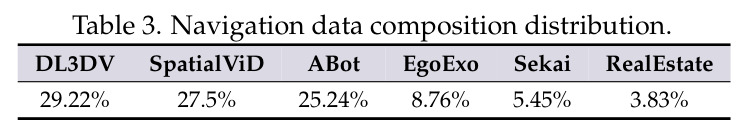
方法可拆为四步。第一步,数据构建:收集 100K 单视角导航片段(DL3DV 29.22%、SpatialViD 27.5%、ABot 25.24%、EgoExo 8.76%、Sekai 5.45%、RealEstate 3.83%)与 500 条 FPP↔TPP 切换序列;经 TransNetV2 镜头切分、UniMatch 光流/VMAF 运动过滤、DOVER 美学评估三道质检;用 Qwen3-VL-32B 自动分类视角模式(歧义样本用重建轨迹交叉验证),ViPE 重建 6-DoF 相机轨迹与 Plücker 射线,离散动作从连续轨迹反演(FPP 中先滤除身体摆动);字幕只描述静态世界状态。第二步,条件编码:视角 token $c^t_{\text{view}}=e_{\text{view}}(v_t)+e_{\text{type}}(\text{view})$,$v_t\in\{\text{FREE},\text{FPP},\text{TPP}\}$;动作按子槽 $S=\{\text{move},\text{turn},\Delta_{\text{trans}},\Delta_{\text{rot}}\}$ 分解,每个 token 组合槽位编码器 $h_s$、连续量残差支路 $r_s$ 与时间/位置/类型嵌入后过 LayerNorm;相机 token 为 $\text{LayerNorm}(\phi_{\text{ray}}(\boldsymbol{\pi}^{t,u,v})+\phi_{\text{pose}}(\text{vec}(E_t))+\phi_\Delta(\xi_t)+e_{\text{type}})$。第三步,IT-RoPE:维护前缀算子 $P^b_t=P^b_{t-1}U^b_t$、$T^b_{i\to j}=(P^b_i)^\top P^b_j$,注意力得分加上 $\sum_{b}\tfrac{\lambda^b}{\sqrt{r}}\,m^b_{ij}g^b_ig^b_j\,(q^b_i)^\top(T^b_{t_i\to t_j}-I)k^b_j$,并利用 $\bigl((Pq)^\top(Pk)-(q)^\top k\bigr)$ 前缀分解实现随序列长度线性扩展的计算。第四步,训练:Stage-1 在 100K 导航片段上用流匹配目标学基础动力学,Stage-2 用 8K 混合课程(切换片段过采样)巩固切换稳定性;默认为双向微调,混合四种条件模式训练。
技术新颖性
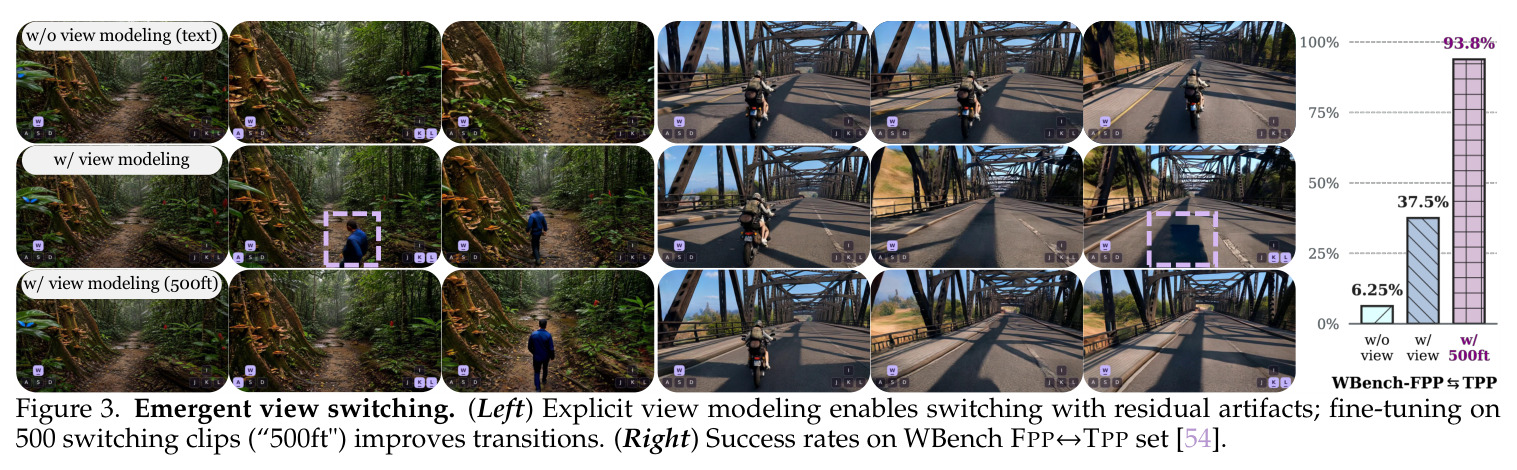
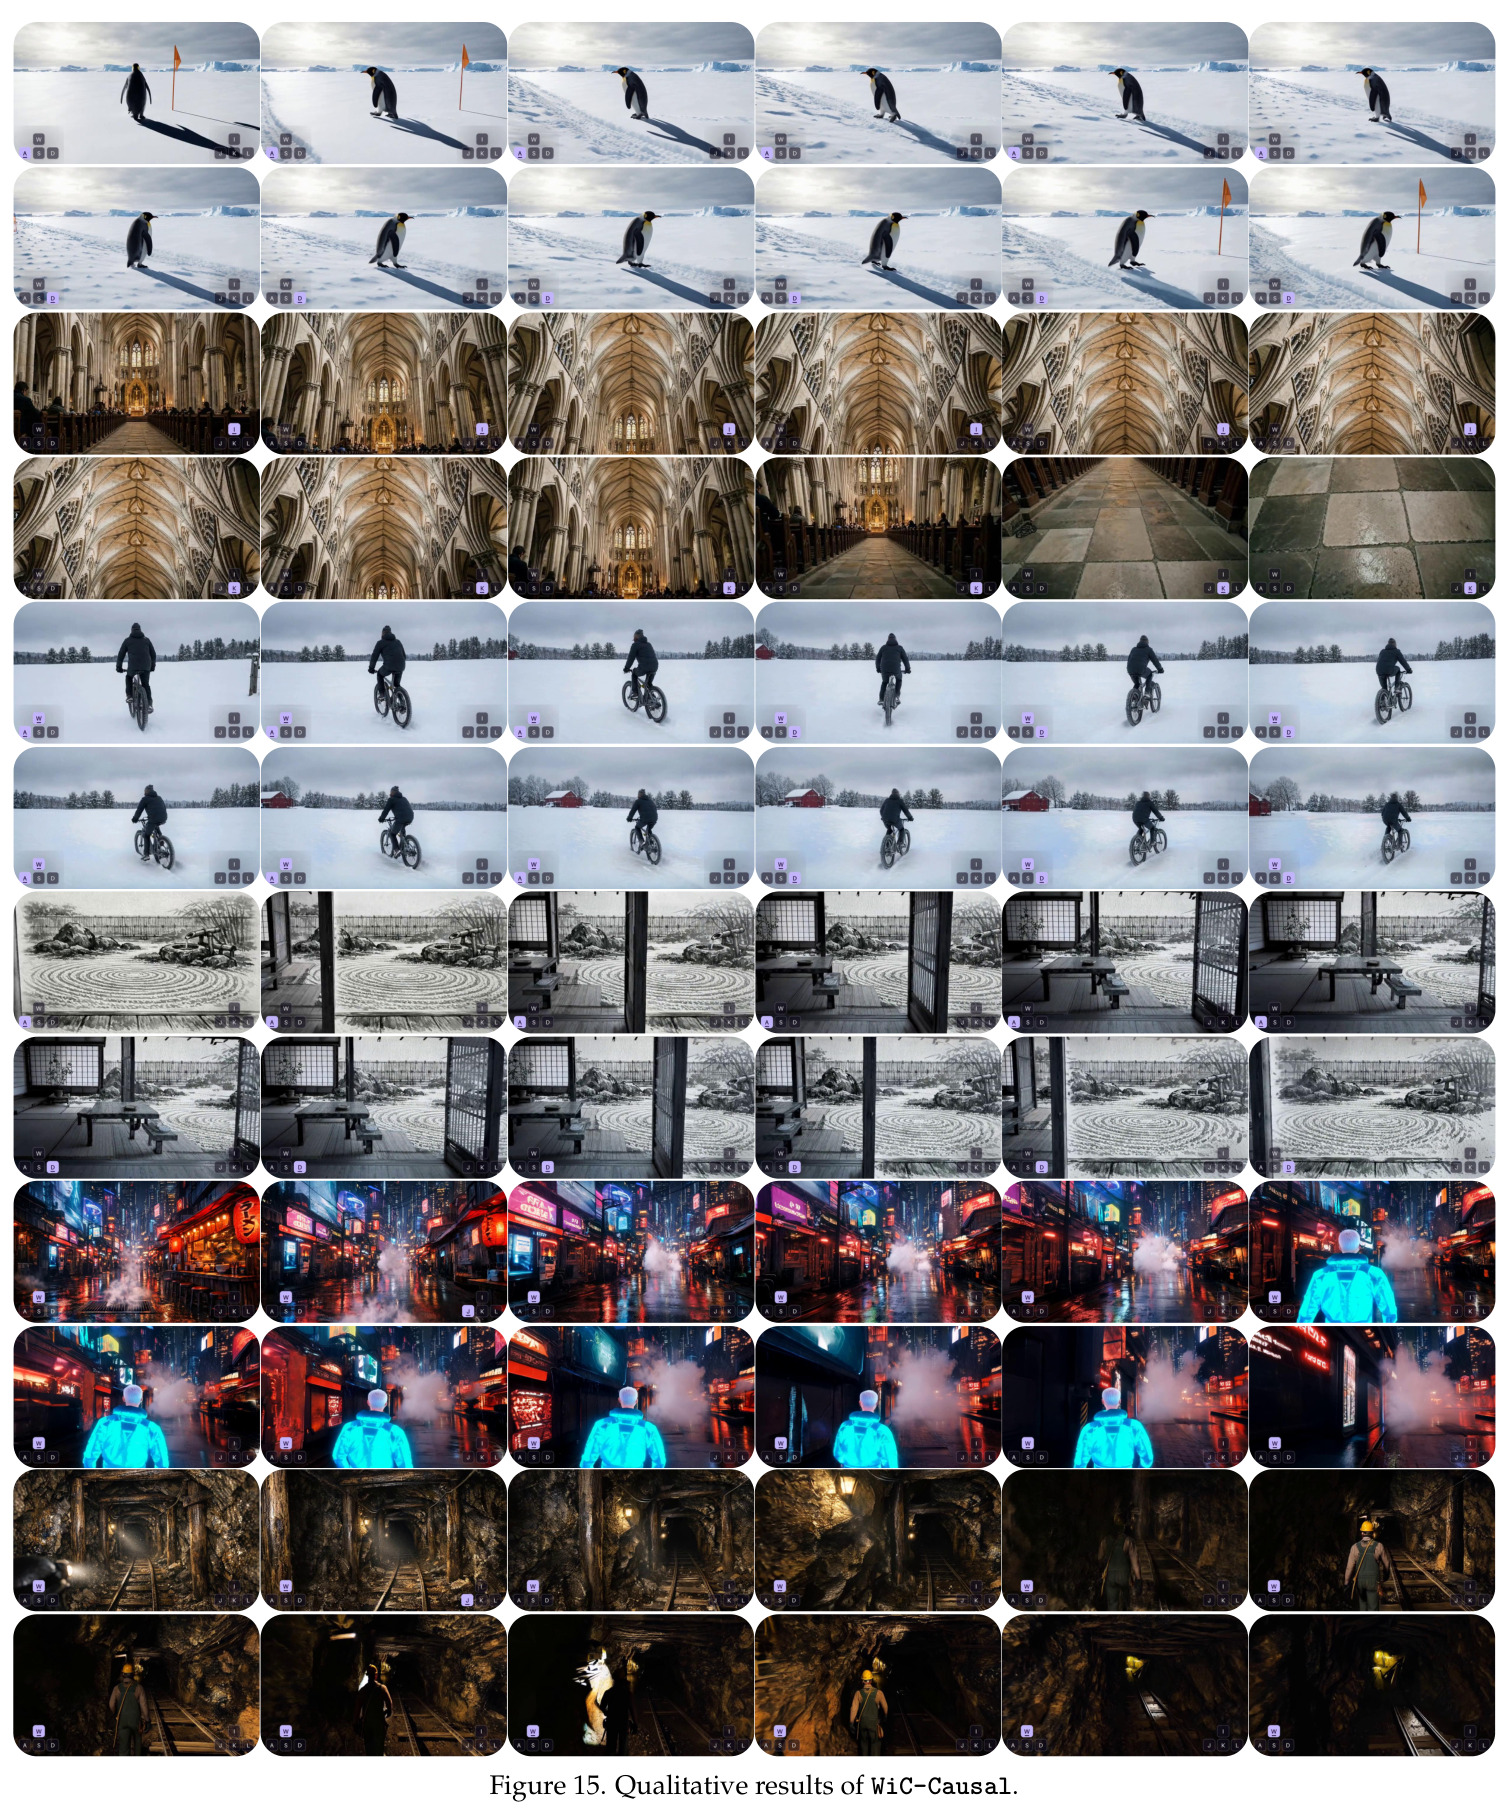
技术新颖性体现在四个层面。其一,条件接口的范式转变:此前世界模型社区默认“每种模态一条架构通路”,本文证明统一 in-context 序列在控制组合丰富时收益复合增长(仅相机条件时与专用通路持平 76.3,加入动作与视角后领先扩大到 +1.0/+1.4),为多条件扩展提供了可扩展接口。其二,IT-RoPE 的“控制驱动”位置编码:受 PaTH attention(累积 Householder 变换的位置编码)启发,但迁移算子由时间有序的用户输入驱动而非数据驱动的可学习变换,且通过减去 $I$ 的中心化与零初始化尺度 $\lambda^b$ 保证训练起点等价于原生 3D-RoPE,属于保守而安全的设计。其三,实证新知:显式视角 token 使仅用单视角片段训练即涌现 37.5% 切换成功率(文本基线 6.25%),500 条切换数据即达 93.8%;动作主导局部指令保真、相机锚定全局稳定性的互补规律也属首次量化。其四,接口的自然延伸性:加入 sink token 与滑动窗口 $c_{\text{recent}}$ 即把同一框架改为因果流式版本,性能几乎无损(81.2 vs 81.5),再加离散游戏控制 token($c_{\text{fire}},c_{\text{duck}},c_{\text{walk}}$)即可扩展到 CS2 级高频操作。
实验结果
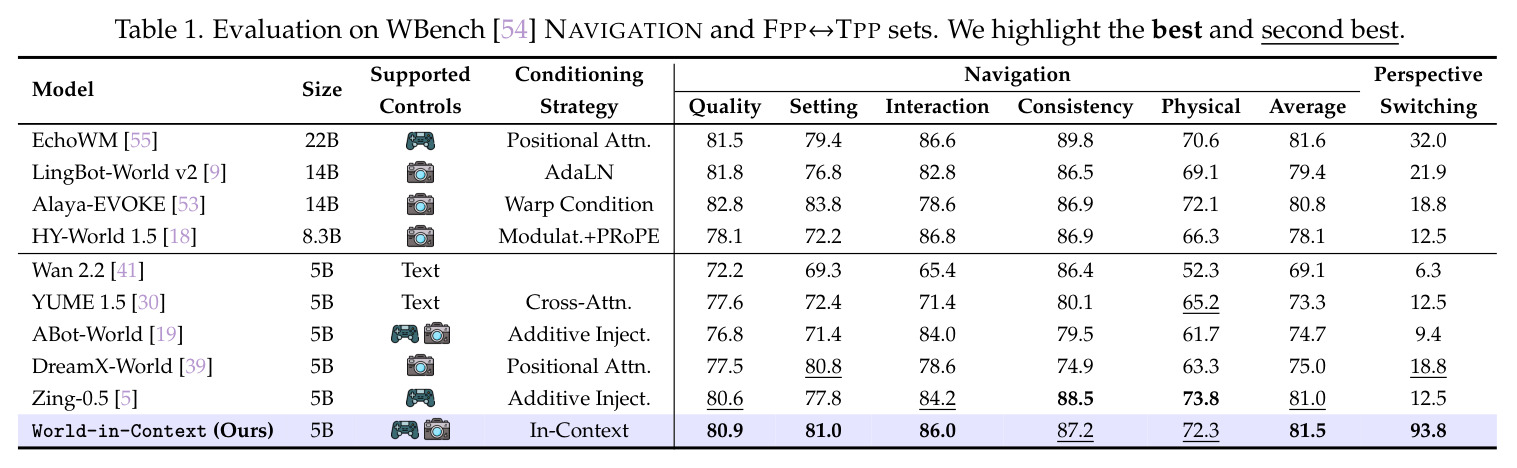
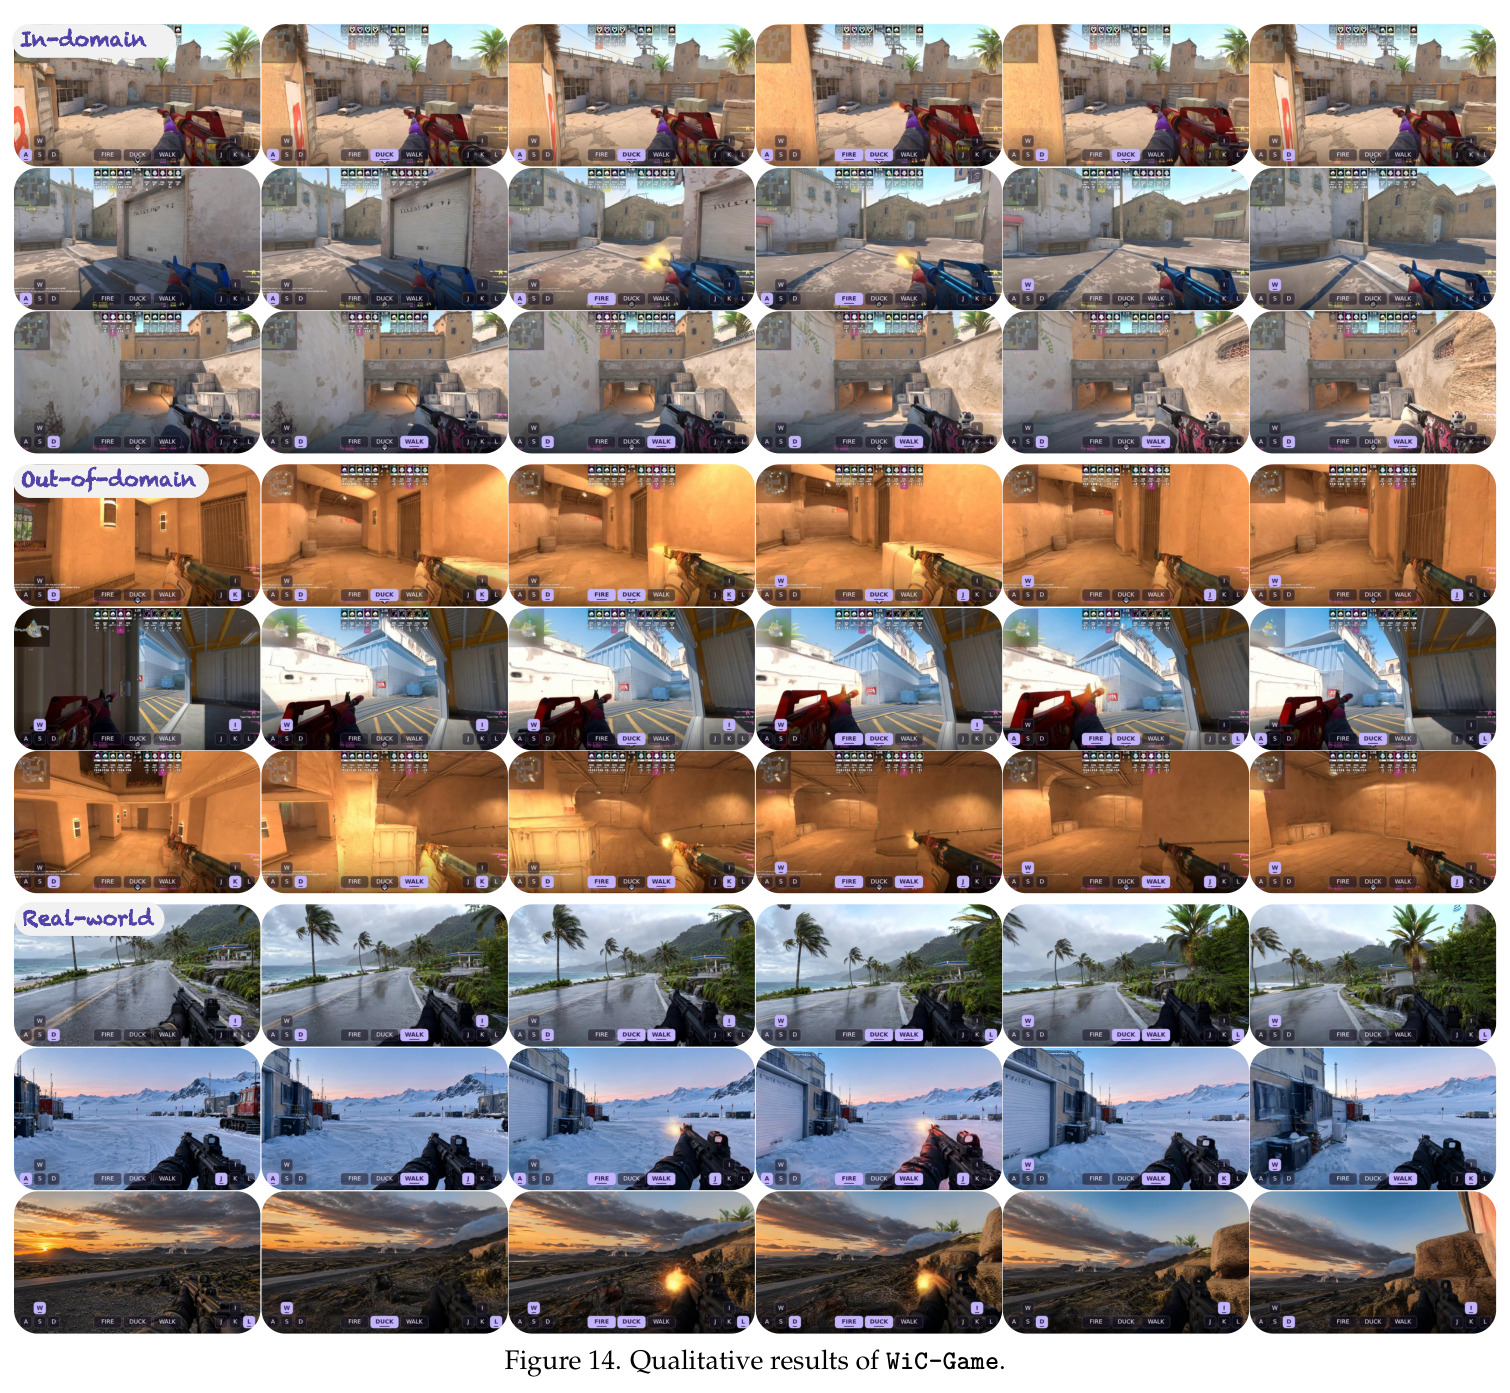
所有实验在 WBench(289 案例、1058 交互轮次)上进行。主结果(Table 1):WiC-5B 导航平均 81.5,超过所有 5B 基线(最佳 Zing-0.5 为 81.0),追平 22B EchoWM(81.6);交互分 86.0 高于 Zing-0.5 的 84.2;FPP↔TPP 切换成功率 93.8%,而最佳 5B 基线仅 18.8%,连 22B EchoWM 也只有 32.0%。涌现切换(Fig.3):无任何切换监督的基座模型即达 37.5%(文本条件基线 6.25%),仅加 500 条切换片段微调后升至 93.8%。视角动力学(Fig.4,100 场景振荡 RMS):显式视角建模下 FPP 呈周期性行走振荡、FREE 保持平滑,文本条件使二者轮廓重叠。动作/相机互补(Fig.5):action-only 平移/旋转精度分别高 6.5/3.9 分但有视觉伪影;camera-only 几何/光度一致性高 2.1/1.9 但位移不足;联合训练旋转精度 90.6、几何一致性 90.8、平移 89.3 最均衡。条件策略消融(Fig.11):ICC 仅相机条件时与 AdaLN/加性注入持平(76.3 vs 76.3–77.0),加动作 +0.6/+1.1,再加视角达 81.2/86.8,优势随条件复合而扩大。IT-RoPE 消融(Fig.12):相对 3D-RoPE 导航 80.5→81.2、交互 86.2→86.8,且明显优于端点-only 变体(80.5/86.6)。数据效率(Fig.13):ICC 用一半数据(50K+250)达 75.0% 切换率,超过两倍数据(100K+500)的加性注入(71.9%);100K+500 的 ICC 在导航与切换上全面超过 125K+750 的加性注入(81.5 vs 80.3;93.8% vs 78.1%)。因果版(Table 2):WiC-Causal 导航 81.2、切换 90.6%,与双向版仅差 0.3 分/3.2 个百分点,且能在回环场景重现先前地标(Fig.15)。游戏扩展(Fig.14):在 CS2 单一地图 DUST II 小规模数据上训练 fire/duck/walk 控制后,未见地图(MIRAGE、NUKE)与真实图像均保持场景一致性与动作可控性。
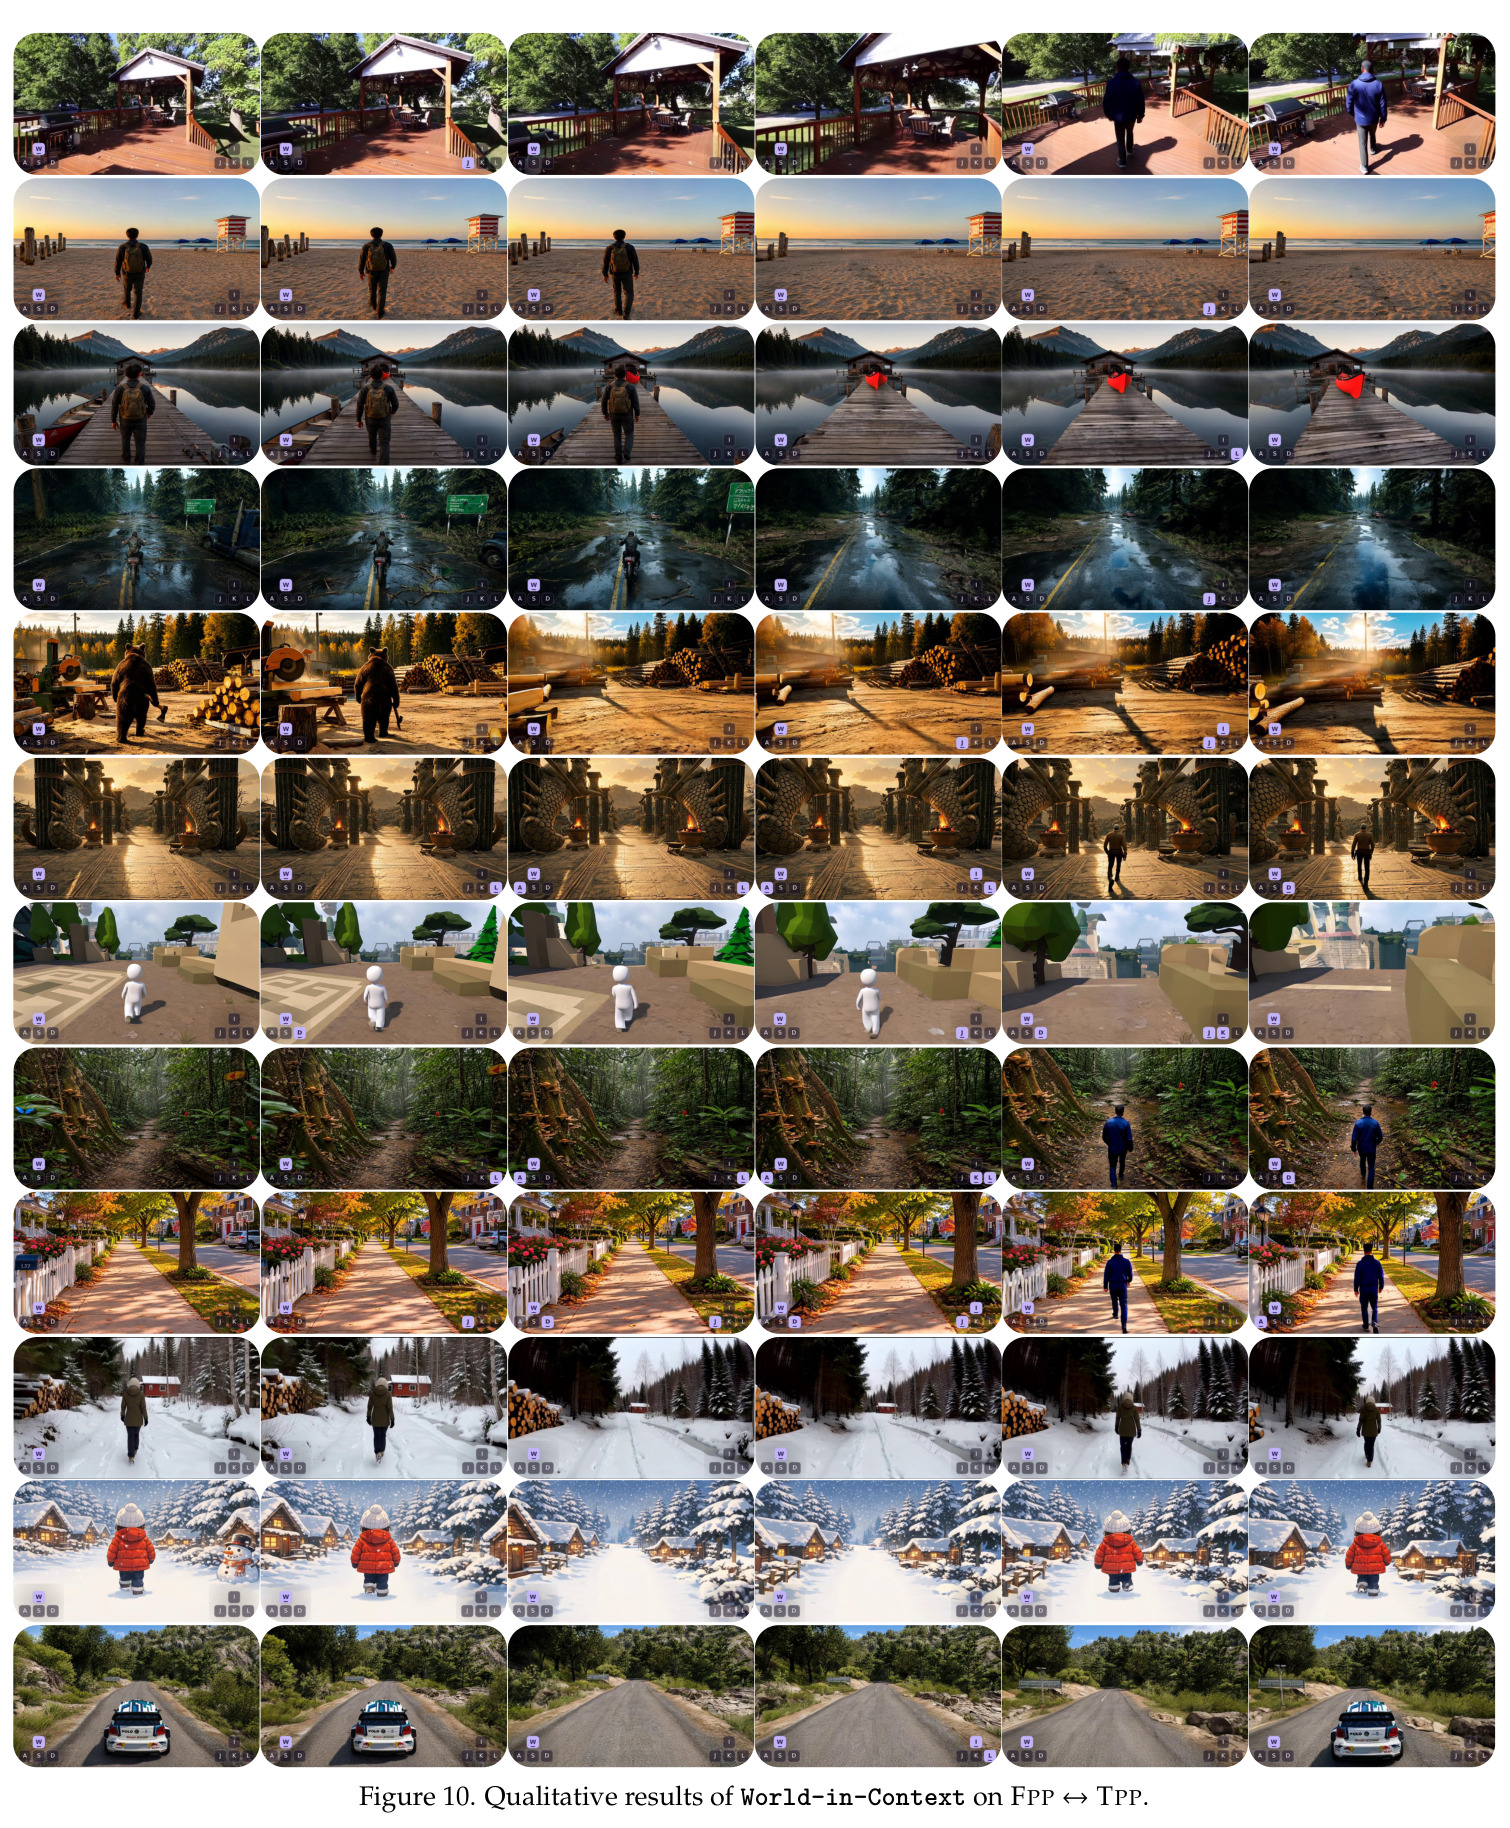
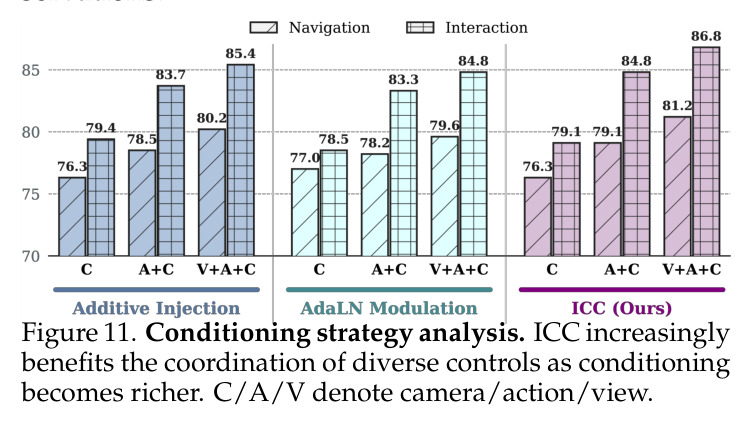
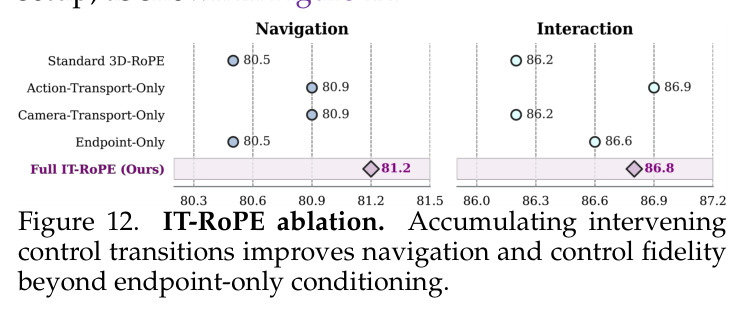
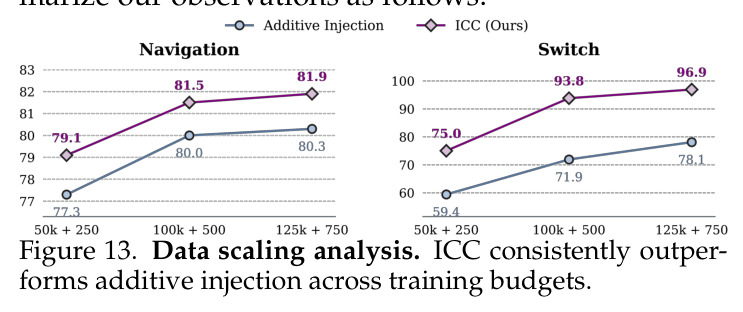
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WBench 导航(NAVIGATION 套件) | 五维平均分(Quality/Setting/Interaction/Consistency/Physical) | 81.5 | 5B 最佳基线 Zing-0.5 为 81.0;22B EchoWM 为 81.6 | 5B 模型中最高,以约 1/4 参数量追平 22B 模型 |
| FPP↔TPP 视角切换(WBench Perspective Switching) | 切换成功率(%) | 93.8 | 最佳 5B 基线 18.8(DreamX-World / Alaya-EVOKE);22B EchoWM 仅 32.0 | +75.0 个百分点(对最佳 5B 基线),+61.8 个百分点(对 22B EchoWM) |
| WBench 交互保真(Interaction 维度) | 生成轨迹与动作参考轨迹的比对得分 | 86.0 | Zing-0.5 为 84.2 | +1.8 |
| 条件策略对比(视图+动作+相机全条件) | 导航 / 交互得分 | 81.2 / 86.8(ICC) | 同数据复现的加性注入与 AdaLN 调制 | 仅相机条件时持平(76.3),随条件复合扩大到 +1.0 / +1.4 |
| IT-RoPE 消融 | 导航 / 交互得分 | 81.2 / 86.8(完整 IT-RoPE) | 3D-RoPE 80.5/86.2;endpoint-only 80.5/86.6 | +0.7/+0.6(对 3D-RoPE) |
| 数据效率对比(50K+250 训练量) | 视角切换成功率(%) | 75.0(ICC) | 加性注入用两倍数据(100K+500)为 71.9 | 半量数据反超 +3.1 个百分点 |
| 因果流式滚动(WiC-Causal) | 导航平均分 / 切换成功率 | 81.2 / 90.6% | 自身双向版本 81.5 / 93.8% | 近乎无损(-0.3 分 / -3.2 个百分点),仍全面领先 5B 基线 |
局限与改进
作者明确承认的局限:本工作聚焦算法层面的条件化公式化而非全能系统,整体能力受限于数据质量、模型规模与训练规模;仅使用 10 万导航片段加 500 条切换序列的适度数据;因各家训练数据规模不公开,主表未做跨方法的数据规模对齐,而是用同数据受控实验替代;混合条件(action-only/camera-only/joint)的调度比例只是经验透明化而非调优后的最优配置(Fig.16/17 公布分布仅为可信度说明)。我自己的观察:其一,动作标注并非真实游戏遥测,而是从 ViPE 重建的相机轨迹反演离散化,TPP 松散跟拍下动作与镜头信号难以干净分离,模型学到的动作语义可能继承轨迹估计偏差;其二,视角切换成功率由 VLM 按过渡平滑度、终态视角、取景几何判定,存在评估者偏差风险;其三,物理维度 72.3 是五个导航维度中的最低分,物理合理性仍是短板;其四,论文未报告推理延迟与实时性(对标 ABot-World、minWM 等实时系统时这是关键指标),分钟级以上长时程滚动也未系统量化;其五,所有结论均在 Wan2.2-TI2V-5B 单一骨干上得出,向其他 DiT 骨干的迁移性未验证。
独立分析的弱点
独立分析出的弱点及改进方向:(1)动作信号是“反演”而非遥测——真实键鼠/手柄动作只在游戏引擎中可得,本文用相机轨迹反推离散动作并在 FPP 中滤除身体摆动,这意味着“动作→画面”映射可能混入相机估计偏差,在角色大幅移动而镜头静止的场景会失真;改进方向是接入游戏引擎遥测数据(如 EWM、Matrix-Game 数据管线)直接监督动作 token。(2)IT-RoPE 的步变换 $U^b_t$ 限定为正交矩阵,只能表达旋转/刚体类几何迁移,无法编码非刚体场景状态(门开关、物体被推动),这些只能靠视觉 latent 隐式学习;可推广到可学习的一般线性变换或引入显式场景状态 token。(3)视角切换评估依赖 VLM 判定,可能高估成功率,建议补充人评与重投影误差等几何硬指标。(4)长时程记忆有限——WiC-Causal 用 sink 加滑动窗口,回环场景尚可,但数十分钟探索仍会遗忘远处地标;可结合检索式记忆(如 WorldPlay 的 patch memory)。(5)实时性缺失——5B 双向流匹配难以实时部署,需结合因果蒸馏(如 causal forcing)与量化加速。(6)物理得分 72.3 偏低,可引入物理约束损失或仿真渲染数据混合训练。
未来方向
作者提出的方向:将 ICC 接口扩展到更丰富的控制模态与更大规模训练,与并行的 scaling 工作互补;论文已示范游戏级控制(fire/duck/walk)与因果流式(WiC-Causal)两条延伸路线。基于其成果可自然延伸的研究:(1)多智能体世界——把 NPC 意图与行为作为额外条件 token,实现可干预的多主体模拟;(2)多模态世界状态——将音频、事件文本与 ICC token 并列,构建视听世界模型;(3)作为强化学习环境的交互世界模型——ICC 的精确条件接口天然适合定义任务与奖励,供智能体策略闭环训练;(4)任意视角连续插值——从离散 FREE/FPP/TPP token 扩展到连续视点参数,实现电影级运镜;(5)实时流式系统——将 WiC-Causal 与因果蒸馏、KV cache 优化结合,追求桌面 GPU 上的实时交互;(6)把 IT-RoPE 迁移算子推广到非正交/可学习变换,编码非刚体场景状态演进;(7)显式 3D 一致性监督——结合 Depth Anything 3 等深度/点图监督提升当前最低的物理维度得分(72.3)。
复现评估
复现条件总体友好。代码已在 GitHub 开源(aigc3d/World-in-Context),项目主页提供演示;骨干为公开的 Wan2.2-TI2V-5B;训练数据全部来自公开数据集(DL3DV、RealEstate、Sekai、SpatialViD、EgoExo、ABot-World-Explorer),但 500 条切换序列来自 EgoExo 与内部数据,内部部分无法获取。标注管线工具链全部公开:Qwen3-VL-32B(视角分类)、ViPE(相机轨迹重建)、TransNetV2(镜头切分)、UniMatch/VMAF(运动过滤)、DOVER(美学评估)、MegaSaM 与 Depth Anything 3(评测用轨迹/深度)。评测采用公开的 WBench 官方协议(289 案例/1058 轮次),未做修改。算力未披露,但 5B 模型两阶段微调 100K 片段估计需要数十张 A100/H100 级 GPU 训练数天。主要复现风险:动作反演的离散化阈值与 FPP 摆动过滤细节、Stage-2 的 8K 课程混合比例、混合条件采样调度只给出了分布图而非精确配置;好在论文提供了充分消融(Fig.11–13),在相同数据与协议下复现核心结论(ICC 优于专用通路、切换率量级)可行性较高。总体难度:中高,适合有视频扩散训练经验的团队。
论文图表
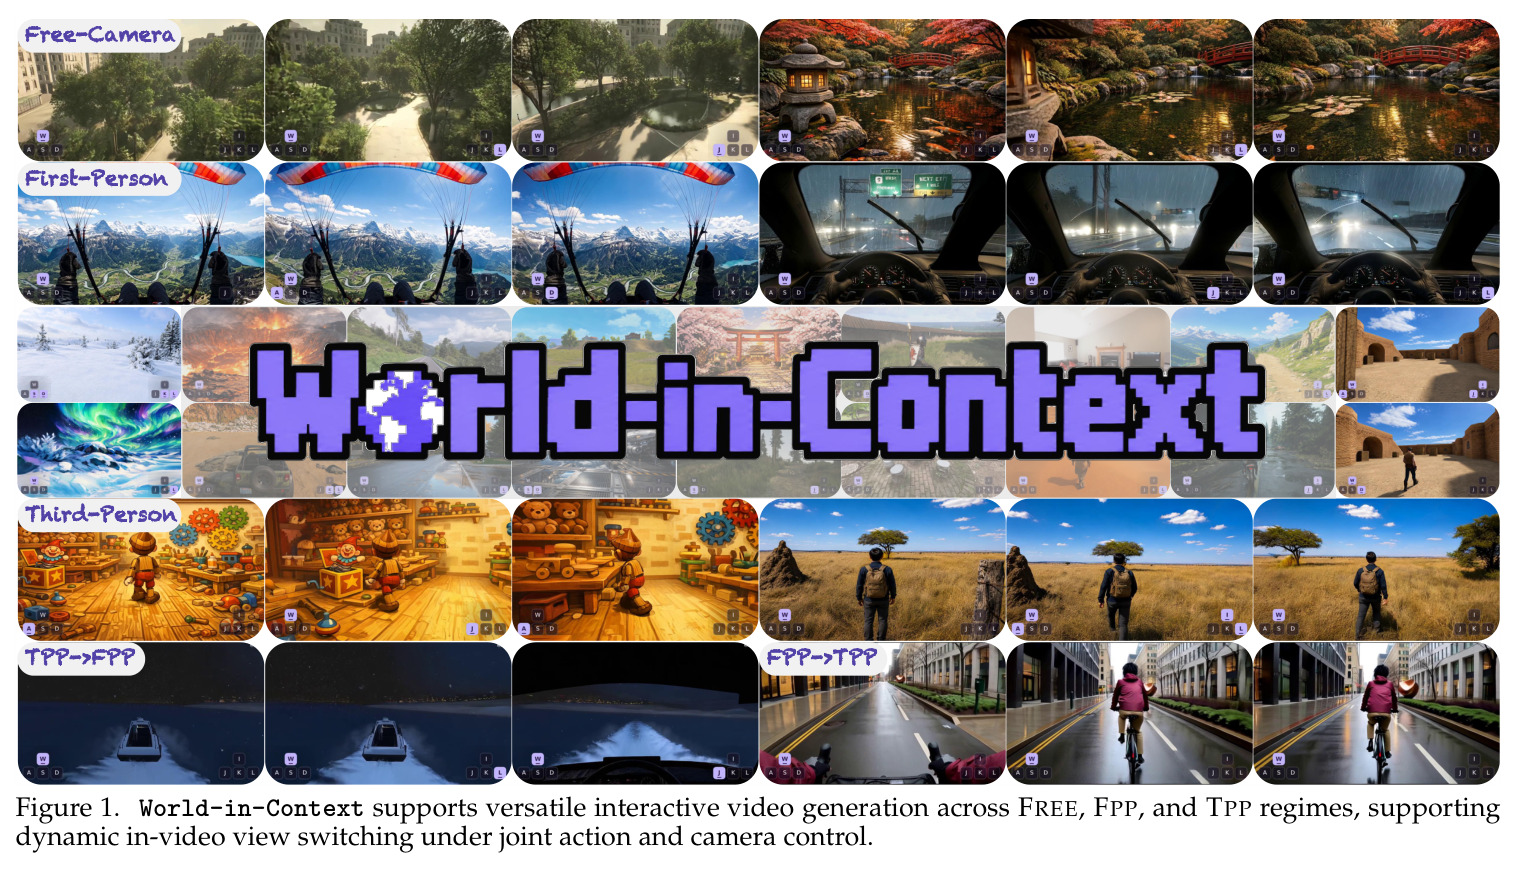
teaser 展示模型支持的三大视角模式(FREE 自由漫游、FPP 第一人称、TPP 第三人称),以及在联合动作与相机控制下视频内部动态切换视角(TPP→FPP 与 FPP→TPP)的能力演示。
一图概括论文的完整能力范围:三种视角模式加视频中途切换,是理解任务设定与应用场景的最快入口。
给出 100K 导航训练数据的来源构成:DL3DV 29.22%、SpatialViD 27.5%、ABot 25.24%、EgoExo 8.76%、Sekai 5.45%、RealEstate 3.83%。
数据配方透明化是复现的基础,也说明训练仅用约 10 万片段即达到上述性能,凸显数据效率。