基础模型时代的游戏人工智能:贯穿游戏生命周期的六大角色综述 AI for Games in the Foundation Model Era
按AI输出的直接用途把游戏AI组织为六大角色,统一梳理能力迁移、制品复用与证据强度。
前置知识
基础模型(Foundation Model)
在海量多模态数据上预训练、可通过自然语言、视觉和代码接口适配到众多下游任务的大型模型(如 GPT-6 Astra、Claude、Gemini 系列)。它们不再针对单一游戏训练,而是以语言规划、视觉理解、工具调用等通用能力介入游戏的开发、游玩与测试各环节。
本文的标题和分析视角都建立在基础模型之上:整篇综述回答的核心问题就是——通用预训练能力进入游戏生命周期后,哪些能力可以跨游戏/引擎/接口/玩家群体迁移,哪些仍然被游戏特定结构锁死。
游戏智能体与强化学习谱系
从 DQN 用像素直接学 Atari 操作,到 AlphaGo/AlphaZero 结合策略-价值网络与搜索自我对弈,再到 AlphaStar、OpenAI Five 的实时大规模训练,以及 DreamerV3 用单一配置搞定 150 多个任务。这一谱系定义了“专用智能体”的能力上限与迁移困境。
综述第一个角色 Play and Act 完全沿这条谱系展开,理解“专用性能”与“泛化迁移”是两个不同成就,才能读懂作者对 generalist 智能体的批判性梳理。
世界模型(World Model)
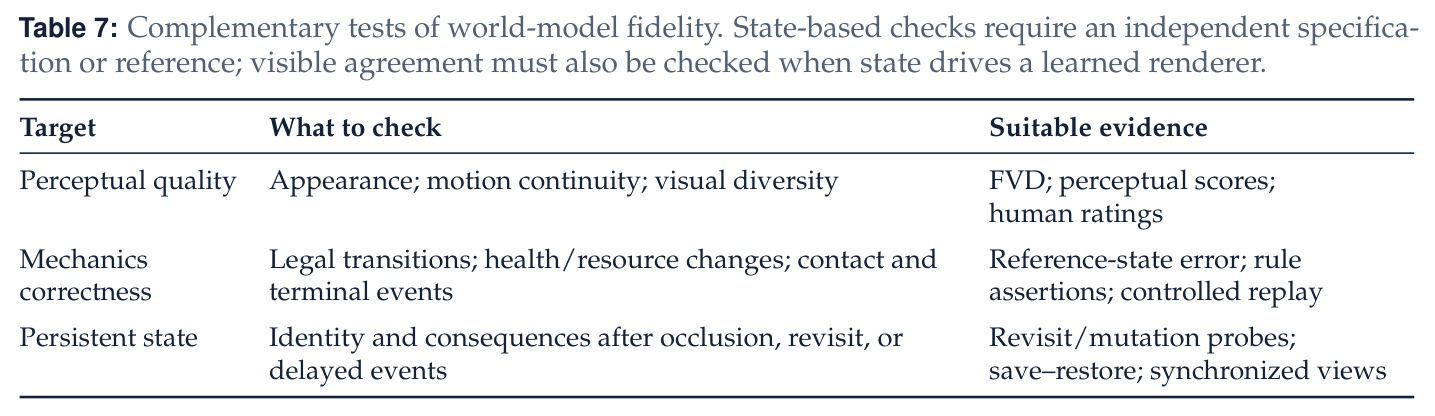
从交互轨迹中学习环境动态 $p(s_{t+1}|s_t,a_t)$ 的模型,可支持规划(MuZero)、策略训练(Dreamer 系列在想象轨迹中训练策略)或直接当可玩模拟器(GameNGen、Genie、GameGen-X)。评测时需区分感知质量(如 FVD 视频指标)、机制正确性与持续状态三个不同保真度目标。
Model Players and Games 是六大角色之一,也是跨角色连接的枢纽:轨迹可以训练世界模型,学到的环境又能反过来给智能体提供训练经验,这条双向通路是本文最核心的复用论证。
程序化内容生成(PCG)
用算法自动生成关卡、规则、资产等游戏内容的技术传统,从搜索式生成(Mechanic Miner)、约束求解(Tanagra)到语言模型生成(MarioGPT、ChatGPT4PCG)和混合主动式共创工具(Sentient Sketchbook、DreamGarden)。
Design 角色是该传统的直接延续;理解 PCG 的经典评测维度(有效性、多样性、可控性、可解性)才能理解作者为什么强调“生成更多候选”不等于“更好的设计”。
迁移层级:map / mode / game
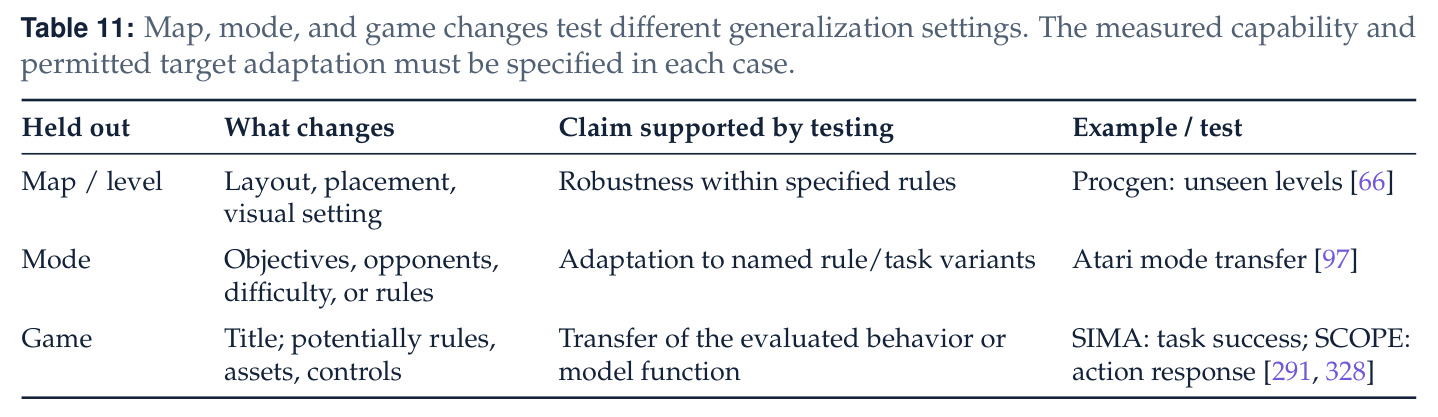
本文提出的泛化设定区分:换地图/关卡(规则不变,测鲁棒性)、换模式(目标、对手或规则变体,测适应)、换游戏(标题、规则、资产、操控都可能变,测真迁移)。并进一步分解为视觉表征迁移、动作-控制迁移、规则推理三类。
这是全文评判“泛化主张”是否成立的尺子:很多论文声称的跨游戏能力,实际只测了其中某一层(比如只换了视觉外观),本文用它来给每条证据划定解释边界。
LLM-as-Judge(模型裁判)与奖励破解
用大模型给生成内容、截图、轨迹打分或判定缺陷。其风险在于自偏好(judge 偏爱同类模型的输出)和把优化目标对准不完美验证器导致的 reward hacking——修复只反馈出的问题而留下其他缺陷。
Test and Evaluate 角色大量依赖模型裁判(GameGen-Verifier、CombatStateBench 等),本文反复提醒:裁判独立性与执行级校验决定“判定”的可信度,这是读懂证据评估章节的前提。
研究动机
游戏AI研究长期分裂为互不相通的社区:游戏对战(从 Shannon 1950 的国际象棋程序到 DQN、AlphaZero、AlphaStar、OpenAI Five、GT Sophy)、程序化内容生成、交互叙事(Façade、PaSSAGE)、玩家建模(TrueSkill、player2vec)、自动化测试各自发展,术语、评测协议与证据标准互不兼容。基础模型时代让这种割裂变得尤为尴尬:同一个模型(如 GPT-6 Astra)既在 ARC-AGI-3 里做陌生交互环境探索,又在 Playco 的 Playbot 里当引擎连接的开发工具生成可玩原型,却被现有综述按“游戏对战/内容生成/玩家建模”等单一路线分别描述。结果是:社区无法区分哪些能力能跨游戏、引擎、接口、玩家群体迁移,哪些只在特定设置成立;一个“会玩”的模型是否自动“会测试”、一条轨迹能否既当训练数据又当诊断证据,都缺乏统一框架回答。
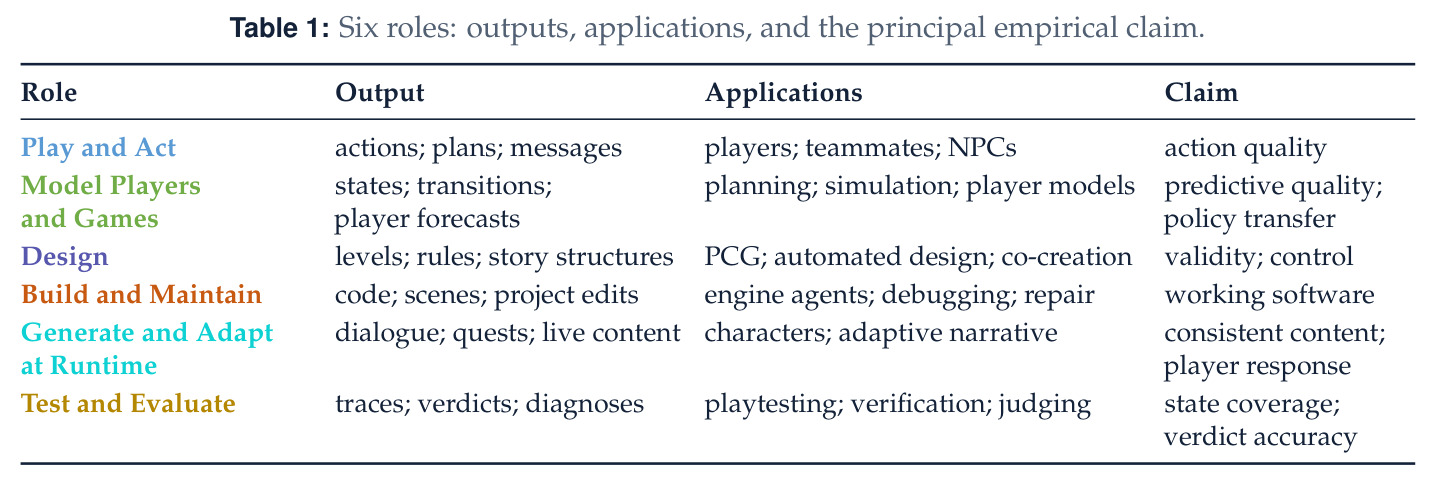
本文的目标是本文要建立一个以“AI 输出的直接用途”为分类轴的统一组织框架,把游戏生命周期上的所有 AI 系统归入六个角色:AI that Plays and Acts(输出动作/计划/消息)、Models Players and Games(输出状态/转移/玩家预测)、Designs Games(输出关卡/规则/叙事结构)、Builds and Maintains Games(输出代码/场景/工程修改)、Generates and Adapts at Runtime(输出对话/任务/实时内容)、Tests and Evaluates Games(输出轨迹/判定/诊断)。对每个角色回答三个问题:边界——游戏或工作流提供了什么结构、AI 学到/生成/预测/修改了什么;迁移与复用——哪些能力可迁移、哪些制品可复用、哪些仍是设置特定的;证据——在输出的实际使用位置上,评测支持什么主张。最终目标是让读者能区分“提出一个机制”“正确实现它”“检验玩家如何遭遇它”三种不同的成就。
与已有工作不同的是,已有综述分别覆盖游戏对战智能体、机器学习 PCG、玩家建模、交互式世界模型、社交智能体、生成式游戏开发、自动化测试等单一领域(如 Yannakakis & Togelius 的广度综合、Gallotta et al. 的 LLM 应用综述)。本文的独特切入是双重的:其一,把可执行的开发与维护、运行时生成、自动化评测与对战、建模、设计放进同一分析框架,并回溯其学习式与符号式前身;其二,以“角色之间传递的输出物”为连接轴——轨迹可以变成模拟器训练数据、学习环境可以给智能体供经验、设计规格可以驱动可执行实现、游玩或测试反馈可以指导修订——从而把六个领域连成一张可检验的信息流图。按输出用途而非模型架构分类,也解决了 MarioGPT(设计)与 Play2Code(开发)这类同一模型跨角色的归属问题。
核心方法
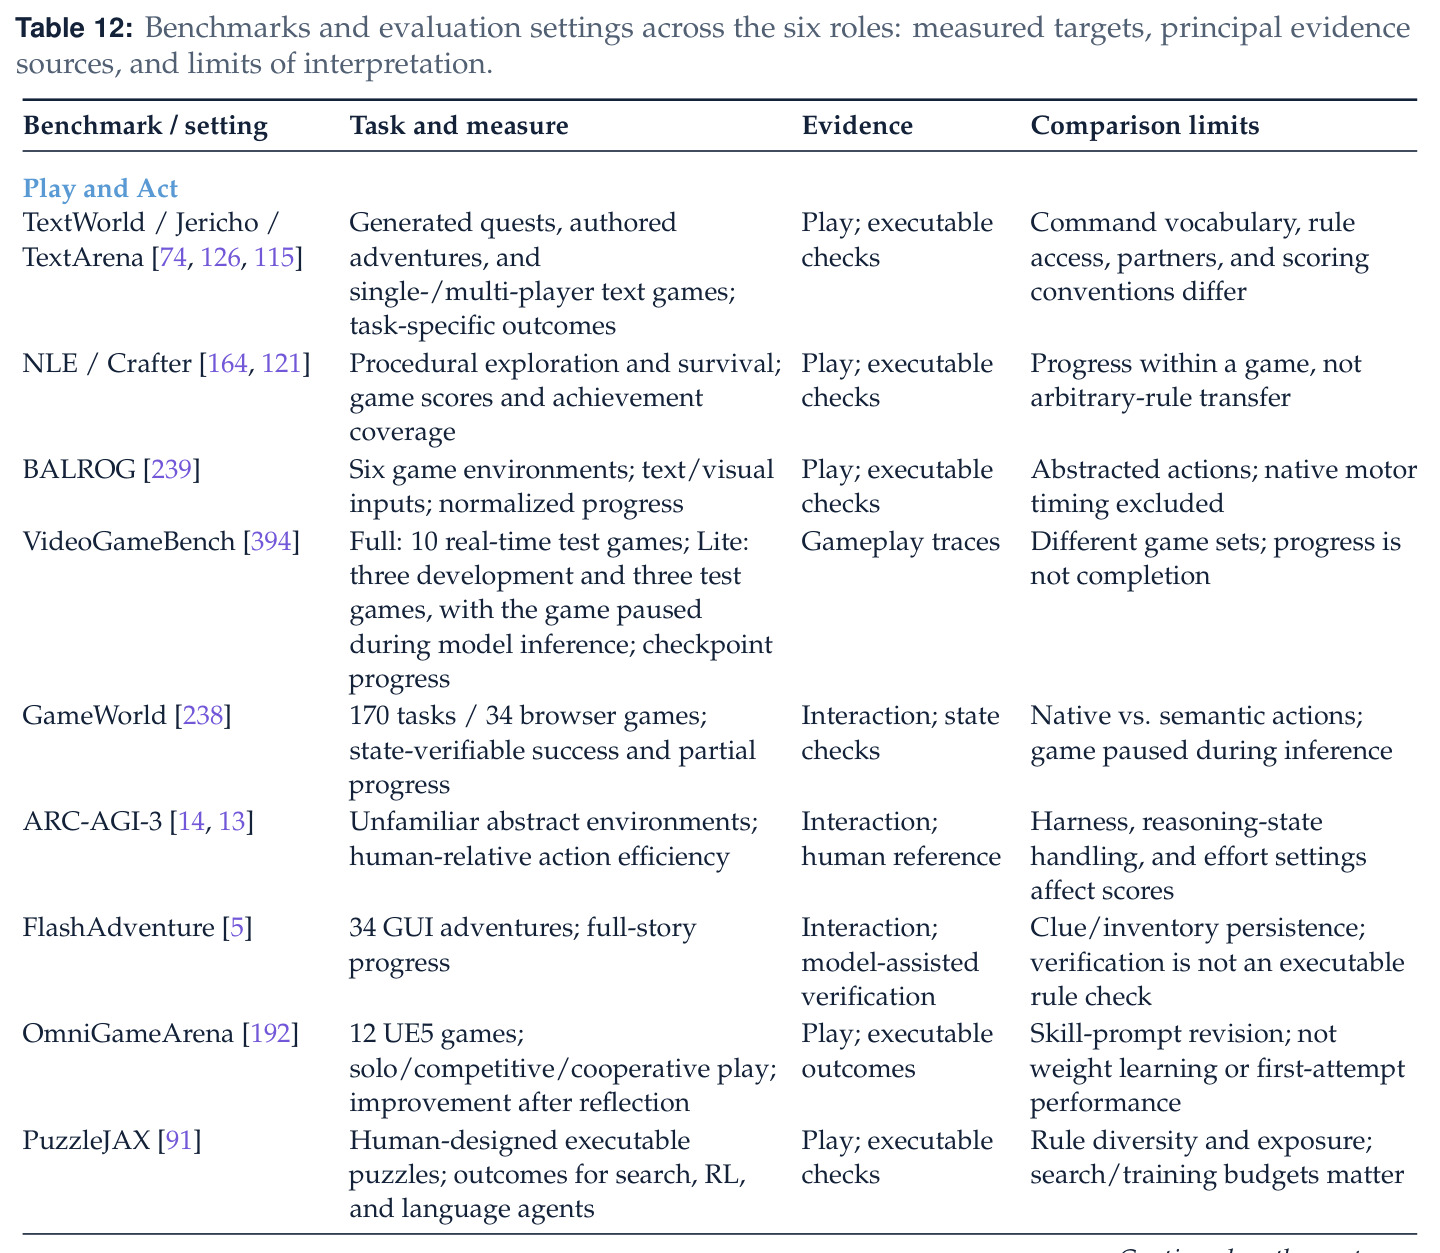
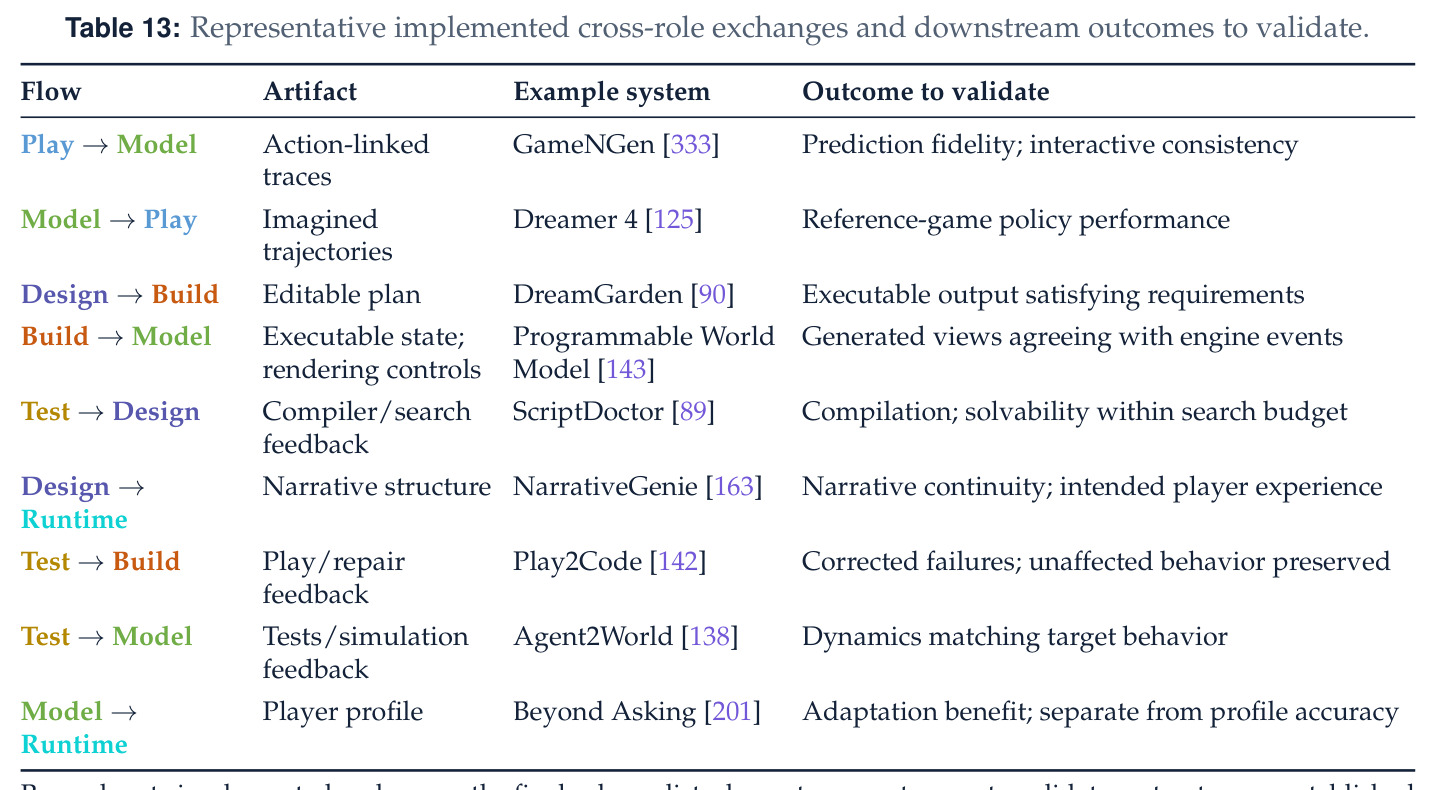
直觉上,一项工作属于哪个角色取决于它的产出物被拿去做什么,而不是它用了什么模型。技术路线分六步:第一,定义角色边界与主次角色分配规则——以经验主张所依赖的输出定主角色(NPC 策略主张动作协调归 Play,会话内对话主张玩家体验影响归 Runtime;MarioGPT 生成关卡内容归 Design,Play2Code 实现并修复软件归 Build);第二,每个角色内部按子方向梳理文献,例如 Play 分为专用到通用智能体、学习与控制层级、测试时适应与记忆、对手队友与 NPC 四支;第三,对每个系统比较“游戏/工作流提供的结构”与“AI 学习、生成、预测或修改的内容”之间的分工;第四,汇总六个角色的基准与评测设置(Table 12 的证据地图),并给出五维比较框架:标准化、执行落地、范围与迁移、时域与修订、外部校验;第五,提炼九种已实现的跨角色制品流动(Table 13);第六,归纳六大开放挑战并给出可检验的进展标准。
核心创新是把“制品复用”与“能力迁移”严格切开:复用指一个可识别的输出(轨迹、规格、模型、反馈信号)被另一任务消费;迁移指在更换游戏、引擎、接口、玩家群体或任务后能力仍然成立。共享一个预训练骨干或组件间通信成功,本身都不构成迁移证据——迁移主张必须指明什么变了,并测试相关能力是否幸存。例如 GameNGen 消费动作关联轨迹训练模拟器,Play2Code 消费对失败交互的观察来修复代码,两者都在“复用玩法”,但接收方需要的信息(动作语义、状态、需求)完全不同;一个搜索轨迹只在关联的规则和搜索条件下证明解有效,对游戏做任意修改后即失效。这个“传递可用记录而非标签、传递条件而非无限制判定”的原则,是全文最有辨识度的分析工具。
方法步骤详情
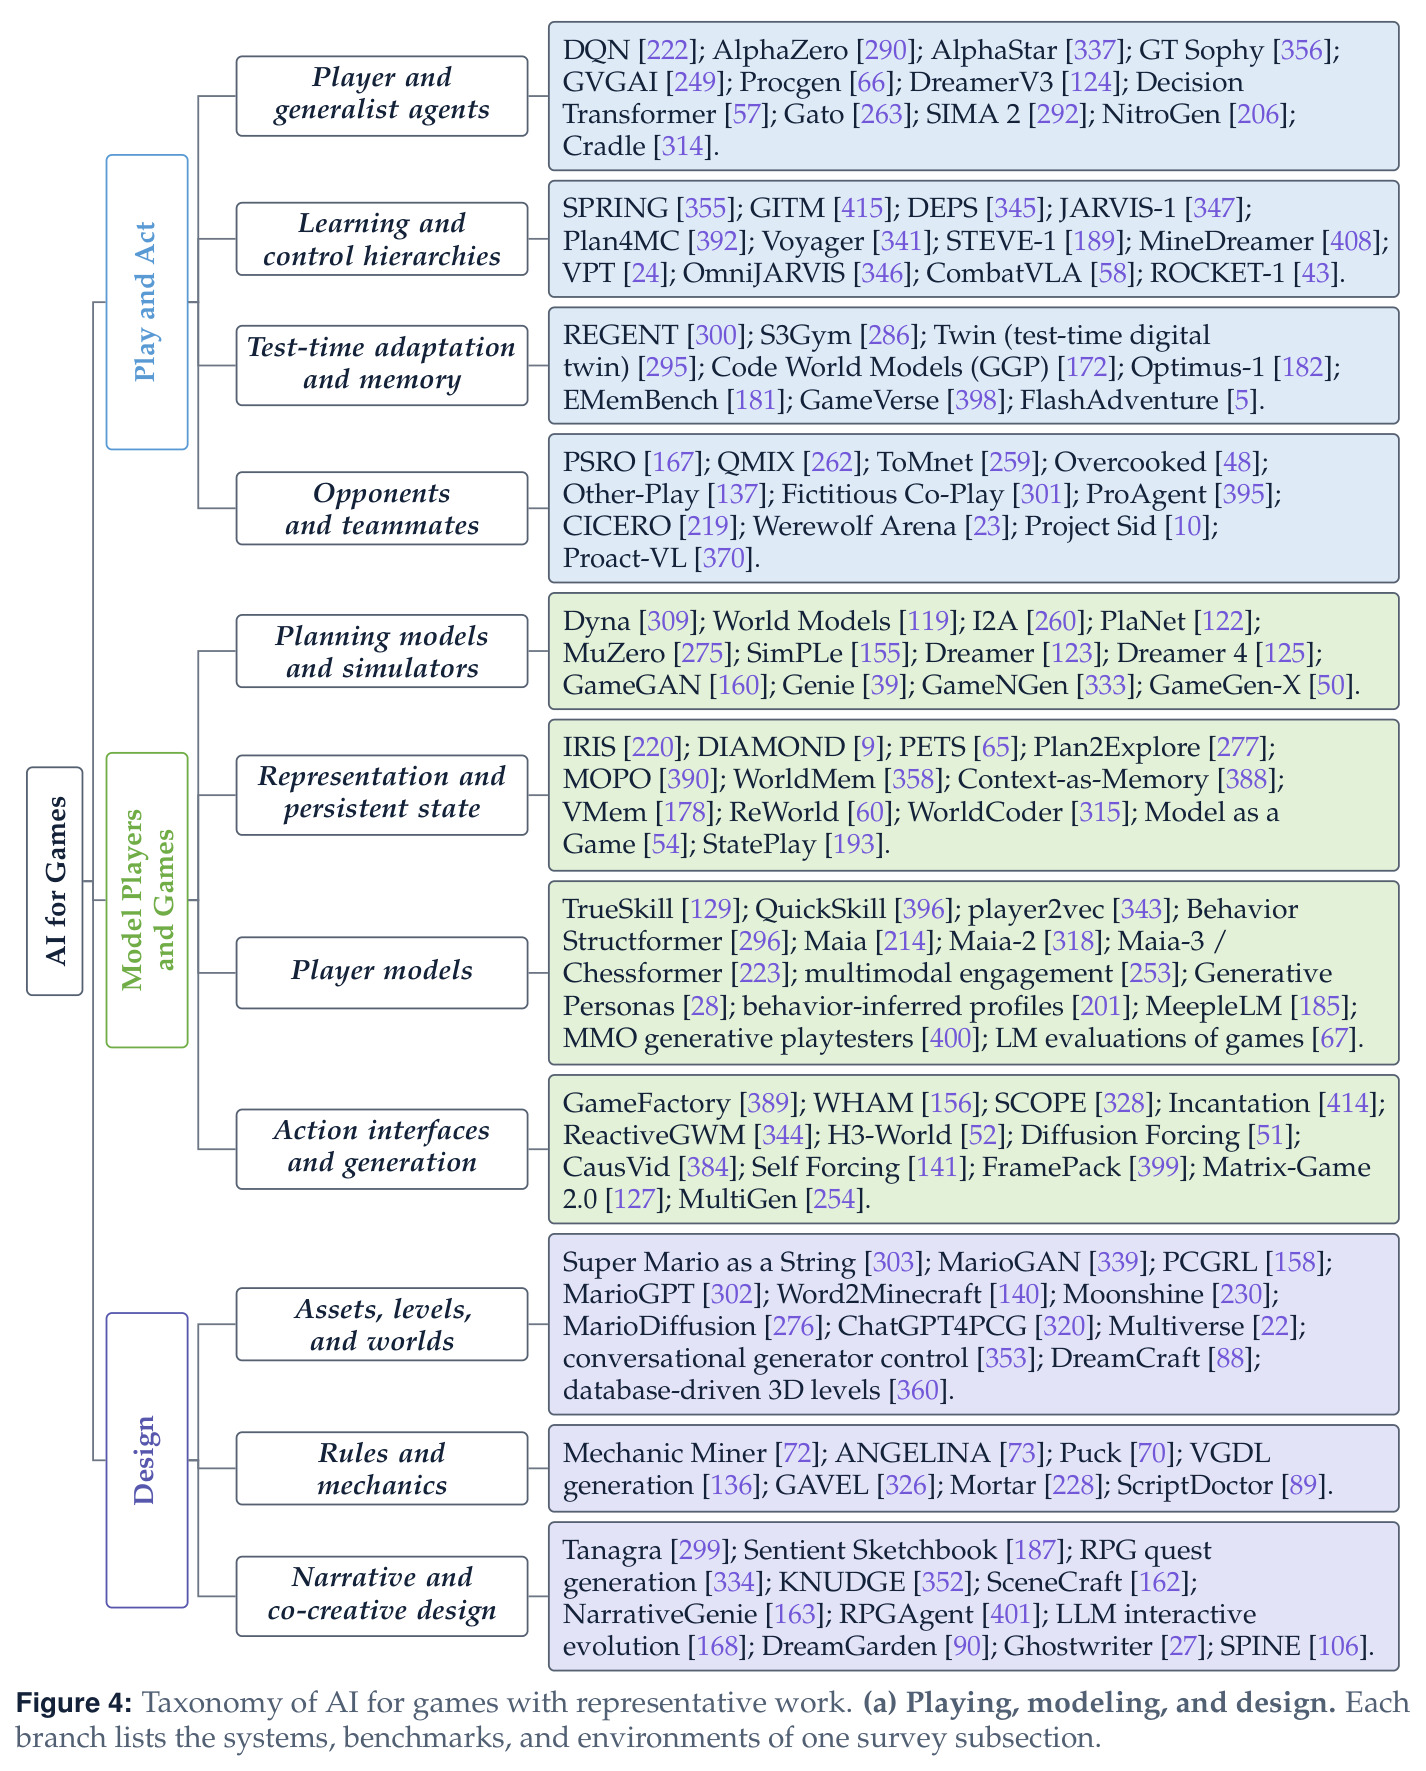
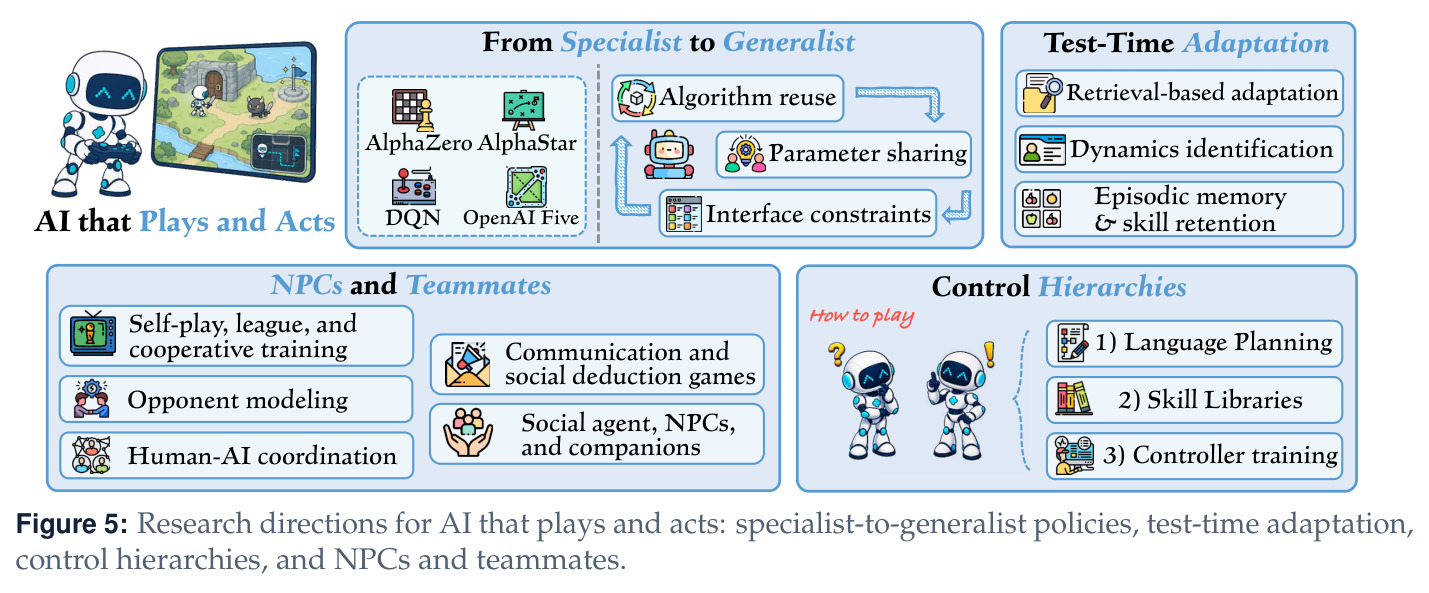
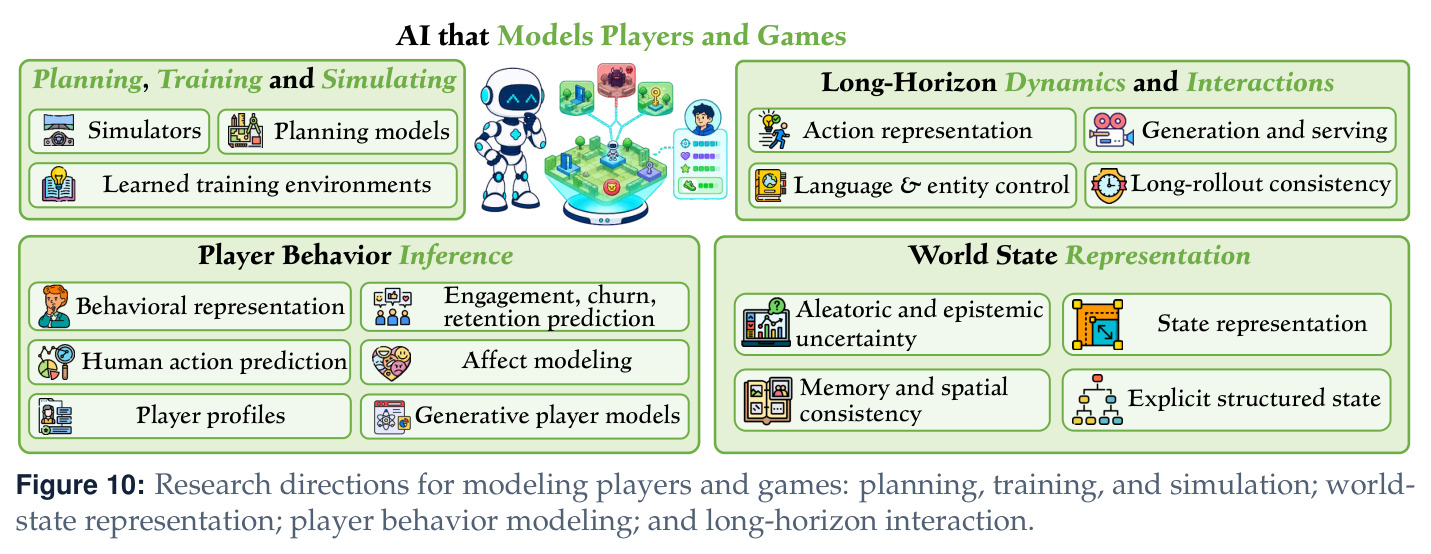
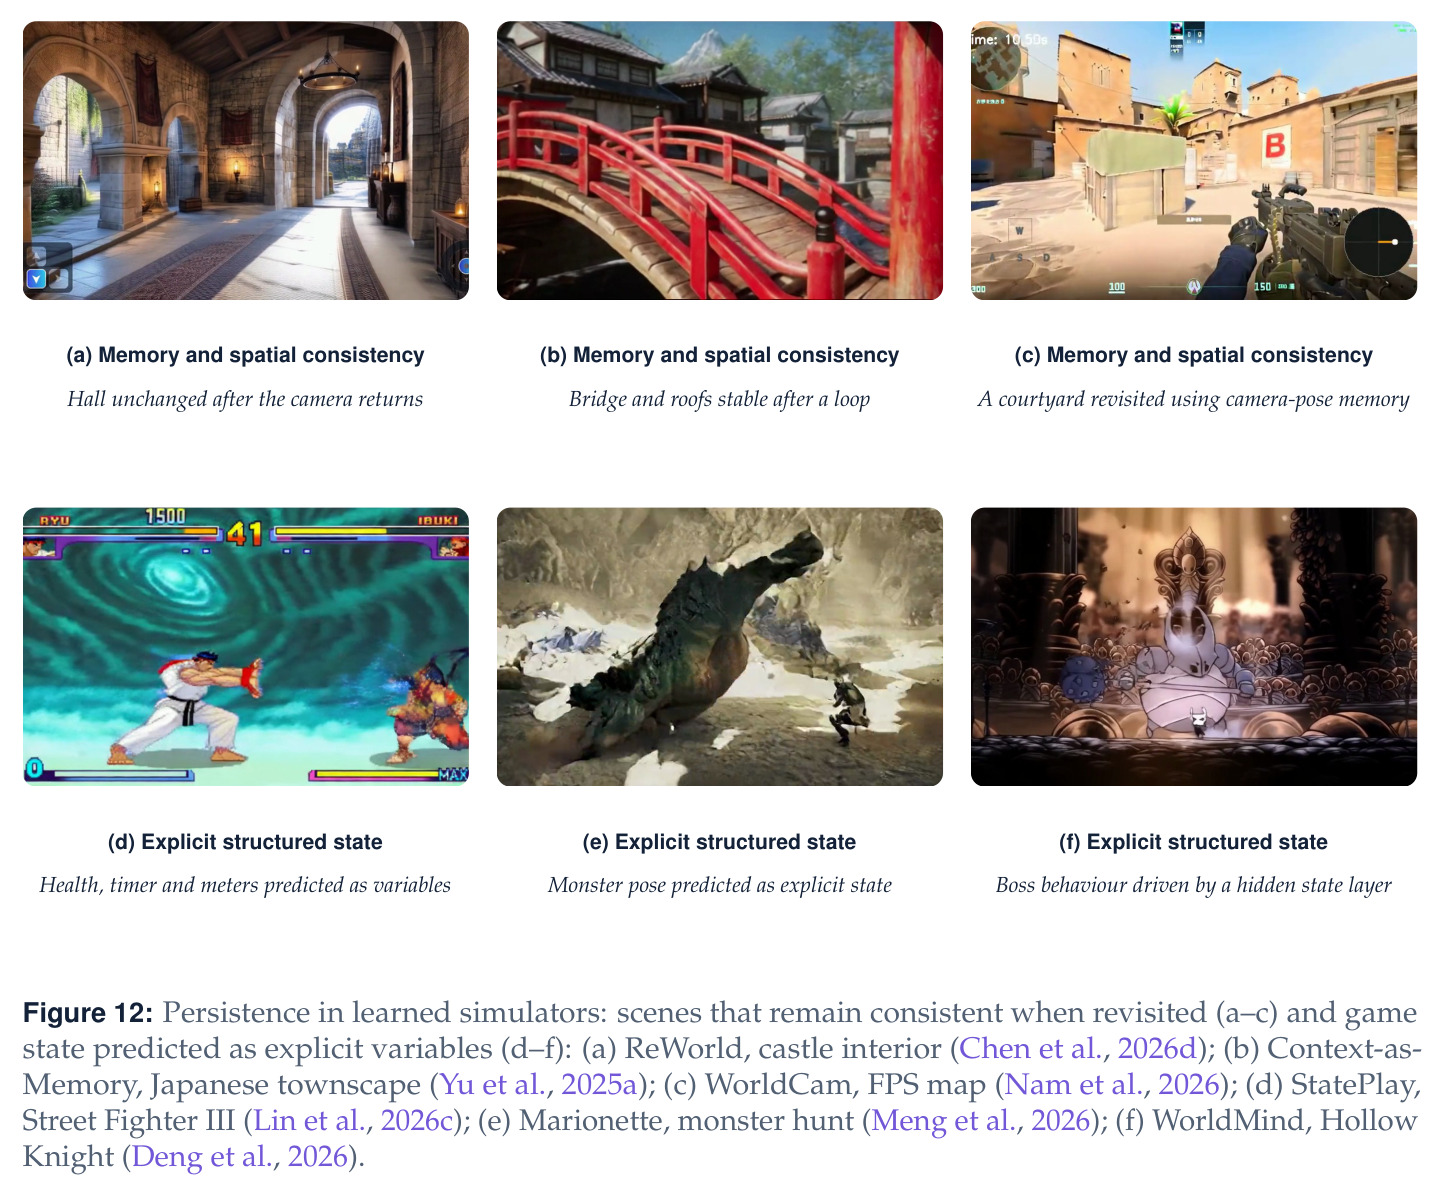
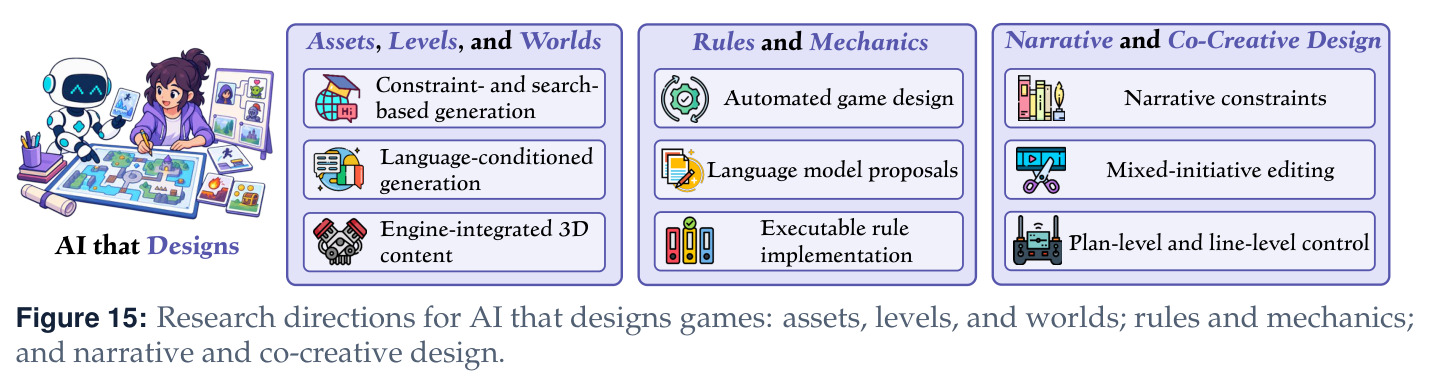
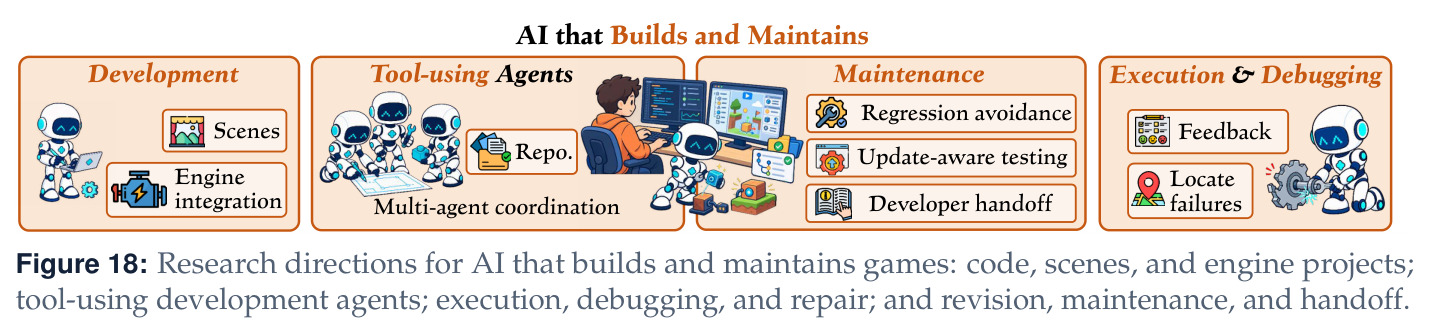
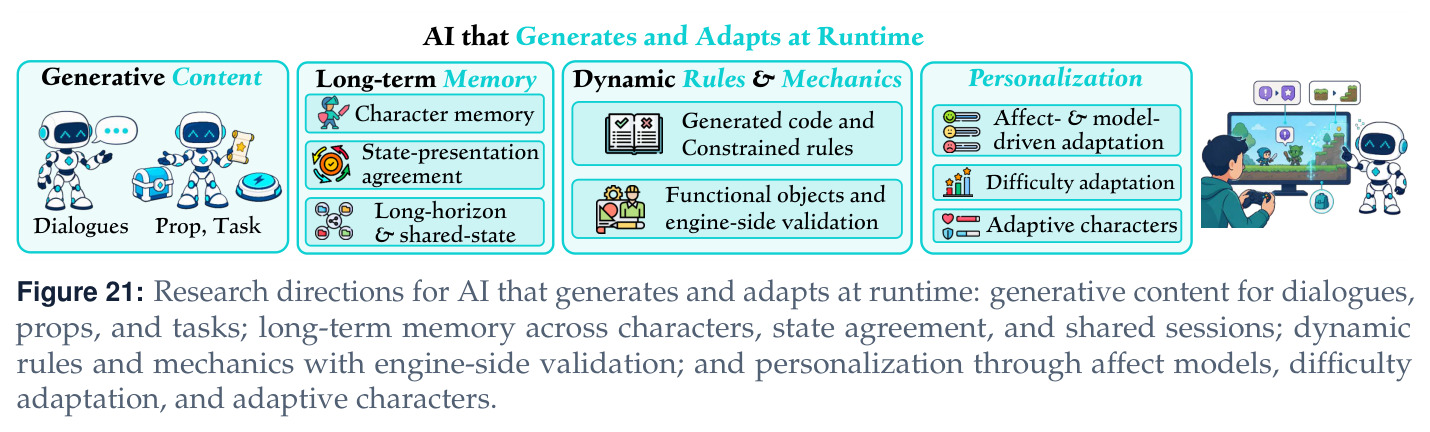
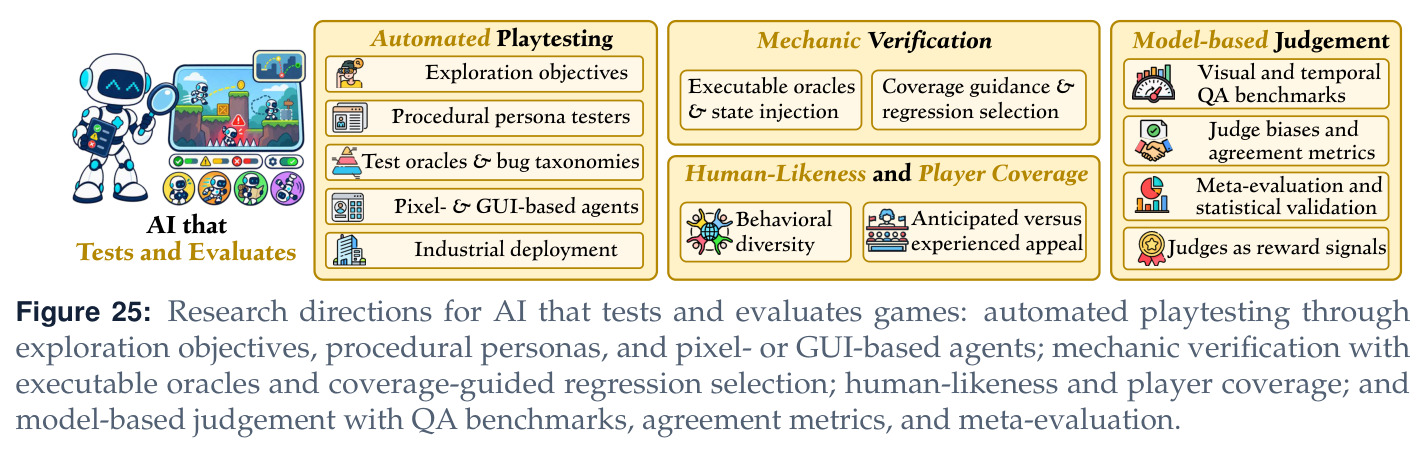
全文按角色展开六章技术综述加三章综合分析。第 3 章 Play and Act:从专用智能体(AlphaStar、OpenAI Five、GT Sophy)到算法复用(GVGAI、DreamerV3 单配置跑 150+ 任务)、控制层级(语言规划选目标、技能库提供程序、控制器管时机,如 Voyager、STEVE-1)、测试时适应(REGENT 检索示范、Twin 做实验推断规则)与人机协作(Other-Play、CICERO)。第 4 章 Modeling:规划模型/训练环境/交互模拟器(Dyna→Dreamer→GameNGen)、状态表示与持续记忆(StatePlay 预测数值变量、WorldMem 检索记忆帧、MASS 学习全局转移)、玩家建模(Maia4All 个体走子预测、Beyond Asking 合成特质恢复)、动作接口与长程一致性。第 5 章 Design:资产关卡(MarioGPT、Word2Minecraft)、规则机制(Mechanic Miner、GAVEL、Mortar)、叙事共创(DreamGarden 可编辑计划层级、Ghostwriter)。第 6 章 Build:引擎项目生成(GameDevBench 333 个 Godot 任务)、工具使用智能体(Play2Code 连接浏览器试玩者)、执行调试修复(GameEngineBench 隐藏运行时测试、GameXpert-Bench 六轮累积修订)。第 7 章 Runtime:生成角色与内容(LIGHT、Concordia、PUBG Ally)、动态规则(IF:CARGO 约束语言规则由引擎校验执行)、状态一致性与个性化部署。第 8 章 Test:自动试玩(程序化人格、好奇心驱动)、机制验证(GameGen-Verifier 状态注入)、模型裁判(VideoGameQA-Bench)、玩家代表性(人类轨迹相似度对比)。第 9–11 章比较证据、连接角色、提出挑战。
技术新颖性
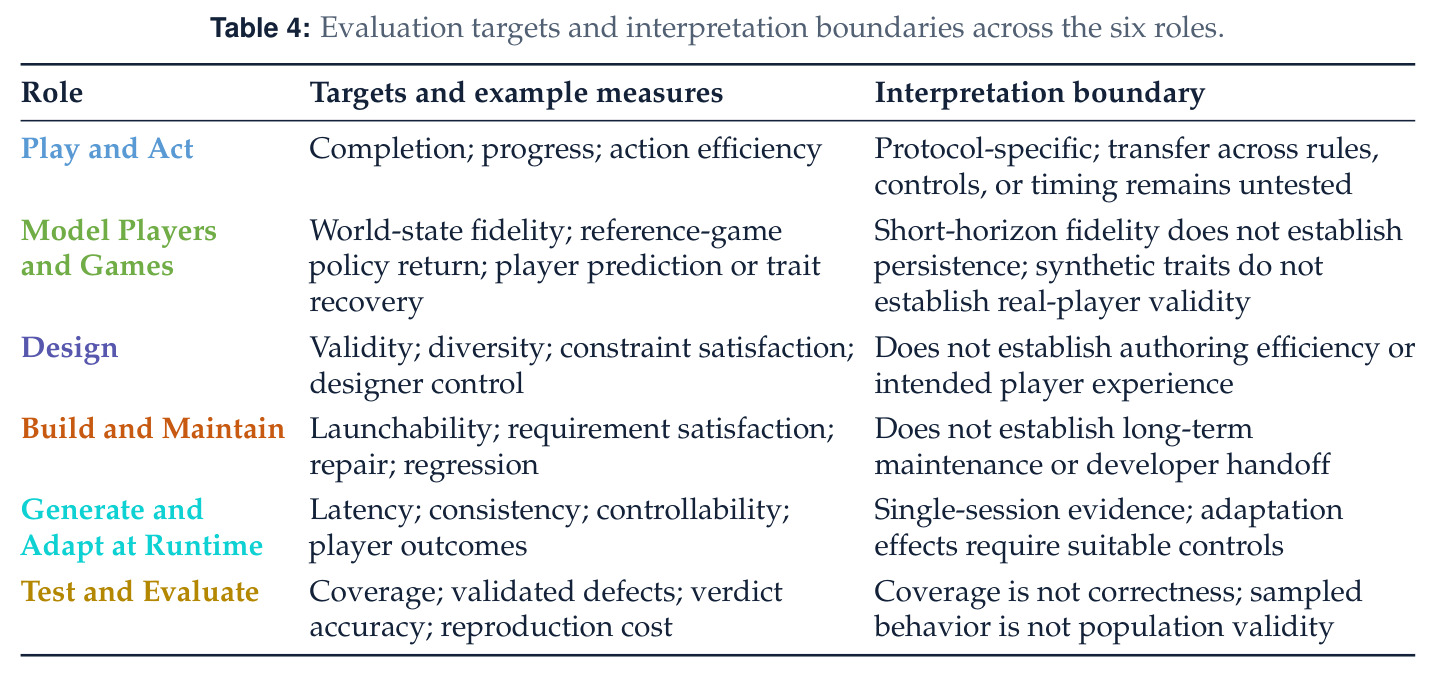
技术新颖性体现在四套分析工具。其一,map/mode/game 三级泛化设定(Table 11)加视觉表征/动作控制/规则推理三类迁移的分解,能把“跨游戏”这类含糊主张拆成可分别测试的组件。其二,世界模型保真度的三层目标(Table 7):感知质量(FVD 等视频分布指标)、机制正确性(健康值、资源、终结事件的参考状态误差)、持续状态(遮挡后重访、延迟事件的探针),并指出“动作跟随”跨层但都不充分——响应移动命令不等于碰撞或背包规则被遵守。其三,五维证据比较框架(标准化、执行落地、范围迁移、时域修订、外部校验)解释了为什么证据可以“标准化却狭窄、有执行落地却短时程、有人类参与却不独立”。其四,兼容性-使用-收益三问(输出是否保留接收方要求的格式与含义、接收方是否真的消费了它、相对合适基线是否改善了目标下游结果)用于审计每条跨角色连接,并给出“可执行灰盒 + 引擎管状态 + 状态条件化神经渲染管外观”的具体工作流设想,让视觉丰富度不必替规则执行背包袱。
实验结果
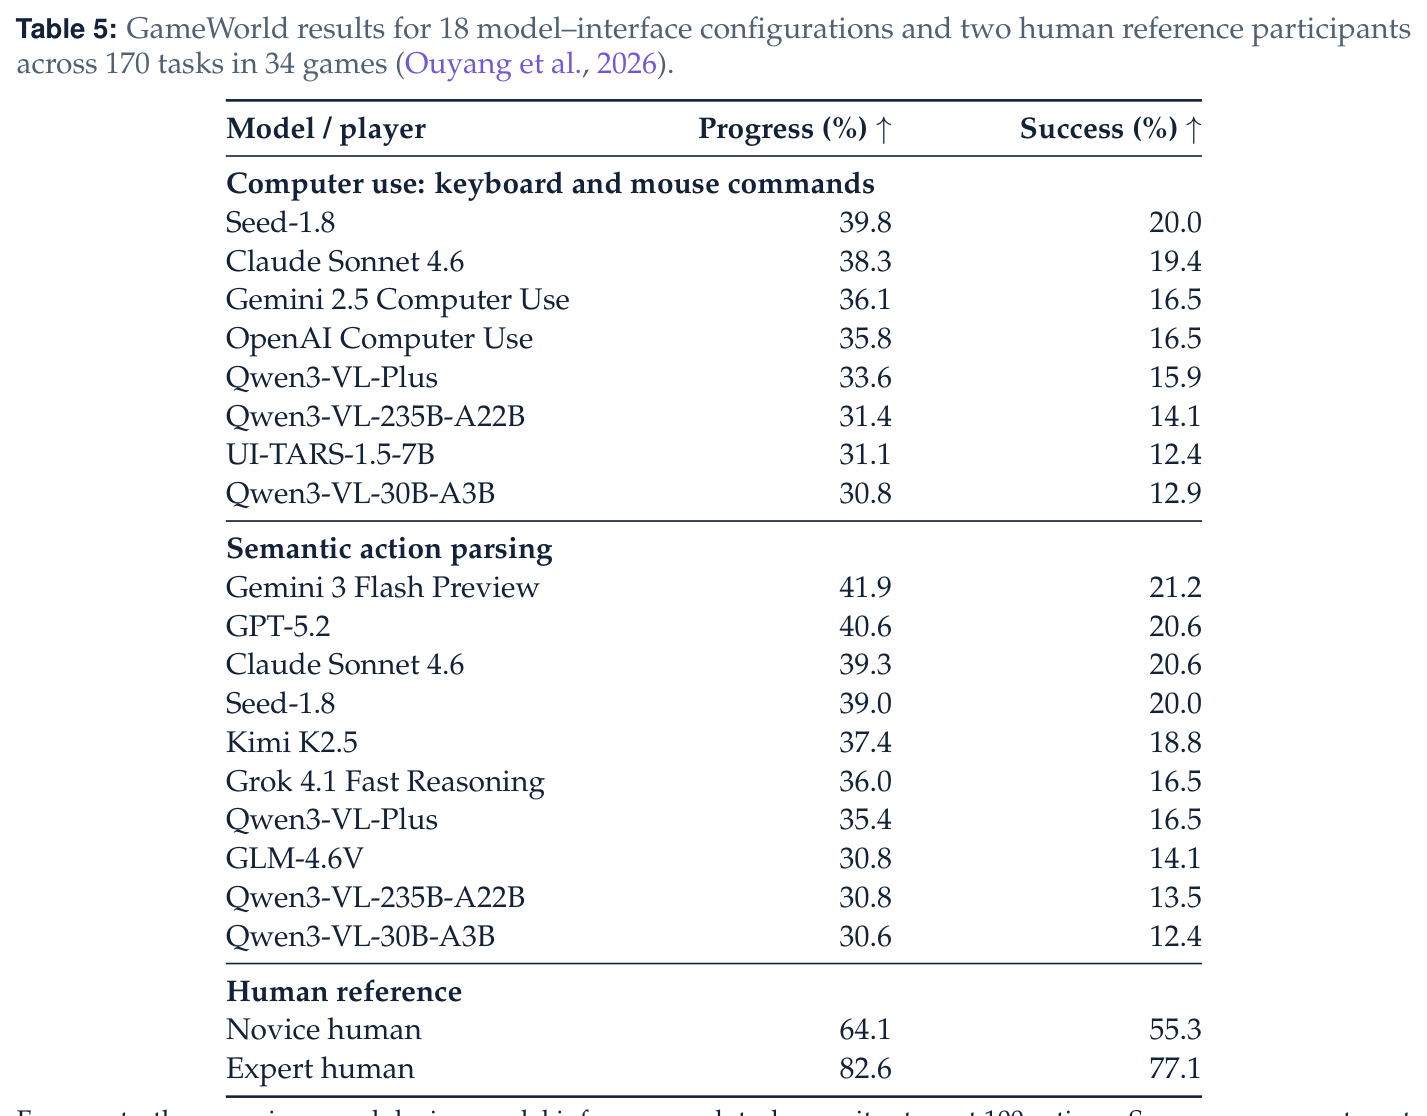
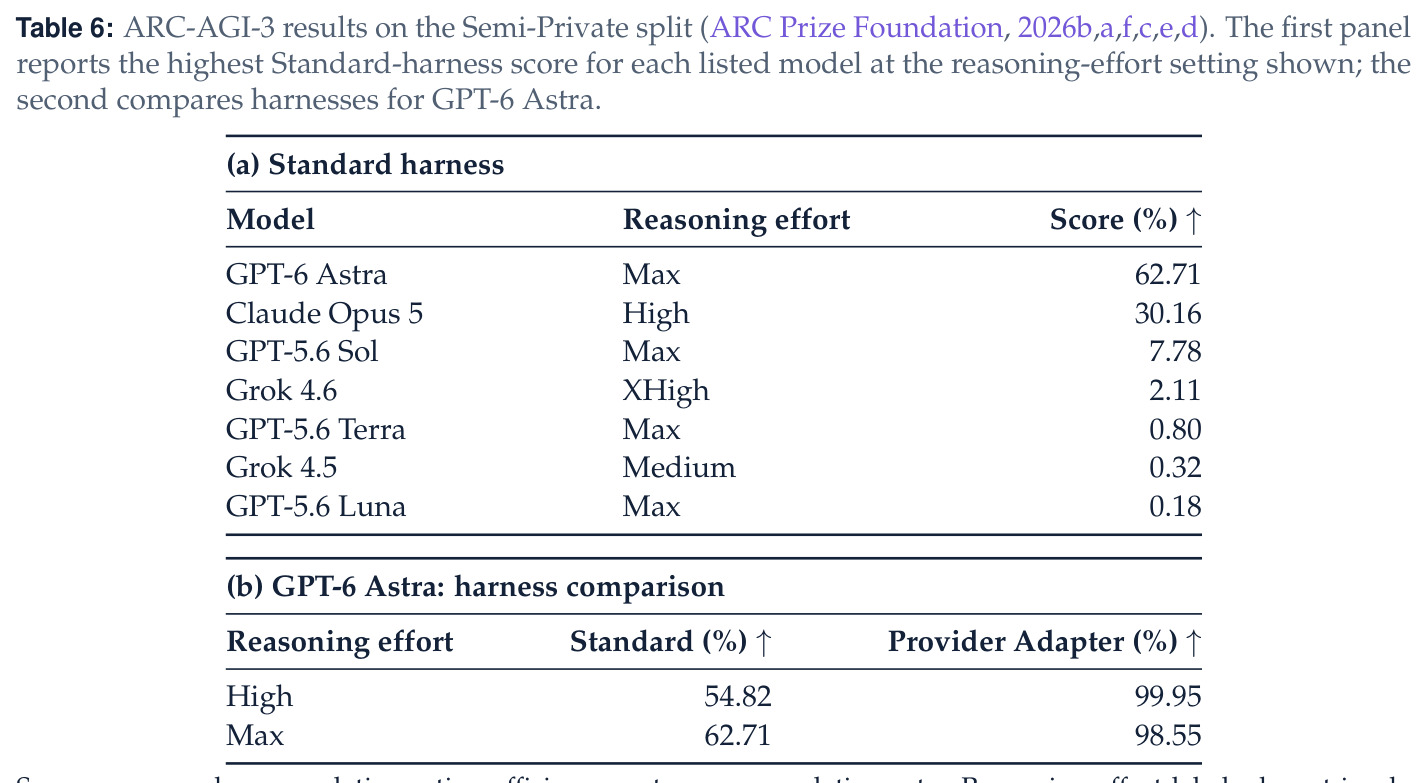
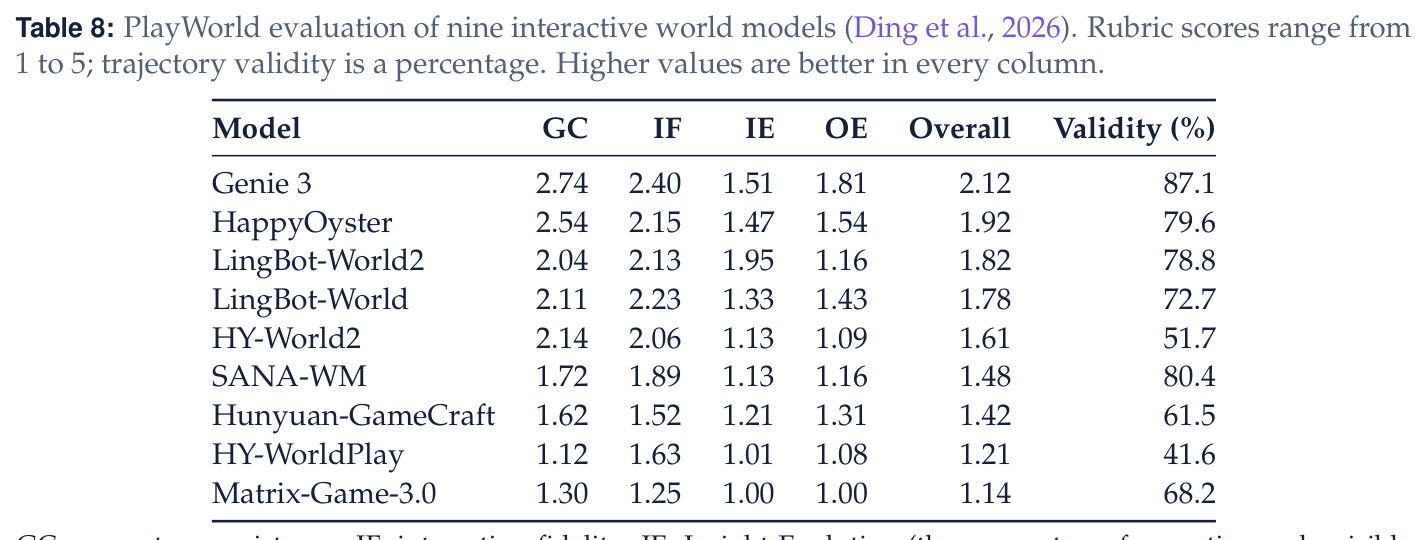
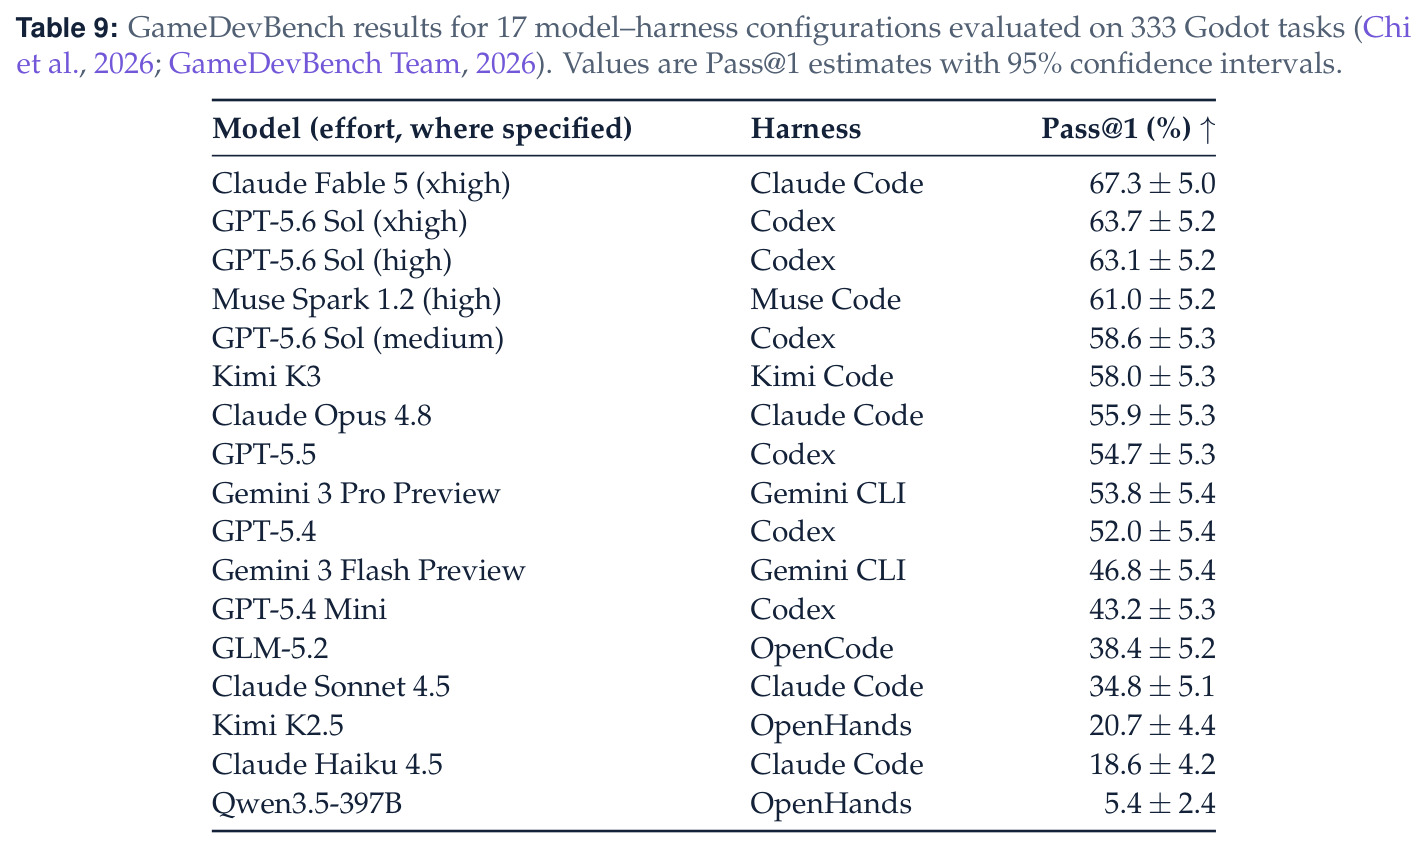
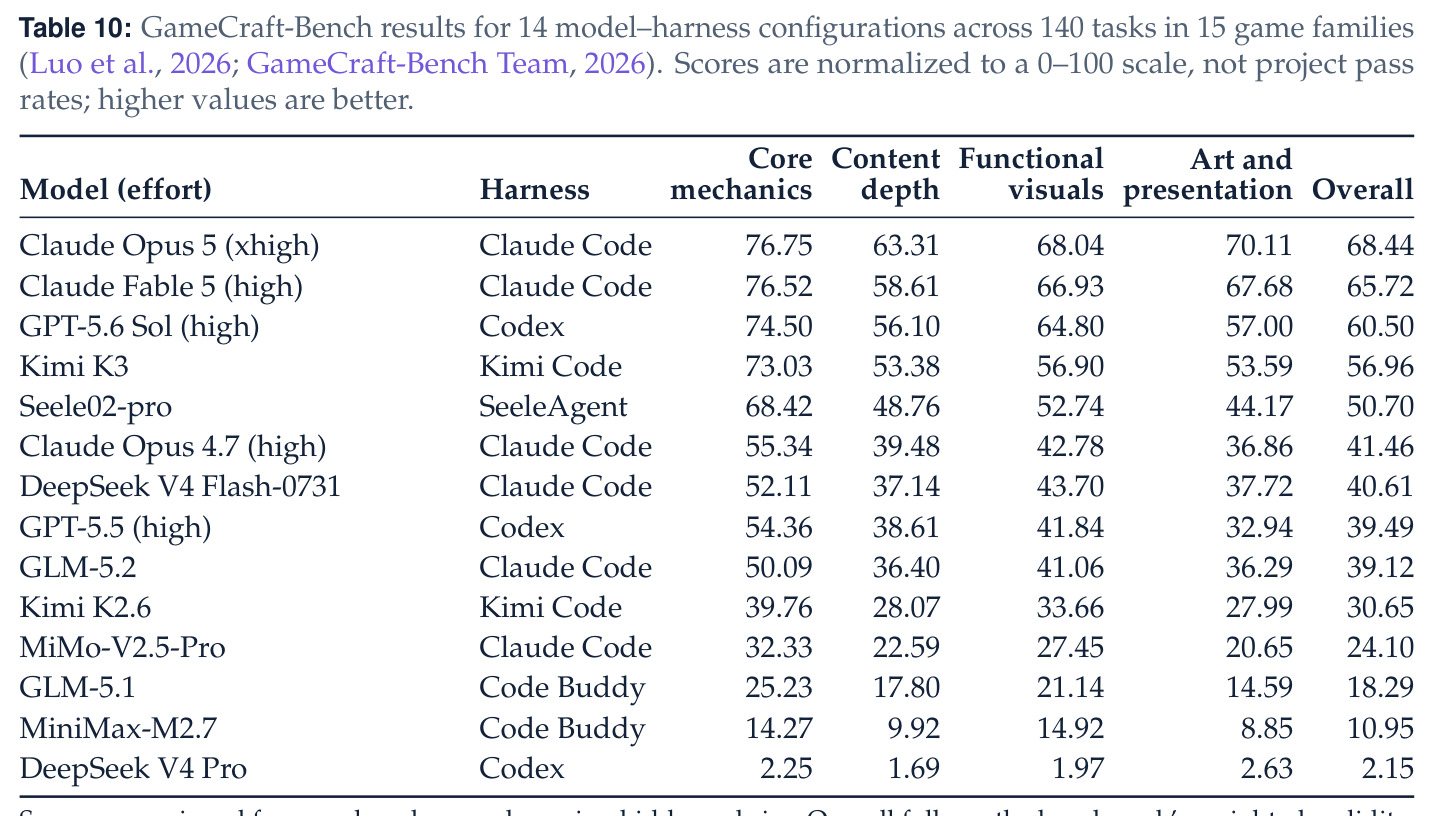
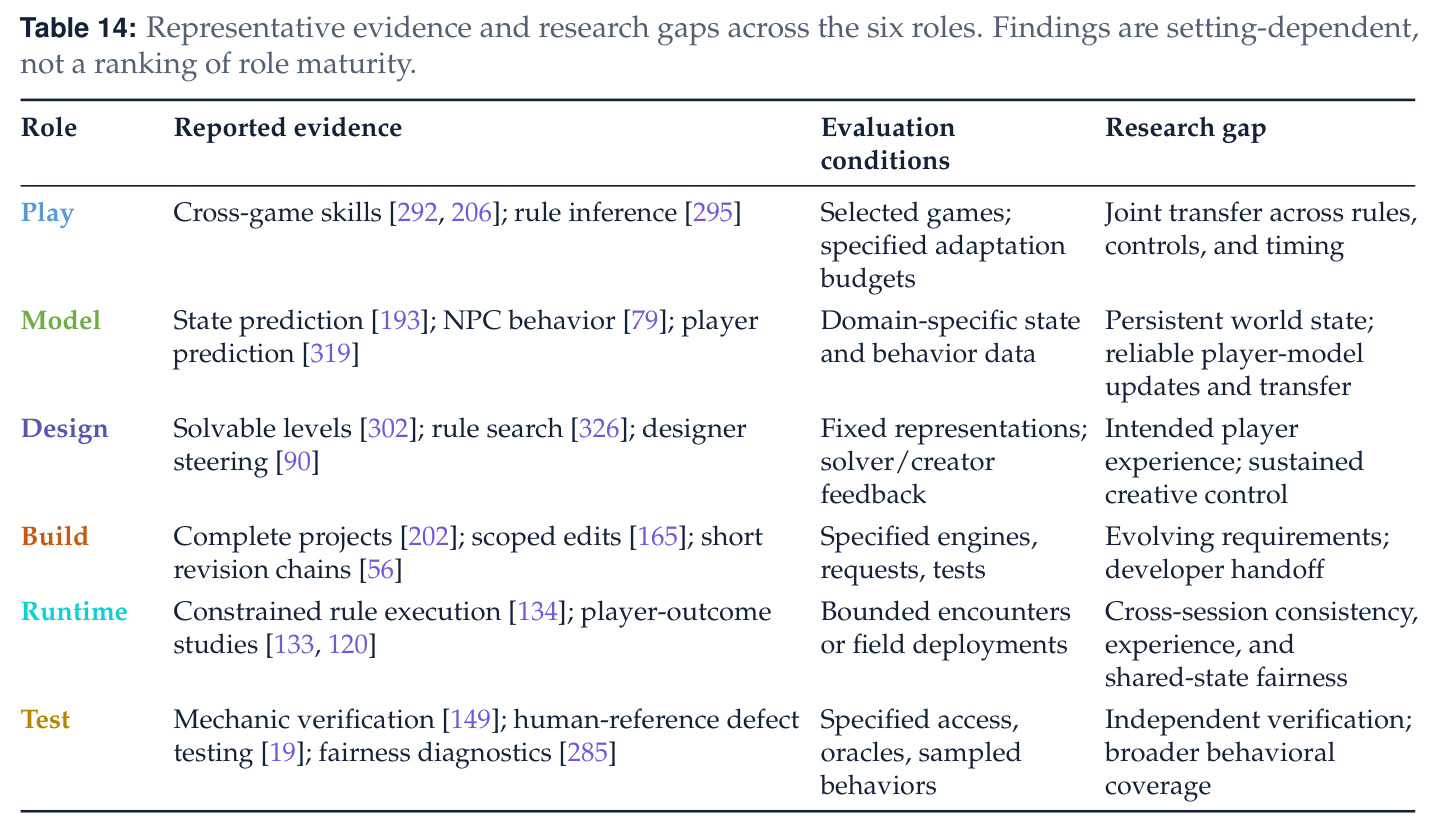
三个反复出现的发现贯穿全文。发现一:广泛预训练扩展了可用接口(语言、视觉、代码、工具),但未消除游戏特定结构——控制方案、规则、引擎接口、状态表示和玩家上下文往往仍是设置特定的;DreamerV3 单配置跑 150+ 任务是算法复用而非参数迁移。发现二:游戏玩法数据的价值日益超出智能体最终得分——轨迹可训练世界模型(GameNGen)、测试反馈可驱动修复(Play2Code)、搜索反馈可指导规则修订(ScriptDoctor)。发现三:进展仍是任务依赖的:有界对战和部分学习环境评测最标准化,而学习世界中的持续状态、软件的重复修订、玩家建模验证、长程运行时适应、代表性自动测试均不成熟。具体数据:GameWorld 在 34 款浏览器游戏 170 任务上,最佳配置 Gemini 3 Flash Preview(语义动作解析)成功率仅 21.2%、进度 41.9%,原生键鼠最佳 Seed-1.8 为 20.0%/39.8%,而人类新手 55.3%/64.1%、专家 77.1%/82.6%(每条件 $n=1$)——最强模型连新手都远不及,且换接口会改变模型排序。ARC-AGI-3 上 GPT-6 Astra Max 推理档 Standard harness 得 62.71%,Claude Opus 5 仅 30.16%,但同一 GPT-6 Astra 换 Provider Adapter harness 高推理档达 99.95%——测的是“配置后的系统”而非孤立模型。PlayWorld 九个交互世界模型中 Genie 3 轨迹有效率 87.1%、综合 rubric 仅 2.12/5,SANA-WM 有效率 80.4% 但两项进化得分接近垫底。GameDevBench 333 个 Godot 任务上 Pass@1 从 Claude Fable 5(xhigh)的 67.3±5.0% 到 Qwen3.5-397B 的 5.4±2.4%,跨度逾 60 个百分点。GameCraft-Bench 140 任务 15 游戏族上 Claude Opus 5(xhigh)总分 68.44,机制分 76.75 明显高于内容深度 63.31——生成项目更能实现可辨识规则而非足够的内容量。可编程世界模型在 CombatStateBench 50 段片段上数量准确率 94%、死亡状态准确率 98%,但死亡检查只验可见死亡角色、不验身份,支持的是粗粒度状态条件化渲染而非完整机制验证。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 有界游戏对战(GameWorld:34 款浏览器游戏、170 任务、每任务至多 100 动作、推理时暂停游戏) | 进度百分比 / 成功率 | 最佳模型配置 Gemini 3 Flash Preview(语义动作解析)41.9% / 21.2%;原生键鼠最佳 Seed-1.8 为 39.8% / 20.0% | 人类新手 64.1% / 55.3%,人类专家 82.6% / 77.1%(每条件 $n=1$ 的参考个案) | 最强模型成功率仍落后人类新手约 34 个百分点、落后专家约 56 个百分点;接口选择(语义解析 vs 原生键鼠)会改变模型间排序 |
| 陌生抽象规则环境探索(ARC-AGI-3 Semi-Private split,无自然语言指令) | 人类相对动作效率分(%) | GPT-6 Astra:Max 推理档 Standard harness 62.71%;高推理档 Provider Adapter harness 99.95% | Claude Opus 5(High)30.16%;GPT-5.6 Sol(Max)7.78%;Grok 4.5(Medium)0.32% | 换 harness 可带来 37–45 个百分点的波动(54.82→99.95),说明分数刻画的是配置后的交互系统而非模型本身 |
| 交互式世界模型评测(PlayWorld:九个模型、rubric 含几何一致性/交互保真/可见进化/不可见进化) | 轨迹有效率(%)与 1–5 分 rubric | Genie 3:有效率 87.1%、综合 2.12;LingBot-World2 可见进化 1.95 最高 | Matrix-Game-3.0:有效率 68.2%、综合 1.14;HY-WorldPlay 有效率仅 41.6% | 视觉质量领先的模型(Genie 3)进化维度仍只有 1.51,SANA-WM 有效率 80.4% 但进化得分接近最低——视觉保真与状态演化脱节 |
| 游戏开发(GameDevBench:333 个多模态 Godot 任务,17 个模型-harness 配置) | Pass@1(%,带 95% 置信区间) | Claude Fable 5(xhigh)+ Claude Code:67.3±5.0 | 最强开源侧 Qwen3.5-397B + OpenHands:5.4±2.4;Claude Haiku 4.5:18.6±4.2 | 顶配与最低配相差约 62 个百分点;视觉反馈消融显示“接口更丰富”不自动带来正确率提升,且增益因模型而异 |
| 完整游戏构建(GameCraft-Bench:140 任务、15 游戏族,隐藏 rubric 从回放打分,0–100 归一化) | 加权总分(带有效性门槛,非算术平均,亦非通过率) | Claude Opus 5(xhigh)+ Claude Code:总分 68.44(机制 76.75 / 内容深度 63.31 / 视觉 68.04 / 表现 70.11) | DeepSeek V4 Pro + Codex:2.15;MiniMax-M2.7:10.95 | 所有靠前配置机制分均高于内容深度分约 10–18 分:模型更能实现可辨识规则,而进度系统与内容体量不足 |
| 世界模型战斗机制状态检查(CombatStateBench,可编程世界模型) | 数量准确率 / 死亡状态准确率(50 段片段,VLM 检查生成帧) | 94% / 98% | 多数世界模型仅有 FVD 等感知指标或动作跟随率,无引擎对照的状态检查 | 支持粗粒度状态条件化渲染,但死亡检查接受任意可见死亡角色、不校验身份,不构成对战斗规则的完整验证 |
局限与改进
作者明确承认的局限贯穿第 9 章:证据高度设置依赖,跨角色的下游能力主张必须在其目标设置中重新验证;GameWorld 的人类参考每条件只有 1 名被试($n=1$),是示意性参照而非总体估计;GameCraft-Bench 各行未报告置信区间,与带区间的 GameDevBench 不可直接比较;ARC-AGI-3 的推理档位标签不代表跨模型算力对齐;总分聚合(加权+有效性门槛)与通过率、rubric 均分是不同量。我自己的观察:第一,这是 2026 年 9 月的快照,大量结论锚定在快速迭代的闭源 API 模型(GPT-6 Astra、Claude Fable 5、Gemini 3 等)的具体版本上,排行榜式数字会迅速过时,但框架性结论更持久;第二,作为定性综合,作者自述不对所有可能的跨角色连接做流行度或成熟度排序,读者得不到“哪条连接最值得投入”的量化指引;第三,许多基准缺少完整规则 oracle(Table 12 的对比限制栏反复出现),状态检查多为抽样或模型裁判,机制级验证的覆盖面有限;第四,作者提出的“灰盒+生成渲染”生产级工作流尚无 UE/Unity 实现验证,属于设想而非结果。
独立分析的弱点
弱点一:评测鸿沟——Design、Runtime、Test 三个角色的研究普遍样本小、协议各异、缺少统计区间(作者引 Agarwal et al. 2021 指出小样本 RL 点估计会支撑不稳定结论),导致跨研究比较近乎不可能;改进方向是预注册评测协议、采用 IQM 等稳健聚合、统一报告重试与选择预算。弱点二:人类验证薄弱——$n=1$ 的人类参考、合成特质恢复(Beyond Asking)和小样本共创研究不能替代真实玩家总体的验证;个性化 PCG 研究中对照组初始关卡生成策略就不同(Hafnar & Demšar 2025),混淆了基线与干预;改进方向是更大规模、跨技能层的纵向玩家研究,并把画像推断、内容生成、适应策略三者用受控实验拆开。弱点三:反馈回路盲区——模型裁判有自偏好,对着不完美验证器优化会产生 reward hacking;GameGen-Verifier 的状态注入绕过了普通可达路径,Play2Code 受限于试玩者到过的状态,两者单独使用都会留下系统性缺陷;改进方向是保留合法复现轨迹、持有缺陷族重测、独立执行检查,把“反馈分数”与“真实修复”分开度量。弱点四:持续世界状态缺乏公认测试——单视角不间断视频指标发现不了重访矛盾,改进方向是 save–restore 与同步视角探针成为标准组件。弱点五:维护与交接几乎无基准覆盖——多版本回归、依赖变更、非作者开发者的失败复现与需求实现没有对应测试集,改进方向是多版本基准加交接任务计时与错误编辑统计。弱点六:多人共享状态下的个性化公平(FAIRGAMER 式差异)只有诊断性研究,缺纵向公平性度量。
未来方向
作者按角色提出六个方向:Play——跨接口与规则的联合迁移,用 map/mode/game 因子化测试分离可迁移组件,并把可执行规则获取(Code World Models、Twin)接到实时控制上,以规则不确定性决定何时再做一个实验;Model——把生成观察与选择性显式可更新状态耦合,确定哪些变量错误会改变后续决策、动作如何更新它们、存储状态与生成观察冲突时如何裁决,并用重访/变异探针与 save–restore 测试;Design——把硬约束与可修订偏好分离、保留多样可玩备选、让局部编辑不悄悄抹掉无关设计决定,沿真实修订过程评测设计师控制;Build——版本感知的项目记忆(保留已接受需求、依赖链接、可复现测试),修复智能体同时提出补丁与预期行为效果,接受测试与实现权限分离;Runtime——把不确定预测转为可逆干预,保留已确认任务事实、已推断偏好与玩家接受/拒绝记录,支持回滚与玩家可见控制;Test——互补探索策略配独立 oracle,昂贵的人工/视觉检查留给不确定且后果重大的情形。基于这些成果可延伸的方向包括:完整的“代码智能体建灰盒→引擎执行状态→状态条件化视频模型渲染外观”生产引擎工作流及其三路对比评测;不确定性感知的规则学习混合智能体;跨角色统一追踪(同一轨迹同时评估预测保真、策略收益与测试覆盖);以及玩家可查看、可更正画像的开放玩家建模接口。
复现评估
作为综述,其“复现”分两层。复现结论本身很容易:论文配套公开项目主页与 GitHub 仓库(awesome-ai-for-games),Appendix A 的系统索引记录了每个系统的主要/次要角色,引用链条完整,适合按图索骥。复现其中引用的实验则参差不齐:顶级对战与对战基准结果大量依赖闭源 API 模型与私有评测(GPT-6 Astra、Claude Fable 5 的具体版本、ARC-AGI-3 Semi-Private split、商业游戏如 Gran Turismo 的内部接入),外部研究者难以严格复现;而 Godot/Craftax 生态的开源基准(GameDevBench 333 任务、Crafter、NetHack、PuzzleJAX 数百个人工设计谜题、TextWorld/Jericho)可行性高,单卡或纯 API 推理即可起步(GameWorld 每任务至多 100 次动作调用)。世界模型训练(Dreamer 级别)与 AlphaStar 级大规模自对弈则需数个量级以上的算力。值得注意的是作者在第 9.3.4 节给出了一套可复现性报告规范——模型与引擎版本、提示词、观察/动作接口、工具权限、随机化设置、重试或选择预算、数据来源与访问条件、无法开源组件的接口文档——这本身可以作为游戏AI论文的写作清单使用。总体难度:理解与使用该综述为入门级,复现具体 SOTA 结果为中等至高,取决于所选角色。
论文图表
由多块游戏画面瓷砖拼成的封面图,覆盖商业游戏、开源游戏、研究环境和生成式游戏系统,直观呈现综述涉及的研究对象范围。
一眼看清综述覆盖的游戏类型与环境谱系,建立读者对“游戏AI”具体所指的直观认识。
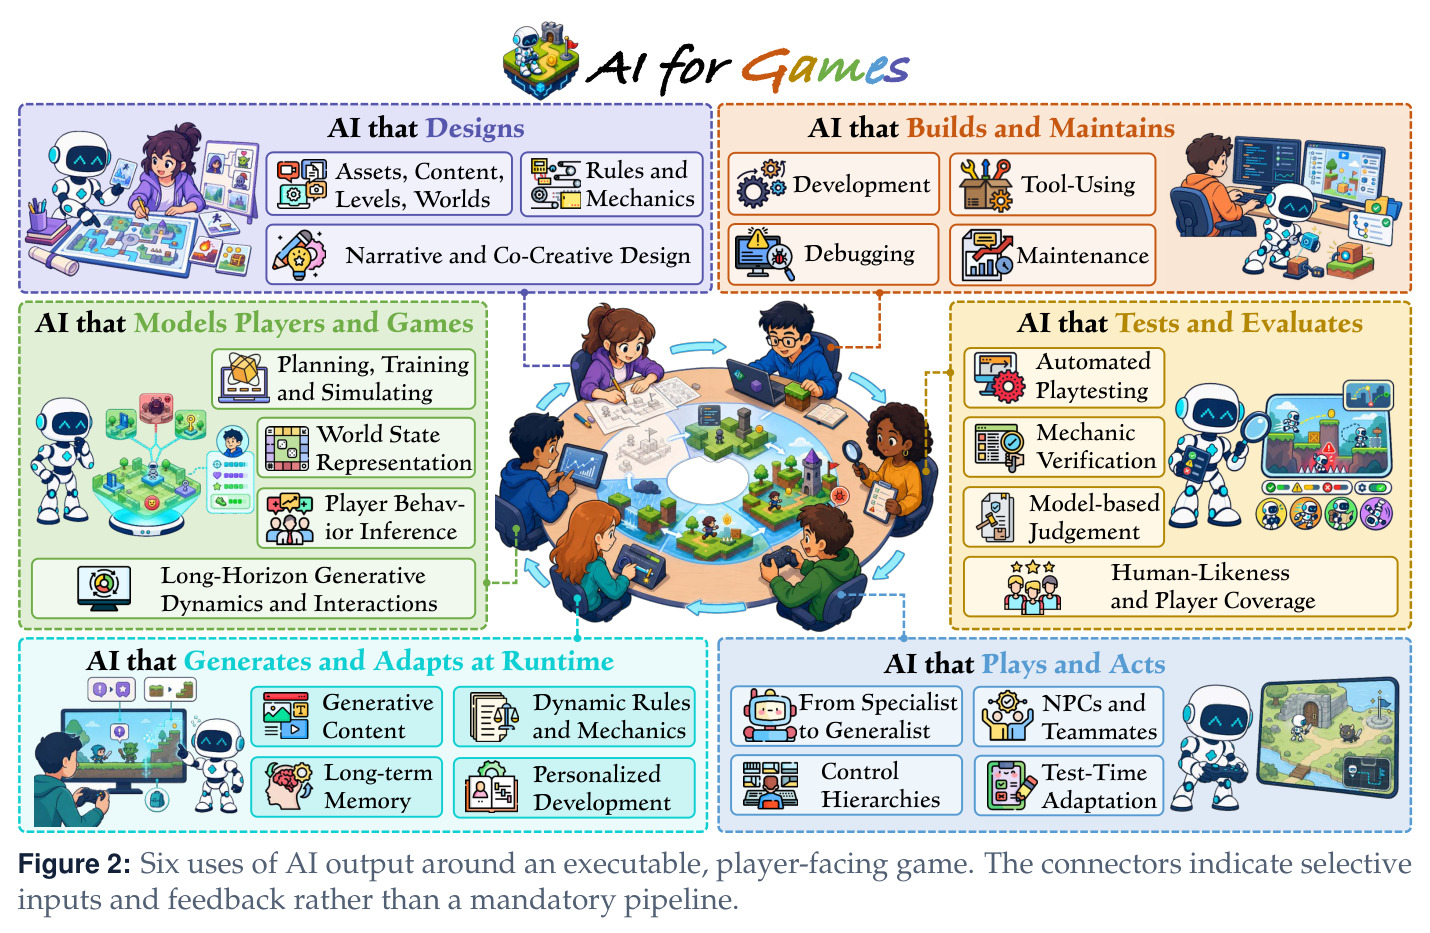
以一个可执行、面向玩家的游戏为中心,画出六大角色的子方向布局(如 Designs 的资产/规则/叙事,Builds 的开发/调试/维护,Plays 的智能体/NPC/测试时适应等),连接线表示选择性的输入与反馈而非强制流水线。
这是全文组织框架的一图总览:六个角色、每个角色的子方向、以及角色间的选择性数据流,理解了它就掌握了综述的骨架。
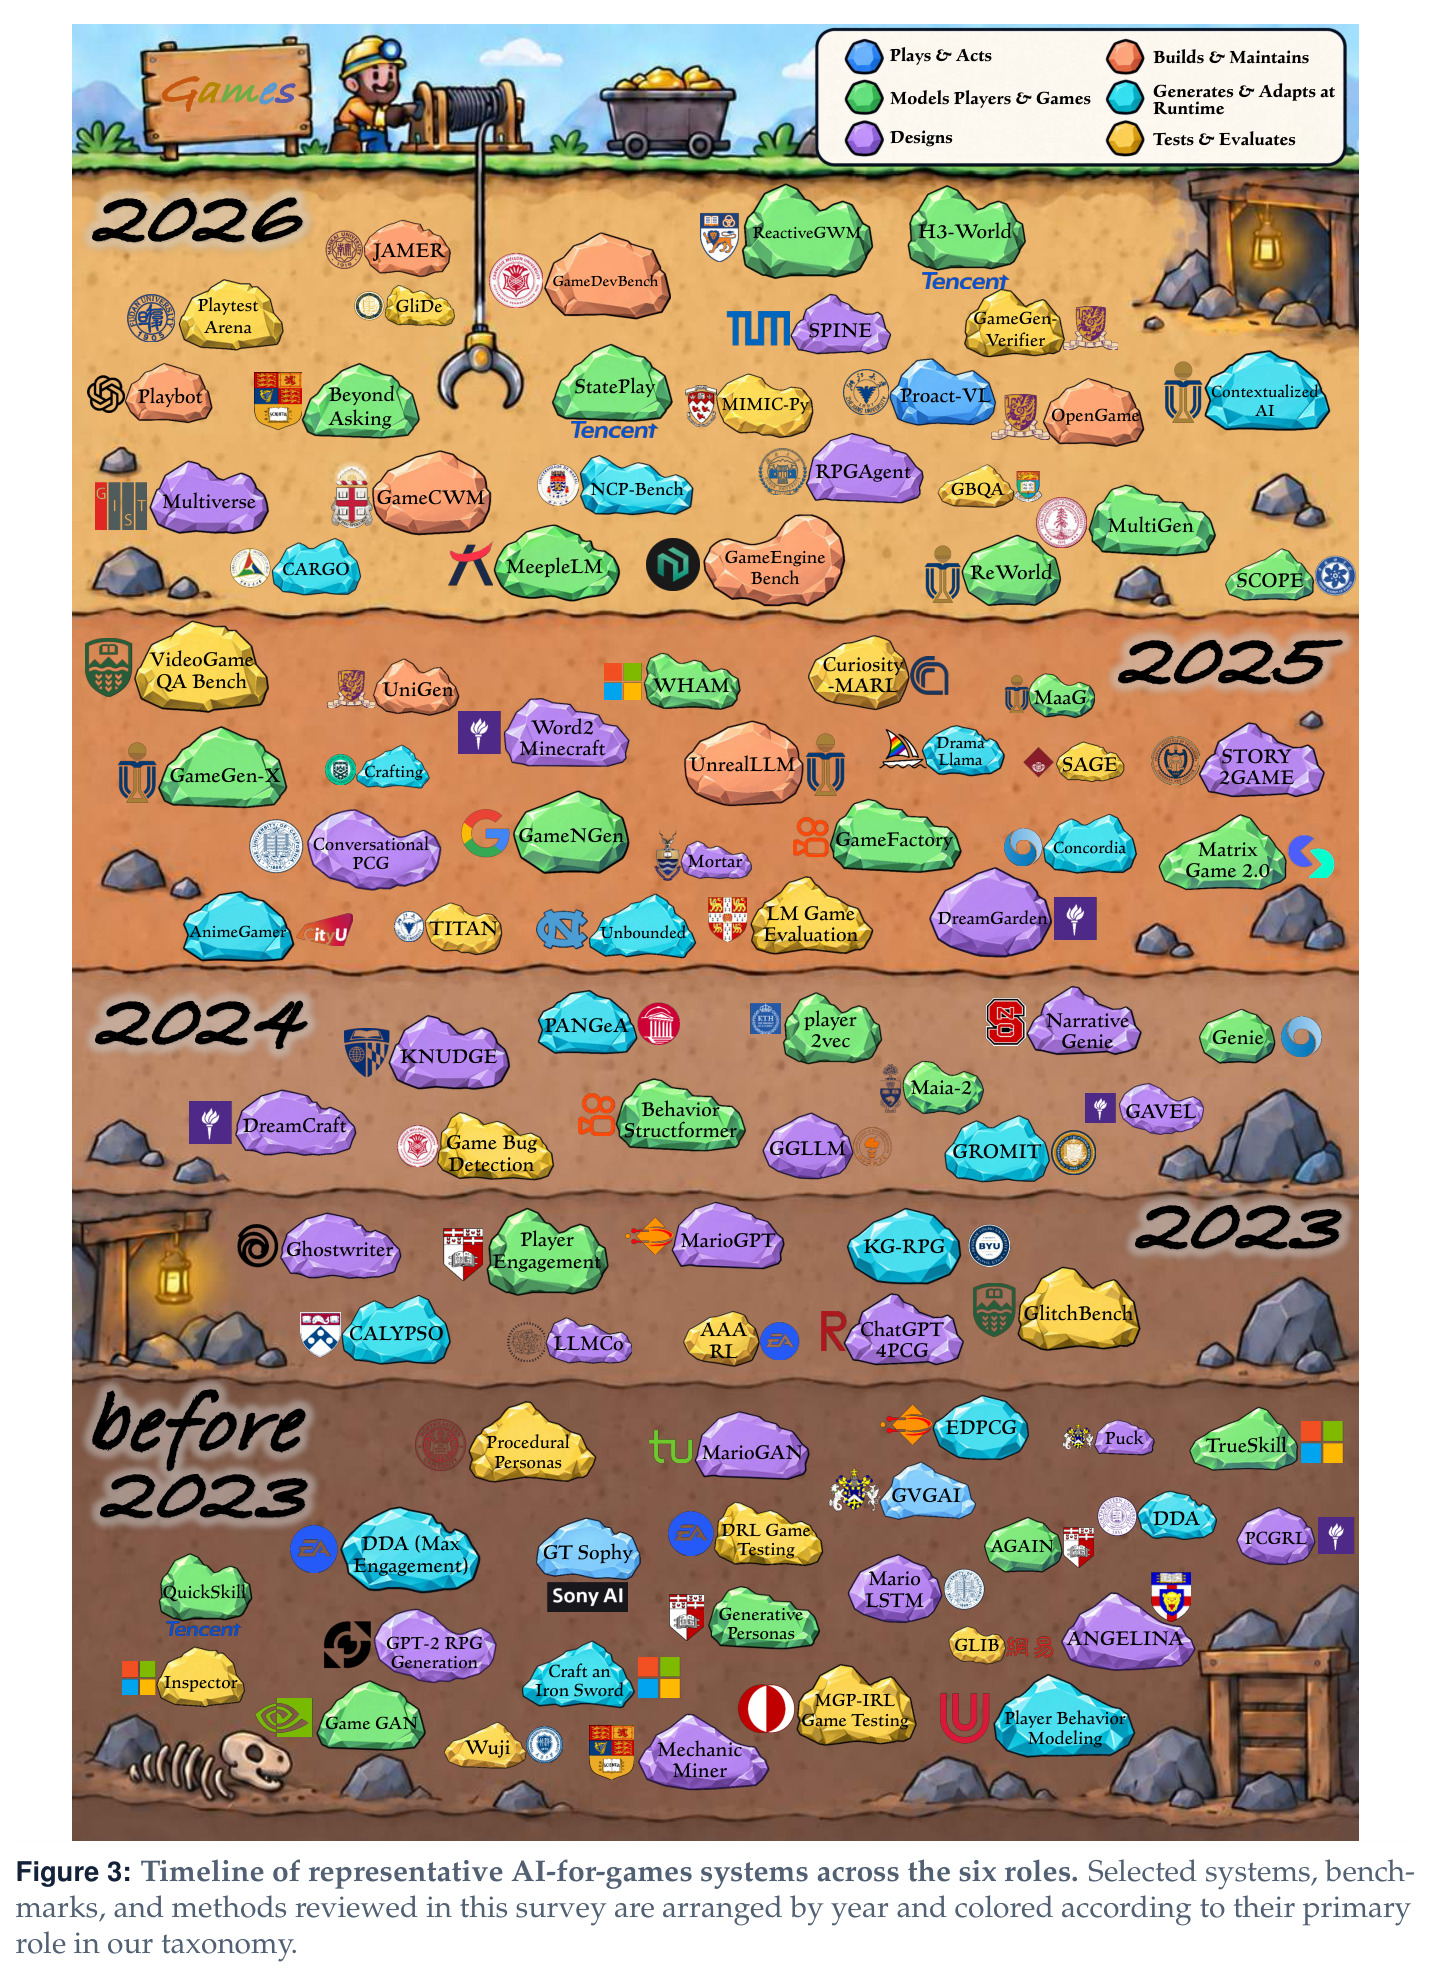
按发表年份和主角色着色的散布时间线,从早期的 Wuji、Game GAN、DDA 一路排到 2026 年的 ReactiveGWM、H3-World、JAMER、Playtest Arena 等数百个代表性系统。
展示了领域从符号式/早期学习式系统到基础模型系统的历史演化,以及六个角色各自的时间密度差异,是定位任何单个系统在领域坐标中位置的最佳索引。