FLAT:将图像与文本重采样为一维可变长度对齐的跨模态令牌,统一支持检索与生成 FLAT: Resampling Image and Text into 1D Flexible-Length Aligned Transmodal Tokens for Retrieval and Generation
共享编码器联合双向生成解码器预训练,一维可变长连续令牌同时胜任检索与生成。
前置知识
对比学习与 InfoNCE
对比学习把配对的图文样本拉近、把批内不配对样本推远。InfoNCE 损失形如 $\mathcal{L}=-\log \frac{\exp(s_{i,i}/\tau)}{\sum_j \exp(s_{i,j}/\tau)}$,其中 $s$ 是相似度、$\tau$ 是温度(FLAT 用 0.07)。负例来自同一全局 batch(FLAT 为 1024),这是 CLIP 系列对齐图文空间的标准做法。
FLAT 的对齐目标就是在 register 位置上做逐位置的 InfoNCE,理解温度、批内负例和双向(I2T/T2I)损失才能读懂其损失设计与消融。
嵌套 Dropout 与套娃表征(Matryoshka)
训练时随机只优化表征的一个前缀(前 $K$ 个维度或 token),其余部分被丢弃,使得前 $K$ 个位置自身就是一个完整可用的表征;推理时可按算力任意选 $K$。MRL 把它用在向量维度上,FlexTok 把它用在图像 token 序列长度上。FLAT 直接对 register 序列做嵌套 dropout,且从几何梯子 $K=\{1,4,16,64,256\}$ 中采样以避免浪费优化步数。
这是 FLAT「灵活长度」的来源:一个预训练模型在推理时输出 1 到 256 个 token,检索、生成、算力均可随 $K$ 缩放,全文所有实验都围绕 $K$ 展开。
一维视觉词元化(TiTok/FlexTok)
把图像的 $16\times16$ 空间网格重采样成极短的 1D token 序列(如 32/256 个),用查询式 transformer 消除空间冗余,再交给生成模型重建图像。TiTok 证明 32 个 token 就能生成高质量图像,FlexTok 进一步让 token 数在推理时可变。
FLAT 借用这套「网格压 1D」技术,但做了关键推广:不只压缩图像,还把文本也压进同一个共享 1D 连续空间,并用生成目标而非重建目标训练。
整流流与流匹配(Rectified Flow / Flow Matching)
一种连续归一化流的生成训练法:把干净数据 $\hat{x}$ 与噪声 $\epsilon$ 线性插值得到 $\hat{x}_t=(1-t)\hat{x}+t\epsilon$,训练网络预测速度场 $v^\star=\epsilon-\hat{x}$,损失为 $\mathbb{E}\|v_\phi(\hat{x}_t,t,c)-(\epsilon-\hat{x})\|^2$。推理时沿速度场积分即可从噪声走向数据。SANA、SD3 等 T2I 模型均采用该范式。
FLAT 的 T2I 解码器就是从 SANA-1.6B 初始化的流匹配 transformer,其条件 $c$ 正是文本侧的 register 前缀 $z_{txt:K}$,读懂式 (7)(8) 需要这个背景。
Register Token(寄存器/查询词元)
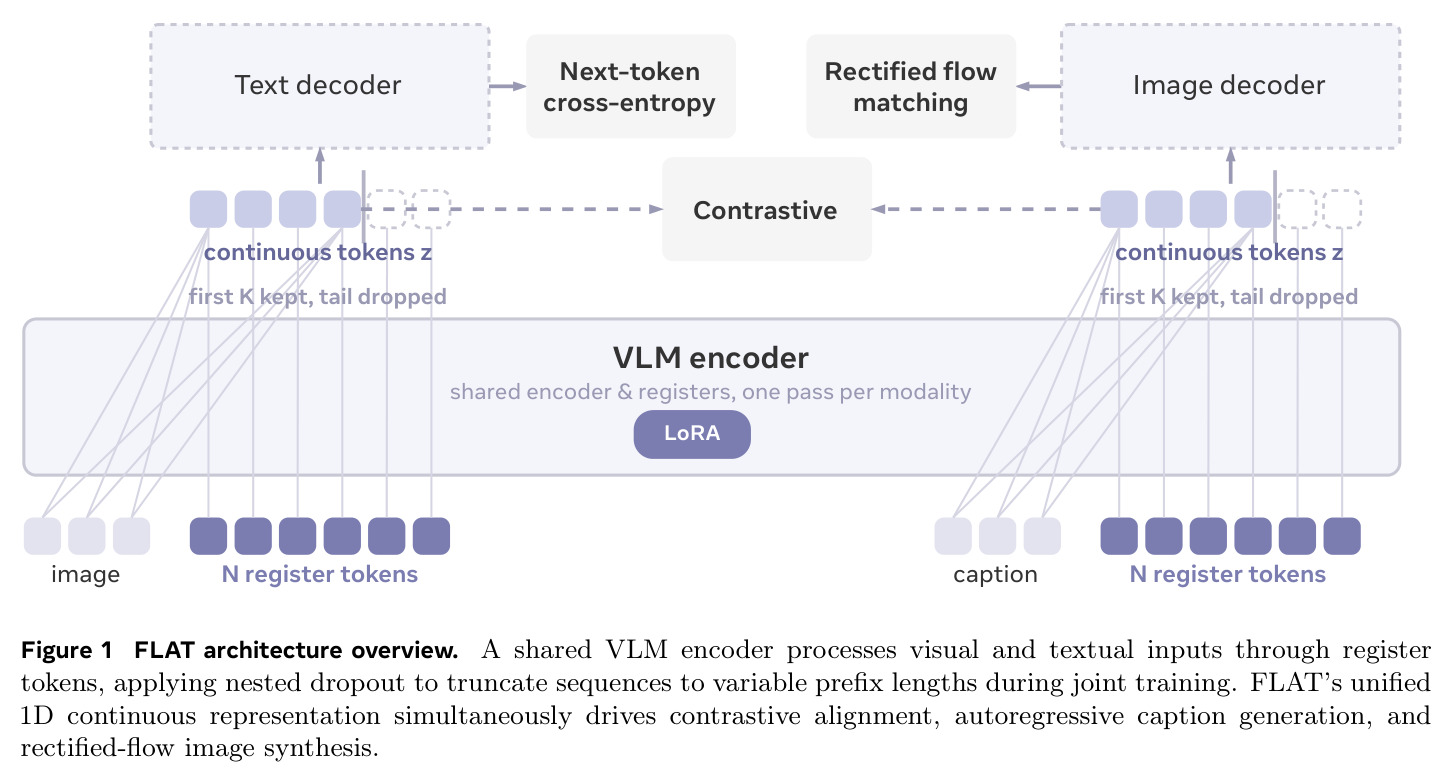
拼接在输入序列末尾的一组可学习向量(FLAT 用 $N=256$ 个、每个 $d=64$ 维)。编码器是因果注意力时,register 只能看到输入内容而后续内容看不到它们,因此其隐状态成为「读出槽」——输入信息的固定容量摘要。BLIP-2 的 Q-Former 查询向量、TiTok 的 token 都是同类机制。
FLAT 的表征就是 register 位置的隐状态经线性投影 $z=W_{lat}f_{enc}(x,R)$ 得到的,整个方法(对比、生成、截断)都作用在这组 token 上。
LoRA 低秩适配
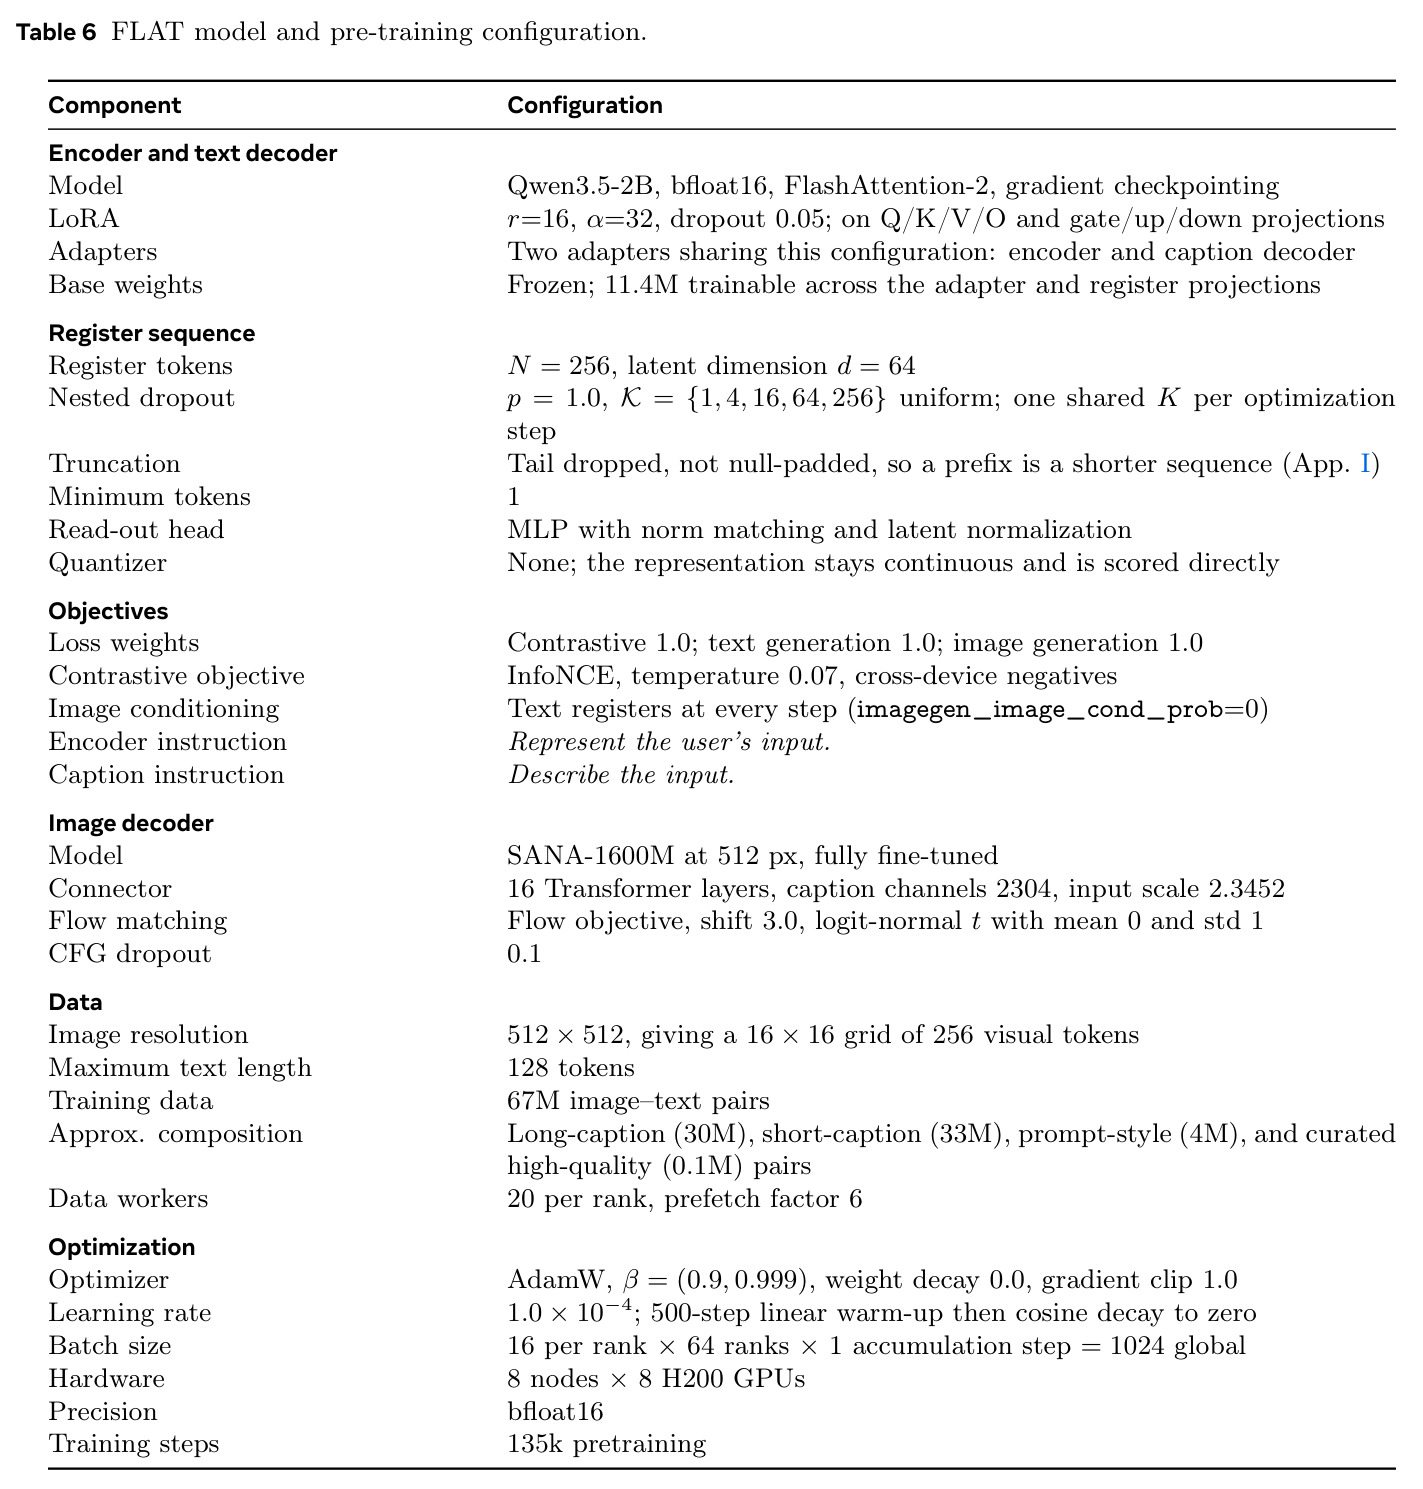
冻结预训练权重 $W$,只训练低秩增量 $\Delta W=BA$($B\in\mathbb{R}^{d\times r}, A\in\mathbb{R}^{r\times k}$,秩 $r\ll d$),大幅减少可训练参数与显存。FLAT 用 $r=16, \alpha=32$,作用在 Qwen3.5-2B 的注意力与 MLP 投影上,编码器与文本解码器各挂一个适配器,可训练参数仅 11.4M。
FLAT 的多任务切换(预训练/检索微调/caption 微调用不同 LoRA)正是靠参数高效适配实现的,这决定了它的复现成本与微调配方。
研究动机
主流多模态系统把「表征学习」和「生成建模」拆成两个先后阶段。表征侧由 CLIP/SigLIP 用对比目标或 DINO/JEPA 用自监督目标单独训练;生成侧则把这些冻结嵌入当作现成条件:BLIP-2、LLaVA 把冻结视觉编码器经 adapter 接入 LLM 做 I2T;Stable Diffusion、SDXL 依赖冻结的 CLIP 文本嵌入,SD3 叠加 CLIP+T5,PixArt-α、Sana、MetaQuery 改用冻结 LLM 隐状态做 T2I 条件。这种解耦带来两个具体代价:其一,生成性能被冻结表征封顶——编码器永远接收不到来自生成损失的梯度,表征里缺失的信息(如细粒度属性绑定、空间关系)解码器无论怎么训练都补不回来;其二,生成器必须先花大量训练「重新对齐」,把别人的嵌入空间翻译成自己的条件空间。另一条统一模型路线(Chameleon、Transfusion 等)为了生成干脆放弃显式嵌入空间,于是失去了对比空间特有的检索能力、线性可插值性和可解释几何结构。
本文的目标是本文想证明:表征学习和生成建模可以在单一预训练阶段内联合完成,且学到的表征同时具备两种身份——既是判别性语义描述子(支撑跨模态检索、线性探针、无监督聚类),又是双向生成的条件(驱动 T2I 图像合成与 I2T 文本生成)。具体目标有三层:(1)架构上把图像和文本都映射进统一的连续 1D 序列空间,用一组共享的 register token 承载;(2)通过嵌套 dropout 让同一模型在推理时自由选择 1 到 256 个 token 的前缀长度,实现从「单 token 检索」到「全序列精细生成」的算力-质量连续调节;(3)不做任务特定训练就能 zero-shot 完成两个方向的检索与生成,经轻量微调后达到各任务的 SOTA 水平,并原生支持线性插值、潜空间算术等几何操作。
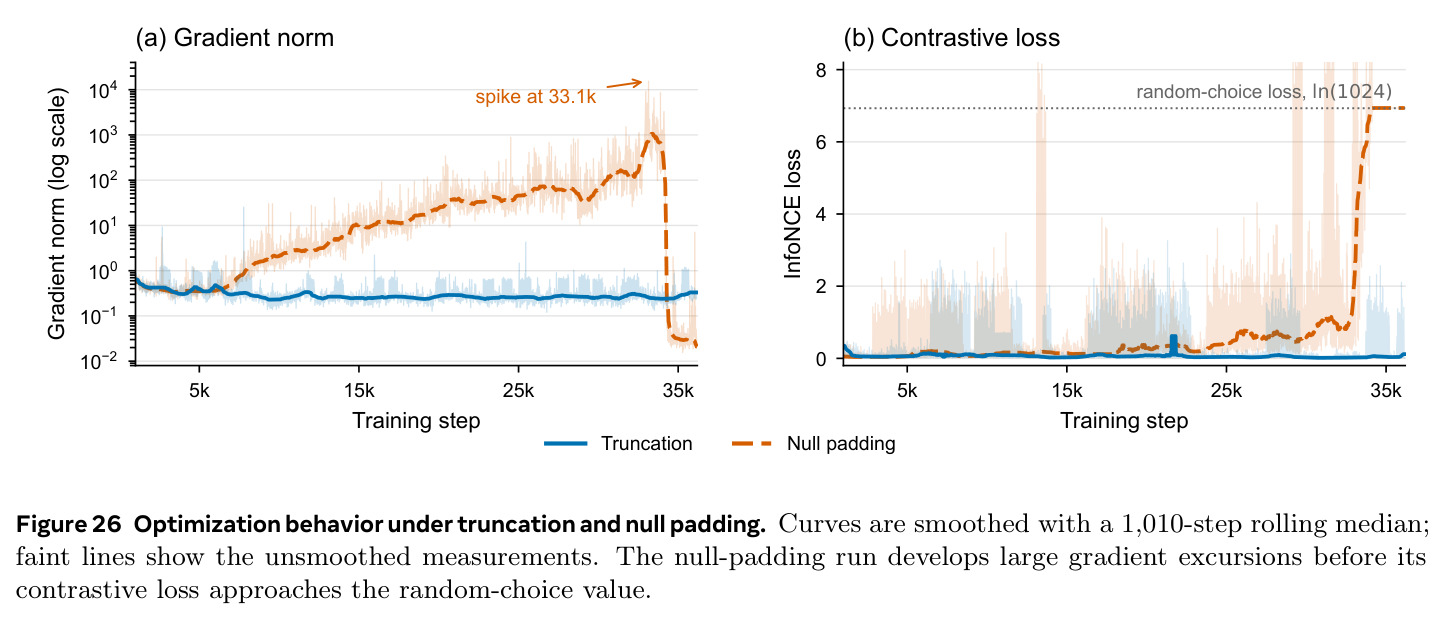
与已有工作不同的是,本文的独特切入在于「既要又要」的第三条路。与 CoCa(对比+单向文本生成)相比,FLAT 把生成扩展为 I2T/T2I 双向,并验证双向生成与对比目标互相增益而非冲突;与 TiTok/FlexTok/GigaTok 等 1D 词元化器相比,FLAT 不只重建图像,而是把图像和文本一起重采样进共享 1D 连续空间并做对比对齐;与 MRL、SAE、CSR 等可变维度表征相比,FLAT 把嵌套 dropout 从「向量维度」搬到「序列长度」维度,并采用直接前缀截断而非 FlexTok 的 null-padding(附录 I 显示后者在联合训练中梯度爆炸、对比损失坍塌到随机水平 $\ln(1024)$);与 Chameleon 类统一模型相比,FLAT 保留了显式、线性可插值的嵌入空间。此外它用逐位置的 late-interaction 相似度做对比,让每个 register 位置与对侧同位置语义对应,这是传统 CLIP 式全局向量对比所没有的。
核心方法
直觉上,一个好的跨模态表征应该既「说得出」——能驱动解码器重建配对的另一模态,又「分得开」——批内对比能精确检索。FLAT 据此把三个目标装进一次预训练。技术上:输入 $x$(模态 $m\in\{img,txt\}$)拼接 $N=256$ 个可学习 register token 后送入共享 VLM 编码器(Qwen3.5-2B 加 LoRA,系统提示为 Represent the input),register 位置的隐状态经线性投影得到表征 $z=W_{lat}f_{enc}(x,R)\in\mathbb{R}^{N\times d}$,其中 $d=64$,两模态共享同一组 register 和投影。每个优化步从梯子 $K=\{1,4,16,64,256\}$ 均匀采样一个保留长度 $K$(全局所有 rank 广播同一个值),只取前缀 $z_{:K}$ 参与全部目标。前缀经任务专属的 $\text{RMSNorm}(\text{MLP}(\cdot))$ 映射成 soft token:视觉前缀送入自回归语言模型生成 caption(I2T),文本前缀经 16 层 connector 以 cross-attention 条件化 rectified flow transformer(SANA-1.6B 初始化,512px)合成 VAE latent(T2I)。三个损失联合优化:双向逐位置 InfoNCE 对比、caption 交叉熵、流匹配损失。
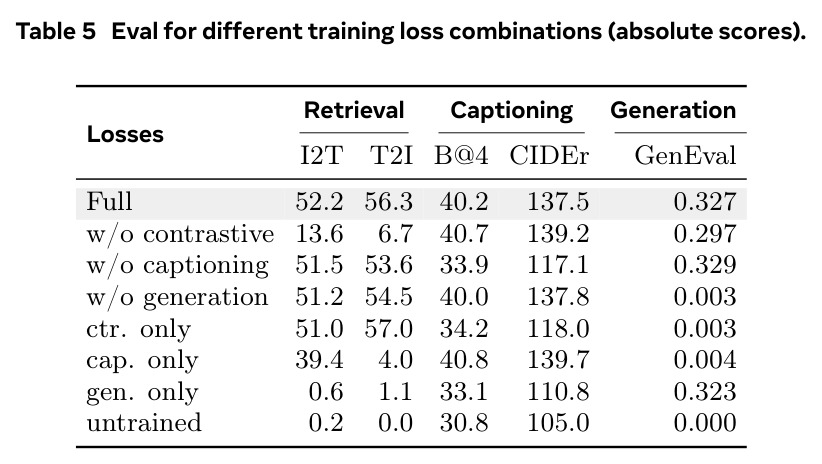
核心创新是「对比对齐 + 双向生成」在共享一维序列空间中的联合优化,本质区别有三点。第一,检索与生成互促被从 CoCa 的单向推广为双向:图文表征必须同时能当 caption 的前缀条件和扩散模型的 cross-attention 条件,迫使空间兼语义充分性与判别性于一体,消融证明三损失联合在所有指标上最优且不冲突。第二,表征长度本身成为可变维度:与 FlexTok 固定 256 长度、尾部填 null 嵌入不同,FLAT 训练时直接截断到前 $K$ 个 token,发现截断优化更稳定——null-padding 会引起梯度范数飙升并在约 33k 步附近令对比损失坍塌到随机基线 $\ln(1024)$。第三,对比打分采用 late-interaction:$s_{ij}^{(K)}=\frac{1}{K}\sum_{n=1}^{K}\frac{(z^{img}_{i,n})^\top z^{txt}_{j,n}}{\|z^{img}_{i,n}\|_2\|z^{txt}_{j,n}\|_2}$,逐位置对齐使第一个 register 天然承载全局语义,这解释了为何 $K=1$ 就足以检索。由此得到一个统一接口:同一次前向的输出,既可截短做检索,也可拉长做生成。
方法步骤详情
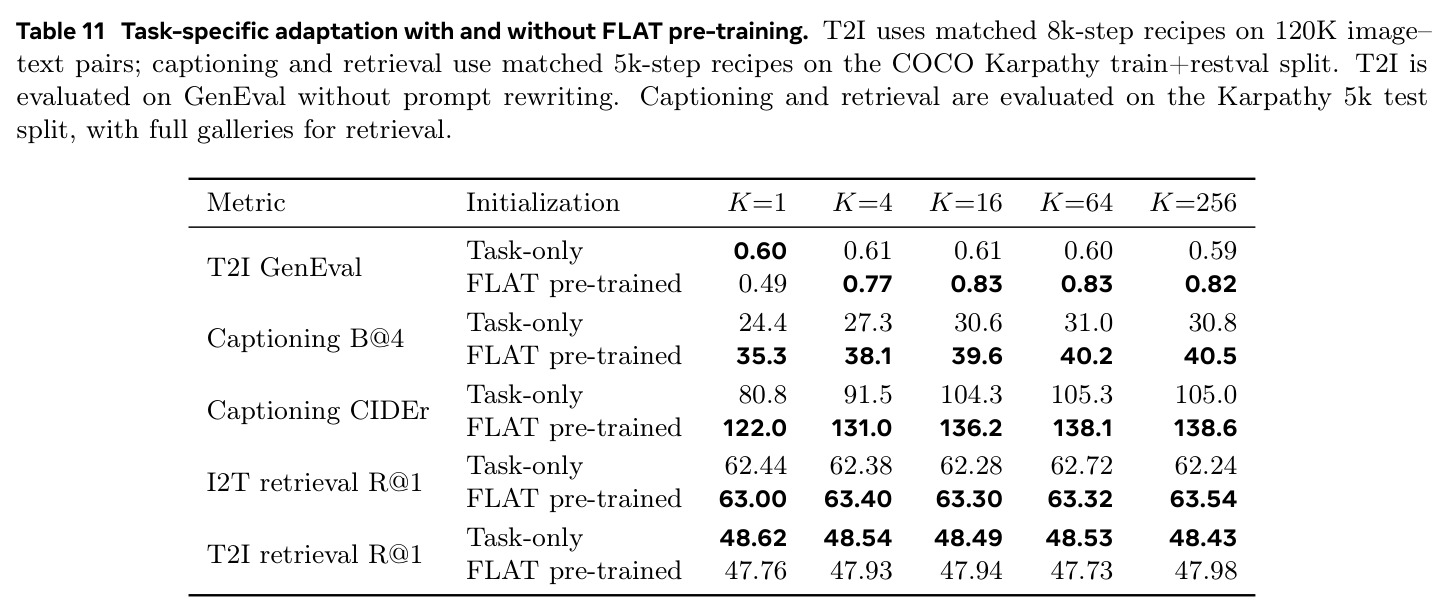
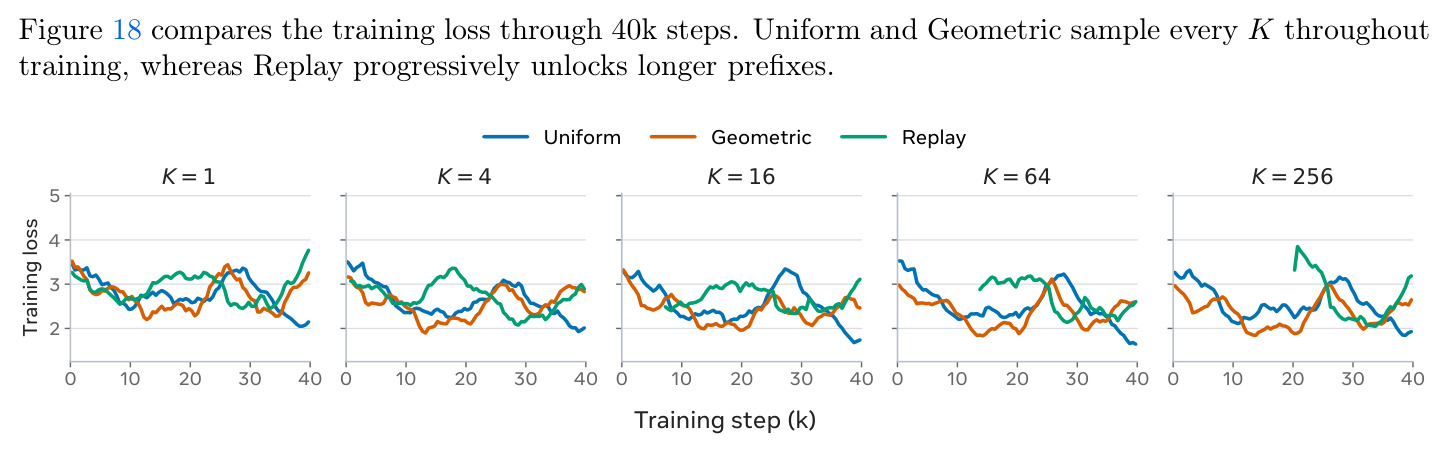
完整流程如下。步骤一(编码):图像以 512×512 输入、文本截断至 128 token,各拼接 $N=256$ 个共享 register,经 Qwen3.5-2B(bfloat16、FlashAttention-2、LoRA $r=16$)编码,读出 register 隐状态并线性投影为 $z\in\mathbb{R}^{256\times64}$。步骤二(截断):每步全局采样一个 $K\in\{1,4,16,64,256\}$,丢弃尾部得到 $z_{:K}$(对比实验表明均匀采样是稳健默认,几何采样偏生成、Replay 偏检索)。步骤三(对比):按式 (3)-(5) 计算逐位置余弦 late-interaction 分数,双向 InfoNCE(温度 0.07,跨设备负例,全局 batch 1024)。步骤四(I2T 生成):$z_{img:K}$ 经 MLP 映射为 soft token,与提示 Describe the input 拼接,自回归损失 $\mathcal{L}_{txt}=-\sum_t\log p_\theta(y_t|y_{<t},z_{img:K})$。步骤五(T2I 生成):$z_{txt:K}$ 条件化 SANA 流匹配解码器,噪声 latent 为 $\hat{x}_t=(1-t)\hat{x}+t\epsilon$,目标是速度 $v^\star=\epsilon-\hat{x}$,损失 $\mathcal{L}_{img}=\mathbb{E}\|v_\phi(\hat{x}_t,t,z_{txt:K})-(\epsilon-\hat{x})\|^2$。步骤六(总目标):$\mathcal{L}_{total}=\lambda_{align}\mathcal{L}_{align}+\lambda_{txt}\mathcal{L}_{txt}+\lambda_{img}\mathcal{L}_{img}$,三个权重均为 1.0。预训练用 65.7M 图文对、135k 步、8 节点×8 张 H200、AdamW 学习率 $10^{-4}$ 余弦衰减。之后各任务轻量微调:T2I 继续训图像解码器 8k 步(120K 高质量对),caption 只训文本解码器 LoRA 5k 步,检索只训编码器 LoRA+register+投影(COCO 5k 步、Flickr30k 仅 320 步)。
技术新颖性
技术新颖性可从四个维度评估。架构上,「图文双模态重采样进同一共享 1D 连续空间」是新的:TiTok/FlexTok 只压缩图像用于重建,AutoCompressor 只压缩文本,BLIP-2 的 Q-Former 只做对齐不做生成,FLAT 把三者统一到一个编码器一次前向中。训练目标上,将对比、单向生成(CoCa 先例)扩展为双向生成且三者严格共享同一截断前缀(每步一个全局 $K$),这种「同一前缀服务所有损失」的耦合是作者刻意设计,保证对比结构与生成条件的一致性。训练技巧上,直接前缀截断替代 null-padding 的发现虽小但关键——附录 I 用梯度范数曲线和对比损失坍塌(逼近 $\ln(1024)$)给出训练动力学证据,这对所有「嵌套 dropout 序列表征」的后续工作都有参考价值。能力上,「单一预训练 checkpoint 原生支持插值、算术和组合检索」不是通过后处理对齐获得,而是联合训练的涌现结果:图文质心距离仅为 CLIP 的 1/2($K=1$)到 1/4($K=256$),模态间隙的大幅缩小是线性操作可行的几何基础。相对局限是各组件(register、嵌套 dropout、流匹配、LoRA)均非首创,创新在于组合方式与系统验证的完整性。
实验结果
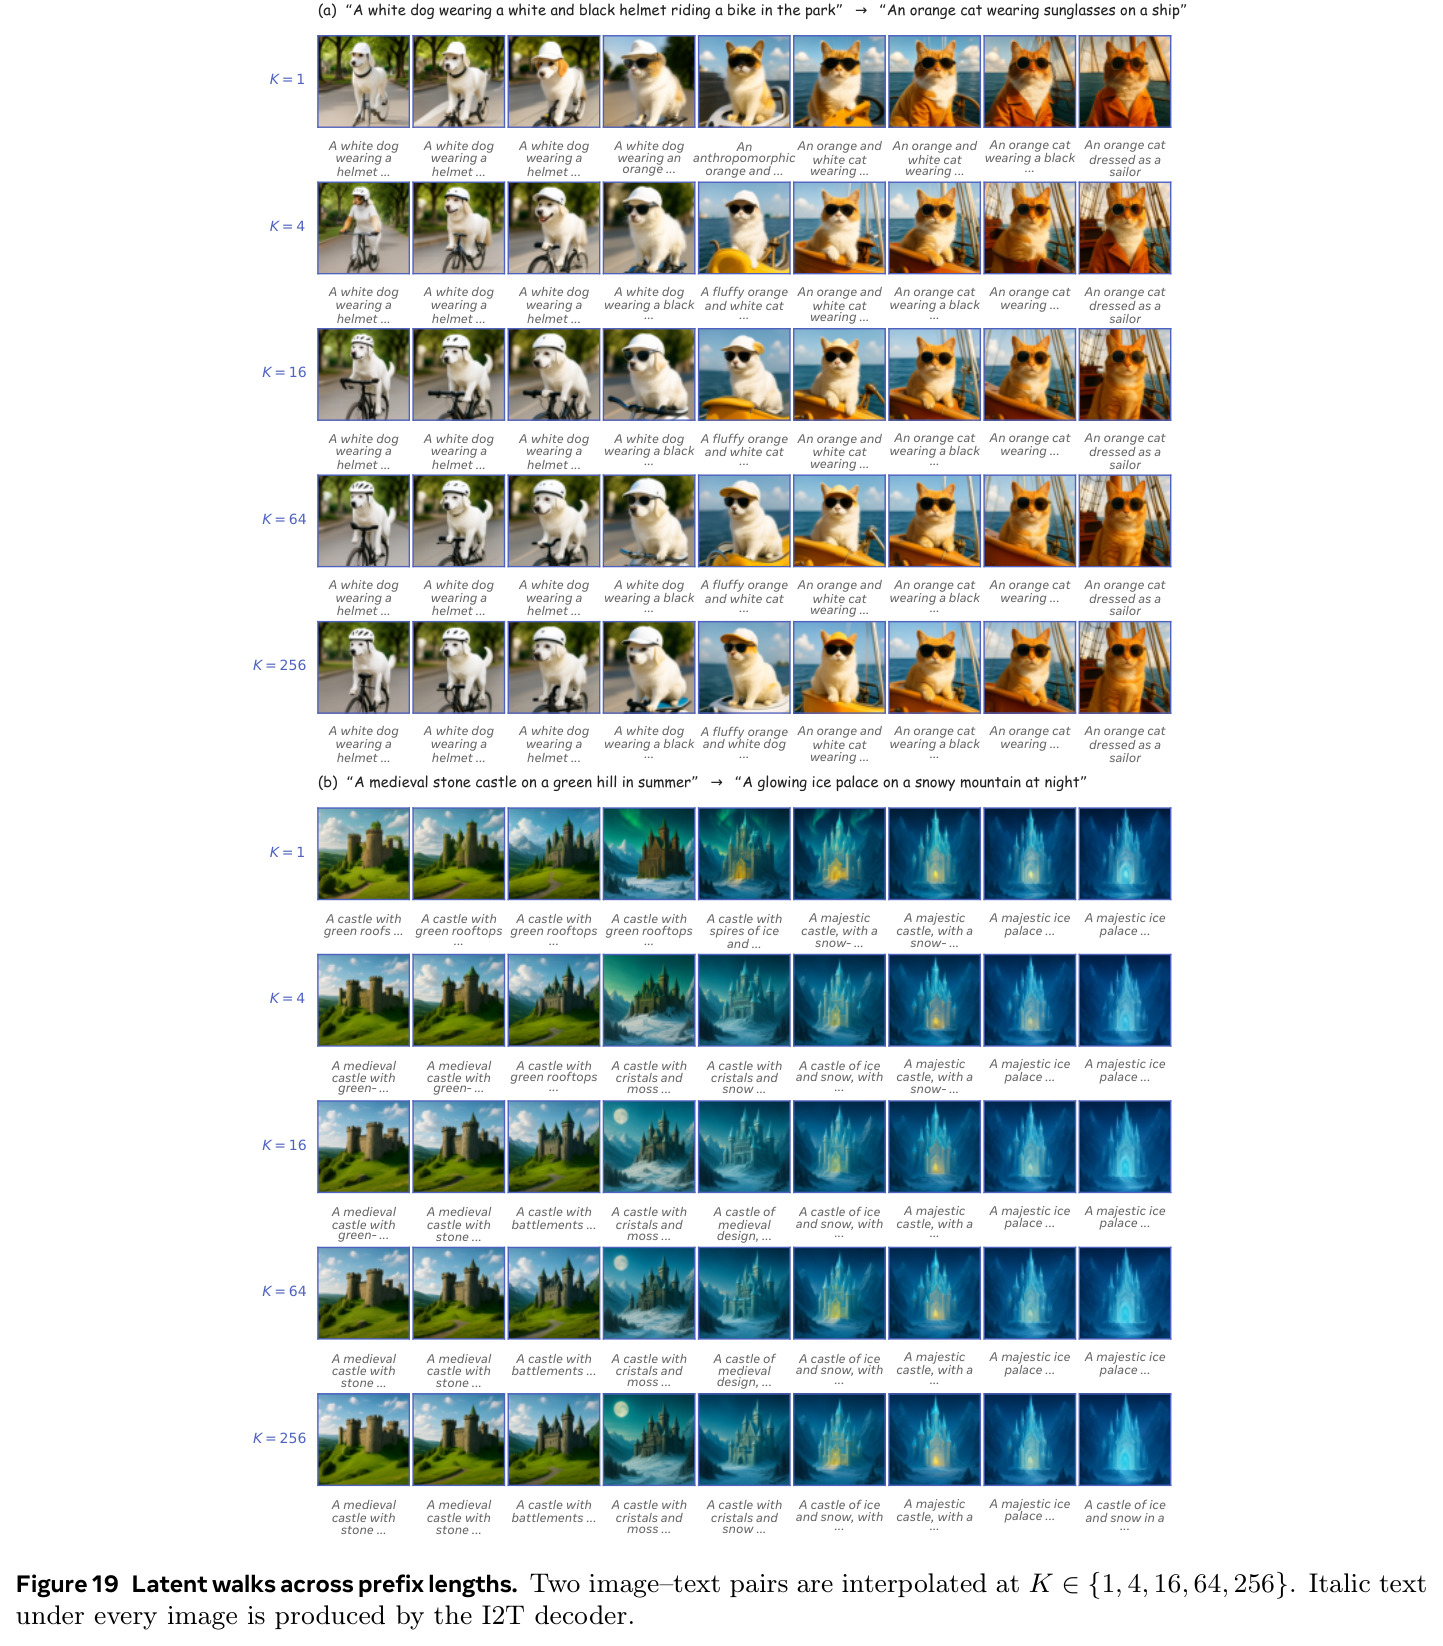
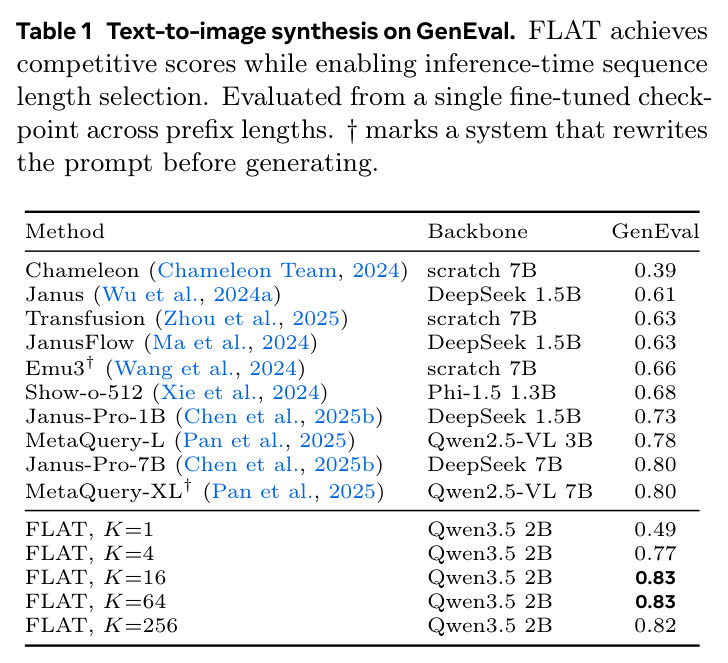
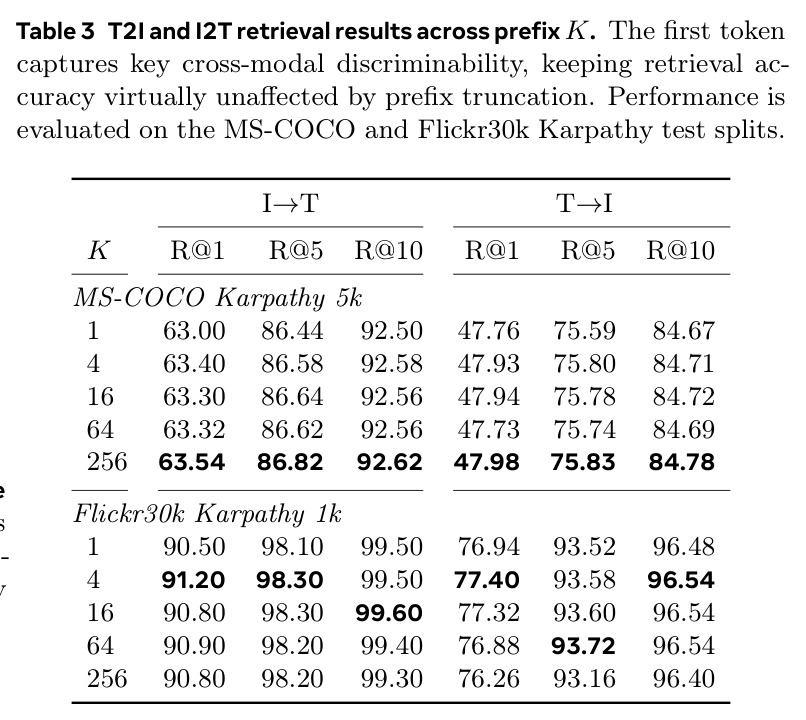
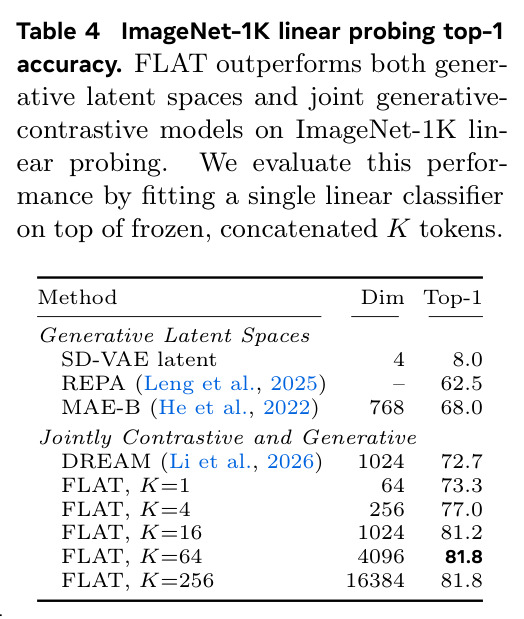
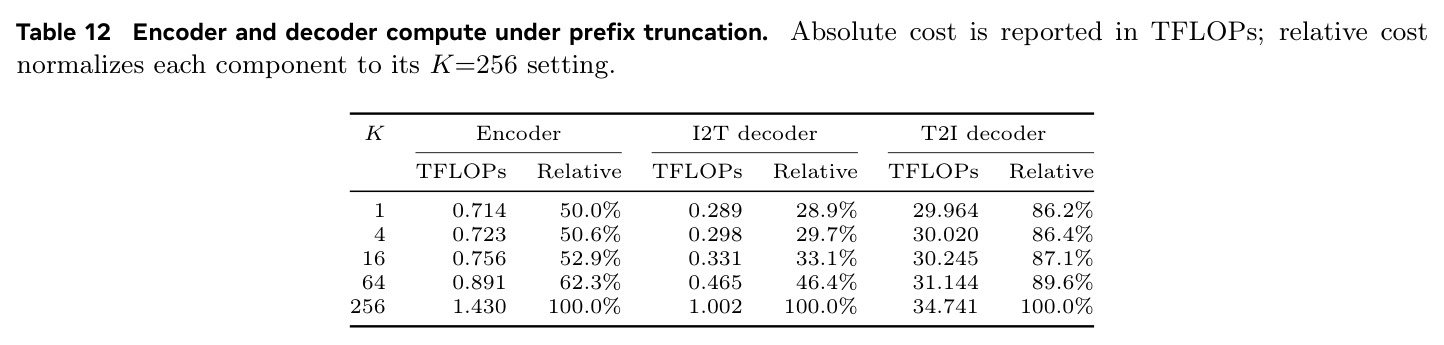
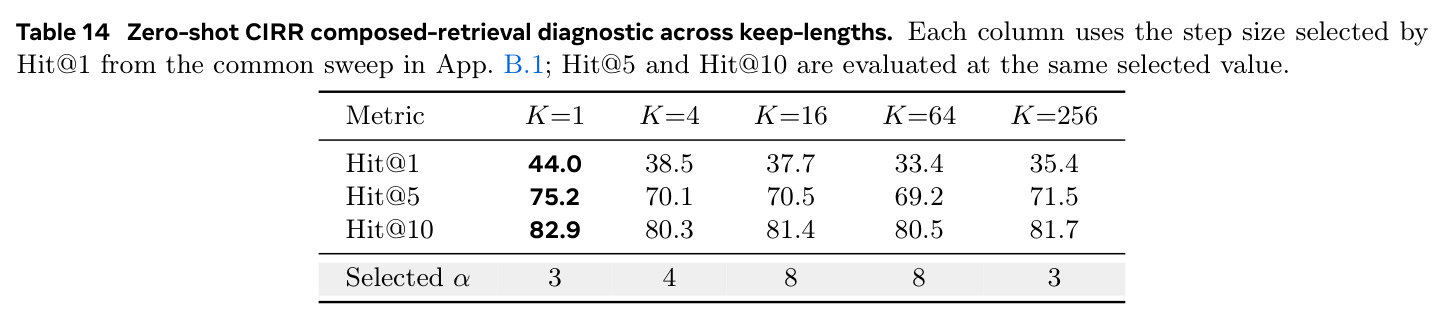
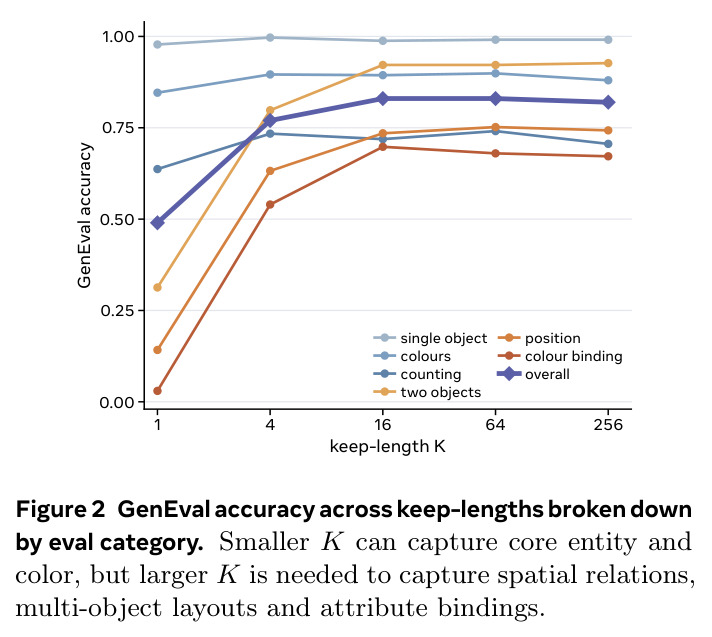
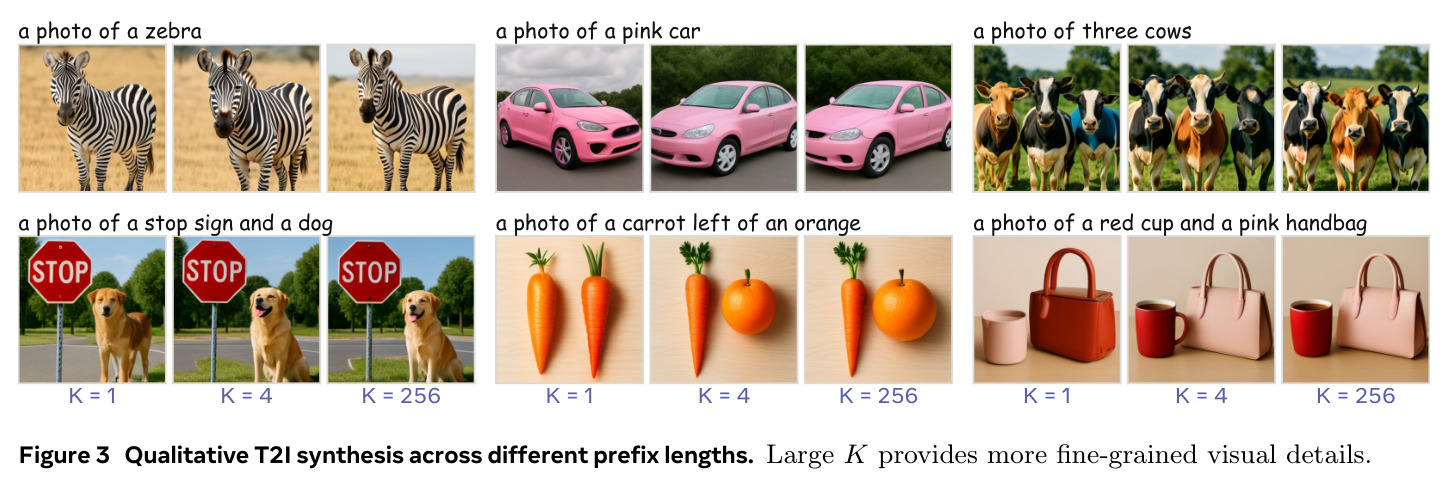
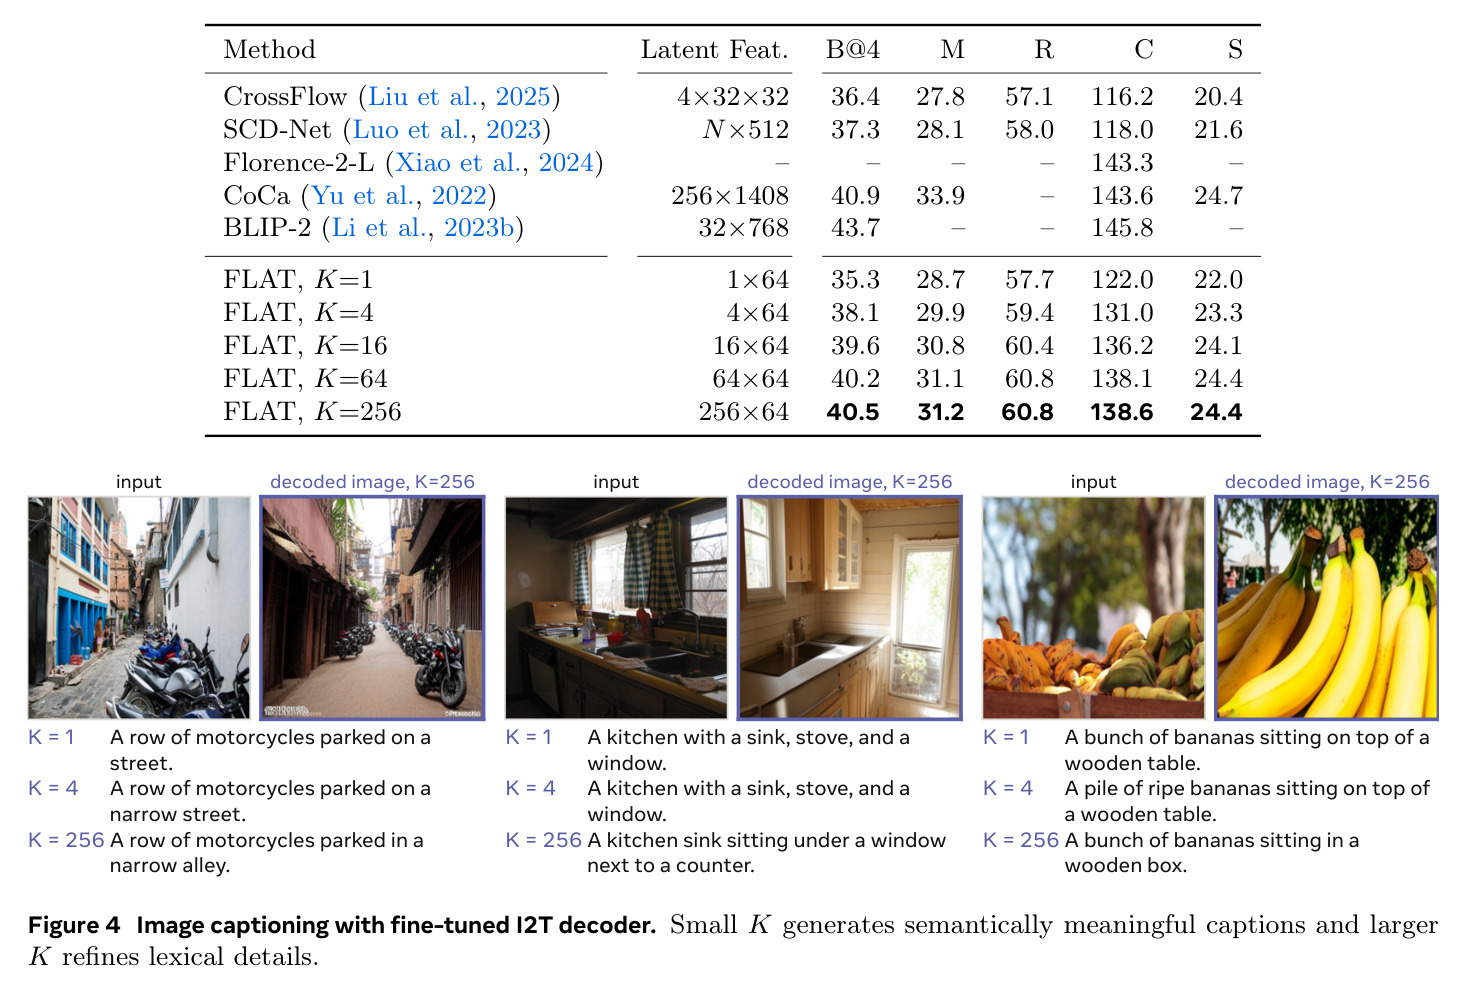
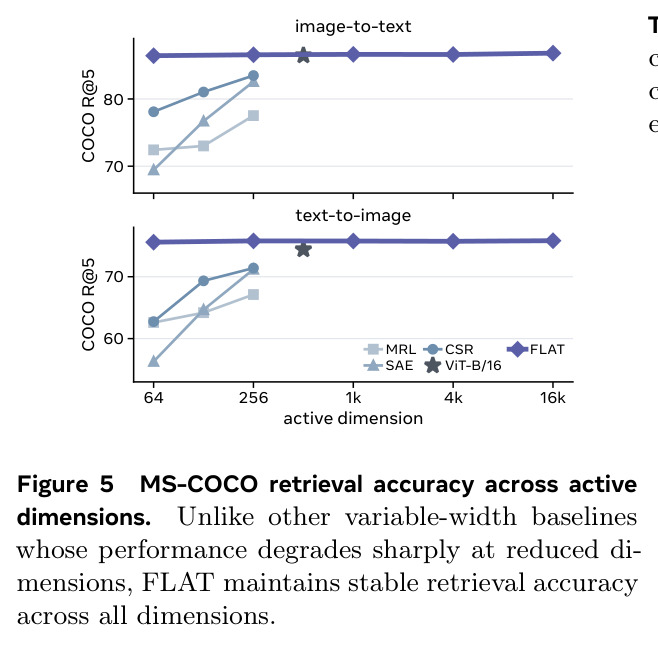
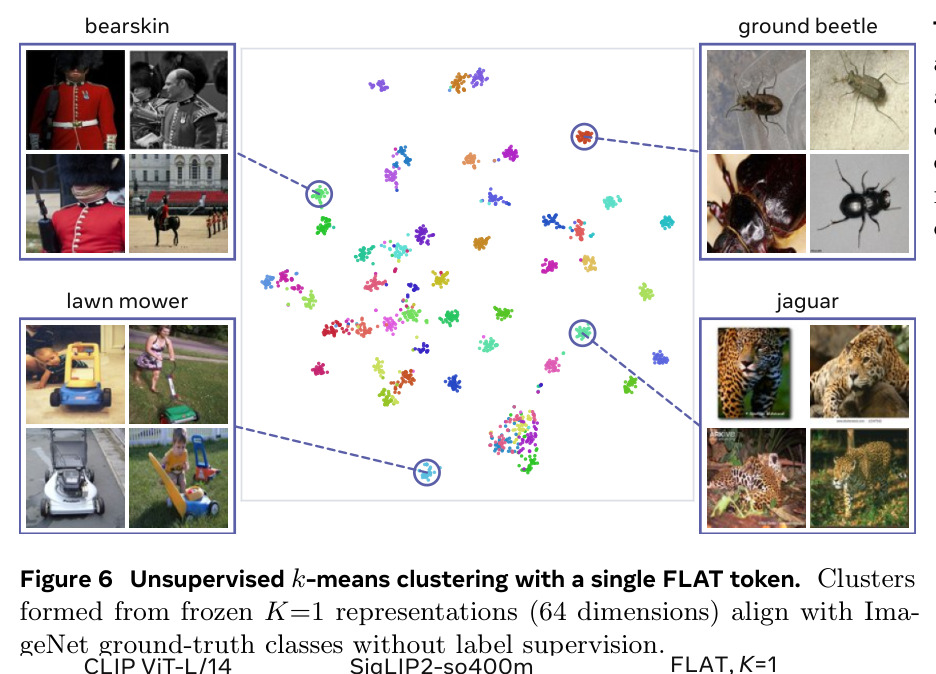
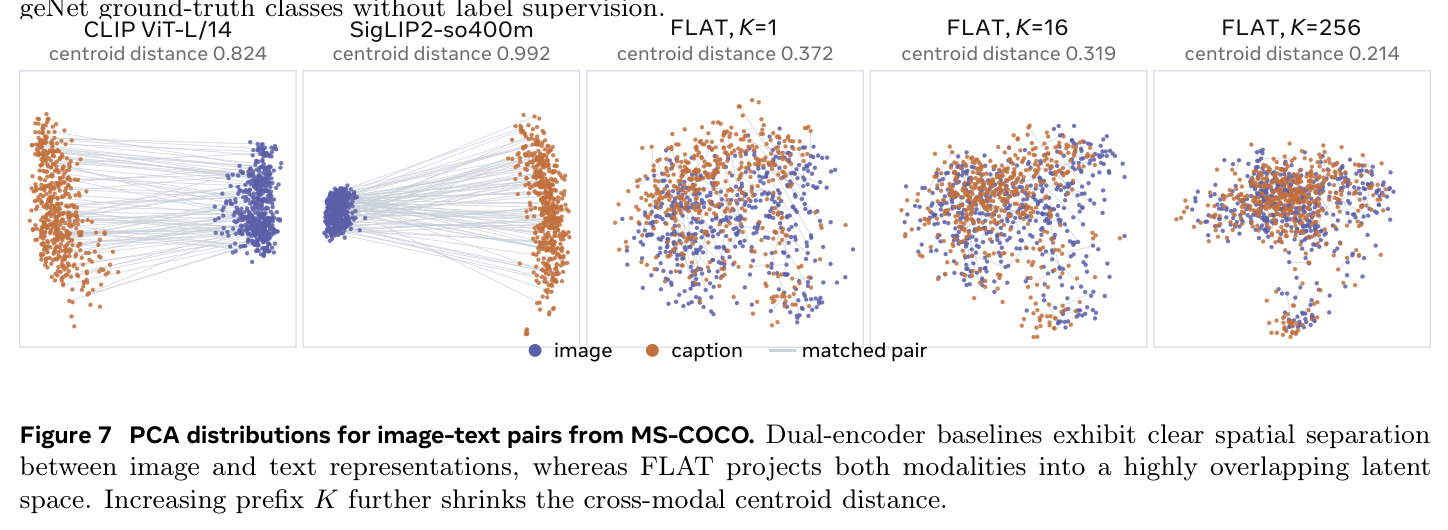
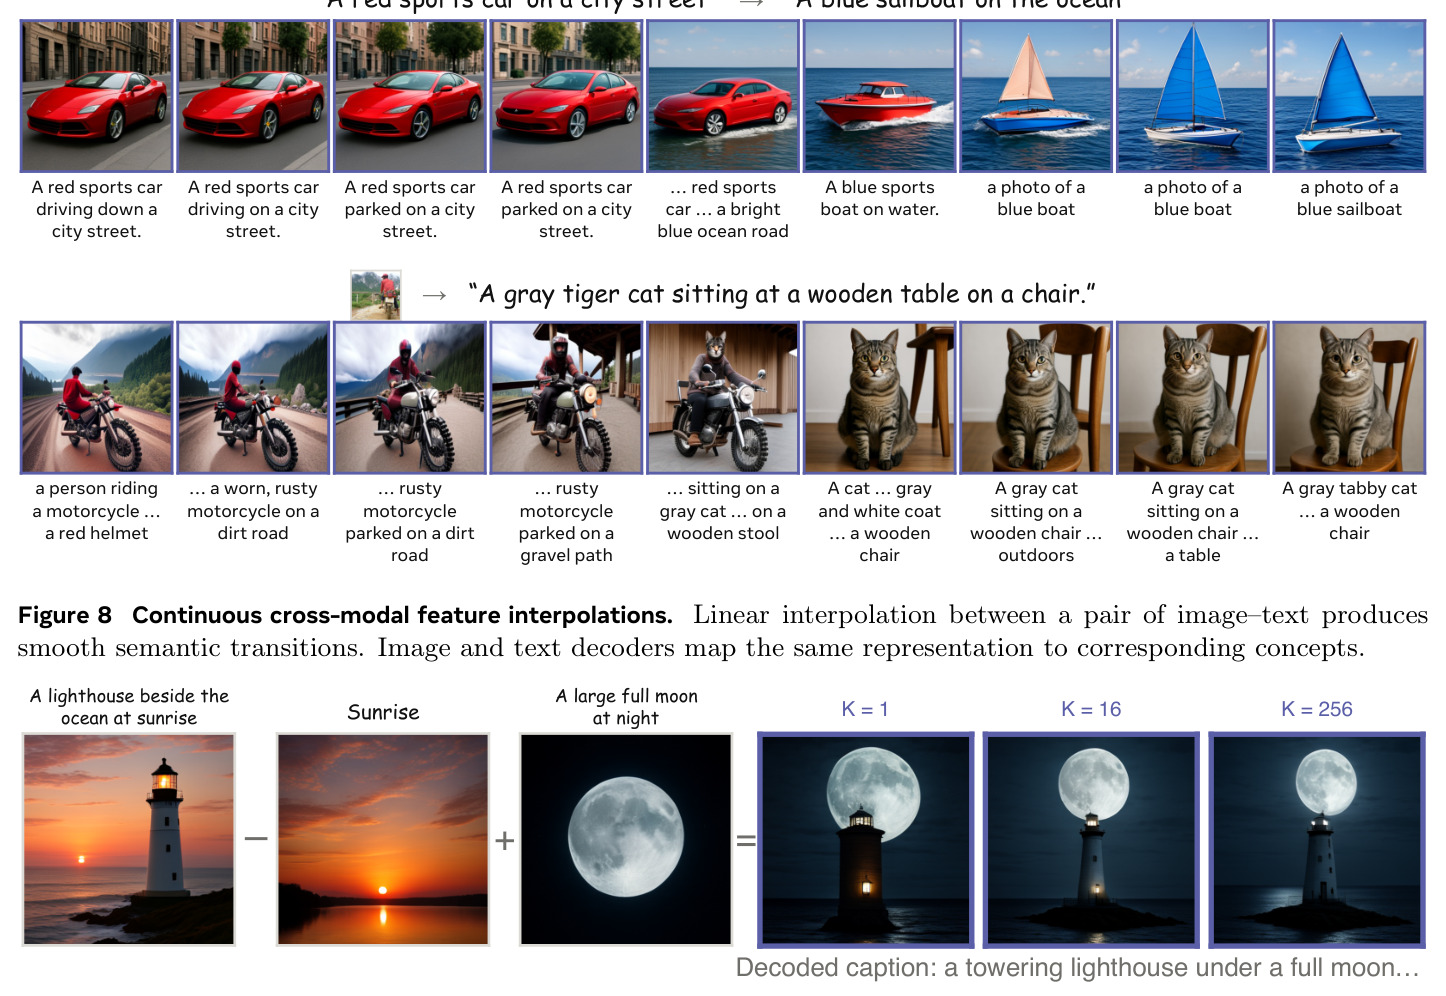
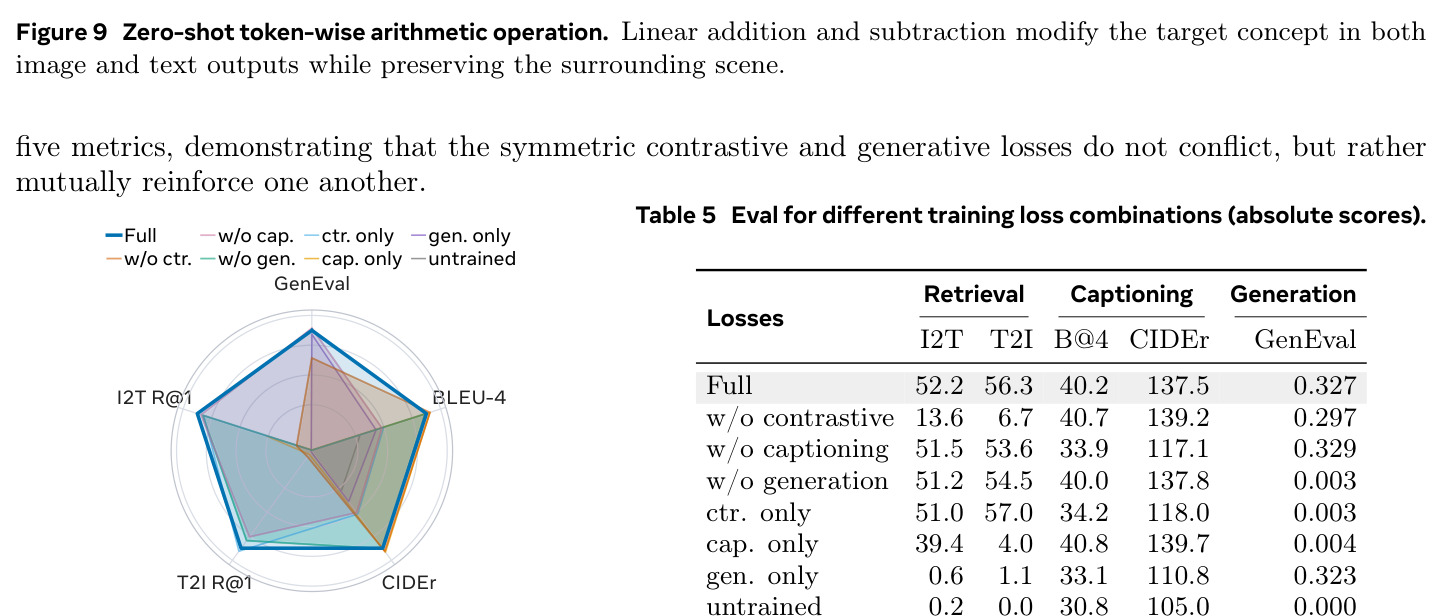
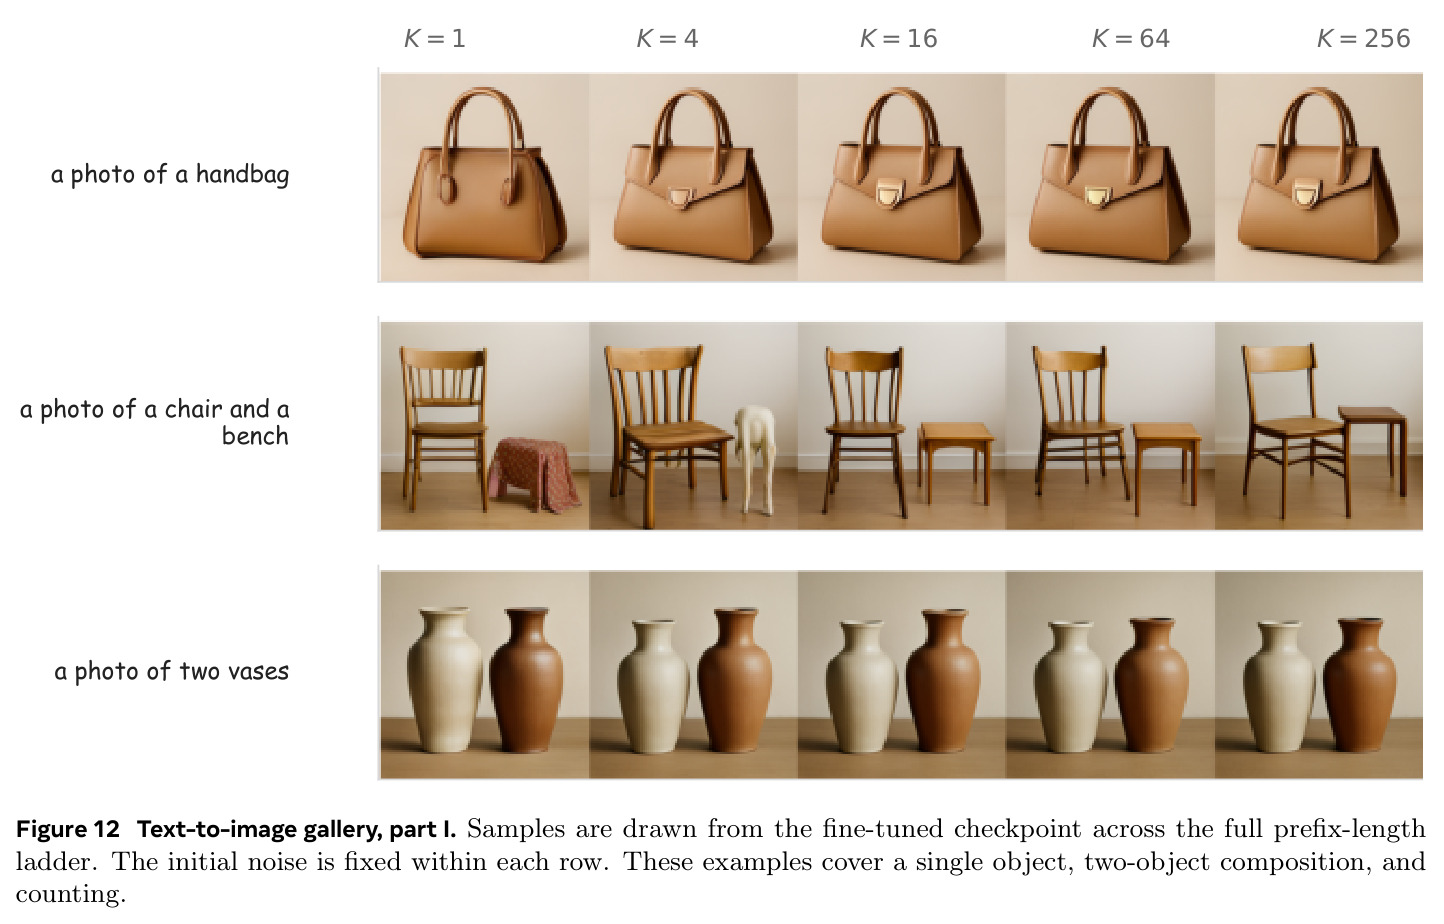
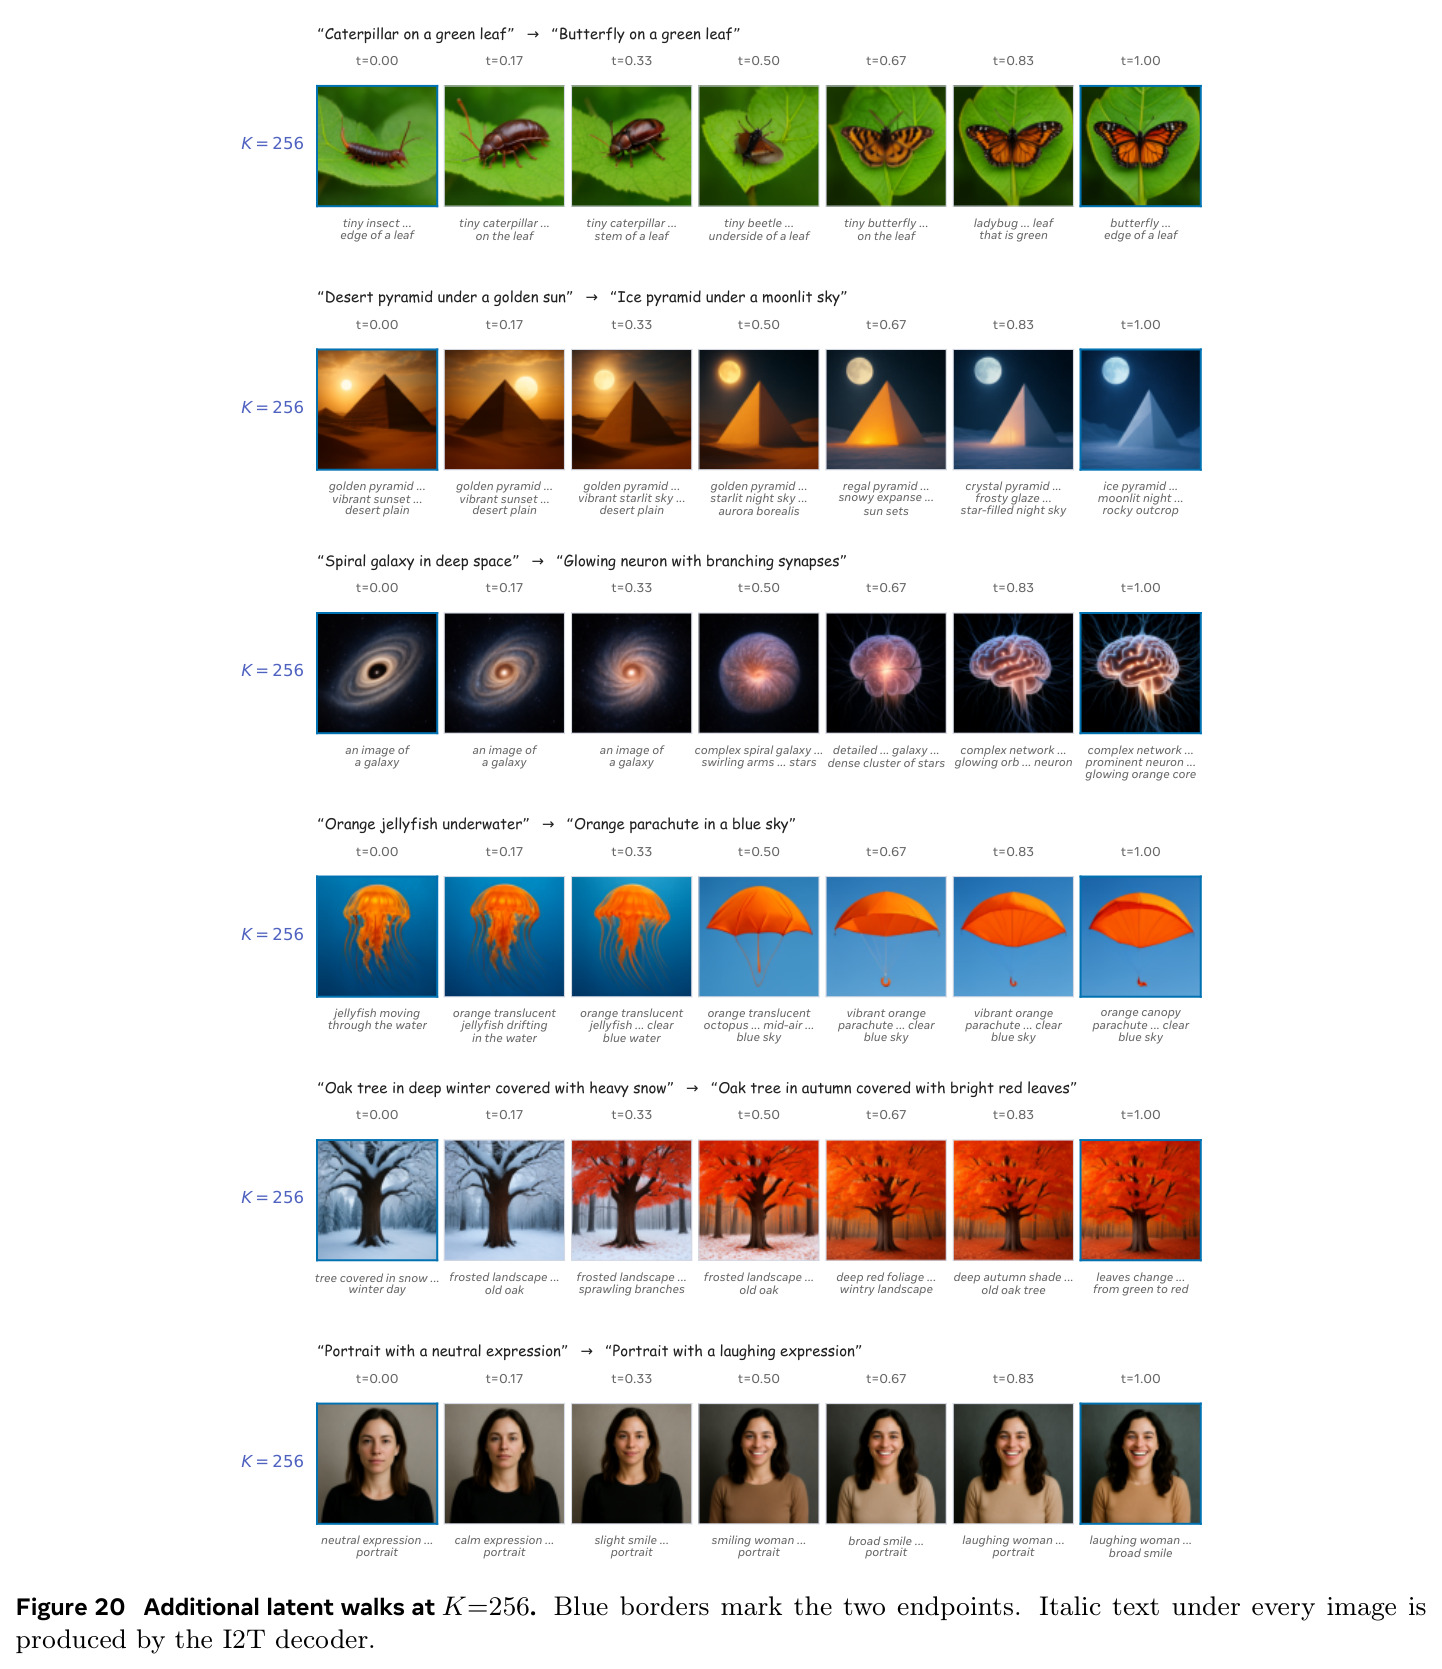
生成方面:微调后 T2I 在 GenEval 上达到 0.83($K=16/64$),使用 2B 骨干且不做 prompt 重写,超过所有对比对象,包括两个 7B 且重写 prompt 的系统(Janus-Pro-7B 0.80、MetaQuery-XL† 0.80)和 MetaQuery-L 的 0.78;逐类别分析(Fig.2)显示 $K=1$ 时颜色绑定仅 0.03,$K=16$ 恢复到 0.67,证明组成性语义需要更大前缀。I2T 在 COCO Karpathy 上 $K=256$ 达 BLEU-4 40.5、CIDEr 138.6、METEOR 31.2、SPICE 24.4,即使 $K=1$(CIDEr 122.0)也超过 CrossFlow(116.2)和 SCD-Net(118.0),虽然仍低于 BLIP-2 的 145.8,但条件特征只有 256×64。检索方面:微调后 COCO R@5 为 86.8(I2T)/75.8(T2I),Flickr30K 为 98.3/93.6;关键发现是 $K$ 几乎不影响检索——从 $K=1$ 到 $K=256$(维度 64→16384)所有指标波动不到 1 个百分点(I2T R@1 63.00→63.54),而 MRL/SAE/CSR 等可变宽度基线在低维时急剧退化(Fig.5)。表征质量方面:ImageNet 线性探针 $K=1$(64 维)73.3%、$K=16$(1024 维)81.2%、$K=64/256$ 81.8%,超过 DREAM 的 72.7%、MAE-B 的 68.0%,远超 SD-VAE latent 的 8.0%;单个 $K=1$ token 的 k-means 能无监督恢复 ImageNet 类别簇(Fig.6)。几何方面:图文质心距离 CLIP 为 0.824、SigLIP2 为 0.992,而 FLAT $K=1$ 降至 0.372、$K=256$ 降至 0.214(Fig.7),支撑了零样本线性插值(Fig.8)、语义算术 $z_{edit}=z_1-z_2+z_3$(Fig.9)与 CIRR 组合检索(Hit@1 44.0)。零napshot预训练 checkpoint 本身 GenEval 0.71、COCO 零样本 R@5 69.1/64.6、CIDEr 63.8。消融(Table 5、Fig.25)显示三损失联合最优,Shapley 分解在 $K=256$ 下对比损失贡献 T2I R@1 提升的 94%、caption 损失贡献 BLEU-4/CIDEr 的 81%、生成损失贡献 GenEval 的 98%。计算方面(Table 12):$K=1$ 使编码器 FLOPs 降 50%、I2T 解码器降 71.1%,但 T2I 仅降 13.8%(被去噪和 VAE 解码主导)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图生成(GenEval,553 prompt,无重写) | GenEval 总分 | 0.83(K=16/64,Qwen3.5-2B 骨干) | Janus-Pro-7B 0.80;MetaQuery-XL† 0.80(7B,含 prompt 重写);MetaQuery-L 0.78 | 以约 1/3 至 1/4 参数量、不加 prompt 重写超过 7B 基线 +0.03;预训练零样本即达 0.71 |
| 图像描述(MS-COCO Karpathy 测试集) | BLEU-4 / CIDEr | 40.5 / 138.6(K=256) | BLIP-2 43.7 / 145.8;CoCa 40.9 / 143.6;CrossFlow 36.4 / 116.2 | 较 CrossFlow +4.1 / +22.4;条件特征仅 256×64(约为 CoCa 256×1408 的 1/22),K=1 也超 CrossFlow 与 SCD-Net |
| 跨模态检索(MS-COCO Karpathy 5k) | R@5(I2T / T2I) | 86.8 / 75.8(任务微调后) | 零样本预训练 checkpoint 69.1 / 64.6(K=1) | 微调带来 +17.7 / +11.2 个百分点;K=1→256 所有指标波动 ≤1 点,远稳于 MRL/SAE/CSR 基线 |
| 跨模态检索(Flickr30k Karpathy 1k) | R@5(I2T / T2I) | 98.3 / 93.6 | 自身 K=1 已达 98.1 / 93.5 | 小数据微调(仅 320 步)即接近饱和,K 几乎不影响 |
| ImageNet-1K 线性探针(冻结表征) | top-1 准确率 | 81.8%(K=64/256);73.3%(K=1,仅 64 维) | DREAM 72.7%(1024 维);MAE-B 68.0%;REPA 62.5%;SD-VAE latent 8.0% | 同维度下超 DREAM +8.5,超过所有已发表的生成式 latent 空间 |
| 零样本组合图像检索(CIRR,MMEB 协议) | Hit@1 / Hit@5 | 44.0 / 75.2(K=1,潜空间算术构造查询) | 未在该任务上做任何训练 | 纯零样本线性算术 $z_q=z_{ref}+\alpha[\sum(z_a-z_0)-\sum(z_r-z_0)]$ 即可驱动检索 |
局限与改进
作者明确承认的局限:其一,小前缀下生成能力受损,$K=1$ 时 GenEval 仅 0.49(甚至低于无预训练的 task-only 版本的 0.60),two objects、position、color binding 等组成类目在 $K=1$ 时接近零分(颜色绑定 0.03),说明全局语义摘要无法编码空间布局与属性绑定;其二,零样本检索性能随 $K$ 增大而退化(COCO I2T R@1 从 44.90 降至 35.48),需任务微调才能消除这种长度敏感性;其三,作者坦承微调带来的指标增益部分来自输出风格对齐而非语义提升——零样本输出中 27.1% 以图像标题式的引号开头,微调主要是让长度和语气贴合 COCO 标注习惯;其四,失败案例(Fig.16)包括渲染文字模糊、次要物体遗漏(羚羊被漏掉)、计数编辑失败等。我自己的观察:检索绝对性能(COCO I2T R@1 63.5)仍明显落后于现代双塔模型(SigLIP2 等可达 80+ R@1),FLAT 的价值在统一性而非单点 SOTA;captioning 距 BLIP-2 尚有 7 个 CIDEr 的差距;T2I 侧 $K$ 从 1 到 256 只节省 13.8% FLOPs,长度自适应的省算力承诺对最贵的生成路径帮助有限;截断优于 null-padding 的结论基于 40k 步、不同训练配方的定性比较,证据强度有限;Shapley 分解在 $K=16/256$ 出现负值(captioning 损失对 GenEval 贡献 -1%~-2%),说明辅助目标并非在所有前缀长度下都严格有益;视频与多语言能力仅有定性展示,没有量化基准。
独立分析的弱点
弱点一:判别性能的绝对水平不足。COCO I2T R@1 只有 63.5,与专用检索模型(EVA-CLIP、SigLIP2 级别,80+ R@1)差距明显,原因可能是 2B VLM 骨干 + 仅 65.7M 对数据对比目标欠火候;改进方向是换更大骨干、扩充对比数据、引入 hard negative 挖掘或 SigLIP 式 sigmoid 损失。弱点二:小 $K$ 的组成性崩塌。$K=1$ 时 GenEval 0.49、颜色绑定 0.03,因为单个 64 维 token 只够存全局语义;可改进为解码器注入长度感知的条件嵌入、或对 $K$ 梯度做课程加权,让单 token 也编码粗布局。弱点三:T2I 侧长度自适应的价值存疑——$K=1$ 到 256 仅省 13.8% FLOPs(去噪与 VAE 解码主导),且 $K=1$ 生成质量大幅下降,「灵活长度」的实际收益集中在编码器和 I2T;改进方向是把前缀压缩同样作用于去噪步数或 latent 分辨率。弱点四:captioning 仍差 BLIP-2 约 7 个 CIDEr,文本解码器只是 2B LM 加 5k 步微调,可引入更强解码器、OCR 辅助特征或更长的 caption 微调。弱点五:算力门槛极高——64 张 H200 跑 135k 步、全局 batch 1024,普通实验室无法复现预训练;可研究分层训练(先对比后生成)或蒸馏小模型。弱点六:零样本检索的 $K$ 敏感退化表明大前缀下对比目标欠约束,逐位置对比可能需要按位置加权或额外正则;弱点七:评测以 GenEval、COCO 这类规则化/短文本基准为主,缺少 FID-30K、人类偏好评估与长 prompt 系统比较,T2I 的真实视觉质量难以据此判断。
未来方向
作者方向上:附录 G 已展示多语言/emoji 理解与 4 帧视频聚合的零样本能力,自然的延伸是把 FLAT 推广到视频、音频等多模态输入与原生分辨率训练,并量化这些迁移能力;把组合检索从手工算术 $z_q=z_{ref}+\alpha[\sum(z_a-z_0)-\sum(z_r-z_0)]$ 升级为可学习的组合算子;扩大前缀梯子(超过 256)以承载更细粒度生成。基于本文成果可延伸的方向:其一,把 FLAT 表征作为任意到任意(any-to-any)统一模型的中间接口——同一个 1D 序列既可被 LM 读、也可被流模型解码,有望替代离散 token 统一理解与生成;其二,利用其线性几何做潜空间编辑(反演+算术)与可控生成,研究插值路径的安全性与可解释性;其三,探索「检索即条件」的应用:先以 $K=1$ 检索近邻,再以大 $K$ 条件化生成,形成检索增强生成的紧凑实现;其四,训练动力学方向,把截断 vs null-padding 的发现形式化,研究嵌套 dropout 在序列模型中的稳定性条件;其五,损失贡献的 Shapley 分析方法本身可复用到其他多目标预训练,指导权重自适应调节;其六,模型压缩:$K=1$ 已省 50% 编码器算力,可进一步蒸馏出「单 token 版 FLAT」用于端侧检索。
复现评估
论文细节披露程度很高但复现门槛分化明显。有利因素:附录 B 给出近乎完整的配置——骨干 Qwen3.5-2B(bfloat16、FlashAttention-2、LoRA $r=16/\alpha=32$,可训练参数仅 11.4M)、register $N=256/d=64$、SANA-1600M@512px 全参微调、16 层 connector、温度 0.07、学习率 $10^{-4}$、500 步 warmup、全局 batch 1024、135k 步,训练数据组成也交代(30M 长 caption + 33M 短 caption + 4M prompt 风格 + 0.1M 精选);评测协议完全可复现(GenEval 固定初始噪声、每 prompt 4 图、20 步采样、CFG 4.5;Karpathy 划分;pycocoevalcap;MMEB CIRR 1000 查询)。主要障碍:65.7M 图文对与 120K 高质量 T2I 微调集均为私有数据,来源未完全公开;预训练需要 8 节点×8 张 H200 约 135k 步,估算为数十万 GPU 时量级,非头部机构难以承受;论文未随文附开源代码链接(仅有项目网站),Qwen3.5 与 SANA 的具体版本依赖需自行对齐。可行的降级复现路径:跳过预训练,用公开 checkpoint(若后续发布)做各任务微调——caption 微调 5k 步、Flickr 检索仅 320 步、消融 40k 步规模均在单节点可承受范围;GenEval、COCO/Flickr 检索与线性探针的评测代码全部基于公开工具链,结果核对容易。综合评级:预训练复现困难(数据+算力双门槛),微调与评测复现中等偏易。
论文图表
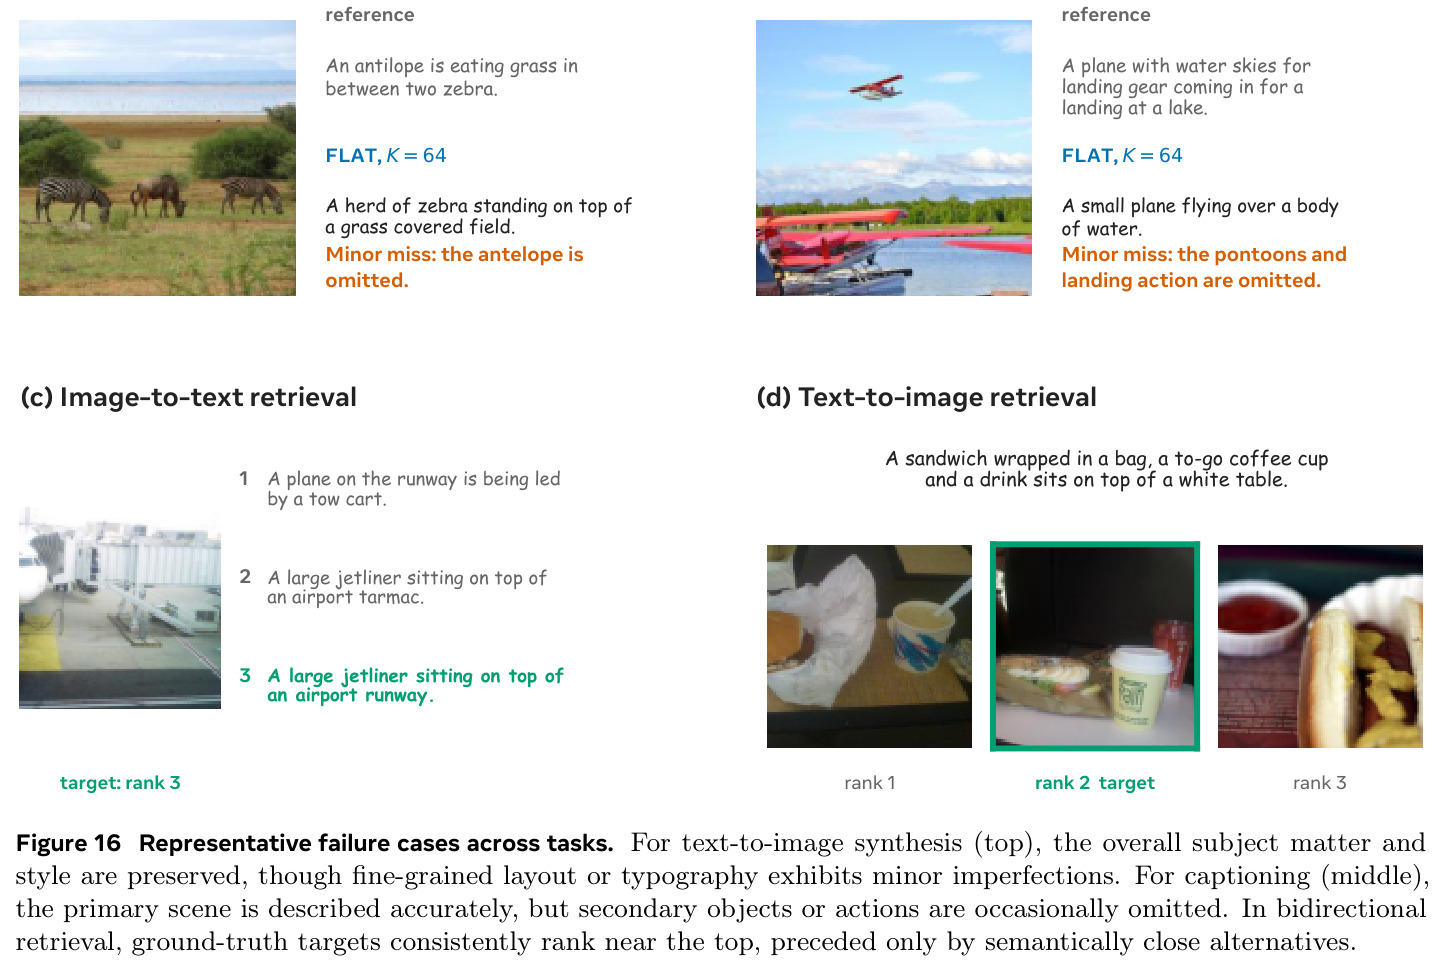
四类代表性失败:T2I 中电商落地页文字模糊、卫星星球图的城市结构表达弱;captioning 漏掉羚羊、漏掉水上滑橇动作;I2T 检索目标排在第 3;T2I 检索目标排在第 2 或前 5 之外。
作者主动展示失败边界:文字渲染、次要物体、计数编辑是系统性短板,帮助读者判断 FLAT 是否适用于自己的场景。