多模态流:嵌入空间中语言与视觉的统一流建模 Multimodal Flow: Unified Flow Modeling of Language and Vision in Embedding Spaces
全连续统一模型:用单一流匹配目标在嵌入空间联合建模文本与图像
前置知识
Flow Matching(流匹配)
一种连续生成建模范式:定义从噪声到数据的线性概率路径 $z_t = t x + (1-t)\epsilon$,训练网络在给定条件 $c_{<k}$ 下回归沿路径的速度场 $v = x - \epsilon$,推理时从高斯噪声出发对学到的向量场做 ODE 积分还原样本。相比扩散模型,它的训练目标更简单(速度 MSE)、概率路径更直、采样步数更少。
本文整个框架建立在 Flow Matching 之上:文本块与图像块的生成单元共享同一个速度 MSE 目标 $\mathcal{L}_{flow}$,不懂流匹配就无法理解其统一性的来源。
视觉 tokenizer 与量化瓶颈
全离散多模态模型(Chameleon、Emu3、Show-o)用 VQ 类 tokenizer 把图像压缩成离散码本索引,使图像与文本 token 共用一套序列建模流程。但量化不可逆:码本覆盖不到或被压缩掉的视觉细节永久丢失,生成保真度的上限被 tokenizer 决定,提高保真度又要付出码本更大、序列更长的代价。
本文的核心动机就是绕开这个瓶颈。理解全离散路线为何受伤(如 LWM 在 GenEval 只有 0.47),才能理解'全连续'路线的价值主张。
Chunk-causal 注意力(块级因果掩码)
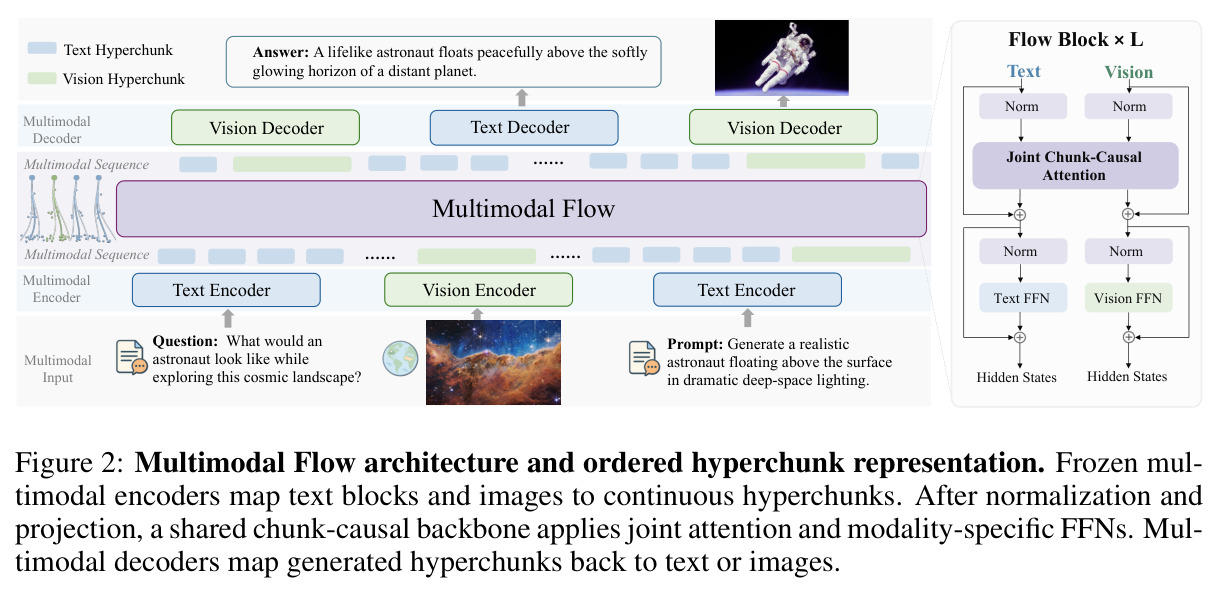
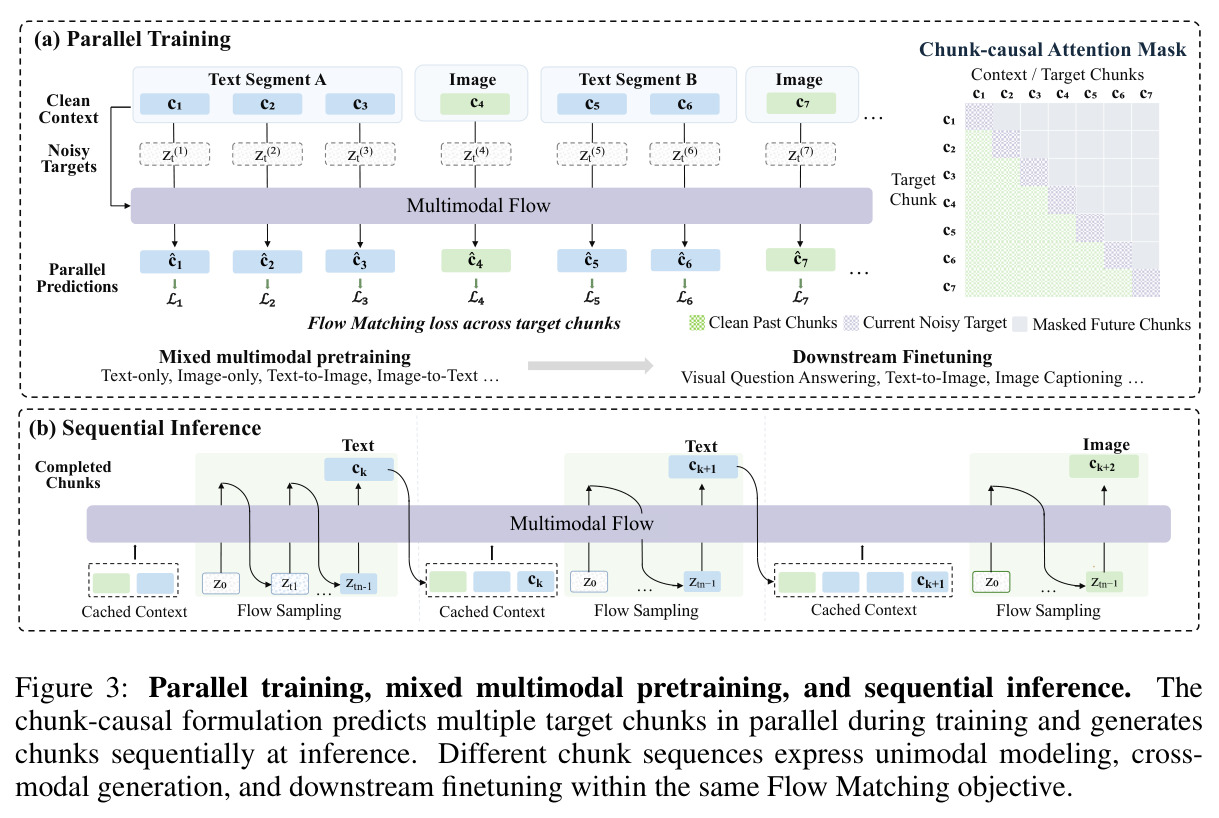
把序列切成块(chunk)后施加的掩码机制:预测当前块 $c_k$ 时,所有先前块 $c_{<k}$ 的干净状态可见,块内位置互相可见(联合建模,非自回归),未来块全部遮蔽。相当于把 next-token 的因果性上移到块级,使训练时可以在一次前向中并行预测多个目标块,推理时按块顺序生成并复用 KV 缓存。
这是本文骨干的核心机制:训练并行、推理串行、KV cache 三者的成立都依赖它,也是 MF 与 Transfusion 等 token 级混合模型的本质结构差异。
Classifier-Free Guidance(CFG,无分类器引导)
一种推理期增强手段:同时计算有条件预测 $\hat{x}_{\theta,c}$ 和无条件预测 $\hat{x}_{\theta,\emptyset}$,用 $\hat{x}_{\theta,\gamma} = \hat{x}_{\theta,\emptyset} + \gamma(\hat{x}_{\theta,c} - \hat{x}_{\theta,\emptyset})$ 外推放大条件的影响,引导强度由尺度 $\gamma$ 控制,越大条件遵从越强但多样性下降。
本文展示同一个 CFG 机制可以同时服务文生图(最佳 $\gamma=5$)和图像描述(最佳 $\gamma=3$)两个方向的生成,这是全连续范式的独特卖点,见图 5(b)。
语义视觉表征与 RepA
与重建导向的 VAE 潜变量不同,SigLIP2、DINOv2 这类图文对齐/自监督编码器输出的 patch 特征携带高层语义。RepA(Representation Autoencoder)路线证明:生成模型直接在语义表征上训练扩散/流,比在 VAE 潜变量上更高效,再由配对的解码器还原图像。本文用冻结的 SigLIP2-so400m 提供 $256 \times 1152$ 的视觉超块。
视觉连续状态选什么表征是本文最重要的消融之一(Figure 5a:DINOv2 生成最强、SigLIP2 更均衡、VAE 潜变量与原始像素都差),直接影响对实验结论的理解。
序列打包(Sequence Packing)
把多个独立样本拼进一个固定最大长度(本文 32768 个位置)的物理序列以提升 GPU 利用率。通过给每个样本分配序列标识符,chunk-causal 掩码只允许样本内部按规则交互、阻断跨样本注意力,padding 位置不参与注意力,从而在长度差异巨大的多模态数据上保持训练效率。
多模态样本(纯文本/图文对/纯图像)长度差异极大,本文的训练效率与正确性都建立在打包机制上,附录 B.3 给出了实现细节。
研究动机
当前统一多模态模型分两大范式,各有结构性缺陷。全离散路线(Chameleon、Emu3、Show-o、UniDisc 等)用视觉 tokenizer 把图像量化成离散 token,与文本共享同一序列和生成目标,对齐性好但视觉保真度被 tokenizer 卡死——量化丢弃的细节模型永远无法恢复,而提高保真度需要更大码本或更长序列;体现在指标上,LWM 在 GenEval 只有 0.47,UniDisc 只有 0.42,Emu3-Gen(8B)也只有 0.54。混合离散-连续路线(Transfusion、JanusFlow、D-DiT)保留连续视觉状态、避免量化,但文本走离散交叉熵、图像走扩散或流,同一个系统必须协调两套训练目标、两套扰动时间表和两套采样流程。真正的全连续建模(语言和视觉都在连续嵌入空间、共享一个目标和一个采样过程)可以同时规避这两个问题,但此前的工作要么只做文本嵌入流(ELF)、要么围绕联合去噪或预定义跨模态路径(UniDiffuser、OmniFlow),没有人验证过:随机初始化的连续骨干能否像 LLM 一样从零做多模态混合预训练并迁移到下游。
本文的目标是本文要建立并验证一个'全连续'的统一多模态生成范式:语言和视觉各自保留模态原生的连续嵌入表征(不做任何量化),却共享同一个生成目标——Flow Matching 的速度回归——和同一套 ODE 采样流程。落到具体技术问题上是三问:一是每种模态的'生成单元'应该是什么(答案是保留 token 序结构/图像空间结构的连续超块 hyperchunk);二是这些单元如何组成有序的条件生成过程(答案是块级因果分解 $p_\theta(C)=\prod_k p_\theta(c_k|c_{<k})$);三是模型如何在模态间共享交互又尊重各自的表征统计(答案是 joint attention 加模态专属 FFN)。最终目标是证明:实例化出的 MF-1 在 0.6B/1.2B/1.6B 三个规模、仅 150B token 的从零预训练下,能在 GenEval、DPG-Bench 等生成指标和 VQAv2、MMBench、POPE 等理解指标上,与用数倍数据训练的统一模型竞争。
与已有工作不同的是,本文的独特切入是把'任务定义的多模态序列'做因果化分解,而不是简单拼接连续嵌入。与 ELF(只建模文本嵌入流)不同,它把文本块和图像统一为有序超块序列;与 UniDiffuser、OmniFlow 等联合去噪系统不同,它以 chunk-causal 方式因子化序列,从而天然支持 KV 缓存和任务定义的任意模态顺序;与 Transfusion 不同,文本不再是 next-token 交叉熵,而是与图像完全同构的连续流目标,四种数据路径(text-only、image-only、text→image、image→text)在同一个 $\mathcal{L}_{flow}$ 下混合预训练。另外它采用'冻结编解码器 + 可训练流骨干'的解耦设计:T5-small 文本编码器、SigLIP2 视觉编码器、RepA 图像解码器、单独训练的文本解码器全部冻结,骨干只学嵌入空间之间的向量场,使得下游微调时任务序列可换而模型接口与目标完全不变。
核心方法
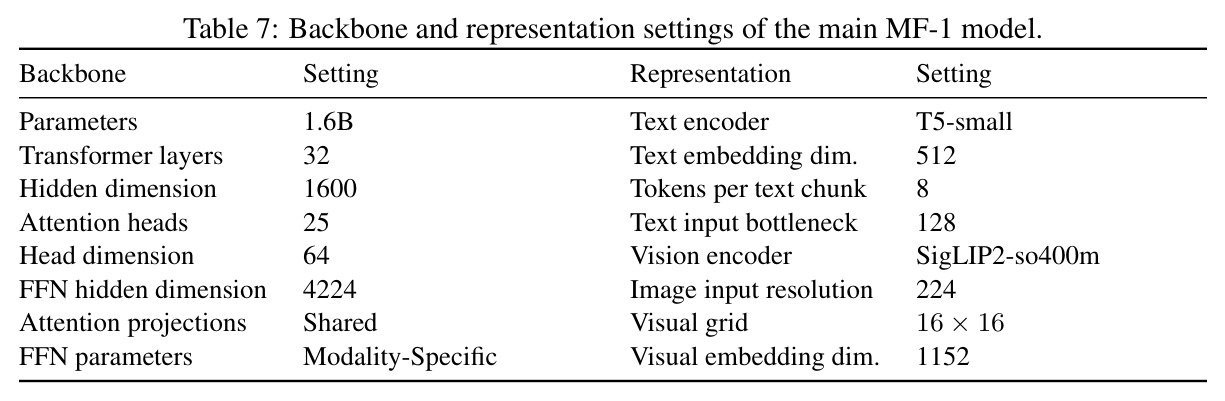
直觉上,这篇文章把'下一 token 预测'推广为'下一超块的连续流生成'。文本按 $B=8$ 个 token 切块,每块由冻结的 T5-small 编码成一个 512 维连续向量(文本超块),保留 token 顺序;一张 $224\times224$ 图像由冻结的 SigLIP2-so400m 编成 $256\times1152$ 的空间网格(视觉超块),保留空间结构。一个样本因此变成有序超块序列 $C=(c_1,\ldots,c_K)$,联合分布按块因果分解 $p_\theta(C)=\prod_{k=1}^{K} p_\theta(c_k \mid c_{<k})$,块内位置联合建模。骨干用线性概率路径 $z_t^{(k)} = t x^{(k)} + (1-t)\epsilon^{(k)}$ 的 Flow Matching:给定先前干净块和加噪目标,预测干净端点 $\hat{x}_\theta$,再换算成速度 $\hat{v}=(\hat{x}_\theta - z_t)/\max(1-t,\,0.05)$ 做速度 MSE。主模型 MF-1 骨干 1.6B 参数、32 层、宽 1600、25 头(头维 64):共享的 joint attention 负责跨模态交互,模态专属 FFN(4224)处理各自表征,MRoPE 同时编码块间顺序与块内位置,序列打包上限 32768。训练时块因果掩码允许一次前向并行预测全部目标块(每块独立采样时间步),推理时按任务顺序逐块生成并复用 KV 缓存。
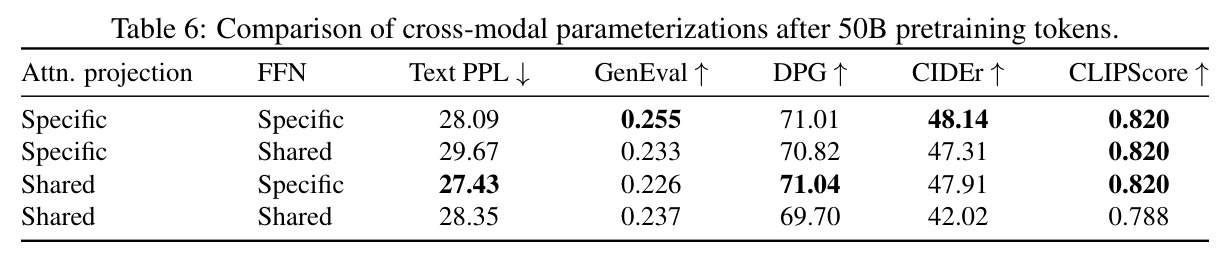
核心创新是'连续超块 + 块因果流'这一组合:语言与视觉首次在完全相同的连续目标(速度 MSE 的 Flow Matching)下从零混合预训练。与全离散范式相比,它没有量化瓶颈——视觉状态是 $256\times1152$ 的连续语义特征,tokenizer 不构成信息上限;与 Transfusion 式混合范式相比,它没有目标分裂——文本块不是 8 个 token 的自回归交叉熵,而是一个与图像同构的连续嵌入分布,文本和图像用同一组流参数、同一套 ODE 采样器生成。块内联合、块间因果的粒度设计兼顾了效率(训练并行、推理 KV 缓存)与结构保留(token 序与图像网格不被打平)。跨模态交互由共享的 joint attention 承担,而模态专属 FFN 吸收两模态的表征统计差异——消融显示这一拆分至关重要:FFN 共享会把 CLIPScore 从 0.820 拖到 0.788、CIDEr 从 48.14 掉到 42.02。此外,同一个 CFG 机制在两个方向上都有效(文生图最佳尺度 5、图生文最佳尺度 3),说明连续流学到的条件结构在模态间是对称的。
方法步骤详情
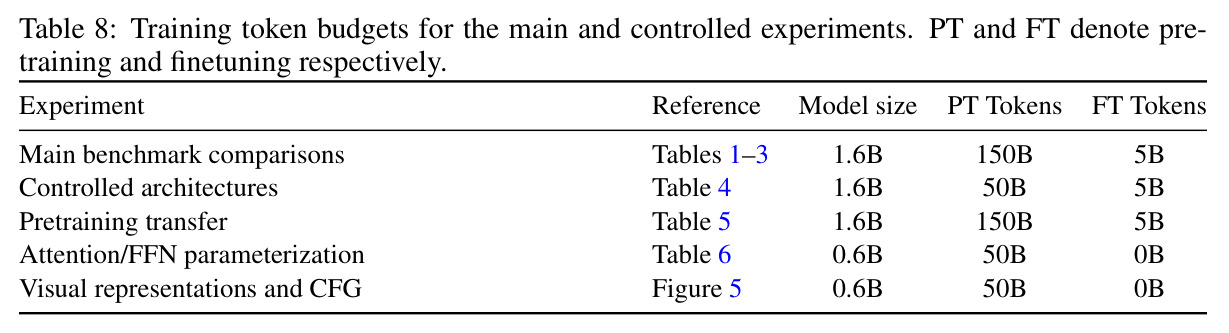
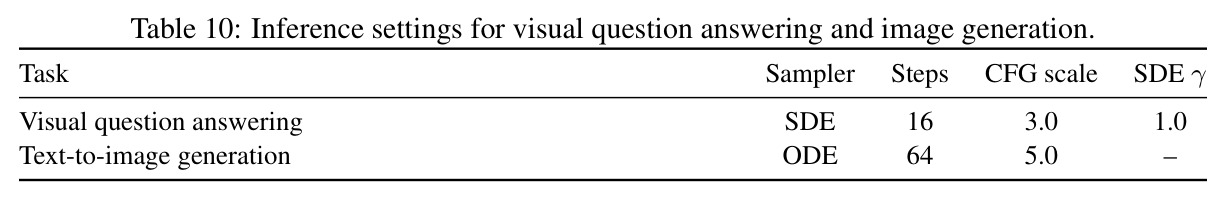
第一步,编码:文本切成 $B=8$ 的块,冻结 T5-small 把每块编为 512 维向量,按维度共享常数($\mu=0$、$\sigma=0.2$)归一化;图像 $224\times224$ 过冻结 SigLIP2-so400m 得 $256\times1152$ patch 网格,逐位置逐通道归一化(统计量来自 50176 张 GPIC 图像)。第二步,构造任务序列:text-only 全部块为目标;图文对做双向(文本块在前→图像目标,或图像在前→文本目标);image-only 只有一个视觉目标块。第三步,加噪:每个目标块独立采时间步(偏移 logit-normal:$z\sim N(0,1)$、$q=\alpha u/[1+(\alpha-1)u]$、$t=1-q$,图像 $\alpha=8$、文本 $\alpha=6$),构造 $z_t=tx+(1-t)\epsilon$。第四步,骨干前向:MRoPE 加位置,chunk-causal 掩码下 joint attention + 专属 FFN,预测 $\hat{x}_\theta$ 并按 $\hat{v}=(\hat{x}_\theta-z_t)/\max(1-t,0.05)$ 转速度,对有效位置求速度 MSE。第五步,混合预训练 150B token:70% 纯文本(Ultra-FineWeb-L3)、20% 图像理解(LLaVA-OneVision-1.5)、9% 文生图(GPIC)、1% 图像-only,1.6B 骨干从零训练。第六步,下游微调 5B token:文生图用 BLIP3o-60k、LAION DALL-E 3、ShareGPT-4o-Image,VQA 用 LLaVA-v1.5 指令数据,冻结编解码器、接口与损失不变。第七步,推理:逐块生成——文生图 ODE 64 步、CFG 5.0;VQA SDE 16 步、CFG 3.0;完成块的 KV 进缓存。
技术新颖性
技术新颖性体现在五点。其一,生成单元的设计:不是拼接连续嵌入而是'超块'——文本超块封装 token 序结构、视觉超块封装 $16\times16$ 空间网格,MRoPE 同时编码块间顺序与块内结构,使异构模态获得统一的条件生成接口。其二,因果性的粒度上移:chunk-causal 掩码把自回归的因果性从 token 级抬到块级,训练端一次前向并行预测所有目标块(各块独立时间步),推理端顺序生成且可 KV 缓存,兼得并行训练效率与串行生成的灵活性。其三,全连续预训练的首次系统验证:随机初始化骨干、150B token、与 Transfusion 式/Chameleon 式架构在同数据、同优化、同可训练参数预算(差距不超过 0.00156%)下对照,直接回答'范式本身孰优'而非'工程孰优'。其四,实证确立语义表征优于重建表征的结论:DINOv2/SigLIP2 嵌入显著优于 FLUX.2/SD-VAE 潜变量和原始像素,为 RepA 路线在统一模型中的适用性提供证据。其五,双向 CFG:证明同一引导机制可同时提升文生图与图像描述,暗示连续流空间中的条件结构具有跨模态对称性。
实验结果
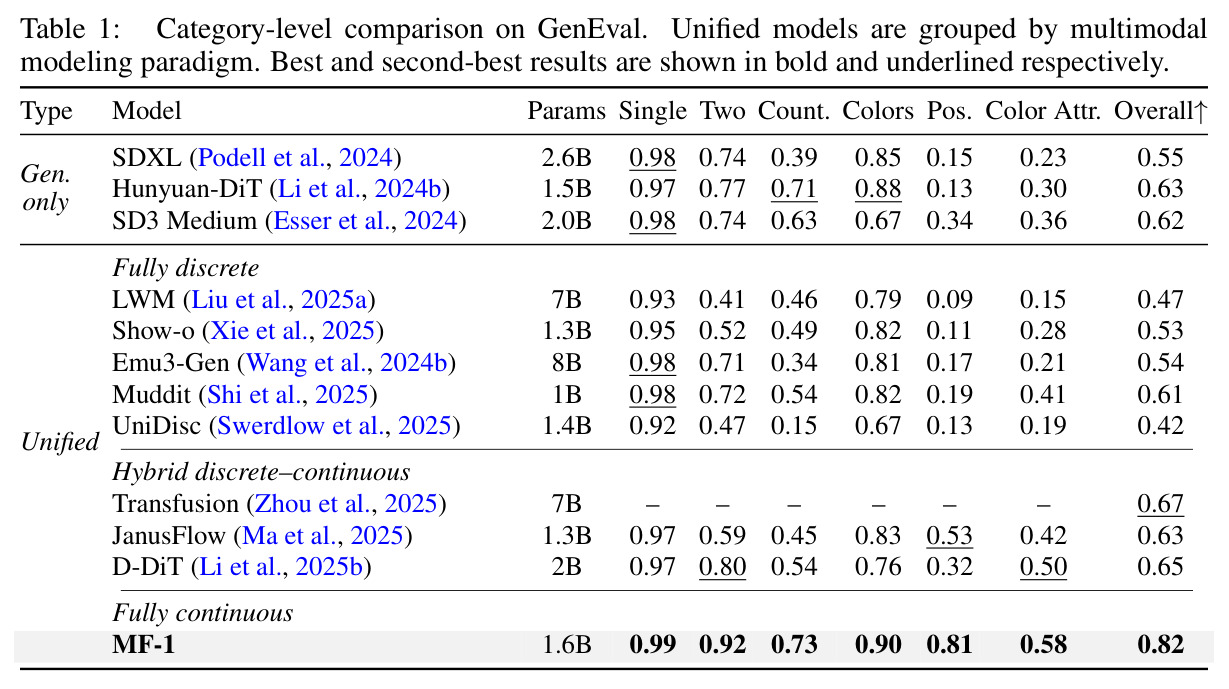
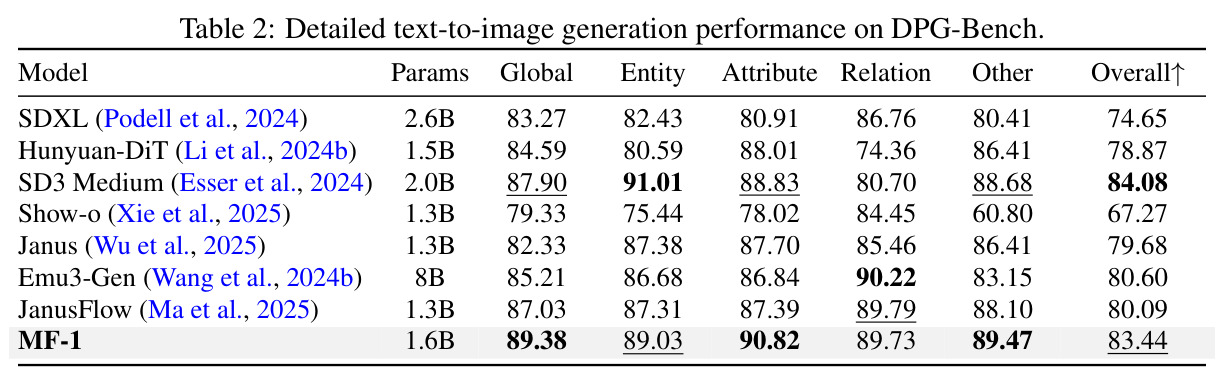
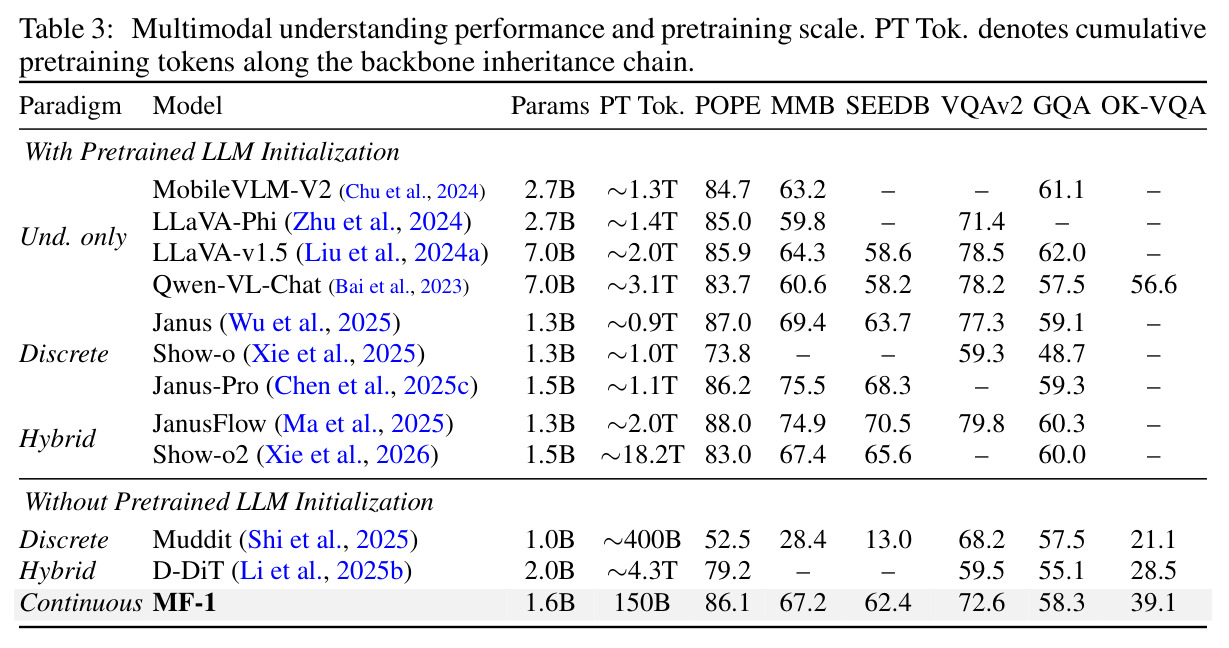
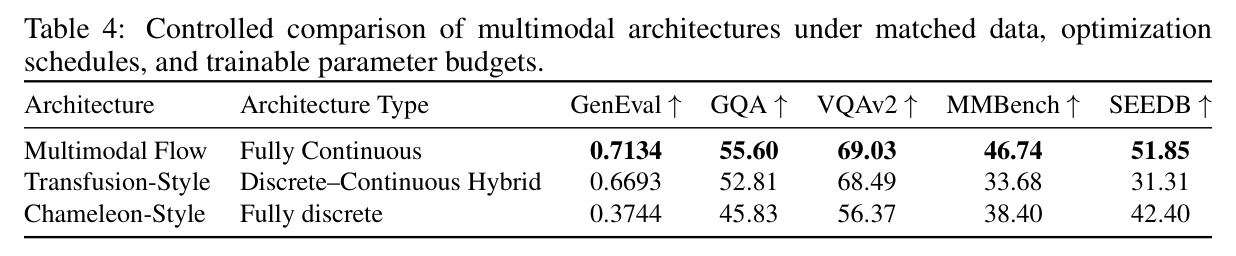
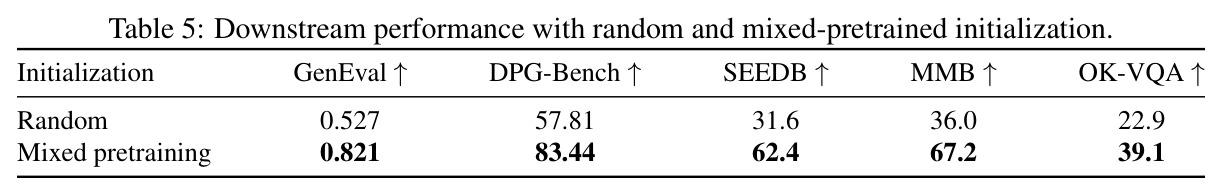
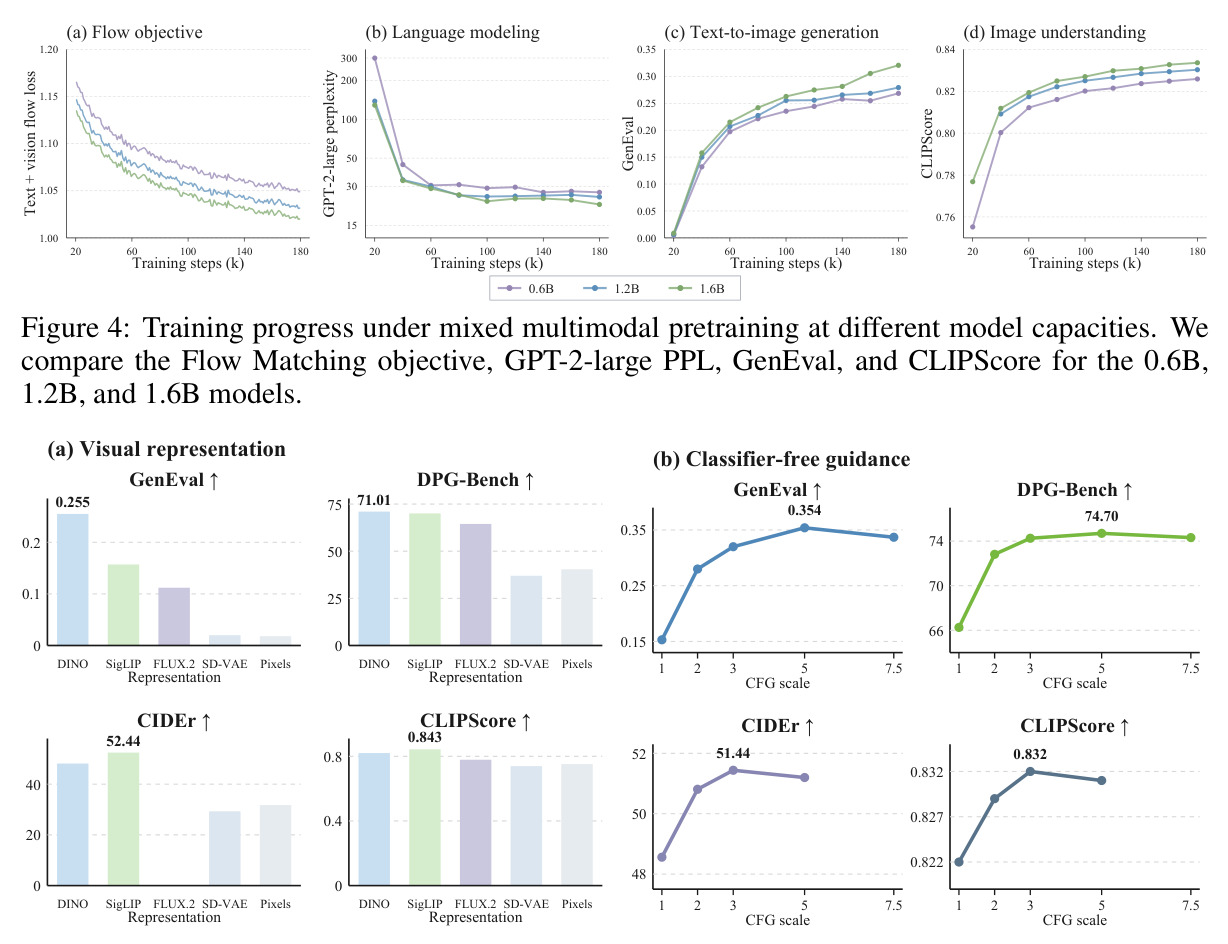
主结果分四块。第一,绝对性能:1.6B 的 MF-1 仅用 150B token 从零预训练、5B token 微调,GenEval 0.821(Single 0.99、Two 0.92、Counting 0.73、Colors 0.90、Position 0.81),DPG-Bench 83.44,两项均为统一模型最佳——GenEval 比 JanusFlow(0.63)高 0.19、比 7B Transfusion(0.67)高 0.15;理解侧 POPE 86.1、MMBench 67.2、SEED-Bench 62.4、VQAv2 72.6、GQA 58.3、OK-VQA 39.1,全面超过同为从零训练的 Muddit(POPE 52.5、MMB 28.4)和 D-DiT(VQAv2 59.5),接近有 LLM 初始化且数据十倍于己的 JanusFlow(MMB 74.9、VQAv2 79.8)。第二,受控架构对比(1.6B、50B+5B token、参数差 ≤0.00156%):MF-1 GenEval 0.7134 > Transfusion 式 0.6693 > Chameleon 式 0.3744;MMBench 46.74 vs 33.68 vs 38.40;SEEDB 51.85 vs 31.31 vs 42.40,说明全连续的优势在公平条件下依然成立。第三,预训练迁移:与补齐总预算(155B token)的随机初始化基线比,混合预训练把 GenEval 0.527→0.821、DPG 57.81→83.44、SEEDB 31.6→62.4、MMB 36.0→67.2、OK-VQA 22.9→39.1,收益来自可迁移表征而非 token 曝光量。第四,消融:0.6B→1.6B 扩展曲线上 flow loss 与 PPL 持续下降、GenEval 与 CLIPScore 持续上升;视觉表征上 DINOv2 生成最强(GenEval 0.255、DPG 71.01)但 SigLIP2 生成-描述更均衡(CIDEr 52.44、CLIPScore 0.843),VAE 潜变量与原始像素全面落后;参数化上共享注意力投影+专属 FFN 最优(PPL 27.43),共享 FFN 使 CLIPScore 跌至 0.788;CFG 对描述最佳尺度 3、对文生图最佳尺度 5。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图(组合生成) | GenEval Overall | 0.821 | JanusFlow 0.63;Transfusion 0.67;Emu3-Gen 0.54 | 统一模型最高,较次优的 Transfusion +0.151,较同量级 JanusFlow +0.191 |
| 文生图(长提示对齐) | DPG-Bench Overall | 83.44 | SD3 Medium 84.08(生成专用);Emu3-Gen 80.60;JanusFlow 80.09 | 统一模型最高,逼近生成专用模型 SD3 Medium |
| 多模态理解 | MMBench | 67.2 | Muddit(从零)28.4;JanusFlow(LLM 初始化,约 2T token)74.9 | 较同从零训练的 Muddit +38.8;与 LLM 初始化模型差距缩至 7.7 |
| 多模态理解(幻觉) | POPE | 86.1 | Muddit 52.5;D-DiT 79.2;Janus-Pro 86.2 | 与 1.1T token 的 Janus-Pro 持平(仅 -0.1),远超 Muddit +33.6 |
| 视觉问答 | VQAv2 | 72.6 | D-DiT 59.5;Show-o 59.3;JanusFlow 79.8 | 较同从零训练的 D-DiT +13.1 |
| 受控架构对比(同数据同优化同参数) | GenEval | 0.7134 | Transfusion 式 0.6693;Chameleon 式 0.3744 | 较混合范式 +0.0441,较全离散范式 +0.3390 |
| 受控架构对比 | SEED-Bench | 51.85 | Transfusion 式 31.31;Chameleon 式 42.40 | 较混合范式 +20.54 |
| 预训练迁移(1.6B,150B+5B token vs 随机初始化 155B token) | SEED-Bench | 62.4 | 随机初始化 31.6 | +30.8,同时 MMBench +31.2、GenEval +0.294 |
局限与改进
作者承认两点局限:规模验证有限——所有结论都在 0.6B–1.6B、150B token 内得出,尚未触及 7B+ 参数或 T 级 token;任务覆盖有限——交错长序列、视频及其他结构化模态留作未来工作。我的观察还有五点:其一,理解侧与 LLM 初始化模型仍有实质差距(MMBench 67.2 vs JanusFlow 74.9、VQAv2 72.6 vs 79.8),说明连续流骨干的语言能力弱于同规模自回归 LLM,文本 PPL 也只到 28 左右(0.6B、50B token 时 28.09);其二,块内 8-token 联合并行预测类似非自回归生成,块间一致性完全依赖因果序,长文本细粒度连贯性存疑,而论文用 GPT-2-large PPL 这一外部指标而非语言任务评测来度量文本质量;其三,固定 $B=8$ 切块可能切断词与句法边界,论文未讨论块大小的敏感性;其四,系统依赖四个外部冻结组件(T5-small、SigLIP2、RepA 图像解码器、单独预训练的文本解码器),链路误差传播与工程复杂度不低;其五,224×224 输入与 $16\times16$ 网格限制细粒度生成上限(GenEval Color Attr 0.58),且理解评测集中于 VQA 类基准,缺少 MMMU 级推理评测。
独立分析的弱点
弱点一:文本生成是短板。块内 8-token 并行预测属非自回归式生成,块间只靠因果前缀衔接(0.6B/50B token 时 PPL 28.09)。改进:句法感知或可学习的块切分替代固定 $B=8$;对文本目标加 token 级辅助损失或块内迭代精修。弱点二:视觉分辨率与网格过粗(224×224、256 个位置),细粒度属性生成受限(Color Attr 0.58)。改进:多分辨率渐进超块、局部窗口超块或更高分辨率语义编码器配窗口注意力。弱点三:70/20/9/1 的任务混合比纯手工设定且未做敏感性分析,仅 9% 的文生图数据却承担核心生成能力。改进:按损失归一化的动态任务加权或混合比搜索。弱点四:训练-推理不一致——训练时多个目标块在各自独立时间步下并行预测,推理时单块串行 ODE,块数多时误差可能累积。改进:训练中随机只更新部分目标块以模拟串行条件。弱点五:评测偏经典 VQA 基准,缺 MMMU/MathVista 级推理评测,'理解能力'结论的外推性有限。
未来方向
作者提出的方向:把超块流范式扩展到更长的交错序列、视频和其他结构化模态——这正是 chunk 接口的优势,任何有内部结构的模态都可封装成超块接入同一骨干。基于本文成果可延伸:其一,scale-up 研究——在 7B+ 参数、T 级 token 上重跑范式对照,验证全连续范式的 scaling law,0.6B→1.6B 的全面改善趋势支持这个方向;其二,效率结合——作者团队有 InfiniteVL(线性+稀疏注意力)与 DiG(门控线性注意力扩散)的积累,块因果流可与线性注意力结合做长上下文多模态流;其三,块级推断优化——利用块内联合建模做自适应提前退出、块间投机解码或独立目标块的并行生成;其四,语言质量专项——更大的文本解码器、迭代解码,或在连续嵌入空间做 RLHF/DPO 式偏好对齐,缩小与 AR LLM 的差距;其五,表征研究——DINOv2 与 SigLIP2 各有所长的结果提示混合表征或按任务路由表征可能进一步提效;其六,同一 CFG 机制在两个方向都有效,暗示可研究跨模态统一的引导与对齐框架。
复现评估
复现透明度较高。代码与模型已在 github.com/hustvl/Multimodal-Flow 公开。数据侧:预训练需 GPIC、LLaVA-OneVision-1.5、Ultra-FineWeb-L3 三套公开数据,微调用 BLIP3o-60k、LAION DALL-E 3 Discord、ShareGPT-4o-Image 和 LLaVA-v1.5 指令数据,均为公开资源。冻结组件需对齐:T5-small 与 SigLIP2-so400m 可直接下载;RepA 图像解码器依赖 Tong et al. 2026 的发布;文本解码器需按附录 B.2 自行预训练(6 层双向 Transformer、宽 512,含 $\lambda=\sigma(0.8+0.8z)$ 扰动公式的完整流程)。算力:主模型 1.6B 骨干 150B token 从零预训练属中等规模,估计需数百张 A100/H100 级 GPU(论文未披露 GPU 时数),是复现主结果的主要门槛;0.6B/50B token 的架构对照与消融(Table 6、Figure 5)在高校实验室可承受。附录信息充分:Table 7 给全部超参、Table 8 给 token 预算、B.3 给时间步采样与 32768 序列打包细节、Table 10 给推理采样配置。主要风险是三套预训练数据管线的复刻与冻结模型版本对齐带来的数值差异。
论文图表
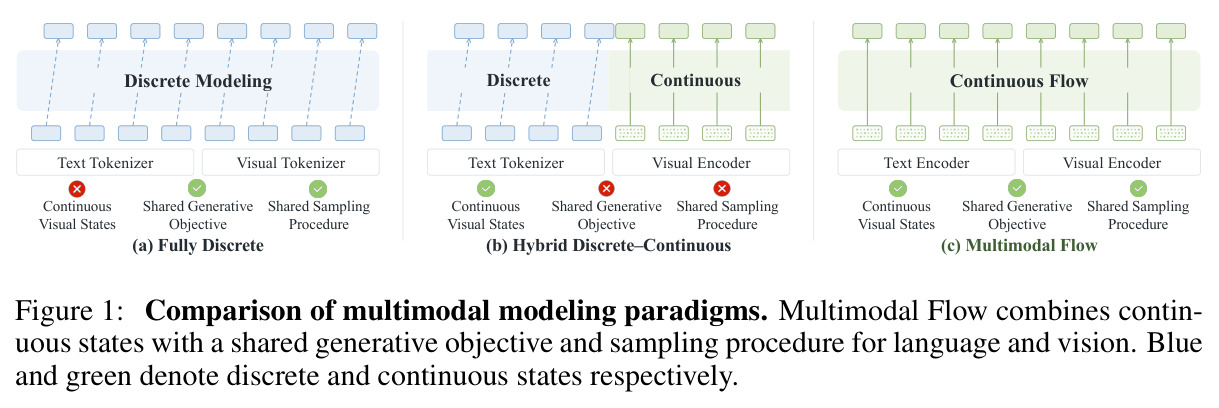
三栏对比图:(a) 全离散范式——文本与视觉都经 tokenizer 量化为离散状态;(b) 混合离散-连续范式——文本离散、视觉经编码器保持连续,但生成目标和采样流程不统一;(c) Multimodal Flow——文本编码器与视觉编码器都输出连续状态,且共享同一生成目标(Flow Matching)和同一采样流程。蓝色表示离散状态,绿色表示连续状态。
一图讲清论文的问题定位:现有两类范式各缺一角(连续状态或共享目标),而 MF 同时占住'连续状态 + 共享目标 + 共享采样'三个格子,是全文论证逻辑的起点。
(a) 在 0.6B/50B token 设定下比较 DINOv2、SigLIP2 语义表征与 FLUX.2 VAE、SD-VAE 潜变量及原始像素:DINOv2 生成指标最强(GenEval 0.255、DPG 71.01),SigLIP2 描述指标更强(CIDEr 52.44、CLIPScore 0.843),VAE 潜变量和像素全面落后。(b) 固定 0.6B EMA 检查点只调 CFG 尺度:图像描述在尺度 3 最佳,文生图在尺度 5 最佳、继续增大后回落。
两个最重要的设计消融:视觉连续状态选什么表征、CFG 强度如何按模态设定。前者给出'语义表征优于重建表征'的关键结论,后者证明 CFG 的跨模态通用性。
三种受控架构的表征与目标配置:Multimodal Flow 用 T5 潜变量(512 维、8 token 块)+ SigLIP2 潜变量(256×1152),全部流目标;Chameleon 式用 T5 token ID + Janus VQ-16(576 个 ID、16384 码本),全部自回归;Transfusion 式用 T5 token ID 自回归 + SigLIP2 潜变量流。三者骨干同规格(32 层、宽 1600、RMSNorm),FFN 宽度微调至参数差 ≤25536。
说明受控对比如何做到'只差范式、不差别的':表征、目标、参数预算的逐项对齐是 Table 4 结论可信的基础。